做电商运营的都知道,多平台开店公认的痛不是没流量,而是重复劳动。同一个商品,要在拼多多、抖店、淘宝、速卖通、Temu、Shopee 上各上一遍,标题、主图、详情、SKU、库存,每个后台填一遍,一天下来上架二三十个品,人就已经麻了。
更难受的是,很多团队的做法是一个平台买一套工具,脚本各写各的,维护成本翻倍。其实换个思路:电商平台的后台逻辑高度同质化,完全可以抽象出一套通用的批量上架流程,再按平台做少量适配。这篇文章把这套方案从数据结构设计到异常处理完整拆开,附可直接套用的 JSON 数据规范和流程伪代码。
一、为什么"一套流程适配多平台"在技术上成立
拆开看各平台商家后台,批量上架的核心链路几乎一致:
登录店铺后台(或客户端)
进入商品发布页
填写类目、标题、属性、SKU、价格、库存
上传主图和详情图
提交审核 / 存入仓库
差异只体现在三处:
入口不同:拼多多、抖店、跨境平台以网页后台为主,淘宝侧千牛客户端占比高;
字段不同:类目结构、属性项、运费模板、资质要求的表单字段不同;
风控不同:滑块、短信验证、登录态有效期不同,账号矩阵还要考虑环境隔离。
所以正确架构是:核心流程抽象成通用骨架 + 平台差异封装为子流程 + 账号环境由指纹浏览器隔离。新增平台时只补一个适配子流程,而不是重写整套流程。这个架构能成立的前提,是数据层足够规范------先看数据怎么设计。
二、数据层:一份商品数据喂所有平台
建议商品数据用 JSON 或 Excel 单表维护,字段规范如
{
"spu_id": "SPU20261003001",
"platforms": "pdd", "douyin", "taobao", "cross",
"title_raw": "秋冬加绒加厚男士卫衣 宽松套头休闲外套",
"category": {
"pdd": 12345,
"douyin": "67890",
"taobao": "50012345",
"cross": "apparel-hoodies"
},
"attrs": {
"material": "棉65%+聚酯纤维35%",
"season": "秋冬",
"style": "宽松"
},
"skus": [
{"spec": "黑色/M", "price": 89.9, "stock": 200},
{"spec": "黑色/L", "price": 89.9, "stock": 150}
],
"images": {
"main": "D:/goods/001/main1.jpg", "D:/goods/001/main2.jpg",
"detail": "D:/goods/001/detail1.jpg"
},
"platform_rules": {
"title_max_len": {"pdd": 30, "douyin": 60, "taobao": 60}
}
}
要点有两个:
类目、标题长度等平台差异字段前置声明,流程运行时不做硬编码判断;
清洗规则集中管理------比如拼多多标题限 30 字,流程里加一步"按平台截断+关键词保留",规则变更只改数据层,不动流程。
三、主流程伪代码
FOR 每条商品数据 IN 数据表:
FOR 每个目标平台 IN 商品.platforms:
环境 = 指纹浏览器.打开(店铺对应指纹配置) // 防关联隔离
TRY:
结果 = 调用子流程(平台 + "上架", 商品, 环境)
数据表.回写(spu_id, 平台, 状态=成功, 商品链接=结果.url)
CATCH 异常:
截图存证("fail " + spu_id + "_" + 平台 + ".png")
数据表.回写(spu_id, 平台, 状态=失败, 原因=异常信息)
FINALLY:
环境.关闭()
随机等待(3~8秒) // 模拟人工节奏,降低风控触发
三个工程细节:
单条失败不中断整批:异常捕获 + 截图 + 日志回写是底线,绝不能让一个商品卡住几百个品的批量任务;
随机等待必须加:固定间隔的机械化操作是风控识别的典型特征;
结果回写要落到表:运营早上打开表格就能看到哪些成功、哪些失败、失败原因,这是"能跑"和"好用"的分水岭。
四、平台适配差异对照
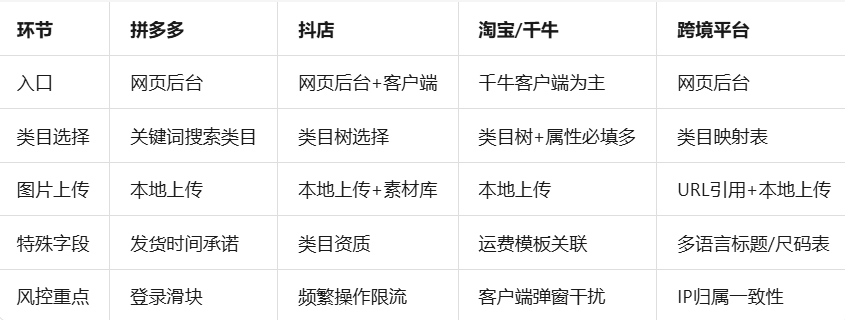
账号矩阵部分,建议一个店铺对应一个指纹浏览器环境(紫鸟、比特、Hubstudio、AdsPower 这类主流方案均支持被自动化工具接管),批量上架按店铺循环切换,环境之间完全隔离。这是防关联的底线,省什么都不能省这个。
五、批量上架流程最容易翻车的三个技术点
- 页面改版导致元素失效
所有网页RPA的噩梦。平台后台一升级,写死的 xpath 批量失效。传统元素路径长这样:
/html/body/div3/div2/div1/div2/form/div5/input1
这种绝对路径在批量上架场景基本不可用------页面插一个 div 就全断。稳妥的做法:
优先用 id、name、placeholder 等稳定属性,其次才是结构相对路径;
利用工具自带的本地智能生成元素路径能力,让工具分析页面给出多条候选路径,也可以直接用自然语言描述"商品标题输入框"生成对应的 xpath 路径,不用啃语法,最后人工选更稳的一条;
核心保险是 Web元素AI自愈:控件失效时自动比对页面结构、结合视觉信息重新定位,修复后流程继续跑,不中断整批任务。
以蓝印RPA为例,它的自愈逻辑是在批量上架流程运行中检测到控件定位失败时,自动分析当前页面结构完成元素路径修复,把"平台改版一次、脚本重写一次"变成"流程自己兜住、人只看告警日志"。对长期挂机跑批的场景,这个功能直接决定方案能不能落地。
- 客户端软件自动化
千牛以及部分抖店场景是企业微信、QQ 那类客户端操作,基于网页 DOM 的方案够不着。这种场景需要视觉颜色操作能力:不依赖元素节点,靠图像识别和颜色定位实现点击、读文本。比如自动读取千牛买家消息、按关键词自动回复,纯网页方案做不了。
- 纯内网环境的部署
不少团队对数据安全要求很硬:商品数据、价格体系、客户信息不出本地。这要求RPA本身支持全离线内网部署,流程数据全部保存在本地设备,不同步到任何服务端------选型时必须确认这一点。另外内网环境调不通云端大模型接口,所以流程本体必须能脱离AI独立稳定运行:AI是加速器,不能是氧气。数据不出本地,再配合元素自愈能力,离线更安全、自愈更稳定,批量上架流程才能真正长期无人值守运行。
六、AI和RPA怎么分工:AI写代码,RPA跑代码
这是被问得最多的问题。我的结论:AI负责思考,RPA负责稳定落地,两者是分工不是替代。
AI干的事:理解自然语言需求、生成和修改脚本、把后台截图翻译成操作逻辑、报错时做诊断并给修复建议、批量创建和修改变量、JSON字段自动提取、自动拆分封装子流程、按截图设计自定义操作界面;
RPA干的事:7×24小时稳定执行、处理登录态和滑块等确定性动作、按授权分发应用、记录执行日志、在内网环境离线跑。
实操就一句话:AI写代码,RPA跑代码。比如给流程加"按平台清洗标题"这一步,把需求用图文方式描述给AI,它生成带详细注释的指令;跑的时候报错看不懂,AI一键分析原因并自动修复调试,直到功能正常。蓝印RPA这类AI+RPA形态的工具把这个闭环做得比较完整:接入了文心一言、豆包、DeepSeek、Kimi 等大模型,支持图片识图和OCR,AI部分走的是用户自行对接各平台API的模式,用多少花多少,费用完全透明可控。
两个新趋势值得留意:
MCP服务:流程搭好后挂到 Workbuddy、Codex、Claude、Trae、豆包工作 等AI编程工具上,外部智能体能反向调用RPA来搭建和修改流程;
Agent控制:把流程接入钉钉、飞书、企业微信、个人微信,发一条指令就触发执行,执行完自动回调结果通知。运营不用开客户端,群里说句话批量上架就跑起来。
七、成果分发与权限管理
流程稳定后要发给团队或多设备使用,建议打包成EXE应用:对方免安装客户端,双击即用。配套四件事:
授权管理:每个EXE绑定授权,控制使用人和设备数,防止流程外流;
应用加密:提高反编译门槛;
在线推送更新:流程改版后不用逐个重发,对方打开应用自动检测升级;
独立配置触发方式:每个分发出的应用可单独设置 API触发 或 定时执行------常规上新走定时(建议凌晨流量低谷跑),ERP或店群系统按需调用走API。
对个体开发者、工作室和中小企业来说,做好一个"多平台批量上架工具"打包授权交付,本身就是一个可复用的小产品。
八、成本怎么算才不踩坑
批量上架是高频长期任务,成本要按年算:
云端RPA按运行时长或流程数量收费,批量任务动辄几小时运行时长,一年下来费用不低,多设备还要重复付费;
云端AI方案持续消耗token,跑一天批量的token费用可能超过工具本身;
本地离线方案一次部署长期使用,无运行时长和流程数量限制,多设备不需要多开会员,AI部分按量自付API费用,花多少看得见。
选型先问三件事:免费版有没有使用时长限制?数据存本地还是同步云端?打包分发的应用怎么做授权?答案清楚了,长期成本基本有数。
九、四周落地路线
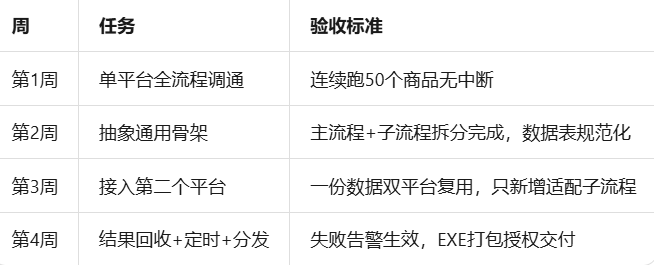
电商RPA批量上架通用方案的本质是三件事:流程骨架通用化、平台差异子流程化、账号环境隔离化。技术选型盯住五个硬指标:全离线内网部署与数据不出本地、Web元素AI自愈、AI生成脚本一键转流程、EXE加密打包加授权管理、AI与流程无缝配合。执行层用 AI+RPA 的组合效率很高------AI负责生成脚本和诊断报错,RPA负责稳定落地长期跑批,像蓝印RPA这类把大模型能力和本地离线执行整合在一起的产品,能让"AI生成脚本一键转流程"在批量上架场景真正闭环。先把一个平台跑稳,再横向复制,一个月就能把多平台上架从人力黑洞变成定时任务。