第8题:泛洪填充------如何给一片连在一起的区域换颜色?
正确答案:D
1. 题目内容
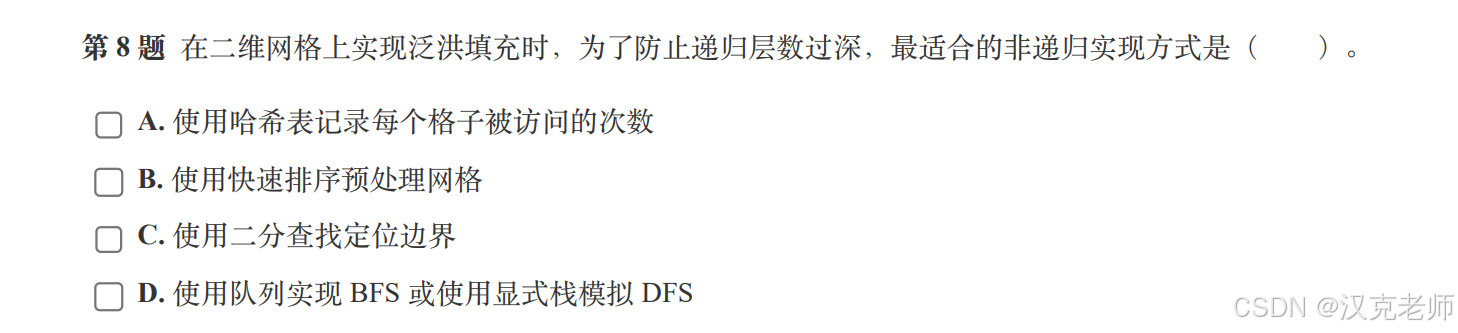
在二维网格上实现泛洪填充时,为了防止递归层数过深,最适合的非递归实现方式是( )。
A. 使用哈希表记录每个格子被访问的次数
B. 使用快速排序预处理网格
C. 使用二分查找定位边界
D. 使用队列实现 BFS 或使用显式栈模拟 DFS
2. 什么是泛洪填充?
同学们,是不是使用过画图软件里的油漆桶工具?
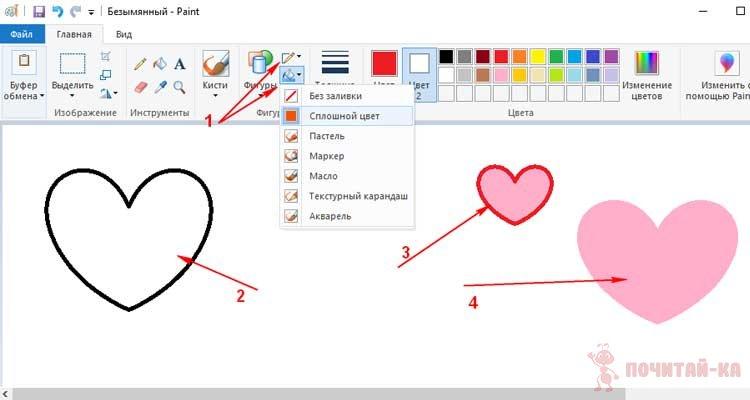
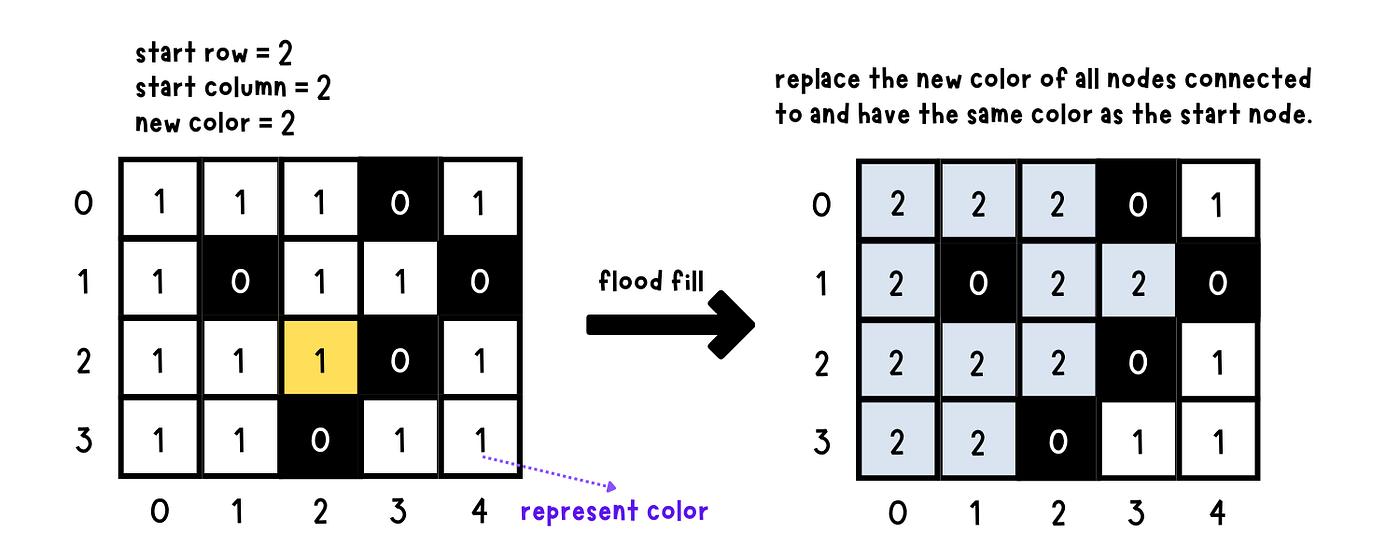
假设我们有一张由很多小格子组成的地图。
每个格子有自己的颜色:
-
蓝色代表海洋。
-
黄色代表沙漠。
-
绿色代表森林。
-
红色代表火山。
现在我们想把一片连在一起的绿色森林全部变成红色。
应该怎么办?
这就是泛洪填充(Flood Fill)。
它的基本思想是:
从一个起始格子出发,不断寻找与它连通、并且满足条件的相邻格子,把它们全部处理。
3. 如何寻找相邻格子?
假设我们站在二维数组的:
C++
a[x][y]如果只考虑上下左右四个方向,那么相邻格子分别是:
C++
a[x - 1][y]  // 上
a[x + 1][y]  // 下
a[x][y - 1]  // 左
a[x][y + 1]  // 右
在C++中,我们通常使用方向数组:
C++
int dx[4] = {-1, 1, 0, 0};
int dy[4] = {0, 0, -1, 1};
这样就可以使用循环寻找四个方向。
4. 方法一:使用DFS
DFS叫作深度优先搜索。
我们可以把它想象成一位森林探险家:
发现一条可以走的路,就一直向前探索,走不通了再返回。
泛洪填充的DFS代码:
C++
void dfs(int x, int y) {
    if (x < 1 || x > n ||
        y < 1 || y > m)
        return;

    if (a[x][y] != oldColor)
        return;

    a[x][y] = newColor;

    for (int k = 0; k < 4; k++) {
        int nx = x + dx[k];
        int ny = y + dy[k];

        dfs(nx, ny);
    }
}
这里有几个关键步骤:
-
首先判断是否越界。
-
判断当前格子是不是需要填充的颜色。
-
如果符合条件,就把它改成新颜色。
-
然后继续向四个方向探索。
注意:一定要先标记当前格子,再继续搜索!
否则可能出现两个格子互相访问、不断重复搜索的问题。
5. 为什么题目不推荐递归?
递归DFS有一个潜在问题:
如果一片森林特别大,可能有几万个甚至更多格子连在一起。
那么递归可能不断深入:
dfs(1,1)
  dfs(1,2)
    dfs(1,3)
      dfs(1,4)
        ...
递归调用太深,可能造成栈空间不足。
这就是题目所说的:
为了防止递归层数过深。
我们需要寻找非递归实现方式。
6. 方法二:使用队列实现BFS
BFS叫作广度优先搜索。
我们可以把它想象成水滴落入池塘:
-
第一圈向外扩散。
-
第二圈继续扩散。
-
第三圈继续扩散。
它使用队列来保存等待访问的格子。
看代码:
C++
#include <iostream>
#include <queue>
using namespace std;

const int N = 105;

int a[N][N];
int dx[4] = {-1, 1, 0, 0};
int dy[4] = {0, 0, -1, 1};

int n, m;

void bfs(int sx, int sy,
         int oldColor, int newColor) {

    if (oldColor == newColor)
        return;

    queue<pair<int, int> > q;

    a[sx][sy] = newColor;
    q.push(make_pair(sx, sy));

    while (!q.empty()) {
        pair<int, int> p = q.front();
        q.pop();

        int x = p.first;
        int y = p.second;

        for (int k = 0; k < 4; k++) {
            int nx = x + dx[k];
            int ny = y + dy[k];

            if (nx < 1 || nx > n ||
                ny < 1 || ny > m)
                continue;

            if (a[nx][ny] != oldColor)
                continue;

            a[nx][ny] = newColor;
            q.push(make_pair(nx, ny));
        }
    }
}
这里有三个特别重要的操作:
C++
q.push(make_pair(nx, ny));把新发现的格子加入队列。
C++
q.front();查看队头的格子。
C++
q.pop();处理完后,把队头格子移出队列。
7. 方法三:使用显式栈模拟DFS
除了队列,我们还可以自己定义一个栈。
原来递归DFS使用的是系统调用栈,现在可以用自己的栈保存待处理格子。
因此:
-
BFS:使用队列。
-
非递归DFS:使用显式栈。
两者都可以解决泛洪填充问题。
最终答案:D
记忆口诀:
泛洪填充找连通区域,DFS可以递归,BFS可以用队列,非递归DFS可以用显式栈。
第9题:哈希表------为什么查找速度快,也可能发生冲突?
正确答案:C
1. 题目内容
关于哈希表,下列说法正确的是( )。
A. 只要哈希函数选择合适,就可以完全避免冲突。
B. 在链地址法中,查找一个元素的时间复杂度一定为 O(1)。
C. 开放定址法发生冲突后,会在表内寻找下一个可用位置。
D. 哈希表的查找速度与表中元素个数无关。
这道题考查哈希表(Hash Table)。
2. 先讲一个故事:学校的储物柜
假设学校有100个储物柜。
现在来了很多同学,每个同学都需要一个柜子。
如果按照名字一个一个寻找柜子,可能很麻烦。
老师想出了一个办法:
把学生的学号经过某种计算,直接得到柜子的编号。
例如:
C++
柜子编号 = 学号 % 100;假设学号是:
12345那么:
12345 % 100 = 45
这个同学就可以使用45号柜子。
这种根据数据计算存储位置的方法,就是哈希思想。
3. 什么是哈希函数?
哈希函数就是一个计算位置的函数。
例如:
C++
int hash(int x) {
    return x % 10;
}
如果有下面这些数字:
12、23、35、42计算结果:
| 原始数字 | 哈希值 |
|---|---|
| 12 | 2 |
| 23 | 3 |
| 35 | 5 |
| 42 | 2 |
大家发现问题了吗?
12和42都得到位置2。
那么两个数字都想放到2号位置,怎么办?
这就出现了哈希冲突。
4. 什么是哈希冲突?
当两个不同的数据经过哈希函数计算后,得到相同的存储位置,就称为哈希冲突。
例如:
C++
hash(12) = 2;
hash(42) = 2;
虽然12和42不相等,但是它们的哈希值相同。
所以A选项错误。
再好的哈希函数,也不能保证对任意可能的数据都完全没有冲突。
5. 哈希冲突的两种常见解决办法
方法一:链地址法
我们可以让同一个位置挂上一条链表。
例如:
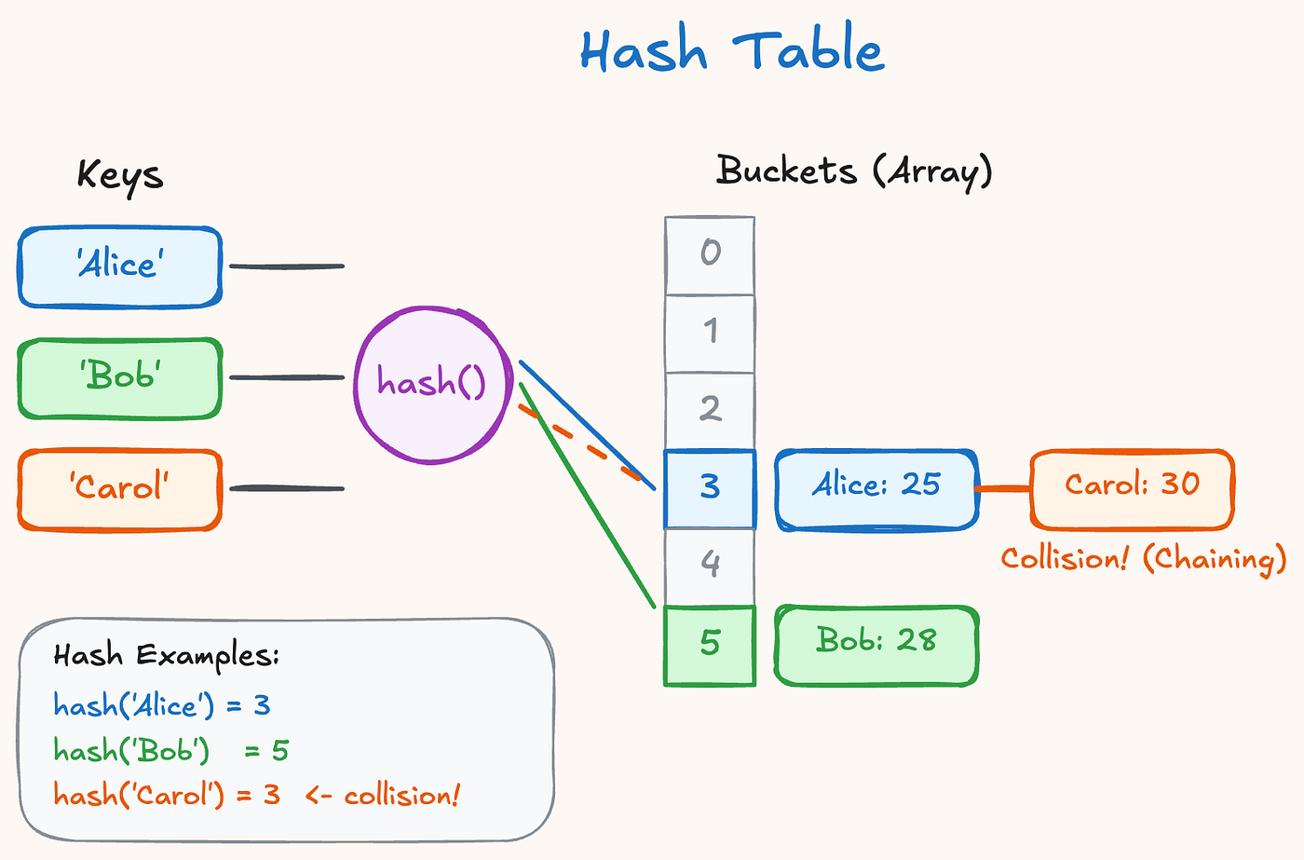
假设12和42都映射到位置2:
位置2 → 12 → 42这样就不用担心两个数据抢同一个位置。
但是,如果大量数据都集中在同一个位置:
位置2 → 12 → 22 → 32 → 42 → 52那么查找时就可能需要沿着链表一个一个寻找。
所以:
链地址法的平均查找效率通常可以达到 O(1),但最坏情况下可能达到 O(n)。
因此B选项错误。
方法二:开放定址法
开放定址法不另外建立链表。
如果原来的位置被占用了,就在哈希表内部继续寻找其他空位置。
例如:
12 → 位置2
42 → 位置2,发生冲突
42 → 尝试位置3
如果位置3空着,就把42存放到位置3。
这正是C选项描述的内容。
所以C正确。
6. 为什么D也错误?
D说:
哈希表的查找速度与表中元素个数无关。
这显然不准确。
哈希表通常很快,但元素数量增加后:
-
可能发生更多冲突。
-
哈希表的装载因子可能增大。
-
查找时可能需要检查更多位置或链表节点。
因此,查找速度会受到元素数量、哈希函数、冲突处理方式等因素的影响。
最终答案:C
七级考试记忆:
-
哈希函数:计算存储位置。
-
哈希冲突:不同数据映射到同一个位置。
-
链地址法:一个位置挂一条链表。
-
开放定址法:冲突后在表内寻找其他位置。

第10题:引用------为什么函数可以直接修改外面的变量?
正确答案:B(4)
1. 题目内容
看下面的C++程序:
C++
#include <iostream>
using namespace std;

void inc(int &x) {
    x++;
}

int main() {
    int a = 3;
    inc(a);
    cout << a;
    return 0;
}
问:程序输出什么?
选项:
-
A. 3
-
B. 4
-
C. 5
-
D. 编译错误
这道题非常重要,因为它考查C++中的引用。
2. 什么是引用?
看函数参数:
C++
int &x这里的 & 表示引用。
引用可以理解为:
给原来的变量再起一个别名。
例如:
C++
int a = 3;
int &x = a;
现在:
-
a是这个盒子的原名字。
-
x是这个盒子的另一个名字。
它们不是两个盒子,而是同一个盒子。
引用就像给同一个盒子起两个名字
名字:a
名字:x
a和x指向同一个变量,不是两个独立的盒子。
因此:
C++
x++;其实就是:
C++
a++;3. 分步模拟
第一步:
C++
int a = 3;此时:
a = 3第二步:
C++
inc(a);把变量a传入函数。
由于函数参数是:
C++
int &x所以x就是a的别名。
此时:
a = 3
x = 3
第三步:
执行:
C++
x++;x增加1。
由于x和a是同一个变量,所以:
a = 4第四步:
函数结束,回到main函数。
执行:
C++
cout << a;输出:
4所以正确答案是B。
4. 对比总结
| 参数形式 | 传递方式 | 能否修改原变量 |
|---|---|---|
int x |
值传递 | 不能 |
int &x |
引用传递 | 能 |
const int &x |
常量引用 | 不能通过该引用修改 |
最终答案:B(4)
记忆口诀:
普通参数传副本,引用参数起别名。修改引用里的值,原变量也会跟着变。
第11题:最长公共子序列LCS------两个字符串有多少共同的字符?
正确答案:A
1. 题目内容
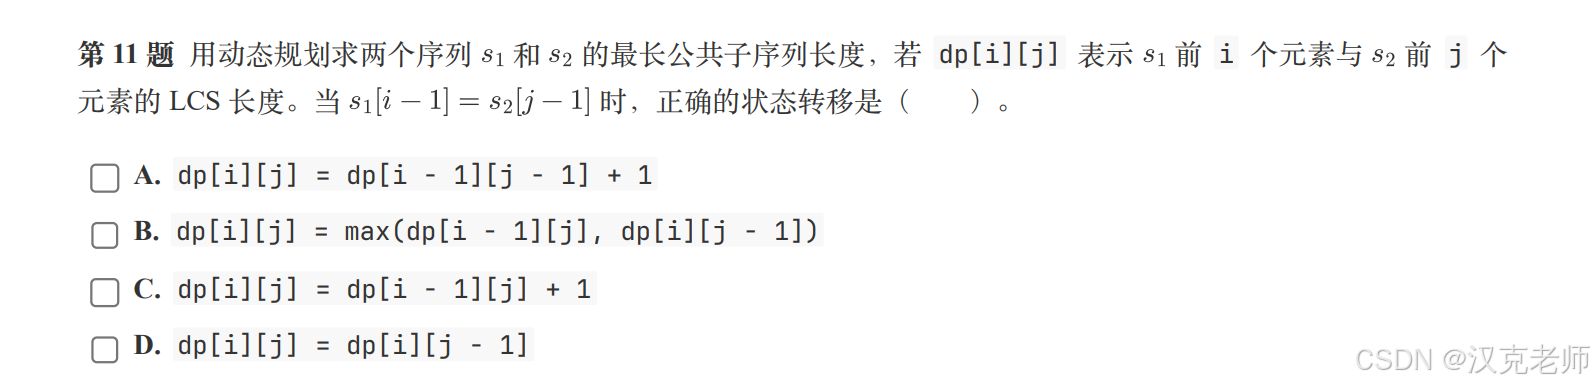
用动态规划求两个序列 s1 和 s2 的最长公共子序列长度。
若:
dpij
表示 s1 前 i 个元素与 s2 前 j 个元素的LCS长度。
当:
s1i-1 = s2j-1
时,正确的状态转移是:A/B/C/D
选项内容见试卷。
2. 先理解:什么是公共子序列?
我们讲一个故事。
小明喜欢一串字母:
A B C D E小红喜欢一串字母:
B A D E现在我们想找出:
他们共同拥有的、顺序不变的最长字母序列。
注意:
子序列可以删除一些字符,但不能改变剩余字符的先后顺序。
例如:
A B C D E可以得到:
A C E因为只需要删除B和D。
但是不能得到:
E A C因为改变了原来的顺序。
3. 什么是最长公共子序列?
例如:
s1 = A B C D E
s2 = B A D E
公共子序列有:
A D E
B D E
它们的长度都是3。
因此最长公共子序列长度为3。
这就是LCS(Longest Common Subsequence)。
4. 为什么使用二维DP?
我们定义:
dpij
表示:
-
第一个序列取前i个字符。
-
第二个序列取前j个字符。
这两个部分的最长公共子序列长度。
为了方便处理,我们通常让数组下标从1开始代表字符数量。
也就是说:
C++
s1[i - 1]
s2[j - 1]
才是两个序列当前正在比较的字符。
5. 最重要的状态转移
现在来看题目中的条件:
s1i-1 = s2j-1
也就是两个序列当前最后一个字符相同。
例如:
s1 = A B C
s2 = B A C
当我们比较到最后一个字符时:
s1最后一个字符 = C
s2最后一个字符 = C
既然两个字符相同,那么我们就可以把它们一起加入公共子序列。
于是:
dpij = dpi-1j-1 +1
为什么?
因为:
-
先去掉两个序列最后一个字符。
-
求剩余部分的最长公共子序列。
-
再把当前相同的字符加进去。
所以长度增加1。
这就是A选项。
6. 如果两个字符不相同怎么办?
虽然题目只问相等的情况,但是我们必须掌握完整的LCS状态转移。
如果:
s1i-1 ≠ s2j−1
那么当前两个字符不能同时作为公共子序列的最后一个字符。
我们可以:
-
去掉第一个序列的最后一个字符。
-
或者去掉第二个序列的最后一个字符。
两种情况取较大值:
dpij = max(dpi−1j,dpij−1)
所以完整公式是:
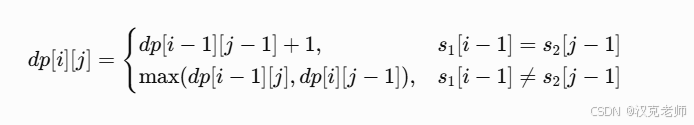
7. 完整C++程序
C++
#include <iostream>
#include <algorithm>
#include <string>
using namespace std;

const int N = 1005;

int dp[N][N];

int main() {
    string s1, s2;
    cin >> s1 >> s2;

    int n = s1.size();
    int m = s2.size();

    for (int i = 1; i <= n; i++) {
        for (int j = 1; j <= m; j++) {

            if (s1[i - 1] == s2[j - 1]) {
                dp[i][j] =
                    dp[i - 1][j - 1] + 1;
            }
            else {
                dp[i][j] = max(
                    dp[i - 1][j],
                    dp[i][j - 1]
                );
            }
        }
    }

    cout << dp[n][m] << endl;

    return 0;
}
最终答案:A
记忆口诀:
两个字符相同,左上角加1;两个字符不同,上方和左方取最大。
第12题:0/1背包------为什么一维数组必须从大到小枚举?
正确答案:D(5)
1. 题目内容
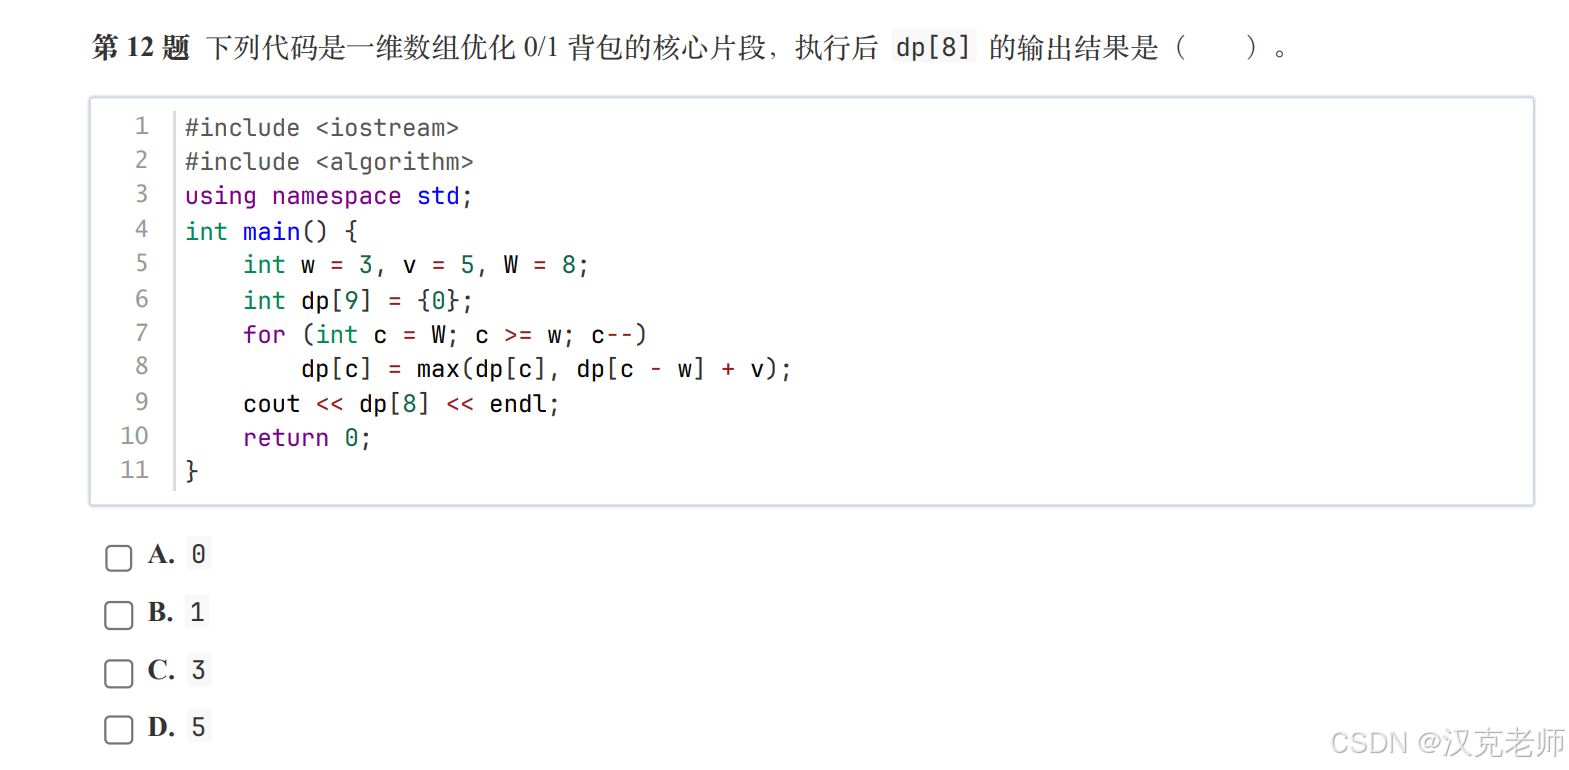
题目给出下面的程序:
C++
#include <iostream>
#include <algorithm>
using namespace std;

int main() {
    int w = 3, v = 5, W = 8;
    int dp[9] = {0};

    for (int c = W; c >= w; c--)
        dp[c] = max(dp[c], dp[c - w] + v);

    cout << dp[8] << endl;

    return 0;
}
问:
C++
dp[8]最终输出多少?
选项:
-
A. 0
-
B. 1
-
C. 3
-
D. 5
2. 先讲故事:魔法背包
假设我们有一个容量为8的魔法背包。
现在只有一种宝物:
| 宝物 | 重量 | 价值 |
|---|---|---|
| 魔法宝石 | 3 | 5 |
我们的问题是:
背包最多装8单位重量的物品,最多能够获得多少价值?
注意:
每种物品只能选择一次。
这就是0/1背包问题。
为什么叫0/1背包?
因为对于每件物品,只有两种选择:
-
0:不选。
-
1:选择。
不能选择两次,也不能选择三次。
3. 理解dp数组
C++
int dp[9] = {0};这里的:
C++
dp[c]表示背包容量为c时,目前能够得到的最大价值。
初始状态:
容量: 0 1 2 3 4 5 6 7 8
价值: 0 0 0 0 0 0 0 0 0
因为一开始还没有放入任何宝物,所以所有价值都是0。
4. 重点分析循环
题目给出:
C++
int w = 3;
int v = 5;
int W = 8;
表示:
-
物品重量为3。
-
物品价值为5。
-
背包容量为8。
循环:
C++
for (int c = W; c >= w; c--)等价于:
C++
for (int c = 8; c >= 3; c--)为什么从8开始?
因为背包容量最大是8。
为什么到3结束?
因为物品重量是3,容量小于3的背包装不下它。
5. 状态转移公式
C++
dp[c] = max(dp[c], dp[c - w] + v);翻译成小朋友能听懂的话:
对于容量为c的背包,有两种选择:
选择一:不放这件宝物。
那么价值保持原来的:
dpc
选择二:放入这件宝物。
那么需要先留出3个单位的空间:
pc−3+5
我们选择价值更大的方案:
dpc = max(dpc,dpc−3+5)
6. 一步一步计算
初始:
dp[0] = 0
dp[1] = 0
dp[2] = 0
dp[3] = 0
dp[4] = 0
dp[5] = 0
dp[6] = 0
dp[7] = 0
dp[8] = 0
现在开始循环。
第一次:c=8
C++
dp[8] = max(dp[8], dp[5] + 5);dp8 = max(0,0+5) = 5
第二次:c=7
C++
dp[7] = max(dp[7], dp[4] + 5);dp7 = 5
第三次:c=6
C++
dp[6] = max(dp[6], dp[3] + 5);dp6 = 5
第四次:c=5
C++
dp[5] = max(dp[5], dp[2] + 5);dp5 = 5
第五次:c=4
dp4 = 5
第六次:c=3
dp3 = 5
最终数组:
| 容量c | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
|---|---|---|---|---|---|---|---|---|---|
| dpcc | 0 | 0 | 0 | 5 | 5 | 5 | 5 | 5 | 5 |
所以:
dp8 = 5
答案是D。
7. 为什么0/1背包必须从大到小枚举?
假设我们把循环改成从小到大:
C++
for (int c = w; c <= W; c++)那么:
C++
dp[3] = dp[0] + 5 = 5;接着:
C++
dp[6] = dp[3] + 5 = 10;但是注意!
dp[3] 刚刚已经使用了这件宝物。
现在计算 dp[6] 时又使用了它。
相当于同一件宝物被使用了两次!
这就变成了完全背包的思想,而不是0/1背包。
所以0/1背包必须:
0/1背包:从大到小
完全背包:从小到大
8. 两种背包的对比
| 类型 | 物品能否重复选择 | 容量循环 |
|---|---|---|
| 0/1背包 | 每件最多一次 | 从大到小 |
| 完全背包 | 每件可以多次 | 从小到大 |
最终答案:D(5)
记忆口诀:
0/1背包倒着走,防止物品被重复使用;完全背包正着走,允许物品重复使用。
第13题:稳定排序------为什么有些排序会改变相同元素的顺序?
正确答案:D
1. 题目内容
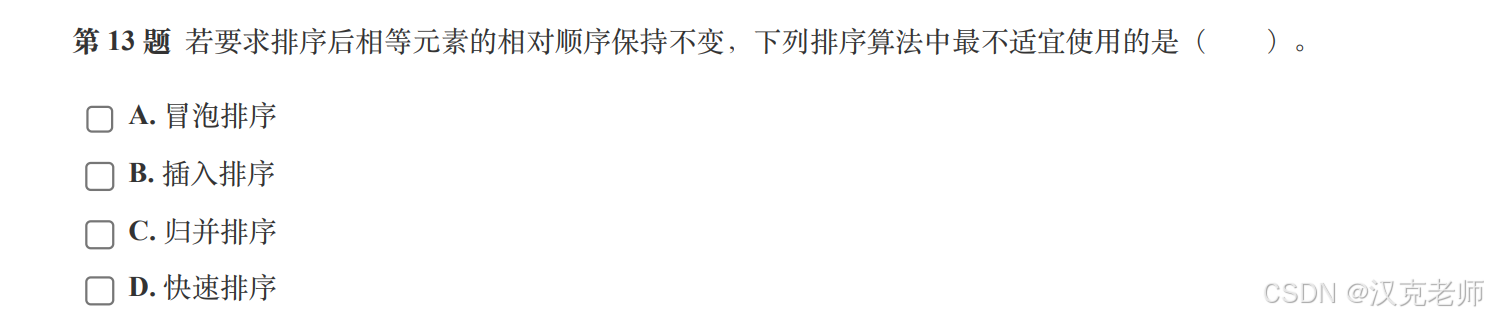
若要求排序后相等元素的相对顺序保持不变,下列排序算法中最不适宜使用的是( )。
A. 冒泡排序
B. 插入排序
C. 归并排序
D. 快速排序
这道题考查一个重要的概念:
稳定排序(Stable Sort)。
2. 什么叫稳定排序?
我们讲一个故事。
学校要给学生的考试成绩排序。
有四个学生:
| 学生 | 成绩 | 原来的顺序 |
|---|---|---|
| 小明 | 90 | 第1个 |
| 小红 | 80 | 第2个 |
| 小刚 | 90 | 第3个 |
| 小华 | 70 | 第4个 |
现在按照成绩从高到低排序。
排序结果:
| 学生 | 成绩 |
|---|---|
| 小明 | 90 |
| 小刚 | 90 |
| 小红 | 80 |
| 小华 | 70 |
注意:
小明和小刚的成绩相同。
原来小明排在小刚前面,排序之后仍然保持这个顺序。
这就叫稳定排序。
3. 四种排序算法的稳定性
| 排序算法 | 是否稳定 |
|---|---|
| 冒泡排序 | 稳定 |
| 插入排序 | 稳定 |
| 归并排序 | 稳定 |
| 快速排序 | 不稳定 |
为什么快速排序不稳定?
因为快速排序会根据基准值进行分区操作。
在交换元素的过程中,即使两个元素的关键字相同,也可能改变它们原位置

第14题:分析程序的时间复杂度
正确答案:B. O(n log n)
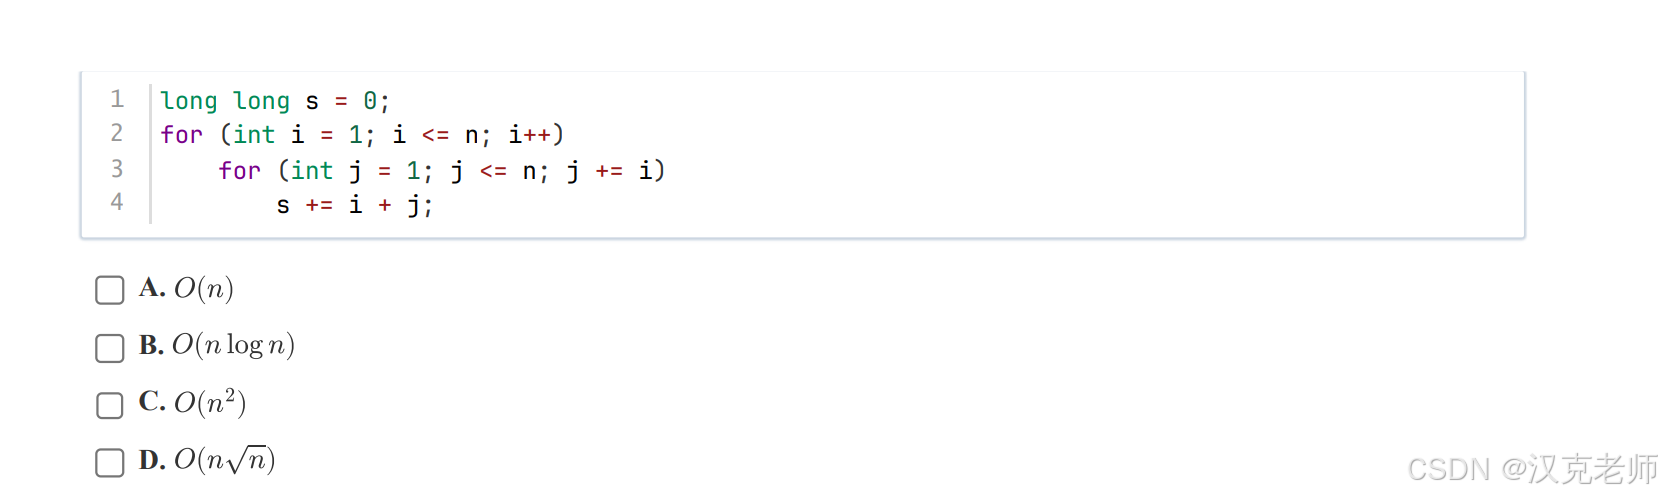
题目代码
C++
long long s = 0;

for (int i = 1; i <= n; i++)
    for (int j = 1; j <= n; j += i)
        s += i + j;
题目问:这段代码的时间复杂度是多少?
选项:
-
A. O(n)
-
B. O(nlogn)
-
C. O(n^2)
-
D. O(n sqrt(n))
第一步:先看外层循环
C++
for (int i = 1; i <= n; i++)外层循环从1开始,一直执行到n。
所以外层循环一共执行:
n 次
如果内层循环每次都执行n次,那么总次数就是:
n×n = n^2
但是,这道题有一个陷阱:
内层循环并不是每次都执行n次!
我们继续往下看。
第二步:观察内层循环
C++
for (int j = 1; j <= n; j += i)注意最后一句:
C++
j += i它表示每次循环,j 都增加当前的 i。
也就是说,内层循环每次增加多少,取决于外层循环的变量 i。
我们用一个具体例子来观察。
假设:
n=10
当 i=1 时:
j = 1, 2, 3, 4, 5, 6, 7, 8, 9, 10一共执行10次。
当 i=2 时:
j = 1, 3, 5, 7, 9一共执行5次。
当 i=3 时:
j = 1, 4, 7, 10一共执行4次。
当 i=4 时:
j = 1, 5, 9一共执行3次。
当 i=5 时:
j = 1, 6一共执行2次。
当 i=6 时:
j = 1, 7一共执行2次。
当 i=10 时:
j = 1只执行1次。
发现规律了吗?
外层变量 i 越大,内层循环执行的次数越少!
第三步:制作循环次数统计表
我们把刚才的情况整理起来:
| 外层变量i | 内层j的取值 | 执行次数 |
|---|---|---|
| 1 | 1,2,3,...,10 | 10 |
| 2 | 1,3,5,7,9 | 5 |
| 3 | 1,4,7,10 | 4 |
| 4 | 1,5,9 | 3 |
| 5 | 1,6 | 2 |
| 6 | 1,7 | 2 |
| 7 | 1,8 | 2 |
| 8 | 1,9 | 2 |
| 9 | 1,10 | 2 |
| 10 | 1 | 1 |
所以,总执行次数是:
10+5+4+3+2+2+2+2+2+1=33
如果真的是普通的两层循环,执行次数应该是:
10×10=100
但是现在只执行了33次。
这说明它并不是简单的 O(n^2)。
第四步:推导真正的时间复杂度
当外层变量为 i 时:
C++
for (int j = 1; j <= n; j += i)每次增加 iii,所以内层循环大约执行:
次。
外层循环从1到n,因此总执行次数大约是:
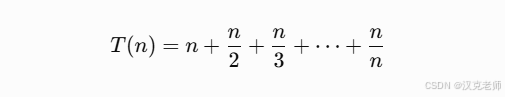
提取公因数 n:
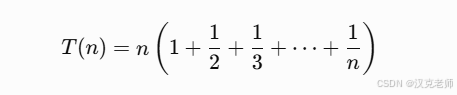
括号里的部分叫作调和级数,它的增长量级是:
O(logn)
因此:
所以正确答案是:
B. O(n log n)
第五步:为什么不是O(n²)?
我们对比一下两种程序。
程序一:普通双重循环
C++
for (int i = 1; i <= n; i++) {
    for (int j = 1; j <= n; j++) {
        // 执行操作
    }
}
内层每次都执行n次:
n×n=n^2
所以是:
O(n^2)
程序二:本题的循环
C++
for (int i = 1; i <= n; i++) {
    for (int j = 1; j <= n; j += i) {
        // 执行操作
    }
}
内层循环步长随着i增大而增大,执行次数越来越少:
所以是:
O(nlogn)
给学生的记忆方法
看到两层 for 循环,不要马上写 O(n2)。
先检查三个问题:
-
内层循环从哪里开始?
-
内层循环什么时候结束?
-
内层循环每次增加多少?
特别注意:
C++
j++;和:
C++
j += i;它们的执行次数可能完全不同!
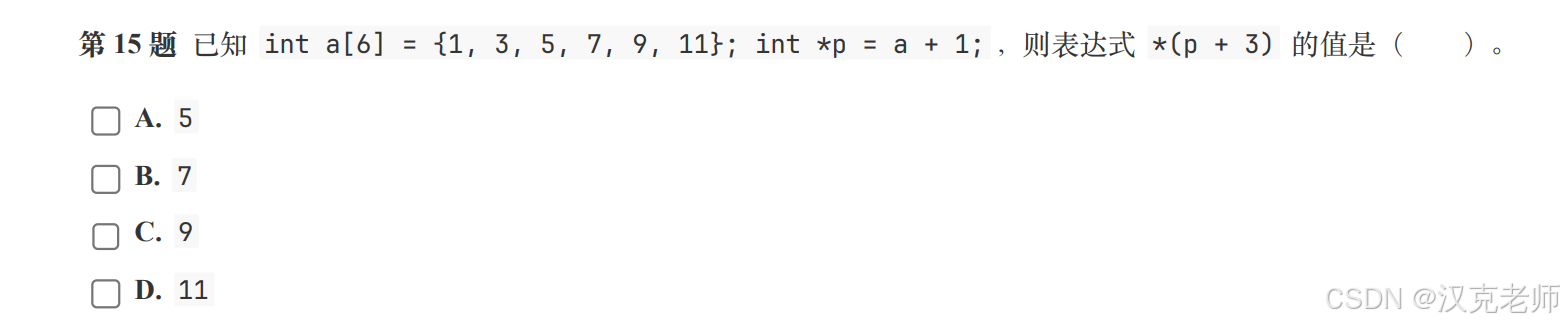
第15题:指针与数组的关系
正确答案:C. 9
题目
已知:
C++
int a[6] = {1, 3, 5, 7, 9, 11};

int *p = a + 1;
则表达式:
C++
*(p + 3)的值是多少?
选项:
-
A. 5
-
B. 7
-
C. 9
-
D. 11
这道题需要理解三个知识点:
-
数组下标从哪里开始?
-
指针加1是什么意思?
-
*运算符是什么意思?
第一步:给数组里的元素安排座位
数组:
C++
int a[6] = {1, 3, 5, 7, 9, 11};可以想象成6个连续排列的小房间。
数组a的六个位置
1
下标0
3
下标1
5
下标2
7
下标3
9
下标4
11
下标5
注意:数组下标从0开始,而不是从1开始。
对应关系:
| 数组表达式 | 数组下标 | 存储的值 |
|---|---|---|
a[0] |
0 | 1 |
a[1] |
1 | 3 |
a[2] |
2 | 5 |
a[3] |
3 | 7 |
a[4] |
4 | 9 |
a[5] |
5 | 11 |
一定要记住:数组的第一个元素,下标是0。
第二步:理解 int *p = a + 1
原代码:
C++
int *p = a + 1;这里的 a 在这个表达式中会转换成指向第一个元素的指针。
因此:
C++
a相当于:
C++
&a[0]那么:
C++
a + 1就是指向下一个元素:
C++
&a[1]因此:
C++
int *p = a + 1;相当于:
C++
int *p = &a[1];也就是说:
现在指针p指向哪里?
p指向a1,也就是数值3所在的位置。
第三步:理解 p + 3
题目要求计算:
C++
*(p + 3)我们先不要着急计算最外面的 *。
先看:
C++
p + 3因为p指向的是:
C++
a[1]那么向后移动3个元素:
原来位置:a[1]
向后移动:3个位置

a[1] → a[2] → a[3] → a[4]
因此:
C++
p + 3相当于:
C++
&a[4]第四步:理解最外面的 *
现在表达式变成:
C++
*(&a[4])这里的 * 表示:
根据地址,取出这个地址里存放的值。
所以:
C++
*(&a[4]) = a[4]而:
C++
a[4] = 9最终答案:
9
选择C
第五步:把整个过程写成一条公式
原表达式:
C++
*(p + 3)已知:
C++
p = a + 1代入:
∗(a+1+3)
合并:
∗(a+4)
取出对应位置的值:
a4 = 9
所以:
三、指针加减法的通用规律
假设:
C++
int a[6] = {1, 3, 5, 7, 9, 11};
int *p = a;
那么:
| 表达式 | 实际对应 | 结果 |
|---|---|---|
*p |
a[0] |
1 |
*(p+1) |
a[1] |
3 |
*(p+2) |
a[2] |
5 |
*(p+3) |
a[3] |
7 |
*(p+4) |
a[4] |
9 |
*(p+5) |
a[5] |
11 |
记住这个公式:
如果:
C++
p = a + t;那么:
注意,指针加1表示移动到下一个同类型元素,而不是简单地让内存地址增加1个字节。
例如:
-
int*加1,移动一个int元素。 -
double*加1,移动一个double元素。 -
char*加1,移动一个char元素。
考点汇总:
| 题号 | 知识点 | 必须掌握的内容 |
|---|---|---|
| 8 | 泛洪填充 | Flood Fill、DFS、BFS、队列、栈 |
| 9 | 哈希表 | 哈希函数、哈希冲突、链地址法、开放定址法 |
| 10 | C++引用 | 值传递、引用传递、变量别名 |
| 11 | LCS | 最长公共子序列、二维DP |
| 12 | 0/1背包 | 一维优化、倒序枚举 |
| 13 | 稳定排序 | 冒泡、插入、归并、快速排序 |
| 14 | 时间复杂度 | 嵌套循环、调和级数、O(nlogn)O(n\log n)O(nlogn) |
| 15 | 指针 | 指针运算、数组下标、解引用 |
特别值得大家掌握的五组知识联系
第一组:DFS、BFS与泛洪填充
它们解决的都是搜索问题。
-
DFS:一条路走到底,再返回。
-
BFS:一层一层向外扩散。
-
泛洪填充:寻找满足条件的连通区域。
第二组:哈希表与STL容器
后续学习STL时,可以进一步认识:
C++
map
unordered_map
set
unordered_set
特别是 unordered_map 和 unordered_set,都与哈希思想密切相关。
第三组:引用与指针
这是C++语言学习中非常重要的一组知识。
C++
int &x = a;引用是变量的别名。
C++
int *p = &a;指针保存变量的地址。
两者不能混为一谈。
第四组:LCS与背包DP
这两道题都是动态规划,但是思考方式不同:
-
LCS:考虑两个序列的前缀。
-
0/1背包:考虑物品和背包容量。
尤其要记住0/1背包的一维优化必须倒序枚举。
第五组:时间复杂度与算法效率
学会分析:
-
O(1)
-
O(logn)
-
O(n)
-
O(nlogn)
-
O(n^2)
不能简单地看到两个for循环就认为是 O(n^2)。
课后巩固:
下面设计一组小测验,帮助大家查自己是否真正理解了这些知识。
- 泛洪填充中,为了避免递归层数过深,可以使用什么?
A. 快速排序
B. 队列实现BFS或显式栈模拟DFS
C. 二分查找
D. 哈希排序
- 哈希表发生冲突时,开放定址法通常怎么处理?
A. 删除原来的数据
B. 扩大所有数组
C. 在表内寻找其他可用位置
D. 停止程序
- void add(int &x)中的&表示什么?
A. 按位与
B. 取地址
C. 引用
D. 逻辑与
- LCS中,如果两个当前字符相同,应该怎样转移?
A. 左上角加1
B. 上方加1
C. 左方加1
D. 取0
- 0/1背包一维优化时,容量应该怎样枚举?
A. 从小到大
B. 从大到小
C. 随机
D. 只计算最大容量
- 以下哪种排序通常不稳定?
A. 冒泡排序
B. 插入排序
C. 归并排序
D. 快速排序
- 两个嵌套循环中,内层 j 每次增加 i,外层 i 从 1到n,总复杂度是什么?
A. O(n)
B. O(n log n)
C. O(n²)
D. O(log n)
- int a\[\]={1,3,5,7,9}; int *p=a+1; 那么*(p+2)是多少?
A. 3
B. 5
C. 7
D. 9