本文要做的,是围绕环形缓冲区,把生产者消费者模型真正跑起来。
先从环形缓冲区的核心逻辑讲起,看看这个"首尾相接"的结构是怎么转的,生产者和消费者又是如何在同一个圈里并发访问、互不踩脚的。接着深入POSIX信号量与P/V操作,把并发控制和同步互斥背后的原理一层层拆开。理论打底之后,动手完成整套模型的代码实现。最后再借几个特殊场景,看看信号量在多线程协作里到底能玩出多少花样。
目录
[1.1 环形缓冲区的结构与核心逻辑](#1.1 环形缓冲区的结构与核心逻辑)
[1.2 并发访问中的同步与互斥问题](#1.2 并发访问中的同步与互斥问题)
[1.2.1 什么情况下可以并发访问](#1.2.1 什么情况下可以并发访问)
[1.2.2 什么情况下必须同步与互斥](#1.2.2 什么情况下必须同步与互斥)
[1.3 用POSIX信号量实现P/V同步](#1.3 用POSIX信号量实现P/V同步)
[1.3.1 信号量如何表示共享资源](#1.3.1 信号量如何表示共享资源)
[1.3.2 生产者与消费者分别如何执行](#1.3.2 生产者与消费者分别如何执行)
[1.4 特殊情况:二元信号量与单缓冲区N=1](#1.4 特殊情况:二元信号量与单缓冲区N=1)
[2.1 初始化信号量](#2.1 初始化信号量)
[2.2 销毁信号量](#2.2 销毁信号量)
[2.3 等待信号量:P操作](#2.3 等待信号量:P操作)
[2.4 发布信号量:V操作](#2.4 发布信号量:V操作)
[3.1 RingQueue.hpp:环形队列的核心实现](#3.1 RingQueue.hpp:环形队列的核心实现)
[3.2 Sem.hpp:POSIX信号量封装](#3.2 Sem.hpp:POSIX信号量封装)
[3.3 Task.hpp:任务对象定义](#3.3 Task.hpp:任务对象定义)
[3.4 Mutex.hpp:互斥锁封装](#3.4 Mutex.hpp:互斥锁封装)
[3.5 Main.cc:程序运行入口](#3.5 Main.cc:程序运行入口)
[4.1 致命问题:RandTask()为何反复创建TaskManager](#4.1 致命问题:RandTask()为何反复创建TaskManager)
[4.2 锁的粒度:为什么V操作应该移到锁外](#4.2 锁的粒度:为什么V操作应该移到锁外)
[4.3 手动加解锁的问题:为什么应该使用RAII锁](#4.3 手动加解锁的问题:为什么应该使用RAII锁)
[4.4 内存泄漏:为什么delete\[\]可能永远执行不到](#4.4 内存泄漏:为什么delete[]可能永远执行不到)
[4.5 rand()的线程安全问题](#4.5 rand()的线程安全问题)
[4.6 Pop()中的T data:为什么依赖默认构造](#4.6 Pop()中的T data:为什么依赖默认构造)
[4.7 优化后的RingQueue核心实现](#4.7 优化后的RingQueue核心实现)
[4.8 对整体实现的评价](#4.8 对整体实现的评价)
[4.9 P操作与Lock操作:谁应该先执行](#4.9 P操作与Lock操作:谁应该先执行)
[4.9.1 为什么这样才能保证正确性](#4.9.1 为什么这样才能保证正确性)
[4.9.2 高效性对比:用"买电影票"理解锁与信号量](#4.9.2 高效性对比:用“买电影票”理解锁与信号量)
一、环形缓冲区生产者消费者模型:从原理到同步机制
1.1 环形缓冲区的结构与核心逻辑
在并发编程里,基于环形缓冲(Ring Buffer)的生产者消费者模型,算得上是一种极其高效的数据同步结构。它跟传统的"单队列加锁"模式不一样,环形缓冲区靠的是固定大小的数组(容量为N)加上POSIX信号量,在条件允许的时候,能让生产和消费真正并行起来。
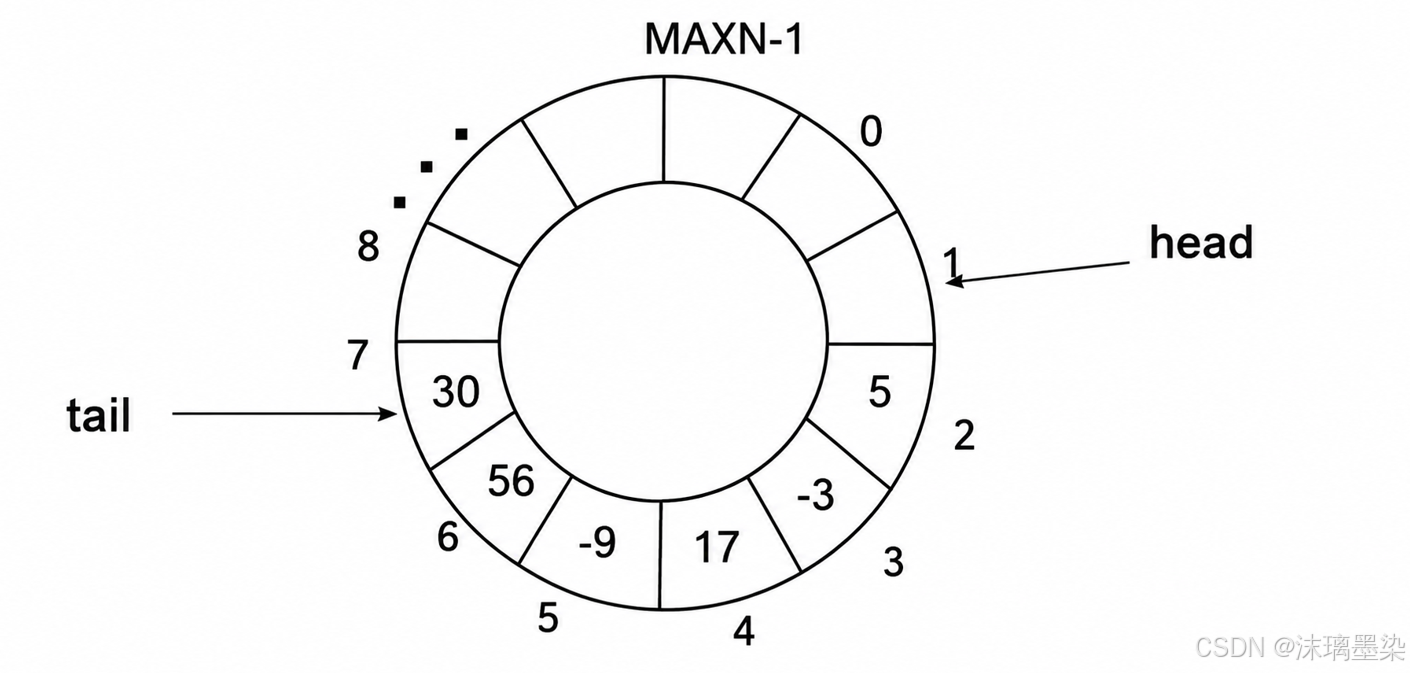
POSIX标准下的信号量,比起老派的System V信号量,更轻量,也更高效。要想让环形缓冲区在多线程环境里既安全又正确,有四条核心约束,我们得先立好:
-
约定 1:缓冲区空了,生产者得先动起来。
-
约定 2:缓冲区满了,消费者得先动手。
-
约定 3:生产者不能把消费者"套圈",不能超出一整圈。本质上,就是防止它覆盖掉上一轮还没被消费的数据。
-
约定 4:消费者不能越过生产者。本质上,就是防止它读到还没生产出来的无效数据。
不妨把环形缓冲区想象成一张大圆桌,桌上摆着一圈盘子(也就是空格子)。生产者往盘子里放数据,消费者从盘子里取数据。一放一取,桌子就转起来了。
1.2 并发访问中的同步与互斥问题
想把环形缓冲区吃透,关键就一件事:弄明白生产者与消费者什么时候能并排跑,什么时候又必须一个等一个。
1.2.1 什么情况下可以并发访问
只要两边不往同一个槽位里伸手,就能同时干活。
当环形队列既不满、也不空的时候,生产者指针(tail/p_step)和消费者指针(head/c_step)各占各的格子,谁也碰不着谁。生产归生产,消费归消费,互不干扰。这时候才是真正的并发,系统吞吐量也跟着往上窜。
1.2.2 什么情况下必须同步与互斥
一旦生产者和消费者瞄上了同一个槽位,线程之间就开始抢资源了。这时候,互斥与同步必须登场。
缓冲区为空时:两个指针又碰头了。没数据可消费,消费者只能靠边站。互斥加同步,先把生产者推上去,等它填好数据,再把消费者叫醒。
缓冲区为满时:两个指针再次重合,生产者套了一圈,追上消费者了。空格子没了,生产者只能干等。互斥加同步,先让消费者上场,腾出空间,再回头唤醒生产者。
1.3 用POSIX信号量实现P/V同步
要把前面那四条约定在代码层面焊死,得请出POSIX信号量提供的原子P/V操作。它就是管理计数资源的那把钥匙。
1.3.1 信号量如何表示共享资源
环形缓冲区里的资源,一分为二,各有人盯:
- **生产者盯着的:**空槽位数量,记作信号量sem_blank,初始值就是N。整个缓冲区,开局全是空的。
- **消费者盯着的:**数据槽位数量,记作信号量sem_data,初始值为0。开局空桌,没东西可吃。
P操作,就是申请资源 ,天生带原子性:资源计数大于0,减一,放行;资源计数为0,申请线程当场挂起,等着。
V操作,就是释放资源:计数加一,顺手叫醒一个正在等它的线程。
1.3.2 生产者与消费者分别如何执行
生产者这边,动作分四步:
- **申请空位:**P(sem_blank),也就是sem_blank--。
- **写数据:**在p_step指向的位置,把数据放进去。
- **挪指针:**p_step = (p_step + 1) % N,转到下一个格子。
- **释放数据资源:**V(sem_data),也就是sem_data++,把可能正堵着的消费者叫醒。
消费者这边,正好反过来:
- **申请数据:**P(sem_data),也就是sem_data--。
- **读数据:**在c_step指向的位置,把数据取出来消费掉。
- **挪指针:**c_step = (c_step + 1) % N,转到下一个格子。
- **释放空位资源:**V(sem_blank),也就是sem_blank++,把可能正堵着的生产者叫醒。
一来一回,环环相扣:生产者用V(sem_data) 去激活消费者的P(sem_data),消费者用V(sem_blank)去激活生产者的P(sem_blank)。一个放,一个取;一个空出位子,一个填补空位。两边互相唤醒,节奏咬得严丝合缝,一个精密的交替闭环,就这么转起来了。
1.4 特殊情况:二元信号量与单缓冲区N=1
当环形缓冲区的容量缩到N = 1时,环形队列就退化成了只有一个格子的单缓冲区。
这时候,sem_blank从1出发,sem_data从0起步。两个信号量都只剩下0和1两种状态,这正是二元信号量的本色。
于是,系统换了一副全新的同步互斥面孔:生产者和消费者围着这唯一的格子,你放我取,轮流上阵。两个二元信号量一卡,天然就实现了对同一临界资源的严格同步与互斥访问。
二、POSIX信号量:核心接口与基本操作
用POSIX信号量之前,头文件得先请进来:<semaphore.h>。
2.1 初始化信号量
cpp
#include <semaphore.h>
int sem_init(sem_t *sem, int pshared, unsigned int value);
参数一个个看:
- sem:指向要初始化的那个信号量对象。
- pshared:0表示线程间共享;非零表示进程间共享。一个值,决定了这把"信号量"的势力范围划在哪儿。
- value:信号量的初始值,也就是一开始有多少可用资源。
2.2 销毁信号量
cpp
int sem_destroy(sem_t *sem);用来释放信号量占用的系统资源。但动手销毁之前,得先确认一件事:没有线程还在等它。有线程堵着,你这边把信号量拆了,那边就悬在半空了。
2.3 等待信号量:P操作
cpp
int sem_wait(sem_t *sem); // P操作行为很干脆:信号量的值大于0,就减一,立刻返回,资源到手;信号量的值等于0,调用线程当场阻塞,一直等到有人把信号量的值抬起来为止。
2.4 发布信号量:V操作
cpp
int sem_post(sem_t *sem); // V操作发布信号量,表示资源用完了,该还回去了。动作就是把信号量的值加一。
三、环形缓冲生产者消费者模型:源码实现与分析
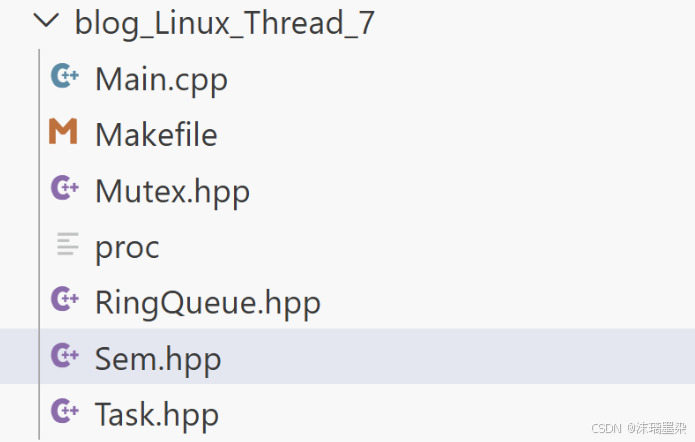
先把整套代码拆开看。这个模型由五个文件组成,各司其职。
3.1 RingQueue.hpp:环形队列的核心实现
cpp
#pragma once
#include <unistd.h>
#include <cstdio>
#include <vector>
#include "Mutex.hpp"
#include "Sem.hpp"
using namespace MySem;
using namespace MyMutex;
const size_t DEFULT_SIZE = 5;
namespace ProducerAndConsumerProblemByRingQueue
{
    template <typename T>
    class RingQueue
    {
    public:
        RingQueue(size_t N = DEFULT_SIZE)
            : _capacity(N), _blank_sem(N), _data_sem(0), _c_step(0), _p_step(0)
        {
            _RingQueue.resize(_capacity);
        }
        void Equeue(const T& args)
        {
            //Producer
            _blank_sem.P();
            {
                _p_mutex.Lock();
                _RingQueue[_p_step] = args ;
                _p_step++;
                _p_step %= _capacity ;
                _data_sem.V();
                _p_mutex.UnLock();
            }
        }
        T Pop()
        {
            //Consumer
            T data ;
            _data_sem.P();
            {
                _c_mutex.Lock();
                data = _RingQueue[_c_step];
                _c_step++;
                _c_step %= _capacity ;
                _blank_sem.V();
                _c_mutex.UnLock();
            }
            return data;
        }
        ~RingQueue()
        {}
    private:
        std::vector<T> _RingQueue;
        size_t _capacity;
        Sem _blank_sem;
        Sem _data_sem;
        size_t _c_step;
        size_t _p_step;
        Mutex _c_mutex;
        Mutex _p_mutex;
    };
}
核心思路:_blank_sem管空位,_data_sem管数据。生产者先申请空位,拿到就往里放,放完把数据资源释放;消费者先申请数据,拿到就取走,取完把空位释放。两把锁_p_mutex和_c_mutex 分别管生产者和消费者之间的竞争。生产者和消费者之间靠信号量天然错开槽位,不需要额外互斥。
3.2 Sem.hpp:POSIX信号量封装
cpp
#pragma once
#include <semaphore.h>
namespace MySem
{
    class Sem
    {
    public:
        Sem(size_t size) { sem_init(&_sem, 0, size); }
        void P() { sem_wait(&_sem); }
        void V() { sem_post(&_sem); }
        ~Sem() { sem_destroy(&_sem); }
    private:
        sem_t _sem;
    };
}
3.3 Task.hpp:任务对象定义
cpp
#include <functional>
#include <iostream>
#include <vector>
using task_t = std::function<void(void)>;
const size_t TASK_NUM = 3;

void MemoryProblem()   { std::cout << "This is a Memory Problem" << std::endl; }
void SQLProblem()      { std::cout << "This is a SQL Problem" << std::endl; }
void InternetProblem() { std::cout << "This is a Internet Problem" << std::endl; }

class TaskManager
{
public:
    TaskManager() = default;
    ~TaskManager() {}
    void Register(task_t task) { _TaskCollection.push_back(task); }
    task_t operator[](size_t i) { return _TaskCollection[i]; }
private:
    std::vector<task_t> _TaskCollection;
};
task_t是std::function<void(void)>,任务被抽象成可调用对象。TaskManager负责注册任务,用下标访问,随机取一个就能派发。
3.4 Mutex.hpp:互斥锁封装
cpp
#pragma once
#include <pthread.h>
namespace MyMutex
{
    class Mutex
    {
    public:
        Mutex() { pthread_mutex_init(&_mutex, nullptr); }
        void Lock() { pthread_mutex_lock(&_mutex); }
        void UnLock() { pthread_mutex_unlock(&_mutex); }
        ~Mutex() { pthread_mutex_destroy(&_mutex); }
    private:
        pthread_mutex_t _mutex;
    };
}
3.5 Main.cc:程序运行入口
cpp
#include "RingQueue.hpp"
#include "Task.hpp"
#include <ctime>
using namespace ProducerAndConsumerProblemByRingQueue;

const size_t THREAD_NUM = 5;

class ThreadData
{
public:
    ThreadData(RingQueue<task_t>* ringqueue, char* name)
        : _ringqueue(ringqueue), _name(name) {}
    RingQueue<task_t>* _ringqueue;
    char* _name;
};

task_t RandTask()
{
    TaskManager tmang;
    tmang.Register(MemoryProblem);
    tmang.Register(SQLProblem);
    tmang.Register(InternetProblem);
    return tmang[rand() % TASK_NUM];
}

void* Producer(void* args)
{
    char* name = static_cast<ThreadData*>(args)->_name;
    RingQueue<task_t>* ringqueue = static_cast<ThreadData*>(args)->_ringqueue;
    while (true)
    {
        std::cout << name << "生产一个任务 " << std::endl;
        ringqueue->Equeue(RandTask());
    }
    delete[](static_cast<ThreadData*>(args)->_name);
}

void* Consumer(void* args)
{
    char* name = static_cast<ThreadData*>(args)->_name;
    RingQueue<task_t>* ringqueue = static_cast<ThreadData*>(args)->_ringqueue;
    while (true)
    {
        std::cout << name << "消费一个任务 " << std::endl;
        task_t task = ringqueue->Pop();
        task();
    }
    delete[](static_cast<ThreadData*>(args)->_name);
}

int main()
{
    srand((unsigned int)time(NULL));
    std::vector<pthread_t> p_thread;
    std::vector<pthread_t> c_thread;
    RingQueue<task_t>* ringqueue = new RingQueue<task_t>();

    // 生产者们
    for (int i = 0; i < THREAD_NUM; i++)
    {
        char* name = new char[64];
        int n = snprintf(name, 64, "ProducerThread-%d", i);
        (void)n;
        ThreadData* data = new ThreadData(ringqueue, name);
        pthread_t tid;
        pthread_create(&tid, nullptr, Producer, data);
        p_thread.push_back(tid);
    }

    // 消费者们
    for (int i = 0; i < THREAD_NUM; i++)
    {
        char* name = new char[64];
        int n = snprintf(name, 64, "ConsumerThread-%d", i);
        (void)n;
        ThreadData* data = new ThreadData(ringqueue, name);
        pthread_t tid;
        pthread_create(&tid, nullptr, Consumer, data);
        c_thread.push_back(tid);
    }

    for (auto e : p_thread) pthread_join(e, nullptr);
    for (auto e : c_thread) pthread_join(e, nullptr);
    return 0;
}
主程序创建 5 个生产者和 5 个消费者,生产者随机选一个任务往环形队列里丢,消费者从队列里取任务并执行。
整体框架选型是对的:信号量管资源计数,两把锁分别保护生产者和消费者指针的竞争。但代码里有几处值得优化的地方。
四、代码问题排查与实现优化
框架没问题,但代码里有几个坑,有的影响性能,有的是隐藏的Bug。
4.1 致命问题:RandTask()为何反复创建TaskManager
cpp
task_t RandTask()
{
    TaskManager tmang;          // 每次调用都新建
    tmang.Register(MemoryProblem);
    tmang.Register(SQLProblem);
    tmang.Register(InternetProblem);
    return tmang[rand() % TASK_NUM];
}
每生产一个任务,都要构造一个TaskManager,往vector里塞三个std::function,返回一个拷贝,然后对象销毁。生产频繁时,这是纯纯的浪费。改成静态对象,一次构造,终身复用:
cpp
task_t RandTask()
{
    static TaskManager tmang = [] {
        TaskManager tm;
        tm.Register(MemoryProblem);
        tm.Register(SQLProblem);
        tm.Register(InternetProblem);
        return tm;
    }();
    return tmang[rand() % TASK_NUM];
}
4.2 锁的粒度:为什么V操作应该移到锁外
cpp
_p_mutex.Lock();
_RingQueue[_p_step] = args;
_p_step = (_p_step + 1) % _capacity;
_data_sem.V();              // 在锁内
_p_mutex.UnLock();
V操作本身不会死锁,但它在锁内会延长持锁时间。唤醒的线程如果立刻去抢同一把锁,还会多一次无谓的上下文切换。挪到锁外:
cpp
_p_mutex.Lock();
_RingQueue[_p_step] = args;
_p_step = (_p_step + 1) % _capacity;
_p_mutex.UnLock();
_data_sem.V();
4.3 手动加解锁的问题:为什么应该使用RAII锁
_p_mutex.Lock()和UnLock()中间万一抛异常或提前返回,锁就永远锁死了。用RAII守卫,构造即加锁,析构即解锁:
cpp
{
    MutexGuard guard(_p_mutex);
    _RingQueue[_p_step] = args;
    _p_step = (_p_step + 1) % _capacity;
}
_data_sem.V();
4.4 内存泄漏:为什么delete\[\]可能永远执行不到
cpp
void* Producer(void* args)
{
    ...
    while(true) { ... }        // 死循环
    delete[](static_cast<ThreadData*>(args)->_name);   // 永远到不了
}
while(true)是死循环,后面的delete\[\]永远执行不到。而且ThreadData* data = new ThreadData(...) 也没人释放。演示代码里进程退出会兜底,但工程代码里这是硬伤。更省心的做法是用智能指针:
cpp
auto data = std::make_unique<ThreadData>(ringqueue, name);
pthread_create(&tid, nullptr, Producer, data.get());
data.release();   // 线程函数里再接管
或者干脆把ThreadData和name都放到栈上,用结构体传值,根本不用new。
4.5 rand()的线程安全问题
五个生产者线程同时调rand(),标准并不保证线程安全。换成thread_local的随机数引擎:
cpp
thread_local std::mt19937 rng(std::random_device{}());
int idx = rng() % TASK_NUM;
4.6 Pop()中的T data:为什么依赖默认构造
cpp
T data;                     // 要求 T 有默认构造函数
_data_sem.P();
data = _RingQueue[_c_step];
如果T没有默认构造函数,这里直接编译不过。改成拷贝初始化:
cpp
T Pop()
{
    _data_sem.P();
    _c_mutex.Lock();
    T data = _RingQueue[_c_step];
    _c_step = (_c_step + 1) % _capacity;
    _c_mutex.UnLock();
    _blank_sem.V();
    return data;
}
4.7 优化后的RingQueue核心实现
cpp
void Enqueue(const T& args)
{
    _blank_sem.P();
    {
        MutexGuard guard(_p_mutex);
        _RingQueue[_p_step] = args;
        _p_step = (_p_step + 1) % _capacity;
    }
    _data_sem.V();
}

T Pop()
{
    _data_sem.P();
    T data;
    {
        MutexGuard guard(_c_mutex);
        data = _RingQueue[_c_step];
        _c_step = (_c_step + 1) % _capacity;
    }
    _blank_sem.V();
    return data;
}
4.8 对整体实现的评价
框架选型没问题:信号量管资源计数,两把锁分别保护生产者之间和消费者之间的竞争,生产者和消费者之间靠信号量天然错开槽位,不需要额外互斥。这套设计是对的。
主要优化集中在三块:**TaskManager别反复重建、V操作移出锁外、手动锁换成RAII。**前两个是性能问题,第三个是健壮性问题。改完之后,这份代码就从"能跑"升级成"跑得好、不容易崩"了。
4.9 P操作与Lock操作:谁应该先执行
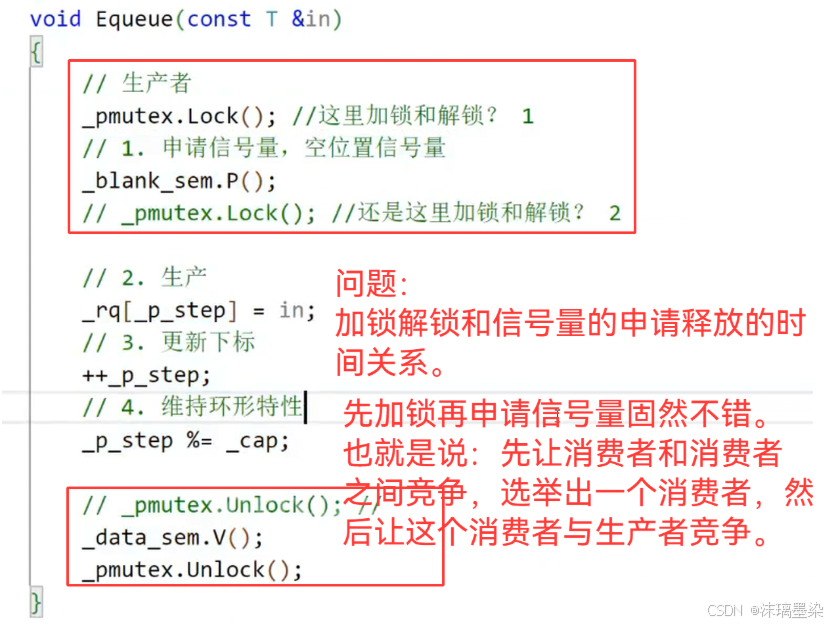
在实现环形缓冲区时,"申请信号量"和"申请互斥锁"谁先谁后,存在两种写法:
顺序一:先加锁,再申请信号量。 线程先拿到互斥锁进入临界区,再进行sem_wait申请资源。
顺序二:先申请信号量,再加锁。 线程先sem_wait申请资源,成功拿到资源后,再获取互斥锁。
两种方式功能上都能跑通,但在多线程环境下,顺序二的执行效率明显更高。
4.9.1 为什么这样才能保证正确性
有人可能会担心:先P操作、后加锁,会不会不安全?答案是不会。信号量的P/V操作,由操作系统底层保证原子性,不需要互斥锁再给它加一层保护。P操作本身就是原子的,线程要么拿到资源,要么被挂起,中间没有可插入的窗口。
4.9.2 高效性对比:用"买电影票"理解锁与信号量
用"买电影票"打个比方,两种顺序的差距一目了然。
先加锁,再申请信号量:相当于所有人排成一条单列长队,只有排到最前面的人,才能掏出手机尝试买票。如果票已经卖完了,这个人挂起等待,身后排队的所有人跟着一起堵死。整条队伍,被卡在一个人身上。
先申请信号量,再加锁:相当于所有人先在网络上各自并发抢票。抢到票的人,再去影院门口排队核验入场。没抢到票的,压根不用去排队,省了那份排队的时间。
在并发场景下,顺序二的优势非常明显:当某一个线程拿到资源、获取锁、在临界区里更新队列下标时,其他线程完全可以并发地执行P操作,提前预分配资源。等到它们需要进临界区时,资源已经攥在手里了,只需要再抢一把锁就行。
换句话说,P操作可以在锁外并行做,锁只负责保护临界区那一小段。 把P操作挪到锁内,等于把"抢资源"这个本来可以并行的事,硬生生塞进了串行的临界区,白白拉长了持锁时间,也拉低了整体并发度。
先申请信号量,再加锁。锁的粒度越细,并发度越高。P操作是原子的,放心放在锁外做。
如果这篇文章对你有帮助,别忘了点个赞、点个收藏、点个关注。你的每一次反馈,都是我继续硬核输出的最大动力。