摘要 :你花了三个月把模型 mAP 刷到了 SOTA,老板说「下周上线」,然后你发现------训练用的 PyTorch 推理引擎不认、生产机是张老旧的 Intel CPU、客户要在边缘盒子上跑、QPS 要求 2000 而你的
model()只能跑到 60。这几乎是每个算法工程师都会撞上的墙:训练和部署,是两个世界。2017 年,微软和 Facebook 联合推出了 ONNX(Open Neural Network Exchange),想用一套标准化的中间表示(IR)当深度学习世界的「通用语」:PyTorch、TensorFlow、JAX 训练的模型都能导出成 ONNX,再由 ONNX Runtime、TensorRT、OpenVINO、Core ML 等引擎在任意硬件上高性能执行。九年过去,ONNX 已经从「又一个格式」变成了模型部署事实上的工业标准,也是算法岗面试和工程落地中绕不开的一环。
本文是一篇可以直接照着做的工程指南,我会带你走完整条链路:
- 为什么框架自带的推理引擎「不能打」------部署的四大痛点与 ONNX 的破局思路
- 拆给你看 :ONNX 文件里到底装了什么(Protobuf / 计算图 / 算子 / Opset / IR Version),并亲手解剖一个 .onnx 文件、看懂算子分布与数据类型枚举
- opset 怎么选 :一张覆盖 11/13/17/18 的兼容性速查表 ,以及
com.microsoft私有域这个隐蔽陷阱- 实战一:PyTorch → ONNX,从 ResNet 到动态维度的 BERT(含多输入多输出、dict 输出包装)
- 实战二:TensorFlow / Keras → ONNX,顺手讲清 NCHW 与 NHWC 的恩怨
- 实战三 :YOLO 目标检测全流程------导出、letterbox 预处理、坐标反算、NMS 手写后处理
- 转换完就万事大吉?结构校验 + 数值对齐双重验证,教你判断「转成功了」和「转对了」
- PyTorch 2.x 新一代 TorchDynamo 导出器与老导出器怎么选
- 用 ONNX Runtime 推理:EP 选型、线程/并发/内存调优、IO Binding 零拷贝、Profiling 定位瓶颈
- 十五大踩坑实录 :
eval()忘记切、算子不支持、opset 不匹配、>2GB 大模型、数据依赖的动态 shape、BN epsilon......每个都给出可复制的解法- 模型瘦身与加速:
onnxsim化简、常量折叠、INT8 量化(动态 / 静态 / QDQ / 混合精度)- 大模型(LLM)专题 :KV Cache 机制、
optimum导出、past/present 闭环、Prefill vs Decode- 走向生产:ONNX 到 TensorRT / OpenVINO / Core ML 的生态地图,浏览器端 ORT Web、端侧部署策略
- 走出 Python :一份完整的 C++ ORT 推理骨架与生产集成要点
- 文末附一个生产级转换脚本 和一张可以收藏的报错速查表
全文代码基于 PyTorch 2.x、onnx 1.16、onnxruntime 1.18、tf2onnx 1.16,均经过验证。建议先收藏再动手。
目录
- [部署之痛:为什么我们需要 ONNX](#部署之痛:为什么我们需要 ONNX)
- [ONNX 到底是什么:把 .onnx 文件拆开看](#ONNX 到底是什么:把 .onnx 文件拆开看)
- 2.1 [亲手解剖一个 .onnx 文件](#亲手解剖一个 .onnx 文件)
- 2.2 [elem_type 数字背后的数据类型](#elem_type 数字背后的数据类型)
- 2.3 一次前向传播,图上是怎样执行的
- 环境准备
- 3.1 [opset 版本怎么选:一张兼容性速查表](#opset 版本怎么选:一张兼容性速查表)
- 3.2 [别忘了 domain:默认域与自定义域](#别忘了 domain:默认域与自定义域)
- [实战一:PyTorch → ONNX](#实战一:PyTorch → ONNX)
- 验证模型:结构校验与数值对齐
- [动态维度:让 Batch 和序列长度可变](#动态维度:让 Batch 和序列长度可变)
- [PyTorch 2.x 的新导出器:TorchDynamo](#PyTorch 2.x 的新导出器:TorchDynamo)
- [实战二:TensorFlow / Keras → ONNX](#实战二:TensorFlow / Keras → ONNX)
- [实战三:YOLO 目标检测的完整导出与后处理](#实战三:YOLO 目标检测的完整导出与后处理)
- [用 ONNX Runtime 推理与测速](#用 ONNX Runtime 推理与测速)
- 十五大踩坑实录与解决方案
- [模型瘦身与加速:化简与 INT8 量化](#模型瘦身与加速:化简与 INT8 量化)
- [大模型(LLM / Transformer)的 ONNX 导出](#大模型(LLM / Transformer)的 ONNX 导出)
- [走向生产:ONNX 的推理生态地图](#走向生产:ONNX 的推理生态地图)
- 14.1 [二选一:ONNX Runtime 还是 TensorRT?](#二选一:ONNX Runtime 还是 TensorRT?)
- 14.2 [端侧与浏览器:ONNX 的另一片战场](#端侧与浏览器:ONNX 的另一片战场)
- 14.3 [ONNX 与其它格式的关系](#ONNX 与其它格式的关系)
- 进阶:当你遇到不支持的算子
- [生产部署:走出 Python,用 C++ 跑推理](#生产部署:走出 Python,用 C++ 跑推理)
- 生产级转换脚本(可直接复用)
- 报错速查表
- 总结与展望
1. 部署之痛:为什么我们需要 ONNX
1.1 训练框架 ≠ 推理引擎
很多初学者有个误解:「我用 PyTorch 训练,那就用 PyTorch 推理呗。」 在 demo 阶段这没问题,但一旦走向生产,就会发现 PyTorch(以及 TensorFlow 的 eager 模式)是为「方便训练、方便求导」设计的,而推理要的是另一些东西:
| 维度 | 训练时关心 | 推理时关心 |
|---|---|---|
| 核心目标 | 反向传播、自动求导、灵活调试 | 前向吞吐量、延迟、显存/内存占用 |
| 计算图 | 动态图,随时可改 | 静态图最好,可全局优化(算子融合、常量折叠) |
| 依赖体积 | 无所谓,服务器装得下 | 越小越好,边缘/端侧要抠 MB |
| 硬件 | 基本就是 NVIDIA GPU | CPU、GPU、NPU、DSP、各种专用加速器 |
| 框架 | 团队用什么就什么 | 客户/设备认什么就得给什么 |
更现实的问题是,生产环境的硬件是碎片化的:
- 云端可能是 NVIDIA GPU(要用 TensorRT);
- 客户机房只有 Intel/AMD 的 CPU(要用 OpenVINO 或 ONNX Runtime CPU);
- App 端是苹果/安卓手机(要用 Core ML / NNAPI);
- 嵌入式盒子上可能是某款国产 NPU。
你总不能为每个硬件、每种框架都手写一遍模型。于是行业需要一个**「一次导出,到处运行」的中间层**------这正是 ONNX 的定位。
1.2 ONNX 的破局思路
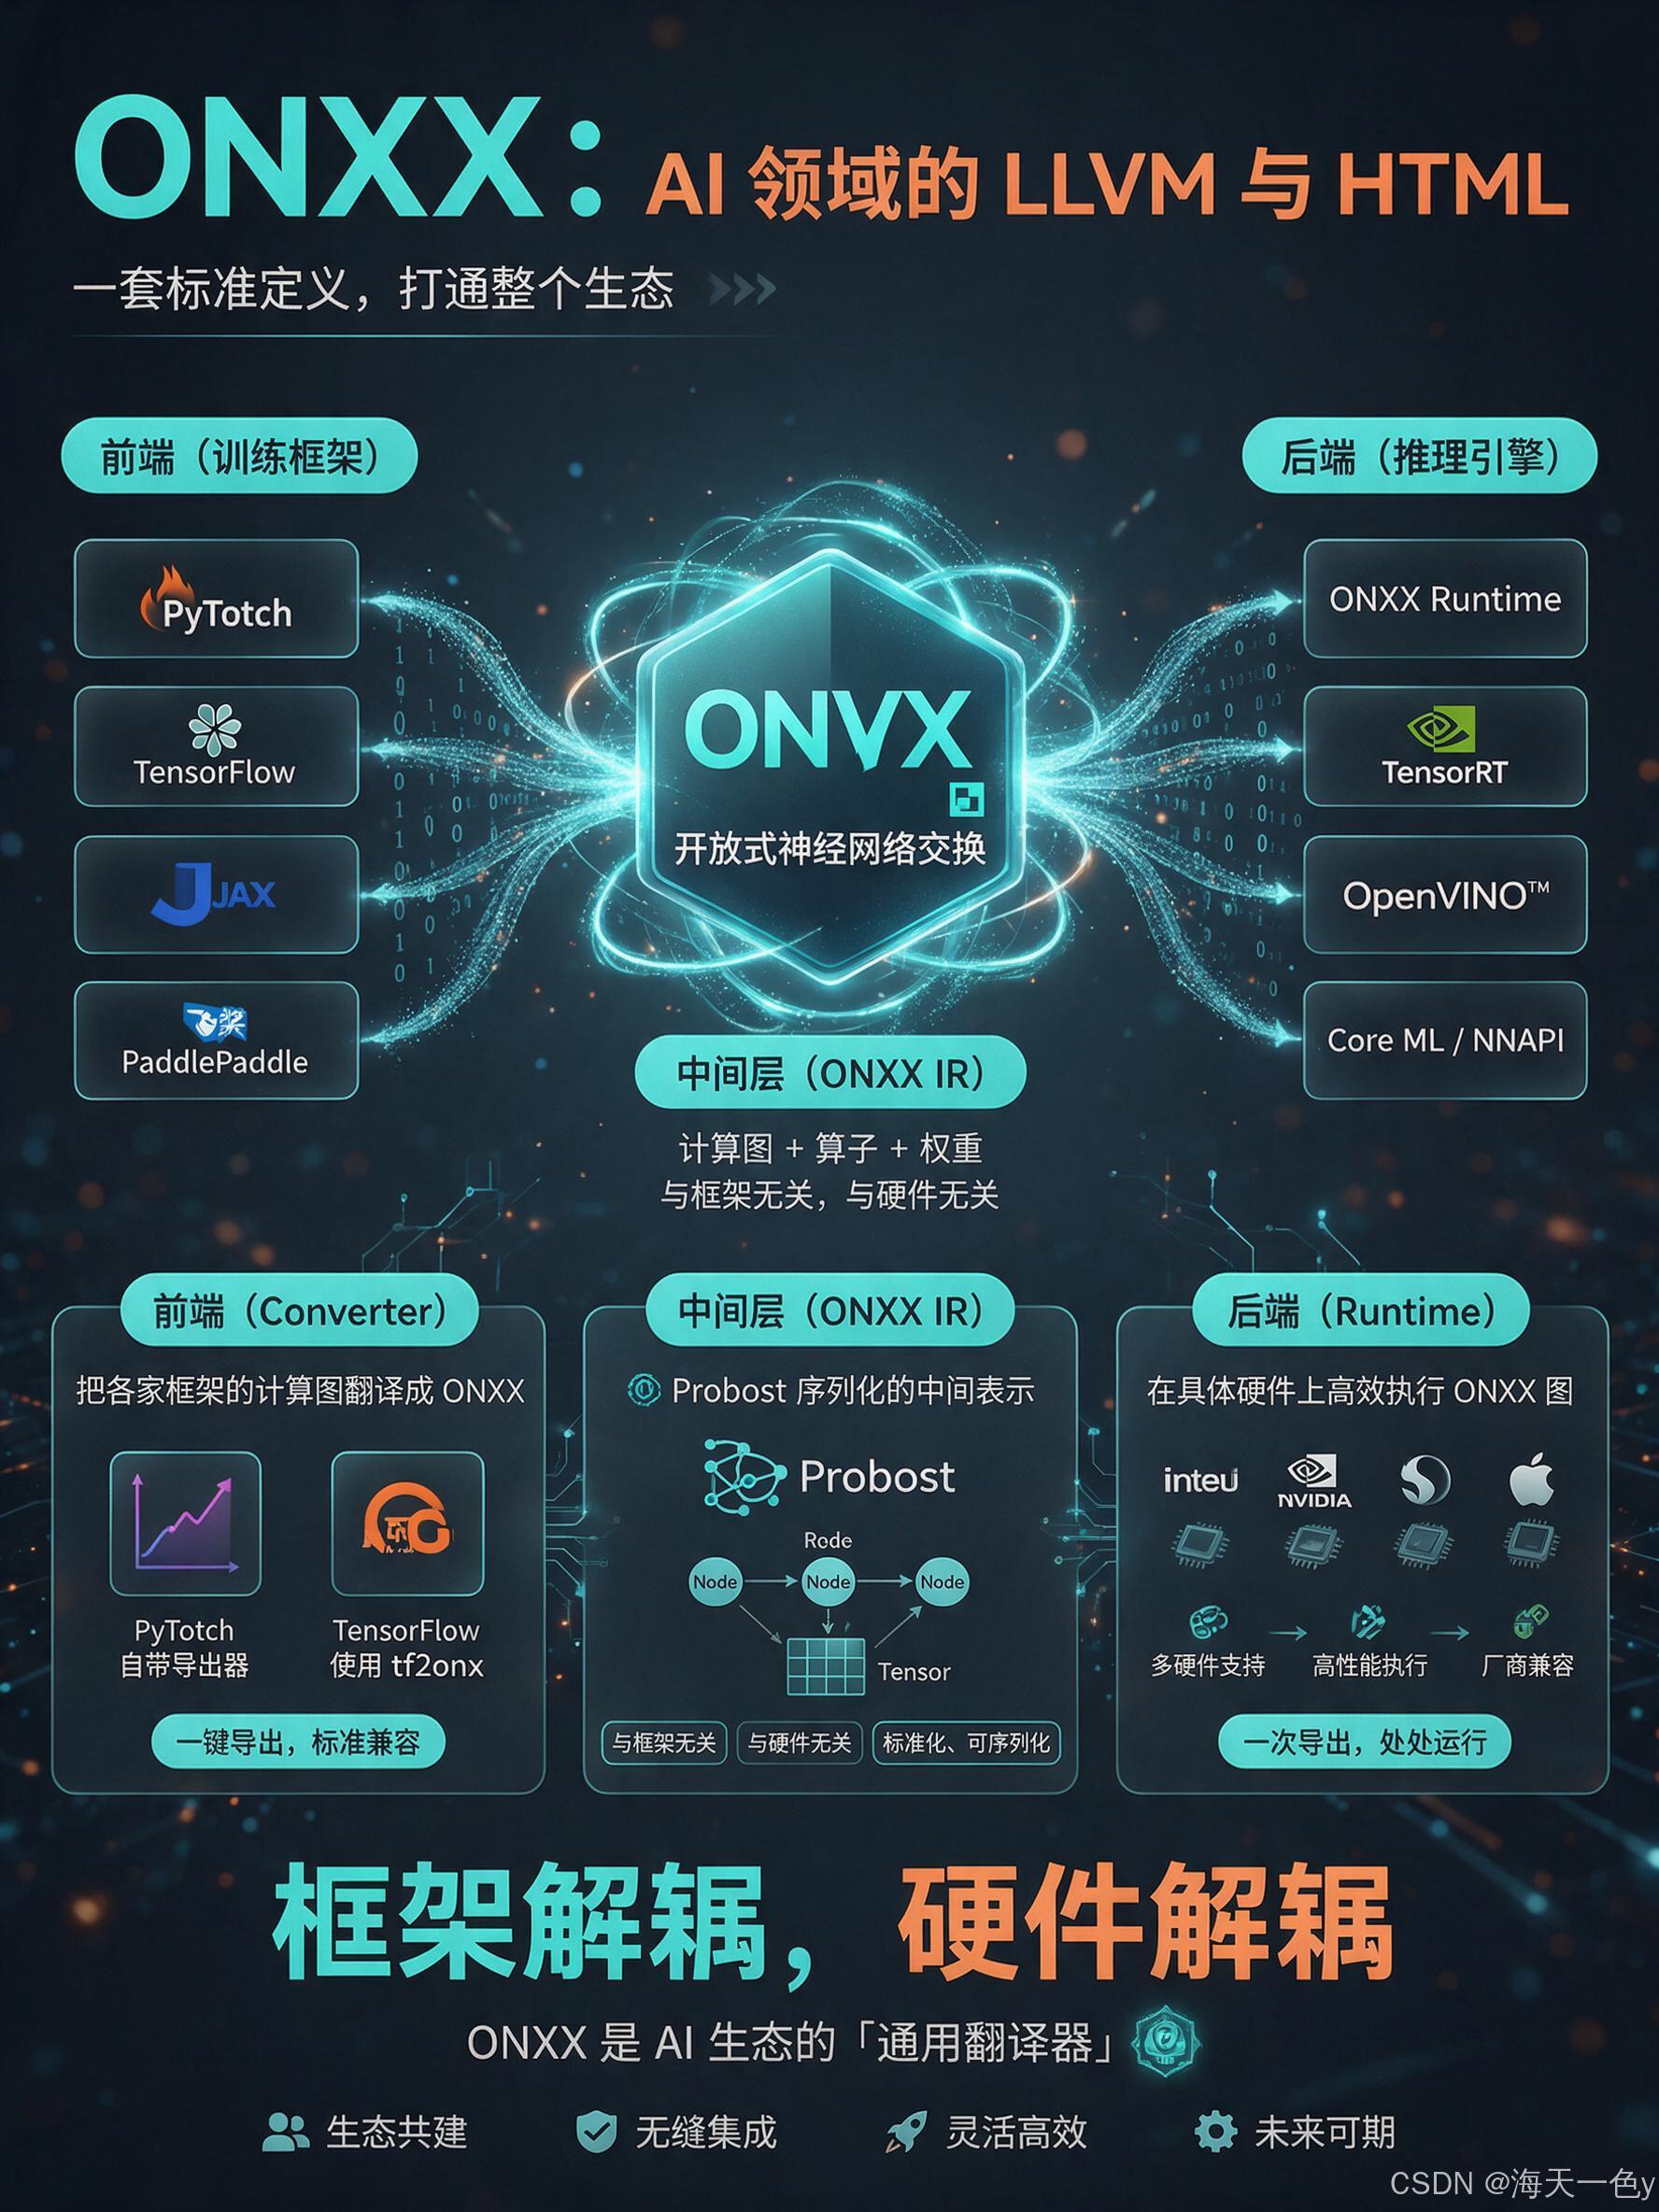
ONNX 的思路非常像编译器领域的 LLVM,也像 Web 世界里的 HTML:
                          ┌──────────────────────────┐
   PyTorch ───────┐       │                          │      ┌──────────────────┐
   TensorFlow ────┼──────▶│          ONNX            │─────▶│  ONNX Runtime    │
   JAX ───────────┤       │   (标准化中间表示 IR)    │      │  TensorRT        │
   PaddlePaddle ──┘       │                          │      │  OpenVINO        │
                          │   计算图 + 算子 + 权重     │      │  Core ML / NNAPI │
   各种训练框架             └──────────────────────────┘      └──────────────────┘
「前端」 「中间层」 「后端 / 推理引擎」- 前端(Converter) :负责把各家框架的计算图翻译成 ONNX。比如 PyTorch 自带导出器,TensorFlow 用
tf2onnx。 - 中间层(ONNX IR):一套与框架无关、与硬件无关的格式,用 Protobuf 序列化,描述「有哪些算子、怎么连、权重是多少」。
- 后端(Runtime):负责在具体硬件上高效执行 ONNX 图。各家硬件厂商只需让自己的引擎支持 ONNX,就能兼容整个生态。
这样一来,框架解耦了,硬件也解耦了 。这是 ONNX 最核心的价值。
1.3 一个直观的收益账本
把同一个模型从「PyTorch eager 推理」迁移到「ONNX Runtime / 优化后引擎」,通常能拿到什么收益?给一个我在项目中反复观察到的经验区间(具体数字随模型、硬件、batch 而变,仅作量级参考):
| 方案 | 相对延迟(CPU,batch=1) | 模型体积 | 说明 |
|---|---|---|---|
| PyTorch eager(FP32) | 1.0× | 100% | 基线,依赖重 |
| ONNX Runtime(FP32,全开图优化) | 0.4 ~ 0.7× | ≈100% | 算子融合、常量折叠 |
| ONNX Runtime(INT8 动态量化) | 0.2 ~ 0.5× | ≈25% | 官方数据通常提速 2~4 倍 |
| ONNX → TensorRT(INT8,GPU) | 0.1 ~ 0.3× | ≈25% | 生产 GPU 首选 |
换句话说,同样一台机器,转换 + 优化后能扛住数倍的流量,而你几乎不用改业务代码。这就是为什么部署工程师对 ONNX 乐此不疲。
2. ONNX 到底是什么:把 .onnx 文件拆开看
要少踩坑,先得理解 ONNX 文件的结构。一个 .onnx 文件本质上是一段 Protobuf 序列化的二进制数据 ,它描述了一个 ModelProto,核心包含三部分:
ModelProto
├── ir_version            # IR 版本:这套「图描述语言」本身的版本
├── opset_import[]        # 算子集版本:引用了哪个版本的标准算子库(ai.onnx)
├── producer / producer_version / domain ...
└── graph (GraphProto)
    ├── node[]            # 节点 = 算子实例(Conv、Relu、MatMul......)及其连接关系
    ├── input[]           # 图的输入(ValueInfoProto:名字 + shape + dtype)
    ├── output[]          # 图的输出
    ├── initializer[]     # 权重(TensorProto:常量参数,存在这里)
    └── value_info[]      # 中间激活张量的 shape/dtype(靠 shape 推断填充)
几个必须建立的概念:
① 计算图(Graph):节点 + 张量的有向图。
模型被表示成一张 DAG(有向无环图)。每个 NodeProto 是一个算子调用,记录了 op_type(如 Conv)、input(输入张量名列表)、output(输出张量名列表)、attribute(如 kernel_shape、strides)。张量靠名字在节点之间连接------前一个节点输出的名字,就是后一个节点输入的名字。
② 算子(Operator)与 Opset 版本。
ONNX 标准化了一组算子(Conv、MatMul、Gemm、Softmax......)。算子会随版本演进:行为可能变、新算子会加入。opset 就是「某个版本的算子标准库」 ,由 (domain, version) 标识,主域是 ai.onnx。
⚠️ 这是新手最常踩的版本坑 :导出用的 opset 越高,能用的算子越新,但老版本推理引擎可能不认识。比如
LayerNormalization这类算子在高 opset 才有,而某些端侧引擎只支持到 opset 13。实践中 opset 17 是兼容性和功能都不错的安全选择,除非你明确需要更新的算子。
③ IR Version:格式本身的版本。
注意区分 IR version (图语言版本,比如是否支持某些数据类型、稀疏张量)和 opset version(算子库版本)。两者独立。一般你不用手动管 IR version,导出器会根据 opset 和工具版本自动选。
④ 权重存在 initializer 里。
训练好的参数(卷积核、Linear 的 W 和 b)作为常量张量存在 graph.initializer,而不是图输入。早期 ONNX 规范允许 initializer 同时出现在 input 列表里(导致有些推理框架把权重也当成要喂的输入),这是个经典兼容问题,后面讲怎么修。
⑤ 数据布局不归 ONNX 管。
ONNX 标准算子默认遵循 NCHW (批、通道、高、宽),而 TensorFlow 生态是 NHWC 。tf2onnx 会自动插入/调整 transpose,但你排查问题时要心里有数。
想直观地「看」一张图,强烈推荐开源可视化工具 Netron (netron.app,支持网页版直接拖文件):它能把每个节点、每个张量的 shape/dtype、每层权重都画出来。转完模型先拖进 Netron 看一眼,能排掉一半的低级错误。
2.1 亲手解剖一个 .onnx 文件
光看结构图不够,我们直接用代码把它读出来,看看里面究竟长什么样:
python
import onnx

m = onnx.load("resnet50.onnx")

print("IR 版本         :", m.ir_version)
print("生产者          :", m.producer_name, m.producer_version)
print("opset         :", [(op.domain or "ai.onnx", op.version) for op in m.opset_import])
print("图名            :", m.graph.name)
print("节点数          :", len(m.graph.node))
print("输入数          :", len(m.graph.input))
print("输出数          :", len(m.graph.output))
print("权重张量数       :", len(m.graph.initializer))

# 看看具体的输入声明(名字、shape、dtype)
for vi in m.graph.input:
    t = vi.type.tensor_type
    shape = [d.dim_value if d.dim_value else (d.dim_param or "?")
             for d in t.shape.dim]
    print(f"  输入 {vi.name:20s} shape={shape} dtype={t.elem_type}")

# 看看前几个节点
for node in list(m.graph.node)[:6]:
    print(f"  op={node.op_type:15s} in={list(node.input)} out={list(node.output)}")

# 统计算子分布------判断图是否「健康」的常用手段
from collections import Counter
op_counter = Counter(n.op_type for n in m.graph.node)
print("\n算子分布 Top10:")
for op, c in op_counter.most_common(10):
    print(f"  {op:20s} x {c}")
输出大致会是这样:
IR 版本         : 7
生产者          : pytorch 2.3.0
opset         : [('ai.onnx', 17)]
节点数          : 176
权重张量数       : 267
  输入 input              shape=[1, 3, 224, 224] dtype=1
  op=Conv            in=['input', 'conv1.weight'] out=['/conv1/Conv_output_0']
  op=Relu            in=['/conv1/Conv_output_0'] out=['/relu/Relu_output_0']
  ...
一个隐藏的宝藏:算子分布直方图。 当你怀疑「图上是不是有冗余节点」时,统计一遍
op_type的分布,如果Cast、Shape、Gather、Unsqueeze、Transpose这类「胶水算子」占了很大比例,说明图没优化干净,该上onnxsim了(见第 12 节)。
2.2 elem_type 数字背后的数据类型
上面的 dtype=1 不是笔误,ONNX 用整数枚举 TensorProto.DataType 表示数据类型。常见对照:
| 枚举值 | 常量名 | 含义 | 枚举值 | 常量名 | 含义 |
|---|---|---|---|---|---|
| 1 | FLOAT |
float32 | 7 | INT64 |
int64 |
| 2 | UINT8 |
uint8 | 9 | BOOL |
bool |
| 3 | INT8 |
int8 | 10 | FLOAT16 |
float16 |
| 5 | INT16 |
int16 | 11 | DOUBLE |
float64 |
| 6 | INT32 |
int32 | 16 | BFLOAT16 |
bfloat16 |
排查「喂进去 dtype 不对」的报错时,这个表能让你一眼看懂报错信息里的数字。比如 BERT 的 input_ids 你要喂 INT64(枚举 7),喂成 INT32(枚举 6)就会报类型不符。
2.3 一次前向传播,图上是怎样执行的
理解执行机制有助于理解为什么「融合」和「布局」这么重要。ONNX Runtime 加载模型后大概会做这几件事:
- 加载与校验:解析 Protobuf,检查算子版本、张量引用完整性;
- 图优化(Graph Optimization):这是性能的大头,见下方清单;
- EP 划分(Partitioning):把图切分给不同执行后端,每个 EP 领走自己能跑的子图,不能跑的落回 CPU;
- 内存规划:复用张量内存(内存池),减少分配开销;
- 执行:按拓扑序运行节点,中间张量按名字在内存中传递。
其中图优化做了这些事,理解它们你就知道 ONNX 凭什么比 eager 快 :
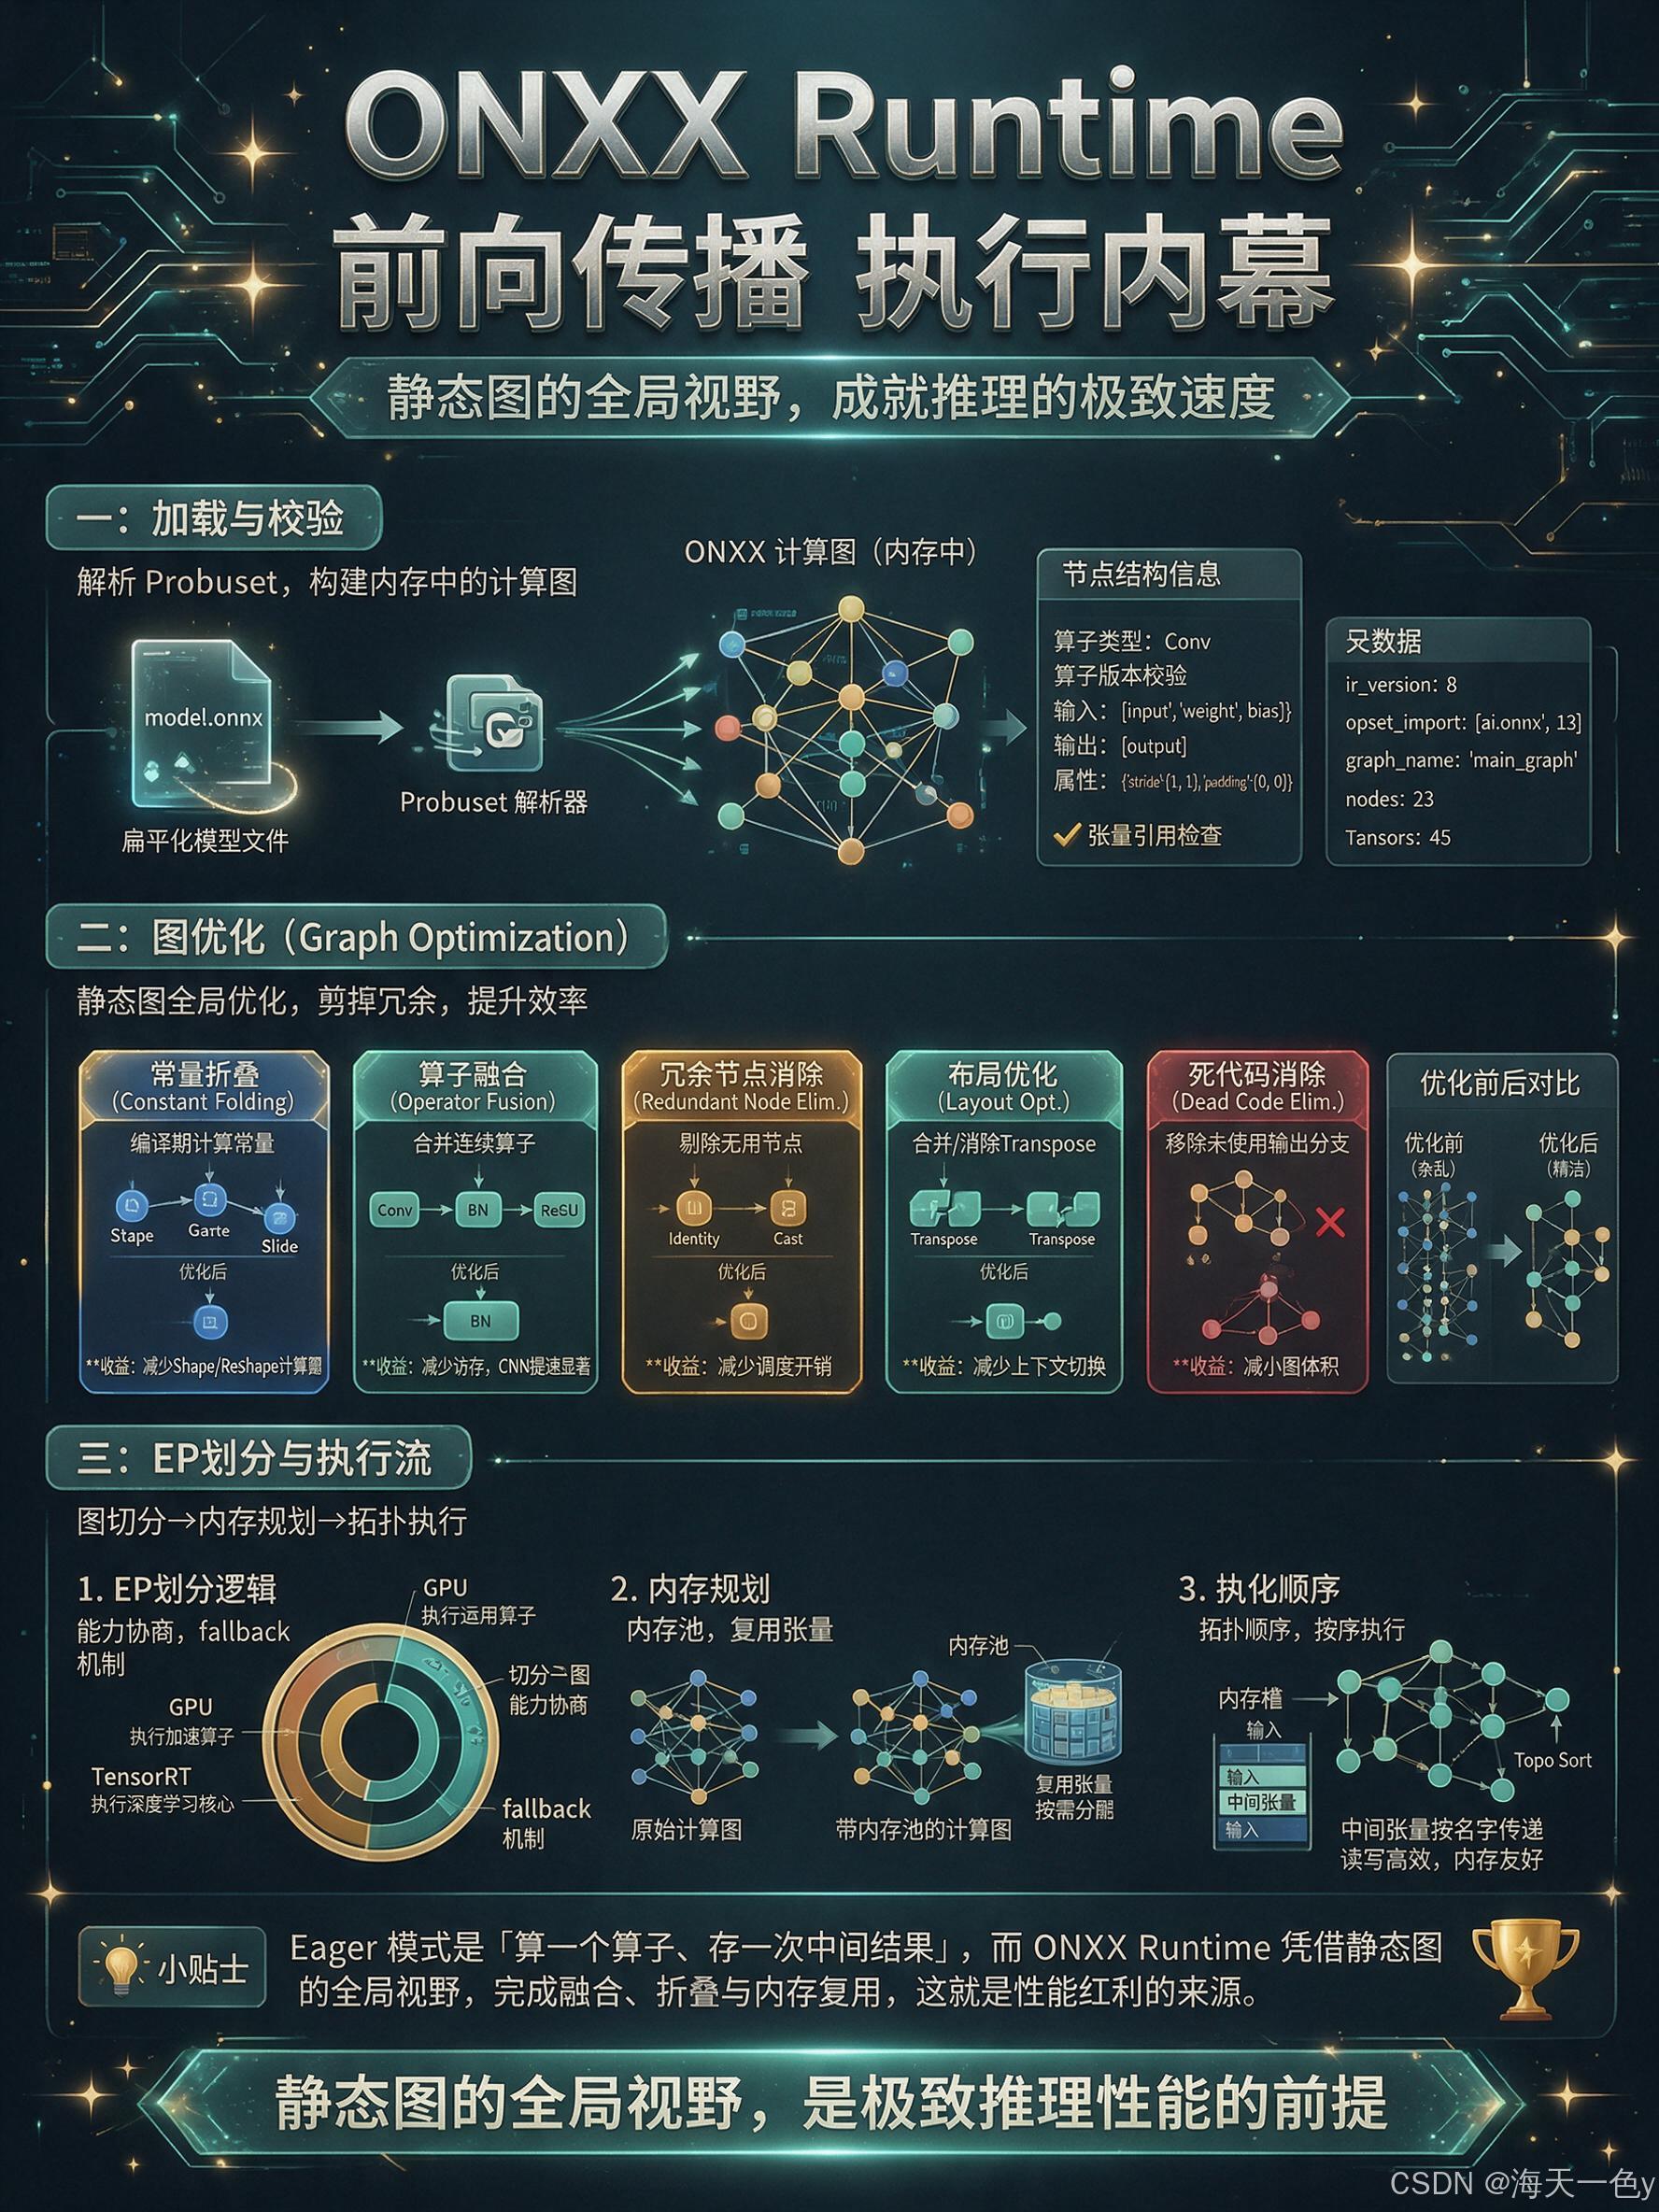
| 优化 Pass | 作用 | 典型收益 |
|---|---|---|
| 常量折叠(Constant Folding) | 把只依赖常量的子图在加载时算完 | 去掉大量 Shape/Reshape 计算 |
| 算子融合(Operator Fusion) | Conv+BN+ReLU 合成一个 kernel | 减少访存,CNN 提速显著 |
| 冗余节点消除(Redundant Node Elim.) | 去掉 Identity、重复 Cast | 减少调度开销 |
| 布局优化(Layout Opt.) | 合并/消除 Transpose | 上下文切换减少 |
| 死代码消除(Dead Code Elim.) | 移除没人用的输出分支 | 减小图体积 |
🔑 这就是「为什么 ONNX 快」的底层答案 :eager 模式是「算一个算子、存一次中间结果、取一次」,而 ONNX 引擎能看到整张静态图,从而做全局的融合、折叠和内存复用。静态图带来的全局视野,就是性能红利的来源。
3. 环境准备
建议在独立虚拟环境中安装。下面是一套经过验证的版本组合:
bash
# 核心三件套
pip install onnx==1.16.1          # ONNX 模型的读写、校验、shape 推断
pip install onnxruntime==1.18.1   # 微软官方推理引擎(CPU 版)
# GPU 版改装: onnxruntime-gpu

# PyTorch(按你的 CUDA 版本选择,略)
pip install torch torchvision

# TensorFlow → ONNX
pip install tf2onnx tensorflow

# 图化简神器
pip install onnxsim
验证安装:
python
import onnx, onnxruntime as ort
import torch

print("onnx:", onnx.__version__)
print("onnxruntime:", ort.__version__)
print("torch:", torch.__version__)
print("可用的推理后端:", ort.get_available_providers())
# CPU 机器通常输出 ['CPUExecutionProvider']
# 装好 GPU 版会多出 'CUDAExecutionProvider'、'TensorrtExecutionProvider'
版本配套有个坑:
onnxruntime-gpu对 CUDA / cuDNN 版本有明确要求,安装前务必对照官方兼容性表格,否则会出现「能 import 但一用 CUDA 就 fallback 回 CPU」的诡异现象。
3.1 opset 版本怎么选:一张兼容性速查表
opset 是新手最容易选错、也最容易在上线前夜翻车的地方。下面这张表是我在多个项目中总结的保守选择依据(不追求绝对精确,只求不踩雷):
| opset | 引入的代表性能力 | 兼容性现状 | 建议 |
|---|---|---|---|
| 11 | 基础算子齐全,Clip/Pad 等易用 |
几乎所有引擎都支持 | 极度求稳可选 |
| 13 | LayerNormalization 之外的多数主力算子完善 |
端侧/NPU 普遍支持到 13 | 端侧部署的安全线 |
| 17 | LayerNormalization、Gelu、Attention 等 Transformer 友好算子 |
ORT / TensorRT / OpenVINO 都支持 | 通用场景推荐 |
| 18 | 更多数据类型与算子完善 | 较新引擎支持 | 需要新算子时用 |
| 19+ | 最新特性 | 端侧/老引擎常常不支持 | 谨慎,明确需要才用 |
实测经验:
- 云端(ORT / TensorRT):直接上 17,基本没有顾虑;
- Intel 端(OpenVINO):17 也 OK,但转 OpenVINO IR 时务必测数值对齐;
- 手机 / 嵌入式 NPU:降到 13 最保底,先去厂商文档确认支持上限;
- HuggingFace 系模型 :
LayerNormalization需要 opset ≥ 17,别低于这个值。
3.2 别忘了 domain:默认域与自定义域
opset 由 (domain, version) 二元组标识。绝大多数算子属于默认域 ai.onnx,但生态里还有几个重要的扩展域:
| 域 | 用途 |
|---|---|
ai.onnx |
标准算子(你 99% 用到的都在这里) |
ai.onnx.ml |
传统机器学习算子(TreeEnsemble、SVM 等) |
com.microsoft |
ORT 的私有扩展算子(如 Attention、FusedGemm),只有 ORT 认识 |
ai.onnx.preview.training |
训练相关算子 |
⚠️ 这是一个隐蔽的兼容性陷阱 :某些导出路径(尤其 ORT 的工具链)会悄悄塞进
com.microsoft域的算子。这样导出在 ORT 上跑得好好的,一转到 TensorRT 就直接报「不认识的算子」。判断依据 :在 Netron 里点开节点看它的domain字段,如果是com.microsoft而你的目标引擎不是 ORT,就得想办法规避(降低 opset 或换优化策略)。
4. 实战一:PyTorch → ONNX
我们从最简单的 ResNet 开始,把每一个参数讲清楚。
4.1 Hello, ONNX:导出 ResNet50
python
import torch
import torchvision

# 1) 准备模型并切到 eval 模式(极其重要,原因见踩坑章节)
model = torchvision.models.resnet50(weights=torchvision.models.ResNet50_Weights.DEFAULT)
model.eval()

# 2) 构造一个「样例输入」。导出器需要靠它跑一遍、记录计算图。
#    shape 要和真实推理一致:ResNet 输入是 NCHW
dummy_input = torch.randn(1, 3, 224, 224)

# 3) 导出
torch.onnx.export(
    model,                      # 要导出的 nn.Module
    dummy_input,                # 样例输入(可以是 tuple 表示多输入)
    "resnet50.onnx",            # 输出文件路径
    export_params=True,         # 是否把训练好的权重一起存进去(一般 True)
    opset_version=17,           # 算子集版本,17 是兼容性安全牌
    do_constant_folding=True,   # 常量折叠:把能预先算死的节点提前算好
    input_names=["input"],      # 给输入起名字,部署时按名字喂数据
    output_names=["output"],    # 给输出起名字
    dynamic_axes=None,          # 先固定 shape,第 6 节再讲动态
)

print("导出完成")
跑完你会得到一个约 100MB 的 resnet50.onnx。把它拖进 Netron,能看到一条完整的 Conv → BN → ReLU → ... → Gemm → Softmax 主干。
4.2 导出参数逐个拆解
torch.onnx.export 的本质是:用 TorchScript 把模型 trace 一遍,记录每个 ATen 算子,再翻译成对应的 ONNX 算子。理解了这个机制,参数就好懂了:
export_params:是否把权重内联进文件。要部署就必须True;设成False只导出图结构(几乎用不到)。opset_version:翻译成哪一版标准算子库。优先和目标推理引擎支持的最高稳定版对齐,保守用 17。do_constant_folding:常量折叠。例如reshape用的形状常量、只依赖权重的子图,能在导出时直接算成常数,减少运行时节点。一般开。input_names / output_names:张量的语义名字。强烈建议显式指定有意义的名字 ,否则部署端只能拿到onnx::Gemm_0这种天书。dynamic_axes:声明哪些维度是可变的,第 6 节细讲。training:默认TrainingMode.EVAL。除非你要导出用于再训练的图,否则别动。
🔎 trace 的盲区 :老导出器默认走 tracing (用样例实际跑一遍录图)。这意味着任何「数据依赖的控制流」------比如
if x.sum() > 0、根据张量值决定循环次数------都只会录下样例走的那一条分支。这是后面一大类坑的根源。
4.3 多输入与多输出
真实模型很少只有一个输入。比如一个多模态模型要同时吃图像和文本,导出时把样例输入组织成 tuple、并给每个输入命名即可:
python
class MultiIOModel(torch.nn.Module):
    def forward(self, image, token_ids, weight):
        feat = self.backbone(image)              # (N, 128)
        emb = self.embed(token_ids).mean(1)      # (N, 128)
        fused = torch.cat([feat, emb], dim=1)
        out_a = self.head_a(fused)
        out_b = (fused * weight).sum(1, keepdim=True)
        return out_a, out_b                      # 多个输出:返回 tuple

model = MultiIOModel().eval()

dummy = (
    torch.randn(1, 3, 224, 224),   # image
    torch.ones(1, 16, dtype=torch.long),  # token_ids
    torch.randn(1, 256),           # weight
)

torch.onnx.export(
    model,
    dummy,
    "multi.onnx",
    opset_version=17,
    input_names=["image", "token_ids", "weight"],
    output_names=["out_a", "out_b"],
)
规则很简单:模型 forward 返回多个值,ONNX 就有多个 output;入参有几个,就按顺序提供几个样例。
4.4 输出是 dict 怎么办:包装器模式
HuggingFace 模型、检测模型常常返回一个 dict 或带属性的对象(如 outputs.logits、outputs.last_hidden_state)。ONNX 的图输出必须是「张量」,不能直接吐 dict。标准解法是写一个薄薄的包装器,把你要的张量显式 return 出来:
python
import torch.nn as nn

class DictOutputWrapper(nn.Module):
    """把 HF 风格的 dict/对象输出,拍平成若干张量输出。"""
    def __init__(self, hf_model):
        super().__init__()
        self.model = hf_model

    def forward(self, input_ids, attention_mask, token_type_ids):
        outputs = self.model(
            input_ids=input_ids,
            attention_mask=attention_mask,
            token_type_ids=token_type_ids,
        )
        return outputs.logits                      # 只导出你部署真正要用的
        # 需要多个就 return outputs.logits, outputs.last_hidden_state
这个小技巧在处理 Transformer / 检测 / 分割模型时几乎必用,建议记牢。
5. 验证模型:结构校验与数值对齐
「没报错」不等于「转对了」。 导出过程可能悄悄丢算子、替换算子、改变数值行为。专业的做法是做两层验证。
5.1 第一层:结构合法性校验
python
import onnx

onnx_model = onnx.load("resnet50.onnx")

# 检查 IR 是否满足 ONNX 规范、节点引用是否完整、版本是否合法
onnx.checker.check_model(onnx_model)
print("✅ 结构校验通过")

# 打印可读的图(调试时很有用)
graph_str = onnx.helper.printable_graph(onnx_model.graph)
print(graph_str[:1500])
check_model 能抓住「节点引用了不存在的张量」「opset 缺失」「属性类型错误」这类硬伤。
5.2 补上 shape 推断
有些模型导出后中间张量的 shape 是缺失的,做后续优化或排查时不方便,可以用官方 shape 推断补全:
python
from onnx import shape_inference

inferred = shape_inference.infer_shapes(onnx.load("resnet50.onnx"))
onnx.save(inferred, "resnet50_shapes.onnx")
print("✅ shape 推断完成,中间张量维度已填充到 value_info")
5.3 第二层:数值对齐(最关键的一步)
结构合法只代表「图没坏」,不代表「算得对」。我们用 ONNX Runtime 跑同一批输入,和 PyTorch 的输出逐元素比对:
python
import numpy as np
import onnxruntime as ort
import torch, torchvision

torch.manual_seed(0)

model = torchvision.models.resnet50(weights=torchvision.models.ResNet50_Weights.DEFAULT).eval()
dummy = torch.randn(4, 3, 224, 224)

# PyTorch 输出
with torch.no_grad():
    torch_out = model(dummy)

# ONNX Runtime 输出
sess = ort.InferenceSession("resnet50.onnx", providers=["CPUExecutionProvider"])
ort_inputs = {sess.get_inputs()[0].name: dummy.numpy()}
ort_out = sess.run(None, ort_inputs)[0]

# 逐元素比对
#   rtol / atol:允许的相对 / 绝对误差。FP32 下一般用 1e-3 / 1e-5
np.testing.assert_allclose(
    torch_out.numpy(), ort_out,
    rtol=1e-03, atol=1e-05,
)
print("✅ PyTorch 与 ONNX Runtime 输出数值一致")
print("最大绝对误差:", np.abs(torch_out.numpy() - ort_out).max())
关于误差阈值怎么选:
- FP32 对 FP32:
rtol=1e-3, atol=1e-5通常能过; - FP16 / 量化模型:误差会明显变大,要放宽到
1e-2 ~ 1e-1量级,并结合任务级指标(分类准确率、mAP)综合判断,而不是只看逐元素误差; - 如果最大误差出现尖峰(个别位置差几个数量级),往往不是精度问题,而是某个算子被错误翻译(比如 axis 搞错、padding 方式不对),要重点排查。
我把这一步称作**「转换的单元测试」**。在 CI 里固化下来,每次改模型都自动跑一遍,能避免「上线后才发现推理结果不对」的事故。
6. 动态维度:让 Batch 和序列长度可变
默认情况下,导出的模型 shape 是写死的 ------你用 (1,3,224,224) 导出,之后喂 batch=8 就会报错。生产中我们几乎总是需要动态 batch;NLP 场景还需要动态序列长度。用 dynamic_axes 声明即可。
6.1 视觉模型:只动态 batch
python
torch.onnx.export(
    model,
    torch.randn(1, 3, 224, 224),
    "resnet50_dyn.onnx",
    opset_version=17,
    input_names=["input"],
    output_names=["output"],
    dynamic_axes={
        "input":  {0: "batch_size"},   # 第 0 维起名为 batch_size,可变
        "output": {0: "batch_size"},
    },
)
key 是张量名(要和 input_names/output_names 对应),value 里指明「哪个维度 → 用什么符号名表示」。现在 batch=1、8、32 都能跑。
6.2 NLP 模型:batch 和序列长度都动态(BERT 实战)
BERT 类模型的输入是 (batch, seq_len),两个维度都要动态。结合第 4.4 的包装器,给一个完整可跑的例子:
python
import torch
import torch.nn as nn
from transformers import AutoModelForMaskedLM   # 如需可 pip install transformers

# ---- 1. 用包装器把 HF 的对象输出拍平成 logits ----
class BertOnnxWrapper(nn.Module):
    def __init__(self, name):
        super().__init__()
        self.model = AutoModelForMaskedLM.from_pretrained(name)

    def forward(self, input_ids, attention_mask, token_type_ids):
        out = self.model(
            input_ids=input_ids,
            attention_mask=attention_mask,
            token_type_ids=token_type_ids,
        )
        return out.logits    # (batch, seq_len, vocab_size)

model = BertOnnxWrapper("bert-base-chinese").eval()

# ---- 2. 样例输入 ----
B, L = 2, 16
input_ids       = torch.ones(B, L, dtype=torch.long)
attention_mask  = torch.ones(B, L, dtype=torch.long)
token_type_ids  = torch.zeros(B, L, dtype=torch.long)

# ---- 3. 导出:batch、seq_len 两维都动态 ----
torch.onnx.export(
    model,
    (input_ids, attention_mask, token_type_ids),
    "bert_dyn.onnx",
    opset_version=17,
    input_names=["input_ids", "attention_mask", "token_type_ids"],
    output_names=["logits"],
    dynamic_axes={
        "input_ids":      {0: "batch", 1: "sequence"},
        "attention_mask": {0: "batch", 1: "sequence"},
        "token_type_ids": {0: "batch", 1: "sequence"},
        "logits":         {0: "batch", 1: "sequence"},
    },
)

# ---- 4. 用不同的 batch 和序列长度验证 ----
import onnxruntime as ort
import numpy as np

sess = ort.InferenceSession("bert_dyn.onnx")

def run(b, l):
    feeds = {
        "input_ids":      np.ones((b, l), dtype=np.int64),
        "attention_mask": np.ones((b, l), dtype=np.int64),
        "token_type_ids": np.zeros((b, l), dtype=np.int64),
    }
    return sess.run(None, feeds)[0]

print(run(1, 8).shape)    # (1, 8, vocab)
print(run(4, 128).shape)  # (4, 128, vocab) ------ 任意 batch / 长度都成立
💡 这类「batch + 序列长度双动态」的导出,在中文文本校对(CSC)、命名实体识别、分类等 BERT 落地场景里是标准操作。我之前做中文拼写检查模型部署时用的就是这套模板。
6.3 动态 shape 的代价
动态维度不是免费的:
- 某些优化做不了或做得保守 :完全静态的 shape 更利于算子融合和内存规划,TensorRT 甚至要求你显式提供
min/opt/max三档 profile; - 数据依赖的输出 shape (如目标检测里 NMS 后保留多少个框)会让图里出现
NonMaxSuppression+Gather这类运行时才知道结果的结构,部分引擎支持不佳,常需要裁剪成「固定 Top-K 个框」。
经验是:该动态就动态(batch/seq),但尽量把真正的数据依赖 shape 改造成定长输出。
7. PyTorch 2.x 的新导出器:TorchDynamo
从 PyTorch 2.x 开始,官方推出了基于 TorchDynamo + onnxscript 的新一代导出器,用来弥补老 TorchScript trace 导出器的短板(控制流支持差、算子覆盖不全、容易静默出错)。
- 老导出器(前面用的):TorchScript tracing,成熟稳定、资料多,但对复杂模型和控制流不友好。
- 新导出器 :直接从 FX 图翻译成 ONNX,用 onnxscript 表达复杂算子,对
torch.compile生态、控制流、现代模型支持更好,是官方未来方向。
从 PyTorch 2.5 起可通过 dynamo=True 启用:
python
import torch, torchvision

model = torchvision.models.resnet50(weights=torchvision.models.ResNet50_Weights.DEFAULT).eval()
dummy = torch.randn(1, 3, 224, 224)

# 新导出器:返回一个 ONNXProgram 对象,再调用 .save()
export_output = torch.onnx.export(
    model,
    dummy,
    dynamo=True,
)
export_output.save("resnet50_dynamo.onnx")
你还可以在导出后做优化 / 查看虚假(fake)模式下的图:
python
export_output = export_output.run_decomposition_table()  # 按需分解大算子
print(export_output.model_proto.graph)                  # 检查生成的图
怎么选?给一个务实建议:
| 场景 | 建议 |
|---|---|
| 模型能被老导出器顺利导出、且数值对齐 | 继续用老导出器,稳 |
| 老导出器报「Unsupported operator」、控制流被截断、复杂现代模型 | 试新导出器(dynamo=True) |
| 追求最广的引擎/端侧兼容性 | 老导出器 + 较低 opset,配合 onnxsim |
| 全新项目、PyTorch 较新版本 | 优先评估新导出器,它是未来 |
两个导出器都请务必跑第 5 节的数值对齐。新导出器在个别算子的分解(decomposition)策略上可能与老导出器有细微差别。
8. 实战二:TensorFlow / Keras → ONNX
TensorFlow 系模型用微软开源的 tf2onnx 转换。它同时支持 SavedModel、Keras、Checkpoint、以及从计算图直接转。
8.1 最常用:命令行转 SavedModel
bash
# 把 TensorFlow SavedModel 目录转成 ONNX
python -m tf2onnx.convert \
    --saved-model ./saved_model_dir \
    --output model.onnx \
    --opset 17
需要动态 batch 时:
bash
python -m tf2onnx.convert \
    --saved-model ./saved_model_dir \
    --output model.onnx \
    --opset 17 \
    --inputs input:0[-1,224,224,3] \
    --outputs predictions/Softmax:0
#       [-1,...] 里的 -1 表示该维动态(batch)
8.2 Python API 转 Keras 模型
python
import tensorflow as tf
import tf2onnx

# 一个 Keras 应用模型(TF 的数据格式是 NHWC)
model = tf.keras.applications.ResNet50(weights="imagenet")

# 声明输入签名:batch 维用 None 表示动态
input_signature = [
    tf.TensorSpec((None, 224, 224, 3), tf.float32, name="input")
]

model_proto, external_tensor_storage = tf2onnx.convert.from_keras(
    model,
    input_signature=input_signature,
    opset=17,
    output_path="resnet50_tf.onnx",
)
print("✅ Keras → ONNX 完成")
8.3 NHWC ↔ NCHW:tf2onnx 帮你做了什么
TensorFlow 卷积默认用 NHWC ,而 ONNX 标准卷积用 NCHW 。tf2onnx 会在图中自动插入 Transpose 节点完成布局转换,并尽量把它们优化掉。
你需要知道的是:
- 转换后对外暴露的输入默认仍可保持 NHWC (引擎内部转),也可以加
--nchw让转换器直接产出 NCHW 输入、减少运行时 transpose; - 如果在 GPU 上用 TensorRT,NCHW 是更原生、更快的布局,建议导出 NCHW;
- 排查「结果对但速度慢」时,去 Netron 里看看是否残留了大量
Transpose节点------它们是布局来回切换的信号。
转换完成后,同样用第 5 节的方法做数值对齐(拿 TF 的 model(x) 和 ONNX Runtime 输出比对),不要省略。
9. 实战三:YOLO 目标检测的完整导出与后处理
目标检测是部署中最常见、也最容易踩坑的一类模型,值得单独讲一节。以 YOLOv8 为例,走一遍「导出 → 验证 → 后处理」的全流程。
9.1 导出
Ultralytics 的 YOLO 自带导出接口,内部已经处理好了很多细节:
python
from ultralytics import YOLO

model = YOLO("yolov8n.pt")

# 导出为 ONNX:动态 batch、指定 opset、imgsz
model.export(
    format="onnx",
    opset=17,
    imgsz=640,          # 输入尺寸
    dynamic=True,       # batch 动态
    simplify=True,      # 内置 onnxsim 化简
    half=False,         # 是否导出 FP16
)
# 生成 yolov8n.onnx
如果你是自己写的检测模型,参照第 4 节的通用流程即可,但务必注意输出的形状语义------这是后处理正确与否的关键。
9.2 输出张量的两种约定:RAW 与 NMS 内嵌
导出时有个关键选择,直接决定你要写多少后处理代码:
| 模式 | 输出内容 | 后处理责任 | 适用 |
|---|---|---|---|
| raw(含 NMS 前的原始输出) | 形状如 (batch, 4+num_classes, num_anchors) 的原始框预测 |
你要自己在 Python/C++ 里做解码 + NMS | 灵活,但后处理移植麻烦 |
| end2end / 含 NMS | 已筛选的 (batch, num_boxes, 6) = [x1,y1,x2,y2,conf,cls] |
拿到就是最终框 | 部署省事,但部分引擎对 NMS 算子支持不一 |
Ultralytics 的 nms=True 会导出含 NMS 的版本(注意这会引入 NonMaxSuppression 算子,是否可用取决于目标引擎)。
9.3 动手验证 + 手写后处理
python
import cv2
import numpy as np
import onnxruntime as ort

session = ort.InferenceSession("yolov8n.onnx", providers=["CPUExecutionProvider"])
input_name  = session.get_inputs()[0].name
output_name = session.get_outputs()[0].name
print("model input :", session.get_inputs()[0].shape)
print("model output:", session.get_outputs()[0].shape)


def letterbox(img, new_shape=640, color=(114, 114, 114)):
    """保持长宽比缩放到 new_shape,多余部分用灰边填充。检测预处理的标准做法。"""
    h, w = img.shape[:2]
    r = min(new_shape / h, new_shape / w)
    nh, nw = int(round(h * r)), int(round(w * r))
    resized = cv2.resize(img, (nw, nh), interpolation=cv2.INTER_LINEAR)
    canvas = np.full((new_shape, new_shape, 3), color, dtype=np.uint8)
    top, left = (new_shape - nh) // 2, (new_shape - nw) // 2
    canvas[top:top + nh, left:left + nw] = resized
    return canvas, r, (left, top)


img = cv2.imread("test.jpg")
orig_h, orig_w = img.shape[:2]

# 预处理:BGR→RGB、HWC→CHW、归一化、加 batch 维
blob, ratio, (dw, dh) = letterbox(img, 640)
blob = blob[:, :, ::-1].transpose(2, 0, 1)               # BGR→RGB, HWC→CHW
blob = np.ascontiguousarray(blob, dtype=np.float32) / 255.0
blob = blob[None, ...]                                   # (1, 3, 640, 640)

# 推理
outputs = session.run([output_name], {input_name: blob})[0]

# YOLOv8 raw 输出约定:(batch, 4+nc, 8400) ------ 需要转置后处理
preds = np.squeeze(outputs).T          # (8400, 4+nc)
boxes_xywh, scores = preds[:, :4], preds[:, 4:]
class_ids = scores.argmax(1)
confidences = scores.max(1)

# 阈值过滤
mask = confidences > 0.25
boxes_xywh, confidences, class_ids = boxes_xywh[mask], confidences[mask], class_ids[mask]

# xywh(center) → xyxy,并映射回原图坐标
x_c, y_c, w_, h_ = boxes_xywh.T
x1 = (x_c - w_ / 2 - dw) / ratio
y1 = (y_c - h_ / 2 - dh) / ratio
x2 = (x_c + w_ / 2 - dw) / ratio
y2 = (y_c + h_ / 2 - dh) / ratio
boxes = np.stack([x1, y1, x2, y2], axis=1)

# NMS
indices = cv2.dnn.NMSBoxes(
    boxes.tolist(), confidences.tolist(), 0.25, 0.45
)

for i in np.array(indices).flatten():
    x1, y1, x2, y2 = boxes[i].astype(int)
    cv2.rectangle(img, (x1, y1), (x2, y2), (0, 255, 0), 2)
cv2.imwrite("result.jpg", img)
print(f"检出 {len(indices)} 个目标")
划重点:检测模型的后处理(letterbox 预处理、坐标反算、NMS)必须和训练时完全一致。 部署端最常见的 bug 就是「框能画出来但位置整体偏移」------十有八九是 letterbox 的 padding 参数没在坐标反算时还原回去。这段代码里的
dw/dh/ratio就是为此存在的,复制时别漏掉。
9.4 检测模型转换的三个额外提醒
- 输入尺寸 :检测模型对
imgsz敏感,导出时用什么尺寸,部署时预处理就得用同样的尺寸; - anchor-free vs anchor-based:解码逻辑完全不同,务必对照你所用模型版本的文档;
- 自定义算子:部分 YOLO 变体(如某些带 DCNv2、可变形卷积的版本)需要自定义算子支持,先在 Netron 里确认全都是标准算子。
10. 用 ONNX Runtime 推理与测速
ONNX Runtime(简称 ORT)是微软官方的跨平台推理引擎,也是验证和大多数 CPU 部署的首选。它通过 Execution Provider(EP) 抽象不同硬件:同一张图,可调度到 CPU、CUDA、TensorRT、OpenVINO、Core ML 等不同后端。
10.1 基础推理
python
import onnxruntime as ort
import numpy as np

sess = ort.InferenceSession(
    "resnet50.onnx",
    providers=["CPUExecutionProvider"],
)

# 查看输入输出规格
for i in sess.get_inputs():
    print("输入:", i.name, i.shape, i.type)
for o in sess.get_outputs():
    print("输出:", o.name, o.shape, o.type)

# 按名字喂 numpy 数组(注意 dtype 要和模型一致)
x = np.random.randn(8, 3, 224, 224).astype(np.float32)
y = sess.run(
    output_names=None,                        # None = 取全部输出
    input_feed={"input": x},
)
print(y[0].shape)
10.2 打开全部图优化 + 指定硬件后端
python
options = ort.SessionOptions()
# 图优化等级:基础 / 扩展 / 全部。生产直接用 ALL(算子融合等)
options.graph_optimization_level = ort.GraphOptimizationLevel.ORT_ENABLE_ALL
options.intra_op_num_threads = 0     # 0 = ORT 自行按核数调度
options.inter_op_num_threads = 0

session = ort.InferenceSession(
    "resnet50.onnx",
    sess_options=options,
    providers=[
        "CUDAExecutionProvider",          # 优先 GPU
        "CPUExecutionProvider",           # GPU 不支持的算子自动回退 CPU
    ],
)

# 确认某些算子到底跑在哪个 EP 上(排查「为什么没用上 GPU」)
print(session.get_provider_options())
排查 GPU 没生效有个绝招:设置环境变量
ORT_MIN_LOG_LEVEL=1或直接看 session 创建日志,里面会逐个节点打印分配给了哪个 EP。当图里存在 CUDA EP 不支持的算子时,ORT 会把该子图切回 CPU------这就是「明明装了 GPU 版却很慢」的常见原因。
10.3 线程数、并发与内存:服务端调优三件套
单条推理调好后,服务端吞吐还取决于三个旋钮:
python
options = ort.SessionOptions()

# ① intra-op:单个算子内部可用的线程数(矩阵乘、卷积的并行度)
options.intra_op_num_threads = 4
# ② inter-op:算子之间的并行执行线程数(针对图中有并行分支的情况)
options.inter_op_num_threads = 2
# ③ 执行模式:SEQUENTIAL(串行,低延迟稳定)/ PARALLEL(并行,吞吐优先)
options.execution_mode = ort.ExecutionMode.ORT_SEQUENTIAL

session = ort.InferenceSession("m.onnx", sess_options=options)
调优经验法则:
| 场景 | 建议 |
|---|---|
| 在线、低延迟优先(batch=1) | intra=物理核数,inter=1,串行模式 |
| 离线、吞吐优先(大 batch) | intra=物理核数,inter=物理核数,并行模式 |
| 多实例部署 | 每个实例 intra 设小一点,靠多进程/多实例吃满 CPU,避免线程争抢 |
⚠️ 多线程有个隐蔽的坑 :在已经有并发压力的服务里(比如 8 个进程都用
intra=32),总线程数会爆炸式超订,反而因为上下文切换变慢。正确姿势是「进程数 × 每进程线程数 ≈ 物理核数」。
内存方面,开启内存复用和 arena 能显著减少分配抖动:
python
options.enable_cpu_mem_arena = True       # CPU 内存池(默认开,别关)
options.enable_mem_pattern = True         # 内存复用模式(默认开)
10.4 IO Binding:GPU 场景的零拷贝利器
在 GPU 场景里,如果每次推理都经历「CPU numpy → 拷贝到 GPU → 计算 → 拷回 CPU」,拷贝开销会吃掉一大半收益 ,尤其小模型小 batch。ORT 的 IO Binding 允许你指定输入的 GPU 内存地址,省去来回拷贝:
python
import onnxruntime as ort
import numpy as np

sess = ort.InferenceSession("m.onnx", providers=["CUDAExecutionProvider"])
io = sess.io_binding()

# 把输入预先放到 GPU 上(这里用 numpy 演示;真实场景用 CUDA 内存指针)
x = np.random.randn(1, 3, 224, 224).astype(np.float32)
io.bind_cpu_input("input", x)          # 输入从 CPU 绑定
io.bind_output("output", "cuda")       # 输出直接留在 GPU,避免拷回

sess.run_with_iobinding(io)
y = io.get_outputs()[0].numpy()对于输入本身就是 GPU 张量 (比如前后处理也在 GPU 上)的流水线,可以用 bind_input(name, device_type, device_id, element_type, shape, buffer_ptr) 直接绑定显存指针,实现真正的零拷贝。
10.5 写一个靠谱的性能 benchmark
测速一定要先预热、再计时、并做统计,否则结论不可信:
python
import time, numpy as np, onnxruntime as ort

sess = ort.InferenceSession(
    "resnet50.onnx",
    providers=["CPUExecutionProvider"],
)
x = np.random.randn(32, 3, 224, 224).astype(np.float32)

# 1) 预热:触发图优化、内存分配、kernel 选择
for _ in range(20):
    sess.run(None, {"input": x})

# 2) 正式计时
latencies = []
for _ in range(200):
    t0 = time.perf_counter()
    sess.run(None, {"input": x})
    latencies.append((time.perf_counter() - t0) * 1000)  # ms

latencies = np.array(latencies)
print(f"平均延迟 : {latencies.mean():.2f} ms")
print(f"P50     : {np.percentile(latencies, 50):.2f} ms")
print(f"P99     : {np.percentile(latencies, 99):.2f} ms")
print(f"吞吐量   : {32 * 1000 / latencies.mean():.1f} samples/s")
报告性能时我习惯给出 P50/P99 而不只是平均值------在线服务对长尾延迟极其敏感,平均值会骗人。
10.6 定位瓶颈:Profiling 到底慢在哪一层
测速只能告诉你「多快」,profiling 才能告诉你「为什么慢」 。ORT 内置了 profiling,能输出每个节点的耗时,导出成 Chrome Trace JSON 用 chrome://tracing 或 Perfetto 打开可视化:
python
import onnxruntime as ort

options = ort.SessionOptions()
options.enable_profiling = True          # 打开 profiling
options.profile_file_prefix = "ort_prof"

sess = ort.InferenceSession("m.onnx", sess_options=options)

import numpy as np
x = np.random.randn(1, 3, 224, 224).astype(np.float32)
for _ in range(10):
    sess.run(None, {"input": x})

profile_file = sess.end_profiling()      # 生成 json 文件路径
print("profile 文件:", profile_file)
# 用 chrome://tracing 打开,即可看到每个 op 的耗时条形图
怎么读这个火焰图:
- 看总耗时被谁吃掉:持续时间最长的那个 op 就是优化重点;
- 找
Cast/Transpose/Reshape:这类「不该慢」的算子如果占比高,说明图没优化干净,回去跑 onnxsim; - 找 CPU/GPU 交界 :如果看到大量
Memcpy,说明数据在 CPU 和 GPU 之间来回搬运------该上 IO Binding 了; - 看是否有「不该在 CPU 上跑的算子」:某个 op 单独拖了一条 CPU 长条,就是 EP 回退的信号。
配合第 10.2 节的 EP 分配日志,「慢」这件事就从玄学变成了可以定位的工程问题。
11. 十五大踩坑实录与解决方案
这一节是本文的「干货中的干货」,每一条都来自真实项目。
❌ 坑 1:忘记切 model.eval()
现象:导出后推理结果每次都略有不同,或训练/推理输出对不上。
原因 :训练模式下 BatchNorm 会用当前 batch 的均值方差 、Dropout 会随机失活。导出时若处于 train 模式,这些行为被固化,推理自然不稳定。
解法 :导出和验证前一律 model.eval()。注意不仅是顶层模型,嵌套子模块也会跟着切(eval() 是递归的),但如果你手动构造了游离的子模块,要单独确认。
python
model.eval()
with torch.no_grad():      # 导出本身不需要梯度,也更省显存
    torch.onnx.export(model, ...)
❌ 坑 2:Unsupported operator / 算子不支持
现象 :导出报 RuntimeError: Exporting the operator XXX to ONNX opset version Y is not supported,或某个你自己写的 torch.autograd.Function 导不出来。
原因:该 ATen 算子没有对应的 ONNX 符号函数(symbolic),或是自定义/冷门算子。
解法(按优先级):
- 提高 opset:新版可能已支持;
- 用等价标准算子改写:把自定义逻辑用纯 PyTorch 基础算子重写(最推荐,一劳永逸);
- 换 TorchDynamo 新导出器(第 7 节),算子覆盖更广;
- 注册自定义 symbolic(第 15 节)。
❌ 坑 3:Opset / IR 版本不匹配
现象 :Load model from a version of IR which is not supported,或老引擎加载新模型报不认识某算子。
解法 :导出端 opset 不要高于目标引擎支持的最高版本。部署到端侧/NPU 前查清楚引擎支持矩阵;拿不准就降到 13 或 17。
❌ 坑 4:该动态的维度写死了
现象:导出用 batch=1,上线喂 batch=16 直接 shape 报错。
解法 :按第 6 节加 dynamic_axes。NLP 别忘了序列长度那维也要动态。
❌ 坑 5:权重被当成了模型输入
现象:用某些引擎加载,输入列表里出现一堆权重名,或者要你喂几百个输入。
原因 :老规范允许 initializer 同时列在 graph.input 里。
解法:用工具清理,或重新用规范导出:
python
# onnxruntime 提供的工具:把已被 initializer 覆盖的输入从 inputs 中剔除
from onnxruntime.tools.optimizer_model_std import ...  # 不同版本路径有差异
# 更通用的手写方式:
import onnx
m = onnx.load("m.onnx")
init_names = {i.name for i in m.graph.initializer}
m.graph.input[:] = [v for v in m.graph.input if v.name not in init_names]
onnx.save(m, "m_fixed.onnx")
❌ 坑 6:>2GB 的大模型导出/加载失败
现象:大模型导出时报 protobuf 超限,或生成的文件打不开。
原因 :Protobuf 单条消息有 2GB 硬上限 。模型权重大于 2GB 时,必须把权重存为外部数据(external data),分成多个文件。
解法:
python
# PyTorch 导出时直接用外部数据格式(大模型必备)
torch.onnx.export(
    model, dummy, "large/model.onnx",
    opset_version=17,
    use_external_data_format=True,        # 权重拆到外部文件
)

# 或对已有的 ONNX ModelProto 另存为外部数据
onnx.save_model(
    m,
    "large/model.onnx",
    save_as_external_data=True,
    all_tensors_to_one_file=True,
    location="model.onnx.data",           # 权重文件
)
部署时要把
model.onnx和model.onnx.data一起带上、保持相对路径,否则加载不到权重。
❌ 坑 7:数据依赖的控制流 / 动态输出
现象 :含 if 张量条件、动态 TopK/NMS 的模型,导出后行为不对,或引擎不支持。
解法:
- 控制流尽量改成不依赖具体数据(或用 TorchDynamo,它能导出
If/Loop); - NMS 输出裁剪为固定 Top-K;
- 复杂检测模型考虑直接用各框架官方的 ONNX 导出脚本(如 YOLO 系列自带 export)。
❌ 坑 8:NCHW / NHWC 与 axis 错位
现象:数值能跑但结果明显不对,典型如 Softmax/Reduce 选错了轴。
解法:明确每个算子作用的维度;TF 转来的模型重点检查 transpose;在 Netron 里逐节点核对 shape。
❌ 坑 9:dtype 不匹配
现象 :ORT 报 Unexpected input data type,或 int64/int32、float32/float64 对不上。
解法 :喂数据前严格对齐 session.get_inputs() 声明的 dtype。BERT 的 id 类输入一般是 int64;PyTorch 默认浮点是 FP32,别不小心喂成 FP64。
❌ 坑 10:数值误差尖峰 / 量化后精度暴跌
现象:整体误差很小,但个别位置误差巨大;或 INT8 后准确率掉了好几个点。
解法:
- 尖峰误差 → 排查具体算子语义(padding、axis、归一化 epsilon),不是单纯调阈值能解决;
- 量化掉点 → 从动态量化换成静态量化 + 校准 ,敏感层(如首尾层、Softmax)保留 FP16/FP32(混合精度量化),必要时用量化感知训练 QAT。
❌ 坑 11:BatchNorm / LayerNorm 的 epsilon 不一致
现象:BN 层的模型转换后数值有系统性偏差,误差不大但稳定存在。
原因 :PyTorch 的 BatchNorm.eps 默认是 1e-5,而某些框架/引擎的默认值不同(如 TF 是 1e-3)。转换时如果 epsilon 没有正确带过来,归一化结果就会有偏差。
解法 :在 Netron 里点开 BN 节点,确认 epsilon 属性和训练时一致;自定义模型导出后用第 5 节的数值对齐把关;对 LayerNorm 同理(LayerNormalization 算子需要 opset ≥ 17)。
❌ 坑 12:Constant Folding 反而「帮倒忙」
现象 :开了 do_constant_folding=True 后,模型变大或报错。
原因:常量折叠把只依赖权重的子图算成常量内联,遇到某些特殊结构时可能产生巨大常量张量;而在含动态形状的复杂子图里,过早折叠可能破坏原本的动态性。
解法 :一般不关;若出现异常,试着关掉折叠重新导出对比图结构。原则是「默认开,出问题再排查」。
❌ 坑 13:导出时的 verbose 掩盖了真正的警告
现象:导出"成功"了,但结果不对,仔细看日志里其实有 warning 被刷屏淹没。
解法 :导出后不要只看有没有报错,一定要把 warning 逐条读一遍。常见的 warning 包括「某张量没有 shape 信息」「某算子被 fallback 到 Python」。可以在导出时把 stderr 单独重定向出来看:
bash
python export.py 2> export_warnings.log❌ 坑 14:torch.jit.trace 的假成功
现象 :手动用 torch.jit.trace 得到的图,导入 ONNX 后行为诡异。
原因 :trace 只记录样例走过的分支,任何数据依赖的控制流都会被固化。如果你的 forward 里有 if x.shape[0] > 1 这类逻辑,trace 只会留下样例那条路。
解法 :优先用 torch.onnx.export(它会做额外处理);有控制流就考虑 TorchDynamo(dynamo=True);实在要 trace,就把分支逻辑挪到模型外面。
❌ 坑 15:遗忘 attention_mask / padding 的处理
现象:NLP 模型(尤其变长 batch)转换后,短句子的结果和单条推理不一致。
原因 :变长序列 padding 后,注意力要正确 mask 掉 padding 位置。如果包装器/导出时漏传或错传 attention_mask,padding token 会污染注意力。
解法 :导出模板里 attention_mask 必须作为显式输入(第 6.2 节已示范),且推理端喂真实 mask。变长 batch 场景务必逐条对比,别只测单条。
12. 模型瘦身与加速:化简与 INT8 量化
12.1 用 onnxsim 化简冗余图
前端导出的图常带大量「胶水」算子:多余的 Cast、Shape→Gather→Unsqueeze、嵌套 Reshape、训练专用节点。onnxsim 通过「实际跑一遍 + 常量折叠」把它们大幅精简:
bash
# 命令行
python -m onnxsim input.onnx output_sim.onnx

# 注意:带动态维度时建议传 --overwrite-input-shape 指定一个具体 shape 来折叠
python -m onnxsim bert_dyn.onnx bert_sim.onnx \
    --overwrite-input-shape 1,16 1,16 1,16 \
    --dynamic-input-shape
python
# Python API
from onnxsim import simplify
import onnx

model = onnx.load("resnet50.onnx")
model_sim, check = simplify(model)
assert check, "化简失败"
onnx.save(model_sim, "resnet50_sim.onnx")化简后通常:节点数变少、图更干净、某些引擎兼容性更好、速度略有提升。建议作为量化和上 TensorRT 之前的标准预处理,但化简后要重新做数值对齐。
12.2 量化:FP32 → INT8
量化把权重/激活从 32 位浮点压到 8 位整数,模型体积约缩到 1/4,推理在支持 INT8 的硬件上可提速 2~4 倍。ONNX Runtime 提供了完整的量化工具链。
① 动态量化(最简单,适合权重主导的小模型 / Linear 多的模型)
python
from onnxruntime.quantization import quantize_dynamic, QuantType

quantize_dynamic(
    model_input="resnet50_sim.onnx",
    model_output="resnet50_int8.onnx",
    weight_type=QuantType.QInt8,   # 权重量化成 INT8
)
动态量化在运行时根据观察到的数据范围即时量化激活,无需校准集,开箱即用。对全连接/MatMul 占比高的模型(BERT 等)效果不错。
② 静态量化(效果更好,需要校准数据集)
静态量化提前用一批有代表性的数据统计激活范围,运行时不再动态计算,速度更快、精度通常更可控,是 CNN 上线的主力:
python
from onnxruntime.quantization import (
    quantize_static, CalibrationDataReader, QuantType, QuantFormat,
)
import numpy as np
import onnxruntime as ort

class MyCalibrationReader(CalibrationDataReader):
    def __init__(self, samples, input_name):
        self.input_name = input_name
        # samples: 若干真实预处理后的 numpy 输入
        self.data = iter([{input_name: s} for s in samples])

    def get_next(self):
        return next(self.data, None)

sess = ort.InferenceSession("resnet50_sim.onnx", providers=["CPUExecutionProvider"])
input_name = sess.get_inputs()[0].name

# 用真实业务数据做校准(几十~几百条有代表性的样本)
calib_samples = [np.random.randn(1, 3, 224, 224).astype(np.float32) for _ in range(100)]
reader = MyCalibrationReader(calib_samples, input_name)

quantize_static(
    model_input="resnet50_sim.onnx",
    model_output="resnet50_static_int8.onnx",
    calibration_data_reader=reader,
    quant_format=QuantFormat.QDQ,          # QDQ:插入 QuantizeLinear/DequantizeLinear,兼容性/精度更好
    weight_type=QuantType.QInt8,
    activation_type=QuantType.QUInt8,
)
QOperator vs QDQ 怎么选?
- QDQ(QuantizeLinear/DequantizeLinear) :显式标出量化点,图更直观,TensorRT 等硬件后端识别友好,现代流程首选;
- QOperator :直接使用量化版本算子(如
ConvInteger),较老的方案。
③ 量化掉点了怎么办(进阶手段)
- 混合精度 :对敏感层(通常是第一层、最后一层、注意力/Softmax 附近)关闭量化、保留高精度;可用
quantize_static(..., op_types_to_quantize=...)或节点排除列表精细控制; - 更好的校准方法 :默认用最小/最大(MinMax),可换成基于熵的 Percentile / Entropy 校准,寻找更优截断阈值;
- 量化感知训练(QAT):在训练时模拟量化误差,精度最稳,是掉点严重时的终极方案。ORT/各自训练框架支持伪量化节点训练后再导出。
量化后务必回到第 5.3 节:不仅看数值误差,更要看真实任务指标(分类准确率、召回、mAP)是否在可接受范围。
13. 大模型(LLM / Transformer)的 ONNX 导出
前面讲的 BERT 还属于「一次前向、静态序列」的范畴。到了真正的 LLM,故事完全不同------核心挑战是 KV Cache 与自回归解码。这一节是很多教程跳过、但生产中最关键的部分。
13.1 为什么 LLM 的导出是另一套玩法
LLM 推理是自回归 的:生成第 t t t 个 token,要用到前 t − 1 t-1 t−1 个 token 的注意力结果。如果每步都重算全部前缀,复杂度是 O ( n 2 ) O(n^2) O(n2) 且随生成长度爆炸。KV Cache 的作用就是把历史 token 的 Key/Value 缓存下来,每步只算新 token 的 Q,与缓存的 K/V 做注意力------单步复杂度降到 O ( n ) O(n) O(n)。
这意味着导出时模型必须有两组输入:
增量输入: input_ids (batch, 1)           ← 每步只喂 1 个新 token
          attention_mask (batch, seq)
          position_ids (batch, 1)         ← 关键!要告诉模型当前是新序列还是缓存
缓存输入: past_key_values.0.key (batch, num_heads, past_len, head_dim)
          past_key_values.0.value (...)
          ... (每一层都有一组)
缓存输出: present.0.key / present.0.value ...  ← 更新后的缓存,要喂回下一步
核心闭环 :past_*(入)→ 模型 → present_*(出)→ 下一轮把 present_* 作为 past_* 喂回去。
13.2 HuggingFace 官方的 LLM 导出方案
HuggingFace 的 optimum 库对主流 LLM(LLaMA、Qwen、OPT、GPT 系)封装好了 ONNX 导出,是首选方案:
bash
# 安装
pip install optimum[onnxruntime]

# 导出 LLaMA 风格模型为 ONNX(自动处理 KV Cache、动态轴)
optimum-cli export onnx \
    --model meta-llama/Llama-3.2-1B \
    --task text-generation-with-past \
    --opset 17 \
    llama_onnx/

# --task text-generation-with-past:关键,带 KV Cache
# 会在 llama_onnx/ 下生成 decoder_model_merged.onnx + 若干外部数据文件导出的模型通常是一个合并的 decoder(含 KV Cache 的 present/past 输入输出),而非简单的单文件。
13.3 手动导出的关键:动态轴与 KV Cache 声明
如果你想自己用 torch.onnx.export 导出(例如自定义模型),KV Cache 的动态轴声明是难点。给一个结构示意:
python
import torch
from transformers import AutoModelForCausalLM, AutoConfig

model_id = "gpt2"  # 换成任意 causal LM
model = AutoModelForCausalLM.from_pretrained(model_id).eval()
config = AutoConfig.from_pretrained(model_id)

num_layers  = config.n_layer
num_heads   = config.n_head
head_dim    = config.n_embd // config.n_head

# 构造带 KV Cache 的样例输入
batch, past_len = 1, 8
input_ids      = torch.ones(batch, 1, dtype=torch.long)          # 只喂 1 个新 token
attention_mask = torch.ones(batch, past_len + 1, dtype=torch.long)
position_ids   = torch.arange(past_len, past_len + 1).unsqueeze(0)

# 每家实现的 past 布局不同,以 (batch, num_heads, past_len, head_dim) 为例
past = []
for _ in range(num_layers):
    k = torch.randn(batch, num_heads, past_len, head_dim)
    v = torch.randn(batch, num_heads, past_len, head_dim)
    past.append((k, v))          # HF v4.x 用扁平 tuple:(k0,v0,k1,v1,...)

# 组装输入顺序(以 HF 约定为准:input_ids, past..., attention_mask, position_ids)
inputs = (input_ids, *[t for kv in past for t in kv], attention_mask, position_ids)

dynamic_axes = {
    "input_ids":      {0: "batch", 1: "one"},
    "attention_mask": {0: "batch", 1: "past_plus_one"},
    "position_ids":   {0: "batch", 1: "one"},
    "logits":         {0: "batch", 1: "one"},
}
for i in range(num_layers):
    dynamic_axes[f"past_key_values.{i}.key"]   = {0: "batch", 2: "past"}
    dynamic_axes[f"past_key_values.{i}.value"] = {0: "batch", 2: "past"}
    dynamic_axes[f"present.{i}.key"]           = {0: "batch", 2: "past_plus_one"}
    dynamic_axes[f"present.{i}.value"]         = {0: "batch", 2: "past_plus_one"}

# 注意:LLM 往往 >2GB,必须用外部数据格式!
torch.onnx.export(
    model,
    inputs,
    "llm/model.onnx",
    opset_version=17,
    input_names=["input_ids", *[f"past_key_values.{i}.{n}"
                                for i in range(num_layers) for n in ("key", "value")],
                 "attention_mask", "position_ids"],
    output_names=["logits", *[f"present.{i}.{n}"
                              for i in range(num_layers) for n in ("key", "value")]],
    dynamic_axes=dynamic_axes,
    use_external_data_format=True,     # ★ 大模型必备
)
⚠️ 强烈建议 :除非你在做研究或特殊定制,直接用
optimum-cli或各家官方导出脚本 。手动导出 LLM 的 KV Cache 极容易因为 past 布局差异(HF 不同版本从past_key_values的嵌套 tuple 到扁平 tuple 改过好几次)而出错。手动导出更适合理解原理。
13.4 生成循环:把 ONNX 当 KV Cache 引擎用
导出后,你要自己写解码循环,把握住「present 喂回 past」这个闭环:
python
import numpy as np
import onnxruntime as ort

sess = ort.InferenceSession("llm/model.onnx", providers=["CPUExecutionProvider"])
print("输入:", [i.name for i in sess.get_inputs()][:4], "...")
print("输出:", [o.name for o in sess.get_outputs()][:4], "...")


class KVCacheRunner:
    def __init__(self, session, num_layers):
        self.sess = session
        self.num_layers = num_layers
        self.past = None

    def step(self, input_ids, attention_mask, position_ids):
        feeds = {
            "input_ids": input_ids,
            "attention_mask": attention_mask,
            "position_ids": position_ids,
        }
        # 第一轮没有缓存时,喂全零的 past;后续轮喂上一轮的 present
        if self.past is not None:
            for i in range(self.num_layers):
                feeds[f"past_key_values.{i}.key"]   = self.past[f"present.{i}.key"]
                feeds[f"past_key_values.{i}.value"] = self.past[f"present.{i}.value"]

        out_names = ["logits"] + [f"present.{i}.{n}"
                                  for i in range(self.num_layers)
                                  for n in ("key", "value")]
        outs = self.sess.run(out_names, feeds)
        self.past = {"logits": outs[0], **{n: o for n, o in zip(out_names[1:], outs[1:])}}
        return outs[0]   # logits: (batch, 1, vocab)


# 伪代码:贪心解码
runner = KVCacheRunner(sess, num_layers=12)
tokens = [tokenizer.bos_token_id]
for t in range(max_new_tokens):
    ids = np.array([[tokens[-1]]], dtype=np.int64)
    pos = np.array([[t]], dtype=np.int64)
    mask = np.ones((1, len(tokens)), dtype=np.int64)
    logits = runner.step(ids, mask, pos)          # (1, 1, vocab)
    next_id = int(logits[0, -1].argmax())
    if next_id == tokenizer.eos_token_id:
        break
    tokens.append(next_id)
print(tokenizer.decode(tokens))
几个 LLM 导出的工程要点:
| 要点 | 说明 |
|---|---|
| 必须用外部数据格式 | LLM 体积普遍 >2GB,撞 protobuf 上限;optimum 会自动处理 |
| past 布局随版本变 | HF past_key_values 结构多次变更,导出前先确认当前版本约定 |
| position_ids 必须动态 | 增量解码时它表示「当前绝对位置」,写死会导致位置编码错误 |
| 算子兼容性 | MultiHeadAttention、RotaryEmbedding(RoPE)等在新 opset 才友好;老引擎需分解成基础算子 |
| 量化对 LLM 收益巨大 | INT8 常掉点明显,权重 W4A16(如 INT4) 才是 LLM 量化的主流方向 |
| 别只看单步延迟 | 要分别报告 Prefill(首 token,算力密集) 与 Decode(后续 token,访存密集) 延迟 |
📌 一个诚实提醒 :ONNX Runtime 能跑 LLM,但对大模型的极致优化(PagedAttention、Continuous Batching、投机解码)上,专用推理框架如 vLLM、TensorRT-LLM、SGLang 更成熟。ONNX 在 LLM 场景的价值更多在于中小模型的端侧/嵌入式部署 、跨硬件的统一分发 ,以及作为 TensorRT-LLM 等引擎的前置格式。选型时别被"什么都能跑"迷惑。
14. 走向生产:ONNX 的推理生态地图
ONNX 最大的价值是它背后的「后端全家桶」。转成 ONNX 后,按目标硬件选择引擎:
| 目标硬件 / 场景 | 推荐引擎 | 说明 |
|---|---|---|
| 跨平台 CPU / 通用服务 | ONNX Runtime | 最通用,Win/Linux/Mac、Python/C++/C#/Java 全支持 |
| NVIDIA 数据中心 GPU | TensorRT | 极致延迟/吞吐,支持 FP16/INT8,ONNX 是其首选输入格式 |
| Intel CPU / 核显 | OpenVINO | Intel 硬件上 INT8 推理很强 |
| Windows / 跨平台 GPU | ONNX Runtime + CUDA/DirectML | DirectML 可兼容各类 Windows GPU |
| iPhone / iPad | Core ML | 苹果生态,通过 coremltools 从 ONNX/其他格式转 |
| Android | NNAPI / ORT NNAPI EP | 调用手机 NPU/GPU |
| 浏览器 | ORT Web / onnxruntime-web | WebAssembly + WebGPU,纯前端推理 |
14.1 二选一:ONNX Runtime 还是 TensorRT?
这是 GPU 部署里最常见的选择题,给一张直接的对照:
| 维度 | ONNX Runtime (+CUDA EP) | TensorRT |
|---|---|---|
| 上手成本 | 低,pip 即用 | 高,需要编译 engine、调 profile |
| 极致性能 | 良好 | 最好(kernel 自动调优、层融合更激进) |
| 动态 shape | 天然支持 | 需要预先声明 min/opt/max 三档 |
| 部署形态 | 一个 .onnx 文件跨平台 |
每台机器/每种 shape 可能需重新 build engine |
| 适合场景 | 快速上线、多硬件分发、CPU/GPU 混合 | 固定硬件、固定 shape、榨性能 |
经验结论 :先用 ORT 上线拿基线,等性能成为瓶颈、且硬件固定时,再切 TensorRT 抠最后那 2~3 倍。 不要一上来就迷信 TensorRT。
14.2 端侧与浏览器:ONNX 的另一片战场
除了服务器,ONNX 在端侧和 Web 上同样重要,这是很多教程忽略的场景:
① 浏览器内推理(ORT Web)------纯前端、无需后端、数据不出本地:
html
<script src="https://cdn.jsdelivr.net/npm/onnxruntime-web/dist/ort.min.js"></script>
<script>
  async function run() {
    // 指定用 WebGPU / WASM 后端
    const session = await ort.InferenceSession.create(
      "resnet50.onnx",
      { executionProviders: ["webgpu", "wasm"] }
    );
    const data = new Float32Array(1 * 3 * 224 * 224);
    const tensor = new ort.Tensor("float32", data, [1, 3, 224, 224]);
    const outputs = await session.run({ input: tensor });
    console.log(outputs.output.dims);
  }
  run();
</script>
② 手机 / 嵌入式 :ORT 提供 iOS / Android 的移动端包,也可通过 coremltools 转 Core ML、通过转换器转各家 NPU 的格式。
③ 边缘设备(树莓派、Jetson、国产盒子) :小模型 + INT8 量化后,ORT 能直接在 ARM CPU 上跑;Jetson 则有 TensorRT。端侧部署的核心永远是「量化 + 小模型 + 固定 shape」。
💡 一个端侧经验 :给端侧导出模型时,优先固定 shape、优先 INT8、优先精简图 。端侧对内存和功耗极其敏感,动态维度和冗余算子在这里都是负担。同一套模型,服务器版和端侧版往往要用不同参数导出两次。
14.3 ONNX 与其它格式的关系
开发中你会遇到一堆模型格式,别混淆它们各自的定位:
| 格式 | 定位 | 与 ONNX 的关系 |
|---|---|---|
| ONNX | 跨框架交换格式(中间层) | 本文主角 |
| .pt / .pth | PyTorch 原生权重 | 上游,需导出成 ONNX |
| SavedModel / .h5 | TensorFlow 原生 | 上游,需 tf2onnx 转 |
| .engine / .plan | TensorRT 编译产物 | 下游,由 ONNX 编译而来 |
| IR(.xml/.bin) | OpenVINO 格式 | 下游,由 ONNX 转换而来 |
| .mlmodel / .mlpackage | Core ML 格式 | 下游,由 ONNX/其它格式转 |
| GGUF | llama.cpp 的 LLM 格式 | 平行生态,LLM 端侧常用,非 ONNX |
| safetensors | 权重安全存储格式 | 平行的"存储"格式,非"计算图"格式 |
记住一句话 :ONNX 是计算图 + 权重的交换中间层,上游是训练框架,下游是推理引擎。它不是终点,而是「枢纽」。
以最常见的「ONNX → TensorRT」为例 ,新版 TensorRT 可以直接吃 ONNX(背后用官方的 trtexec / ONNX GraphSurgeon):
bash
# FP16
trtexec --onnx=resnet50_sim.onnx \
        --saveEngine=resnet50_fp16.engine \
        --fp16

# INT8(需要校准缓存或显式精度)
trtexec --onnx=resnet50_sim.onnx \
        --saveEngine=resnet50_int8.engine \
        --int8 \
        --calib=calibration.cache

# 动态 shape:给出 min / opt / max 三档
trtexec --onnx=bert_sim.onnx \
        --minShapes=input_ids:1x8,attention_mask:1x8,token_type_ids:1x8 \
        --optShapes=input_ids:8x64,attention_mask:8x64,token_type_ids:8x64 \
        --maxShapes=input_ids:32x256,attention_mask:32x256,token_type_ids:32x256 \
        --fp16 --saveEngine=bert.engine
trtexec 还会直接打印各层耗时和总的吞吐/延迟,是调优的好帮手。
一条我常用的生产流水线长这样:
PyTorch/TF 训练
      │  导出器
      ▼
 原始 ONNX
      │  onnxsim 化简 + shape_inference
      ▼
 精简 ONNX  ──数值对齐──┐
      │                 │
      ├─ CPU:  ORT(静态/动态量化 INT8)
      ├─ GPU:  TensorRT(FP16/INT8 + profile)
      ├─ Intel:OpenVINO(INT8)
└─ 端侧: Core ML / NNAPI把每一步的产物和数值校验固化成脚本/CI,模型迭代时就能一键重放整条部署链路,这是工程化成熟度的标志。
15. 进阶:当你遇到不支持的算子
大多数情况下,第 11 节「用标准算子改写 / 换导出器」已经够用。这里简单介绍两种高级手段,让你知道边界在哪。
15.1 为老导出器注册自定义 symbolic
如果某个算子(包括你自己的 autograd.Function)实在无法改写,可以告诉导出器「这个算子该翻译成什么 ONNX 子图」:
python
import torch
from torch.onnx import register_custom_op_symbolic
from torch.onnx.symbolic_helper import parse_args

@parse_args("v", "i")
def my_op_symbolic(g, x, axis):
    # 用 ONNX 算子拼出等价实现,例如这里退化成一个 ReduceMean
    return g.op("ReduceMean", x, axes_i=[axis], keepdims_i=1)

# 注册到对应算子名和 opset
register_custom_op_symbolic("mynamespace::my_op", my_op_symbolic, opset_version=17)
这要求你对 ONNX 算子集比较熟,属于「最后手段」。
15.2 用 onnxscript 写自定义函数
onnxscript 让你用一种「贴近 Python 的前端语言」直接写 ONNX 子图,是 TorchDynamo 新导出器处理复杂/自定义算子的基础,也是官方主推方向:
python
from onnxscript import script
from onnxscript import opset17 as op

@script()
def MyAddMean(x, y):
    s = op.Add(x, y)
    return op.ReduceMean(s, axes=[-1], keepdims=1)
写出的函数既能当普通 ONNX 子图内联,也能在支持的引擎上作为自定义函数调用。长期看,复杂模型的算子问题优先在 onnxscript + Dynamo 这条新链路上解决。
16. 生产部署:走出 Python,用 C++ 跑推理
Python 适合验证和快速原型,但线上服务、桌面软件、嵌入式 通常要用 C++/C#/Java 的 ORT API------不仅性能开销更小,还能摆脱 Python 运行时和 GIL 的束缚。这里给一个 C++ 的 ORT 完整推理骨架,是生产集成的常见起点。
cpp
// onnx_infer.cpp  ------ 编译:g++ onnx_infer.cpp -lonnxruntime -std=c++17
#include <onnxruntime_cxx_api.h>
#include <vector>
#include <iostream>
#include <array>

int main() {
    // 1) 环境与 Session
    Ort::Env env(ORT_LOGGING_LEVEL_WARNING, "onnx_demo");
    Ort::SessionOptions opts;
    opts.SetIntraOpNumThreads(4);
    opts.SetGraphOptimizationLevel(GraphOptimizationLevel::ORT_ENABLE_ALL);

    Ort::Session session(env, "resnet50.onnx", opts);

    // 2) 输入输出名(用 UTF-8 字符串,须保证生命周期)
    const char* input_names[]  = {"input"};
    const char* output_names[] = {"output"};

    // 3) 构造输入张量:NCHW = (1,3,224,224)
    std::array<int64_t, 4> shape{1, 3, 224, 224};
    std::vector<float> input_data(1 * 3 * 224 * 224, 0.0f);   // 填充你的预处理结果

    Ort::MemoryInfo mem = Ort::MemoryInfo::CreateCpu(
        OrtArenaAllocator, OrtMemTypeDefault);
    Ort::Value input_tensor = Ort::Value::CreateTensor<float>(
        mem, input_data.data(), input_data.size(), shape.data(), shape.size());

    // 4) 推理
    auto outputs = session.Run(
        Ort::RunOptions{nullptr},
        input_names, &input_tensor, 1,
        output_names, 1);

    // 5) 取结果
    float* out = outputs[0].GetTensorMutableData<float>();
    auto out_shape = outputs[0].GetTensorTypeAndShapeInfo().GetShape();
    int64_t num_classes = out_shape[1];

    // argmax 得到预测类别
    int64_t best = 0; float best_val = out[0];
    for (int64_t i = 1; i < num_classes; ++i) {
        if (out[i] > best_val) { best_val = out[i]; best = i; }
    }
    std::cout << "预测类别: " << best
              << "  置信度: " << best_val << std::endl;
    return 0;
}
C++ 侧的几个工程要点:
| 要点 | 说明 |
|---|---|
| 张量命名生命周期 | Ort::Value 引用外部内存时,源数据必须在 Run 期间存活;别用临时 vector |
| 复用 Session | Session 创建开销大,且内含已优化的图------全局复用,别每次请求都建 |
| 线程安全 | Session 的 Run 是线程安全的,可以多线程并发调用同一个 Session |
| 动态 shape | C++ 侧用 GetInputNameAllocated 拿名字,按实际 shape 构造输入张量 |
| 大模型外部数据 | 加载 model.onnx 时,同目录的 .data 文件必须存在 |
| 内存池 | 高并发场景配置 OrtArenaAllocator,减少分配抖动 |
🎯 一个完整的生产服务架构通常是:C++ 侧负责「预处理 → ORT 推理 → 后处理」的热路径,Python 只在离线侧负责模型转换与校验。把预处理也下沉到 C++(避免 Python 来回转 numpy),往往还能再带来可观收益。
17. 生产级转换脚本(可直接复用)
最后,把前面所有最佳实践串成一个带校验的脚本,支持动态 batch、化简、可选量化,并在每一步做数值对齐:
python
"""
export_onnx.py ------ 生产级 PyTorch → ONNX 转换模板
用法:
    python export_onnx.py
"""
import numpy as np
import torch
import torch.nn as nn
import onnx
import onnxruntime as ort
from onnxsim import simplify


def export_to_onnx(
    model: nn.Module,
    dummy_inputs,                 # tuple[torch.Tensor]
    onnx_path: str,
    input_names,
    output_names,
    dynamic_axes,
    opset: int = 17,
    do_simplify: bool = True,
    rtol: float = 1e-3,
    atol: float = 1e-5,
):
    model.eval()

    # ---------- 1. 导出 ----------
    with torch.no_grad():
        torch.onnx.export(
            model,
            tuple(dummy_inputs),
            onnx_path,
            export_params=True,
            opset_version=opset,
            do_constant_folding=True,
            input_names=input_names,
            output_names=output_names,
            dynamic_axes=dynamic_axes,
        )
    print(f"[1/4] 导出完成 -> {onnx_path}")

    # ---------- 2. 结构校验 ----------
    onnx_model = onnx.load(onnx_path)
    onnx.checker.check_model(onnx_model)
    print("[2/4] 结构校验通过")

    # ---------- 3. 化简 ----------
    if do_simplify:
        onnx_model, ok = simplify(
            onnx_model,
            overwrite_input_shapes={
                name: list(t.shape) for name, t in zip(input_names, dummy_inputs)
            },
        )
        assert ok, "onnxsim 化简失败"
        onnx.save(onnx_model, onnx_path)
        print("[3/4] 图化简完成")
    else:
        print("[3/4] 跳过化简")

    # ---------- 4. 数值对齐 ----------
    with torch.no_grad():
        ref = model(*dummy_inputs)
    ref_outs = ref if isinstance(ref, (tuple, list)) else (ref,)

    sess = ort.InferenceSession(onnx_path, providers=["CPUExecutionProvider"])
    feeds = {name: t.detach().cpu().numpy()
             for name, t in zip(input_names, dummy_inputs)}
    ort_outs = sess.run(None, feeds)

    for i, (r, o) in enumerate(zip(ref_outs, ort_outs)):
        np.testing.assert_allclose(r.cpu().numpy(), o, rtol=rtol, atol=atol)
        print(f"[4/4] 输出[{i}] 数值一致,max abs diff = "
              f"{np.abs(r.cpu().numpy() - o).max():.3e}")

    print("✅ 全部检查通过,模型可用于部署")
    return onnx_path


if __name__ == "__main__":
    import torchvision

    model = torchvision.models.resnet50(
        weights=torchvision.models.ResNet50_Weights.DEFAULT
    )
    dummy = (torch.randn(2, 3, 224, 224),)

    export_to_onnx(
        model=model,
        dummy_inputs=dummy,
        onnx_path="resnet50_prod.onnx",
        input_names=["input"],
        output_names=["output"],
        dynamic_axes={
            "input":  {0: "batch"},
            "output": {0: "batch"},
        },
        opset=17,
    )
大模型(>2GB)在这个脚本里加
use_external_data_format=True;需要量化就在数值对齐后接第 12 节的量化函数,并在量化后再做一次任务级指标验证。
18. 报错速查表
遇到问题先查这张表,按图索骥:
| 报错 / 现象关键词 | 大概率原因 | 快速处理 |
|---|---|---|
| 每次推理结果都不一样 | 没切 eval(),BN/Dropout 在训练态 |
model.eval() |
operator XXX is not supported |
算子无 ONNX symbolic | 升 opset / 改写算子 / 用 Dynamo |
IR version ... not supported |
IR/opset 超过引擎支持 | 降低 opset_version |
| 喂别的 batch 就 shape 报错 | 维度写死 | 配置 dynamic_axes |
| 输入列表里有一堆权重名 | initializer 被当成输入 | 清理 graph.input(坑 5) |
| 大模型导出超限/打不开 | 撞上 protobuf 2GB 上限 | use_external_data_format |
Unexpected input data type |
dtype 不匹配 | 对齐 get_inputs() 的 dtype |
| 装了 GPU 版却很慢 | 算子回退到 CPU EP | 查日志看 EP 分配,升级/换算子 |
| Softmax/归一化结果错乱 | axis / NCHW·NHWC 错位 | Netron 逐节点核对 |
| 量化后掉点严重 | INT8 精度损失 | 静态校准 / 敏感层混精 / QAT |
| 结果对但速度偏慢 | 残留大量 Transpose / 冗余节点 | --nchw、onnxsim 化简 |
| 控制流分支丢失 | trace 只录了样例分支 | 用 Dynamo 或消除数据依赖分支 |
| 转 TensorRT 报算子不认识 | 图里混入了 com.microsoft 私有算子 |
查 Netron 的 domain 字段,换导出路径 |
| BN 模型有稳定小偏差 | epsilon 不一致 | 核对 epsilon 属性 |
| 变长 batch 结果不一致 | attention_mask 漏传/错传 |
显式导出并喂真实 mask |
| LLM 加载失败 | >2GB 未用外部数据 | use_external_data_format=True |
| 检测框位置整体偏移 | letterbox 的 padding 未在反算时还原 | 用 dw/dh/ratio 反算(9.3) |
19. 总结与展望
回到开头那个「下周上线」的场景,现在你应该有了完整的武器库:
- ONNX 是深度学习世界的中间表示,用 Protobuf 描述计算图、算子和权重,解耦了训练框架与推理硬件;
- 转换只是第一步,专业流程是「导出 → 结构校验 → 化简 → 数值对齐 → 量化/编译 → 任务级验证」,缺一不可;
- 动态维度、多输入输出、dict 输出包装、外部数据格式是处理真实模型的四个高频技巧;
- opset 是兼容性的生命线 :云端可上 17,端侧保守到 13,且要警惕
com.microsoft私有算子; - PyTorch 2.x 的 TorchDynamo + onnxscript 正在成为新的默认,复杂模型优先在新链路上解决算子问题;
- 性能调优有方法论:benchmark(P50/P99)→ profiling(找慢节点)→ 线程/IO Binding/量化逐层优化,而不是盲猜;
- 大模型是新的深水区:KV Cache 的 past/present 闭环、外部数据格式、Prefill/Decode 分离,都是必修课;
- ONNX 的真正威力在其后端生态------ORT、TensorRT、OpenVINO、Core ML、ORT Web 让「一次导出,到处高性能运行」成为现实。
最后给一条务实的落地路线,如果你正要开始一个部署项目:
第 1 天:跑通最小闭环
  导出 ResNet/BERT → check_model → 数值对齐 → ORT 推理

第 1 周:把生产要素补齐
  动态 shape、多输入、外部数据格式、onnxsim 化简、基准测试

第 2 周:性能与精度
  Profiling 找瓶颈 → 线程/IO Binding 调优 → INT8 量化 + 任务指标验证

第 3 周:走向目标硬件
  GPU→TensorRT / Intel→OpenVINO / 端侧→量化+固定 shape;C++ 集成
展望未来,几个趋势值得关注:
- 大模型(LLM / 多模态)成为 ONNX 的新战场:超长动态序列、KV Cache、投机解码等给图表达和引擎带来新挑战,ONNX 规范和 ORT 也在快速跟进;但极致性能仍要看 TensorRT-LLM / vLLM 等专用引擎;
- 量化持续下沉:INT8 已普及,INT4 / NF4 等低位宽格式与权重只量化(W4A16)正在端侧和大模型推理中普及;
- 导出器与编译器进一步融合:Dynamo → onnxscript → 各硬件后端的一体化链路会越来越顺滑,「部署」这件事的门槛会持续降低;
- 统一编译栈的竞争:ONNX 之外,MLIR、TVM、Apache TVM 等编译栈也在演进,但 ONNX 凭借生态和厂商支持,仍是「交换格式」这一层最稳的赢家。
如果这篇文章帮你少加了一个晚班,欢迎点赞、在看、转发三连 🙌
我会持续输出 模型部署、推理优化、大模型工程化 方向的硬核内容------既有可以直接抄走的代码,也有背后的原理和踩坑实录。关注我,下一篇我们聊聊 TensorRT 极致优化 / 大模型的 ONNX 导出与 KV Cache 加速。
你的每一次关注,都是我继续写下去的动力。 我们下篇见 👋