HTTP协议详解:从URL到HTTP服务器的完整实战
-
- 一、HTTP协议概述
- 二、认识URL
- 三、urlencode和urldecode
- 四、HTTP协议格式
-
- [1. HTTP请求格式](#1. HTTP请求格式)
- [2. HTTP响应格式](#2. HTTP响应格式)
- [3. 请求和响应怎么保证应用层读取到完整的内容](#3. 请求和响应怎么保证应用层读取到完整的内容)
- [4. 请求和响应是怎么做到序列化和反序列化的](#4. 请求和响应是怎么做到序列化和反序列化的)
- 五、HTTP的方法
- 六、HTTP的状态码
- 七、HTTP常见Header
- 八、最简单的HTTP服务器
- 九、HTTP请求方法的理解
- 十、长连接
- 十一、HTTP的会话保持
- 十二、实现一个简单的HTTP服务器
一、HTTP协议概述
到目前为止我们在做的工作主要分为三点:1. 基本的socket写完了
-
一般的服务器设计原则和方式+场景的各种场景
-
自定义协议+序列化和反序列化但实际上,已经有大佬们定义了一些现成的、又非常好用的应用层协议,供我们直接参考使用。HTTP(超文本传输协议)就是其中之一------http协议、https协议。
所有未来http/https协议做的事情和我们之前做的基本一致,只是在协议层上做一些优化和封装。
我们回顾一下osi模型和我们之前写的线程池版本的服务器。
我们线程池版本的服务器分为了三层:
- 第一层线程池
- 第二层就是我们的服务器(处理业务逻辑、序列化等等工作)
- 第三层就是上层用户实际的业务(就是用户上层传什么任务第二层就执行这个任务)
其实我们的三层就对应osi模型的三层:
- osi模型的应用层,就是我们第三层,功能(针对特定的应用的协议)
- osi模型的表示层,就是我们的第二层,功能(设备固有数据格式和网络标准数据格式的转换)
- osi模型的会话层,就是我们的线程池,功能(负责和客户端的会话管理、通信管理、负责建立和断开连接)
http就是应用层协议,就要完成上面三层的功能。
二、认识URL
平时我们俗称的"网址"其实就是说的URL。
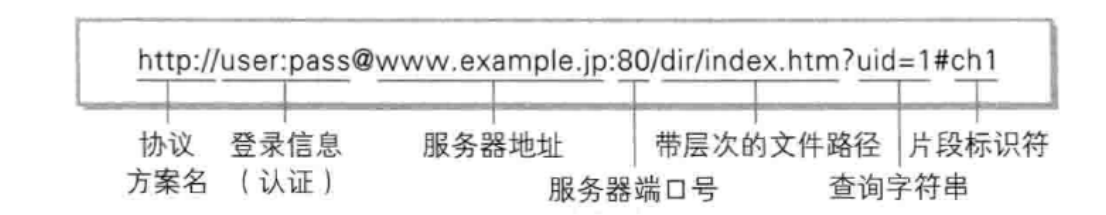
url格式为:
http://www.baidu.com:8080/index.htmlhttp://协议方案名www.baidu.com域名,最后会转换为ip地址(域名解析服务)/8080端口号/index.html带层次的文件路径,就是需要请求的文件路径
实际过程就是我们通过协议名+域名找到对应的ip地址主机,然后通过端口号找到对应的服务器,然后通过文件路径找到对应的文件。
协议和端口号是强绑定的,不能改变,如果改变协议名或端口号,就会导致连接失败。
目录是从web根目录开始的,所以 / 就是web根目录,一般而言可以是linux目录下的任意目录。
所以http的本质就是通过http协议从服务器拿到对应的资源,资源就是一切你在网络中看到的都是资源文件。
这些资源就在服务器的磁盘上,所以我们要拿到对应的文件就需要linux的文件系统的路径结构。
业务文件资源的种类多,http都能搞定,所以http叫做超文本传输协议。
三、urlencode和urldecode
像 / ? : 等这样的字符,已经被url当做特殊意义理解了。因此这些字符不能随意出现。
比如,某个参数中需要带有这些特殊字符,就必须先对特殊字符进行转义。
转义的规则如下:
将需要转码的字符转为16进制,然后从右到左,取4位(不足4位直接处理),每2位做一位(也即是两个16进制数),前面加上%,编码成 %XY 格式。
例如:"+" 被转义成了 "%2B"。
urldecode就是urlencode的逆过程。
四、HTTP协议格式
HTTP是以行为单位的协议。
1. HTTP请求格式
宏观HTTP请求格式:
第一部分为请求行:
- 第一列是请求方法
- 第二列是url
- 第三列是http版本
- 以
\r\n或\n结尾
第二部分为请求报头:
- 包含多行,里面都是该次请求的属性
- 格式为
name:value - 以
\r\n或\n结尾
第三部分:
- 没有什么内容,只是一个空行
\r\n或\n
第四部分为请求体:
- 里面是请求体的内容(请求正文)
- 这个部分可以为空,也可以不为空
- 内容就是用户需要传递给服务器的数据
在有了HTTP请求格式后,实际我们在发送http请求时,就是将请求行+请求报头+空行+请求体这四部分拼接起来,通过socket发送给服务器。
2. HTTP响应格式
响应格式和请求格式是非常相似的。
第一部分为状态行:
- 第一列是http版本
- 第二列是状态码(是一个三位数)
- 第三列是状态描述
- 以
\r\n或\n结尾
第二部分为响应报头:
- 包含多行,里面都是该次响应的属性
- 格式为
name:value - 以
\r\n或\n结尾
第三部分:
- 没有什么内容,只是一个空行
\r\n或\n
第四部分为响应体:
- 里面是响应体的内容(响应正文)
- 这个部分可以为空,也可以不为空
- 内容就是服务器需要传递给客户端的数据
- 比如:服务器需要传递给客户端的html文件
返回时根据tcp连接的socket向客户端发送返回响应。
3. 请求和响应怎么保证应用层读取到完整的内容
首先我们可以读到完整的一行,那么while读取到完整的一行,就可以保证读取到完整的内容(请求行+请求报头),一直读到空行结束。
空行之前就是按行的信息,我们就可以读到了。现在我们能保证把报头读完,而报头有一个属性是 Content-Length,它可以告诉我们正文的长度。
所以我们有了完整的请求体就可以解析了,我们可以根据 Content-Length 属性来判断正文的长度,然后根据正文的长度来读取正文。
4. 请求和响应是怎么做到序列化和反序列化的
http的序列化是自己实现的,就是第一行+请求/响应报头的序列化,就是每一行按照 \r\n 或者 \n 来分隔,然后往流中写入即可,不需要任何的序列化操作。
读取的时候就按照 \r\n 或者 \n 为结尾来读取即可,就可以保证读取到完整的内容了(其实就是按照特殊字符来分隔行)。
正文部分就不用序列化了,因为正文部分是二进制数据,不需要序列化。但是正文部分需要结构化数据的时候就需要自己去序列化(比如json格式)。
五、HTTP的方法
| 方法 | 说明 | 支持的HTTP协议版本 |
|---|---|---|
| GET | 获取资源 | 1.0、1.1 |
| POST | 传输实体主体 | 1.0、1.1 |
| PUT | 传输文件 | 1.0、1.1 |
| HEAD | 获得报文首部 | 1.0、1.1 |
| DELETE | 删除文件 | 1.0、1.1 |
| OPTIONS | 询问支持的方法 | 1.1 |
| TRACE | 追踪路径 | 1.1 |
| CONNECT | 要求用隧道协议连接代理 | 1.1 |
| LINK | 建立和资源之间的联系 | 1.0 |
| UNLINE | 断开连接关系 | 1.0 |
其中最常用的就是GET方法和POST方法。
六、HTTP的状态码
| 类别 | 原因短语 |
|---|---|
| 1XX | Informational(信息性状态码)接收的请求正在处理 |
| 2XX | Success(成功状态码)请求正常处理完毕 |
| 3XX | Redirection(重定向状态码)需要进行附加操作以完成请求 |
| 4XX | Client Error(客户端错误状态码)服务器无法处理请求 |
| 5XX | Server Error(服务器错误状态码)服务器处理请求出错 |
最常见的状态码,比如200(OK),404(Not Found),403(Forbidden),302(Redirect,重定向),504(Bad Gateway)。
http状态码的理解:
主要分为5大类:
- 以1开头的:信息类(Informational),就是请求已经收到,但是正在处理
- 以2开头的:成功类(Success),就是请求成功,服务器返回了请求的数据
- 以3开头的:重定向类(Redirection),就是需要进行附加的操作才能完成请求
- 以4开头的:客户端错误类(Client Error),就是请求参数错误,服务器无法处理请求
- 以5开头的:服务器错误类(Server Error),就是服务器内部错误,无法处理请求
重定向类(Redirection):
就是需要进行附加的操作才能完成请求。
例如:
- 301 Moved Permanently:就是重定向到其他url,且是永久重定向
- 307 Temporary Redirect:就是重定向到其他url,且是临时重定向
重定向整个过程是:client->server,客户端向服务器发送请求,服务器返回重定向状态码 301/307 和要重定向的url,客户端会自动根据重定向的url发送新的请求。
所以重定向功能是客户端自动完成的,服务器端不会自动完成重定向操作,也就是浏览器会自动完成重定向操作。
临时重定向和永久重定向的区别:
- 缓存:301永久重定向浏览器会缓存跳转关系,下次访问旧url直接本地跳转;307临时重定向不会缓存,每次都要访问服务器获取新地址。
- SEO:301会将旧链接权重转移到新链接;307不会转移权重,保留旧链接索引。
- 请求方法:301存在POST转GET的历史行为;307严格保持原来的HTTP请求方法,POST跳转后依旧POST。
- 适用场景:301用于域名永久迁移、页面永久更换;307用于临时维护、短期页面跳转。
我们可以模拟301和307的重定向效果:
cpp
std::string respline = "HTTP/1.1 307 Temporary Redirect\r\n"; //重定向状态行
// respheader += "Location: https://www.qq.com/\r\n"; //重定向响应头,指定跳转地址
七、HTTP常见Header
Content-Type:数据类型(text/html等)Content-Length:Body的长度Host:客户端告知服务器,所请求的资源是在哪个主机的哪个端口上User-Agent:声明用户的操作系统和浏览器版本信息referer:当前页面是从哪个页面跳转过来的location:搭配3xx状态码使用,告诉客户端接下来要去哪里访问Cookie:用于在客户端存储少量信息。通常用于实现会话(session)的功能
User-Agent里的历史故事。
八、最简单的HTTP服务器
实现一个最简单的HTTP服务器,只在网页上输出"hello world";只要我们按照HTTP协议的要求构造数据,就很容易能做到。
cpp
#include <sys/socket.h>
#include <netinet/in.h>
#include <arpa/inet.h>
#include <unistd.h>
#include <stdio.h>
#include <string.h>
#include <stdlib.h>

void Usage() {
    printf("usage:./server [ip] [port]\n");
}

int main(int argc, char* argv[]) {
    if (argc != 3) {
        Usage();
        return 1;
    }
    int fd = socket(AF_INET, SOCK_STREAM, 0);
    if (fd < 0) {
        perror("socket");
        return 1;
    }
    struct sockaddr_in addr;
    addr.sin_family = AF_INET;
    addr.sin_addr.s_addr = inet_addr(argv[1]);
    addr.sin_port = htons(atoi(argv[2]));
    int ret = bind(fd, (struct sockaddr*)&addr, sizeof(addr));
    if (ret < 0) {
        perror("bind");
        return 1;
    }
    ret = listen(fd, 10);
    if (ret < 0) {
        perror("listen");
        return 1;
    }
    for (;;) {
        struct sockaddr_in client_addr;
        socklen_t len;
        int client_fd = accept(fd, (struct sockaddr*)&client_addr, &len);
        if (client_fd < 0) {
            perror("accept");
            continue;
        }
        char input_buf[1024 * 10] = {0}; // 用一个足够大的缓冲区直接把数据读完.
        ssize_t read_size = read(client_fd, input_buf, sizeof(input_buf) - 1);
        if (read_size < 0) {
            return 1;
        }
        printf("[Request] %s", input_buf);
        char buf[1024] = {0};
        const char* hello = "<h1>hello world</h1>";
        sprintf(buf, "HTTP/1.0 200 OK\nContent-Length:%lu\n\n%s", strlen(hello), hello);
        write(client_fd, buf, strlen(buf));
    }
    return 0;
}
该代码中的知识点:
socket(AF_INET, SOCK_STREAM, 0):创建TCP套接字。bind:绑定IP和端口。listen:设置监听状态,第二个参数是连接队列长度。accept:接受连接,返回新的socket用于通信。read:读取HTTP请求数据。sprintf:构造HTTP响应报文,格式为HTTP/1.0 200 OK\nContent-Length:%lu\n\n%s。write:发送响应给客户端。
备注:
此处我们使用9090端口号启动了HTTP服务器,虽然HTTP服务器一般使用80端口,但这只是一个通用的习惯,并不是说HTTP服务器就不能使用其他的端口号。使用chrome测试我们的服务器时,可以看到服务器打出的请求中还有一个 GET /favicon.ico HTTP/1.1 这样的请求。
实验:
把返回的状态码改成404,403,504等,看浏览器上分别会出现什么样的效果。
九、HTTP请求方法的理解
我们在进行网址交互的时候,大体上分为两种:1. 请求资源 2. 上传资源。
我们在进行数据提交的时候,本质是通过form表单提交数据的,浏览器会自动将form表单中的内容转化成为Get/Post请求。
html
<!-- 表单的结构 -->
<!-- 我们进行数据提交的时候,本质前端是通过form表单提交的,浏览器会自动将form表单的内容转化成GET/POST方法请求 -->
<form action="/a/b/c.py" method="POST">
    <!-- action="/a/b/c.py"浏览器会自动拼接到网站ip+端口号的后面 --> 例如197.168.1.100:8080/a/b/c.py
    <!-- 这里如果使用GET方法就会把提交的内容以key/value的模型拼接到我们的url的后面也就是...?a/b/c.py的后面 通过问号连接-->
    例如197.168.1.100:8080/a/b/c.py?xname=张三&ypwd=123456 这里是明文提交
    我们服务器在获取请求在第一行的请求行中的url时 会自动解析出url中的参数
     url中获取到xname=张三&ypwd=123456 这两个参数
    <!-- 但无论是POST还是GET都不安全要加密 只是相对来说POST更安全 -->
    <!-- 不一定非要提取到一个python脚本里面 c++文件等都可以 -->
    姓名:<br>
     <input type="text" name="xname" value="请输入用户姓名">
    <!-- name属性 表单提交时 作为当前输入框数据的「参数键名」 与输入值(value)组成键值对(xname=用户输入内容) 供服务端获取数据 -->
    <!-- value是预设的内容 不是提示 --> 就是暗文
    <br>
    密码:<br>
    <input type="password" name="ypwd">
    <br><br>
    <input type="submit" value="登陆">
    <!-- submit就是我们平时登录的按钮  -->
</form>
因为GET方法是把提交的内容以key/value的模型拼接到我们的url的后面,所以GET方法注定了参数不能太大。
但是POST方法没有这个限制,POST方法把提交的内容拼接到请求体中,所以POST方法注定了参数可以很大。
如果我们是get方法,那么我们在进行把url拼接到我们默认网页根目录后面时就要主动分离参数。我们可以通过 ? 来分离我们要的目录和参数。
cpp
// if(req.path == "test.py") //如果提交到。py的脚本里就这样做
// {
//     //建立进程间通信,pipe
//     //fork创建子进程,execl("/bin/python", test.py) 子进程执行脚本
//     // 父进程,将req.parm参数 通过管道写给某些后端语言,py,java,php等语言
// }
// if(req.path == "/search")
// {
//     // req.parm
//     // 使用我们自己写的C++的方法,提供服务
// }
我们可以根据这个url访问的路径来绑定我们的服务器的回调方法:
cpp
// httpsvr->registerCb("/", Get); // 功能路由!注册不同方法根据不同的路径执行不同方法
// httpsvr->registerCb("/search", Search);
// httpsrv->registerCb("/test.py", Other);
可以根据不同的路径来绑定不同的回调方法。
十、长连接
我们知道一个网页是可能有多个元素组成的,一个元素就对应一个http请求。http是基于tcp的,频繁的发起请求tcp是面向连接的就会有频繁创建连接的问题。
所以需要client和server都要支持长连接,建立一条连接,获取一大份资源的时候通过一条连接完成。
是通过协议报头中的 Connect:keep-alive 支持的。
十一、HTTP的会话保持
会话保持严格意义上不是天然具备的,而是我们后续使用中发现需要的。
首先http是无状态的,就是请求之前是不知道对方的存在的,即使请求的是同一个东西,就导致了每次进入的都是一个新网页。
但是用户需要这种,例如我们在一些网址登录后后续一段时间就不用登录了,一个网址不同网页的跳转也不用重新登录。
所以有了会话保持。
在我们进行登录后会在浏览器下保存我们的用户名和密码,往后只要访问同一个网址浏览器会自动推送我们浏览器保存的历史信息。
凡是访问带有权限要求的网页时,在被获取之前都要进行身份验证,但是用户不需要每次都被要求验证,所以这功能要自动验证。
这种实现自动验证的功能叫做cookie。
cookie级别分为文件级别和内存级别,因为浏览器也是一个进程,既然是进程那么保存到进程上下文中的数据就不是永久性的。
所以我们在一些网址登录过后退出浏览器再进入浏览器发现仍然是登录的,所以这个就是文件级别的,但是这个可以配置的。
我们在浏览器存储cookie后再下一次进入要验证的页面时会自动利用cookie进行验证。
但是因为cookie是保存到浏览器的,所以就有被盗用的风险,就被盗用账号和密码。
所以有了新方案:
我们不在浏览器内部保存账号和密码,而是在服务器保存。在我们首次登录后会在服务端用你的账号和密码生成一个session文件,文件里面就保存了用户的认证信息、浏览信息等等。但是服务器不止为一个人提供服务,所以会有很多用户都登录,所以就会有很多session文件,所以每一个用户的session文件都要有唯一的名字,叫做session id。在成功登录后会返回这个session id,浏览器只保存这个session id作为cookie。所以在下一次进行访问要验证的网页时就会携带这个cookie一起作为一个请求发送到服务器,服务器会拿着这个session id去找对应的文件,如果有就登录,没有就重新登录。
这样因为账号和密码被保存到了服务端,所以即使cookie被盗用了也不会泄露账号和密码。但是cookie被盗用没法防止,但是公司会有其他的手段来防止你的消息被泄露。
那么server是怎么在你的浏览器写入cookie消息的呢?
在响应报头里面添加Set-Cookie这个属性,例如 Set-Cookie: 12345678\r\n。
浏览器在收到响应后如果携带这个属性就会保存你的cookie。
在下一次发送请求的时候如果有cookie就会以请求报头中的一个属性发送到服务器。
十二、实现一个简单的HTTP服务器
我们实现一个简单的http服务器,服务器就不用自己写了,用现成的浏览器就可以测试了。
功能来获取一个http的请求。
上层http协议:
cpp
#pragma once

#include <iostream>
#include <string>
#include <vector>
#include <sstream>
#include "Util.Hpp"

const std::string sep = "\r\n";
const std::string default_root = "./wwwroot"; //这就是我们web的根目录的路径 也就是说
//                                             这个可以是当前目录下的一个文件夹里面放各种网页

const std::string home_page = "index.html";  //默认首页

class HttpRequest
{
public:
    HttpRequest(){}
    ~HttpRequest(){}
    void parse() //解析方法
    {
        // 1. 从inbuffer中拿到第一行,分隔符\r\n
        std::string line = Util::getOneLine(inbuffer, sep);
        if(line.empty()) return;
        // 2. 从请求行中提取三个字段
        // std::cout << "line: " << line << std::endl;
        std::stringstream ss(line);
        ss >> method >> url >> httpversion; //自动以空格为分割符把字符串分割并且输入到字符串中

        // 3. 添加web默认路径
        path = default_root; // ./wwwroot,
        path += url; //./wwwroot/a/b/c.html, ./wwwroot/
        // url可以先理解为对应服务端默认网页路径(网站根目录)下的特定物理文件;

        // 因为可能会出现这样的情况我访问网页的时候不带任何其他的参数也就是url 那么我
        // 接受到的请求的url就是 /  path += url就会得到./wwwroot/这个就不对了因为./wwwroot/是wwwroot下一级目录
        // 可能有很多文件或者目录 所以我们要特殊处理一下这个
        if(path[path.size()-1] == '/') path += home_page;
    }
public:
    std::string inbuffer;
    // std::string reqline;
    // std::vector<std::string> reqheader;
    // std::string body;

    std::string method;
    std::string url;
    std::string httpversion;
    std::string path;
};

class HttpResponse
{
public:
    std::string outbuffer;
};
该代码中的知识点:
HttpRequest类封装了HTTP请求的解析逻辑。parse()方法从inbuffer中解析出请求行,提取方法、URL和HTTP版本。path字段是拼接了web根目录的完整文件路径。- 如果URL以
/结尾,自动添加默认首页index.html。 HttpResponse类封装了响应数据。
tcp服务器头文件:
cpp
#pragma once

#include <iostream>
#include <string>
#include <cstring>
#include <cstdlib>
#include <functional>
#include <unistd.h>
#include <sys/types.h>
#include <sys/socket.h>
#include <netinet/in.h>
#include <arpa/inet.h>
#include <sys/wait.h>
#include <signal.h>
#include "Protocol.hpp"

namespace server
{
    enum
    {
        USAGE_ERR = 1,
        SOCKET_ERR,
        BIND_ERR,
        LISTEN_ERR
    };

    static const uint16_t gport = 8080;
    static const int gbacklog = 5;

    using func_t = std::function<bool (const HttpRequest &, HttpResponse &)>;

    class HttpServer
    {
    public:
        HttpServer(func_t func, const uint16_t &port = gport) : _func(func), _listensock(-1), _port(port)
        {
        }
        void initServer()
        {
            // 1. 创建socket文件套接字对象
            _listensock = socket(AF_INET, SOCK_STREAM, 0);
            if (_listensock < 0)
            {
                exit(SOCKET_ERR);
            }
            // 2. bind绑定自己的网络信息
            struct sockaddr_in local;
            memset(&local, 0, sizeof(local));
            local.sin_family = AF_INET;
            local.sin_port = htons(_port);
            local.sin_addr.s_addr = INADDR_ANY;
            if (bind(_listensock, (struct sockaddr *)&local, sizeof(local)) < 0)
            {
                exit(BIND_ERR);
            }

            // 3. 设置socket 为监听状态
            if (listen(_listensock, gbacklog) < 0) // 第二个参数backlog后面在填这个坑
            {
                exit(LISTEN_ERR);
            }
        }

        void HandlerHttp(int sock)
        {
            // 1. 读到完整的http请求
            // 2. 反序列化 序列化函数和反序列化函数在httprequst, httpresponse这两个类里面实现
            // 3. 反序列化后得到httprequst, httpresponse,的对象  回调这个函数_func(req, resp)
            // 4. 对resp序列化
            // 5. send 序列化后的resp
            // 上面这些操作我们在这个demo代码就不做了

            // 我们这里就直接接受信号
            // 我们这里就简单写了就不再自己定协议了
            char buffer[4096];
            HttpRequest req;
            HttpResponse resp;
            size_t n = recv(sock, buffer, sizeof(buffer)-1, 0); // 大概率我们直接就能读取到完整的http请求
            if(n > 0)
            {
                buffer[n] = 0;
                req.inbuffer = buffer;
                req.parse();
                _func(req, resp); // req -> resp //执行上层 HttpServer.cc往里面传的回调函数
                send(sock, resp.outbuffer.c_str(), resp.outbuffer.size(), 0);
            }
        }

        void start()
        {
            for (;;)
            {
                // 4. server 获取新链接
                // sock, 和client进行通信的fd
                struct sockaddr_in peer;
                socklen_t len = sizeof(peer);
                int sock = accept(_listensock, (struct sockaddr *)&peer, &len);
                if (sock < 0)
                {
                    continue;
                }

                // version 2 多进程版(2)
                pid_t id = fork();
                if (id == 0) // child
                {
                    close(_listensock);
                    if(fork()>0) exit(0);

                    HandlerHttp(sock);

                    close(sock);
                    exit(0);
                }
                close(sock);

                // father
                pid_t ret = waitpid(id, nullptr, 0);
            }
        }

        ~HttpServer() {}

    private:
        int _listensock; // 不是用来进行数据通信的,它是用来监听链接到来,获取新链接的!
        uint16_t _port;
        func_t _func;
    };

} // namespace server
该代码中的知识点:
func_t是回调函数类型,处理请求并填充响应。initServer创建socket、bind、listen。HandlerHttp读取HTTP请求,调用parse()解析,调用回调函数处理,发送响应。start是主循环,accept新连接,fork子进程处理。- 子进程关闭监听socket,父进程关闭已连接socket。
- 使用
fork()两次是为了让孙子进程成为孤儿进程,由init回收,避免僵尸进程。
主程序:
cpp
#include "HttpServer.hpp"
#include <memory>
#include "Util.hpp"

using namespace std;
using namespace server;

void Usage(std::string proc)
{
    cerr << "Usage:\n\t" << proc << " port\r\n\r\n";
}

// 3. 我们要正确的给客户端返回资源类型,我们首先要自己知道!所有的资源都有后缀!!
std::string suffixToDesc(const std::string suffix)
{
    std::string ct = "Content-Type: ";
    if (suffix == ".html")
        ct += "text/html; charset=utf-8"; // 补充charset,避免中文乱码
    else if (suffix == ".jpg" || suffix == ".jpeg") // 兼容.jpg和.jpeg
        ct += "image/jpeg"; // 标准JPG图片MIME类型
    else if (suffix == ".png")
        ct += "image/png"; // 标准PNG图片MIME类型
    else if (suffix == ".gif")
        ct += "image/gif"; // 标准GIF图片MIME类型
    else
        ct += "application/octet-stream"; // 未知类型,默认二进制流
    ct += "\r\n";
    return ct;
}

// Get方法:处理HTTP GET请求,组装HTTP响应报文存入resp.outbuffer,最终通过socket发送给浏览器
bool Get(const HttpRequest &req, HttpResponse &resp)
{
    cout << "----------------------http start---------------------------" << endl;
    cout << req.inbuffer << std::endl;
    std::cout << "method: " << req.method << std::endl;
    std::cout << "url: " << req.url << std::endl;
    std::cout << "httpversion: " << req.httpversion << std::endl;
    std::cout << "path: " << req.path << std::endl;
    std::cout << "suffix: " << req.suffix << std::endl;
    std::cout << "size: " << req.size << std::endl; // req.size:客户端http请求报文的body大小,不是响应文件大小

    cout << "----------------------http end---------------------------" << endl;

    std::string respline = "HTTP/1.1 200 OK\r\n"; // HTTP响应【状态行】:协议版本+状态码+描述,❗当前bug:文件找不到时状态码仍然是200,应该改为404 Not Found
    // std::string respline = "HTTP/1.1 307 Temporary Redirect\r\n"; //重定向状态行

    // std::string respheader = "Content-Type: text/html\r\n";
    std::string respheader = suffixToDesc(req.suffix); // HTTP响应头:调用suffixToDesc根据文件后缀生成Content‑Type,告诉浏览器返回资源MIME类型

    if (req.size > 0)
    {
        respheader += "Content-Length: ";
        respheader += std::to_string(req.size);
        respheader += "\r\n";
    }

    // respheader += "Location: https://www.qq.com/\r\n"; //重定向响应头,指定跳转地址
    std::string respblank = "\r\n"; // HTTP协议规定:响应头结束后单独\r\n,作为【响应头和响应体的分隔符】,必不可少

    std::string body; // HTTP【响应体】,存放从磁盘读取的静态资源二进制数据(html/jpg/png/404页面)
    if(!Util::readFile(req.path,&body)) // 读取请求路径对应的磁盘文件,读取失败代表文件不存在
    {
        Util::readFile(html_404 , &body); // 文件不存在就读取404页面覆盖body;隐患:404.html本身丢失会导致body为空,缺少兜底
    }

    resp.outbuffer += respline;        // 拼接①状态行到输出缓冲区
    resp.outbuffer += respheader;      // 拼接②响应头集合到输出缓冲区
    resp.outbuffer += respblank;       // 拼接③头体分隔空行\r\n

    cout << "----------------------http response start---------------------------" << endl;
    std::cout << resp.outbuffer << std::endl;
    cout << "----------------------http response end---------------------------" << endl;

    resp.outbuffer += body;            // 拼接④响应体(文件二进制内容)到输出缓冲区,outbuffer就是完整待发送HTTP报文

    return true;
}

// ./httpServer 8080
int main(int argc, char *argv[])
{
    if(argc != 2)
    {
        Usage(argv[0]);
        exit(0);
    }
    uint16_t port = atoi(argv[1]);
    unique_ptr<HttpServer> httpsvr(new HttpServer(Get, port));

    // httpsvr->registerCb("/", Get); // 功能路由!注册不同方法根据不同的路径执行不同方法
    // httpsvr->registerCb("/search", Search);
    // httpsrv->registerCb("/test.py", Other);

    httpsvr->initServer();
    httpsvr->start();

    return 0;
}
该代码中的知识点:
suffixToDesc根据文件后缀生成Content-Type头,告诉浏览器返回资源的MIME类型。Get函数是回调函数,处理HTTP GET请求。respline是状态行,格式为HTTP/1.1 200 OK\r\n。respheader是响应头,包含Content-Type和Content-Length。respblank是空行,分隔响应头和响应体。body是响应体,从磁盘读取文件内容。readFile以二进制模式读取文件,支持图片等所有文件类型。resp.outbuffer是完整的HTTP响应报文,拼接了状态行、响应头、空行和响应体。
读取文件的工具函数:
cpp
// 二进制模式读取(支持图片/所有文件)
static bool readFile(const std::string& path, std::string* out)
{
    // 以二进制模式打开文件(ios::binary)
    std::ifstream in(path, std::ios::in | std::ios::binary);
    if (!in.is_open()) return false;

    // 获取文件大小(已在HttpRequest::parse中通过stat获取此处可复用)
    struct stat st;
    if (stat(path.c_str(), &st) != 0) return false;
    out->resize(st.st_size); // 预分配内存

    // 一次性读取所有二进制数据
    in.read(&(*out)[0], st.st_size);
    in.close();
    return true;
}
该代码中的知识点:
std::ifstream以二进制模式打开文件。stat获取文件大小。out->resize(st.st_size)预分配内存。in.read(&(*out)[0], st.st_size)一次性读取所有数据。- 返回false表示文件不存在或读取失败。
使用浏览器访问 http://localhost:8080 就能看到服务器返回的http请求。
第一行为 GET / HTTP/1.1
- 其中get就是我们请求的方法,一般来说利用浏览器访问服务器时会发送get请求。
- 当我们没有指定url时,会默认访问web根目录url:
/: web根目录,但是不一定是linux的根目录,而是我们自己指定的根目录。 - 其实web server是有自己的默认的首页的。
http请求会交换bs双方的协议版本,目的是为了根据协议版本来提供不同的服务。
请求第二行是 HOST: localhost:8080,就是我这个请求未来要发给哪个服务器。
第三行是 Connection: keep-alive,就是我这个请求未来要保持连接,不关闭连接。close 就是我这个请求未来要关闭连接。
第四行是 Upgrade-Insecure-Requests: 1,就是我这个请求未来要升级安全请求(这个我们不关心,有的服务器会要求我们升级安全请求)。
第五行是 User-Agent: Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/114.0.0.0 Safari/537.36,就是我这个请求未来要使用什么浏览器和主机的信息。
下一行就是 accept: text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,image/apng,*/*;q=0.8,application/signed-exchange;v=b3;q=0.7,就是我这个请求未来要接受的媒体类型,服务器会根据这个来判断要返回什么类型的响应。
下一行是 accept-encoding: gzip, deflate, br,就是我这个请求未来要接受的压缩类型,服务器会根据这个来判断要返回什么类型的压缩响应。
下一行就是 accept-language: zh-CN,zh;q=0.9,就是我这个请求未来要接受的语言,服务器会根据这个来判断要返回什么语言的响应。
其实我们还可以通过telnet指令来实现测试。
首先,我们使用telnet指令连接到服务器:
telnet localhost 8080然后 ctrl+] 进入telnet模式,然后回车,再手动发送http请求:
GET / HTTP/1.1\r\n就可以在服务端看到服务器返回的http请求为 GET / HTTP/1.1。
然后我们就可以在浏览器中查看服务器返回的响应了。
我们发现我们请求的时候明明请求的是 /,但是服务器返回的响应中是 /favicon.ico。这个其实是浏览器会自动请求的图标,服务器返回这个图标。
其实未来我们的服务器的根目录可以指定为任何目录,所以我们的服务器会创建一个目录来存放我们的网页。
那么我们怎么让别人访问我们的服务器的时候,不带路径的时候访问我们的默认目录呢?
cpp
// 3. 添加web默认路径 拼接我们的默认路径
path = default_root; // ./wwwroot,
path += url; //./wwwroot/a/b/c.html, ./wwwroot/ 这个目录下存放的就是资源了
// url可以先理解为对应服务端默认网页路径(网站根目录)下的特定物理文件;

// 因为可能会出现这样的情况我访问网页的时候不带任何其他的参数也就是url 那么我
// 接受到的请求的url就是 /  path += url就会得到./wwwroot/这个就不对了因为./wwwroot/是wwwroot下一级目录
// 可能有很多文件或者目录 所以我们要特殊处理一下这个
if(path[path.size()-1] == '/') path += home_page;
然后默认路径就在我们的结构体里面了作为一个成员变量了。
然后我们在我们的get方法里面可以拿到默认路径了。
但是我们硬编码我的的html显然不合理,所以我们去文件里面读出完整的html或者其他数据图片等等。
cpp
// 二进制模式读取(支持图片/所有文件)
static bool readFile(const std::string& path, std::string* out)
{
    // 以二进制模式打开文件(ios::binary)
    std::ifstream in(path, std::ios::in | std::ios::binary);
    if (!in.is_open()) return false;

    // 获取文件大小(已在HttpRequest::parse中通过stat获取此处可复用)
    struct stat st;
    if (stat(path.c_str(), &st) != 0) return false;
    out->resize(st.st_size); // 预分配内存

    // 一次性读取所有二进制数据
    in.read(&(*out)[0], st.st_size);
    in.close();
    return true;
}
但是我们如果读取的文件不存在,那么我们按照习惯来说会返回一个404页面。
cpp
std::string body; //我们不想直接在代码里面写 我们要从文件里面读
if(!Util::readFile(req.path,&body))
{
    Util::readFile(html_404 , &body); //访问没有的对象 跳转到404页面
}
我们在上层访问一个网页不是只发送一个http请求。
其实浏览器会根据网页里面的内容相应的去发起http请求访问特定的资源,所以会发起多个请求,多个请求里面包含的不止是网页。
所以我们直接返回html是有问题的。
我们根据 suffix: " << req.suffix 来判断浏览器要的是什么资源。
我们在返回的时候返回特定的资源:
cpp
std::string respheader = suffixToDesc(req.suffix);要根据我们要正确的给客户端返回资源类型,我们首先要自己知道!所有的资源都有后缀!!
cpp
std::string suffixToDesc(const std::string suffix)
{
    std::string ct = "Content-Type: ";
    if (suffix == ".html")
        ct += "text/html; charset=utf-8"; // 补充charset,避免中文乱码
    else if (suffix == ".jpg" || suffix == ".jpeg") // 兼容.jpg和.jpeg
        ct += "image/jpeg"; // 标准JPG图片MIME类型
    else if (suffix == ".png")
        ct += "image/png"; // 标准PNG图片MIME类型
    else if (suffix == ".gif")
        ct += "image/gif"; // 标准GIF图片MIME类型
    else
        ct += "application/octet-stream"; // 未知类型,默认二进制流
    ct += "\r\n";
    return ct;
}
本质就是你浏览器要什么资源,我判断好后帮你拼接好报头信息告诉浏览器我给返回的资源是什么类型的,浏览器好按照对应的方式读取。因为我们知道要访问的文件是什么,通过 readFile 就可以拿到对应的资源了,加到报文里面。