✨作者主页 :IT研究室✨
个人简介:曾从事计算机专业培训教学,擅长Java、Python、微信小程序、Golang、安卓Android等项目实战。接项目定制开发、代码讲解、答辩教学、文档编写、降重等。
☑文末获取源码☑
文章目录
一、前言
系统介绍
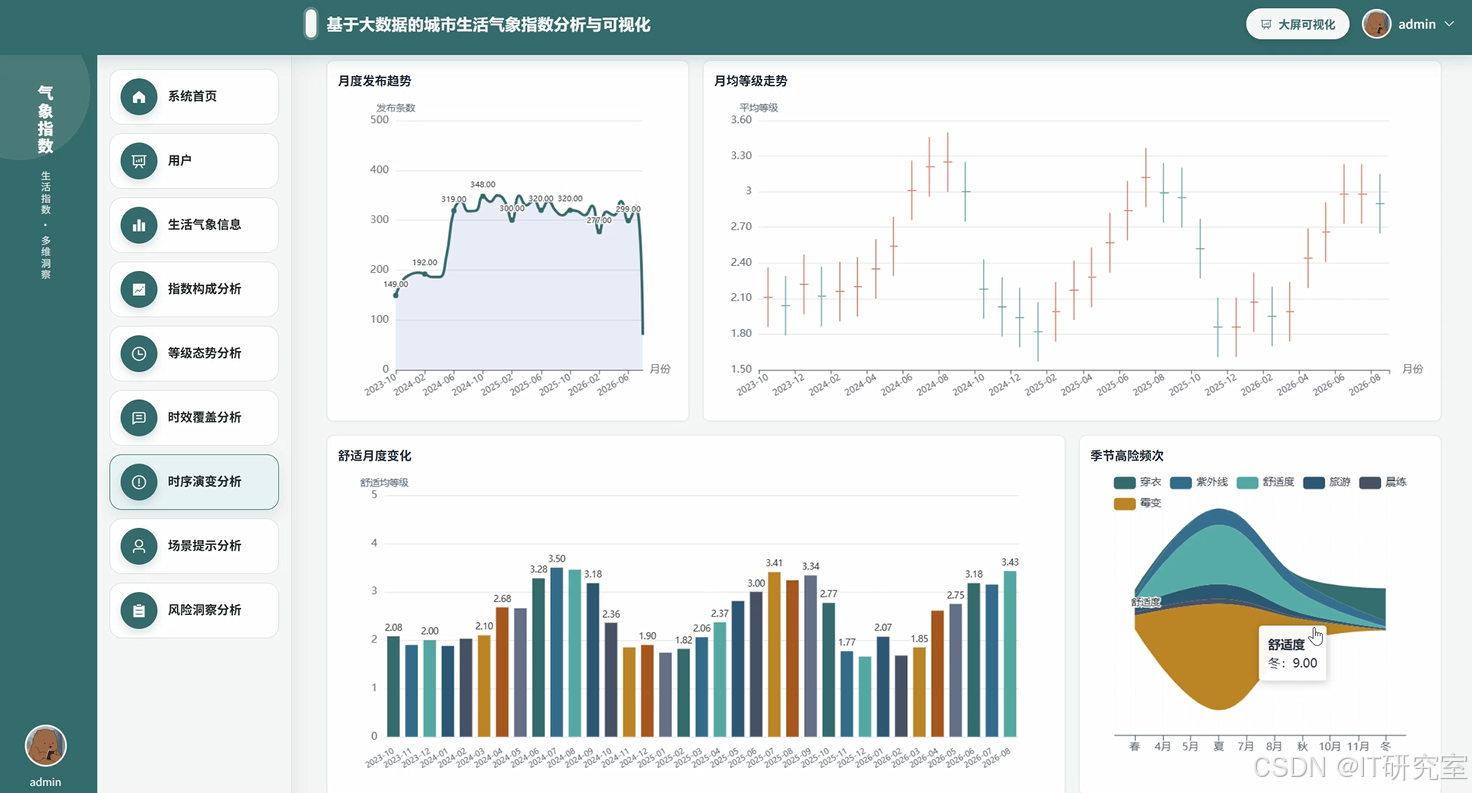
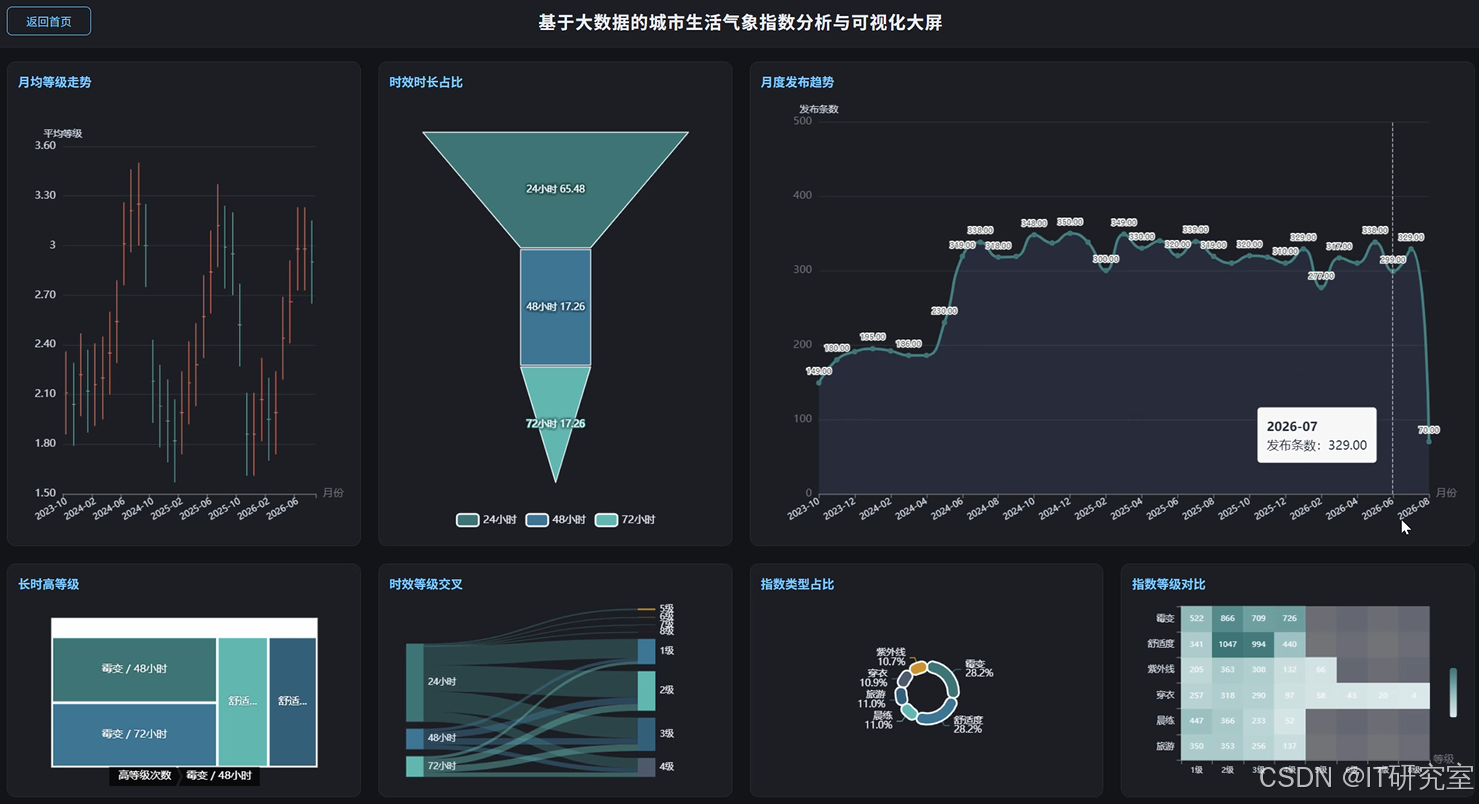
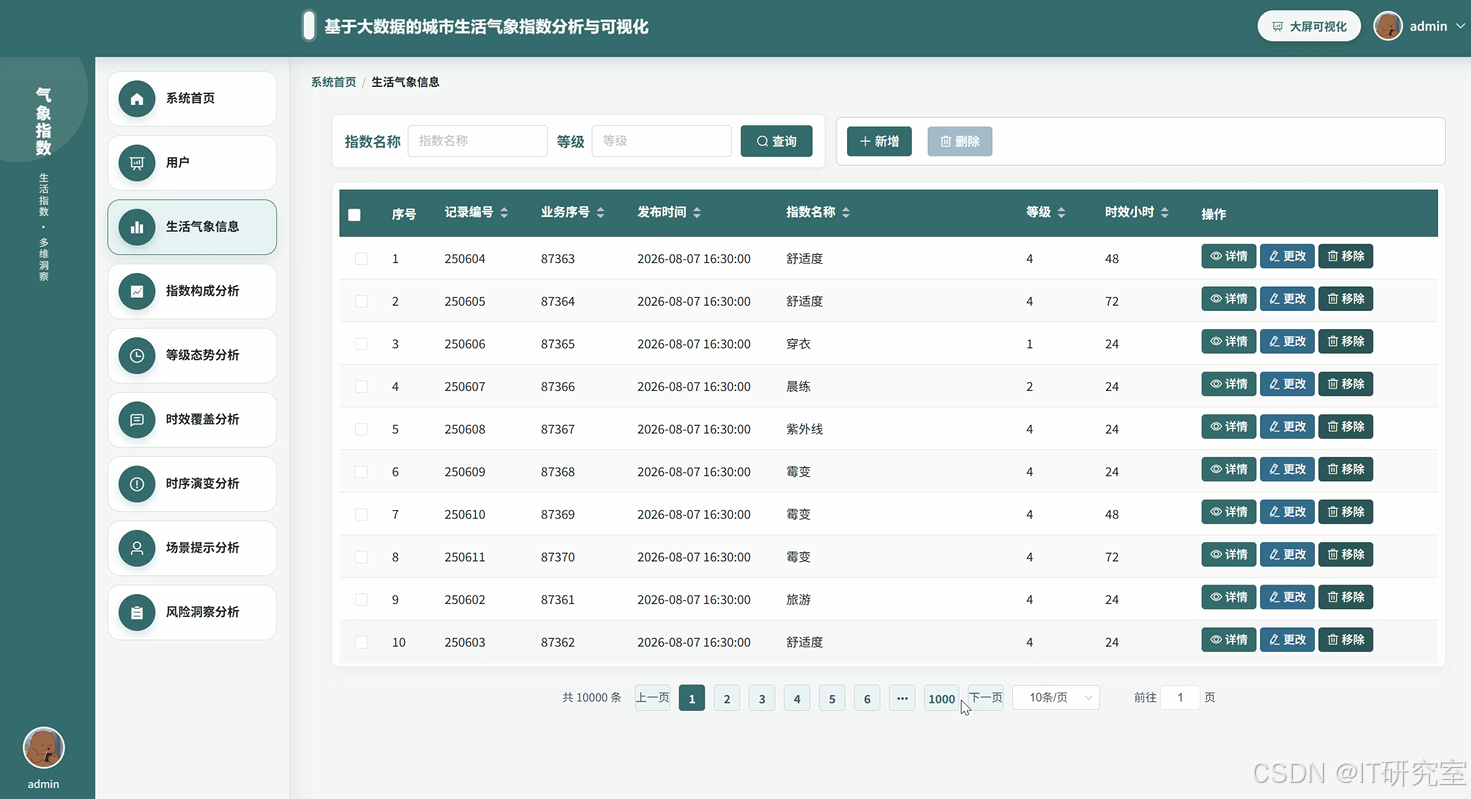
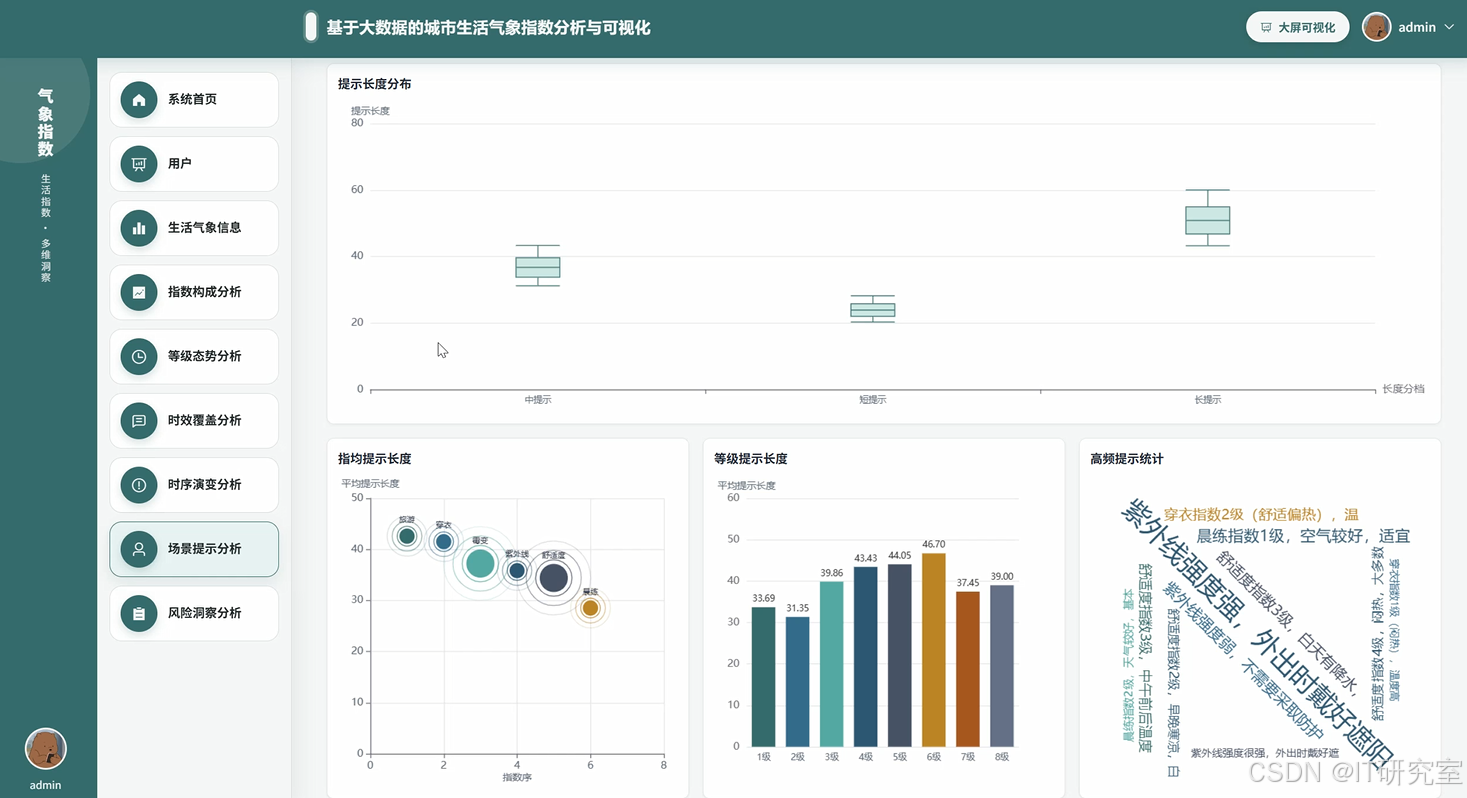
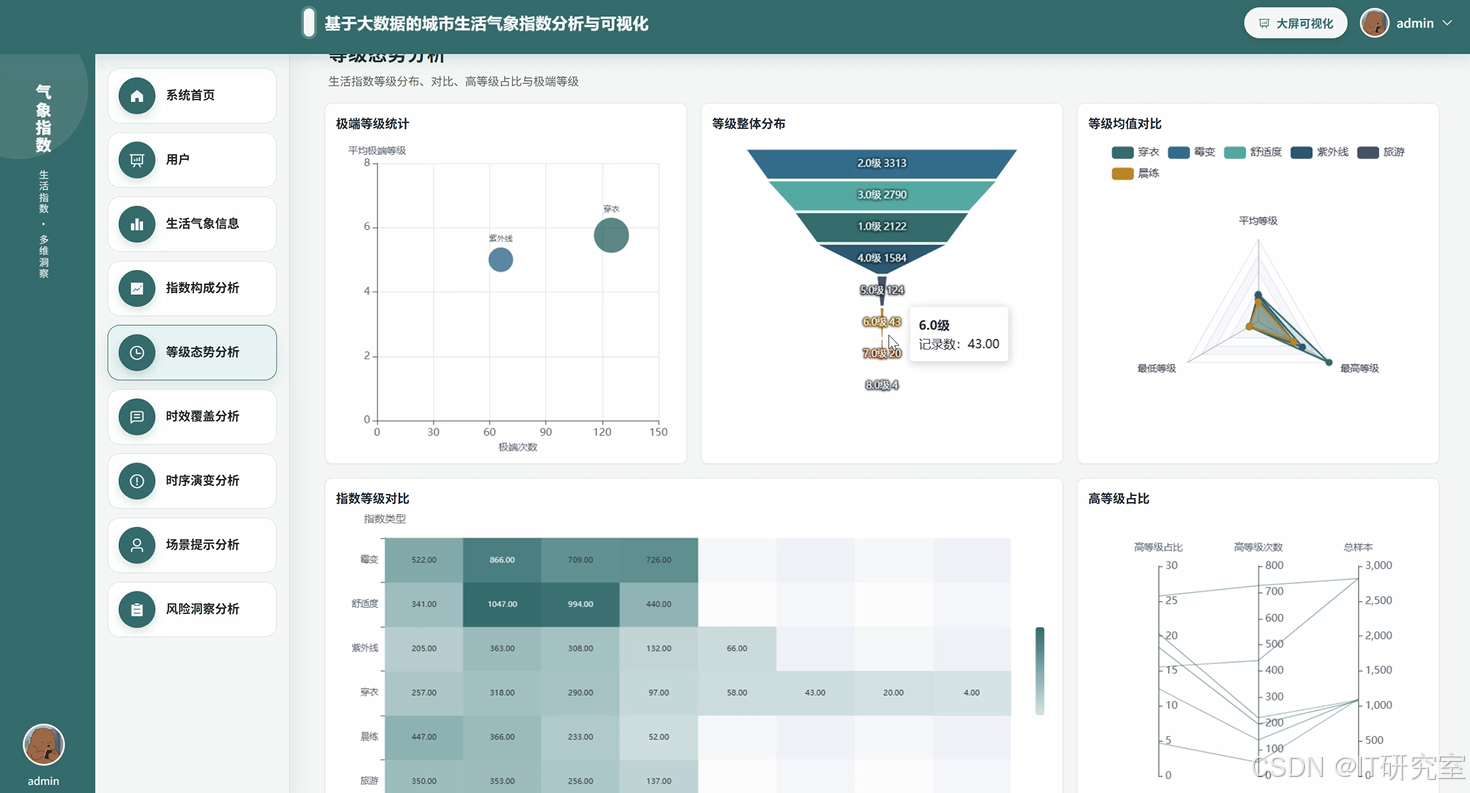
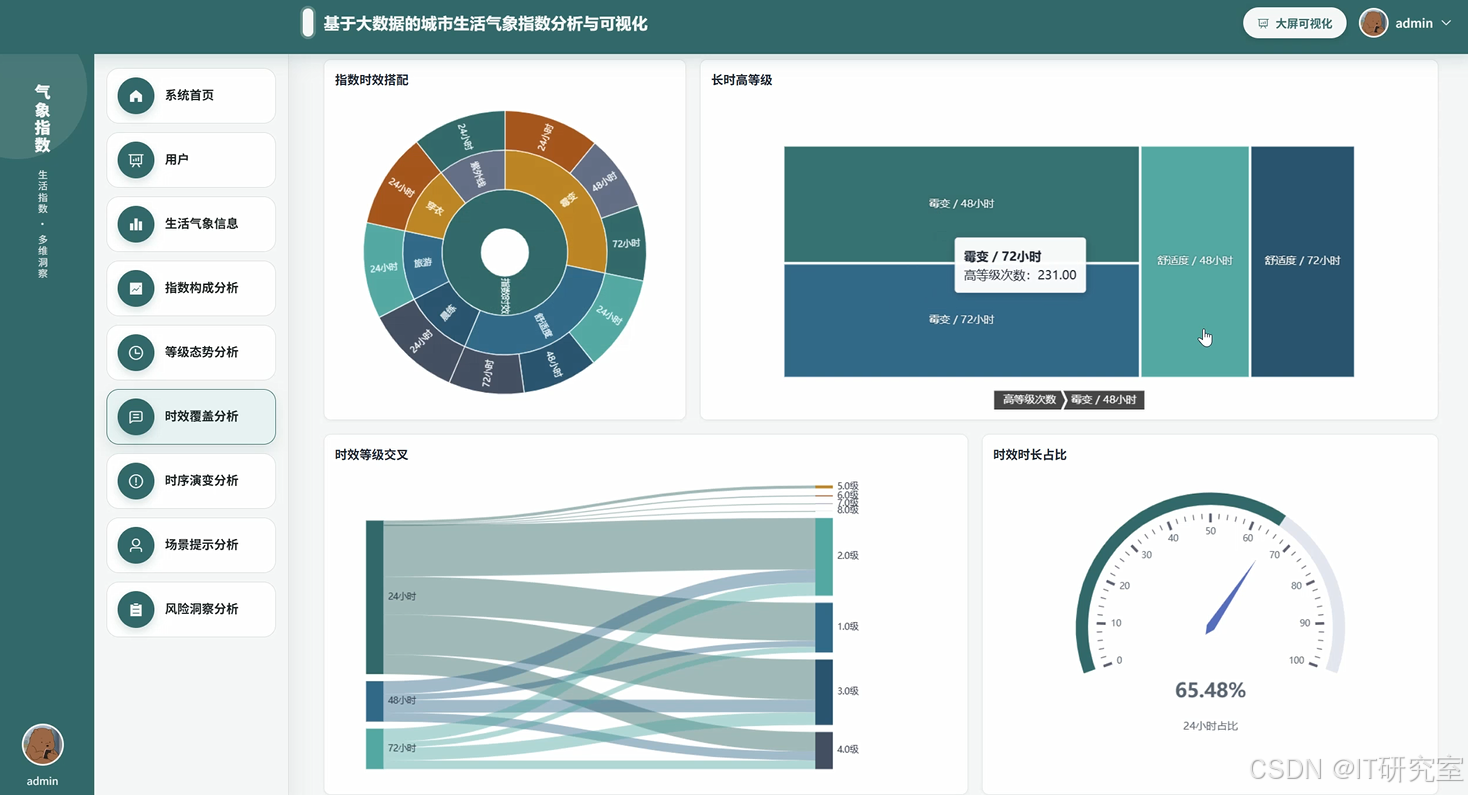
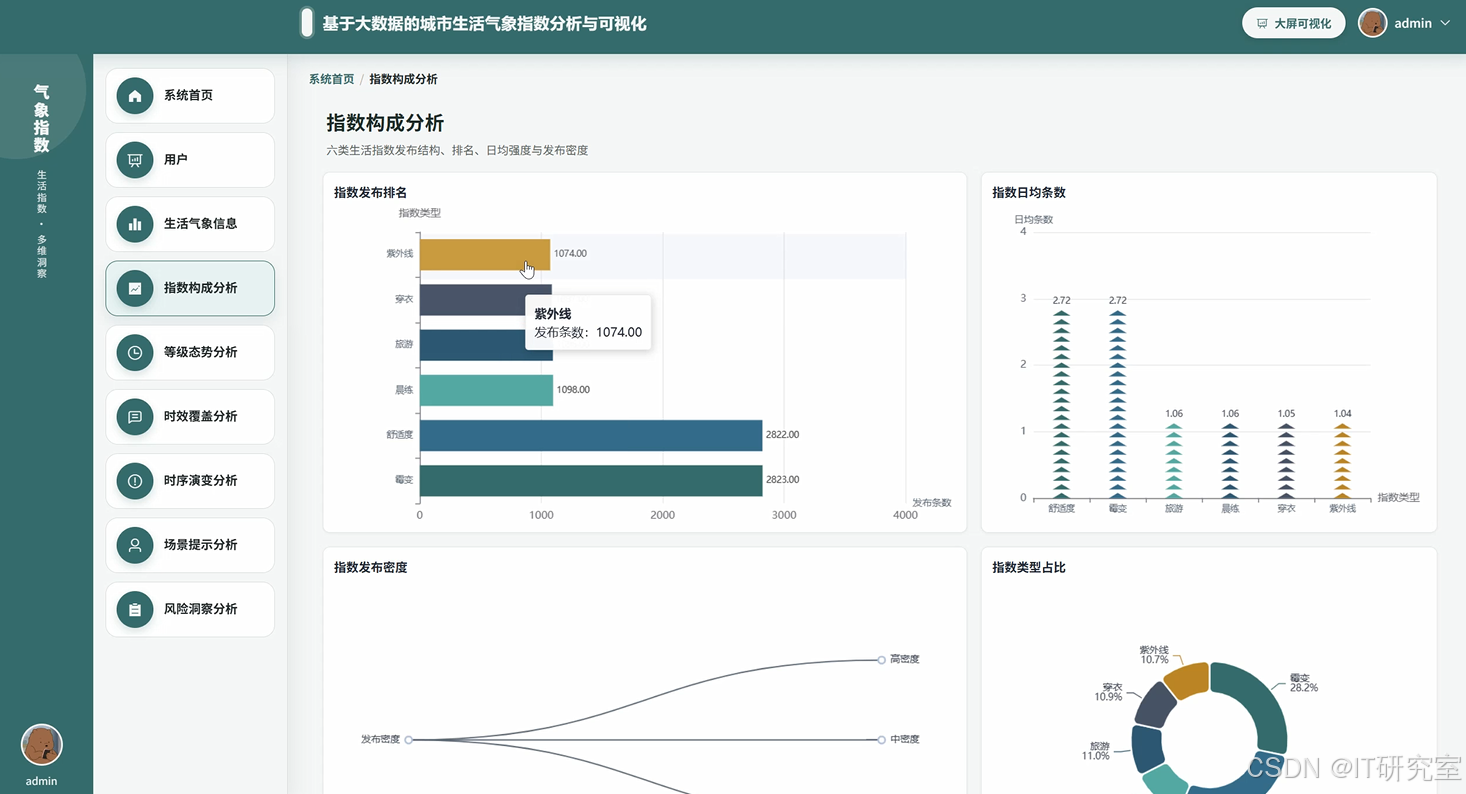
《基于大数据的城市生活气象指数分析与可视化》系统是一个面向城市居民日常出行与生活决策的大数据应用平台。系统以Hadoop分布式文件系统(HDFS)作为底层存储基础,依托Spark计算引擎对海量城市气象原始数据进行高效清洗、转换与聚合加工,并利用Spark SQL提供的结构化数据处理能力完成多维度指标运算。在此基础上,系统将计算结果持久化至MySQL关系型数据库,通过Spring Boot框架构建后端业务服务接口,前端采用Vue框架结合ECharts图表库实现气象指数数据的动态可视化呈现。系统功能覆盖生活气象信息的综合展示、指数构成的多维拆解、等级态势的区域对比、时效覆盖的时间粒度分析、时序演变的趋势挖掘、场景提示的规则匹配以及风险洞察的异常预警,旨在为城市居民提供直观、全面、可交互的生活气象指数参考服务。
选题背景
每年到了毕业设计选题的时候,总有不少计算机专业的学生一头雾水,不知道该选什么方向,更不清楚一个完整的项目到底该怎么做。市面上能找到的参考案例要么太理论化,要么用的技术栈陈旧,跟企业实际用到的大数据技术搭不上边。气象数据本身具有天然的海量特性,全国上百个城市逐小时的气象观测记录日积月累下来,数据量相当可观,这就给大数据技术的落地提供了合适的应用场景。用Hadoop加Spark这套主流的分布式计算框架去处理气象数据,把原始数据经过清洗、计算、聚合之后,再用直观的图表展示出来,整个过程刚好把大数据处理链条上的核心环节都串起来了。目前不少高校在毕设指导中缺乏贴近实际的大数据项目案例可以参考,学生做起来心里没底,也不知道从何入手。基于这样的现实情况,拿城市生活气象指数分析作为切入点来做这个系统,既能把大数据技术实实在在用上,又能给学生提供一个看得见摸得着的完整项目参考。
选题意义
从实际应用的角度来说,这个系统做出来对普通市民日常出行和生活安排确实有一定的参考价值。气象指数这东西平时大家都会关注,但是散落在各个平台上的信息太零散,不够集中,可视化程度也不高。把多个城市的气象数据整合到一个平台上,用图表把指数构成的逻辑、等级分布的态势、随时间变化的趋势这些信息直观展示出来,用户看一眼就能明白当前天气对生活的影响程度,省去了自己琢磨的麻烦。从学习的角度来讲,做这个系统能帮助掌握大数据处理的基本流程,从数据采集、存储、计算到展示,每个环节都得亲手去实现,对HDFS的读写操作、Spark的RDD和DataFrame编程、Spark SQL的查询优化这些技能都能在实际编码中加深理解。从教学参考的角度来看,这个项目可以作为一个比较完整的大数据毕设案例供后续的学生参考,至少知道一个正经的大数据项目应该长什么样、包含哪些模块,不至于在选题阶段完全摸不着方向。整个系统做下来,学到的技术和方法在今后的工作中也能用得上。
二、开发环境
- 大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
- 开发语言:Python+Java(两个版本都支持)
- 后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
- 前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
- 详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy
- 数据库:MySQL
三、系统界面展示
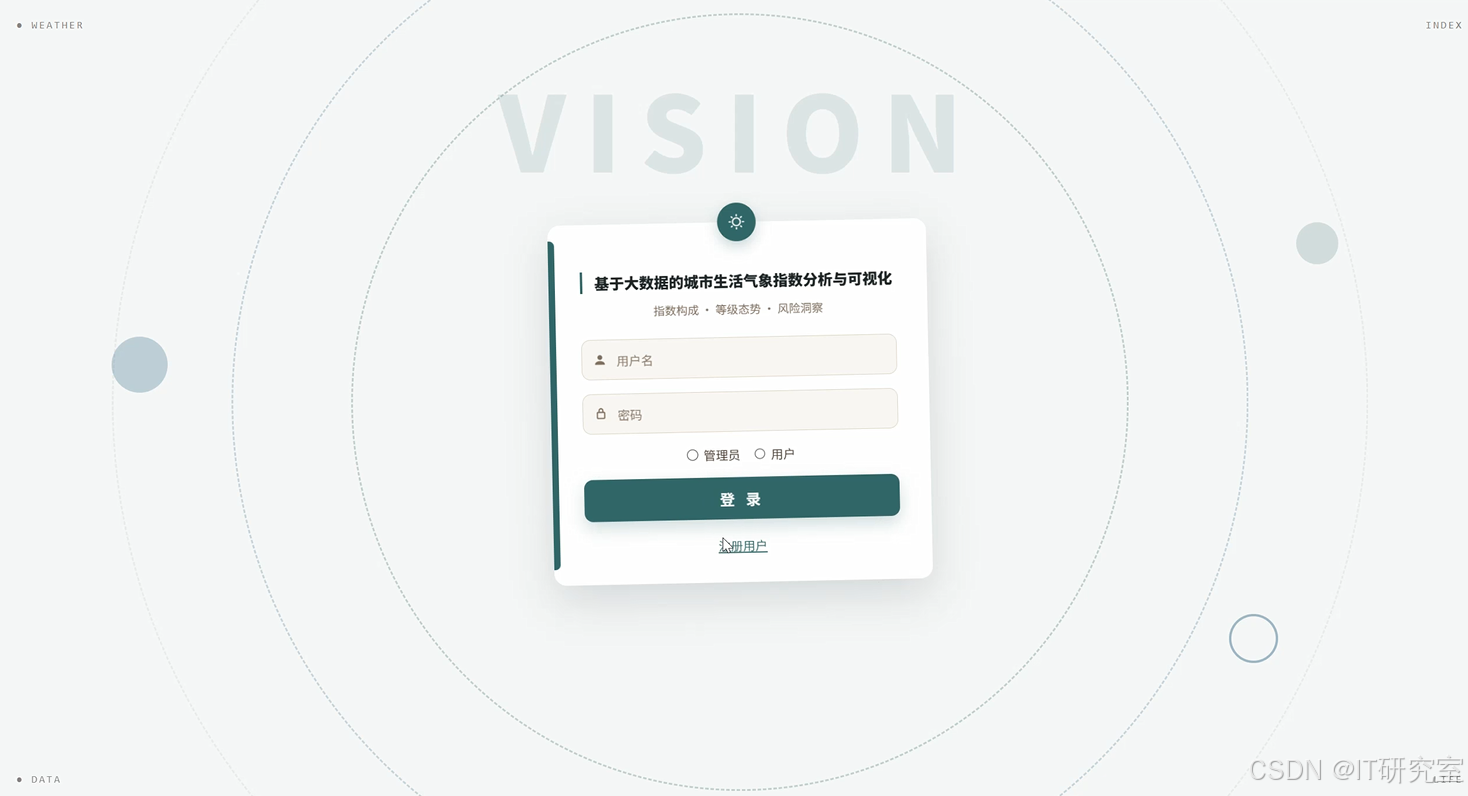
- 基于大数据的城市生活气象指数分析与可视化界面展示:
四、代码参考
- 项目实战代码参考:
java(贴上部分代码)
SparkSession spark = SparkSession.builder().appName("WeatherIndexAnalysis").master("local[*]").config("spark.sql.shuffle.partitions", "10").getOrCreate();
Dataset<Row> weatherDF = spark.read().option("header", true).option("inferSchema", true).csv("hdfs://localhost:9000/data/weather/*.csv");
Dataset<Row> cleanedDF = weatherDF.filter(weatherDF.col("temperature").isNotNull().and(weatherDF.col("humidity").isNotNull()).and(weatherDF.col("windSpeed").isNotNull())).filter(weatherDF.col("temperature").between(-50, 50)).filter(weatherDF.col("humidity").between(0, 100)).filter(weatherDF.col("windSpeed").between(0, 60)).dropDuplicates("city", "recordTime");
cleanedDF.createOrReplaceTempView("weather_data");
Dataset<Row> cityDailyAgg = spark.sql("SELECT city, DATE(recordTime) AS date, AVG(temperature) AS avgTemp, AVG(humidity) AS avgHumidity, AVG(windSpeed) AS avgWind, MAX(temperature) AS maxTemp, MIN(temperature) AS minTemp, COUNT(*) AS recordCount FROM weather_data WHERE recordTime >= DATE_SUB(CURRENT_DATE(), 30) GROUP BY city, DATE(recordTime) HAVING COUNT(*) >= 12");
cityDailyAgg.createOrReplaceTempView("city_daily");
Dataset<Row> comfortIndex = spark.sql("SELECT city, date, avgTemp, avgHumidity, avgWind, (100 - 0.5 * (avgTemp - 22) * (avgTemp - 22) - 0.3 * (avgHumidity - 50) * (avgHumidity - 50) - 0.2 * avgWind * avgWind) AS comfortScore, CASE WHEN (100 - 0.5 * (avgTemp - 22) * (avgTemp - 22) - 0.3 * (avgHumidity - 50) * (avgHumidity - 50) - 0.2 * avgWind * avgWind) >= 80 THEN '舒适' WHEN (100 - 0.5 * (avgTemp - 22) * (avgTemp - 22) - 0.3 * (avgHumidity - 50) * (avgHumidity - 50) - 0.2 * avgWind * avgWind) >= 60 THEN '较舒适' WHEN (100 - 0.5 * (avgTemp - 22) * (avgTemp - 22) - 0.3 * (avgHumidity - 50) * (avgHumidity - 50) - 0.2 * avgWind * avgWind) >= 40 THEN '一般' ELSE '不舒适' END AS comfortLevel FROM city_daily");
comfortIndex.createOrReplaceTempView("comfort_result");
Dataset<Row> trendAnalysis = spark.sql("SELECT city, date, avgTemp, LAG(avgTemp, 1) OVER (PARTITION BY city ORDER BY date) AS prevTemp, avgHumidity, LAG(avgHumidity, 1) OVER (PARTITION BY city ORDER BY date) AS prevHumidity, comfortScore, LAG(comfortScore, 1) OVER (PARTITION BY city ORDER BY date) AS prevScore FROM comfort_result");
Dataset<Row> trendChange = trendAnalysis.withColumn("tempTrend", functions.when(functions.col("avgTemp").gt(functions.col("prevTemp")), "上升").when(functions.col("avgTemp").lt(functions.col("prevTemp")), "下降").otherwise("平稳")).withColumn("comfortTrend", functions.when(functions.col("comfortScore").gt(functions.col("prevScore")), "改善").when(functions.col("comfortScore").lt(functions.col("prevScore")), "恶化").otherwise("稳定"));
trendChange.createOrReplaceTempView("trend_result");
Dataset<Row> riskAlert = spark.sql("SELECT city, date, avgTemp, avgHumidity, avgWind, comfortScore, comfortLevel, CASE WHEN avgTemp > 35 THEN '高温预警' WHEN avgTemp < -5 THEN '低温预警' WHEN avgHumidity > 85 AND avgTemp > 28 THEN '闷热预警' WHEN avgWind > 25 THEN '大风预警' WHEN comfortLevel = '不舒适' THEN '舒适度预警' ELSE '正常' END AS riskLevel FROM comfort_result WHERE comfortLevel = '不舒适' OR avgTemp > 35 OR avgTemp < -5 OR avgHumidity > 85 OR avgWind > 25");
Dataset<Row> levelDistribution = spark.sql("SELECT city, comfortLevel, COUNT(*) AS levelCount FROM comfort_result GROUP BY city, comfortLevel");
Dataset<Row> cityRanking = spark.sql("SELECT city, AVG(comfortScore) AS avgComfort, COUNT(CASE WHEN comfortLevel = '舒适' THEN 1 END) AS comfortableDays, COUNT(CASE WHEN comfortLevel = '不舒适' THEN 1 END) AS uncomfortableDays FROM comfort_result GROUP BY city ORDER BY avgComfort DESC");
Dataset<Row> timeCoverage = spark.sql("SELECT DATE(date) AS dayOfMonth, AVG(comfortScore) AS dailyAvgScore, MAX(comfortScore) AS dailyMax, MIN(comfortScore) AS dailyMin, COUNT(DISTINCT city) AS cityCount FROM comfort_result GROUP BY DATE(date) ORDER BY dayOfMonth");
Dataset<Row> sceneSuggestion = spark.sql("SELECT city, date, comfortLevel, avgTemp, avgHumidity, avgWind, CASE WHEN comfortLevel = '舒适' AND avgTemp BETWEEN 18 AND 25 THEN '适宜户外活动' WHEN comfortLevel = '较舒适' AND avgTemp BETWEEN 25 AND 30 THEN '注意防晒补水' WHEN comfortLevel = '一般' THEN '减少长时间户外' WHEN comfortLevel = '不舒适' THEN '建议室内活动' WHEN avgTemp > 35 THEN '避免高温时段出行' WHEN avgTemp < 0 THEN '注意防寒保暖' ELSE '正常出行' END AS sceneTip FROM comfort_result");
Dataset<Row> finalResult = sceneSuggestion.select("city", "date", "comfortLevel", "avgTemp", "avgHumidity", "avgWind", "sceneTip", "riskLevel");
finalResult.write().mode("overwrite").jdbc("jdbc:mysql://localhost:3306/weather_db", "weather_index_result", connectionProperties);
五、系统视频
基于大数据的城市生活气象指数分析与可视化项目视频:
结语
最新大数据毕业设计选题推荐-基于大数据的城市生活气象指数分析与可视化-大数据-Spark-Hadoop-Bigdata
想看其他类型的计算机毕业设计作品也可以和我说都有 谢谢大家!
有技术这一块问题大家可以评论区交流或者私我~
大家可以帮忙点赞、收藏、关注、评论啦~
源码获取:⬇⬇⬇