我排查过一条统计接口,SQL 没改、索引没动,只是把本该用的 UNION ALL 写成了 UNION,数据量过百万后,响应时间从 200ms 飙到 8 秒。
这篇不背"哪个更快"的死结论,只给你一套按表大小、索引和执行计划现场选型的判断框架,文末附决策速查表。
一、三个关键字,分别在解决什么问题?
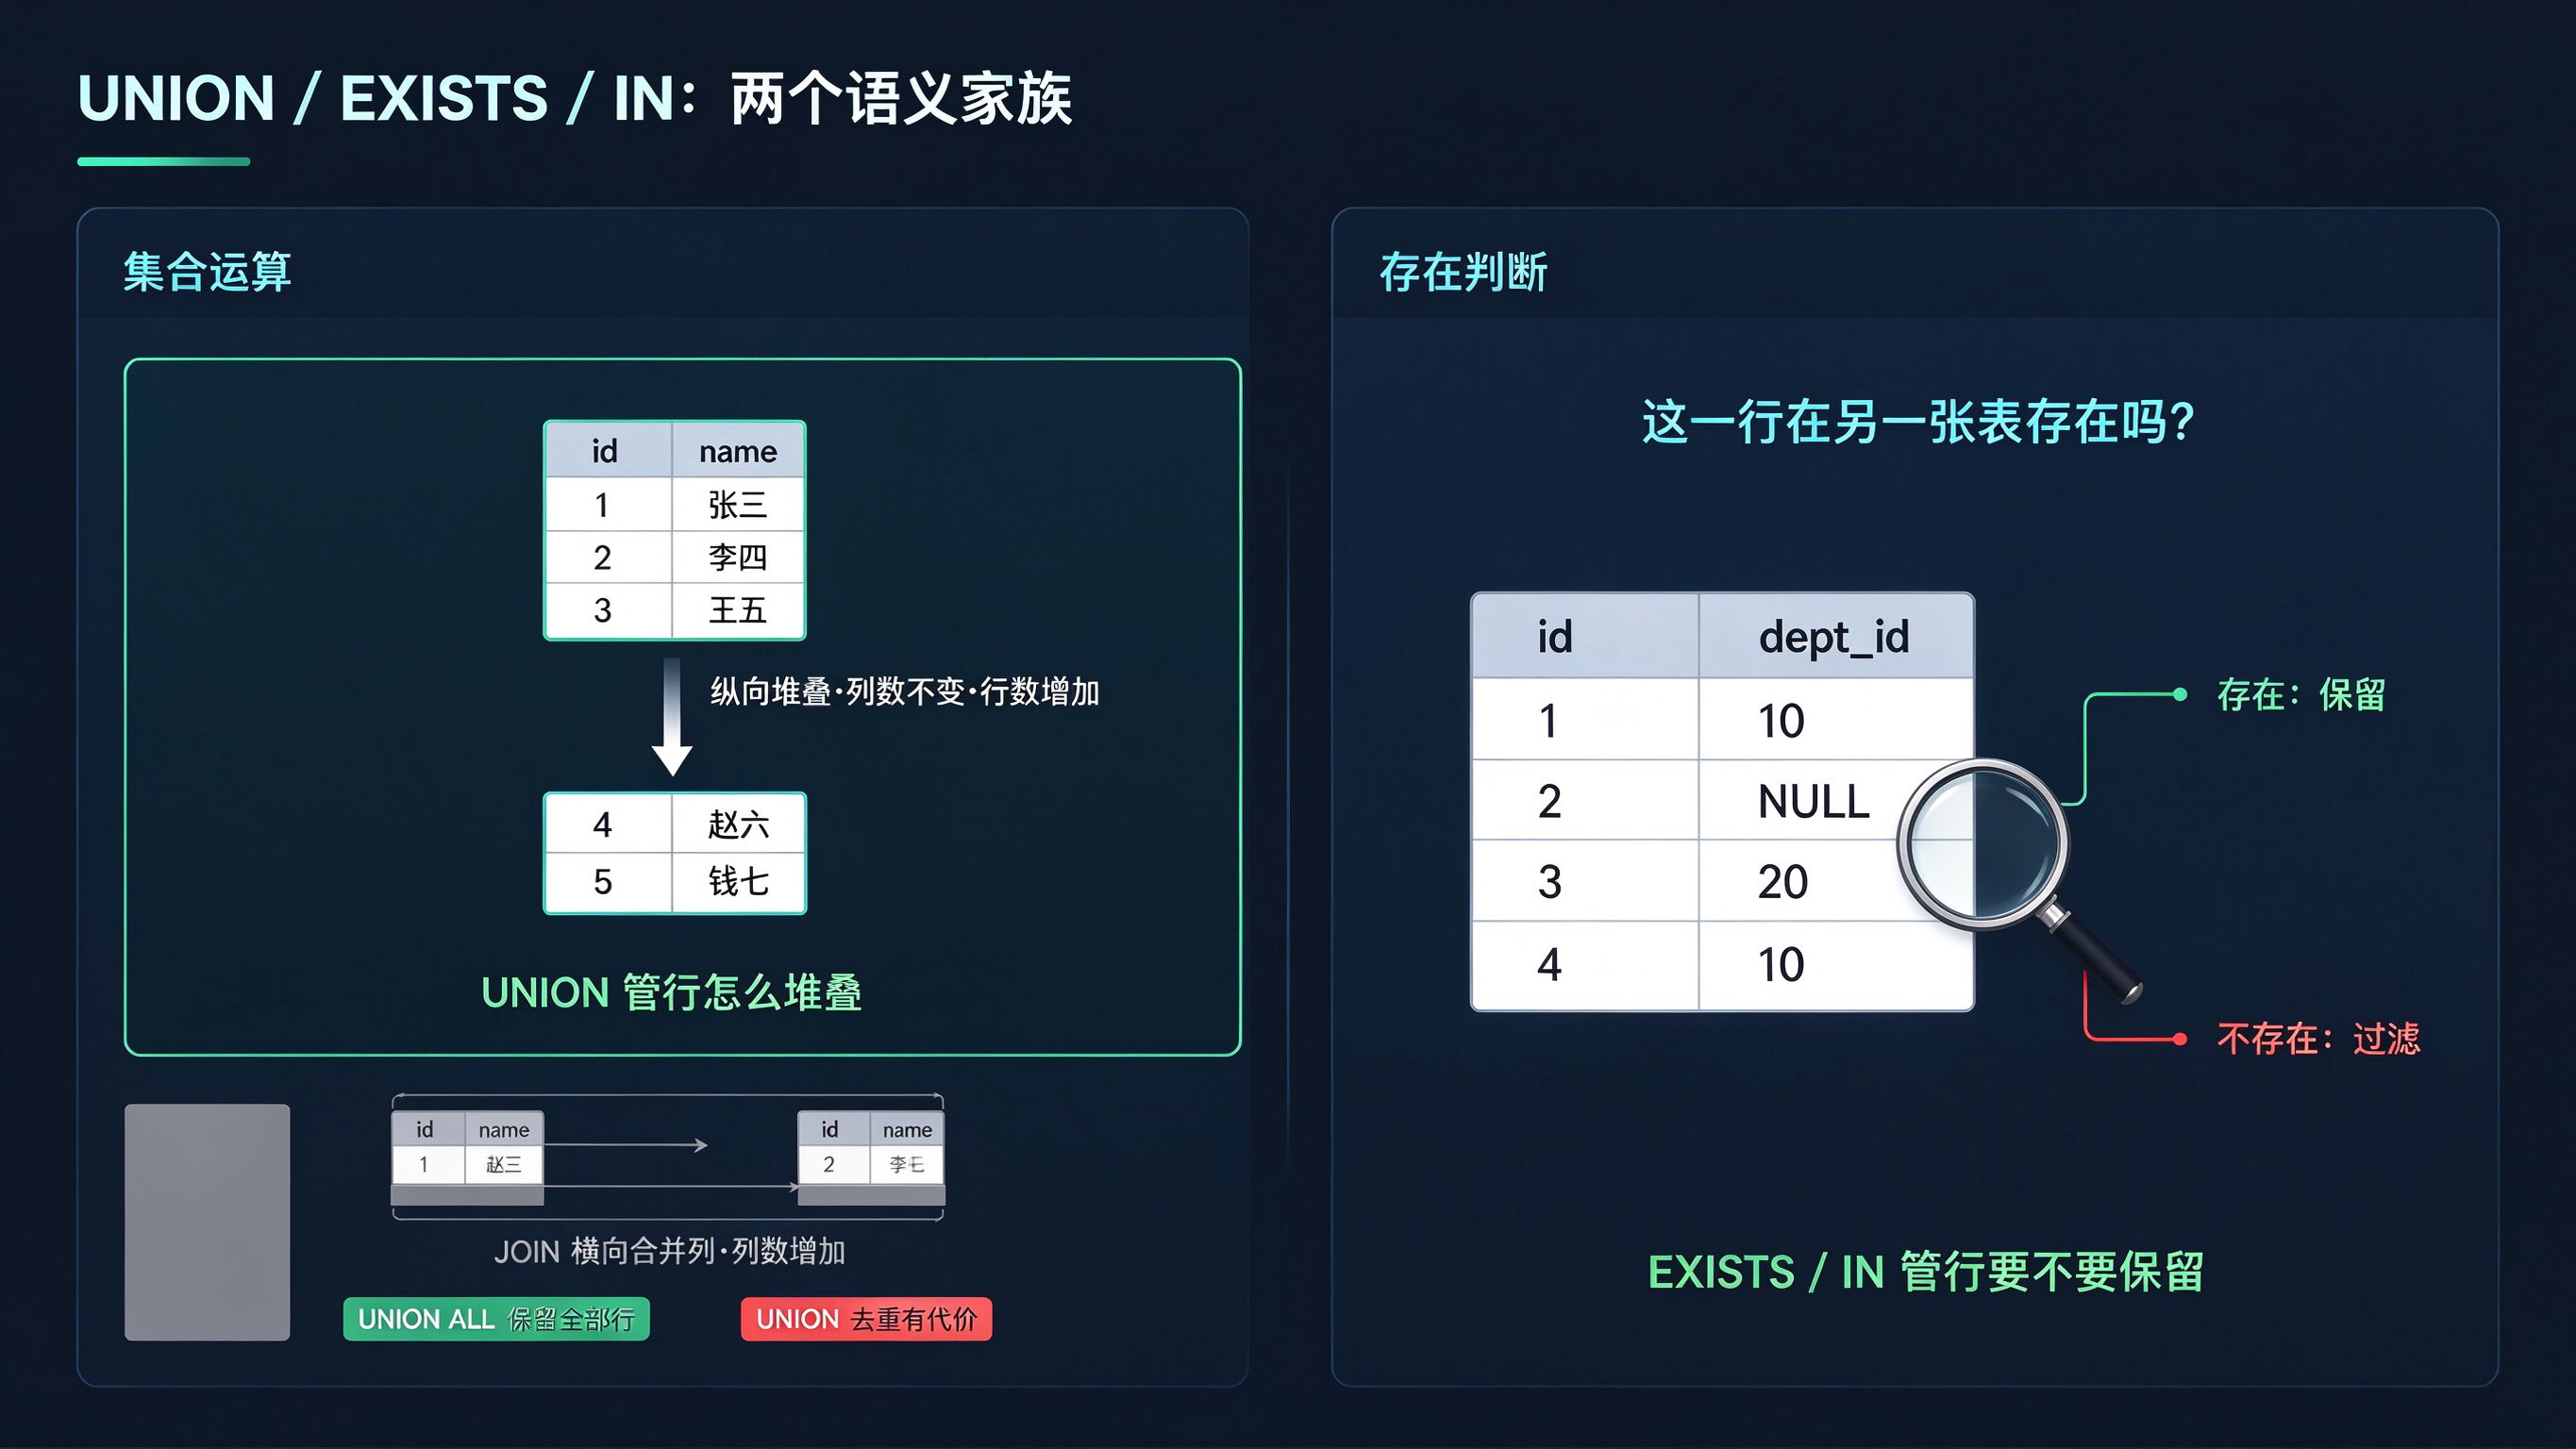
UNION、EXISTS、IN 出现频率极高,却分属两个语义家族。先把职责边界钉死,后面才不会混。
| 语义家族 | 关键字 | 回答的问题 | 结果集变化 |
|---|---|---|---|
| 集合运算 | UNION | 多个结果集怎么拼成一个 | 列数不变,行数增加 |
| 存在判断 | EXISTS / IN | 这一行在另一张表里存在吗 | 行被保留或过滤 |
之所以容易混,是因为三个关键字最终都产出"一个结果集",但数据流向完全不同:UNION 改变行数,EXISTS、IN 改变哪些行被保留。
我在代码评审里见过有人用 UNION 把部门名称"加"到员工行上,语句不报错,返回的却是逻辑全错的结果。横向加列是 JOIN 的活,UNION 只会纵向堆行。
注意:UNION 管"行怎么堆叠",EXISTS、IN 管"行要不要保留"。
二、UNION 和 UNION ALL,差的不只是重复行?
知道了 UNION 是堆行,那 UNION 和 UNION ALL 到底差在哪?UNION 合并后去除重复行,UNION ALL 保留全部行,去重从来不是免费动作。
UNION 能跑还依赖两条硬性规则,违反直接报错:
- 参与合并的每个查询必须返回相同数量的列。
- 对应列的数据类型必须兼容(允许隐式转换);列名不必一致,结果集采用第一个查询的列名。
| 对比项 | UNION | UNION ALL |
|---|---|---|
| 重复行 | 去除 | 全部保留 |
| 内部动作 | 排序或哈希,逐行比较 | 直接拼接 |
| 成本特征 | 排序 O(n log n),可能溢磁盘 | 接近线性 |
| 适用场景 | 业务明确要求去重 | 确定无重复,或重复无害 |
sql
SELECT id, name FROM employee
UNION
SELECT id, name FROM employee_history;
我那次慢查询就踩在这:合并后的数据超过 work_mem,排序溢出到磁盘,这是 UNION 在数据增长后突然变慢的最常见原因。哈希去重对中等数据量通常更快,但哈希表同样要驻留内存。
至于走排序还是走哈希,同样由基数估计决定;行数估算偏差大时,连去重方式都会选错。
注意:确定两个结果集无重复(或重复不影响业务),就用 UNION ALL。
三、EXISTS 和 IN,数据库分别怎么跑?
拼接的坑说完,再看存在判断。EXISTS 和 IN 能回答同一个问题,执行路径却完全不同。
| 对比项 | IN | EXISTS |
|---|---|---|
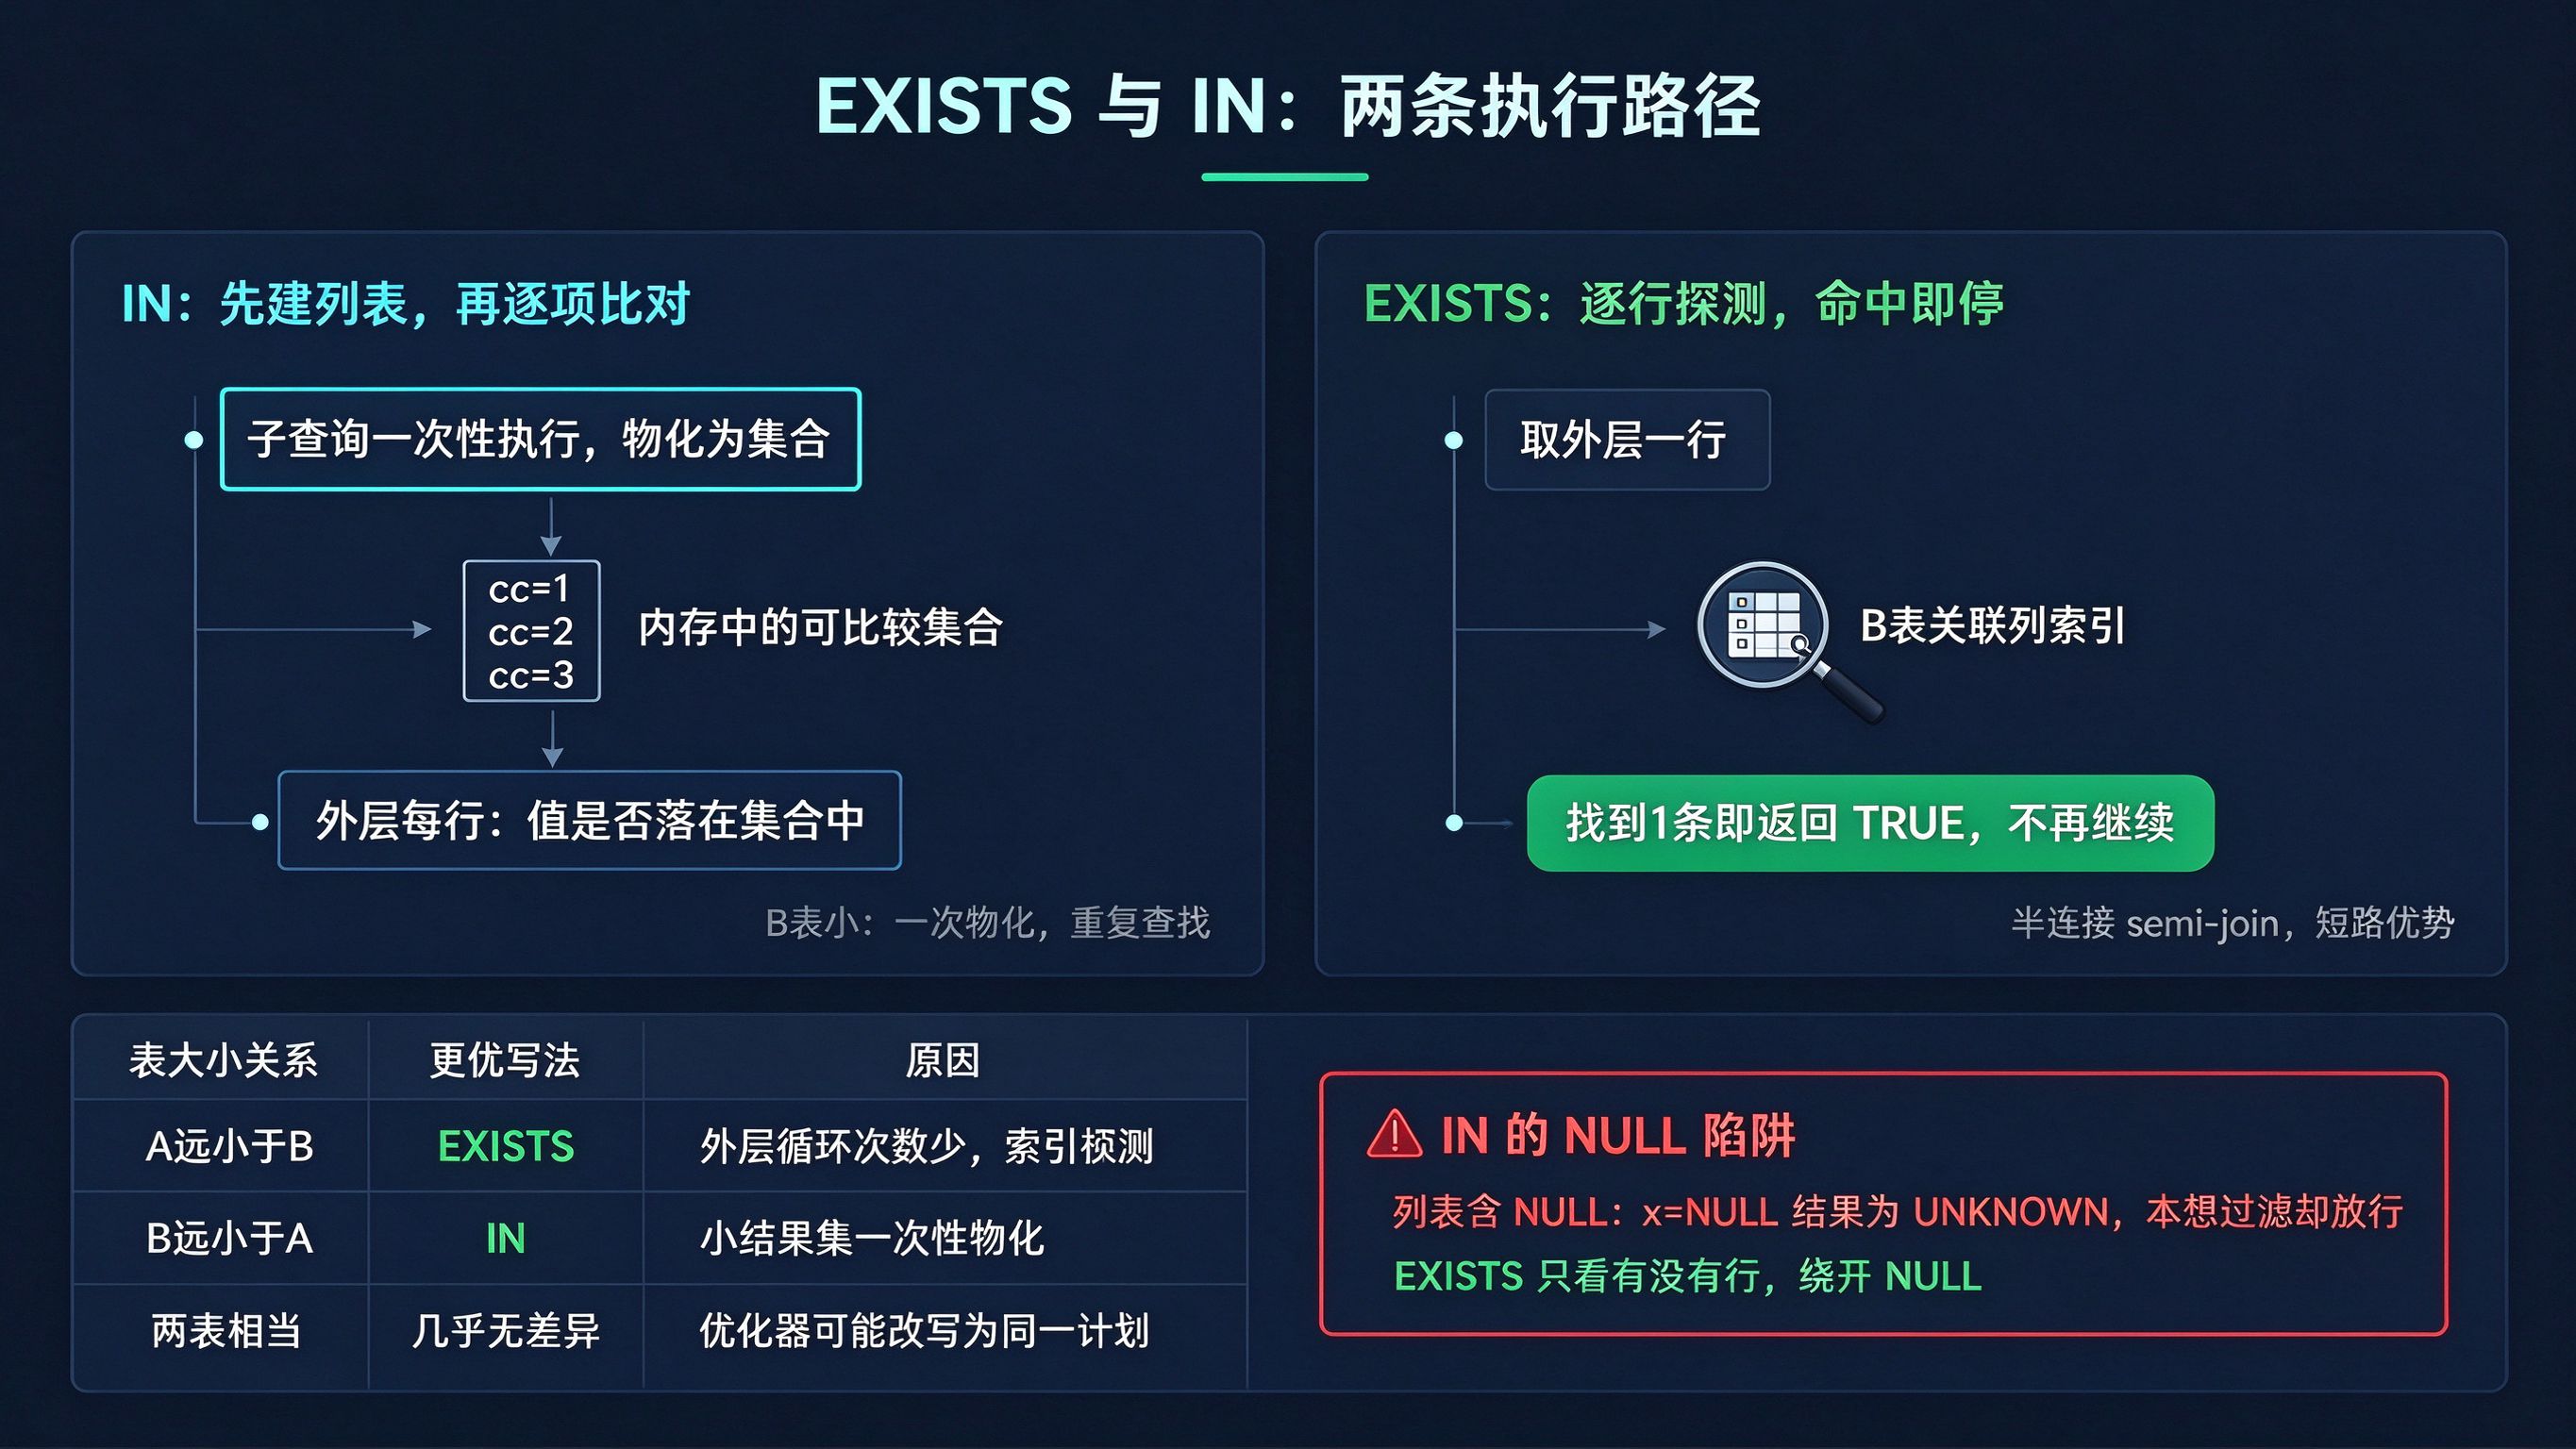
| 执行方式 | 先建列表,再逐项比对 | 逐行探测,命中即停 |
| 子查询 | 一次性物化为集合 | 关联子查询,逐行执行 |
| 优化器实现 | 可改写为半连接 | 半连接(semi-join) |
| NULL 处理 | 列表含 NULL 会异常放行 | 只看有无行,绕开 NULL |
IN 先把结果物化成一个可比较集合,再对外层每行做成员判断;EXISTS 以半连接(semi-join)实现,外层每行只需在内部找到一个匹配。这个差异在关联子查询里最明显:子查询引用了外层列(如 B.cc = A.cc)时,EXISTS 每行可走一次索引查找、命中即停,IN 必须先收集完整个子查询结果,无法短路。
latex
IN    : 子查询物化集合 ──> 外层每行查集合(一次建表,反复查找)
EXISTS: 外层取一行 ──> 关联列索引探测 ──> 命中1条即停(短路)
sql
SELECT * FROM A WHERE A.cc IN (SELECT cc FROM B);

SELECT * FROM A
WHERE EXISTS (SELECT 1 FROM B WHERE B.cc = A.cc);
WHERE x IN (1, 2, NULL) 中,x = NULL 的结果是 UNKNOWN 而非 FALSE,整行可能不被过滤,本意是过滤却放行了更多行。EXISTS 只关心有没有行返回,不比较具体值,天然绕开这个坑。
IN 后接字面量列表(如 IN (1,2,3))时只构建常量集合,真正涉及物化的是后接子查询。更狠的是 NOT IN:子查询一旦含 NULL,整个结果直接为空,因为每行判断都退化成 UNKNOWN,而 NOT EXISTS 不受影响。
注意:EXISTS 命中即停,且不与 NULL 比较,涉及可空列时更安全。
四、到底选哪个?让小集合待在外层
执行路径清楚了,落到 A、B 两张表上怎么选?核心就一件事:控制循环的层级。
| 表大小关系 | 更优写法 | 原因 |
|---|---|---|
| A 远小于 B | EXISTS | 外层循环少,B 表索引探测 |
| B 远小于 A | IN | 小结果集一次物化,内存查找 |
| 两表相当 / 数据量小 | 几乎无差异 | 优化器可能改写成同一计划 |
A 远小于 B 时,EXISTS 近似"遍历 A、每行去 B 探测",外层次数少;B 远小于 A 时,IN 把子查询结果一次性物化,对 A 的每行做内存集合查找,避免反复深入 B。
量级上最直观:A 一万行、B 一千万行时,EXISTS 只触发一万次索引探测;若用 IN,则要先物化一千万行,内存和耗时都被大结果集拖死。
注意:选型的本质是控制循环层级,让小集合待在外层。
五、为什么这些规则有时不灵?
那为什么按规则选了,查询还是慢?因为性能从不由语法单独决定,优化器会改写查询,也会误判。
现代优化器会把 IN 改写为半连接,甚至把 EXISTS 改写为哈希连接。一旦被改写成同一形态,两种写法耗时几乎没有差别,纠结语法就失去意义。我查到两组对比鲜明的实测:
| 场景 | 实测现象 | 执行计划 |
|---|---|---|
| PostgreSQL,约 1431 条匹配 | IN 约 66ms,显式 JOIN 约 65ms | Hash IN Join |
| SQL Server,9000 万行大表 | IN 跑数小时,改 INNER JOIN 约 10 秒 | 前者误用嵌套循环 |
真正决定计划走向的,是下面三个因素:
| 因素 | 作用 | 缺失后果 |
|---|---|---|
| 关联列索引 | 支撑 EXISTS 逐行探测 | 无索引退化为全表扫描 |
| 统计信息 | 基数估计驱动算法选择 | 统计过时,选错计划 |
| 优化器版本 | IN / EXISTS 互相改写 | 旧版本可能不走半连接 |
同理,把 EXCEPT 改写为 NOT EXISTS 之前,必须确认两侧比较列都有索引;没有索引,反连接(anti-join)会对每行外层记录做完整扫描,可能是最差的执行计划。
注意:脱离索引、数据量和执行计划谈"谁更快",都是空谈。
六、落到具体 SQL,怎么验证?
与其记"总是用 EXISTS",不如走一套可重复的验证流程。
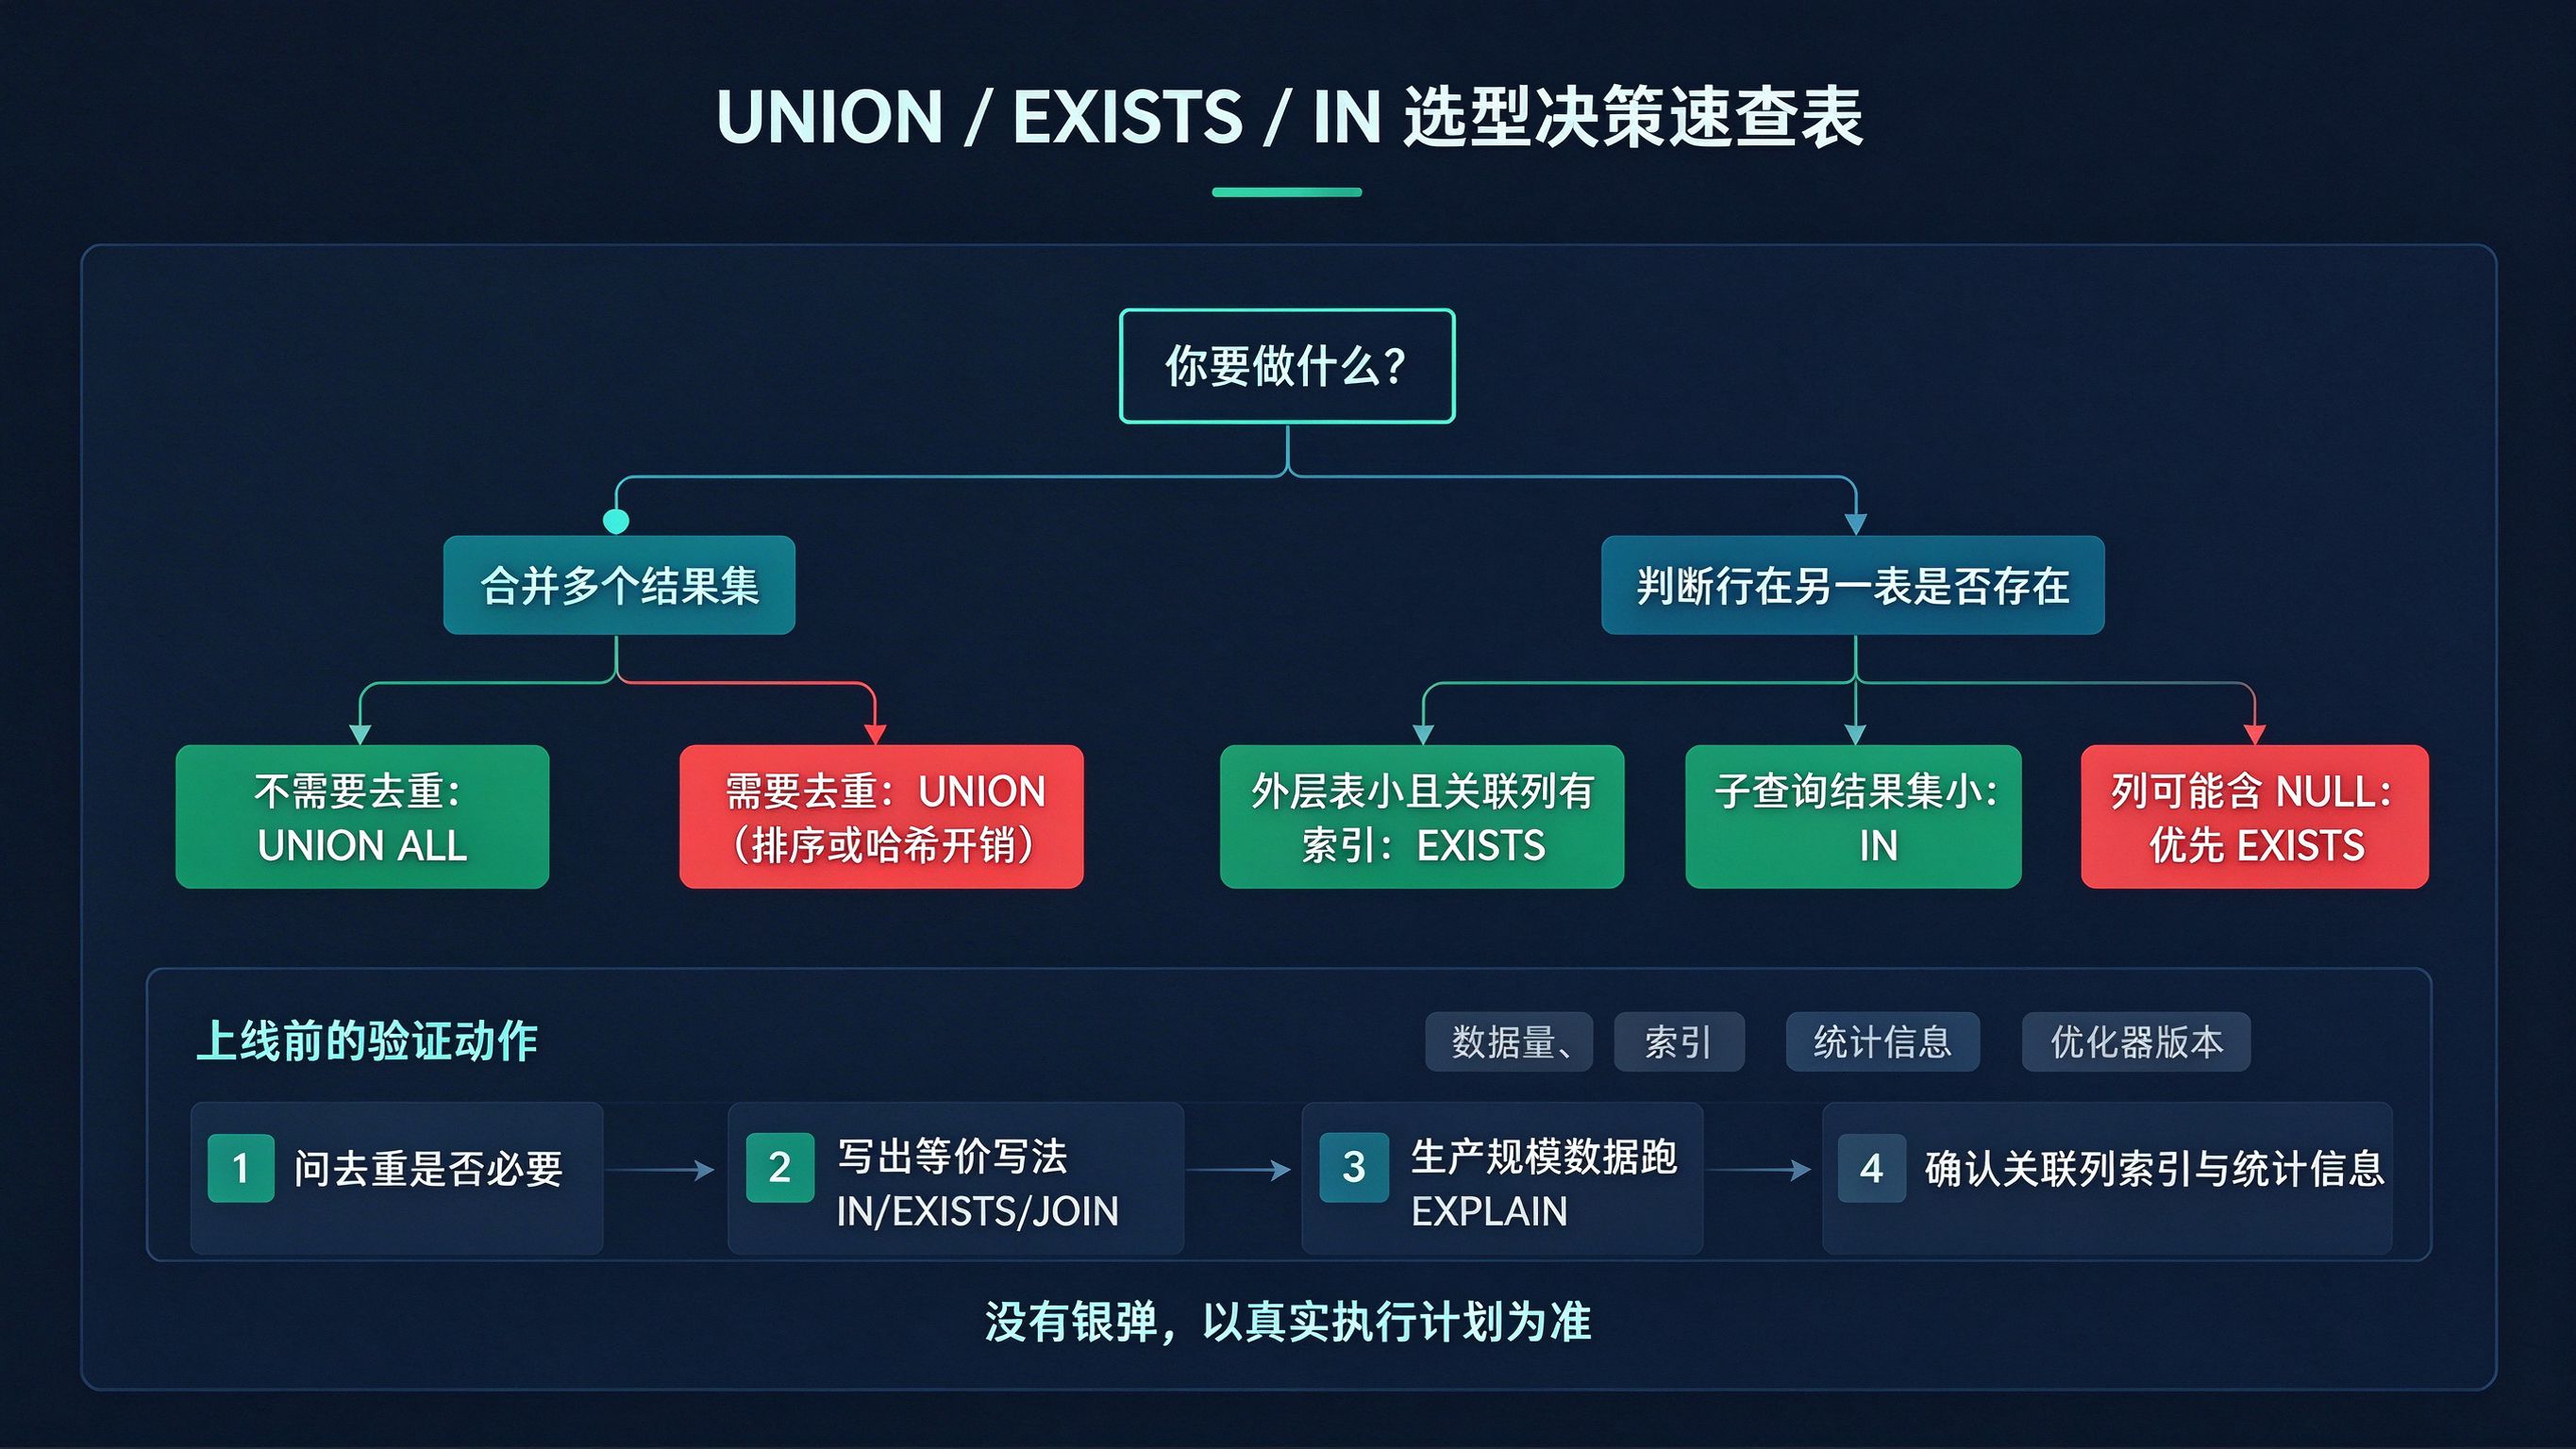
- 先问去重是否必要,不需要就写
UNION ALL。 - 把关键查询的 IN / EXISTS / JOIN 等价写法都写出来。
- 在生产规模数据上跑执行计划,别用教学小表下结论。
- 确认关联列索引与统计信息,再决定用哪个写法。
sql
EXPLAIN (ANALYZE, BUFFERS)
SELECT * FROM A
WHERE EXISTS (SELECT 1 FROM B WHERE B.cc = A.cc);
需要补索引或刷新统计信息时,执行:
sql
CREATE INDEX idx_b_cc ON B (cc);
ANALYZE B;
看计划时重点确认三件事:关联探测是否走了索引、有没有 Sort 溢出磁盘或全表扫描、估算行数与实际行数是否接近;行数偏差过大说明统计信息过时,先跑 ANALYZE 再判断。
对比两种写法时,只看同一份数据、同一份统计下的总耗时和扫描行数,别拿一次冷缓存的结果下结论。
七、总结
UNION 管"行怎么堆叠",要警惕不必要的去重开销;EXISTS 和 IN 管"行要不要保留",要理解半连接的短路优势和 NULL 语义陷阱。
术语速查表
| 术语 | 英文 | 含义 |
|---|---|---|
| 集合运算 | Set Operation | 纵向拼接多个结果集 |
| 存在性判断 | Existence Check | 判断行是否在另一结果集中存在 |
| 半连接 | Semi-join | 外层每行只需在内部找到一个匹配 |
| 关联子查询 | Correlated Subquery | 引用外层表列的子查询 |
| 基数估计 | Cardinality Estimate | 优化器对结果行数的预估 |
| 统计信息 | Statistics | 表数据分布信息,驱动计划选择 |
最终决策依据,永远是你的数据、你的索引、你的执行计划,而不是某条放之四海皆准的规则。一句话收口:先分清是"拼结果"还是"判存在",再用表大小和索引定写法,用执行计划拍板。
参考链接