《Agentic Design Patterns》第 3 章导读:并行化(Parallelization)
本文是对开源书籍《Agentic Design Patterns》第 3 章的解读与导读,内容忠实呈现原文,并附个人思考。
原书在线阅读:https://adp.xindoo.xyz/ | 翻译项目代码仓库:https://github.com/xindoo/agentic-design-patterns
前两章我们讲了提示词链 (顺序工作流)和路由 (动态分流)。但现实中的很多复杂智能体任务,其实藏着大量可以同时做、没必要排队等的子任务。比如要调研一个主题,明明可以同时去搜多个来源;要分析一批客户反馈,明明可以同时跑情感分析、关键词提取、分类......这时候,一条道走到黑的顺序执行,就是在白白浪费时间。
这正是第 3 章**并行化(Parallelization)**模式的价值:把互相独立的任务并发执行,显著压缩总耗时。
一、什么是并行化:让独立任务"同时跑"
并行化指的是并发执行多个组件------可以是多个 LLM 调用、多次工具使用,甚至是整个子智能体。它不是"串行等待每一步完成再走下一步",而是让独立任务一起开工。
书中用一个"调研并总结"的例子对比了两种做法:
顺序方法(慢):
- 搜索来源 A
- 总结来源 A
- 搜索来源 B
- 总结来源 B
- 基于摘要 A 和 B 合成最终答案
并行方法(快):
- 同时搜索来源 A 和来源 B
- 两个搜索完成后,同时总结来源 A 和来源 B
- 合成最终答案(这一步通常仍需顺序执行,要等前面的并行步骤走完)
核心思想一句话:找出那些不依赖彼此输出、可以齐头并进的环节,把它们并行掉。 这在对方是 API、数据库这类有延迟的外部服务时尤其划算------多个请求同时发出去,等回来的总时间就摊薄了。
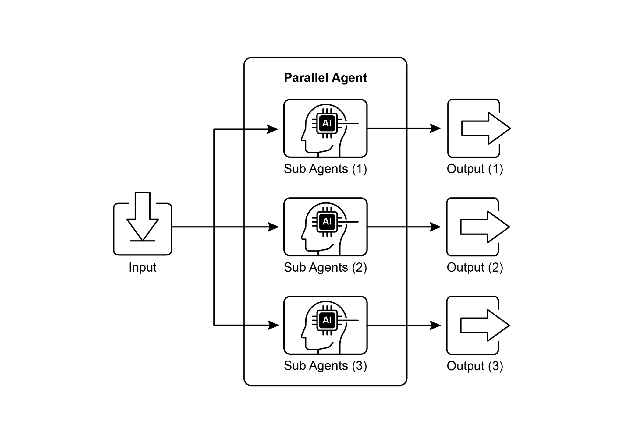
图 1:带有子智能体的并行化示例------多个研究员智能体被并发调度。
二、7 个典型应用场景
书中给出了 7 个很接地气的用例,我整理成速览表:
| 场景 | 并行任务 | 收益 |
|---|---|---|
| 信息收集与研究 | 同时搜新闻、取股票数据、监控社媒、查数据库 | 更快拿到全面视图 |
| 数据处理与分析 | 对反馈条目同时做情感分析、关键词提取、分类、紧急识别 | 快速输出多维分析 |
| 多 API / 工具交互 | 同时查航班价、酒店、当地活动、餐厅推荐 | 更快拼出完整旅行方案 |
| 多组件内容生成 | 同时生成邮件主题、正文、配图、行动号召按钮 | 高效组装成品 |
| 验证与核实 | 同时校验邮箱、手机号、地址库匹配、不当内容检测 | 更快给出有效性反馈 |
| 多模态处理 | 同时分析文本情感词 + 图像对象场景 | 更快速整合多模态洞察 |
| A/B 测试 / 多选项 | 用不同提示词/模型同时生成多个标题变体 | 便于快速对比选优 |
这些场景有个共同点:子任务之间彼此独立、且都受外部 I/O 或算力延迟的影响。它们是并行化的最佳土壤。
三、代码实战一:用 LangChain(RunnableParallel)并行
LangChain 并行执行的基石是LangChain 表达式语言(LCEL) 。方法是在一个字典或列表结构里组织多个可运行组件,当这些组件被喂给链条后续环节时,LCEL 就并发 执行它们。对应构造叫 RunnableParallel。
python
import os
import asyncio
from typing import Optional
from langchain_openai import ChatOpenAI
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import Runnable, RunnableParallel, RunnablePassthrough

llm: Optional[ChatOpenAI] = ChatOpenAI(model="gpt-4o-mini", temperature=0.7)

## --- 定义三个可并行执行的独立链 ---
summarize_chain: Runnable = (
    ChatPromptTemplate.from_messages([
        ("system", "简洁地总结以下主题:"),
        ("user", "{topic}")
    ])
    | llm
    | StrOutputParser()
)

questions_chain: Runnable = (
    ChatPromptTemplate.from_messages([
        ("system", "生成关于以下主题的三个有趣问题:"),
        ("user", "{topic}")
    ])
    | llm
    | StrOutputParser()
)

terms_chain: Runnable = (
    ChatPromptTemplate.from_messages([
        ("system", "从以下主题中识别 5-10 个关键术语,用逗号分隔:"),
        ("user", "{topic}")
    ])
    | llm
    | StrOutputParser()
)

## --- 1. 并行任务块:三个链同时跑,原始 topic 透传 ---
map_chain = RunnableParallel(
    {
        "summary": summarize_chain,
        "questions": questions_chain,
        "key_terms": terms_chain,
        "topic": RunnablePassthrough(),
    }
)

## --- 2. 综合提示词:把三个并行结果汇总 ---
synthesis_prompt = ChatPromptTemplate.from_messages([
    ("system", """基于以下信息:
    摘要:{summary}
    相关问题:{questions}
    关键术语:{key_terms}
    综合一个全面的答案。"""),
    ("user", "原始主题:{topic}")
])

## --- 3. 完整链:并行块 → 综合提示词 → LLM → 输出解析 ---
full_parallel_chain = map_chain | synthesis_prompt | llm | StrOutputParser()

async def run_parallel_example(topic: str) -> None:
    response = await full_parallel_chain.ainvoke(topic)
    print(response)

if __name__ == "__main__":
    asyncio.run(run_parallel_example("太空探索的历史"))
逻辑拆解 :map_chain 用 RunnableParallel 把"总结、提问、提术语"三条链并发跑起来,同时用 RunnablePassthrough 保留原始主题;三个结果齐了之后,再交给一个综合提示词做最终的整合------这就是典型的 "并行收集 + 串行综合" 结构。
技术提示:书里特别点明,
asyncio提供的是并发(concurrency)而非真正的并行(parallelism)------它靠事件循环在单线程上等网络请求时切换任务,制造"同时进行"的效果,仍受 Python GIL 限制。所以这里的加速大多来自"等待外部 API 时别空转"。
四、代码实战二:用 Google ADK(ParallelAgent + SequentialAgent)
Google ADK 提供了更原生的多智能体并行机制,其中两个关键原语是 ParallelAgent(并发跑子智能体)和 SequentialAgent(按序拼流水线)。
python
from google.adk.agents import LlmAgent, ParallelAgent, SequentialAgent
from google.adk.tools import google_search

GEMINI_MODEL = "gemini-2.0-flash"

## --- 1. 三个研究员子智能体(各自负责一个主题分支)---
researcher_agent_1 = LlmAgent(
    name="RenewableEnergyResearcher", model=GEMINI_MODEL,
    instruction="研究'可再生能源'的最新进展,用 Google 搜索,1-2 句话总结你的主要发现,*只*输出摘要。",
    tools=[google_search], output_key="renewable_energy_result"
)
researcher_agent_2 = LlmAgent(
    name="EVResearcher", model=GEMINI_MODEL,
    instruction="研究'电动汽车技术'的最新发展,用 Google 搜索,1-2 句话总结,*只*输出摘要。",
    tools=[google_search], output_key="ev_technology_result"
)
researcher_agent_3 = LlmAgent(
    name="CarbonCaptureResearcher", model=GEMINI_MODEL,
    instruction="研究'碳捕获方法'的当前状态,用 Google 搜索,1-2 句话总结,*只*输出摘要。",
    tools=[google_search], output_key="carbon_capture_result"
)

## --- 2. 并行执行三个研究员 ---
parallel_research_agent = ParallelAgent(
    name="ParallelWebResearchAgent",
    sub_agents=[researcher_agent_1, researcher_agent_2, researcher_agent_3],
    description="并行运行多个研究智能体以收集信息。"
)

## --- 3. 合并智能体:把并行结果综合成结构化报告 ---
merger_agent = LlmAgent(
    name="SynthesisAgent", model=GEMINI_MODEL,
    instruction="""
    综合以下研究摘要,清楚地将发现归属于其来源领域。
    输入摘要:可再生能源:{renewable_energy_result}
    电动汽车:{ev_technology_result}
    碳捕获:{carbon_capture_result}
    *只*基于上面提供的信息输出结构化报告,不要添加外部知识。""",
    description="将并行智能体的研究发现组合成结构化报告。"
)

## --- 4. 顺序流水线:先并行研究,再综合报告 ---
sequential_pipeline_agent = SequentialAgent(
    name="ResearchAndSynthesisPipeline",
    sub_agents=[parallel_research_agent, merger_agent],
    description="协调并行研究并综合结果。"
)

root_agent = sequential_pipeline_agent
关键点 :三个研究员用 ParallelAgent 并发跑,各自通过 output_key 把结果写进会话状态;等全部完成后,merger_agent 再读出状态、把它们拼成一份带归属的报告;最后 SequentialAgent 把"先并行、后合并"两端串成一个整体流程。这再次印证了**"并行收集、串行综合"**的经典编排思路。
五、速览
- 问题背景:很多智能体工作流包含多个必须完成才能达成目标的子任务。纯顺序执行每个任务都要等前一个完成,通常低效又慢;当任务依赖外部 I/O(调不同 API、查多个库)时,延迟成为主要瓶颈------总耗时等于所有单任务耗时之和。
- 解决方案:识别工作流中不依赖彼此输出的组件(工具使用或 LLM 调用),让它们并发执行。框架(LangChain、Google ADK)提供内置构造来定义管理这些并发操作(如主进程并行调多个子任务,等全部完成再继续)。
- 实践建议:当工作流包含多个可同时运行的独立操作时使用此模式,例如从多个 API 取数据、处理不同数据块、或生成多个内容片段供后续综合。
可视化总结
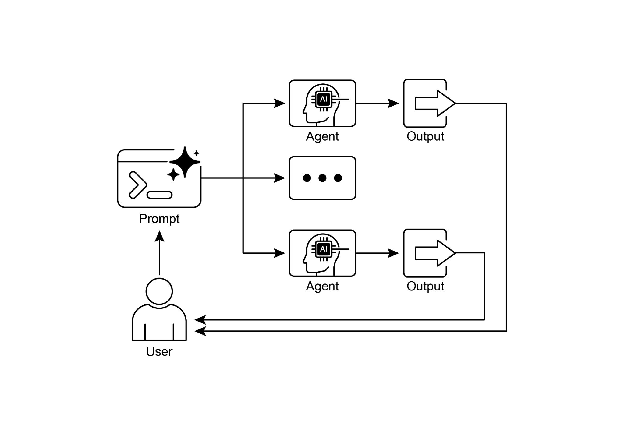
图 2:并行化设计模式------独立子任务并发执行,待全部完成后汇聚到下游。
关键要点
- 并行化是通过并发执行独立任务来提升效率的模式;
- 在处理涉及等待外部资源(如 API 调用)的任务时尤其有效;
- 并发/并行架构会引入显著复杂性和成本,影响设计、调试与系统日志等关键环节------不是免费的午餐;
- LangChain 用
RunnableParallel、LCEL 提供并行支持;Google ADK 则通过 LLM 驱动的多智能体委托(协调器识别独立子任务并触发子智能体并发处理)实现并行; - 并行化有助于减少整体延迟,让系统在处理复杂任务时更具响应性。
结语与个人思考
第 3 章其实是前两章的"提速器":顺序用链条、分流用路由、能并行的就并行。把这三种控制流结合起来,就能搭出既有条理、又高性能的复杂系统------这句话几乎是全书方法论的一条主线,后面很多高级模式都是它的变体。
但也要清醒地看到并行的代价,这正是书中诚实指出的地方:
- 收益有边界:并行只对"彼此独立"的任务有效。一旦某个步骤必须依赖前面跑完的结果(比如综合报告必须等三个研究员都出结论),就得停下来等------所以现实中几乎都是"并行 + 顺序"混合编排。
- 成本很真实:并发引入的竞态、状态同步、日志错乱、调试复杂度,都会随着子任务数量上升。并行不是越多越好,而是要"该并行才并行"。
- 别混淆并发与并行 :像 Python 的
asyncio本质是并发(单线程事件循环),对 I/O 等待型任务友好;真要吃满多核做 CPU 密集计算,还得靠多进程或专门的并行运行时。
下一步建议阅读第 4 章 反思(Reflection)------从"怎么把任务编排得更快、更顺"转向"怎么让模型自己审一遍再交付",是提升输出质量的关键一环。
本文基于开源书籍《Agentic Design Patterns》(https://github.com/xindoo/agentic-design-patterns ,在线阅读 https://adp.xindoo.xyz/ )整理,供学习交流,版权归原作者所有。