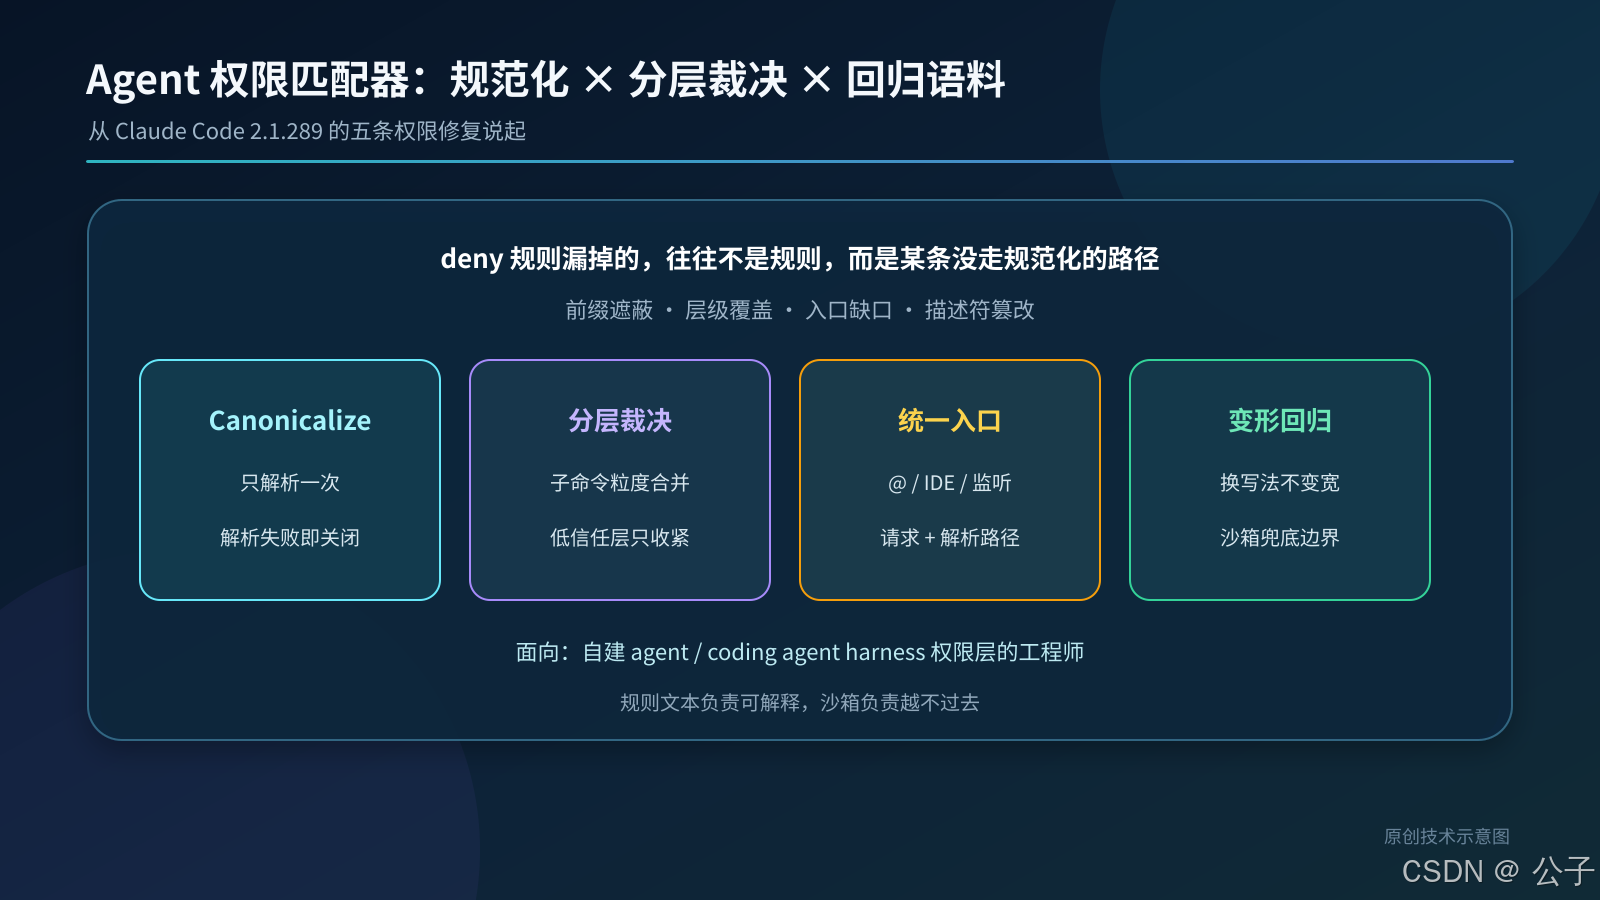
本文写给正在自建 agent / coding agent harness 权限层 的软件与平台工程师。素材来自 Anthropic 官方仓库的 Claude Code 2.1.289 CHANGELOG (npm 发布时间 2026-10-03 20:12 UTC,即北京时间 10-04 04:12)、官方 Configure permissions 文档,以及 2026-10-04 的社区解读。文中区分「公开事实」和「作者架构建议」。只讨论防御侧的设计与测试,不提供任何绕过权限规则的操作步骤。
1. 为什么值得关心:一次「清理版本」里藏着五条权限修复
2.1.289 是一个以修复为主的版本,changelog 共 27 行,只有一行以 Added 开头。真正值得 agent 平台工程师逐行读的,是其中五条和权限有关的修复:
- Bash 的 deny / ask 规则,在沙箱自动放行 (sandbox auto-allow)开启时,漏掉了「前面带环境变量前缀、且值会展开」的命令(官方示例形如
TZ="$HOME" rm -rf build); - 同样在沙箱自动放行下,命令前有裸变量赋值时,deny / ask 规则被跳过;
- 在受管机器上,deny / ask 规则只命中复合命令里嵌套的某一段时,没能压过用户自装 mod 给出的批准;
Readdeny 规则没有作用到经由符号链接、并通过 @-mention、文件变更或 IDE 选区进入上下文的文件;- 用户自装插件可以改写组织托管 MCP server 的登录类工具描述。
这五条单看都只是「某个分支漏了一个判断」。放在一起看,暴露的是所有 agent 权限层都会碰到的结构问题:规则写在文本上,决策走了多条路径,信任分了好几层,入口也不止一个。 只要有一条路径少做一次规范化,deny 就会漏。
官方文档对这一点说得很直白:Bash 规则匹配的是 Claude 写出的命令文本(在拆分复合命令、剥掉 wrapper 之后),「不是围绕该程序的安全边界」 ;文件系统和网络层面的强制约束应交给 sandbox。这是本文的出发点:权限匹配器要尽量做对,但它不能是唯一的一道墙。
2. 公开事实一览(只复述可以核对的内容)
| 项 | 公开信息(来源) | 本文不做的事 |
|---|---|---|
| 版本与时间 | 2.1.289 于 2026-10-03 20:12 UTC 发布到 npm;27 行 changelog,以修复为主(npm registry / CHANGELOG / clauding.de 解读) | 不推测缺陷是否被利用过 |
| 五条权限修复 | 见上一节 1--5,均为 CHANGELOG 原文的中文转述 | 不给出复现脚本或变形 payload |
| 相邻版本 | 2.1.288 修复:BASHPID 赋值的值会被 shell 当算术表达式求值时,改为先提示再执行,不再静默放行;沙箱下不加引号定界符的 heredoc 不再每次都要求批准(CHANGELOG) |
不展开 shell 算术求值的细节 |
| 求值顺序 | 规则按 deny → ask → allow 求值,先命中者决定结果;规则写得再具体也不改变这个顺序;allow 不能从 deny 里「挖例外」(官方 permissions 文档) | --- |
| 复合命令 | 识别 &&、` |
|
| 前缀与 wrapper | 匹配前剥掉固定的 wrapper(timeout、nice、nohup 等);allow 只跳过「已知安全」的环境变量赋值,deny / ask 可以越过任意前置赋值(官方文档) |
--- |
| 符号链接 | allow 要求「请求路径」和「解析后路径」都 命中;deny 只要任一命中就生效;打开文件时会再确认路径仍解析到当初批准的位置(官方文档) | --- |
| mod 与托管策略 | 用户安装的 mod 处理 tool.check 时,在规则和 PreToolUse hook 之后作答,可能替换它们的结论;在受管机器或 Team / Enterprise 登录下,deny 默认压过 mod(官方文档) |
不评价具体 mod 生态 |
| 沙箱关系 | 开启沙箱且 autoAllowBashIfSandboxed 为默认 true 时,沙箱边界代替整工具级的提示;但内容级 ask 规则、显式 deny 仍然生效(官方文档) |
--- |
纪律: 表中只有 changelog 原句的转述和官方文档的行为描述。下文的失效模式命名、内核结构和字段名都属于作者建议,不是 Anthropic 的官方实现。
3. 把五条修复映射成四类失效模式
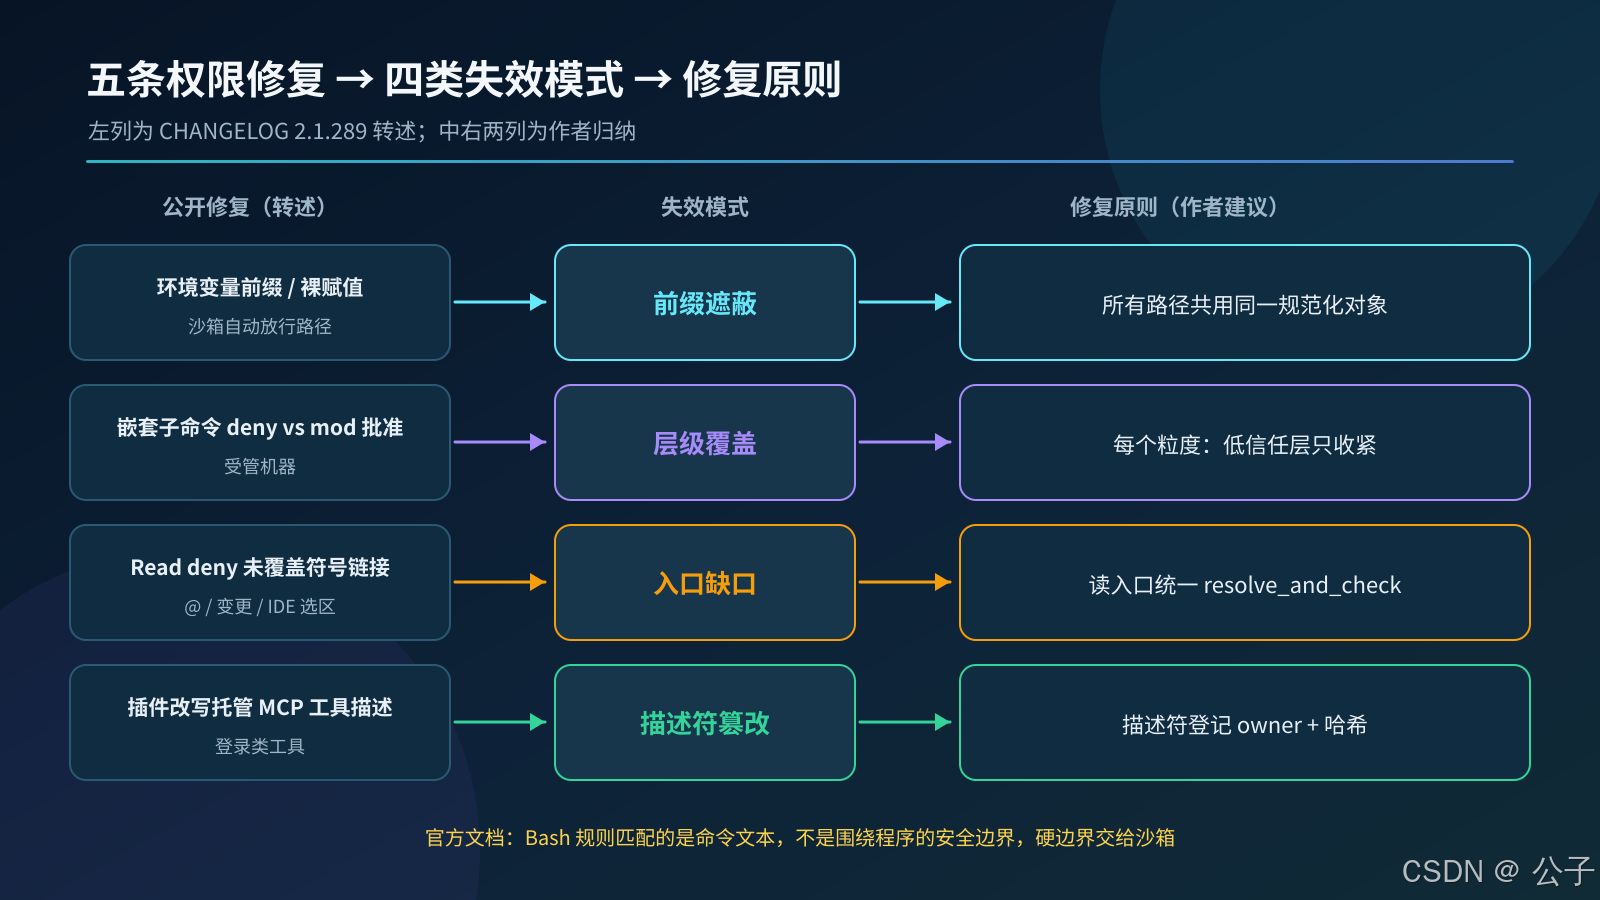
3.1 前缀遮蔽(Prefix Blindness):快速路径没走规范化
对应修复: 第 1、2 条(环境变量前缀、裸赋值,都发生在沙箱自动放行路径上)。
结构性原因: 文档写明 deny 会越过任意前置赋值去匹配,说明主路径上本来有这一步规范化。问题出在另一条决策路径------沙箱自动放行的快速路径------没有复用同一套规范化结果。
作者建议的验收问题: 系统里有几条路径能让一次工具调用「不经提示直接执行」?每条路径在调用规则引擎之前,拿到的是否是同一个规范化后的命令对象,而不是各自从原始字符串重新解析?
3.2 层级覆盖(Layer Override):低信任层改写了高信任层的拒绝
对应修复: 第 3 条(受管机器上,嵌套子命令的 deny / ask 没能压过用户 mod 的批准)。
结构性原因: 文档里「managed deny 压过 mod」这条原则,在整条命令层面是成立的,但在子命令粒度上没有一起执行。信任分层只要在某个粒度上做成「后答者覆盖先答者」,低信任层就能借这个粒度绕过去。
作者建议的验收问题: 每一个决策粒度(整条命令、子命令、参数、路径)上,是否都满足「低信任层只能收紧,不能放宽高信任层的 deny / ask」?
3.3 入口缺口(Ingress Gap):规则只守了工具调用这一道门
对应修复: 第 4 条(@-mention、文件变更、IDE 选区经符号链接带入的文件,没走 Read deny)。
结构性原因: agent 的上下文不只来自 Read 工具。用户 @ 的文件、IDE 共享的选区、文件监听推送的变更、Grep / Glob 的结果,都是读入口。文档也说明,Read 规则对这些入口是「尽力而为」。只要有一个入口没走统一的路径解析和规则检查,deny 就只守住了正门。
作者建议的验收问题: 列一张「读入口清单」,每个入口是否都调用同一个 resolve_and_check(path, channel),并且同时检查请求路径和解析后路径?
3.4 元数据篡改(Descriptor Tampering):工具描述也属于信任面
对应修复: 第 5 条(用户插件能改写组织托管 MCP server 登录类工具的描述)。
结构性原因: 模型依据工具描述来决定怎么调用、何时调用。描述能被低信任组件改写,等于低信任组件可以间接引导模型对高信任工具的使用方式,登录、授权类工具尤其敏感。
作者建议的验收问题: 每个工具描述符是否有明确的 owner 层级和内容哈希?低于 owner 层级的组件改写它时,是被拒绝并告警,还是被静默接受?
4. 作者架构建议:PermissionKernel 五段式
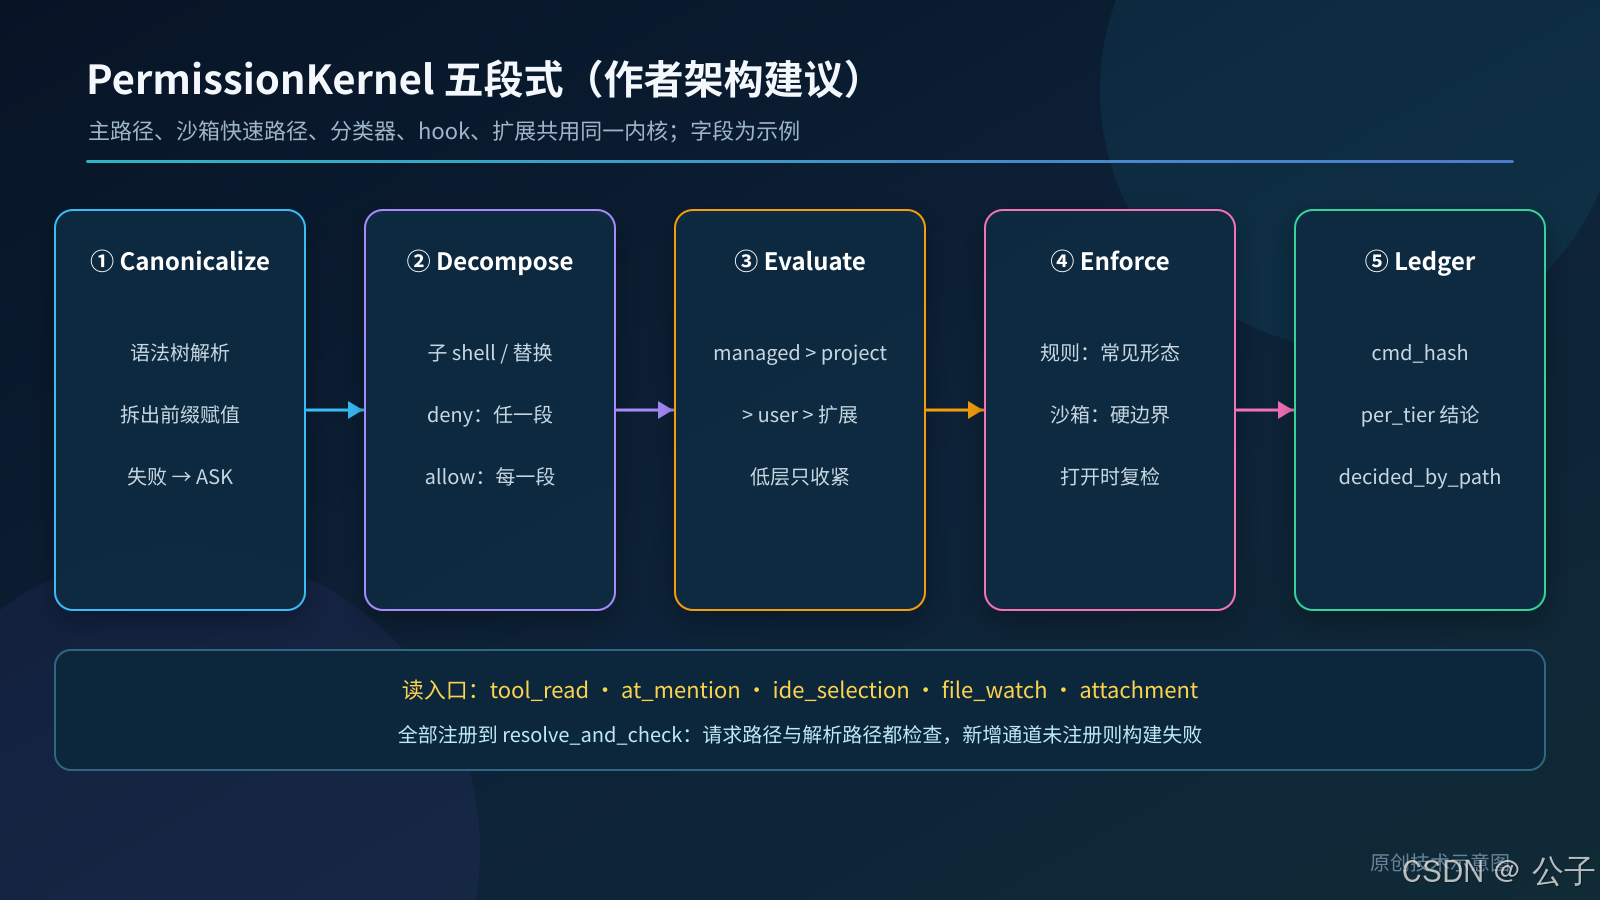
以下整节是作者架构建议 ,不是 Claude Code 的内部实现。字段名、层级名和阈值全部是示例。
4.1 Canonicalize:只解析一次,所有路径共用
text
# 示例:规范化后的命令对象(作者示意)
canonical_command:
  raw: "<原始命令文本>"
  parse_status: ok | partial | failed      # partial/failed → 禁止自动放行
  segments:                                  # 见 4.2
    - argv: ["rm", "-rf", "build"]
      env_assignments: {TZ: {expanded: true}} # 前缀赋值拆出来单独记录
      wrappers_stripped: []
      origin: top_level | subshell | cmd_subst | loop_body
  hash: "sha256:..."                         # 决策账本引用
规则:
- 用真正的 shell 语法解析器产出语法树(开源实现有 tree-sitter-bash 等,选型不限),不要用正则或前缀匹配去「猜」命令;
- 前置赋值、裸赋值、wrapper 一律拆出来单独记录,不要直接丢掉;值会被展开或被当表达式求值的赋值,单独打标;
parse_status != ok时失败即关闭:降级为 ask 或 deny,不进任何自动放行通道;- 沙箱自动放行、auto 模式分类器、hook、mod 拿到的都是同一个
canonical_command,禁止各自重新解析原始字符串。
4.2 Decompose:deny 看「任一段」,allow 看「每一段」
text
# 示例判定(作者示意)
function decide_segments(cmd, rules):
    if cmd.parse_status != ok:
        return ASK("UNPARSEABLE")             # 失败即关闭
    for seg in cmd.segments:                  # 含子 shell / 命令替换 / 循环体
        if matches(rules.deny, seg): return DENY(seg)
    for seg in cmd.segments:
        if matches(rules.ask, seg):  return ASK(seg)
    if all(matches(rules.allow, seg) for seg in cmd.segments):
        return ALLOW
    return ASK("NOT_ALL_ALLOWED")
这和官方文档描述的语义一致:deny / ask 任一子命令命中即生效,allow 要求全部命中。工程上要补的是:这个函数是唯一入口,快速路径不得绕开它。
4.3 Evaluate:分层裁决,低层只能收紧
text
# 示例:信任层级(作者示意,名称可本地化)
trust_tiers:      # 从高到低
  - managed       # 组织托管策略
  - project       # 仓库内受信任配置
  - user          # 用户个人配置
  - extension     # 插件 / mod / 第三方 hook

# 示例:合并规则
function evaluate(seg, tiers):
    verdict = ALLOW_CANDIDATE
    for tier in tiers:                        # 每一层都在「子命令粒度」上执行
        v = tier.decide(seg)
        verdict = most_restrictive(verdict, v) # DENY > ASK > ALLOW
    # 低信任层的 "approve" 只能消掉同层或更低层产生的 ASK
    return verdict
要点:
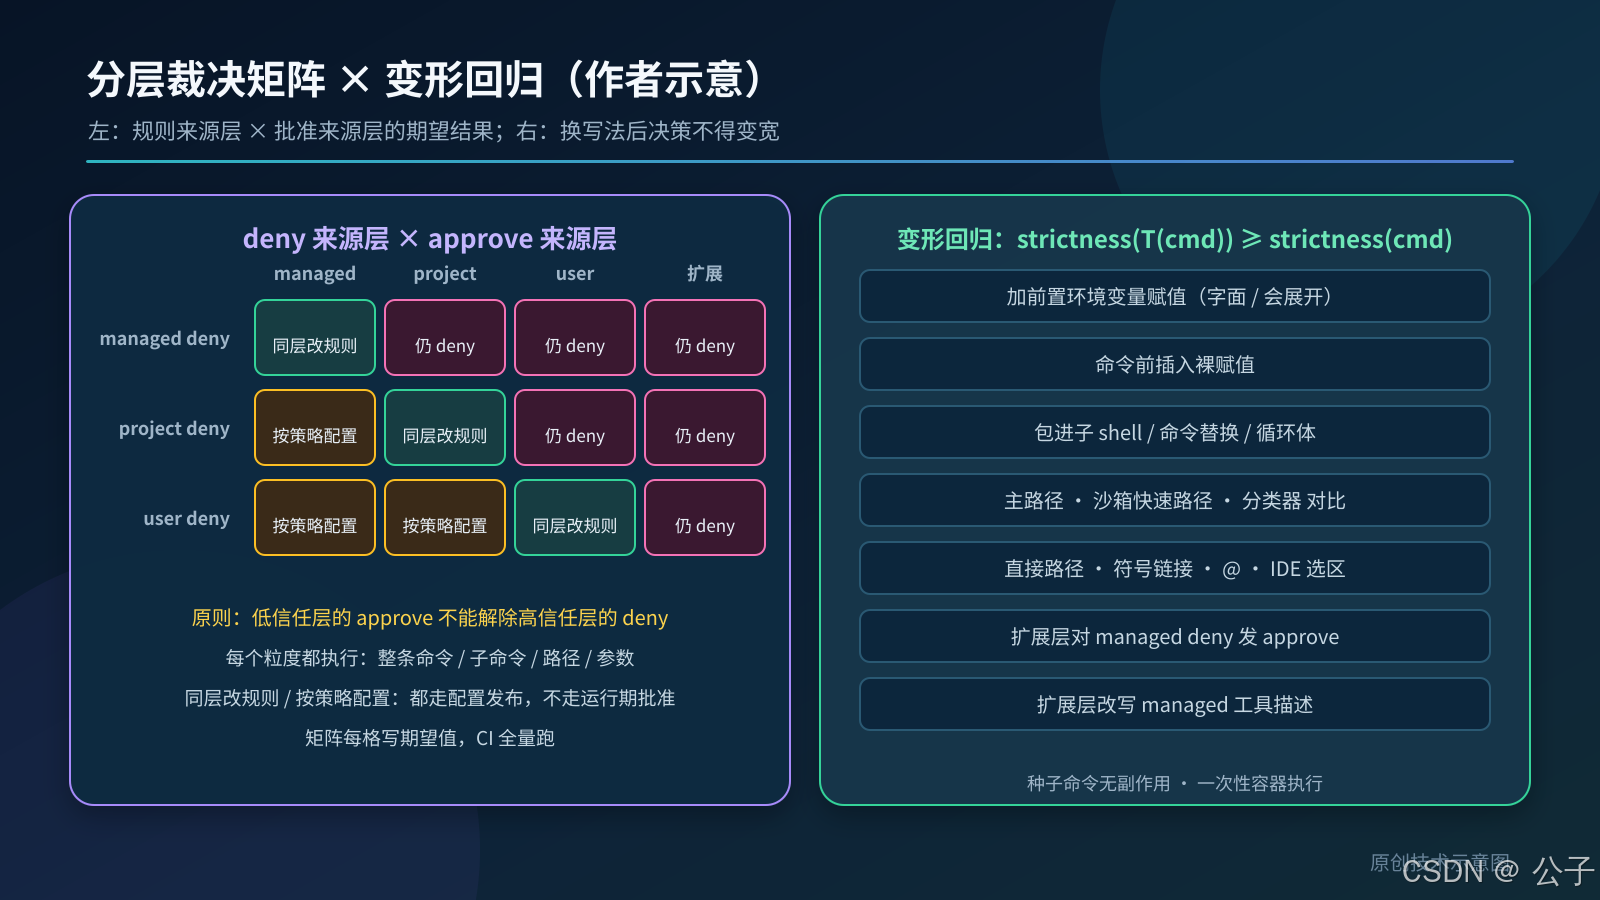
- 在每个粒度上合并 :整条命令、子命令、路径、参数,分别按
most_restrictive合并,不能只在最外层合并; - 批准是有层级的:扩展层给出的 approve,不能消掉 managed / project 层的 deny 或 ask。是否允许扩展层消掉 user 层的 ask,是产品策略,要写进配置,不能藏在代码分支里;
- 用一张矩阵测试来固定行为:行是规则来源层,列是批准来源层,每格写期望结果,CI 全量跑。
4.4 统一入口:所有「读进上下文」的通道走同一个检查
text
# 示例:读入口清单(作者示意)
read_channels:
  - tool_read        # Read / Grep / Glob 等工具
  - at_mention       # 用户在提示里 @ 的文件
  - ide_selection    # IDE 共享的选区 / 打开的文件
  - file_watch       # 文件变更推送
  - attachment       # 粘贴或上传的附件

function resolve_and_check(path, channel):
    requested = normalize(path)
    resolved  = realpath(path)                # 跟随符号链接;循环 → 拒绝
    if deny_matches(requested) or deny_matches(resolved):
        return DENY(channel)
    if not (allow_matches(requested) and allow_matches(resolved)):
        return ASK(channel)
    return ALLOW_WITH_RECHECK(resolved)       # 真正打开时再确认一次,防 TOCTOU
和官方文档的符号链接语义一致:deny 看任一路径,allow 看两条路径都要命中。工程上要补的是:通道清单要显式维护 ,新加一个上下文来源(比如新的 IDE 集成)时,CI 检查它有没有注册到 resolve_and_check。
4.5 Descriptor Integrity:工具描述符要有 owner 和哈希
text
# 示例:工具描述符登记(作者示意)
tool_descriptor:
  tool_id: "mcp__corp_sso__sign_in"         # 示例
  owner_tier: managed
  description_hash: "sha256:..."
  mutable_by: [managed]                      # 低层不可改
on_mutation_attempt: reject_and_alert- 描述符在加载时计算哈希,运行期任何改写都要和
mutable_by比对; - 登录、授权、支付、删除这类高敏工具,默认只允许 owner 层修改;
- 描述符的变化写进账本,事后能回答「模型当时看到的是哪一版描述」。
4.6 Enforce:规则管体验,沙箱管边界
官方文档已经说明:Bash 规则匹配不到绝对路径调用、sh -c 之类的形式,它「不是围绕程序的安全边界」。所以作者建议明确分工:
| 层 | 负责 | 不负责 |
|---|---|---|
| 规则匹配器 | 常见调用形态下的拒绝与提示、可解释的 UX | 保证任何写法都拦得住 |
| 沙箱(文件系统 / 网络) | 进程级的硬边界,与命令怎么写无关 | 理解业务语义 |
| 账本 | 决策可追溯、可复盘 | 实时拦截 |
deny 规则写给「模型通常会写出的命令」,沙箱写给「所有可能写出的命令」。 两者缺一不可。
4.7 Ledger:每次决策都能复盘
text
# 示例事件(作者示意)
permission_decision:
  decision_id: "pd_20261005_0001"
  cmd_hash: "sha256:..."
  parse_status: ok
  channel: tool_bash | at_mention | ide_selection | ...
  path_requested: "./link"
  path_resolved: "/abs/target"
  per_tier: {managed: deny, user: allow, extension: approve}
  final: deny
  decided_by_path: main | sandbox_fast_path | classifier | hook | extension
decided_by_path 这个字段是专门针对 3.1 设计的:如果某条快速路径的放行比例异常高,账本能第一时间暴露出来。
5. 回归语料:用「变形关系」测权限层
逐条手写绕过用例永远写不完。作者建议改用变形测试 (metamorphic testing):不关心某条命令本身该不该放行,只断言「对命令做语义保持的变形之后,决策不能变宽」。
| 变形类别(示例) | 断言 | 对应失效模式 |
|---|---|---|
| 加前置环境变量赋值(字面值 / 会展开的值) | 决策严格程度不降低 | 前缀遮蔽 |
| 在命令前插入裸赋值 | 同上 | 前缀遮蔽 |
| 把命令包进子 shell、命令替换、循环体 | deny / ask 仍命中 | 层级覆盖 / 分解 |
| 同一调用分别走主路径、沙箱快速路径、分类器路径 | 三条路径结论一致或更严 | 前缀遮蔽 |
| 对同一文件分别用直接路径、符号链接、@-mention、IDE 选区引入 | deny 在所有通道都生效 | 入口缺口 |
| 让扩展层对 managed deny 发出 approve | 结果仍为 deny | 层级覆盖 |
| 扩展层尝试修改 managed 工具描述 | 拒绝并告警 | 元数据篡改 |
text
# 示例:变形测试骨架(作者示意)
for rule in deny_rules ∪ ask_rules:
    for base_cmd in seed_commands_matching(rule):     # 用无害的种子命令
        for T in transforms:                           # 上表的变形
            for path in decision_paths:                # main / sandbox / classifier
assert strictness(decide(T(base_cmd), path)) >= strictness(decide(base_cmd, main))种子命令请使用无副作用的测试命令,在一次性容器里执行。语料随每次上游修复扩充:上游 changelog 每出现一条权限修复,就在本地语料里补一个变形类别,而不是只补一条具体字符串。
6. 两周内可落地的验收清单(作者建议)
- 决策路径清单 :列出所有能让工具调用不经提示执行的路径(主路径、沙箱快速路径、分类器、hook、扩展),确认它们共用同一个
canonical_command。 - 解析失败即关闭 :解析器返回
partial / failed时,CI 断言结果为 ask 或 deny。 - 子命令粒度合并:复合命令、子 shell、命令替换、循环体中的 deny / ask 都有单测。
- 信任层矩阵:规则来源层 × 批准来源层,每格有期望值,全量跑。
- 读入口注册表 :新增上下文通道必须注册到
resolve_and_check,否则构建失败。 - 描述符哈希:高敏工具描述符登记 owner 层和哈希,越权改写有告警。
- 沙箱兜底:对「绝不能发生」的动作(删除工作区外的文件、访问凭据目录、任意外连),用 OS 级沙箱实现,不只依赖规则文本。
- 变形回归:至少覆盖第 5 节表中七类变形,跑遍三条决策路径。
- 跟上游:如果直接使用 Claude Code,及时升级到包含这些修复的版本(2.1.289 及以后),升级后跑一遍本地语料。
7. 结语
2.1.289 的五条权限修复本身不复杂,难的是它们背后的共性:同一个决策被拆在多条路径、多个信任层、多个入口上执行,任何一处少做一次规范化,deny 就形同虚设。 对自建 agent 的团队来说,最有用的回应不是照抄某一条修复,而是把权限层改造成一个可测试的内核:只解析一次、分段判定、分层只收紧、所有入口共用一个检查、工具描述符可校验、沙箱兜底、决策可复盘,再用变形测试持续证明「换一种写法不会变宽」。规则文本负责让人看得懂,沙箱负责让 agent 越不过去。