PDF 能选中文字,粘贴以后也不是空白,怎样判断这份结果还能不能用?这次检查自己生成的通知时遇到的麻烦比满屏方块更隐蔽:正常版本与缺映射版本在 pypdf 里都返回 152 个字符,后者却没提取出原来的 56 个汉字。长度一样。只在提交按钮前检查"不能为空",这份坏结果会照样过去。
我对原页上能明确读懂的短句做了逐字检查再把它与提取结果并排核对。通知标题很合适:不用读很多内容就能确认"放假通知"里的字。测试文案来自 ReportLab 生成脚本不是客户文件。处理自己的资料时若没有原始文案可以先人工确认一个短段,记住页码和位置。这个动作只核验了所选片段。其余部分还没检查。输出先保留原样。我没有马上去掉不可见字符也没有交给纠错工具改句子。缺映射通知在这次 pypdf 输出里有 41 个 C0 控制字符,统计时排除了换行、回车和制表符;但 U+FFFD 替换符为零。只查那个常见的替换符会漏掉它。先保留原始文本才有机会解释那些看不见的位置究竟返回了什么。
如果文字看起来正常还需要看对应内容。另一个受控版本把一条映射从"假"改到了"真",页面仍然显示放假通知,提取标题却变成放真通知。正文2处改错没有改变56个汉字的计数。这个结果没有本轮统计的异常控制字符也没有替换符。它并不是乱码检测里最醒目的那类输入却同样与原文不同。
我这次把"发现异常"和"已经核对"分开记录。前一种判断可以提示值得复查,后一种需要真正对照原文。正常汉字比例、有没有字符返回、字体是否带 ToUnicode都只能提供部分信息。尤其金额、编号、日期这类后面要单独使用的字段,不能只看整段话大致能读就略过对应位置。这些检查建议没有被用于处理真实财务数据。
多页文件要按页保留结果。我把正常通知与缺映射通知拼成两页,第一页正确,第二页错误,三种提取引擎都表现出这个差别。全文合并后仍然有中文,单看整个字符串会掩盖坏页。先记录哪页核对过、哪页需要复查比先做一个笼统的文件成功状态更容易解释。页号别丢。
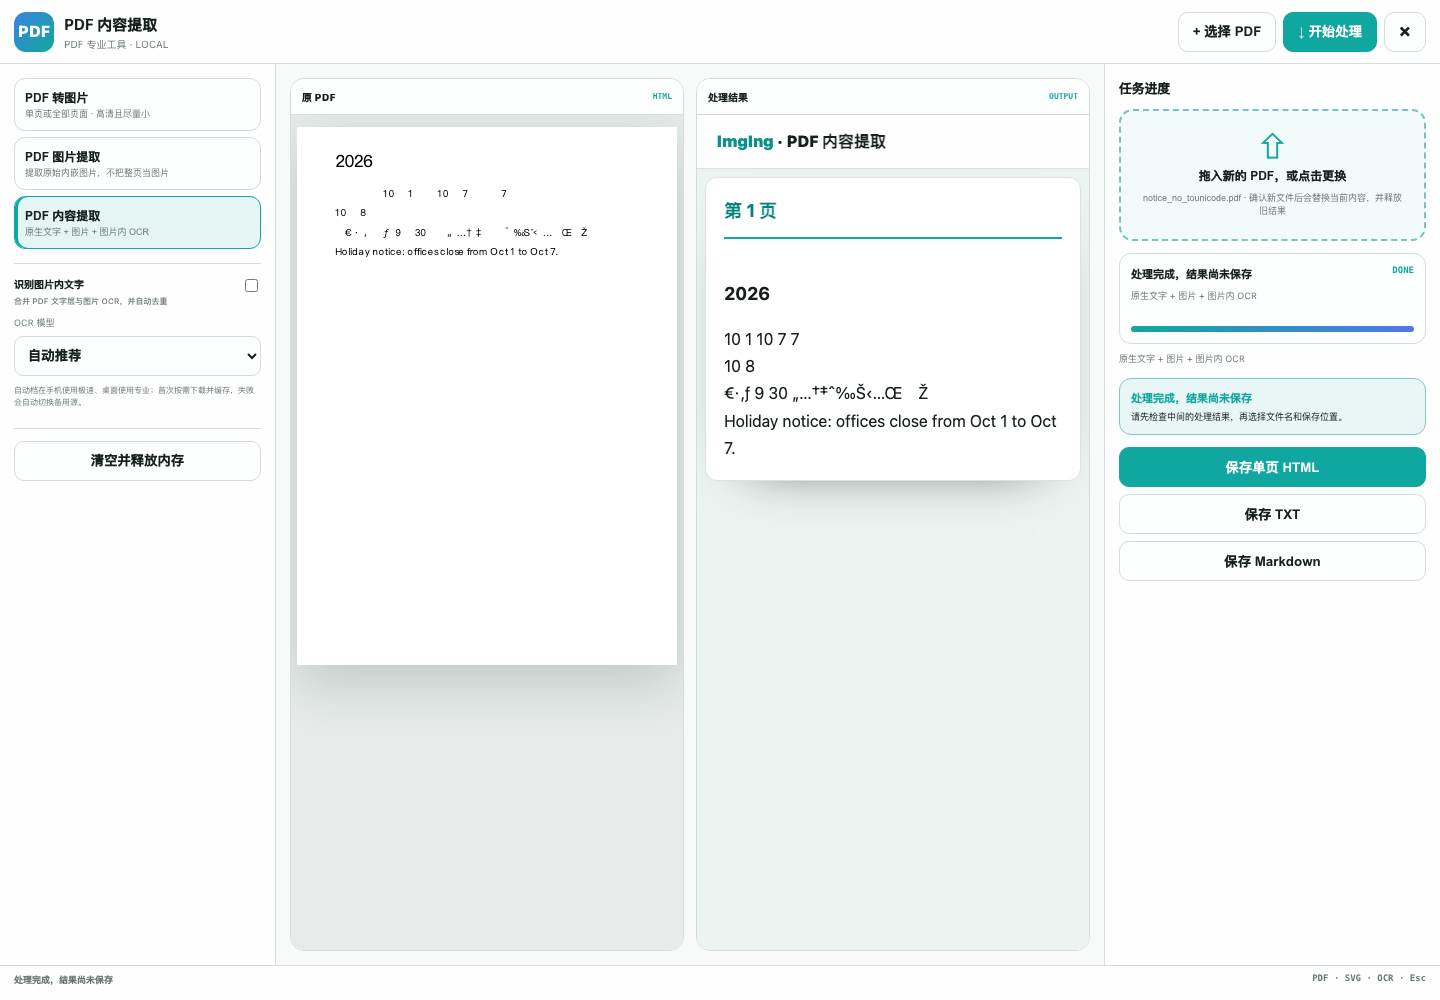
图里中间的处理结果虽保留了日期和英文却没有恢复中文通知。右侧仍然有完成提示。这说明生成了结果与内容正确可以同时是两种状态。左边源预览的窗格标记 HTML不是用来证明原 PDF 原生显示损坏的画面;本次原页能正确显示,另有固定条件下的 MuPDF 渲染对照。
我用的是图映(imging.cn),这一步仍然输入同一份自造通知比较开启与关闭图片内 OCR 的预览文本。两份输出逐字一致。开启选项并没有改变这次纯文字故障页的结果。我只用输入、设置与实际输出判断有无改善,不凭选项名称猜测产品内部怎样挑选识别对象。
若决定尝试图片识字,先从能够正确显示原页的阅读器或渲染器取得清晰图。本次图映 PDF 转图在单页 PNG、216 dpi 下报错,后续成功识字使用的是外部渲染得到的清晰 PNG。图映独立图片 OCR 恢复了 5 行信息,中文空格与源文不同;识别结果仍应按同一段原文核对,不能直接覆盖原来的提取记录。
这轮没有测扫描件隐藏文字层也没有找到真实公开的缺映射故障文件,不能把通知实验推广成所有 PDF 的规律。真正可以带回去用的动作很朴素:先核对一段原文再按页记录结果,异常输出另存不清洗。发现字符合法但内容不一致时把它留在待复核状态,不要因为接口返回成功就继续当作正确正文。