上一篇写报价审批工作流时,重点在实现:状态机、人工审批、幂等写入和补偿。但很多项目真正的分水岭,在验收阶段。
演示环境里 20 条流程全绿,不代表生产环境能跑。验收时如果没有指标埋点和审计日志,最后很容易变成口头争论:供应商说功能交付了,业务方说根本没法用。
这篇把验收做成一套可执行系统:用真实业务数据回放,用事件表统计指标,用审计链路解释每一次自动通过和人工接管。
一、验收要回答四个问题,而不是看页面能点通
流程自动化上线前,至少要回答:
| 问题 | 对应指标 |
|---|---|
| 有多少流程不用人碰就能跑完 | 自动完成率 |
| 流程有没有真的变快 | 流程完成时间 |
| 系统边界划得准不准 | 异常转人工率 |
| AI 产出能不能直接用 | 人工返工率 |
这四个指标不能靠 PPT 展示,必须能从数据里查出来。
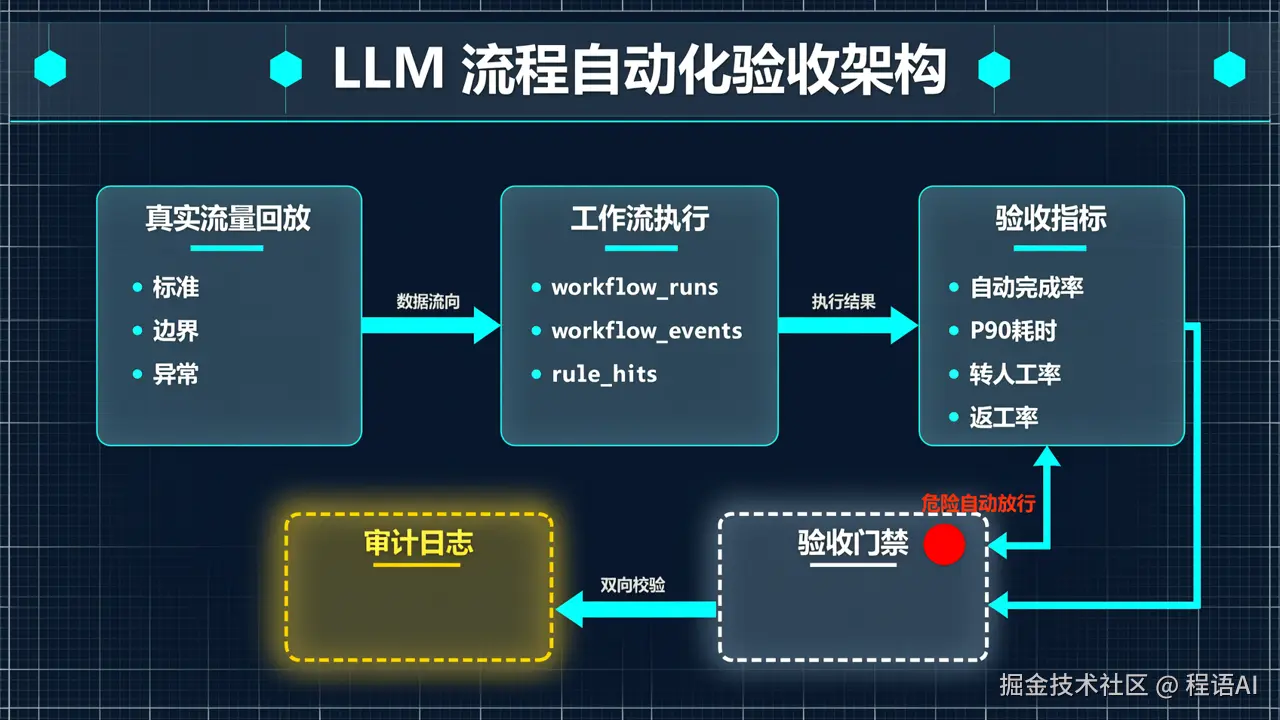
一个合格的验收系统至少要有三层:
text
真实流量回放层
   │  标准流程 / 边界流程 / 异常流程
   ▼
工作流执行层
   │  workflow_runs + workflow_events
   ▼
验收指标层
   │  自动完成率 / 耗时 / 转人工率 / 返工率
   ▼
审计解释层
      为什么自动通过、为什么转人工、谁改了什么
如果只有第三层的报表,没有前两层的事件数据,指标就没法被信任。
二、先把「一次流程执行」建模清楚
很多项目验收做不好,根源是数据模型里缺少「一次流程执行」的完整记录。
1. workflow_runs:流程实例表
sql
CREATE TABLE workflow_runs (
    id UUID PRIMARY KEY,
    tenant_id UUID NOT NULL,
    workflow_key TEXT NOT NULL,
    workflow_version TEXT NOT NULL,

    source_type TEXT NOT NULL,
    source_id TEXT,

    input_payload JSONB NOT NULL,
    input_hash TEXT NOT NULL,

    status TEXT NOT NULL,

    is_auto_completed BOOLEAN NOT NULL DEFAULT FALSE,
    is_human_taken_over BOOLEAN NOT NULL DEFAULT FALSE,
    is_dangerous_auto_pass BOOLEAN NOT NULL DEFAULT FALSE,

    started_at TIMESTAMPTZ NOT NULL DEFAULT NOW(),
    finished_at TIMESTAMPTZ,

    failure_code TEXT,
    failure_message TEXT,

    replay_id UUID,
    scenario_type TEXT,

    created_at TIMESTAMPTZ NOT NULL DEFAULT NOW(),
    updated_at TIMESTAMPTZ NOT NULL DEFAULT NOW()
);

CREATE INDEX idx_workflow_runs_tenant_time
ON workflow_runs (tenant_id, started_at DESC);

CREATE INDEX idx_workflow_runs_replay
ON workflow_runs (replay_id);
status 至少要能区分这些状态:
text
RUNNING
AUTO_COMPLETED
HUMAN_TAKEN_OVER
FAILED
CANCELLED
不要把「自动完成」和「人工接管后完成」混成一个 COMPLETED。验收时这两类必须分开。
2. workflow_events:节点事件表
sql
CREATE TABLE workflow_events (
    id BIGSERIAL PRIMARY KEY,
    run_id UUID NOT NULL REFERENCES workflow_runs(id),
    node_key TEXT NOT NULL,
    event_type TEXT NOT NULL,
    status TEXT NOT NULL,

    actor_type TEXT NOT NULL DEFAULT 'SYSTEM',
    actor_id TEXT,

    payload JSONB NOT NULL DEFAULT '{}',
    error_code TEXT,

    started_at TIMESTAMPTZ NOT NULL DEFAULT NOW(),
    finished_at TIMESTAMPTZ,

    created_at TIMESTAMPTZ NOT NULL DEFAULT NOW()
);

CREATE INDEX idx_workflow_events_run
ON workflow_events (run_id, started_at);
每个节点开始、结束、失败、重试、转人工,都应该落事件。
3. human_interventions:人工接管表
sql
CREATE TABLE human_interventions (
    id UUID PRIMARY KEY,
    run_id UUID NOT NULL REFERENCES workflow_runs(id),

    node_key TEXT NOT NULL,
    reason_code TEXT NOT NULL,
    reason_detail TEXT,

    actor_id TEXT NOT NULL,

    before_snapshot JSONB NOT NULL DEFAULT '{}',
    after_snapshot JSONB NOT NULL DEFAULT '{}',

    action TEXT NOT NULL,

    started_at TIMESTAMPTZ NOT NULL,
    finished_at TIMESTAMPTZ
);
这张表很关键。人工接管不可怕,可怕的是验收统计时不算。
4. rework_records:返工记录表
sql
CREATE TABLE rework_records (
    id UUID PRIMARY KEY,
    run_id UUID NOT NULL REFERENCES workflow_runs(id),

    artifact_type TEXT NOT NULL,
    artifact_id TEXT NOT NULL,

    severity TEXT NOT NULL,

    changed_fields JSONB NOT NULL DEFAULT '[]',
    operator_id TEXT NOT NULL,

    reason_code TEXT NOT NULL,
    reason_detail TEXT,

    created_at TIMESTAMPTZ NOT NULL DEFAULT NOW()
);
severity 可以按业务定义,例如:
text
TRIVIAL       改错别字
MINOR         改普通字段
MAJOR         改价格 / 折扣 / 交付时间
CRITICAL      完全重做
只统计「有没有返工」不够,必须看返工的严重程度。
5. rule_hits:规则命中表
sql
CREATE TABLE rule_hits (
    id BIGSERIAL PRIMARY KEY,
    run_id UUID NOT NULL REFERENCES workflow_runs(id),

    node_key TEXT NOT NULL,
    rule_key TEXT NOT NULL,
    rule_version TEXT NOT NULL,

    result TEXT NOT NULL,
    detail JSONB NOT NULL DEFAULT '{}',

    created_at TIMESTAMPTZ NOT NULL DEFAULT NOW()
);
例如报价审批里可以记录:
text
DISCOUNT_LIMIT         PASS
GROSS_MARGIN_LIMIT     BLOCK
MISSING_REQUIRED_FIELD BLOCK
LLM_LOW_CONFIDENCE     HUMAN_REVIEW
有了这张表,才能回答「为什么自动通过」和「为什么转人工」。
三、指标必须从事件表里算出来
有了数据模型,四个指标就能用 SQL 复现。
1. 自动完成率
sql
SELECT
    COUNT(*) FILTER (
        WHERE status = 'AUTO_COMPLETED'
    )::NUMERIC
    / NULLIF(COUNT(*) FILTER (
        WHERE status IN ('AUTO_COMPLETED', 'HUMAN_TAKEN_OVER', 'FAILED')
    ), 0) AS auto_completion_rate,

    COUNT(*) FILTER (
        WHERE status = 'AUTO_COMPLETED'
    ) AS auto_completed,

    COUNT(*) FILTER (
        WHERE status = 'HUMAN_TAKEN_OVER'
    ) AS human_taken_over,

    COUNT(*) FILTER (
        WHERE status = 'FAILED'
    ) AS failed,

    COUNT(*) FILTER (
        WHERE status IN ('AUTO_COMPLETED', 'HUMAN_TAKEN_OVER', 'FAILED')
    ) AS total_valid
FROM workflow_runs
WHERE replay_id = :replay_id;
这里把 CANCELLED 排除掉,因为取消通常不是系统执行能力的表现。
2. 流程完成时间
不要只看平均耗时。验收时至少看三个值:
sql
SELECT
    PERCENTILE_CONT(0.5) WITHIN GROUP (
        ORDER BY EXTRACT(EPOCH FROM (finished_at - started_at))
    ) AS p50_seconds,

    PERCENTILE_CONT(0.9) WITHIN GROUP (
        ORDER BY EXTRACT(EPOCH FROM (finished_at - started_at))
    ) AS p90_seconds,

    AVG(EXTRACT(EPOCH FROM (finished_at - started_at))) AS avg_seconds,

    MAX(EXTRACT(EPOCH FROM (finished_at - started_at))) AS max_seconds
FROM workflow_runs
WHERE replay_id = :replay_id
  AND finished_at IS NOT NULL;
P90 很重要。平均 5 分钟、P90 两天,员工感受到的是后者。
3. 异常转人工率
sql
SELECT
    reason_code,
    COUNT(*) AS total
FROM human_interventions
WHERE run_id IN (
    SELECT id
    FROM workflow_runs
    WHERE replay_id = :replay_id
)
GROUP BY reason_code
ORDER BY total DESC;
比比例更重要的是原因分布:
- 字段缺失
- 规则不明确
- 超出权限
- 外部系统失败
- AI 置信度不足
- 客户提出特殊要求
如果大量异常是「字段缺失」或「规则不明确」,那问题不在模型,而在流程和数据。
4. 人工返工率
sql
SELECT
    COUNT(DISTINCT r.run_id)::NUMERIC
    / NULLIF(COUNT(DISTINCT w.id), 0) AS rework_run_rate,

    COUNT(*) FILTER (
        WHERE r.severity IN ('MAJOR', 'CRITICAL')
    ) AS critical_rework_count,

    COUNT(*) AS total_rework
FROM rework_records r
JOIN workflow_runs w ON w.id = r.run_id
WHERE w.replay_id = :replay_id;
还可以按字段统计:
sql
SELECT
    jsonb_array_elements_text(changed_fields) AS changed_field,
    COUNT(*) AS total
FROM rework_records
WHERE run_id IN (
    SELECT id FROM workflow_runs WHERE replay_id = :replay_id
)
GROUP BY changed_field
ORDER BY total DESC;
如果 discount、price、delivery_date 反复出现在返工里,这就是上线前必须修的点。
四、真实流量回放:不要用供应商挑好的数据
验收数据建议从历史业务里抽:
text
10 条标准流程
 5 条边界流程
 5 条异常流程
标准流程看主链路能不能跑,边界流程看规则清不清楚,异常流程看失败处理和人工接管。
1. 验收数据集结构
可以用 JSON 定义:
json
{
  "replay_id": "3f6f4d0e-8f18-4f4d-9a3f-2a9c7f47b1d2",
  "workflow_key": "quote_approval",
  "workflow_version": "v1.2.0",
  "environment": "staging",
  "cases": [
    {
      "case_id": "case-001",
      "scenario_type": "STANDARD",
      "source_id": "quote-2026-09-001",
      "input": {
        "customer_name": "示例客户A",
        "product_sku": "SKU-1001",
        "quantity": 300,
        "expected_delivery_days": 7,
        "requested_discount": 0.96
      },
      "expected_route": "AUTO_COMPLETED",
      "expected_artifact": {
        "status": "GENERATED",
        "required_fields": ["price", "discount", "delivery_date"]
      }
    },
    {
      "case_id": "case-002",
      "scenario_type": "BOUNDARY",
      "source_id": "quote-2026-09-014",
      "input": {
        "customer_name": "示例客户B",
        "product_sku": "SKU-1002",
        "quantity": 5000,
        "expected_delivery_days": 3,
        "requested_discount": 0.88
      },
      "expected_route": "HUMAN_TAKEN_OVER",
      "expected_rule": "DISCOUNT_LIMIT"
    },
    {
      "case_id": "case-003",
      "scenario_type": "EXCEPTION",
      "source_id": "quote-2026-09-031",
      "input": {
        "customer_name": "示例客户C",
        "product_sku": "",
        "quantity": 100,
        "expected_delivery_days": 10
      },
      "expected_route": "HUMAN_TAKEN_OVER",
      "expected_rule": "MISSING_REQUIRED_FIELD"
    }
  ]
}
注意:示例里的客户和单号都要脱敏。真实验收时,业务方和交付方应共同确认数据集,不要由供应商单方面挑。
2. 回放时的关键原则
回放不是把生产数据复制到生产系统里重跑,而是要控制副作用:
| 副作用 | 回放处理 |
|---|---|
| 发送报价给客户 | 使用 staging 适配器,不真实发送 |
| 写入 CRM | 写入 CRM 沙箱租户或 mock |
| 扣减库存 | 不真实扣减,使用预占接口或 mock |
| 发送企业微信通知 | 发送到测试群或 mock |
| 生成 PDF | 可以真实生成,但文件路径要隔离 |
每个 case 都要有唯一 idempotency_key,避免重复回放造成重复副作用。
text
idempotency_key = replay_id:case_id如果同一个 case 需要跑第二轮,应递增版本:
text
replay_id:case_id:v2五、一个简化版回放器
下面用 Python 写一个可扩展的回放骨架。重点是结构,不是完整生产代码。
python
import asyncio
import hashlib
import json
from dataclasses import dataclass, field
from typing import Any

import httpx


@dataclass
class ReplayResult:
    case_id: str
    scenario_type: str
    run_id: str | None
    status: str
    expected_route: str
    passed: bool
    errors: list[str] = field(default_factory=list)
    metrics: dict[str, Any] = field(default_factory=dict)


class WorkflowReplayer:
    def __init__(
        self,
        base_url: str,
        api_token: str,
        environment: str = "staging",
    ):
        self.base_url = base_url.rstrip("/")
        self.api_token = api_token
        self.environment = environment

    def _headers(self, idempotency_key: str) -> dict[str, str]:
        return {
            "Authorization": f"Bearer {self.api_token}",
            "X-Environment": self.environment,
            "Idempotency-Key": idempotency_key,
        }

    @staticmethod
    def input_hash(payload: dict[str, Any]) -> str:
        canonical = json.dumps(
            payload,
            ensure_ascii=False,
            sort_keys=True,
            separators=(",", ":"),
        )
        return hashlib.sha256(canonical.encode("utf-8")).hexdigest()

    async def submit_case(
        self,
        client: httpx.AsyncClient,
        replay_id: str,
        case: dict[str, Any],
    ) -> str:
        idempotency_key = f"{replay_id}:{case['case_id']}"

        response = await client.post(
            f"{self.base_url}/api/v1/workflows/quote-approval/runs",
            headers=self._headers(idempotency_key),
            json={
                "source_type": "ACCEPTANCE_REPLAY",
                "source_id": case.get("source_id"),
                "input_payload": case["input"],
                "scenario_type": case["scenario_type"],
                "replay_id": replay_id,
                "dry_run": True,
            },
        )
        response.raise_for_status()

        data = response.json()
        return data["run_id"]

    async def wait_for_run(
        self,
        client: httpx.AsyncClient,
        run_id: str,
        timeout_seconds: int = 300,
        poll_interval_seconds: int = 2,
    ) -> dict[str, Any]:
        elapsed = 0

        while elapsed < timeout_seconds:
            response = await client.get(
                f"{self.base_url}/api/v1/workflow-runs/{run_id}",
                headers={"Authorization": f"Bearer {self.api_token}"},
            )
            response.raise_for_status()

            data = response.json()
            status = data["status"]

            if status in {
                "AUTO_COMPLETED",
                "HUMAN_TAKEN_OVER",
                "FAILED",
                "CANCELLED",
            }:
                return data

            await asyncio.sleep(poll_interval_seconds)
            elapsed += poll_interval_seconds

        raise TimeoutError(f"workflow run {run_id} timeout")

    async def replay_case(
        self,
        client: httpx.AsyncClient,
        replay_id: str,
        case: dict[str, Any],
    ) -> ReplayResult:
        errors: list[str] = []

        try:
            run_id = await self.submit_case(client, replay_id, case)
            run = await self.wait_for_run(client, run_id)

            actual_status = run["status"]
            expected_route = case["expected_route"]

            if actual_status != expected_route:
                errors.append(
                    f"route mismatch: expected={expected_route}, actual={actual_status}"
                )

            # 危险放行检查:预期人工,实际自动完成
            dangerous_auto_pass = (
                expected_route == "HUMAN_TAKEN_OVER"
                and actual_status == "AUTO_COMPLETED"
            )

            passed = not errors and not dangerous_auto_pass

            return ReplayResult(
                case_id=case["case_id"],
                scenario_type=case["scenario_type"],
                run_id=run_id,
                status=actual_status,
                expected_route=expected_route,
                passed=passed,
                errors=errors,
                metrics={
                    "dangerous_auto_pass": dangerous_auto_pass,
                    "input_hash": self.input_hash(case["input"]),
                },
            )

        except Exception as exc:
            return ReplayResult(
                case_id=case["case_id"],
                scenario_type=case["scenario_type"],
                run_id=None,
                status="REPLAY_ERROR",
                expected_route=case["expected_route"],
                passed=False,
                errors=[f"{type(exc).__name__}: {exc}"],
            )
回放入口:
python
async def run_acceptance(replay_file: str):
    with open(replay_file, "r", encoding="utf-8") as f:
        replay = json.load(f)

    async with httpx.AsyncClient(timeout=30) as client:
        replayer = WorkflowReplayer(
            base_url="https://staging.example.com",
            api_token="staging-token",
            environment=replay["environment"],
        )

        tasks = [
            replayer.replay_case(client, replay["replay_id"], case)
            for case in replay["cases"]
        ]

        results = await asyncio.gather(*tasks)

    passed = sum(1 for result in results if result.passed)
    total = len(results)

    report = {
        "replay_id": replay["replay_id"],
        "total": total,
        "passed": passed,
        "pass_rate": passed / total if total else 0,
        "results": [result.__dict__ for result in results],
    }

    print(json.dumps(report, ensure_ascii=False, indent=2))
    return report
这个回放器只做了路由级判断。实际项目里还可以继续校验:
- 必填字段是否存在
- 报价金额是否符合规则
- 审批人是否正确
- 事件链是否完整
- 是否产生了危险自动放行
六、审计日志:让每一次结果都能被解释
验收阶段最怕听到一句话:
系统就是这么算的。
没有审计日志,指标就只是结果;有了审计日志,才能解释过程。
1. 事件要包含 actor
text
actor_type = SYSTEM / LLM / RULE_ENGINE / HUMAN / EXTERNAL_SYSTEM
actor_id   = 节点名 / 模型名 / 规则ID / 用户ID / 系统名
例如报价审批可以记录:
text
extract_requirement      LLM           提取出客户、SKU、数量
pricing_rule             RULE_ENGINE   毛利规则通过
approval_router          RULE_ENGINE   折扣超限,转人工
sales_manager_approval   HUMAN         审批通过
crm_sync                 EXTERNAL_SYS  写回成功
2. 敏感数据要脱敏
不要把客户原始聊天记录、手机号、合同金额全部塞进日志。
建议日志里存:
- 原始输入 hash
- 脱敏后的关键字段
- 模型输出 hash
- 规则命中结果
- 错误码
python
import hashlib
import json


def digest(value: dict) -> str:
    canonical = json.dumps(
        value,
        ensure_ascii=False,
        sort_keys=True,
        separators=(",", ":"),
    )
    return hashlib.sha256(canonical.encode("utf-8")).hexdigest()
需要排查时,再通过受控权限查看原始数据。
3. 审计事件建议 append-only
审计表只追加,不更新:
sql
CREATE TABLE workflow_audit_logs (
    id BIGSERIAL PRIMARY KEY,

    run_id UUID NOT NULL,
    node_key TEXT NOT NULL,
    event_type TEXT NOT NULL,

    actor_type TEXT NOT NULL,
    actor_id TEXT,

    payload_digest TEXT NOT NULL,
    payload JSONB NOT NULL DEFAULT '{}',

    prev_event_hash TEXT,
    event_hash TEXT NOT NULL,

    created_at TIMESTAMPTZ NOT NULL DEFAULT NOW()
);

CREATE INDEX idx_workflow_audit_logs_run
ON workflow_audit_logs (run_id, created_at);
event_hash 可以用 prev_event_hash + payload_digest + created_at 计算,形成简单链式校验。不一定所有项目都需要,但涉及报价、合同、审批时值得做。
七、验收门禁:让「能不能上线」变成可判断条件
验收不应该由某个人凭感觉拍板,可以拆成一组门禁。
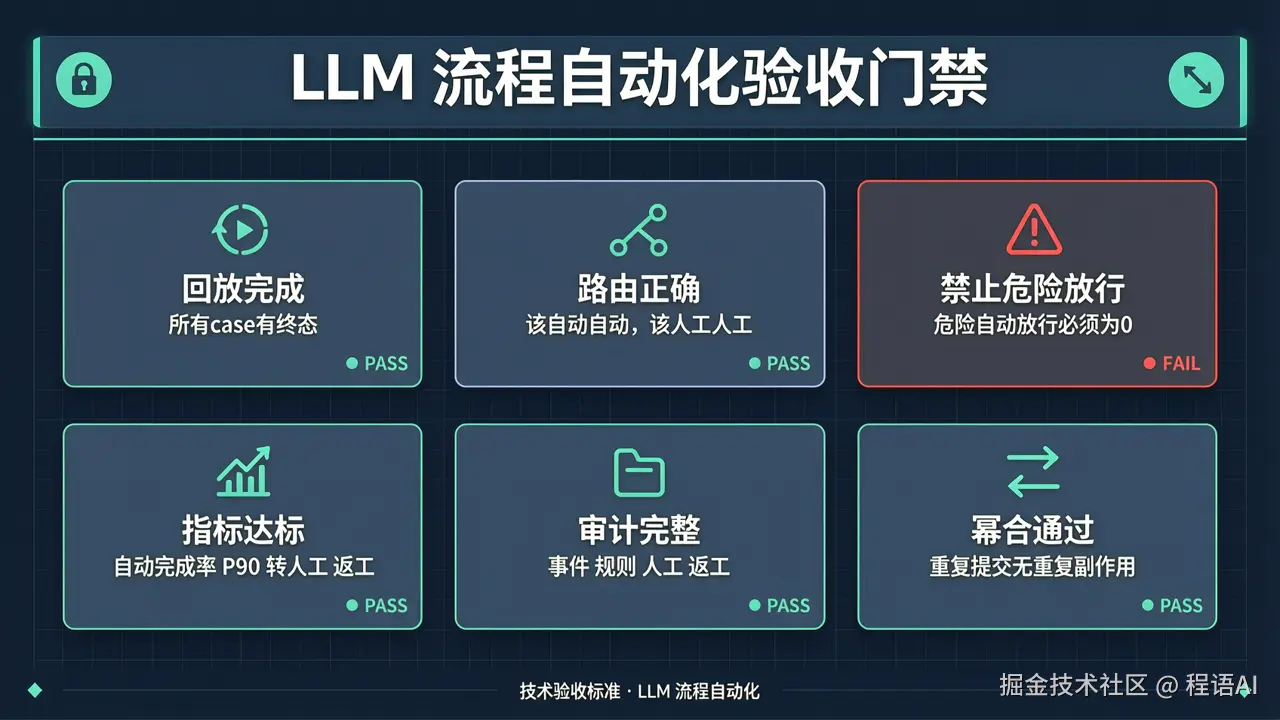
Gate 1:回放完成率
text
所有 case 必须有终态。
RUNNING / REPLAY_ERROR 数量必须为 0。
如果 20 条里有 3 条卡住,验收还没开始。
Gate 2:路由正确率
每个 case 都有 expected_route:
text
STANDARD   期望 AUTO_COMPLETED
BOUNDARY   期望 AUTO_COMPLETED 或 HUMAN_TAKEN_OVER
EXCEPTION  期望 HUMAN_TAKEN_OVER 或 FAILED
关键不是「自动越多越好」,而是「该自动的自动,该人工的人工」。
Gate 3:禁止危险自动放行
下面情况必须直接失败:
text
expected_route = HUMAN_TAKEN_OVER
actual_status  = AUTO_COMPLETED
这类错误比普通失败严重得多。失败会卡住流程,危险放行可能把错误报价发给客户。
Gate 4:指标达到合同阈值
阈值由业务方、使用员工和交付方共同约定,不建议写死成通用值。
可以参考这种格式:
| 指标 | 阈值 | 统计口径 |
|---|---|---|
| 自动完成率 | ≥ 双方约定值 | AUTO_COMPLETED / 有效终态流程数 |
| P90 完成时间 | ≤ 双方约定值 | 从发起到最后终态 |
| 异常转人工率 | 区间值 | 需要按原因分类看 |
| MAJOR/CRITICAL 返工率 | ≤ 双方约定值 | 按返工记录统计 |
Gate 5:审计完整性
每个 run 至少要有:
text
input_hash
workflow_events
rule_hits
human_interventions(如果转人工)
rework_records(如果人工修改)
side_effect_records(如果触发外部副作用)
缺少事件链的流程,不能算验收通过。
Gate 6:幂等性
对同一个 idempotency_key 重复提交,必须得到同一个 run 或明确拒绝,不能产生两份报价、两次 CRM 写入。
验收时可以专门跑一个重复提交用例:
text
case_id: case-duplicate-001
action: 连续提交两次
expect: 只产生一个业务副作用
八、验收报告里应该有什么
不要只给一个「验收通过」。
建议输出一份机器可读 + 人可读的报告:
json
{
  "replay_id": "3f6f4d0e-8f18-4f4d-9a3f-2a9c7f47b1d2",
  "workflow_key": "quote_approval",
  "workflow_version": "v1.2.0",
  "environment": "staging",
  "summary": {
    "total_cases": 20,
    "auto_completed": 12,
    "human_taken_over": 5,
    "failed": 2,
    "dangerous_auto_pass": 1,
    "auto_completion_rate": 0.6,
    "pass_rate": 0.85
  },
  "duration": {
    "p50_seconds": 180,
    "p90_seconds": 2400,
    "max_seconds": 5400
  },
  "human_reasons": {
    "MISSING_REQUIRED_FIELD": 4,
    "DISCOUNT_LIMIT": 3,
    "LLM_LOW_CONFIDENCE": 2
  },
  "rework": {
    "total": 9,
    "major_or_critical": 3,
    "top_fields": [
      "discount",
      "delivery_date",
      "product_sku"
    ]
  },
  "gates": {
    "replay_completed": true,
    "route_accuracy": false,
    "no_dangerous_auto_pass": false,
    "metrics_within_threshold": true,
    "audit_complete": true,
    "idempotency_passed": true
  },
  "conclusion": "BLOCKED"
}
只要 dangerous_auto_pass > 0,结论就应该是 BLOCKED。
这不是吹毛求疵。失败会卡住流程,危险放行可能已经造成业务事故。
九、常见验收坑,从工程角度看
坑一:没有 case_id,数据对不上
供应商说跑了 20 条,业务方说只看到 17 条,双方查不出差异。
每个回放 case 都要有:
text
case_id
source_id
replay_id
run_id
input_hash
这样能从原始业务数据追到 run,再从 run 追到事件。
坑二:人工接管没有埋点
表面自动完成,实际有人补字段、改价格、手动触发。
如果 human_interventions 缺失,自动完成率会虚高。
人工兜底不可怕,不埋点才可怕。
坑三:只统计平均耗时
平均值好看,不代表员工体验好。
一定要看 P90 和最长耗时,并把转人工流程单独统计。
坑四:异常被提前剔除
有些供应商会只拿格式最好的数据跑。
验收数据集必须由业务方确认,标准、边界、异常都要覆盖。
坑五:只测一次成功
流程自动化要测失败路径:
- LLM 返回格式错误
- 价格服务超时
- CRM 写入失败
- 审批人拒绝
- 重复提交
- 权限不足
如果异常路径没有测过,上线后第一次故障就会暴露问题。
坑六:验收完就没人运营
上线后还要有人:
- 看失败原因
- 改规则
- 处理人工接管
- 分析返工字段
- 定期复盘指标
这些责任要在验收文档里写清楚。
十、一个可执行的上线清单
| # | 检查项 | 通过标准 |
|---|---|---|
| 1 | 验收数据集 | 业务方确认,覆盖标准 / 边界 / 异常 |
| 2 | 回放环境 | staging 或隔离环境,外部副作用可控 |
| 3 | 幂等键 | replay_id:case_id,重复提交无重复副作用 |
| 4 | workflow_runs | 每个 case 都有 run_id 和终态 |
| 5 | workflow_events | 每个节点都有开始 / 结束 / 失败事件 |
| 6 | rule_hits | 自动通过和转人工都能解释 |
| 7 | human_interventions | 所有人工接管都有记录 |
| 8 | rework_records | 所有返工都有严重程度和字段 |
| 9 | 指标报表 | 四个指标可复现,口径写入文档 |
| 10 | 危险放行 | 数量为 0 |
| 11 | 审计日志 | 可按 run 回放完整过程 |
| 12 | 验收报告 | 机器可读 + 人可读,结论明确 |
总结
LLM 流程自动化的验收,重点不是看界面能不能点通,而是把验收做成一套可执行的数据链路:
- 用真实业务数据回放,不用供应商挑好的 Demo 数据
- 用事件表记录流程执行,而不是只保存最终结果
- 用 SQL 复现四个指标,统一统计口径
- 用人工接管和返工表识别真实成本
- 用审计日志解释每次自动通过和转人工
- 用门禁判断能不能上线,尤其是危险自动放行必须为 0
一句话:
没有埋点和审计的流程自动化,验收通过的只是演示;有完整事件链的流程自动化,才可能通过生产。
你们的 LLM 工作流验收时,会统计人工接管和返工率吗?指标埋点是靠日志系统,还是单独建了事件表?评论区交流。
原文首发于公众号「程语AI」