一、起点:笔记越多,越找不到
我的知识库是纯 Markdown,一路记到 457 篇。
问题不是"没有内容",而是内容找不到。全文搜索只能匹配字面------我想找"怎么判断一条自动化任务该不该做",可笔记里写的是"日常事务自动化二分判定法",一个字都不重合。搜"去重",标题里写"重复或高度相似笔记"的那篇不会出现。
关键词检索的失效点在语义层,不在匹配层。
要补的就是这一层:把文本变成向量,让"意思相近"能被算出来。
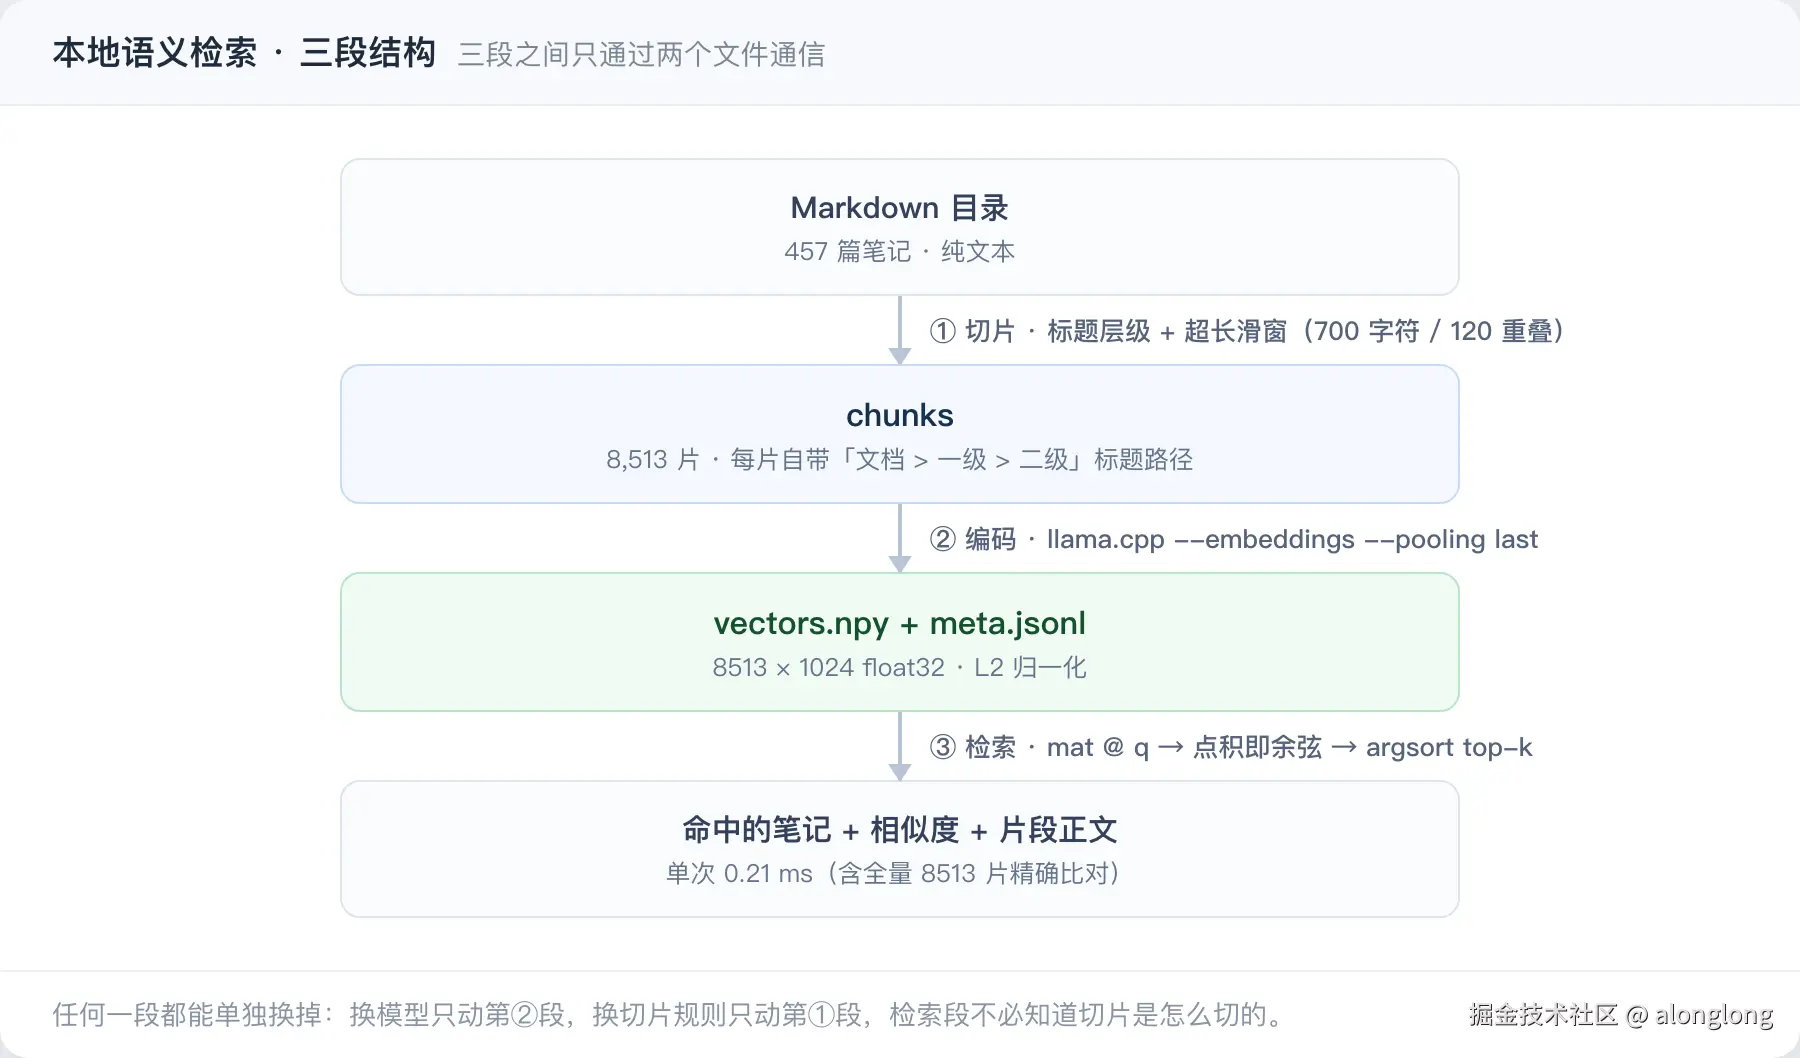
二、三段结构,每段都只有一个职责
scss
Markdown 目录
   │  ① 切片:按标题层级切段 + 超长滑窗
   ▼
chunks(8,513 片)
   │  ② 编码:llama.cpp --embeddings 批量前向
   ▼
vectors.npy (8513 × 1024, L2 归一化)  +  meta.jsonl
   │  ③ 检索:mat @ q → 点积即余弦 → top-k
   ▼
命中的笔记 + 相似度 + 片段正文
三段之间只通过两个文件通信(一个向量矩阵、一个元数据 jsonl)。任何一段不满意都能单独换掉:想换模型只动第②段,想换切片规则只动第①段,检索段根本不用知道切片是怎么切的。
三、选型:三个决定,每个都能说清为什么
决定一:为什么不上向量数据库
这是最容易过度设计的地方。先算一下规模:
| 项 | 值 |
|---|---|
| 切片数 | 8,513 |
| 维度 | 1,024 |
| 矩阵体积 | 8513 × 1024 × 4 字节 = 33.3 MiB |
三十几兆的矩阵,直接读进内存做一次点积就是全量精确检索------没有近似、没有索引构建、没有召回损失。我实测了 20 次:
yaml
检索耗时(8513 片 × 1024 维,纯矩阵点积): 平均 0.21 ms0.21 毫秒。 这个数量级上,向量数据库能提供的一切------近似索引、分片、持久化服务------都是净增加:多一个进程、多一份依赖、多一种会坏的方式,换来的是一个 0.2 毫秒的查询变成 0.2 毫秒。
什么时候该上向量数据库?我的判断线是:十万片以上,或者需要边跑边增删改。 到那个规模,np.load 整个矩阵进内存开始变得不划算,精确点积的线性增长也顶不住。除此之外,numpy 就是正确答案。
决定二:为什么用 llama.cpp 的 embedding
因为我机器上已经在跑 llama.cpp。
bash
# 先探一下现有的服务支不支持
curl -s --noproxy '*' http://127.0.0.1:8082/v1/embeddings \
  -H 'Content-Type: application/json' \
  -d '{"input":"x","model":"<alias>"}'

# 返回:
# 501 This server does not support embeddings. Start it with --embeddings
这个 501 是整件事里最有价值的一行输出。 它说明服务在、能力在,只是缺一个启动参数------不需要装新东西、不需要新环境。
于是编码这一段的全部依赖就是:一个 llama-server 进程 + 一次 HTTP POST。不需要 sentence-transformers,不需要 torch,不需要模型下载脚本之外的任何包。
决定三:为什么是 0.6B / Q8_0
| 参数 | 选择 | 理由 |
|---|---|---|
| 模型 | Qwen3-Embedding-0.6B | 1,024 维 / 32k 上下文 / 100+ 语言;再大对"笔记检索"这个任务收益递减 |
| 量化 | Q8_0 | 官方实测 min cosine 0.99887;Q4_K_M 掉到 0.943 ------ embedding 任务上低比特量化会直接伤检索质量 |
| 体积 | 639,150,592 B(609.5 MiB) | 一个文件,走镜像站直接拉 |
这里有个容易被忽略的原则:embedding 模型不是对话模型,别套用同一套量化直觉。 对话模型掉一点精度你几乎看不出来,向量掉一点精度是直接反映在排序上的。
四、切片:给每一片带上它在文档里的位置
切片规则决定检索上限------切错了,后面再好的模型也救不回来。
我用的是"标题层级 + 滑窗"两级:
第一级,按标题切。 用栈维护标题层级,让每一片都带上 文档 > 一级标题 > 二级标题 的完整路径:
知识库日常维护SOP > 操作步骤 > 每周维护为什么要把标题路径拼进去------因为一段正文脱离上下文后经常无法自证主题。比如"扫描重复或高度相似的笔记,合并建议"这段话,单看不知道在说什么;带上标题路径,它的语义就落到了"知识库维护 / 去重"这个位置上。检索时这一段的命中率就直接上来了。
第二级,超长段落滑窗。 段落超过 700 字符就切,切的时候保留 120 字符重叠,避免一句话正好被切断、两边都拿不到完整语义。低于 40 字符的碎片直接丢弃------它们只会污染向量空间。
实测:457 篇 → 8,513 片,总字符 3,387,400,平均每片 397 字符。这个粒度下,一片大致是"一个能自证主题的小节"。
五、编码:四条会静默毁掉检索质量的铁律
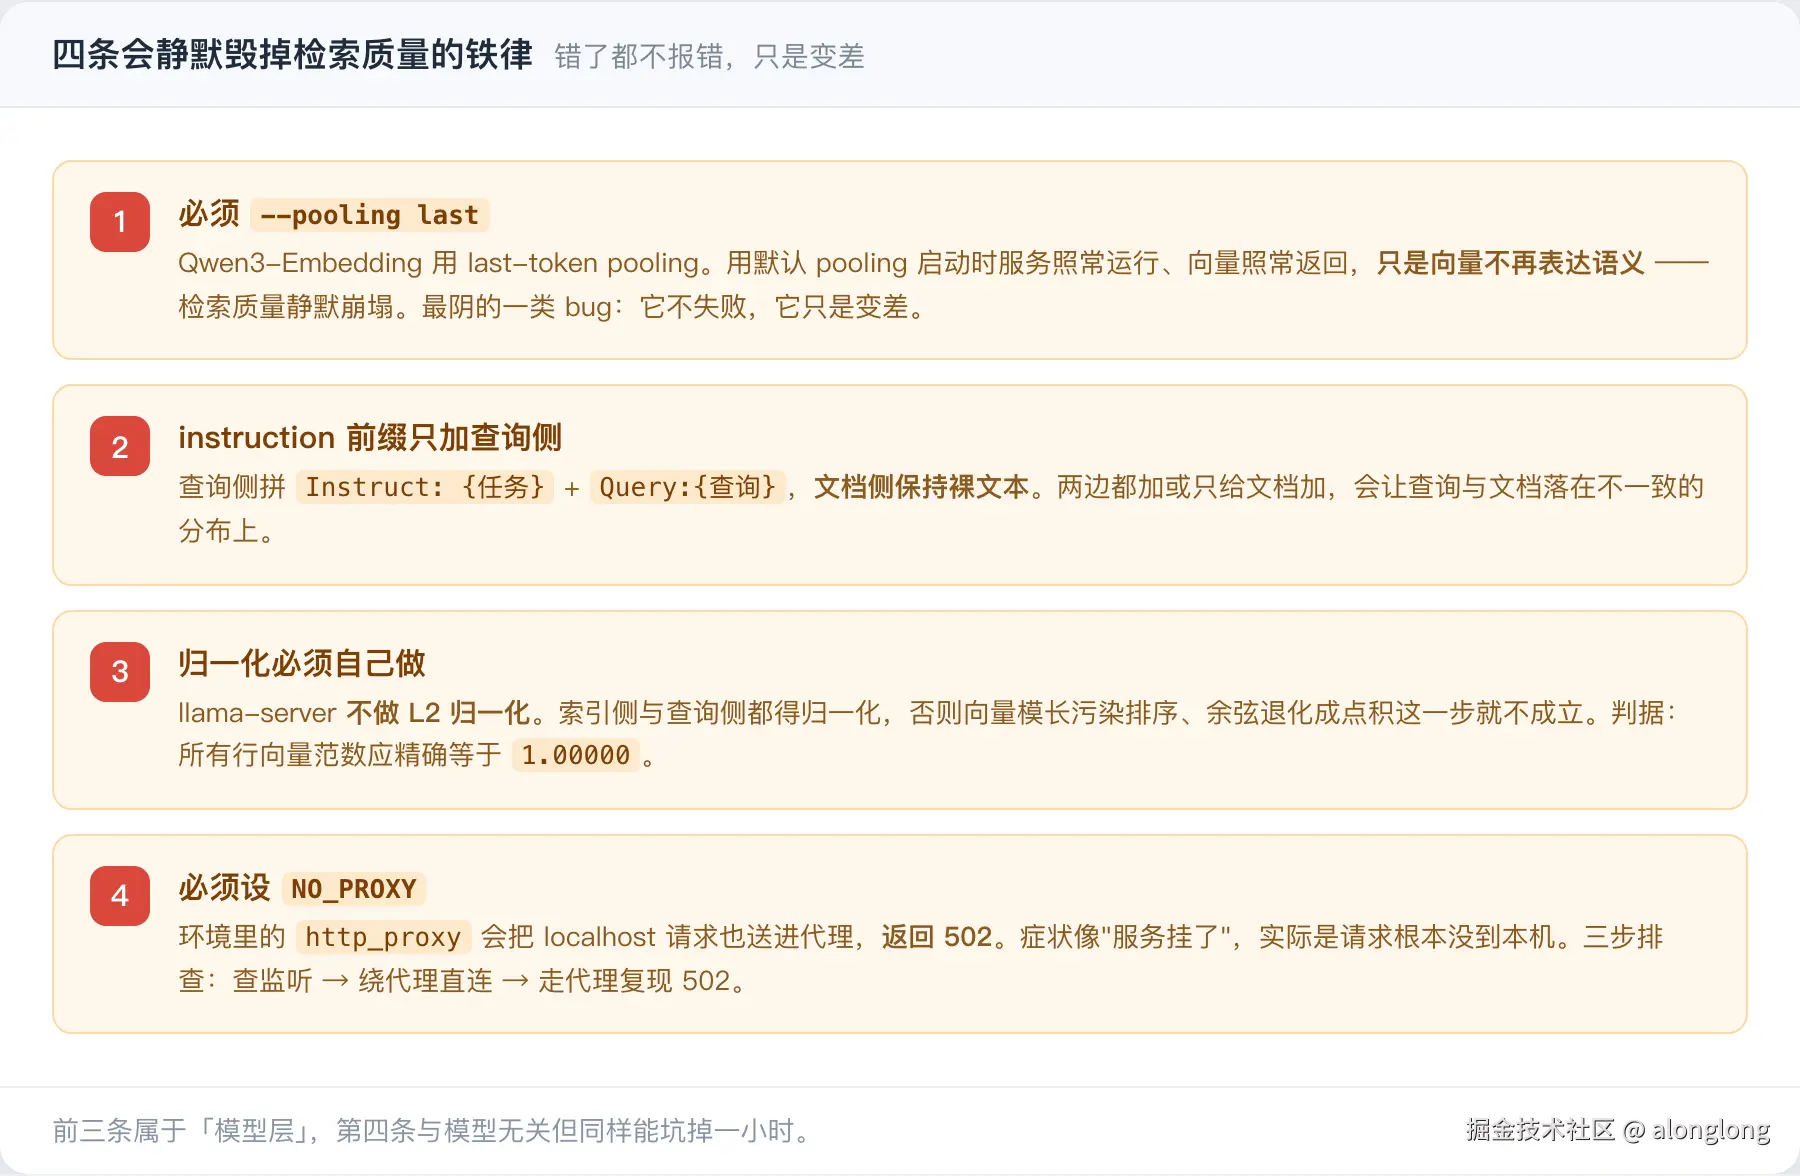
这一段代码不到 100 行,但有四个点错了不会报错------服务照样返回向量,搜索结果照样有结果,只是结果是错的。这类坑最难查,所以我单列出来。
铁律一:--pooling last 不能省
css
llama-server --model Qwen3-Embedding-0.6B-Q8_0.gguf \
  --embeddings --pooling last \
  -ngl 99 -c 8192 -ub 8192 \
  --host 127.0.0.1 --port 8084
Qwen3-Embedding 用的是 last-token pooling 。用默认的 pooling(mean / cls)不会报任何错,服务正常运行,向量正常返回------只是这个向量不再表达"这句话的意思",检索质量静默崩塌。
这是我见过最阴的一类 bug:它不失败,它只是变差。
铁律二:instruction 前缀只加查询侧,不加文档侧
Qwen3-Embedding 是 instruction-aware 的。正确用法是给查询 加一段任务说明,文档不加:
vbnet
Instruct: Given a user question, retrieve the relevant notes from a personal knowledge base
Query:怎么给笔记建立双链
文档侧保持裸文本。两边都加、或者只给文档加,都会让查询和文档落在不一致的分布上。
铁律三:归一化必须自己做
llama-server 不做 L2 归一化。 索引侧和查询侧都得自己归一化,否则向量模长会污染排序结果------余弦相似度就退化不成点积了。
归一化之后有个可验证的判据:所有行向量的 L2 范数应该精确等于 1。实测:
arduino
norm min/max 1.00000/1.00000看到这个数,说明归一化这一环是对的。没归一化的话,这一行会给出五花八门的值------这是个 5 秒钟就能做完的健康检查,值得每次都跑。
铁律四:NO_PROXY 必须设(这条和模型无关,但能坑你一小时)
我本机环境里有一次请求返回:
vbnet
urllib.error.HTTPError: HTTP Error 502: Bad Gateway访问的是 127.0.0.1:8084------本机端口,怎么会 502?
查下来是环境变量里的 http_proxy 把 localhost 请求也送了进去 ,代理连不上目标就回 502。症状看起来像"服务挂了",实际是请求根本没到本机。
所以脚本里显式写了:
bash
export NO_PROXY=127.0.0.1,localhost排查这类问题有个三步顺序,能立刻分清是"服务真挂了"还是"被代理拦了":
bash
lsof -nP -iTCP:8084 -sTCP:LISTEN                                   # 谁在听?空 = 服务真不在
curl -s --noproxy '*' -m 3 http://127.0.0.1:8084/health            # 绕代理直连
curl -s -m 3 -o /dev/null -w "%{http_code}\n" http://127.0.0.1:8084/health   # 走代理 → 502
六、构建结果:一次真实的全量跑批
yaml
扫描到 457 个 md 文件
切出 8513 个片段
  ...
  8496/8513  用时 514s

✅ 完成:8513 片 × 1024 维,用时 515s| 指标 | 实测值 |
|---|---|
| 扫描文件 | 457 篇 Markdown |
| 切片数 | 8,513 |
| 向量维度 | 1,024 |
| 构建耗时 | 514.9 秒 |
| 失败任务 | 0 |
| 被截断的片段 | 0 |
vectors.npy |
34,869,376 B |
meta.jsonl |
9,287,419 B |
| L2 范数 | min = max = 1.00000 |
| NaN / Inf | 无 |
515 秒 ≈ 8.6 分钟,约 16.5 片/秒。对"一天跑一次"的场景,这个速度完全够用。
(顺带一个实现细节:meta.jsonl 里连正文一起落盘,所以它从 1.5MB 涨到了 9.3MB。值得------不然检索出结果后还得回读源文件、再按偏移量定位片段,多一次 I/O 还容易错位。)
七、检索:从查询到命中
python
q = embed("Instruct: {task}\nQuery:{query}")   # 编码 + L2 归一化
sims = mat @ q                                  # 索引已归一化 → 点积即余弦
order = np.argsort(-sims)                       # 取 top-k
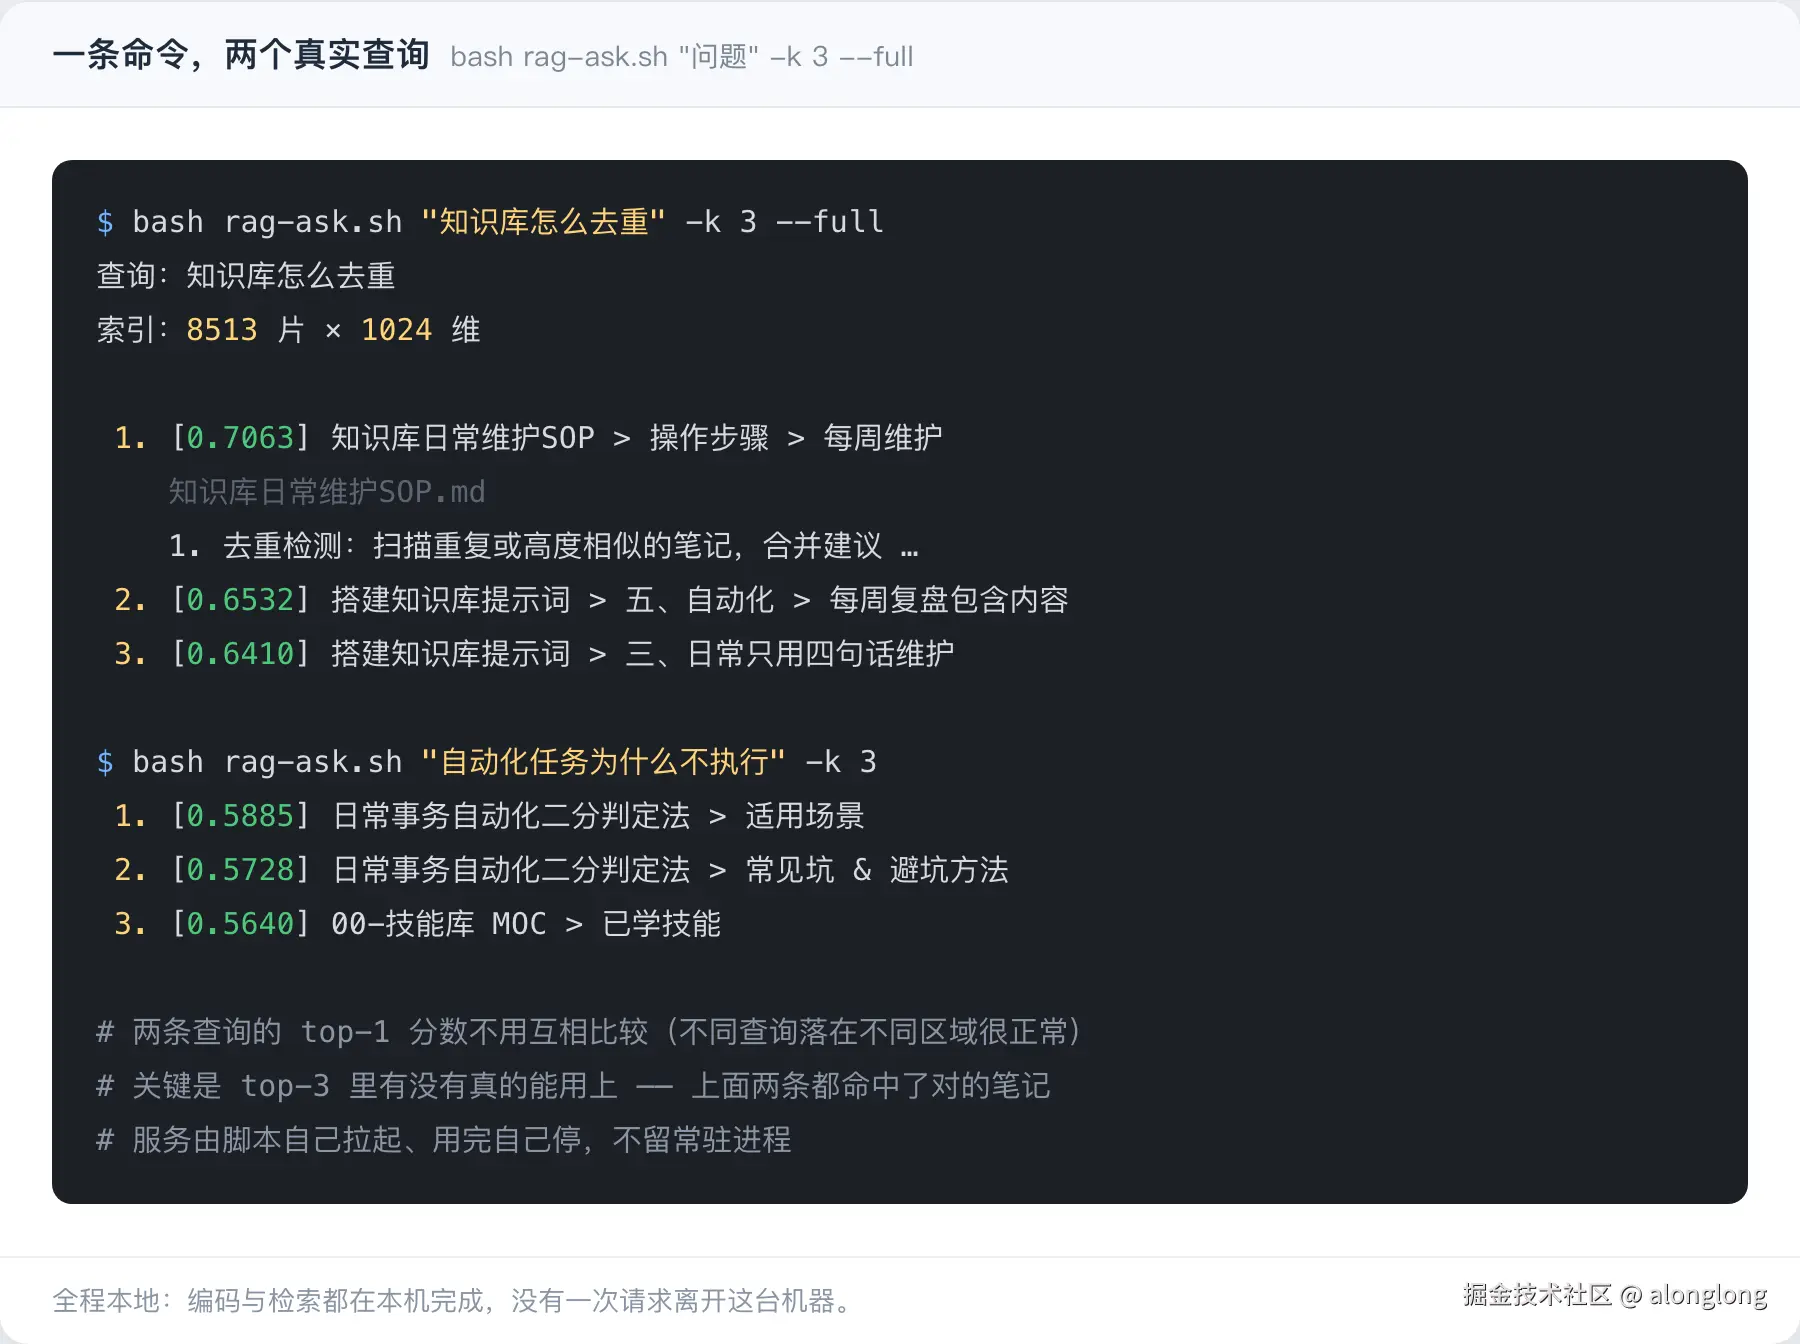
跑两个真实查询:
查询一:知识库怎么去重
markdown
 1. [0.7063] 知识库日常维护SOP > 操作步骤 > 每周维护
    知识库日常维护SOP.md
    1. 去重检测:扫描重复或高度相似的笔记,合并建议 ...

 2. [0.6532] 搭建知识库提示词 > 五、自动化 > 每周复盘包含内容
    1. 去重检测:扫描重复或高度相似笔记,给出合并建议 ...

3. [0.6410] 搭建知识库提示词 > 三、日常只用四句话维护查询二:自动化任务为什么不执行
css
 1. [0.5885] 日常事务自动化二分判定法 > 适用场景
 2. [0.5728] 日常事务自动化二分判定法 > 常见坑 & 避坑方法
 3. [0.5640] 00-技能库 MOC > 已学技能
两条查询的 top-1 相似度分别是 0.7063 和 0.5885------分数高低不用互相比较(不同查询落在不同区域很正常),关键是 top-3 里有没有真的能用上。上面两条都命中了对的笔记。
八、一次推翻"常识"的实测:instruction 前缀真的会涨分吗
 官方文档说得很硬:"没有 last-token pooling 和 instruction 前缀,检索质量会崩。"
--pooling last 我照做了(不报错的静默劣化,没法不照做)。但 instruction 前缀这一条,我想知道到底涨多少。于是做了 A/B:同一批查询,裸查询 vs 带前缀,比 top-1 余弦。
第一轮结果(定量):
| 查询 | 裸查询 top-1 | 带前缀 top-1 | 差值 |
|---|---|---|---|
| 知识库怎么去重 | 0.7063 | 0.6767 | −0.0296 |
| 定时任务启动失败看不到日志 | 0.5752 | 0.5605 | −0.0147 |
| 怎么给笔记建立双链 | 0.6661 | 0.6626 | −0.0035 |
| 本地模型怎么切换 | 0.5976 | 0.6499 | +0.0523 |
| 图文平台封面怎么不被裁切 | 0.6676 | 0.6793 | +0.0117 |
平均 +0.0032 ------ 基本等于没有,而且 5 个里 3 个是负的。
如果就此下结论"前缀没用",那就掉进坑里了。问题出在指标本身:
加了 instruction 前缀之后,查询向量进入了另一个子空间。它的余弦绝对值,和裸查询的余弦绝对值,本来就不在同一个刻度上。
拿两个不同刻度的数去比大小,得到的差异不是"效果差异",是"刻度差异"。
于是我换成定性 判据:不看分数,看命中的片段是不是更贴题。
第二轮结果(定性):
自动化任务为什么不执行:
| top-1 命中 | 是否贴题 | |
|---|---|---|
| 裸查询 | 日常事务自动化二分判定法 › 适用场景 | 讲"什么时候用",没回答"为什么不执行" |
| 带前缀 | 日常事务自动化二分判定法 › 常见坑 & 避坑方法 | 直接命中"坑",贴题 |
笔记双链怎么做:
| top-2 命中 | 是否贴题 | |
|---|---|---|
| 裸查询 | 抖音双号关联风控评估法 | 与双链无关("双"字带偏) |
| 带前缀 | 知识库日常维护SOP › 新笔记入库检查 | 命中"是否加了至少 2 个双链关联",贴题 |
4 个查询里,2 个明显更准、2 个持平,没有一个变差。
结论(我把两轮都写出来,因为过程本身就是重点):
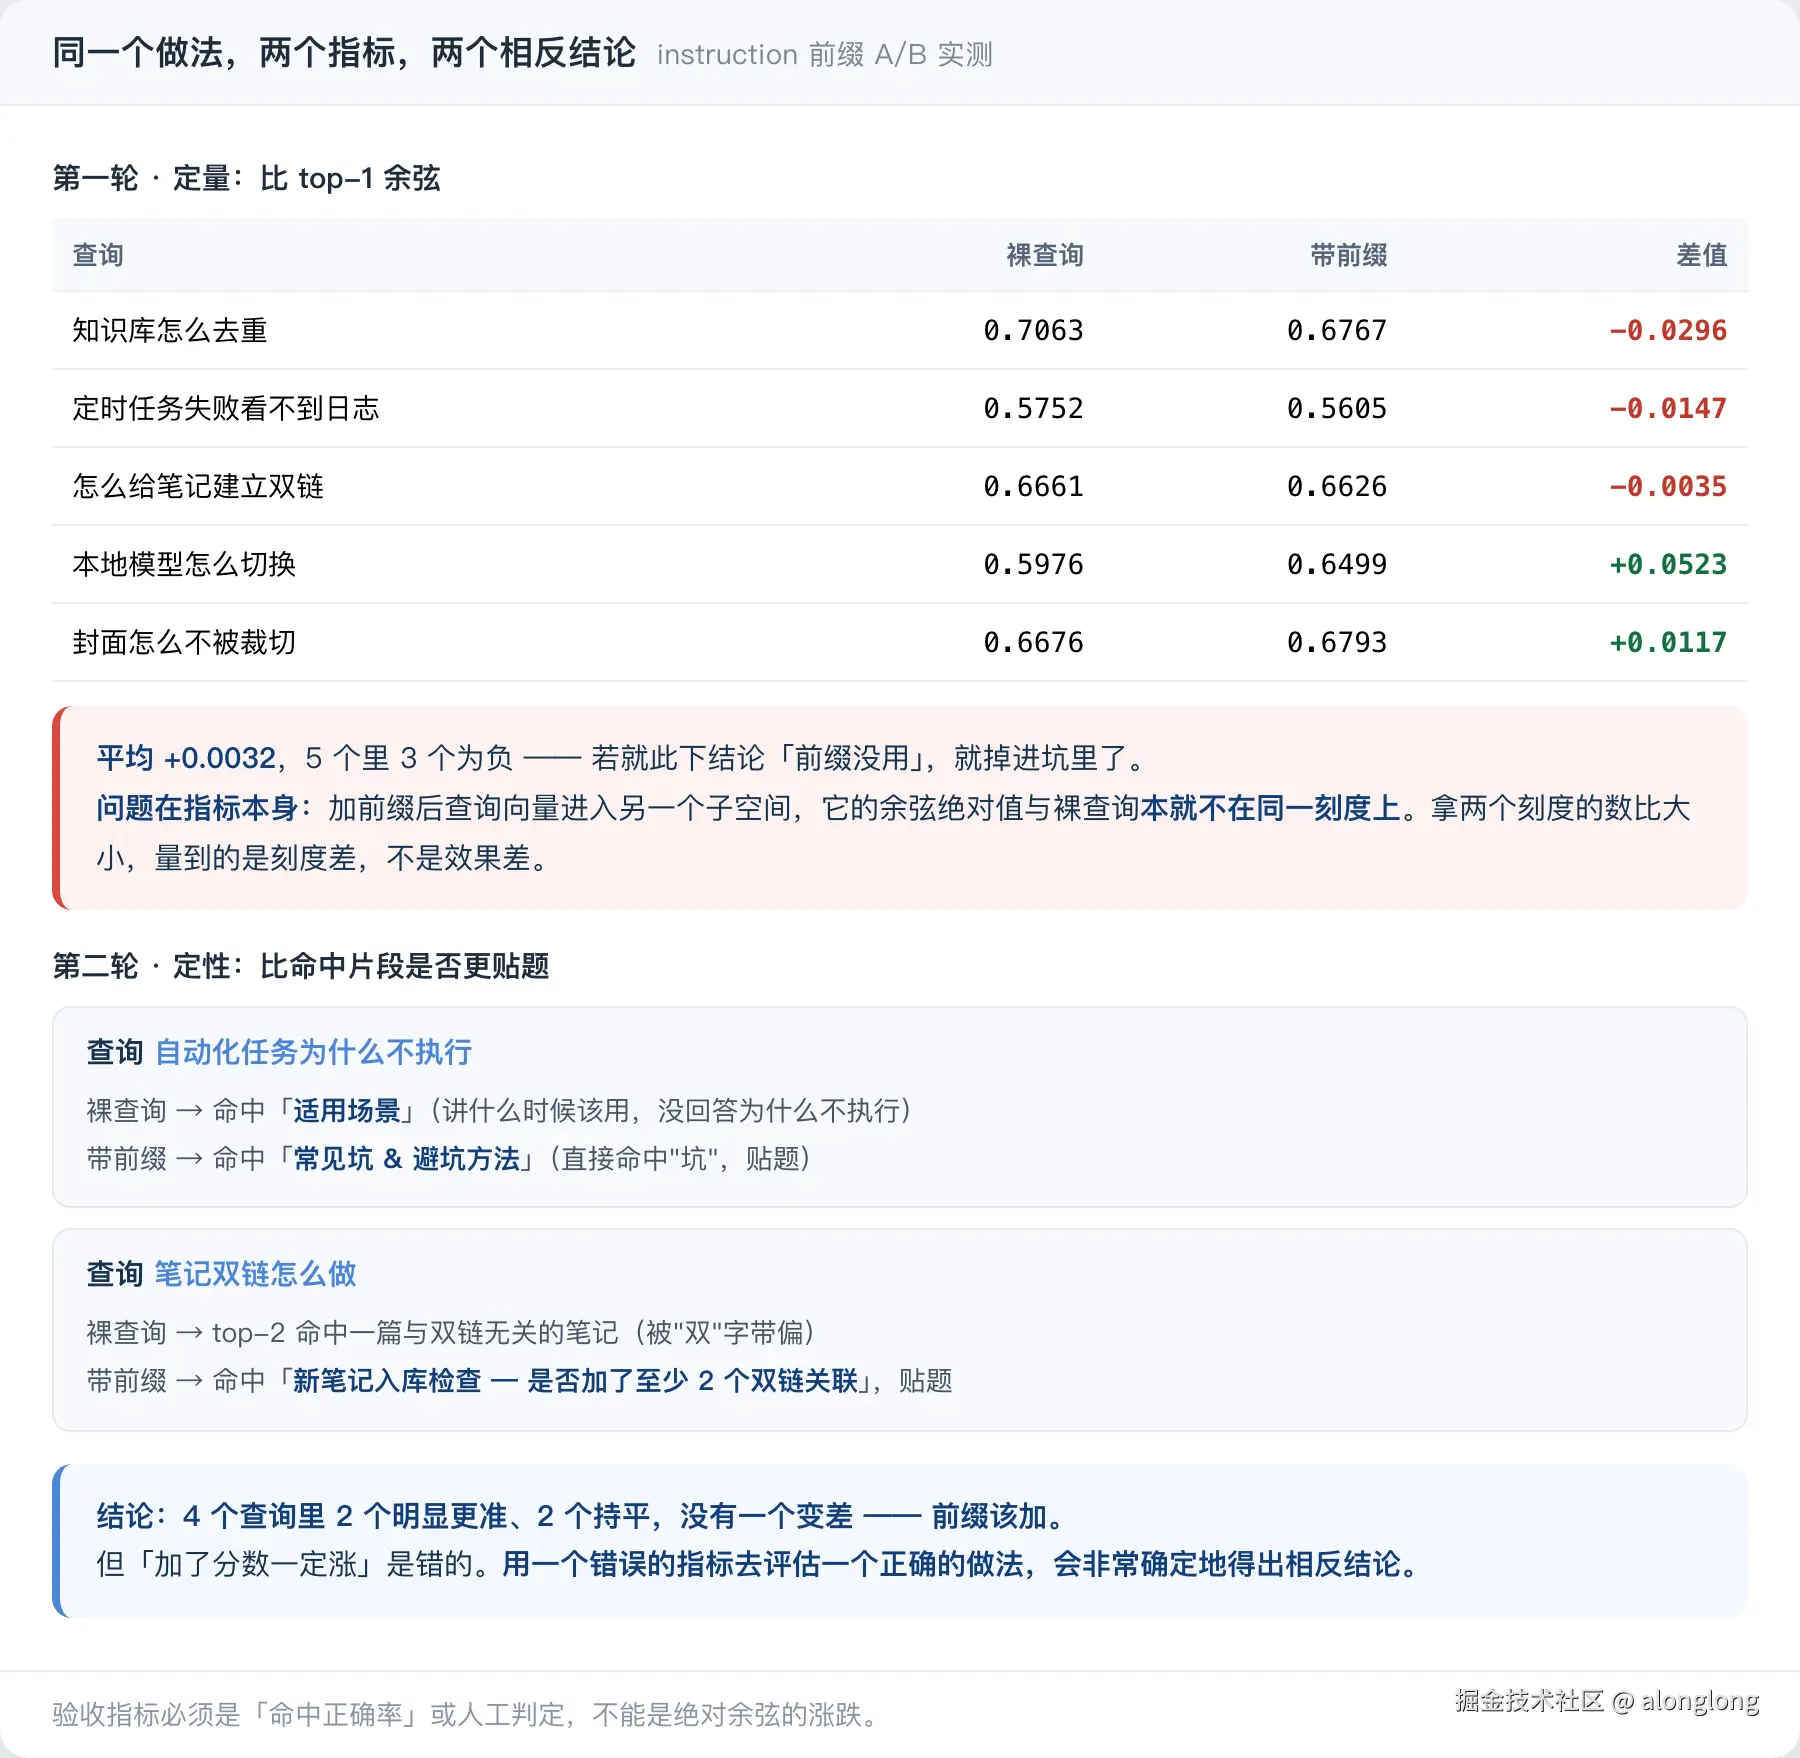
- 前缀该加------模型训练时就带指令,不用等于让查询落在模型不熟悉的分布上;
- 但**"加了分数一定涨"是错的**。绝对余弦不是有效判据;
- 验收指标必须是"命中正确率"或人工判定,不是分数涨跌。
这条教训比"记住要加前缀"更有用:当你用一个错误的指标去评估一个正确的做法,你很可能得出"这个做法没用"的相反结论。
九、三个把我绊住的实际问题
问题一:进程跨调用被回收,长任务必须一次跑完
搭建过程中我最迷惑的是:起了服务、验证通过,下一分钟它就不见了。
原因是我所在的环境里,由一次调用派生的后台进程会在调用结束时被回收。这直接改变了工程做法:
- 构建脚本必须自己管服务:一次调用内完成"起服务 → 编码 → 停服务",中途不能依赖上一次调用留下的进程;
- 日常检索要包装成命令:每次自己拉起、用完自己停,而不是假设"服务应该一直在"。
问题二:模型刚起来的 2 秒内首次请求会失败
/health 会先返回就绪,但模型可能还在加载。这时候第一个请求拿到的不是向量,是错误体------如果代码直接取 data[0] 就炸。
对策 :批量编码必须有重试(3 次 + 退避),不能一次失败就放弃整批。这个不修,构建会在最后一刻随机挂掉,而且看起来像"模型有问题"。
问题三:索引只存路径+标题,会导致检索结果展不出来
这是我自己写出来的 bug。检索脚本要打印命中片段,读的是 meta.jsonl 里的 text 字段------但索引脚本当时只写了 rel 和 title。必然 KeyError。
修法就是上面说的:索引侧连正文一起落盘。索引文件应该自包含------检索侧不该再回头去读源文件。
十、现状、代价和没做完的
跑通的 :457 篇 → 8,513 片的索引;语义检索命中相关笔记;rag-ask.sh 一条命令完成"起服务 → 检索 → 停服务";检索已经接进聊天页 ------点开开关提问,会先检索本机知识库、把命中的片段作为上下文一起发给模型;增量重建 ------无变更时 0.1 秒(对比全量 514.9 秒),改一个文件只重编那几片;索引每日凌晨自动重建,早上检索到的是最新笔记。
有代价的:
- 全量重建 515 秒 (
--full)。日常走增量,只有清单丢失、或换了模型/目录范围才会退化为全量。 - 编码跨进程有约 1e-4 的位级差异 (同进程内完全可复现)。所以索引的回归判据只能是"Top-K 命中是否变化",不能用文件哈希------我实测过:改了文件再重建,哈希必变,但 Top-10 命中行完全一致(cos 0.9999998)。只有"0 个切片重编"的那一次,哈希才逐字节不变,我拿那一次证明了复用路径零漂移。
- 检索质量依赖切片质量。切片规则是启发式的,长表格、长代码块切出来效果一般。
- 有静默丢弃:切不出 ≥40 字符片段的小文件会被排除(当前 456/457),日志里只有一行提示。
- embedding 服务要占 GPU。和对话模型抢统一内存,所以我把它设计成"用完就停",不做常驻。
没做完的:
- 重排(rerank):先向量召回 20 条、再用小模型重排到 5 条,是标准的第二步,还没做;
- 索引保鲜到分钟级:现在是每天凌晨增量重建一次,白天新写的笔记要等下一轮才进索引;
- 多轮检索:现在是每次提问独立检索,没有跨轮的话题延续。
十一、小结
如果重来一次,我的判断顺序会是这样:
- 先算规模,再选架构。 8,513 片 × 1,024 维 = 33 MiB,点积 0.21 ms------这个数量级上向量数据库是负债不是资产;
- 先探已有能力,再决定装什么。 一个 501 告诉我"加个
--embeddings就行",省掉了一整套依赖; - 把"不报错的坑"单列出来。
--pooling last、归一化、instruction 前缀,三个错了都不报错,只是变差; - 验收指标错了,正确的做法会被判成错的。 用"命中正确率"验收,不要用绝对余弦。
- 别把"可复现"当默认假设。 我一度以为"内容没变 → 哈希不变",实测才发现编码跨进程有 1e-4 的非确定性。先验证可复现性,再决定回归判据------用什么去验,本身也需要先验。
最后一句:检索这件事的价值不在"能搜",在"搜得到"。 一套检索如果 top-3 里没有你要的东西,它和 grep 相比唯一的优势就是更慢。
复现清单
| 文件 | 行数 | 职责 |
|---|---|---|
rag-index.py |
380 | 切片(标题层级 + 滑窗)→ 批量编码 → 归一化 → 落盘(含增量清单比对) |
rag-search.py |
90 | 带 instruction 前缀查询 → 余弦 top-k |
rag-build.sh |
46 | 一次调用内完成「起服务 → 索引 → 停服务」 |
rag-ask.sh |
42 | 日常入口:自动拉起服务、检索、用完停掉 |
核心四个文件合计 558 行 (另有两个 A/B 实验脚本 72 行)。除 llama-server 外,只依赖 Python 标准库 + numpy。
索引产物:vectors.npy(8513 × 1024 float32)+ meta.jsonl + index_state.json。