你让 Agent 修一个 bug。前十轮它干得不错,第十五轮开始它忘了自己改过什么,第二十轮它一本正经地引用了一段根本不存在的代码,最后 token 烧完,任务烂尾。
多数人的反应是换个更贵的模型。但我把 Codex 的源码读了一遍之后发现:失忆、幻觉、破产,三件事的根因是同一个------你把"聊天式上下文策略"搬到了代码库场景。聊天机器人的打法是"把可能相关的内容都塞进 prompt",这套思路在代码库里必死,而且是物理层面的死。
这篇文章讲清楚:为什么塞必死、Codex 的替代方案是什么、上下文预算怎么管、跑长了怎么"交接班"。全部结论带源码证据(Codex Rust 版 commit 2685e3a4)。上一篇讲了编辑工具(《Agent 改代码为什么总把仓库改坏》),这一篇往前走一步:代码还没改之前,它怎么找到那该改的几行。
一、"塞 prompt"在代码库场景必死:三个死因
死因一:数量级差距,装不下。 一个中型仓库轻松超过 100 万行,按代码每行 8-15 token 折算是千万 token 级。128k 窗口装下它的 2-3%,即使 1M 窗口也只装得下 13-19%------而一个任务真正需要的"相关代码"往往只有几千行,占总量的千分之一。所以问题从一开始就不是"怎么塞",而是"怎么找到那千分之一"。
死因二:塞满的窗口,中段是盲区。 就算窗口真够大,塞满也有独立代价:模型对中段内容的召回显著变差(lost in the middle,Liu et al., 2023)。头部的系统提示词和尾部的最新输入被注意力偏爱,中间那一大坨"你辛苦塞进去的相关内容"恰恰最容易被无视。预算花了,买来的是心理安慰。
死因三:上下文是活的,还会说谎。 这是编程 Agent 独有的:Agent 自己的每个动作都在改变上下文的客体。看一个真实时序------模型 read 了 parse_config() 的定义(进了上下文)→ 下一轮修改了它的签名 → 此时上下文里那份定义已作废,而模型不知道 → 它基于旧签名继续写调用方 → 编译错误,且错误指向一段"它亲眼读过"的代码。静态预装的内容以每回合一次的速度腐烂。
三个死因指向同一个结论:
| 思路 | 隐含假设 | 结局 |
|---|---|---|
| 全量塞入 | 仓库装得下 | 数量级差距,装不下 |
| 精选塞入(RAG 式预检索) | 相关性可以在任务开始时确定 | 相关性随任务推进漂移;中段召回差 |
| 检索式(Agentic Retrieval) | 模型自己决定何时取、取多少 | 上下文只留坐标和结论,代码按需进入 |
Codex CLI 正是这么做的:它的上下文里常驻的不是代码,而是系统指令 + AGENTS.md + 对话历史。代码永远按需进入。
二、检索工具栈:四件套的粒度设计
检索的核心设计原则是粗到细的漏斗------每个工具返回的信息量控制在"模型一屏能扫完":
| 工具 | 粒度 | 返回什么 | 典型 token 量 |
|---|---|---|---|
| ls | 目录 | 当前层级结构 | 数十 |
| glob | 文件名模式 | 候选文件路径列表 | 数十到数百 |
| grep | 符号/字符串 | file:line 坐标 + 命中行 | 数十到数百 |
| read | 行区间 | 带行号的源码片段 | 数百到数千 |
ls 给结构感 ,glob 给候选集 ,grep 给坐标 ,read 给细节------信息量逐层放大,token 花费也逐层放大,所以顺序不能反。
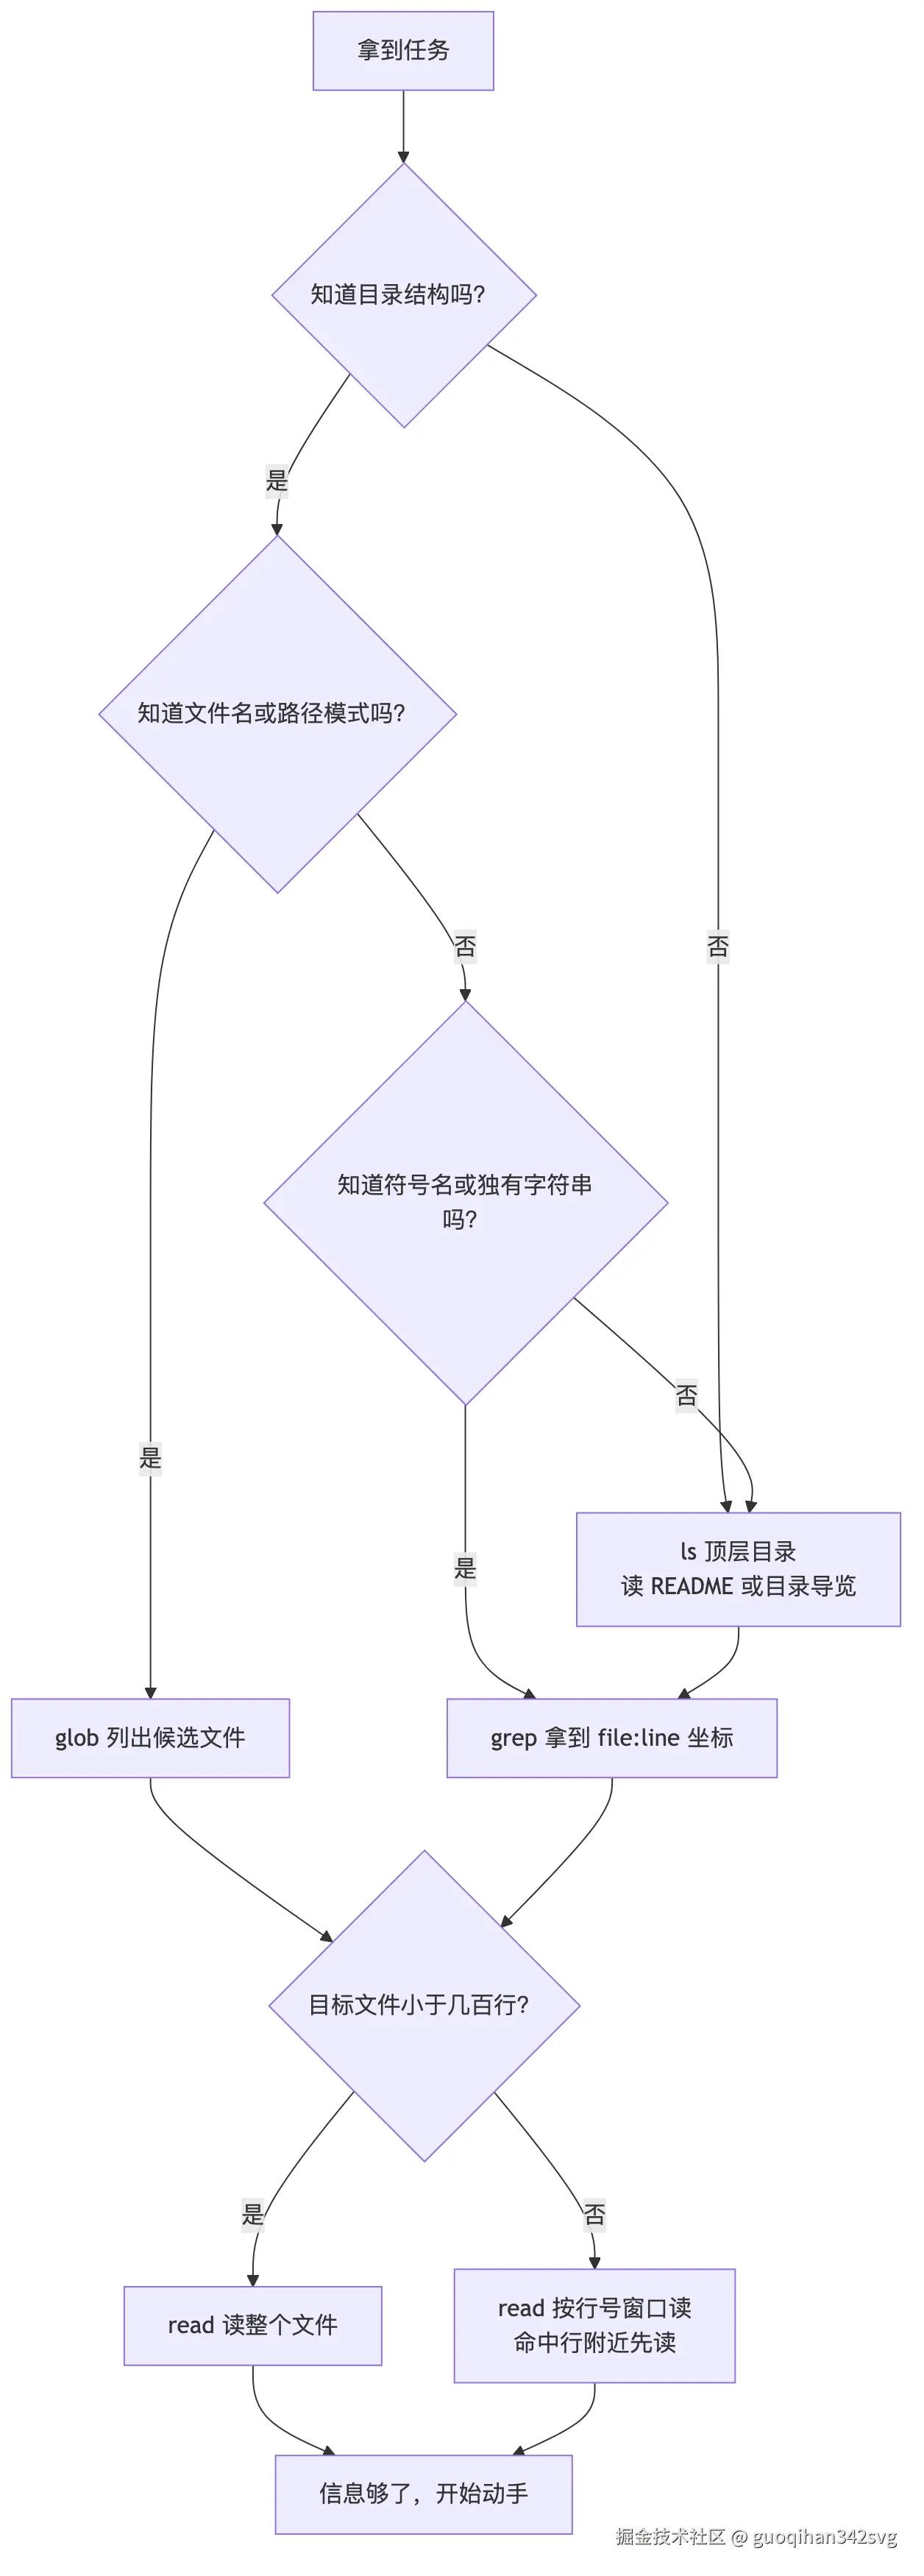
图解:决策树分叉的依据是"你手里已有什么坐标"------什么都没有就先 ls 建立结构感;有任何一种坐标(文件名/符号名)就直奔 glob 或 grep。整读的阈值给个经验数:300 行以内整读不亏;超过 1000 行必须 grep 定位后开窗读。
三条实现细节,条条都是踩坑换来的:
- read 带行号是硬要求。read 的下游是编辑,无论 search/replace 还是 patch 都需要锚定------没有行号,模型连"第 47 行"都数不出来。
- grep 输出带
file:line:前缀。这个前缀本身就是下一次 read 的入参,模型可以零转换接力。 - 一切返回都要设上限 。Codex 对命令输出按字节截断(
retained_bytes_cap,codex-rs/core/src/exec.rs:752-761)。宁可截断后让模型补一页,不可一次吃掉半扇窗口。
顺带回答一个架构选型问题:Codex 核心其实没有内置 read/grep/glob 工具 ,它直接把 shell 交给模型,检索原语就是模型自己拼的 rg、cat -n、ls。固定四件套 vs shell 自由检索的取舍这里不展开,结论是:要点不在工具形态,而在三条不变量------粗到细的漏斗、返回带坐标、输出有上限。满足这三条,两条路线都能用。
三、读多少、怎么截断:全部秘密在截断之后
单次 read 的上限是个两难:太高,一次吃几千 token;太低,一个函数要读三四次,回合数暴涨。经验起点:默认 800-2000 行/次,暴露 offset/limit 让模型自己决定深浅。真正决定成败的是截断之后发生什么------三条纪律:
- 保头保尾,中间可折叠。 import 和类型定义集中头部,收尾逻辑在尾部,中段长函数体最可以牺牲。
- 截断必须显式告知。 这是整篇最重要的一句话:把"没读完"诚实地告诉模型。模型对未标注的截断的处理方式是臆测------它会一本正经地引用根本不存在的代码,且语气自信。这是最难排查的故障之一。
- 大文件与二进制直接拒绝。 检测到 null byte 的拒绝整读;超过阈值(比如 5MB)的文本要求带 offset 分段。
同一份截断,提示写法的正反对比:
text
坏:...(输出过长已截断)...
模型的理解:后面是没了,还是工具坏了?→ 倾向于自行补全缺失部分

好:[已显示第 1-400 行与 9711-9911 行,中间 6571 行已折叠;offset=400 可继续读取]
模型的理解:一张明确的地图 + 一个明确的下一步动作区别在于"好"的版本把三件事说全了:截了哪里、还剩多少、怎么继续。缺任何一件,模型都会用自己的想象补上------而它的想象永远不会承认自己是编的。
四、上下文预算:工具输出占大头,稳定内容是钱袋子
一个典型编程 Agent 会话中,各类内容占窗口的经验配比:
| 层 | 内容 | 经验配比 | 变化频率 |
|---|---|---|---|
| 第 1 层 | 系统提示词 + 工具定义 | 3-8% | 永远不变 |
| 第 2 层 | AGENTS.md + 环境信息 | 2-5% | 每仓库不变 |
| 第 3 层 | 任务描述 + 用户约束 | 2-5% | 每任务不变 |
| 第 4 层 | 对话历史 | 15-25% | 每轮追加 |
| 第 5 层 | 工具输出(grep/read/exec) | 55-75% | 每轮爆炸式增长 |
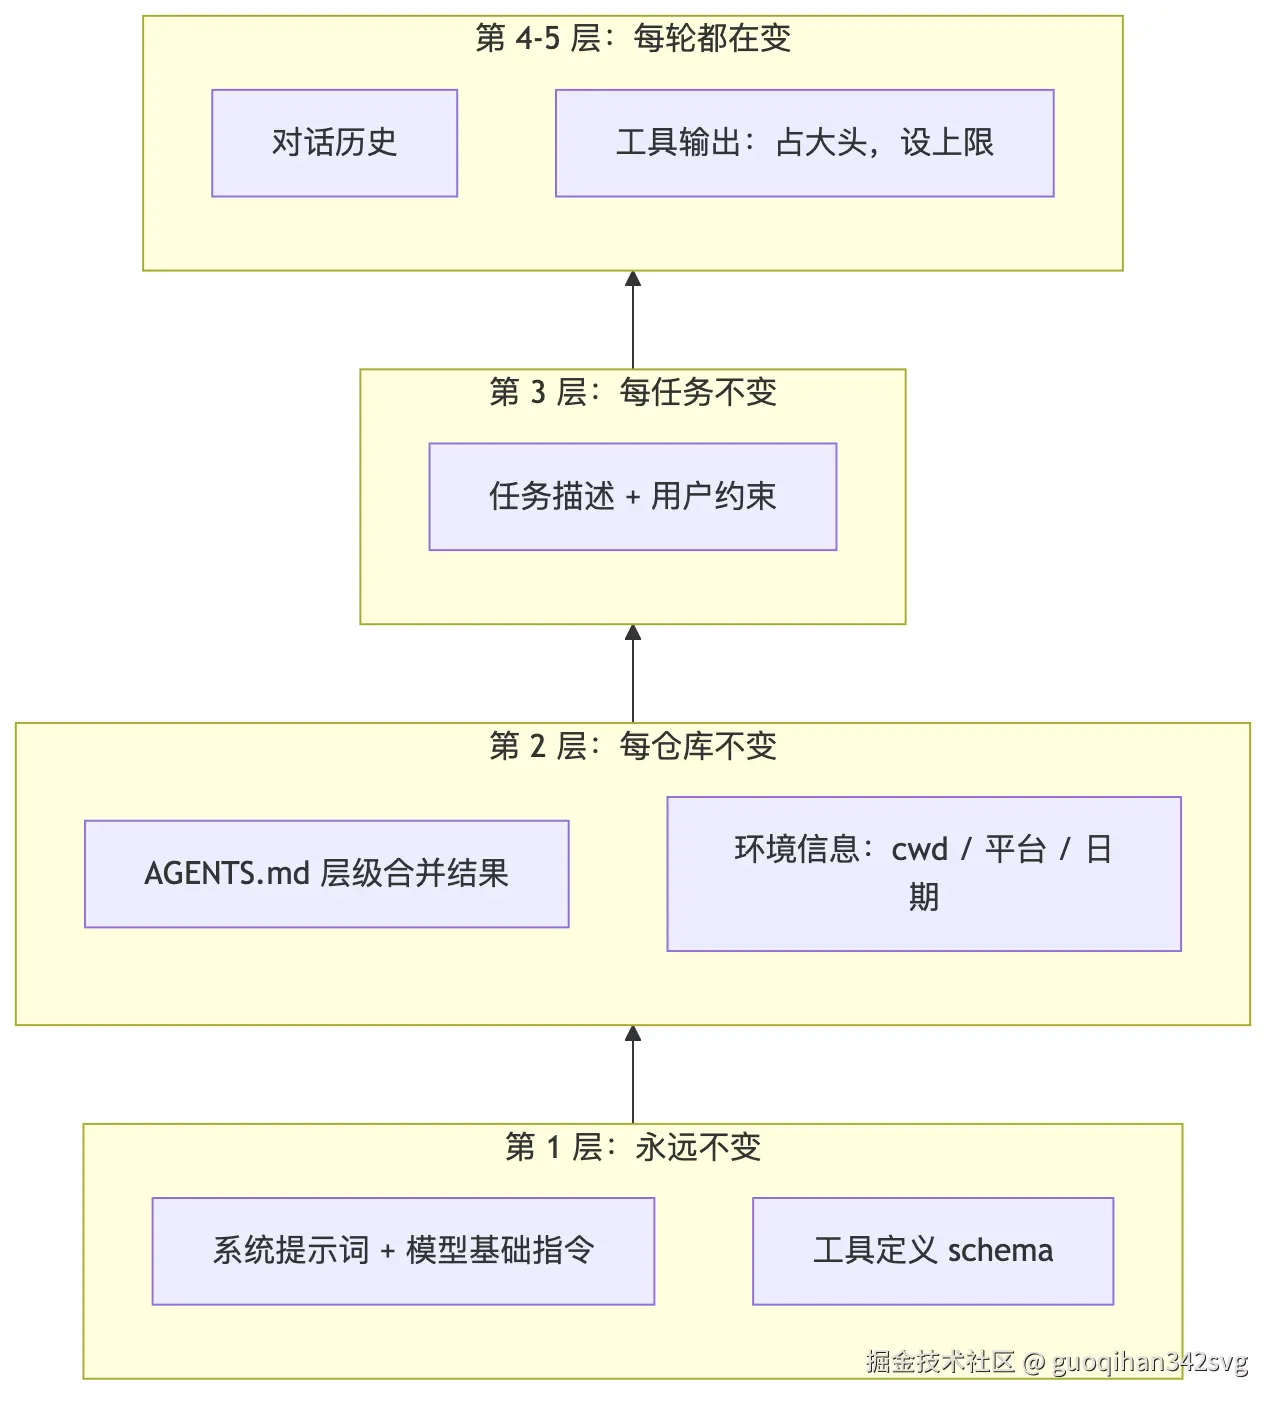
两个方向性事实不可妥协:
工具输出必须占绝对多数------占比太低说明模型检索得太少,在靠猜干活。
排列顺序本身就是成本问题。 主流模型的 prompt cache 按前缀命中:从第一个 token 开始的最长公共前缀可以复用,前缀一旦变化,其后所有内容的缓存全部失效。把每轮都在变的工具输出插在系统提示词后面,等于每轮都把后面所有内容变成"未缓存",成本差出一个数量级。原则只有一条:稳定内容在前,易变内容在后,每轮变化的东西尽量靠近窗口尾部。
Codex 在这点上有个容易被忽略的设计:基础指令不来自本地拼装的 md 文件,而是取自模型目录的 instructions_template(codex-rs/prompts/src/model_instructions.rs:8)------指令跟模型走而不是跟仓库走,保证"同一模型 + 同一仓库"场景下第 1 层字节级稳定,prompt cache 从第一个 token 就命中。
预算不能只写在文档里,要有运行时守卫 :per_call 上限防"一次 cat 吃掉半窗"的事故,per_turn 累计上限防"每次都合规、十次吃满窗"的温水煮青蛙------只设前者的系统,会在第 8 次工具调用时莫名其妙触顶。
五、压缩 compaction:长任务的「交接班」
预算管得再好,长任务也必然触顶。压缩是最后的安全网,三个问题按序回答:
何时压:水位触发,不要等溢出。 Codex 给每个模型配 model_auto_compact_token_limit(codex-rs/config/src/config_toml.rs:181),达到水位即自动压缩;实际可用窗口按 95% 计(effective_context_window_percent),为压缩本身的输出预留缓冲。还有个隐蔽的坑:压缩要尽量发生在回合边界------若压缩发生在工具调用序列中间(模型刚 read 完还没 edit),摘要一旦丢失"已读未改"的状态,接手的模型会重读一遍甚至改错对象。
留什么:摘要是交接文档,不是内容缩写。 Codex 的压缩提示词把任务定义为"为另一个即将接手的 LLM 写交接摘要",强制包含四块:
| 必须保留 | 丢了会怎样 |
|---|---|
| 任务目标与验收标准 | 模型忘了目标就会开始"自由发挥" |
| 已完成修改清单(文件 + 意图) | 重复劳动、互相覆盖 |
| 关键符号与路径(file:line 级坐标) | 编辑打偏、找不到定义 |
| 失败尝试与原因 | 在同一个坑里摔第二次 |
压完怎么继续:立刻重检索。 压缩即信息丢失,没有例外。摘要再好也装不下所有符号定义,而丢掉的恰恰是"现在用不上、五分钟后要用"的那种。所以压缩流程的最后一步必须是:按摘要里保留的坐标,重新 grep/read 即将操作的定义。把重检索设计成压缩协议的一部分,而不是指望摘要面面俱到。
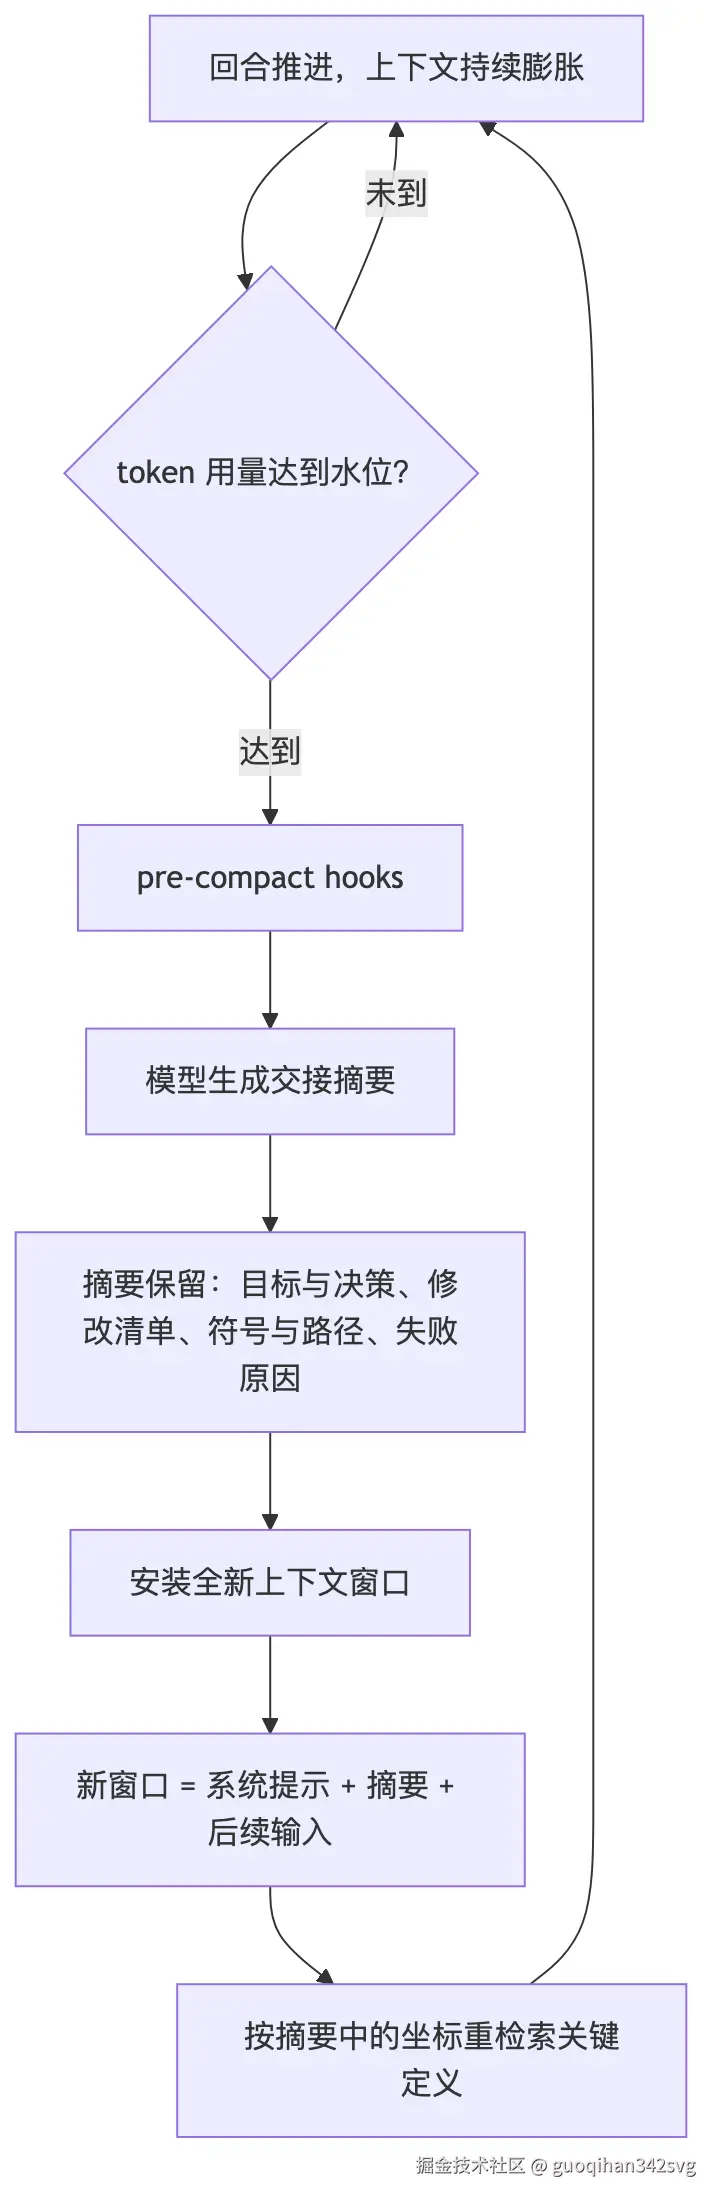
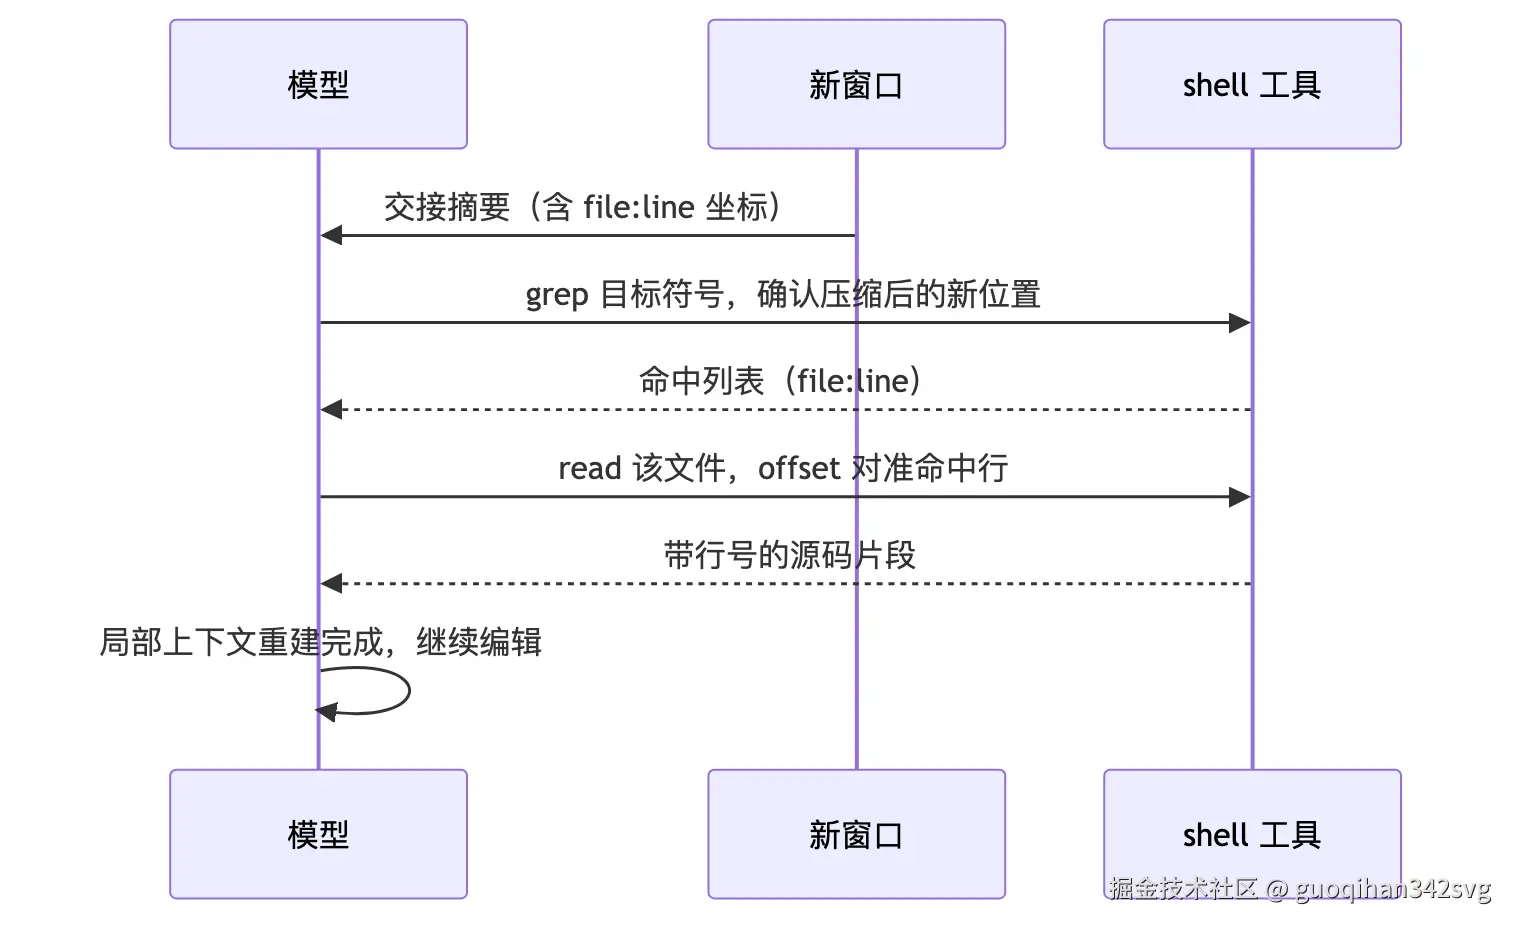
最后一个反直觉的事实:压得更频繁不等于更安全 。摘要本身也占窗口,长任务会发生二次压缩------模型面对"摘要 + 少量新对话",最省力的输出是把摘要再压缩一遍。信息每压缩一次丢一层,代际损失是复利的。对策:水位不要定得太低,给压缩后的窗口留足纯增量空间;并且把压缩事件连同原始历史一起持久化(Codex 的 rollout 日志就是这么做的),恢复会话时可以基于原始历史重新生成一份更好的摘要,而不是在旧摘要上叠新摘要。
六、AGENTS.md:每一行都要值得每个会话为它付一次 token
AGENTS.md 是常驻预算(第 2 层)的主要 occupants。Codex 对它的处理有三个值得抄的细节:层级合并 (从项目根到 cwd 逐层拼接,根到叶顺序意味着模型读到的最后一条是最具体的规则)、字节上限 (全部内容合计默认 32 KiB ,AGENTS_MD_MAX_BYTES,装载时按剩余预算截取)、不重复(通用规范已在基础指令里,AGENTS.md 只补仓库特有信息)。
该写什么(按优先级):
- 构建/测试命令:哪个命令是"改完必须跑的"?这是模型最需要、又最难自己发现的信息;
- 目录导览 :不是文件清单,是地图注释------
core/ 是领域逻辑,web/ 是 HTTP 层,改协议先看 proto/; - 代码风格约定 :只写与主流惯例不同的部分;
- 禁区:哪些目录勿碰、哪些是生成产物不许手改。
反面示例,每一条都在真实项目里随处可见,每一条都在烧钱:
markdown
- 请始终编写清晰、可维护、高性能的代码      ← 零信息量,删
- 遵循 SOLID / DRY / KISS 原则             ← 与模型基础指令完全重复,删
- src/ 下共 200 个文件,分别负责......          ← 这是 glob 的活,删
- 当前正在重构 auth 模块,请勿修改          ← 三周后就是谎言,删
一个 32 行以内的合格样本(直接可抄):
markdown
# AGENTS.md

## 命令
- 构建:cargo build;测试:cargo test -p <crate>
- 提交前必须:cargo clippy -- -D warnings && cargo fmt

## 目录
- core/     会话主循环与压缩(改前先读 session/)
- tools/    工具 schema 与执行
- protocol/ 事件类型(跨模块改动从这里起)

## 约定
- 错误处理用 thiserror,禁止 panic/unwrap 进库代码
- protocol 类型变更必须同步 wire 格式

## 禁区
- vendor/、install/ 为生成产物,勿手改
- 不要升级依赖版本(升级走独立 PR)长度纪律:AGENTS.md 每个 token 都在每个会话 常驻。50 行的导览和 500 行的 wiki,差距不是"模型多知道一些",而是每轮对话多付 10 倍的第 2 层成本,且关键约定淹没在噪音里。一屏(约 60-100 行)是软上限,32 KiB 是硬上限------超了就说明你在写文档,不是在写导览。
写在最后
失忆不是玄学,是工程问题。五句话带走:
- 塞 prompt 死于三条数量级约束------出路是检索式:上下文只留坐标和结论;
- 检索栈三条不变量:漏斗、坐标、上限,比工具形态重要;
- 截断必须显式告知 + 给恢复手段,否则模型臆测,且语气自信;
- 稳定内容在前、工具输出占大头且设双上限,排列顺序就是钱;
- 压缩是交接班:摘要按"交接文档"标准写,压完立刻按坐标重检索。
我是源码派,正在连载《编程 Agent 开发避坑指南》------12 章、46 张图,讲清楚怎么造一个类 Codex 的编程 Agent。上一篇讲编辑工具(为什么不能让模型手写 unified diff),这一篇讲上下文,下一篇讲 Shell 执行工程。每章都有源码证据(Codex commit 2685e3a4 / opencode v1.18.34)。完整目录 + 可运行示例源码,公众号「源码派」后台回复 agent 获取。
首发声明:本文首发于掘金/知乎/CSDN/微信公众号(同名「源码派」),转载请保留本声明与作者信息。