文章目录
-
- 一、先明确:这一轮模型需要做什么决定
- 二、用一个例子,看清"有信息"和"信息可用"的区别
- [三、OpsArk 运维智能体 中值得展开的四种做法](#三、OpsArk 运维智能体 中值得展开的四种做法)
-
- [3.1 按调用阶段缩小输入范围](#3.1 按调用阶段缩小输入范围)
- [3.2 最近历史保留细节,较早历史保留可追溯摘要](#3.2 最近历史保留细节,较早历史保留可追溯摘要)
- [3.3 压缩正文,同时保留补读路径](#3.3 压缩正文,同时保留补读路径)
- [3.4 长任务复核优先看新增变化](#3.4 长任务复核优先看新增变化)
- [四、预算要量得准:字符数、Token 和整个请求是不同口径](#四、预算要量得准:字符数、Token 和整个请求是不同口径)
- [五、对知识和 Skills 做选择时,保留来源与权限边界](#五、对知识和 Skills 做选择时,保留来源与权限边界)
- 六、怎么证明调优有效:做可比较的实验
- 七、开始调优时,可以按这个顺序做
一个运维任务执行了十几步之后,Agent 又开始检查已经检查过的目录;用户明明要求"只排查,不修改",后续计划却出现了变更操作;历史记录写着服务正常,模型便忽略了刚刚出现的新错误。
这些都是值得用来检验上下文设计的场景。问题可能来自信息缺失、重复、过期,或者不同来源的信息被混在一起。要定位原因,需要查看模型那一轮实际收到了什么。
本文结合 OpsArk 运维智能体 的当前实现,讨论如何组织任务目标、工具定义、执行证据和历史经验,让模型拿到做出下一步判断所需的信息。
这里的"上下文调优",指的是模型每次调用时,输入信息的选择、组织、压缩和更新。下面的场景用于说明设计方法,不是新增的线上故障报告。
想了解OpsArk 运维智能体的可以看看这篇文章:设计 OpsArk 运维智能体:从一句需求,到一项可验收的任务
一、先明确:这一轮模型需要做什么决定
在开始删日志、改提示词之前,我会先问:这一轮调用究竟要解决哪个问题?
首次规划需要理解目标、环境和可用能力;执行异常后的调整需要知道哪里失败、哪些工作已完成、剩余目标是什么;最终验收需要把用户要求与实际证据对应起来。
它们关注的信息不同。如果每一轮都发送同一份大而全的历史,即使没有超过模型的上下文窗口,也可能增加模型寻找关键信息的负担。
Anthropic 在《Effective context engineering for AI agents》中,将上下文工程讨论为对模型可用信息的持续组织,并介绍了按需获取资料、压缩和结构化笔记等方法。对工程实践的启发是:每次调用都应重新考虑哪些信息与当前决策有关。阅读原文
我会先把输入分成下面几类:
| 信息类别 | 回答的问题 | 需要保留的边界 |
|---|---|---|
| 用户目标与约束 | 要完成什么,允许做什么? | 后续摘要不能悄悄改变范围 |
| 当前目标对象 | 正在操作哪台服务器、哪个资源? | 其他对象的证据不能直接套用 |
| 工具与流程说明 | 有哪些能力,如何正确使用? | 流程建议不等于额外权限 |
| 执行与校验证据 | 实际做过什么,观察到了什么? | 保留来源、状态和适用范围 |
| 历史阶段摘要 | 之前走到哪里,哪些问题仍需关注? | 摘要不等同于原始输出 |
| 检索知识与经验 | 有哪些可能有帮助的参考? | 历史经验不能证明当前现场状态 |
OpsArk 运维智能体 的上下文组装已经体现了这种区分。buildAgentContext 分别组织任务目标、权限、服务器信息、工具目录、已知执行事实、用户已确认输入和知识引用,而不是只拼接一段聊天记录。
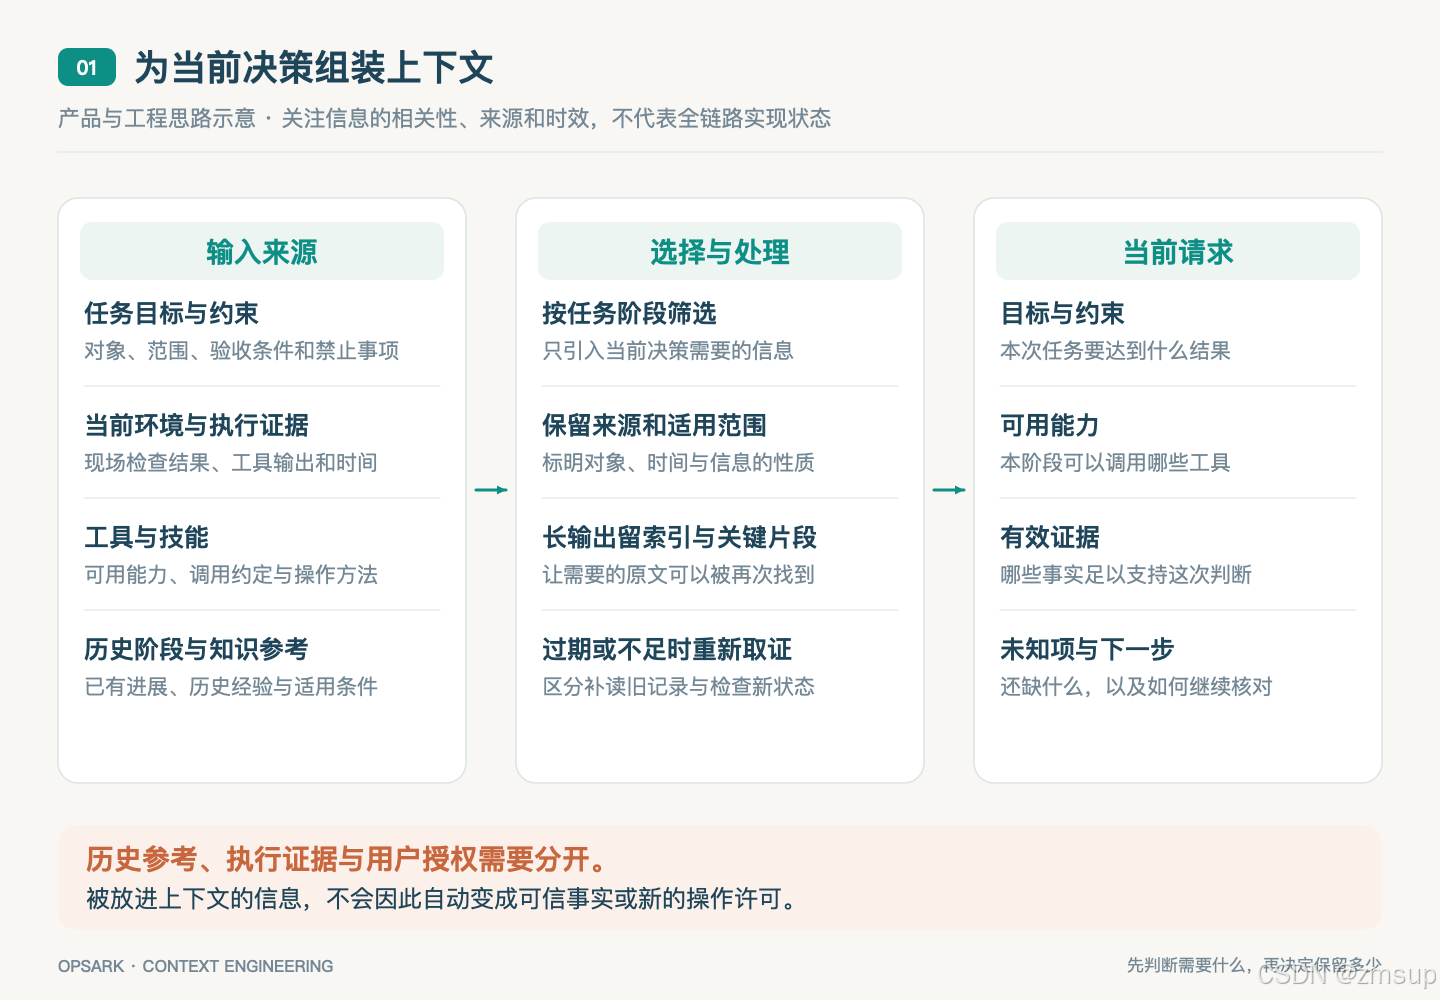
图 1:上下文组装的工程思路示意,具体字段和流程随调用阶段变化。
二、用一个例子,看清"有信息"和"信息可用"的区别
假设用户提交了这样的任务:
检查测试服务器上的服务为什么启动失败。先排查,不修改配置,也不要重启。
几轮执行之后,系统已经有启动日志、配置检查结果、旧版部署文档,以及模型之前提出的修复建议。
这些内容如果混在一起,模型需要自行判断:哪段是事实,哪段只是建议,哪段已经过期,哪段适用于当前服务器。
可以先按下面的方式组织信息。这是教学用的语义结构,不是 OpsArk 运维智能体 的实际 API Schema,也不代表一段提示词就能强制保证约束。
yaml
当前决策: 确定下一项必要的只读排查
目标对象: 示例测试服务器 / 示例服务
用户约束:
  - 不修改配置
  - 不重启服务
已知事实:
  - 启动检查未通过,依据为本任务的执行记录 E1
  - 配置检查已完成,依据为执行记录 E2
证据缺口:
  - 当前上下文只包含启动日志节选
历史参考:
  - 旧部署文档,适用版本尚未核对
待验证假设:
  - 配置路径可能与运行环境不一致
下一步原则:
  - 判断依赖已省略的日志时,先补读 E1 的可用归档
  - 判断依赖当前现场状态时,再安排授权范围内的检查
这个结构的价值,在于给信息确定身份。
"配置路径可能不一致"仍然是假设,不能在下一轮摘要中变成"已经确认配置错误"。"配置检查完成"也需要结合检查范围与结果理解,不能直接推出整个服务没有配置问题。
压缩之后,事实、推测、用户决定和未知项仍然应该能够分辨。
三、OpsArk 运维智能体 中值得展开的四种做法
3.1 按调用阶段缩小输入范围
OpsArk 运维智能体 对不同阶段构造不同上下文。例如,失败后的方案调整会提供目标快照、调整原因、当前事件及已有证据。
其中一个很具体的设计是:当问题属于执行前的确定性安全检查拒绝时,上下文集中描述被拒绝的字段、规则和相邻步骤,并省去通用任务快照等无关内容。协议修复也有专门的输入范围。
这种做法值得借鉴:如果只需要修复一个字段,就把任务边界表达为局部修复,并提供足以修复它的信息。
它能减少无关信息参与决策,但正确性仍需要后续的协议校验和执行检查来保障。
3.2 最近历史保留细节,较早历史保留可追溯摘要
随着任务推进,历史会越来越长。OpsArk 运维智能体 的任务决策快照保留当前需求轮次最近两个执行阶段的有界细节,将更早历史整理到 historyCheckpoint,其中包含事实、异常记录和阶段摘要等信息。
这里有两个重要细节。
第一,较早的异常不能因为离当前轮次较远就失去踪迹。项目对历史异常保留索引,再有界展开相关或最近的详情。
第二,同一份执行输出可能同时出现在当前步骤、事件说明和历史记录中。快照通过执行证据身份识别重复内容,并使用 contentRef 指向当前快照中已展开的正文或对应摘要,减少重复发送。这个内部引用与用于补读存档的归档引用是不同的。
这比只保留最近几条消息更接近任务的实际需要:时间远近是一个因素,尚未解决的问题、用户约束和关键证据同样需要被关注。
3.3 压缩正文,同时保留补读路径
OpsArk 运维智能体 的证据投影会区分 complete、excerpt 和 omitted,表示当前上下文中的正文是完整、节选还是省略。
对于满足条件、已经成功归档的证据,在相应工具可用且获授权时,可以通过 evidence.read 分页读取当前任务的已保存内容。
这让模型有机会按需展开细节,但有三个条件不能省略:归档确实存在、引用有效、读取能力可用。 缺少这些条件时,需要如实说明证据不足。分页结束也只说明已保存内容读完,不表示原始采集完整。
还有一个很容易混淆的区别:
| 情况 | 含义 | 合适的处理方向 |
|---|---|---|
| 上下文正文被省略 | 信息可能已经采集,只是本轮没有全部发送 | 优先补读已有记录 |
| 采集本身不完整 | 原始检查就没有覆盖全部内容 | 明确缺口,必要时补充采集 |
| 历史记录已经过期 | 当时记录可能准确,但现场可能已变化 | 重新检查当前状态 |
读取旧日志不会刷新远端状态。 相反,仅仅因为本轮没有带上旧日志,就重新执行整套检查,也可能浪费时间和资源。
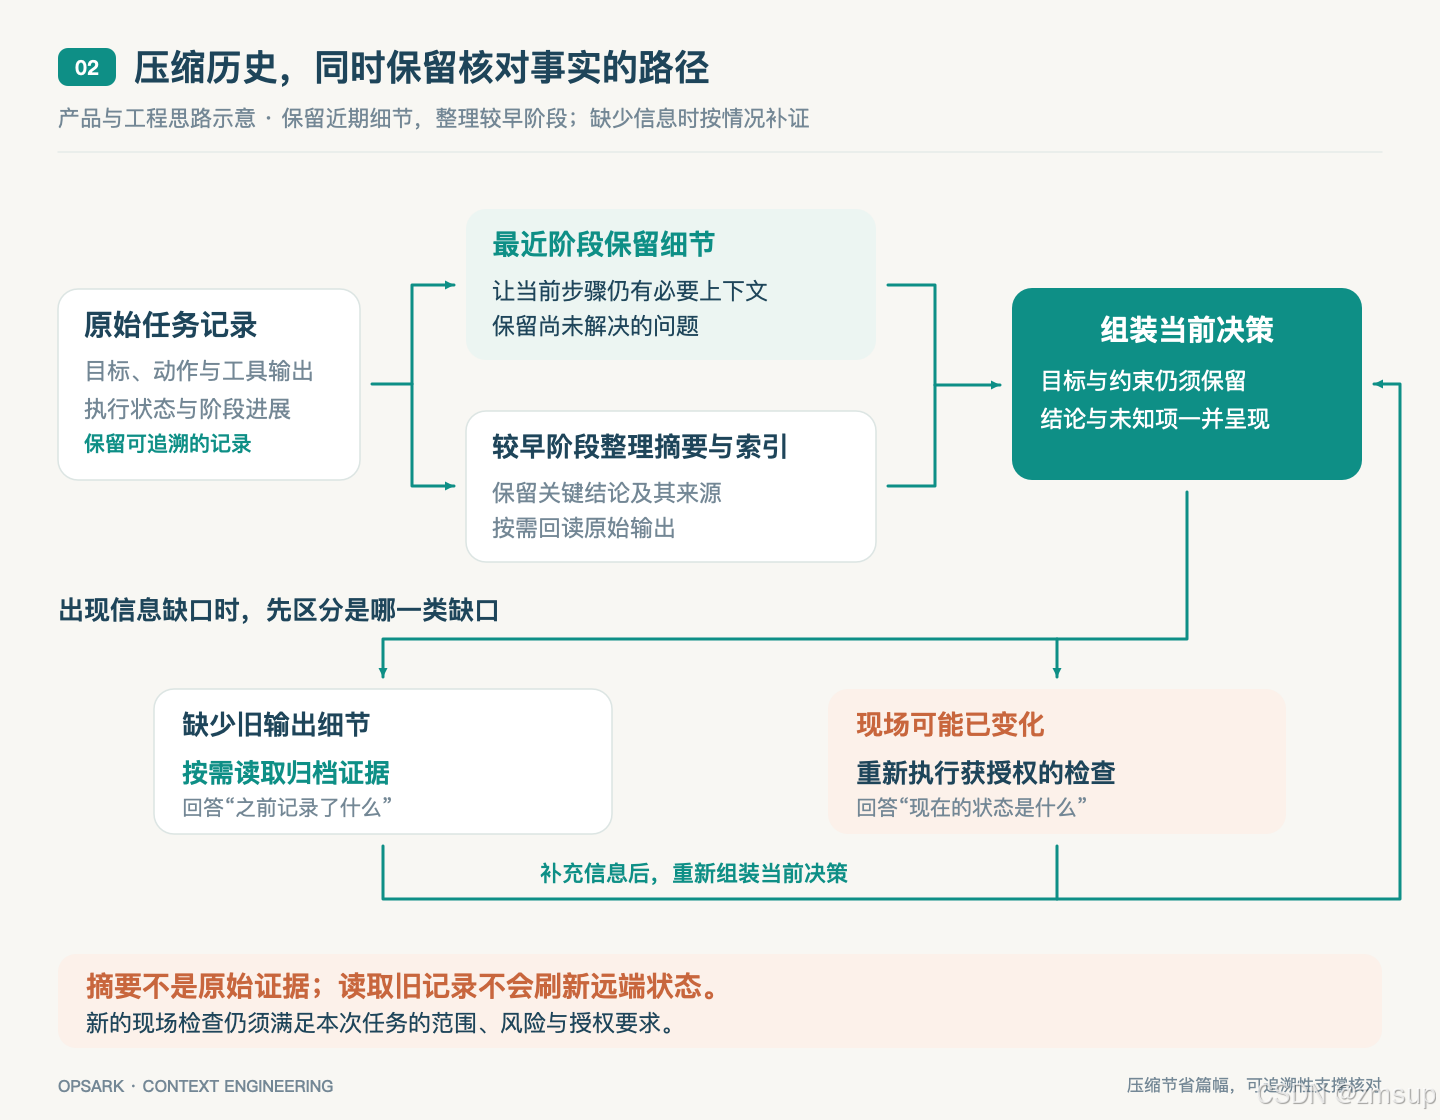
图 2:压缩历史后保留核对路径。补读历史和重新取证解决的是不同的信息问题。
3.4 长任务复核优先看新增变化
长时间运行的命令可能持续产生进度条、时间戳和重复提示。每轮都把累计输出重新发送,会让同样的内容反复占用上下文。
OpsArk 运维智能体 的长任务输出窗口使用游标和锚点识别新增内容;如果原缓冲区发生滚动或改写,会重新同步。相关处理还会压缩重复行、清理进度噪声,并保留有界的错误、警告和里程碑片段。
产品上,这对应一个直接的问题:与上次复核相比,出现了什么值得重新判断的新信息?
需要注意,这些关键行识别包含规则匹配,覆盖范围有限。某个没有命中规则的业务错误仍然可能重要;保留了"success"一行,也不能直接证明用户目标已经达成。
四、预算要量得准:字符数、Token 和整个请求是不同口径
上下文调优经常从"限制长度"开始,但必须先说清楚限制的是什么。
OpsArk 运维智能体 当前部分代码中的配置如下:
typescript
// decisionEvidence.ts
export const SHORT_DECISION_OUTPUT_LIMIT = 2_048;
export const DECISION_OUTPUT_BUDGET = 12_000;

// longRunningReviewOutput.ts
export const LONG_RUNNING_OUTPUT_CONTEXT_LIMIT = 1_200;这些是当前实现中的配置值,不是推荐给所有 Agent 的最佳参数。
DECISION_OUTPUT_BUDGET 约束的是同一次决策投影中共享的输出正文预算,不覆盖整个模型请求。工具 Schema、任务目标、结构化字段和其他消息仍会占用空间。长任务的 1_200 则针对相关输出窗口,并非整个复核上下文。
此外,这些前端长度计算使用 JavaScript 字符串的 length 和 slice,技术上按 UTF-16 代码单元计数,不能直接等同于 Token 数量。
项目后端的 request_metrics 会记录请求字节数、消息长度、稳定前缀信息和输入 Token 估计值;其中估计采用 UTF-8 字节数的启发式换算,并明确标记 exactTokens: false、contextWindowKnown: false。
因此,调优时应同时观察:
- 哪个部分在增长:工具定义、历史、输出,还是重复的背景说明。
- 哪些数值是本地估计,哪些来自模型服务返回的 usage。
- 请求是否给所需输出留出了余量;窗口限制及各类 Token 的计算以具体服务口径为准。
OpsArk 运维智能体 还把部分工具与 Skill 内容组织到相对稳定的前缀中,为复用相同请求前缀创造条件。但前缀稳定不等于已经获得缓存命中,实际收益仍需依据供应商支持情况和返回指标确认。
五、对知识和 Skills 做选择时,保留来源与权限边界
上下文中的工具说明、Skill、历史文档和执行输出,作用并不相同。
在 OpsArk 运维智能体 中,规划工具目录会根据工具启用情况、可见性与当前执行授权筛选。Skill 描述流程方法,不会因为写到某个工具,就自动获得对应执行权限。
对于满足相应规划契约条件的 Skill,项目还支持按阶段提供流程信息,并在需要时展开更多内容;条件不满足时会保留或返回完整内容。不能把这一点理解为所有 Skill 都已经自动完成最佳拆分。
知识引用则携带版本、行号等信息,并被标记为历史参考。项目在后续业务规划前可以刷新已有检索,减少沿用已替换或下架资料的风险。
这些设计有助于追溯信息来源,但版本最新的文档也未必适用于当前环境。检索片段中的操作建议,还需要结合现场证据和用户授权判断。
同样,把资料标记成"不可信参考"是一项上下文约束,不能单独构成防提示注入的完整保障。执行侧仍然需要检查工具参数、权限与任务范围。
六、怎么证明调优有效:做可比较的实验
上下文变短只是输入发生了变化。它是否改善了决策,需要另外验证。
LangChain 的《Context Engineering》也把查看执行轨迹、跟踪 Token 使用和评估任务表现列为实践基础。它提醒我们将输入变化与任务结果一起观察,而不是只检查请求长度。阅读原文
我建议从一组预先定义的任务开始,固定模型版本、提示词版本、工具配置和环境起点,让不同上下文策略处理同一批任务。条件允许时进行多次运行,记录波动;涉及变更的任务要重置环境,避免上一轮执行影响下一轮。
可以逐项比较:原策略、增加证据去重、增加分层历史、增加按需补读。一次只调整一个主要因素,更容易判断效果来自哪里。
测试集至少应包含以下场景:
| 场景 | 重点检查 |
|---|---|
| 关键错误出现在长输出中间 | 压缩后是否仍能发现,或正确补读 |
| 多轮任务早期提出"禁止修改" | 后续计划是否仍遵守约束 |
| 旧故障已被较新的验收证据覆盖 | 是否仍机械重复旧修复 |
| 服务器或资源范围发生变化 | 是否误用其他对象的历史结果 |
| 归档缺失、工具不可用或采集不完整 | 是否如实保留未知,而非编造结论 |
| 知识版本被替换或下架 | 是否刷新引用并核对适用性 |
评估时,我会同时看目标达成、约束遵守、证据依据、重复执行、总耗时和总成本。
目标达成率应以预先定义的全部任务为分母,失败、未知和中途退出分别列示。任务结论由独立验收标准或人工复核判断,不能仅以 Agent 自称"完成"为准。
按需补读可能减少单次输入,却增加模型轮次和工具调用。因此,应统计整个任务的成本,包括失败尝试与补读过程,而不是只展示最短的一次请求。
对"归档确实缺失"这类测试,还要区分两个评价:Agent 是否正确处理不确定性,以及用户目标是否真正完成。前者表现正确,不代表后者可以计为成功。
以上是建议的评估方案,本文没有执行真实模型 A/B 实验,也没有宣称 OpsArk 运维智能体 已取得某个成本降幅或成功率提升。
七、开始调优时,可以按这个顺序做
- 找一轮具体决策。 写清楚它需要什么信息、最终要输出什么。
- 检查实际发出的请求。 确认用户约束、目标对象和关键证据是否真的进入了上下文;排查副本只保留必要且可使用的数据。
- 标明每段信息的身份。 分清事实、假设、用户决定、历史参考和未知项。
- 先去重,再压缩。 优先处理重复输出和无关材料,压缩时保留来源、范围及省略标记。
- 设计信息恢复路径。 缺细节时补读,采集不足时补采,状态过期时重查;无法获取就明确保留缺口。
- 用同一组任务对比。 同时观察完成质量、约束遵守和整个任务的成本。
OpsArk 运维智能体 当前的实现提供了一个具体例子:上下文会随着任务阶段变化,旧记录经过压缩和引用重新进入决策,新的执行结果又持续更新后续输入。
每当准备删掉一段内容时,都值得问:模型如果因此缺少了做决定的依据,它能否知道自己缺什么,并有办法重新取得?