写代码这件事,AI agent确实越来越像个靠谱的搭档了。但凡接触过Cursor、Claude Code、GitHub Copilot这类工具的人都会有个共同感受,让它写Python脚本几乎是信手拈来,可一旦换成Rust,那种卡顿感、反复报错、agent自己都开始绕圈子修bug的场面就很常见。这不是错觉,而是有扎实的数据和社区反馈支撑的现象。
下面从训练数据特征、语言本身的反馈机制、业界基准测试结果三个角度,把目前AI编程agent最拿手的十种语言梳理清楚,顺便聊聊Rust这类语言为什么容易让agent掉链子。
为什么语言之间差距会这么大
AI agent写代码的本质,是在海量训练语料里学到的模式匹配加上编译 / 运行时反馈驱动的试错循环。决定一门语言对agent友不友好的,主要是三个变量。
训练语料规模。GitHub上Python、JavaScript相关代码仓库数量级远超Rust,agent见过的样本越多,越容易生成符合惯用法的代码。
语法确定性与容错度。动态类型语言写错了变量类型,程序往往还能跑,只是结果不对,这给了agent试错空间。强类型加上严格所有权检查的语言,一旦逻辑有瑕疵,编译器直接拒绝通过,agent需要更深的语义推理能力才能一次写对。
反馈信号的清晰度。像Go和TypeScript这类语言,编译器报错信息结构化、定位精准,agent可以把报错当作下一轮修正的直接输入,形成高效闭环。而Rust的借用检查器报错往往牵涉生命周期、所有权转移等跨多行的复杂关系,agent很难靠单次报错准确定位根因。
用一张图来表示这套反馈循环的差异。
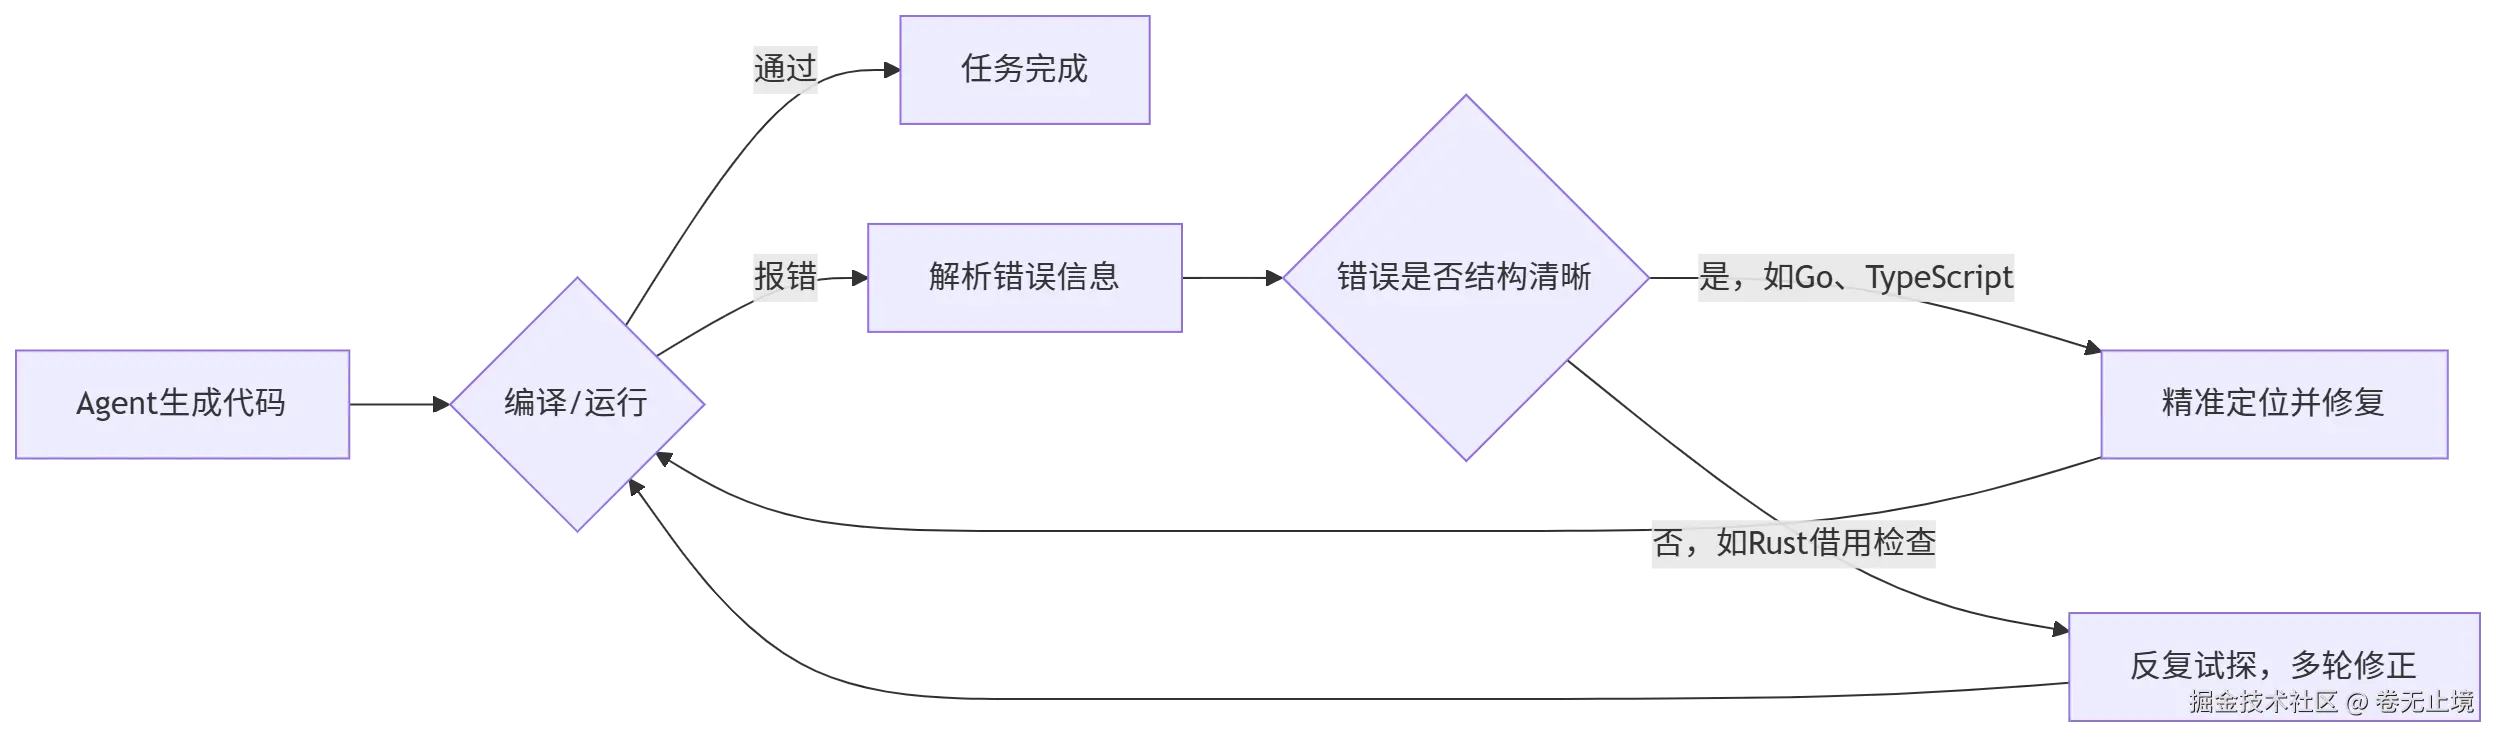
这也解释了社区里反复出现的吐槽,Tencent在今年发布的AutoCodeBench基准测试里,专门用了跨20种语言的真实任务来考察各大模型的代码生成能力,结果显示语言之间的完成率差距相当悬殊。衡量这类基准常用的指标很简单。
Completion Rate=总测试用例数通过测试用例数
HumanEval及其多语言扩展版本HumanEval-XL也证实了同一个模型在不同语言上的pass@1分数可以相差一倍以上。
AI编程agent目前最擅长的十种语言
综合开发者社区评价、HumanEval系列基准、Tencent AutoCodeBench多语言测试结果,以及实际agent工具的用户反馈,可以归纳出下面这份榜单。排名不是绝对精确的分数排序,更像是业界共识的综合画像。
| 排名 | 语言 | 擅长原因 | 代表性佐证 |
|---|---|---|---|
| 1 | Python | 训练语料海量,语法简洁,动态类型容错度高,pytest生态完善方便agent自测 | |
| 2 | JavaScript | Web开发代码库规模巨大,agent生成前端逻辑和Node脚本都很顺手 | |
| 3 | TypeScript | 继承JavaScript语料优势,同时类型系统给agent提供了清晰的编译期反馈 | |
| 4 | Java | 语言结构高度规范,IDE工具链和Maven/Gradle生态让agent容易按模板生成代码 | |
| 5 | Go | 标准库风格统一,编译器报错信息直白,agent修复效率高 | |
| 6 | SQL | 查询语义相对固定,agent在数据库任务里的生成准确率一直很稳 | |
| 7 | HTML/CSS | 配合前端框架生成界面代码,agent在视觉还原类任务里表现突出 | |
| 8 | C# | .NET生态下Roslyn编译器诊断信息结构化程度高,便于agent自我修正 | |
| 9 | Ruby | 语法灵活度高,配合Sorbet等渐进式类型工具后agent生成的可维护性明显提升 | |
| 10 | Elixir | 在Tencent跨20种语言的AutoCodeBench测试中完成率意外登顶,函数式模式匹配语法减少了歧义 |
把这十种语言按agent友好程度画成分层图会更直观。
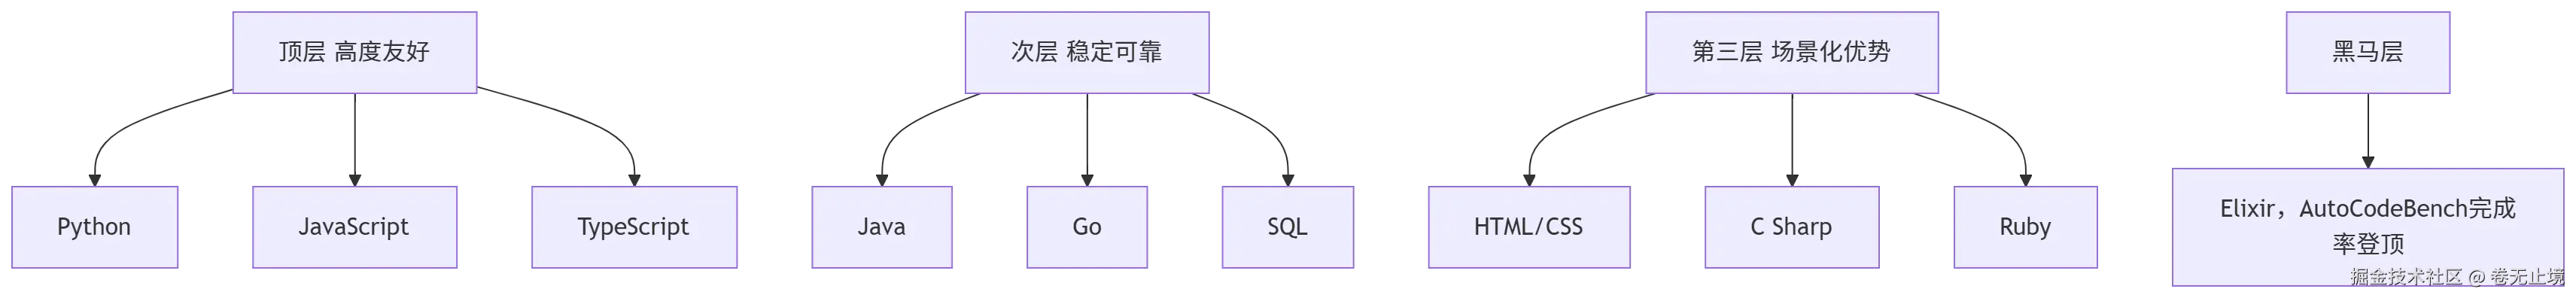
需要说明的是,Elixir能排进前十多少有点出人意料,它的用户基数远不如Java、C#这类主流企业语言,但函数式编程的模式匹配语法天然减少了逻辑歧义,agent在生成这类代码时犯的语义错误反而更少。这提示我们一个反直觉的结论,语言的流行程度和agent友好程度并不完全成正比,语法的确定性和一致性有时候比生态规模更重要。
Rust为什么始终是agent的老大难
反过来看Rust,它几乎是开发者社区里公认的agent软肋。原因主要集中在所有权和生命周期系统上,这套机制要求代码在编译期就必须严格证明内存安全,agent如果没有真正理解某个变量的借用关系链条,哪怕逻辑思路完全正确,编译器照样会报错拒绝。
更麻烦的是,Rust的报错信息虽然号称全行业最友好,但涉及生命周期标注的问题往往牵涉函数签名、结构体定义、调用链路等多处代码,agent很难像处理Go的类型不匹配那样一步到位修复,经常陷入改了这里又炸了那里的循环。C和C++面临的挑战类似,手动内存管理加上大量未定义行为的坑,让agent生成的代码即便能编译通过,也不一定在运行时安全。
对比来看,Python之所以成为agent的舒适区,恰恰是因为它几乎站在Rust的对立面,动态类型给了容错空间,海量训练语料给了惯用法参考,而run-test-fix的循环又特别契合agent的试错式工作方式。
写在最后
AI编程agent的语言能力版图正在动态变化,HumanEval-XL、AutoCodeBench这类多语言基准测试的出现,本身就说明业界已经意识到单一语言的评测结果没法代表agent的真实水平。对普通开发者来说,一个实用的经验法则是,涉及脚本处理、数据分析、后端API这类任务,大胆交给agent,Python、JavaScript、Go都能给出相当靠谱的产出,但一旦进入内存安全要求严苛的系统级编程领域,Rust代码还是建议多留一道人工review的关卡。
参考资料
1 Ruby Is the Best Language for Building AI Apps www.reddit.com/r/ruby/comm...
2 The First Agent-Native Programming Language www.mattsenter.com/blog/first-...
3 How to Build AI Agents A Beginner's Guide www.coursera.org/articles/ho...
4 Vibe coding vs agentic coding Ralph Wiggum loop discourse.julialang.org/t/vibe-codi...
5 HumanEval as an accurate code benchmark www.reddit.com/r/LocalLLaM...
6 HumanEval-XL A Multilingual Code Generation Benchmark arxiv.org/html/2402.1...
7 What Is HumanEval www.ibm.com/think/topic...
8 HumanEval Dataset Code Synthesis Benchmark www.emergentmind.com/topics/huma...
9 Hunyuan-TurboS Advancing Large Language Models arxiv.org/html/2505.1...
10 The Great AI Coding Showdown A Deep Dive into Tencent AutoCodeBench www.communeify.com/en/blog/ten...
11 Best LLMs for Programming Languages 2026 AI Coding Leaderboard ai-llm-leaderboard.com/leaderboard...
12 Assessing and Advancing Benchmarks for Evaluating Large Language Models arxiv.org/html/2505.0...