AIOps实战03:两代AIOps,传统机器学习与大模型该怎么配合
我是老计。前两篇讲了 AIOps 是什么、能力全景和成熟度。这一篇要把一条贯穿全系列的主线讲透:AIOps 的两代技术,传统机器学习和大模型,它们各自擅长什么、不擅长什么、以及最关键的,该怎么配合。 看懂这两代和它们的融合,你就有了理解今天整个 AIOps 技术版图的钥匙。
很多人有个误解,以为大模型一来,传统那套 AIOps 就过时了、要被取代了。这是彻底的误读。 真相是,这两代技术擅长的事根本不一样,谁也替代不了谁,未来好的 AIOps 一定是两者的结合。这一篇我就来掰扯清楚。
一,第一代,传统AIOps用机器学习做运维
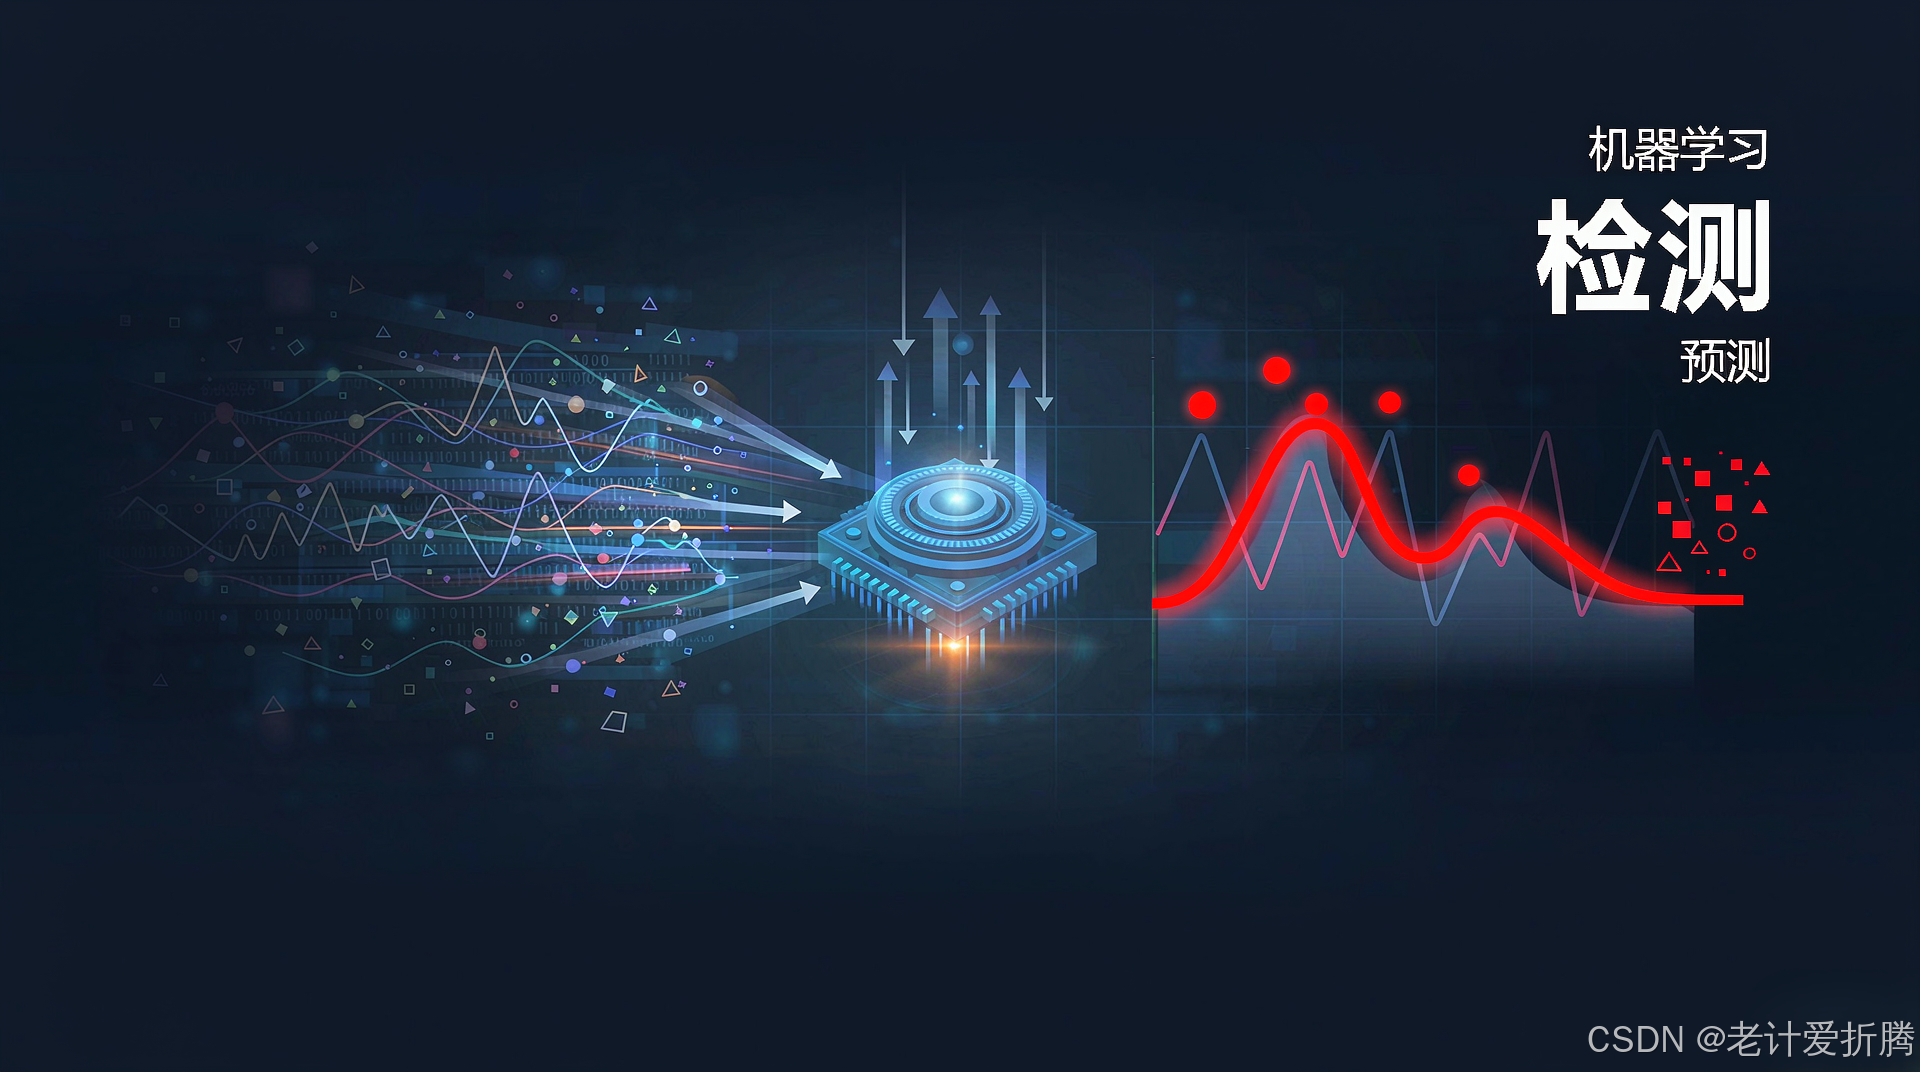
先看第一代。传统 AIOps 的核心,是用机器学习和统计方法,从海量的运维数据里找规律、发现异常、做预测。 这是过去很多年 AIOps 的主线,今天依然是根基。
它最擅长什么?处理大量的、数值型的、有规律可循的数据。 运维世界里,指标数据是海量的:每台机器的 CPU、内存、每个接口的响应时间和错误率,每秒钟都在产生成千上万个数字。这些数字里藏着系统的健康状况,但人根本盯不过来,而机器学习恰恰最擅长从这种海量数字里挖规律。
它的典型场景,都是这个特点的体现:指标异常检测 ,让模型学出某个指标正常时长什么样,一旦偏离就报警,不用人去定死阈值;告警关联与降噪 ,用算法发现哪些告警总是一起出现、有先后因果,把它们归并压制;容量与趋势预测 ,用历史数据的规律,预测磁盘什么时候满、流量什么时候会超载;日志的聚类与模式挖掘,把海量日志自动归成有限的几类模式,发现里面的异常。
传统 AIOps 的强,是实打实的。但它也有明显的短板,这些短板恰恰是大模型的长处。 第一,它主要处理数值和结构化数据,面对大段的自然语言文本(比如一条复杂的报错日志、一份故障文档),它的理解能力很弱。第二,它的结果往往不好解释:模型报了个异常,给你一个异常分数,但为什么异常、意味着什么,它讲不清楚,还得靠人去解读。第三,它需要专门的数据科学能力去建模调参,门槛不低,用起来不够亲切。这三个短板,长期是传统 AIOps 落地的痛点,直到大模型来了。
二,第二代,LLM for Ops用大模型做运维
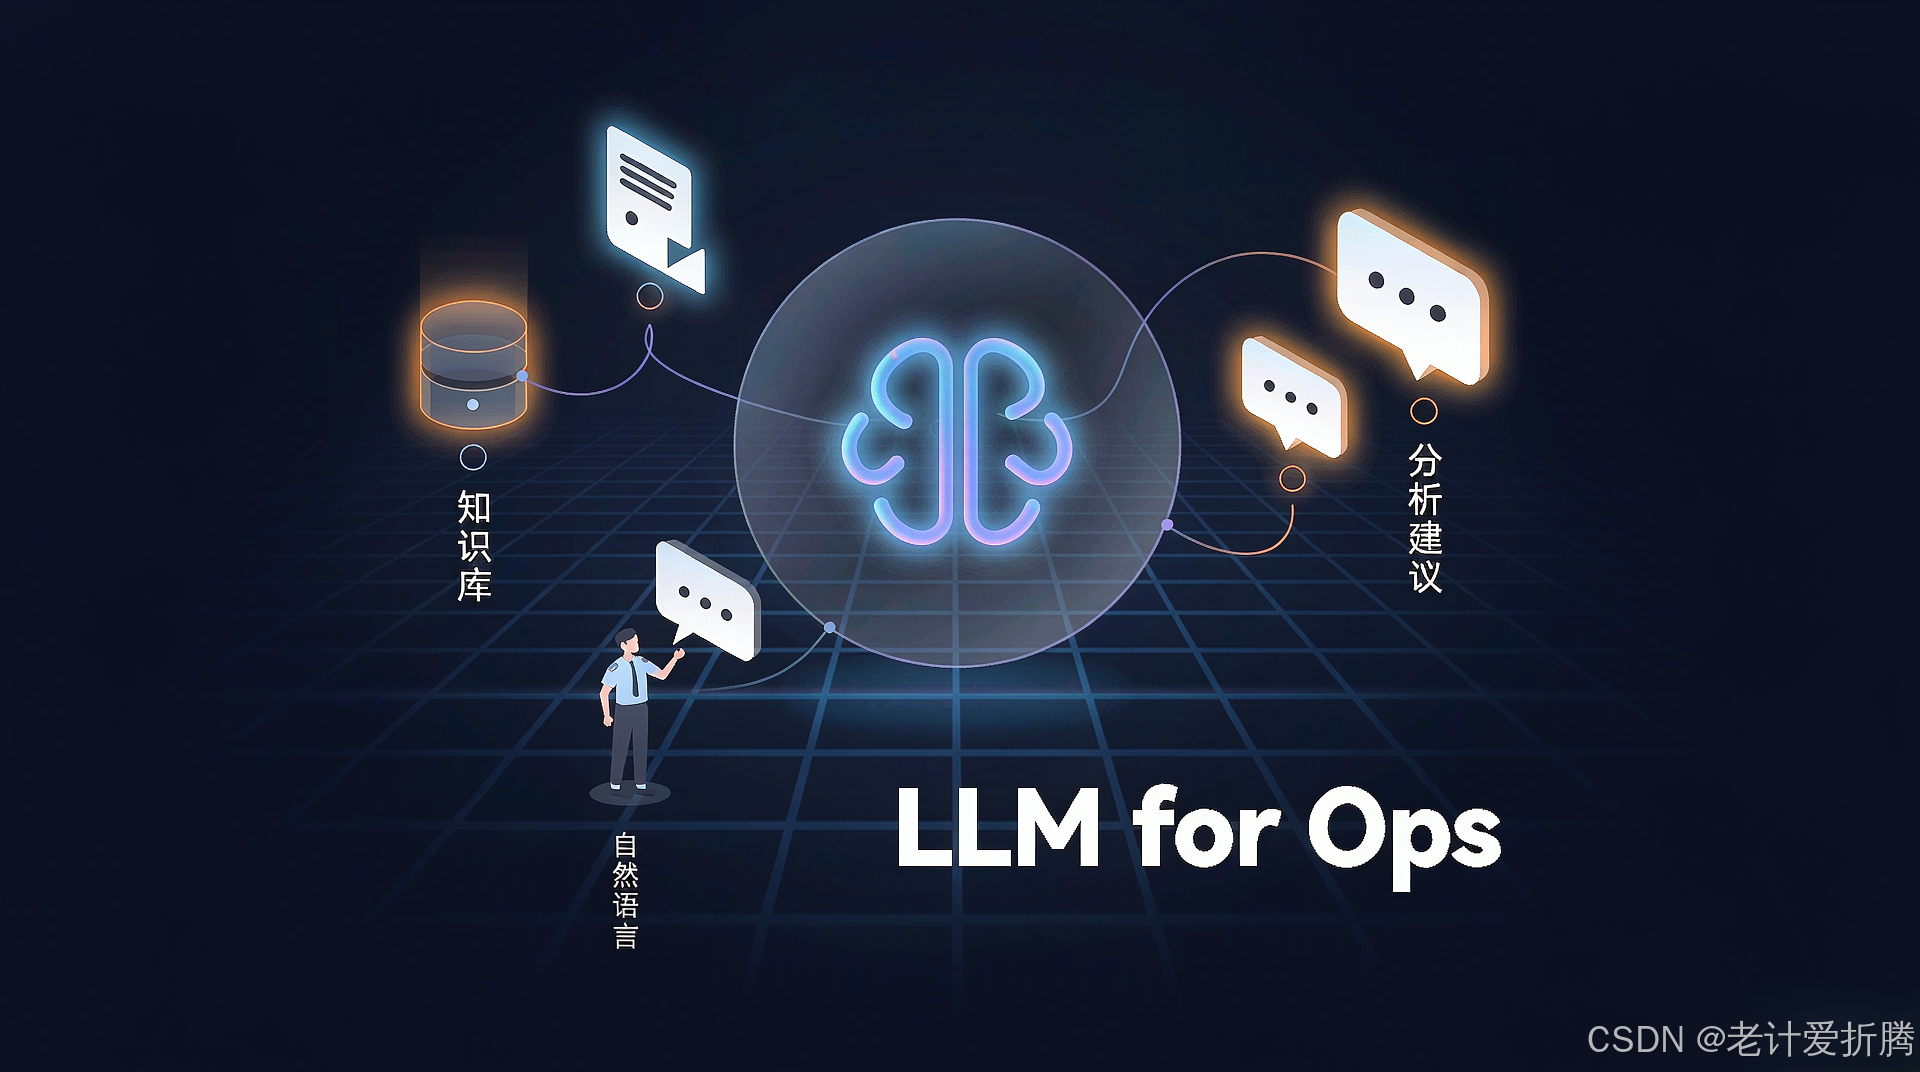
第二代,就是这两年因为大模型爆发而兴起的 LLM for Ops。它的核心,是用大模型的语言理解和生成能力,来做运维。
它擅长的,恰好是传统 AIOps 的短板。第一,理解自然语言和文本。 大模型天生就是处理语言的,一大段乱七八糟的报错日志、一份写得随意的故障记录、运维文档,它都能读懂、能总结、能提炼要点。运维世界里其实有大量的文本数据,以前只能靠人读,现在大模型能帮着读了。
第二,自然语言交互,大幅降低门槛。 这是最直观的改变。以前查个系统状态、排个故障,你得懂命令、懂查询语法、懂各种工具。现在,你可以直接用大白话问:那个服务为什么变慢了、帮我看看这个 Pod 的日志有什么问题。大模型把运维的操作门槛,从会各种工具,降到了会说话,这个意义非常大。
第三,知识整合与辅助分析。 通过检索增强(也就是 RAG),可以把你团队的运维知识库、历史故障案例、处理手册,都喂给大模型,让它在回答和排障时能引用这些知识。相当于给团队配了一个读遍了所有内部文档和历史故障、随叫随到的专家助手。 我做那个 K8s 运维 AI 工具时,核心用的就是这套思路,后面第五板块会细讲。
但大模型也绝不是万能的,它的短板同样明显。第一,它不擅长精确的数值计算和大规模数据的实时检测。 你不可能把每秒上万个指标数据点实时喂给大模型让它算异常,那又慢又贵又不准,这活还得传统 ML 干。第二,它会一本正经地胡说八道,也就是幻觉。 它可能给出一个听起来很对、其实错误的分析,这在运维这种严肃场景里是危险的。第三,成本和延迟。 大模型推理要消耗算力、有延迟,不适合那些需要极快、极高频响应的场景。把这三条记住,你就不会盲目地把什么都塞给大模型。
三,最关键的,两代怎么融合
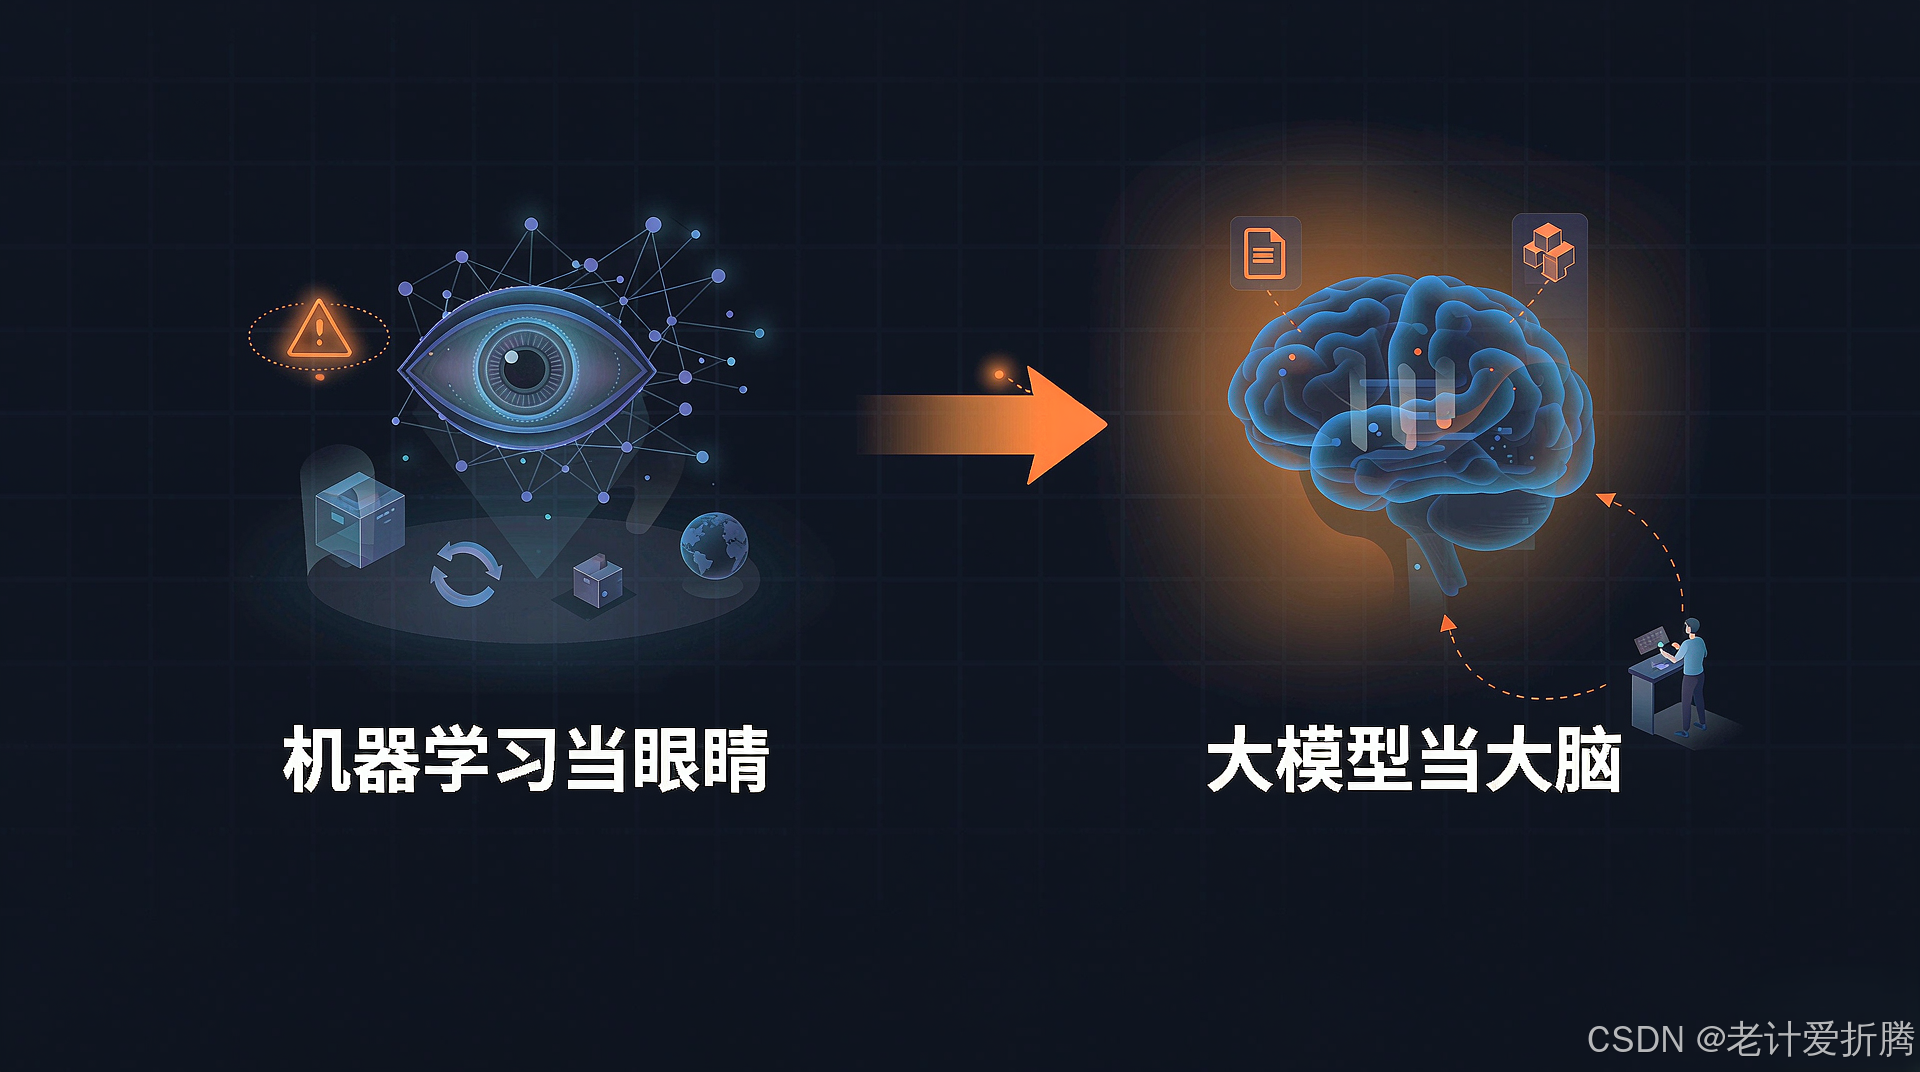
讲清了两代各自的长短,现在到最关键的部分:它们该怎么配合。我的核心观点是:传统 ML 做底层的感知,大模型做上层的交互和理解,两者分工协作。
我用一个贯穿的比方来讲这个融合,你会一下记住。传统 ML 像是系统的眼睛和神经,大模型像是系统的嘴巴和一部分大脑。 眼睛(传统 ML)时刻从海量数据里感知,发现哪里不对劲;嘴巴和大脑(大模型)负责把感知到的东西用人话讲出来、理解你的提问、调取知识帮你分析。眼睛看得见但说不清,嘴巴会表达但看不见细节,两者合起来,才是一个既能感知又能沟通的完整智能。
落到具体的协作流程,一个典型的融合场景是这样的:第一步,传统的异常检测模型(眼睛)从海量指标里发现某个服务的延迟异常升高了,报出一个异常。第二步,这个异常信号交给大模型(大脑),大模型去检索关联的日志、历史上类似的故障案例、相关的运维文档。第三步,大模型把这些信息整合起来,用人话告诉你:这个延迟异常,很可能和某某原因有关,历史上类似情况是怎么处理的,建议你先查哪里。第四步,你还可以继续用自然语言追问,让它进一步分析。
你看,在这个流程里,传统 ML 干了它最擅长的精准检测,大模型干了它最擅长的理解、整合和表达,各展所长、无缝衔接。 这就是 1 加 1 大于 2 的融合。单靠传统 ML,你只能得到一个冷冰冰的异常分数,还得自己费劲解读;单靠大模型,它压根没法实时盯着海量指标。只有两者结合,才能既看得准、又说得清,这才是我心目中成熟 AIOps 该有的样子。
再强调一遍那个要破除的误解:大模型不是来取代传统 AIOps 的,而是来补齐它一直以来的短板的。 谁要是听信了大模型一统天下、传统 AIOps 淘汰论,把底层的检测和预测也硬塞给大模型去做,那是既不懂传统 ML 的价值、也不懂大模型的边界,迟早要在成本、性能和准确性上栽跟头。
四,给你的实践启示
把这两代的认知,落成几条能指导实践的启示:第一,别用错工具。 数值型、海量、实时的检测和预测,交给传统 ML;文本理解、自然语言交互、知识整合,交给大模型。先想清楚你的问题是哪一类,再选对应的技术,别拿大模型去干它不擅长的实时数值检测,也别指望传统 ML 去读懂一段自然语言故障描述。
第二,往融合的方向设计。 如果你在规划 AIOps,别只盯着一代。理想的架构是:底层用传统 ML 构建感知能力,上层用大模型构建交互和分析能力,让两者协作。这是当下最有生命力的技术路线。
第三,对大模型的输出保持警惕。 大模型会幻觉,它给的分析和建议,是辅助你判断的参考,不是可以闭眼执行的结论。尤其在涉及操作生产系统时,人的审核这一关不能省,这也是我下面产品需求板块会反复强调的安全底线。
小结
这一篇讲透了 AIOps 的两代技术:第一代传统 AIOps,用机器学习从海量数值数据里做检测和预测,擅长处理大量结构化数据,短板是不懂文本、结果难解释、有门槛。第二代 LLM for Ops,用大模型做文本理解、自然语言交互和知识整合,恰好补上前者的短板,但不擅长精确数值计算、会幻觉、有成本和延迟。最关键的是融合:传统 ML 当眼睛做底层感知,大模型当大脑做上层交互和理解,各展所长、协作互补,这才是成熟 AIOps 的样子。 核心的实践启示是别用错工具、往融合方向设计、对大模型输出保持警惕。
下一篇,我们换一个视角,从产品的角度,看一款完整的 AIOps 平台到底该具备哪些功能。
延伸阅读
- OpenTelemetry 官方文档,可观测数据标准(opentelemetry.io/docs)
- Hugging Face Transformers 官方文档,大模型使用基础(huggingface.co/docs/transformers)
- LangChain 官方文档,大模型应用与 Agent 编排(python.langchain.com)
- 时序异常检测综述,可在 arXiv 检索关键词 time series anomaly detection survey(arxiv.org)
(本文为技术经验分享,旨在梳理AIOps两代技术的区别与融合。文中观点结合个人运维经验,不构成具体产品或采购建议,实际选型与落地请结合自身环境评估。)