上承〔05 · 从 768 维到下一个 token〕。前五篇把推理链路走完了:文字进来,过 8 层积木,出去变成下一个 token。这一篇做一个收拢:用一张架构图,把前五篇的所有零件各就各位;再用一百行伪代码,把 MiniMind 的实现意图压到最短。承上,也启下。
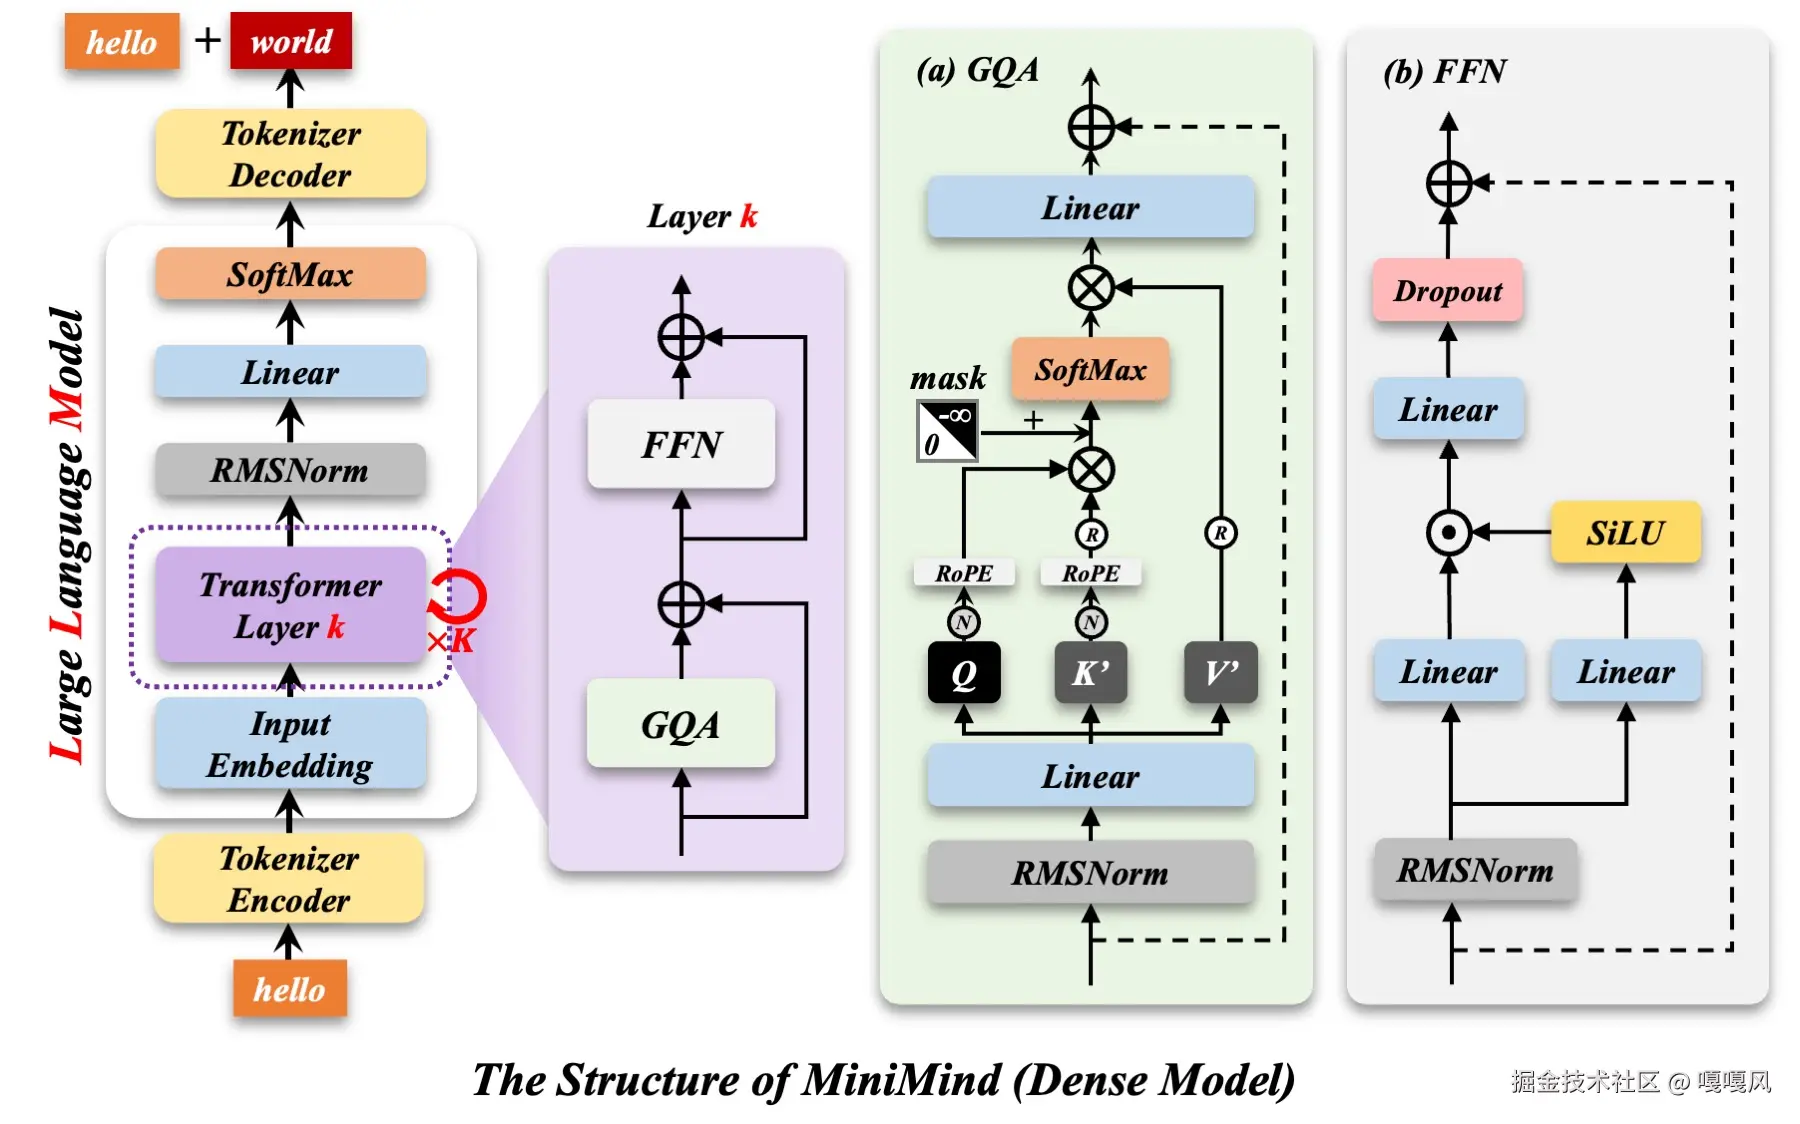
一、架构图:前五篇的零件各就各位
MiniMind 的整体数据流,从输入到输出,长这样:
ini
输入文本
  │
  ▼
[BPE 分词器] ──→ token id 序列 [B, S]
  │
  ▼
[Embedding 层] (6400 × 768,与 lm_head 共享权重)
  │
  ▼
┌───────────────────────────────────────────────────────┐
│  MiniMindBlock × 8 层                                 │
│                                                       │
│  residual = hidden_states                            │
│  hidden_states = RMSNorm(hidden_states)              │
│  hidden_states = Attention(hidden_states)            │
│    ├─ QKV 投影 (GQA: 8 Q头 / 4 KV头)                 │
│    ├─ RoPE 旋转 Q, K                                 │
│    ├─ KV Cache 拼接                                  │
│    ├─ Flash Attention (is_causal=True)               │
│    └─ o_proj 输出                                    │
│  hidden_states = hidden_states + residual            │
│                                                       │
│  residual = hidden_states                            │
│  hidden_states = RMSNorm(hidden_states)              │
│  hidden_states = FeedForward(hidden_states)          │
│    ├─ gate_proj → SiLU                               │
│    ├─ up_proj                                        │
│    ├─ 逐元素相乘 (门控)                               │
│    └─ down_proj                                      │
│  hidden_states = hidden_states + residual            │
│                                                       │
└───────────────────────────────────────────────────────┘
  │
  ▼
[Final RMSNorm]
  │
  ▼
[lm_head] (768 → 6400,与 embed_tokens 共享权重)
  │
  ▼
[Softmax + 采样] ──→ 下一个 token
这张图里,前五篇的零件全部就位:
- 02 篇:BPE 分词、Embedding 层。文字怎么变成向量。
- 03 篇:Attention 里的 QKV 投影、因果掩码、多头。
- 04 篇:RoPE、KV Cache、GQA、Flash Attention、FFN/SwiGLU、RMSNorm、残差连接。
- 05 篇:Final RMSNorm、lm_head、Softmax、采样。
一张图,把五篇串完了。
二、一百行伪代码:骨架版的 MiniMind
真实代码 3500 行,里面大部分是工程细节:数据加载、训练循环、日志、检查点、分布式支持、模型变体。模型架构本身,一百行就够。
下面这份伪代码,去掉了所有工程噪音,数字全部硬编码。读起来清爽,记住几个关键数:768、96、6400、8、4、2432。
python
import torch
import torch.nn as nn
import torch.nn.functional as F

# 全局硬编码:768 维、96 头维、6400 词表、8 层、8 Q头、4 KV头、2432 FFN中间维
# RoPE 基频 1000000,最大位置 32768

class RMSNorm(nn.Module):
    def forward(self, x):
        # 除以均方根,不减均值
        return x * torch.rsqrt(x.pow(2).mean(-1, keepdim=True) + 1e-5)

def precompute_rope():
    # 48 个频率,从高到低;对应 96 维分 48 对
    freqs = 1.0 / (1000000.0 ** (torch.arange(0, 96, 2).float() / 96))
    t = torch.arange(32768)
    angles = torch.outer(t, freqs)                    # [32768, 48]
    return (torch.cat([torch.cos(angles)]*2, -1),     # [32768, 96]
            torch.cat([torch.sin(angles)]*2, -1))

def rope(x, cos, sin):
    # x: [B, H, S, 96],前后两半交换,前半取负
    x1, x2 = x[..., :48], x[..., 48:]
    return x * cos + torch.cat([-x2, x1], -1) * sin

class Attention(nn.Module):
    def __init__(self):
        self.q_proj = nn.Linear(768, 768, bias=False)   # 8 头 × 96 维
        self.k_proj = nn.Linear(768, 384, bias=False)   # 4 头 × 96 维
        self.v_proj = nn.Linear(768, 384, bias=False)
        self.o_proj = nn.Linear(768, 768, bias=False)
        self.cos, self.sin = precompute_rope()

    def forward(self, x, kv_cache=None):
        B, S, _ = x.shape
        # 投影 + 拆头:[B, 8, S, 96] / [B, 4, S, 96]
        q = self.q_proj(x).view(B, S, 8, 96).transpose(1, 2)
        k = self.k_proj(x).view(B, S, 4, 96).transpose(1, 2)
        v = self.v_proj(x).view(B, S, 4, 96).transpose(1, 2)

        # RoPE 只旋转 q 和 k
        q = rope(q, self.cos[:S], self.sin[:S])
        k = rope(k, self.cos[:S], self.sin[:S])

        # KV Cache:拼上缓存
        if kv_cache is not None:
            k = torch.cat([kv_cache[0], k], dim=2)
            v = torch.cat([kv_cache[1], v], dim=2)

        # GQA:4 个 KV 头复制成 8 个,和 Q 头对齐
        k = k.repeat_interleave(2, dim=1)
        v = v.repeat_interleave(2, dim=1)

        # Flash Attention,内部处理因果掩码
        out = F.scaled_dot_product_attention(q, k, v, is_causal=True)

        # 合并头,输出投影
        out = out.transpose(1, 2).reshape(B, S, 768)
        return self.o_proj(out), (k, v)

class FFN(nn.Module):
    def __init__(self):
        self.gate = nn.Linear(768, 2432, bias=False)
        self.up   = nn.Linear(768, 2432, bias=False)
        self.down = nn.Linear(2432, 768, bias=False)

    def forward(self, x):
        # gate 过 SiLU 当门控,up 提供信息,逐元素相乘
        return self.down(F.silu(self.gate(x)) * self.up(x))

class Block(nn.Module):
    def __init__(self):
        self.norm1 = RMSNorm()
        self.attn  = Attention()
        self.norm2 = RMSNorm()
        self.ffn   = FFN()

    def forward(self, x, kv_cache=None):
        # 注意力 + 残差
        h, new_kv = self.attn(self.norm1(x), kv_cache)
        x = x + h
        # FFN + 残差
        x = x + self.ffn(self.norm2(x))
        return x, new_kv

class MiniMind(nn.Module):
    def __init__(self):
        self.embed = nn.Embedding(6400, 768)
        self.layers = nn.ModuleList([Block() for _ in range(8)])
        self.norm = RMSNorm()
        self.lm_head = nn.Linear(768, 6400, bias=False)
        self.lm_head.weight = self.embed.weight   # 权重绑定

    def forward(self, ids, kv_caches=None):
        x = self.embed(ids)                        # [B, S, 768]
        new_kvs = []
        for i, layer in enumerate(self.layers):
            cache = kv_caches[i] if kv_caches else None
            x, new_kv = layer(x, cache)
            new_kvs.append(new_kv)
        return self.lm_head(self.norm(x)), new_kvs  # [B, S, 6400]

    @torch.no_grad()
    def generate(self, ids, max_new=100, temperature=0.7, top_k=50, top_p=0.9):
        kv_caches = None
        for _ in range(max_new):
            inp = ids if kv_caches is None else ids[:, -1:]
            logits, kv_caches = self.forward(inp, kv_caches)
            logits = logits[:, -1, :] / temperature
            # Top-k + Top-p 过滤
            v, _ = torch.topk(logits, top_k)
            logits[logits < v[:, [-1]]] = -float('inf')
            sorted_logits, sorted_idx = torch.sort(logits, descending=True)
            cum = torch.cumsum(F.softmax(sorted_logits, -1), -1)
            sorted_logits[cum > top_p] = -float('inf')
            probs = F.softmax(sorted_logits, -1)
            # 采样
            next_id = sorted_idx.gather(-1, torch.multinomial(probs, 1))
            ids = torch.cat([ids, next_id], -1)
            if next_id.item() == 2:   # 假设 2 是结束符
                break
        return ids
约 100 行。每一块在前五篇都拆过:
| 代码块 | 前五篇对应 |
|---|---|
RMSNorm |
04 篇 6.3--6.4 节 |
precompute_rope / rope |
04 篇 1.5--1.6 节 |
Attention 里的 q/k/v 投影 |
03 篇 5.1 节 |
repeat_interleave (GQA) |
04 篇 3.3--3.5 节 |
scaled_dot_product_attention |
04 篇 4.2 节 |
FFN 里的 gate/up/down |
04 篇 5.5--5.7 节 |
Block 里的残差连接 |
04 篇 6.2 节 |
embed 和 lm_head 权重绑定 |
05 篇 1.3 节 |
generate 里的采样 |
05 篇三、四节 |
三、从 100 行到 3500 行:多出来的 3400 行是什么
一百行是骨架,跑不起来------它没有训练、没有数据、没有保存、没有日志。真实代码的 3500 行里,多出来的部分大概是这几类:
| 类别 | 占比 | 内容 |
|---|---|---|
| 训练循环 | 约 15% | 前向、损失、反向、优化器、学习率调度、梯度累积、日志、检查点 |
| 数据工程 | 约 25% | 数据加载、清洗、分词、格式化、批处理、padding、mask |
| 模型变体 | 约 20% | MoE 版本、VLM 版本、Omni 版本、不同尺寸的配置 |
| 工具代码 | 约 30% | 模型转换、推理部署、Web 演示、评估脚本、tokenizer 训练 |
| 模型架构 | 约 10% | 这一百行,加上各种辅助函数和边界处理 |
模型架构只占一成。 剩下九成,是把模型变成一个能跑、能训、能用的项目所需的工程。
这不是 MiniMind 独有的比例。几乎所有大模型项目都是这样:模型本身很简单,围绕它的工程很复杂。这也是为什么读完前五篇,再看真实代码,会发现"核心部分其实都见过了"。
另外,现代 LLM 基本不用 Dropout。MiniMind 的配置里也预留了这个参数,但默认值是 0。所以架构图和伪代码里都没画它。
四、承上,启下
这一篇起的作用是两个。
承上:把前五篇的所有零件,收拢到一张图和一百行代码里。如果前五篇是拆零件,这一篇是把零件装回去,让你看到整机长什么样。
启下 :这一百行里,全是 forward,没有 backward。模型怎么从随机初始化,被拧到能猜词,这一百行里没有答案。
下一个问题自然就出来了:那些旋钮,是怎么被拧动的?
这就要讲训练了。下一篇,我们从这一百行的 forward 出发,补上它的另一半:backward。