note
- 动机: 传统具身智能模型通常针对单一任务/机器人分别训练,例如机械臂操作、导航、轨迹预测各用一套模型,跨任务、跨环境、跨本体泛化差。Qwen-VLA 希望把这些任务统一成一个"视觉+语言→连续动作/轨迹"的通用模型。
- 核心方法: 以 Qwen3.5-4B VLM 为认知骨干,负责视觉理解、空间推理和指令理解;外接约 1.15B DiT flow-matching action decoder,生成连续机器人动作。通过 embodiment-aware prompt 告诉模型当前机器人类型、单/双臂、控制频率、动作定义等,使不同机器人共用同一 action head;同时将 manipulation、VLN waypoint、人类手部/身体轨迹统一成固定维度 action/trajectory tensor,并用 mask 忽略无效维度。
- 模型输出侧:H×K 动作/轨迹张量,H:预测时域(操作 H=16,导航 H=8);K:全部形态共用的通道预算;前 c 个通道放实际动作,后续 K−c 通道补零;损失只对掩码内有效时间步和通道计算 MSE,再对有效通道平均。
- 训练优化: 采用四阶段:
- ① T2A:冻结 VLM,只用文本+机器人描述先训练 DiT 学"语言→动作先验";
- ② CPT:解冻全模型,用机器人、人类第一视角、仿真、导航及 VL 数据联合预训练;
- ③ SFT:高质量多任务/真机数据微调;
- ④ RL:在 SimplerEnv 用稀疏成功奖励优化闭环任务成功率。训练目标同时包含 action flow-matching loss 和 VL next-token loss,避免具身训练导致 VLM 能力遗忘。
- 结果: Qwen-VLA-Instruct 在 LIBERO 达 97.9%,Simpler-WidowX 73.7%,RoboTwin Easy/Hard 86.1%/87.2%,R2R OSR 69.0%、RxR SR 59.6%;真实 ALOHA OOD 平均成功率 76.9%,DOMINO 动态操作 zero-shot 26.6%。整体说明:VLA 不只是"VLM 后面接个动作头",而是在统一多任务、多机器人经验后,学习可迁移的视觉理解+连续控制能力
文章目录
- note
-
- 摘要
- 一、研究动机:异构具身任务可以共享结构,但不应被伪装成同构控制
-
- [1. 现状:具身智能被"切碎"了](#1. 现状:具身智能被"切碎"了)
- [2. 关键取舍:统一"动作---轨迹空间",而非统一"物理动作空间"](#2. 关键取舍:统一"动作—轨迹空间",而非统一"物理动作空间")
-
- (1)如果强行统一物理动作空间,会发生什么?
- [(2)Qwen-VLA 的做法:只统一"接口",不统一"物理量"](#(2)Qwen-VLA 的做法:只统一"接口",不统一"物理量")
- [3. 动机的边界:联合训练 ≠ 必然优于专家模型](#3. 动机的边界:联合训练 ≠ 必然优于专家模型)
- [二、模型架构------"理解者 + 生成者"的双脑结构](#二、模型架构——"理解者 + 生成者"的双脑结构)
-
- [1. 总体架构:VLM 管"想",DiT 管"做"](#1. 总体架构:VLM 管"想",DiT 管"做")
-
- [(1)视觉---语言骨干:Qwen3.5 的早融合优势](#(1)视觉—语言骨干:Qwen3.5 的早融合优势)
- (2)动作专家:不是"输出头",而是"独立生成模块"
- [2. 输入侧:三种条件](#2. 输入侧:三种条件)
-
- [(1)视觉上下文 `o_t`](#(1)视觉上下文
o_t) - [(2)语言指令 `x`](#(2)语言指令
x) - [(3)具身提示 `e`(详见第四章)](#(3)具身提示
e(详见第四章))
- [(1)视觉上下文 `o_t`](#(1)视觉上下文
- [3. 输出侧:H×K 动作/轨迹张量](#3. 输出侧:H×K 动作/轨迹张量)
- 三、统一动作---轨迹表征------"接口统一,动力学不统一"
-
- [1. 四要素对齐法](#1. 四要素对齐法)
- [2. 四类任务,同一框架](#2. 四类任务,同一框架)
- [3. 工程启示:数据中心不必先解决"动作标准化"](#3. 工程启示:数据中心不必先解决"动作标准化")
- [4. 量纲处理:只做归一化,不做物理变换](#4. 量纲处理:只做归一化,不做物理变换)
- 四、具身感知提示------跨形态控制的"软路由"
-
- [1. 提示模板:把平台差异写成自然语言](#1. 提示模板:把平台差异写成自然语言)
- [2. 覆盖的平台谱系](#2. 覆盖的平台谱系)
- [3. 本质:把"架构分支"变成"提示路由"](#3. 本质:把"架构分支"变成"提示路由")
- [4. 反向验证:本体感受(state)到底有多重要?](#4. 反向验证:本体感受(state)到底有多重要?)
- 五、数据混合与训练配方------"先压缩,再接地,再对齐,再优化"
-
- [1. 数据混合:操作为核心,其他模态补语义](#1. 数据混合:操作为核心,其他模态补语义)
-
- [导航细分(占 7.5%):](#导航细分(占 7.5%):)
- [2. 自研仿真的两条数据链](#2. 自研仿真的两条数据链)
-
- [(1)视觉---语言---动作链(VLA chain)](#(1)视觉—语言—动作链(VLA chain))
- [(2)语言---动作链(LA chain)](#(2)语言—动作链(LA chain))
- [3. 四阶段训练:全文第二大创新](#3. 四阶段训练:全文第二大创新)
-
- [阶段一:T2A(Text-to-Action)DiT 预训练](#阶段一:T2A(Text-to-Action)DiT 预训练)
- [阶段二:CPT(Continued Pretraining)多模态继续预训练](#阶段二:CPT(Continued Pretraining)多模态继续预训练)
- [阶段三:SFT(Supervised Fine-Tuning)监督微调](#阶段三:SFT(Supervised Fine-Tuning)监督微调)
- [阶段四:RL(Reinforcement Learning)强化学习](#阶段四:RL(Reinforcement Learning)强化学习)
- [4. T2A 消融:数字最有说服力](#4. T2A 消融:数字最有说服力)
- 六、实验结果:单一模型在操作、导航与域外泛化上同时成立
-
- [1. 两个模型变体](#1. 两个模型变体)
- (1)操作基准:单一模型接近或超过专用模型
-
- [① 成绩一览](#① 成绩一览)
- [② 与专用基线的横向对比](#② 与专用基线的横向对比)
- [③ 横向比较的"不可比"清单 ⚠️](#③ 横向比较的"不可比"清单 ⚠️)
- [(2)导航、真实机 OOD 与动态操作:泛化才是主考场](#(2)导航、真实机 OOD 与动态操作:泛化才是主考场)
-
- [① 视觉---语言导航(VLN-CE)](#① 视觉—语言导航(VLN-CE))
- [② 真实 ALOHA 双手机器人](#② 真实 ALOHA 双手机器人)
- [③ 静态 SimplerEnv-OOD(组合泛化)](#③ 静态 SimplerEnv-OOD(组合泛化))
- [④ 动态操作 DOMINO(35 套)](#④ 动态操作 DOMINO(35 套))
- (3)分阶段与联合训练分析:谁在贡献?
-
- [① 后训练三检查点(CPT → +SFT → +RL)](#① 后训练三检查点(CPT → +SFT → +RL))
- [② 核心结论:SFT 是主要提升源,RL 主要强化其训练域](#② 核心结论:SFT 是主要提升源,RL 主要强化其训练域)
- [③ 多形态投影消融](#③ 多形态投影消融)
- 七、横向比较与局限:统一"可行且强",但非"必然更优"
-
- [1. 与同期 VLA 模型的差异](#1. 与同期 VLA 模型的差异)
- [2. 四条硬限制](#2. 四条硬限制)
- [3. 能力边界判定](#3. 能力边界判定)
- [4. 未来方向(论文自述,非已具备能力)](#4. 未来方向(论文自述,非已具备能力))
- 八、启示与工程建议:迁移"结构",不迷信"比例"
-
- [1. 可复用的工程路线(按序执行)](#1. 可复用的工程路线(按序执行))
-
- 第一步:定义统一接口
- 第二步:构建语言---动作配对
- [第三步:解冻视觉主干,联合 grounding](#第三步:解冻视觉主干,联合 grounding)
- [第四步:多任务 SFT](#第四步:多任务 SFT)
- [第五步:在奖励可可靠测量的环境中加 RL](#第五步:在奖励可可靠测量的环境中加 RL)
- [2. 真正值得迁移的是"训练流程的结构"](#2. 真正值得迁移的是"训练流程的结构")
- [3. 下一步最有价值的三个证据链](#3. 下一步最有价值的三个证据链)
- 九、总结:一句话判定
-
- [贡献高于单点 SOTA 的三件事](#贡献高于单点 SOTA 的三件事)
- 仍未翻过的三座山
摘要
Qwen-VLA 的做法,不是声称"把所有机器人统一成一种动作",而是用 Qwen3.5-4B 视觉---语言骨干 + 约 1.15B 参数的 DiT 流匹配动作专家 + 一套 H×K 张量/前缀掩码/具身提示的接口 ,把操作、导航、人本动作、轨迹预测接进同一个条件生成框架。
其旗舰模型 Qwen-VLA-Instruct 报告的成绩单为:
| 评测维度 | 基准 | 成绩 |
|---|---|---|
| 操作 | LIBERO | 97.9% |
| 操作 | Simpler-WidowX | 73.7% |
| 操作 | RoboTwin-Easy / Hard | 86.1% / 87.2% |
| 导航 | R2R(OSR) | 69.0% |
| 导航 | RxR(SR) | 59.6% |
| 真实机 OOD | ALOHA 平均 OOD 成功率 | 76.9% |
| 动态操作 | DOMINO 零样本成功率 | 26.6% |
最值得迁移的工程洞见有三条:
- 保留各数据集的原生控制语义,而不是强行把动作投影到同一物理空间;
- 先训练"语言 → 动作"先验,再接入视觉 grounding;
- 用文本具身提示选择平台、控制频率、预测长度与动作约定。
限制同样明确 :具身动作数据仍远少于纯视觉---语言语料;多目标联合训练会带来优化折中;当前评测以短时程、基准化任务为主,长时程、失败恢复、接触力与真实安全部署尚未解决。
一、研究动机:异构具身任务可以共享结构,但不应被伪装成同构控制
Qwen-VLA: Unifying Vision-Language-Action Modeling across Tasks, Environments, and Robot Embodiments
1. 现状:具身智能被"切碎"了
(1)专用模型割据,能力无法累积
现有具身系统往往各自为战:
- 操作模型:面向桌面或灵巧控制;
- 导航模型:围绕室内 waypoint 或离散移动决策;
- 轨迹模型:预测自动驾驶车辆或行人的未来路径;
- 人本动作模型:输出手腕、手部或骨骼序列。
它们不共享参数、不共享数据、不共享评测协议,导致:
- 能力无法跨任务迁移;
- 数据无法跨形态复用;
- 无法像视觉---语言预训练那样"scale up"。
(2)表面异构,结构同构
论文抓住的关键洞察是:这些任务输出格式不同,但计算结构相同。
具身智能体的共同结构是------把任务、环境和自身状态映射到多模态表示,再生成未来可执行信号。
具体共享要素:
| 共享要素 | 说明 |
|---|---|
视觉观测 o_t |
单帧 / 多帧 / 视频 / 历史窗口 |
语言指令 x |
"把红色杯子放到左边" |
具身描述 e |
平台、臂型、控制约定、频率、时域 |
任务标识 z |
操作 / 导航 / 轨迹预测 / 人本动作 |
预测目标 y |
未来 H 步的动作或轨迹 |
统一条件预测式:
p θ ( y t : t + H − 1 ∣ o t , x , e , z ) p_{\theta}(y_{t:t+H-1} \mid o_t, x, e, z) pθ(yt:t+H−1∣ot,x,e,z)
2. 关键取舍:统一"动作---轨迹空间",而非统一"物理动作空间"
这是全文最重要的设计判断。
(1)如果强行统一物理动作空间,会发生什么?
不同数据的原生控制量完全不同:
| 形态 | 原生动作 |
|---|---|
| 单臂 WidowX | 相对末端位移 + 夹爪 |
| 单/双臂 Franka | 绝对关节动作 |
| 导航 | 相对位移 + 偏航角 |
| 人类 Ego4D | 相对手腕 SE(3) 变换 + 手部 PCA 系数 |
| 灵巧手 | 关节角度 |
若强行投影到同一坐标系:
- 丢失执行器动力学信息;
- 引入人为折损;
- 跨形态迁移反而变差。
(2)Qwen-VLA 的做法:只统一"接口",不统一"物理量"
- 所有样本共用一个固定 H×K 张量接口;
- 有效通道放前面,其余零填充;
- 由二元掩码决定损失计算范围;
- 各数据集保留原始控制约定。
统一性的价值在于共用视觉 grounding、空间推理和生成主干,而不是用形式统一掩盖硬件与动力学差异。
3. 动机的边界:联合训练 ≠ 必然优于专家模型
论文没有 、也不能证明"一个模型必然优于专家模型"。联合训练引入的新问题:
- 目标平衡:操作 MSE、导航 SPL、VQA 准确率如何加权?
- 数据比例:操作占 74.2%,是否会淹没导航信号?
- 灾难性遗忘:动作训练是否会损害 VLM 的推理能力?
- 容量竞争:共享 DiT 是否被高频操作任务霸占?
作者也承认:动作导向训练可能使部分纯视觉---语言和导航评测出现轻微回退。
✅ 因此,论文真正支持的结论是:
联合预训练可以在一个共享接口上得到强泛化基线,而不是它已消除专家模型在特定硬件、任务或数据分布上的优势。
二、模型架构------"理解者 + 生成者"的双脑结构
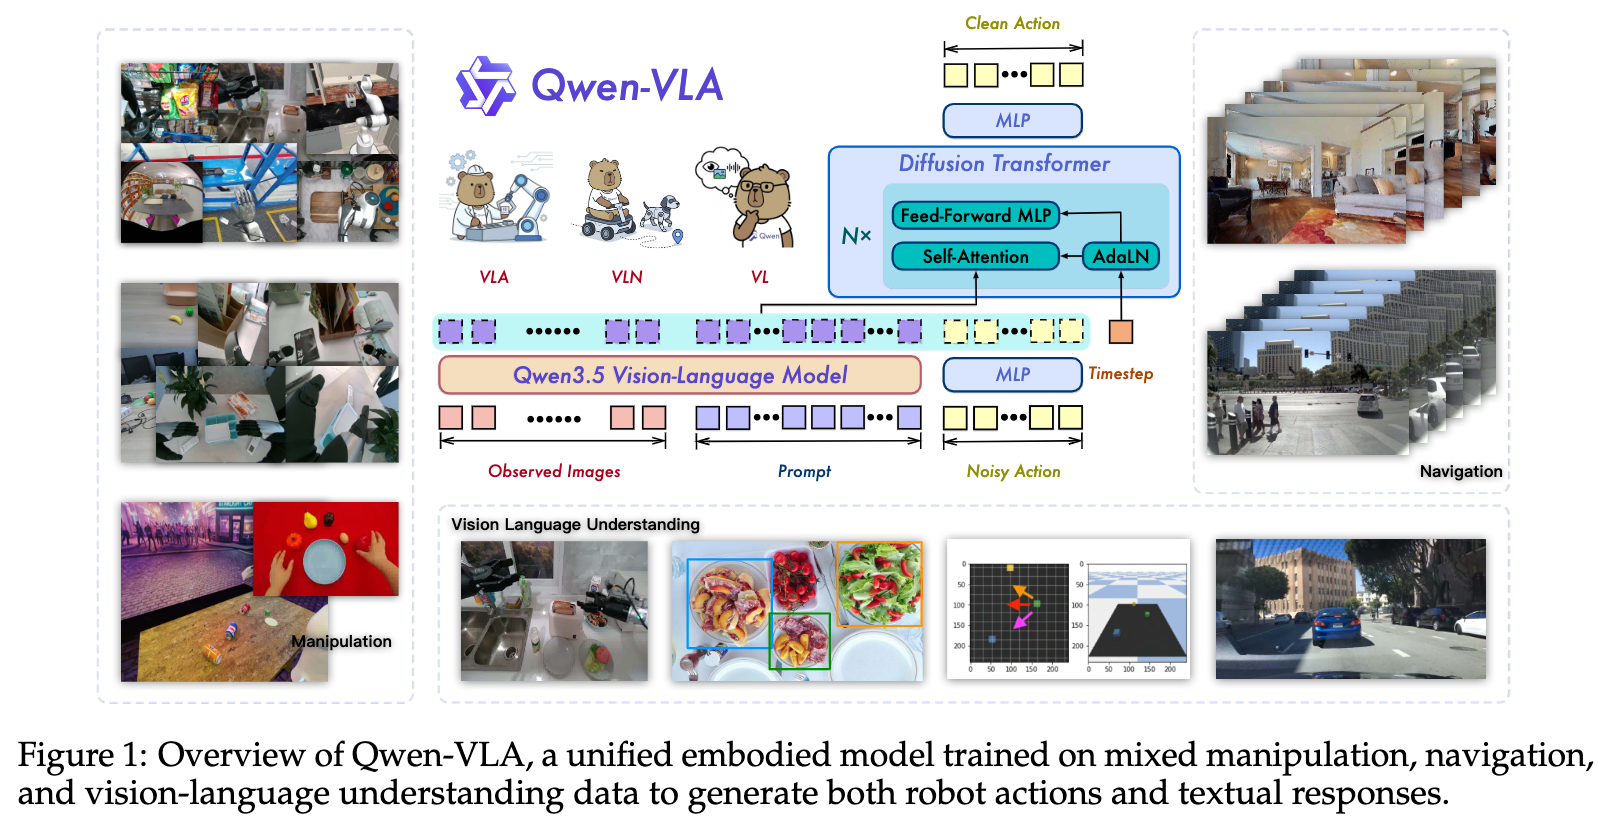
1. 总体架构:VLM 管"想",DiT 管"做"
Qwen-VLA = 通用多模态理解器 + 具身动作解码器
| 模块 | 组件 | 职责 |
|---|---|---|
| 高层 | Qwen3.5-4B(原生多模态) | 视觉感知、语言理解、空间推理、指令遵循 |
| 低层 | DiT 流匹配动作专家(~1.15B) | 连续动作/轨迹的精细生成 |
(1)视觉---语言骨干:Qwen3.5 的早融合优势
Qwen3.5 是原生多模态模型,关键特性:
- 视觉 token 由 ViT + 空间合并产生;
- 视觉 token 直接交织进文本 token 流(非末端拼接);
- 混合注意力:多数层用门控线性注意力 (效率),定期用分组查询 softmax 注意力(全局推理)。
✅ 这使其能同时处理图像、视频、语言,为具身任务提供:
- 细粒度视觉感知;
- 指称 grounding("那个红色的");
- 多语言指令遵循;
- 结构化空间推理。
(2)动作专家:不是"输出头",而是"独立生成模块"
约 1.15B 的动作专家,绝非把 VLM 的词表生成能力直接扩展为连续动作。参数分解:
| 子模块 | 参数量 |
|---|---|
| 16 个 DiT 块(每块 70.8M) | ~1.13B |
| 动作投影 | ~4.9M |
| VLM 隐状态 → DiT 通道映射 | ~3.9M |
| 时间步嵌入 | ~2.8M |
| 输出 AdaLN 调制 | ~4.7M |
| 合计 | ~1.15B |
单流 DiT 工作机制:
- 把 VLM 隐状态 与带噪动作块拼接;
- 通过联合自注意力让语言/视觉条件影响动作;
- 用 AdaLN 注入时间步条件(flow matching);
- 用多段 RoPE保持与主干的位置对齐;
- 在连续动作流场中反演可执行 action chunk。
这正是"先想清楚,再精细执行"的分工:VLM 提供"做什么、对谁做、在哪做",DiT 解决"手怎么动"。
2. 输入侧:三种条件
(1)视觉上下文 o_t
- 单帧 / 多帧 / 视频 / 历史窗口;
- 显式插入视角标签 :
ego、cam_left_wrist、cam_right_wrist; - 使模型能分辨"第一视角"与"左右腕视图"。
(2)语言指令 x
- 任务描述:"pick up the red cup";
- 可含多步、组合、空间关系指令。
(3)具身提示 e(详见第四章)
- 平台标签、单/双臂、腰/移动底座;
- 控制频率(FPS);
- 待预测动作块长度(chunk size)。
3. 输出侧:H×K 动作/轨迹张量
- H:预测时域(操作 H=16,导航 H=8);
- K:全部形态共用的通道预算;
- 前 c 个通道放实际动作,后续 K−c 通道补零;
- 损失只对掩码内有效时间步和通道计算 MSE,再对有效通道平均。
✅ 避免零填充和不同形态通道数主导梯度。
三、统一动作---轨迹表征------"接口统一,动力学不统一"
1. 四要素对齐法
统一表征由四部分组成:
| 要素 | 作用 |
|---|---|
| ① 固定预测长度 H | 不同任务可有不同名义长度,共享张量中截断/补齐 |
| ② 固定通道数 K | 全部形态共用的通道预算 |
| ③ 通道布局 | 前 c 通道 = 有效动作,后 K−c = 零 |
| ④ 逐样本有效性掩码 | 标明哪些 (t, k) 真实有效 |
2. 四类任务,同一框架
| 数据家族 | 输出含义 | 监督信号 |
|---|---|---|
| 机器人操作 | 末端位移、旋转、关节位置、夹爪、灵巧手关节 | 真实/仿真轨迹 |
| 视觉---语言导航 | 地面平面 waypoint(位移 + 航向变化) | 连续航点序列 |
| 轨迹预测(自动驾驶/运动预测) | 未来空间轨迹 | 连续坐标 |
| 第一视角人本动作 | 手腕 SE(3) 动作 + 10 维 eigengrasp PCA 系数 | 人体/手部运动 |
它们共享的是"条件生成 + 时间块 + 连续监督",而不是共享同一个物理量。
3. 工程启示:数据中心不必先解决"动作标准化"
只要每个样本携带足够明确的原生控制元数据,即可用:
- 张量补齐(padding)
- 有效性掩码(mask)
- 具身提示(prompt)
实现异构联合训练。
这绕开了具身领域最棘手的数据清洗难题------不必等到全行业统一动作定义,就能开始联合训练。
4. 量纲处理:只做归一化,不做物理变换
对各数据集按各自的 第 1 / 99 分位 进行线性映射,裁剪到 −1, 1:
- ✅ 消除量纲和幅度差异;
- ❌ 不改变动作变量的物理含义。
保留原始动作语义,是统一架构能够成立的前提,而不是附属实现细节。
四、具身感知提示------跨形态控制的"软路由"
1. 提示模板:把平台差异写成自然语言
模板结构:
The robot is {robot_tag} with {arm_config}...
The control frequency is {FPS} Hz.
Please predict the next {chunk_size} control actions...- 训练时:当作普通文本过 VLM → 隐状态进入 DiT;
- 推理时:只切换文本,即可在同一模型参数下选择不同平台。
2. 覆盖的平台谱系
| 类别 | 代表平台 |
|---|---|
| 单臂 | WidowX、Google Robot、Franka、ARX5 |
| 双臂 | Franka 双机、Mobile ALOHA |
| 人形 | Fourier GR-1、TienKung、AIRBOT MMK2 |
| 移动操作 | AgiBot A2-D、Galaxea R1 |
| 人类 | Ego4D / EPIC-KITCHENS 第一视角 |
动作类型覆盖:相对/绝对末端位姿、绝对关节位姿、夹爪、灵巧手动作。
3. 本质:把"架构分支"变成"提示路由"
传统多形态方案:
- 每套机器人一个输出头 ❌
- 或每套机器人一个子网 ❌
Qwen-VLA:
- 同一 DiT 参数集 ✅
- 文本提示作为控制协议选择器 ✅
具身提示实现了参数共享条件下的控制协议选择,但不能替代校准。
4. 反向验证:本体感受(state)到底有多重要?
在 RoboTwin-2.0 上的消融(Easy/Hard):
| 条件方式 | Easy | Hard |
|---|---|---|
| 不加状态 | 88.7% | 87.4% |
| 关节角离散化写入 VLM 提示 | 89.3% | 88.7% |
| 连续关节向量直接输入 DiT | 89.4% | 88.3% |
最大差距仅 0.7 / 1.3 个百分点。
如何解读?
✅ 证明 :多视角视觉 + 相对动作,足以承载当前多数基准任务。
❌ 不能证明:状态反馈无用。在以下场景状态仍关键:
- 遮挡;
- 高动态接触;
- 精细力控;
- 关节漂移。
把提示作为唯一平台输入,是降低多形态接口复杂度的有效默认选择,不应被理解为通用原则。
五、数据混合与训练配方------"先压缩,再接地,再对齐,再优化"
1. 数据混合:操作为核心,其他模态补语义
| 数据家族 | 训练混合占比 | 核心监督信号 | 主要作用 |
|---|---|---|---|
| 机器人操作轨迹 | 74.2% | 真实与仿真末端、关节、夹爪、双机动作 | 直接控制经验 |
| 人类第一视角轨迹 | 6.0% | 相对手腕变换、10 维 eigengrasp | 开放世界人手先验 |
| 导航轨迹 | 7.5% | 2 FPS 视频 + 指令 + waypoint | 长视野探索 |
| 自研仿真轨迹 | 3.7% | 自动生成并成功校验的轨迹 | 场景/物体/配置覆盖 |
| 通用视觉---语言 | 3.4% | 图文对齐、VQA、OCR、推理、grounding | 保持感知与推理 |
| 空间 grounding | 2.5% | 2D 框 grounding | 对象定位 |
| 自动驾驶 VQA | 2.4% | 时间理解、多视角空间推理、定位 | 车辆域决策 |
| 细粒度具身动作字幕 | 0.2% | ~4.8 万视频---字幕对、13 维标注 | 语言---动作语义桥接 |
数据规模量级:
- 公开 + 自研机器人操作:> 1 万小时交互;
- 自研真实机器人:> 1,000 小时,约占总体 20%;
- 自研仿真:> 800 万条轨迹(占 3.7%)。
导航细分(占 7.5%):
- 指令跟随 4.3%
- 对象搜索 2.3%
- 目标跟踪 1.0%
2. 自研仿真的两条数据链
(1)视觉---语言---动作链(VLA chain)
- 工具:IsaacLab + cuRobo;
- 规模:20 场景 × 10 物体位姿 × 450 任务 × 300 条轨迹;
- 产出:~35.98 万条完整或子任务轨迹;
- 特点:有渲染、有物理。
(2)语言---动作链(LA chain)
- 6 类模板:抓取放置、推、拉、旋转、朝向旋转、交换;
- 6 种单臂构型,各 ~20 万条;
- 合计:~720 万条、> 1.4 万小时;
- 特点:无渲染、无物理,只保留可达空间、位姿、碰撞约束。
✅ 用途:低成本扩展"语言 ↔ 动作"对应关系,专供 T2A 阶段。
⚠️ 风险:轨迹过于运动学理想化。
✅ 最优消融 :~20% 合成 + 80% 真实语言---动作数据,而非纯合成或纯真实。
3. 四阶段训练:全文第二大创新
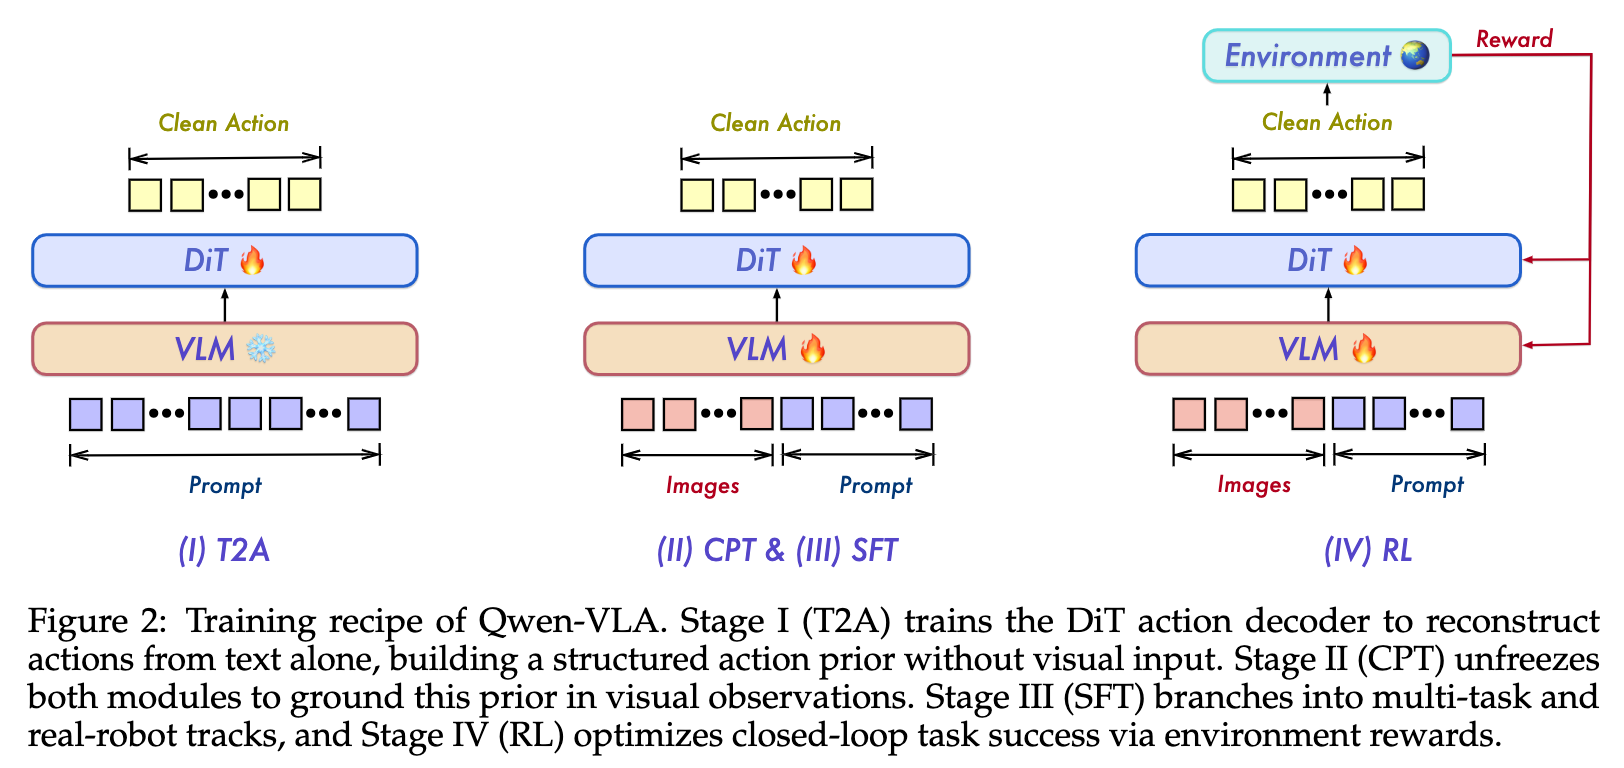
阶段一:T2A(Text-to-Action)DiT 预训练
- 冻结 VLM,仅用文本 + 具身提示训练 DiT;
- 不输入图像;
- 目标:让解码器先学会
- 语言选择的动作分布;
- 平台调制;
- 轨迹时序结构。
直觉 :"pick up the red cup" + 具身提示,用极少 token 就编码了任务意图;而对应动作轨迹可能是数百个高维关节值。这是结构化解压缩问题------T2A 先教会 DiT 当"语言条件的动作解压器"。
阶段二:CPT(Continued Pretraining)多模态继续预训练
- 解冻 VLM + DiT;
- 异构真实 + 仿真混合数据;
- 把"语言动作先验"grounding 到视觉。
阶段三:SFT(Supervised Fine-Tuning)监督微调
- 从 CPT 分两支:
- 多任务指令微调;
- 自研遥操作数据 → 面向真实机器人微调。
- 损失权重:VLM next-token 0.1 ,动作损失 1.0;
- 操作 chunk H=16,导航 waypoint H=8。
阶段四:RL(Reinforcement Learning)强化学习
- 起点:SFT;
- 环境:仅 SimplerEnv;
- 奖励:稀疏二值成功;
- 算法:PPO + GAE + RLinf;
- 目标:优化闭环任务成功率;
- 产出:Qwen-VLA-Instruct。
总目标:L = λ_act L_act + λ_vl L_vl,batch 内固定混合多任务样本。
4. T2A 消融:数字最有说服力
| 设置 | Simpler 成功率 |
|---|---|
| 不用 T2A 的基线 | 60.9% |
| ~20% 合成 + 80% 真实 + 全序列预测(最优) | 71.1% |
| 纯真实数据 | 51.0% |
| 纯合成数据 | 64.1% |
| 把图像加入 T2A 的 chunk 设定 | 57.6%(降) |
| T2A 2,000 步(最优) | 71.1% |
| T2A 40,000 步 | 60.4%(过拟合) |
关键读数:
- T2A 带来 +10.2 pp 提升;
- 合成覆盖 ↔ 真实动力学互补;
- 加入图像反而降到 57.6% → 佐证"无视觉条件迫使 DiT 学习语言---动作映射";
- T2A 也会过拟合(40k 步降至 60.4%)→ 先验阶段需要早停。
分阶段训练将"学习动作"拆成先验、grounding、模仿对齐、成功导向优化四步,是有实验证据支持的核心方法创新。
六、实验结果:单一模型在操作、导航与域外泛化上同时成立
评测逻辑:不只看"域内任务成功",更看统一模型能否在场景布局、背景、光照、物体配置、语言指令、传感器噪声与机器人本体发生变化时仍保持鲁棒。
1. 两个模型变体
| 变体 | 训练阶段 | 定位 |
|---|---|---|
| Qwen-VLA-Base | T2A + CPT | 通用基座 |
| Qwen-VLA-Instruct | + SFT + RL | 指令微调后的通才策略 |
(1)操作基准:单一模型接近或超过专用模型
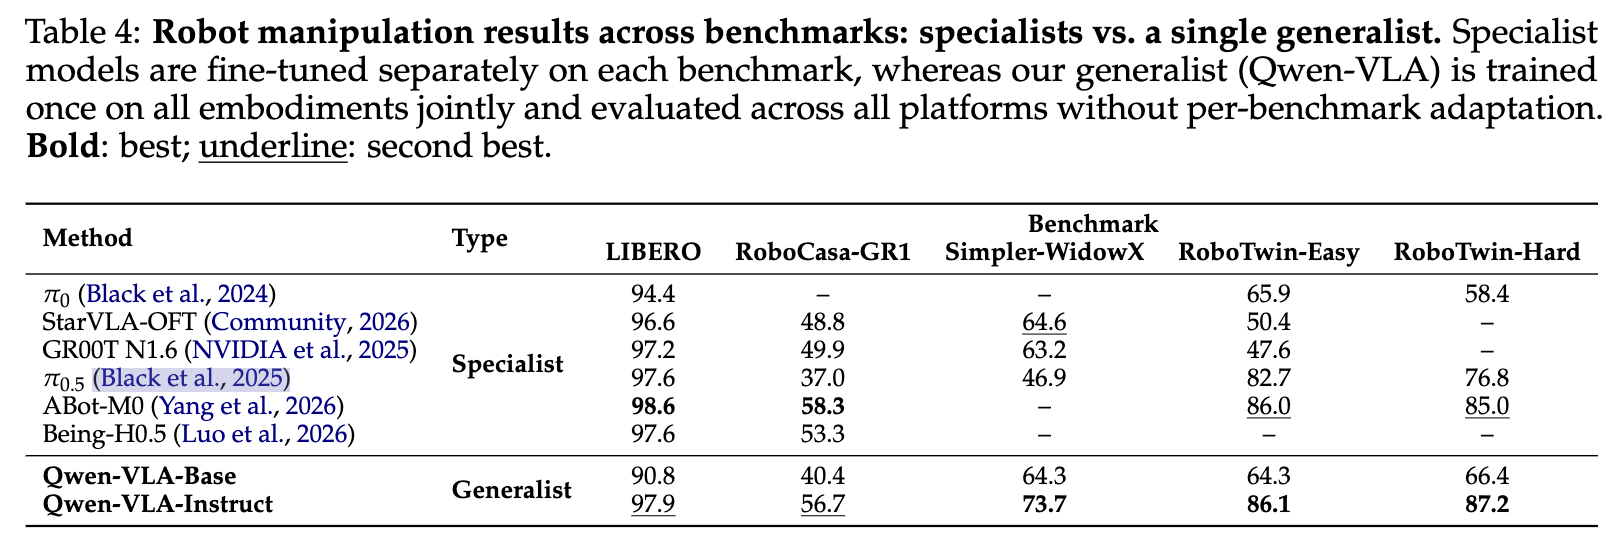
① 成绩一览
| 基准 | Qwen-VLA-Base | Qwen-VLA-Instruct | 相对增益 |
|---|---|---|---|
| LIBERO | 90.8% | 97.9% | +7.1 pp |
| RoboCasa-GR1 | 40.4% | 56.7% | +16.3 pp |
| Simpler-WidowX | 64.3% | 73.7% | +9.4 pp |
| RoboTwin-Easy | 64.3% | 86.1% | +21.8 pp |
| RoboTwin-Hard | 66.4% | 87.2% | +20.8 pp |
规律 :双机 RoboTwin 增益最大 (+21.8 / +20.8 pp),说明联合训练对高维、多自由度、长时域任务帮助最显著。
② 与专用基线的横向对比
| 基准 | Qwen-VLA-Instruct | 最强专用基线 | 结论 |
|---|---|---|---|
| LIBERO | 97.9% | 98.6%(专用) | 接近 |
| Simpler-WidowX | 73.7% | 64.6%(StarVLA-OFT) | 超越 |
| RoboTwin-Easy/Hard | 86.1% / 87.2% | 86.0% / 85.0%(ABot-M0) | 超越 |
| RoboCasa-GR1 | 56.7% | 49.9%(GR00T N1.6)、37.0%(π0.5) | 显著超越 |
③ 横向比较的"不可比"清单 ⚠️
表 4 不能解释为完全公平的全维度横评,原因:
- 多个对比项用 "--" 表示未报告;
- 各模型可能采用不同本体;
- 图像输入、数据接入、后训练配置不一致;
- RL 仅在单一仿真环境进行。
✅ 数字支持的是:"统一架构具备竞争力" ;
❌ 不支持的是:"在所有硬件和所有条件下已胜过专用模型"。
(2)导航、真实机 OOD 与动态操作:泛化才是主考场
① 视觉---语言导航(VLN-CE)
| 指标 | R2R Val-Unseen | RxR Val-Unseen |
|---|---|---|
| NE(越低越好) | 5.1 | 5.8 |
| OSR / SR | OSR 69.0% | SR 59.6% |
| SR | 57.5% | --- |
| SPL | 51.2% | 47.8% |
| nDTW | --- | 57.1% |
对比开源基线 StreamVLN:
- R2R SR:57.5% > 56.9% ✅
- RxR SR:59.6% > 52.9% ✅
论文结论:VLA 与 VLN 联合训练没有损害导航 。
更保守表述:共享模型在操作 + 连续导航 上可同时保持强性能;但因骨干规模、动作接口不同,表 7 更适合证明模型内部的多任务可行性,而非给出统一导航排行榜。
② 真实 ALOHA 双手机器人
a)域内 vs OOD
| 设置 | 从头训练 | 从 Qwen-VLA-Base 微调 |
|---|---|---|
| 域内平均 | 48.5% | 83.6% |
| OOD 平均 | 36.2% | 76.9% |
✅ 这是"预训练而非仅架构变化带来增益"的有力证据------架构一致,仅改变初始化与预训练数据。
b)逐任务 OOD 提升(揭示泛化边界)
| 任务 | 从头 | Base 微调 | 提升 |
|---|---|---|---|
| Pick and Place | 30.8% | 96.2% | +65.4 pp |
| Table Cleaning | 53.8% | 92.3% | +38.5 pp |
| Towel Folding | 50.0% | 65.4% | +15.4 pp |
| Fine-grained Manipulation | 30.8% | 61.5% | +30.7 pp |
规律 :预训练对可复用感知---动作原语 (抓取、放置、清理)帮助最大;对可变形物体(毛巾)和精确接触提升仍有限。
c)五类 OOD 维度(关键!)
| OOD 维度 | 从头 | Base 微调 | 提升 |
|---|---|---|---|
| 颜色 | 42.3% | 88.5% | +46.2 pp |
| 实例 | 30.8% | 76.9% | +46.1 pp |
| 背景 | 30.8% | 80.8% | +50.0 pp |
| 指令 | 42.3% | 84.6% | +42.3 pp |
| 位置 | 34.6% | 53.8% | +19.2 pp(最小) |
位置相关的平均提升最小 → 说明视觉鲁棒性并不必然转化为几何与位姿泛化。
⚠️ 论文未给出样本数、置信区间、多重比较校正,因此 76.9% 应读作其特定 ALOHA 设置下的结果,而非任意双机、任意对象、任意环境的通用 OOD 比例。
③ 静态 SimplerEnv-OOD(组合泛化)
设定:模型只在 Bridge 的简单抓取放置数据上训练 ,测试 6 项未见空间关系或反向堆叠任务。
| 模型 | 平均 OOD 成功率 |
|---|---|
| π0.5 | 12.6% |
| Qwen-VLA-Instruct | 32.0% |
分项:
- MoveRight:33.3%(π0.5 = 0.0%) ✅
- PlaceNear:39.6%(π0.5 = 0.0%) ✅
- PutFront:4.2%(Base = 6.3%) ⚠️
✅ 这是更严格的组合泛化证据 :训练数据与测试指令、关系、物体配对均不相同。
⚠️ 但 32.0% 的绝对成功率 也清楚表明:零样本空间关系泛化尚未成熟。
④ 动态操作 DOMINO(35 套)
| 模型 | Success Rate | Manipulation Score |
|---|---|---|
| Qwen-VLA-Base | 21.1% | 37.4 |
| Qwen-VLA-Instruct | 26.6% | 39.5 |
关键条件:
- 仅用当前帧;
- 未使用动态操作微调;
- 却超过一些动态微调基线。
⚠️ 需区分 SR 与 MS:
- SR = 任务是否完成;
- MS = 连续执行质量评价;
- MS 差距通常小于 SR → 优势不能解释为在所有动态质量维度上同等幅度领先。
"动态能力来自宽域联合预训练"是合理假设,但因果证据不足以证明每一个非机器人数据源都贡献了独立增益。
(3)分阶段与联合训练分析:谁在贡献?
① 后训练三检查点(CPT → +SFT → +RL)
| 基准 | CPT (Base) | +SFT | +RL (Instruct) | 主要来源 |
|---|---|---|---|---|
| Simpler | 64.3% | 70.8% | 73.7% | SFT + RL |
| RoboCasa | 40.4% | 56.0% | 56.7% | SFT |
| RoboTwin-Easy | 64.3% | 86.3% | 86.1% | SFT |
| LIBERO | 90.8% | 97.8% | 97.9% | SFT |
| SimplerEnv-OOD | 25.3% | 31.6% | 32.0% | SFT |
| DOMINO SR | --- | 25.7% | 26.6% | SFT + 微 RL |
| DOMINO MS | --- | 39.1 | 39.5 | 微 RL |
② 核心结论:SFT 是主要提升源,RL 主要强化其训练域
a)SFT 的贡献
- 全面提升;
- 尤其在数据稀缺、任务复杂的 RoboTwin(+21.8 / +20.8 pp)上。
b)RL 的真实作用
- Simpler:+2.9 pp(最大);
- RoboTwin-Easy/Hard、LIBERO、SimplerEnv-OOD:仅 +0.1 ~ 0.6 pp;
- DOMINO SR:+0.9 pp,MS:+0.4。
RL 的主要作用不是显著扩展跨域泛化,而是在稀疏成功奖励下优化闭环执行。
c)为什么 RL 跨域增益小?
- Rollout 只来自 SimplerEnv;
- 最直接改善的是该环境中的任务成功与错误累积;
- 对非训练基准的保持 → 只支持"未发生严重灾难性遗忘";
- 不足以支持"RL 天然跨域泛化"。
⚠️ 若奖励不编码碰撞、能耗、平滑、任务中断和安全约束,单纯追求成功率可能带来不希望的执行策略。
③ 多形态投影消融
| 投影方式 | Bridge(单独 62.8%) | RoboCasa(单独 53.4%) |
|---|---|---|
| 每种形态各自 MLP | 63.3% | 52.1% |
| 拼接式共享 MLP | 63.0% | 52.8% |
| 零填充共享 MLP(采用) | 63.0% | 53.2% |
差距 < 1.2 pp → 作者选择参数最少的零填充方案。
✅ 支持:"共享 DiT 空间不会显著增加平均任务损失"。
⚠️ 局限:仅在两个基准、三类投影上比较,无法覆盖全部平台、控制频率和安全关键任务。
七、横向比较与局限:统一"可行且强",但非"必然更优"
1. 与同期 VLA 模型的差异
| 模型 | 范式 | 特点 |
|---|---|---|
| π0 / π0.5 | 流匹配 VLA | 强操作基线 |
| GR00T N1.6 | 多形态 + 仿真扩展 | 强调规模化 |
| StarVLA-OFT | 高效动作表示 | OFT 动作 token |
| ABot-M0 | 专用强基线 | RoboTwin 标杆 |
| Qwen-VLA | 统一动作---轨迹 + 四阶段训练 | 跨操作/导航/轨迹/人本 |
Qwen-VLA 的差异化优势:
- 把导航、操作、轨迹预测、人本视频、视觉---语言辅助数据放进同一接口;
- 用 T2A 热身解决冷启动;
- CPT → SFT → RL 四阶段稳定训练;
- 具身提示替代多套输出头。
代价:
- 系统、数据、评测栈更复杂;
- 来自 Qwen3.5 的强 VLM 先验本身是大团队资源优势。
2. 四条硬限制
(1)具身数据仍太少
具身动作数据 ≪ 视觉---语言预训练语料。
- 长尾对象不足;
- 长尾环境不足;
- 长尾形态不足;
- 接触丰富任务不足。
(2)多目标优化存在折中
视觉---语言理解、导航、动作联合训练存在目标冲突:
- 某些纯 VLM 评测回退;
- 某些导航评测回退;
- 需要手动调 λ_act / λ_vl。
(3)评测偏短时程、基准化
- 长时程 ❌
- 易失败任务 ❌
- 真实部署 ❌
- 失败恢复 ❌
(4)评测指标不可直接相加
| 领域 | 指标 | 衡量对象 |
|---|---|---|
| 导航 | OSR / SR / SPL / nDTW | 路径 + 指令遵循 |
| 操作 | Success Rate | 任务完成 |
把两者并列为"统一能力提升" → 适合说明接口与训练框架通用 ;
若合成"综合智能指标" → 混淆评测语义。
3. 能力边界判定
✅ 已证明:宽域感知 + 中短程动作生成
- 未见颜色、对象、背景、组合指令上的成功率提高 → 感知迁移的强证据;
- 动态物体零样本结果 → 零样本泛化的积极证据。
❌ 未证明:物理因果或安全闭环
- 柔性物体 ❌
- 遮挡 ❌
- 长程失败恢复 ❌
- 双臂接触动力学 ❌
- 力/触觉反馈 ❌
- 机器人损坏/异常 ❌
当前最可信的能力边界是"宽域感知与中短程动作生成",而不是物理因果或安全闭环。
4. 未来方向(论文自述,非已具备能力)
自主数据收集、sim-to-real、长时程规划、情景记忆、世界模型、触觉与力反馈。
八、启示与工程建议:迁移"结构",不迷信"比例"
1. 可复用的工程路线(按序执行)
第一步:定义统一接口
H × K动作张量;- 有效性掩码;
- 平台元数据。
❌ 不要强行把各机器人动作标准化。
第二步:构建语言---动作配对
- 让解码器在无视觉条件 下形成平台条件化动作先验;
- 可用无渲染合成轨迹低成本扩量。
第三步:解冻视觉主干,联合 grounding
- 跨真实、仿真、导航、语言数据;
- 固定 batch 内多任务比例。
第四步:多任务 SFT
- 提高具体任务精度;
- VLM 损失权重 << 动作损失权重。
第五步:在奖励可可靠测量的环境中加 RL
- 稀疏成功奖励;
- PPO / GAE;
- 监控非训练域是否遗忘。
2. 真正值得迁移的是"训练流程的结构"
论文中的特定数值,都是特定数据集与实验栈下的最优值:
- 74.2% 操作数据 ❌ 不可直接照搬
- 20% 合成 T2A 数据 ❌
- T2A 2,000 步 ❌
- Sig-Normal / Beta 时间步分布 ❌
换用不同硬件、控制频率、图像视角、数据噪声后,比例与超参数需重新验证。
✅ 应保留的诊断框架:
T2A 基线成功率
    → CPT 视觉增益
    → SFT 下游增益
→ RL 闭环增益用以定位失败来自:动作先验 / 视觉 grounding / 任务模仿 / 奖励设计。
3. 下一步最有价值的三个证据链
证据链一:公平对比
在控制机器人、控制频率、图像输入、训练样本、评测协议完全对齐的条件下,比较:
- 统一模型 vs 专用模型;
- 量化"共享"是否带来净收益。
证据链二:真实长时程评测
发布:
- 成功率;
- 恢复率;
- 碰撞率;
- 执行时间;
- 安全指标。
场景:多步骤、不可恢复错误、接触任务。
证据链三:数据贡献归因
- 哪类仿真 → 何种泛化?
- 哪类人本数据 → 何种技能?
- 哪种视觉---语言数据 → 何种能力?
避免把联合训练的所有增益笼统归因于"大模型"。
九、总结:一句话判定
Qwen-VLA 为通才具身模型提供了可验证、可扩展的强基线;但它尚未解决跨机器人、跨任务和跨环境的通用控制。
贡献高于单点 SOTA 的三件事
- ✅ 统一接口:能同时处理多形态动作、导航轨迹、人本运动、语言输出;
- ✅ 具身提示:用文本代替多套输出头;
- ✅ 分阶段训练:解决了"强 VLM + 随机 DiT"的真实冷启动问题。
仍未翻过的三座山
- ❌ 动作数据规模;
- ❌ 目标权衡与容量竞争;
- ❌ 长时程部署与物理反馈。