在学习和开发过程中,我们经常同时使用 Markdown 笔记、PDF 文档、项目资料和 AI 对话。资料可以保存下来,但要把一次回答与原文对应起来,再整理成能够反复使用的知识,往往还需要在几个工具之间切换。
Trellora 围绕这个过程构建了一个 Windows 本地优先 AI 知识工作台,将笔记写作、资料管理、知识库问答、Wiki 学习和知识关联放进同一个桌面应用。
本文介绍 Trellora 的主要功能、技术架构和使用方式,也说明哪些能力可以直接在本地使用,哪些需要额外配置模型或外部服务。
本文根据项目当前 README 整理,面向 Windows x64,README 所列版本为 1.0.0。项目仍在持续开发,发行包的验证情况以仓库中的桌面分发验收记录为准。
一、Trellora 解决什么问题
Trellora 面向需要持续阅读、写作和整理资料的开发者、学生及知识工作者。它组织的是一条连续的知识工作流程:
收集资料 → 解析和索引 → 阅读与提问 → 整理为笔记 → 建立关联 → 持续复用例如,在学习一个项目时,可以先导入设计文档,通过知识库问答查找某个模块的说明,点击引用回到原文,然后把整理后的回答保存为 Markdown 笔记。需要逐章学习时,可以进入 Wiki;需要探索跨文档关系时,可以在完成图谱增强后进入地图。
这几个入口各有用途:
| 入口 | 主要用途 |
|---|---|
| 笔记 | 主动写作、编辑和整理 Markdown |
| 资料 | 保存原始文档,完成解析和检索准备 |
| 助手 | 围绕问题、当前笔记或个人知识库提问 |
| Wiki | 按文档章节浏览、分析和整理学习内容 |
| 地图 | 探索资料库中的实体、关系和社区 |
基础编辑、文件浏览和笔记关键词搜索不要求配置 AI,可以先从普通的本地笔记工作流开始使用。
二、主要功能与界面
2.1 Markdown 写作:编辑、预览与源码
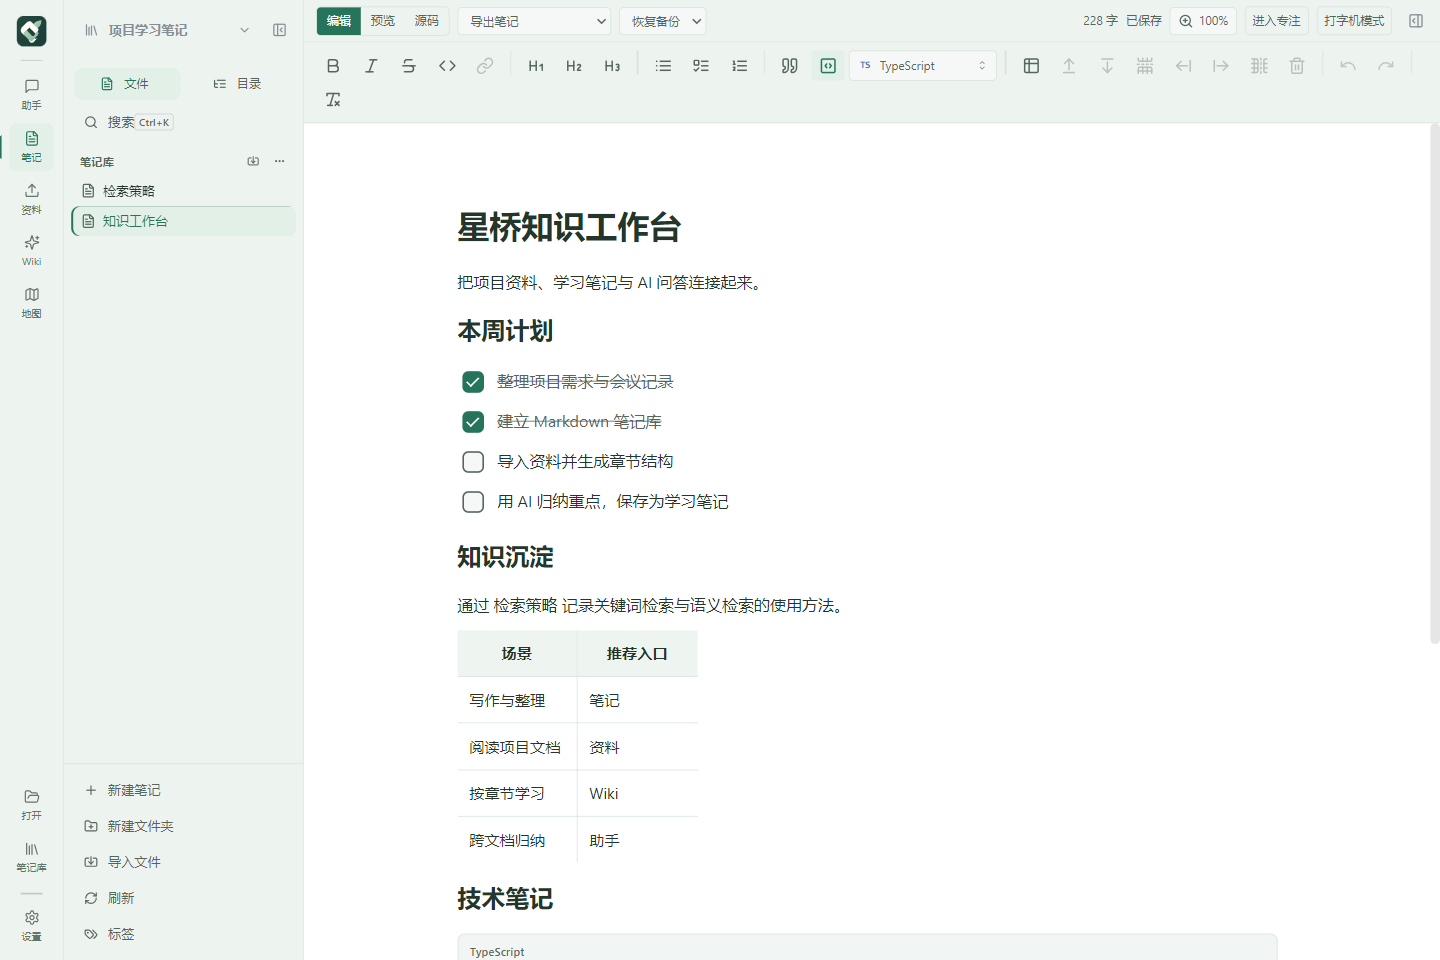
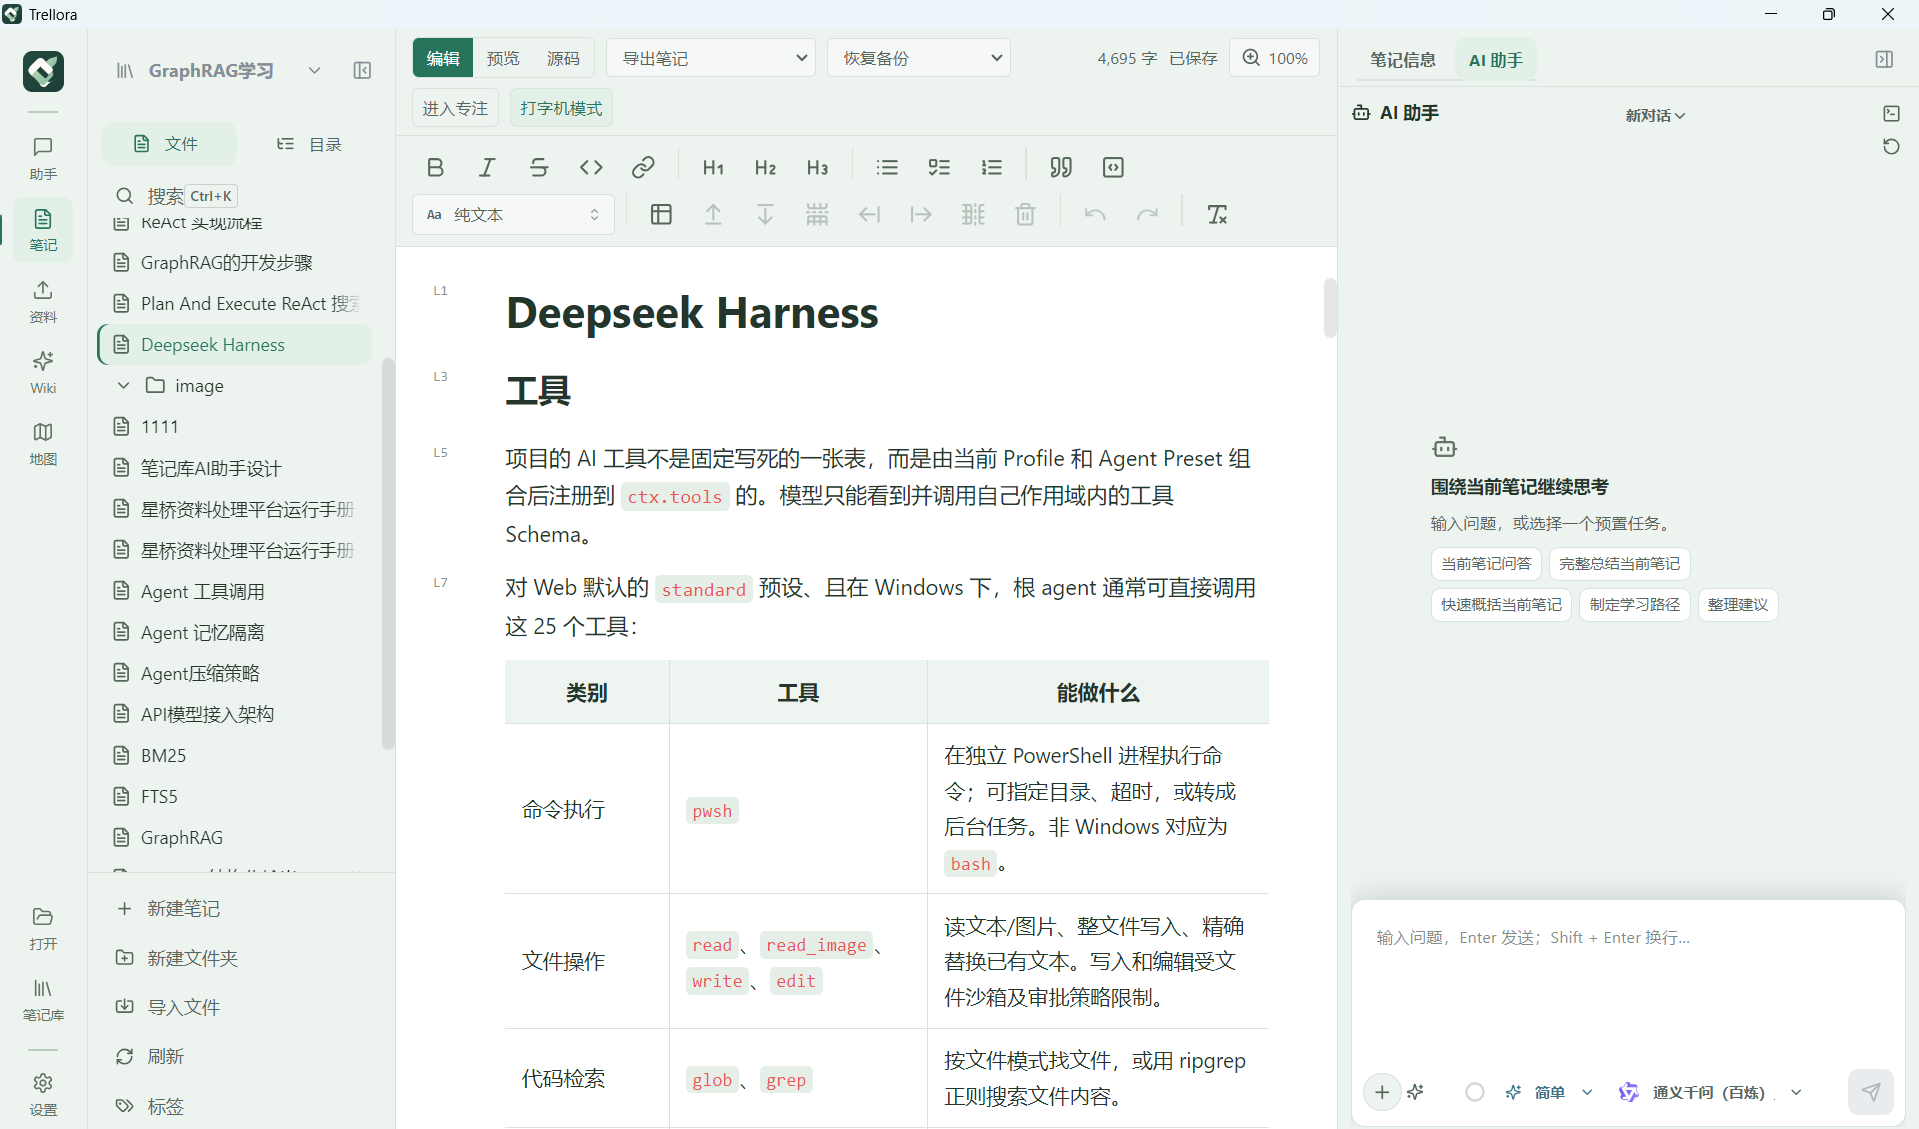
笔记是 Trellora 的基础工作区。左侧提供文件树、文档目录、搜索和标签,中间是编辑器,右侧可以查看笔记信息或使用当前笔记 AI 助手。
编辑器提供三种模式:
-
编辑模式:使用 Tiptap 进行所见即所得编辑。
-
预览模式:查看 Markdown 渲染后的内容。
-
源码模式:使用 CodeMirror 编辑 Markdown 原文。
写作内容支持表格、待办、代码高亮、KaTeX 公式、Mermaid 和 Wiki 链接;写作工具包括实时字数、缩放、目录定位、选区工具栏、专注模式和打字机模式。配置模型后,还可以进行 AI 选区变换与扩写。
库内笔记支持自动保存和备份恢复。对于直接打开的独立文件,应用先保存恢复草稿,原文件通过手动保存写回,这两种保存行为需要区分。
2.2 资料库:让文档进入检索流程
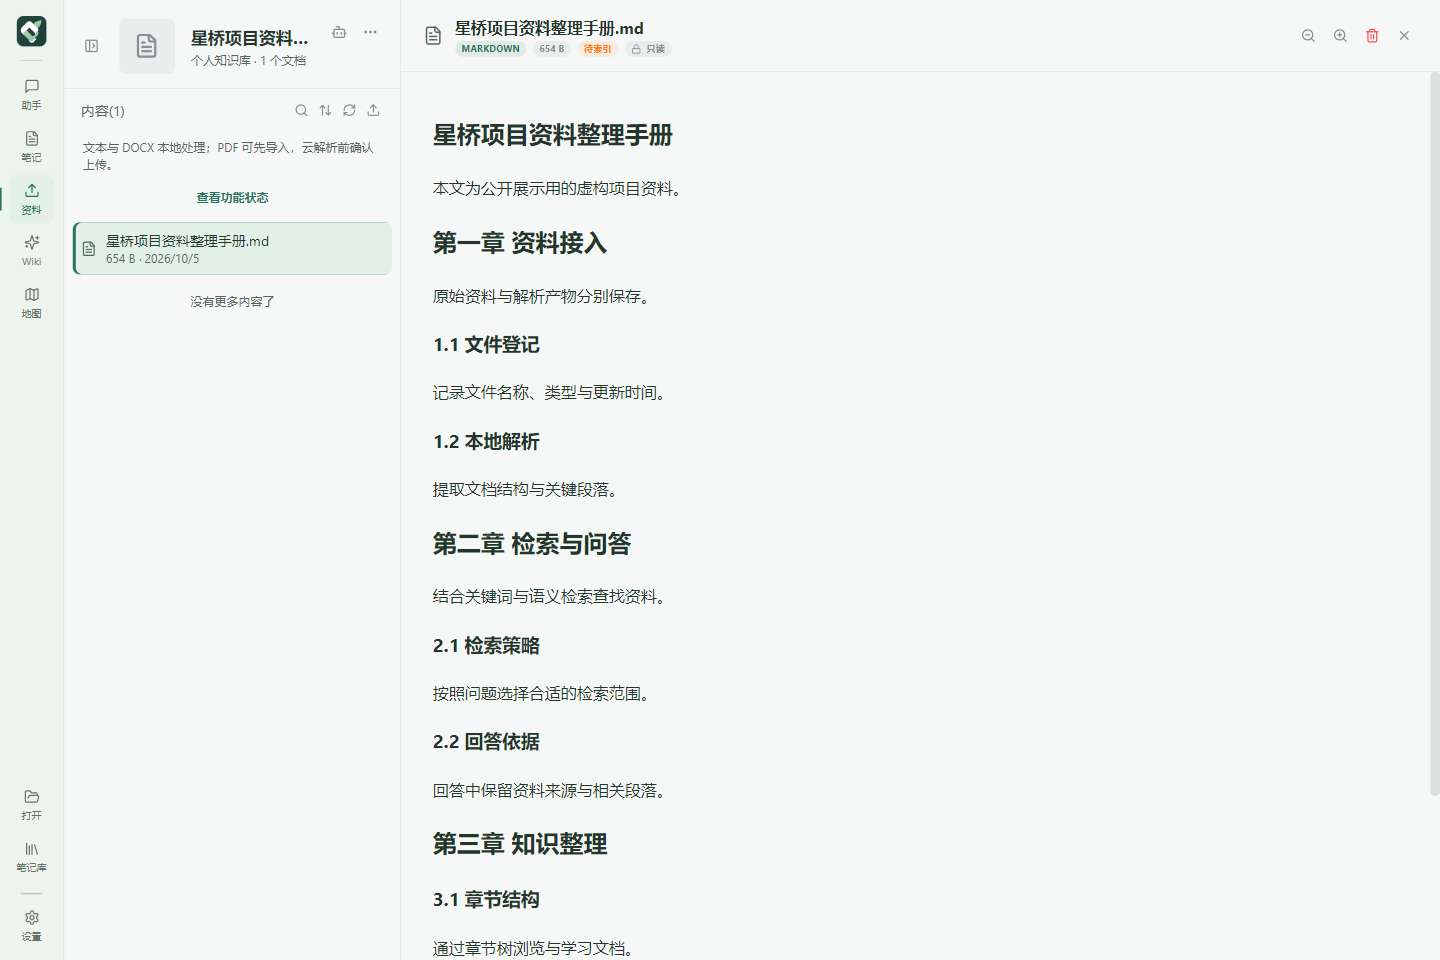
资料页面用于管理作为知识来源的文档,提供上传、搜索、排序、预览、重新扫描,以及流水线配置、状态和阶段产物查看。
不同格式使用不同的解析路线:
| 文档类型 | 当前处理方式 |
|---|---|
| 文本文件 | 在本机解析 |
| DOCX | 由 Mammoth Worker Thread 在本机解析 |
| 可以先导入和预览;建立可检索内容时使用单独配置并授权的 MinerU 云解析 |
文档流水线按配置执行解析、逻辑行处理、结构信号识别、歧义处理、结构树构建、父子切块、关键词、向量和实体处理。界面展示阶段状态、进度与错误,并提供取消和重试。
解析产物保存在资料库的 .menghan-meta/ 下,处理阶段不会覆盖原始文档。图谱增强和 LLM 辅助处理属于可选配置。
2.3 AI 助手:根据任务选择问答范围
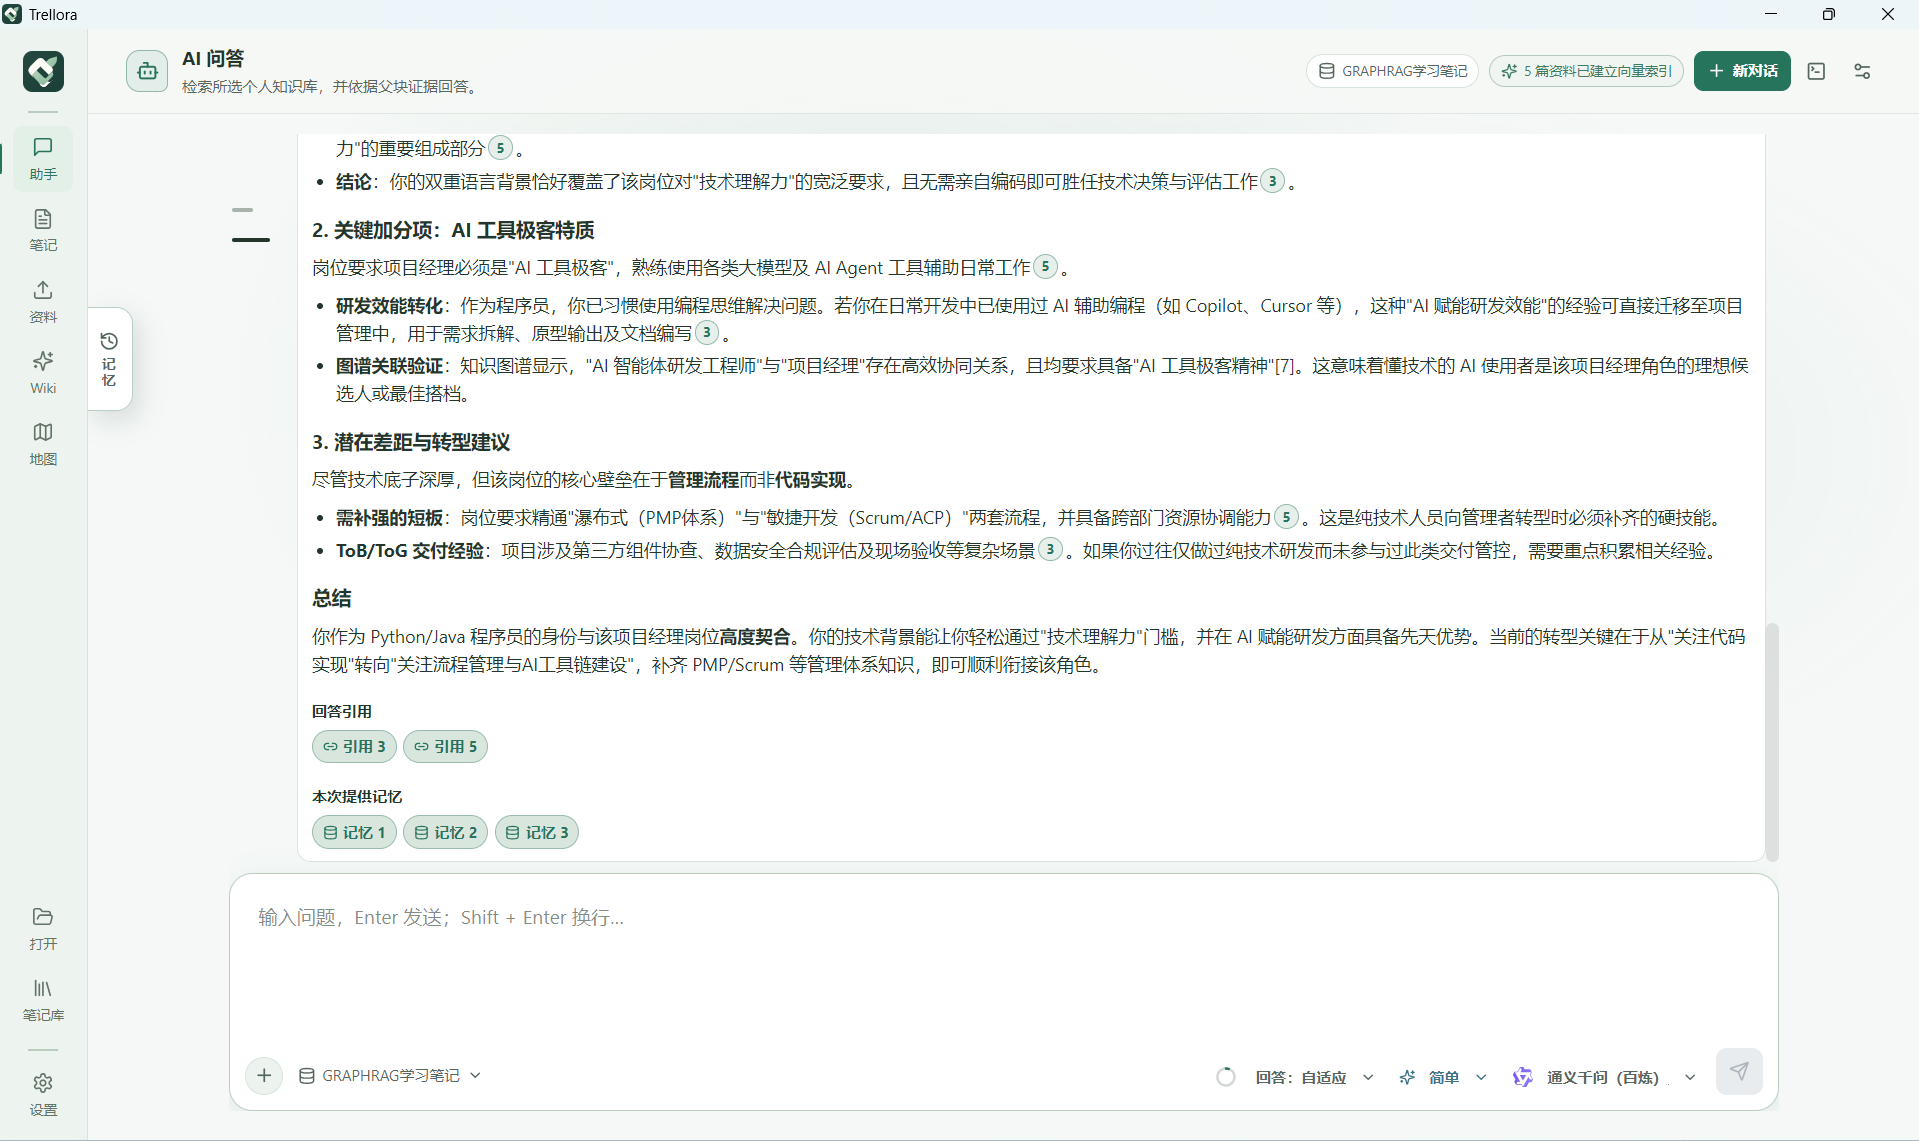
Trellora 的助手提供三种问答范围:
| 范围 | 内容来源 | 使用示例 |
|---|---|---|
| 自由问答 | 问题、主动添加的附件与适用的会话上下文 | 解释概念、讨论方案、辅助写作 |
| 当前笔记 | 当前笔记及按需读取的章节 | 总结内容、检查表述、继续追问 |
| 个人知识库 | 选定资料库中的检索证据 | 查找项目依据、跨文档归纳、整理学习材料 |
回答支持流式显示、停止生成和保存为笔记。资料引用可以定位来源,复杂问题可以展示计划与工具调用;需要公开信息时,还可以配置并启用联网搜索。
一个实用的提问方式是先明确范围和目标,例如:
请根据当前资料库中的项目文档,整理文档解析流程。
按阶段说明输入、输出和职责,并标注对应来源。
这是使用示例。回答能否找到充分依据,取决于已导入的资料、索引状态和模型配置,使用时仍应打开引用核对原文。
2.4 Wiki:按章节组织学习
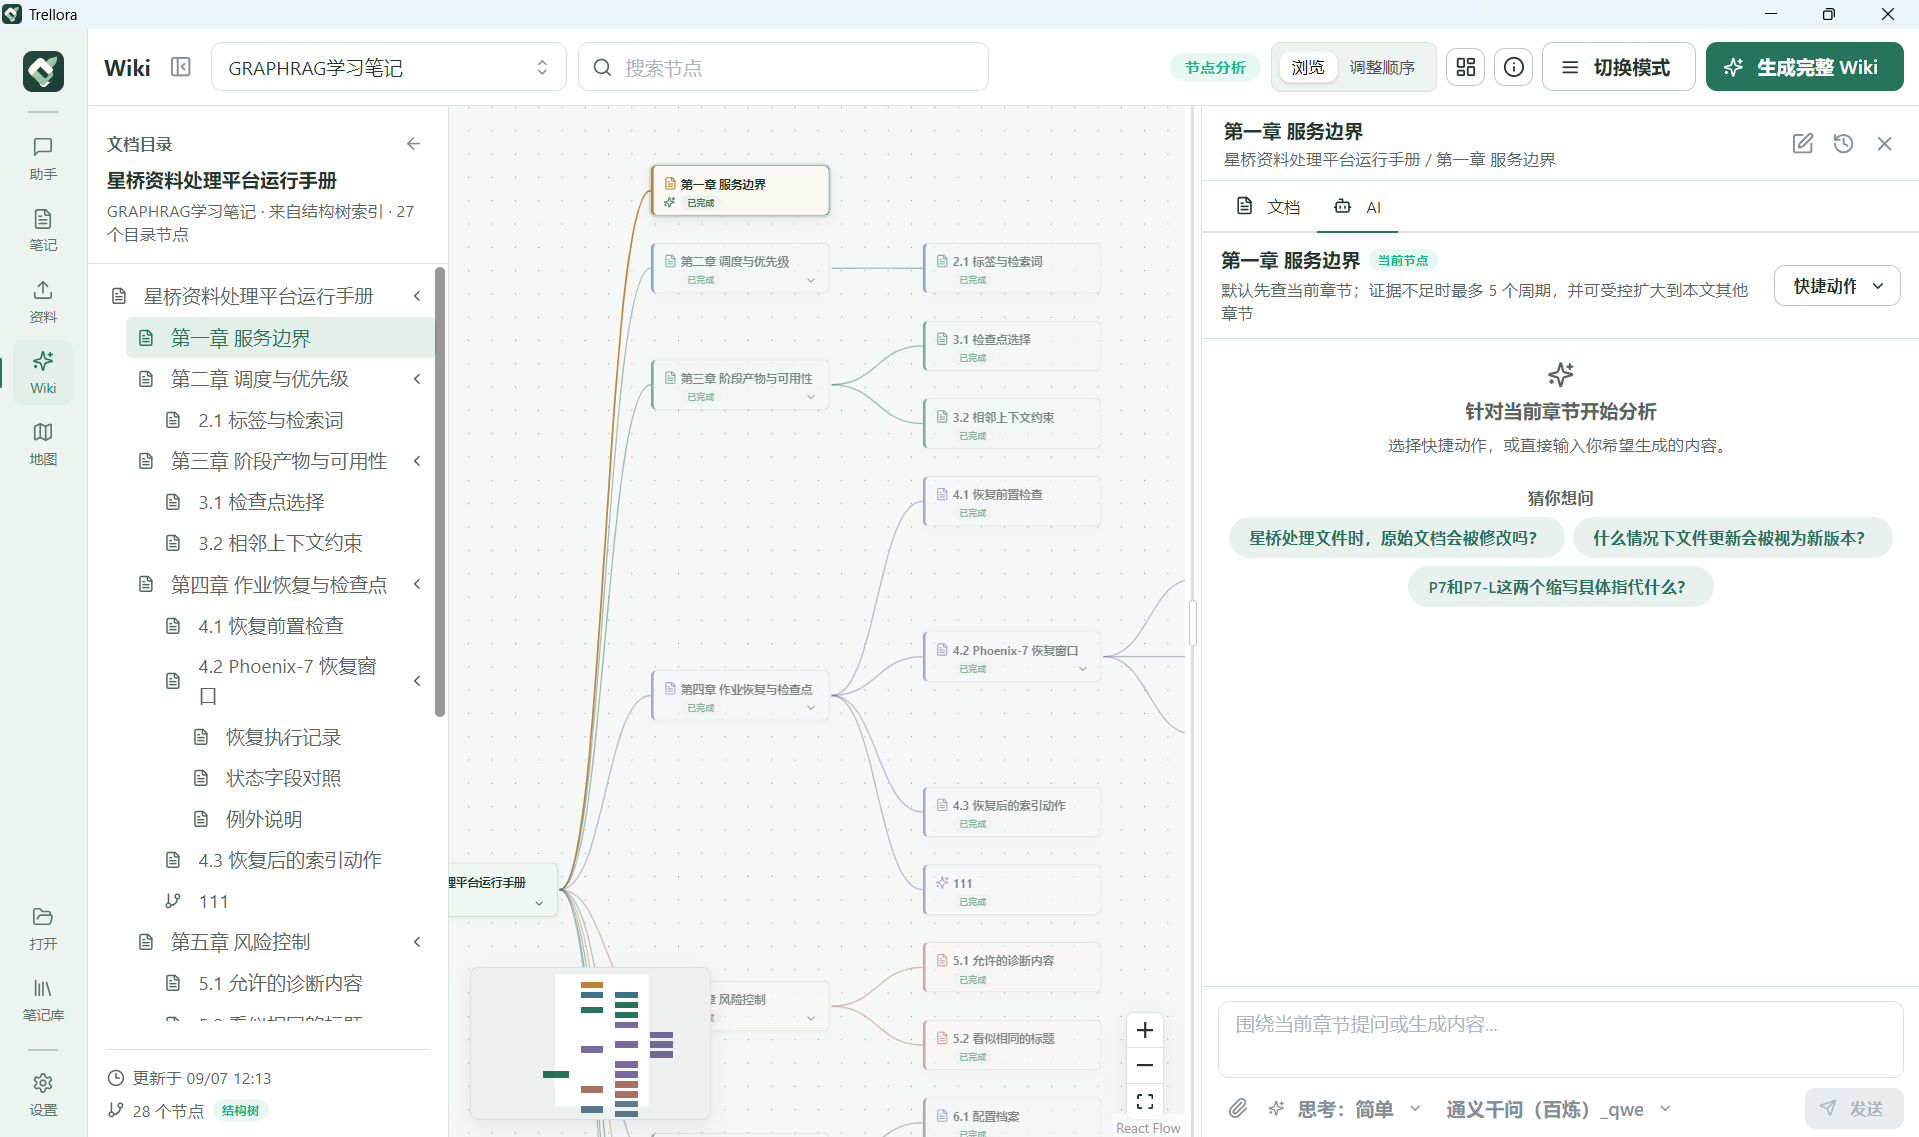
Wiki 将已建立结构索引的资料展开成章节学习空间。选择资料库和文档后,可以查看文档目录、章节节点及父子关系,并进行搜索、折叠、缩放和同级章节排序。
在章节节点上,可以查看原文、围绕章节提问、执行快捷分析,或生成完整 Wiki。生成结果可以形成派生节点,也可以保存为 Wiki AI 内容;章节任务支持取消和失败重试。
结构浏览使用本地解析结果,AI 分析与生成需要可用模型。Wiki 主要呈现文档的章节结构,地图则用于探索跨文档实体关系。
2.5 地图:探索实体与关系
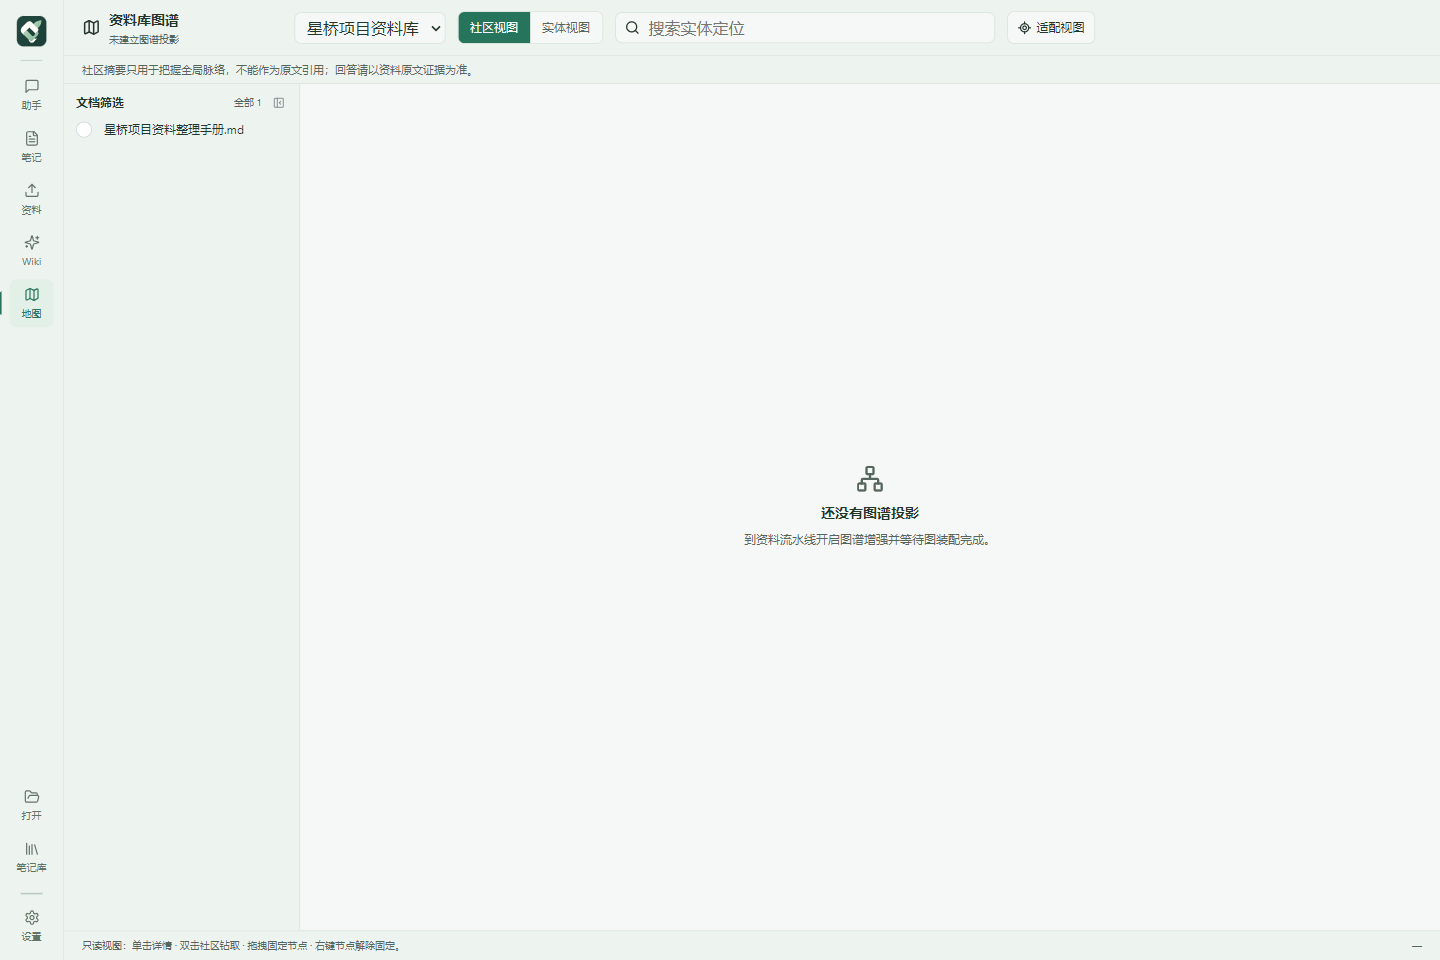
地图提供社区视图、实体视图、实体搜索、文档筛选和节点详情,帮助发现资料之间的联系。
使用前需要在资料流水线启用图谱增强,并完成实体处理和库级图装配。图谱可以为助手提供局部实体检索和全局社区检索;社区摘要用于理解整体主题,回答依据仍需要回到资料原文。
下面的截图展示尚未生成图谱时的实际界面及准备提示。
2.6 会话历史、长期记忆与桌面管理
助手支持会话历史和历史对话搜索。长期记忆提供手动保存、明确要求记住,以及可选自动提炼等方式,并支持来源查看、记忆管理和待确认变更。回答中的长期记忆引用与文档证据分别展示,方便核对来源。
桌面管理方面,Trellora 支持多个笔记库、中英文界面、深浅主题、五种配色,以及笔记备份、完整工作区备份与恢复、存储迁移和诊断。
也可以通过 Ctrl+O 直接打开受支持的本地文本文件,无需先创建笔记库。移除笔记库注册会保留磁盘上的笔记文件。
三、技术架构:桌面主进程统一管理本地能力
Trellora 使用 Electron、React 和 TypeScript 构建桌面应用,核心进程关系如下:
React 渲染进程
    │
    ▼
Preload / 类型化 IPC
    │
    ▼
Electron 主进程
    ├── 本地文件、保存与恢复
    ├── SQLite / FTS5 / sqlite-vec
    ├── AI 调用、索引与任务编排
    ├── Node Worker Threads:笔记索引、DOCX 解析
    └── Python Sidecar:结构、切块、关键词、图装配等阶段
React 负责展示界面和处理用户交互,通过受限的 preload IPC 请求桌面能力。Electron 主进程负责文件权限、任务编排、数据库、模型连接和安全设置。
DOCX 解析放在 Mammoth Worker Thread 中执行,避免阻塞主进程。Python Worker 负责后续结构化阶段,通过 NDJSON 标准输入输出与 Electron 通信,不默认启动 FastAPI,也不监听本地 HTTP 端口。
Python 不直接写入应用 SQLite,阶段产物由 Electron 校验和导入。这样的职责划分使桌面应用能够集中管理文件、任务和索引写入。
3.1 核心技术栈
| 模块 | 主要技术 |
|---|---|
| 桌面与界面 | Electron、React、TypeScript、Vite、Mantine |
| 编辑与渲染 | Tiptap / ProseMirror、CodeMirror 6、remark / unified、KaTeX、Mermaid、DOMPurify |
| 索引与检索 | MiniSearch、better-sqlite3、SQLite FTS5、sqlite-vec |
| 文档处理 | Mammoth、PDF.js、docx-preview、Python、Jieba |
| Agent 与模型 | 多协议模型适配、ReAct 执行循环、LangGraph 相关编排 |
| 图谱与可视化 | igraph / Leiden、NetworkX、React Flow、力导向布局 |
3.2 项目目录
src/              React 界面、编辑器、Wiki 与国际化
electron/         生命周期、文件、IPC、AI、索引、流水线与恢复
shared/           跨进程类型、配置合同、限额和默认值
pipeline-python/  NDJSON Worker、结构化阶段与 Python 测试
build/            品牌资源、内置技能与安装器配置
scripts/          构建、功能与发行包验证脚本
docs/ 产品、架构、展示资源和验收记录需要进一步了解模块调用链,可以阅读完整代码架构文档。
四、本地数据与外部服务如何配合
Trellora 以普通本地文件保存笔记和原始资料,同时为检索、对话和恢复维护独立数据。
| 数据 | 保存位置 |
|---|---|
| 笔记原文 | 用户选择的本地笔记库 |
| 笔记元数据与索引 | 笔记库 .menghan-meta/ |
| 资料流水线产物 | 资料库 .menghan-meta/pipeline/ |
| 问答历史与长期记忆 | 工作区 ConversationMemory/qa-memory.db,部分旧库保留兼容存储 |
| 技能文件 | 工作区 AI-Skill/ |
| 库内笔记备份 | .menghan-backups/ |
| 设置、密钥和独立文件恢复草稿 | Electron userData,API Key 使用 safeStorage 加密保存 |
首次启动默认使用"文档"目录中的 Trellora工作区。工作区迁移在校验和加载成功后启用新位置,并保留原目录;外部已注册库继续关联原位置。换电脑时,需要备份工作区及相关外部笔记库。
使用远程 AI 时,会按问答范围发送问题、必要文档片段、主动添加的附件和适用上下文。远程 Embedding 有独立同意控制,PDF 云解析另需允许完整文件上传。
不同能力的配置条件如下:
| 能力 | 配置条件 |
|---|---|
| 编辑、文件浏览、笔记关键词搜索 | 不要求 AI 模型 |
| AI 回答、分析与生成 | 可用的本地或远程生成模型 |
| 向量检索与长期记忆向量召回 | Embedding 服务及相应索引 |
| 检索重排序 | 可选 Rerank 服务 |
| PDF 可检索内容解析 | MinerU 配置及上传授权 |
| 联网搜索 | 启用并配置搜索服务 |
| 地图展示 | 完成图谱增强及图装配 |
生成模型支持 Ollama,以及 OpenAI、Anthropic、Google Gemini、DeepSeek、Moonshot、通义千问、智谱、SiliconFlow、OpenRouter 和自定义兼容 API。具体功能仍取决于服务商、协议和模型能力。
生成模型、Embedding 和 Rerank 分别配置。资料库已有向量绑定模型档案,切换模型通过建立新索引代际、校验后激活和可选回滚完成,避免不同模型的向量直接混查。
五、如何开始使用
5.1 使用 Windows 桌面包
README 提供安装版和免安装版两种 Windows x64 分发形式:
发行文件说明、校验值与清单见下载目录,后续版本可关注 GitHub Releases。
发行包设计为携带所需 Python runtime,最终用户无需自行搭建 Python Web 服务。首次运行、备份恢复和更新方法见桌面分发与备份恢复使用说明。
建议按以下顺序体验:
-
创建一个笔记库,写一篇 Markdown,或直接打开已有文本。
-
在"设置 → 模型配置"添加模型并测试连接。
-
使用自由问答或当前笔记问答。
-
创建资料库,导入文档并完成解析与索引;需要语义检索时配置 Embedding。
-
通过知识库问答和 Wiki 整理内容,把有价值的回答保存为笔记。
5.2 从源码启动
开发环境准备 Windows x64、Git、Node.js 和 pnpm。README 建议 Node.js 22 或 24、pnpm 9 或更高版本;原生模块缺少可用预编译产物时,需要 Visual Studio C++ Build Tools。
git clone https://github.com/Elevenoven/Trellora-plus.git
cd Trellora-plus
pnpm install
pnpm run rebuild:native
pnpm dev
pnpm dev 同时启动 Vite 和 Electron。仅打开浏览器页面不会提供本地文件、SQLite、Worker 和桌面 IPC 能力。
开发和测试文档流水线时,再准备 Python 环境:
python -m venv pipeline-python\.venv
.\pipeline-python\.venv\Scripts\python.exe -m pip install -r pipeline-python\requirements.txt
.\pipeline-python\.venv\Scripts\python.exe -m unittest discover -s pipeline-python\tests -v
Worker 优先使用该虚拟环境,并通过标准输入输出通信。
六、开发检查与 Windows 打包
项目提供类型检查、代码检查和按功能划分的验证脚本。例如:
pnpm exec tsc -b
pnpm lint
pnpm run verify:markdown
pnpm run verify:ai-provider
pnpm run verify:current-note-react-loop
pnpm run verify:pipeline-worker
pnpm run verify:wiki-workspaceWindows 打包需要为发布 Worker 准备独立的 .deps 依赖目录:
python -m pip install -r pipeline-python\requirements.txt --target pipeline-python\.deps
pnpm build
pnpm run release:manifest
输出文件位于 trellora/,名称形式为:
Trellora-<version>-portable-x64.exe
Trellora-<version>-setup-x64.exe
类型检查与构建通过,不能替代真实模型调用、文档解析、Windows 文件关联或干净机器运行验证。当前已验证内容与待完成的发行门,见桌面分发验收记录。
七、项目资源与反馈
如果希望把本地 Markdown 写作、项目资料阅读和 AI 辅助学习连接起来,可以从笔记和当前笔记问答开始体验,再按需求配置资料检索、Wiki 和图谱能力。
反馈时可以提供应用版本、复现步骤和相关诊断信息,避免附带密钥或私人资料。
当前仓库尚未声明开源许可证,使用与分发条件以后续 LICENSE 文件为准。本文中的界面图片来自项目 README 展示资源,包含演示截图和实际使用截图;截图不替代功能或发行包验收。