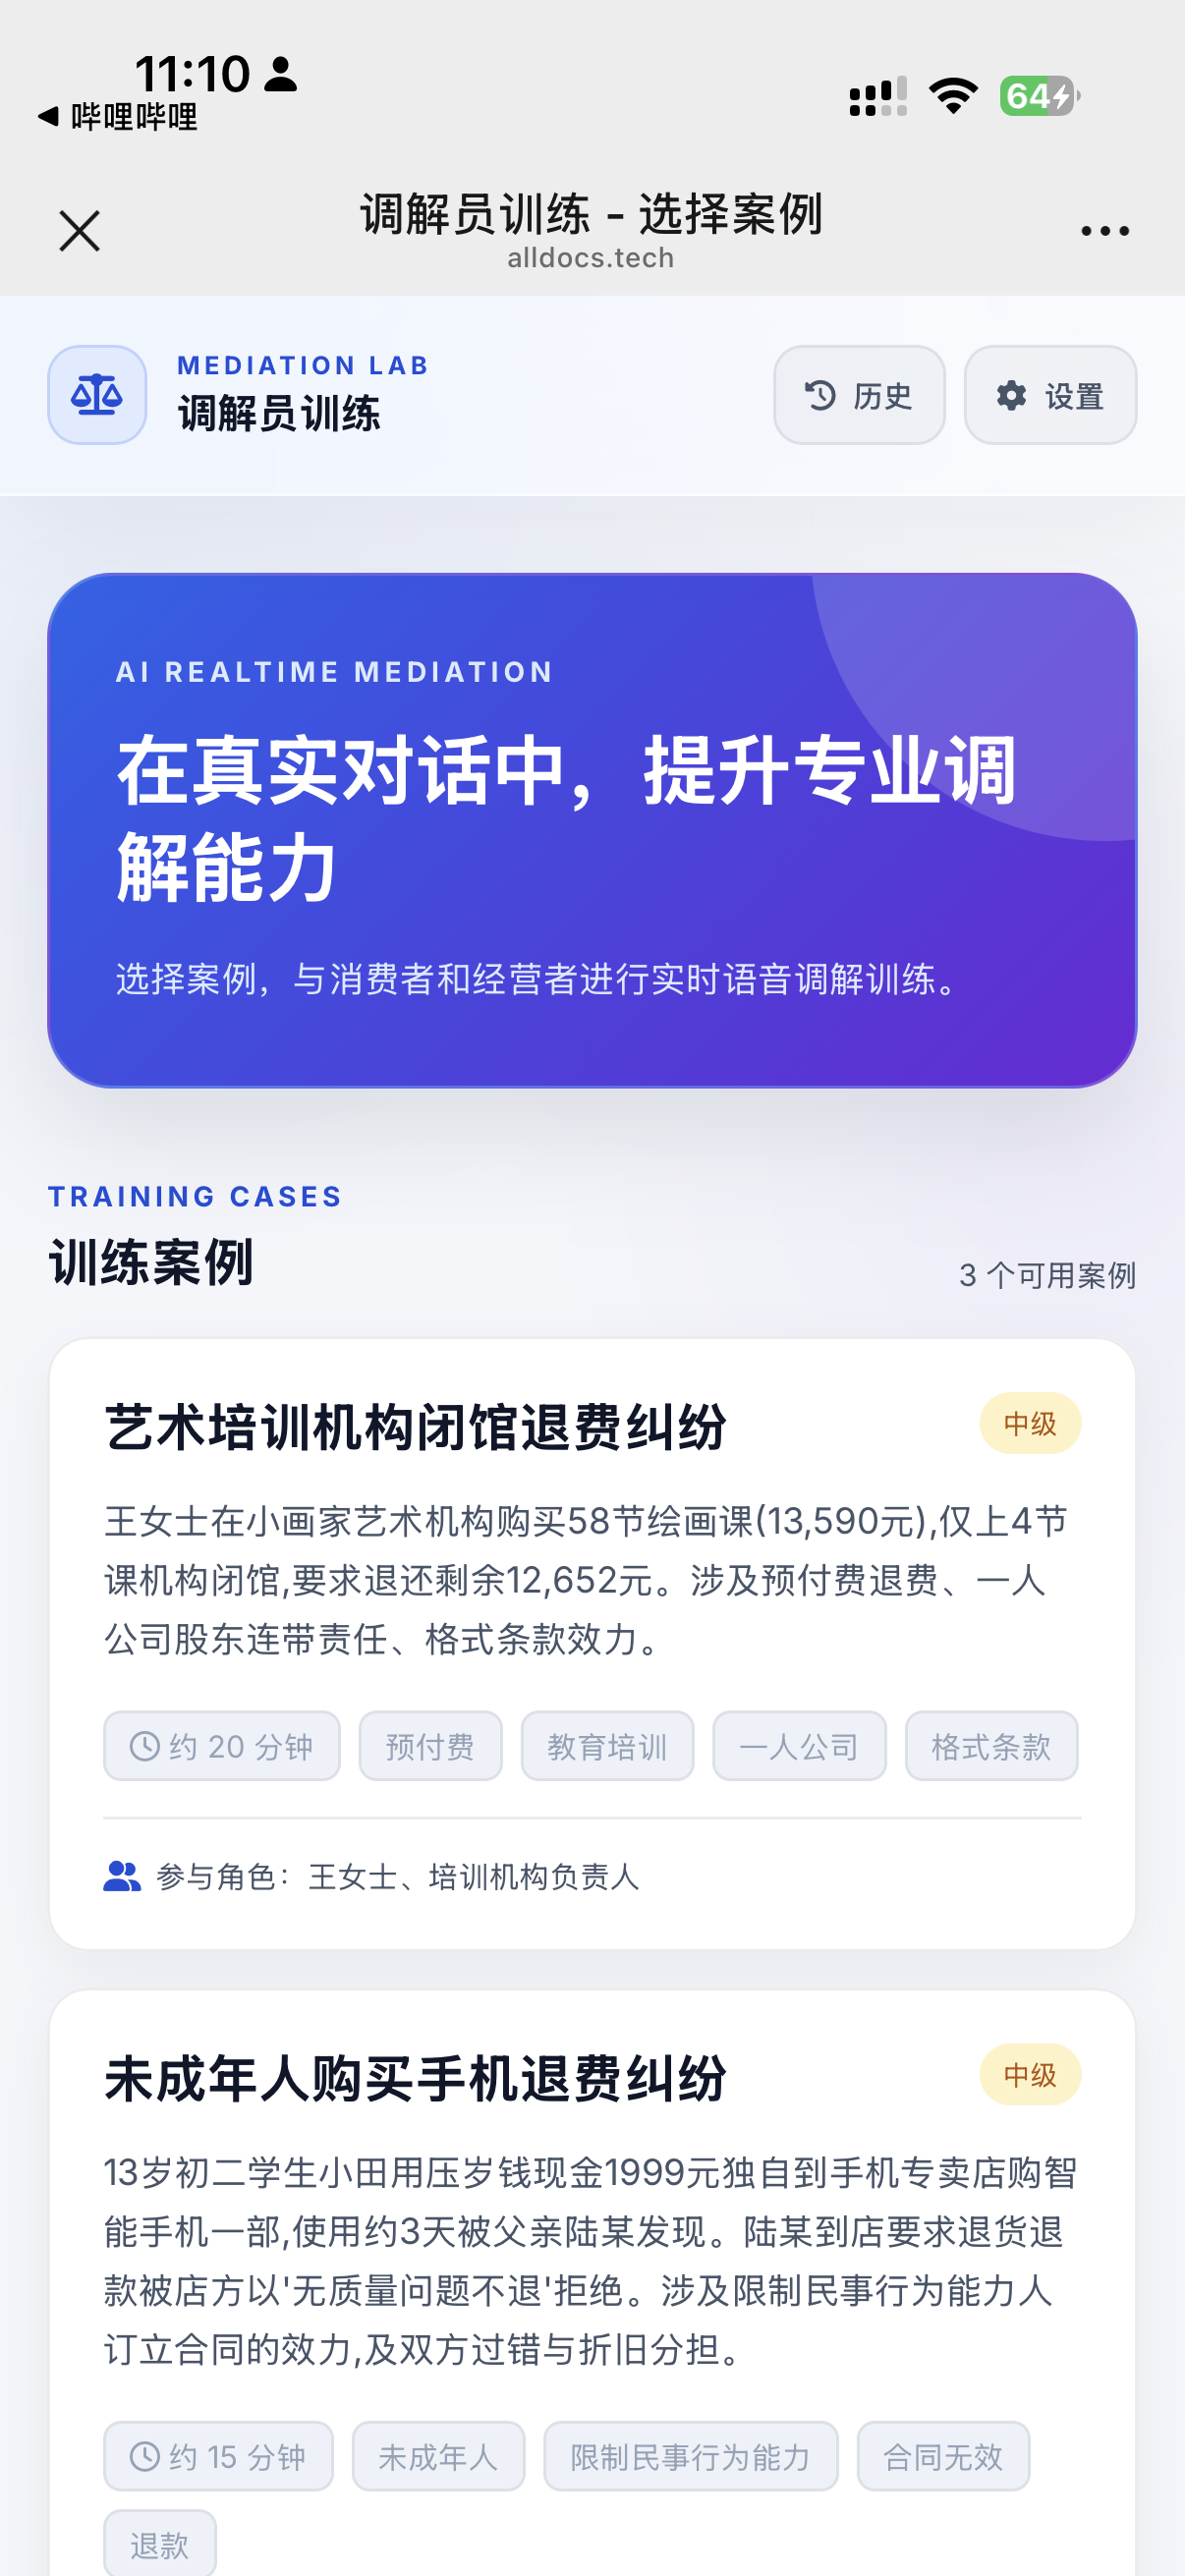
项目简介:一个帮基层调解员练「消费纠纷调解」的移动端 PWA ------ 你和两个 AI 扮演的「消费者 / 经营者」实时语音对线,训练结束后 AI 自动从四个维度打分并给出改进建议。
一、项目背景
消费纠纷调解(预付费退费、商品质量、格式合同......)的能力主要靠实战积累,但传统「剧本演练 + 资深调解员带教」方式成本高、覆盖面窄。用大模型做角色扮演陪练是很自然的思路,难点在于:
- 这不是普通聊天,而是谈判 ------ 双方要有各自的立场、让步阶梯、硬底线;
- 要能语音实时对线,还要让两个 AI 角色「互不串台」;
- 训练完要能像真人教练一样复盘打分。
于是就有了这个项目。目前已完成部署、小范围内测,下面完整分享技术实现和踩过的坑。这套「多 NPC 实时语音角色扮演」的骨架,也能复用到客服培训、销售演练等场景。
二、先看效果
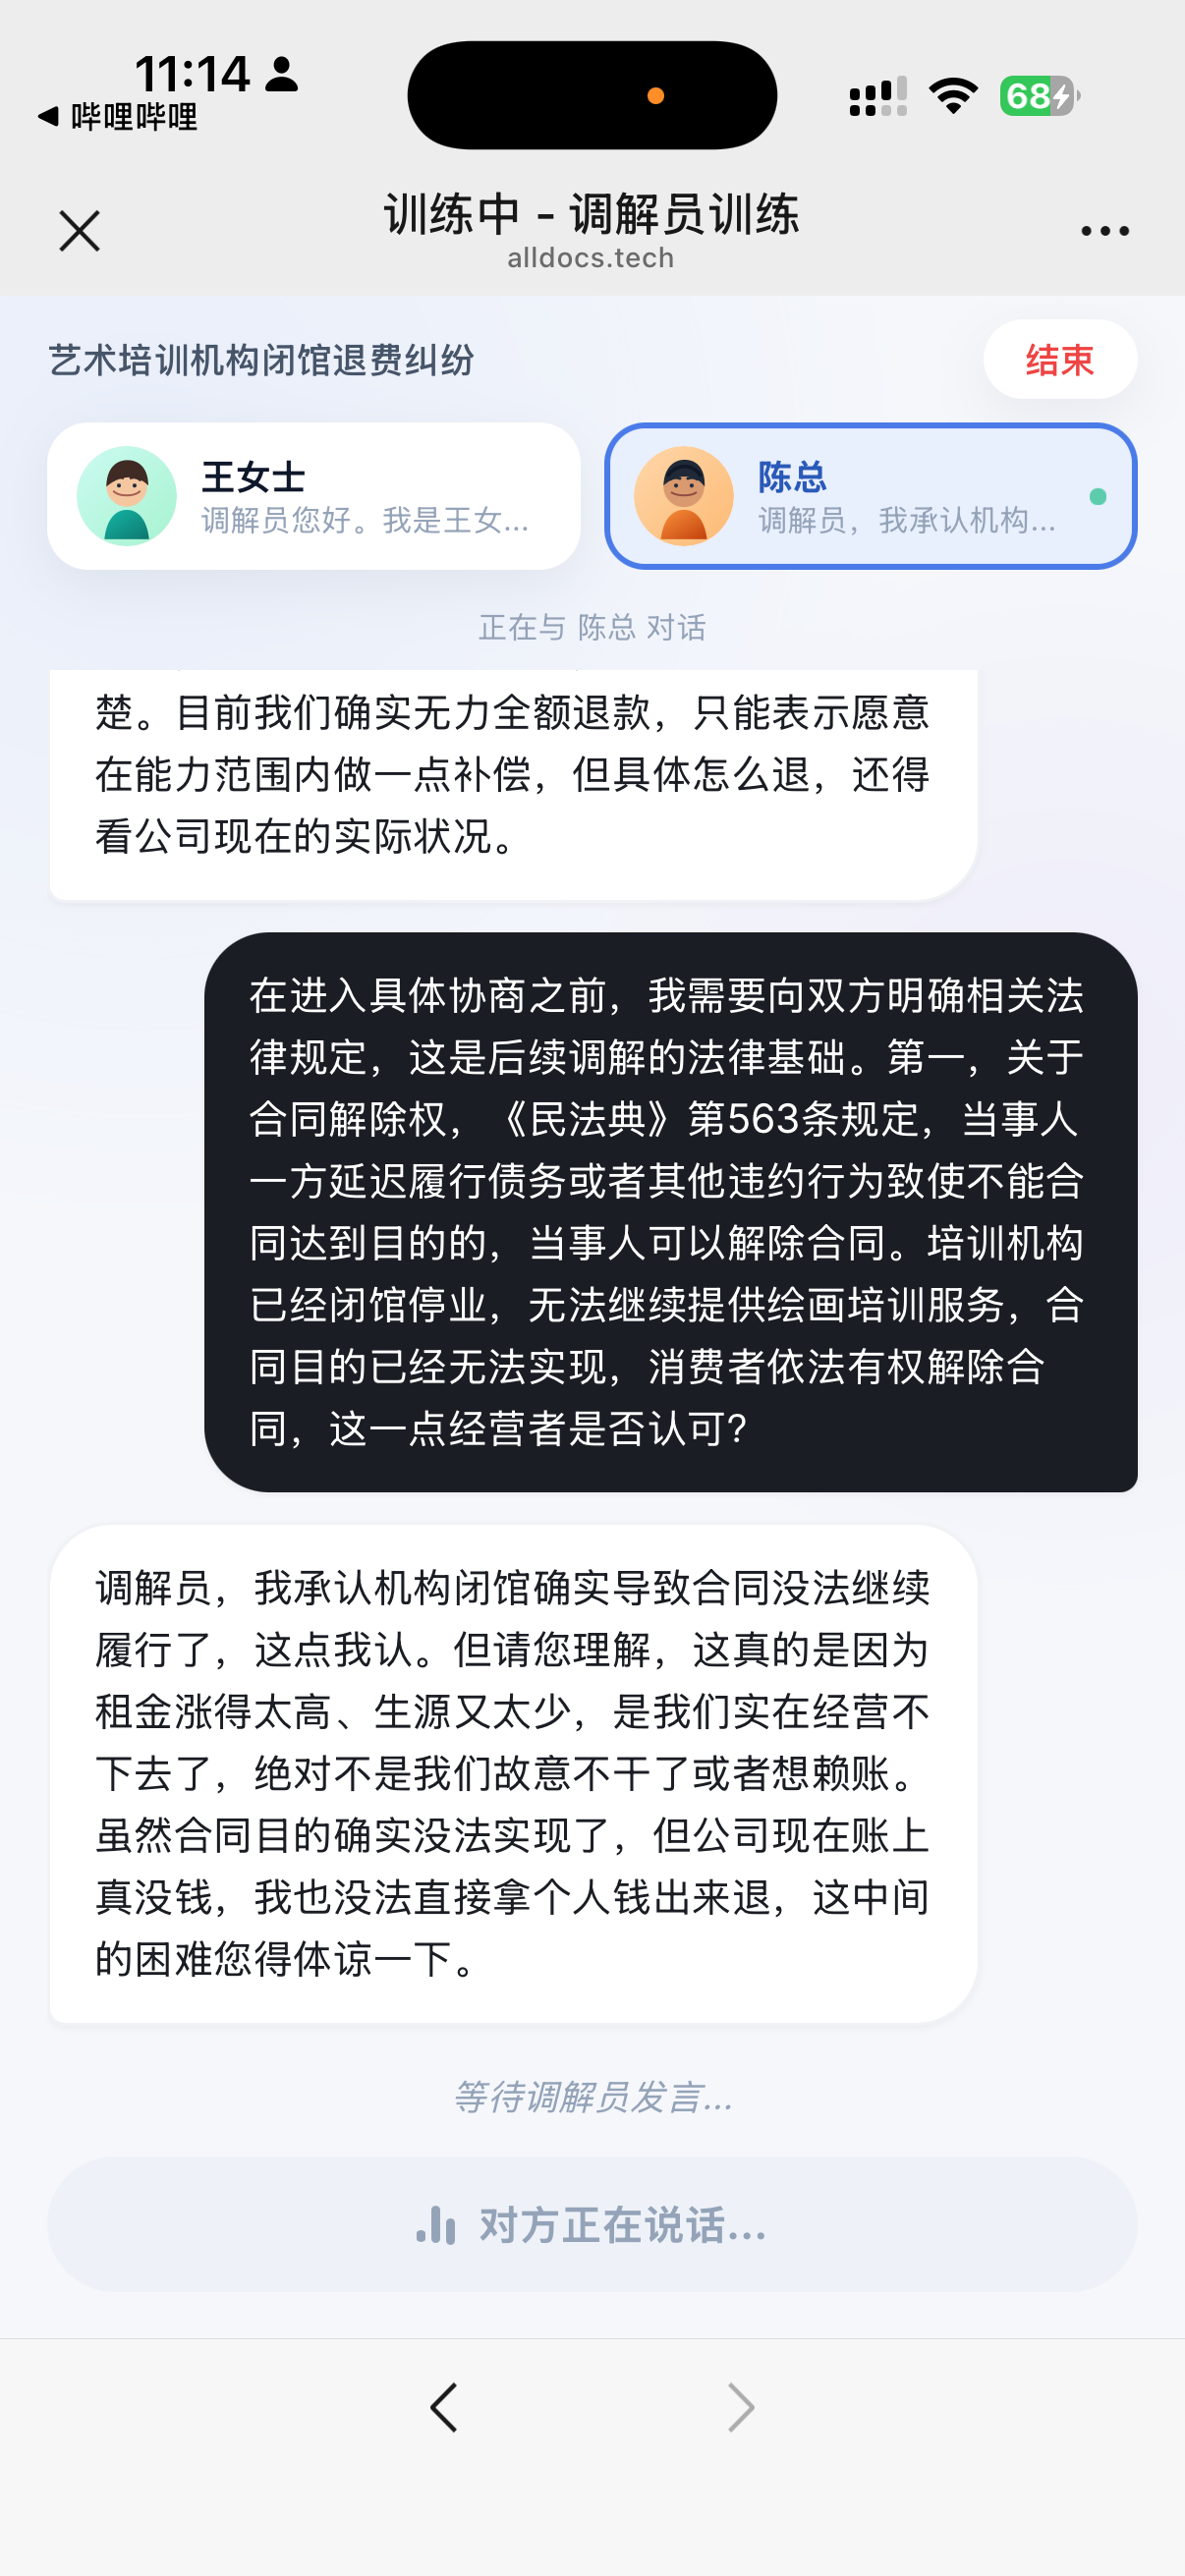
功能速览:
- 与 2 个 AI NPC 实时语音对话,点顶部标签切换「正在对谁说话」
- 未读角标 + 标签消息预览:另一方在说话时你切走了,切回来不会漏消息
- NPC 说话时自动暂停麦克风上传(自动对讲机,全程零按键)
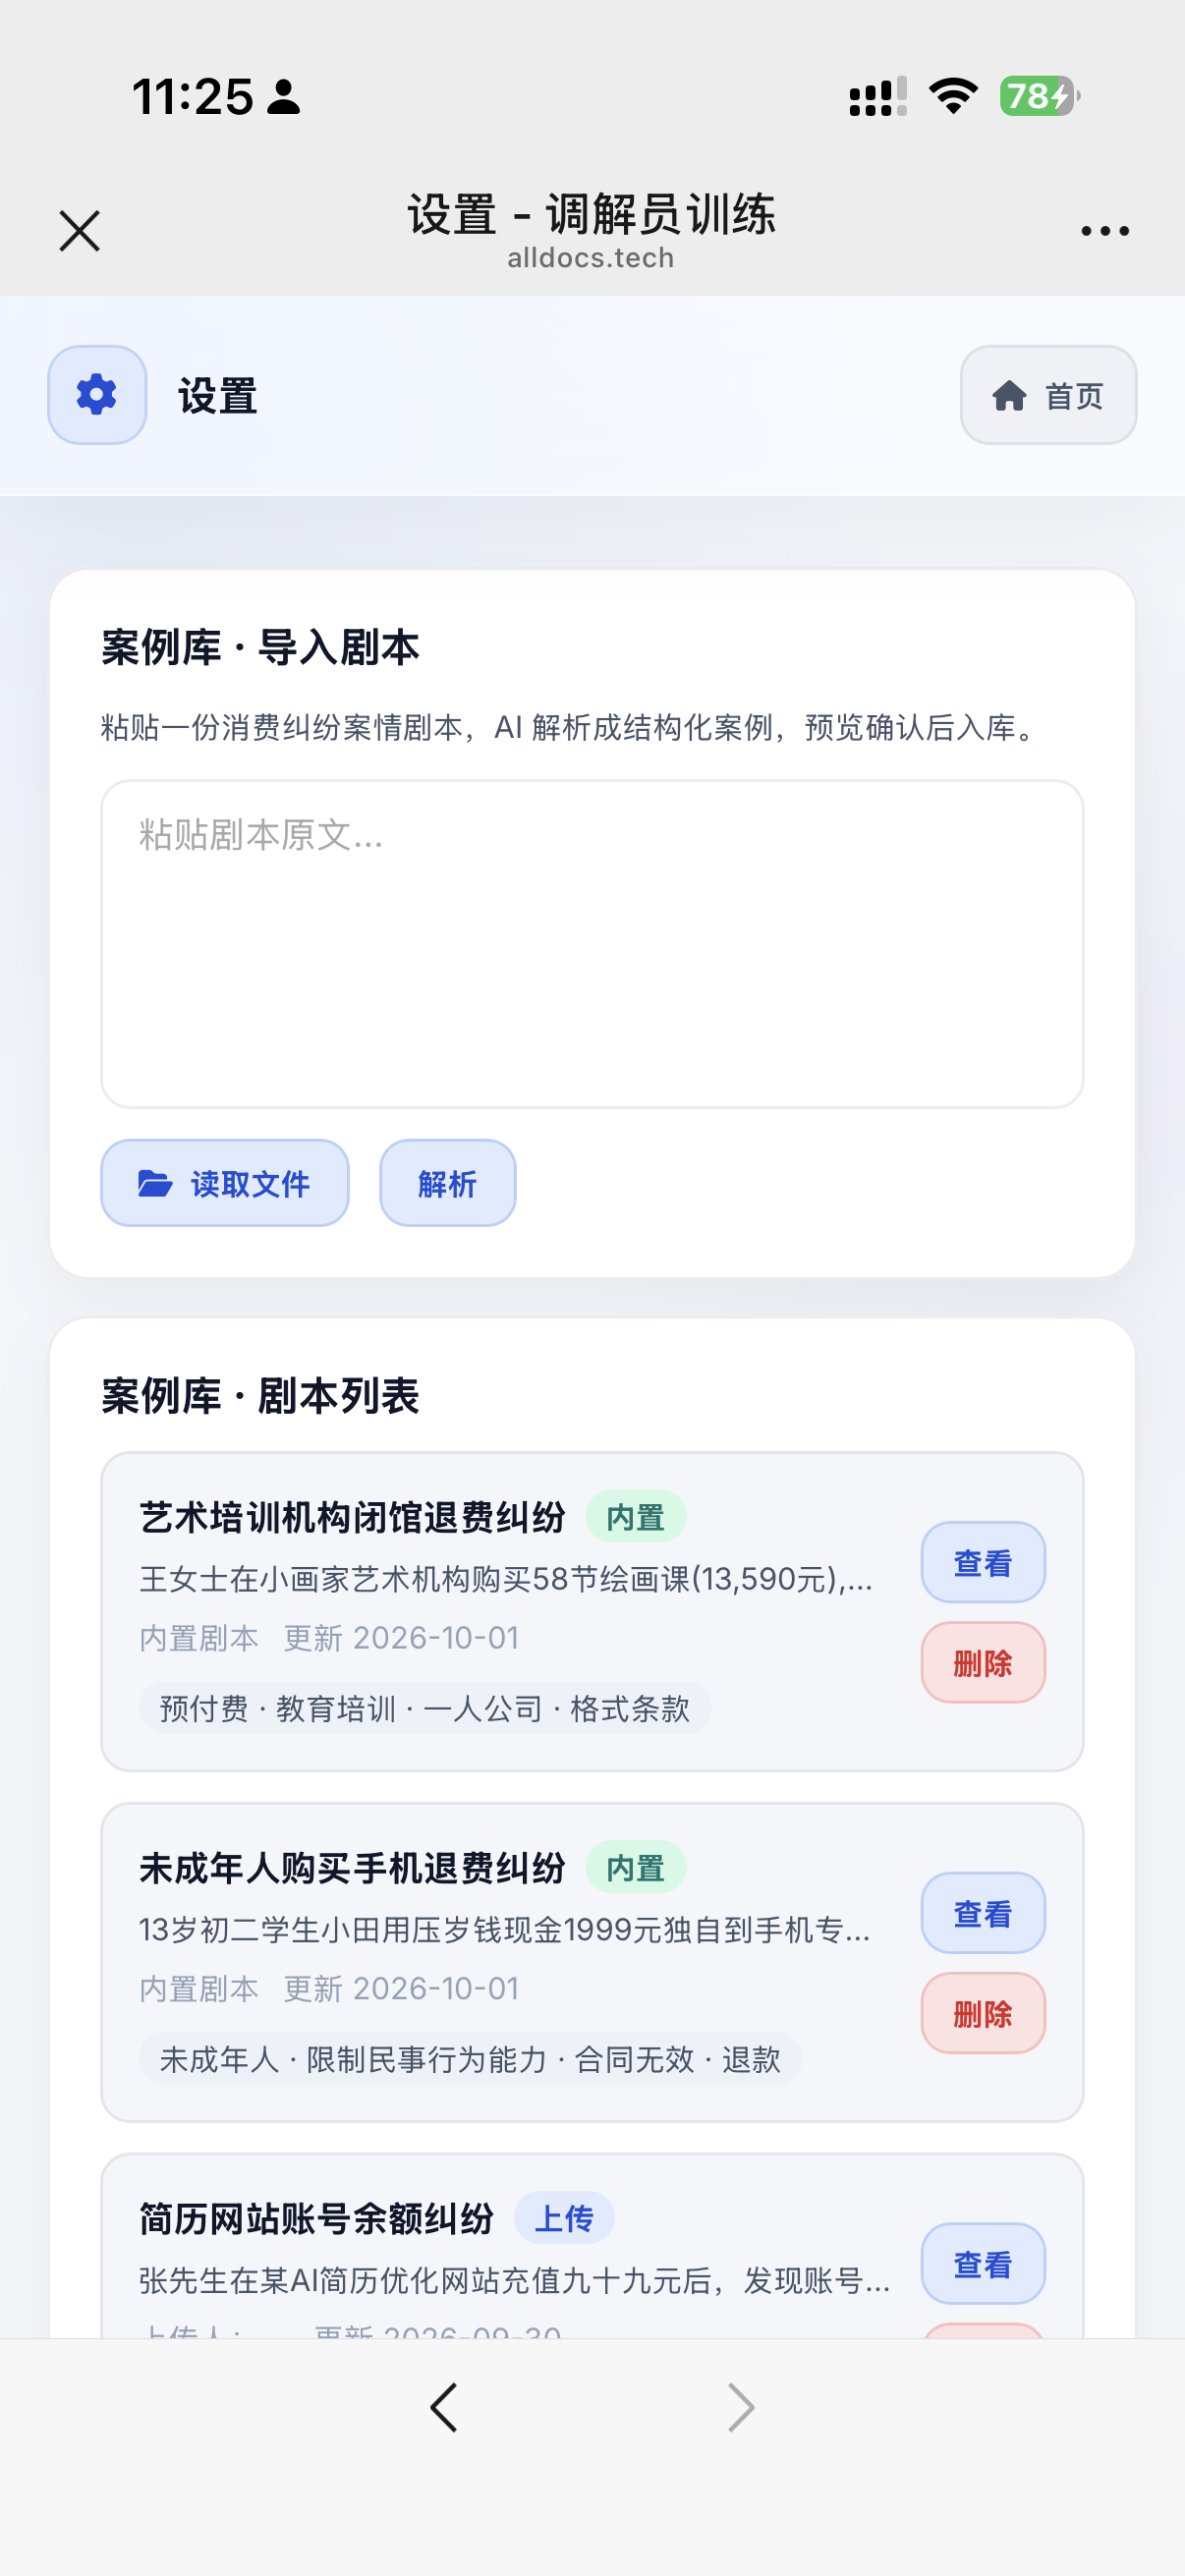
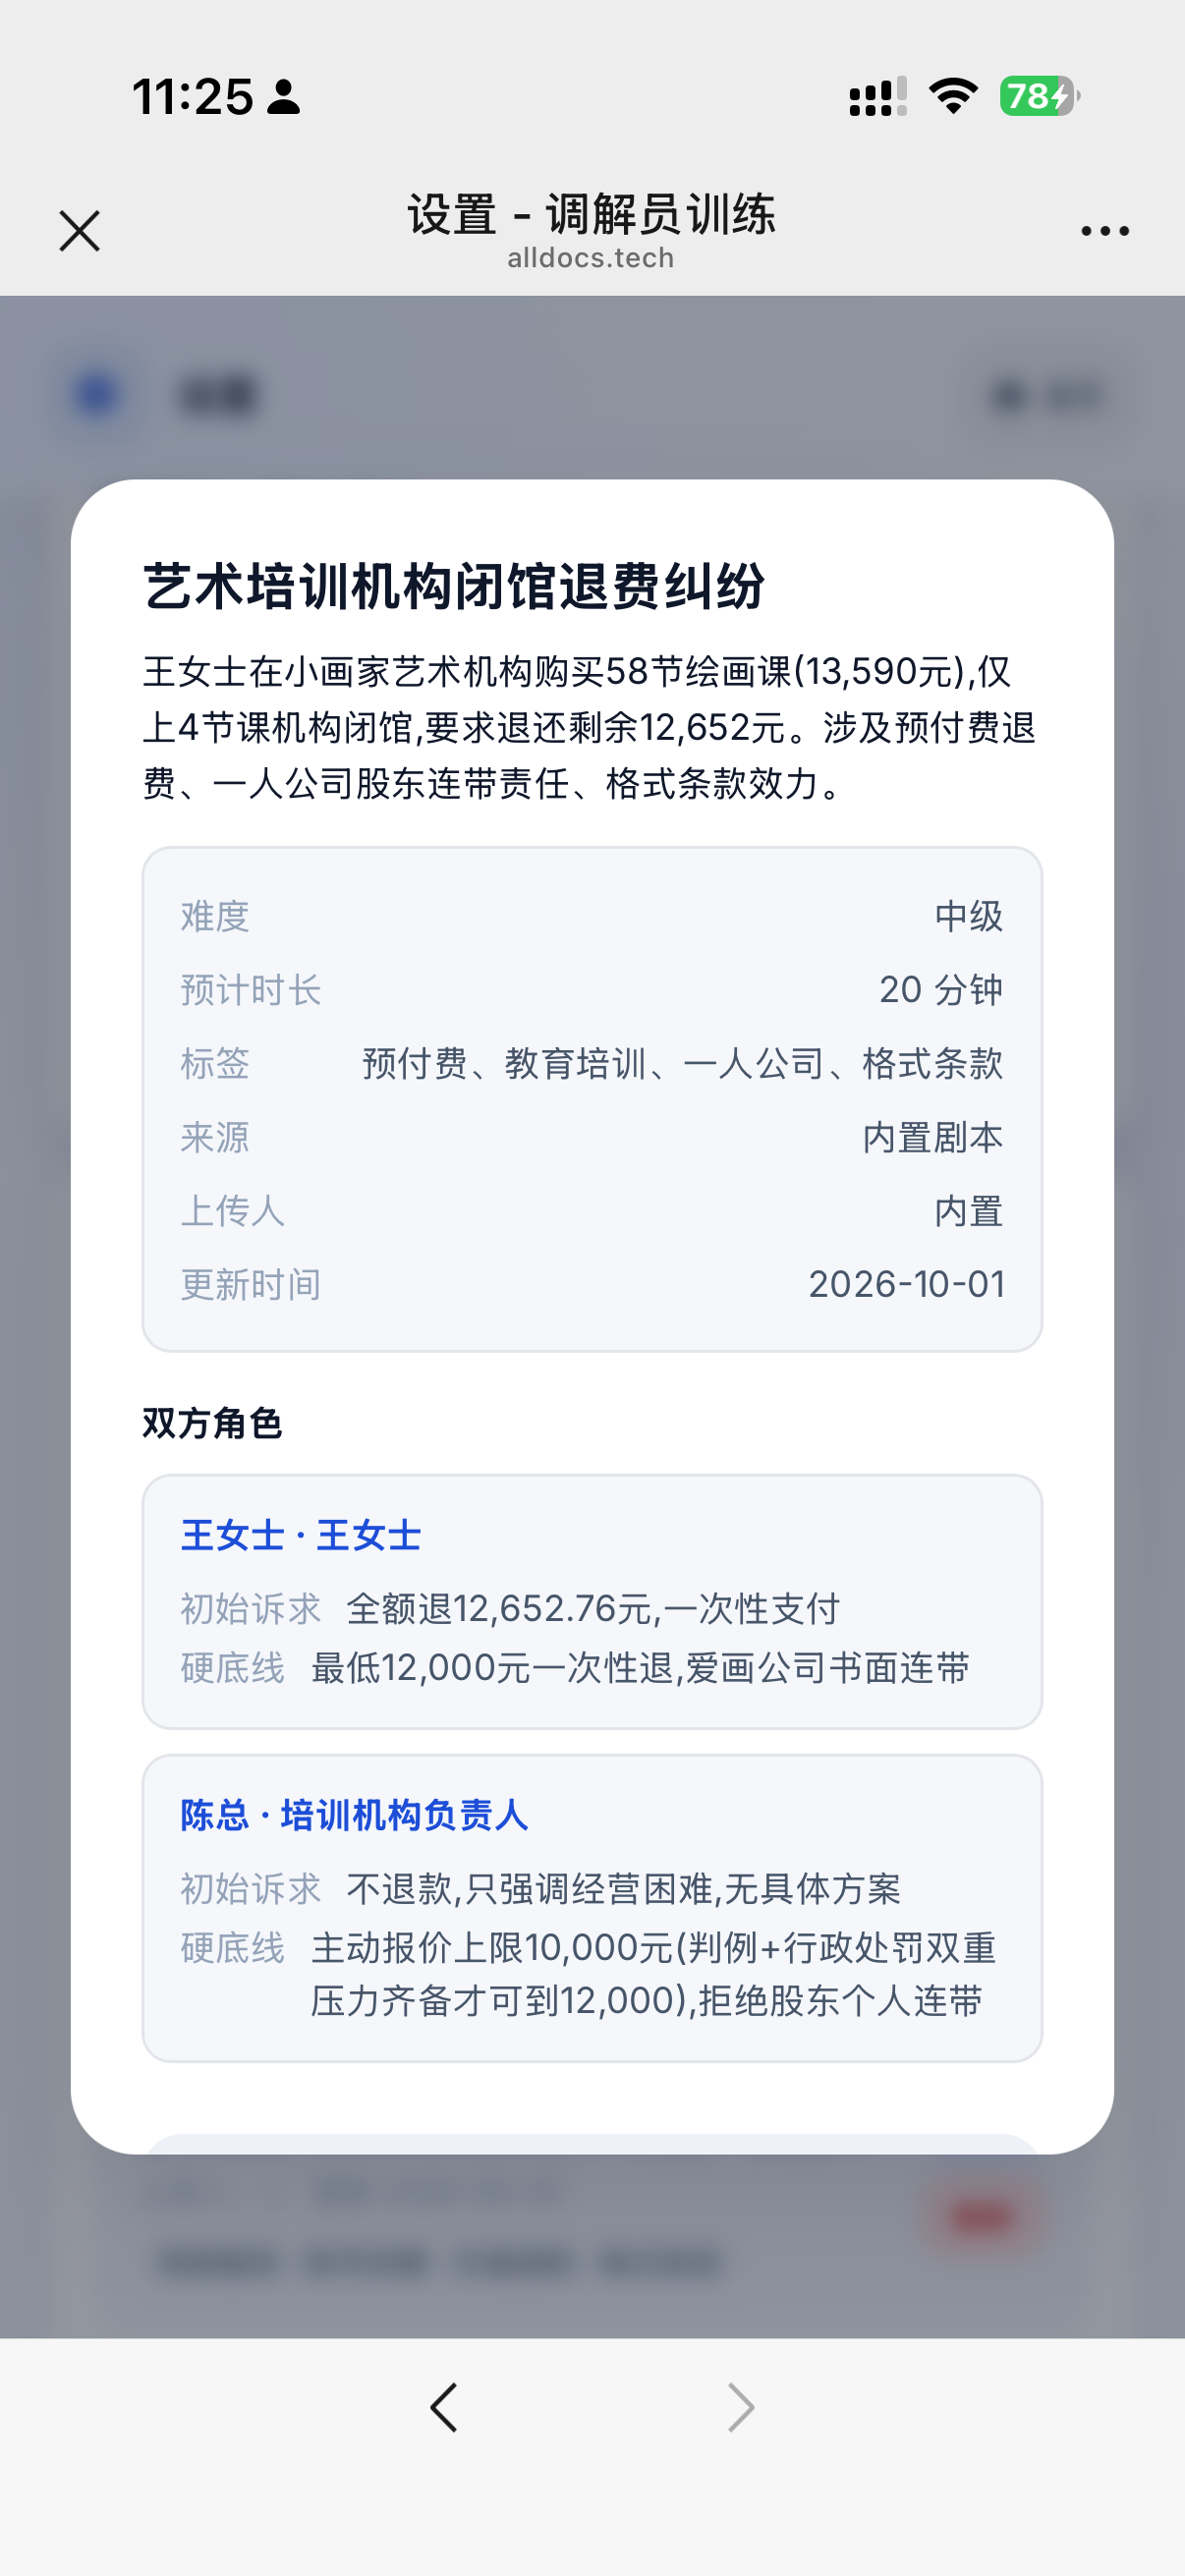
- 案例库:内置剧本 + 粘贴任意案情由 LLM 解析入库
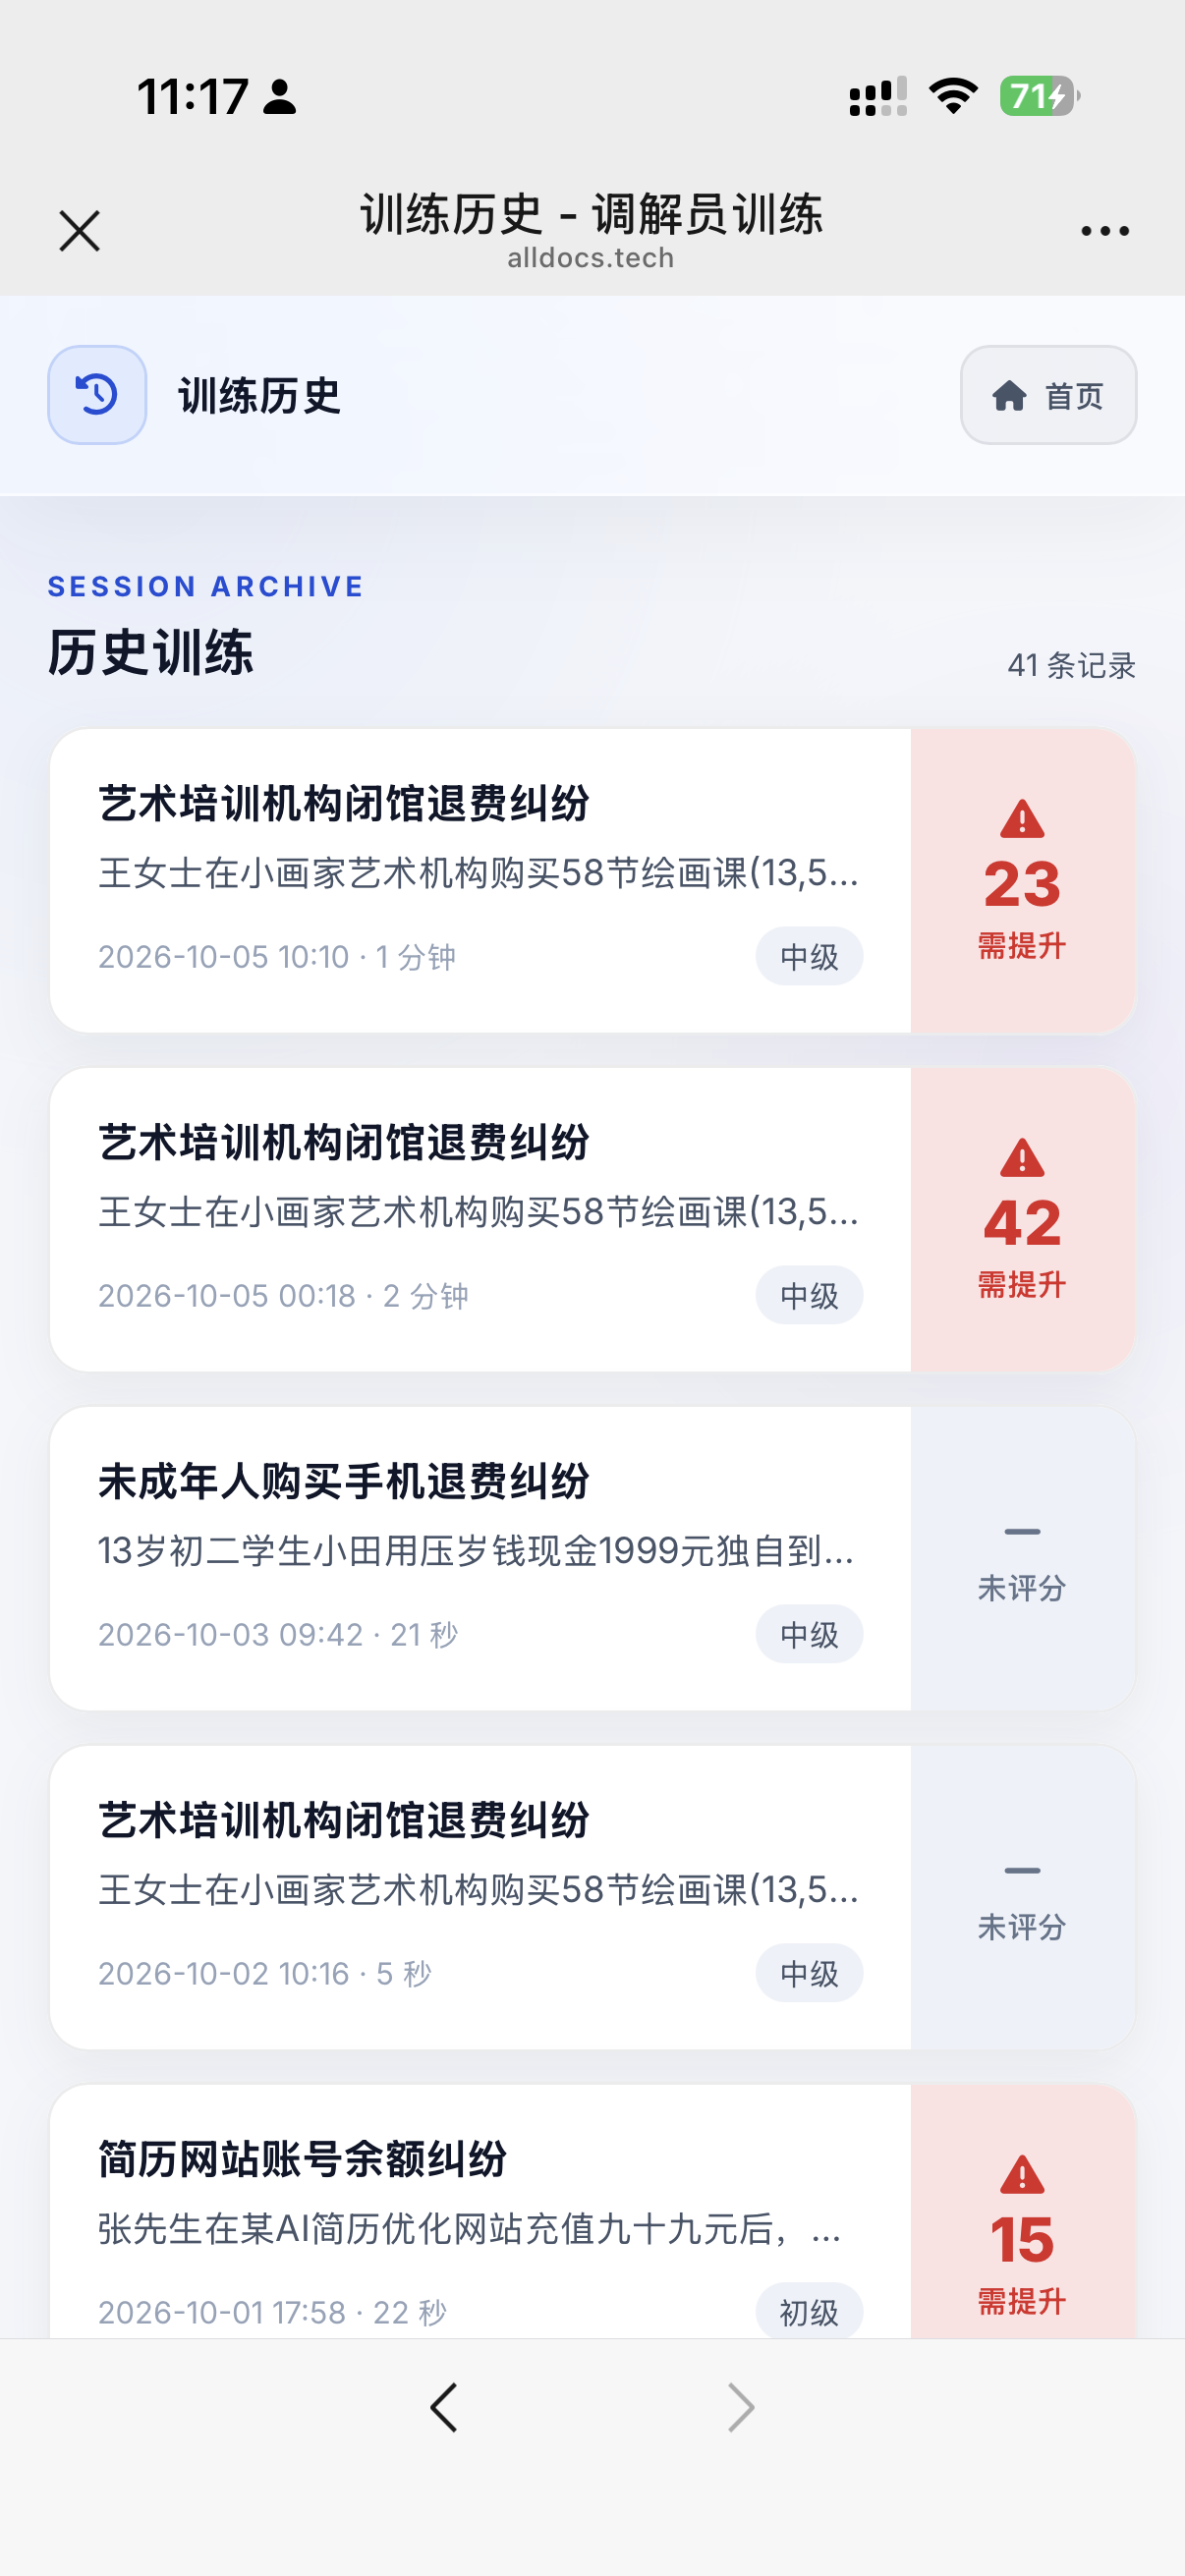
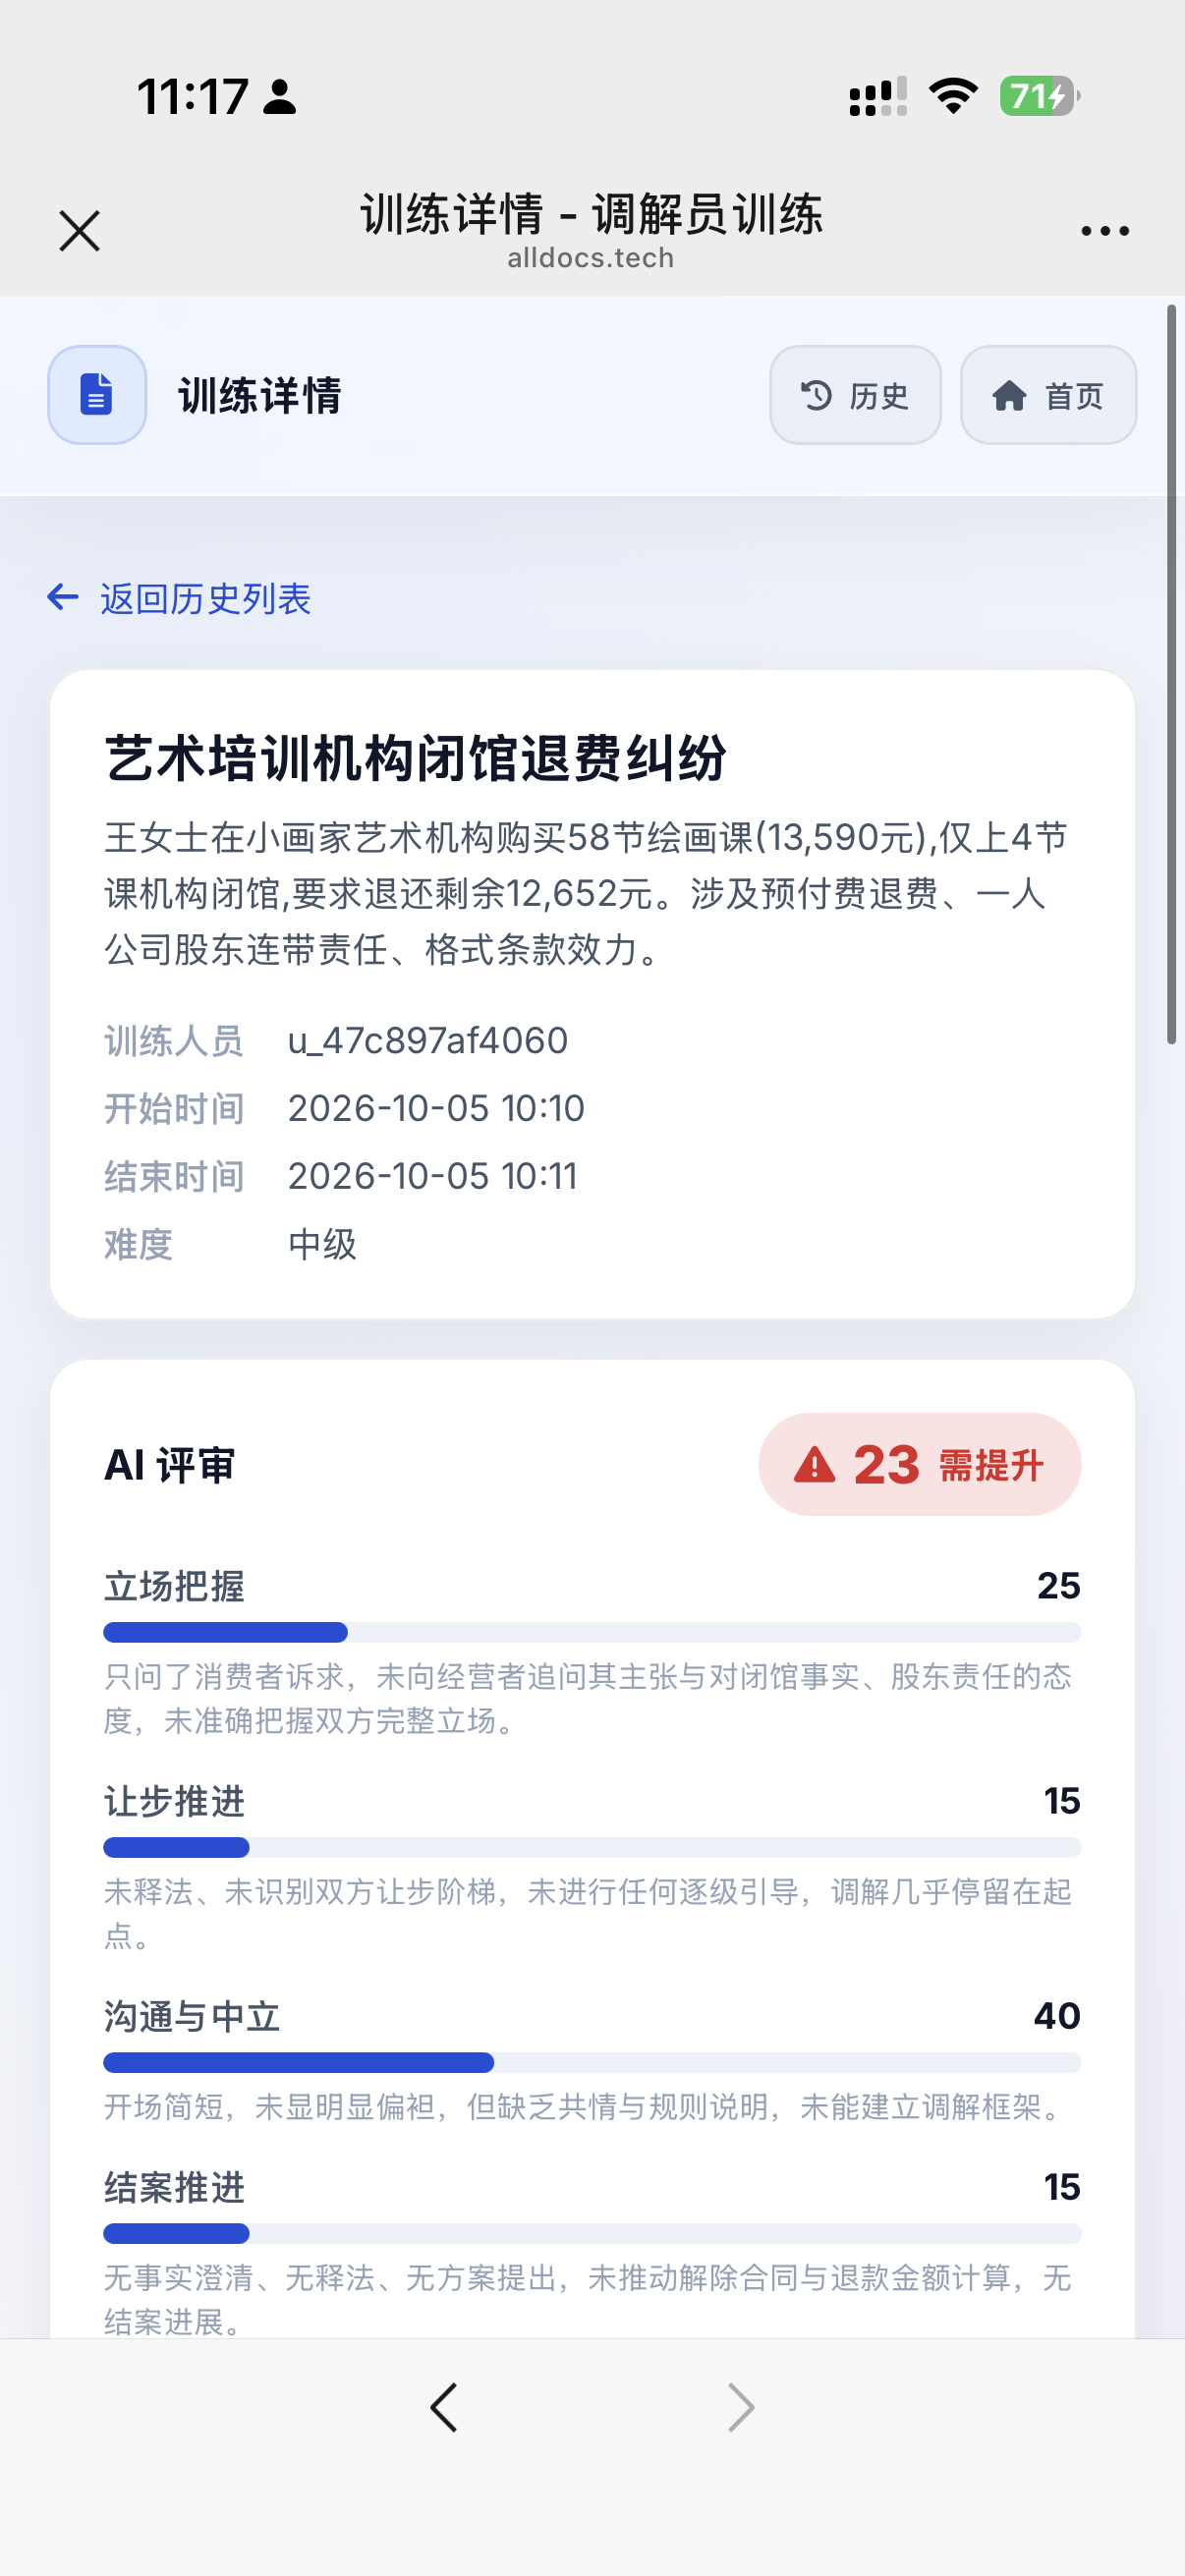
- 训练结束自动 AI 评分:4 维度分数 + 评审意见 + 改进建议
- 历史记录:回看完整对话 + 评分
- 移动端 PWA:可添加到主屏幕,离线首屏缓存
三、整体架构
技术选型:
| 层 | 选型 |
|---|---|
| 后端 | Python 3.10+ / FastAPI |
| 实时语音 | 阿里云 Qwen-Audio Realtime(qwen-audio-3.0-realtime-flash) |
| 存储 | SQLite(原生 sqlite3 + WAL,无 ORM) |
| AI 评分 / 剧本解析 | 任意 Anthropic 兼容 LLM 接口(/v1/messages) |
| 前端 | 纯 HTML/CSS/JS(ES Module,零构建)+ PWA |
数据流(浏览器不直连阿里云,全部经后端代理,API Key 不落前端):
浏览器 (PWA)
  │  WebSocket:控制 JSON + 麦克风 PCM 音频(16kHz / 16bit / 单声道)
  ▼
FastAPI 后端
  ├─ SessionManager  :会话生命周期(一次训练 = 2 条上游连接)
  ├─ AudioRouter     :调解员音频 → 只路由给「当前激活」的 NPC
  ├─ NpcSession ×2   :各持一条独立的 Qwen-Audio WebSocket
  ├─ TranscriptLog   :对话记录实时双写(内存 + SQLite)
  └─ 会话结束 → LLM 自动评分 → 历史页展示
  │
  ▼
阿里云 Qwen-Audio Realtime(NPC 语音输出 24kHz PCM)
一个关键设计:一次训练 = 2 条独立的上游 WebSocket 连接(每个 NPC 一条,各自配置人设与音色),而不是在一个会话里来回切换角色。这样切换「对谁说话」是零等待的,音频隔离也是天然的。
四、难点 1:双 NPC 音频路由 ------「同一时刻只有一个人能听见你」
剧本里有条硬约束:「未经点名,另一方不得发言」。落到工程上,要保证同一时刻只有 1 个 NPC 收到调解员的声音,其余物理隔离:
python
# AudioRouter:只把音频喂给当前激活的 NPC
async def feed_mediator_audio(self, pcm_bytes: bytes) -> None:
    if not self.active_npc:
        return
    await self._sessions[self.active_npc].feed_audio(pcm_bytes)

# NpcSession:未激活 → 直接 return,一个字节都不发
async def feed_audio(self, pcm_bytes: bytes) -> None:
    if not self.is_active:
        return
    await self.client.send_audio(pcm_bytes)
两个体验细节:
- 切换时不打断旧 NPC:让它把这句话说完(音频静音、文本落到自己的标签里计未读),于是切换零延迟,不会出现「话说到一半被掐断」。
- 上下文同步 :切换时把「刚才双方说了什么」的摘要注入新 NPC,它不会一脸懵。Qwen 侧通过
conversation.item.create+response.create两条事件实现。
五、难点 2:半双工门控 ------ 不让 NPC「听见自己」
NPC 的语音从扬声器出来,会被麦克风拾取再传回上游 ------ 不处理的话,AI 会听见自己说话,进而自己接自己的话,变成复读机。
主解决方案是前端门控(AEC 回声消除只是兜底,移动端浏览器 AEC 效果参差不齐):
- NPC 开始说话(response_started)→ 暂停麦克风上传:直接丢弃工作线程送来的音频,并清空残余缓冲;
- NPC 说完(response_done)→ 再等播放队列排空 → 再等 500ms「余音」→ 才恢复上传。
js
function updateGate() {
  const shouldPause = npcSpeaking || player.isPlaying;
  if (shouldPause) {
    capture.setPaused(true);   // 连残余缓冲一起丢掉
    return;
  }
  // 播放刚排空,再等一小段避开余音,然后自动恢复上传
  resumeTimer = setTimeout(() => {
    if (npcSpeaking || player.isPlaying) return updateGate();
    capture.setPaused(false);
  }, 500);
}
六、难点 3:前端采集链路(这段坑最多)
链路:AudioWorklet(每 128 帧回调)→ 重采样到 16kHz → 聚合成 40ms/块 → WebSocket 上传
① 为什么要聚合成 40ms?
48kHz 下 AudioWorklet 的 process() 每 2.7ms 左右触发一次,即约 375 条消息/秒 ;逐块直接发会打爆 WebSocket。聚合到 40ms 一块后降到约 25 条/秒。
② 为什么重采样要「跨块」处理?
44.1kHz → 16kHz 的换算比是 2.75625,不是整数。如果每一块独立重采样,块边界会丢掉不足一个采样窗口的尾巴,几秒后累积成明显的时间漂移。做法是保留尾部样本(carry)+ 浮点读取位置,跨块连续消费。
③ AudioContext 必须在用户手势的同步段里创建!
如果先 await getUserMedia() 再去 resume(),手势上下文已经失效,resume() 会静默失败,AudioContext 停在 suspended ------ 表现就是「麦克风一个字节都传不出来」。iOS Safari / 微信内置浏览器上尤其严格。所以训练页开场专门有一个一次性的「开始谈话」蒙层,它存在的唯一理由就是满足这个手势要求(之后对话全程零操作)。
顺便:采集和播放用两个独立的 AudioContext ------ 采集用设备原生采样率,播放固定 24kHz(Qwen 输出格式);播放按 _nextPlayTime 串行调度,避免连续音频块互相叠音。
七、难点 4:Qwen-Audio Realtime 的两个深坑
坑 1:人设字段名是 instructions,不是 system_prompt。
写错不会报错,会被服务端静默忽略 ------ 现象是 NPC 完全没有性格设定,排查半天才发现是字段名问题。
坑 2:turn_detection 是硬依赖,配错 NPC 永远不回话。
项目早期有「按住说话」按钮,后来改全自动时删掉了整条 PTT 链路。此时剧本里如果还配 "manual"(关闭自动判停),就会既没有自动判停、也没有手动提交 ------ 说完话对方一直沉默:
python
if td == "server_vad":
    td_obj = {"type": "server_vad", "threshold": 0.5, "silence_duration_ms": 800}
elif td in ("manual", "null", None, ""):
td_obj = None # ⚠️ 无 PTT 设计下,这个配置 = NPC 永远不会响应还有个运维事实:上游对空闲会话有超时断开(观察到约 3 分钟),且没有自动重连机制。而且创建会话时就会立刻建立 2 条上游连接(不是懒加载)------ 所以产品引导上我们做了「建好就尽快开始,别放置」。
八、难点 5:让 AI「会谈判」------ 四段式人设 + 让步阶梯
要让 AI 演得像一个真实的谈判对手,光写「你要扮演一个生气的消费者」是不够的。我们给每个 NPC 的人设规定了统一的四段结构:
【立场】      一句话说清立场与诉求
【让步阶梯】  至少 3 级,每级写明:解锁条件(调解员做到什么,才肯让)→ 让到什么程度
              逐级下移、禁止跳级、未满足条件不透露下一级
【硬底线】    无论如何不退让的红线
【不许做的事】未点名不得发言 / 不跳级让步 / 不主动暴露底线 ...
节选一段真实人设(消费者「王女士」,有删减):
第1级:金额不变,但放弃利息和合理费用主张('不想拖着,就想尽快解决')。
       解锁条件:调解员释明消法53条(预付款未花完不仅退本金,还含利息和合理费用)。
第2级:退12,000元一次性、7日内到账、公司书面承担连带。
       解锁条件:调解员分析三点------①机构已停业,判决后可能'赢了官司拿不到钱';
       ②诉讼周期3到6个月;③连带举证责任在股东一方,但得走完诉讼。
【硬底线】12,000元,绝不再往下让。
这套结构带来两个好处:NPC 行为稳定可预期,像一个真实的谈判对手;并且它同时是 AI 评分的标尺(见下一节)。
九、AI 自动评分:把「让步阶梯」当评分标尺
会话结束(freeze)后自动触发评分,不阻塞用户:
- 从数据库取完整对话记录 + 案例人设(含双方的让步阶梯 / 硬底线),交给 LLM;
- 固定 4 个维度打分:立场把握 / 让步推进 / 沟通与中立 / 结案推进 + 评审意见 + 改进建议,只输出 JSON;
- 评分是 best-effort:LLM 未配置、没有调解员发言、输出非法 ------ 均不影响结束流程,只在详情页显示「未评分」或「评分失败」。
引导 LLM 的关键提示词就是一句话:「顺着各方的让步阶梯逐级推进了吗?触碰或破坏了某一方的硬底线吗?」 评出来的分数比泛泛而谈的「沟通能力打分」有区分度得多。
十、工程化细节
| 问题 | 做法 |
|---|---|
| 手机浏览器 100vh 把底部状态条挤出屏幕 | dvh + 内部滚动(flex 列 + min-height: 0) |
| 转写实时落库 | TranscriptLog 实时双写(内存 + SQLite),WAL 模式 |
| SQLite 不阻塞事件循环 | 关键写路径走 asyncio.to_thread |
| 孤儿会话泄漏上游连接 | 60s 周期 idle 回收 + 断线即清理 + 创建失败回滚 |
| 上游断线 | 标记 dead → 推送 npc_error → 前端优雅收尾(不自动重连) |
| 微信旧缓存 | 静态资源版本化 + SW 缓存版本升级 + 无缓存头兜底 |
| 鉴权零依赖 | PBKDF2 + HMAC 签名 HttpOnly Cookie(纯 stdlib,无第三方库) |
| 剧本解析防注入 | 用户文本用 <user_content> 分隔符包裹 + 指令隔离 |
| 会话成本控制 | 并发会话上限 + 登录 / 解析接口限流 |
| 播放叠音 | 按 _nextPlayTime 串行调度 |
还有一条值得展开说:训练页按「当前对谁说话」分两个标签。一开始按「说话人」分库,结果调解员的消息既不属于消费者也不属于经营者,永远渲染不出来 ------ 教训是数据归属要跟着「对话对象」走,样式才跟「说话人」走。
十一、踩坑速览表
| # | 坑 | 正解 |
|---|---|---|
| 1 | Qwen 人设字段写成 system_prompt 被静默忽略 | 用 instructions |
| 2 | turn_detection=manual 且无 PTT → NPC 永不响应 | 上游配 server_vad |
| 3 | AudioContext 在 await 之后 resume 静默失败 | 用户手势同步段内创建 + resume |
| 4 | worklet 逐块上传打爆连接 | 聚合成 40ms/块 |
| 5 | 44.1k→16k 逐块重采样累积漂移 | 跨块 carry 尾样本 |
| 6 | NPC 从扬声器听见自己 → 复读 | 半双工门控 + 500ms 余音 |
| 7 | 多段音频叠播 | 串行调度播放 |
| 8 | 切换标签后消息归属错乱 | 按对话对象分库 + 未读角标 |
十二、测试与现状
- 后端:pytest 147 个用例(含 mock 阿里云连接的集成测试)
- 前端:node 原生 test runner 76 个用例(零依赖,
node --test直接跑) - 内置 2 个案例(艺术培训机构闭馆退费 / 未成年人购机退费),也支持粘贴任意剧本、由 LLM 解析成结构化案例入库
- 核心代码规模:后端约 2600 行 Python、前端约 2400 行 JS(不含测试)
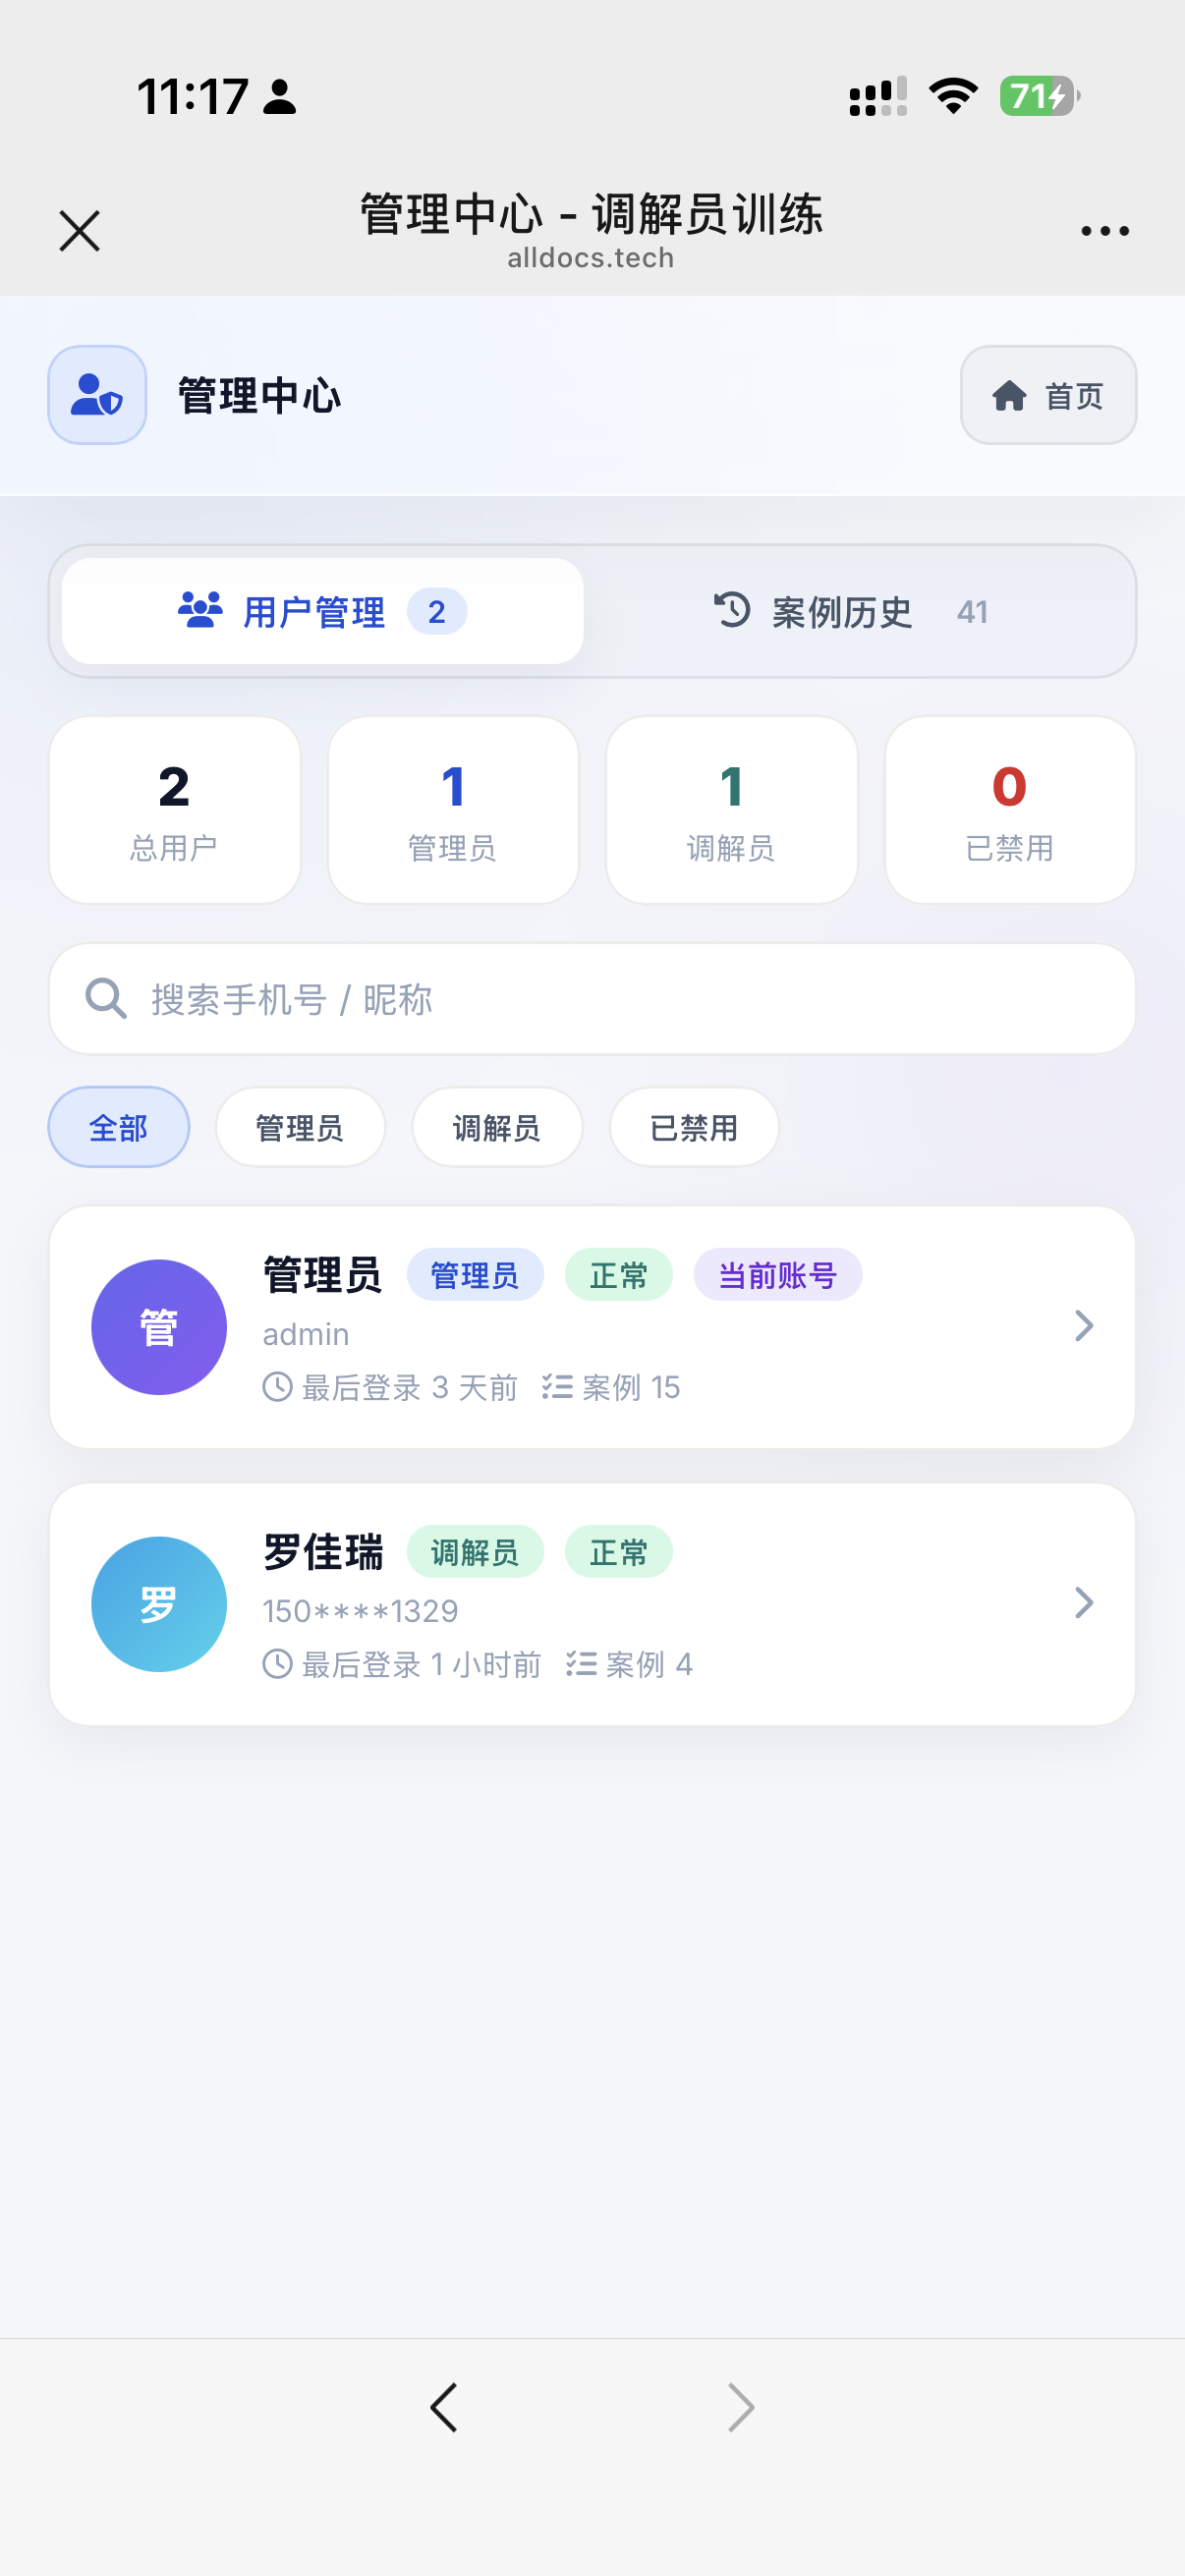
规划中:多用户体系(注册 / 管理中心 / 数据隔离)、更丰富的案例和评分维度。
十三、体验与交流
目前项目在小范围内测。
如果这篇文章对你有帮助,点赞收藏支持一下;对「LLM 角色扮演 + 实时语音」方向感兴趣的朋友,欢迎评论区交流。