文章目录
摘要
项目地址:https://github.com/haeggee/bacadi
从实验数据中推断因果结构是众多领域的核心任务。然而,干预的作用靶点 往往存在不确定性甚至完全未知,同时观测样本数量有限。这就导致传统的因果挖掘方法不再可靠。
为解决该问题,本文提出一套贝叶斯框架 BaCaDI,用于挖掘并解读多类未知实验 / 干预条件下生成数据背后的因果结构。BaCaDI 具备完全可微 的特性,能够借助高效的基于梯度的变分推断 ,同时对干预靶点与因果结构求解复杂的联合后验分布。
传统因果发现:因果图是离散组合对象 。一张图就是一堆 0/1 的邻接矩阵。把离散的 0‑1 邻接矩阵,松弛成0~1 之间的连续概率值 ,再增加约束保证最终得到有向无环图(DAG)。整个模型从输入数据 → 因果图概率 → 干预靶点概率 → 损失函数,整条计算链路全部可以求导 。把原本离散、不能求导的因果挖掘问题,变成一个光滑连续的优化函数,可以用梯度下降来训练。
- 不用暴力枚举海量因果图;
- 适配深度学习 / 贝叶斯优化框架;
- 可以同时优化因果结构 + 干预靶点两套变量。
真实想要的是后验分布: p ( G , I ∣ D ) p(\boldsymbol{G},\mathcal{I}\mid \mathcal{D}) p(G,I∣D) ,也就是 给定观测数据,因果图 G \boldsymbol{G} G是什么、干预靶点 I \mathcal{I} I是哪些 的概率分布。变分法的思路:拿一个简单好算的近似分布 q ( G , I ) q(\boldsymbol{G},\mathcal{I}) q(G,I)去逼近真实后验 ;最小化 KL 散度这个损失函数,如果整个模型可微,我们就可以用梯度下降不断更新近似分布q的参数,不需要慢速的 MCMC 采样。
- 普通贝叶斯方法:MCMC 采样,速度慢,变量一多直接跑不动;
- 梯度变分推断:神经网络式迭代优化,支持高维变量、大数据集。
我们同时有两套未知量: G \boldsymbol{G} G:底层真实不变的因果网络图, I = { I 1 , I 2 . . . I M } \mathcal{I}=\{I_1,I_2...I_M\} I={I1,I2...IM}:每一组实验到底干预了哪些基因 / 变量(本文设定干预靶点本身是未知的 )联合后验 p ( G , I ∣ D ) p(\boldsymbol{G},\mathcal{I}\mid \mathcal{D}) p(G,I∣D) :不是单独猜一个因果图,也不是单独猜干预靶点;它输出一整套概率分布:在观测到多批干预实验数据之后,「因果图是某一种结构 + 这批实验敲除的是某几个变量」这件事共同发生的概率。
- 传统方法:我先假定干预了基因 A,再去学因果图;
- BaCaDI:只给你多批次测量数据,算法同时回答两件事:①基因之间真实调控关系是什么;②每一次药物处理到底改变了哪些基因,并且给出每一个猜测的可信程度。
在合成因果挖掘任务与仿真基因表达数据的多组实验中,BaCaDI 在识别因果结构与干预靶点上的表现均优于同类方法。
合成因果挖掘任务(synthetic causal discovery tasks):人工构造一套已知标准答案的因果 DAG 图;根据人为指定的干预规则,模拟生成多组干预数据集;真实因果图、真实干预靶点全部已知;作用:干净的仿真测试集,可以精确计算误差,定量对比不同算法能不能找回真实结构。
仿真基因表达数据(simulated gene‑expression data):更贴近真实生物学的模拟器,生成单细胞转录组数据:使用符合真实基因调控规律的生成模型; 模拟基因敲除、药物扰动之后的表达量变化;数据会增加噪声、非线性效应、模型失配(真实生物系统并不严格符合我们假设的简单数学模型); 目的:测试算法在模型设定不准、噪声大、更贴近真实生物场景时鲁棒性怎么样。
引言
BaCaDI 提供了一套严谨的贝叶斯范式,对全部隐变量传递认知不确定性;如果把不确定性量化与干预识别拆分成独立、串行的步骤,这些隐变量本身是无法求解的。除此之外,BaCaDI 可以在连续空间内,对因果贝叶斯网络(CBN)与干预操作对应的隐概率表示完成运算。这套形式化方案允许我们使用高效、基于梯度的粒子变分推断技术去逼近复杂的联合后验分布,因此本方法可以拓展到变量规模更大的因果系统上。
隐变量就是观测数据里直接看不到、必须通过推断反推出来的未知量:
- 离散隐结构
- G ∈ { 0 , 1 } d × d \boldsymbol{G}\in\{0,1\}^{d\times d} G∈{0,1}d×d:因果图邻接矩阵(0/1 离散值,代表两个变量之间有没有因果边)
- I t a r = { I 1 t a r , . . . , I M t a r } \mathcal{I}^{\mathrm{tar}}=\{\boldsymbol{I}_1^{\mathrm{tar}},...,\boldsymbol{I}_M^{\mathrm{tar}}\} Itar={I1tar,...,IMtar}:干预靶点掩码(0/1 离散值,标记每一组实验中哪个变量被人为干预)
- 连续松弛隐变量(可微代理)
- Z \boldsymbol Z Z:生成因果图 G \boldsymbol G G的嵌入矩阵;用连续实数替代离散的 0‑1 邻接矩阵
- Γ \boldsymbol \Gamma Γ:生成干预掩码 I t a r \mathcal I^{\mathrm{tar}} Itar的实值隐矩阵;用连续实数表达干预发生的概率
- 机制参数
- Θ \boldsymbol \Theta Θ:观测状态下因果方程的参数
- Θ I \boldsymbol \Theta_\mathcal I ΘI:干预发生后,被干预变量新的数据生成参数
G 、 I t a r \boldsymbol G、\mathcal I^{\mathrm{tar}} G、Itar是真实离散因果结构 ; Z 、 Γ \boldsymbol Z、\boldsymbol \Gamma Z、Γ是为了求导、优化引入的连续代理隐变量 ; Θ , Θ I \boldsymbol \Theta,\boldsymbol \Theta_\mathcal I Θ,ΘI是因果机制的未知参数。全部这一堆,都是模型的隐变量,无法直接从数据集读出。
认知不确定性含义 不是数据噪声带来的随机波动;而是数据量有限,我们无法百分百确定真实因果图 / 真实干预靶点到底是哪一个 。现有数据同时支持两种完全不同的因果结构图 G 1 、 G 2 G_1、G_2 G1、G2,两套图都可以拟合观测,此时模型对因果结构就存在认知不确定性。传递 = 不做硬决策,全程用概率分布表达所有可能性
传统串行方法会先固定一个确定的干预集合,再固定一张确定的因果图,相当于直接抛弃了不确定性;
而 BaCaDI 用联合后验分布 p ( G , I t a r , Θ , Θ I ∣ D ) p(\boldsymbol G,\mathcal I^{\mathrm{tar}},\boldsymbol \Theta,\boldsymbol \Theta_\mathcal I|\mathcal D) p(G,Itar,Θ,ΘI∣D) :同时对「因果图、干预位置、机制参数」全部保留一整套概率分布。当我们计算干预效应、评估结果的时候,会对整个后验分布求期望,上游每一个隐变量的不确定性,都会自动传递到下游所有预测结果中。
串行方案(传统做法)先固定识别干预,拿着上一步确定不变的干预结果,再去学习因果图 G ^ \hat G G^。
第一步干预识别本身自带不确定性 。如果直接输出一个确定的干预标签,相当于把不确定的估计当成完全真实的已知条件;第一步的误差会被锁死,无法回传给因果图的推断过程。
什么样的因果图,会改变我们判断 "哪个变量发生了干预";反过来,干预的位置,也会改变因果图的拟合损失。联合真实后验是 p ( G , I t a r ∣ D ) p(G,\mathcal I^{\mathrm{tar}}|\mathcal D) p(G,Itar∣D),不能拆成 p ( G ∣ I ^ t a r ) p ( I ^ t a r ) p(G|\hat{\mathcal I}^{\mathrm{tar}})\;p(\hat{\mathcal I}^{\mathrm{tar}}) p(G∣I^tar)p(I^tar)。
模型丢失全部联合分布信息,我们只能得到单点估计,无法得到完整的隐变量联合后验;我们无法评估:「干预判断不准,会给因果结构带来多大的不确定性」。
BaCaDI 做了一个关键变换:引入连续隐变量 Z , Γ \boldsymbol Z,\boldsymbol \Gamma Z,Γ;通过 Sigmoid + Gumbel‑Softmax 重参数化技巧,建立连续概率松弛:p ( G ∣ Z ) p(G|Z) p(G∣Z):从连续矩阵Z采样一张离散因果图;
p ( I t a r ∣ Γ ) p(\mathcal I^{\mathrm{tar}}|\Gamma) p(Itar∣Γ):从连续矩阵 Γ \Gamma Γ采样离散干预掩码;
整个生成流程变成完全可微 ;再增加退火策略:训练时不断提高温度系数 α , β \alpha,\beta α,β,训练后期连续概率会收敛到严格的 0/1 离散结构。
粒子来自 Stein 变分梯度下降(SVGD,粒子变分推断)传统变分推断:用一个固定形式的简单分布(比如高斯分布)去近似复杂后验;复杂的离散‑混合联合后验很难拟合。
SVGD 的粒子:每一个粒子 = 一套完整的候选因果模型实例
单个粒子: ( Z ( l ) , Γ ( l ) , Θ ( l ) , Θ I ( l ) ) \big(\boldsymbol Z^{(l)},\boldsymbol \Gamma^{(l)},\boldsymbol \Theta^{(l)},\boldsymbol \Theta_\mathcal I^{(l)}\big) (Z(l),Γ(l),Θ(l),ΘI(l)) ,一个粒子就代表一套完整的猜想:一组因果嵌入、一组干预概率、一套因果机制参数。训练过程:几十个 / 上百个粒子同时在连续空间里迭代更新;粒子之间自带排斥力,自动铺满高概率的候选模型区域。训练完成:每一个粒子退火之后,都可以还原出一张完整离散因果图 + 一套离散干预方案;所有粒子合在一起,就是对完整联合后验分布 p ( G , I t a r , Θ , Θ I ∣ D ) p(\boldsymbol G,\mathcal I^{\mathrm{tar}},\boldsymbol \Theta,\boldsymbol \Theta_\mathcal I|\mathcal D) p(G,Itar,Θ,ΘI∣D) 的离散采样近似;做预测时对全部粒子的结果加权平均,天然保留全部认知不确定性。
相关工作
面向结构学习的连续优化
传统因果结构学习算法,大多依赖条件独立性检验或者组合搜索。自 Zheng 等人(2018)的工作开始,一系列研究将结构学习重新定义为连续优化问题,从而可以使用基于梯度的学习算法完成任务。
在这类技术的基础上,近期的研究工作开始尝试对因果图进行贝叶斯推断 ,而非仅仅学习一个单点估计结果。本文所提出的方法也属于该方向,但本文首次针对多数据集、干预未知的场景开展贝叶斯推断。
条件独立性检验(CI Test):给定三个变量集合 X , Y , Z \boldsymbol{X},\boldsymbol{Y},\boldsymbol{Z} X,Y,Z,检验原假设 X ⊥ ⊥ Y ∣ Z X \perp\!\!\!\perp Y \mid \boldsymbol{Z} X⊥⊥Y∣Z:在给定变量集 Z \boldsymbol{Z} Z的条件下,X与Y相互独立。
- 如果接受原假设 :数据支持二者条件独立,因果图中不存在直接边;
- 如果拒绝原假设:二者条件依赖,说明变量之间存在直接或间接因果关联。
算法流程:遍历所有变量对,不断增大条件集 Z \boldsymbol{Z} Z做独立性检验;利用 d‑分离规则,删除无向图中不需要的边;最后定向边的方向,输出一个等价类(CPDAG,因果充分等价图) 。
p‑value、显著性水平 α \alpha α控制结果,结果只有「独立 / 不独立」二元判定,不给这条边存在的概率 ; 只能识别马尔可夫等价类:很多不同的真实 DAG 会对应同一套条件独立关系,检验无法区分。
因果图的贝叶斯推断(贝叶斯因果学习):把整个 DAG 本身当作随机变量 。目标求解完整后验分布: p ( G , Θ ∣ D ) = p ( D ∣ G , Θ ) p ( G ) p ( Θ ) p ( D ) p(\boldsymbol{G},\boldsymbol{\Theta}\mid \mathcal{D})=\dfrac{p(\mathcal{D}\mid \boldsymbol{G},\boldsymbol{\Theta})\,p(\boldsymbol{G})\,p(\boldsymbol{\Theta})}{p(\mathcal{D})} p(G,Θ∣D)=p(D)p(D∣G,Θ)p(G)p(Θ)
- p ( G ) p(\boldsymbol{G}) p(G):图结构先验(偏好稀疏 DAG、无环约束)
- p ( Θ ∣ G ) p(\boldsymbol{\Theta}\mid\boldsymbol{G}) p(Θ∣G):给定图之后因果机制参数的先验
- p ( D ∣ G , Θ ) p(\mathcal{D}\mid\boldsymbol{G},\boldsymbol{\Theta}) p(D∣G,Θ):数据似然
贝叶斯方法不输出唯一一张图 ,而是得到: 所有符合数据的 DAG,以及每一张 DAG 对应的后验概率 p ( G ∣ D ) p(\boldsymbol{G}\mid \mathcal{D}) p(G∣D)
- 多条候选因果结构都可以解释观测数据;贝叶斯会保留全部候选结构,给每一个分配置信权重;
- 贝叶斯模型平均(BMA) :做下游干预预测时,不是只用一张图,而是对所有 DAG 按后验概率加权平均 ; E f ( G ) ∣ D = ∑ G f ( G ) p ( G ∣ D ) \mathbb{E}f(\\boldsymbol{G})\\mid \\mathcal{D}=\sum_{\boldsymbol{G}} f(\boldsymbol{G})\;p(\boldsymbol{G}\mid\mathcal{D}) Ef(G)∣D=∑Gf(G)p(G∣D)
- 输出边的边缘后验概率 : p ( G i j = 1 ∣ D ) p(G_{ij}=1\mid\mathcal{D}) p(Gij=1∣D),量化这条因果边存在的可信度。
DAG 的数量随变量数超指数爆炸,无法穷举全部图。因此论文里使用 SVGD、粒子变分推断、MCMC 采样来近似整个后验分布,而不是穷举。
多上下文场景下的因果挖掘
针对同一因果系统、不同干预环境下采集的数据进行因果结构学习,该方向被统称为联合因果推断(JCI) 。多样本方法能够同时处理观测数据与干预数据,但这类方法均假设干预靶点是完全已知的。
还有一类工作以不变性作为理论基础,但这类方法无法推广到全图结构,或是对局部因果效应施加了过强的约束假设。
- 多样本方法:一次同时利用多个干预环境数据集来学因果结构的算法(对应论文里的多上下文 / 多数据集推断)。
- 同时处理观测数据与干预数据:一份 "纯观测" 数据(无干预)+ 若干份 "干预后" 数据,全部丢进同一个模型里联合学习。
干预未知场景下的因果挖掘
Mooij 等人(2016)、Squires 等人(2020)、Wang 等人(2022)将干预靶点未知的问题改造为标准因果挖掘任务,同样利用条件独立性与不变性检验。然而,这类假设检验方法通常需要大规模数据集,在小样本的真实场景下鲁棒性较差。Jaber 等人(2020)针对无穷样本的极限条件,从理论上推导了混合分布对应的等价类,且干预操作未知。
其他近期研究针对干预未知的联合推断问题,构造了连续松弛形式,并采用基于梯度的优化求解目标。但是,这类方法仅输出单点估计值。
本文采用完全贝叶斯范式,实现严谨的不确定性量化。Eaton 与 Murphy(2007)是唯一一项采用相同思路的已有工作;但该方法仅支持离散变量,并且使用动态规划算法,无法拓展到大规模图结构上。
把「环境分组」当作已知,把「干预位置」当作隐变量,利用跨环境的分布不变性作为新的因果判定准则,将隐干预问题转化为一套可检验的统计约束。
- 常规因果挖掘(无干预) :只给观测数据,任务是找满足条件独立性约束的 DAG,核心判定规则:因果图对应的变量间独立关系必须和数据一致。
- 干预靶点未知的多环境数据集 :我们拿到多份来自不同干预实验 的数据,但不知道每一组样本到底干预了哪个变量。直接跑普通因果搜索行不通,因为干预会打破原本的条件独立关系。
搜索因果 DAG(传统因果挖掘); 对每个候选 DAG,做一组不变性假设检验,自动识别每个环境中哪些变量是干预目标。
背景知识:因果发现
因果贝叶斯网络
贝叶斯网络(BN)用有向无环图(DAG) G \boldsymbol{G} G 与参数集 Θ \boldsymbol{\Theta} Θ对d维变量 x = x 1 : d \boldsymbol{x}=x_{1:d} x=x1:d的联合分布 p ( x ) p(\boldsymbol{x}) p(x)建模。整体联合分布可以拆解为一系列局部条件概率的乘积:对每个变量 x i x_i xi,定义 p i ( x i ∣ x p a G ( i ) ; Θ ) p_i\big(x_i \mid x_{\mathrm{pa}{\boldsymbol{G}}(i)};\boldsymbol{\Theta}\big) pi(xi∣xpaG(i);Θ),其中 p a G ( i ) \rm pa{\boldsymbol{G}}(i) paG(i)代表图 G \boldsymbol{G} G中节点i的父节点集合;参数 Θ \boldsymbol{\Theta} Θ用来描述精确的局部条件分布。
在因果贝叶斯网络(CBN) 中,边直接代表因果关系。对于因果结构学习任务,我们假设不存在未观测的混淆变量(即因果充分性,参考 Pearl,2009;Spirtes 等人,2000;Peters 等人,2017)。
干预
对变量 x i x_i xi施加干预,等价于把原有条件分布 p i p_i pi替换为新的分布 p i ′ p_i' pi′。如果干预移除了该变量全部的父节点依赖关系,则称之为完美(硬 / 结构化)干预 ;此时原图会被修改为破损图 G I k \boldsymbol{G}^{I_k} GIk(Pearl,2009;Peters 等人,2017)。
本文设定一共有M组干预操作 I : = ( I 1 , ... , I M ) \mathcal{I}:=(I_1,\dots,I_M) I:=(I1,...,IM);每一项干预 I k : = ( I k t a r , Θ I k ) I_k:=(I_k^{\rm tar},\boldsymbol{\Theta}_{I_k}) Ik:=(Iktar,ΘIk)作用于一组靶点 I k t a r ⊆ { 1 , ... , d } I_k^{\rm tar}\subseteq \{1,\dots,d\} Iktar⊆{1,...,d}。
我们用 Θ I k \boldsymbol{\Theta}{I_k} ΘIk表示干预 I k I_k Ik施加在靶点 { x i ∣ i ∈ I k t a r } \{x_i\mid i\in I_k^{\rm tar}\} {xi∣i∈Iktar}后,描述局部条件分布 p i k ( x i ∣ x p a G ( i ) , Θ I k ) p_i^k\big(x_i\mid x{\mathrm{pa}{\boldsymbol{G}}(i)},\boldsymbol{\Theta}{I_k}\big) pik(xi∣xpaG(i),ΘIk)的参数。
为简化表述,下文默认采用完美干预,即 p i k ( x i ∣ x p a G ( i ) , Θ I k ) = p i ′ ( x i ∣ Θ I k ) p_i^k\big(x_i\mid x_{\mathrm{pa}{\boldsymbol{G}}(i)},\boldsymbol{\Theta}{I_k}\big)=p_i'\big(x_i\mid \boldsymbol{\Theta}_{I_k}\big) pik(xi∣xpaG(i),ΘIk)=pi′(xi∣ΘIk);但本文全部论证同样适用于软干预场景。
在干预 I k I_k Ik作用下,完整的数据分布可以拆解为观测条件分布与干预条件分布的乘积:
p ( x ∣ G , Θ , I k ) = ∏ i ∉ I k p i ( x i ∣ x p a G ( i ) , Θ ) ⋅ ∏ i ∈ I k p i k ( x i ∣ Θ I k ) p\big(\boldsymbol{x}\mid \boldsymbol{G},\boldsymbol{\Theta},I_k\big) =\prod_{i\notin I_k} p_i\big(x_i\mid x_{\mathrm{pa}{\boldsymbol{G}}(i)},\boldsymbol{\Theta}\big) \cdot\prod{i\in I_k} p_i^k\big(x_i\mid \boldsymbol{\Theta}_{I_k}\big) p(x∣G,Θ,Ik)=∏i∈/Ikpi(xi∣xpaG(i),Θ)⋅∏i∈Ikpik(xi∣ΘIk)
没有被干预的变量,其局部条件分布和观测状态保持一致,该性质通常被称为不变性 (Peters 等人,2016)或者模块性(Peters 等人,2017)。
贝叶斯网络的贝叶斯推断
给定独立同分布的被动观测样本集合 D = { x ( 1 ) , ... , x ( N ) } \mathcal{D}=\{\boldsymbol{x}^{(1)},\dots,\boldsymbol{x}^{(N)}\} D={x(1),...,x(N)},贝叶斯推断用来在观测基础上估计贝叶斯网络完整的后验概率密度。参考 Friedman 与 Koller(2003)的思路:给定有向无环图的先验分布 p ( G ) p(\boldsymbol{G}) p(G),以及网络参数关于图的先验 p ( Θ ∣ G ) p(\boldsymbol{\Theta}\mid \boldsymbol{G}) p(Θ∣G),由贝叶斯公式可以得到后验分布:
p ( G , Θ ∣ D ) ∝ p ( G ) p ( Θ ∣ G ) p ( D ∣ G , Θ ) (1) p(\boldsymbol{G},\boldsymbol{\Theta}\mid \mathcal{D})\propto p(\boldsymbol{G})p(\boldsymbol{\Theta}\mid \boldsymbol{G})\,p(\mathcal{D}\mid \boldsymbol{G},\boldsymbol{\Theta}) \tag{1} p(G,Θ∣D)∝p(G)p(Θ∣G)p(D∣G,Θ)(1) 式中 p ( D ∣ G , Θ ) = ∏ i = 1 n p ( x ( i ) ∣ G , Θ ) p(\mathcal{D}\mid \boldsymbol{G},\boldsymbol{\Theta})=\prod_{i=1}^n p(\boldsymbol{x}^{(i)}\mid \boldsymbol{G},\boldsymbol{\Theta}) p(D∣G,Θ)=∏i=1np(x(i)∣G,Θ),代表数据集 D \mathcal{D} D中独立样本的似然(不包含系统干预)。
得到后验分布之后,我们就可以计算任意函数f在该分布下的期望:
E p ( G , Θ ∣ D ) f ( G , Θ ) (2) \mathbb{E}_{p(\boldsymbol{G},\boldsymbol{\Theta}\mid \mathcal{D})}\bigf(\\boldsymbol{G},\\boldsymbol{\\Theta})\\big \tag{2} Ep(G,Θ∣D)f(G,Θ)(2) 该式适用于任意我们关心的函数f。
举例来说,如果要计算后验预测分布,令 f ( G , Θ ) = p ( x ∣ G , Θ ) f(\boldsymbol{G},\boldsymbol{\Theta})=p(\boldsymbol{x}\mid \boldsymbol{G},\boldsymbol{\Theta}) f(G,Θ)=p(x∣G,Θ)即可。
p ( x ∣ G , Θ ) p(x \mid G, \Theta) p(x∣G,Θ):给定一个具体的图 G 和一组具体的参数 Θ \Theta Θ,新样本 x 的条件概率密度 。如果我们确定因果图就是 G、参数就是 Θ \Theta Θ,那么新数据 x 出现的概率就是它。这是单个模型的预测分布 。
我们的目标是求看完数据 D 之后,对新样本 x 的预测分布 ,记为 p ( x ∣ D ) p(x \mid D) p(x∣D)。
由全概率公式展开: p ( x ∣ D ) = ∫ G ∫ Θ p ( x , G , Θ ∣ D ) d Θ d G p(x \mid D) = \int_G \int_\Theta p(x,\,G,\,\Theta \mid D) \; d\Theta\, dG p(x∣D)=∫G∫Θp(x,G,Θ∣D)dΘdG,再用条件概率分解: p ( x , G , Θ ∣ D ) = p ( x ∣ G , Θ , D ) ⋅ p ( G , Θ ∣ D ) p(x,\,G,\,\Theta \mid D) = p(x \mid G,\,\Theta,\,D) \cdot p(G,\,\Theta \mid D) p(x,G,Θ∣D)=p(x∣G,Θ,D)⋅p(G,Θ∣D)
关键性质:给定真实模型 G , Θ G,\Theta G,Θ,新样本 x 和训练数据 D 相互独立 (独立同分布假设)。因此: p ( x ∣ G , Θ , D ) = p ( x ∣ G , Θ ) p(x \mid G,\,\Theta,\,D) = p(x \mid G,\,\Theta) p(x∣G,Θ,D)=p(x∣G,Θ)代入回去就得到: p ( x ∣ D ) = ∫ G ∫ Θ p ( x ∣ G , Θ ) ⋅ p ( G , Θ ∣ D ) d Θ d G p(x \mid D) = \int_G \int_\Theta p(x \mid G,\Theta) \cdot p(G,\Theta \mid D) \; d\Theta\, dG p(x∣D)=∫G∫Θp(x∣G,Θ)⋅p(G,Θ∣D)dΘdG
右边恰好就是期望的定义: p ( x ∣ D ) = E p ( G , Θ ∣ D ) p ( x ∣ G , Θ ) p(x \mid D) = \mathbb{E}_{p(G,\Theta\mid D)}\Big\\,p(x \\mid G,\\Theta)\\,\\Big p(x∣D)=Ep(G,Θ∣D)p(x∣G,Θ)
在因果贝叶斯网络的主动学习场景中,常用的f代表施加特定干预后,图 G \boldsymbol{G} G带来的期望信息增益。后验分布 p ( G , Θ ∣ D ) p(\boldsymbol{G},\boldsymbol{\Theta}\mid \mathcal{D}) p(G,Θ∣D)刻画了图结构与参数本身的认知不确定性。在大样本极限下,先验权重会消失,后验分布收敛到能够最大化似然的图与参数集合。
求解后验分布在计算层面极具挑战:n个节点对应的有向无环图总数是超指数级别的,即 O ( n ! 2 n 2 ) O(n!2^{n^2}) O(n!2n2)(Robinson,1973)。因此,对归一化常数 p ( D ) p(\mathcal{D}) p(D)直接求解通常不可实现。
基于多上下文数据的贝叶斯因果发现
问题描述 :本节提出一种通用方法,在干预目标与干预效应均未知的条件下,基于多组干预数据集,对因果贝叶斯网络(CBN)进行贝叶斯推断。
给定 M 个数据集 D = { D 1 , ... , D M } \mathcal{D}=\{\mathcal{D}_1,\dots,\mathcal{D}_M\} D={D1,...,DM},这些数据集由若干(未知)干预 I = { I 1 , ... , I M } \mathcal{I}=\{I_1,\dots,I_M\} I={I1,...,IM} 生成。每个数据集 D k \mathcal{D}_k Dk 包含独立同分布样本 D k = { x ( k , 1 ) , ... , x ( k , n k ) } \mathcal{D}_k=\{\mathbf{x}^{(k,1)},\dots,\mathbf{x}^{(k,n_k)}\} Dk={x(k,1),...,x(k,nk)},样本取自干预后的数据分布 p ( x ∣ Θ , G , I k ) p(\mathbf{x}|\boldsymbol{\Theta},\mathbf{G},I_k) p(x∣Θ,G,Ik)。
如果存在观测数据,可将其作为 D 0 : = D \mathcal{D}_0:=\mathcal{D} D0:=D 并入数据集集合,此时对应的干预目标 I 0 = ∅ I_0=\emptyset I0=∅(空集,代表无干预,纯观测数据)。
我们的目标:给定数据集 D \mathcal{D} D,推断完整的未知因果贝叶斯网络 ( G , Θ ) (\mathbf{G},\boldsymbol{\Theta}) (G,Θ),同时推断未知干预集合 I \mathcal{I} I。
相比标准因果推断,这里的核心难点:除真实因果贝叶斯网络之外,干预目标 I k tar I_k^{\text{tar}} Iktar 和生成数据的干预参数 Θ I k \boldsymbol{\Theta}_{I_k} ΘIk 全部未知 。因此,我们本质上是对 M 个被修改图(mutilated graphs)做联合推断;这 M 张被修改图,全部由同一个未被观测的基础图 G \mathbf{G} G 关联在一起。
只有当每次干预 I k I_k Ik 带来的结构变化,相对于图 G \mathbf{G} G 的整体规模是稀疏的,这类推断才是适定问题,即满足 ∣ I k ∣ ≪ d |I_k| \ll d ∣Ik∣≪d(被干预变量数量远小于总变量数 d)。
如果不同上下文下,因果模型中被干预的部分差异很大,那么各个被干预后的残缺 DAG 之间几乎没有重叠,也就缺少多任务联合学习的基础。该假设在 Brouillard 等人(2020)的前期工作中已被采用,通常被称为稀疏机制偏移假设(Sparse Mechanism Shift hypothesis,Schölkopf 等人,2021):该假设认为分布的变化往往以稀疏形式体现。
贝叶斯推断
在生物学等很多相关应用领域,观测样本量 n k n_k nk 很小,且存在噪声。因此,我们不能只输出单个原型因果贝叶斯网络,以及每个数据集对应的某一个干预假设;还需要对它们共同的认知不确定性做推理 。这类不确定性估计,可以量化预测结果的可靠程度,还能用于主动设计后续实验。因此我们从贝叶斯视角处理该问题。
这样一来,基于数据集 D \mathcal{D} D 的学习就转化为后验推断问题:预先选定先验概率与似然函数,作为推断的前置条件。下面我们逐步构建该问题。
已知干预的场景
当干预目标 I k tar I_k^{\text{tar}} Iktar 和干预效应参数 Θ I k \boldsymbol{\Theta}_{I_k} ΘIk ( k = 1 , ... , M (k=1,\dots,M (k=1,...,M)全部已知时,因果贝叶斯网络的后验包含两部分:
(i) 全部数据集 D \mathcal{D} D 的数据似然的乘积;
(ii) 对于 k ≥ 1 k\ge1 k≥1 的数据集 D k \mathcal{D}_k Dk,使用干预似然而非观测似然。
后验 ∝ 先验 × 数据似然 \text{后验} \propto \text{先验} \times \text{数据似然} 后验∝先验×数据似然,把观测似然和所有干预似然乘起来,因为各数据集独立生成,联合似然是乘积。
p ( G , Θ ∣ D , I ) ∝ p ( G ) p ( Θ ∣ G ) ⏟ 先验 p ( D 0 ∣ Θ , G ) ⏟ 观测似然 ⋅ ∏ k = 1 M p ( D k ∣ Θ , G , I k ) ⏟ 干预似然 (3) p(\mathbf{G},\boldsymbol{\Theta}|\mathcal{D},\mathcal{I}) \propto \underbrace{p(\mathbf{G})p(\boldsymbol{\Theta}|\mathbf{G})}{\text{先验}} \underbrace{p(\mathcal{D}0|\boldsymbol{\Theta},\mathbf{G})}{\text{观测似然}} \cdot \prod{k=1}^M \underbrace{p(\mathcal{D}k|\boldsymbol{\Theta},\mathbf{G},I_k)}{\text{干预似然}} \tag{3} p(G,Θ∣D,I)∝先验 p(G)p(Θ∣G)观测似然 p(D0∣Θ,G)⋅k=1∏M干预似然 p(Dk∣Θ,G,Ik)(3)式中 p ( D k ∣ Θ , G , I k ) = ∏ i = 1 n k p ( x ( k , i ) ∣ Θ , G , I k ) p(\mathcal{D}k|\boldsymbol{\Theta},\mathbf{G},I_k) = \prod{i=1}^{n_k} p(\mathbf{x}^{(k,i)}|\boldsymbol{\Theta},\mathbf{G},I_k) p(Dk∣Θ,G,Ik)=∏i=1nkp(x(k,i)∣Θ,G,Ik),是给定干预 I k = ( I k tar , Θ I k ) I_k=(I_k^{\text{tar}},\boldsymbol{\Theta}_{I_k}) Ik=(Iktar,ΘIk) 时,数据集 D k \mathcal{D}_k Dk 的干预似然。
未知干预的场景
我们引入额外的先验分布 p ( I k tar ) p(I_k^{\text{tar}}) p(Iktar) 和 p ( Θ I k ∣ I k tar ) p(\boldsymbol{\Theta}_{I_k}|I_k^{\text{tar}}) p(ΘIk∣Iktar),从而把未知干预纳入推断模型。对应的修正后验如下:
p ( G , Θ , I ∣ D ) ∝ p ( G ) p ( Θ ∣ G ) ⏟ 先验 p ( D 0 ∣ Θ , G ) ⏟ 观测似然 ⋅ ∏ k = 1 M p ( I k tar ) p ( Θ I k ∣ I k tar ) ⏟ 干预相关先验 p ( D k ∣ Θ , G , I k ) ⏟ 干预似然 (4) p(\mathbf{G},\boldsymbol{\Theta},\mathcal{I}|\mathcal{D}) \propto \underbrace{p(\mathbf{G})p(\boldsymbol{\Theta}|\mathbf{G})}{\text{先验}} \underbrace{p(\mathcal{D}0|\boldsymbol{\Theta},\mathbf{G})}{\text{观测似然}} \cdot \prod{k=1}^M \underbrace{p(I_k^{\text{tar}})p(\boldsymbol{\Theta}{I_k}|I_k^{\text{tar}})}{\text{干预相关先验}} \underbrace{p(\mathcal{D}k|\boldsymbol{\Theta},\mathbf{G},I_k)}{\text{干预似然}} \tag{4} p(G,Θ,I∣D)∝先验 p(G)p(Θ∣G)观测似然 p(D0∣Θ,G)⋅k=1∏M干预相关先验 p(Iktar)p(ΘIk∣Iktar)干预似然 p(Dk∣Θ,G,Ik)(4)干预目标的先验 p ( I k tar ) p(I_k^{\text{tar}}) p(Iktar) 编码了我们对干预结构的先验信念,例如:同一时间只有少量稀疏变量会被施加干预。
式 (3): I = { I 1 , . . . , I M } \mathcal I=\{I_1,...,I_M\} I={I1,...,IM} 是已知给定的条件 ,不是待推断随机变量;
式 (4): I \mathcal I I(干预目标 I k tar I_k^{\text{tar}} Iktar、干预效应参数 Θ I k \boldsymbol{\Theta}_{I_k} ΘIk)全部是未知隐随机变量 ,和图 G \mathbf G G、机制参数 Θ \boldsymbol \Theta Θ一起要从数据中推断出来。
贝叶斯定理指出 只要是待推断的随机变量,就必须给它指定先验分布 。所以新增的 p ( I k tar ) \boldsymbol{p(I_k^{\text{tar}})} p(Iktar)、 p ( Θ I k ∣ I k tar ) \boldsymbol{p(\boldsymbol{\Theta}_{I_k}|I_k^{\text{tar}})} p(ΘIk∣Iktar),就是给两组干预隐变量配置的先验,合起来叫干预相关先验 。
I k = ( I k tar , Θ I k ) I_k = \big(I_k^{\text{tar}},\; \boldsymbol{\Theta}_{I_k}\big) Ik=(Iktar,ΘIk)
干预分布 p i I ( x i ∣ Θ I ) p_i^I(x_i|\boldsymbol{\Theta}_I) piI(xi∣ΘI) 的参数化方式由具体应用场景决定,反映干预的一般特性,例如生物学中的基因敲除实验。
因果贝叶斯网络与干预的可微生成模型
在下文,我们将邻接矩阵记为 G ∈ { 0 , 1 } d × d \boldsymbol{G} \in \{0,1\}^{d\times d} G∈{0,1}d×d; I k tar = I k , 1 tar , ... , I k , d tar ⊤ ∈ { 0 , 1 } d \boldsymbol{I}k^{\text{tar}} = I_{k,1}\^{\\text{tar}},\\dots,I_{k,d}\^{\\text{tar}}^\top \in \{0,1\}^d Iktar=Ik,1tar,...,Ik,dtar⊤∈{0,1}d 为指示向量:当第 l 个变量受到干预时, I k , l tar = 1 I{k,l}^{\text{tar}}=1 Ik,ltar=1,否则为 0。由于多个节点可以同时被干预, I k tar \boldsymbol{I}_k^{\text{tar}} Iktar 一般不是独热编码。我们记 I tar \boldsymbol{I}^{\text{tar}} Itar 为干预目标 I 1 tar , ... , I M tar \\boldsymbol{I}_1\^{\\text{tar}},\\dots,\\boldsymbol{I}_M\^{\\text{tar}} I1tar,...,IMtar 的堆叠矩阵, Θ I : = Θ I 1 , ... , Θ I M \boldsymbol{\Theta}_I := \\boldsymbol{\\Theta}_{I_1},\\dots,\\boldsymbol{\\Theta}_{I_M} ΘI:=ΘI1,...,ΘIM 代表干预效应参数。
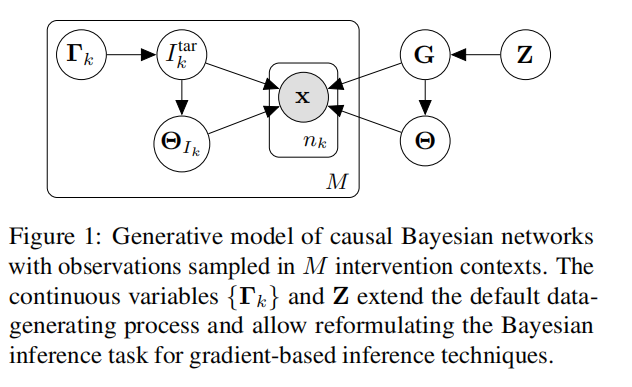
因果贝叶斯网络的生成模型,在 M 个干预上下文下采样得到观测数据。 { Γ k } \{\boldsymbol{\Gamma}_k\} {Γk} 和 Z \boldsymbol{Z} Z 扩展了基础的数据生成过程,允许我们将贝叶斯推断任务改写为可基于梯度的推断形式。
难点挑战
当从多组由未知干预目标、未知干预效应生成的数据集学习时,贝叶斯推断任务十分棘手。公式 (4) 要求在离散有向无环图 DAG、连续机制参数,以及 M 组干预 { I k } k = 1 M \{I_k\}_{k=1}^M {Ik}k=1M 上求解复杂的联合后验分布,而这些量又会反过来影响 DAG 图本身的辨识。因此,如果使用 EM 类方法交替推断 G \boldsymbol{G} G 和 I tar \boldsymbol{I}^{\text{tar}} Itar,会无法在所有隐变量之间传递认知不确定性,最终得到次优结果。
公式(4)同时刻画 离散DAG图,因果机制参数和干预集合各自的不确定性,以及它们之间的相互依赖。EM(Expectation‑Maximization,期望‑最大化)用于含有隐变量的极大似然 / 极大后验估计。它把问题拆成两步循环迭代: E 步(期望步) :固定模型参数,基于当前估计,求隐变量的后验期望;M 步(最大化步) :固定隐变量的统计量,最大化似然 / 后验,更新模型参数。 交替推断(交替优化)是 EM 一类的思路 :把一堆未知量拆成两批,固定 A 优化 B,再固定 B 优化 A,来回循环。
此外,推断干预似然 p i k ( x i ∣ Θ I k ) p_i^k(x_i|\boldsymbol{\Theta}_{I_k}) pik(xi∣ΘIk)(公式 11)的参数至关重要,尤其是当干预会带来强烈分布偏移时。如果简单掩盖观测似然,当变量被判定为干预目标时,我们将无法评估干预本身的似然;这会让模型在贝叶斯框架之外运行,倾向于预测不存在的干预,最终学到的模型在数据解释上表现较差。
偷懒的建模思路 是如果判定变量 i 是干预目标,直接扔掉、屏蔽观测似然项,但是不引入任何干预参数 Θ I k \boldsymbol{\Theta}_{I_k} ΘIk,不定义任何干预的分布 。这时模型会找到一个 "作弊捷径":只要某个变量的数据噪声大、和原图预测对不上,直接把它标记成干预目标,就可以逃避似然惩罚。
为解决这类联合推断难题,我们借鉴 Lorch 等人(2021)的思路:该方法将分布映射到连续隐空间,仅基于单组观测数据集 D \mathcal{D} D 实现因果贝叶斯网络 ( G , Θ ) (\boldsymbol{G},\boldsymbol{\Theta}) (G,Θ) 后验的高效推断。我们对该方法进行扩展,将多上下文推断问题,转化为仅在连续隐变量上求解的问题;该形式与公式 (4) 的原始任务保持一致,同时可以直接估计 G \boldsymbol{G} G 和每个上下文 k = 1 , ... , M k=1,\dots,M k=1,...,M 下 I k tar \boldsymbol{I}_k^{\text{tar}} Iktar 的联合后验得分。
Lorch 等人 2021,只处理普通观测数据集(单上下文,没有任何干预) 。DAG 是离散结构,DAG 数量爆炸,直接在离散空间做贝叶斯后验推断不可行。他们不直接对离散 DAG G \boldsymbol G G 采样;引入连续隐变量 Z \boldsymbol Z Z 。离散图 G \boldsymbol G G 是从 p ( G ∣ Z p(\boldsymbol G \mid \boldsymbol Z p(G∣Z) 这个条件分布采样得到。把对离散 DAG 的后验推断,转化成对连续潜变量 Z \boldsymbol Z Z 的后验推断 。
BaCaDI 要处理 M 个干预环境,干预目标 I k tar \boldsymbol I_k^{\text{tar}} Iktar 也是未知离散 0‑1 掩码。除了图对应的连续隐变量 Z \boldsymbol Z Z,新增另一组连续隐变量 Γ \boldsymbol \Gamma Γ;离散干预掩码 I k tar \boldsymbol I_k^{\text{tar}} Iktar 由 p ( I k tar ∣ Γ ) p(\boldsymbol I_k^{\text{tar}} \mid \boldsymbol \Gamma) p(Iktar∣Γ) 采样生成。
针对多上下文、未知干预场景设计这套推断方案,需要精细建模干预目标的先验,从而准确捕捉我们对数据生成过程的假设(例如干预的稀疏性、尖锐性);同时这套模型要支持变分推断等可追踪的推断方法(Blei 等人,2017),并且在实际场景中表现良好。
为实现全部隐变量的联合推断,我们引入连续隐变量 Z \boldsymbol{Z} Z、 Γ k \boldsymbol{\Gamma}_k Γk 以及对应的先验分布,用来建模生成过程。 G \boldsymbol{G} G 和 I k tar \boldsymbol{I}_k^{\text{tar}} Iktar 通过 p ( G ∣ Z ) p(\boldsymbol{G}|\boldsymbol{Z}) p(G∣Z) 与 p ( I k tar ∣ Γ k ) p(\boldsymbol{I}_k^{\text{tar}}|\boldsymbol{\Gamma}_k) p(Iktar∣Γk) 耦合。这就得到扩展后的生成模型因式分解形式,同样如图 1 所示:
p ( Z , G , Θ , Γ , I , D ) = p ( Z ) p ( G ∣ Z ) p ( Θ ∣ G ) ⏟ 因果贝叶斯网络生成过程 ∏ k = 1 M p ( Γ k ) p ( I k tar ∣ Γ k ) p ( Θ I k ∣ I k tar ) ⏟ 干预生成过程 p ( D k ∣ G , Θ , I k tar , Θ I k ) ⏟ 干预似然 (5) p(\boldsymbol{Z},\boldsymbol{G},\boldsymbol{\Theta},\boldsymbol{\Gamma},\mathcal{I},\mathcal{D}) = \underbrace{p(\boldsymbol{Z})p(\boldsymbol{G}|\boldsymbol{Z})p(\boldsymbol{\Theta}|\boldsymbol{G})}{\text{因果贝叶斯网络生成过程}} \prod{k=1}^M \underbrace{p(\boldsymbol{\Gamma}_k)p(\boldsymbol{I}_k^{\text{tar}}|\boldsymbol{\Gamma}k)p(\boldsymbol{\Theta}{I_k}|\boldsymbol{I}k^{\text{tar}})}{\text{干预生成过程}} \underbrace{p(\mathcal{D}k|\boldsymbol{G},\boldsymbol{\Theta},\boldsymbol{I}k^{\text{tar}},\boldsymbol{\Theta}{I_k})}{\text{干预似然}} \tag{5} p(Z,G,Θ,Γ,I,D)=因果贝叶斯网络生成过程 p(Z)p(G∣Z)p(Θ∣G)k=1∏M干预生成过程 p(Γk)p(Iktar∣Γk)p(ΘIk∣Iktar)干预似然 p(Dk∣G,Θ,Iktar,ΘIk)(5)
为简洁起见,记 Γ : = Γ 1 , ... , Γ M \boldsymbol{\Gamma}:=\\boldsymbol{\\Gamma}_1,\\dots,\\boldsymbol{\\Gamma}_M Γ:=Γ1,...,ΓM。
如后文所示,该扩展生成模型允许我们将公式 (4) 中的后验,改写为连续隐变量 Z , Γ , Θ I \boldsymbol{Z},\boldsymbol{\Gamma},\boldsymbol{\Theta}_I Z,Γ,ΘI 上的后验。
命题 1:在公式 (5) 与图 1 的扩展生成模型下,下式成立:
E p ( G , Θ , I ∣ D ) f ( G , Θ , I ) = \mathbb{E}_{p(\boldsymbol{G},\boldsymbol{\Theta},\mathcal{I}|\mathcal{D})}\bigf(\\boldsymbol{G},\\boldsymbol{\\Theta},\\mathcal{I})\\big = Ep(G,Θ,I∣D)f(G,Θ,I)= E ∗ p ( Z , G , Γ , Θ ∗ I ∣ D ) E ∗ p ( G ∣ Z ) p ( Θ ∣ G ) p ( I ∣ Γ ) \[ f ( G , Θ , I ) ⋅ Ψ E ∗ p ( G ∣ Z ) p ( I ∣ Γ ) Ψ ] (6) \mathbb{E}*{p(\boldsymbol{Z},\boldsymbol{G},\boldsymbol{\Gamma},\boldsymbol{\Theta}*I|\mathcal{D})}\left \\frac{\\mathbb{E}\*{p(\\boldsymbol{G}\|\\boldsymbol{Z})p(\\boldsymbol{\\Theta}\|\\boldsymbol{G})p(\\boldsymbol{\\mathcal{I}}\|\\boldsymbol{\\Gamma})}\\big\[f(\\boldsymbol{G},\\boldsymbol{\\Theta},\\mathcal{I})\\cdot \\boldsymbol{\\Psi}\\big} {\mathbb{E}*{p(\boldsymbol{G}|\boldsymbol{Z})p(\boldsymbol{\mathcal{I}}|\boldsymbol{\Gamma})}\\boldsymbol{\\Psi}} \right] \tag{6} E∗p(Z,G,Γ,Θ∗I∣D)E∗p(G∣Z)p(I∣Γ)\[ΨE∗p(G∣Z)p(Θ∣G)p(I∣Γ)f(G,Θ,I)⋅Ψ](6)
等式左边是原始问题,对离散的 G , I \boldsymbol G,\mathcal I G,I求后验期望,我们真正想要的量,但是算不了。等式右边:对**连续隐变量 Z , Γ \boldsymbol Z,\boldsymbol \Gamma Z,Γ**求外层期望;里面是条件于 Z , Γ \boldsymbol Z,\boldsymbol \Gamma Z,Γ的内层期望比值。
其中权重项 Ψ = p ( G ) p ( Θ ∣ G ) p ( D ∣ G , Θ , I ) \boldsymbol{\Psi} = p(\boldsymbol{G})p(\boldsymbol{\Theta}|\boldsymbol{G})p(\mathcal{D}|\boldsymbol{G},\boldsymbol{\Theta},\mathcal{I}) Ψ=p(G)p(Θ∣G)p(D∣G,Θ,I),并且 p ( D ∣ G , Θ , I ) = ∏ k = 1 M p ( D k ∣ G , Θ , I k tar , Θ I k ) p(\mathcal{D}|\boldsymbol{G},\boldsymbol{\Theta},\mathcal{I})=\prod_{k=1}^M p(\mathcal{D}_k|\boldsymbol{G},\boldsymbol{\Theta},\boldsymbol{I}k^{\text{tar}},\boldsymbol{\Theta}{I_k}) p(D∣G,Θ,I)=∏k=1Mp(Dk∣G,Θ,Iktar,ΘIk)。这个核心结论说明:图与干预上的后验期望,可以转化为隐变量后验 p ( Z , Θ , Γ , Θ I ∣ D ) p(\boldsymbol{Z},\boldsymbol{\Theta},\boldsymbol{\Gamma},\boldsymbol{\Theta}_I|\mathcal{D}) p(Z,Θ,Γ,ΘI∣D) 上的期望 。附录 A.1 给出证明。内层项类似于对 Z , Γ \boldsymbol{Z},\boldsymbol{\Gamma} Z,Γ 条件下 ( G , Θ , I ) (\boldsymbol{G},\boldsymbol{\Theta},\mathcal{I}) (G,Θ,I) 的似然比。除隐变量之外,所有因子都可以精确或近似计算。接下来我们讨论如何对 p ( Z , Θ , Γ , Θ I ∣ D ) p(\boldsymbol{Z},\boldsymbol{\Theta},\boldsymbol{\Gamma},\boldsymbol{\Theta}_I|\mathcal{D}) p(Z,Θ,Γ,ΘI∣D) 执行近似推断,并且进一步说明如何让生成模型的条件概率满足可微性。
DAG 图的生成模型
沿用 Lorch 等人(2021)的思路,我们定义隐变量 Z \boldsymbol{Z} Z 为嵌入矩阵 U , V ∈ R d × d \boldsymbol{U},\boldsymbol{V}\in\mathbb{R}^{d\times d} U,V∈Rd×d 的堆叠,利用内积构建邻接矩阵 G \boldsymbol{G} G 的生成模型:
引入连续隐变量 Z = U , V \boldsymbol Z = \\boldsymbol U,\\boldsymbol V Z=U,V,用连续实数矩阵去间接生成离散 DAG,实现可微松弛。
p α ( G ∣ Z ) = ∏ i = 1 d ∏ j ≠ i d p α ( g i j ∣ u i , v j ) (7) p_\alpha(\boldsymbol{G}|\boldsymbol{Z})=\prod_{i=1}^d\prod_{j\neq i}^d p_\alpha(g_{ij}|\mathbf{u}_i,\mathbf{v}_j) \tag{7} pα(G∣Z)=i=1∏dj=i∏dpα(gij∣ui,vj)(7)
其中 g i j ∣ u i , v j ∼ Bern ( σ α ( u i ⊤ v j ) ) g_{ij}|\mathbf{u}_i,\mathbf{v}j \sim \text{Bern}\big(\sigma\alpha(\mathbf{u}_i^\top \mathbf{v}_j)\big) gij∣ui,vj∼Bern(σα(ui⊤vj))。
式中 σ α ( x ) = 1 / ( 1 + exp ( − α x ) ) \sigma_\alpha(x)=1/(1+\exp(-\alpha x)) σα(x)=1/(1+exp(−αx)) 是带逆温度参数 α \alpha α 的 sigmoid 函数; u i , v j \mathbf{u}_i,\mathbf{v}_j ui,vj 分别是矩阵 U \boldsymbol{U} U、 V \boldsymbol{V} V 的第 i、第 j 列向量。原文作者证明,该参数化方案效果优于直接基于 d × d d\times d d×d 矩阵的标量参数化。
U \boldsymbol U U 有 d 列,第 i 列 u i \mathbf u_i ui 是节点 i 的「原因嵌入向量」 ,维度是 d 维; V \boldsymbol V V 有 d 列,第 j 列 v j \mathbf v_j vj 是节点 j 的「结果嵌入向量」 ,维度也是 d 维;
对任意两个节点 i , j i,j i,j,算它们嵌入向量的内积 u i ⊤ v j \mathbf u_i^\top \mathbf v_j ui⊤vj:如果 u i \mathbf u_i ui 和 v j \mathbf v_j vj 方向越接近(内积越大、越正),就越倾向于存在 i → j i\to j i→j 的因果边;
然后用带温度的 sigmoid 函数 σ α ( x ) \sigma_\alpha(x) σα(x),把这个实数内积压到 0~1 之间,得到边 i → j i\to j i→j 的存在概率: P ( g i j = 1 ∣ Z ) = σ α ( u i ⊤ v j ) P(g_{ij}=1 \mid \boldsymbol Z) = \sigma_\alpha(\mathbf u_i^\top \mathbf v_j) P(gij=1∣Z)=σα(ui⊤vj) 最后对每条边做伯努利采样。
我们记给定 Z \boldsymbol{Z} Z 时, G \boldsymbol{G} G 的边概率矩阵为 G α ( Z ) ∈ 0 , 1 d × d \boldsymbol{G}\alpha(\boldsymbol{Z}) \in 0,1^{d\times d} Gα(Z)∈0,1d×d,其中 G α ( Z ) i j : = σ α ( u i ⊤ v j ) \\boldsymbol{G}_\\alpha(\\boldsymbol{Z}){ij}:=\sigma_\alpha(\mathbf{u}_i^\top \mathbf{v}_j) Gα(Z)ij:=σα(ui⊤vj)。
对 Z \boldsymbol{Z} Z 的先验包含两部分:(i) 独立同分布高斯分布,方差取 η Z 2 = 1 / d \eta_Z^2=1/d ηZ2=1/d,保证梯度稳定;(ii) 无环性项,用来惩罚给定 Z \boldsymbol{Z} Z 下 G \boldsymbol{G} G 的期望循环程度:
p β ( Z ) = p ( U , V ) ∝ exp ( − β E p ( G ∣ Z ) h ( G ) ) ⏟ 无环先验 ⋅ ∏ i = 1 d N ( u i ∣ 0 , η Z 2 I ) N ( v i ∣ 0 , η Z 2 I ) ⏟ 推断稳定性 (8) p_\beta(\boldsymbol{Z})=p(\boldsymbol{U},\boldsymbol{V}) \propto \underbrace{\exp\big(-\beta \mathbb{E}{p(\boldsymbol{G}|\boldsymbol{Z})}h(\\boldsymbol{G})\big)}{\text{无环先验}} \cdot \prod_{i=1}^d \underbrace{\mathcal{N}(\mathbf{u}_i|\mathbf{0},\eta_Z^2\mathbf{I})\mathcal{N}(\mathbf{v}i|\mathbf{0},\eta_Z^2\mathbf{I})}{\text{推断稳定性}} \tag{8} pβ(Z)=p(U,V)∝无环先验 exp(−βEp(G∣Z)h(G))⋅i=1∏d推断稳定性 N(ui∣0,ηZ2I)N(vi∣0,ηZ2I)(8)其中, β \beta β 是逆温度参数,控制无环约束的强度; h ( G ) = tr ( I + 1 d G ) d − d ≥ 0 h(\boldsymbol{G})=\text{tr}\big(I+\\tfrac1d \\boldsymbol{G})\^d\\big-d \ge0 h(G)=tr(I+d1G)d−d≥0。根据 Yu 等人(2019)的定理 1: G \boldsymbol{G} G 是无环 DAG,当且仅当 h ( G ) = 0 h(\boldsymbol{G})=0 h(G)=0。当 β → ∞ \beta\to\infty β→∞, p ( Z ) p(\boldsymbol{Z}) p(Z) 的支撑集将收缩到所有能生成 DAG 的 Z \boldsymbol{Z} Z。
干预目标 I tar \boldsymbol{I}^{\text{tar}} Itar 的生成模型
为在连续空间建模干预目标,我们引入隐变量 Γ ∈ R M × d \boldsymbol{\Gamma}\in\mathbb{R}^{M\times d} Γ∈RM×d。每个 γ k , i \gamma_{k,i} γk,i 是独立伯努利分布的 logit,对应干预掩码矩阵 I tar = I 1 tar , ... , I M tar ∈ { 0 , 1 } M × d \boldsymbol{I}^{\text{tar}}=\\boldsymbol{I}_1\^{\\text{tar}},\\dots,\\boldsymbol{I}_M\^{\\text{tar}} \in \{0,1\}^{M\times d} Itar=I1tar,...,IMtar∈{0,1}M×d 的第 ( k , i ) (k,i) (k,i) 项: p ( I tar ∣ Γ ) = ∏ k = 1 M ∏ i = 1 d p α ( I k , i tar ∣ γ k , i ) (9) p(\boldsymbol{I}^{\text{tar}}|\boldsymbol{\Gamma})=\prod_{k=1}^M \prod_{i=1}^d p_\alpha(I_{k,i}^{\text{tar}}|\gamma_{k,i}) \tag{9} p(Itar∣Γ)=k=1∏Mi=1∏dpα(Ik,itar∣γk,i)(9) 其中 I k , i tar ∣ γ k , i ∼ Bern ( σ α ( γ k , i ) ) I_{k,i}^{\text{tar}}|\gamma_{k,i} \sim \text{Bern}\big(\sigma_\alpha(\gamma_{k,i})\big) Ik,itar∣γk,i∼Bern(σα(γk,i))。
M:干预上下文 / 实验的总数(比如做了 M 次不同的基因敲除实验);d:变量总数(比如 d 个基因);
引入连续实数隐变量 Γ \boldsymbol \Gamma Γ,让离散的干预掩码 I tar \boldsymbol I^{\text{tar}} Itar 变成「从 Γ \boldsymbol \Gamma Γ 里随机采样出来的对象」。我们只需要在连续空间推断 Γ \boldsymbol \Gamma Γ 的后验,就能间接得到干预目标的后验。
我们记干预目标概率矩阵为 I α tar ( Γ ) ∈ 0 , 1 M × d \mathcal{I}\alpha^{\text{tar}}(\boldsymbol{\Gamma}) \in 0,1^{M\times d} Iαtar(Γ)∈0,1M×d,满足 I α tar k , i = σ α ( γ k , i ) \\mathcal{I}_\\alpha\^{\\text{tar}}{k,i}=\sigma_\alpha(\gamma_{k,i}) Iαtark,i=σα(γk,i)。
每个元素 γ k , i \gamma_{k,i} γk,i 是连续实数,是「第 k 次实验干预第 i 个基因」的对数几率(logit)。
Γ \boldsymbol{\Gamma} Γ 的先验包含三部分:(i) 高斯项,保证推断稳定;(ii) Beta 分布锐度先验,鼓励 σ α ( γ k , i ) \sigma_\alpha(\gamma_{k,i}) σα(γk,i) 趋近于 0 或 1;(iii) 稀疏先验,基于 σ α ( Γ k ) \sigma_\alpha(\boldsymbol{\Gamma}_k) σα(Γk) 的 L1 范数,搭配逆温度参数 λ \lambda λ。
高斯项 和 DAG 部分完全一致,保证数值稳定。每个实验的 Γ k \boldsymbol \Gamma_k Γk(也就是矩阵的第 k 行)都从零均值高斯分布采样。防止 γ k , i \gamma_{k,i} γk,i 的数值变得正负无穷大,避免 sigmoid 饱和、梯度消失。
Beta 锐度先验 拒绝模糊状态。如果没有任何约束, γ k , i \gamma_{k,i} γk,i 经过 sigmoid 之后的干预概率可能停在 0.3、0.5 这种中间值,也就是「这个基因 50% 概率被干预,50% 没被干预」,这完全不符合现实。Beta 先验 大部分区域的概率都集中在靠近 0 的位置,也就是默认「这个基因没被干预」;在 p=0.5 附近的密度非常低,惩罚「半干预」的模糊状态,把概率往靠近 0 或靠近 1 的两端推。
Beta 分布的均值是 ζ 1 ζ 1 + ζ 2 = 1 / d 1 / d + ( d − 1 ) / d = 1 d \frac{\zeta_1}{\zeta_1+\zeta_2} = \frac{1/d}{1/d + (d-1)/d} = \frac{1}{d} ζ1+ζ2ζ1=1/d+(d−1)/d1/d=d1,也就是单个基因被干预的先验概率是 1/d 。总共有 d 个基因,所以单次实验期望被干预的基因数是 d × 1 d = 1 d \times \frac{1}{d} = 1 d×d1=1,刚好对应现实中「一次生物实验通常只靶向一个目标基因」的先验假设。
哪怕 Beta 先验已经让单个基因的干预概率偏低,还是要防止模型走捷径:小样本下,模型为了拟合训练噪声,会把很多基因都标记成被干预 ------ 因为一旦标记成干预,就不用受原图的观测似然约束,可以自由拟合噪声,也就是之前讲过的「虚假干预」问题。
∥ σ α ( Γ k ) ∥ 1 \|\sigma_\alpha(\boldsymbol{\Gamma}_k)\|_1 ∥σα(Γk)∥1 就是第 k 次实验里,所有基因的干预概率之和。这个和越大,说明这次实验里有越多基因的干预概率偏高,先验惩罚就越重。
p ( Γ ) ∝ ∏ k = 1 M exp ( − λ ∥ σ α ( Γ k ) ∥ 1 ) ⏟ 稀疏掩码 ⋅ ∏ i = 1 d Beta ( σ α ( γ k , i ) ; ζ 1 , ζ 2 ) ⏟ 掩码锐度 N ( γ k ∣ 0 , η γ 2 I ) ⏟ 推断稳定性 (10) p(\boldsymbol{\Gamma}) \propto \prod_{k=1}^M \underbrace{\exp\big(-\lambda \|\sigma_\alpha(\boldsymbol{\Gamma}k)\|1\big)}{\text{稀疏掩码}} \cdot \prod{i=1}^d \underbrace{\text{Beta}\big(\sigma_\alpha(\gamma_{k,i});\zeta_1,\zeta_2\big)}{\text{掩码锐度}} \underbrace{\mathcal{N}(\gamma_k|\mathbf{0},\eta\gamma^2\mathbf{I})}_{\text{推断稳定性}} \tag{10} p(Γ)∝k=1∏M稀疏掩码 exp(−λ∥σα(Γk)∥1)⋅i=1∏d掩码锐度 Beta(σα(γk,i);ζ1,ζ2)推断稳定性 N(γk∣0,ηγ2I)(10)我们假设干预发生的概率很低:期望上每次仅干预一个变量。因此取 ζ 1 = 1 / d , ζ 2 = ( d − 1 ) / d \zeta_1=1/d,\zeta_2=(d-1)/d ζ1=1/d,ζ2=(d−1)/d。该稀疏先验表达:在同一个上下文 k 中,如果变量 i 已经被干预,那么其余变量 j ≠ i j\neq i j=i 被干预的先验概率更低。干预的稀疏程度还可以通过参数 λ \lambda λ 调节。
干预似然
结合公式 (8)(9) 的 DAG 生成模型与干预模型,借助 Gumbel-Softmax 技巧(Jang 等人,2016;Maddison 等人,2017),采样图 G ∼ Bern ( σ α ( U V ⊤ ) ) \boldsymbol{G}\sim\text{Bern}(\sigma_\alpha(\boldsymbol{U}\boldsymbol{V}^\top)) G∼Bern(σα(UV⊤)) 和掩码 I tar ∼ Bern ( σ α ( Γ ) ) \boldsymbol{I}^{\text{tar}}\sim\text{Bern}(\sigma_\alpha(\boldsymbol{\Gamma})) Itar∼Bern(σα(Γ)),在每个变量上选择使用观测似然或者干预似然,从而得到可微的干预似然:
p ( D k ∣ G , Θ , I k tar , Θ I k ) = ∏ j = 1 n k ∏ i = 1 d ( p ( x i ( k , j ) ∣ x pa G ( i ) , Θ ) ) ( 1 − I k , i tar ) ⋅ ( p ( x i ( k , j ) ∣ Θ I k ) ) I k , i tar (11) p(\mathcal{D}k|\mathbf{G},\boldsymbol{\Theta},\boldsymbol{I}k^{\text{tar}},\boldsymbol{\Theta}{I_k})= \prod{j=1}^{n_k}\prod_{i=1}^d \Big( p\big(x_i^{(k,j)}|x_{\text{pa}{\mathbf{G}}}(i),\boldsymbol{\Theta}\big) \Big)^{(1-I{k,i}^{\text{tar}})} \cdot \Big( p\big(x_i^{(k,j)}|\boldsymbol{\Theta}{I_k}\big) \Big)^{I{k,i}^{\text{tar}}} \tag{11} p(Dk∣G,Θ,Iktar,ΘIk)=j=1∏nki=1∏d(p(xi(k,j)∣xpaG(i),Θ))(1−Ik,itar)⋅(p(xi(k,j)∣ΘIk))Ik,itar(11)
该形式不强制指定特定似然或干预模型。也就是说,可以选用任意受限模型(例如线性机制、非高斯噪声)描述变量之间的因果关系。干预部分同样灵活,硬干预、软干预都可以接入公式 (11) 的干预似然,用来建模分布的局部变化。
对于上述两部分,唯一的硬性要求是:对隐参数可微。似然模型要结合应用场景、专家知识、数据类型来选定;同时,必须加入一定约束模型,才能保证真实结构的可识别性。我们将在第 6 节末尾重新讨论可识别性问题。
实验部分
我们在不同因果发现任务上评估 BaCaDI,使用来自多个环境(context)的数据。我们的目标是通过实证检验 BaCaDI 预测因果结构与干预目标的准确度,并将其与相关领域的前沿方法对比。首先,我们使用由因果贝叶斯网络(CBN)生成的合成数据集开展实验;其次,我们使用 SERGIO 模拟器(Dibaeinia 和 Sinha,2020)在模拟基因表达数据上评估各类方法。在这个更贴近真实场景的设定中,模型存在显著的模型误设定问题 ------ 也就是数据生成过程与先验、似然函数并不匹配。
实验设置
数据集 。遵循相关前人工作(Zheng 等人,2018;Yu 等人,2019;Zheng 等人,2020;Annadani 等人,2021;Scherrer 等人,2021;Lorch 等人,2021),我们在随机采样图上执行贝叶斯推断。我们考虑Erdős--Rényi(ER)随机图(Gilbert,1959)与无标度 Barabási--Albert(BA)随机图(Albert,1999),节点数(d=20),期望边数2d(ER-2 和 SF-2)。
我们随机采样 CBN 参数、模拟生成数据,随后将数据集拆分为用于推断的训练集与用于计算指标的测试集。在所有实验设定中,我们收集 n 0 = 100 n_0=100 n0=100个观测样本,每个干预环境 k ∈ { 1 , ... , M } k \in \{1,\dots,M\} k∈{1,...,M}附带 n k = 10 n_k=10 nk=10个样本。这是很多实际应用里常见的小样本场景。更多数据生成细节见附录 D。
基线方法 。由于 BaCaDI 是概率类方法,我们将它与现有算法的自助采样(bootstrap)版本对比,这些基线算法可以在多个含未知干预的环境中完成联合因果推断。我们将 BaCaDI 与带约束的方法 UT-IGSP(Squires 等人,2020)、JCI 框架下的 JCI-PC 算法(Mooj 等人,2016),以及基于分数的 DCDI 方法(Brouillard 等人,2020)做基准对比,这些方法都能够处理未知干预。JCI-PC 与 UT-IGSP 基于条件独立性 / 不变性检验;DCDI 使用神经网络对局部条件建模,噪声为高斯加性噪声(DCDI-G)。由于这些基线方法仅输出单个 DAG 点估计,我们采用非参数 DAG 自助采样方案 (Friedman 等人,1999;Agrawal 等人,2019),得到 DAG 和干预目标上的近似后验分布。我们在基线名称前增加前缀 "B-",代表采用自助采样。全部实验中,所有方法均使用 200 份自助采样样本。
BaCaDI 实例化 。我们使用 20 个粒子实例化 BaCaDI,用于 SVGD( Stein 变分梯度下降),粒子数量与基线方法的自助样本数量保持一致,迭代 2000 步 SVGD 更新。如果返回的粒子对应的是有环图,我们会丢弃该粒子,不参与后验近似。除非另行说明,我们建模干预时,固定均值 μ I k \boldsymbol{\mu}{I_k} μIk,方差 σ I 2 = 0.5 \sigma_I^2=0.5 σI2=0.5。我们推断干预效应参数 Θ I k = μ k , 1 I , ... , μ k , d I \boldsymbol{\Theta}{I_k}=\\mu_{k,1}\^I,\\dots,\\mu_{k,d}\^I ΘIk=μk,1I,...,μk,dI,使用无信息高斯先验 p ( Θ I k ) = ∏ i ∈ I k tar p ( μ k , i I ∣ I k tar = 1 ) = ∏ i ∈ I k tar N ( μ k , i I ; 0 , 10 ) p(\boldsymbol{\Theta}{I_k})=\prod{i\in I_k^{\text{tar}}} p(\mu_{k,i}^I|\mathcal{I}k^{\text{tar}}=1)=\prod{i\in I_k^{\text{tar}}}\mathcal{N}(\mu_{k,i}^I;0,10) p(ΘIk)=∏i∈Iktarp(μk,iI∣Iktar=1)=∏i∈IktarN(μk,iI;0,10)。该先验在大范围干预效应上属于无信息先验。观测似然的条件可以建模为线性或带加性高斯噪声的非线性模型;后者对应 DCDI-G 模型,使用含 5 个隐藏层的 1 层神经网络。生成模型的更多细节见附录 D.1。
评价指标。我们报告的指标聚焦推断问题的三个核心方面:因果发现、干预检测、完整 CBN 模型的干预效应推断。
- 因果结构 :结构干预距离 SID(Peters 和 Bühlmann),量化推断图G与真实图 G gt G_{\text{gt}} Ggt之间的差异,判定二者的调整集是否一致。由于我们执行后验推断,这里报告期望 SID: E -SID ( p , G gt ) : = ∑ G p ( G ∣ D ) ⋅ SID ( G , G gt ) \mathbb{E}\text{-SID}(p,G_{\text{gt}}):=\sum_G p(G|\mathcal{D})\cdot\text{SID}(G,G_{\text{gt}}) E-SID(p,Ggt):=∑Gp(G∣D)⋅SID(G,Ggt)。UT-IGSP 和 JCI-PC 仅返回干预马尔可夫等价类(I-MEC)的 CPDAG,因此我们计算 SID 的上下界,并取中点作为 E -SID \mathbb{E}\text{-SID} E-SID。我们还基于后验边缘分布 p ( g i j = 1 ∣ D ) p(g_{ij}=1|\mathcal{D}) p(gij=1∣D),报告单条边预测的精确率 - 召回曲线下面积(AUPRC)。
- 干预目标:报告干预 AUPRC(INTV-AUPRC),用于在每个环境中检测单个目标变量。
- 干预效应 :在 M test = 10 M^{\text{test}}=10 Mtest=10个留出的干预测试集 D test = { D 1 test , ... , D 10 test } \mathcal{D}^{\text{test}}=\{\mathcal{D}1^{\text{test}},\dots,\mathcal{D}{10}^{\text{test}}\} Dtest={D1test,...,D10test}上,报告平均负干预对数似然(I-NLL)。测试集的干预与训练集不同,且干预目标 I k tar \mathcal{I}_k^{\text{tar}} Iktar、效应分布已知。由于 UT-IGSP 和 JCI-PC 不会学习条件分布,我们使用线性高斯模型的闭式极大似然估计(MLE)参数,计算留出集的 I-NLL(Hauser 和 Bühlmann,2014)。
指标的更多细节见附录 D.5。
结果聚合。对于所有方法与实验设定,我们在指定超参数范围内搜索,至少使用 20 种配置。针对超参数的特定选择,我们在 30 组不同随机任务实例上收集结果,选取在留出集干预负对数似然最低的超参数。我们报告每组指标的中位数,以及基于经验分位数得到的 90% 置信区间。
合成数据上的实验结果
在合成数据实验中,我们聚焦硬干预 :将目标变量的值采样自高斯分布,均值随机选取、远离 0,方差固定为 0.5。每个干预数据集,都是通过对图中某个特定变量施加干预生成。我们以图中全部变量作为干预目标,即干预环境数量 M = d M=d M=d。对于 d = 20 d=20 d=20变量的合成数据集,总共生成 300 个样本, n 0 = 100 n_0=100 n0=100, n k = 10 n_k=10 nk=10。
我们首先考虑线性高斯 CBN,每个变量是其父节点的线性组合,叠加高斯加性噪声。ER-2、SF-2 对应的结果见图 3 (a)。第二个任务,我们评估非线性高斯条件设定:给定父节点,每个变量的均值由神经网络描述(详见附录 D.2),图 3 (b) 展示非线性 CBN 的结果。
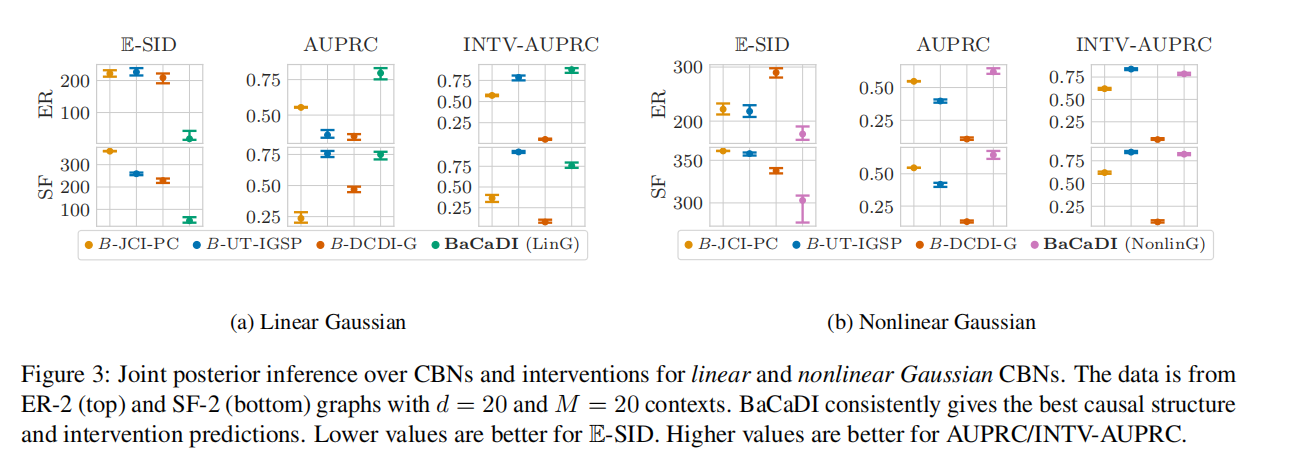
线性高斯与非线性高斯 CBN、干预下的联合后验推断。图为 ER-2(上)、SF-2(下)图,节点 d = 20 d=20 d=20,环境数 M = 20 M=20 M=20。BaCaDI 在因果结构与干预预测上持续取得最优结果。 E -SID \mathbb{E}\text{-SID} E-SID数值越低越好;AUPRC/INTV-AUPRC 数值越高越好。(a) 线性高斯;(b) 非线性高斯
在这 4 组合成评估设定下,BaCaDI 的因果结构预测,在干预含义层面最接近真实 CBN( E -SID \mathbb{E}\text{-SID} E-SID指标);单条边预测(AUPRC)的表现也优于基线。多数场景下,我们方法显著优于基线。此外 BaCaDI 在干预目标预测上取得很高的 INTV-AUPRC 分数。基线中,UT-IGSP 检测干预的能力最好,很大程度上和 BaCaDI 接近。虽然 UT-IGSP 在线性 SF-2 设定上同样取得高 AUPRC,但在其余设定与指标上,该方法性能显著弱于 BaCaDI。DCDI 在预测干预、因果机制上表现较差。
和我们完整贝叶斯的联合后验 p ( G , Θ , I tar ∣ D ) p(G,\boldsymbol{\Theta},\mathcal{I}^{\text{tar}}|\mathcal{D}) p(G,Θ,Itar∣D)处理方式不同,基于自助采样的基线方法无法传递认知不确定性,无法同时完成干预目标、干预效应、CBN 的推断。这使得像 DCDI 这类方法不做正则化,神经网络条件模型在小样本下极易过拟合。
额外分析 。我们在 d = 50 d=50 d=50节点图与更大数据集上开展额外实验,结果见图 7、图 9 与附录 E。在大图场景下,BaCaDI 能够媲美当前前沿因果发现方法。但对于规模极大的图,基于 SVGD 做推断的计算代价会急剧上升。一个有趣的消融实验案例见附录 E.2,探究 BaCaDI 相比观测数据,如何利用干预数据提升推断效果,即使干预目标未知。
基因调控网络实验
我们在真实应用场景下评估所有方法,使用 SERGIO 模拟器(Dibaeinia 和 Sinha,2020)生成单细胞基因表达数据。给定用户定义的因果图G,SERGIO 利用随机微分方程模拟基因表达动力学,生成真实单细胞转录组数据集,对应这个动态系统稳态的样本。真实基因调控网络类似无标度结构(Albert,2005;Ouma 等人,2018)。我们随机采样 d = 20 d=20 d=20节点的 SF-2 图。在该领域,我们设置 M = 10 M=10 M=10组基因敲除干预环境,每组随机选取一个干预目标,数据集总共包含 200 个样本(含干预前的观测样本)。数据在推断前做标准化,更多细节见附录 D.3。
贝叶斯建模框架允许 BaCaDI 以原则化的方式,将先验知识嵌入推断流程。这里我们做基因敲除干预,预期干预变量取值趋近于 0,方差很小。为体现该先验知识,我们设置干预噪声 σ I 2 = 0.01 \sigma_I^2=0.01 σI2=0.01,使用先验 p ( μ k , i I ∣ I k , i tar = 1 ) = N ( μ k , i I ∣ 0 , 1 ) p(\mu_{k,i}^I|\mathcal{I}{k,i}^{\text{tar}}=1)=\mathcal{N}(\mu{k,i}^I|0,1) p(μk,iI∣Ik,itar=1)=N(μk,iI∣0,1)。
实验结果。图 4 展示 SERGIO 数据集的结果。和合成 CBN 场景类似,BaCaDI 最准确地推断真实图。同时,该方法在预测干预目标上精度很高,体现为干预 AUPRC 指标;这得益于先验知识。在该场景下,JCI-PC 的精度接近随机猜测,几乎无法预测干预与边。
SERGIO 生成的数据取自随机动力系统的稳态样本,我们第 5 节的贝叶斯模型存在模型误设定。BaCaDI 依然表现良好,证明该方法在实际场景下具备鲁棒性。总体而言,BaCaDI 仅使用 200 个模拟基因表达测量,就可以在多实验场景下完成高质量因果结构预测。这是生命科学领域联合因果推断的一个有前景进展。这里预测的干预目标,对于理解药物脱靶效应等场景有独立研究价值。
我们认为,在 SERGIO 这类更贴近真实的基准上评估因果发现算法,是未来研究的重要方向。尤其是当前算法在真实数据上的实际适用性,还有大量开放问题。我们参考 Reisach 等人(2021)的工作,详细讨论了合成基准里潜在的偏差,以及连续优化因果结构学习的尺度敏感性问题。
CBN 与干预下的联合后验推断,模拟基因表达数据, d = 20 d=20 d=20,$M=10个环境。BaCaDI 在因果机制预测上显著优于基线方法,并且可以准确识别干预目标。(\mathbb{E}\text{-SID})、I-NLL 数值越低越好;AUPRC、INTV-AUPRC 数值越高越好。
讨论
本文提出 BaCaDI:一个全可微贝叶斯因果发现框架,用于在各类未知干预条件下生成的数据。BaCaDI 从多个环境中,对底层因果图、机制、未知干预一起执行近似推断。BaCaDI 的核心特点是以原则化的端到端方式建模认知不确定性。在我们的实验中,以往方法朴素的自助采样方案表现更差,这很可能是因为认知不确定性无法在未知干预、未知因果贝叶斯网络参数之间传递。与之相反,BaCaDI 在数据稀缺时依然可以稳定运行,并且能够兼容任意参数化模型,还可以融入领域专家给出的特定先验知识。
虽然贝叶斯方法在因果发现领域展现潜力,但仍存在一些有趣的开放性问题。第一,当图规模超过 5 个节点时,后验分布会高度不可求解,很难精确刻画后验近似的质量。此外,由于后验由似然项驱动,后验会按照样本和观测似然、干预似然的匹配程度对样本聚类。因此,当分布偏移更强时,识别干预的效果会提升;而干预仅轻微改变分布时,在有限数据下很难检测到干预。
我们这项工作的动机,是从真实单细胞基因表达数据推断基因调控网络的因果机制,这是一个极具挑战性的问题。第 7.3 节的实验结果证明,BaCaDI 为实现该目标迈出了重要一步。要最终达成目标,未来工作还需要解决一系列进一步的挑战,例如单细胞测序技术带来的实验测量噪声。