FP32/FP16/BF16浮点数介绍
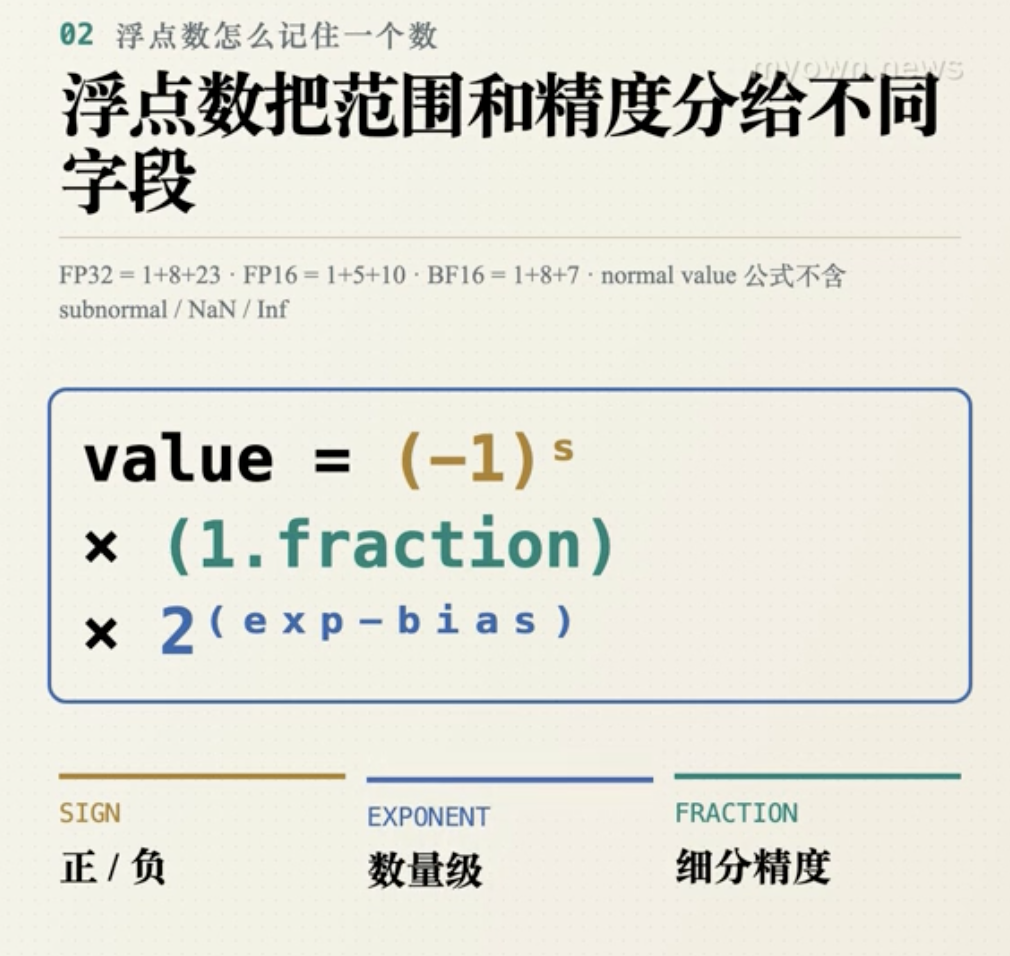
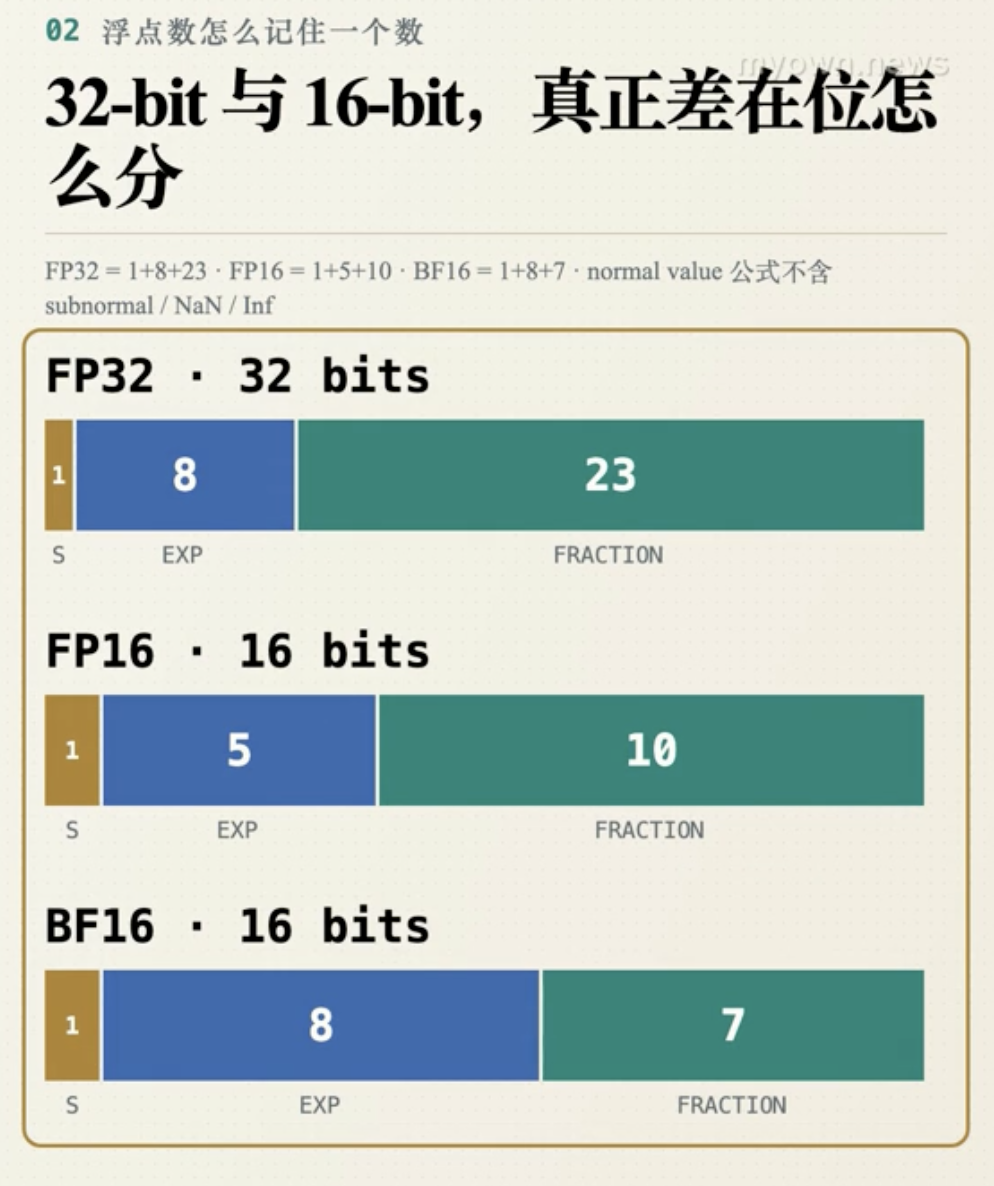
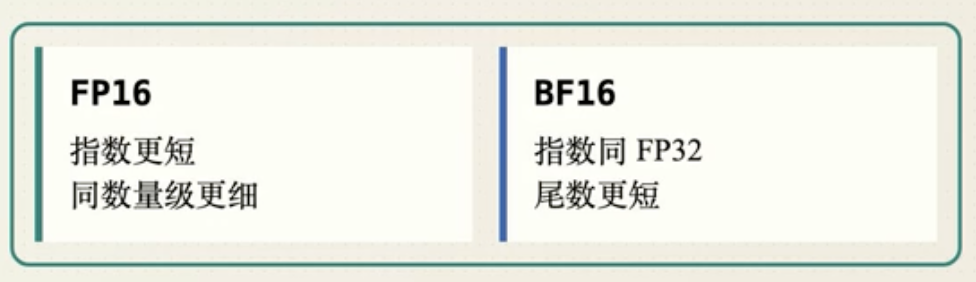
normal value 公式:sign位宽度/exp位宽度/fraction位宽度
- FP32 = 1/8/23
- FP16 = 1/5/10
- BF16 = 1/8/7
normal value 公式不包含 subnormal/NaN/Inf
value = (-1)^s ✖️ (1.fraction) ✖️ 2^(exp - bias)
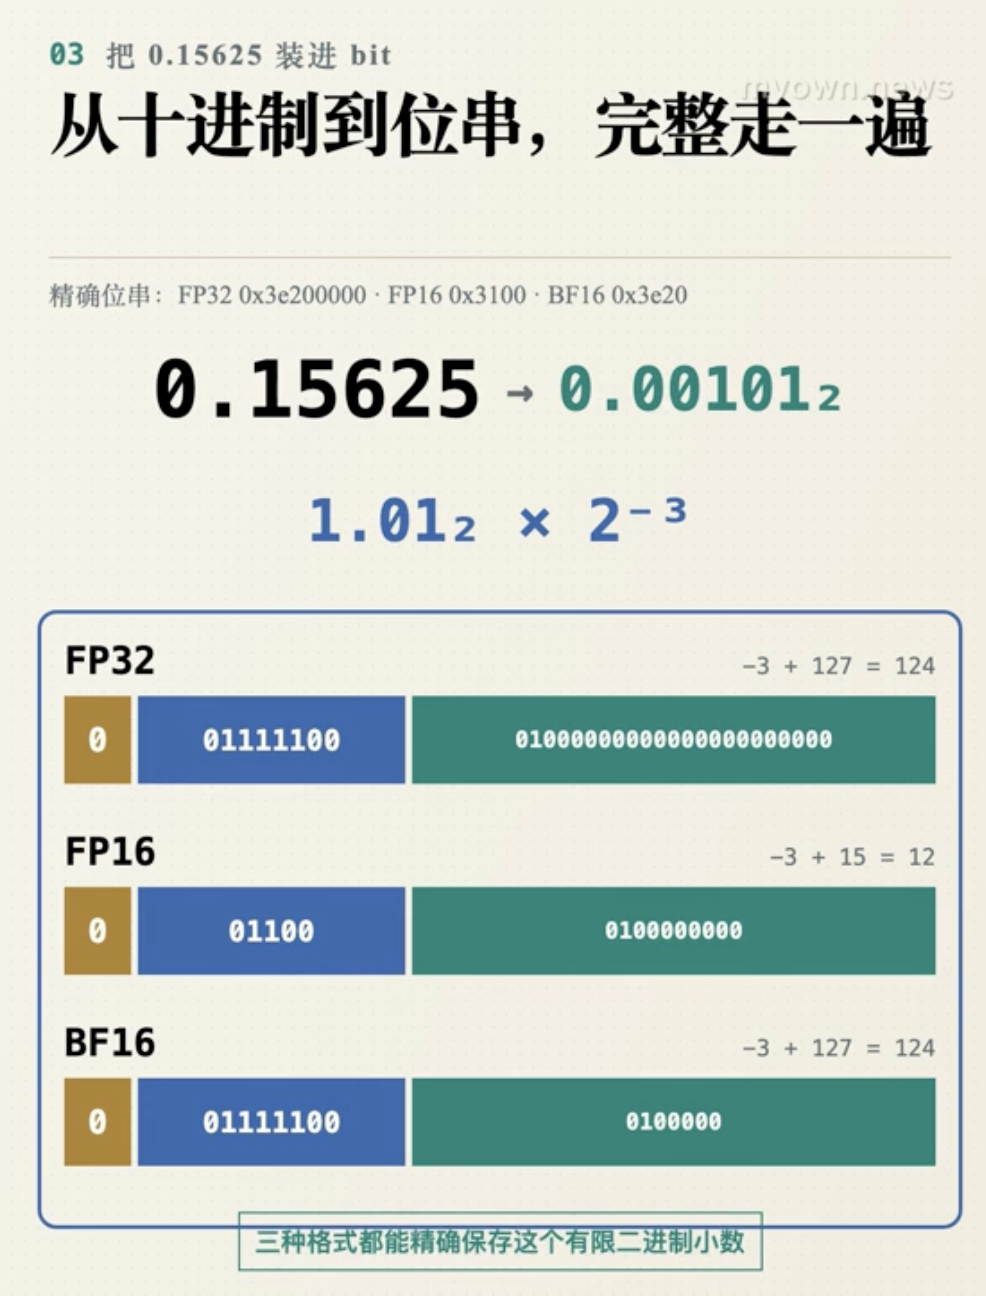
0.15625 = 0.125 + 0.03125 = 2^(-3) + 2^(-5) = 0.00101_2 = 1.01_2 * 2^(-3) 这里 _2 表示 2 进制
带入 (-1)^s ✖️ (1.fraction) ✖️ 2^(exp - bias) 公式:
- FP32,fraction = 01,exp - bias=-3,bias=127,exp = 124,01111100
- FP16,fraction = 01,exp - bias=-3,bias=15, exp = 12,01100
- BF16,fraction = 01,exp - bias=-3,bias=127,exp = 124,01111100
为什么浮点数要加 bias(偏移)
为了让指数可以用无符号整数比较大小,硬件电路做排序、比较的时候更简单
指数真值有负数
浮点数规格化的真实指数 e_true 可正可负。比如 FP32:e_true in -126, +127
如果内存里直接存有符号补码:硬件比较两个数大小时,要单独处理符号位,电路复杂、慢
补码比较:正数、负数规则不一样,要额外判断符号
Bias 思路:平移,把全部指数变成非负整数,e_storage = e_true + bias ,把整个指数区间向右平移,全部变成 ≥0 的无符号数
FP32:bias = 127
- e_true = -126 e_storage = -126 +127 = 1
- e_true = +127 e_storage =127+127=254
现在 e_storage in 1,254,是无符号 8 位整数
特殊位置
指数存储值全 0 → 非规格化数
指数存储值全 1 → Inf / NaN
这两个编码被预留出来,不用于普通规格化数字
为什么 bias 取 2^(k-1)-1(k 是指数位数)
指数位 k=8:2^7-1=127
- 平移之后,指数范围对称:负指数和正指数的区间尽量均衡,1~127(-126~0),128~254(1~127)
- 刚好把 0 真值指数映射到 e_storage = bias
- e_true = 0 e_storage=bias,即
1.0 * 2^0 =1.0
FP16 k=5,bias=2^4-1=15;BF16 k=8,bias=127,遵循同一个公式
Q4量化
处理的是一组权重的数值分布,不是把每个浮点数的存储砍短一点
统一affine的教学模型
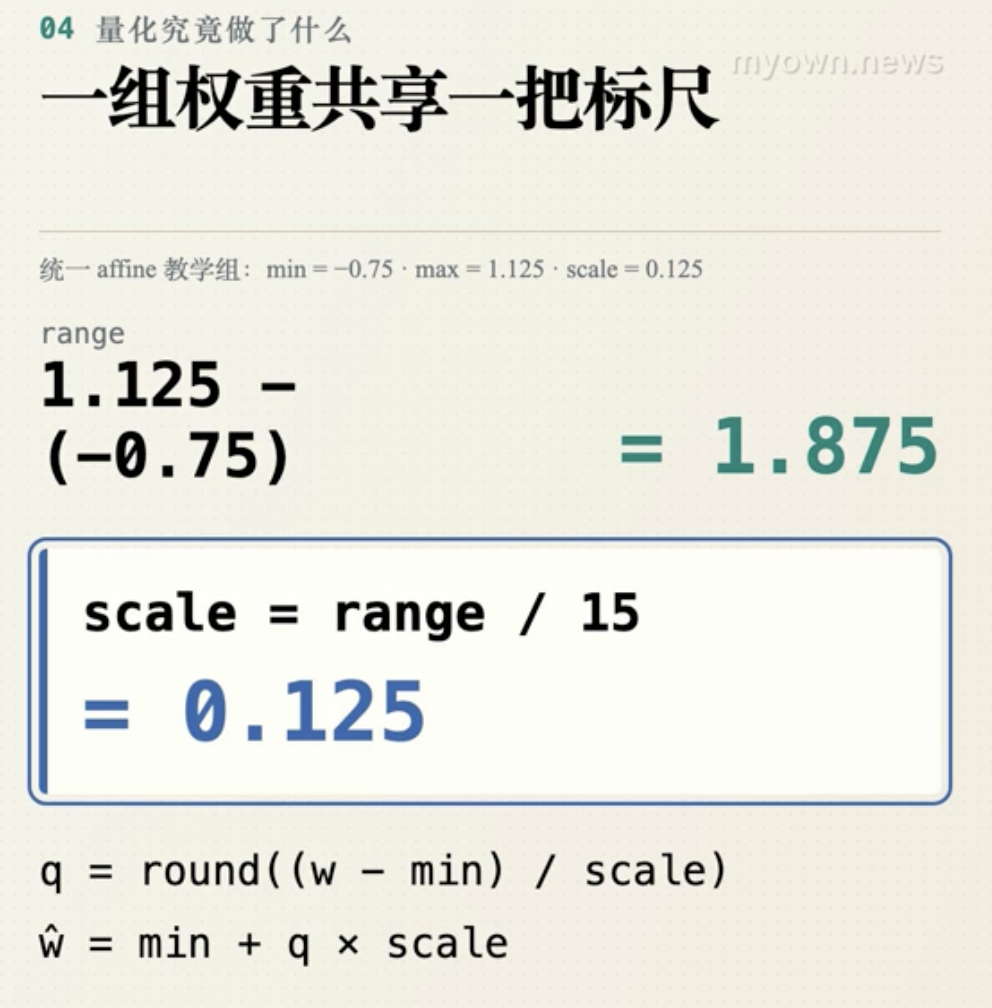
min和scale每组共享
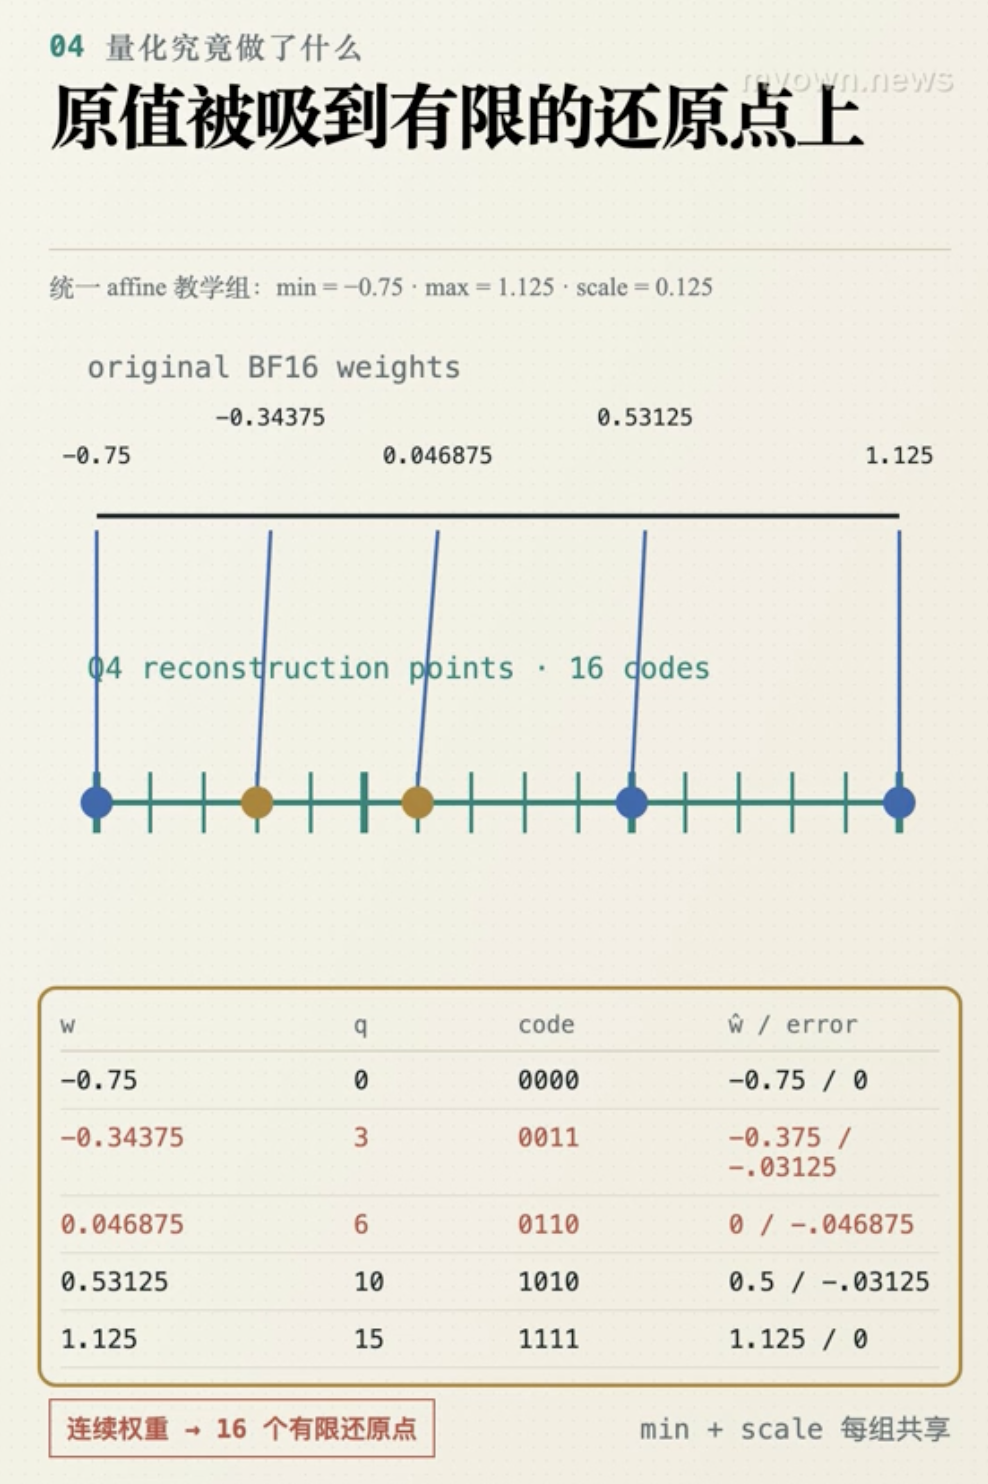
注意:这不是 Q4_K的字节复刻
Q4_K
GGUF是保存张量和元数据的文件容器,Q4表示主要权重使用 4bit 量化编码(注意:这里是主要权重,不是所有权重),K指向 llama.cpp 量化家族
Q4_K_M 是 llama.cpp 生态 GGUF 模型最推荐的默认量化档位,兼顾显存占用和模型能力,Ollama / LM Studio 大量默认使用它
老式 Q4_0:32 个权重一个 block(块),全局一组 scale
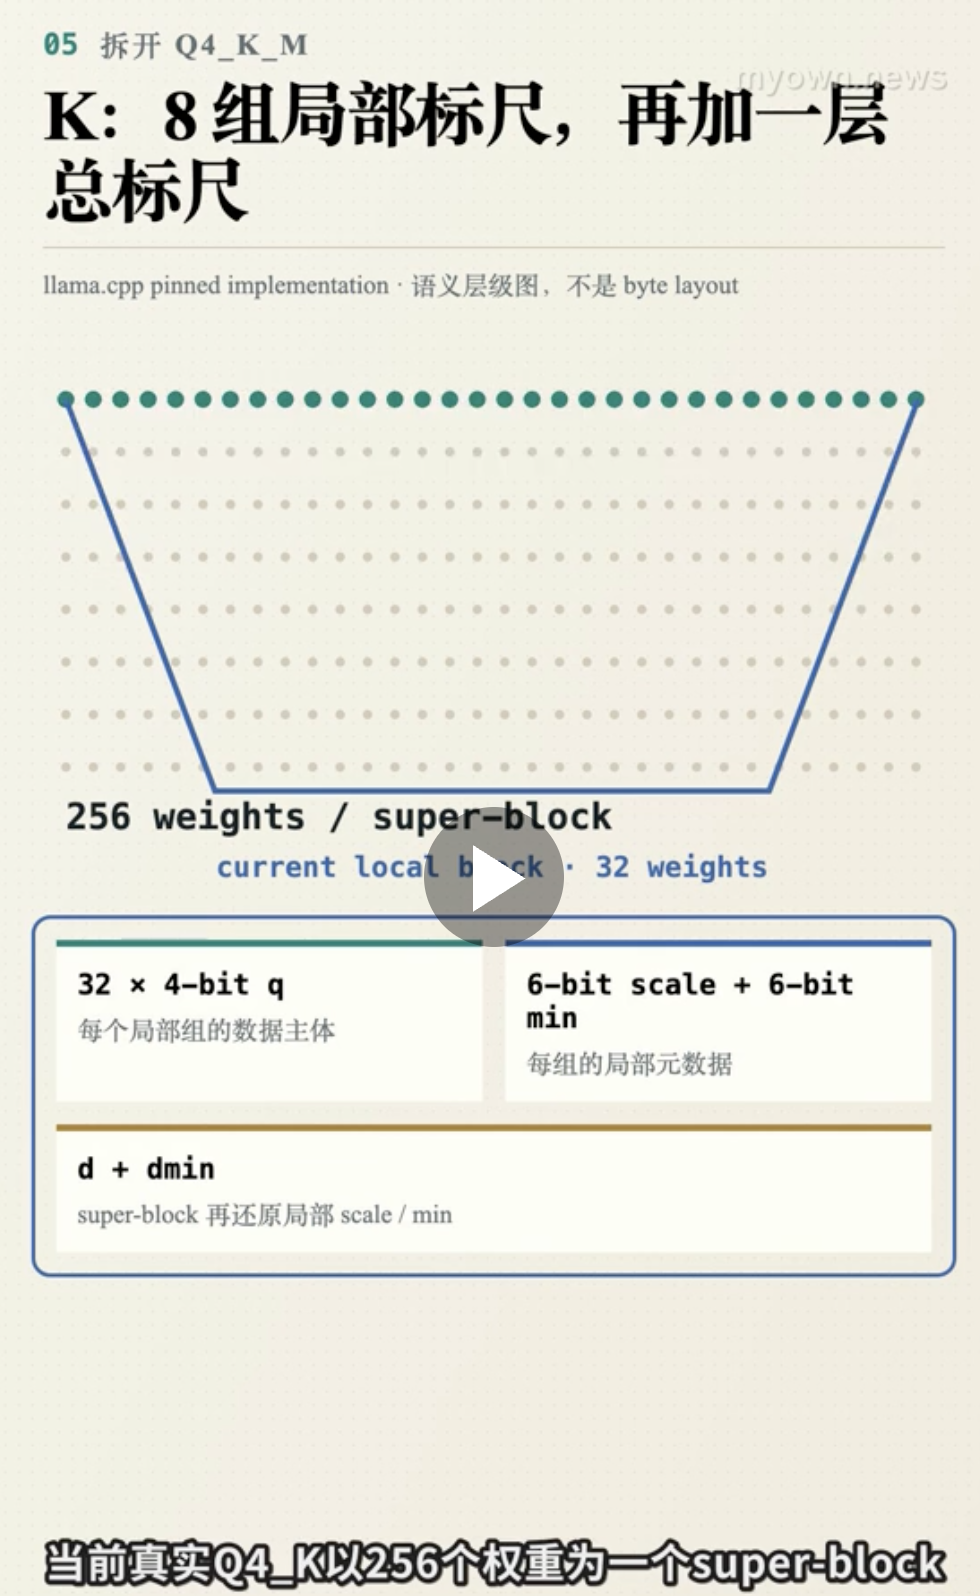
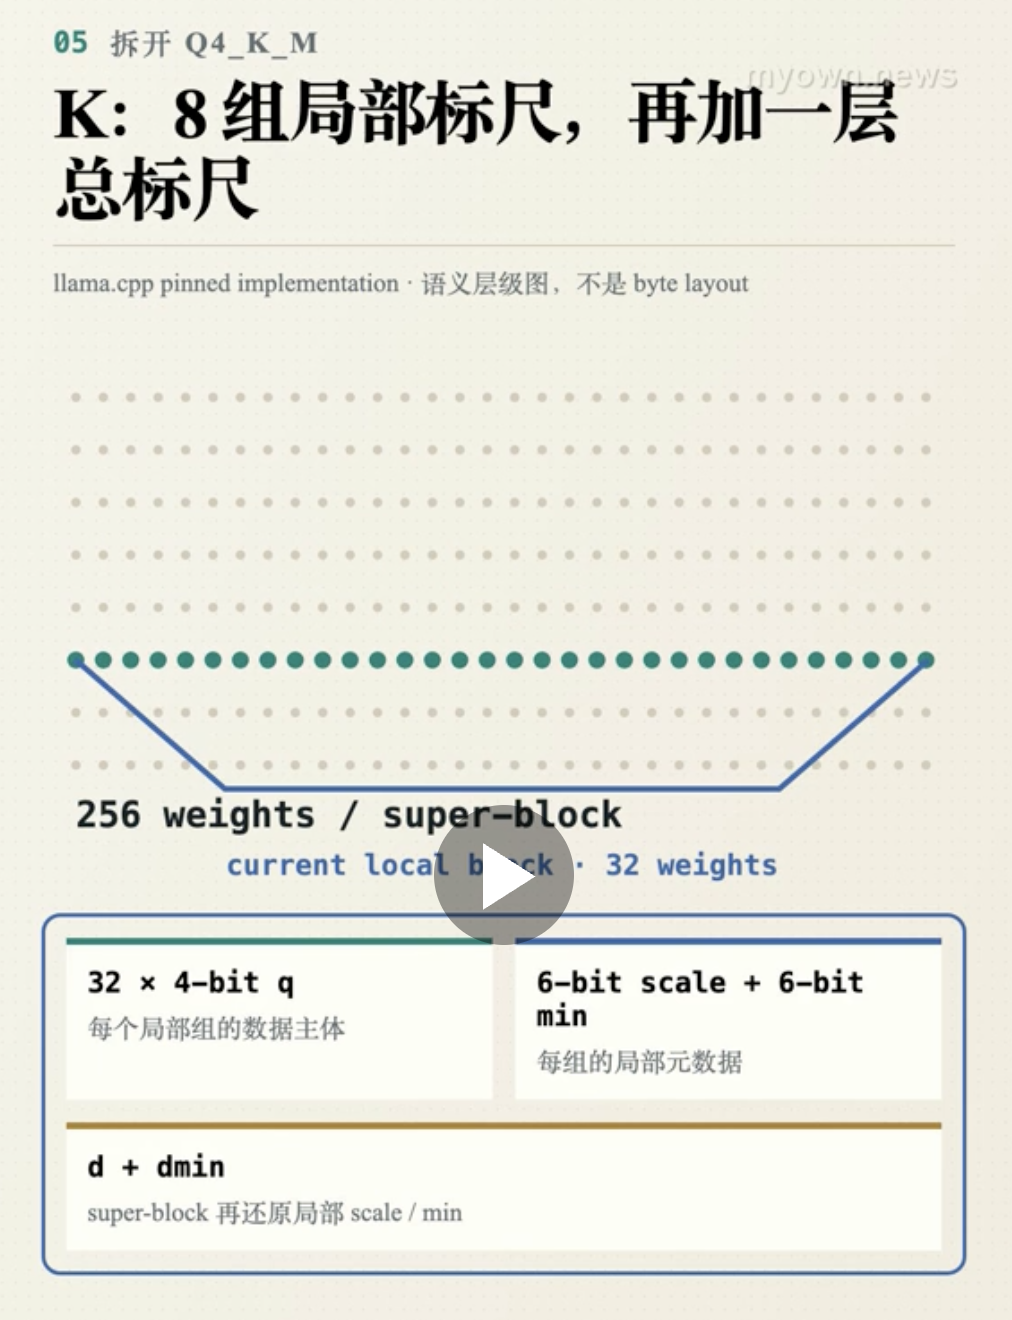
K-quant:256 个权重为一个 super-block(超块),再拆成 8 个子块,每个子块带独立 scale/min(每组的局部元数据)
M(Medium 混合策略),不是全部张量统一 4bit
Q4_K_M 是混合量化:大部分张量用 Q4_K;注意力等敏感张量自动升到更高精度(Q5_K/Q6_K),保证推理质量
- Q4_K_S:Small,全部尽量 4bit,文件更小,质量略差
- Q4_K_M:Medium,平衡,社区首选
- Q4_K_L:Large,更多张量用高位,质量更好,体积更大
神经网络权重大部分是正负混合
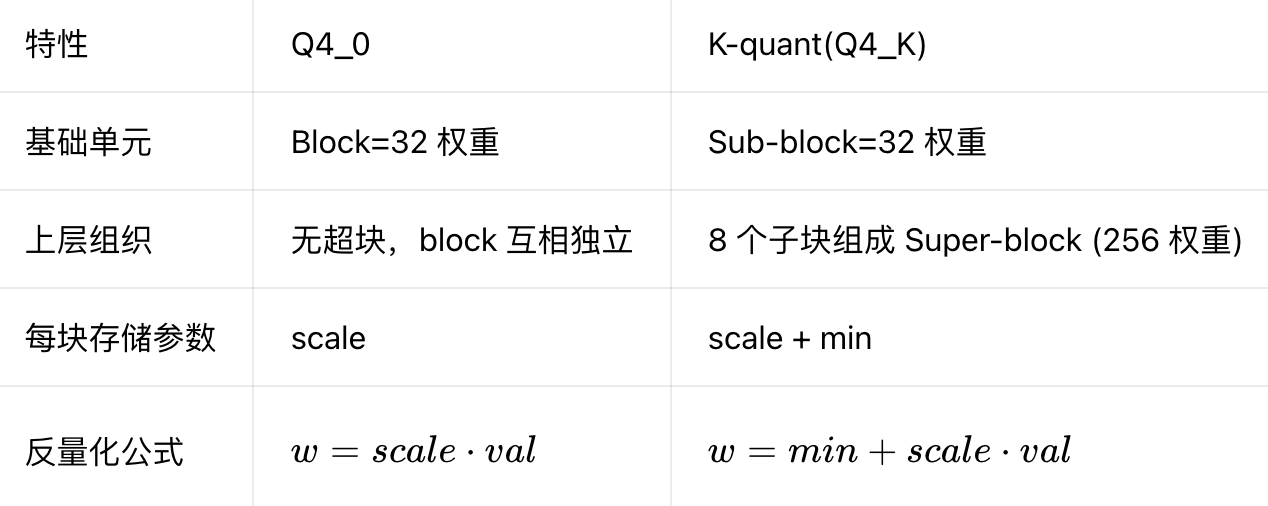
Q4_0 用 uint4,只能表达 0~15,要把负数塞进去,只能把整个值域平移,会压缩有效精度
Q4_0 是对称量化,没有独立 min 偏移 ;K-quant 每个子块带独立 min,属于非对称量化
K-quant 的min就是专门用来做这个平移,每个子块独立设置 min,4bit 的动态范围利用率高很多,同等 bit 数,量化误差明显下降
Q4_0 和 Q4_K 都是32 个权重一组,每组拥有自己的局部缩放因子
Q4_0 的 scale 是完整 FP16 ;K-quant 子块的 scale/min 本身是被二次量化的(6bit) ,还要乘以超块顶层的全局 FP16 系数 ,是两级分层缩放 :1 super-block =256 权重,拆成 8 个子块,1 sub-block=32 权重
Q4_K 的参数存储:
- 超块顶层:2 个 FP16:
d(super-scale)、dmin(super-min) - 8 个子块:每个子块保存量化后的子 scale、子 min(6bit,不是 FP16)
- 反量化公式:
w_i = d * s_b * q_i - dmin * m_b - d,dmin:超块顶层 FP16
- s_b,m_b:子块的 scale/min(从 6bit 解包出来)
为什么 Q4_K 要这么设计呢
Q4_0:简单粗暴,每个 32 权重独立,硬对称映射,scale 用 FP16,遇到非对称权重分布就浪费比特
Q4_0的定义
- q:4bit 无符号整数,只能取 0,1,2,...,15 一共 16 个值(16 个编码格子)
- 公式:
w = scale * (q - 8) - 固定偏移
-8是 Q4_0 对称量化的硬编码规则,不能改
在当前 block 内,遍历 32 个权重,算出 w_max = max(|w_1|,|w_2|,...,|w_32|)。注意:取绝对值的最大值
令 7 * scale = w_max,则scale = w_max/7
以 block 权重 0.1 \~ 2.0 为例,scale=0.2857,看每个 q 对应的 w
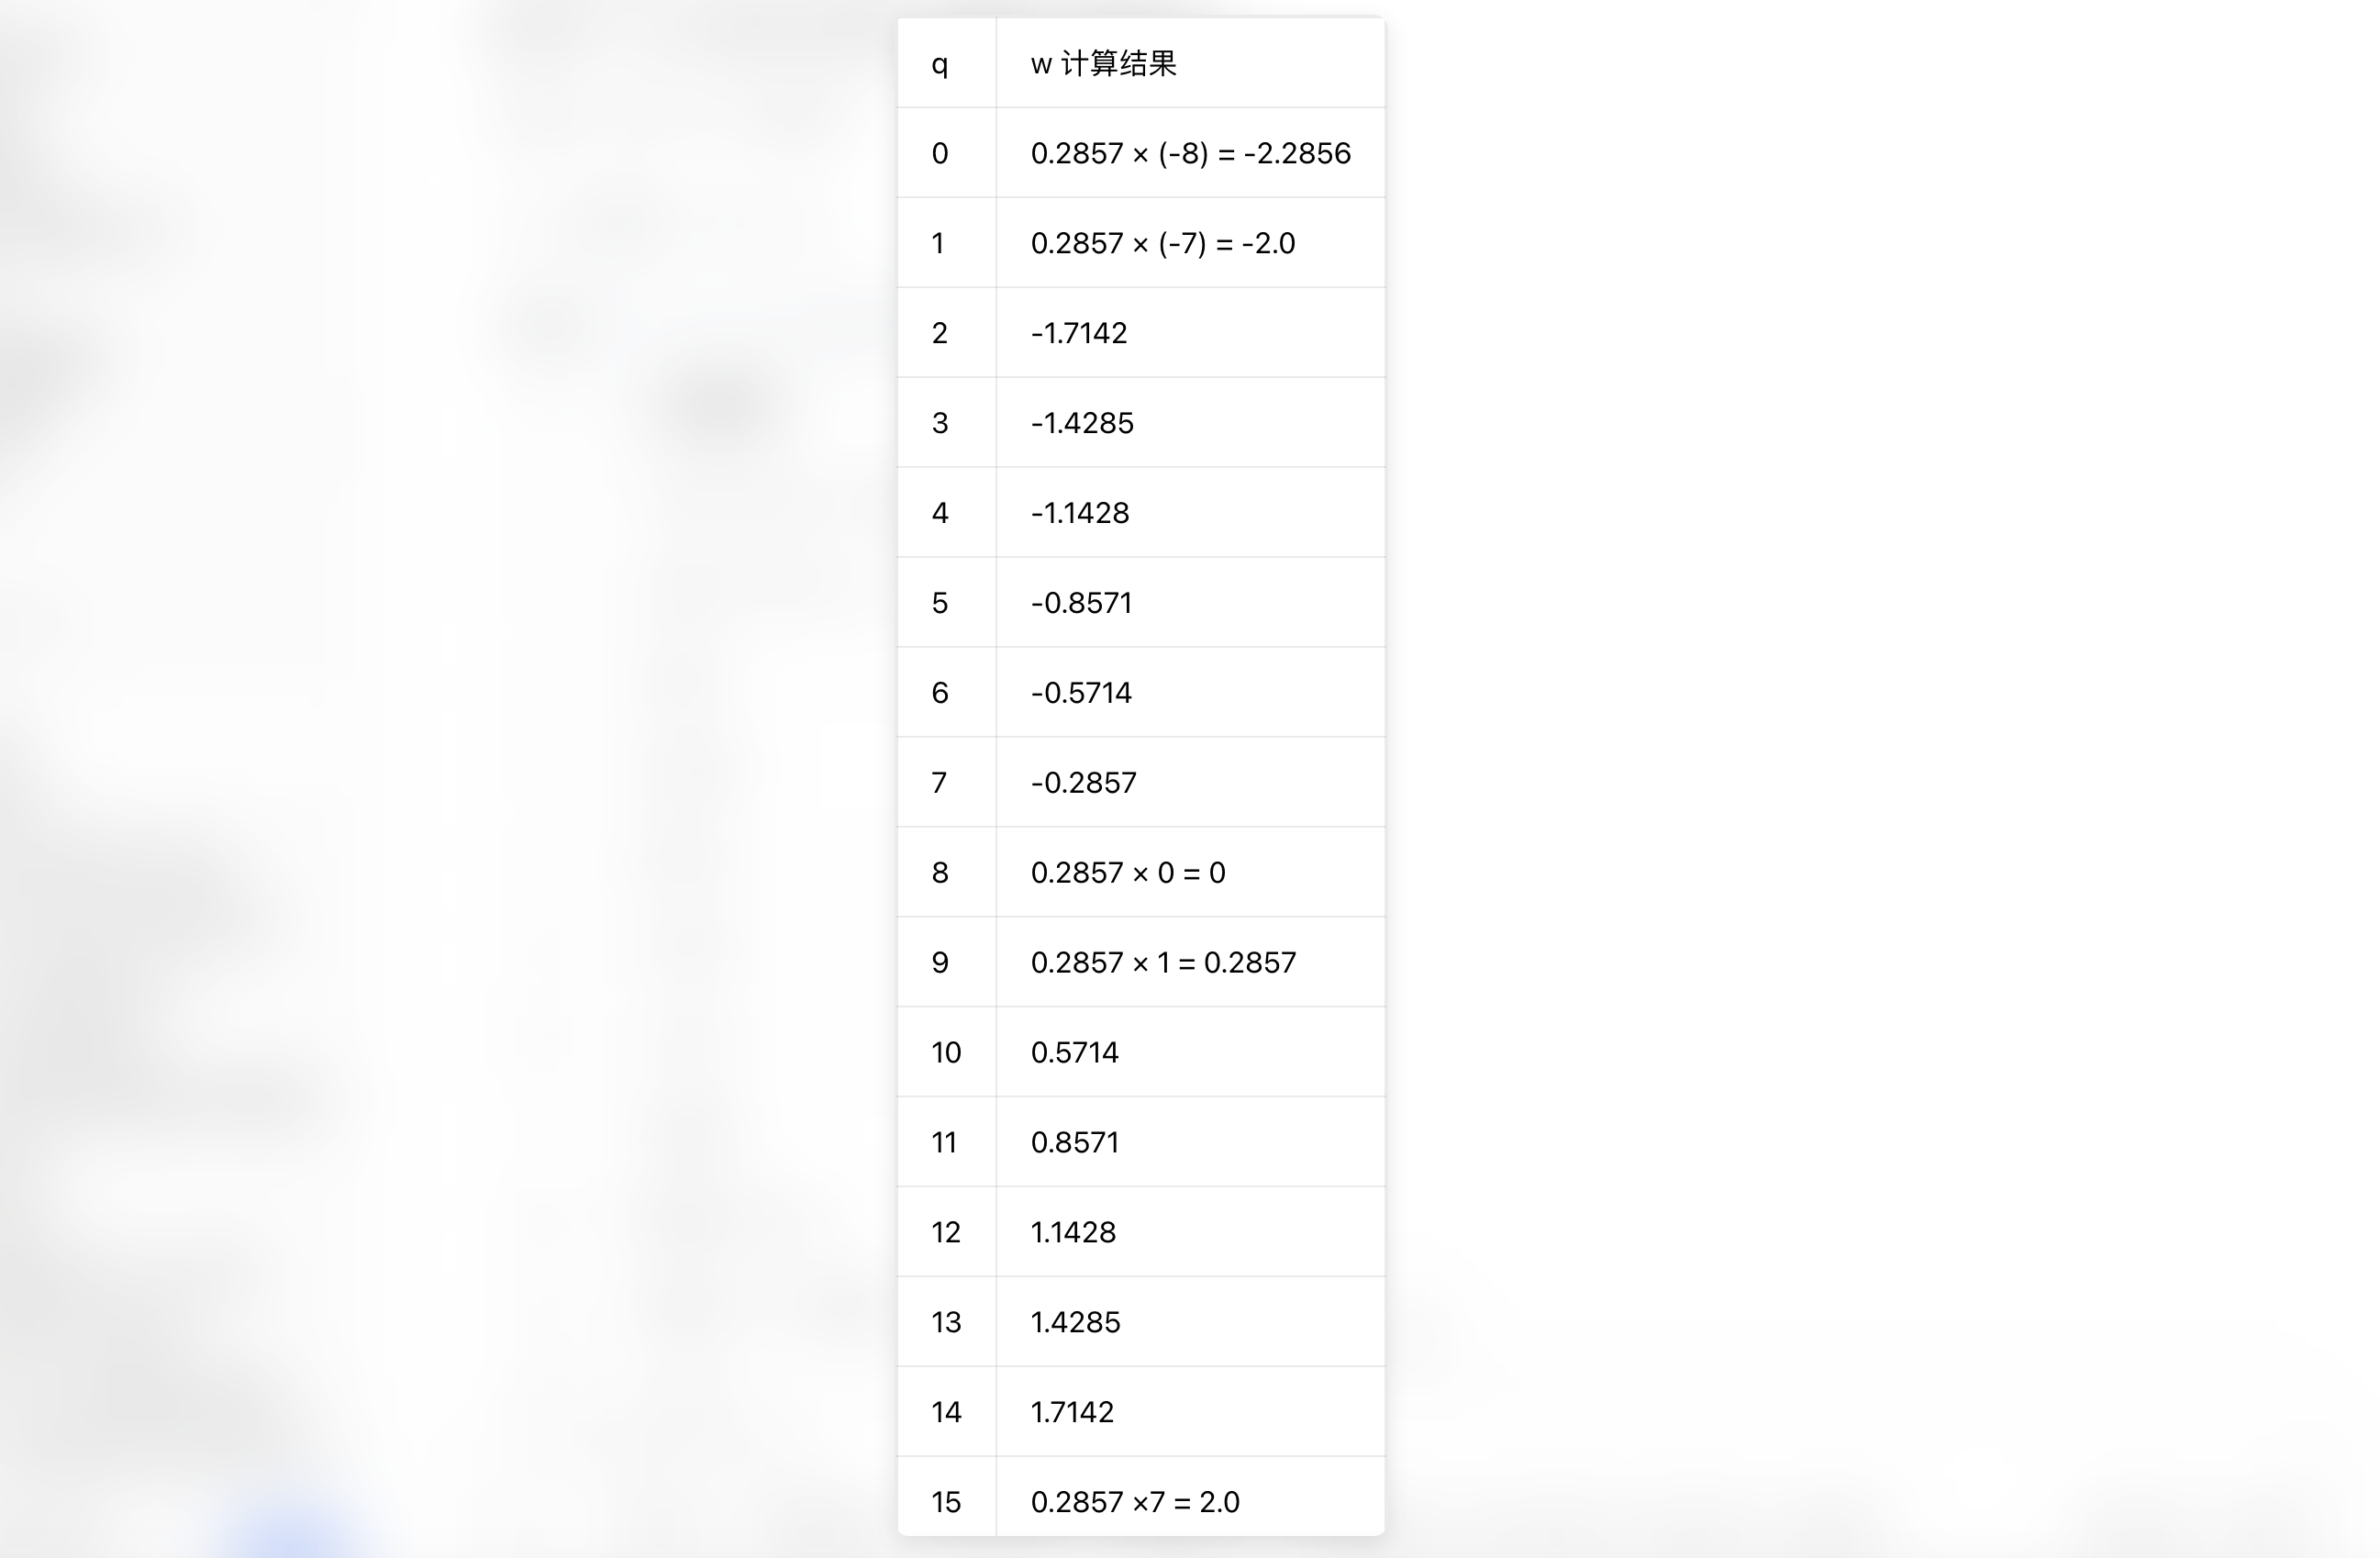
16 个 q 对应 16 个 w 点,范围:-2.2856 , 2.0,量化后多出来一截不用的区间 [-2.2856, 0.1)
8 个编码点完全闲置,没用
q=8~15:剩下 8 个编码点,对应 w:0 ~ 2.0。但这个例子真实起点是 0.1,不是 0
现在,只用 8 个点去覆盖区间 0.1, 2.0 ,区间长度 = 2.0 - 0.1 = 1.9,即 8 个点,相邻两点间隔 ≈ 1.9/7 ≈ 0.27
量化步长≈0.27。意思:真实权重落在两个编码点中间时,最多误差接近 0.135
K-quant 设计者观察到两件事
- 子块内权重的最小值 min很重要,不能硬编码;
- scale/min 这类统计参数不需要 FP16,可用低比特(6bit)相对值表达,由一个超块顶层系数(d 和 dmin,FP16)统一缩放
于是设计成:大超块做全局值域,内部 32 权重子块带独立 min + 压缩后的 scale,用微小的计算代价,显著降低量化误差