文章目录
- 前言
- 零、论文基本信息
- [一、背景与问题:为什么 RL Agent 不会主动探索](#一、背景与问题:为什么 RL Agent 不会主动探索)
-
- [1. 预训练知识既是优势,也是探索偏置](#1. 预训练知识既是优势,也是探索偏置)
- [2. 非参数记忆能救急,却没有改变模型本身](#2. 非参数记忆能救急,却没有改变模型本身)
- [3. 纯参数 RL 又缺少足够好的探索数据](#3. 纯参数 RL 又缺少足够好的探索数据)
- [二、相关工作:EMPO² 改变了记忆的角色](#二、相关工作:EMPO² 改变了记忆的角色)
-
- [1. Verbal RL:把失败写成经验](#1. Verbal RL:把失败写成经验)
- [2. Offline RL 与 Online RL](#2. Offline RL 与 Online RL)
- [3. Context Distillation](#3. Context Distillation)
- [4. 内在奖励与探索](#4. 内在奖励与探索)
- 三、方法总览:记忆先带路,参数再接管
- [四、预备知识:GRPO 在更新什么](#四、预备知识:GRPO 在更新什么)
-
- [1. 多步 Agent 轨迹](#1. 多步 Agent 轨迹)
- [2. 组内相对优势](#2. 组内相对优势)
- [五、自生成记忆:给不同 rollout 建立语义连续性](#五、自生成记忆:给不同 rollout 建立语义连续性)
-
- [1. 记忆不是完整轨迹,而是一句话 tip](#1. 记忆不是完整轨迹,而是一句话 tip)
- [2. 当前策略既是行动者,也是反思者](#2. 当前策略既是行动者,也是反思者)
- [3. 检索与存储实现](#3. 检索与存储实现)
- [六、三种训练模式:EMPO² 的核心结构](#六、三种训练模式:EMPO² 的核心结构)
-
- [1. 模式一:无记忆 rollout + on-policy update](#1. 模式一:无记忆 rollout + on-policy update)
- [2. 模式二:带记忆 rollout + on-policy update](#2. 模式二:带记忆 rollout + on-policy update)
- [3. 模式三:带记忆 rollout + off-policy update](#3. 模式三:带记忆 rollout + off-policy update)
- [4. 为什么它是奖励引导的蒸馏](#4. 为什么它是奖励引导的蒸馏)
- [七、稳定 off-policy 更新:低概率 token mask](#七、稳定 off-policy 更新:低概率 token mask)
-
- [1. 为什么直接蒸馏会崩溃](#1. 为什么直接蒸馏会崩溃)
- [2. 修改后的目标](#2. 修改后的目标)
- 八、状态新颖性奖励:避免探索再次收缩
- 九、训练算法串联
- 十、实验设置
-
- [1. 环境](#1. 环境)
- [2. 基线](#2. 基线)
- [3. 公平性设置](#3. 公平性设置)
- [4. 训练资源](#4. 训练资源)
- 十一、主实验一:ScienceWorld
-
- [1. 提升不是来自测试时继续查记忆](#1. 提升不是来自测试时继续查记忆)
- [2. 提升集中在需要跨步骤探索的任务](#2. 提升集中在需要跨步骤探索的任务)
- [3. 不是每个任务都最好](#3. 不是每个任务都最好)
- 十二、主实验二:WebShop
- 十三、分布外适应:参数已经学会"怎样使用记忆"
- 十四、消融实验:为什么三种模式必须并存
-
- [1. 移除 off-policy:记忆帮助探索,但没有完成内化](#1. 移除 off-policy:记忆帮助探索,但没有完成内化)
- [2. 移除带记忆 on-policy:teacher 本身训练不足](#2. 移除带记忆 on-policy:teacher 本身训练不足)
- [3. 两者互补](#3. 两者互补)
- 十五、超参数与辅助机制消融
-
- [1. Memory rollout probability p p p](#1. Memory rollout probability p p p)
- [2. Off-policy update probability q q q](#2. Off-policy update probability q q q)
- [3. 内在奖励](#3. 内在奖励)
- 十六、定性案例:一条失败经验怎样改变动作
- 十七、计算成本:训练更重,推理更轻
-
- [1. 记忆 rollout 的额外开销](#1. 记忆 rollout 的额外开销)
- [2. 总训练时间是否值得](#2. 总训练时间是否值得)
- [十八、与 Agent Memory 系列方法的横向比较](#十八、与 Agent Memory 系列方法的横向比较)
- [十九、对 Coding Agent、Tool Agent 与 Multi-Agent 的启发](#十九、对 Coding Agent、Tool Agent 与 Multi-Agent 的启发)
-
- [1. Coding Agent:把测试失败提示蒸馏为无提示修复能力](#1. Coding Agent:把测试失败提示蒸馏为无提示修复能力)
- [2. Tool Agent:将工具文档从永久依赖变成课程](#2. Tool Agent:将工具文档从永久依赖变成课程)
- [3. Multi-Agent:让专家提示成为训练期 teacher](#3. Multi-Agent:让专家提示成为训练期 teacher)
- [4. 记忆何时不该被内化](#4. 记忆何时不该被内化)
- 二十、局限性与复现风险
-
- [1. 只验证了一个 7B 模型](#1. 只验证了一个 7B 模型)
- [2. 环境仍是可控 benchmark](#2. 环境仍是可控 benchmark)
- [3. Tip 质量没有独立评估](#3. Tip 质量没有独立评估)
- [4. 简单相似度检索限制上限](#4. 简单相似度检索限制上限)
- [5. Off-policy 仍存在分布偏移](#5. Off-policy 仍存在分布偏移)
- [6. 主实验缺少更完整统计检验](#6. 主实验缺少更完整统计检验)
- [7. OOD 结论样本很少](#7. OOD 结论样本很少)
- [8. p p p 的定义存在文本不一致](#8. p p p 的定义存在文本不一致)
- [9. ScienceWorld 任务数量表述不一致](#9. ScienceWorld 任务数量表述不一致)
- [10. 内化可能带来不可逆错误](#10. 内化可能带来不可逆错误)
- 二十一、我的理解与启发
-
- [1. EMPO² 重新定义了 Memory Agent 的终点](#1. EMPO² 重新定义了 Memory Agent 的终点)
- [2. 真正的核心不是 on-policy 加 off-policy,而是条件移除](#2. 真正的核心不是 on-policy 加 off-policy,而是条件移除)
- [3. Reward 让反思从"说得合理"变成"做得有效"](#3. Reward 让反思从“说得合理”变成“做得有效”)
- [4. 外部记忆与参数记忆应该动态分工](#4. 外部记忆与参数记忆应该动态分工)
- [5. 更强的下一步是可逆内化](#5. 更强的下一步是可逆内化)
- 二十二、总结
- 参考资料
前言
在 Agent Memory 系列里,我们通常把记忆看作推理时的外部能力:模型本身不知道某段经验,但可以从记忆库里检索出来,临时放进上下文,再据此行动。
这种方式很有效,却留下了一个更深的问题:
如果 Agent 每次都必须查阅记忆才能做对,那么它究竟是"学会了",还是只是"每次都在看答案"?
这个问题在强化学习 Agent 中尤其明显。
假设 Agent 在 ScienceWorld 里接到"打开红色灯泡"的任务。当前房间里根本没有红色灯泡,但预训练模型容易机械执行指令,反复尝试"聚焦红色灯泡",每次都失败。GRPO 能看到一个标量奖励,却不知道失败发生在哪里,也无法把不同 rollout 之间的经验连接起来。
Reflexion 一类方法会让 Agent 回顾失败轨迹,生成一条自然语言经验,例如"红色灯泡不在走廊,下一次应该先搜索工作间"。这能帮助下一次探索,但如果没有这条 tip,模型依旧可能回到原来的错误行为。
EMPO² 试图打通外部记忆与参数学习之间的隔离:训练时允许记忆帮助 Agent 发现更好的轨迹,再通过离策略更新,让不读取记忆的策略也学会复现这些高收益行为。
EMPO² 的唯一核心增量,是把外部记忆从永久依赖的推理组件改造成训练期的探索脚手架,并通过混合 on-policy/off-policy 优化,将 tips 辅助发现的高收益行为选择性内化到无记忆策略参数中。
自生成 tips、状态新颖性奖励和低概率 token mask 都很重要,但它们分别服务于"找到更好的行为"和"稳定地完成内化",不是与混合优化并列的独立主线。
零、论文基本信息
- 论文名称:Exploratory Memory-Augmented LLM Agent via Hybrid On- and Off-Policy Optimization
- 发表平台:ICLR 2026
- 代码仓库 :Microsoft Agent Lightning:EMPO²(合并版本)
- 作者:Zeyuan Liu、Jeonghye Kim、Xufang Luo、Dongsheng Li、Yuqing Yang
一、背景与问题:为什么 RL Agent 不会主动探索
1. 预训练知识既是优势,也是探索偏置
LLM Agent 的初始能力来自预训练。它知道大量常识,也习惯选择语言上最自然、最符合既有知识的动作。
但交互环境可能有自己的规则。正确行为有时恰恰需要离开模型最熟悉的分布:进入陌生房间、尝试不确定动作、先寻找工具,再完成最终目标。
对普通 RL Agent 来说,这叫 exploration;对 LLM Agent 来说,它还意味着抵抗预训练先验。
论文用一个非常直观的失败说明问题。
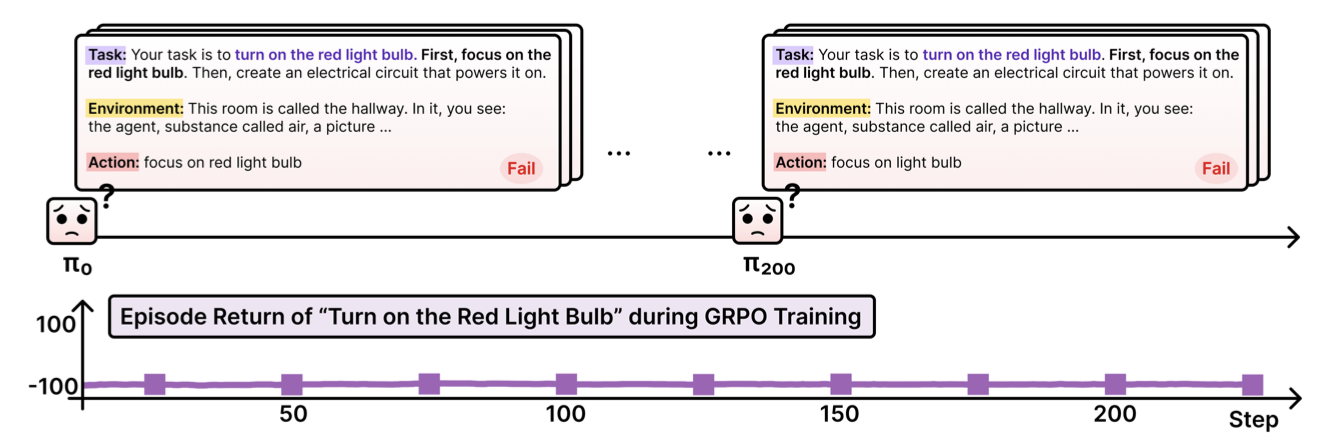
Figure 3:GRPO 的探索停滞。 Agent 反复执行"聚焦红色灯泡",却没有先搜索灯泡所在位置;训练继续进行,回报仍长期停留在失败区间。
任务要求打开红色灯泡,但当前走廊里没有灯泡。模型应该先去其他房间搜索。然而它把"先聚焦灯泡"理解成必须立即执行的动作,失败后又重复同样策略。
问题不只是奖励稀疏,而是不同 rollout 之间缺少语义连续性。一次失败只留下一个低分,没有留下"为什么失败、下次应该探索什么"的可复用结论。
2. 非参数记忆能救急,却没有改变模型本身
Reflexion、REMEMBERER 等方法把历史轨迹转化为反思、示例或 Q-value 记录,在下一轮作为上下文提供给模型。
这类 non-parametric update 有两个优点:
- 不需要更新模型参数;
- 可以迅速利用刚刚发生的经验。
但它们也有明显边界:参数固定时,模型对记忆的依赖不会消失;记忆拿掉后,能力可能随之消失。论文引用既有观察指出,只更新外部经验的性能容易较快饱和。
3. 纯参数 RL 又缺少足够好的探索数据
GRPO 等在线 RL 方法能够真正改变参数,但参数更新依赖采样轨迹。如果当前策略总在局部最优附近重复,训练数据本身就缺少成功行为。
于是形成一个循环:
探索不足 → 轨迹单一 → 奖励信号贫乏 → 参数更新仍停留在原策略附近 \text{探索不足}\rightarrow\text{轨迹单一}\rightarrow\text{奖励信号贫乏}\rightarrow\text{参数更新仍停留在原策略附近} 探索不足→轨迹单一→奖励信号贫乏→参数更新仍停留在原策略附近
EMPO² 的切入点是让两类更新互相引导:记忆先提高探索质量,参数更新再把有价值的探索结果吸收到模型中。
二、相关工作:EMPO² 改变了记忆的角色
1. Verbal RL:把失败写成经验
Reflexion 让模型对失败进行语言反思,在后续试验中将反思放进 prompt。它证明自然语言记忆可以弥补标量奖励信息不足。
EMPO² 继承了这一点,但目标不同:Reflexion 主要希望下一轮在 tip 帮助下取得更高回报;EMPO² 进一步要求这些收益能够沉淀到参数,使推理时不带 tip 也能行动。
2. Offline RL 与 Online RL
Retrospex 使用离线轨迹与 Q-function 学习策略;GRPO 和 GiGPO 则让当前策略在线采样并更新。
离线 RL 可以重复利用已有数据,却依赖数据质量;在线 RL 与当前策略分布一致,训练通常更稳定,但探索质量受当前策略限制。EMPO² 不是简单拼接两套数据,而是在同一训练循环里制造两种条件分布:有 tip 的行为策略和无 tip 的目标策略。
3. Context Distillation
Context distillation 让 teacher 在丰富提示下解决问题,再训练 student 在简化提示下复现输出。EMPO² 的 off-policy update 与之类似:
- teacher 条件:状态、任务、检索 tips;
- student 条件:只有状态和任务;
- 筛选信号:轨迹相对优势,而不是无差别模仿。
因此,论文将其称为 reward-guided knowledge distillation。
4. 内在奖励与探索
Count-based exploration、Random Network Distillation 和 Go-Explore 都用状态新颖性推动探索。EMPO² 也加入新颖性奖励,但它只是补充 Agent"去没去过的地方"的动力;真正让跨 rollout 经验可读、并最终内化的仍是 tips 与混合策略优化。
三、方法总览:记忆先带路,参数再接管
先看论文对整体效果的概括。
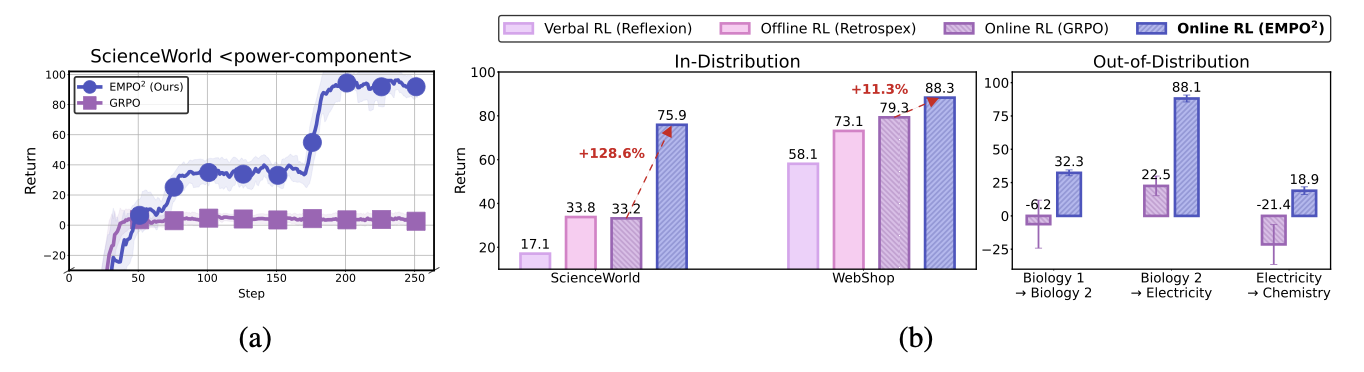
Figure 1:EMPO² 的主要结果。 左图显示 EMPO² 在
power-component上摆脱 GRPO 的局部停滞;中间比较 ScienceWorld 与 WebShop 的分布内结果;右图展示在新任务上仅靠少量记忆试验进行适应。
EMPO² 的训练循环可以概括为四步:
- Agent 分别进行无记忆 rollout 或带记忆 rollout;
- 每条轨迹结束后,当前策略自行总结一条 tip 并写入记忆;
- 无记忆轨迹按普通 on-policy 方式更新;带记忆轨迹可保留 tips 做 on-policy 更新,也可移除 tips 做 off-policy 更新;
- 新颖状态获得内在奖励,低概率 token 在 off-policy loss 中被 mask,以维持探索并稳定训练。
最终评测的重点不是"训练时带着更强记忆能得多少分",而是训练后的模型在测试时不使用记忆能得多少分。
四、预备知识:GRPO 在更新什么
1. 多步 Agent 轨迹
给定任务 u ∼ p ( U ) u\sim p(U) u∼p(U),策略 π θ \pi_\theta πθ 在状态 s t s_t st 下生成动作:
a t + 1 ∼ π θ ( ⋅ ∣ s t , u ) a_{t+1}\sim\pi_\theta(\cdot\mid s_t,u) at+1∼πθ(⋅∣st,u)
环境执行动作后返回奖励 r t + 1 r_{t+1} rt+1 与新状态。完整轨迹为:
τ = ( u , a 1 , r 1 , s 1 , a 2 , r 2 , ... , s T ) \tau=(u,a_1,r_1,s_1,a_2,r_2,\ldots,s_T) τ=(u,a1,r1,s1,a2,r2,...,sT)
轨迹回报是各步奖励之和:
R ( i ) = ∑ t = 1 T r t ( i ) R^{(i)}=\sum_{t=1}^{T}r_t^{(i)} R(i)=t=1∑Trt(i)
2. 组内相对优势
GRPO 对同一任务采样 N N N 条轨迹,并用组内均值与标准差构造相对优势:
A ( a t ( i ) ) = R ( i ) − 1 N ∑ j = 1 N R ( j ) σ ( R ) A(a_t^{(i)})=\frac{R^{(i)}-\frac{1}{N}\sum_{j=1}^{N}R^{(j)}}{\sigma(R)} A(at(i))=σ(R)R(i)−N1∑j=1NR(j)
高于组平均的轨迹获得正优势,低于平均的轨迹获得负优势。因此它不需要单独训练 value model。
基础 GRPO 目标可以写为:
E 1 N T ∑ i = 1 N ∑ t = 1 T min ( ρ θ ( a t ( i ) ) A ( a t ( i ) ) , clip ( ρ θ ( a t ( i ) ) , 1 − ϵ , 1 + ϵ ) A ( a t ( i ) ) ) − β D K L ( π θ ∥ π r e f ) \mathbb{E}\left \\frac{1}{NT}\\sum_{i=1}\^{N}\\sum_{t=1}\^{T} \\min\\left( \\rho_\\theta(a_t\^{(i)})A(a_t\^{(i)}), \\operatorname{clip}(\\rho_\\theta(a_t\^{(i)}),1-\\epsilon,1+\\epsilon)A(a_t\^{(i)}) \\right) \\right -\beta D_{KL}(\pi_\theta\Vert\pi_{ref}) ENT1i=1∑Nt=1∑Tmin(ρθ(at(i))A(at(i)),clip(ρθ(at(i)),1−ϵ,1+ϵ)A(at(i)))−βDKL(πθ∥πref)
其中重要性采样比率为:
ρ θ ( a t ( i ) ) = π θ ( a t ( i ) ∣ s t ( i ) , u ) π θ o l d ( a t ( i ) ∣ s t ( i ) , u ) \rho_\theta(a_t^{(i)})= \frac{\pi_\theta(a_t^{(i)}\mid s_t^{(i)},u)} {\pi_{\theta_{old}}(a_t^{(i)}\mid s_t^{(i)},u)} ρθ(at(i))=πθold(at(i)∣st(i),u)πθ(at(i)∣st(i),u)
ϵ \epsilon ϵ 限制单次更新幅度, β \beta β 控制与参考策略的 KL 距离。
EMPO² 不改变"高回报强化、低回报抑制"的基本逻辑;它改变的是动作由什么上下文采样,以及更新时策略是否仍能看到同一份 tips。
五、自生成记忆:给不同 rollout 建立语义连续性
1. 记忆不是完整轨迹,而是一句话 tip
EMPO² 的记忆缓冲区为:
M = { t i p 1 , t i p 2 , ... } \mathcal{M}=\{tip_1,tip_2,\ldots\} M={tip1,tip2,...}
当任务 u u u 的第 i i i 条 episode 在状态 s t s_t st 终止时,当前策略自己回顾轨迹并生成 tip:
t i p i ∼ π θ ( ⋅ ∣ s t , u , tip-generation prompt ) tip_i\sim\pi_\theta(\cdot\mid s_t,u,\text{tip-generation prompt}) tipi∼πθ(⋅∣st,u,tip-generation prompt)
tip 生成提示要求模型总结轨迹、获得了什么信息、距离完成任务还有多远,并限制为一行、100 词以内。
例如在电路任务中,Agent 会生成:
- 在厨房和浴室之间移动,但没有找到绿色导线或绿色灯泡;
- 聚焦了红色灯泡,却没有完成点亮任务;当前在走廊,需要先寻找路径;
- 绿色灯泡电路已经部分连接,但还缺少电池连接。
这些 tips 不一定是正确的完整策略,却比一个标量 − 100 -100 −100 提供了更具体的探索方向。
2. 当前策略既是行动者,也是反思者
论文没有另用 GPT-4 生成经验,tip 由不断更新的 π θ \pi_\theta πθ 自己产生。
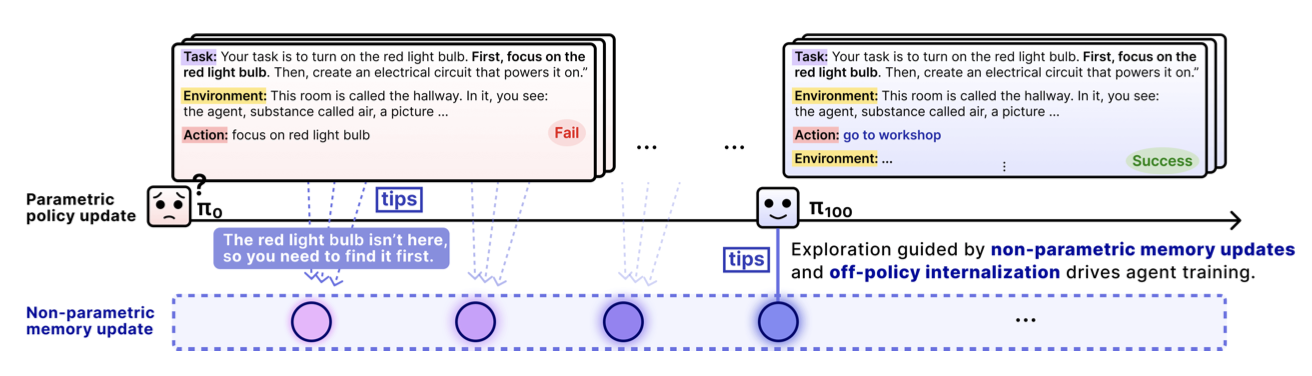
Figure 4:参数更新与非参数记忆更新的闭环。 当前策略回顾失败轨迹、生成 tips 写入记忆;后续 rollout 检索这些 tips,探索新行为,再通过策略更新沉淀能力。
这形成一个相互促进的过程:
策略变强 → 反思质量提高 → 记忆引导更有效 → 采样轨迹变好 → 策略继续变强 \text{策略变强}\rightarrow\text{反思质量提高}\rightarrow\text{记忆引导更有效}\rightarrow\text{采样轨迹变好}\rightarrow\text{策略继续变强} 策略变强→反思质量提高→记忆引导更有效→采样轨迹变好→策略继续变强
但它也存在自举风险:策略早期能力弱时,可能生成错误或空泛 tips;错误 tip 又会干扰后续探索。论文主要通过奖励筛选最终行为,而没有直接验证 tip 的事实正确率。
3. 检索与存储实现
在 ScienceWorld 实现中,记忆缓冲区最多保留 1000 条,超过后淘汰最旧内容。检索以当前对话/状态的 embedding 为键:
- 余弦相似度必须高于 0.5;
- 候选再按记录的 score 排序;
- 最多返回 10 条 tips;
- 重复文本不会重复写入。
这是简单的相似度检索,并没有复杂的图结构、时间关系或学习式 retriever。论文的主要提升因此不能归因于高级记忆检索器。
六、三种训练模式:EMPO² 的核心结构
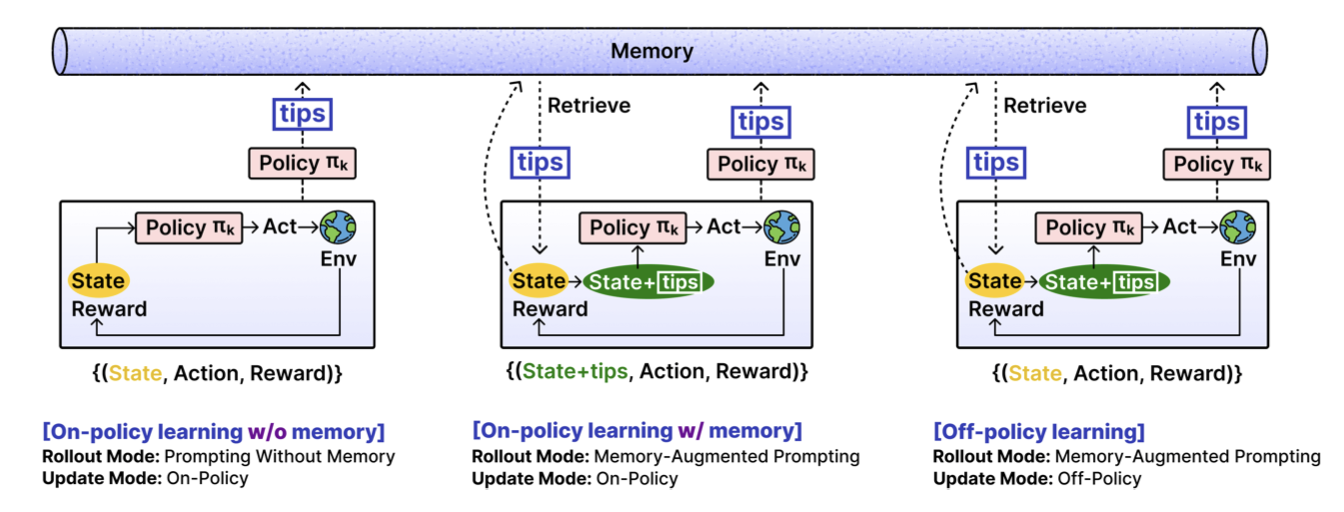
Figure 5:EMPO² 的三种训练模式。 从左到右分别是无记忆 on-policy、带记忆 on-policy,以及带记忆采样但移除 tips 更新的 off-policy 模式。
1. 模式一:无记忆 rollout + on-policy update
动作只依赖状态和任务:
a t + 1 ∼ π θ ( ⋅ ∣ s t , u ) a_{t+1}\sim\pi_\theta(\cdot\mid s_t,u) at+1∼πθ(⋅∣st,u)
采样策略与更新策略看到同样的输入,因此是标准 on-policy 学习。它维持无记忆策略的基本能力,也是最终推理形态的直接训练来源。
2. 模式二:带记忆 rollout + on-policy update
先从缓冲区检索与当前状态相关的 tips:
t i p s t = R e t r ( s t ; M ) tips_t=Retr(s_t;\mathcal{M}) tipst=Retr(st;M)
再生成动作:
a t + 1 ∼ π θ ( ⋅ ∣ s t , u , t i p s t ) a_{t+1}\sim\pi_\theta(\cdot\mid s_t,u,tips_t) at+1∼πθ(⋅∣st,u,tipst)
更新时也保留 tips,重要性比率为:
ρ θ t i p ( a t ) = π θ ( a t ∣ s t , u , t i p s t ) π θ o l d ( a t ∣ s t , u , t i p s t ) \rho_\theta^{tip}(a_t)= \frac{\pi_\theta(a_t\mid s_t,u,tips_t)} {\pi_{\theta_{old}}(a_t\mid s_t,u,tips_t)} ρθtip(at)=πθold(at∣st,u,tipst)πθ(at∣st,u,tipst)
这一模式训练模型"怎样使用记忆"。如果只有它,Agent 会越来越擅长在 tips 帮助下行动,却不能保证移除 tips 后仍然有效。
3. 模式三:带记忆 rollout + off-policy update
这是论文最关键的一步。
动作是在 tips 条件下采样的:
a t ∼ π θ o l d ( ⋅ ∣ s t , u , t i p s t ) a_t\sim\pi_{\theta_{old}}(\cdot\mid s_t,u,tips_t) at∼πθold(⋅∣st,u,tipst)
但更新当前策略时,重新计算不含 tips 的动作概率:
π θ ( a t ∣ s t , u ) \pi_\theta(a_t\mid s_t,u) πθ(at∣st,u)
相应重要性采样比率为:
ρ θ o f f ( a t ) = π θ ( a t ∣ s t , u ) π θ o l d ( a t ∣ s t , u , t i p s t ) \rho_\theta^{off}(a_t)= \frac{\pi_\theta(a_t\mid s_t,u)} {\pi_{\theta_{old}}(a_t\mid s_t,u,tips_t)} ρθoff(at)=πθold(at∣st,u,tipst)πθ(at∣st,u)
分母代表"带着 tip 的旧策略怎样产生动作",分子代表"当前无 tip 策略认为这个动作多自然"。两个策略的条件信息不同,因此属于 off-policy 更新。
4. 为什么它是奖励引导的蒸馏
可以把带 tips 的 rollout 看作 teacher demonstration,把无 tips 策略看作 student。
但 EMPO² 不会无差别模仿所有 teacher 行为:
- 当相对优势 A t > 0 A_t>0 At>0,无记忆策略提高该动作概率;
- 当 A t < 0 A_t<0 At<0,无记忆策略降低该动作概率。
所以记忆只负责提出候选探索方向,奖励决定哪些行为值得被内化。
这比普通 SFT 蒸馏多了一道"环境验证"。错误 tip 如果导致低回报轨迹,不会被当成正样本强化。
七、稳定 off-policy 更新:低概率 token mask
1. 为什么直接蒸馏会崩溃
带 tip 策略可能产生无 tip 策略几乎不可能生成的 token。此时重要性比率会非常大,导致梯度、entropy loss、KL loss 和 policy gradient loss 出现 NaN。
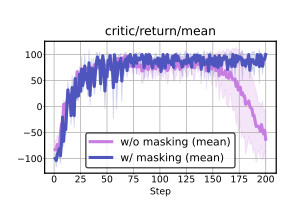
Figure 6:Token mask 稳定训练。 不做 mask 的训练后期回报发生明显崩塌;过滤低概率 token 后回报保持稳定。
2. 修改后的目标
论文为无 tip 策略概率低于阈值 δ \delta δ 的 token 屏蔽优势项:
E 1 N T ∑ i = 1 N ∑ t = 1 T min ( ρ θ ( i , t ) A ( a t ( i ) ) , clip ( ρ θ ( i , t ) , 1 − ϵ , 1 + ϵ ) A ( a t ( i ) ) ) 1 \[ π θ ( a t ( i ) ∣ s t ( i ) , u ) ≥ δ ] − β D K L ( π θ ∥ π r e f ) \mathbb{E}\left \\frac{1}{NT}\\sum_{i=1}\^{N}\\sum_{t=1}\^{T} \\min\\left( \\rho_\\theta\^{(i,t)}A(a_t\^{(i)}), \\operatorname{clip}(\\rho_\\theta\^{(i,t)},1-\\epsilon,1+\\epsilon)A(a_t\^{(i)}) \\right) \\mathbf{1}\\left\[\\pi_\\theta(a_t\^{(i)}\\mid s_t\^{(i)},u)\\ge\\delta\\right \right] -\beta D_{KL}(\pi_\theta\Vert\pi_{ref}) ENT1i=1∑Nt=1∑Tmin(ρθ(i,t)A(at(i)),clip(ρθ(i,t),1−ϵ,1+ϵ)A(at(i)))1\[πθ(at(i)∣st(i),u)≥δ]−βDKL(πθ∥πref)
指示函数 1 ⋅ \mathbf{1}\\cdot 1⋅ 的意义是:如果某 token 对无记忆策略过于陌生,就不强迫 student 立刻模仿。
这是一种保守内化。它牺牲一部分 teacher 提供的新行为,以避免过大的分布偏移摧毁训练。
八、状态新颖性奖励:避免探索再次收缩
EMPO² 另外维护一份不同状态列表。对新状态计算与历史状态的余弦相似度,如果低于阈值,就写入列表并给予内在奖励:
r i n t r i n s i c = 1 n r_{intrinsic}=\frac{1}{n} rintrinsic=n1
n n n 表示相似历史状态的数量。状态越少见,内在奖励越高。
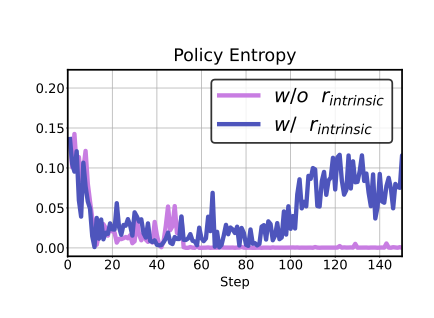
Figure 7:内在奖励维持策略熵。 加入状态新颖性奖励后,训练后期策略熵重新上升,说明行为没有过早收缩到单一模式。
这里要区分两类"memory":
- tip memory 存储自然语言反思,用于条件化动作;
- novelty memory 记录状态,用于计算新颖性奖励。
前者提供"应该尝试什么"的语义指导,后者提供"继续探索新状态"的数值激励。
九、训练算法串联
完整流程可以还原为:
- 从任务分布采样 B B B 个任务,每个任务建立 N N N 个环境副本;
- 选择无记忆或带记忆 rollout;
- 逐步生成动作并与环境交互,直到结束或达到最大步数;
- 对每条终止轨迹生成 tip,写入记忆;
- 如果是带记忆轨迹,再选择保留 tips 的 on-policy 更新,或移除 tips 的 off-policy 更新;
- 使用加入 token mask 的 GRPO loss 更新策略;
- 重复以上过程,让记忆与参数共同演化。
论文正文将 p p p 定义为 memory-rollout probability,将 q q q 定义为 off-policy update probability;消融部分也按这一含义解释。但 Appendix Algorithm 1 和成本分析中的 p p p、 1 − p 1-p 1−p 表述存在前后不一致。复现时应以代码实际配置为准,不能仅凭伪代码中的采样行确定概率语义。
十、实验设置
1. 环境
ScienceWorld
ScienceWorld 是文本交互式科学实验环境。任务需要长期多步规划、假设检验、工具寻找与动作探索。论文正文称选取 19 个任务,覆盖化学、分类、生物、电学和测量;但正式 Table 1 实际列出 18 个任务行,这也是复现时需要向代码配置核实的一处文本差异。
每个任务使用前 5 个 variant 训练,在 20 个未见 variant 上测试。失败任务会得到负奖励,return 范围为 − 100 , 100 -100,100 −100,100。
WebShop
WebShop 是 HTML 电商环境。Agent 根据用户要求搜索、导航并购买商品,最终奖励取决于商品属性和价格是否匹配。
2. 基线
- Naive Qwen2.5-7B-Instruct:不进行记忆或 RL 更新;
- Reflexion:非参数 verbal RL;
- Retrospex:offline RL;
- GRPO:online RL;
- GiGPO:在 WebShop 上通过相似 observation 分组改善 advantage estimation。
3. 公平性设置
所有主要实验以 Qwen2.5-7B-Instruct 为基础模型。ScienceWorld 的 GRPO 与 EMPO² 使用相同超参数;WebShop 也沿用 GiGPO 的训练配置。
Retrospex 原论文使用不同基础模型和人工启发式。作者将其统一为 Qwen2.5-7B-Instruct,并移除 teleport、延迟 focus 等手工规则,因此表中结果不是 Retrospex 原始论文数字,而是重新实现后的结果。
4. 训练资源
ScienceWorld 与 WebShop 在线 RL 均使用 8 张 NVIDIA A100 40GB GPU。ScienceWorld 每个 episode 最多 30 步,actor 学习率为 10 − 6 10^{-6} 10−6,GRPO group size 为 8;WebShop 每个 episode 最多 15 步,actor 学习率同样为 10 − 6 10^{-6} 10−6。
十一、主实验一:ScienceWorld
论文 Table 1 有 18 个任务行,完整复现会形成过宽表格。这里保留各主题任务结果与总体均值,数值均来自正式表格。
| 主题 | 任务 | Naive | Reflexion | Retrospex | GRPO | EMPO² |
|---|---|---|---|---|---|---|
| Chemistry | chemistry-mix | -42.0 | 1.2 | 20.8 | 12.4 | 42.7 |
| Chemistry | paint-secondary-color | -33.0 | 0.0 | 27.8 | 7.1 | 33.3 |
| Chemistry | paint-tertiary-color | -33.9 | 36.9 | 7.6 | 42.6 | 39.2 |
| Classification | find-animal | -58.2 | 39.5 | 25.9 | 72.4 | 100.0 |
| Classification | find-living-thing | -65.1 | 36.6 | 20.6 | 68.7 | 100.0 |
| Classification | find-non-living-thing | -35.9 | 4.8 | 89.1 | 24.7 | 100.0 |
| Classification | find-plant | -47.1 | 15.1 | 23.0 | 46.2 | 100.0 |
| Biology 1 | identify-life-stages-1 | -48.9 | 9.2 | 19.0 | 17.9 | 36.2 |
| Biology 1 | identify-life-stages-2 | -50.7 | 33.8 | 11.0 | 39.5 | 56.3 |
| Biology 2 | lifespan-longest-lived | -51.8 | 44.6 | 55.0 | 78.2 | 100.0 |
| Biology 2 | lifespan-longest/shortest | -56.2 | 34.1 | 38.0 | 62.3 | 100.0 |
| Biology 2 | life-span-shortest-lived | -56.8 | 6.1 | 67.0 | 20.6 | 100.0 |
| Electricity | power-component | -90.0 | 6.3 | 8.2 | 15.1 | 94.3 |
| Electricity | renewable-vs-nonrenewable | -85.0 | 11.7 | 10.0 | 24.6 | 92.6 |
| Electricity | test-conductivity | -86.9 | 13.2 | 60.0 | 27.8 | 89.5 |
| Electricity | conductivity-unknown-sub | -81.7 | 2.6 | 65.5 | 9.5 | 71.4 |
| Measurement | melting-point-known-sub | -97.5 | 11.4 | 26.5 | 19.8 | 27.6 |
| Measurement | use-thermometer | -83.7 | 0.9 | 32.5 | 7.6 | 82.7 |
| Average | --- | -61.3 | 17.1 | 33.8 | 33.2 | 75.9 |
Table 1:ScienceWorld 未见任务变体上的 return。 EMPO² 平均达到 75.9,相比 GRPO 的 33.2 提高 42.7 分,即论文报告的 128.6% 相对提升。
1. 提升不是来自测试时继续查记忆
Table 1 对 EMPO² 的评测使用训练后的模型,测试时不带 memory。这个设置直接支撑论文的主张:训练期记忆带来的收益已部分进入参数,而不是只在 prompt 中暂存。
2. 提升集中在需要跨步骤探索的任务
power-component 从 GRPO 的 15.1 提升到 94.3,use-thermometer 从 7.6 提升到 82.7。它们都需要寻找物品、理解环境反馈并完成多步操作,符合 EMPO² 针对 hard exploration 的设计。
3. 不是每个任务都最好
在 chemistry-mix-paint-tertiary-color 上,GRPO 为 42.6,EMPO² 为 39.2。这说明混合优化并非无条件优于普通在线 RL;某些较熟悉或较少依赖探索的任务,额外 tips 与 off-policy 分布偏移未必有益。
同时,Retrospex 在部分任务显著低于 Reflexion,说明离线参数更新可能受数据分布限制。EMPO² 的优势来自在线探索与记忆引导同时存在,而不是"只要参数化就一定更好"。
十二、主实验二:WebShop
| 指标 | Naive | Reflexion | Retrospex | GRPO | GiGPO w/ std | GiGPO w/o std | EMPO² |
|---|---|---|---|---|---|---|---|
| Score | 26.4 | 58.1 | 73.1±4.1 | 79.3±2.8 | 84.4±2.9 | 86.2±2.6 | 88.3±2.6 |
| Success Rate | 7.8 | 28.8 | 60.4±3.9 | 66.1±3.7 | 72.8±3.2 | 75.2±3.8 | 76.9±4.1 |
Table 2:WebShop 三个随机种子的平均结果。 EMPO² 的 score 和成功率均最高,但相对强基线 GiGPO w/o std 的绝对增益分别只有 2.1 和 1.7。
论文强调相对 GRPO 的 11.3% score 提升:79.3 提升到 88.3。这个比较成立,但 WebShop 上更强的直接对手是 GiGPO。与 GiGPO w/o std 相比,优势明显小于 ScienceWorld,且标准差区间重叠。
因此更谨慎的结论是:EMPO² 在 WebShop 上保持最好均值,说明机制可以迁移到网页环境;但证据没有 ScienceWorld 那样压倒性,论文也未报告显著性检验。
十三、分布外适应:参数已经学会"怎样使用记忆"
论文把在一个任务训练后的模型迁移到新任务,不更新参数,只在 10 次试验中积累 memory。
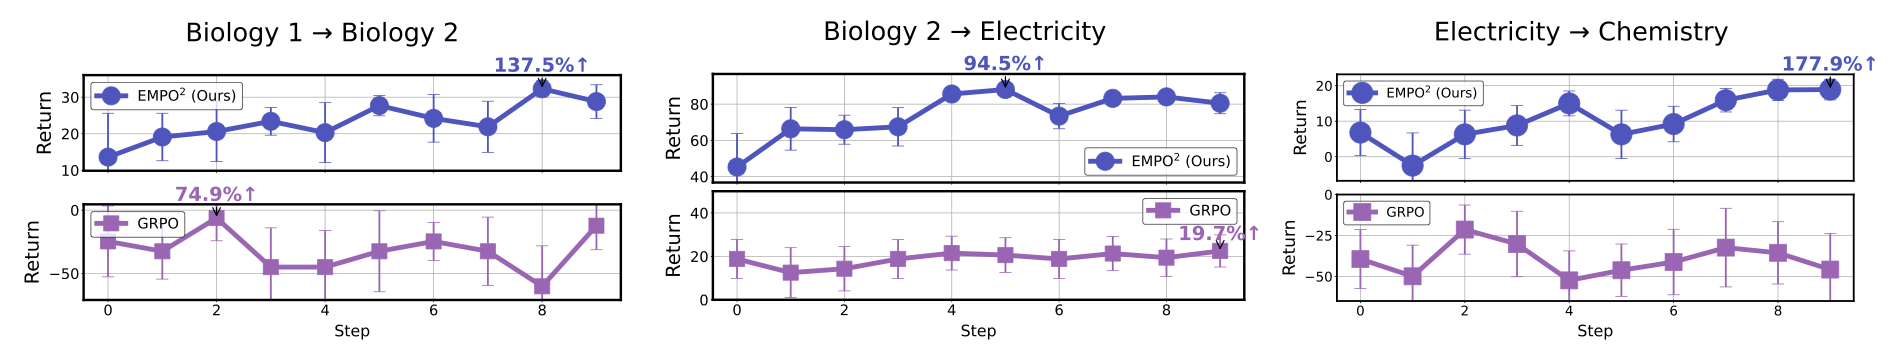
Figure 8:新任务上的快速适应。 Step 0 不使用记忆,后续步骤逐步积累 tips;EMPO² 在三个迁移场景中平均提高 136%,GRPO 的收益更不稳定。
三个迁移方向分别为:
- Biology 1 → Biology 2;
- Biology 2 → Electricity;
- Electricity → Chemistry。
EMPO² 在 step 0 已普遍高于 GRPO,说明无记忆基础策略本身更强;启用新任务记忆后又快速提高,说明训练还让策略学会了如何利用 tips。
但这个实验只有三个迁移组合,作者也将其称为 preliminary。136% 是三个场景中的平均相对改善,不应外推为任意 OOD 任务都能获得类似收益。
十四、消融实验:为什么三种模式必须并存
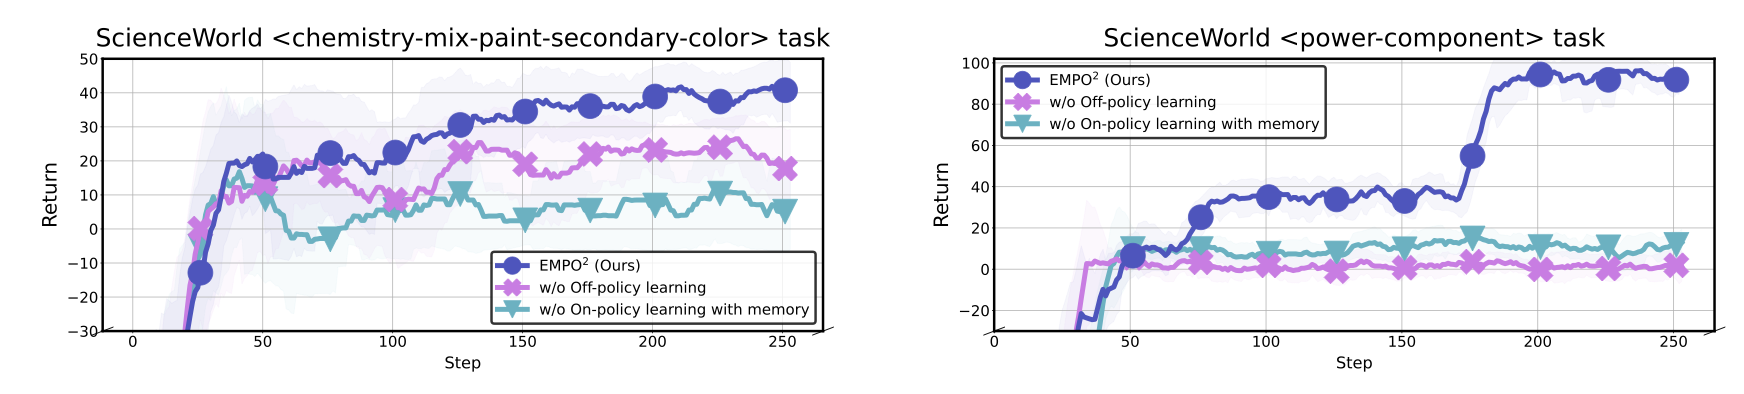
Figure 9:模式组合消融。 在化学混色与电路任务上,移除 off-policy 学习或移除带记忆 on-policy 学习都会降低收敛速度与最终回报。
1. 移除 off-policy:记忆帮助探索,但没有完成内化
如果只有带记忆 on-policy 更新,模型主要学习"看到 tips 时怎样做"。探索轨迹可能更好,却缺少将这些行为迁移到无 tips 分布的直接目标。
2. 移除带记忆 on-policy:teacher 本身训练不足
如果只做 off-policy distillation,带 tips 的策略没有得到充分 on-policy 强化,teacher 轨迹质量难以持续提高。低质量 teacher 再怎么蒸馏,也无法产生强 student。
3. 两者互补
带记忆 on-policy 让模型更会使用外部经验,off-policy 让模型逐步摆脱经验依赖。一个提升 teacher,一个训练 student;再加上无记忆 on-policy 维持基础策略分布,构成完整闭环。
十五、超参数与辅助机制消融
1. Memory rollout probability p p p
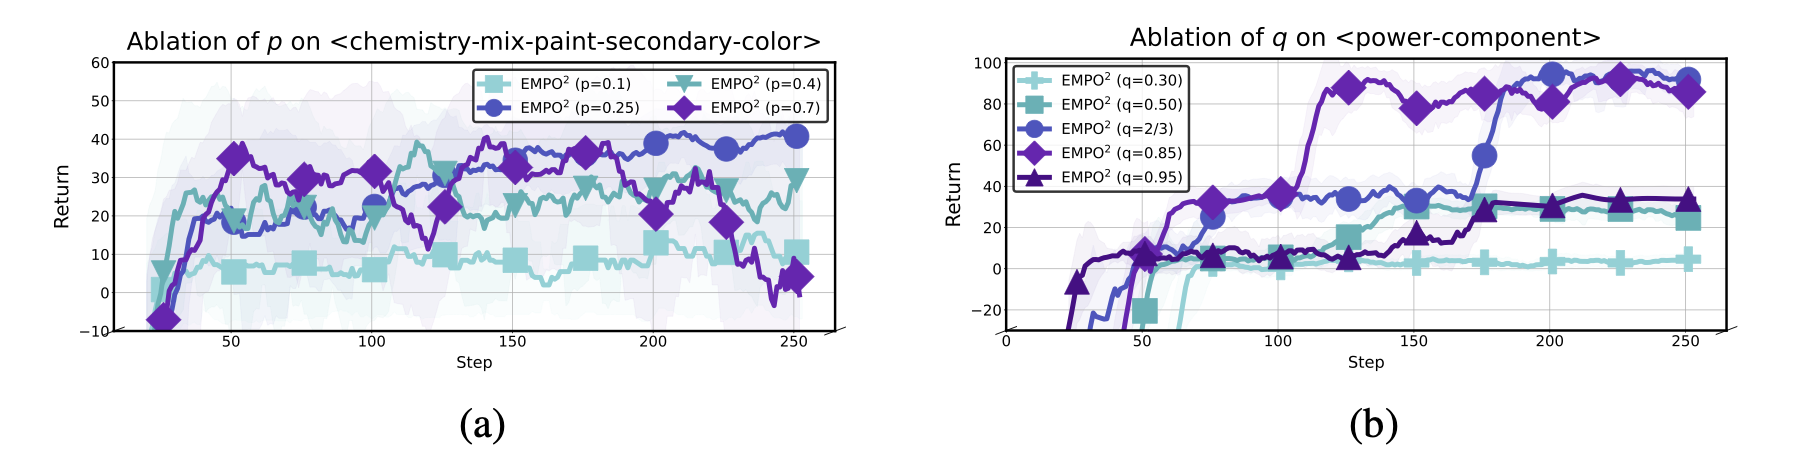
Figure 10:Rollout 与 update 概率消融。 左图改变带记忆 rollout 概率 p p p,右图改变 off-policy 更新概率 q q q;过低或过高都可能损害稳定性。
作者测试 p ∈ { 0.1 , 0.25 , 0.4 , 0.7 } p\in\{0.1,0.25,0.4,0.7\} p∈{0.1,0.25,0.4,0.7}:
- p = 0.1 p=0.1 p=0.1 时性能显著下降,接近普通 GRPO;
- p = 0.4 p=0.4 p=0.4 与 p = 0.7 p=0.7 p=0.7 初期学习更快;
- p = 0.7 p=0.7 p=0.7 后期波动更明显;
- 默认 p = 0.25 p=0.25 p=0.25 被选作跨任务稳定配置。
这说明记忆 rollout 太少时无法提供探索突破,太多时又可能让策略过度依赖 tips。
2. Off-policy update probability q q q
作者测试 q ∈ { 0.3 , 0.5 , 0.67 , 0.85 , 0.95 } q\in\{0.3,0.5,0.67,0.85,0.95\} q∈{0.3,0.5,0.67,0.85,0.95}:
- q q q 太小,知识内化速度慢;
- q q q 太大,过度强调 distillation,带记忆策略训练不足;
- q = 0.85 q=0.85 q=0.85 在特定任务上早期探索最快;
- 默认 q = 2 / 3 q=2/3 q=2/3 更重视跨任务稳健性。
3. 内在奖励
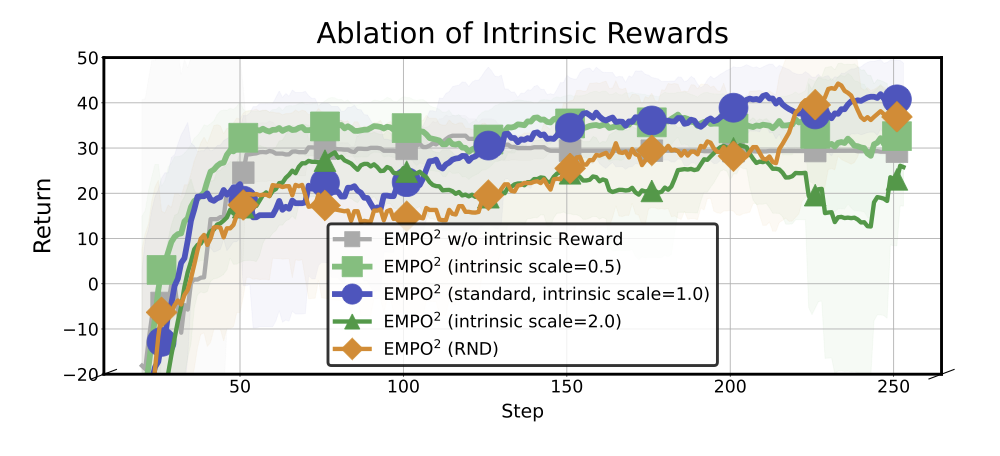
Figure 11:内在奖励消融。 0.5×、1×、2× 与 RND 最终收敛接近;完全移除内在奖励时,学习停在更低平台。
内在奖励的具体形式不是决定最终性能的唯一因素。缩小系数使收敛更平滑但更慢,放大系数增加轻微不稳定,RND 也能达到相近终点。
真正关键的是"有无探索激励":完全移除后策略更容易收缩到同质行为。这说明 EMPO² 的收益不是全部来自 tips;新颖性奖励也承担了防止探索坍缩的作用。
十六、定性案例:一条失败经验怎样改变动作
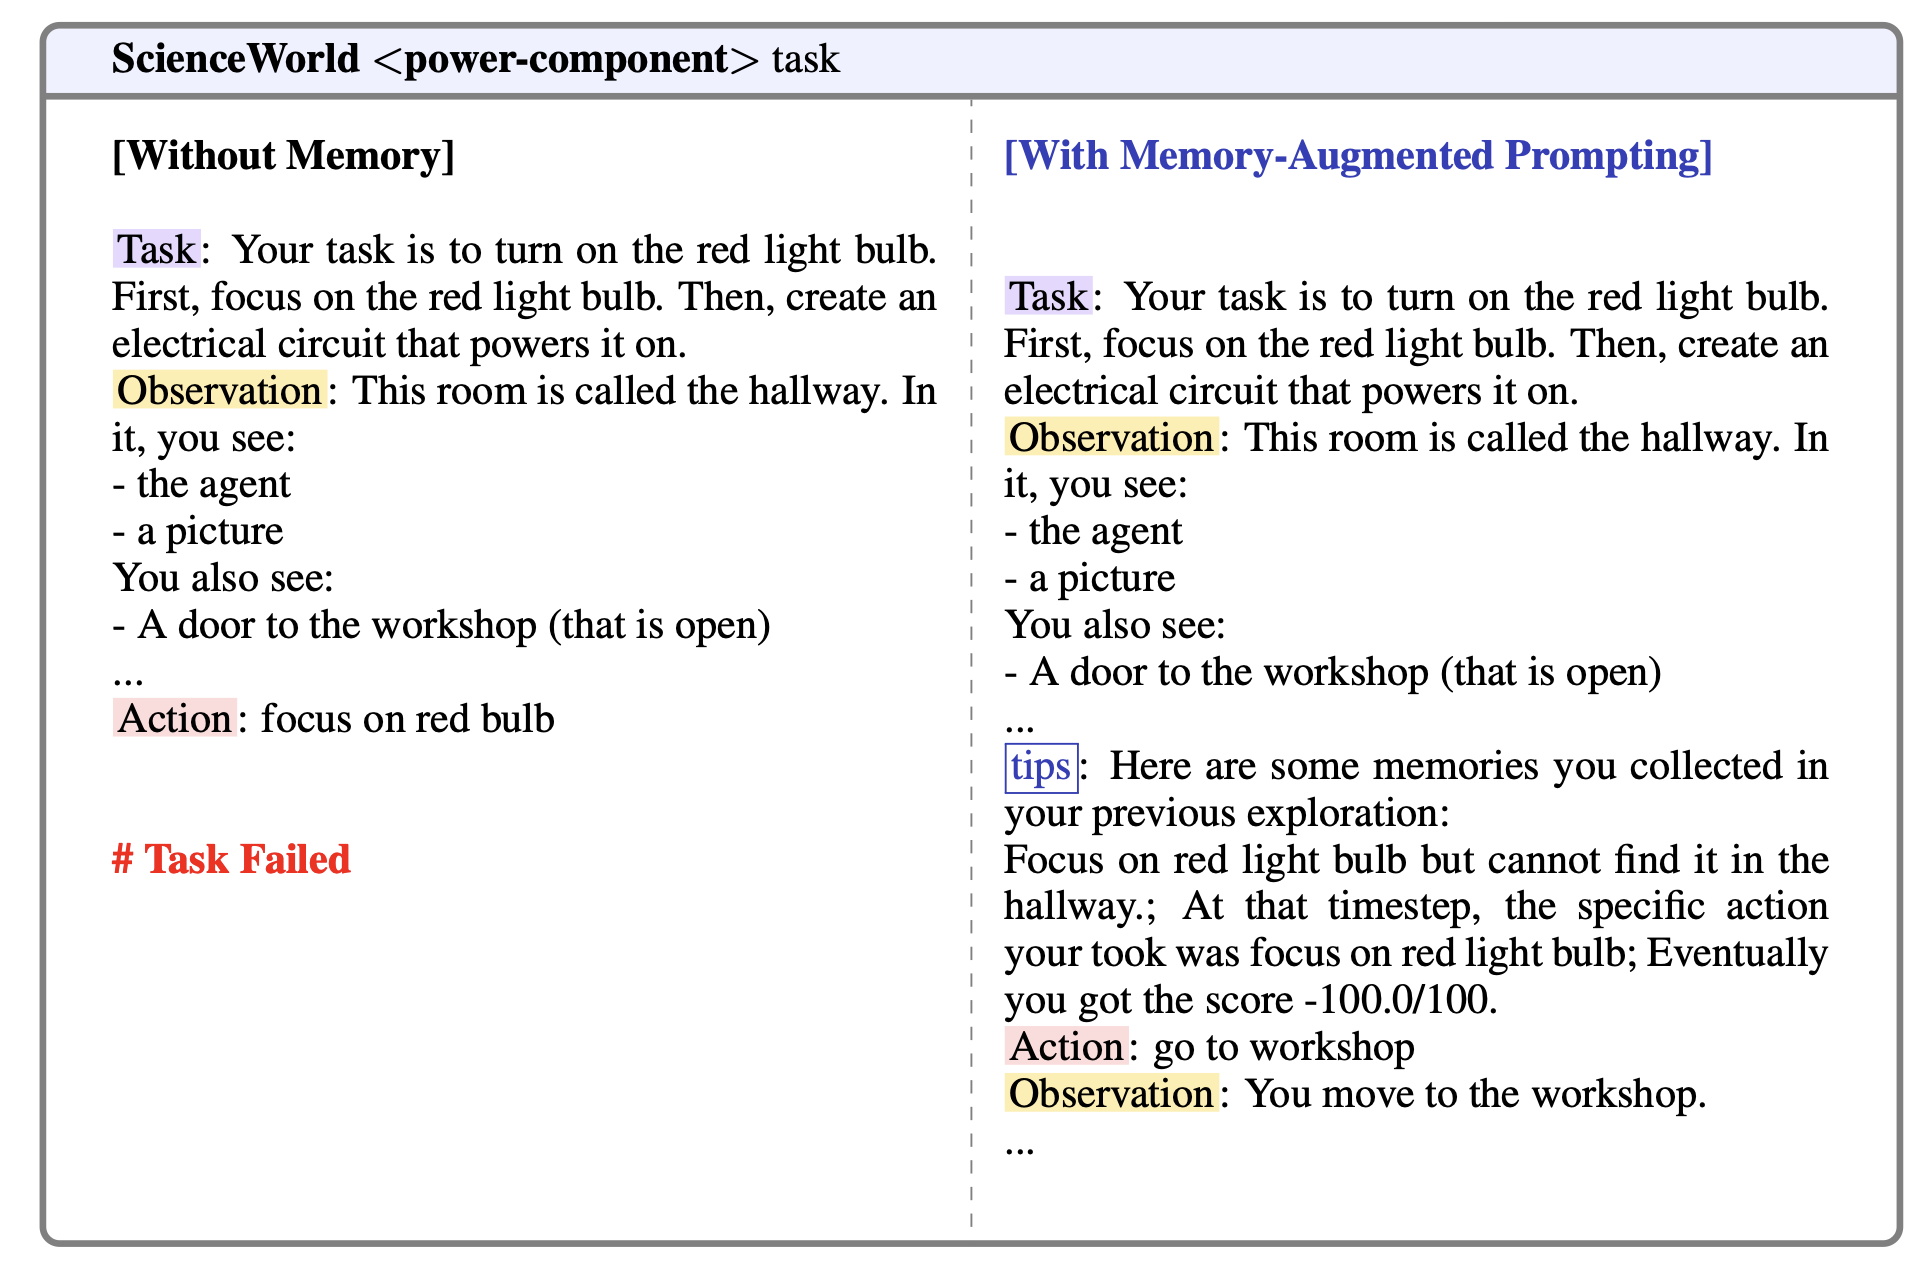
Appendix E.2:化学混色任务的探索案例。 无记忆策略在走廊里直接尝试倒颜料并失败;带记忆策略根据过去的失败信息,先前往艺术工作室寻找材料。
这个例子说明 tips 并不直接给出完整答案。它们提供局部负面信息:"当前地点没有足够材料""过去的倒颜料动作失败"。Agent 利用这些信息改变搜索方向。
这类负面经验很难从单一 scalar reward 中恢复,却很适合用自然语言保存。EMPO² 的贡献在于,不让这种经验永远停留在 prompt,而是把它产生的高回报行为继续用于参数更新。
十七、计算成本:训练更重,推理更轻
1. 记忆 rollout 的额外开销
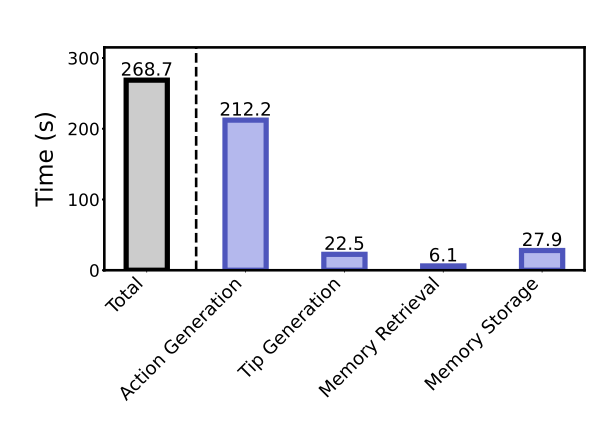
Figure 12:Rollout 时间分解。 总耗时 268.7 秒,其中动作生成 212.2 秒、tip 生成 22.5 秒、检索 6.1 秒、记忆存储 27.9 秒。
记忆机制增加约 50.4 秒,占总 rollout 时间约 19%。主要额外开销不是检索,而是 tip 生成和存储。
2. 总训练时间是否值得
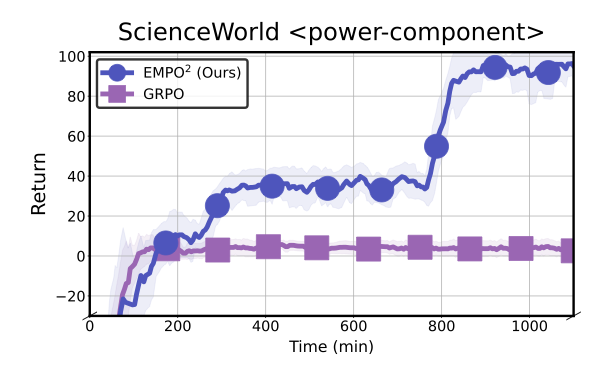
Figure 13:时间---性能曲线。 即使横轴改为训练分钟数而不是 step,EMPO² 仍明显早于 GRPO 达到高回报。
EMPO² 的单步更慢,而且带 tips 后响应通常更长,log-prob 计算和 actor 更新也更贵。但如果它能显著减少达到目标性能所需的训练步数,总体 sample efficiency 与 wall-clock efficiency 仍可能更好。
它的成本结构体现了"训练期多花钱,推理期少依赖"的取舍:最终评测不需要 memory,因此部署时不承担持续检索和长 prompt 成本。
十八、与 Agent Memory 系列方法的横向比较
| 方法 | 记忆的主要角色 | 是否更新参数 | 推理时是否依赖记忆 | 与 EMPO² 的关键差异 |
|---|---|---|---|---|
| A-MEM | 自主构建与组织经验 | 通常否 | 是 | 强调记忆写入与组织;EMPO² 强调把记忆诱导出的行为内化 |
| MAGMA | 多关系图上的记忆检索 | 通常否 | 是 | MAGMA 改善结构化检索;EMPO² 使用简单检索,把创新放在训练目标 |
| CoM | 压缩长期上下文并保真 | 通常否 | 是 | CoM 解决记忆规模;EMPO² 解决记忆能力如何进入参数 |
| ReMemR1 | 写入时主动回访历史 | 可涉及训练策略 | 是 | ReMemR1 优化记忆形成;EMPO² 优化 tips 条件轨迹的参数蒸馏 |
| Mem²Evolve | 让记忆机制持续演化 | 视实现而定 | 通常是 | Mem²Evolve 关注记忆系统自身演化;EMPO² 关注外部记忆向内在策略迁移 |
| Reflexion | 用语言反思指导下次试验 | 否 | 是 | EMPO² 继承 verbal memory,并通过 reward-guided off-policy update 降低依赖 |
| EMPO² | 训练期探索脚手架与 teacher context | 是 | 主结果不依赖 | 在有 tips 采样、无 tips 更新之间建立能力迁移 |
EMPO² 在 Agent Memory 演进中的位置很特别:它不是更强的存储或检索框架,而是在追问"外部记忆能否转化为模型自身能力"。
这也意味着它与 A-MEM、MAGMA、CoM 并非替代关系。更强的记忆组织可以产生更准确的 tips,更好的压缩可以降低训练上下文成本;EMPO² 则提供把这些非参数收益进一步参数化的训练接口。
十九、对 Coding Agent、Tool Agent 与 Multi-Agent 的启发
以下内容是基于论文机制的工程推演,不是论文已完成的实验。
1. Coding Agent:把测试失败提示蒸馏为无提示修复能力
Coding Agent 可以把失败测试、编译错误和 code review 意见总结成 tips,在下一轮修复时提供给模型。传统做法到此结束;EMPO² 的思路还会:
- 用 tips 引导 Agent 找到通过测试的轨迹;
- 以测试结果作为 reward;
- 去掉 tips,训练基础策略复现成功 patch。
这样,常见的调试模式有机会进入模型参数,而不是每次都重新检索同一条经验。
2. Tool Agent:将工具文档从永久依赖变成课程
对陌生 API,初期可以检索调用示例和错误处理建议。成功轨迹经奖励验证后,再蒸馏给不含文档上下文的策略。
不过生产环境中的 API 会变化,完全移除检索并不安全。更合理的分工是:稳定操作模式内化,版本、权限和实时参数继续检索。
3. Multi-Agent:让专家提示成为训练期 teacher
一个专家 Agent 可以给执行 Agent 提供建议,执行 Agent 在建议条件下探索;随后移除专家消息,训练执行策略复现高收益决策。
这相当于把多 Agent 协作中的临时沟通,转化为单 Agent 的长期能力。但必须保留奖励或验证器,否则 student 可能把专家的错误意见一并内化。
4. 记忆何时不该被内化
EMPO² 的思路不适用于所有记忆:
- 用户隐私与个性化事实不应写入共享参数;
- 快速变化的 API 信息应保留为可更新外部知识;
- 带授权边界的工具凭证必须留在安全存储;
- 难以验证的反思不应仅因语言流畅就被蒸馏。
最适合内化的是稳定、可验证、可跨任务复用的行为模式。
二十、局限性与复现风险
1. 只验证了一个 7B 模型
主实验使用 Qwen2.5-7B-Instruct。不同规模、不同预训练分布的模型是否同样受益尚不明确。更强模型可能自行探索得更好,也可能生成质量更高的 tips;更小模型则可能无法可靠反思。
2. 环境仍是可控 benchmark
ScienceWorld 与 WebShop 能提供清晰奖励和有限动作空间。真实工具调用、开放网页、代码仓库或机器人环境的状态更嘈杂,奖励更延迟,错误探索也更昂贵。
3. Tip 质量没有独立评估
论文给出定性例子,却没有系统报告 tips 的正确率、可执行性、重复率或错误传播比例。性能提升证明整套系统有效,但不能说明自生成记忆本身总是高质量。
4. 简单相似度检索限制上限
作者承认当前只使用 similarity search。状态表述变化、长任务依赖和组合经验可能使相关 tip 无法被命中。未来可以引入结构化检索、轨迹图或学习式 retriever。
5. Off-policy 仍存在分布偏移
Token mask 只过滤无 tip 策略概率过低的 token,不能完全消除 teacher/student 条件差异。过强的 tips 可能产生 student 无法自然复现的行为,过度 mask 又会丢失最有新意的探索动作。
6. 主实验缺少更完整统计检验
WebShop 报告三个随机种子的均值与标准差,ScienceWorld 表中也有方差,但论文未报告显著性检验。尤其 WebShop 相对 GiGPO 的提升较小,证据强度应谨慎解读。
7. OOD 结论样本很少
新任务适应只展示三个任务迁移组合、十个 memory steps。结果很有启发性,但不足以证明广泛的跨领域泛化。
8. p p p 的定义存在文本不一致
正文和消融把 p p p 称为 memory rollout probability,Algorithm 1 的采样标签与成本分析中的 1 − p = 0.25 1-p=0.25 1−p=0.25 又呈现不同含义。复现者应检查官方代码中的实际分支概率,并记录所用 commit。
9. ScienceWorld 任务数量表述不一致
实验设置正文写有 19 个任务,Table 1 按行统计则是 18 个。它不影响表中平均分本身,但会影响数据划分和复现配置,不能仅靠论文叙述推断实际任务列表。
10. 内化可能带来不可逆错误
外部记忆可以删除、修正或降权;进入参数后的行为偏置更难定位和撤销。如果 reward 被投机、环境反馈错误或 tip 诱导出捷径,off-policy 蒸馏可能把坏策略固化。
二十一、我的理解与启发
1. EMPO² 重新定义了 Memory Agent 的终点
很多记忆系统把目标设为"检索到正确内容"。EMPO² 进一步提出:如果某类经验稳定、通用且被环境验证,那么系统应该逐步减少对外部记忆的依赖。
这可以看作一个能力迁移过程:
外部经验 → 上下文指导 → 成功行为 → 参数能力 \text{外部经验}\rightarrow\text{上下文指导}\rightarrow\text{成功行为}\rightarrow\text{参数能力} 外部经验→上下文指导→成功行为→参数能力
记忆不再只是数据库,也可以是模型自我改进的临时 curriculum。
2. 真正的核心不是 on-policy 加 off-policy,而是条件移除
如果带 tips rollout 后,更新时仍然保留 tips,模型只会学会"依赖提示做对"。EMPO² 的关键操作是更新时主动拿掉 teacher context,让 student 在信息更少的条件下解释同一动作。
这种设计可以推广到更多辅助信息:长链思维、工具示例、专家建议、检索文档、环境特权信息。训练时先借助它们发现正确行为,再尝试让更轻量的策略独立完成。
3. Reward 让反思从"说得合理"变成"做得有效"
自然语言 reflection 经常看起来很有道理,却未必真的改善行为。EMPO² 没有直接相信 tip,而是相信 tip 产生的轨迹是否获得更高回报。
这个原则值得保留:
不蒸馏反思文本本身,而蒸馏经过环境验证的行为结果。
4. 外部记忆与参数记忆应该动态分工
不是所有知识都应该内化,也不是所有经验都应该永久检索。
一个成熟 Agent 可能需要三层:
- 参数层:稳定、通用的技能与策略;
- 长期记忆层:个体经验、可更新事实和任务历史;
- 工作记忆层:当前任务状态与短期计划。
EMPO² 展示了从长期记忆层向参数层迁移的一种机制,但还缺少判断"何时迁移、迁移什么、何时撤销"的控制器。
5. 更强的下一步是可逆内化
如果未来把这种方法用于真实 Agent,仅有 reward-guided distillation 还不够。系统还需要:
- 记录每次参数更新对应的 memory 来源;
- 对被内化技能做独立回归测试;
- 发现 reward hacking 后能够定向回滚;
- 将隐私和用户特定信息排除在参数更新之外。
也就是说,外部记忆向参数能力迁移之后,还要保留可审计的 provenance。
二十二、总结
EMPO² 关注的不是"怎样存更多记忆",而是"怎样让 Agent 最终不必永远依赖记忆"。
它让当前策略回顾轨迹并生成 tips,用记忆增强 rollout 打破探索局部最优;再把带 tips 发现的轨迹分成 on-policy 与 off-policy 两种更新。最关键的 off-policy 模式在更新时移除 tips,以优势函数筛选高价值行为,将外部指导蒸馏进无记忆策略。
ScienceWorld 上,EMPO² 的平均 return 从 GRPO 的 33.2 提升到 75.9;WebShop score 从 79.3 提升到 88.3。更重要的是,这些主结果都在测试时不使用 memory。模式消融、概率消融与训练时间分析共同支持"记忆探索 + 混合内化"的有效性。
它仍有明显边界:模型规模单一、环境受控、tip 质量未系统评估、OOD 场景有限,off-policy 分布偏移也没有彻底解决。但这篇论文提供了一个重要方向:
好的 Agent Memory 不只应该在需要时把过去拿回来,还应该帮助模型把可验证、可复用的经验逐步变成自身能力。
参考资料
- Liu, Z. et al. Exploratory Memory-Augmented LLM Agent via Hybrid On- and Off-Policy Optimization. ICLR 2026.
- OpenReview 论文页面
- arXiv 论文页面
- EMPO² 项目页面
- Microsoft Agent Lightning:EMPO² 合并代码
- Shinn, N. et al. Reflexion: Language Agents with Verbal Reinforcement Learning. NeurIPS 2023.
- Zhang, Z. et al. Rememberer: Learning to Remember for Long-Horizon LLM Agents. 2023.
- Shao, Z. et al. DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models. 2024.
- Wang, R. et al. ScienceWorld: Is Your Agent Smarter than a 5th Grader? EMNLP 2022.
- Yao, S. et al. WebShop: Towards Scalable Real-World Web Interaction with Grounded Language Agents. NeurIPS 2022.