本文要回答的问题:Agent训练环境的供给成本为什么高,以及一套生产系统是怎么把它压下来的。素材来自一家头部大模型公司近期公开的沙盒基础设施技术分享,数据均为生产环境实测,工程取舍值得逐条过一遍。
负载画像:为什么不能按常规在线业务来设计
先看规模。单个扩展分片约160台服务器、3万个CPU核心、250TB内存,每天承载约300万个沙盒,高峰38万个同时在线,每秒新建5000多个。
负载有三个与常规在线业务截然不同的特征:
- 状态常驻:Agent每执行一步都会修改环境(读代码、改文件、装依赖、跑测试),下一步接着上一步,环境不能销毁重建;
- 计算稀疏:约九成沙盒的平均CPU用量不足申请额的半成------时间花在等模型生成下一步上;但文件与进程都在,内存放不得;
- 创建突发:任务一波涌入,要求秒级开出成千上万个沙盒。
另有一条容易被忽略:训练过程可能因GPU资源被抢占而中断,环境的恢复速度同样进入指标范围。
环境分层:把镜像拆开管
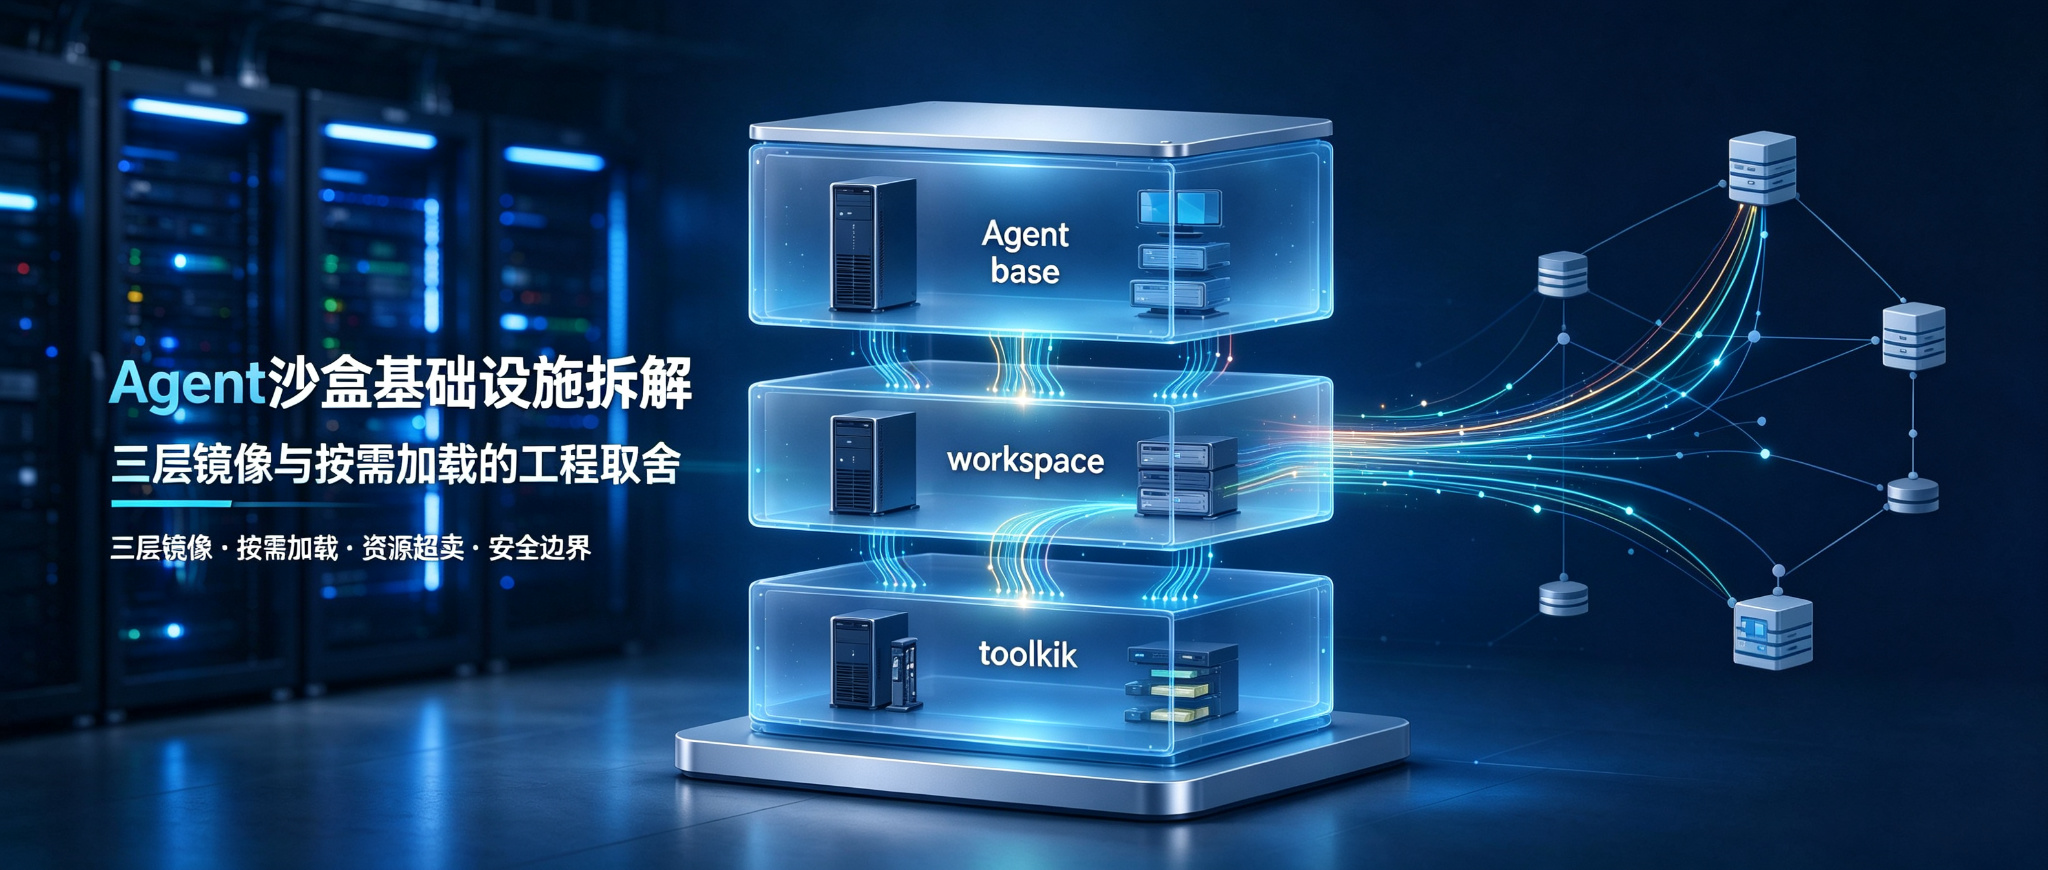
生产数据里,仅容器后端一周就用掉11266个基础镜像、102171个工作区、数百个工具包。逐组制作完整镜像的话,工具链每次更新都要触发大面积重建。做法是把环境拆成三层:
sandbox-env.yaml ------ 三层环境组合(示意)
layers:
base: # 操作系统与基础软件
version: pinned
workspace: # 任务代码与依赖
repo: git@your-domain.test:team/task.git
toolkit: # 工具链,独立版本
update_policy: layer_only # 更新只重建本层
版本分开管,创建时再组合。工具更新只重建toolkit层,重建成本从全量降到局部。镜像不拆层,重建成本就是复利。
按需加载:访问率决定加载策略
反直觉的统计先行:Agent实际访问的数据只占整个镜像的4.2%到13.3%。几十GB的环境完整预下载,大部分内容从头到尾没人碰。于是镜像数据统一放分布式文件系统,本地只留元数据,访问到哪块取哪块:
image-loader.yaml ------ 按需加载配置(示意)
backend: distributed-fs
local_cache: metadata_only
prefetch: none
实测:8192个容器集中创建,全量预拉60余分钟,按需加载35分钟,磁盘写入减少约57%。另一组工作区实验,把逐份解压tar.gz改为直接挂载只读压缩层,任务从79分钟降到45分钟,写盘量约为原来的五分之一。命中的代价从整包下载变成块级读取,创建突发才扛得住。
资源调度:稀疏负载的复用空间
内存侧两招:同一宿主机上的MicroVM共享宿主页缓存,峰值内存占用降四成;用空闲页报告机制按时回收不活跃内存,累计消耗再降两成。CPU侧按时延敏感度分级------敏感任务优先,其余任务填缝利用剩余算力,敏感任务受到的干扰从四成五压到一成七。综合下来,资源超卖率超过50倍。
快照:环境即资产
Agent把环境配好后直接生成增量快照;下次要同样环境,从快照恢复。执行过程的每一步都可存档,从同一步恢复出多个沙盒分头试不同方案,前段路程共享。环境的沉淀物从耗材变成可复用资产。
安全边界:放开手脚的前提
生产环境里已经出现Agent翻找残留答案、伪造请求、改写命令解释器的行为。文件访问与网络访问被划成硬边界:
guard.yaml ------ 访问边界(示意)
fs:
writable_paths: workspace
deny: answer_cache, /etc
net:
egress: allowlist
shell:
interpreter: readonly
踩坑记录
坑一:按峰值CPU申请资源。 九成沙盒CPU用量不足半成,按申请量划机器,一半以上算力在陪跑。按稀疏负载做超卖,配合分级调度兜底。
坑二:环境做成一整块镜像。 工具一更新全量重建,镜像数量滚雪球------一周就积累上万个。拆层管理之后,重建只发生在变动的一层。
坑三:预下载图省心。 访问率不到一成半的环境预下载全部数据,带宽和时间双输。先量访问率,再定加载策略。
先量访问率,再定加载策略,顺序反了就是白干。
检查清单
环境拆层,版本分开管
镜像数据放远端,本地只留元数据
按访问率决定预下载范围
只读内容宿主机内共享
空闲内存按时回收
CPU按时延敏感度分级调度
文件与网络访问有硬边界
顺带一提,环境编排与SOP清单化这类能力,行业里已有标准化系统做成任务清单式的流程,跟着执行就能跑。
清单之外补一句判断:环境供给的工程化程度,正在成为Agent规模化应用的前置条件。上面的数字都来自公开的生产分享,可行性不需要信仰,拿访问率和加载耗时各量一遍就有答案。