🔥 星光编译者 · 个人主页
📚 学习专栏: 《C/C++ 成长笔记》 · 《Linux 实践手册》 · 《数据结构与算法》
🌄 向云端飞扬,编译属于自己的代码星河。
☕ 写在开篇
你好,这里是 星光编译者。
这里记录我在 C/C++、Linux、数据结构与算法 学习中遇到的真实问题、亲手验证过的代码,以及那些容易被忽略的实现细节。
比起简单罗列结论,我更愿意从问题出发,把一个知识点的来由讲清楚,把"为什么会这样"和"应该怎样解决"说明白,让每一次踩坑都沉淀成可以复用的经验。
如果这篇记录能帮你少绕一点路,或让某个模糊的地方忽然变得清晰,那么这次分享便有了意义。愿我们在一次次阅读、编译与调试中稳步向前,慢慢搭起属于自己的技术世界。
🔥 本文定位 :从"只会写单文件脚本"走向"会复用 Python 生态"。我们会理解模块与导入机制,使用标准库完成日期和目录任务,学习
pip、PyPI 与虚拟环境,再通过二维码、Excel、键盘监听和学生管理系统把多个能力组合起来。💡 学习目标 :能区分内置能力、标准库和第三方库;能解释
import的基本过程;会用python -m pip安装依赖并排查解释器不一致;能阅读第三方库文档;能给命令行项目加入存档,并使用 PyInstaller 构建可分发程序。📌 阅读说明 :本文根据课程 PDF《5.使用库》整理。示例面向 Python 3,并根据当前官方文档修正了课件中的旧方案:Excel 示例改用
openpyxl,安装命令优先使用解释器驱动的python -m pip,打包命令修正为pyinstaller,同时补充虚拟环境、依赖文件、路径对象和打包边界。
文章目录
- 一、为什么"会用库"是编程能力的一部分
- 二、先分清库、模块、包与发行包
- 三、import:不只是把文件复制进来
- 四、标准库实战:日期间隔计算
- 五、内置字符串能力:三道题看方法组合
- [六、目录搜索器:用 os.walk 遍历文件树](#六、目录搜索器:用 os.walk 遍历文件树)
- [七、第三方库、PyPI、pip 与虚拟环境](#七、第三方库、PyPI、pip 与虚拟环境)
- 八、第三方库实战一:生成二维码
- [九、第三方库实战二:读取 Excel 并统计](#九、第三方库实战二:读取 Excel 并统计)
- 十、第三方库实战三:监听按键与避免回调阻塞
- 十一、综合项目:命令行学生管理系统
- 十二、让数据跨越程序生命周期:存档与读档
- [十三、用 PyInstaller 打包与发布](#十三、用 PyInstaller 打包与发布)
- 十四、常见错误与排查清单
- 十五、高频问答与动手练习
- 总结
一、为什么"会用库"是编程能力的一部分
刚开始学习编程时,我们很容易产生一种错觉:真正厉害的程序员应该把所有代码都亲手写出来。可真实开发恰恰相反。成熟工程师通常会先问:
- Python 自己是否已经提供这个能力?
- 社区里是否有维护良好、文档清晰的实现?
- 现有工具是否满足许可证、安全性和性能要求?
- 哪一部分才是项目真正独有、必须自己实现的逻辑?
例如,要计算两个日期相隔多少天,如果自己处理每个月的天数、闰年规则和跨年情况,不仅代码很长,还容易在边界处出错。标准库 datetime 已经把这些规则封装成经过验证的对象,我们只需正确构造日期并相减。
再比如生成二维码。二维码涉及编码模式、版本、纠错级别和矩阵绘制。业务需求可能只是"把一个网址保存成可扫描图片",此时使用成熟库比从标准规范开始重写更合理。
**复用库不是偷懒,而是把有限精力放到更有价值的地方。**当然,"能安装"并不等于"会使用"。真正的能力还包括:
- 找到可信文档,而不是盲目复制旧博客中的命令;
- 读懂函数输入、返回值与异常;
- 知道依赖被安装到了哪个解释器;
- 能把版本记录下来,让别人复现环境;
- 了解第三方库带来的许可证、供应链和维护风险。
二、先分清库、模块、包与发行包
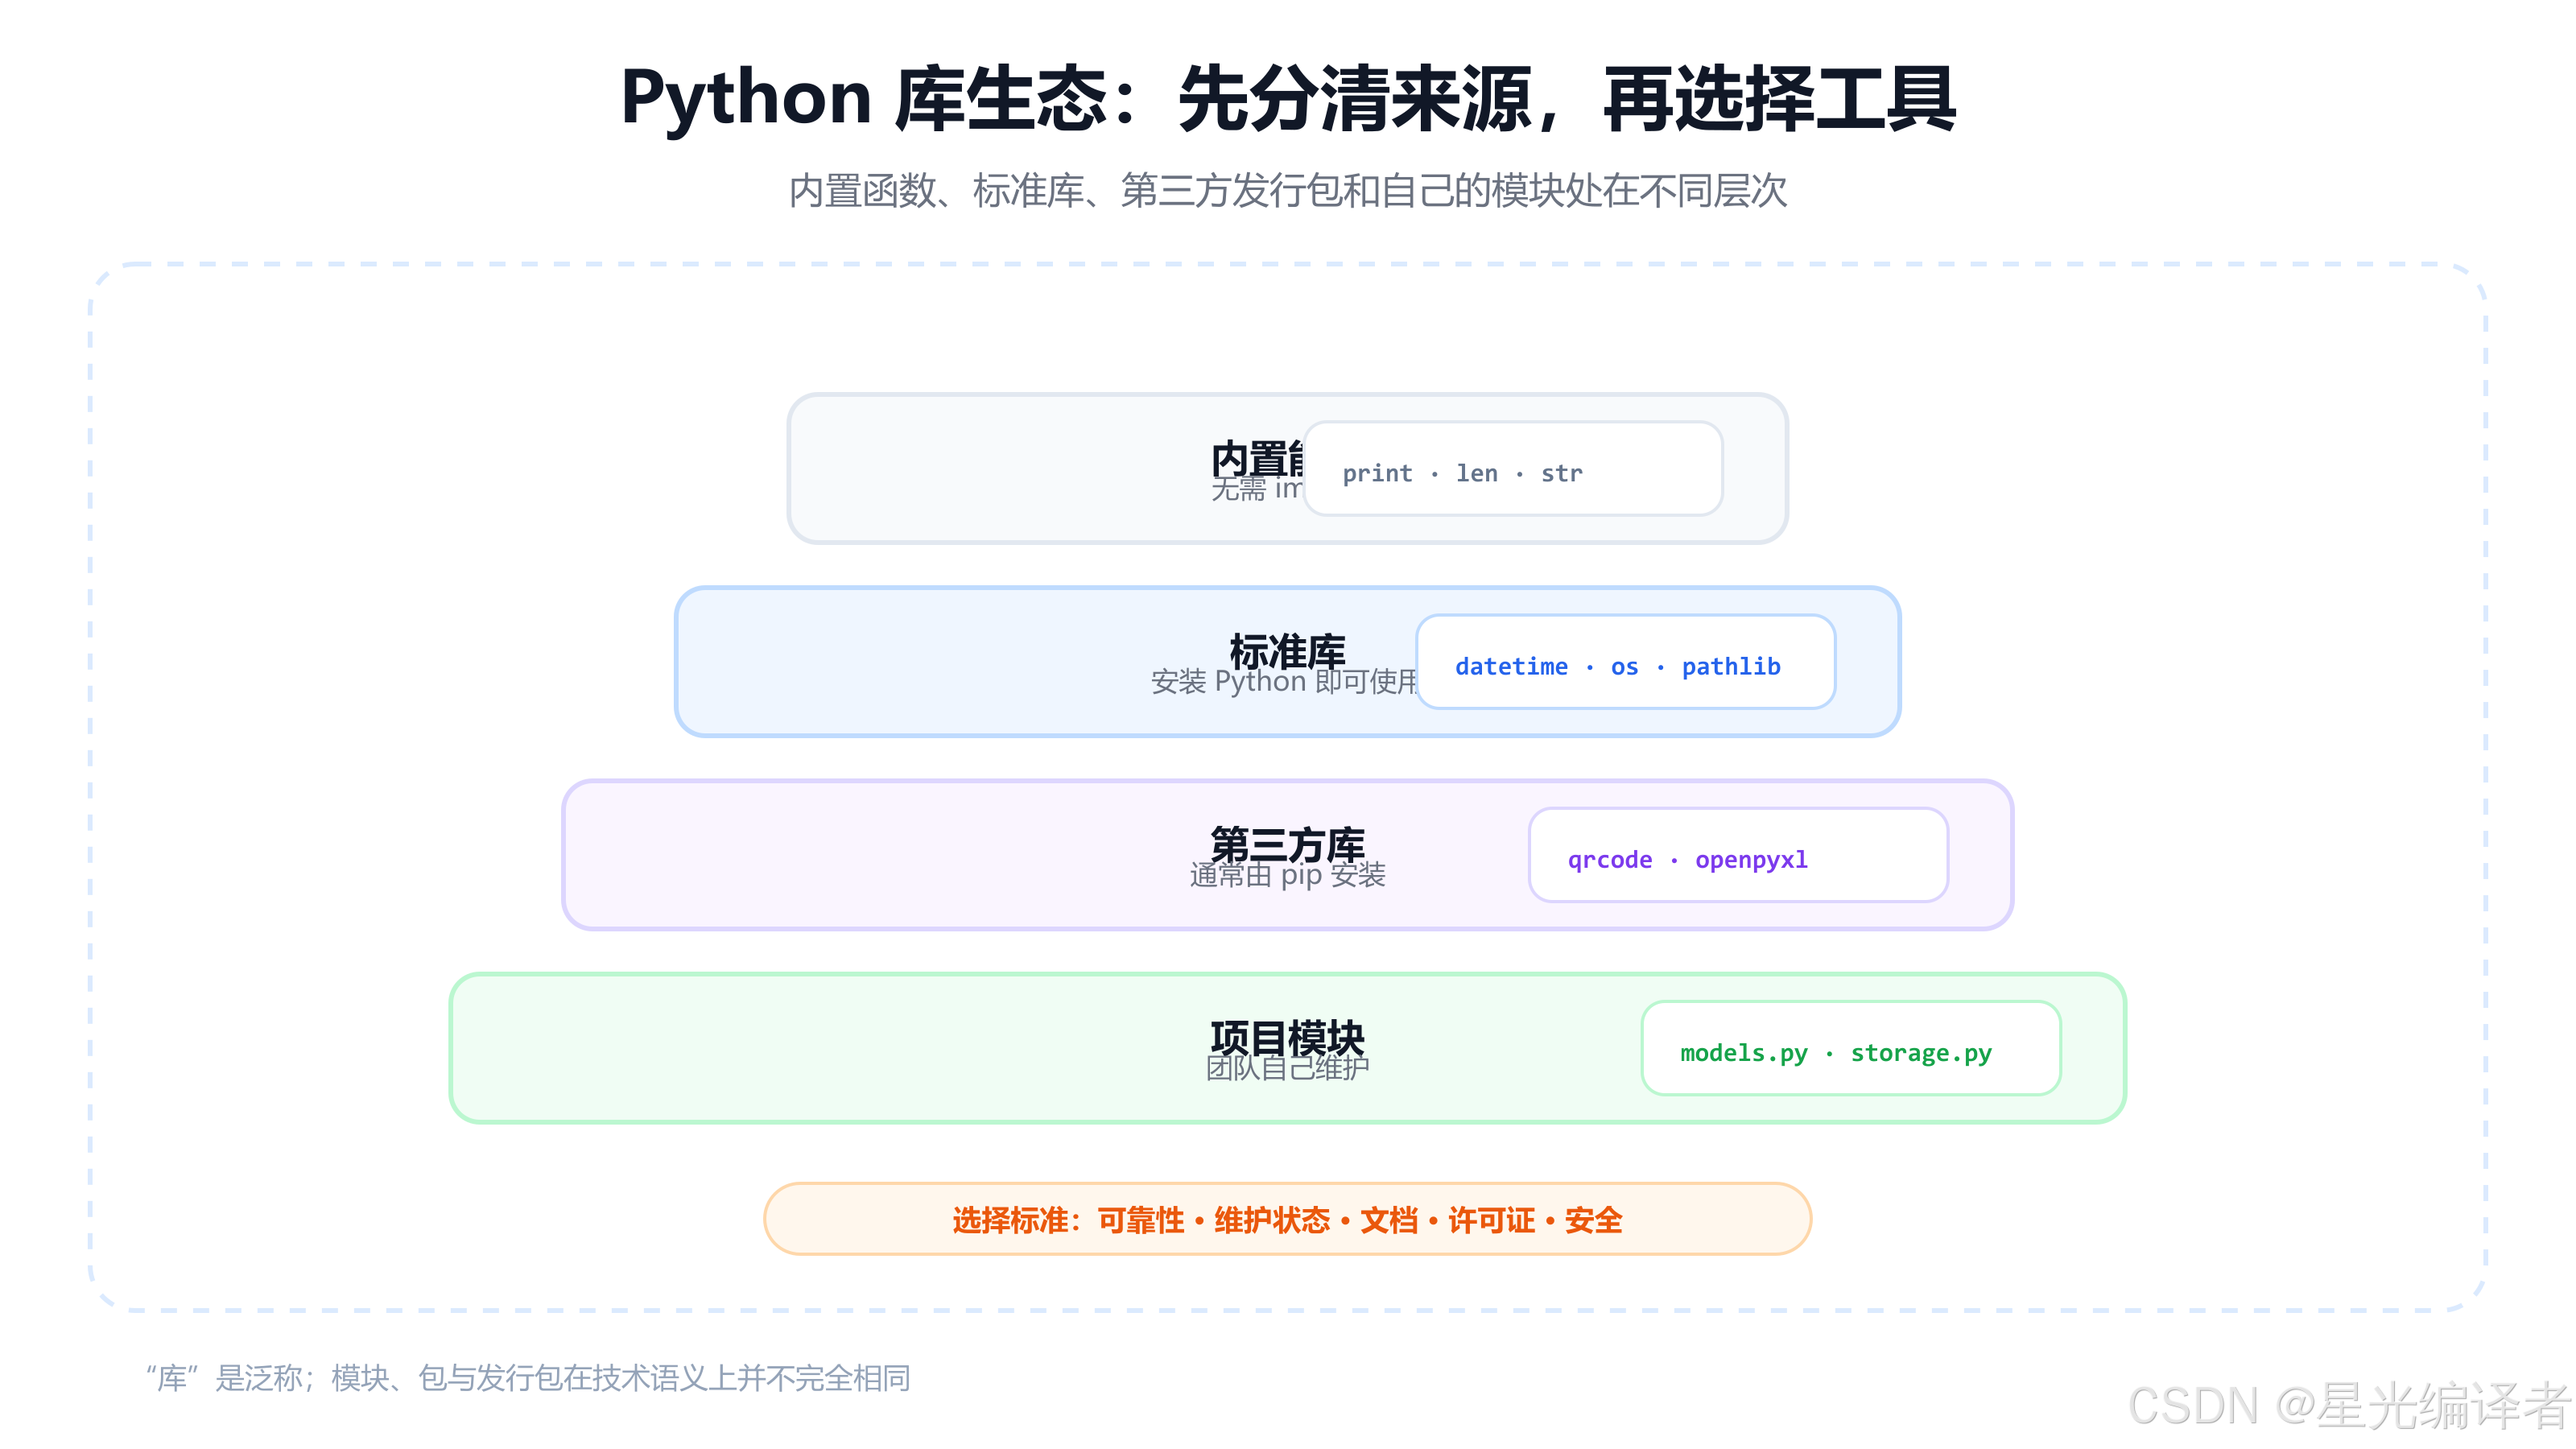
日常交流中,人们经常把可复用代码统称为"库"。这没有问题,但在安装和排错时,最好知道几个更精确的概念。
2.1 内置函数与内置类型
print()、len()、input() 等函数无需导入即可使用;int、str、list、dict 等类型同样由解释器直接提供。
python
message = "hello"
print(len(message))
字符串的 split()、join()、startswith() 等方法也不需要额外安装,因为它们属于 str 类型本身。
2.2 标准库
标准库随 Python 发行版提供。安装 Python 后,一般不需要再通过 pip 安装:
python
import datetime
import json
import os
from pathlib import Path
标准库覆盖文本、日期、数学、文件系统、数据序列化、并发、网络等大量常见任务。学习标准库时不必背下全部 API,更重要的是建立"这里大概有什么"的地图,并学会查询官方文档。
2.3 模块与包
一个普通的 .py 文件可以是模块。例如:
text
project/
├─ main.py
└─ calculator.py
calculator.py 中写有:
python
def add(left, right):
    return left + right
main.py 可以导入它:
python
import calculator

print(calculator.add(10, 20))
当多个模块按照目录组织在一起时,就形成包。现代 Python 支持多种包形态,初学阶段可以先把它理解成"可按层级导入的一组模块"。
2.4 第三方发行包
pip install openpyxl 安装的是一个发行包 ;代码里 import openpyxl 导入的是 Python 包。安装名和导入名常常相同,但并非永远如此。因此排错时不要想当然,应查看项目在 PyPI 或官方文档中的说明。
三、import:不只是把文件复制进来
3.1 import 的基本过程
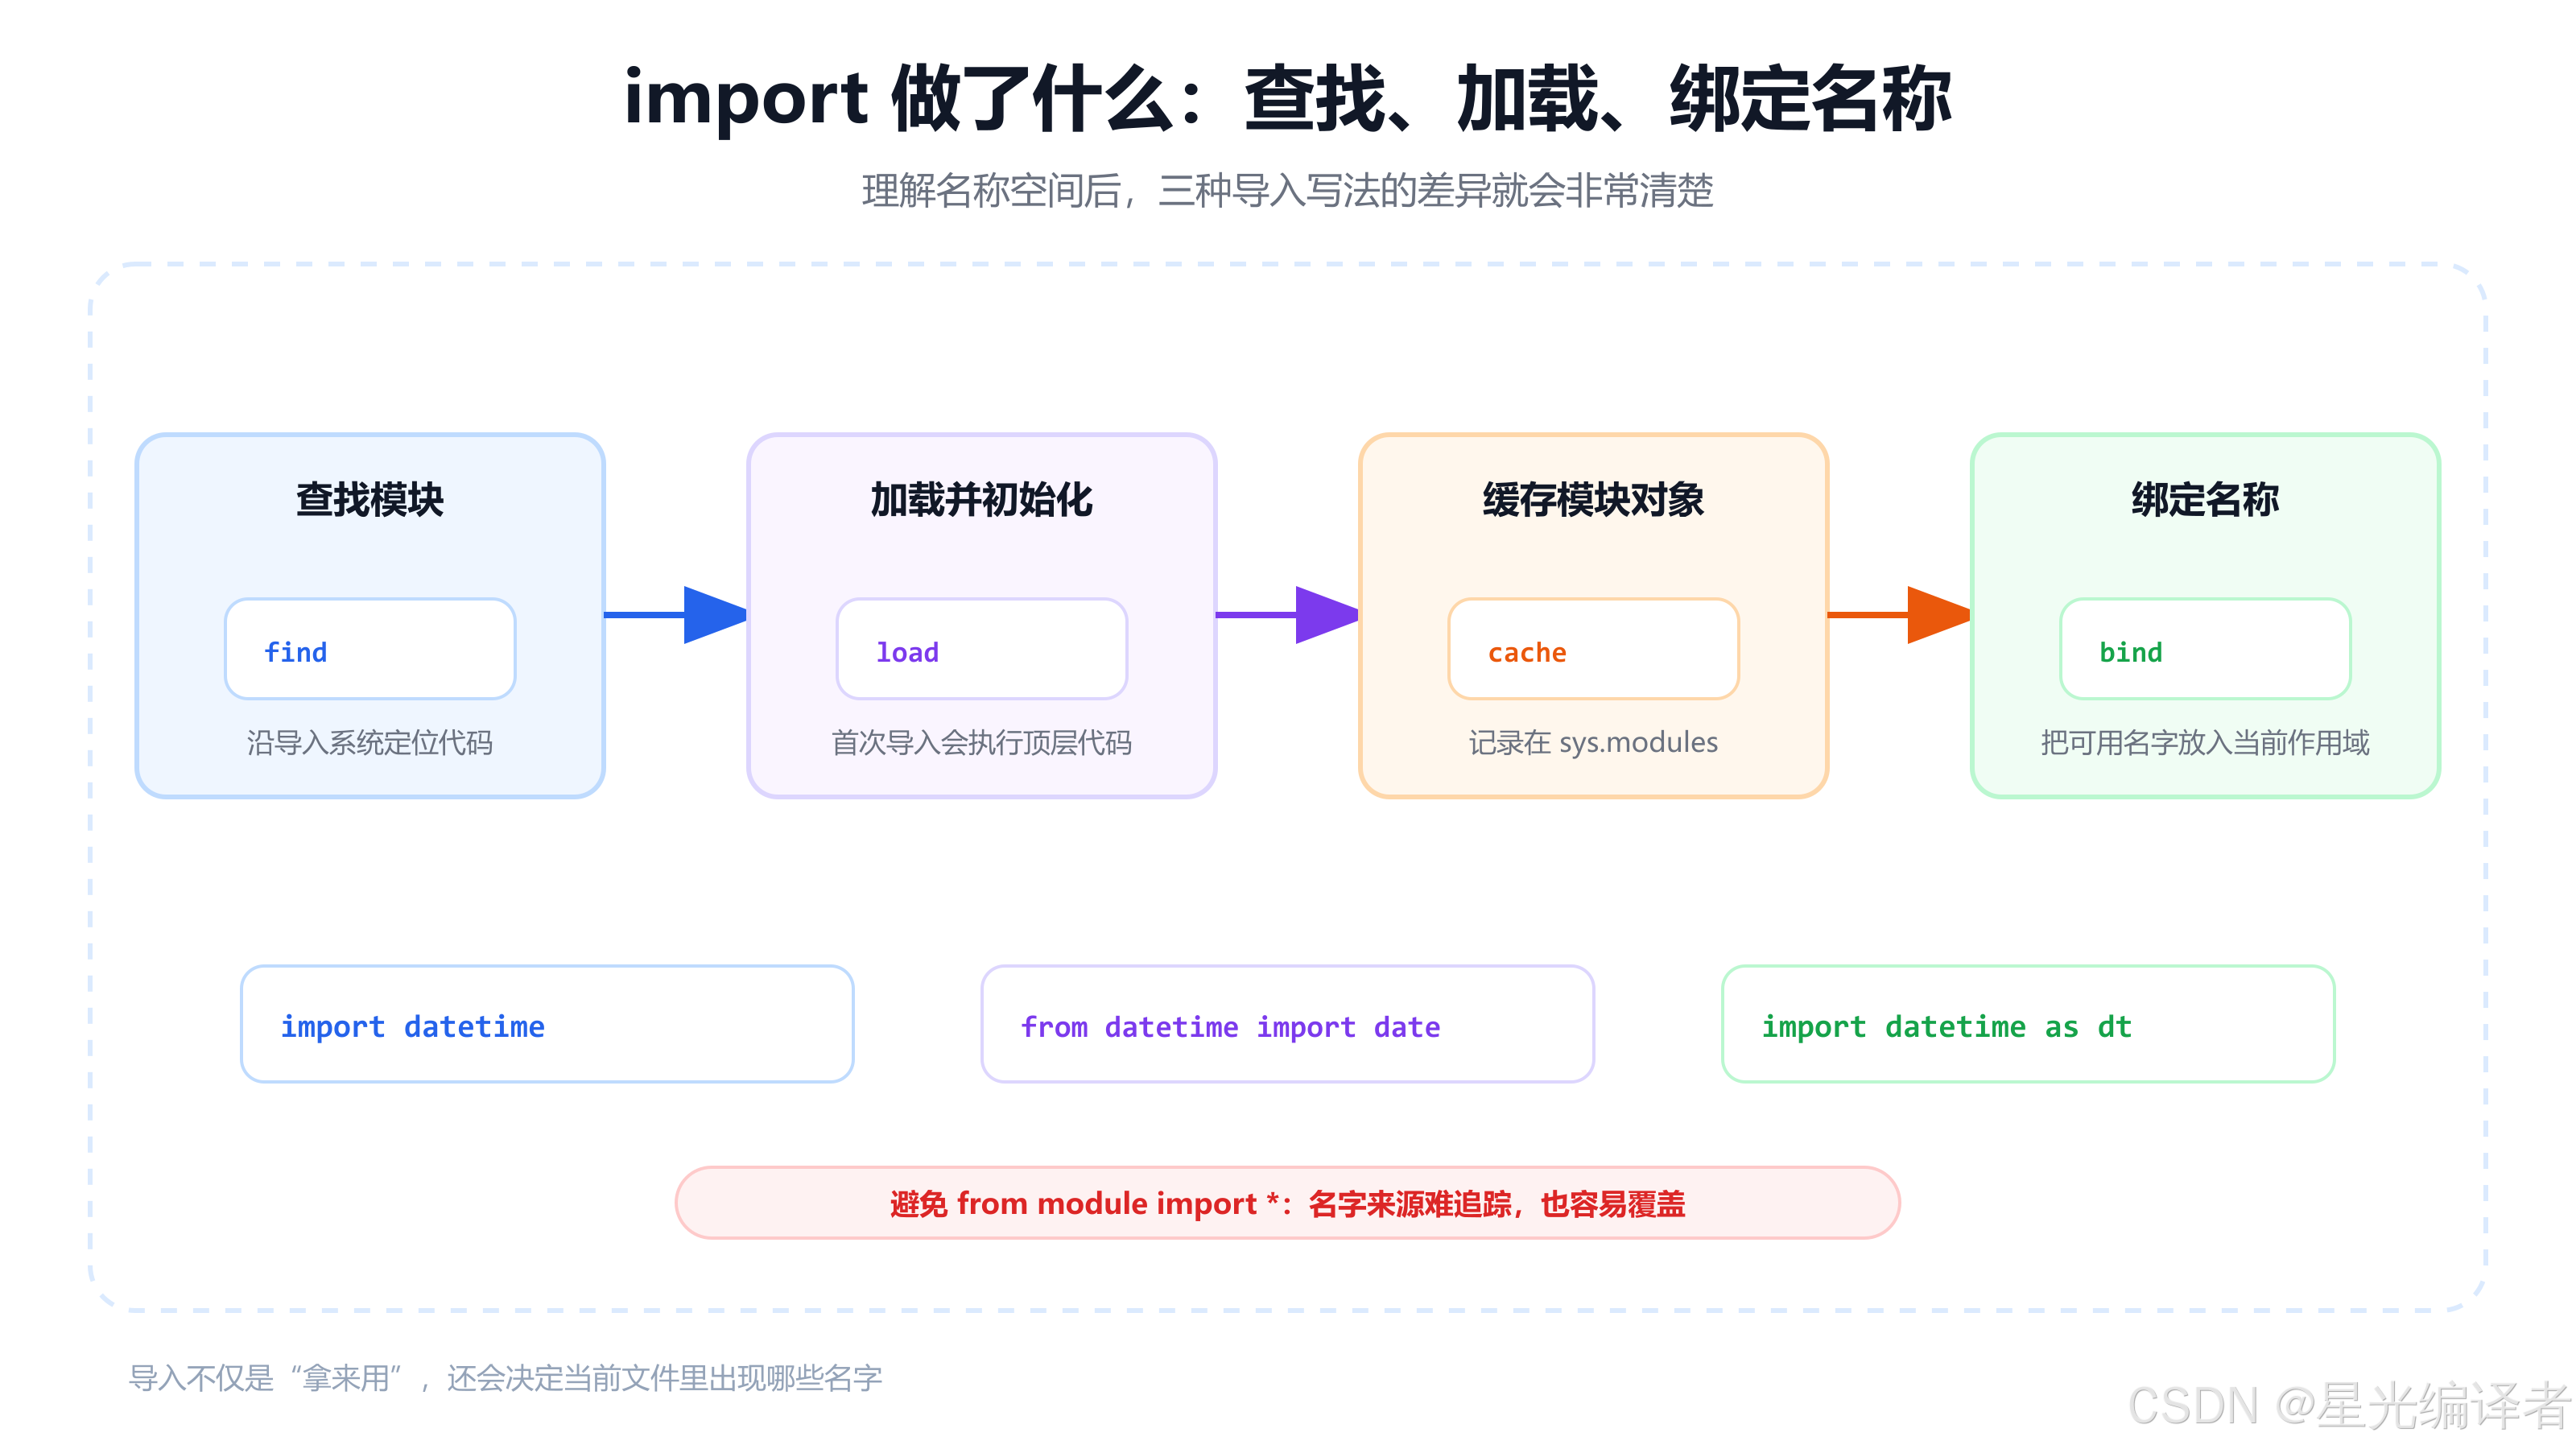
从使用者角度看,一条导入语句大致经历四步:
- 根据模块名寻找可导入对象;
- 必要时加载并初始化模块;
- 把模块对象记录到缓存中;
- 在当前作用域绑定一个可访问的名字。
最常见的三种写法如下:
python
import datetime

today = datetime.date.today()
这种写法保留模块名前缀,看到 datetime.date 时很容易判断 date 的来源。
python
from datetime import date

today = date.today()
这种写法把 date 直接绑定到当前作用域,使用更短,但名字来源需要结合导入语句判断。
python
import datetime as dt

today = dt.date.today()
别名适合模块名很长或社区已经形成通用约定的场景。别名应稳定、清晰,不要为了少打几个字符使用难懂缩写。
3.2 为什么不推荐星号导入
python
from datetime import *这会把模块公开的多个名字放入当前作用域。文件稍大后,你很难从使用位置判断名字来自哪里;两个模块导出同名对象时,后一次导入还可能覆盖前一个绑定。
更稳妥的原则是:
- 默认使用
import module; - 频繁使用少量明确对象时,使用
from module import name; - 避免在业务代码中使用
import *。
3.3 模块顶层代码何时执行
模块首次被导入时,其顶层语句会执行。假设 settings.py 中写有:
python
print("settings loaded")
TIMEOUT = 10
第一次 import settings 会打印文本。之后在同一进程中再次导入,通常直接复用缓存中的模块对象,而不是重新完整执行。
这也是为什么可复用模块不应在导入时做大量不可控操作,例如弹窗、读取用户输入或立即删除文件。脚本入口通常写成:
python
def main():
    print("program started")


if __name__ == "__main__":
    main()
文件被直接运行时调用 main();被其他文件导入时,只提供函数而不自动启动业务流程。
四、标准库实战:日期间隔计算
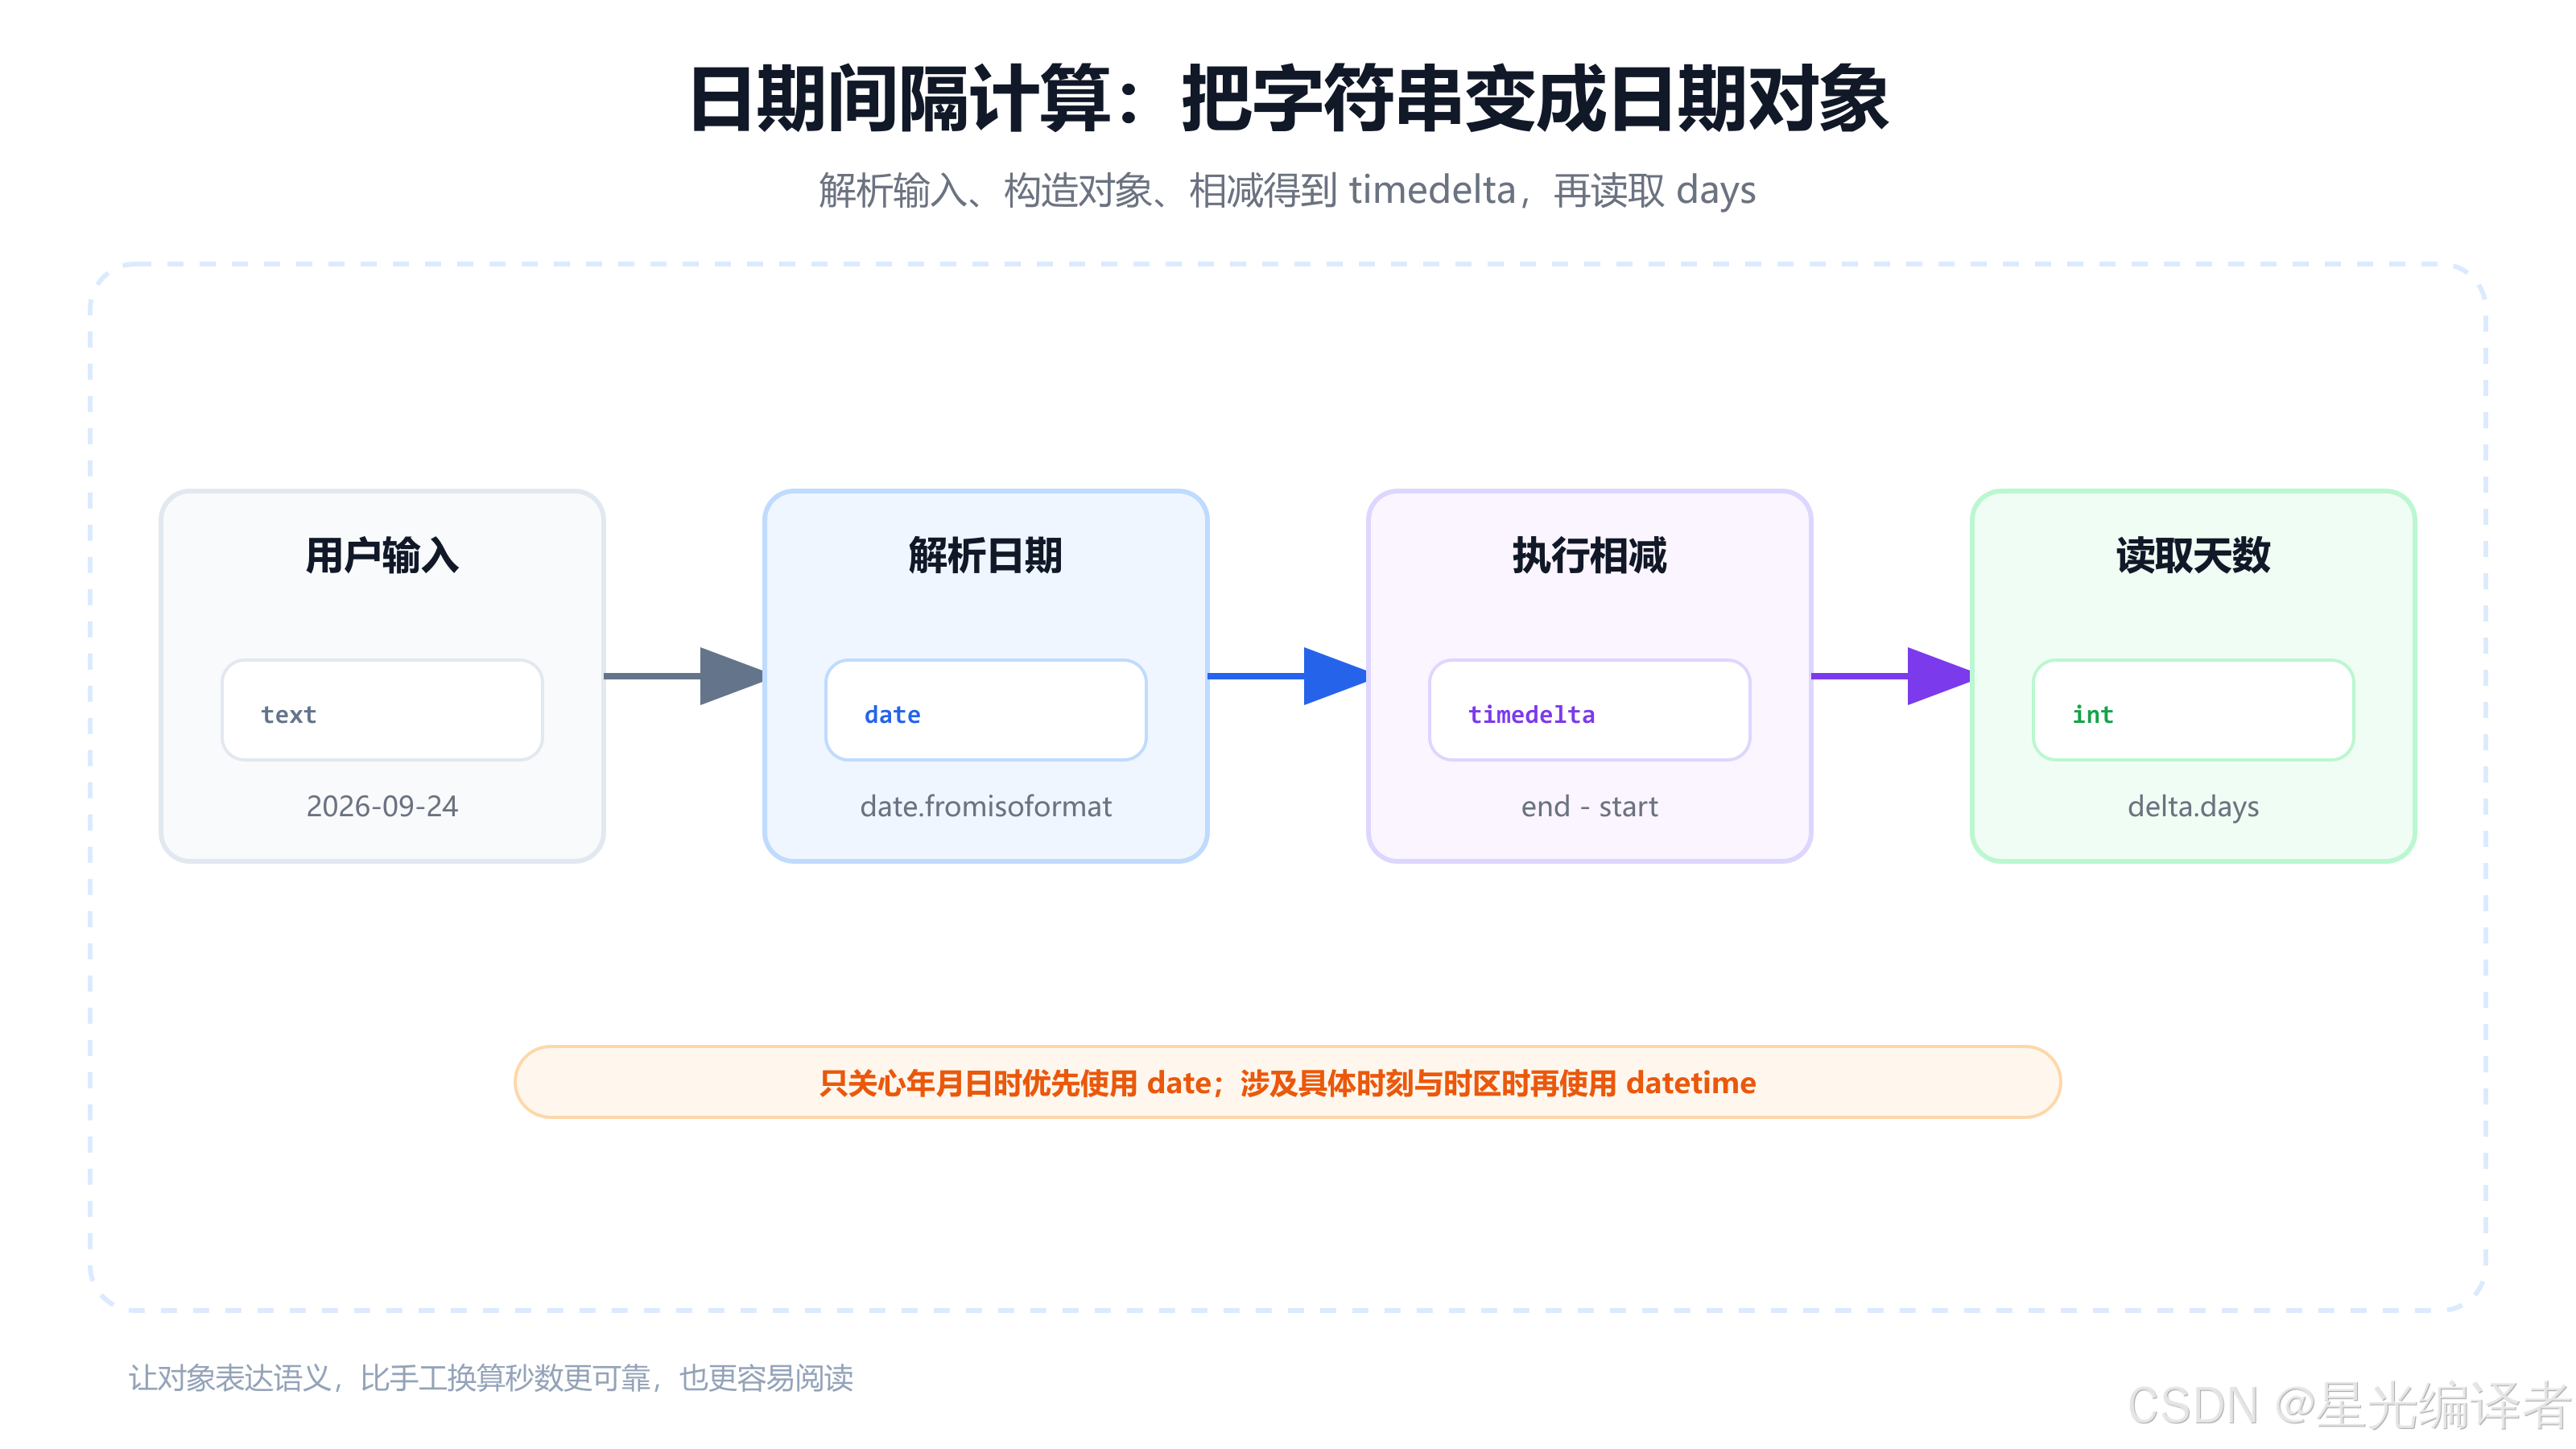
课件使用 datetime.datetime 构造两个日期并相减。如果只关心年月日,不涉及具体时分秒,datetime.date 更贴合语义:
python
from datetime import date

start = date(2012, 2, 14)
end = date(2022, 7, 12)

delta = end - start
print(delta.days)
相减结果不是普通整数,而是 timedelta 对象。读取 delta.days 才得到完整天数。
4.1 接收用户输入
ISO 日期格式 YYYY-MM-DD 便于阅读和排序,可以使用 date.fromisoformat() 解析:
python
from datetime import date


def read_date(prompt):
    while True:
        raw = input(prompt).strip()
        try:
            return date.fromisoformat(raw)
        except ValueError:
            print("日期格式或数值不合法,请按 YYYY-MM-DD 输入。")


start = read_date("开始日期:")
end = read_date("结束日期:")

print(f"相差 {abs((end - start).days)} 天")
fromisoformat() 不只检查字符串长得像不像日期,还会验证月份和日期范围。例如 2026-02-30 会触发 ValueError。
4.2 date、datetime 与时区
- 只处理日历日期:优先
date; - 需要小时、分钟、秒:使用
datetime; - 处理跨时区的真实时间点:使用带时区信息的 aware
datetime。
"两个日期相减"和"两个跨时区时刻相减"不是同一个问题。初学时先把对象语义选对,可以避免以后在夏令时、UTC 和本地时间上踩坑。
五、内置字符串能力:三道题看方法组合
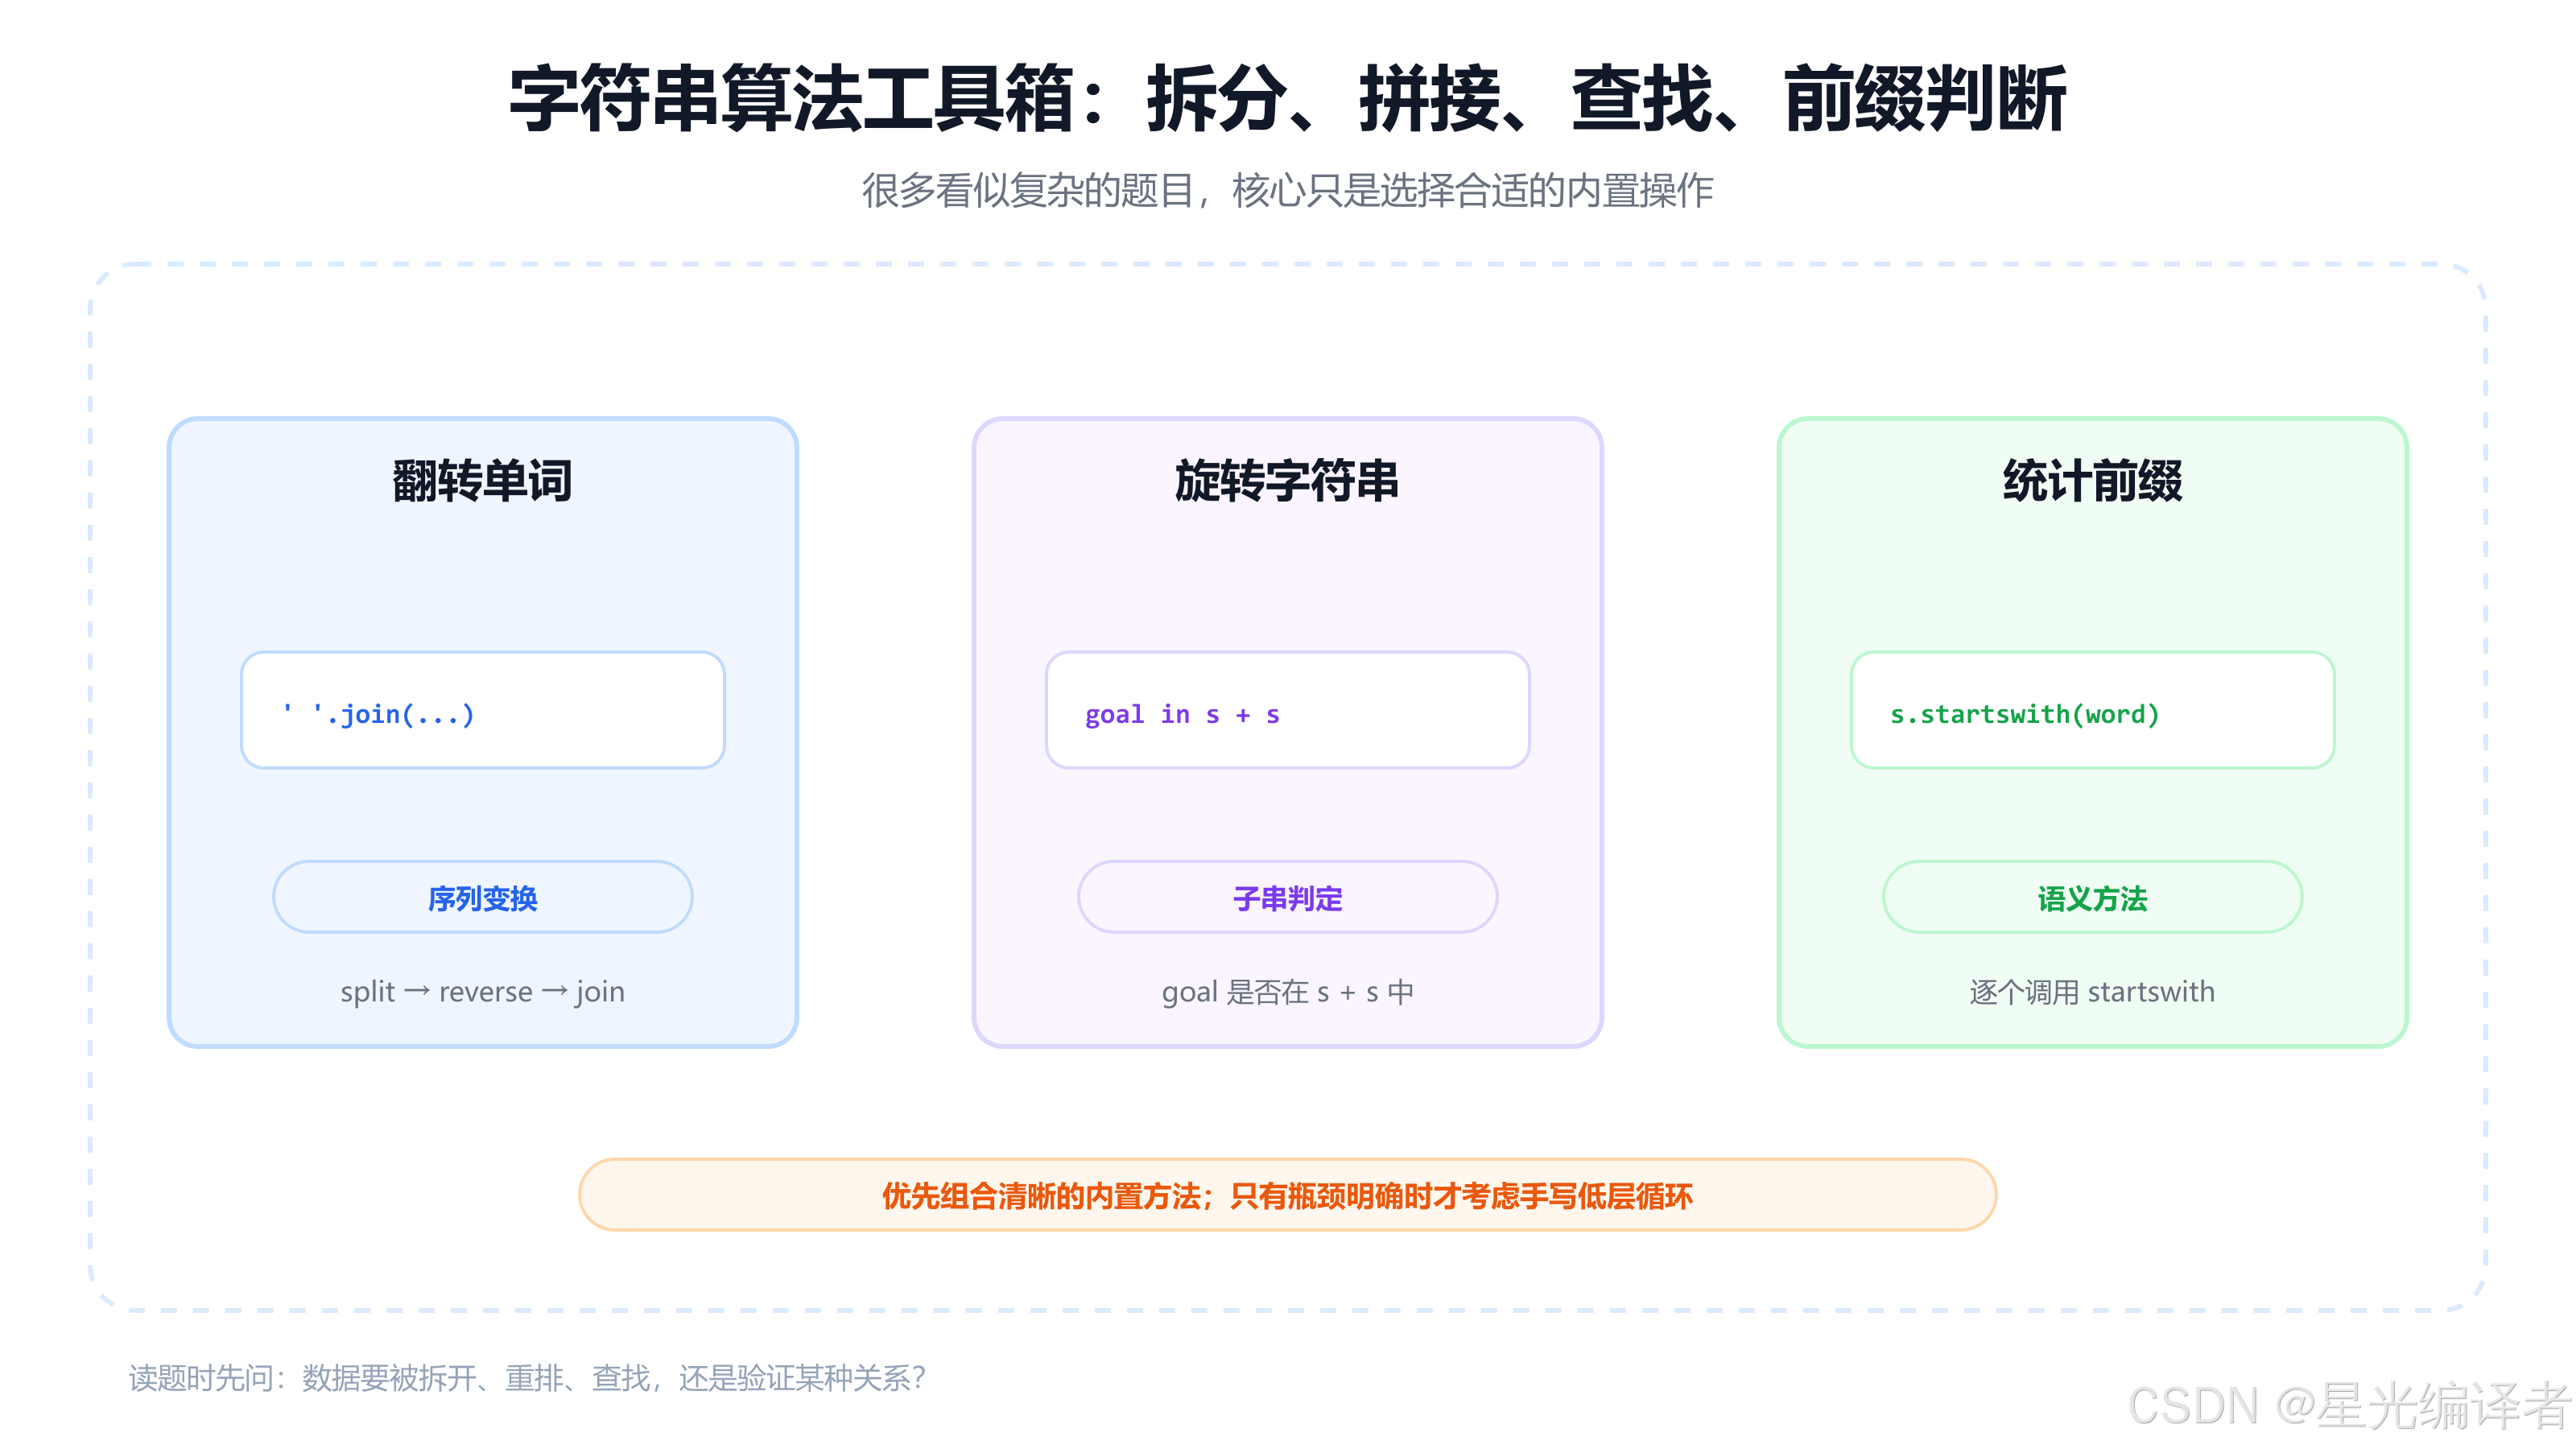
课件通过三道算法题展示了一个重要思想:先熟悉类型提供的操作,再考虑自己实现底层过程。
5.1 翻转句子中的单词
输入:
text
I am a student.输出:
text
student. a am I实现:
python
def reverse_words(text):
    words = text.split()
    words.reverse()
    return " ".join(words)


print(reverse_words("I am a student."))
这里组合了三个动作:
split()按连续空白切分,并忽略多余空白;reverse()原地逆序列表,返回值是None;" ".join(words)使用单个空格连接单词。
也可以写成:
python
def reverse_words(text):
    return " ".join(reversed(text.split()))
短不代表一定更好。初学阶段优先选择自己和团队都能快速读懂的形式。
5.2 判断旋转字符串
若 goal 是 s 的旋转结果,那么它一定会出现在 s + s 中:
python
def is_rotation(s, goal):
    return len(s) == len(goal) and goal in (s + s)


print(is_rotation("abcde", "cdeab"))  # True
长度判断不能省略。否则空字符串和某些长度不同的子串会破坏"旋转后长度保持不变"这一业务约束。
5.3 统计前缀
python
def count_prefixes(words, text):
    count = 0
    for word in words:
        if text.startswith(word):
            count += 1
    return count


print(count_prefixes(["a", "b", "c", "ab", "bc", "abc"], "abc"))
也可以利用布尔值可参与整数求和:
python
def count_prefixes(words, text):
    return sum(text.startswith(word) for word in words)
第一版适合初学和断点调试,第二版更紧凑。两者核心都是调用语义明确的 startswith(),比手工切片更直接。
六、目录搜索器:用 os.walk 遍历文件树
需求是:给定根目录和关键字,递归查找文件名中包含关键字的文件。
os.walk() 每次产生三个值:
dirpath:当前正在访问的目录;dirnames:该目录下的子目录名;filenames:该目录下的文件名。
6.1 基础实现
python
import os
from pathlib import Path


def search_files(root, keyword):
    matches = []

    for dirpath, dirnames, filenames in os.walk(root):
        for filename in filenames:
            if keyword.lower() in filename.lower():
                matches.append(Path(dirpath) / filename)

    return matches


root = input("待搜索目录:").strip()
keyword = input("文件名关键字:").strip()

for path in search_files(root, keyword):
    print(path)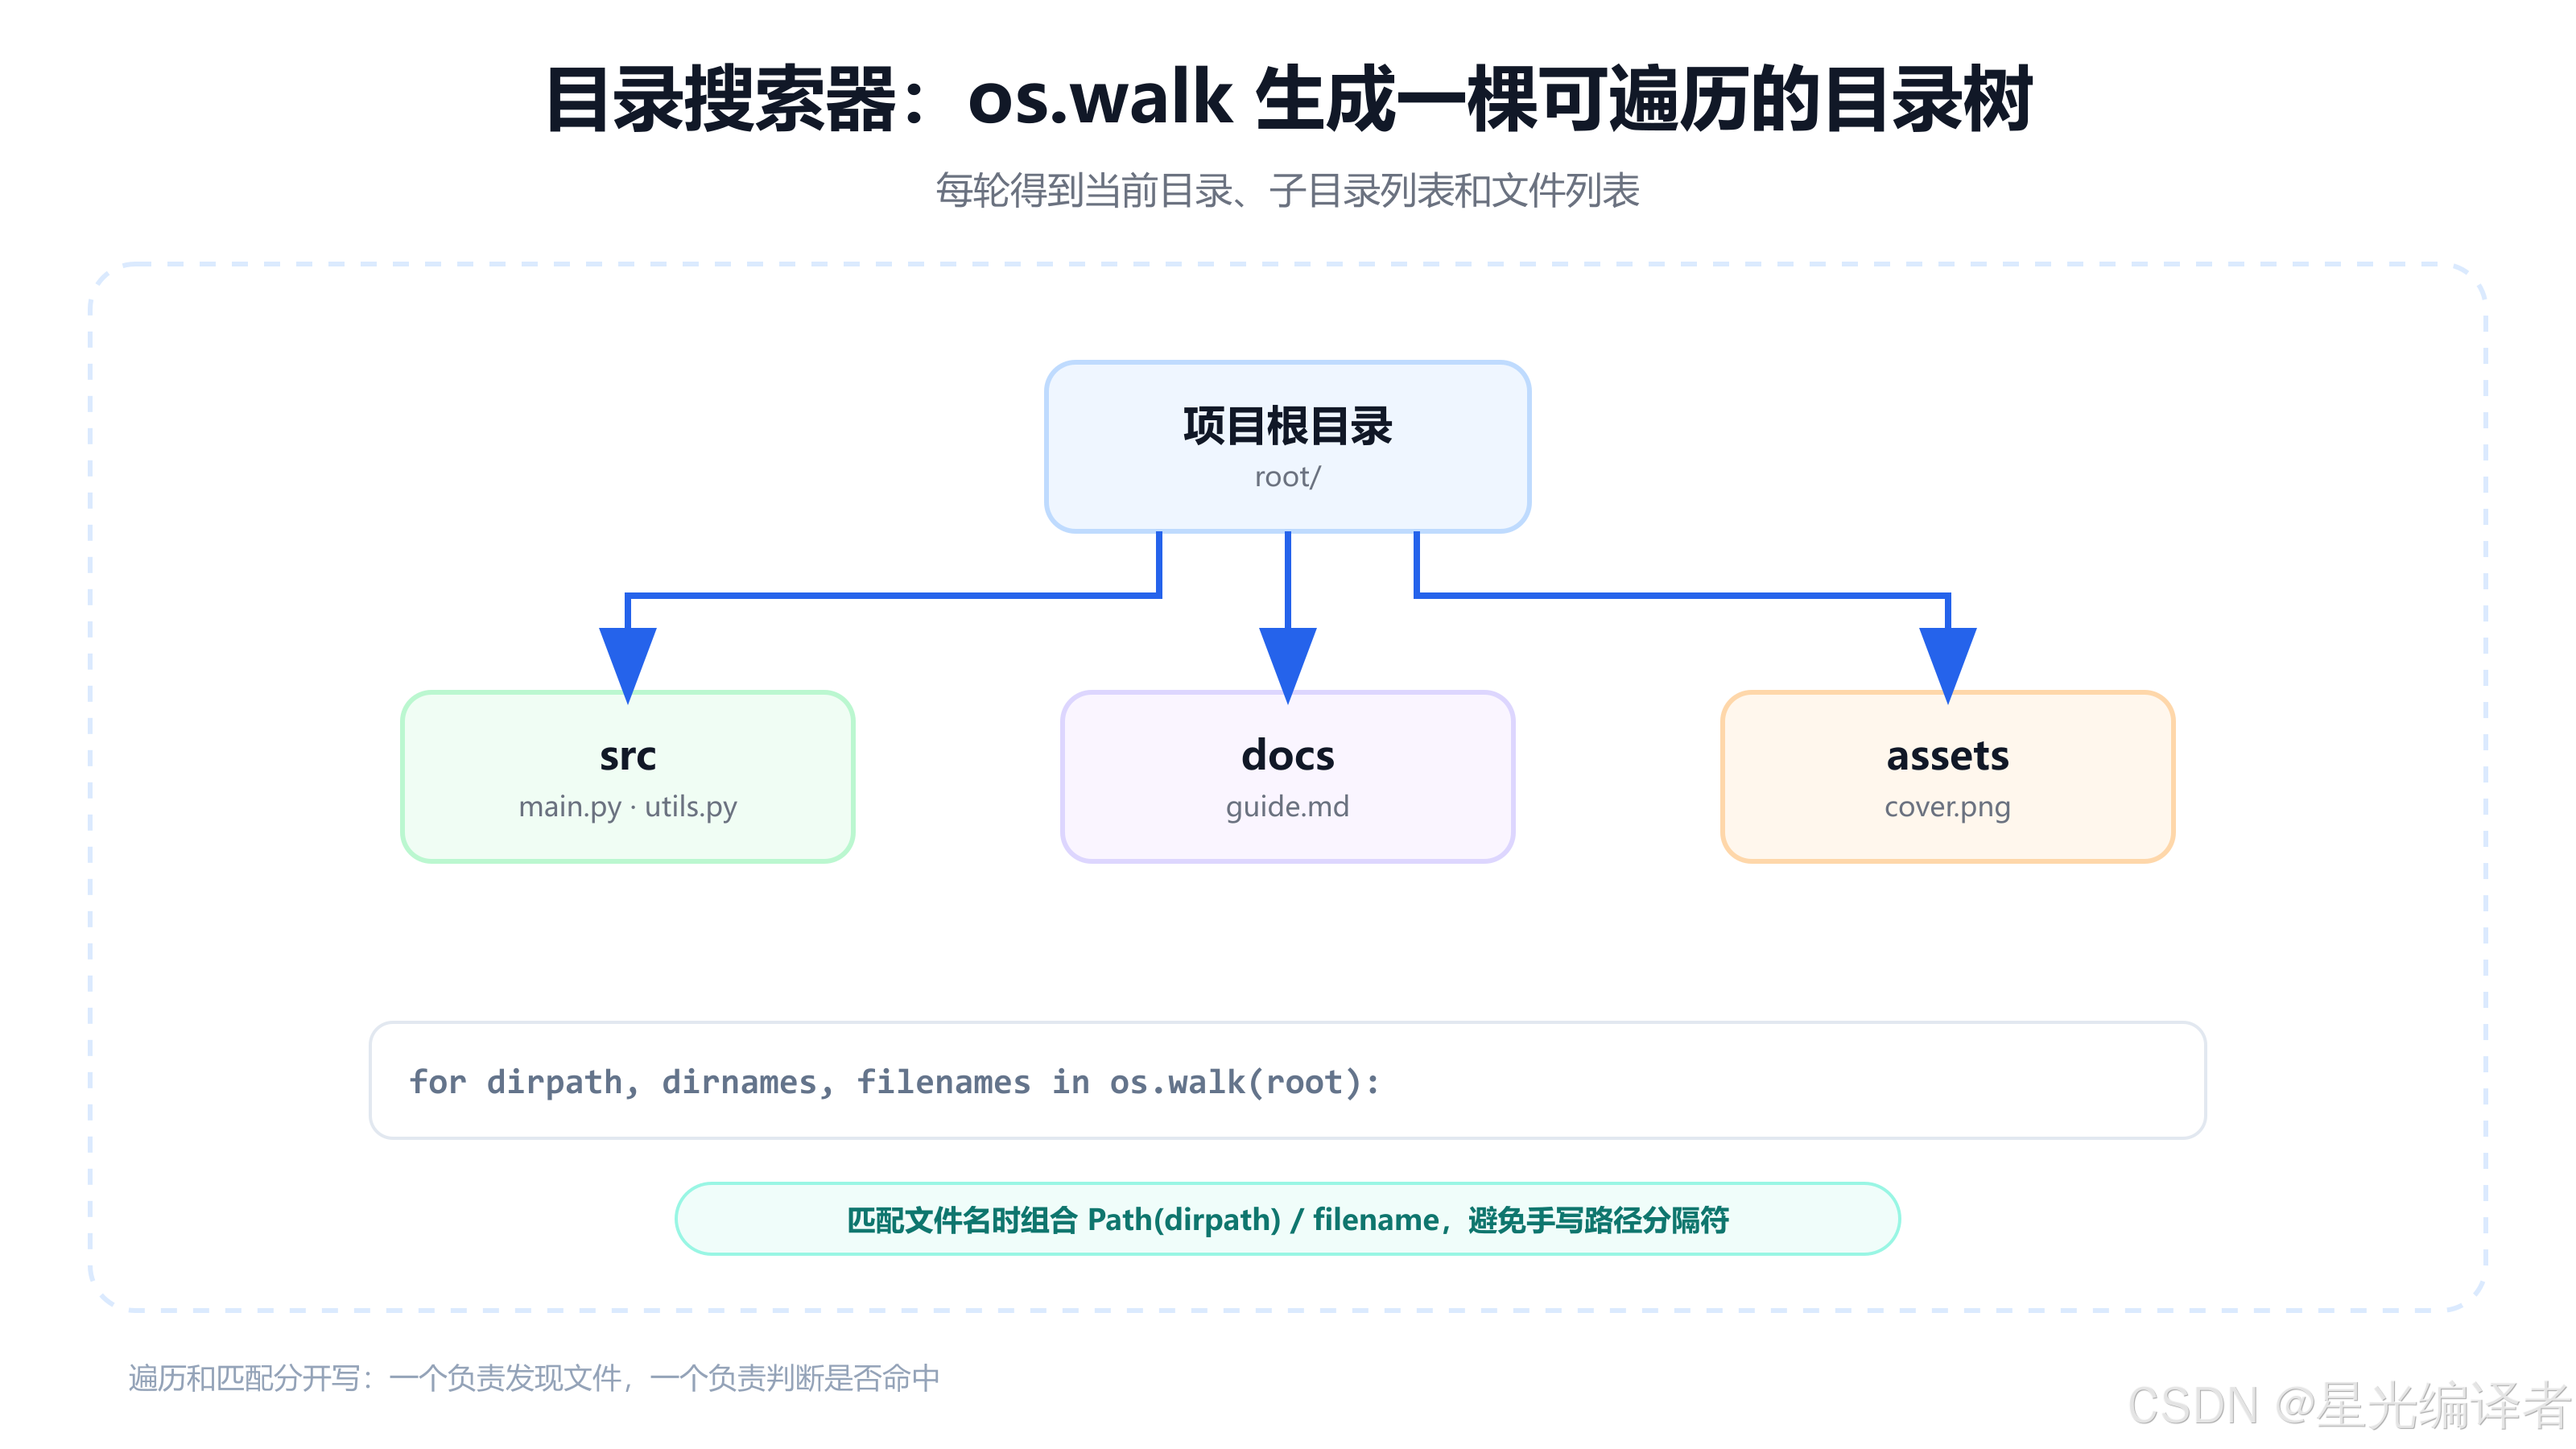
课件用 f"{dirpath}/{filename}" 拼路径,在简单环境中可能工作,但不同操作系统的路径分隔规则并不完全相同。Path(dirpath) / filename 更清楚,也能正确交给系统处理。
6.2 增加输入检查
python
from pathlib import Path


root = Path(input("待搜索目录:").strip()).expanduser()

if not root.exists():
    print("路径不存在")
elif not root.is_dir():
    print("输入的不是目录")
else:
    for path in search_files(root, ".py"):
        print(path)
6.3 大目录的改进方向
如果目录非常大,不必先把所有结果放进列表,可以把函数改成生成器:
python
def iter_matching_files(root, keyword):
    for dirpath, _, filenames in os.walk(root):
        for filename in filenames:
            if keyword.lower() in filename.lower():
                yield Path(dirpath) / filename
调用者会逐个得到结果,内存中无需保存整个匹配集合。还可以继续增加:
- 跳过
.git、.venv等目录; - 按文件扩展名过滤;
- 捕获权限错误;
- 搜索文件内容,而不仅是文件名;
- 把结果导出为 CSV。
七、第三方库、PyPI、pip 与虚拟环境
标准库很丰富,但不可能覆盖所有业务。第三方项目会把可复用实现发布到 Python Package Index,也就是 PyPI。pip 是常见的安装工具。
7.1 为什么推荐 python -m pip
课件使用:
text
pip install qrcode[pil]命令本身可以工作,但电脑同时存在多个 Python、IDE 又使用独立解释器时,裸 pip 可能对应另一个环境。更稳妥的写法是:
text
python -m pip install "qrcode[pil]"Windows 若使用 Python Launcher,也可以写:
text
py -m pip install "qrcode[pil]"python -m pip 的含义是:使用这个 python 解释器运行它所属环境里的 pip 模块。这样"运行程序的解释器"和"安装依赖的解释器"更容易保持一致。
7.2 为项目创建虚拟环境
不同项目可能依赖同一个库的不同版本。把所有依赖都装进全局环境,会让升级和排错越来越困难。可以为每个项目创建独立环境:
text
py -m venv .venv在 Windows PowerShell 中激活:
text
.\.venv\Scripts\Activate.ps1在 Windows CMD 中激活:
text
.venv\Scripts\activate.bat在 Linux 或 macOS 中激活:
text
source .venv/bin/activate激活后再安装:
text
python -m pip install "qrcode[pil]" openpyxl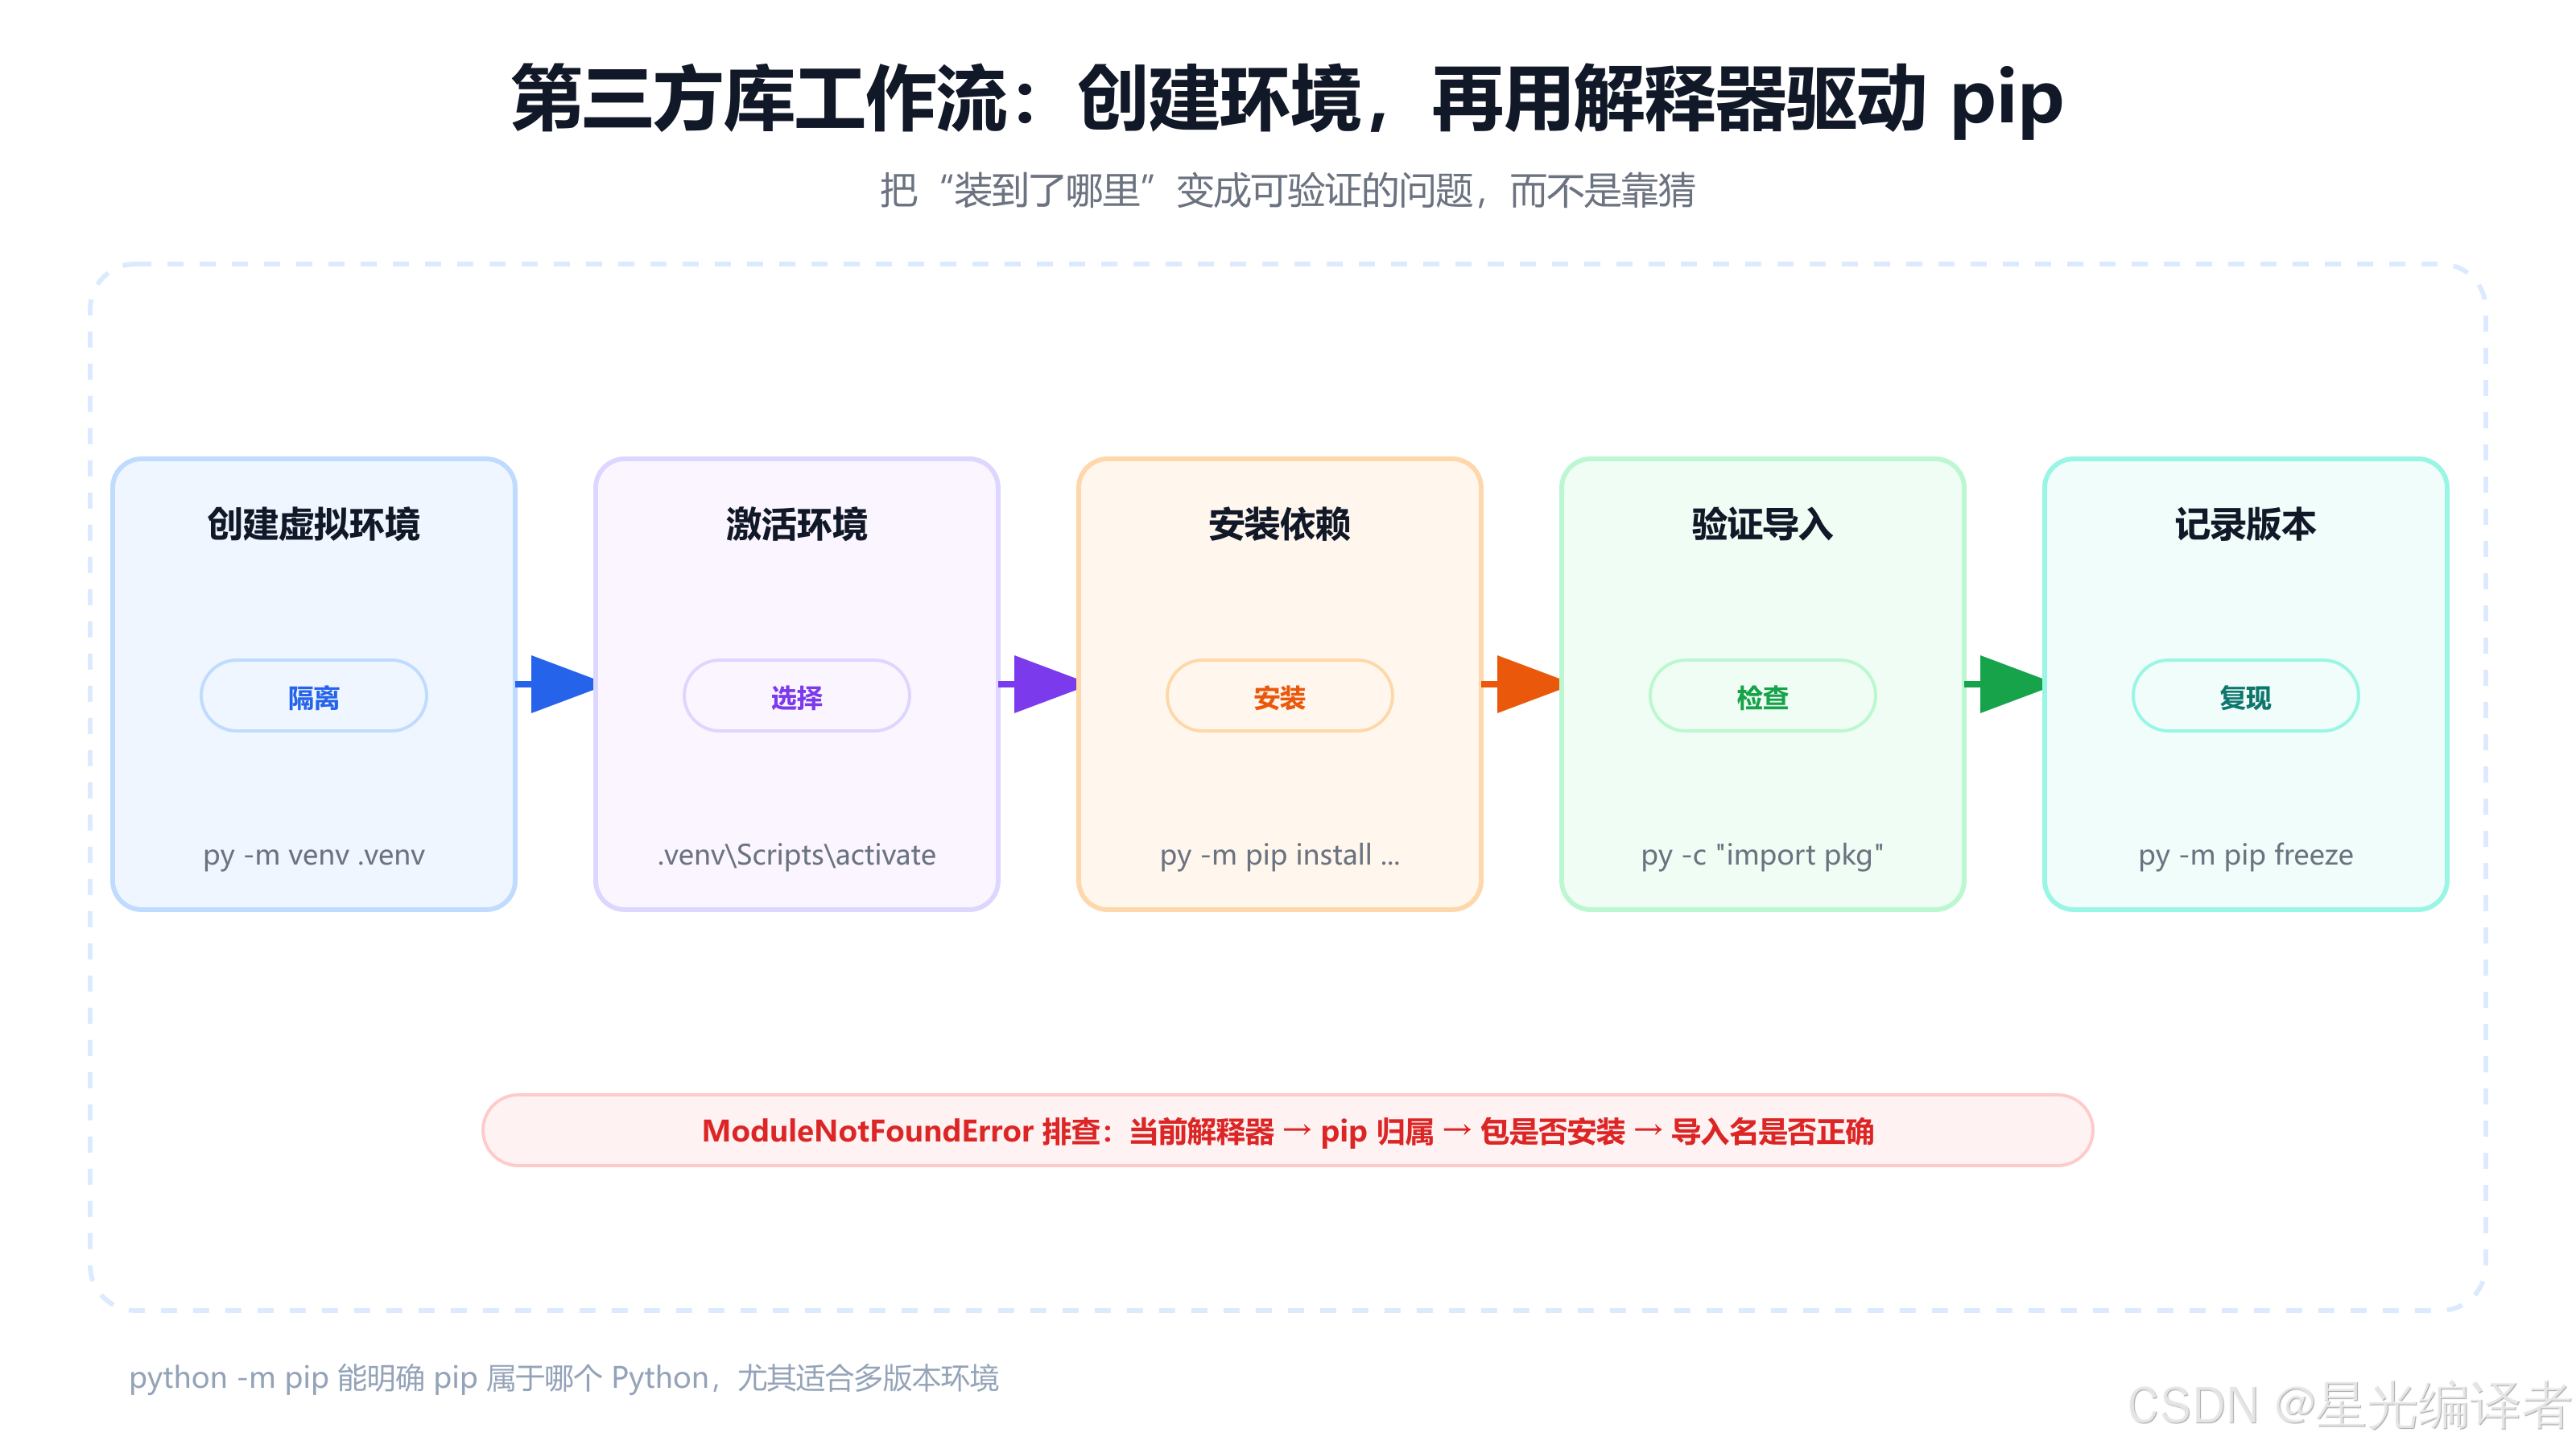
7.3 记录依赖
小型学习项目可以先使用:
text
python -m pip freeze > requirements.txt其他人拿到项目后运行:
text
python -m pip install -r requirements.txt注意,freeze 会记录当前环境中已安装的包,不一定都属于项目。正式项目可以进一步使用专门的依赖管理方案,但核心目标不变:让环境可重建,而不是只在自己电脑上"碰巧能跑"。
7.4 ModuleNotFoundError 排查顺序
看到:
text
ModuleNotFoundError: No module named 'xxx'按下面顺序检查:
text
1. 当前运行的是哪个 Python?
2. python -m pip 对应哪个环境?
3. 目标发行包是否真的安装成功?
4. 安装名与 import 名是否一致?
5. IDE 选择的解释器是否与终端一致?
6. 项目中是否有同名文件遮蔽了第三方包?
最后一种情况很常见。例如把自己的脚本命名成 qrcode.py,再在其中 import qrcode,导入系统可能先找到当前目录里的文件,造成循环导入或属性缺失。
八、第三方库实战一:生成二维码
qrcode 项目的 PyPI 页面给出了安装方式和快速示例。带 Pillow 图像支持的安装命令为:
text
python -m pip install "qrcode[pil]"8.1 最短可用示例
python
import qrcode

image = qrcode.make("https://blog.csdn.net/weixin_64304261")
image.save("blog-qrcode.png")
二维码承载的是数据。常见内容是 URL,因此扫码工具会把它识别为链接,但也可以编码普通文本。
8.2 自定义二维码
python
import qrcode


qr = qrcode.QRCode(
    version=None,
    error_correction=qrcode.constants.ERROR_CORRECT_M,
    box_size=10,
    border=4,
)
qr.add_data("Python libraries make development faster.")
qr.make(fit=True)

image = qr.make_image(fill_color="black", back_color="white")
image.save("message-qrcode.png")
几个参数的含义:
version控制二维码矩阵规模,None配合fit=True可自动选择;error_correction控制纠错等级;box_size控制每个小方块的像素大小;border控制四周留白宽度。
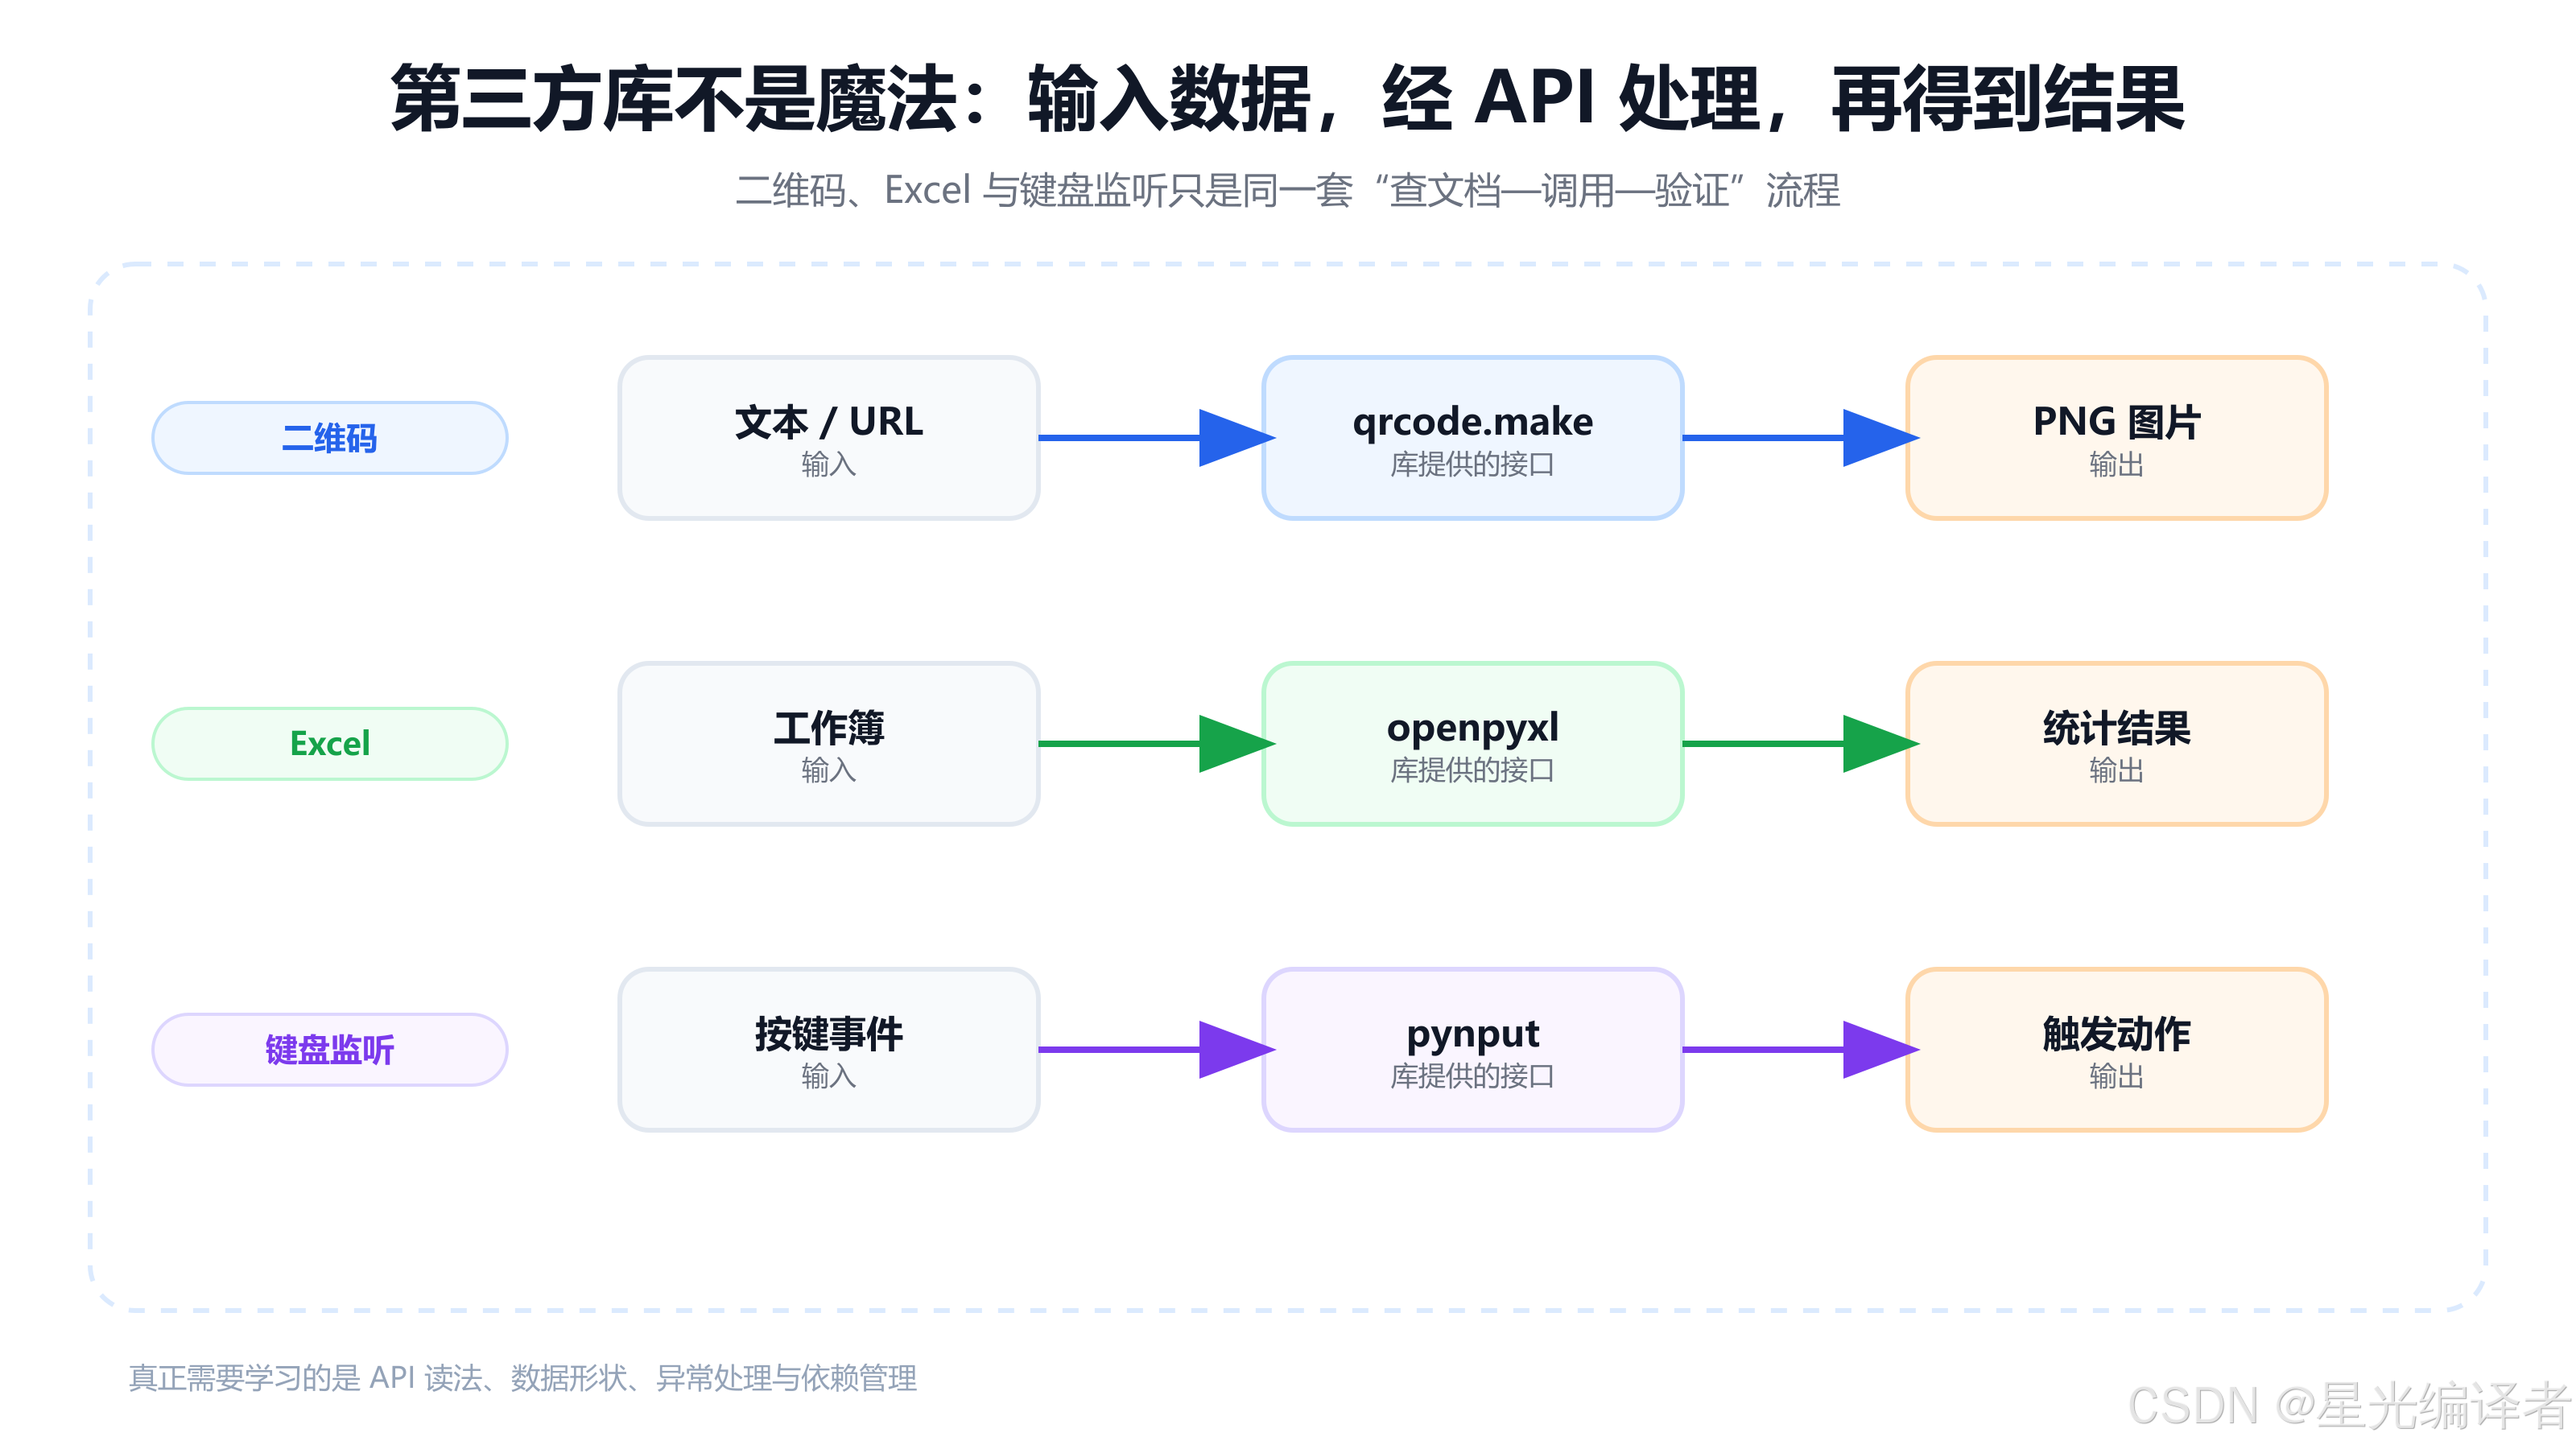
第三方库的学习路径通常都是:明确输入和输出,找到最小示例,运行成功,再逐步增加参数。不要一开始就复制一大段"高级配置",否则出错时很难判断是哪一步引起的。
九、第三方库实战二:读取 Excel 并统计
课件使用 xlrd==1.2.0 读取 .xlsx。这是当时常见的兼容方案,但在现代项目中继续固定旧版本并不理想。处理 .xlsx 可以使用 openpyxl:
text
python -m pip install openpyxl假设工作表第一行为表头,列顺序如下:
| 姓名 | 班级 | 分数 |
|---|---|---|
| 张三 | 100 | 88 |
| 李四 | 101 | 76 |
| 王五 | 100 | 94 |
9.1 计算指定班级平均分
python
from pathlib import Path

from openpyxl import load_workbook


def average_score(filename, class_id):
    workbook = load_workbook(filename, data_only=True, read_only=True)
    sheet = workbook.active

    total = 0.0
    count = 0

    try:
        for name, current_class, score in sheet.iter_rows(
            min_row=2,
            values_only=True,
        ):
            if current_class == class_id and isinstance(score, (int, float)):
                total += score
                count += 1
    finally:
        workbook.close()

    if count == 0:
        return None
    return total / count


path = Path("scores.xlsx")
result = average_score(path, 100)

if result is None:
    print("没有找到符合条件的有效成绩")
else:
    print(f"100 班平均分:{result:.2f}")
9.2 这段代码比"能跑"多做了什么
read_only=True更适合只读取的大工作簿;data_only=True尝试读取公式单元格的缓存结果;values_only=True直接得到单元格值;- 检查分数类型,跳过空值或异常文本;
count == 0时不执行除法,避免ZeroDivisionError;- 使用
finally确保工作簿被关闭。
还要注意:Excel 中看起来都是"100",底层可能一个是数字 100,另一个是字符串 "100"。真实项目应先定义数据规范,再决定是否统一转换。
十、第三方库实战三:监听按键与避免回调阻塞
课件设计了一个"程序员鼓励器":监听键盘,每达到一定按键次数就播放一次音频。这个案例比功能本身更重要的知识点是:事件回调应该尽快返回。
10.1 同步播放为什么卡顿
python
def on_release(key):
    global count
    count += 1
    if count % 20 == 0:
        play_audio("ding.mp3")
如果 play_audio() 在当前线程中阻塞一秒,监听器这段时间无法及时处理后续事件,用户就会感觉程序卡住。
10.2 把耗时任务交给工作线程
下面保留课件的核心思路。音频播放库和后端在不同操作系统上差异较大,请根据所选库的官方文档安装并测试,不要盲目固定一个很旧的版本。
python
from threading import Thread

from playsound import playsound
from pynput import keyboard


count = 0


def play_in_background(filename):
    worker = Thread(
        target=playsound,
        args=(filename,),
        daemon=True,
    )
    worker.start()


def on_release(key):
    global count
    count += 1

    if count % 20 == 0:
        play_in_background("ding.mp3")


with keyboard.Listener(on_release=on_release) as listener:
    listener.join()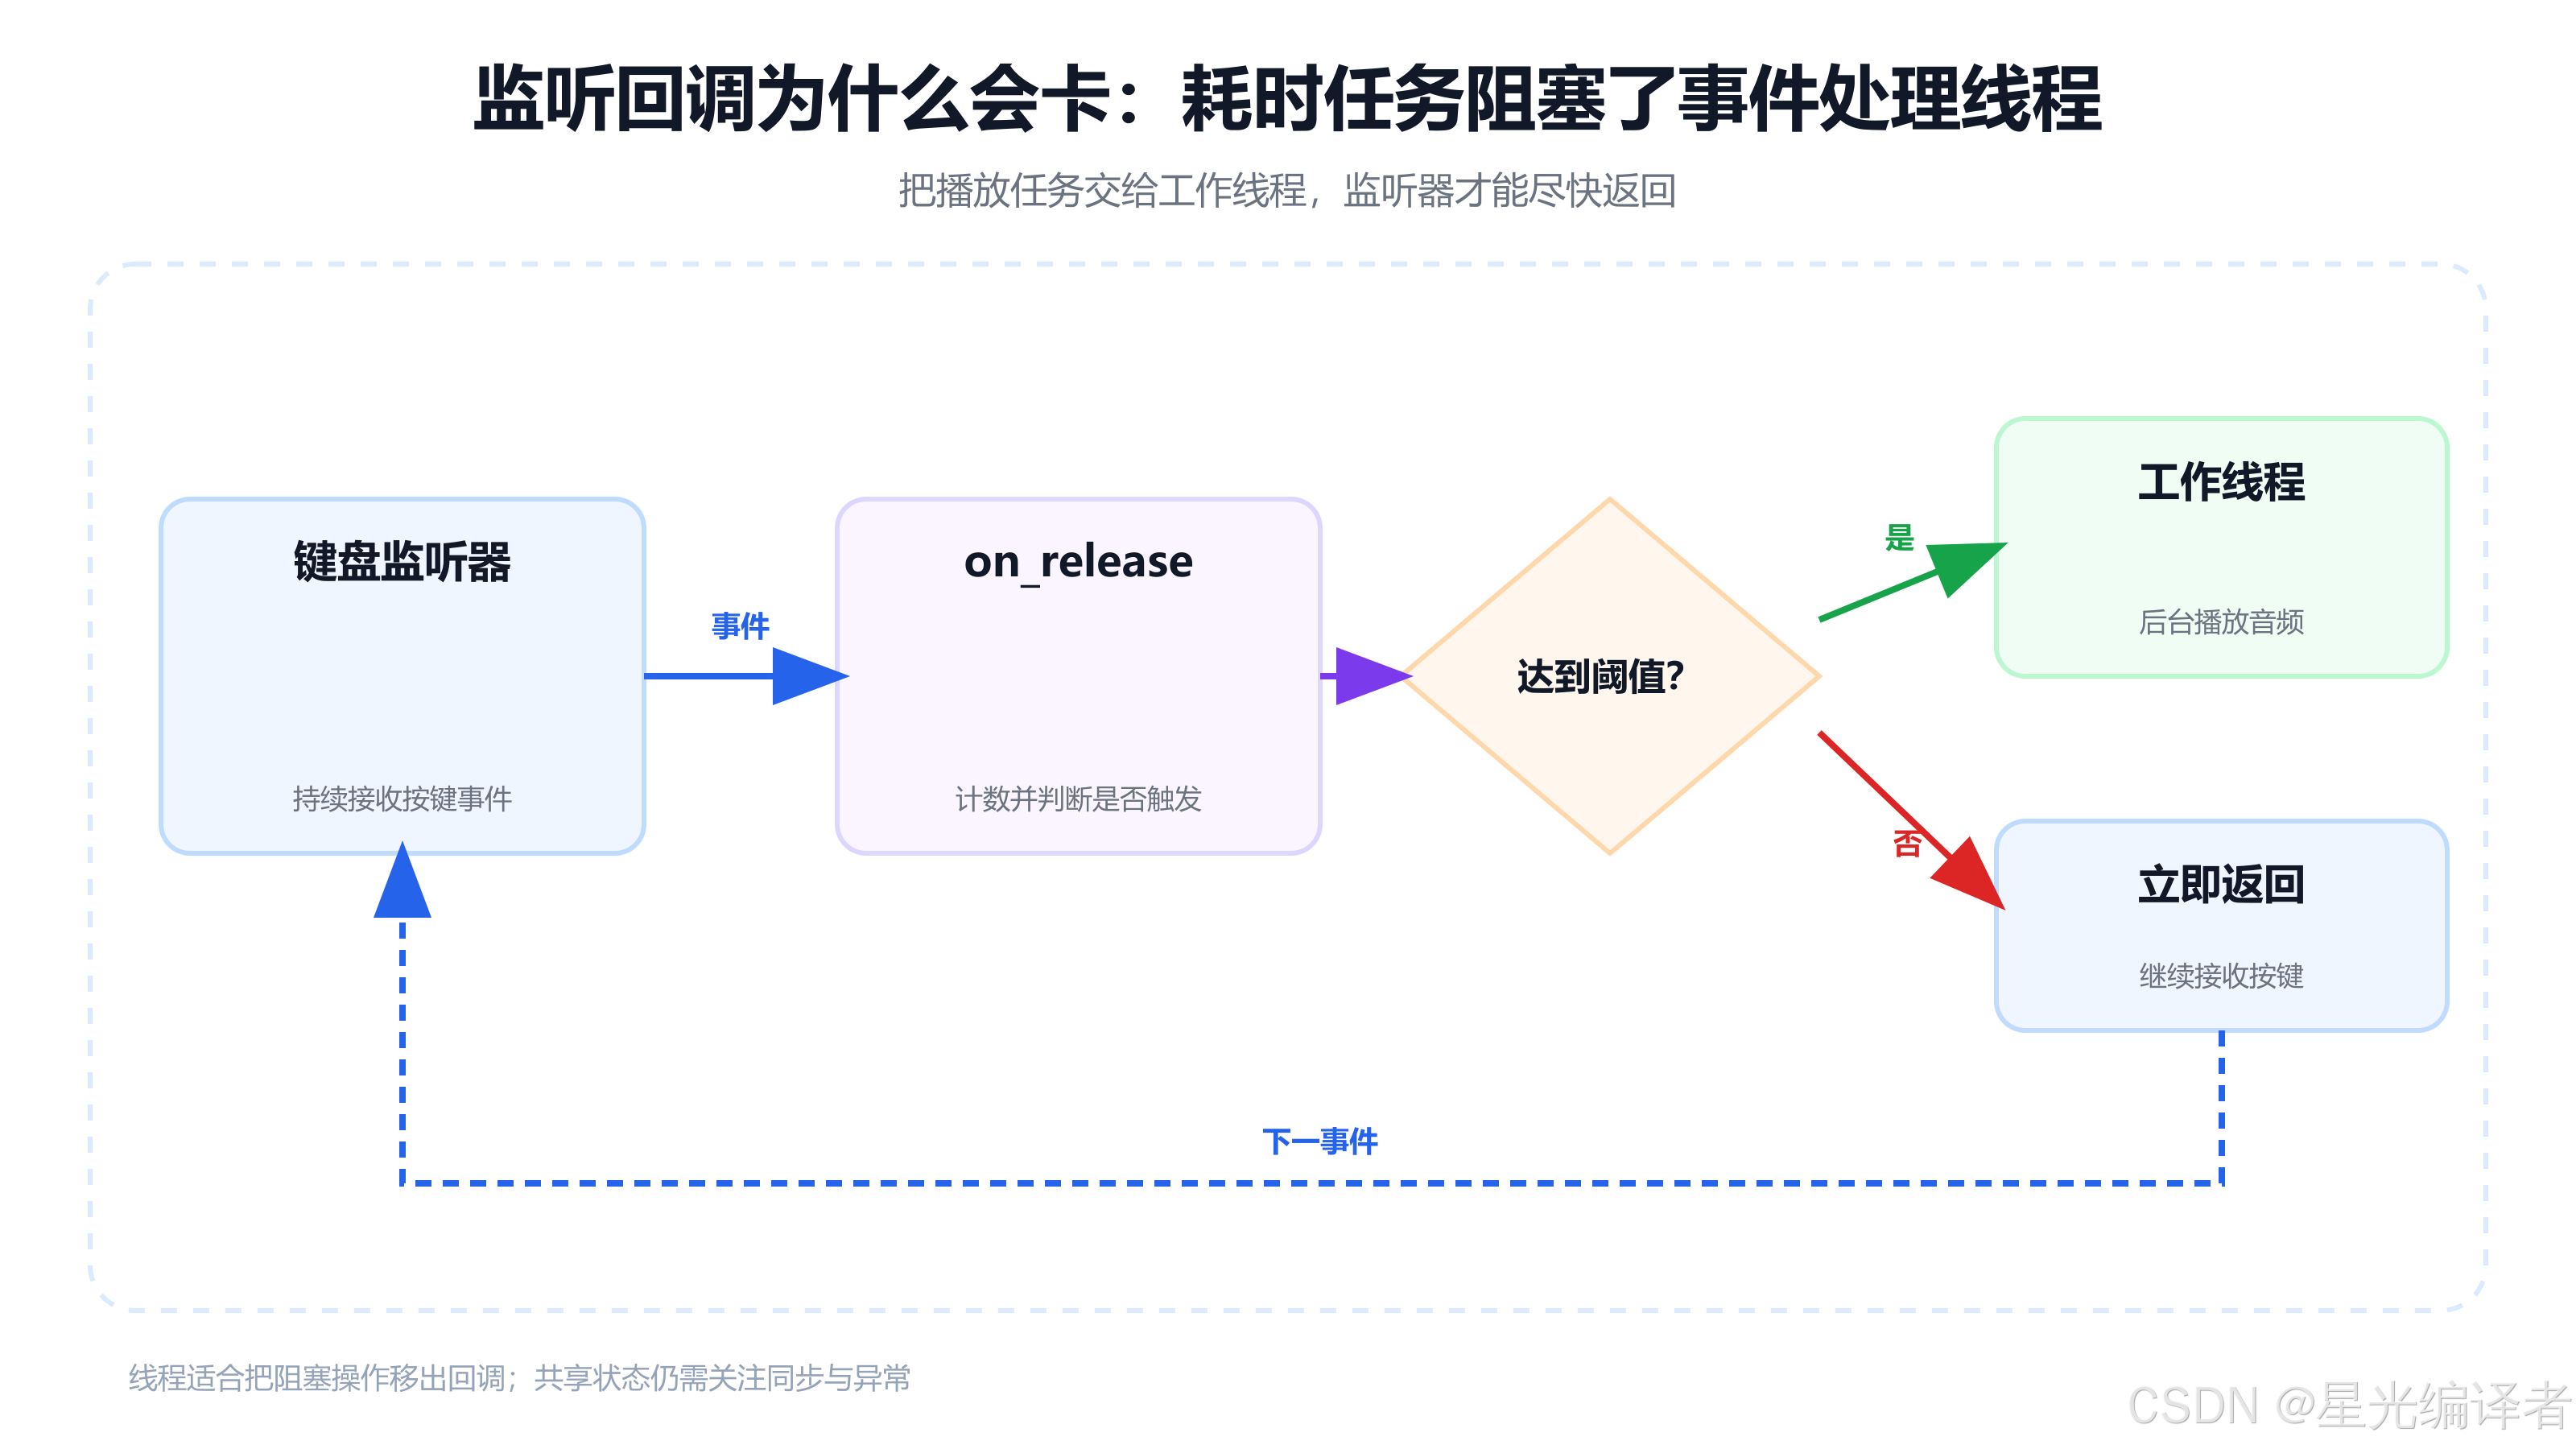
10.3 线程版本还要考虑什么
把任务放进线程并不意味着所有问题自动消失:
- 用户快速触发时,可能同时创建很多播放线程;
- 多个线程可能同时访问共享状态;
- 子线程中的异常不会自然变成主线程的友好提示;
- 程序退出时,要决定是否等待后台任务完成。
更成熟的结构通常使用任务队列和固定数量的工作线程。本文先保留最小示例,重点理解"回调线程不应执行长时间阻塞任务"。
十一、综合项目:命令行学生管理系统
课程最后把前面的函数、列表、字典、文件和第三方工具串成一个完整项目。需求包括:
- 新增学生;
- 显示所有学生;
- 按姓名查找;
- 按学号删除;
- 保存到文件;
- 程序启动时恢复数据。
11.1 先画职责,再写代码
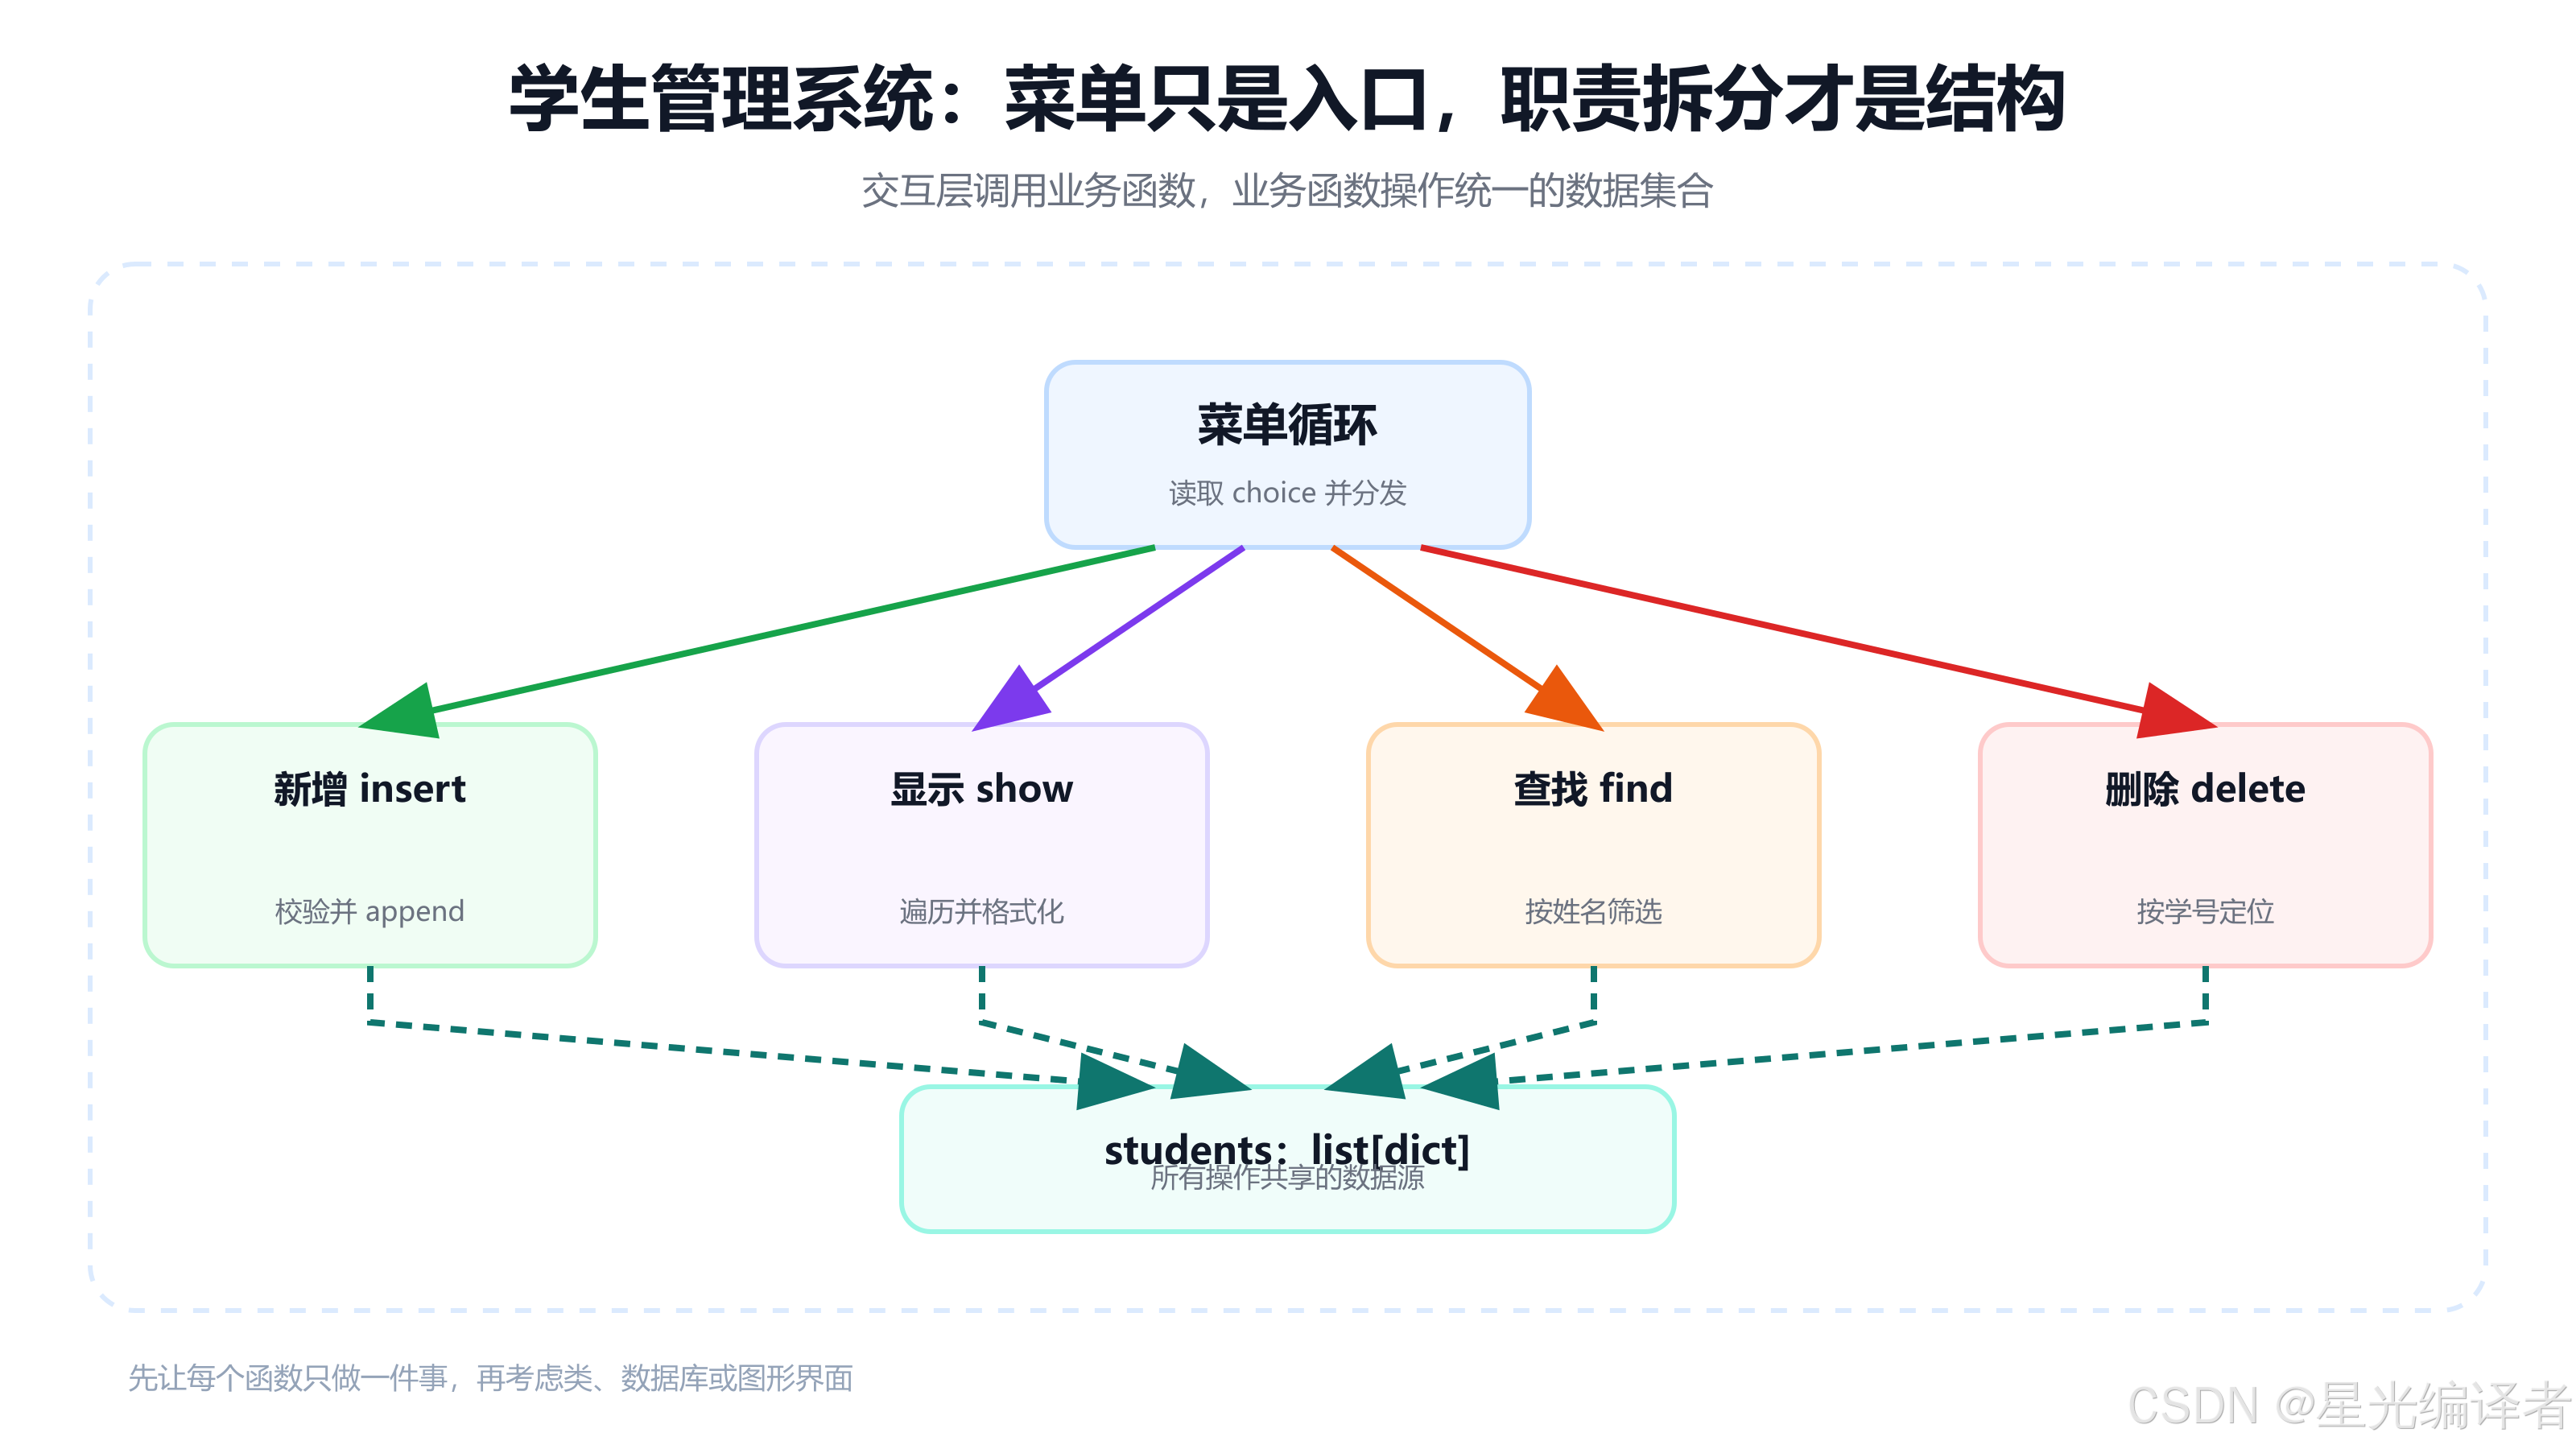
菜单只负责读取选择和分发任务。insert_student()、show_students()、find_students()、delete_student() 分别负责一种业务行为;save_students() 和 load_students() 负责持久化。
如果把所有逻辑都塞进一个巨大的 while True,程序也许能运行,但后续增加"修改学生""按班级统计""导出 Excel"会越来越痛苦。
11.2 数据结构
使用字典表示一个学生:
python
student = {
    "student_id": "2026001",
    "name": "小林",
    "gender": "男",
    "class_name": "Python-01",
}
使用列表保存所有学生:
python
students = [student]这种结构适合小型学习项目。数据量很大或需要高效按学号查询时,可以改成以学号为键的字典,或者使用数据库。
11.3 新增学生
python
def insert_student(students):
    print("[新增学生]")

    student_id = input("学号:").strip()
    if any(item["student_id"] == student_id for item in students):
        print("学号已存在")
        return False

    name = input("姓名:").strip()
    gender = input("性别:").strip()
    class_name = input("班级:").strip()

    if not student_id or not name or not class_name:
        print("学号、姓名和班级不能为空")
        return False

    if gender not in {"男", "女", "其他"}:
        print("性别输入不合法")
        return False

    students.append(
        {
            "student_id": student_id,
            "name": name,
            "gender": gender,
            "class_name": class_name,
        }
    )
    print("新增成功")
    return True
与直接追加相比,这里增加了空值检查和学号唯一性检查,并返回布尔值告诉调用者数据是否发生变化。
11.4 显示学生
python
def show_students(students):
    if not students:
        print("暂无学生记录")
        return

    print(f"{'学号':<14}{'姓名':<12}{'性别':<8}{'班级'}")
    print("-" * 52)

    for student in students:
        print(
            f"{student['student_id']:<14}"
            f"{student['name']:<12}"
            f"{student['gender']:<8}"
            f"{student['class_name']}"
        )
终端中中文字符宽度与 Python 字符串长度并不总是严格一致,因此复杂表格可使用专门格式化库。这里保持基础实现。
11.5 查找学生
python
def find_students(students):
    keyword = input("姓名关键字:").strip().lower()

    matches = [
        student
        for student in students
        if keyword in student["name"].lower()
    ]

    if not matches:
        print("没有找到学生")
        return

    show_students(matches)
课件使用姓名完全相等;这里改成关键字包含,使练习更接近常见搜索体验。
11.6 删除学生
不要在遍历列表的同时删除当前列表中的元素,否则索引移动后可能跳过数据。可以先定位,再删除:
python
def delete_student(students):
    student_id = input("待删除学号:").strip()

    for index, student in enumerate(students):
        if student["student_id"] == student_id:
            confirm = input(f"确认删除 {student['name']}?[y/N] ").strip().lower()
            if confirm == "y":
                del students[index]
                print("删除成功")
                return True
            print("已取消")
            return False

    print("未找到该学号")
    return False
返回值同样表示数据是否改变。主循环可以只在新增或删除成功后存档。
十二、让数据跨越程序生命周期:存档与读档
列表只存在于当前进程内存中。程序退出后,数据就消失。课件使用制表符分隔字段,每个学生占一行,这是一种简单的 TSV 形式。
12.1 保存数据
python
from pathlib import Path


RECORD_FILE = Path("record.tsv")


def save_students(students, filename=RECORD_FILE):
    with filename.open("w", encoding="utf-8", newline="") as file:
        for student in students:
            row = [
                student["student_id"],
                student["name"],
                student["gender"],
                student["class_name"],
            ]
            file.write("\t".join(row) + "\n")
需要明确两点:
"w"会清空旧文件,再写入完整最新数据;- 文本编码显式指定为 UTF-8,避免换机器后中文乱码。
如果字段本身可能包含制表符或换行,手写分隔就不够稳妥,应使用标准库 csv 的 excel-tab 方言,或改用 JSON。
12.2 加载数据
python
def load_students(filename=RECORD_FILE):
    if not filename.exists():
        return []

    students = []

    with filename.open("r", encoding="utf-8") as file:
        for line_number, line in enumerate(file, 1):
            values = line.rstrip("\n").split("\t")

            if len(values) != 4:
                print(f"跳过格式错误的第 {line_number} 行")
                continue

            student_id, name, gender, class_name = values
            students.append(
                {
                    "student_id": student_id,
                    "name": name,
                    "gender": gender,
                    "class_name": class_name,
                }
            )

    return students
加载函数不直接修改全局变量,而是返回新列表。这样更容易测试,也减少函数对外部状态的依赖。
12.3 菜单与入口函数
python
def menu():
    print("\n1. 新增学生")
    print("2. 显示学生")
    print("3. 查找学生")
    print("4. 删除学生")
    print("0. 退出程序")
    return input("请选择:").strip()


def main():
    students = load_students()
    print(f"已加载 {len(students)} 条记录")

    actions = {
        "2": lambda: show_students(students),
        "3": lambda: find_students(students),
    }

    while True:
        choice = menu()

        if choice == "0":
            print("再见")
            return
        if choice == "1":
            if insert_student(students):
                save_students(students)
        elif choice == "4":
            if delete_student(students):
                save_students(students)
        elif choice in actions:
            actions[choice]()
        else:
            print("输入无效,请重试")


if __name__ == "__main__":
    main()
这里保留 if / elif 处理会修改数据的操作,同时用小型分发表展示另一种菜单组织方式。项目继续扩大时,可以把数据访问、业务规则和终端界面拆到不同模块。
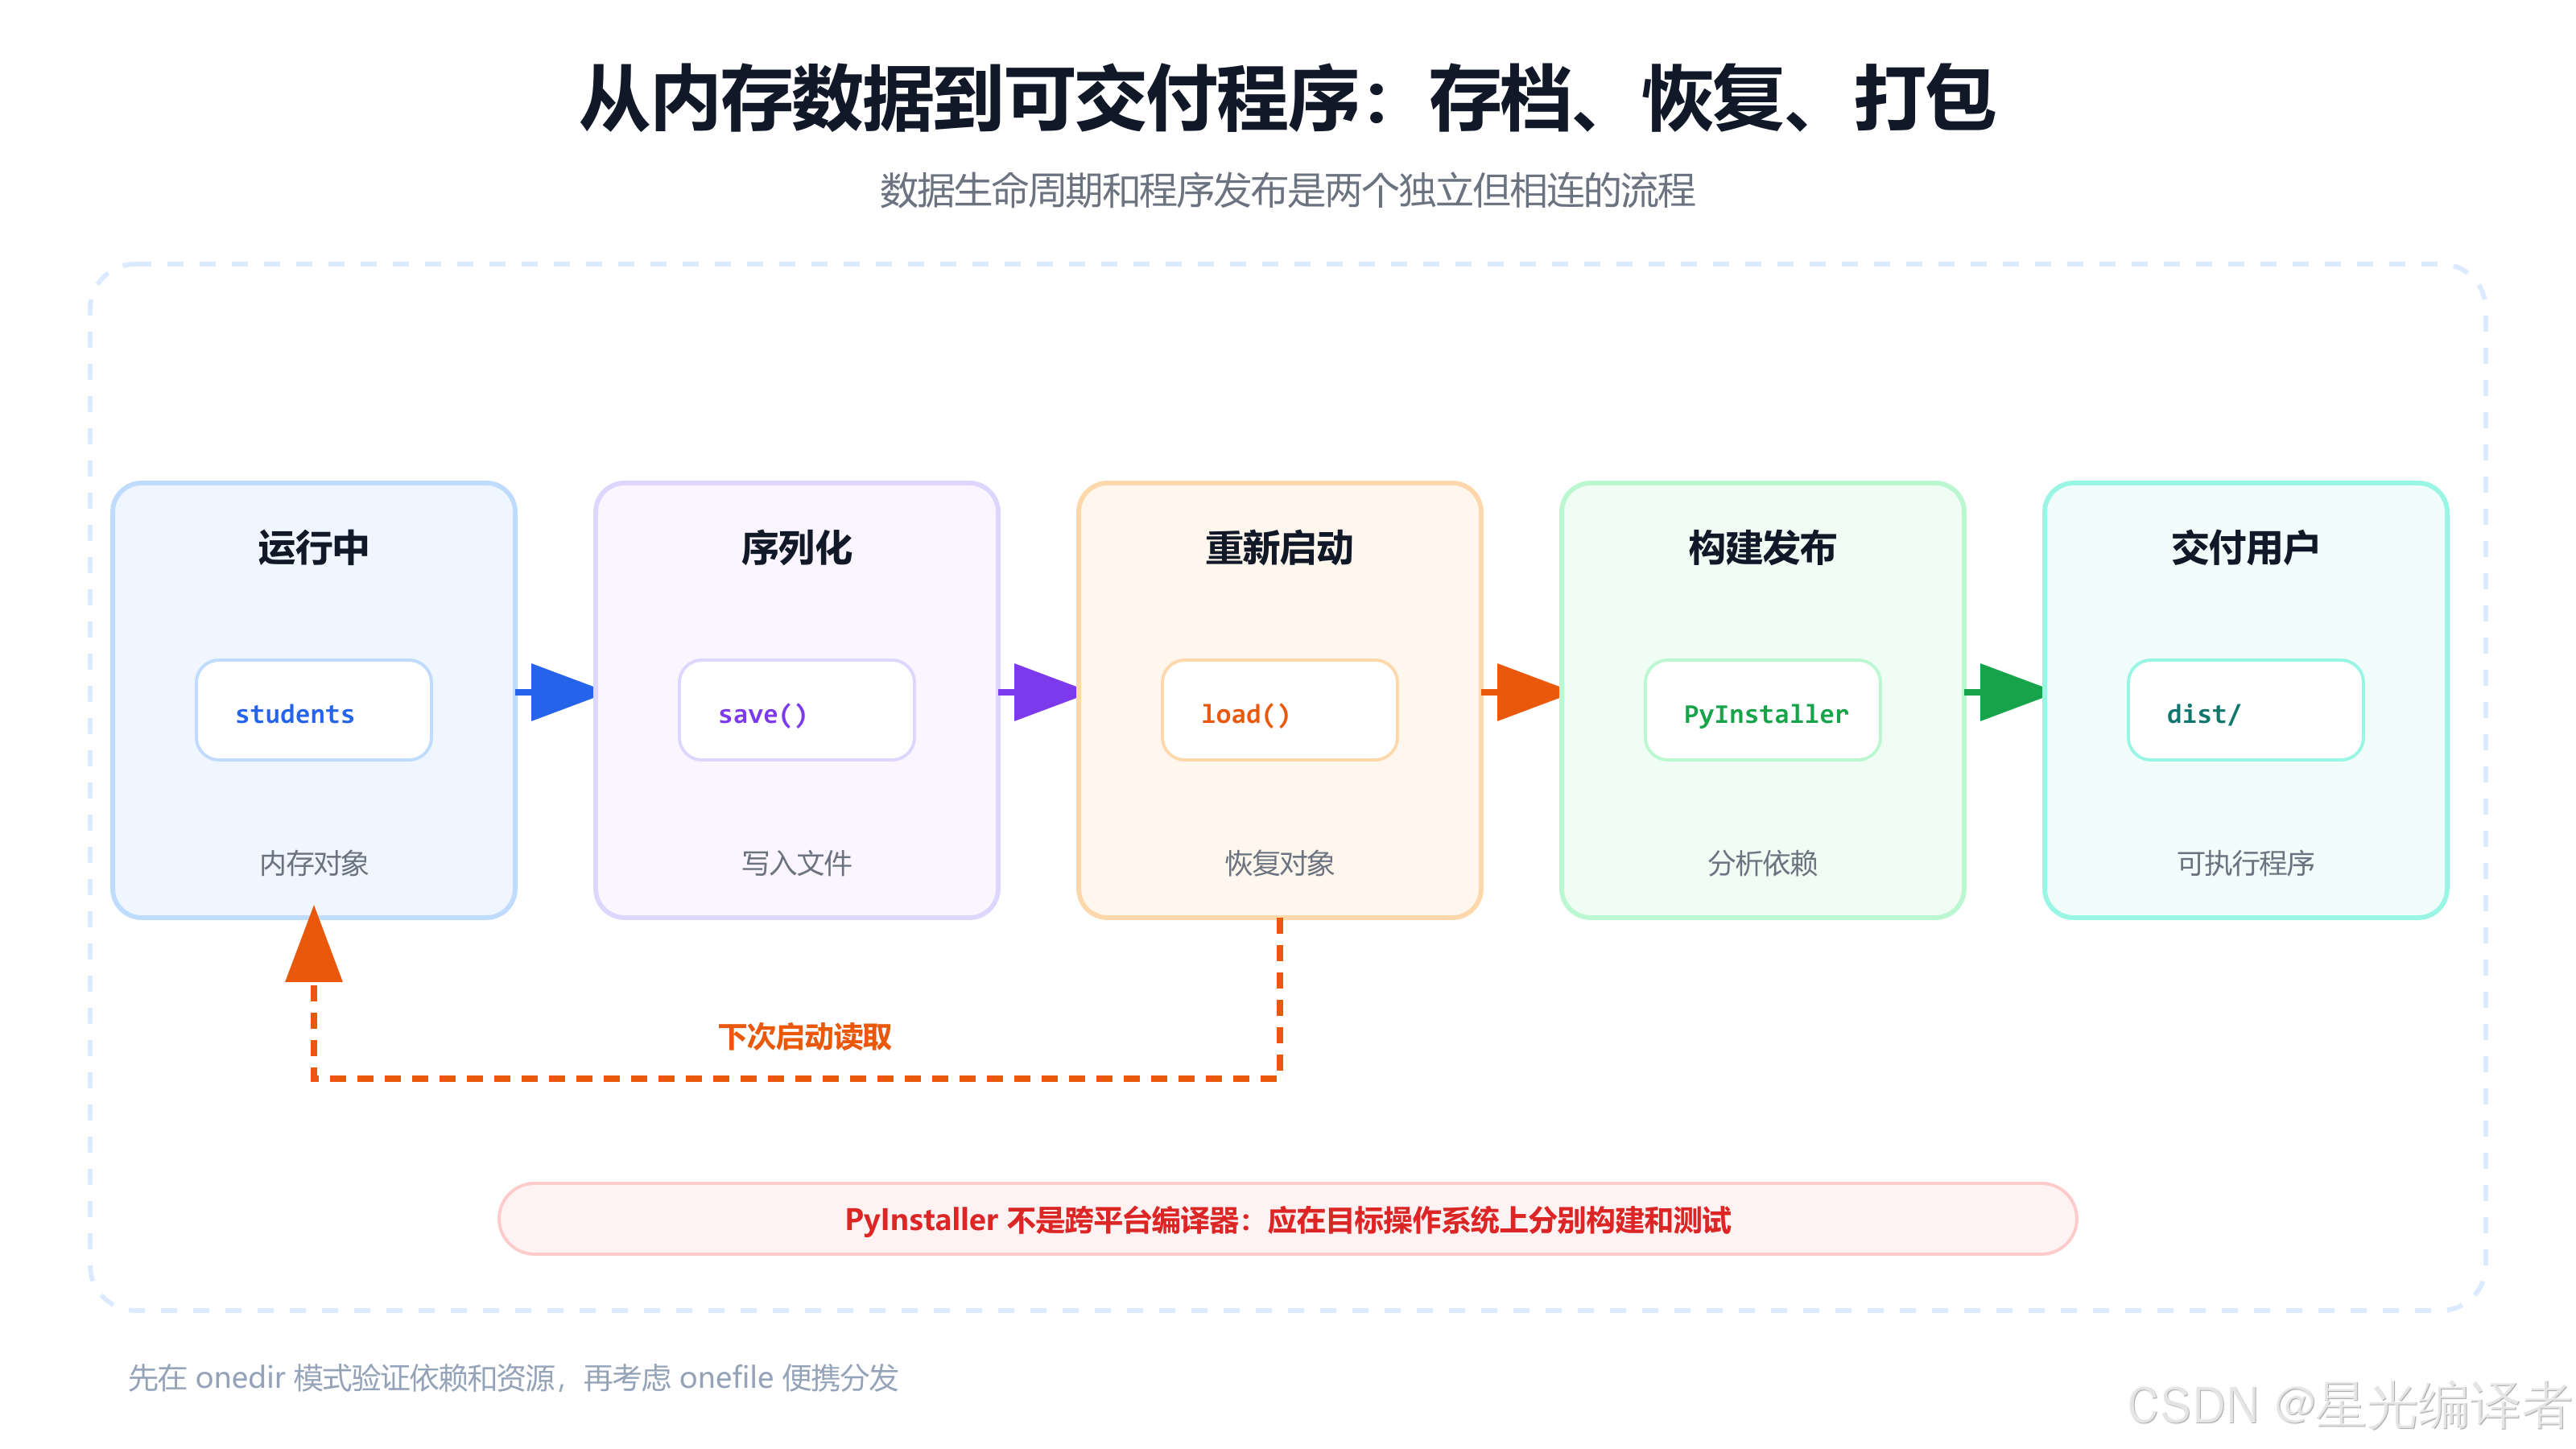
十三、用 PyInstaller 打包与发布
.py 文件通常需要 Python 解释器和依赖环境。PyInstaller 会分析入口脚本及其导入,把解释器、代码和依赖收集成可分发目录,或进一步生成单文件程序。
13.1 安装与基础构建
在项目虚拟环境中安装:
text
python -m pip install pyinstaller先使用默认的 one-folder 模式:
text
python -m PyInstaller student_manager.py构建完成后重点关注:
text
build/                 构建过程产生的临时文件
dist/                  最终可分发结果
student_manager.spec   构建配置
课件最后写成了 pyinstall -F,正确命令名是 pyinstaller。为避免 PATH 中找不到命令,也可以使用模块方式:
text
python -m PyInstaller --onefile student_manager.py13.2 为什么建议先 onedir,再 onefile
--onefile 的确更方便传输,但不是调试打包问题的最佳起点。默认目录模式更容易检查:
- 哪些依赖被收集;
- 外部资源是否存在;
- 动态库是否缺失;
- 程序从哪个位置读取配置和存档。
目录模式验证通过后,再构建单文件版本。
13.3 打包不等于跨平台编译
在 Windows 构建的程序面向 Windows;要发布 macOS 或 Linux 版本,应分别在对应平台构建和测试。操作系统、CPU 架构、Python 版本与底层二进制依赖都可能影响结果。
13.4 外部资源路径
如果程序依赖 ding.mp3、模板、图标等外部文件,需要在构建配置中显式加入,并在运行时正确定位资源。只打包 .py 入口而忽略资源,是"源码能跑、exe 报错"的常见原因。
13.5 打包不是源码保护方案
PyInstaller 的主要目标是分发,不是加密。它会收集编译后的 Python 字节码,不能把业务逻辑变成不可逆的秘密。如果项目包含密钥,也不能因为"已经打成 exe"就把密钥硬编码进去。
十四、常见错误与排查清单
14.1 pip 安装成功,程序仍然找不到模块
大概率安装环境和运行环境不是同一个。分别执行:
text
python -c "import sys; print(sys.executable)"
python -m pip --version
确认两者指向预期环境,并检查 IDE 的项目解释器。
14.2 自己的文件名遮蔽了标准库或第三方包
把脚本命名为 datetime.py、qrcode.py、openpyxl.py,可能导致导入当前文件而不是目标包。重命名后还要清理对应的 __pycache__,再重新运行。
14.3 把安装名当成导入名
并非所有发行包都用同名导入。以项目官方说明为准,不要不断尝试相近名字。
14.4 使用过时教程中的固定版本
固定版本有时是为了可复现或规避兼容问题,但把多年以前的版本号无条件复制到新环境,可能带来 Python 版本不兼容和安全风险。先查看项目当前文档,再决定版本范围。
14.5 from module import * 导致名字冲突
显式导入具体名字,或保留模块前缀。代码多写几个字符,换来更清楚的来源。
14.6 os.walk 拼接路径时手写斜杠
使用 Path(dirpath) / filename,不要依赖某一种操作系统的分隔符。
14.7 Excel 中数字和字符串混用
先打印 repr(value) 或检查 type(value),确认单元格真实类型。必要时统一清洗,但不要在不了解规则时随意转换。
14.8 在事件回调中执行耗时操作
回调应尽快返回。阻塞任务交给工作线程、线程池或任务队列,并控制并发数量。
14.9 遍历列表时直接 remove
删除会改变后续元素索引,可能跳过匹配项。可先找到索引再 del,或用列表推导生成新列表。
14.10 写文件时忘记 w 会覆盖
w 代表重写,a 代表追加。学生系统采用"内存中维护完整状态,每次重写完整快照"的策略,因此 w 是有意选择;使用前仍应确认路径。
14.11 PyInstaller 找不到命令
优先使用:
text
python -m PyInstaller --version模块名中的大小写按官方说明书写。若此命令也失败,说明 PyInstaller 没装进当前解释器环境。
14.12 exe 中找不到数据文件
确认资源是否加入构建、运行时路径如何计算、程序是否把当前工作目录误当成可执行文件目录。先使用目录模式排查,再构建单文件。
十五、高频问答与动手练习
15.1 高频问答
问题一:标准库是不是绝对不需要安装?
它随 Python 发行版提供,但部分模块会受平台和构建选项影响。普通桌面 Python 中常用标准库通常可直接导入,遇到平台差异仍应查看对应版本文档。
问题二:import 会不会每次都重新执行模块?
同一进程中,成功导入的模块通常会缓存在 sys.modules,后续导入复用模块对象。手动重载属于另一套显式操作。
问题三:模块、包和库到底怎么区分?
模块通常对应单个可导入单元,包用于组织多个模块,库是更宽泛的功能集合称呼;pip 安装的是发行包。日常表达可以宽松,排错时要精确。
问题四:为什么一定要虚拟环境?
小脚本并非语法上"必须"使用,但项目隔离能显著减少版本冲突,并让依赖更容易复现。形成习惯的成本很低,长期收益很高。
问题五:requirements.txt 要不要提交?
如果它是项目约定的依赖清单,通常应进入版本控制;.venv 目录不应提交,因为它体积大、与本机路径和平台相关,而且可以重建。
问题六:第三方库越多越好吗?
不是。每个依赖都会增加升级、安全、许可证和部署成本。一个功能若标准库已经清晰满足,就没有必要仅为了"更高级"再引入大型依赖。
问题七:打包后用户一定不需要 Python 吗?
PyInstaller 生成的自包含包会携带运行所需解释器和依赖,用户通常无需另装对应 Python;但程序仍可能依赖操作系统组件、驱动或未正确收集的外部资源。
问题八:onefile 一定优于 onedir 吗?
不一定。单文件便于传输,目录模式启动和调试通常更直接。选择取决于交付场景,不应只看文件数量。
15.2 动手练习
- 导入观察 :编写
helper.py,在顶层打印一句话;从另一个文件连续导入两次,观察输出次数。 - 日期计算:输入生日和今天日期,输出已经生活的天数;对错误日期给出重试提示。
- 字符串组合:不用手写字符循环,完成单词翻转、旋转判断和前缀统计。
- 文件搜索 :为目录搜索器增加扩展名过滤,并跳过
.git和.venv。 - 环境验证 :创建
.venv,安装qrcode[pil],打印sys.executable和qrcode的模块路径。 - 二维码:把个人主页 URL 生成二维码,并尝试调整纠错等级、颜色和边框。
- Excel 统计:增加"按班级汇总平均分"的功能,输出每个班级的数量与平均分。
- 回调解耦 :用
queue.Queue连接监听线程和单个工作线程,避免无限创建播放线程。 - 学生修改:为学生管理系统增加"按学号修改班级"功能,并确保修改成功后自动存档。
- JSON 存档:把 TSV 存档改成 JSON,比较可读性、类型保留和异常处理差异。
- 拆分模块 :将学生系统拆为
main.py、service.py、storage.py,说明每个模块的职责。 - 打包验证:先构建 onedir,确认存档位置与资源文件;再构建 onefile,对比启动和排错体验。
总结
这一讲看似在介绍很多互不相关的工具,真正的主线却只有一条:把别人已经验证过的能力,正确地接入自己的程序。
text
先确认需求
    ↓
判断标准库是否已经提供
    ↓
需要第三方库时查官方文档与 PyPI
    ↓
在项目虚拟环境中安装并验证
    ↓
通过清晰的 import 和函数边界接入
    ↓
记录依赖、处理异常、编写存档
    ↓
在目标平台构建并测试交付物
请记住以下几点:
- 内置能力、标准库、第三方发行包和项目模块处在不同层次。
import会查找并加载模块,再把名字绑定到当前作用域;显式导入更容易维护。- 标准库不需要背诵,关键是知道能力边界,并会查官方文档。
- 优先使用
python -m pip,让安装动作与目标解释器保持一致。 - 每个项目使用独立虚拟环境,并记录依赖,才能让环境可复现。
- 学习第三方库先跑最小示例,再逐步增加参数,不要从复杂代码开始复制。
- 事件回调要尽快返回;阻塞任务应移交工作线程或任务队列。
- 综合项目先拆职责:交互、业务、数据与存储不要全挤在一个函数里。
- 存档格式要考虑编码、分隔符、异常行和覆盖策略。
- PyInstaller 用于分发,不是跨平台编译器,也不是源码加密工具。
当你能独立创建虚拟环境,选择并安装一个库,读懂它的最小示例,把能力接入项目,最后让另一个人按依赖清单复现并运行,你就不再只是"会写几行 Python",而是开始具备组织真实项目的能力。