🔥 星光编译者 · 个人主页
📚 学习专栏: 《C/C++ 成长笔记》 · 《Linux 实践手册》 · 《数据结构与算法》
🌄 向云端飞扬,编译属于自己的代码星河。
☕ 写在开篇
你好,这里是 星光编译者。
这里记录我在 C/C++、Linux、数据结构与算法 学习中遇到的真实问题、亲手验证过的代码,以及那些容易被忽略的实现细节。
比起简单罗列结论,我更愿意从问题出发,把一个知识点的来由讲清楚,把"为什么会这样"和"应该怎样解决"说明白,让每一次踩坑都沉淀成可以复用的经验。
如果这篇记录能帮你少绕一点路,或让某个模糊的地方忽然变得清晰,那么这次分享便有了意义。愿我们在一次次阅读、编译与调试中稳步向前,慢慢搭起属于自己的技术世界。
🔥 本文定位 :在函数指针的基础上,继续理解回调函数如何把"行为"传给通用算法,并以
qsort为主线拆解比较器、void *、元素宽度和逐字节交换。💡 学习目标 :能正确使用
qsort排序整数和结构体;能写出满足契约且不会因减法溢出的比较器;能解释通用排序为何需要void *、size与回调;能独立实现一个教学版泛型冒泡排序。📌 阅读说明 :本文根据课程 PDF《第14讲:深入理解指针(4)》整理,并补充标准接口、边界条件和常见未定义行为。示例按 C11 编写;教学版
generic_bubble_sort用来解释机制,不用于替代经过优化的标准库实现。
文章目录
- 一、从函数指针到回调函数
- 二、qsort:把数据与比较规则分离
- 三、比较器契约:真正重要的是返回值符号
- [四、用 qsort 排序整数](#四、用 qsort 排序整数)
- [五、用 qsort 排序结构体](#五、用 qsort 排序结构体)
- [六、void 指针如何支撑泛型算法](#六、void 指针如何支撑泛型算法)
- 七、模拟实现一个通用冒泡排序
- 八、常见错误、安全边界与工程建议
- 九、高频问答与动手练习
- 总结
一、从函数指针到回调函数
1.1 什么是回调函数
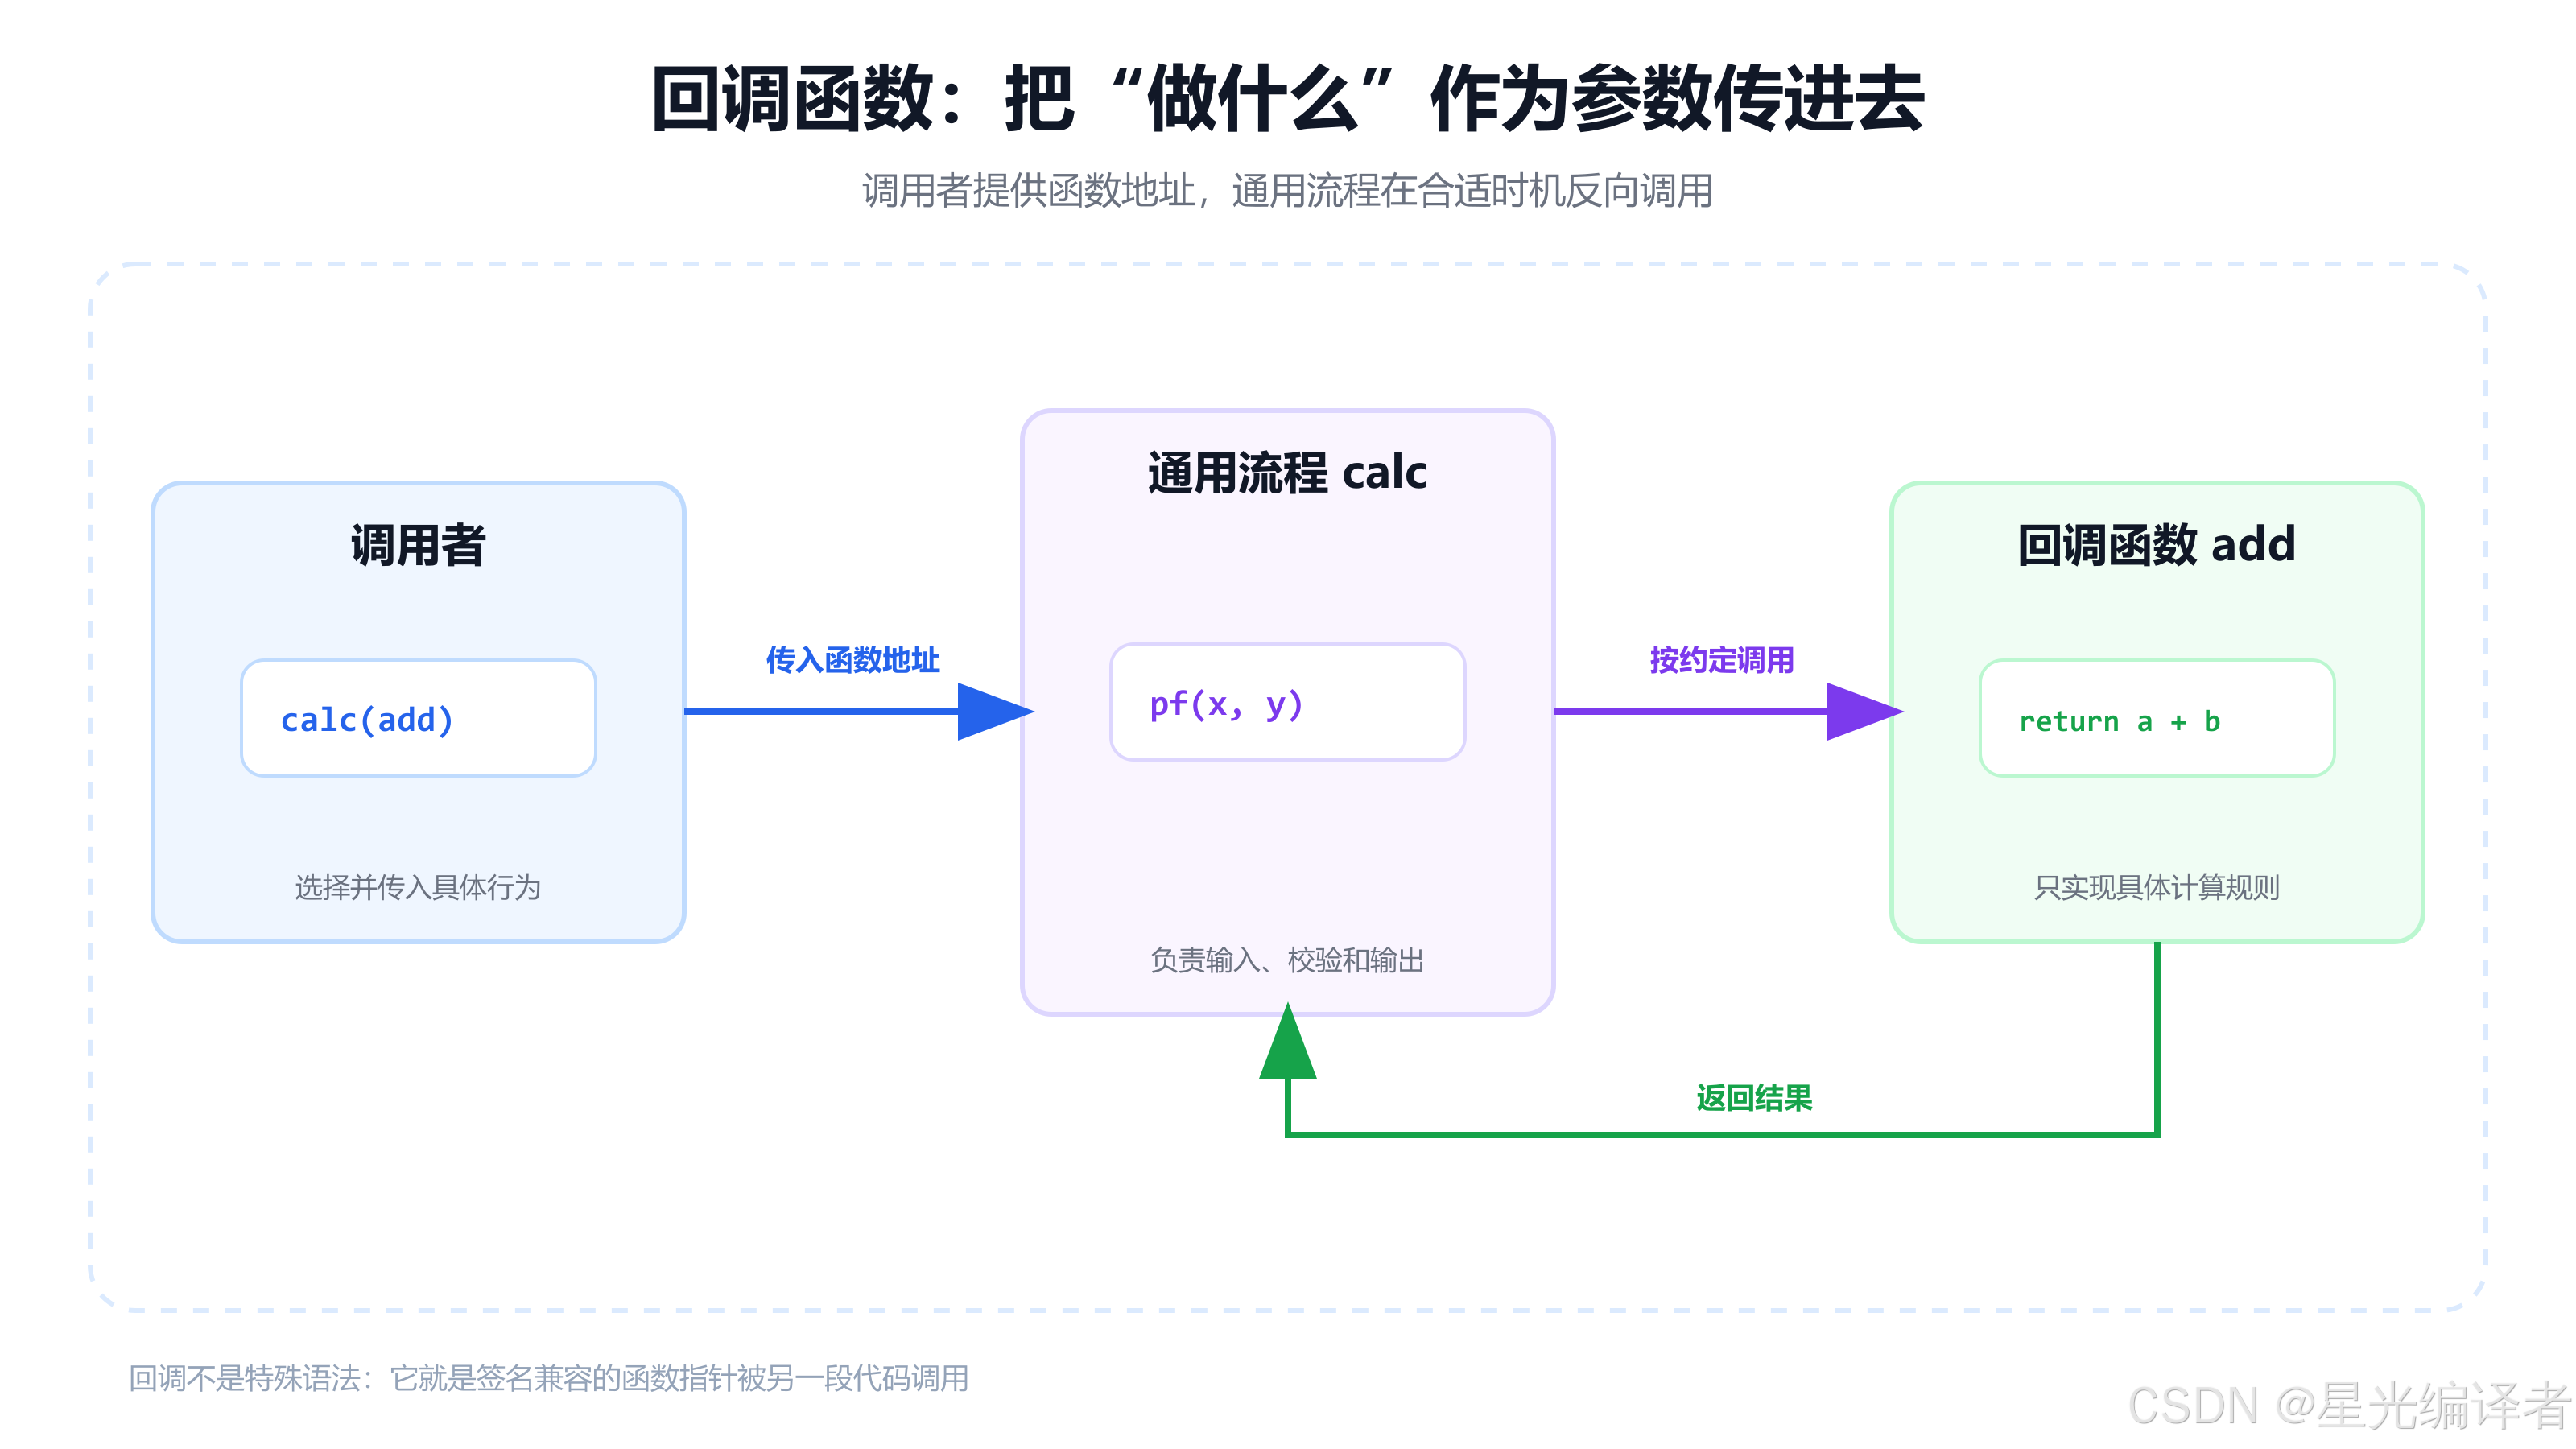
回调函数不是一种新的函数,也不是 C 语言额外提供的神秘语法。它的本质仍然是普通函数,只是调用关系发生了变化:
- 调用者先把某个函数的地址交给另一段代码;
- 另一段代码保存或接收这个函数指针;
- 当流程运行到合适位置时,再通过该指针调用原函数。
因此,可以把回调概括为一句话:
回调函数就是通过函数指针间接调用的函数;它让调用者把"具体行为"作为参数传入通用流程。
1.2 为什么要把函数作为参数
课件使用四则运算计算器引出回调。若直接在 switch 的每个分支中读取两个操作数、执行运算并输出结果,就会反复出现相同的输入输出代码:
c
case 1:
    printf("请输入两个整数:");
    scanf("%d%d", &x, &y);
    result = add(x, y);
    printf("result = %d\n", result);
    break;

case 2:
    printf("请输入两个整数:");
    scanf("%d%d", &x, &y);
    result = sub(x, y);
    printf("result = %d\n", result);
    break;
这两个分支真正不同的只有 add 与 sub,其余流程都相同。既然变化的是"调用哪个函数",就可以把函数地址提取成参数:
c
#include <stdio.h>

typedef int (*binary_operation)(int, int);

static int add(int left, int right)
{
    return left + right;
}

static int sub(int left, int right)
{
    return left - right;
}

static int calculate(binary_operation operation)
{
    int left = 0;
    int right = 0;

    printf("请输入两个整数:");
    if (scanf("%d%d", &left, &right) != 2) {
        return 0;
    }

    printf("result = %d\n", operation(left, right));
    return 1;
}
调用时只需选择行为:
c
calculate(add);
calculate(sub);
calculate 负责不变的输入与输出流程,add、sub 负责变化的计算规则。这样的设计带来三个直接收益:
- 公共流程只保留一份,减少重复代码;
- 新增运算时更容易扩展;
- 输入输出流程与具体算法可以分别测试。
1.3 回调函数必须满足签名约定
形参声明为:
c
int (*operation)(int, int)那么传入的函数就必须接收两个 int,并返回 int。参数数量、参数类型或返回类型不兼容时,不能靠强制转换"骗过"编译器:
c
double average(double, double);

/* 错误思路:强制转换不会让真实调用约定变得兼容。 */
/* calculate((binary_operation)average); */
通过不兼容函数指针类型调用函数会产生未定义行为。正确做法是统一接口,或额外编写一个签名匹配的适配函数。
二、qsort:把数据与比较规则分离
2.1 qsort 的标准接口
qsort 声明在 <stdlib.h> 中。常见声明形式如下:
c
void qsort(void *base,
           size_t nmemb,
           size_t size,
           int (*compar)(const void *, const void *));
这里有四个参数:
| 参数 | 含义 | 调用者需要提供的信息 |
|---|---|---|
base |
待排序数组首元素地址 | 数据从哪里开始 |
nmemb |
元素个数 | 一共有多少个元素 |
size |
单个元素的字节数 | 怎样找到相邻元素 |
compar |
比较器函数指针 | 两个元素谁应排在前面 |
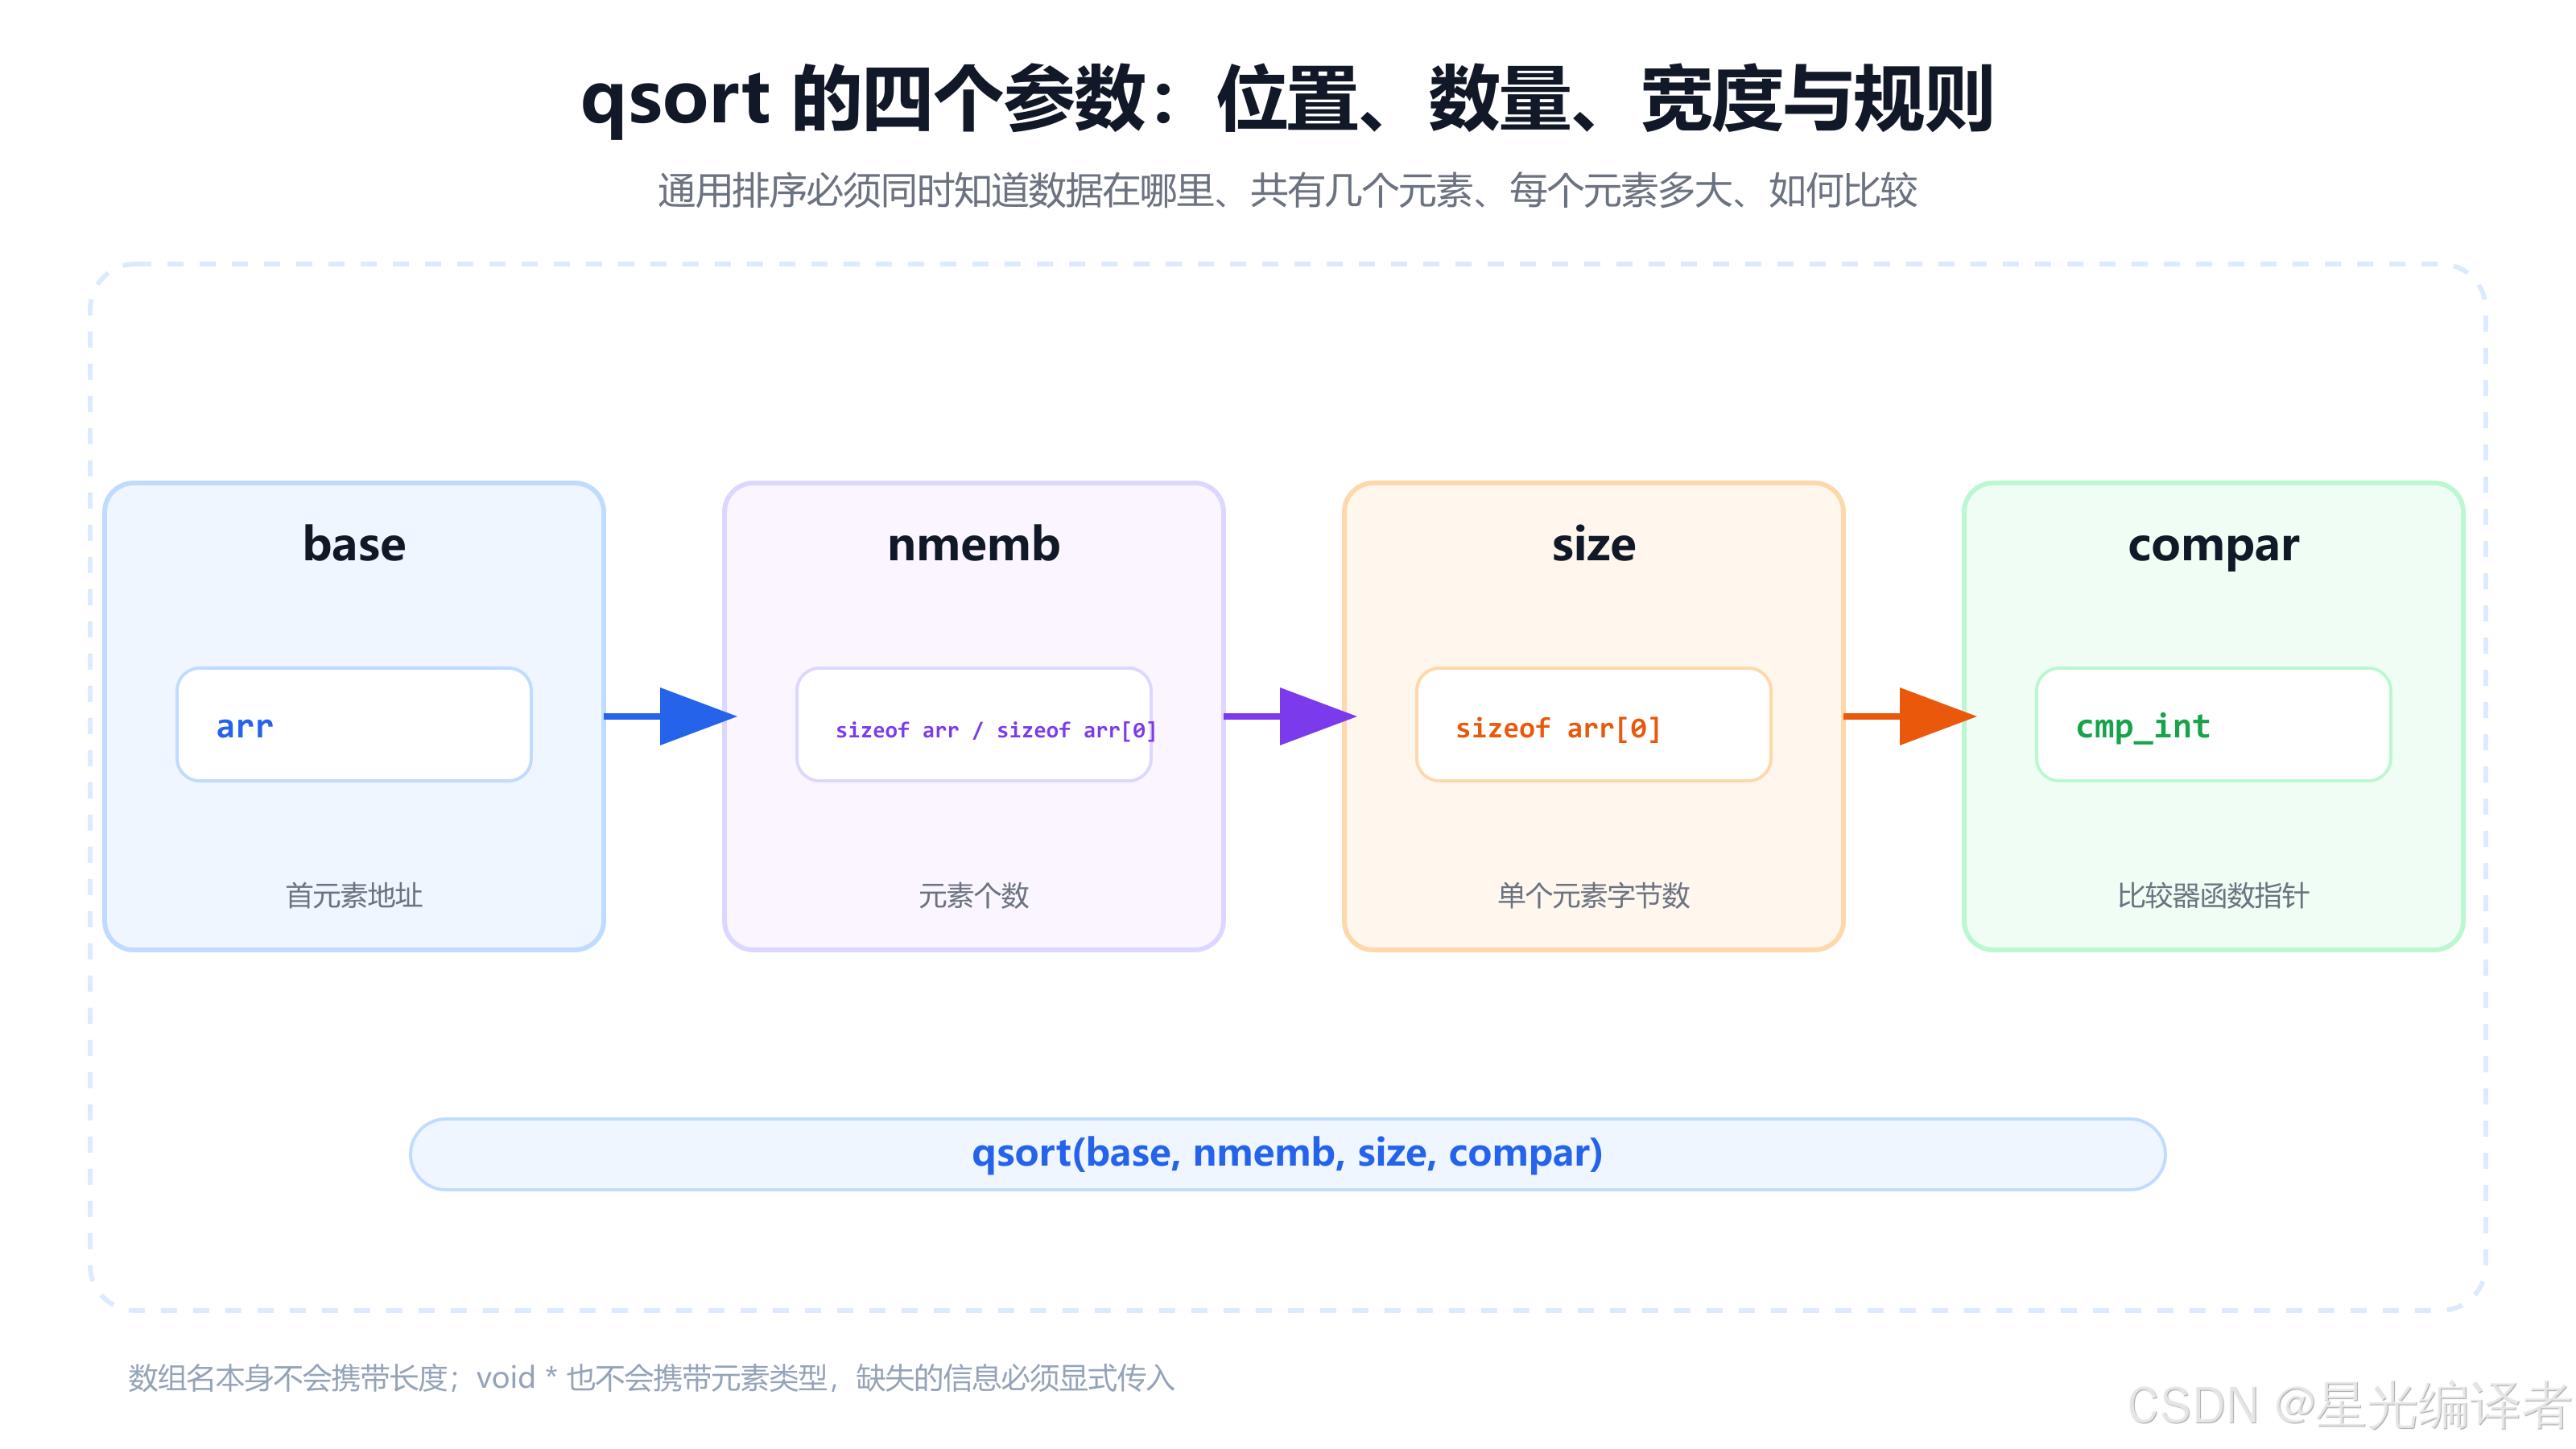
一个典型调用如下:
c
qsort(arr,
      sizeof arr / sizeof arr[0],
      sizeof arr[0],
      compare_int_ascending);
建议把第三个参数写成 sizeof arr[0],而不是手写 sizeof(int)。这样即使将来数组元素类型改变,元素宽度仍会自动保持一致。
2.2 qsort 为什么能够排序不同类型
标准库不知道你要排序的是 int、double、字符串指针还是结构体。它也不需要知道全部细节,因为调用者通过四个参数补齐了算法所需的信息:
text
base + nmemb + size  → 描述一段由等宽元素组成的连续存储
compar               → 描述任意两个元素之间的顺序
qsort 负责"选择元素、比较、重排"这套不变流程;比较器负责把 const void * 恢复成具体类型并定义顺序。这就是泛型算法与回调配合的核心。
2.3 qsort 不承诺什么
使用前还要明确几个边界:
- C 标准没有规定库内部必须使用快速排序;名字叫
qsort,实现仍可以选择其他算法; qsort不保证稳定,相等元素的原有先后次序可能改变;- 比较器接收到的是元素地址,不应在其中修改元素;
- 比较器必须给出自洽顺序,不能对同一对值时而说"大于"、时而说"小于"。
如果业务依赖稳定排序,不能仅凭函数名推测,要选择明确保证稳定性的实现或自行保存原始序号作为次关键字。
三、比较器契约:真正重要的是返回值符号
3.1 三种返回结果
比较器接收两个元素地址,通常记作 left 与 right。qsort 只关心返回值的正负:
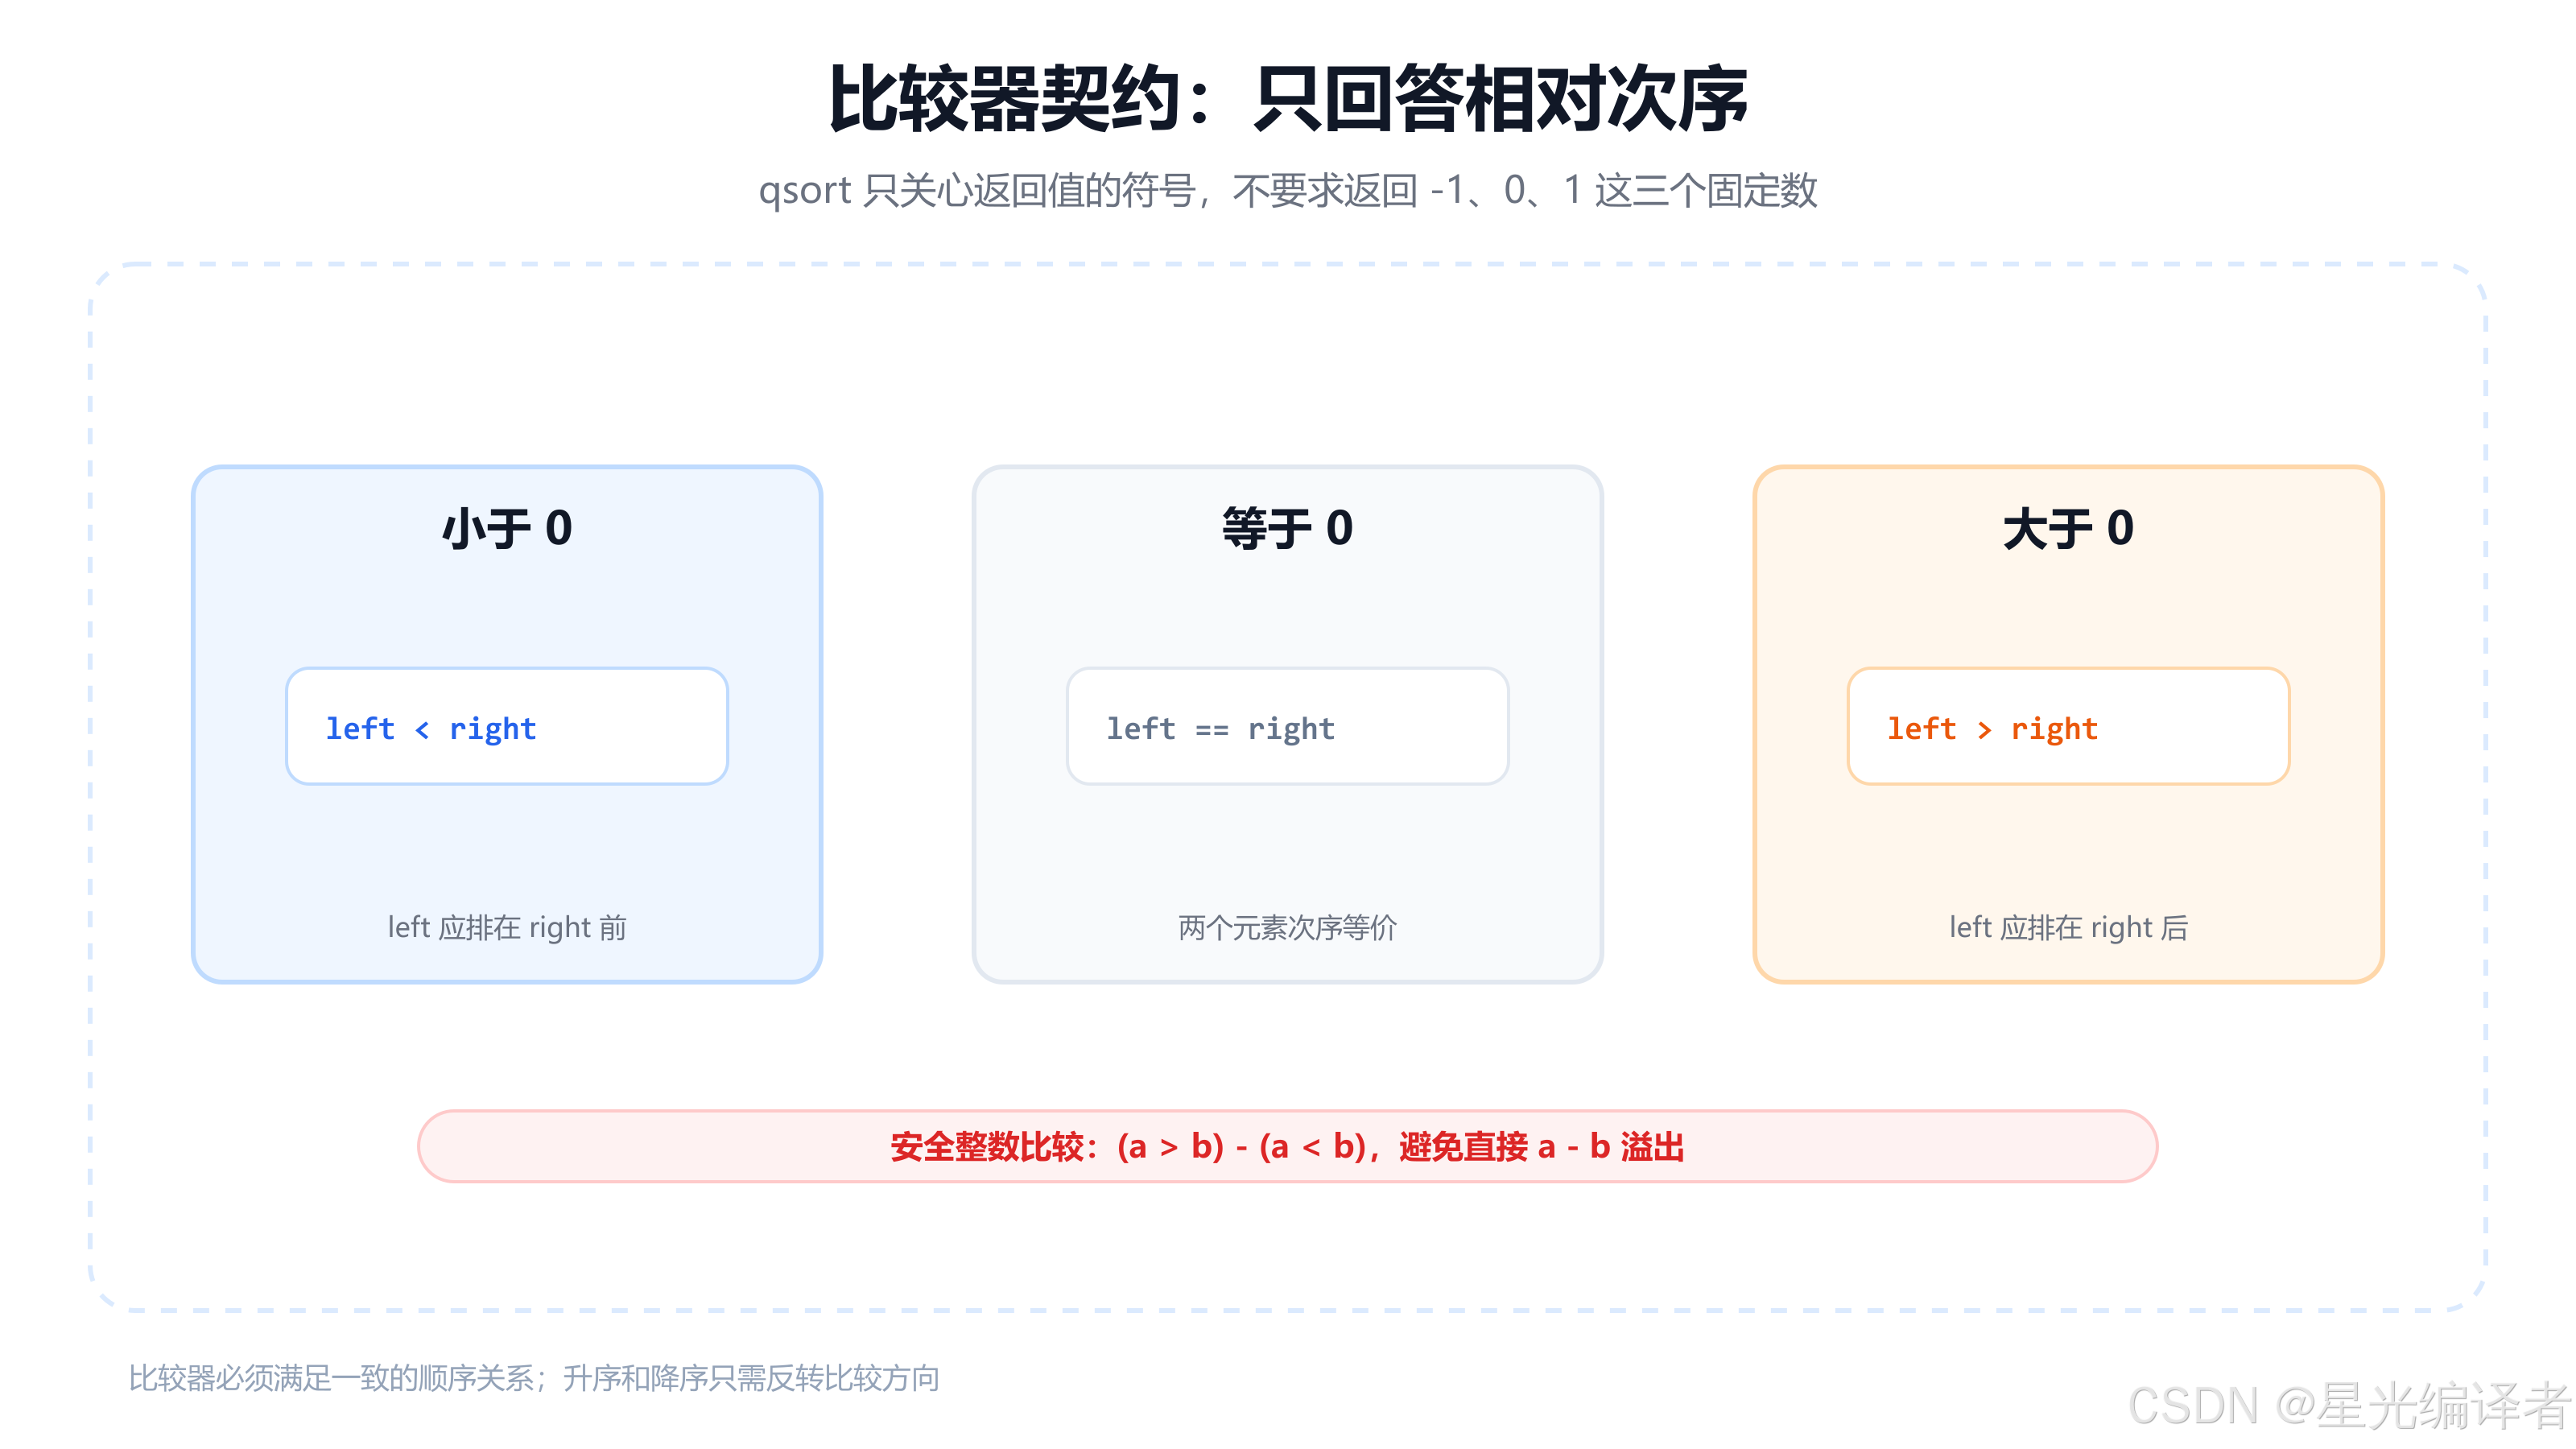
| 返回值 | 含义 |
|---|---|
小于 0 |
left 应排在 right 前面 |
等于 0 |
两个元素在排序意义下等价 |
大于 0 |
left 应排在 right 后面 |
不要求比较器只返回 -1、0、1,但主动归一化为这三个值通常更安全、更易读。
3.2 先转换,再解引用
const void * 不能直接解引用,因为编译器不知道目标对象的大小与解释方式。排序整数时,要先转换成 const int *:
c
static int compare_int_ascending(const void *left,
                                 const void *right)
{
    const int a = *(const int *)left;
    const int b = *(const int *)right;

    return (a > b) - (a < b);
}
表达式 (a > b) - (a < b) 的结果恰好为:
a > b时:1 - 0 = 1;a == b时:0 - 0 = 0;a < b时:0 - 1 = -1。
3.3 为什么不推荐直接 return a - b
课件中的入门写法常见于很多示例:
c
return *(const int *)left - *(const int *)right;对较小数据它通常能得到预期结果,但若左值为 INT_MAX、右值为 -1,减法结果超出 int 范围,会产生有符号整数溢出,而有符号整数溢出是未定义行为。
所以更稳妥的整数升序比较器是:
c
return (a > b) - (a < b);降序则反转方向:
c
static int compare_int_descending(const void *left,
                                  const void *right)
{
    const int a = *(const int *)left;
    const int b = *(const int *)right;

    return (b > a) - (b < a);
}
3.4 比较器要满足一致性
排序算法会以实现自定的顺序、多次调用比较器。比较器不应依赖"这是第几次调用",也不应偷偷修改参与比较的数据。至少要保持这些直觉规则:
- 同一个元素与自己比较,应得到
0; - 若
a < b,交换参数后应得到b > a; - 若
a < b且b < c,就应保持a < c; - 排序期间,比较结果不应因无关的可变全局状态突然改变。
一旦规则自相矛盾,排序结果就失去可靠含义。
四、用 qsort 排序整数
4.1 完整升序示例
c
#include <stdio.h>
#include <stdlib.h>

static int compare_int_ascending(const void *left,
                                 const void *right)
{
    const int a = *(const int *)left;
    const int b = *(const int *)right;
    return (a > b) - (a < b);
}

int main(void)
{
    int numbers[] = {1, 3, 5, 7, 9, 2, 4, 6, 8, 0};
    const size_t count = sizeof numbers / sizeof numbers[0];

    qsort(numbers, count, sizeof numbers[0], compare_int_ascending);

    for (size_t i = 0; i < count; ++i) {
        printf("%d%c", numbers[i], i + 1 == count ? '\n' : ' ');
    }

    return 0;
}
输出为:
text
0 1 2 3 4 5 6 7 8 9这里要注意:
qsort的声明来自<stdlib.h>,不是<stdio.h>;- 元素个数的类型是
size_t; sizeof numbers / sizeof numbers[0]只能在numbers仍是真数组的作用域中正确计算;- 数组一旦作为参数传入函数,形参中的"数组"会调整为指针,不能再用同一公式求原数组长度。
4.2 封装成函数时必须额外传长度
错误思路:
c
void sort_numbers(int numbers[])
{
    /* 此处 sizeof numbers 是指针大小,不是原数组总大小。 */
}
正确接口应显式接收数量:
c
void sort_numbers(int *numbers, size_t count)
{
    qsort(numbers,
          count,
          sizeof numbers[0],
          compare_int_ascending);
}
调用者仍在数组所在作用域计算数量:
c
sort_numbers(numbers, sizeof numbers / sizeof numbers[0]);五、用 qsort 排序结构体
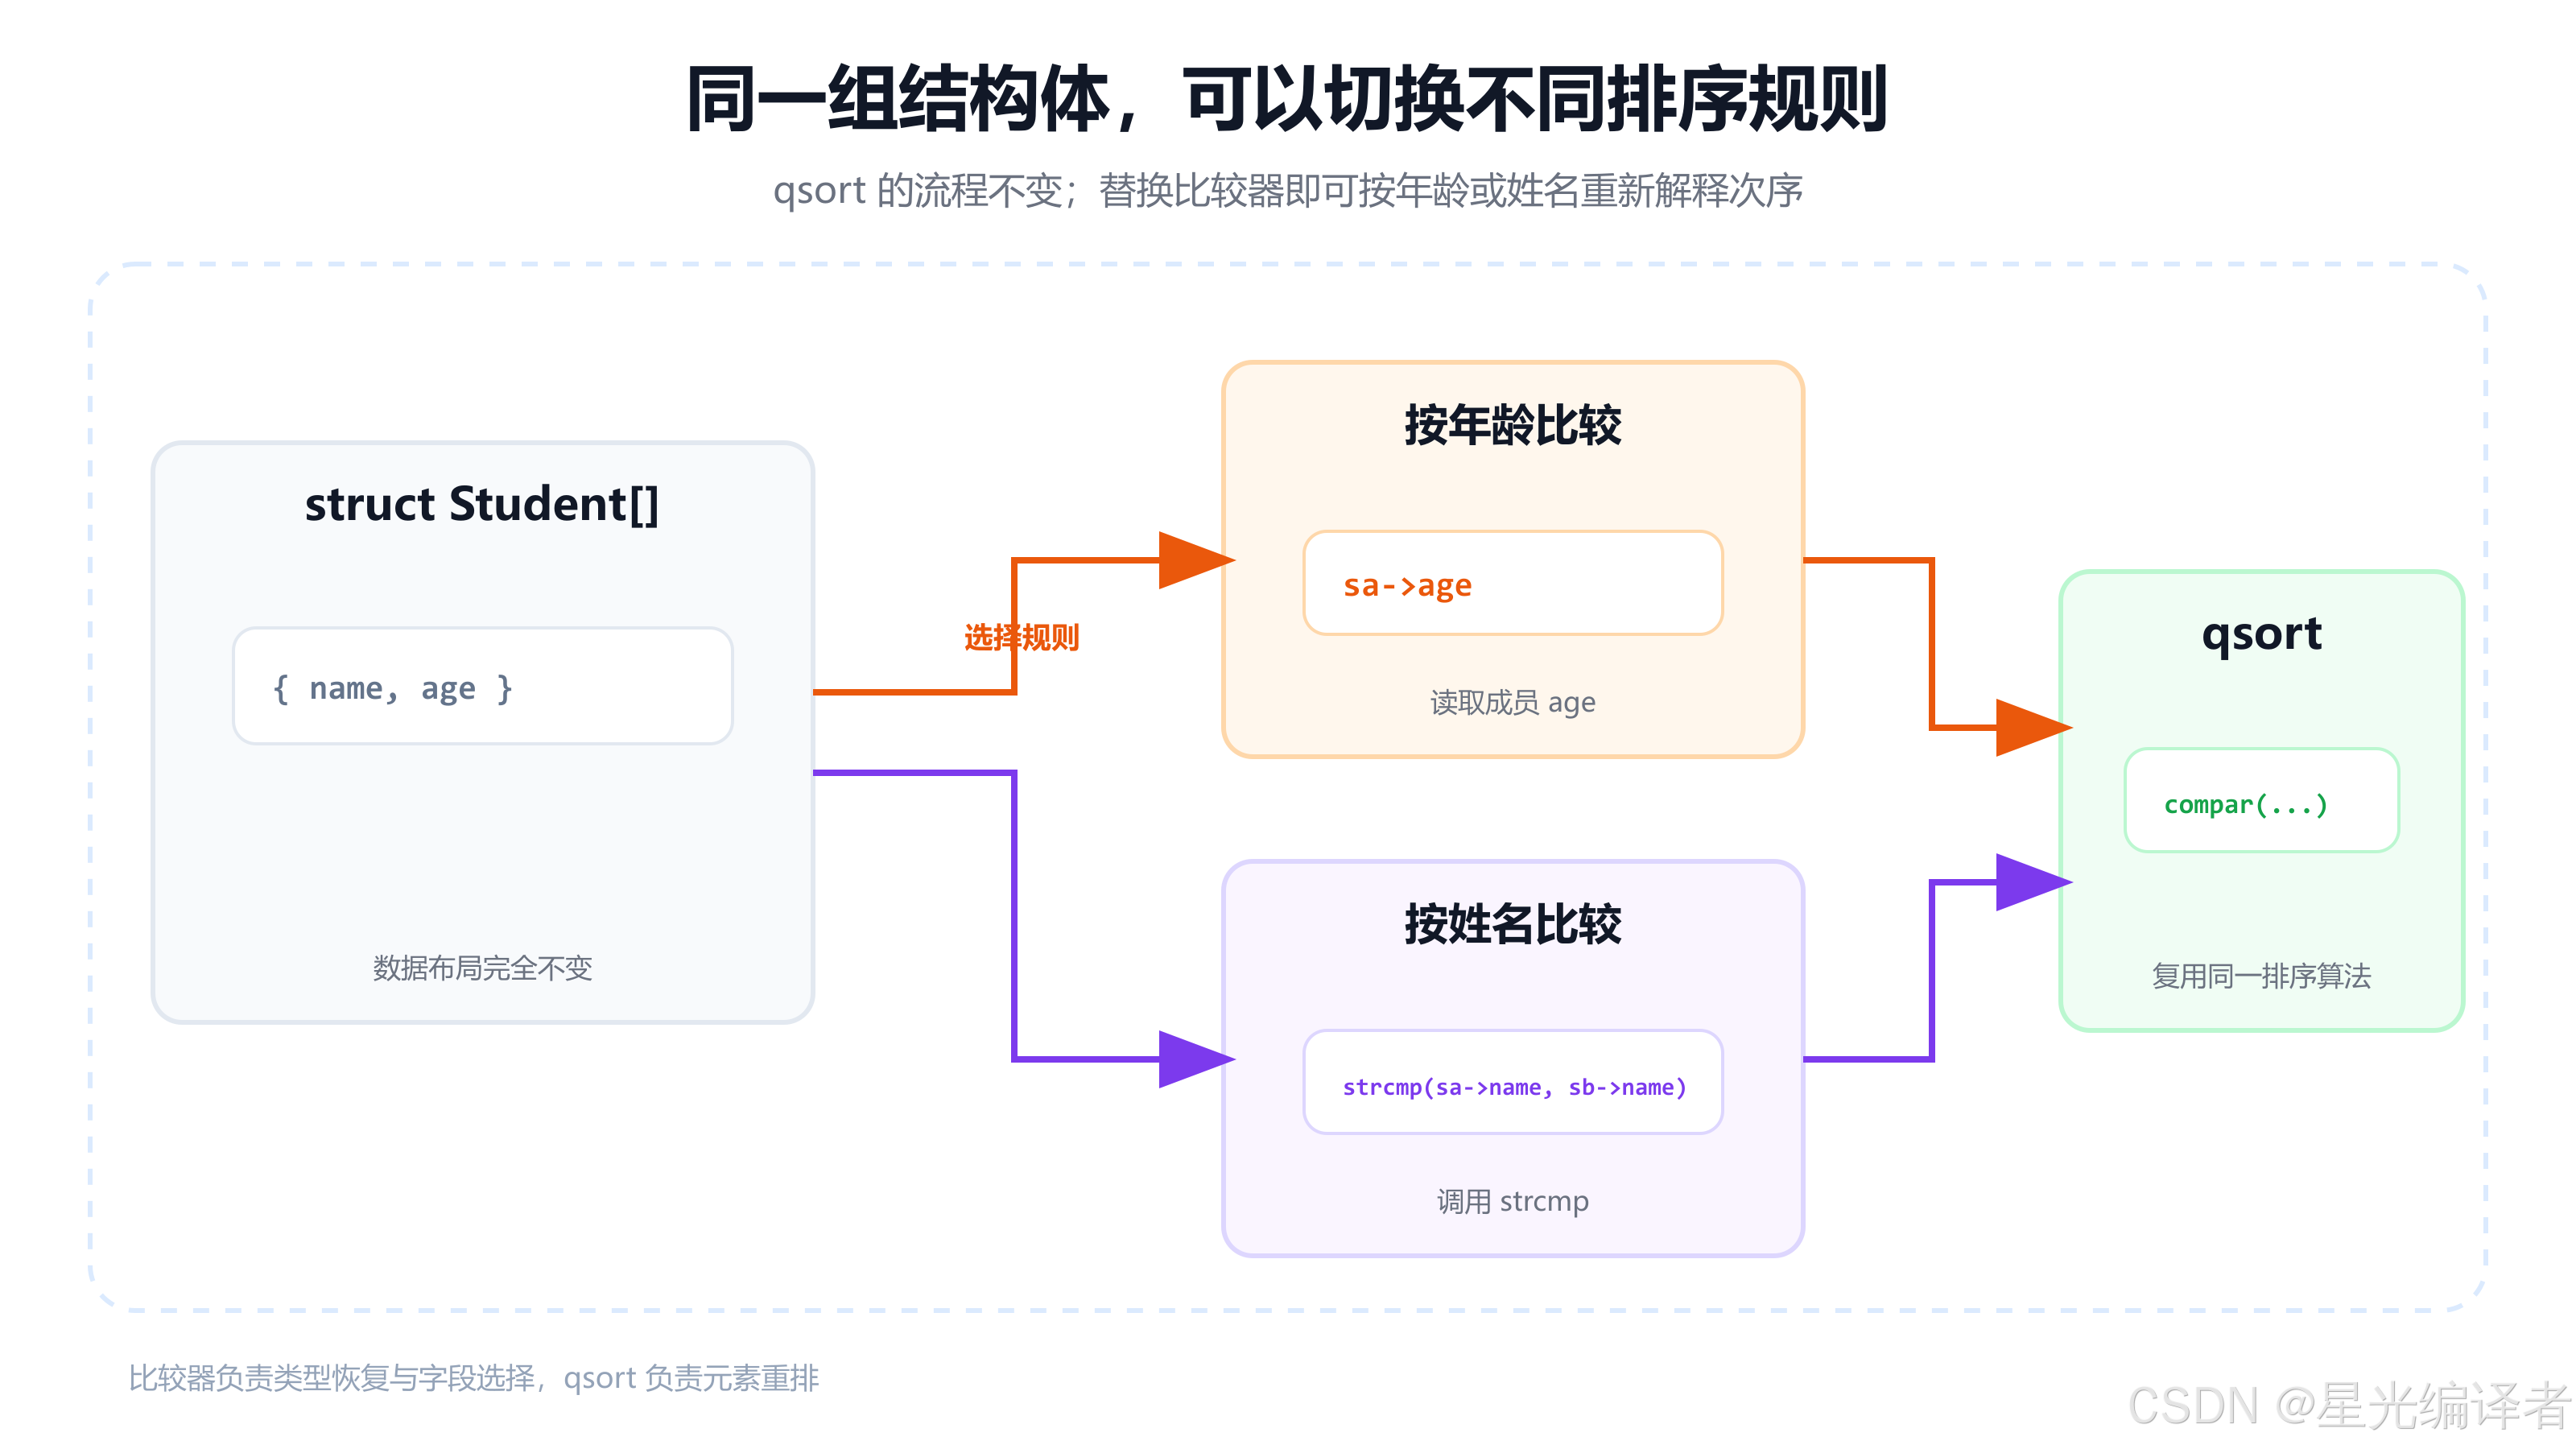
5.1 同一份数据可以有多种顺序
结构体排序更能体现回调的价值。假设有学生数组:
c
struct Student {
    char name[20];
    int age;
};
我们既可以按年龄排序,也可以按姓名排序。数组的数据类型与 qsort 调用框架没有改变,变化的只有比较器。
5.2 按年龄排序
c
static int compare_student_by_age(const void *left,
                                  const void *right)
{
    const struct Student *a = left;
    const struct Student *b = right;

    return (a->age > b->age) - (a->age < b->age);
}
由于任意对象指针都可隐式转换为 void *,void * 也可隐式转换回对象指针,所以在 C 代码中可以直接写:
c
const struct Student *a = left;不必像 C++ 那样显式转换。保留 const 很重要,它表达了比较器只读取元素。
5.3 按姓名排序
姓名是以 \0 结束的字符串,不能使用 == 或直接相减,应调用 <string.h> 中的 strcmp:
c
#include <string.h>

static int compare_student_by_name(const void *left,
                                   const void *right)
{
    const struct Student *a = left;
    const struct Student *b = right;

    return strcmp(a->name, b->name);
}
5.4 完整示例
c
#include <stdio.h>
#include <stdlib.h>
#include <string.h>

struct Student {
    char name[20];
    int age;
};

static int compare_student_by_age(const void *left,
                                  const void *right)
{
    const struct Student *a = left;
    const struct Student *b = right;
    return (a->age > b->age) - (a->age < b->age);
}

static int compare_student_by_name(const void *left,
                                   const void *right)
{
    const struct Student *a = left;
    const struct Student *b = right;
    return strcmp(a->name, b->name);
}

static void print_students(const struct Student *students, size_t count)
{
    for (size_t i = 0; i < count; ++i) {
        printf("%-10s %d\n", students[i].name, students[i].age);
    }
}

int main(void)
{
    struct Student students[] = {
        {"zhangsan", 20},
        {"lisi", 30},
        {"wangwu", 15},
        {"zhaoliu", 20}
    };
    const size_t count = sizeof students / sizeof students[0];

    qsort(students,
          count,
          sizeof students[0],
          compare_student_by_age);
    puts("按年龄升序:");
    print_students(students, count);

    qsort(students,
          count,
          sizeof students[0],
          compare_student_by_name);
    puts("按姓名升序:");
    print_students(students, count);

    return 0;
}
5.5 多关键字排序
若希望"先按年龄升序,年龄相同再按姓名升序",可以在第一个关键字相等时继续比较:
c
static int compare_student(const void *left, const void *right)
{
    const struct Student *a = left;
    const struct Student *b = right;

    if (a->age != b->age) {
        return (a->age > b->age) - (a->age < b->age);
    }

    return strcmp(a->name, b->name);
}
这样即使 qsort 本身不保证稳定,年龄相同的学生也会按姓名形成明确顺序。
六、void 指针如何支撑泛型算法
6.1 void * 是通用对象指针
void * 可以保存任意对象的地址:
c
int number = 42;
double ratio = 0.5;

void *p1 = &number;
void *p2 = ∶
它的优势是通用,代价是丢失了"目标对象是什么类型"的信息。编译器不知道应该读取多少字节,也不知道这些字节应解释为整数、浮点数还是结构体,所以不能直接解引用:
c
/* printf("%d\n", *p1); */ /* 错误:void 没有可解引用的对象大小。 */必须先转换回正确的对象指针:
c
printf("%d\n", *(int *)p1);6.2 标准 C 中不要直接对 void * 做算术
某些编译器把 void * 算术当作扩展,按 1 字节处理,但 ISO C 并未规定 void 的大小。编写可移植 C 代码时,应先转为字符指针:
c
unsigned char *bytes = base;
void *element = bytes + index * size;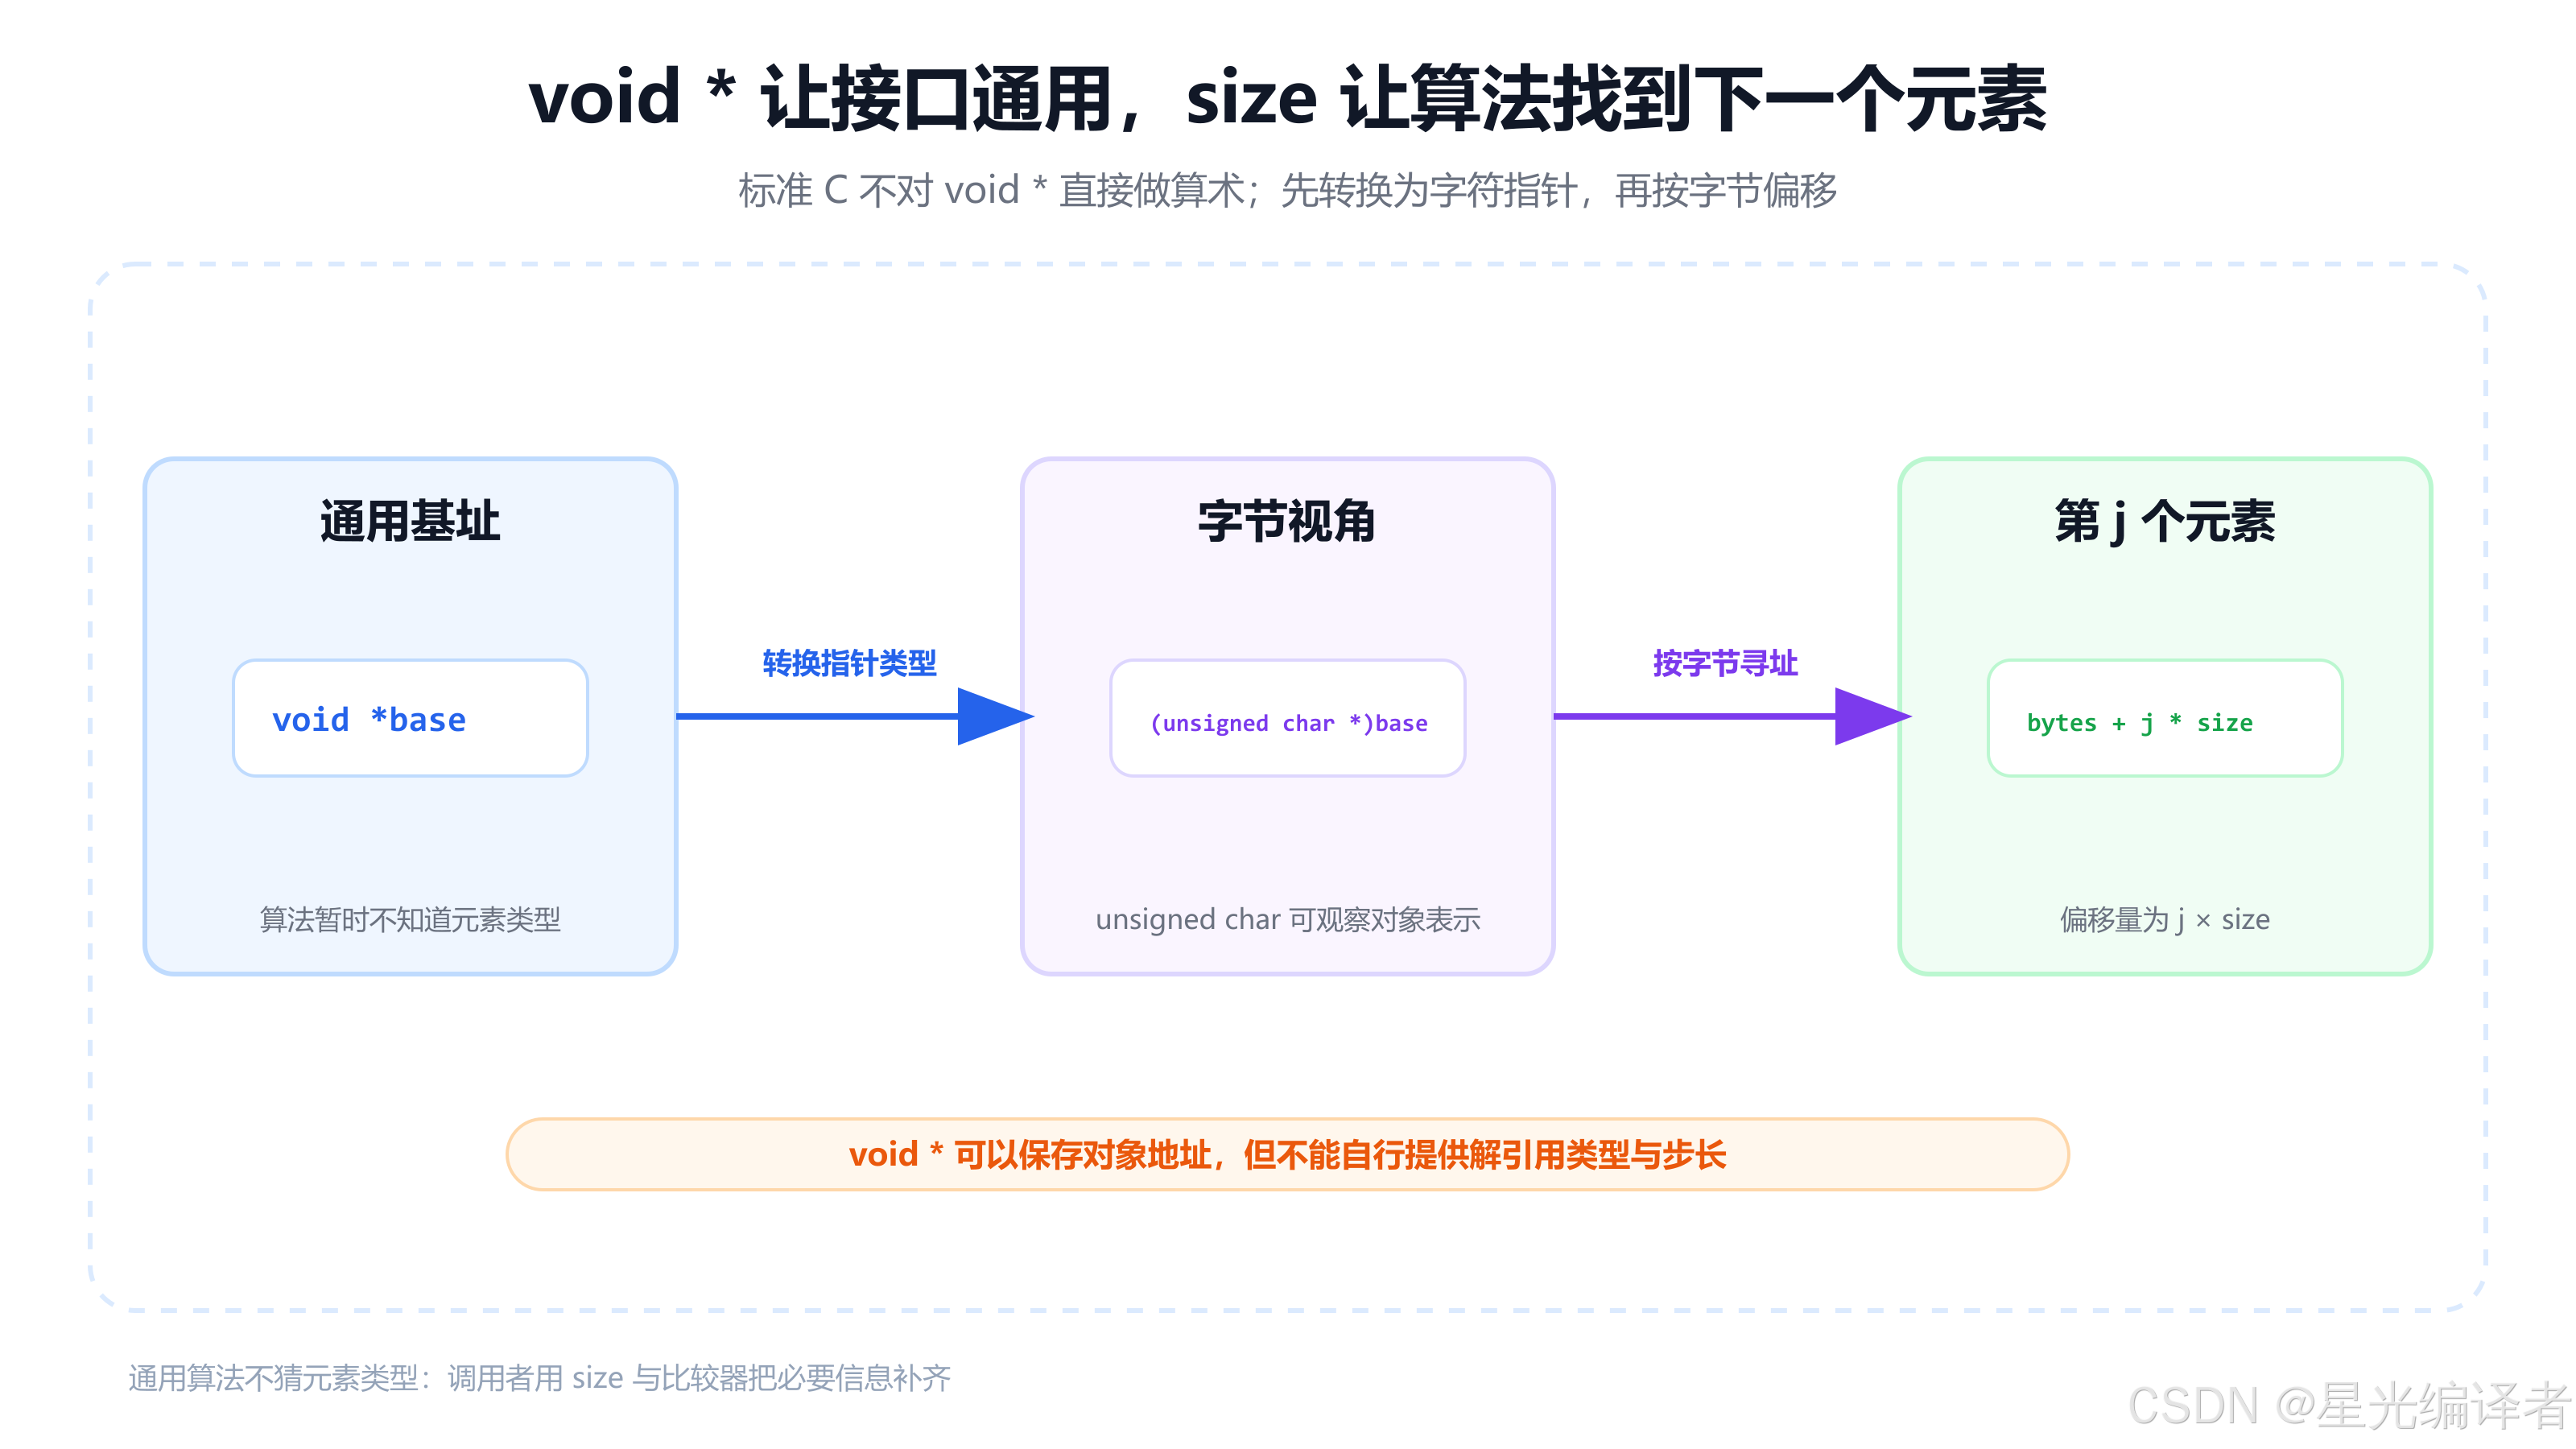
unsigned char 的大小按定义就是 1 字节,并且字符类型允许查看对象的字节表示。因此,通用算法可以把未知元素暂时看作一串字节。
6.3 为什么 qsort 还需要 size
base 只告诉算法起点,void * 本身没有步长。若每个元素占 size 字节,第 j 个元素的地址就是:
text
(unsigned char *)base + j * size相邻元素地址是:
text
(unsigned char *)base + (j + 1) * size这条公式解释了 qsort 的第三个参数为什么不可缺少。没有元素宽度,算法连"下一个元素在哪里"都无法确定。
6.4 void * 不等于关闭类型检查
通用接口只是把类型恢复责任交给调用者。若数组元素是 double,比较器却把地址转换为 int *,代码不会因为使用了 void * 就自动变安全:
c
/* 错误示意:真实元素是 double,却按 int 解释。 */
const int value = *(const int *)left;
base 指向的真实元素类型、size 和比较器中的转换必须三者一致。
七、模拟实现一个通用冒泡排序
7.1 先实现逐字节交换
若只交换 int,可以写 int temp = *a。通用排序不知道元素类型,只知道一个元素占 size 字节,因此可以逐字节交换:
c
static void swap_bytes(void *left, void *right, size_t size)
{
    unsigned char *a = left;
    unsigned char *b = right;

    for (size_t i = 0; i < size; ++i) {
        const unsigned char temp = a[i];
        a[i] = b[i];
        b[i] = temp;
    }
}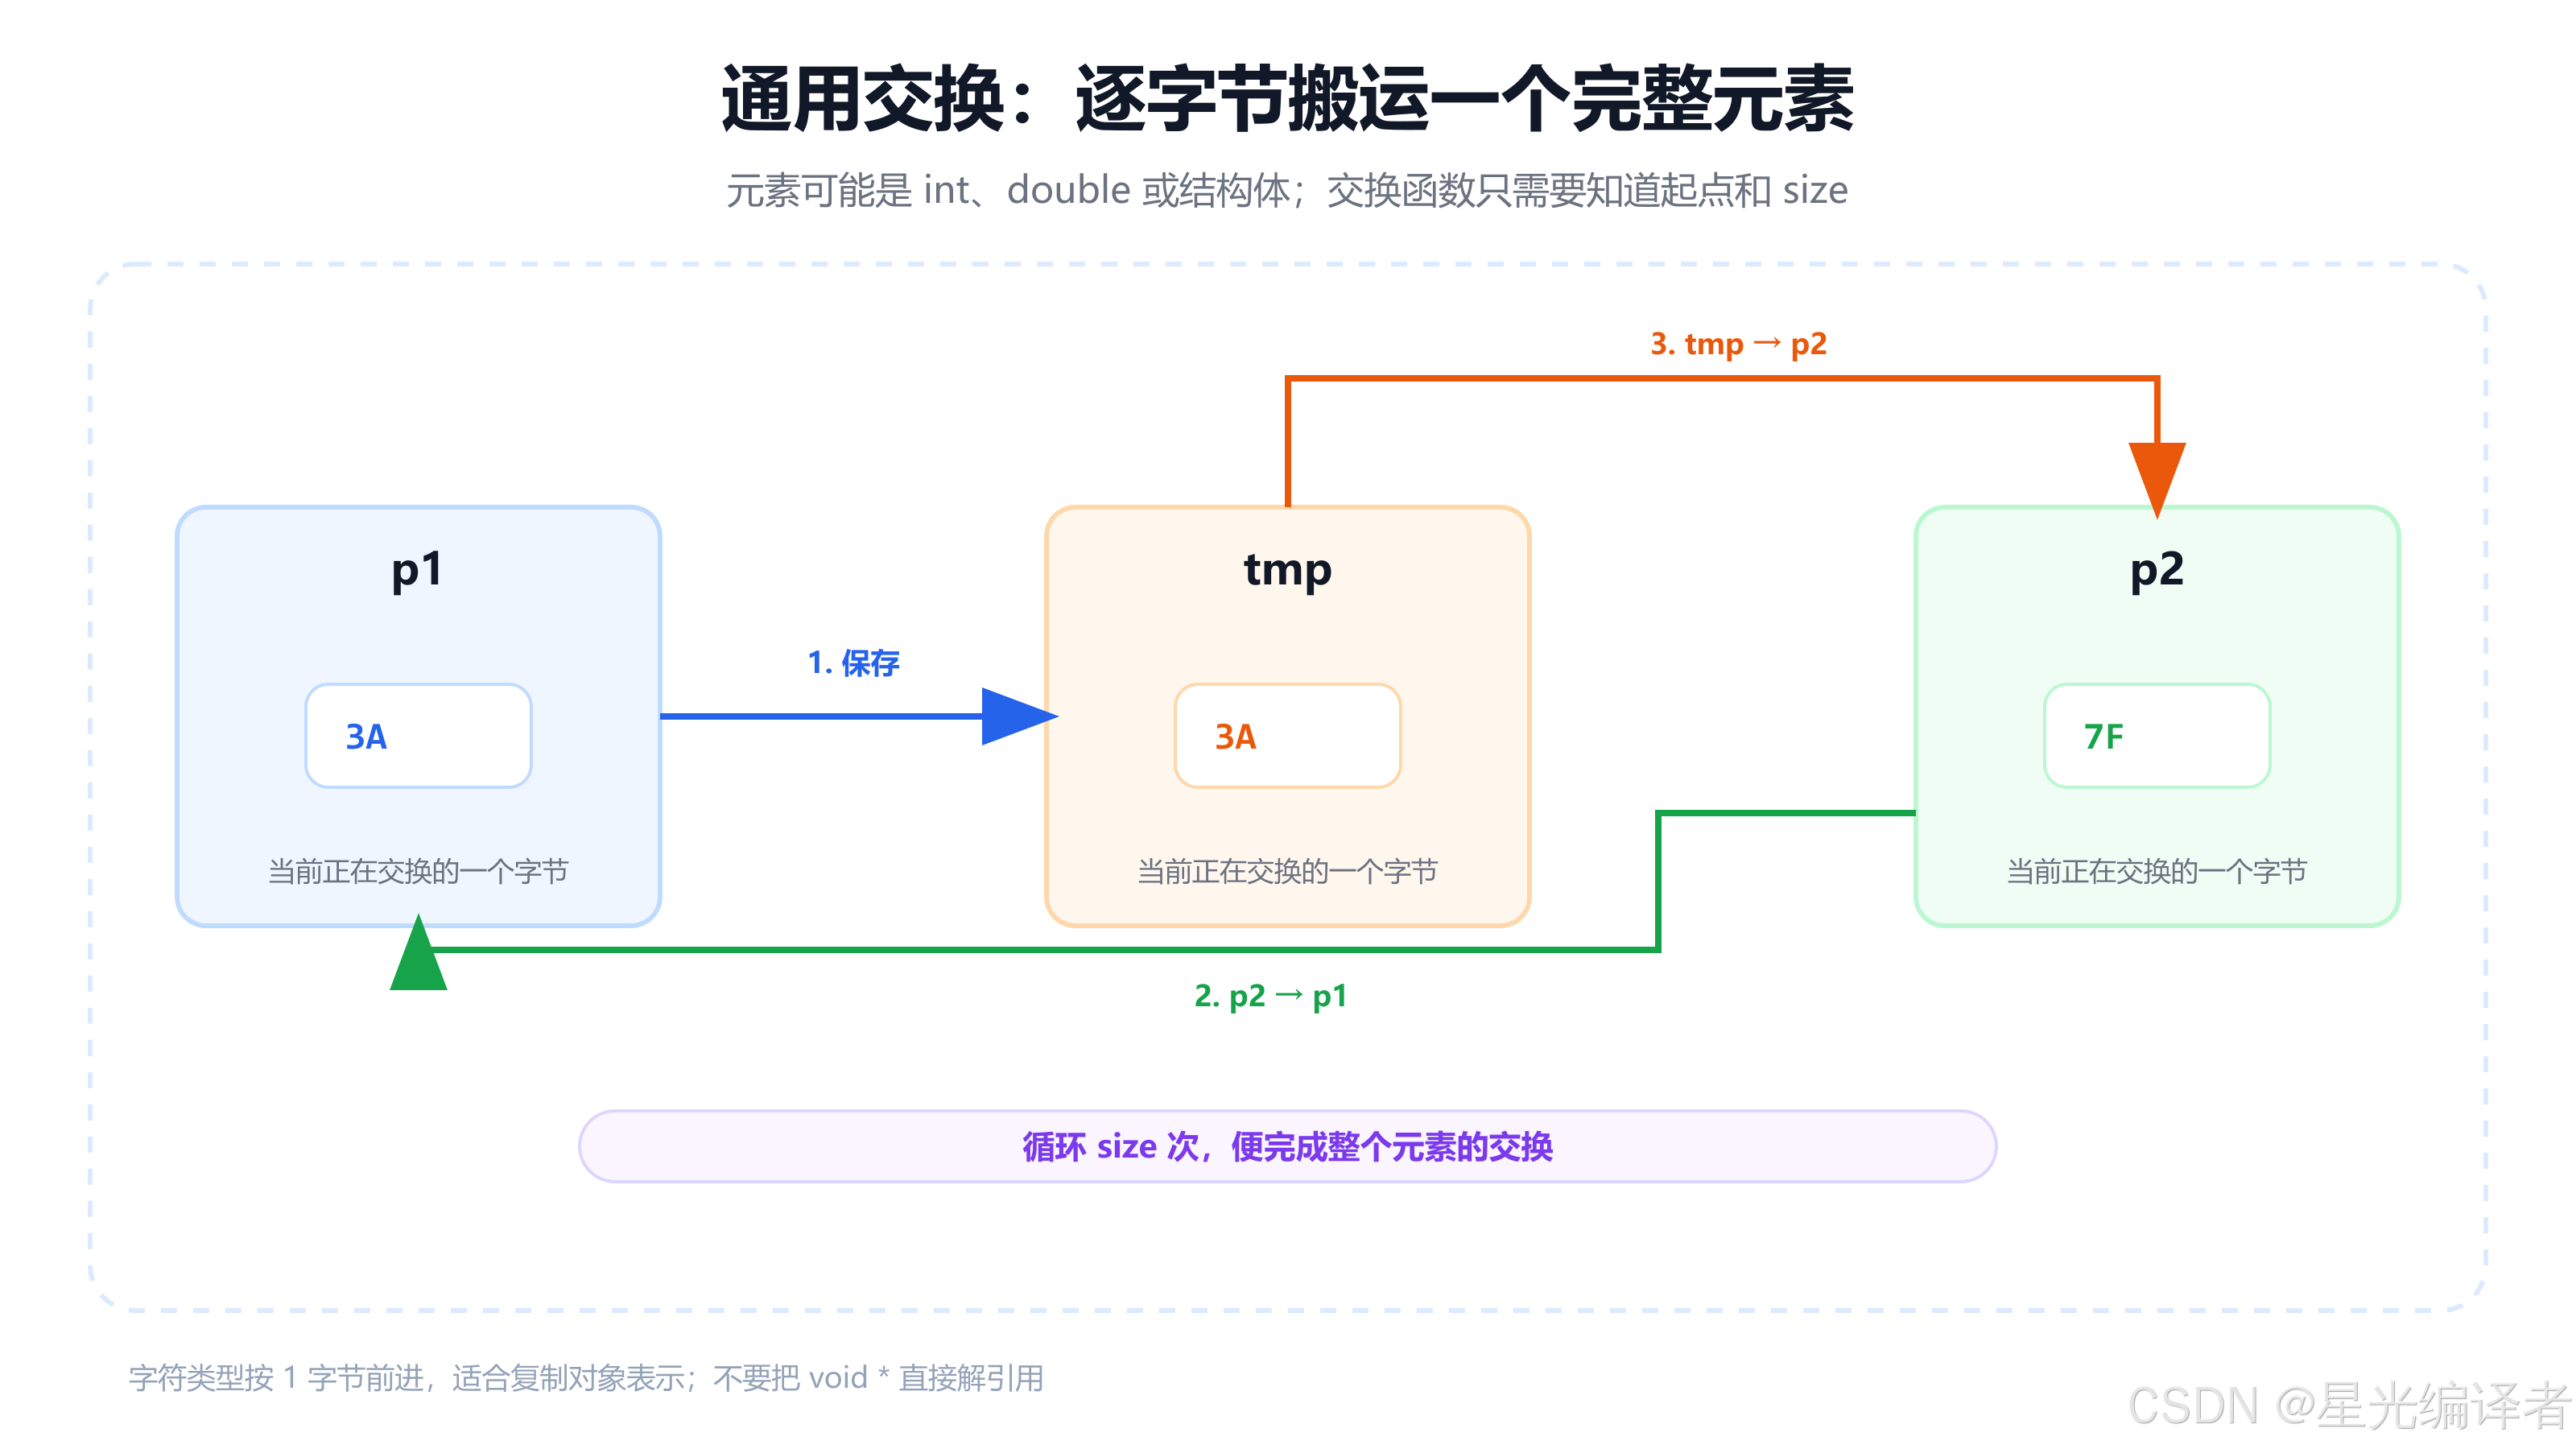
这里选 unsigned char * 有两个原因:
- 指针每次
+1恰好前进 1 字节; - 字符类型可以合法访问对象表示的每个字节。
教学实现逐字节交换容易理解,但工程实现通常会针对块复制、对齐和平台特性做优化。
7.2 定义比较器类型
先给复杂的函数指针签名取一个清晰名字:
c
typedef int (*compare_fn)(const void *, const void *);与标准库 qsort 一样,比较器只读取元素,所以参数保留 const。排序函数自身会交换元素,base 则不能是 const void *。
7.3 完整教学版实现
c
#include <stddef.h>

typedef int (*compare_fn)(const void *, const void *);

static void swap_bytes(void *left, void *right, size_t size)
{
    unsigned char *a = left;
    unsigned char *b = right;

    for (size_t i = 0; i < size; ++i) {
        const unsigned char temp = a[i];
        a[i] = b[i];
        b[i] = temp;
    }
}

static void generic_bubble_sort(void *base,
                                size_t count,
                                size_t size,
                                compare_fn compare)
{
    if (count < 2 || size == 0) {
        return;
    }

    unsigned char *bytes = base;

    for (size_t pass = 0; pass + 1 < count; ++pass) {
        int swapped = 0;

        for (size_t j = 0; j + 1 < count - pass; ++j) {
            void *left = bytes + j * size;
            void *right = bytes + (j + 1) * size;

            if (compare(left, right) > 0) {
                swap_bytes(left, right, size);
                swapped = 1;
            }
        }

        if (!swapped) {
            break;
        }
    }
}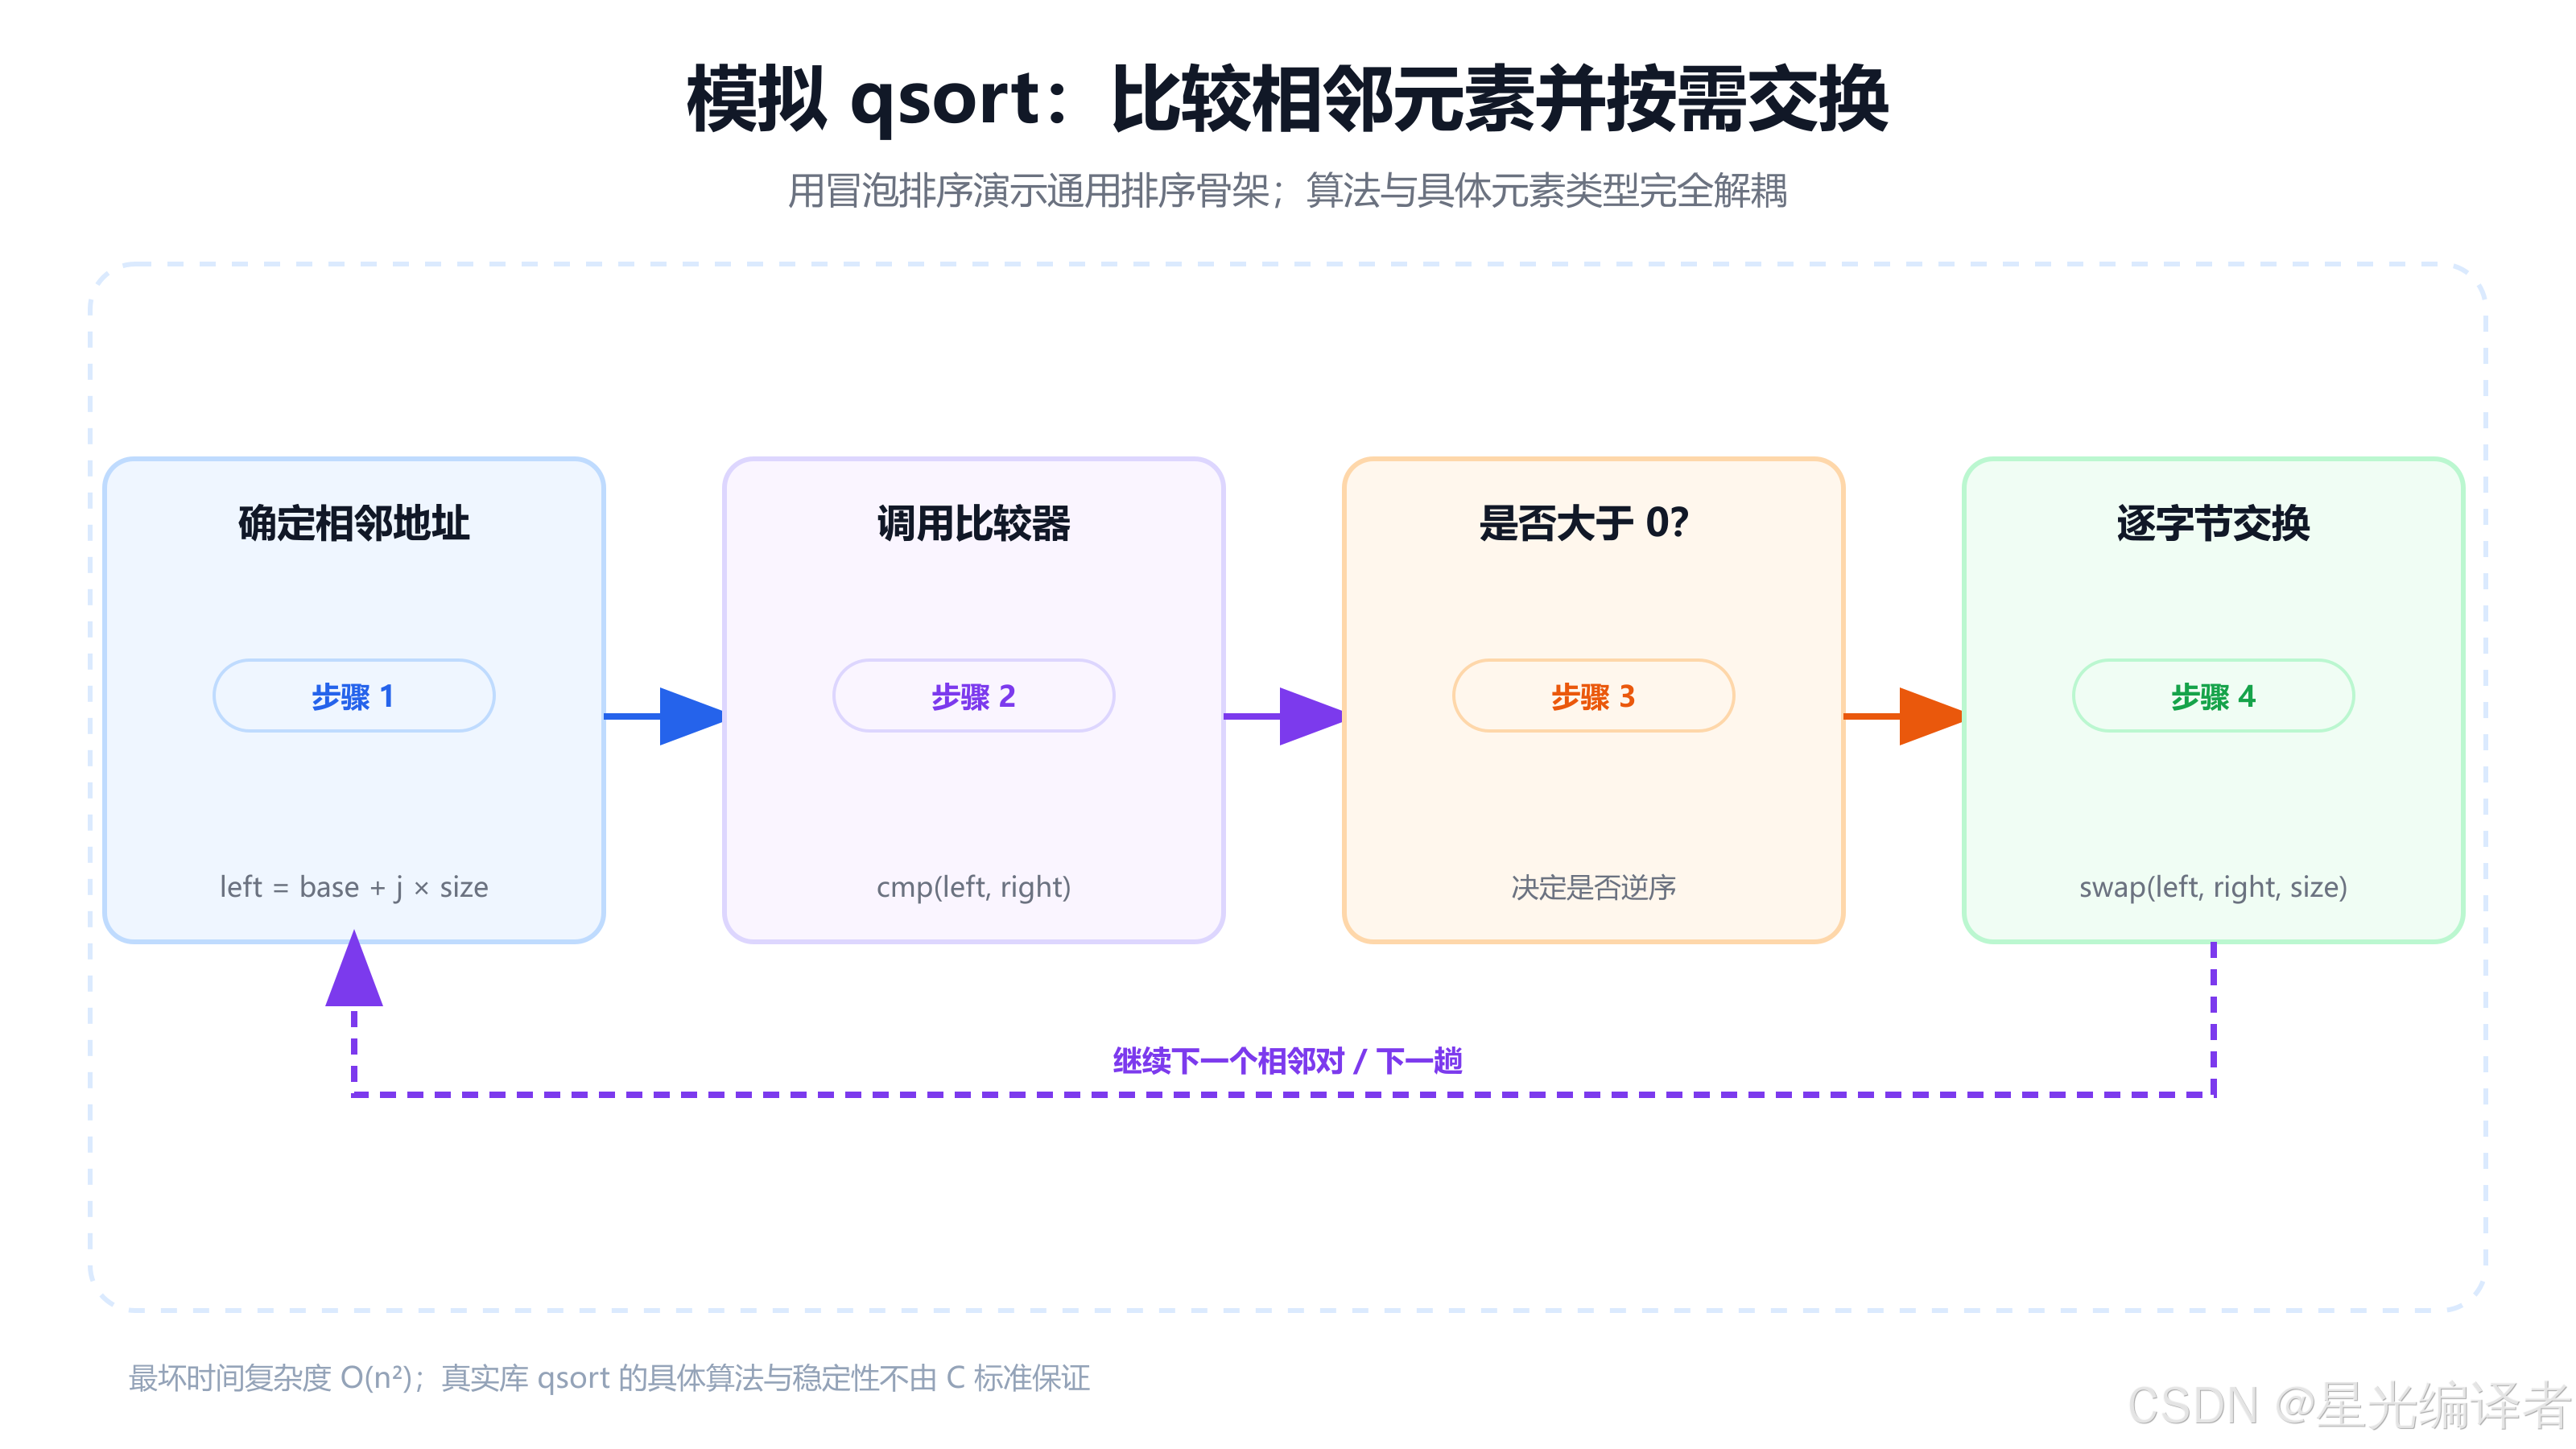
相比课件中的基础版本,这里做了几处适合现代 C 代码的调整:
- 数量与字节数使用
size_t; - 比较器参数写成
const void *; - 使用
unsigned char *进行字节寻址; count < 2时直接返回,避免无符号减法下溢;- 一整趟没有交换时提前结束。
7.4 用教学版排序整数
c
#include <stdio.h>

static int compare_int_ascending(const void *left,
                                 const void *right)
{
    const int a = *(const int *)left;
    const int b = *(const int *)right;
    return (a > b) - (a < b);
}

int main(void)
{
    int numbers[] = {1, 3, 5, 7, 9, 2, 4, 6, 8, 0};
    const size_t count = sizeof numbers / sizeof numbers[0];

    generic_bubble_sort(numbers,
                        count,
                        sizeof numbers[0],
                        compare_int_ascending);

    for (size_t i = 0; i < count; ++i) {
        printf("%d%c", numbers[i], i + 1 == count ? '\n' : ' ');
    }

    return 0;
}
只需换成结构体比较器,同一份排序函数就能处理结构体数组。这正是模拟实现真正想说明的内容:
泛型不是算法"什么类型都知道",而是算法只依赖地址、元素宽度与由调用者提供的操作契约。
7.5 教学实现与标准库实现的差别
这个版本使用冒泡排序:
- 最坏和平均时间复杂度为
O(n²); - 额外空间为
O(1); - 代码简单,适合理解回调与字节寻址;
- 大规模数据不应优先选择它。
标准库 qsort 的具体算法由实现决定,通常会使用更高效的策略,并针对平台进行优化。学习模拟实现是为了理解接口与机制,不是为了在项目中重新造一个更慢的库函数。
八、常见错误、安全边界与工程建议
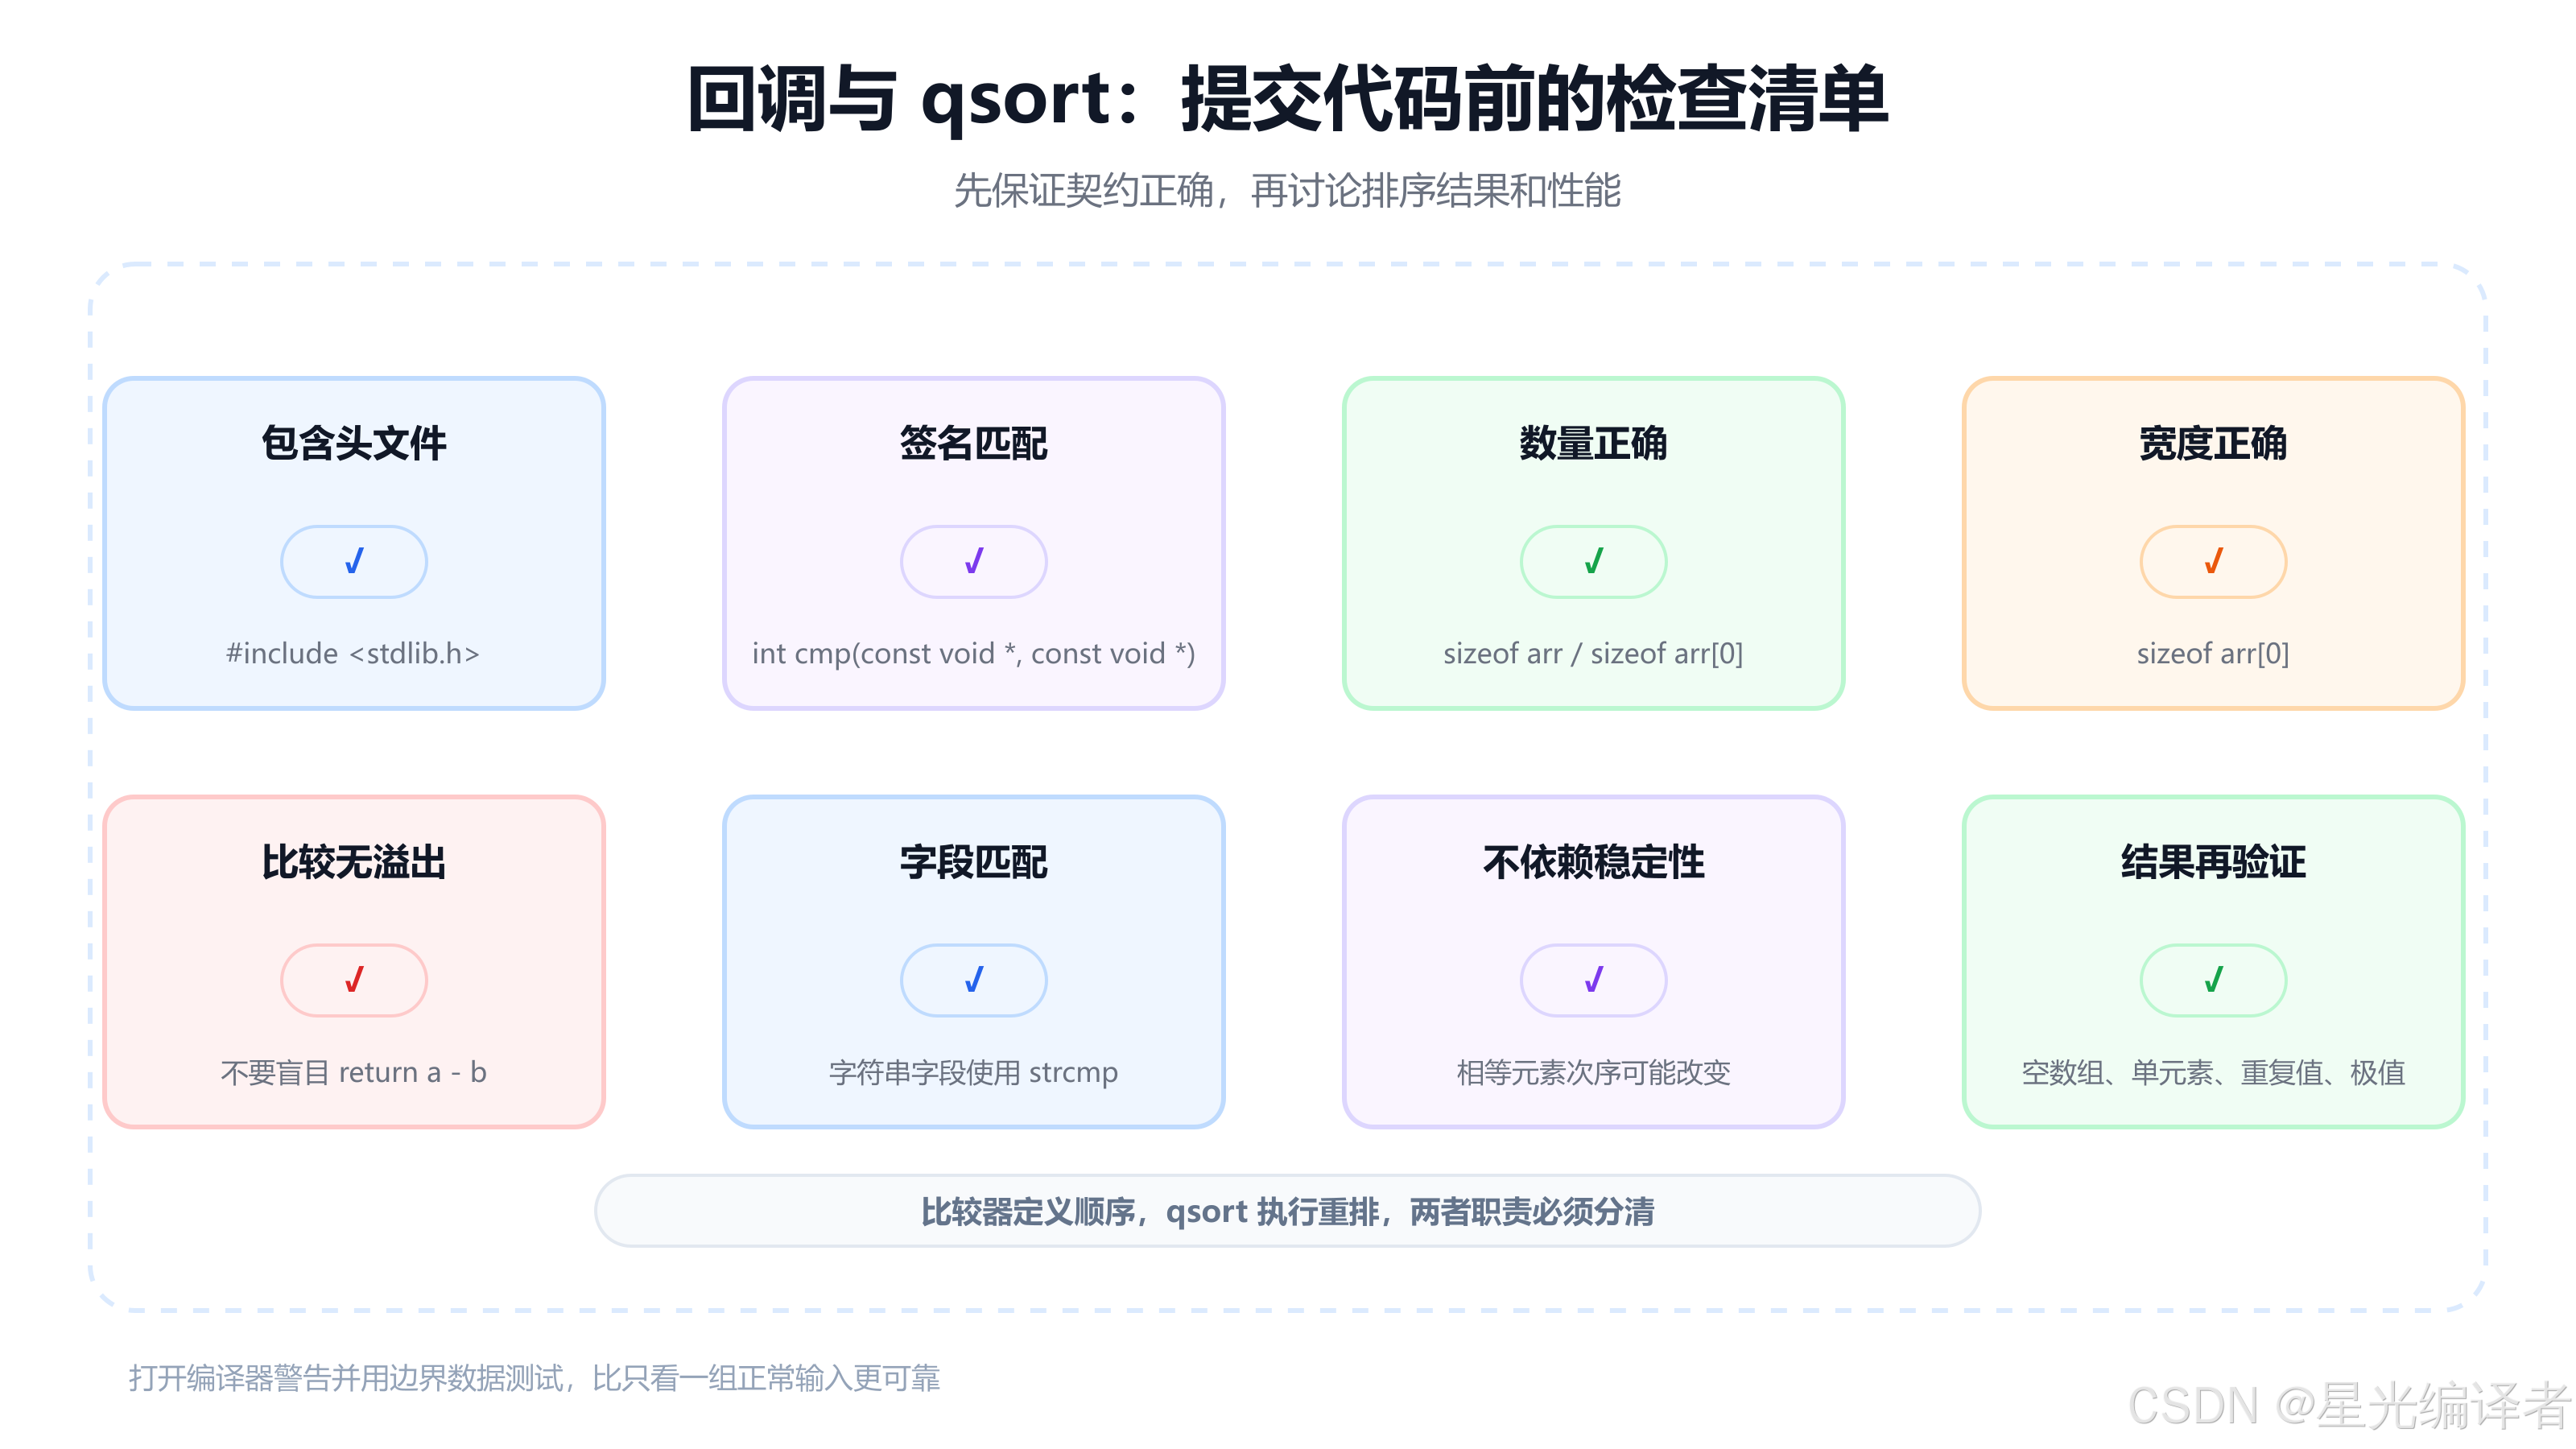
8.1 忘记包含 stdlib.h
qsort 声明在:
c
#include <stdlib.h>现代 C 中不应依赖隐式函数声明。打开编译器警告,头文件遗漏会更早暴露。
8.2 把字节数当成元素个数
错误:
c
qsort(numbers, sizeof numbers, sizeof numbers[0], compare_int_ascending);sizeof numbers 是总字节数,不是元素个数。正确写法是:
c
sizeof numbers / sizeof numbers[0]8.3 元素宽度写错
如果结构体数组却传入 sizeof(int),qsort 会按错误边界切分内存。更稳妥的模式始终是:
c
qsort(array,
      sizeof array / sizeof array[0],
      sizeof array[0],
      comparator);
8.4 比较器类型恢复错误
比较器中的目标类型必须与数组元素一致。不要用强制转换压掉不匹配,更不要把任意字节都当成另一种对象类型解释。
8.5 用减法比较整数导致溢出
c
return a - b;仅在能够证明差值不会超出类型范围时才安全。通用整数比较器优先写:
c
return (a > b) - (a < b);8.6 用减法比较浮点数
这类写法同样错误:
c
return *(const double *)left - *(const double *)right;函数返回 int,浮点差值转换为 int 后,小于 1 的非零差可能变成 0;还要额外考虑 NaN 的顺序语义。浮点比较器应显式使用关系运算,并根据业务决定如何排列 NaN。
8.7 用 == 比较字符串内容
结构体中的字符数组或字符指针字段,应使用 strcmp 比较文本内容。== 比较的是地址或不适用于数组,并不能回答"字符串内容是否相同"。
8.8 直接对 void * 做加法
c
/* 非标准扩展,不要依赖。 */
/* void *next = base + size; */
改为:
c
unsigned char *next = (unsigned char *)base + size;8.9 依赖 qsort 的稳定性
比较器返回 0 只表示两个元素排序等价,不保证它们保持原始先后顺序。若需要确定次序,为比较器加入第二关键字,或使用明确提供稳定性保证的排序方案。
8.10 忽略空指针与尺寸乘法边界
标准库接口的调用者必须保证传入的指针、数量与宽度形成有效数组对象。自写接口若要用于不受信任输入,还应在计算 index * size、count * size 前检查 size_t 溢出,并明确空数组、size == 0、空比较器如何处理。
本文的教学版在 count < 2 或 size == 0 时返回,但它仍假设:只要确实需要访问元素,base 与 compare 都有效。工程接口可以进一步加断言或返回错误码。
8.11 建议开启的编译器警告
text
GCC / Clang: -std=c11 -Wall -Wextra -Wpedantic -Wconversion
MSVC: /W4
测试时至少覆盖:
- 空范围与单元素;
- 已排序与逆序数据;
- 大量重复值;
INT_MIN、INT_MAX等极值;- 结构体中第一关键字相同的情况;
- 字符串为空串或共享前缀的情况。
九、高频问答与动手练习
高频问答
Q1:回调函数与普通函数有什么本质区别?
函数本身没有本质区别。区别在调用方式和角色:普通直接调用由当前代码点明确写出函数名;回调则把函数地址交给另一段代码,由后者在约定时机通过函数指针调用。
Q2:函数名传给 qsort 时为什么不用写 &?
函数名在大多数表达式中会转换为指向该函数的指针,所以直接传 compare_int_ascending 即可。写 &compare_int_ascending 通常也能得到兼容的函数指针,但直接写函数名更常见。
*Q3:compar 参数为什么是 const void ?
比较器只需要读取两个元素并判断次序,不应修改它们。void * 提供通用对象地址,const 则把"只读"约束写进接口。
Q4:qsort 为什么既要元素个数,又要元素大小?
元素个数决定要处理多少项;元素大小决定相邻元素间隔多少字节。只知道总字节数,无法区分"10 个 4 字节元素"和"5 个 8 字节元素"。
Q5:比较器必须返回 -1、0、1 吗?
不必须。qsort 只关心负数、零、正数三类结果。返回规范化的 -1、0、1 只是常见且安全的写法。
Q6:return a - b 不是最简单吗?
它可能因有符号整数溢出产生未定义行为。对任意 int 值,使用 (a > b) - (a < b) 更稳妥。
Q7:void * 既然能指向任何对象,为什么不能直接解引用?
因为 void 没有大小,也没有可读取的值表示。解引用前必须恢复为正确的对象指针类型。
*Q8:为什么交换时使用 unsigned char ?
字符类型按 1 字节寻址,并允许观察和复制对象表示。这样无需知道元素是整数还是结构体,也能搬运它的全部字节。
Q9:qsort 真的是快速排序吗?
标准没有要求具体内部算法。函数名是历史接口名,程序不能依赖实现一定采用某一种排序算法。
Q10:qsort 稳定吗?
标准不保证稳定。若相等元素的先后次序有业务意义,需要额外设计次关键字或使用稳定排序。
动手练习
- 写一个比较器,把
int数组按降序排列,并解释为何没有减法溢出。 - 定义
struct Book { char title[64]; double price; };,分别按价格和书名排序。 - 在价格相同时继续按书名排序,形成确定的多关键字次序。
- 修改
generic_bubble_sort,让它通过返回值报告无效参数。 - 说明
base、count、size与compare中任意一个信息错误会导致什么后果。 - 为整数排序准备包含
INT_MIN、INT_MAX和重复值的测试数据。 - 思考浮点比较器遇到 NaN 时应如何定义顺序,并把业务规则写进代码。
参考答案要点:
- 降序可返回
(b > a) - (b < a)。 - 价格使用关系运算比较,书名使用
strcmp。 - 先比较价格;相等时再返回
strcmp(a->title, b->title)。 - 可把返回类型改为状态码,并在访问前验证
base、compare、size与数量关系。 - 起点错误会访问无效对象;数量错误会越界或漏排;宽度错误会切错元素边界;比较器错误会误读对象或给出矛盾顺序。
- 这组数据能直接检验比较器是否错误使用
a - b。 - NaN 不满足普通大小关系,应由业务明确放在开头、末尾,或视为错误数据。
总结
这一讲把函数指针真正放进了通用算法。回调函数让调用者把"具体行为"传给公共流程;qsort 用 base、nmemb 与 size 描述一段连续元素,再用比较器定义顺序;void * 提供通用地址,字符指针负责按字节寻址和交换;教学版泛型冒泡排序则把这些零散知识连成了完整执行链。
理解这套机制时,可以始终追问四个问题:
- 数据从哪个地址开始?
- 一共有多少个元素?
- 每个元素占多少字节?
- 谁来决定两个元素的先后?
前三个问题描述数据布局,第四个问题由回调回答。当"数据"和"规则"通过清晰接口汇合,C 语言就能在没有模板和运行时泛型系统的情况下,写出可复用的通用算法。