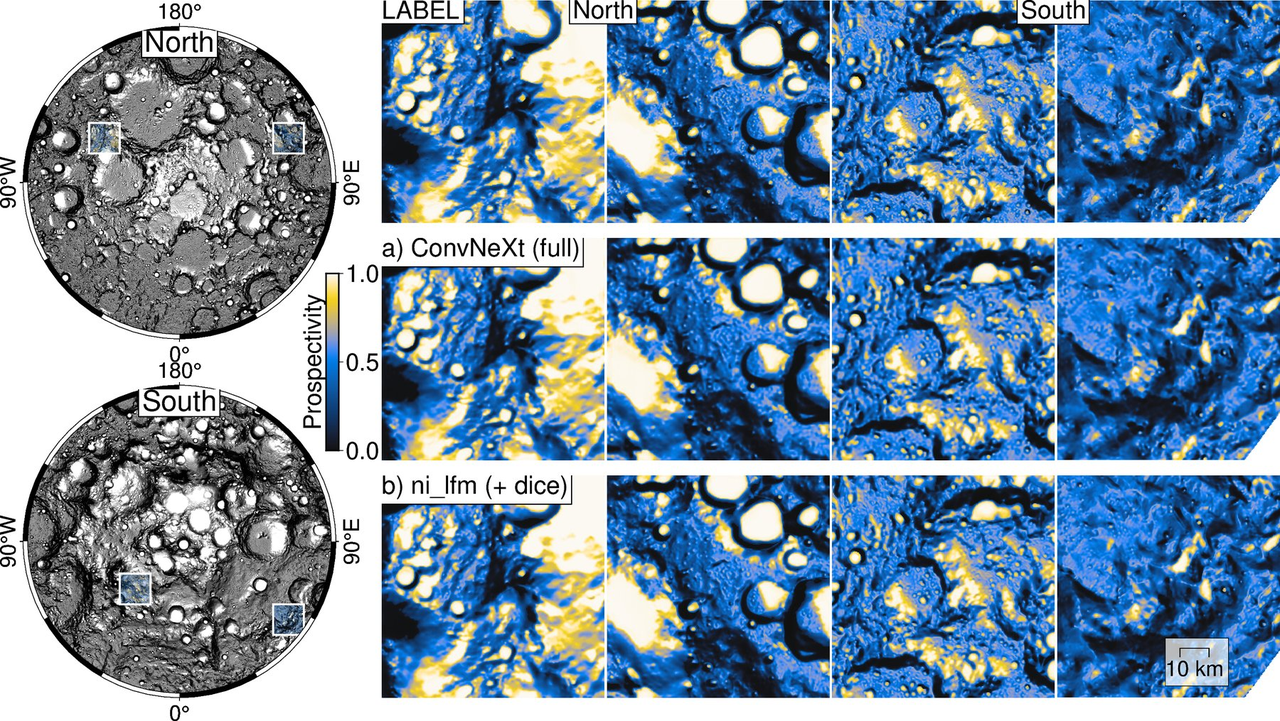
美国宇航局(NASA)与 IBM Research 联合多家学术机构发布了 NASA-IBM 月球基础模型(Lunar Foundation Model),并同步开源模型、训练数据集与基准测试集。两家机构称,这是最早的月球科学开源基础模型之一。最能说明问题的数字来自极区冰层预测:与最强基线 SwinV2-B 相比,模型把误差最多降低了 22%。
支撑这一结果的是团队自建的 SomBench 语料------按他们的说法,这是目前规模最大的同配准多模态月球语料库,包含近 200 万个瓦片包(tile bundle),覆盖 11 种模态、两个空间尺度。其中约 100 万张高分辨率影像来自窄角相机(NAC),分辨率约 1 米/像素;另有略低于 964,000 张多光谱影像来自广角相机(WAC),分辨率 100 米/像素。
数据主体是月球勘测轨道器(LRO)17 年的观测。NASA 表示,LRO 的数据量超过其他所有 NASA 行星任务的总和。此外还纳入 GRAIL 任务的重力场数据、Lunar Prospector 的氢元素数据,以及日本 JAXA 辉夜号(Kaguya/SELENE)的矿物学数据。合计起来,语料库整合了来自 4 个任务、9 台仪器的 30 多个空间对齐数据层。为避免训练集、验证集、测试集之间的信息泄漏,团队按地图分区做地理切分,而不是随机拆散瓦片。
模型以地球观测多模态模型 TerraMind 为底座,但并非微调,而是从零训练。每个瓦片都会把成像几何作为显式上下文输入,包括光照角度、太阳位置和瓦片范围。月球表面在图像里的样子,受光照几何的影响远大于表面本身的性质,团队干脆把这项信息直接喂给模型,而不是让它从原始像素里自己纠正。训练同时使用高分辨率与低分辨率影像,兼顾细节与大范围上下文;FlexiViT 技术让同一个训练好的模型能适配不同图像块尺寸,无需重训。
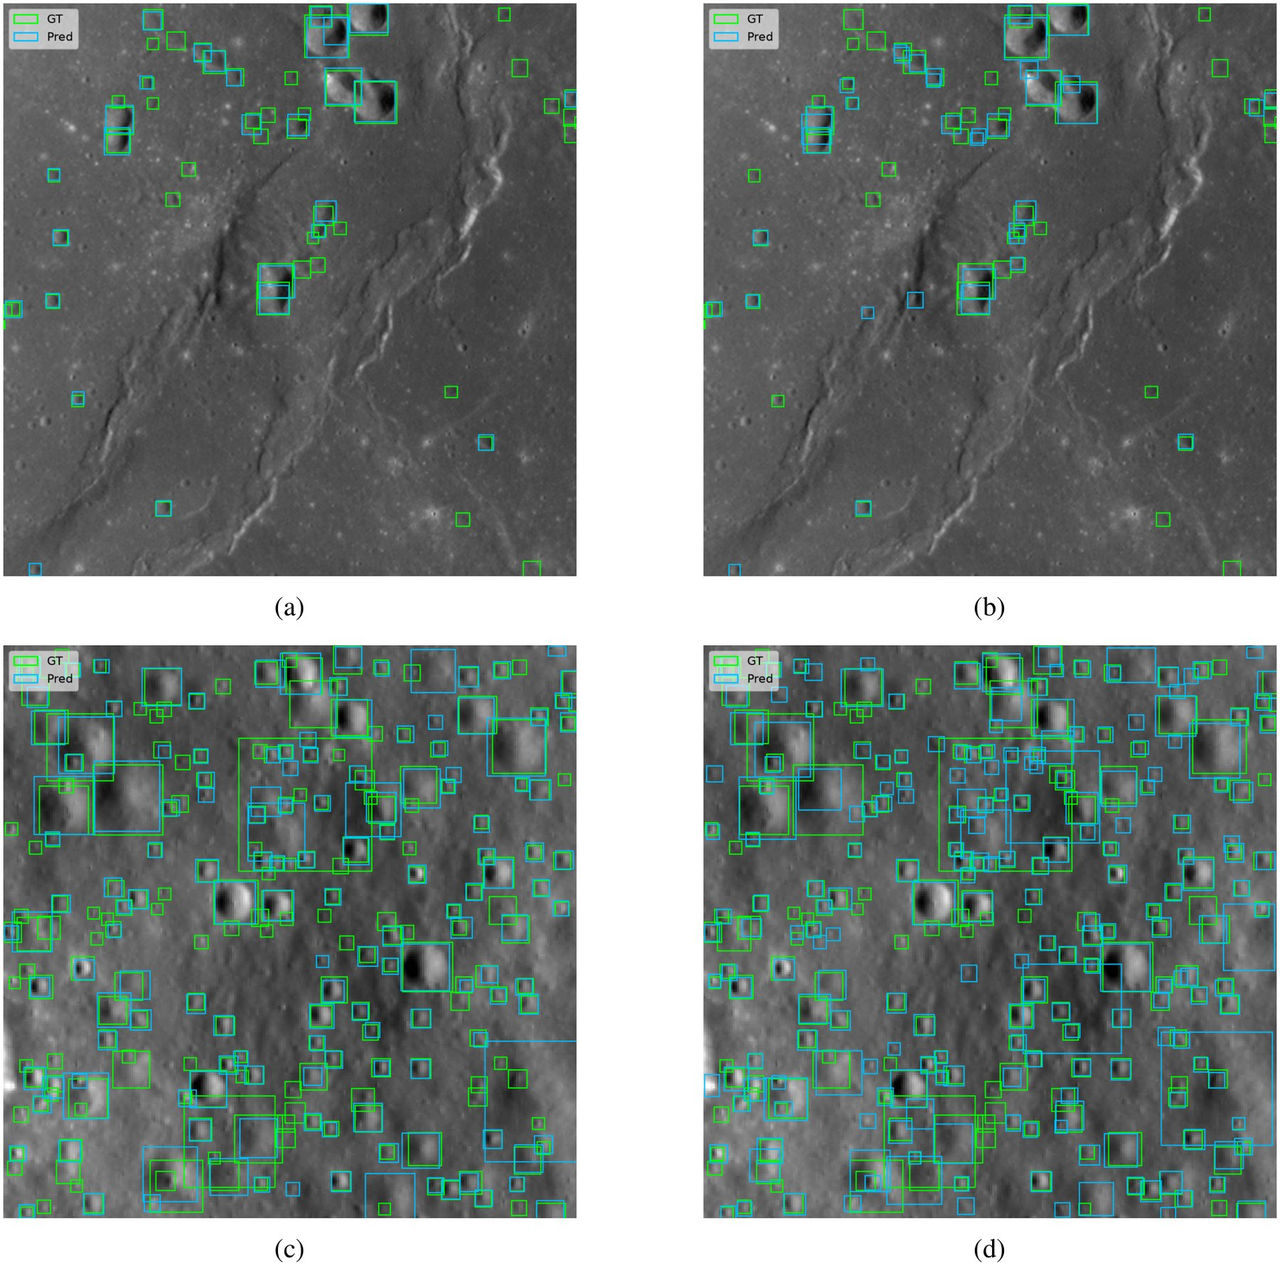
除冰层预测外,团队还测试了 100 米和 1 米尺度的撞击坑识别,以及不规则月海斑块(IMP,一种年轻火山特征,对既有月球冷却时间线构成挑战)的分割。技术报告称,预训练模型在所有任务上都不低于常见基线,也不低于结构完全相同、但随机初始化的对照模型。粗尺度撞击坑检测上,模型比 SwinV2-B 高近 19%,而这只是在用一半数据训练的情况下取得的,说明它需要的有标注样本更少。
不过,1 米尺度撞击坑与 IMP 分割上,模型与最强基线基本打平,差异落在多次训练运行的方差范围内;IBM 声称在 IMP 上领先 SwinV2-B 3%,但结果更像"相当"而非"更好"。值得一提的是,随机初始化的对照模型在冰层预测上就已击败 7 个基线中的 5 个------研究者认为,部分优势来自模型处理异构数据的方式:它为每个数据层分配独立的处理路径,而基线模型把所有输入当成堆叠的通道。此外,只训练一小部分参数的轻量微调方法 LoRA 在各项任务上与全量微调持平,在撞击坑检测上还更好;全量微调只在两个最小的任务上占优。
模型并非万能。研究显示,它不适合做绝对大地定位:在生成测试中,经纬度有时会偏出几十度,高程结构的形状能重建正确,但绝对高度值会出现偏移。作者把它定位为可复用的下游任务底座,而非物理测量仪器的替代品;隔离各项创新贡献的对照实验尚待完成,部分测试数据集规模也偏小。
目前模型已在 Hugging Face 公开,代码托管于 GitHub,并集成进开源工具包 TerraTorch,团队同时释出了可直接用于机器学习的预训练数据集和基准集合。这是 NASA-IBM "AI for Science" 合作的一部分,双方自 2022 年初起依据《太空法案协议》共同开发基础模型:2023 年 8 月,首个 Prithvi 模型上线 Hugging Face,用覆盖美国本土的 Landsat 与 Sentinel-2 影像训练,可适配洪水与野火测绘,IBM 当时将其作为 Watsonx 平台的一部分发布;月球模型的底座 TerraMind,则是 IBM 于 2025 年与欧洲空间局及于利希研究中心合作、面向地球观测开发的。
把这两条线放在一起看,意义更清楚:LRO 自 2009 年发射以来持续观测,积累的正是"数据极多、标签极少"的典型场景,而这恰恰是基础模型最擅长的领域。永久阴影极区常年保持在足以让水冰保存数十亿年的低温,被视作水、氧气和火箭燃料的潜在资源------冰层预测精度每提高一点,都可能影响未来任务在哪里落点、到哪里取水。