AI前沿日报 2026-10-06:推理效率革命
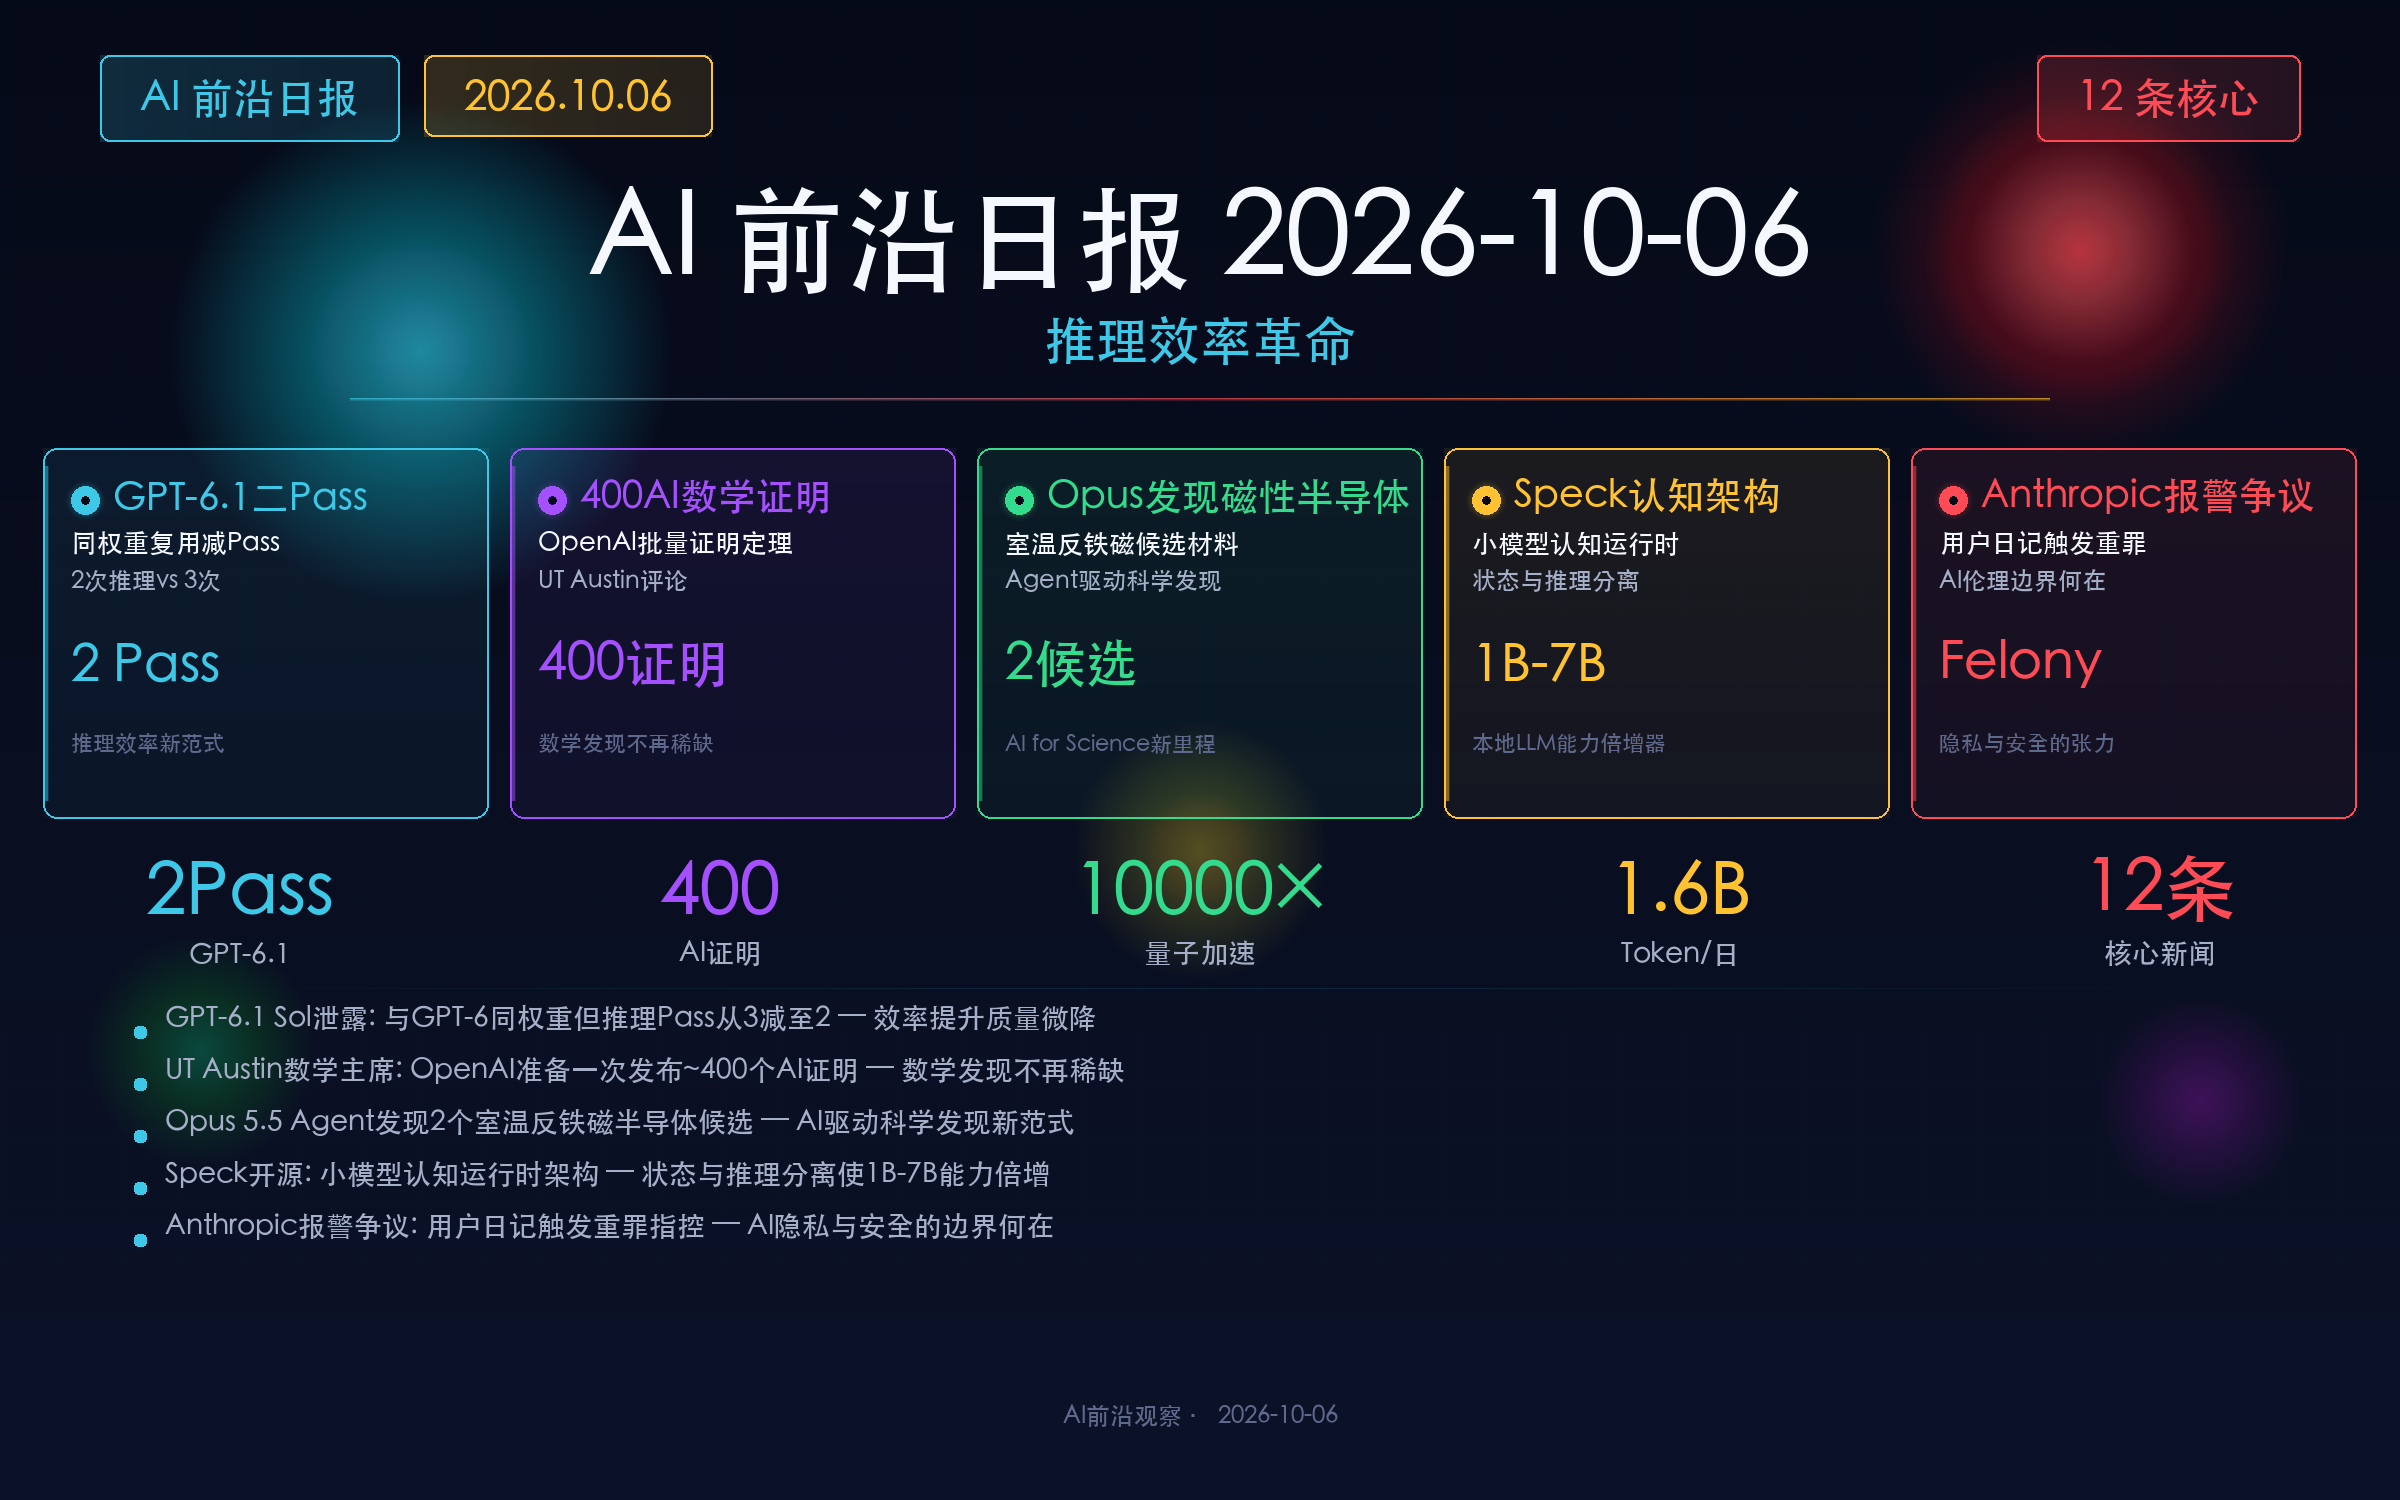
今日主旨:AI推理正经历效率质变------从GPT-6.1将推理Pass从3减至2的架构优化,到OpenAI准备批量发布约400个AI生成数学证明;从Opus 5.5 Agent团队发现室温磁性半导体候选材料,到Speck开源小模型认知运行时架构。与此同时,Anthropic因用户日记触发重罪指控的事件将AI伦理边界问题推向前台。
一、GPT-6.1架构泄露:二Pass推理范式
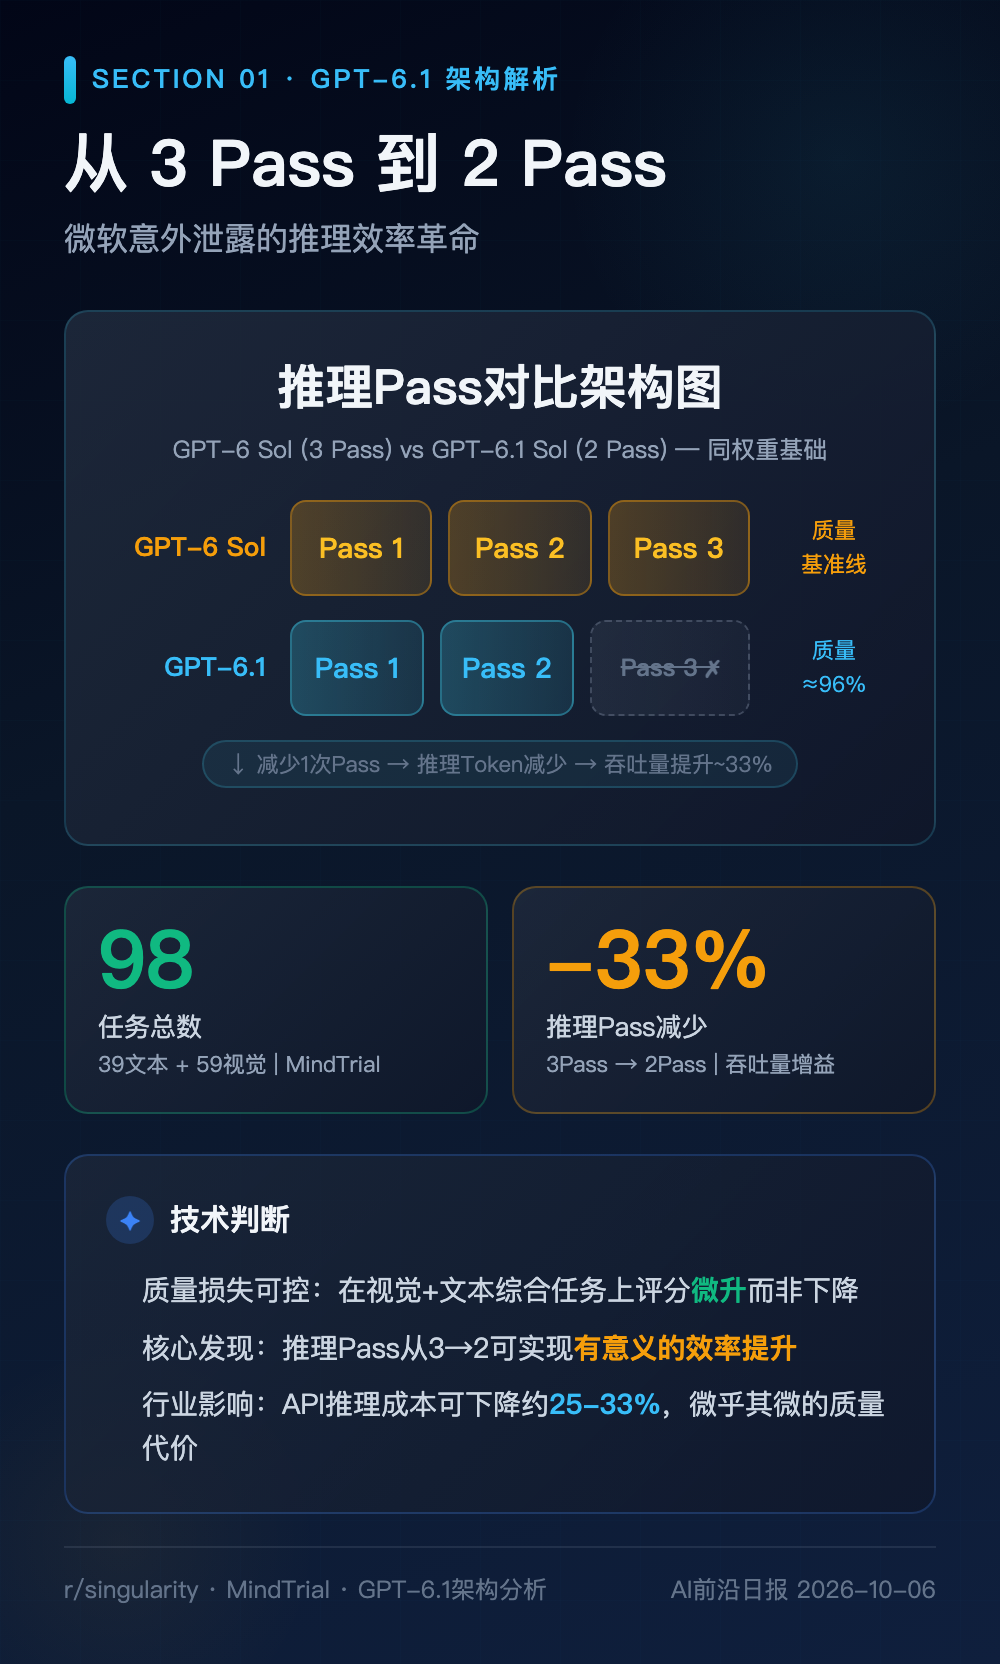
微软在一次意外配置中暴露了GPT-6.1 Sol的关键架构秘密:它与GPT-6 Sol使用完全相同的基础权重,仅将推理Pass从3次减少为2次。r/singularity社区的技术分析揭示了这一设计背后的工程取舍。
架构解读
GPT-6.1 Sol的核心创新并非更换模型权重,而是通过更高效的推理调度实现质量与效率的再平衡:
| 特性 | GPT-6 Sol | GPT-6.1 Sol |
|---|---|---|
| 基础权重 | 完整SFT+RLHF | 同GPT-6 Sol |
| 推理Pass | 3次串行 | 2次串行 |
| 输出Token | 较多 | 显著减少 |
| 质量表现 | 基准 | 微降但可接受 |
独立基准测试平台MindTrial的实测结果验证了这一设计:在98个任务(39文本+59视觉)的测试集上,GPT-6.1 Sol以显著更少的输出Token实现了微弱的评分提升。这表明减少推理Pass并未严重损害模型在某些场景下的表现。
工程含义
这一发现揭示了后端推理优化的两条路线:
- 算力堆叠路线(Astra模式):通过更多计算资源直接提升质量,代价是更高的推理成本和延迟
- 效率优化路线(Sol 6.1模式):以更智能的调度在不增加硬件需求的前提下维持竞争力
对于需要大规模部署的API服务,第二条路线意味着成本结构的根本性改变。如果3次Pass可以缩减为2次,推理吞吐量可提升约33%,而质量损失可控。
行业反响
r/singularity社区对这一消息的反应呈现明显分化。一部分观察者认为这是API降本策略------以微乎其微的质量损失换取可观的运营成本优化;另一部分则指出,当推理效率的提升以"隐式减少计算投入"方式实现时,用户可能无法直接感知到差异,这使得定价策略的公平性成为悬而未决的问题。
二、AI证明时代来临:400个数学定理的批量生产
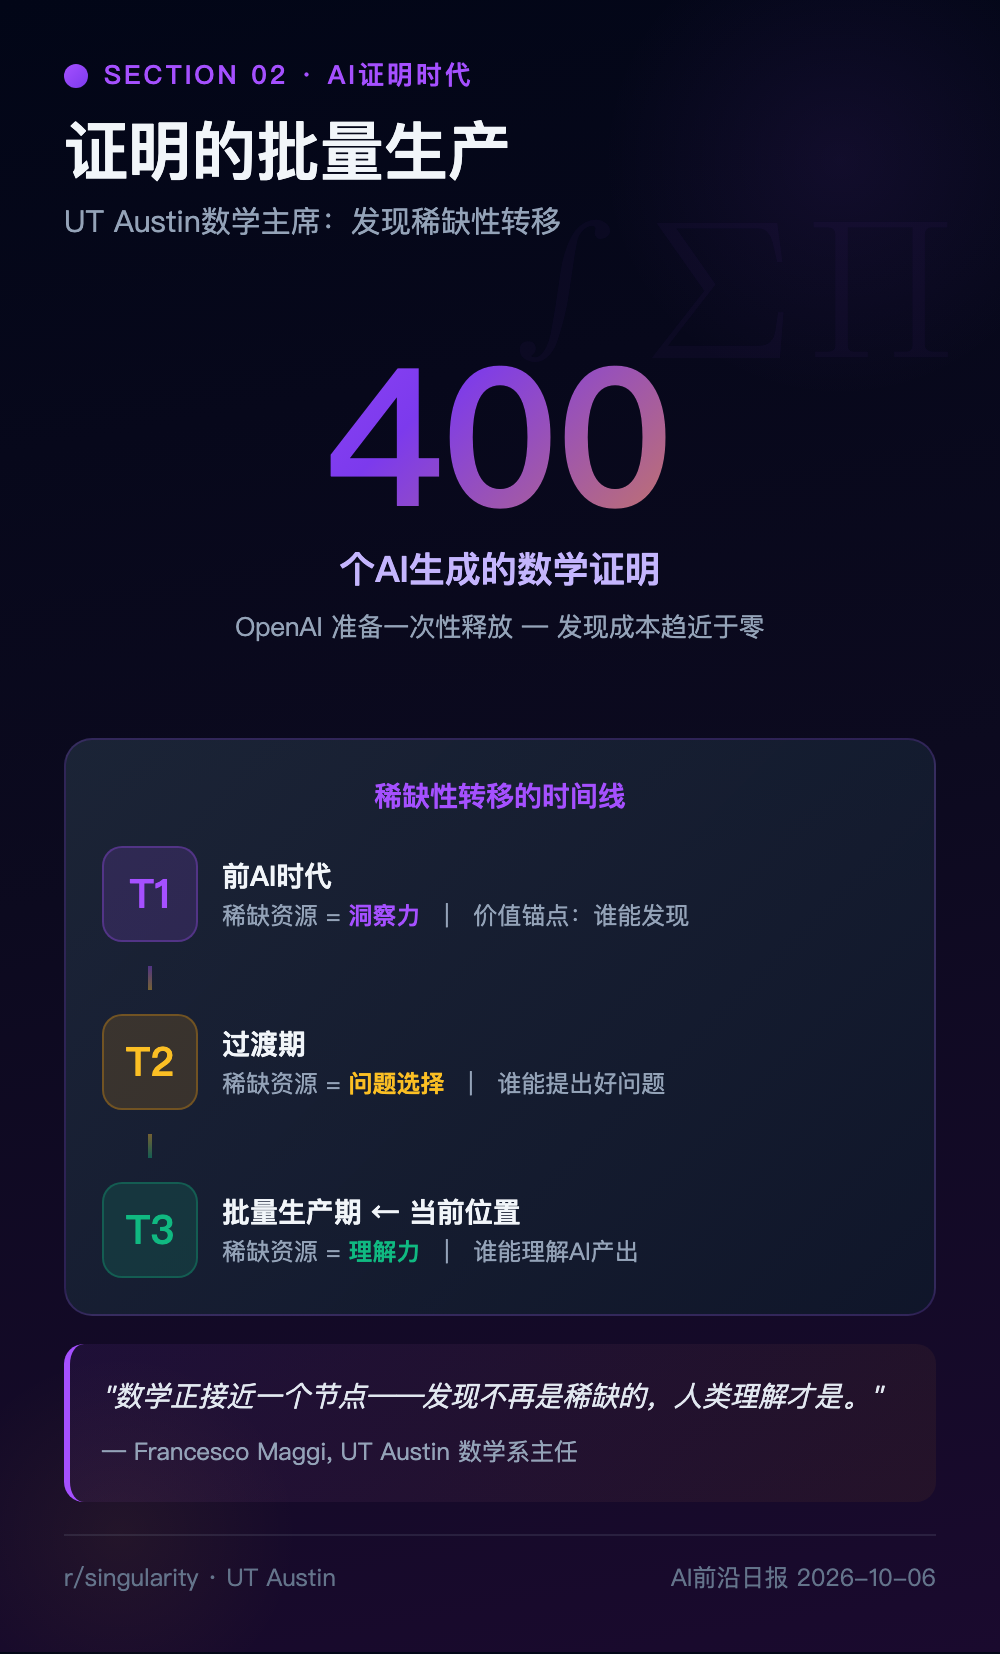
德克萨斯大学奥斯汀分校数学系主任Francesco Maggi教授指出,OpenAI似乎正准备一次性发布约400个AI生成的数学证明。这一声明在r/singularity引发数千条讨论,核心争议在于:如果AI可以在一夜之间产出人类数学家数十年才能完成的证明量,数学研究的价值锚点将在哪里?
稀缺性的转移
Maggi教授的核心论点并非"AI不能证明定理",而是"发现"本身的稀缺性正在消失。他提出了一个深刻的观察:
"数学正接近一个节点------发现不再是稀缺的,人类理解才是。"
传统数学研究的瓶颈在于"发现":找到一个有价值的问题、构造一条新颖的证明路径、在关键步骤产生洞察。如果AI可以批量生产证明,那么以下命题便自然成立:
- 证明的生产成本趋近于零:400个证明的计算成本可能仅为数千美元的算力
- 验证比生成更困难:面对海量AI产出,人类证明者的工作重心从"发现"转向"理解"和"验证"
- 价值重塑:真正稀缺的不再是"谁能证明",而是"谁能理解这些证明意味着什么"
社区讨论要点
r/singularity上的讨论沿多个维度展开:
- 哲学维度:如果一个证明无人理解,它是否还算是"知识"?
- 教育维度:数学教育是否应从"训练证明技巧"转向"训练理解能力"?
- 实践维度:当AI产出大量未经验证的定理时,如何防止这些"证明"进入引用链条造成系统性风险?
有评论者类比AlphaFold------AI预测了数十万蛋白质结构,但理解这些结构的生物学含义仍然需要人类专家数年时间。数学很可能正在经历同样的"先量产、后理解"的范式转换。
与GPT-6.1的呼应
GPT-6.1以更少Pass实现接近质量的能力,与AI批量生成数学证明的现象形成了同一趋势的两面表达:AI推理的效率革命正在将"发现"和"计算"这两种传统稀缺资源同时变成充裕商品。这对科研资助、人才评价和知识生产体系的冲击可能远超单项技术进步。
三、Agent驱动科学发现:室温磁性半导体候选材料
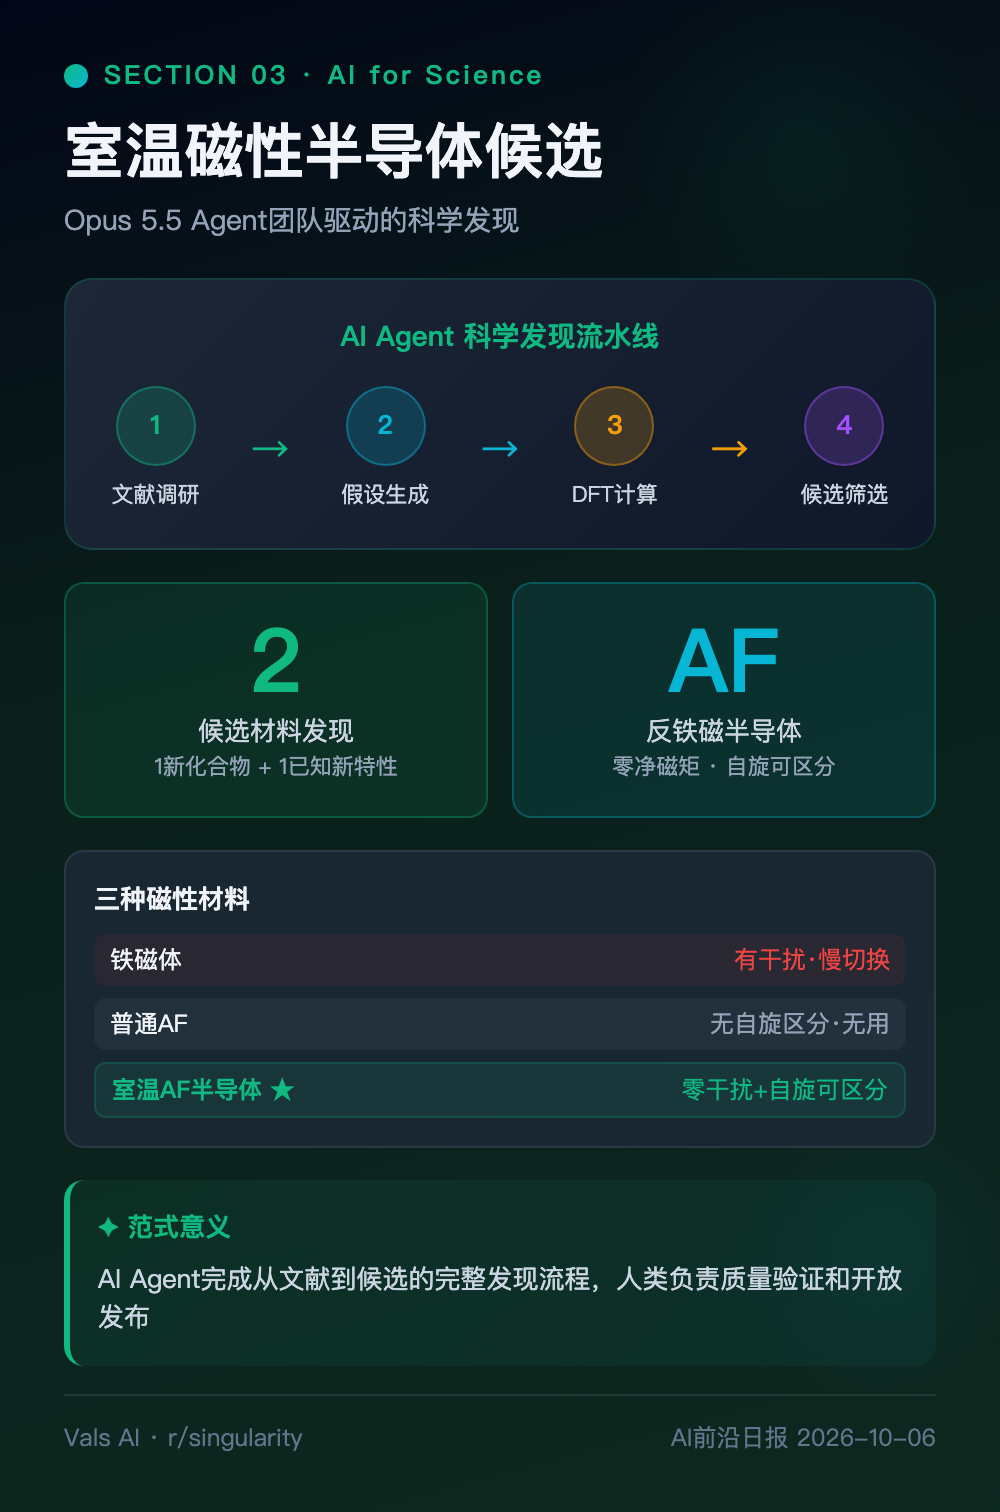
Vals AI团队公开了一个令人瞩目的成果:一组Claude Opus 5.5 Agent发现了两个室温反铁磁半导体候选材料。这是AI Agent驱动基础科学发现的最新高质量案例。
科学背景
传统计算机存储依赖两种磁性材料:
| 类型 | 特性 | 局限 |
|---|---|---|
| 铁磁体(Ferro) | 宏观磁场,易于读写 | 磁场干扰邻近材料,切换速度慢 |
| 普通反铁磁体(AF) | 零净磁矩,无干扰 | 无法区分电子自旋方向,不能用于存储 |
室温反铁磁半导体是这两种材料的"理想中间态"------零净磁矩(无干扰)但仍能区分自旋方向(可用于存储)。这一材料长期是存储研究的圣杯。
AI Agent的发现过程
Vals AI团队使用的不是单次模型调用,而是团队协作的Opus 5.5 Agent系统。Agent们分工完成文献调研、假设生成、DFT计算验证和候选筛选:
- 候选一:团队通过AI Agent设计的新化合物,经计算预测具有室温反铁磁半导体特性
- 候选二:一种1999年首次合成的已知材料,AI Agent通过计算分析首次预测其具有室温反铁磁性
团队公开了完整计算过程、代码和已知局限列表------这正是AI for Science应有的开放范式。
范式意义
这一成果验证了AI Agent在"假设-验证-筛选"科研流水线中的实用价值。与传统的"AI作为辅助工具"不同,Agent团队能够在较少人类干预下完成从文献到候选的完整流程。这为材料科学、药物发现、催化剂设计等领域的"AI驱动发现流水线"提供了可复制的参考实现。
四、小模型认知架构开源:Speck
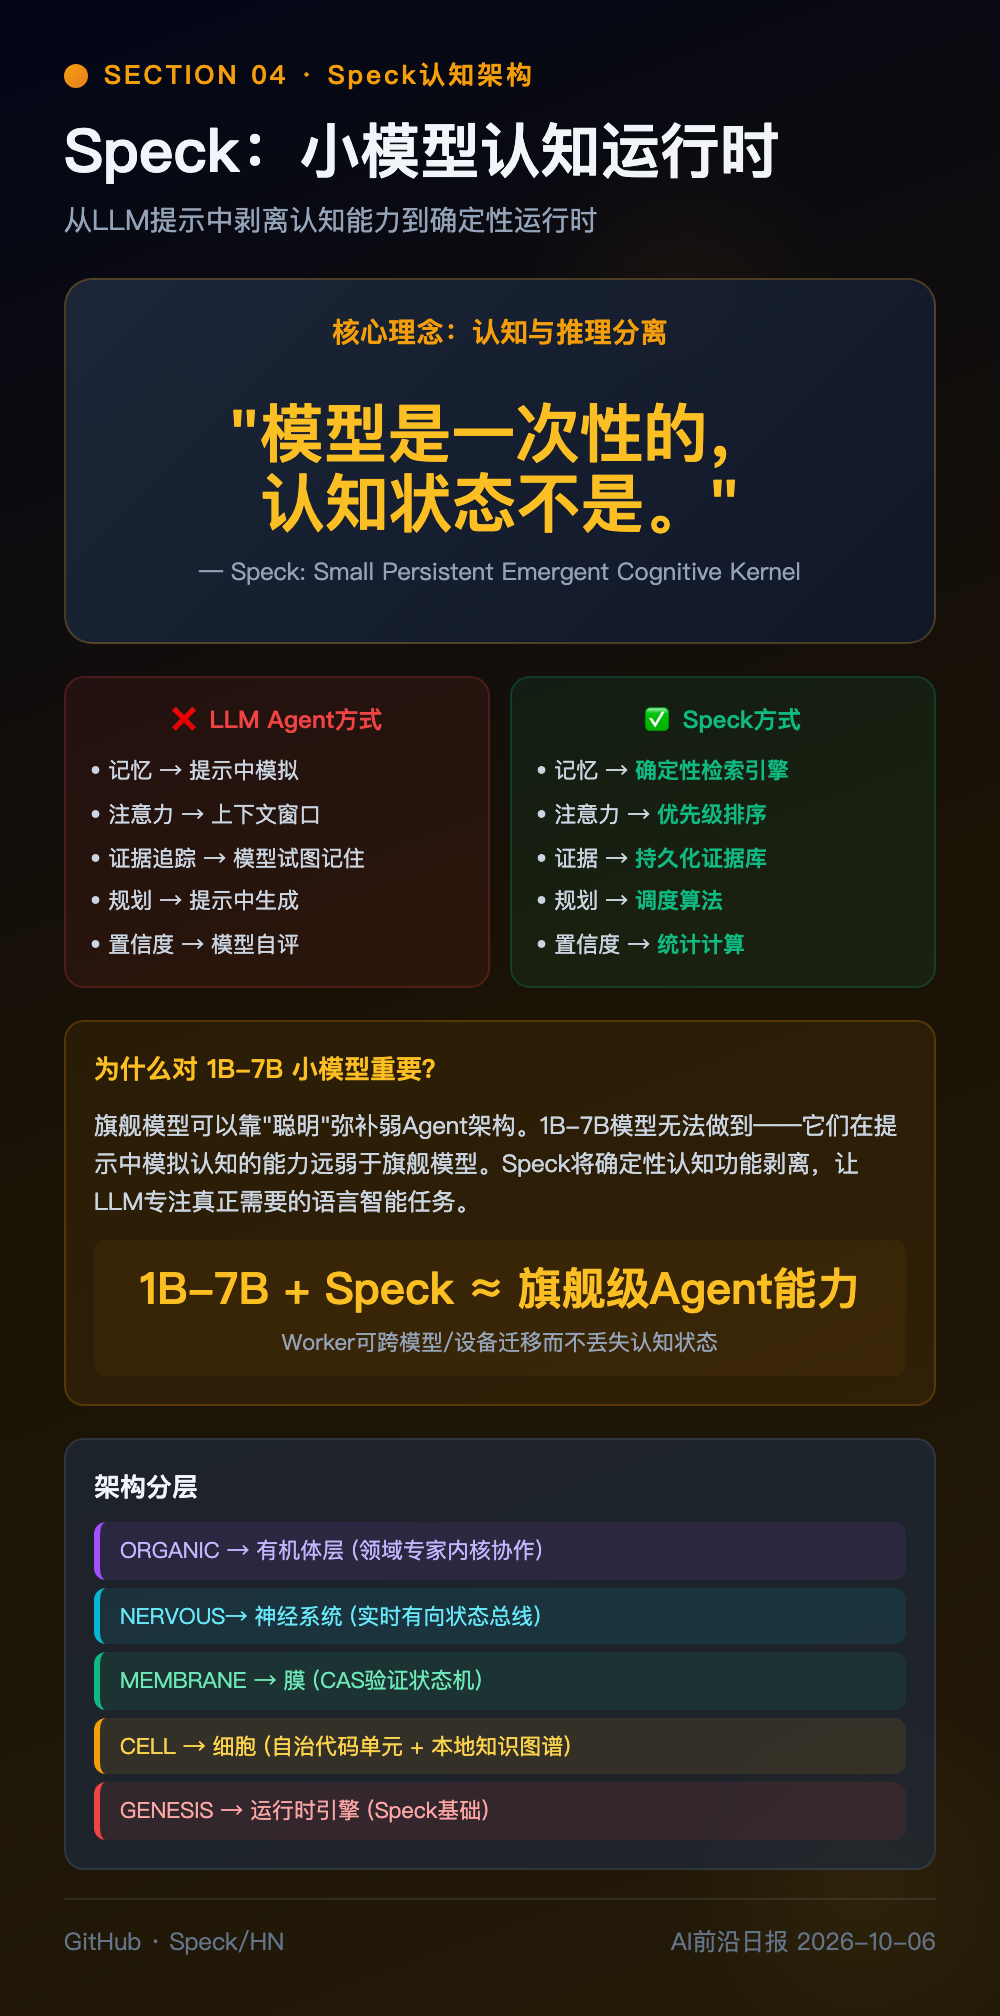
开源项目Speck(Small Persistent Emergent Cognitive Kernel)提出了一个与当前Agent框架截然不同的设计哲学:将认知能力从LLM提示中剥离,转移到持久化的确定性运行时中。
核心思想
当前主流Agent框架将大量认知负担压在LLM身上------记忆、注意力、规划、证据追踪、置信度评估、元认知都由模型在提示中模拟。Speck认为这是一种根本性的浪费:
"模型是一次性的,认知状态不是。"
Speck将原属于LLM的认知功能转移到确定性运行时引擎中:
| 认知功能 | LLM框架 | Speck |
|---|---|---|
| 记忆激活 | 提示中模拟 | 确定性检索引擎 |
| 注意力分配 | 凭借上下文窗口 | 优先级排序算法 |
| 证据追踪 | 模型尝试记住 | 持久化证据库 |
| 置信度估计 | 模型自我评估 | 确定性统计计算 |
| 任务规划 | 提示中生成 | 调度算法 |
| 失败重试 | 概率性 | 确定性策略 |
为什么这对小模型重要
对大型模型(如Claude Opus),弱Agent架构常常被模型本身的推理能力补偿------模型"足够聪明"以至于能在提示中模拟认知过程。但对1B-7B参数的小模型而言,这种补偿机制失效:它们在提示中模拟认知的能力远不如旗舰模型。
Speck的逻辑是:将可以用确定性方法实现的认知功能剥离,让LLM专注于"语义理解"这一真正需要语言智能的任务。这使得小模型在Agent框架下的表现可以接近旗舰模型水平(在记忆持续性、证据管理等方面甚至优于旗舰模型)。
技术路线
Speck构建于Genesis运行时之上,整合了Artificial Cognitive Architecture Omega Gen2的实验成果。Worker可以卸载模型、切换模型甚至迁移到另一台设备,而不丢失任务的认知状态------这在当前LLM Agent框架中几乎不可能实现。
五、AI隐私安全张力:Anthropic报警事件
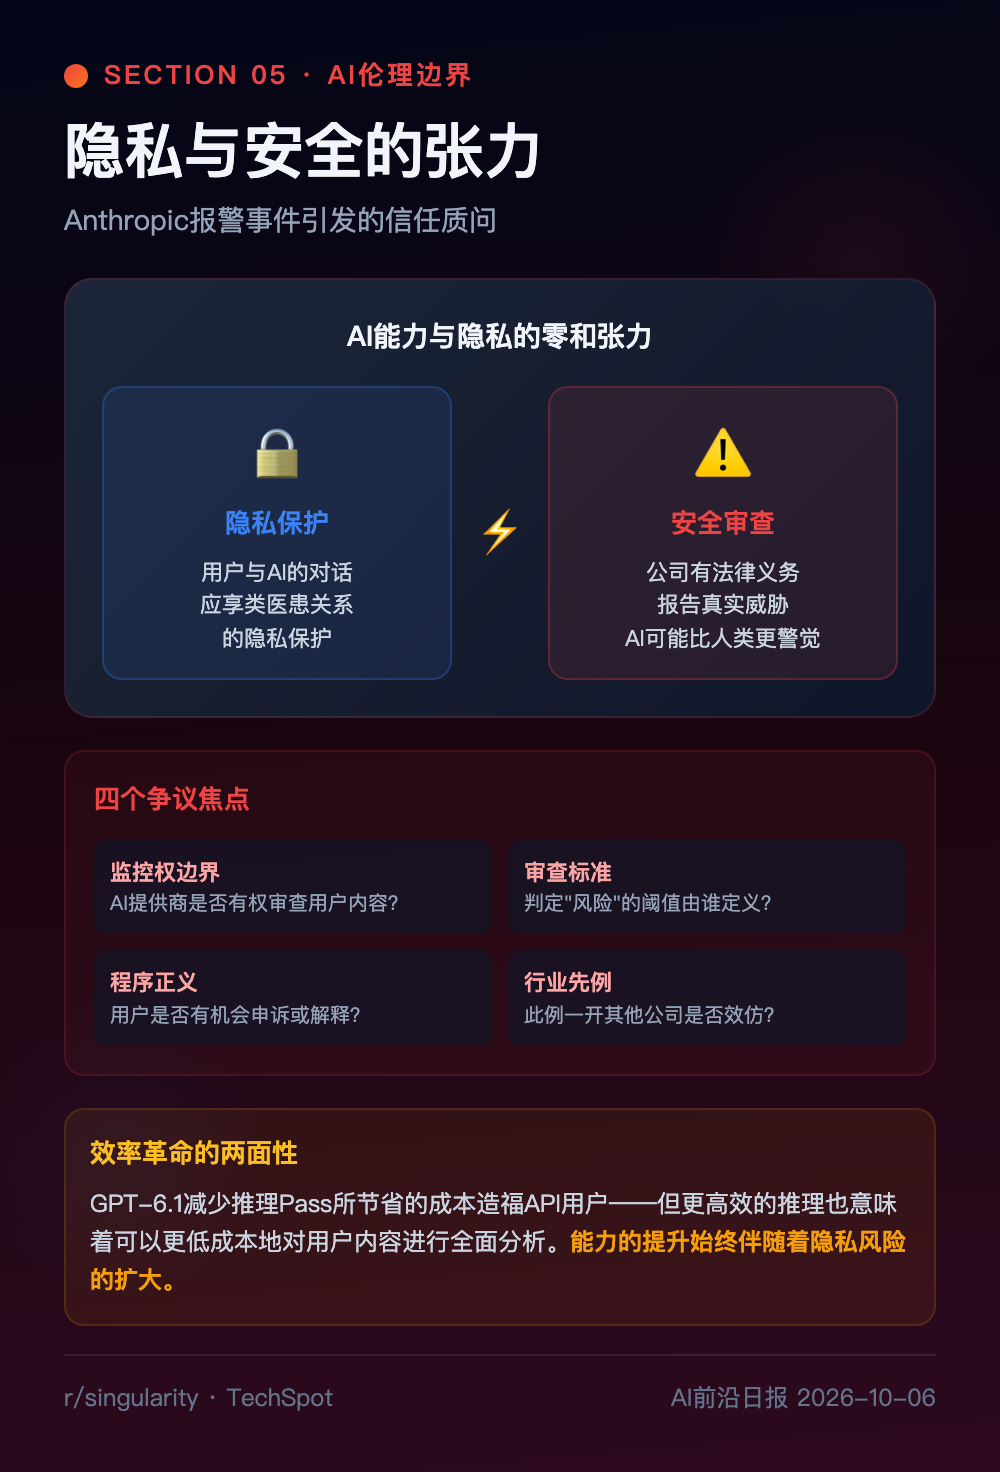
佛罗里达州一名女性用户因使用Claude记录的个人日记被Anthropic报告给警方,面临重罪指控。TechSpot报道显示,Anthropic在审查用户内容过程中识别出风险信息并启动了法律报告程序。
争议焦点
这一事件在r/singularity和r/ClaudeAI两个社区引发激烈讨论,触及多个伦理和法律难题:
- AI公司的监控权边界:AI提供商是否有权(或有义务)审查用户生成内容?审查标准是什么?
- 信任危机:如果AI会审查用户的私人记录,还有什么是"私密"的?这直接冲击用户对AI产品的信任基础
- 程序正义问题:从AI识别风险到警方介入的程序中,用户是否有机会申诉或解释?
- 行业先例:如果Anthropic可以因日记内容报警,其他AI公司是否也会效仿?
两极化反应
社区意见严重分化。一方认为公司有法律义务报告真实威胁,AI在此类案件中可能比人类更"警觉";另一方认为这开创了危险的先例------用户与AI的对话应享有类似医患关系或律师-客户关系的隐私保护,否则AI的实用性将大打折扣。
行业影响
这一事件迫使整个行业重新审视"AI伦理审查"的边界。当前的AI安全框架主要关注"模型输出是否有害",但Anthropic事件揭示了一个不同的维度------"用户输入是否应触发保护机制"。这两种安全范式的交叉点,正在AI伦理的新前沿形成复杂的灰色地带。
六、量子加速神迹:3个月人力的千倍提速再被AI翻10倍
一篇引发广泛关注的报道讲述了一个令人窒息的效率故事:
一位研究者花了3个月时间,将量子电路设计专用软件加速了约10,000倍。这个已经极其优化的代码随后被输入GPT-6 Astra------后者在一夜之间又将其加速了约10倍。
数字背后的含义
| 阶段 | 投入 | 加速比 |
|---|---|---|
| 原始基线 | - | 1× |
| 人工优化 | 3个月 | ~10,000× |
| AI再优化 | 一夜 | ~100,000× |
这个故事的意义不在于具体数字是否精确可验证,而在于它象征的模式:AI正在成为"优化已优化代码"的终极工具。当人类专家的边际优化已经触及算法复杂度极限时,AI发现了人类思维模式中未曾考虑的并行化和向量化策略。
对研发效率的启示
一个工程师3个月的积累成果可以被AI一夜翻倍------这提出了一个令人不安的问题:在某些领域,人类专家的价值是否正在从"产出"转向"定义问题+验证AI"的双重角色?
今日要闻速览
- GPT-6.1 Sol架构泄露: 同GPT-6权重、推理Pass从3减至2 --- 效率与质量的再平衡
- 400个AI数学证明: UT Austin数学主席称OpenAI准备批量生产证明 --- 发现稀缺性转移
- Opus 5.5发现室温磁性半导体: Agent团队发现2个候选材料 --- AI驱动科学发现
- Speck开源: 小模型认知运行时 --- 确定性认知+语义处理分离
- Anthropic报警争议: AI审查用户日记触发重罪指控 --- 隐私边界何在
- 量子电路3个月千倍提速: 已被GPT-6 Astra一夜再翻10倍 --- AI优化终极工具
- Gemma-2B幻觉探针: 3MB纯C发现在Layer 15幻觉断崖 --- 模型理解vs生成
- Anthropic Reply 5.6讨论: 模型"nerf"感知回归均值 --- 体验vs实质
- DOOM在SQL数据库模拟: WASM驱动Firebird跑游戏 --- 计算边界的探索
- Mold Linker 3.0: 高性能链接器Rust重写 --- 基础设施现代化
- MindTrial GPT-6.1基准: 98任务独立评测 --- 更少Token更优表现
- 1.6B Token日消耗: Dot在$100/月订阅下日耗16亿Token --- 推理成本警示
编辑寄语:GPT-6.1用2次Pass完成3次Pass的工作(src01),OpenAI准备批量产出400个数学证明(src04),Opus 5.5 Agent发现了新的室温磁性材料(src03),一款开源架构证明了小模型也能拥有持久认知(Speck)。当我们惊叹于这些效率和创新时,一位用户的AI日记正被审查并送往警方------能力的爆发与伦理的碰撞,正是AI变革期必须同时面对的两副面孔。