本篇速览
- 综合实战的真正难点不是"会用每个组件",而是编排:决定数据在组件间怎么流、什么节奏流、哪个慢了怎么办。
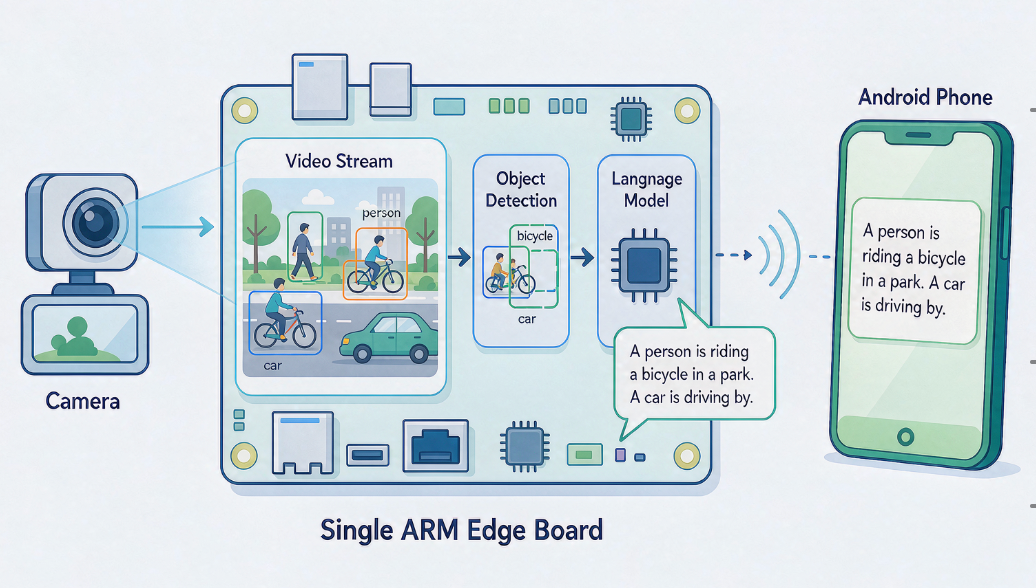
- 本讲把 AidStream(视频)、AidLite(检测)、AidGen/AidGenSE(大模型)、AidConnect(跨系统)装成一个"智能摄像头解说"应用:摄像头看画面 → 检测出目标 → 大模型生成中文解说 → 推送到 Android 展示。
- 多组件系统最大的两个工程风险是节奏不匹配 (大模型慢、检测快,帧会堵)和资源叠加(各组件内存加起来爆掉),两者都要在设计期解决,而不是跑起来再补。
- 联调的铁律是分阶段:先把每一段单独跑通,再逐段拼接,每接一段就验证一段,切忌一次全连通再排错。
一、从"会用每个零件"到"攒出一台机器"
1.1 先盘点一下家底
到第 10 讲为止,这套工具链的零件你已经逐个摸过了:AidLite 管推理底座,AIMO/Model Farm 管模型供给,AidCV 管图像处理,AidStream 管视频流水线,AidGen/AidGenSE 管大模型,AidConnect 管跨系统通信,AidVoice 管语音。每一个你都单独跑通过,知道它的接口长什么样、坑在哪里。
但请注意一个事实:这些实战都是"单组件 Demo"------一次只让一个组件干活。真实产品从来不长这样。真实产品是多个组件同时运转、互相喂数据、彼此等结果。从"会用每个零件"到"攒出一台能跑的机器",中间隔着一道很多教程都不讲的坎:系统集成。这一讲就专门过这道坎。
1.2 集成的难点不在"会",在"编排"
为什么单组件都会、攒一起就翻车?因为集成引入了一类单组件时不存在的问题------编排(orchestration):
- 节奏问题:视频是 30fps 连续来的,检测每帧几十毫秒,大模型生成一句话要一两秒。三者节奏完全不同,谁等谁?帧来了大模型还在忙,是丢帧还是排队?
- 资源问题:每个组件单独跑内存都够,一起跑就可能爆。视频缓冲、检测模型、大模型权重、KV Cache,全挤在一块板子的内存里。
- 状态问题:组件分布在不同进程甚至不同系统(Linux/Android),它们之间的状态怎么保持一致?一个重启了,其他的怎么知道?
- 依赖问题:大模型服务没起好,检测就先来了;通道没建连,结果就要发。启动顺序、依赖等待,都得有人管。
这些问题,单组件教程不会教,因为它们只在"攒起来"时才出现。这正是本讲的价值。
1.3 选什么做综合案例:智能摄像头解说
综合实战需要一个能"把所有零件都用上"的案例。我们选智能摄像头解说------它在第 5、6、7 讲就埋过伏笔:摄像头实时看画面,检测到有意思的目标(比如有人经过、出现某个物体),就让大模型用一句自然的中文把画面"说"出来,推送到 Android 界面上展示。
这个案例几乎是工具链的"全科考试":用 AidStream 采视频、AidLite 跑检测、AidGen/AidGenSE 生成解说、AidConnect 把结果送上 Android。它不追求功能多花哨,而追求"链路完整、结构清晰"------把这套骨架吃透,换成你自己的业务(工业巡检、门店客流、园区安防)只是替换检测目标和解说逻辑的事。
1.4 目标、硬件与"做到什么算成"
先把"做成什么样"定义清楚,免得跑偏。最终效果:摄像头对着一个场景,当画面里出现设定目标时,Android 界面上隔几秒就刷新一句中文解说(如"画面中有一个人正从左侧走过"),过程流畅不卡死。
硬件用犀牛派 X1(QCS8550) ------要同时扛视频解码、检测推理和大模型,需要它的算力与内存。模型沿用第 7、8 讲的 Qwen2.5-0.5B-Instruct 做解说生成,检测用一个轻量目标检测模型(如 YOLO 系列)跑在 AidLite 上。成功的判据在第八节细化为可测的指标,这里先记住一句话:链路通、节奏顺、不崩溃。
二、系统总体设计:先画蓝图再动手
2.1 数据流总览
动手前先把整张蓝图铺开。数据怎么从摄像头一路流到 Android 屏幕,一张图看清:
#mermaid-svg-Bw24qifGCwBLvNZ4{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-Bw24qifGCwBLvNZ4 .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-Bw24qifGCwBLvNZ4 .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-Bw24qifGCwBLvNZ4 .error-icon{fill:#552222;}#mermaid-svg-Bw24qifGCwBLvNZ4 .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-Bw24qifGCwBLvNZ4 .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-Bw24qifGCwBLvNZ4 .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-Bw24qifGCwBLvNZ4 .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-Bw24qifGCwBLvNZ4 .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-Bw24qifGCwBLvNZ4 .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-Bw24qifGCwBLvNZ4 .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-Bw24qifGCwBLvNZ4 .marker{fill:#333333;stroke:#333333;}#mermaid-svg-Bw24qifGCwBLvNZ4 .marker.cross{stroke:#333333;}#mermaid-svg-Bw24qifGCwBLvNZ4 svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-Bw24qifGCwBLvNZ4 p{margin:0;}#mermaid-svg-Bw24qifGCwBLvNZ4 .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-Bw24qifGCwBLvNZ4 .cluster-label text{fill:#333;}#mermaid-svg-Bw24qifGCwBLvNZ4 .cluster-label span{color:#333;}#mermaid-svg-Bw24qifGCwBLvNZ4 .cluster-label span p{background-color:transparent;}#mermaid-svg-Bw24qifGCwBLvNZ4 .label text,#mermaid-svg-Bw24qifGCwBLvNZ4 span{fill:#333;color:#333;}#mermaid-svg-Bw24qifGCwBLvNZ4 .node rect,#mermaid-svg-Bw24qifGCwBLvNZ4 .node circle,#mermaid-svg-Bw24qifGCwBLvNZ4 .node ellipse,#mermaid-svg-Bw24qifGCwBLvNZ4 .node polygon,#mermaid-svg-Bw24qifGCwBLvNZ4 .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-Bw24qifGCwBLvNZ4 .rough-node .label text,#mermaid-svg-Bw24qifGCwBLvNZ4 .node .label text,#mermaid-svg-Bw24qifGCwBLvNZ4 .image-shape .label,#mermaid-svg-Bw24qifGCwBLvNZ4 .icon-shape .label{text-anchor:middle;}#mermaid-svg-Bw24qifGCwBLvNZ4 .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-Bw24qifGCwBLvNZ4 .rough-node .label,#mermaid-svg-Bw24qifGCwBLvNZ4 .node .label,#mermaid-svg-Bw24qifGCwBLvNZ4 .image-shape .label,#mermaid-svg-Bw24qifGCwBLvNZ4 .icon-shape .label{text-align:center;}#mermaid-svg-Bw24qifGCwBLvNZ4 .node.clickable{cursor:pointer;}#mermaid-svg-Bw24qifGCwBLvNZ4 .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-Bw24qifGCwBLvNZ4 .arrowheadPath{fill:#333333;}#mermaid-svg-Bw24qifGCwBLvNZ4 .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-Bw24qifGCwBLvNZ4 .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-Bw24qifGCwBLvNZ4 .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-Bw24qifGCwBLvNZ4 .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-Bw24qifGCwBLvNZ4 .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-Bw24qifGCwBLvNZ4 .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-Bw24qifGCwBLvNZ4 .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-Bw24qifGCwBLvNZ4 .cluster text{fill:#333;}#mermaid-svg-Bw24qifGCwBLvNZ4 .cluster span{color:#333;}#mermaid-svg-Bw24qifGCwBLvNZ4 div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-Bw24qifGCwBLvNZ4 .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-Bw24qifGCwBLvNZ4 rect.text{fill:none;stroke-width:0;}#mermaid-svg-Bw24qifGCwBLvNZ4 .icon-shape,#mermaid-svg-Bw24qifGCwBLvNZ4 .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-Bw24qifGCwBLvNZ4 .icon-shape p,#mermaid-svg-Bw24qifGCwBLvNZ4 .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-Bw24qifGCwBLvNZ4 .icon-shape .label rect,#mermaid-svg-Bw24qifGCwBLvNZ4 .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-Bw24qifGCwBLvNZ4 .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-Bw24qifGCwBLvNZ4 .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-Bw24qifGCwBLvNZ4 :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 是
否
摄像头
AidStream
采集/解码
AidLite
目标检测
触发判断
有新目标?
AidGen/AidGenSE
生成中文解说
AidConnect
跨系统通道
Android 界面
展示解说
注意中间那个"触发判断"菱形------它是整个系统的节拍器。不是每一帧都惊动大模型(那样大模型根本忙不过来),而是只有"画面里出现了值得关注的变化"时才调用一次。这个设计决策,是系统不卡死的关键,第三章会重点讲。
2.2 模块划分与职责边界
把系统切成几个职责单一的模块,每个只做一件事:
- 采集检测模块:从 AidStream 拿帧、喂给 AidLite 检测、产出"当前画面有哪些目标"。节奏快(跟随帧率)。
- 触发决策模块:盯着检测结果的流,判断"值不值得让大模型说一次"。做节流与去抖。
- 解说生成模块:拿到触发,把检测结果组织成 prompt,调 AidGenSE 生成解说。节奏慢(秒级)。
- 结果上报模块:把解说文本经 AidConnect 发到 Android。
- 编排器(orchestrator):把上面几个模块串起来,管启动顺序、数据传递、异常兜底。
职责边界划清的好处:每个模块可单独开发、单独测试,出问题能立刻定位到模块。这和前面每讲"封装成模块"的思想一脉相承,只是这次是把多个模块再往上组一层。
2.3 线程/进程模型:谁快谁慢怎么共处
节奏不同的模块不能挤在一个同步循环里------否则大模型生成的那一两秒,视频帧就全堵死了。经典解法是生产者-消费者 + 队列解耦:采集检测在一个线程/进程里跑,把"值得解说的事件"丢进一个队列;解说生成在另一个线程/进程里,从队列取事件慢慢处理。这样检测不被大模型拖慢,大模型也不被帧率压垮。
队列要有界:如果大模型处理不过来,事件会堆积。队列满了怎么办?常见策略是丢旧留新 (解说这种场景,旧画面的事件丢了就丢了,最新才重要)或直接丢弃新事件(太忙就不添乱)。选哪种看业务,但"队列必须有界、必须有满的策略"是铁律------无界队列等于把内存炸弹埋进系统。
2.4 资源预算:先算账再分配
多组件共享一块板子,内存是最先撞的墙。动手前粗算一笔:视频解码缓冲(几帧 × 每帧几 MB)+ 检测模型权重与激活(几十到几百 MB)+ 大模型权重(0.5B 量化后几百 MB 到 1GB+)+ KV Cache(随 cl 增长)+ 各进程运行时开销。把这些加起来,对照 X1 的可用内存,确认有富余。如果紧张,优先级是:先缩大模型 cl、再缩视频缓冲帧数、再降视频分辨率。这笔账不用精确到字节,但"先估算、再动手"能避免"攒起来才发现内存不够返工"的尴尬。具体占用以真机实测为准。
2.5 配置驱动 vs 硬编码:让系统可调
多组件系统的参数远比单组件多:抽帧率、冷却时间、队列长度、置信度阈值、模型路径、通道名、服务地址......如果硬编码在代码各处,联调时改一个参数要翻半天、还容易改漏。工程上的好习惯是配置驱动:把所有可调参数集中到一份配置(如 6.1 的 CONFIG,或独立的 YAML/JSON),代码只读配置、不写死数值。好处有三:联调改参不用动代码、不同部署(开发板/量产机)用不同配置、参数一目了然便于审查。多组件系统的复杂度,一半来自"参数太多太散",配置驱动正是治这个病。把"哪些该进配置"想清楚------凡是可能随场景、随硬件、随部署而变的,都该进配置,而不是埋进代码。
三、关键技术决策:把零件连成线
3.1 帧的流转与检测节奏
视频是连续的,但不是每帧都要检测。检测本身要几十毫秒,30fps 全检会把算力吃光。常见做法是抽帧检测:每秒只取几帧(比如 5fps)喂给检测,既能跟上画面变化,又给大模型和其他组件留出算力。抽帧间隔按"画面变化多快"定------场景稳定就少检,变化快就多检。这是第一道"节奏调节阀"。
3.2 "什么时候让大模型说话":触发策略
这是整个系统最值得琢磨的设计。如果每检到一个目标就叫大模型,大模型会被淹没(生成一次要秒级,而检测每秒好几次)。触发策略要回答"什么变化值得说"。几个常用思路,常组合用:
- 目标集合变化:当画面里的目标种类/数量发生变化(出现了新类别、人走了)才触发,而不是"一直有人就一直说"。
- 冷却时间:两次解说之间至少间隔 N 秒,避免大模型连轴转。
- 显著性过滤:太小的框、置信度太低的框不值得解说,过滤掉。
把这三条叠起来,大模型的调用频率就从"每秒数次"降到"画面真有变化时才说一次",系统节奏一下就顺了。触发逻辑写成一个独立函数,输入检测结果、输出"要不要说 + 说什么的事由",便于单测。
3.3 检测与 LLM 的衔接:从"框"到"话"
检测输出的是结构化数据(一堆框:类别、位置、置信度),大模型要的是自然语言 prompt。中间需要一道"翻译":把检测结果组织成大模型能理解的描述。比如把 [{person, 左侧, 0.9}, {dog, 中间, 0.8}] 组织成 prompt:"画面左侧有一个人(置信度高),中间有一只狗。请用一句自然的中文描述这个画面。"这道"结构化 → 自然语言"的转换,是视觉和大模型衔接的关键。prompt 里带上位置、数量、类别,大模型生成的解说才会有依据、不空洞。
3.4 结果上行:Linux → Android 的通道设计
解说文本要从 Linux 侧送上 Android。这正是第 9 讲 AidConnect 的用武之地:解说文本是小数据(一句话几十上百字节),走 AidConnect 的轻量通道即可,不必动用为零拷贝准备的大通道。设计上把"结果上报"单独成一个模块,封装 AidConnect 的连接管理、发送、断线重连(复用第 9 讲 6.5 的封装思路)。Android 侧收到文本,切主线程更新界面------和第 9 讲的接法完全一致。
3.5 降级与容错:某个零件慢了/挂了怎么办
多组件系统必须假设"任何零件都可能慢或挂"。为每个关键环节想好降级:大模型服务暂时不可用,是跳过这次解说、还是用一句模板话("检测到 N 个目标")兜底?Android 通道断了,是缓存结果等重连、还是直接丢弃?检测模型加载失败,整个系统要不要降级为"只预览不解说"?把这些"万一"提前想清楚、写进编排器,系统才不会因为一个小零件抽风就整体瘫痪。容错设计的核心原则:任何一个非核心组件失效,系统都应降级运行而非整体崩溃。
3.6 数据在组件间怎么"过手":拷贝、引用还是消息
组件之间传数据,有三种"过手"方式,选错了性能和正确性都会受影响。一是拷贝 :把数据完整复制一份给对方,简单安全,但大数据(图像帧)拷贝开销大;二是引用/共享 :传一个指向共享内存的句柄或索引(第 9 讲的零拷贝思路),快,但要管好"这块内存谁在用、用到什么时候"的生命周期;三是消息 :只传一个小描述("第 N 帧在缓冲区的哪个位置、检测结果是什么"),数据本体不动,动的只是描述。本讲的实践是混合用:帧这种大数据走共享/引用(别来回拷),检测结果、解说文本这种小数据走消息/拷贝。原则一句话:大数据传引用,小数据传消息,能不拷就不拷。
四、环境调研:组件清单与依赖核对
4.1 组件与模型清单
把这次要用到的东西列成清单,逐条确认就绪:
| 组件/资源 | 用途 | 来源/前置讲 |
|---|---|---|
| AidStream | 视频采集解码 | 第 06 讲 |
| AidLite + 检测模型 | 目标检测 | 第 02、04 讲 |
| AidGenSE + Qwen2.5 | 生成解说 | 第 07、08 讲 |
| AidConnect | 结果上行 Android | 第 09 讲 |
| 摄像头 | 画面来源 | 第 05、06 讲 |
每一项都应在前序章节单独跑通过。若有任何一项还没验证,先回到对应讲把它跑通再回来------综合实战不是验证单组件的地方。
4.2 版本对齐总表(终极版)
到这一讲,版本总表已经攒了不少行。把它更新到"终极版":QNN 版本、AidLite 版本、AidStream 插件版本、AidGen/AidGenSE 版本、AidConnect 版本(Linux/Android 两侧)、检测模型版本、大模型版本,全部对齐并记录。多组件系统里,版本错配的概率比单组件高得多------任何一个组件版本对不上,链路就断在那一环。这张表是联调期排障的第一参考。
4.3 资源预算落地:各组件限多少
把 2.4 的粗算落成具体限额:视频缓冲限几帧、检测每秒限几帧、大模型 cl 限多大、解说队列限多长。把这些写成配置项(而不是散落代码里的魔法数字),联调时改起来方便,也能一目了然看到"资源都分给谁了"。资源限额是系统稳定的第一道闸,宁可保守起步再逐步放开。
五、操作步骤:分阶段搭建与联调
铁律先立:不要试图一次把整个系统连通再调。分四个阶段,每阶段独立验证通过再进下一段。
5.1 阶段一:视频采集 + 检测跑通
先把 AidStream 采集和 AidLite 检测接起来:摄像头出画面,检测实时出框,在 Linux 侧能把框画到画面上(复用第 6 讲的管线)。这一阶确认"看得清、检得出",且不涉及大模型和 Android,问题域最小。
5.2 阶段二:接入大模型生成解说
在阶段一基础上,加触发判断和解说生成:检测到目标变化时,组织 prompt 调 AidGenSE,把生成的解说打印到 Linux 终端。这一阶确认"检得出 → 说得出",重点调触发策略(别太频繁)和 prompt(解说要言之有物)。先在终端看效果,不接 Android。
5.3 阶段三:结果上 Android 展示
把解说文本经 AidConnect 推到 Android 界面。这一阶确认"说得出 → 看得见",重点调通道的稳定(断线重连)和 Android 侧的 UI 更新(切主线程)。到这一步,端到端链路就通了。
5.4 阶段四:加节流与容错,成型
最后把节奏调顺、把容错补齐:抽帧间隔、冷却时间、队列上限、降级策略都配上,做压力测试(连续跑、目标频繁变化),观察是否卡顿、是否内存爬升。这一阶把"能跑"打磨成"跑得稳"。
5.5 联调顺序的纪律
四阶段顺序不能乱,背后是排障效率的考量:每接一段就验证一段,出问题时你确切知道"是新接的这段出了问题",而不是在五个组件里大海捞针。这条"分而治之、逐段验证"的纪律,是一切多系统集成的通用心法,远比记住本讲的具体代码重要。
5.6 一份可复用的联调清单
把四阶段联调落成一份可勾选的清单,以后做类似系统可直接复用:
- 每路组件单独跑通(采集 / 检测 / 大模型 / 通道各自验证过)
- 版本总表对齐,依赖检查脚本通过(4.2、4.4)
- 阶段一:采集 + 检测出框,帧率达标
- 阶段二:触发 + 解说,终端能看到合理文本
- 阶段三:解说上 Android,显示正确、断线能重连
- 阶段四:节流 / 容错配齐,压测不卡、内存不涨
- 埋点日志能看清每环耗时与队列长度(8.5)
- 优雅启停:反复 start/stop 无资源泄漏(6.6)
把"联调"从凭经验摸索,变成按清单逐项确认,效率和覆盖率都会高得多。这份清单和第 12 讲的量产验收清单是上下衔接的------联调清单管"拼得对不对",量产清单管"跑得久不久"。
4.4 依赖检查脚本:联调前先过一遍
在正式联调前,用一个脚本把所有依赖自动检查一遍,能省下大量"东漏一个西缺一个"的时间。脚本要做的事:检测模型文件是否存在、大模型服务是否探活(对 8888 发一个最小请求)、AidConnect 通道能否建连、摄像头设备是否可打开。每一项通过打勾、失败给出明确提示。把这个脚本作为联调的"第 0 步",跑通了再进四阶段------很多"系统不起来"的问题,其实是某个依赖压根没就绪,而脚本能在 10 秒内告诉你缺的是哪一个。
六、关键代码:主编排器
下面给一个把各模块串起来的编排器骨架。各组件 API 以官方文档为准,这里重点看编排结构:初始化 → 检测循环 → 触发 → 解说 → 上报。
6.1 配置与组件初始化
python
# orchestrator.py ------ 智能摄像头解说 编排器骨架(API 以官方文档为准)
import queue, threading, time

CONFIG = {
    "detect_fps": 5,          # 抽帧检测:每秒检几帧
    "cooldown_s": 4,          # 两次解说最小间隔
    "queue_max": 4,           # 解说事件队列上限
    "min_conf": 0.5,          # 置信度阈值
    "llm_url": "http://127.0.0.1:8888/v1/chat/completions",
    "model": "qwen2.5-0.5b-instruct",
    "channel": "caption",     # AidConnect 通道名
}

event_q = queue.Queue(maxsize=CONFIG["queue_max"])  # 有界队列,解耦快慢两端
把所有节奏与资源参数集中在 CONFIG,联调时只改这里。
6.2 检测循环 + 触发判断(生产者)
python
def detection_loop(detector, frames):
    last_labels = set()
    last_fire = 0.0
    for frame in frames:                      # AidStream 帧流(已抽帧到 detect_fps)
        dets = detector.infer(frame)          # AidLite 检测
        labels = {d.label for d in dets if d.score > CONFIG["min_conf"]}
        now = time.time()
        # 触发:目标集合有变化 且 过了冷却期
        if labels != last_labels and now - last_fire > CONFIG["cooldown_s"]:
            try:
                event_q.put_nowait({"labels": sorted(labels), "ts": now})
                last_fire = now
                last_labels = labels
            except queue.Full:
                pass                          # 队列满则丢弃本次,保护大模型
生产者的职责是"快":检测、判断、丢事件,绝不等大模型。队列满了就丢,这是保护慢端的关键。
6.3 调 LLM 生成解说(消费者)
python
import requests

def caption_loop(channel):
    while True:
        ev = event_q.get()                    # 阻塞等事件,不忙时自然休眠
        prompt = (
            "画面中出现以下目标:" + "、".join(ev["labels"]) +
            "。请用一句简洁自然的中文描述这个监控画面。"
        )
        try:
            r = requests.post(CONFIG["llm_url"], json={
                "model": CONFIG["model"],
                "messages": [{"role": "user", "content": prompt}],
            }, timeout=60)
            caption = r.json()["choices"][0]["message"]["content"]
        except Exception:
            caption = "检测到:" + "、".join(ev["labels"])   # 降级:模板话兜底
        channel.send_text(caption)            # 上报 Android
消费者从队列取事件、调大模型、上报。大模型挂了就用模板话兜底,不让链路断。
6.4 经 AidConnect 上报(复用第 9 讲封装)
python
class ResultChannel:                          # 复用第 9 讲的通道封装思路
    def __init__(self, name):
        import aidconnect
        self.ch = aidconnect.create_channel(name=name, role="server")
        self.ch.wait_connected(timeout=10)
    def send_text(self, text):
        try:
            self.ch.send(text.encode("utf-8"))
        except Exception:
            self.reconnect()                  # 断线重连
    def reconnect(self):
        pass                                  # 重连逻辑,见第 9 讲
6.5 组装:主函数
python
def main():
    channel = ResultChannel(CONFIG["channel"])
    detector, frames = init_pipeline()        # 初始化 AidStream + AidLite
    t = threading.Thread(target=caption_loop, args=(channel,), daemon=True)
    t.start()                                 # 消费者在后台线程跑
    detection_loop(detector, frames)          # 生产者在主线程跑

if __name__ == "__main__":
    main()
两个线程、一个有界队列,快慢两端解耦------这就是整个系统的骨架。真正的工程细节(帧的解码、检测后处理、通道重连)填进各函数即可,但"生产者-消费者 + 有界队列"这个结构是灵魂。
6.6 优雅启停与资源释放
产品要能干净地启动和停止。启动时按依赖顺序拉起:先 AidGenSE 服务、再通道、再检测管线;停止时先停帧流、再清空队列、再关通道、最后释放模型。用 try/finally 或上下文管理器确保异常时也能释放资源(显存、内存、文件句柄)。能"干净地停",和能"跑起来"同等重要------量产时进程要被反复启停,资源泄漏会在长跑后爆发。
6.7 把解说做成"流式"推送
6.3 里解说是"生成完一整句才上报",Android 要等一两秒才看到完整一句话。可以做得更好:利用第 8 讲的流式 SSE,让大模型边生成、Android 边逐字显示(打字机效果)。改法是 caption_loop 里把非流式请求换成流式请求,每收到一个增量就经 AidConnect 推一小段给 Android,Android 侧追加显示。这样用户从"画面变化到看到第一个字"的等待大幅缩短,体验接近实时对话。代价是通道消息变多(每 token 一条),但文本极小,AidConnect 完全扛得住。要不要上流式,看产品对"响应感"的要求------监控解说这种场景,流式是明显的体验加分项。
6.8 一份完整的配置文件长这样
把 CONFIG 落到一份独立文件(如 config.yaml),便于审查与分部署管理:
yaml
# config.yaml ------ 智能摄像头解说 配置
detect_fps: 5          # 抽帧检测帧率
cooldown_s: 4          # 两次解说最小间隔(秒)
queue_max: 4           # 解说事件队列上限
min_conf: 0.5          # 检测置信度阈值
llm:
  url: "http://127.0.0.1:8888/v1/chat/completions"
  model: "qwen2.5-0.5b-instruct"
  timeout_s: 60
channel:
  name: "caption"      # AidConnect 通道名
  role: "server"
camera:
  device: "/dev/video0"
  resolution: [1280, 720]
把这份配置纳入版本管理,每次改动有迹可循;不同部署(开发板 / 量产机)各维护一份,启动时加载对应那份。配置即文档------看这份文件,就知道系统当前是怎么调的,也为第 12 讲的量产部署打好了"环境可分"的基础。
七、坑点
7.1 帧率被大模型拖垮(节奏不匹配)
最经典的坑:把检测和大模型写在一个同步循环里,大模型生成的那一两秒,视频全卡住。对策就是 2.3/6.2 的生产者-消费者解耦------检测绝不等大模型,靠有界队列传递。出现"画面卡"先查是不是快慢两端没解耦。
7.2 内存叠加爆掉
每个组件单跑都够,一起跑就崩------资源叠加没算(2.4)。对策:先缩大模型 cl、再减视频缓冲帧、再降分辨率;把各组件内存限额写进 CONFIG 并监控实际占用。内存问题要在设计期解决,别等跑了才补。
7.3 触发过于频繁 / 解说抖动
解说刷得太快、内容反复横跳,是触发策略没做好(3.2)。对策:加冷却时间、要求目标集合"稳定变化"再触发、过滤低置信度框。让大模型"少而精"地说,比"喋喋不休"体验好得多。
7.4 跨进程 / 跨系统状态不一致
大模型服务没起好检测就来了、通道没连上结果就发了------启动依赖没管好。对策:编排器按依赖顺序启动并做就绪检查(服务探活、通道 wait_connected),未就绪不进入主循环。
7.5 一个组件崩,全链路瘫
某个非核心组件(如解说生成)挂了,整个系统跟着死。对策:按 3.5 做降级------非核心组件失效时系统降级运行(如只检测不解说、用模板话兜底),核心链路(采集→检测)保持可用。
7.6 调试多组件的方法论:缩小问题域
多组件系统排障最大的陷阱,是在五六个组件里漫无目的地找。正确的心法是持续缩小问题域 :先用埋点日志(8.5)定位"是哪一环异常"------是检测、大模型、还是通道;再把那一环单独抽出来复现:检测异常就用固定图片单测检测,大模型异常就用固定 prompt 单测服务,通道异常就用第 9 讲的回环测试单测通道。把"系统级的问题"降解成"单组件的问题",而单组件问题你早就会解了。这套"定位到环 → 抽出来单测"的动作,和第五章的分阶段联调是同源思想------都拒绝"整体揉在一起调",坚持"分而治之"。记住一句:在多组件系统里,找到问题出在哪一环,往往比修复它更难、也更关键。
八、验证:端到端跑起来
8.1 功能正确性
对着摄像头制造几个已知场景(没人、一个人走过、出现特定物体),看 Android 上的解说是否与实际相符、是否在该说的时候才说。正确性首先看"说的对不对",其次看"说的时机对不对"。
8.2 端到端延迟分解
从"画面出现变化"到"Android 显示解说"的总延迟,拆开打点:检测耗时 + 触发判断 + 大模型生成 + 通道传输 + UI 刷新。大头通常是大模型生成(秒级),其余都是毫秒级。知道时间花在哪,才知道优化哪------这个场景里,延迟基本由大模型决定,优化方向是缩 cl、换更小模型或减少调用频率。
8.3 帧率与资源占用
跑稳后看两项:检测通路的实际帧率(是否达到 detect_fps、有没有被拖慢)和整体内存占用(是否有富余、长跑是否爬升)。这两项直接反映"节奏顺不顺、资源够不够"。长跑几小时观察内存是否泄漏(6.6)。
8.4 异常对照表
综合系统出问题,按现象对号入座:"画面卡死" → 快慢端没解耦(7.1);"跑一会儿崩" → 内存叠加或泄漏(7.2、6.6);"解说刷屏/抖动" → 触发策略(7.3);"启动就乱" → 依赖顺序(7.4);"大模型一挂全瘫" → 缺降级(7.5);"Android 收不到" → 通道未连或断开(5.3、第 9 讲)。多组件系统排障的第一原则是"先定位到哪一环,再深挖那一环"。
8.5 多组件系统的可观测性:给每一环埋点
单组件出问题好查,多组件出问题常卡在"不知道是哪一环慢了、哪一环错了"。解法是可观测性:在每个关键环节埋点记录------每帧检测耗时、每次触发的理由、每次大模型调用的延迟、每次上报的成功与否、队列的实时长度。把这些指标定期打进日志(或暴露成一个简单的查询接口),出问题时翻一眼就知道瓶颈在哪。比如发现队列持续满,说明慢端跟不上、该调节奏;发现大模型延迟飙升,说明资源不够。可观测性不是锦上添花,而是多组件系统的"仪表盘"------没有它,你就是在盲开。量产阶段更系统的监控与告警,第 12 讲会展开。
8.6 把这次实战变成"回归基线"
这套端到端系统跑通后,别急着拆------把它固化成一份"回归基线"。做法:固定几个测试场景(无人、单人经过、特定物体)、固定预期结果(该触发几次、解说大意),写成可重复执行的验收用例。以后每次升级某个组件(换检测模型、换大模型版本、改触发参数),都用这套基线跑一遍,立刻知道"这次改动让端到端效果变好还是变坏"。单组件有单组件的基线(第 8 讲的 LLM 验收、第 10 讲的语音测试集),系统也要有系统级基线------它衡量的是"拼起来之后"的整体表现,这是任何单组件基线都替代不了的。到第 12 讲量产,这份基线会是你每次升级决策的依据。
九、FAQ
Q1:为什么一定要解耦,直接顺序调用不行吗?
顺序调用意味着快组件要等慢组件。视频 30fps、大模型秒级,顺序执行会让视频被大模型拖死。生产者-消费者加有界队列,让两端各按各的节奏跑,是实时多组件系统的标准解法。
Q2:队列设多大合适?
看慢端的处理速度和解说的时效性。解说这类"旧事件意义不大"的场景,小队列(3~5)加"满则丢弃"即可;若每个事件都必须处理,则要更慢的触发或更快的慢端,而不是无限加大队列。
Q3:检测模型和解说大模型能同时放内存吗?
能,但要把两者的内存占用加起来对照板子内存(2.4、4.3)。紧张时优先缩大模型 cl、再缩视频缓冲。X1 跑"轻量检测 + 0.5B 大模型"通常可行,以实测为准。
Q4:这个案例能换成我的业务吗?
完全可以。把检测模型换成你的目标(缺陷、客流、车牌),把 prompt 换成你的解说逻辑,把触发条件换成你的业务规则,骨架不变。本讲的价值就在这副可复用的骨架。
Q5:语音能加进来吗?
能。把第 10 讲的 ASR 接成另一路输入("听到指令 → 触发特定解说"),或把解说文本经 TTS 读出来。注意语音和大模型都吃算力,资源预算要重算。
Q6:为什么用 AidConnect 而不是直接 Android 调 AidGenSE 的 HTTP?
两者都行。若 Android 能直连 Linux 的 8888 端口,用 HTTP 更省事;AidConnect 的优势在跨系统大数据零拷贝(第 9 讲)。本案例解说文本很小,HTTP 或 AidConnect 轻量通道均可,按你的部署形态选。
Q7:多路摄像头怎么办?
每路一套采集检测,事件汇入同一个(或各自的)队列,但要重新核算算力与内存------多路是资源的倍数级增长。大模型通常仍是共享的一个,触发策略要更严格。
Q8:触发判断能用大模型做吗?
可以但通常不值------触发要高频低成本,用大模型做触发等于每次都调用,违背节流初衷。触发用规则/小模型,大模型只负责"值得说时怎么说"。
Q9:怎么测试触发策略好不好?
录几段典型场景的视频,离线跑触发逻辑,统计"触发次数、漏触发、误触发",和人工标注对比。把触发策略做成可离线回放测试的纯函数,迭代会快很多。
Q10:这套系统怎么变成能交付的产品?
那就要解决进程守护、开机自启、日志监控、远程升级这些量产问题了------正是下一讲的主题:把综合实战这台"能跑的机器",变成"能交付、能长期稳定运行的产品"。
十、结论
这一讲,我们把前九讲的零件真正装配成了一台机器:AidStream 采视频、AidLite 跑检测、AidGen/AidGenSE 生成解说、AidConnect 把结果送上 Android,一个"智能摄像头解说"的端到端应用就跑起来了。但比这个应用本身更重要的,是你掌握了多组件集成的通用方法论:先画数据流蓝图、再划模块边界、用有界队列解耦快慢、给每个零件想好降级、然后分阶段逐段联调。
这套方法论不绑定本讲的具体案例------把检测换成你的业务目标、把解说换成你的生成逻辑,骨架照样成立。可以说,到这里你已经具备了用这套工具链做一个完整端侧 AI 应用的全部技术能力。
剩下最后一块拼图:Demo 跑得再好,也只是"能跑"。要把它变成能交付、能 7×24 小时稳定运行、能远程维护升级的产品,还有一段工程化的路要走------进程守护、日志监控、量产升级。这正是下一讲、也是本系列收官之作要解决的问题:从综合实战到量产部署。
本文多组件编排结构、AidStream/AidLite/AidGenSE/AidConnect 的组合用法参考 AidLux 官方文档与前序各讲;生产者-消费者、有界队列、触发节流等为实时系统通用工程方法;帧率、延迟、内存占用等指标随模型、算力与场景而异,精确值以真机实测与当前版本文档为准。文中 API、类名、代码为结构示意,具体以各组件 SDK 与官方文档为准。