一、StartLux-Decision 介绍
最近,决策模型 Jev 很快火了起来。与普通对话模型不同,这类模型不是围绕开放式问答生成一段文字,而是针对给定材料和候选项直接做出判断。比如客服工单该分给哪个团队、故障是否需要升级、影响程度属于哪一级,都可以由模型输出明确的选项和对应概率。
Jev 目前是闭源服务,用户仅能通过接口调用模型,无法本地部署。而本文介绍的 StartLux-Decision 作为开源决策模型,不仅在性能表现上与 Jev 相当,还提供了从 0.8B 到 35B-A3B 的多个尺寸,便于根据硬件条件选择本体部署。
在公开的评测中, StartLux-Decision 系列多个尺寸在 JevBench 和 Intern-Decision 上与 Jev 1.13 处于同一水平,9B 及以上版本在这两项指标上均取得更高分数:
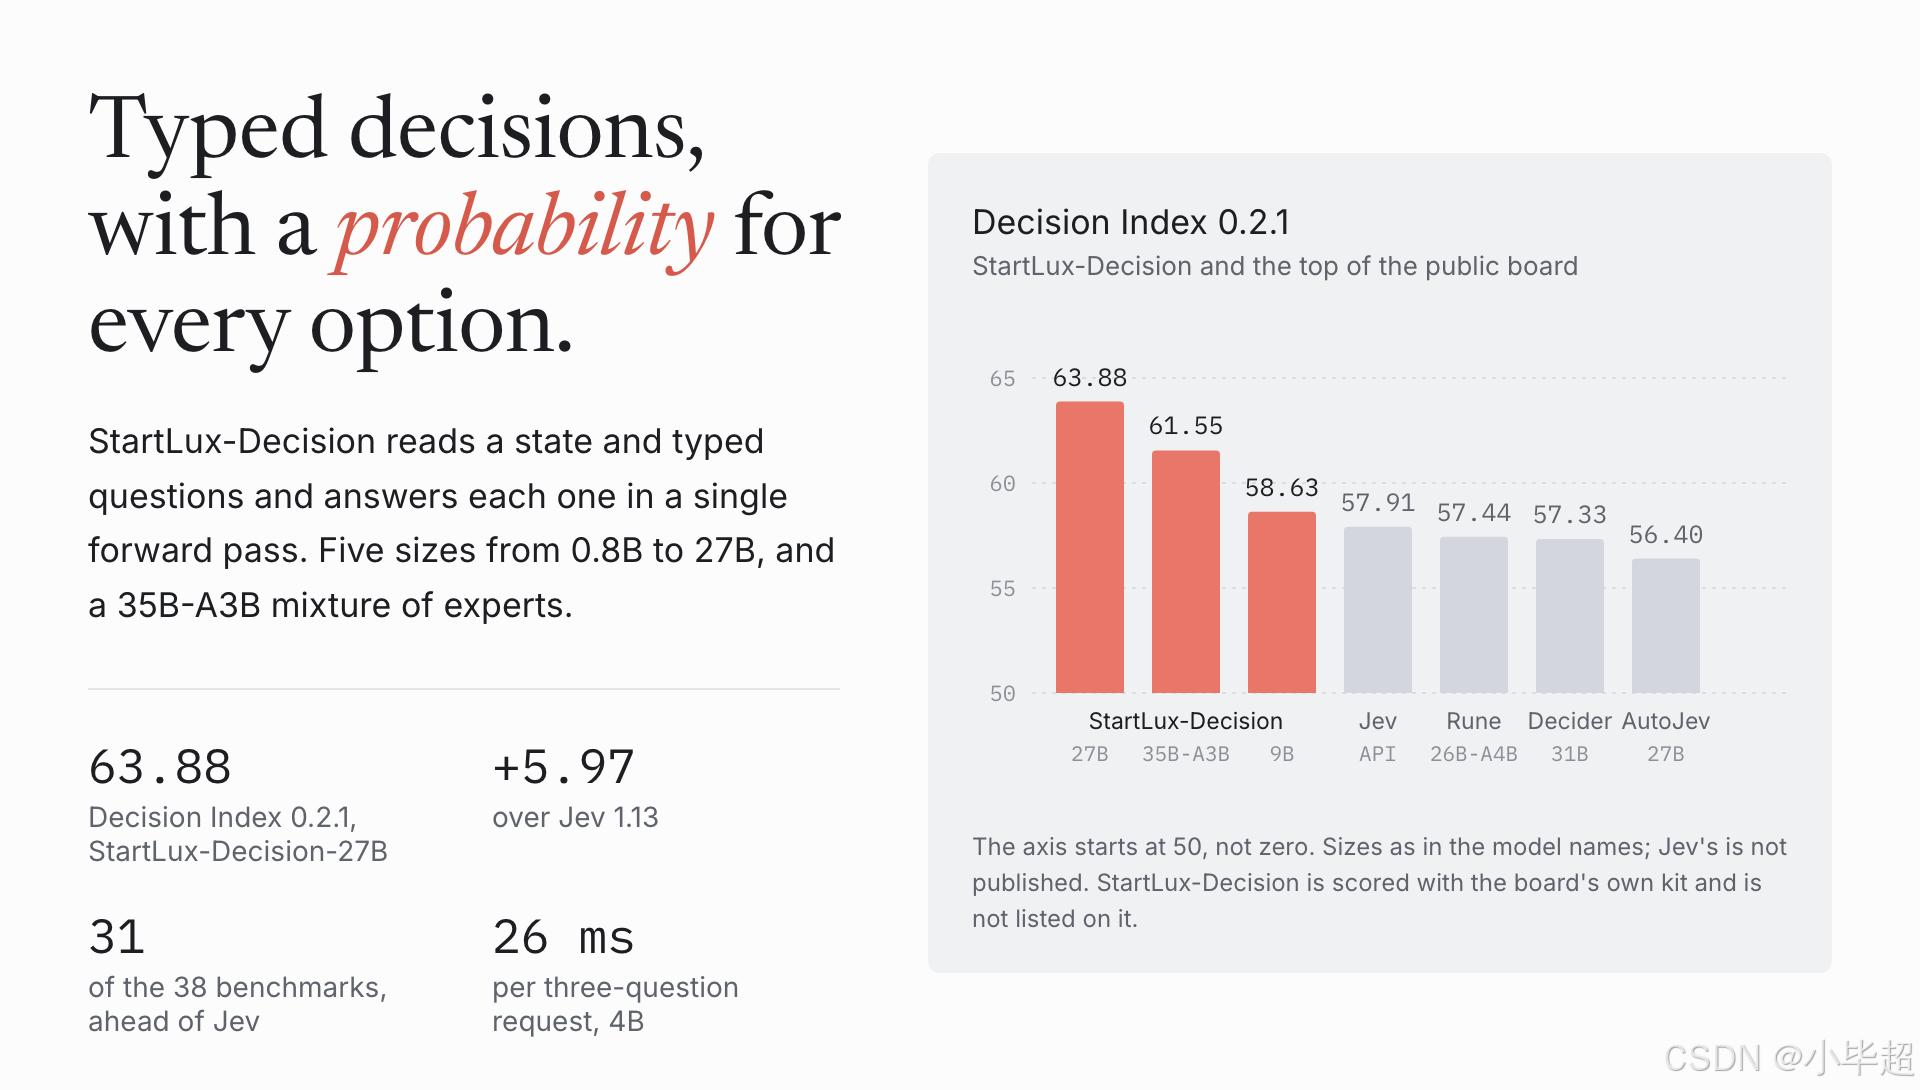
官方公布与其他决策模型对比:
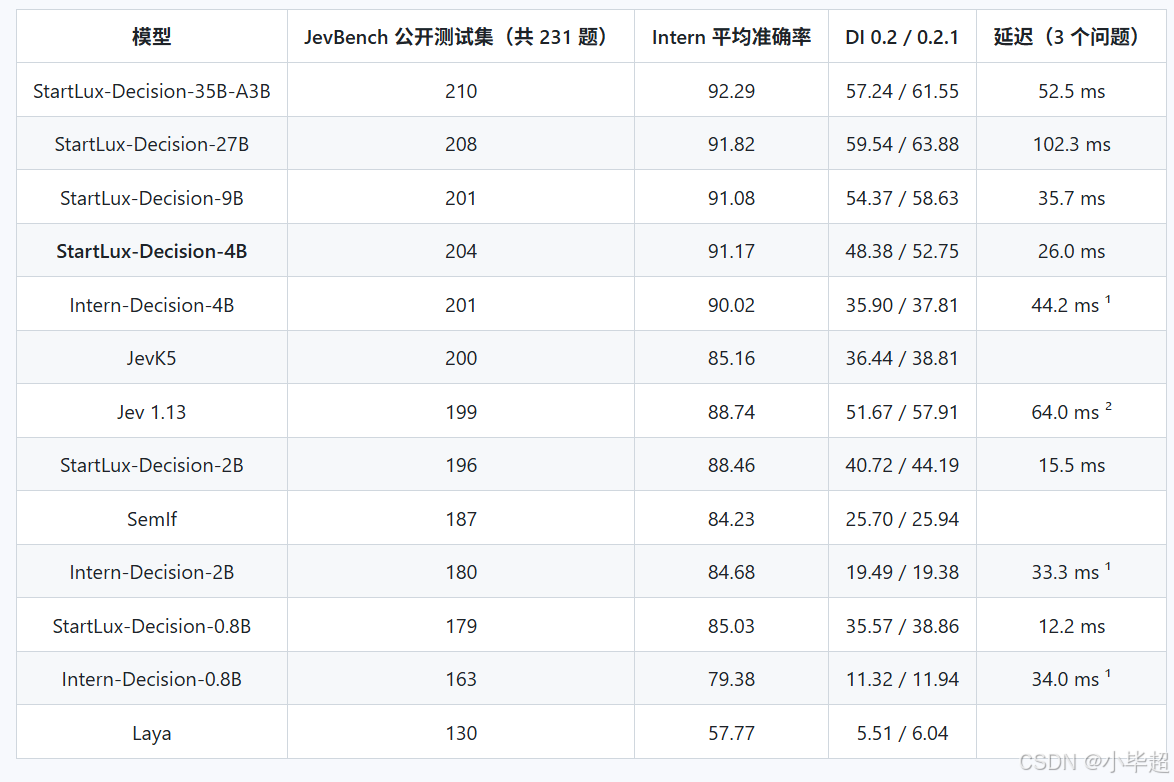
说明 :JevBench 公开测试集统计了 Intern-Decision 套件中 231 个公开题目的正确答案数量;Intern 平均准确率是其七个测试套件的平均值;DI 表示两个版本的 Decision Index,其他系统的数值来自公开排行榜。空白单元格表示该数值未公开。StartLux-Decision 的延迟数据基于单颗 H200 测得,三个问题在一次前向传播中完成解答。Intern-Decision 在 RTX 4090 上自行测量的结果。 TypeSafe API 网关报告的同一请求的服务端时间(100 次平均值),与我们的测量方式一致,已排除网络延迟;Intern-Decision 报告的端到端延迟为 109.7 ms。
从对比数据看,StartLux-Decision 系列不同尺寸各有侧重。在JevBench 和Intern-Decision 测试集上,4B及以上版本均优于 Jev 1.13 而且 4B 模型在延迟上比 Jev 1.13 下降约 59.375% 。
同时,StartLux-Decision 项目提供的 Sever 方式兼容 Jev 的 TypeSafe /v1/systemone 接口规范,支持三种问题类型:
| 类型 | 用途 | 主要返回字段 |
|---|---|---|
choice |
从候选项中选择一个 | choice、probabilities、confidence |
noul |
判断是或否 | noul,表示为真的概率 |
score |
在有序等级中评分,criteria 为等级列表 |
score、legend、probabilities、confidence |
更多介绍、开源协议和说明请参考官方Github:
Github地址:https://github.com/StartLuxLabs/StartLux-Decision
ModelScope 地址 (模型权重以 CC BY-NC 4.0 许可发布):https://www.modelscope.cn/models/StartLuxAI/StartLux-Decision-4B
本文以轻量级的 StartLux-Decision-4B 模型为例,介绍本地部署以及调用过程,4B 版本下如果没有 GPU 的话,使用 CPU 也可以做推理运算。
二、StartLux-Decision-4B 本地部署
2.1 下载项目及模型
项目目前已经托管至 Hugging Face 和 ModelScope,这里使用 ModelScope 快速下载:
shell
modelscope download --model="StartLuxAI/StartLux-Decision-4B" --local_dir StartLux-Decision-4B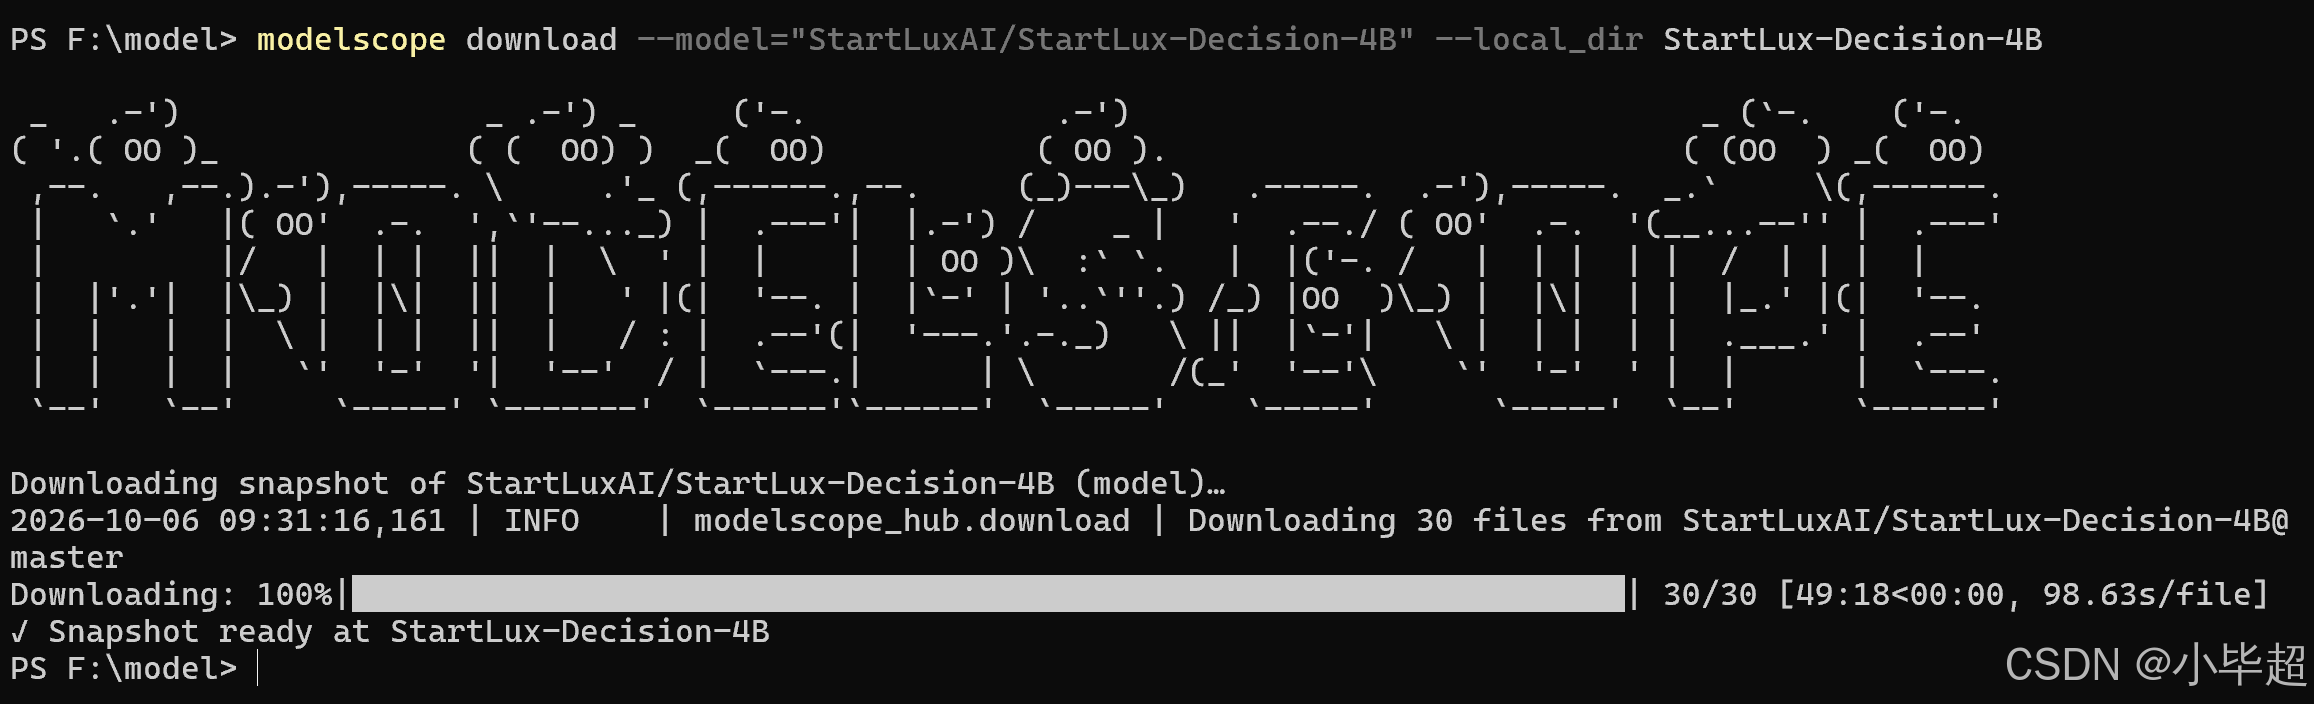
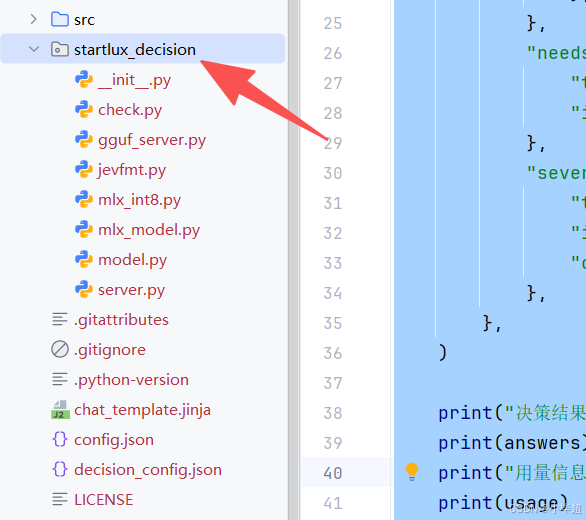
下载完毕后,进入项目,后续所有操作均在项目目录中进行,其中 startlux_decision 包下,就是封装好的API入口:
2.2 环境配置
这里推荐使用 uv 下载相关依赖:
初始化项目,并下载 venv 环境,使用 python 3.14:
bash
uv init --python=3.14
uv venv --python=3.14
安装依赖:
bash
uv pip install -r requirements.txt --index-url https://pypi.tuna.tsinghua.edu.cn/simple说明:官方的 requirements.txt 中,如果在 Windows 环境下,是不会安装flash-linear-attention 和 causal-conv1d 两个依赖的,启动时会提示降级至 PyTorch 的实现上,速度相对会慢。
如果本地环境有 CUDA,可以手动移除 requirements.txt 中的 sys_platform == "linux" 条件后再安装。
注意:在 CUDA 上运行,如果这两个加速内核没有生效,推理会抛出 RuntimeError 拒绝启动。
三、SDK 方式运行测试
StartLux-Decision 提供了 API Server 和 SDK直接调用两种方式,这里先进行SDK调用测试,第四节为 API Server 方式的启动测试过程。
SDK 的入口是 startlux_decision 包导出的 StartLuxDecision 类,主要参数如下:
| 参数 | 说明 |
|---|---|
path |
模型目录,例如 "." |
device |
"cuda" 或 "cpu",不传时自动选择(有 CUDA 则用 CUDA) |
images |
是否加载视觉塔,设为 False 可省下约 0.2 到 0.9 GB 显存 |
max_length |
本次运行的提示词长度上限,默认 262144,并不是模型能力上限 |
graphs |
是否录制 CUDA 图,GPU 上默认开启 |
max_pixels / min_pixels |
单张图片缩放后的像素上下限 |
3.1 文本决策
下面用客服工单分流作为文本决策测试。正文和各问题字段对应仓库示例;判断结果应以实际运行模型为准,不预设分类、分值或概率。
在项目根目录下创建如下内容 py 脚本:
python
import json

from startlux_decision import StartLuxDecision

def main() -> None:
    model = StartLuxDecision(
        ".",
        device="cpu",
        images=False,
        graphs=False,
        max_length=4096,
    )

    answers, usage = model.decide(
        {"text": "客户:小毕超;问题: 包裹送达时已经破损,客户希望申请退款。"},
        {
            "team": {
                "type": "choice",
                "instructions": "这个问题应该由哪个团队处理?",
                "criteria": {
                    "billing": "付款、退款和账单问题",
                    "shipping": "配送和包裹破损问题",
                    "technical": "应用、登录和账户问题",
                },
            },
            "needs_refund": {
                "type": "noul",
                "instructions": "是否应该为客户办理退款?",
            },
            "severity": {
                "type": "score",
                "instructions": "对客户造成的影响有多严重?",
                "criteria": ["轻微影响", "明显不便", "客户无法正常使用"],
            },
        },
    )

    print("决策结果:")
    print(json.dumps(answers, ensure_ascii=False, indent=4))
    print("用量信息:")
    print(json.dumps(usage, ensure_ascii=False, indent=4))

if __name__ == "__main__":
    main()
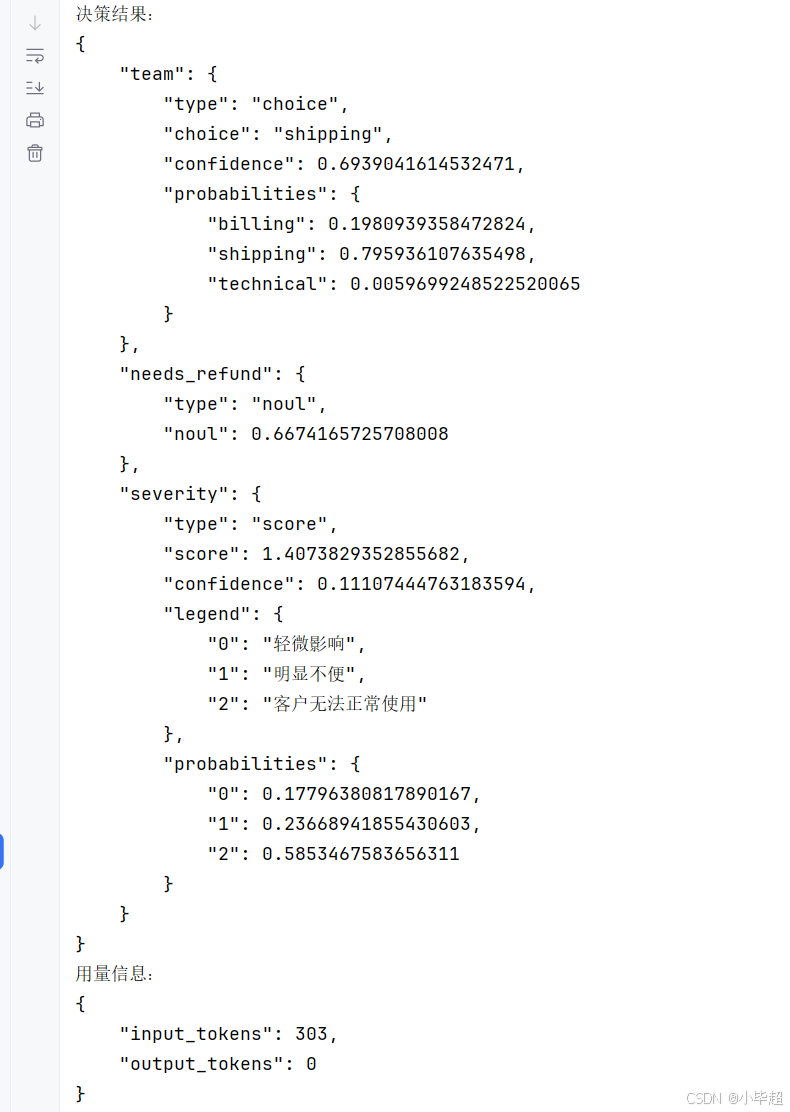
这里的 state 描述了问题现象,questions 是一个字典,键名就是返回结果里的字段名,因此命名时建议直接使用业务语义。三个问题分别覆盖了 choice、noul、score 三种类型,在同一次调用中一起返回。
运行结果如下:
如果需要在离线场景下批量处理大量请求,可以把多个 (state, questions) 组成列表交给 decide_batch,它会把所有问题合并成排序后的批量前向运算,比循环调用 decide 快:
python
many = model.decide_batch([(state_a, questions_a), (state_b, questions_b)])3.2 图片决策
SDK 的 images 参数可接收图片文件路径等格式;状态文本中的 <image> 标记图片所在位置。
具体来说,decide(state, questions, images=[...]) 中的 images 可以是 PIL 图片、文件路径、编码后的字节、base64 字符串或 data URI,按顺序对应 state 里出现的 <image> 标记;如果 state 是结构化对象或没有 <image> 标记,图片会统一放在状态前面。需要注意图片输入依赖视觉塔,而视觉塔只在 PyTorch 后端上加载,MLX 和 GGUF 后端只支持文本。
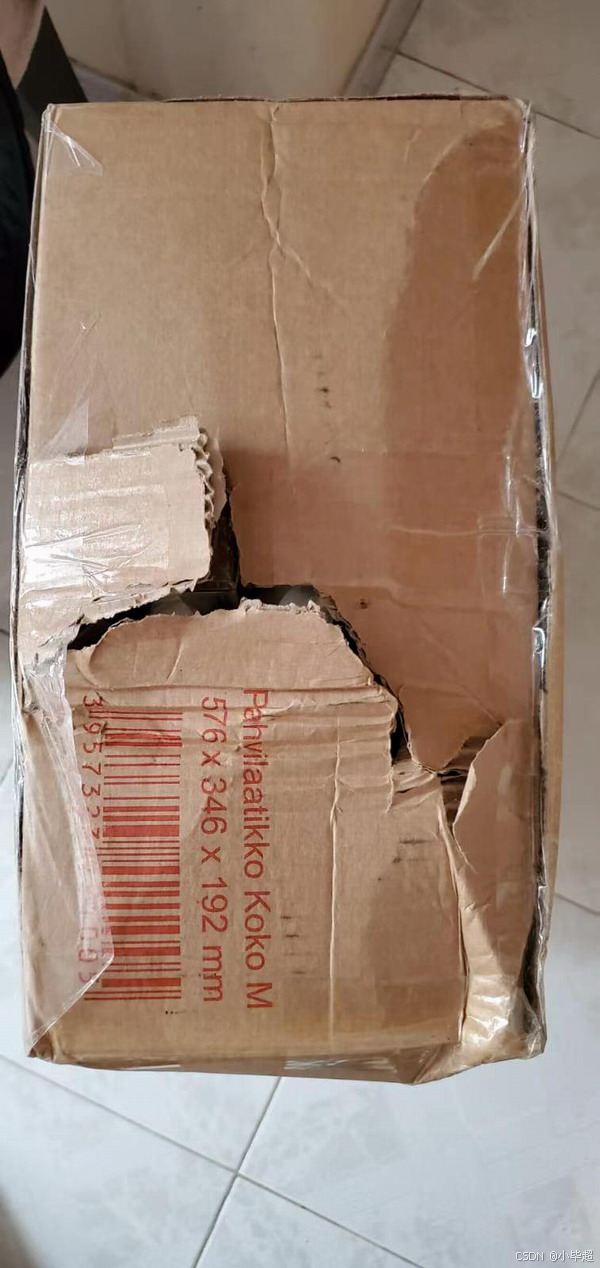
测试图片:
实现逻辑如下:
python
import json
from pathlib import Path

from startlux_decision import StartLuxDecision

IMAGE_PATH = Path(r"test.jpg")


def main() -> None:
    if not IMAGE_PATH.is_file():
        raise FileNotFoundError(f"找不到图片文件:{IMAGE_PATH}")

    model = StartLuxDecision(
        ".",
        images=True,
        graphs=False,
    )

    answers, usage = model.decide(
        "<image> 请检查包裹外观,判断是否存在明显破损。",
        {
            "damaged": {
                "type": "noul",
                "instructions": "包裹是否有明显撕裂、压瘪或内容物暴露?",
            },
            "damage_type": {
                "type": "choice",
                "instructions": "最明显的问题属于哪一类?",
                "criteria": {
                    "none": "未见明显破损",
                    "crushed": "包装被压瘪或变形",
                    "torn": "包装撕裂或开口",
                    "wet": "包装被水浸湿",
                },
            },
        },
        images=[str(IMAGE_PATH)],
    )

    print("决策结果:")
    print(json.dumps(answers, ensure_ascii=False, indent=4))
    print("用量信息:")
    print(json.dumps(usage, ensure_ascii=False, indent=4))


if __name__ == "__main__":
    main()
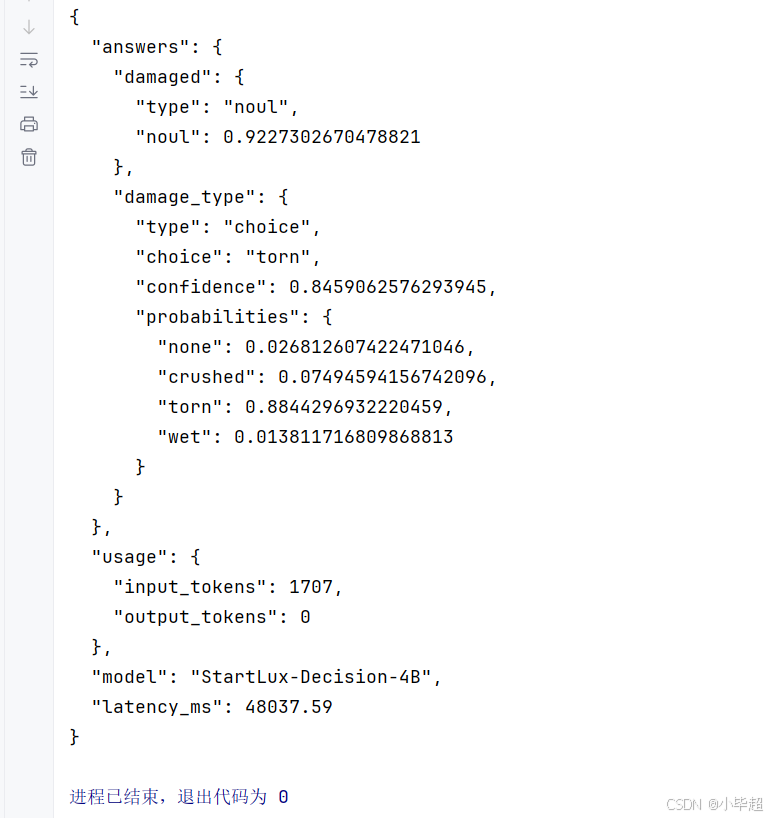
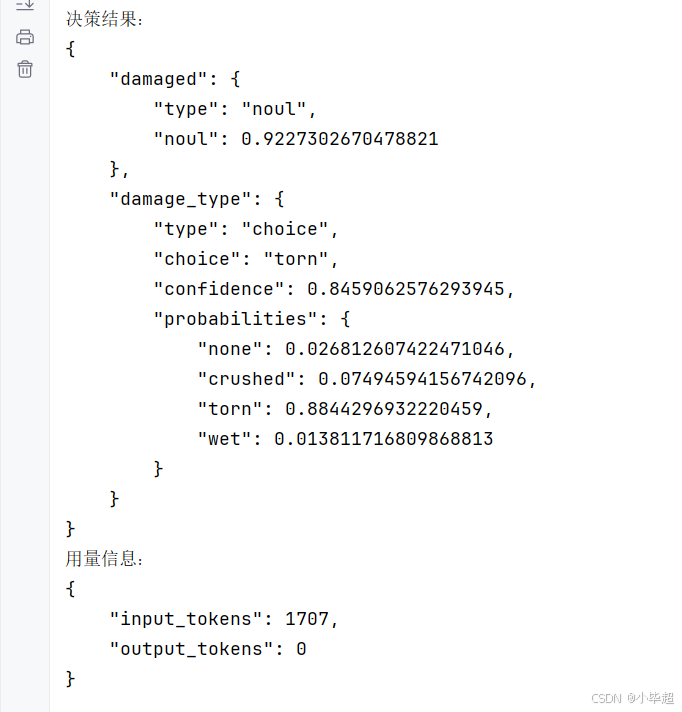
运行结果:
四、API Server 方式运行测试
4.1 启动服务
API Server 的实现已经封装好,在 startlux_decision/server.py 下,可直接启动:
shell
uv run --link-mode=copy python -m startlux_decision.server --name StartLux-Decision-4B --model . --port 8090 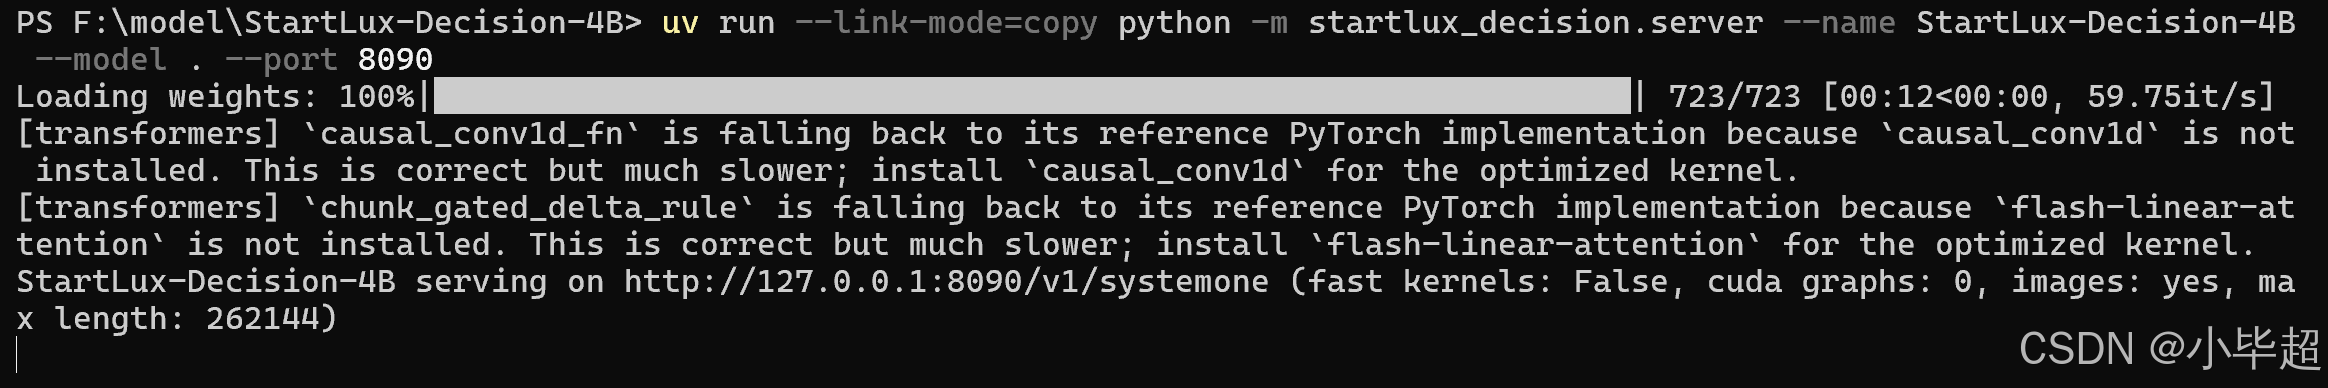
服务端常用的启动参数如下:
| 参数 | 说明 |
|---|---|
--model |
必填,本地模型目录 |
--host / --port |
监听地址与端口,默认 127.0.0.1:8090 |
--name |
响应中返回的模型名称,默认取目录名,示例里显式指定为 StartLux-Decision-4B |
--device |
cuda 或 cpu,默认有 CUDA 时用 CUDA |
--backend |
auto / torch / mlx;auto 在 Apple Silicon 上装了 mlx-lm 时自动走 MLX,其余走 torch |
--int8 |
MLX 后端下在 M5 及之后的 Mac 上启用 int8 矩阵乘 |
--max-length |
最长提示词长度,默认 262144(torch 后端) |
--max-pixels |
单张图片缩放后的像素上限,默认 1048576 |
--no-images |
不加载视觉塔(torch 后端) |
说明 :服务是单并发实现的:内部用锁把推理串行化,一次只处理一个请求。因此它适合本地验证和低并发业务,高并发场景需要自行在外层做队列或启动多个实例。
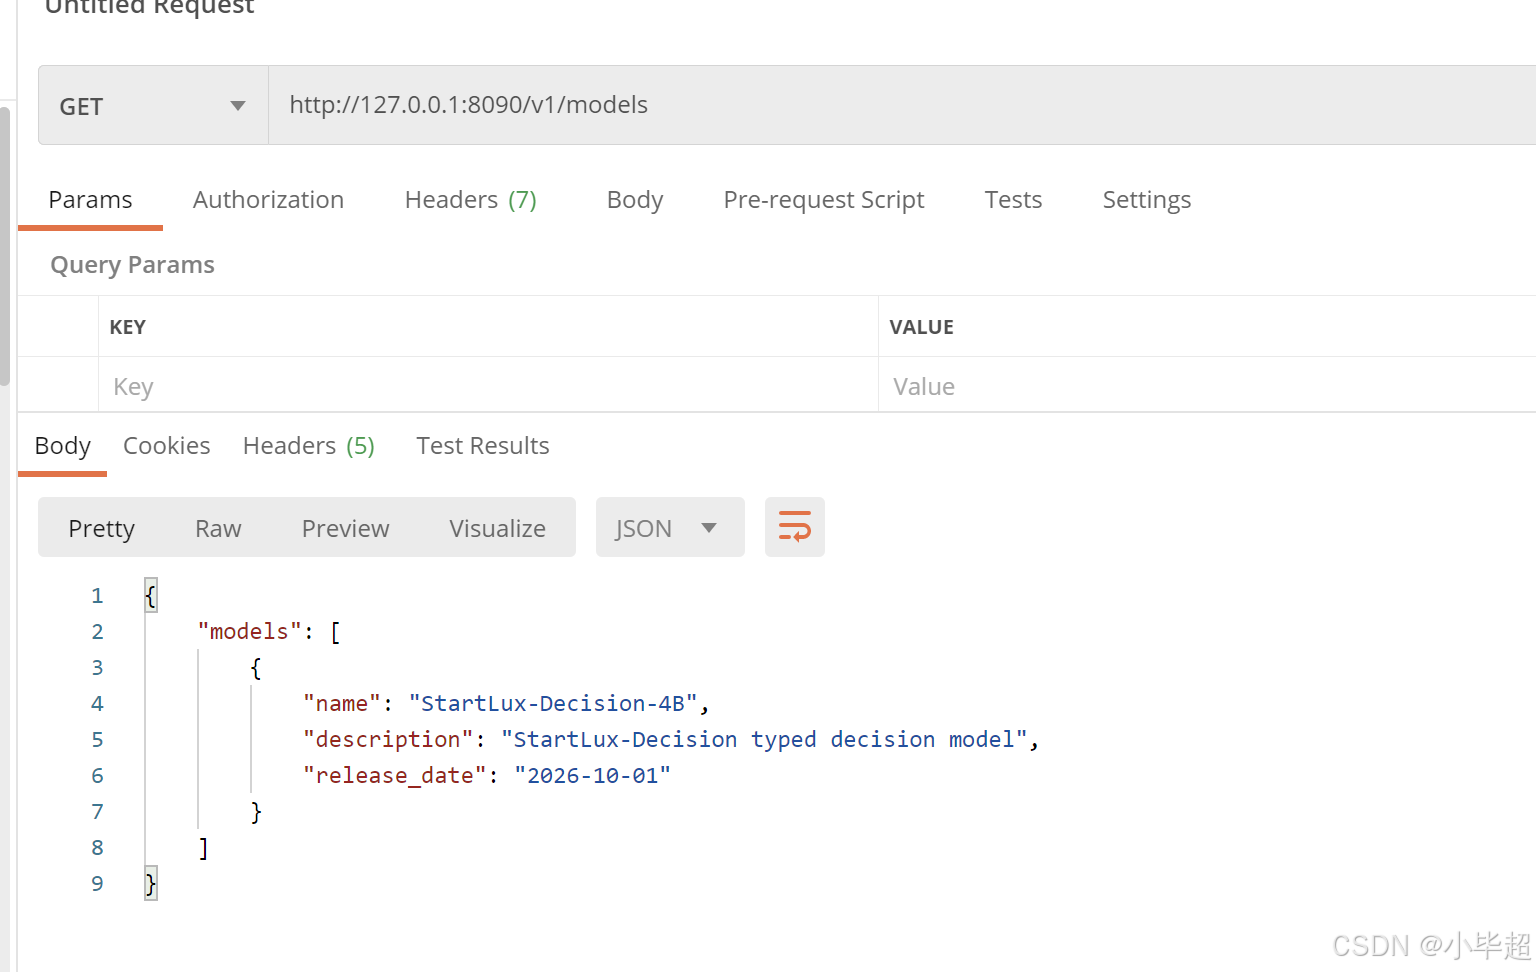
4.2 查看可用模型
使用 /v1/models 接口查看可用模型:
4.3 文本决策
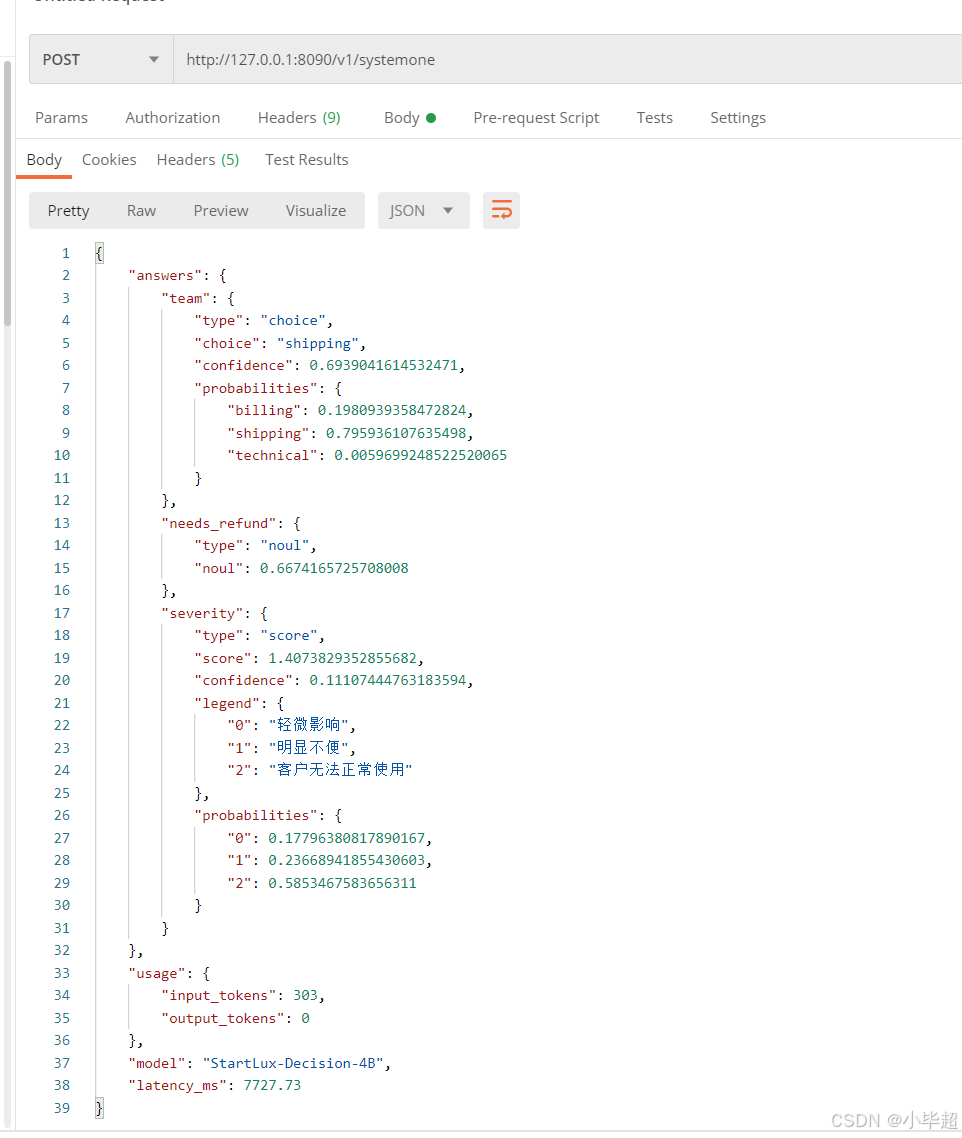
下面依然用客服工单分流作为文本决策测试。请求正文和各问题字段对应仓库示例;判断结果应以实际运行模型为准,不预设分类、分值或概率。
接口:
shell
POST http://127.0.0.1:8090/v1/systemone请求体:
json
{
  "state": {"text": "客户:小毕超;问题: 包裹送达时已经破损,客户希望申请退款。"},
  "questions": {
       "team": {
            "type": "choice",
            "instructions": "这个问题应该由哪个团队处理?",
            "criteria": {
                "billing": "付款、退款和账单问题",
                "shipping": "配送和包裹破损问题",
                "technical": "应用、登录和账户问题"
            }
        },
        "needs_refund": {
            "type": "noul",
            "instructions": "是否应该为客户办理退款?"
        },
        "severity": {
            "type": "score",
            "instructions": "对客户造成的影响有多严重?",
            "criteria": ["轻微影响", "明显不便", "客户无法正常使用"]
        }
    }
}
响应结果:
4.4 图片决策
状态文本中的 <image> 标记图片所在位置。使用 images 数组传入 base64 字符串或 data URI。以下示例以本地包裹照片判断是否存在可见破损,这里使用 py 脚本调用 Server,其中将图片以base64的方式传至 images 参数下,测试图片和前面相同:
python
import asyncio
import base64
import json
import mimetypes
from pathlib import Path

import httpx

API_URL = "http://127.0.0.1:8090/v1/systemone"
IMAGE_PATH = Path(r"test.jpg")


async def main():
    image_bytes = IMAGE_PATH.read_bytes()
    mime_type = mimetypes.guess_type(IMAGE_PATH.name)[0] or "image/jpeg"
    data_uri = (
        f"data:{mime_type};base64,"
        f"{base64.b64encode(image_bytes).decode('ascii')}"
    )

    payload = {
        "state": "<image> 请检查包裹外观,判断是否存在明显破损。",
        "images": [data_uri],
        "questions": {
            "damaged": {
                "type": "noul",
                "instructions": "包裹是否有明显撕裂、压瘪或内容物暴露?",
            },
            "damage_type": {
                "type": "choice",
                "instructions": "最明显的问题属于哪一类?",
                "criteria": {
                    "none": "未见明显破损",
                    "crushed": "包装被压瘪或变形",
                    "torn": "包装撕裂或开口",
                    "wet": "包装被水浸湿",
                },
            },
        },
    }

    async with httpx.AsyncClient(timeout=120) as client:
        response = await client.post(API_URL, json=payload)
        response.raise_for_status()
        result = response.json()

    print(json.dumps(result, ensure_ascii=False, indent=2))


if __name__ == "__main__":
    asyncio.run(main())
运行结果: