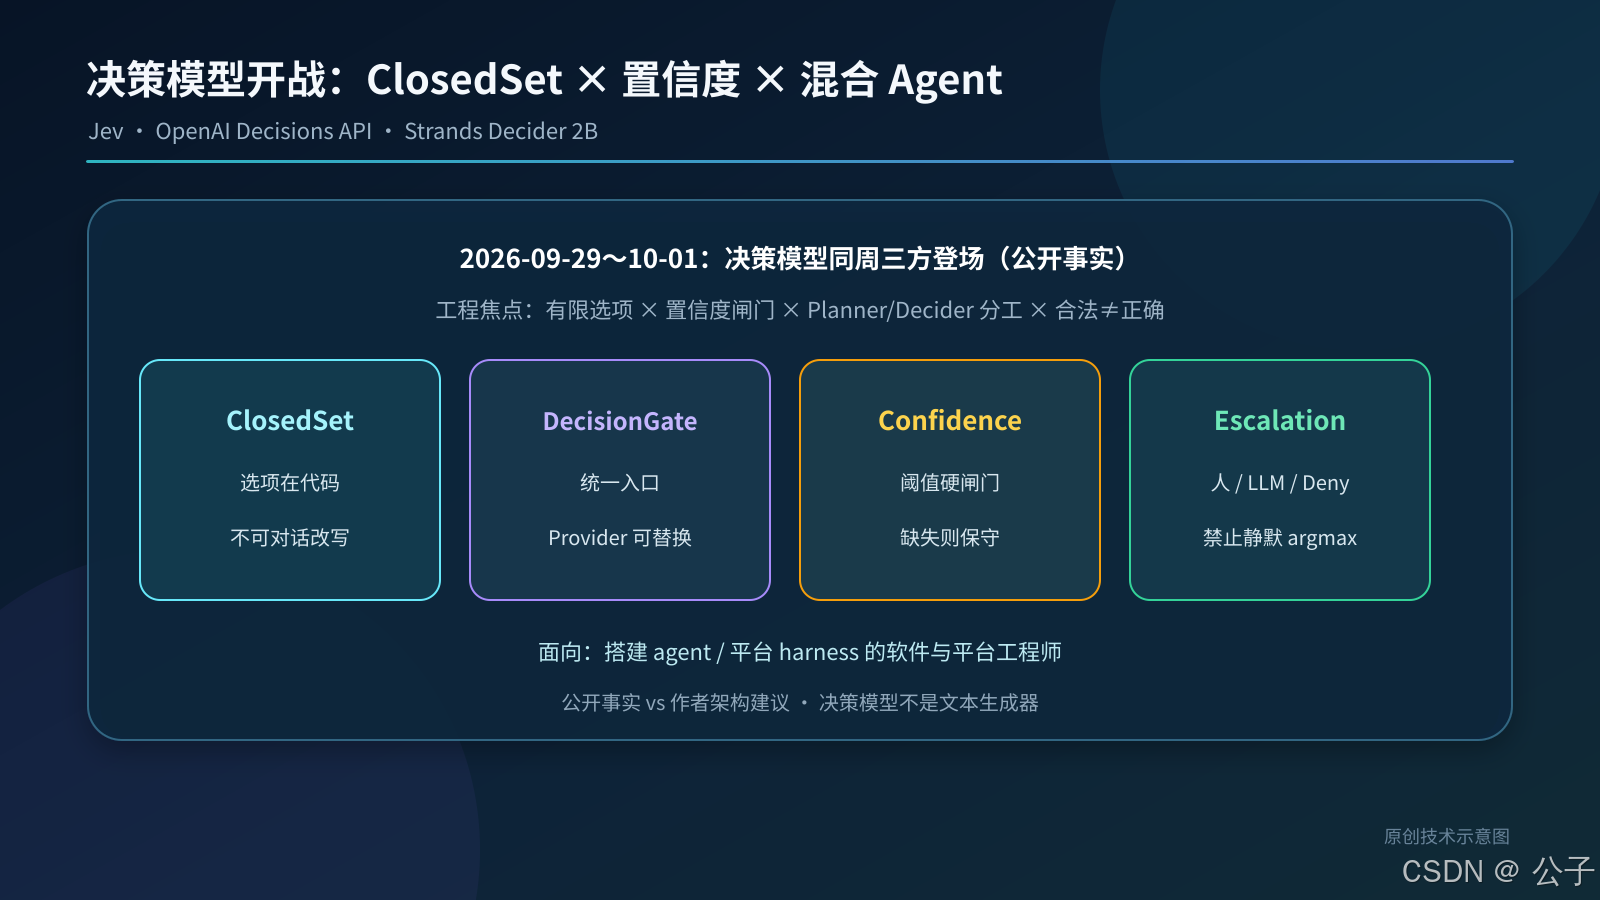
本文面向正在搭建 agent / 平台 harness 的软件与平台工程师。素材来自 2026-09-29~10-01 前后 TypeSafe Jev、OpenAI Decisions API(DevDay)、AWS Strands Decider 2B 的公开报道与官方博文。文中严格区分「公开事实」与「作者架构建议」;不编造未公布的 OpenAI 请求 JSON / 价目表,也不把决策模型写成「不会出错的文本生成器」。
1. 为什么工程师该关心:又一类模型,不是又一个聊天框
过去一周,「决策模型 / System One」从单点产品变成三方同场:
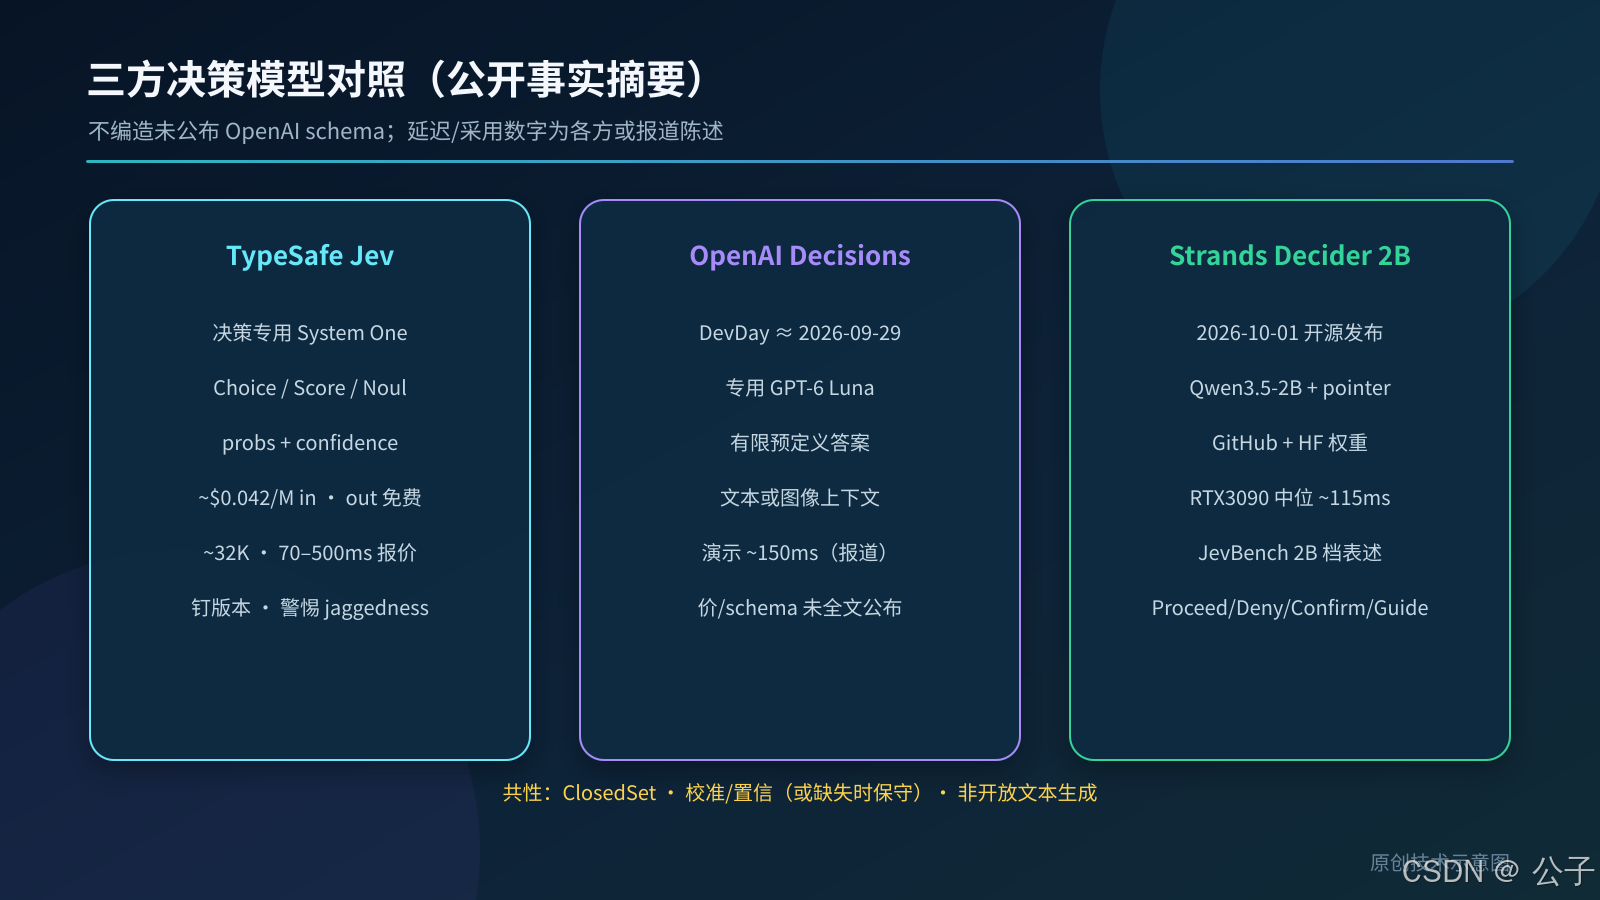
- TypeSafe Jev:只做决策、不吐开放文本,返回带概率与置信度的类型化答案;
- OpenAI Decisions API :DevDay 宣布,专用 GPT-6 Luna 引擎,在有限预定义选项里做选择(分类 / 路由 / agent 下一步);
- AWS Strands Decider 2B:开源 + Hugging Face 权重,Qwen3.5-2B 躯干 + pointer head,本地毫秒级,面向 Strands harness 介入点。
对自建 agent 栈,冲击不是「又多了三个模型名」,而是:
- ClosedOptionSet 变成一等公民:调用方先声明有限选项,模型在集合内选;
- 置信度 / 校准 开始进入产品闸门:低于阈值就升级,而不是「模型说了就算」;
- Planner(LLM)vs Decider 分离:长程规划留给文本模型,高频分支留给决策模型;
- wrong-but-valid 仍然存在:类型合法 ≠ 语义正确------闸门必须承认这一点。
公开材料描述的是各家产品能力与早期采用轶事,不是 强制行业标准。可立刻写进 harness 的是作者建议的四件套:DecisionGate + ClosedOptionSet + ConfidenceThreshold + EscalationPolicy。
2. 公开事实一览(仅复述可核对信息)
以下表格只收录截至 2026-10-02(CST) 可从 InfoQ、TechCrunch、Strands 官方博文与 CryptoBriefing 等交叉核对的信息。不补全未公布细节:
| 项 | 公开信息 | 明确「未公布 / 勿发明」 |
|---|---|---|
| TypeSafe Jev 定位 | 决策专用「System One」;不生成开放文本;返回 Choice / Score / Noul,带概率分布与置信度;单次并行评估多题 | 完整训练数据与内部评测方法未要求正文复现 |
| Jev 成本 / 窗口 / 延迟 | 输入约 $0.042 / M tokens ,输出免费 ;上下文约 32K ;厂商报价端到端延迟 70--500ms | 各区域实际 SLA、批量计费细则以官方为准 |
| Jev 训练与采用 | Reinforcement Learning for Calibrated Decisions ;Vercel AI Gateway 次日接入,InfoQ/Vercel 报道称约 24h 内达近 13% 付费团队(引用报道,非作者复测);LangChain 等有集成叙事 | 勿把「13%」写成全网市占;勿发明未报道的百分比 |
| Jev 能力边界 | 官方 jaggedness 页提示计数/算术/日期比较不可靠;大噪声 state 精度下降;建议数学放代码里;钉死版本 (如 jev-1.13.x),勿用 jev-latest |
完整 jaggedness 清单以厂商页为准 |
| OpenAI Decisions API | DevDay ≈ 2026-09-29 宣布;专用 GPT-6 Luna ;有限预定义答案;用例含分类、路由、agent next action;支持文本或图像上下文(报道所述);limited preview ;演示延迟约 150ms vs 标准 Luna ~1.6s(约 10×,演示数字) | 公开定价、完整 request/response schema、置信度字段、准确率基准尚未全文公布------正文不发明 JSON |
| Strands Decider 2B | 2026-10-01 strandsagents.com 宣布;开源 GitHub + HF 权重;Qwen3.5-2B 躯干,去掉 LM head,换 pointer head ;本地 RTX 3090 中位延迟约 115ms (博客);JevBench 2B 档有竞争力表述;示例 InterventionHandler.before_tool_call → Proceed / Deny / Confirm / Guide |
完整训练脚本细节以仓库为准;勿把示例阈值写成官方强制 |
| 用例共性(报道/博客) | 路由、工具选择、护栏、混合 agent(LLM 难决策 + Decider 高频分支) | 不声称覆盖编码/长文摘要等开放生成任务 |
纪律: 二手文若给出「OpenAI Decisions 正式价 / 未公开字段名」却无官方同口径出处,一律不进正文。Vercel 采用比例一律标注「Vercel/InfoQ 报道」。
3. 把发布特性映射到 harness 失效模式
产品语言偏「更快、更便宜、更结构化」;落到工程上,作者建议映射为四类可观测失效。
3.1 Open-Set Leak(开放集合泄漏)
公开镜像: 决策模型要求有限选项;Jev/Strands 在集合内打分;OpenAI Decisions 也强调预定义答案。
Harness 侧症状:
- Prompt 里写「选一个工具」,但运行时工具表可被模型侧改写;
- 选项集合与权限矩阵不同步,已下线工具仍在 ClosedSet;
- 把「结构化 JSON 输出的 LLM」误当成决策模型------仍可能吐出集合外键。
作者建议的验收问题: 进入执行器前,选项是否来自代码侧注册表(不可被对话改写)?集合外答案是否在物理上不可达?
3.2 Confidence Bypass(置信度旁路)
公开镜像: Jev 返回置信度并强调阈值上下的行动/升级;Strands 强调校准;OpenAI Decisions 的置信度字段尚未公开------不能假设已有。
Harness 侧症状:
- 永远
argmax,从不读 confidence; - 阈值写在运维 Wiki,不在执行器;
- 用「延迟低」代替「可信」。
作者建议的验收问题: 低于 min_confidence 时,是否强制走 EscalationPolicy(人审 / 更大模型 / Deny),而不是静默放行?
3.3 Wrong-but-Valid(合法但错误)
公开镜像: Hacker News 等讨论指出------决策模型不能吐非法类型,但可以吐完全错误的合法值;CryptoBriefing 亦强调 constrained ≠ correct。
Harness 侧症状:
- 营销话术「不会幻觉」被写进验收;
- 无金标回归集,只测 schema 合法;
- 把 ClosedSet 当成正确性证明。
作者建议的验收问题: 是否有「错误但合法」的合成用例(错路由、错工具、错升级)必须被下游闸门拦住?
3.4 Planner/Decider Confusion(规划器与决策器混用)
公开镜像: Strands 博客明确------决策模型不适合编码/聊天/长文;适合路由、工具选择、护栏、混合 agent。
Harness 侧症状:
- 用 Decider 做开放式规划;
- 用大模型做每次
before_tool_call的是/否; - 一套 Prompt 既当 Planner 又当 Decider,无角色边界。
作者建议的验收问题: 高频分支是否走 Decider;开放推理是否走 LLM;二者交接是否有显式契约?
4. 作者架构建议:DecisionGate + ClosedOptionSet + ConfidenceThreshold + EscalationPolicy
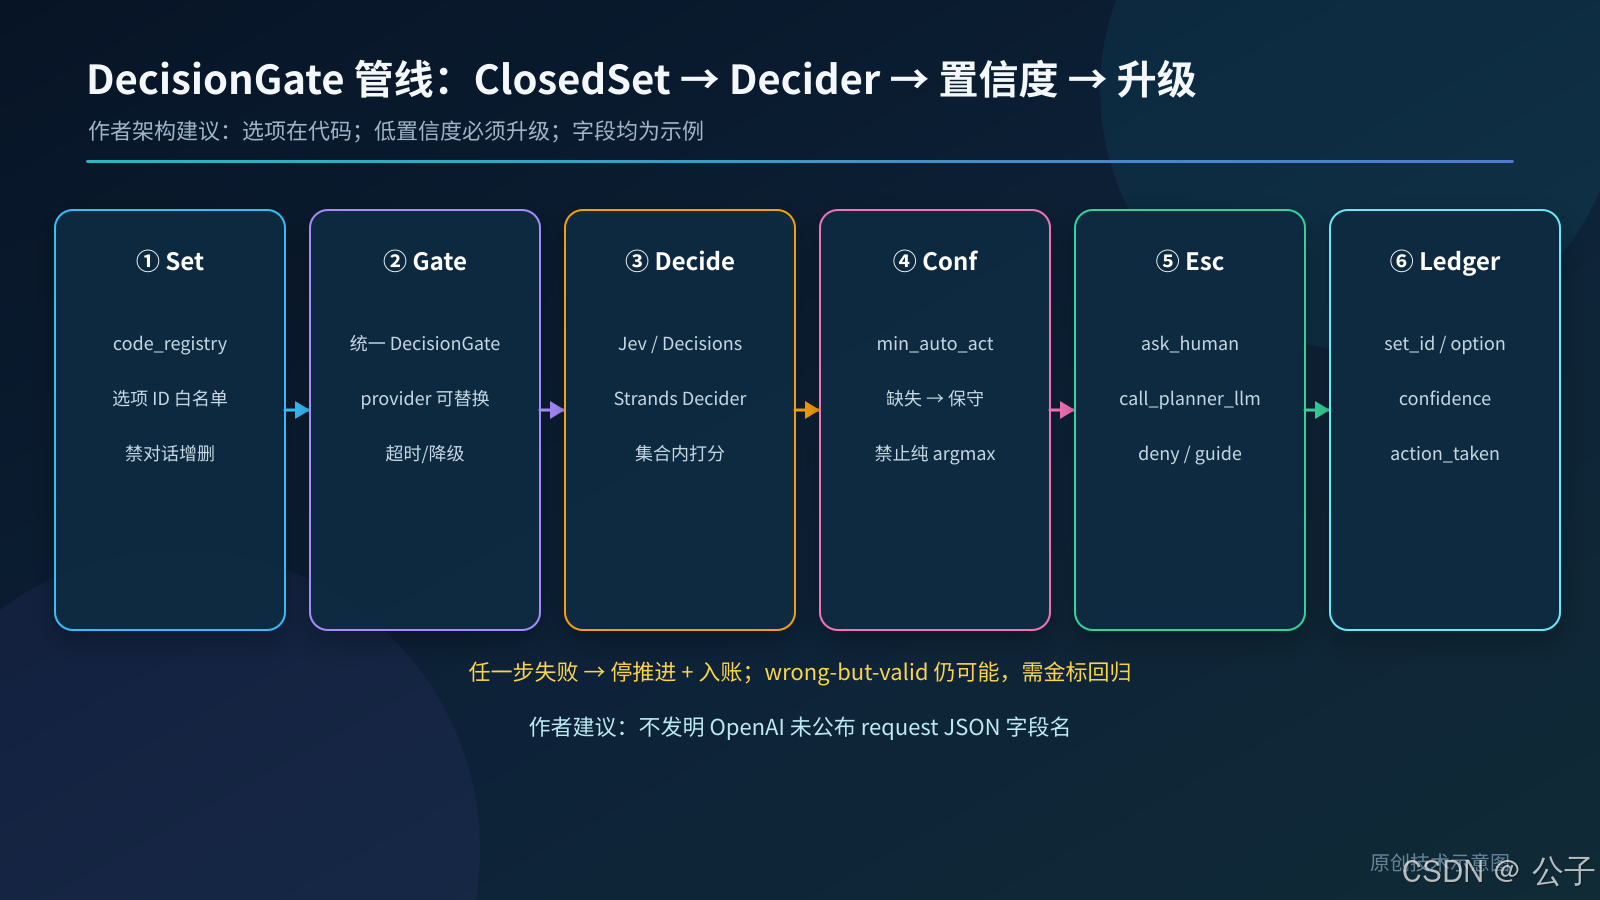
以下整节为作者架构建议 ,不是 TypeSafe / OpenAI / AWS 官方处方。字段均标为示例 。对 OpenAI Decisions:不填写未公开的请求体字段名。
4.1 ClosedOptionSet:选项在代码里,不在 Prompt 散文里
text
# 示例 schema(作者示意,非官方 API)
closed_option_set:
  set_id: "tool_select_v3"              # 示例
  options:
    - id: search_docs
    - id: create_ticket
    - id: escalate_human
    - id: no_op
  source: code_registry                 # 示例:禁止对话改写
  allow_model_to_add_options: false
规则:
- 选项 ID 与权限 / 计费 / 审计字典同一来源;
- 集合变更走配置发布,不走「模型建议加一个工具」;
- 对 LLM 结构化输出路径,仍应用同一 ClosedSet 校验------类型合法不等于集合合法。
4.2 DecisionGate:统一入口,屏蔽三家方言
text
# 示例:每次决策前
decision_gate:
  provider: typesafe_jev | openai_decisions | strands_decider | mock
  set_id: "tool_select_v3"
  state_ref: "opaque_state_handle"      # 示例:文本或结构化状态引用
  question_id: "next_tool"              # 示例
  # OpenAI:仅声明「有限预定义答案 + 文本/图像上下文」能力面
# 不在此发明 request JSON 字段名- Gate 在执行器内实现;模型拿不到「绕过 ClosedSet」的开关;
- Provider 可替换,业务策略不绑死一家 SDK;
- Preview / 本地 / 云端延迟差异巨大------Gate 必须带超时与降级,而不是假设「都是 100ms」。
4.3 ConfidenceThreshold:阈值是闸门,不是日志装饰
text
# 示例
confidence_policy:
  min_auto_act: 0.85                    # 示例阈值,非厂商硬限
  min_escalate: 0.55                    # 示例:介于中间则升级
  below_min_escalate: deny              # 示例:过低直接拒绝
  on_missing_confidence: escalate       # 示例:OpenAI 字段未公开时的默认
要点:
- 有置信度就用(Jev / Strands 公开强调校准);
- 无置信度就升级/保守 (OpenAI Decisions 公开材料尚未给出置信度字段------作者建议默认
on_missing_confidence=escalate或等价保守策略,而不是假装有分); - 阈值进配置中心与审计,不进某次 Prompt;
- 演示延迟数字(如 ~150ms)不替代置信度策略。
4.4 EscalationPolicy:人、更大模型、或硬拒绝
text
# 示例事件
escalation_event:
  decision_id: "dec_20261002_001"
  reason: low_confidence | provider_timeout | set_mismatch | jagged_task
  action: ask_human | call_planner_llm | deny | guide_retry
  evidence_ref: "scores_and_option_ids_only"   # 示例:保留可审计摘要
落地纪律:
- 低置信度 / 超时 / 集合不匹配 → 结构化事件;
call_planner_llm只处理「需要开放推理」的分支,不要把所有失败都扔回同一 Decider 死循环;- Strands 示例中的
Proceed / Deny / Confirm / Guide是很好的动作枚举灵感(作者借用形状,不声称照搬官方强制 API); - Jev jaggedness(计数/数学/日期)→ 这类题不要进 Decider,留在代码或 Planner。
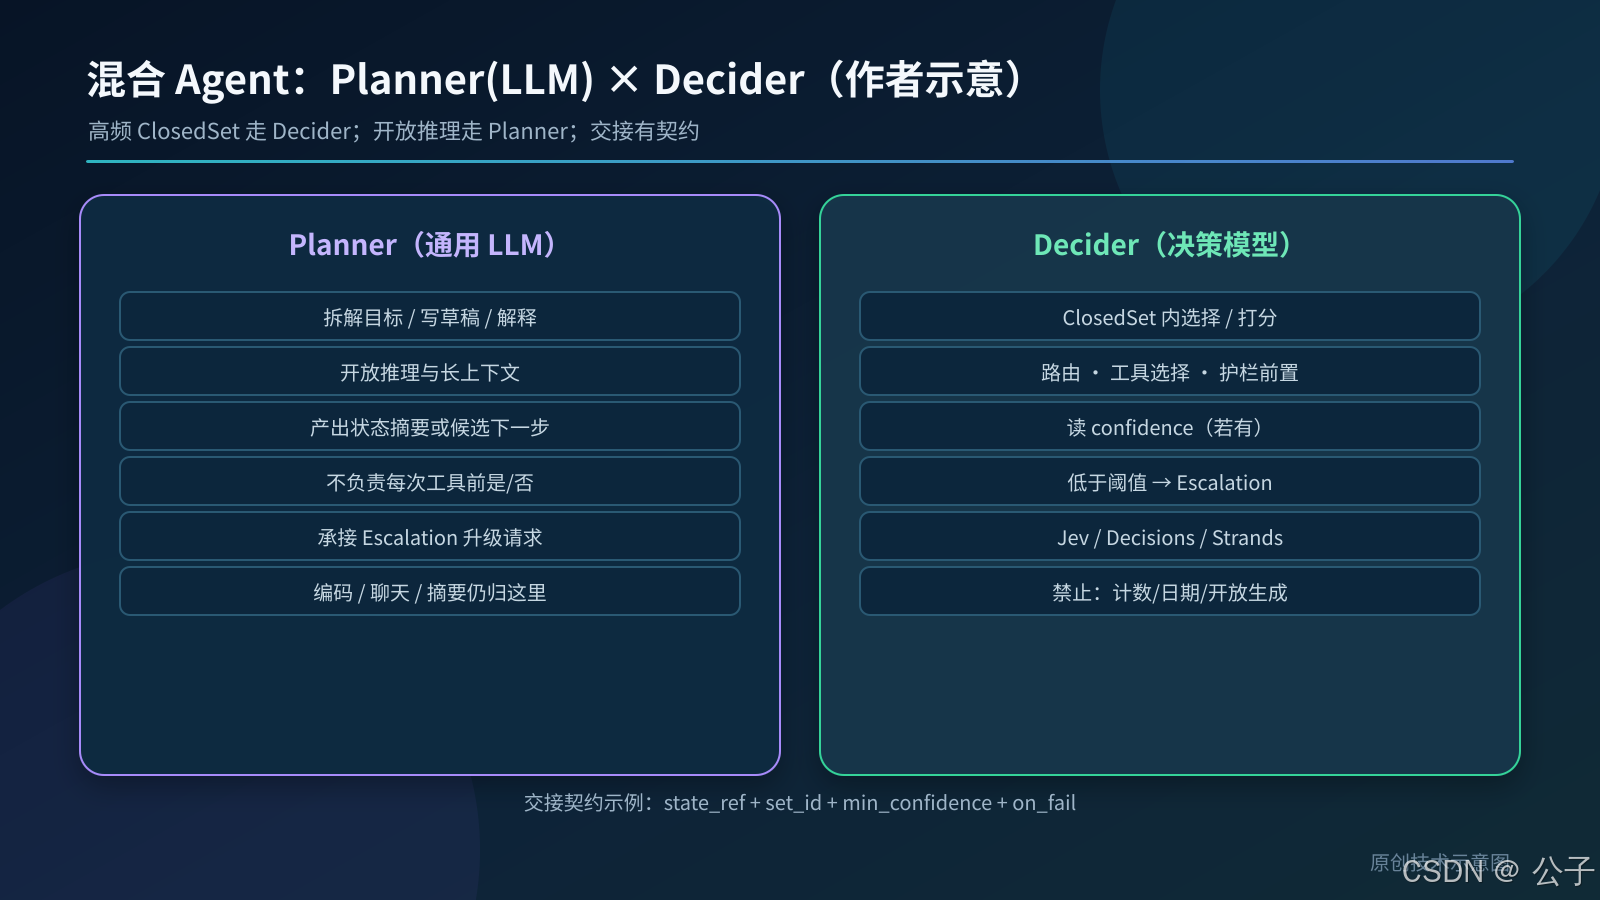
4.5 混合 Agent:谁规划、谁拍板
| 角色 | 典型模型 | 负责 | 不负责 |
|---|---|---|---|
| Planner | 通用 LLM(按你们现网选型) | 拆解目标、写草稿、解释、开放推理 | 每次工具前的是/否高频闸门 |
| Decider | Jev / Decisions API / Strands Decider | ClosedSet 选择、打分、护栏前置 | 写代码、长聊天、开放摘要 |
| Gate | 你们的 harness | ClosedSet、阈值、升级、审计 | 「相信模型自觉」 |
作者建议的最小闭环:
- Planner 产出「候选下一步」或状态摘要;
- Decider 在 代码注册的 ClosedSet 上选择;
confidence >= min_auto_act→ 执行;否则 Escalation;- 账本同时记
provider、set_id、option_id、confidence(若有)、action_taken。
5. 两周内可落地的验收清单(作者建议)
- ClosedSet 注册表:至少一条业务决策(如工具选择 / 工单路由)选项只来自代码;对话无法增删。
- DecisionGate 单测 :注入集合外答案必须硬失败;钉死模型版本(禁
*-latest作为生产默认)。 - 置信度闸门 :构造低置信度响应,断言走升级而非静默
argmax;对「无置信度字段」的 provider 走保守策略。 - wrong-but-valid:金标集包含「合法但错误」样本,下游必须拦或升级。
- 混合路径:统计一周内「Decider 自动放行 / 升级 LLM / 人审 / Deny」比例;没有升级通道的「纯 argmax」不允许上生产。
- Jaggedness 黑名单:计数、日期比较、金额算术等任务默认不进 Decider。
- 延迟与降级:超时 → 预定降级(缓存策略 / Deny / Planner),禁止无限重试烧钱。
- 无营销 CTA:价档与采用比例仅作公开可用性事实;UI/文档不出现试用导流话术。
6. 结语
Jev、Decisions API、Strands Decider 2B 在同一周把「决策」从 Prompt 散文里拽了出来:有限选项、概率/置信度、毫秒级分支、开源与托管并行。对 agent / 平台建设者,现阶段最有用的回应不是押注哪一家永久获胜,而是把浪潮翻译成代码:ClosedOptionSet、DecisionGate、ConfidenceThreshold、EscalationPolicy,以及 Planner 与 Decider 的硬分工。公开事实止于各源已写明的内容;上文闸门与 schema 均为作者架构建议。待 OpenAI 公布完整 schema/定价、各家校准评测更清晰时,再替换示例字段------但「选项在代码里、低置信度必须升级、合法不等于正确、决策模型不是文本生成器」这四条,现在就可以写死。