DPDK是什么?
有什么用?
什么场景用?
怎么用?
dpdk的作用是从网卡中截获数据。可以绕过内核,获取最原始的网络数据。
DPDK 通过一套核心库来支撑高性能应用开发:
- 环境抽象层(EAL):屏蔽底层硬件和操作系统差异,提供统一的接口。
- 内存池与缓冲区管理:预分配内存池,减少运行时动态分配的开销。
- 无锁环形队列(Ring):提供高效的多核间无锁通信机制。
- 轮询模式驱动(PMD):直接接管网卡,持续轮询数据包。
网络数据的链路
网卡--->网卡驱动--->tcp/ip协议栈---->通过recv,send拷贝到用户空间
网卡的作用是将物理信号(光信号、电信号)转换为数字信号。网卡不属于物理层也不属于数据链路层。只是一个ad、da转换的设备。
网卡中有数据到来会触发中断,每一个中断都是相互独立的。多队列网卡,每个队列一个中断。
dpdk可以绑定网卡,在做业务时可以为每一个网卡队列分配一下线程。
hugepage巨页
操作系统默认的系统页为4kb。
hugepage可以是2M或者1G。
巨页和系统页都是内存管理的单位,不是存放特定数据的容器。CPU 运行时需要不断访问内存,每次访问都要将虚拟地址翻译成物理地址,翻译结果缓存在 TLB 里。TLB 容量有限,如果页太小(4KB),很容易 Miss,CPU 就得去查页表,很影响性能。所以设置更大的页(2MB/1GB),让一条 TLB 记录覆盖更多内存,减少 TLB Miss,从而提升性能。
网卡--->网卡驱动--->tcp/ip协议栈---->通过recv,send拷贝到用户空间
这个过程涉及多次系统调用、上下文切换、数据拷贝,开销巨大。
网卡的da、ad转换是非常快的,真正限制网络吞吐量的是网络协议栈。
dpdk可以实现零拷贝,消除上下文切换,减少页切换与开销。
dpdk能够提升qps吗?
提升很有限。qps是每秒的请求数。pps每秒钟处理数据包的个数。吞吐量每搬运的字节数。
虽然dpdk不提供协议栈但是数据到用户空间还是需要对协议进行解析的。dpdk主要处理的是把数据包收发的路径,而不是处理的过程,中间的协议解析和机制都是存在的。
dpdk能够降低网络延迟吗?
提升很有限。延迟分为网络硬件延迟+报文处理延时。
dpdk能够提升吞吐量吗?
能。
使用场景1
大量数据的备份。
从一台电脑备份到另一台电脑。底层用dpdk,业务层可以使用rdma。
主要提升的是吞吐量,每秒钟处理的数据量。
第二个场景
防火墙,网卡、路由器等的防火墙。
dpdk可以更自由的编程,实现各种防火墙的规则。主要用于高性能路由、防火墙等。
第三个场景
实时视频处理,通过dpdk的高吞吐量对实时视频进行处理。
如果不使用内核中的协议栈,也可以使用开源的协议栈,
utycp、4.4BSD、mtcp、lwip
对于数据是需要大小端转化的。只要大于两个字节的数据都需要。
0x123456
大端:高字节在低地址。内存中12 34 56
小端:高字节在高地址。内存中56 34 12
dpdk中的mbuf和kernel里面的skbuffe功能是一样的。
mbuf和skbuffe都是用来描述数据包的结构体。里面记录的是数据的地址、长度、协议类型以及各种标志位等。
UDP中的源地址和目的地址进行互换,crc的值会不会改变?
会改变。
以太网校验和,CRC-32 多项式除法,网卡硬件自动追加。
IPv4 头校验和,16 位反码求和。
UDP/TCP 校验和,16 位反码求和。
16 位反码求和:
1. 把数据按 16 位(2 字节)分组
2. 若总字节数为奇数,末尾补 1 个 0 字节
3. 把所有 16 位字相加(用反码加法)
4. 若结果超过 16 位,把高 16 位加回低 16 位(回卷)
5. 重复步骤 4 直到结果在 16 位内
6. 对结果取反(按位取反)
7. 得到校验和
IP协议中源IP地址、目的IP地址都是32bit,相互交换后,分组之后相加数值不变,所以不会改变。UDP协议中源端口和目的端口都是16bit,分组之后相加数值不变,所以不会改变。
CRC-32 多项式除法,其中一个步骤是把二进制串的每一位看作多项式的系数,那么顺序不一样,计算出来的多项式就不一样,所以会改变。
二进制:1 0 1 1
对应:1·x³ + 0·x² + 1·x¹ + 1·x⁰ = x³ + x + 1
为什么tcp协议栈中没有长度的字段?
- ip协议报里面有数据长度信息,根据ip协议包里面的长度信息减去tcp协议包的帧头数据,可以反推数据长度。
- ack = 对方seq + 数据长度。所以可以直接用减法得出数据长度。
eal 是:Environment Abstraction Layer 环境抽象层,是 DPDK 框架的核心基础组件。
pkt: packet数据包
ETHER:Ethernet以太网
RTE: Run-Time Environment运行时环境
desc:Descriptor描述符
hdr:header头部
dgram:datagram数据报
ustack:user stack 用户态协议栈
一个客户端对应一个skbuffer,如果有大量的客户端,就会有大网卡--->网卡驱动--->tcp/ip协议栈---->通过recv,send拷贝到用户空间量的skbuffer,那么通过什么方式来组织这些skbuffer?
通过哈希表进行查找,根据五元组找到对应的socket。管理使用红黑树。
网络输出传输的封装过程
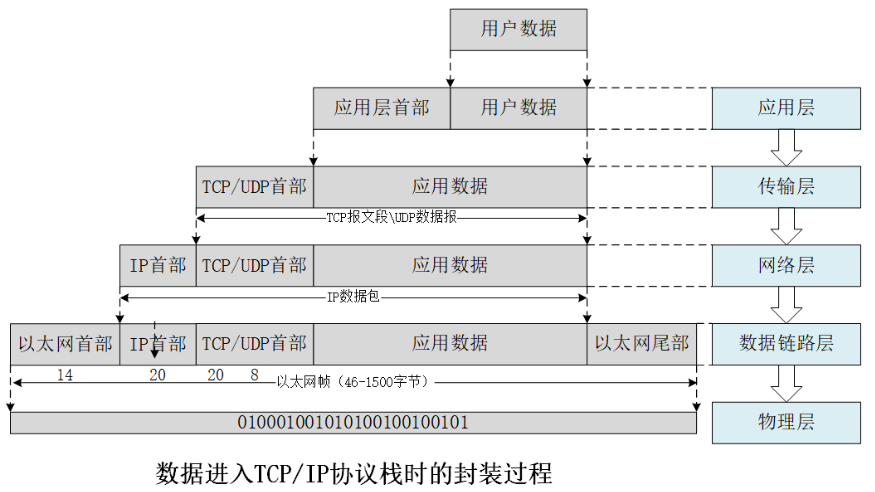
以太网协议
数据链路层
mac:网卡的物理地址,网卡的唯一硬件标识
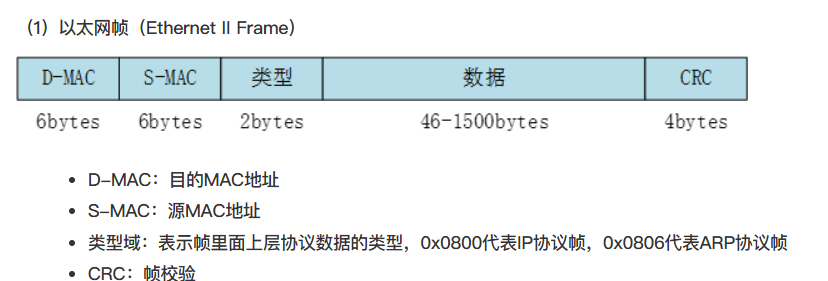
// 1 ether header 14B
 // 6B D-MAC | 6B S-MAC | 2B type | 46-1500B data | 4B CRC
struct rte_ether_hdr *eth = (struct rte_ether_hdr *)msg;
rte_memcpy(eth->d_addr.addr_bytes, global_dmac, RTE_ETHER_ADDR_LEN); // 目的 MAC
rte_memcpy(eth->s_addr.addr_bytes, global_smac, RTE_ETHER_ADDR_LEN); // 源 MAC
eth->ether_type = htons(RTE_ETHER_TYPE_IPV4); // 协议
// 以太网头部的crc由网卡硬件自动追加
IP协议
网络层
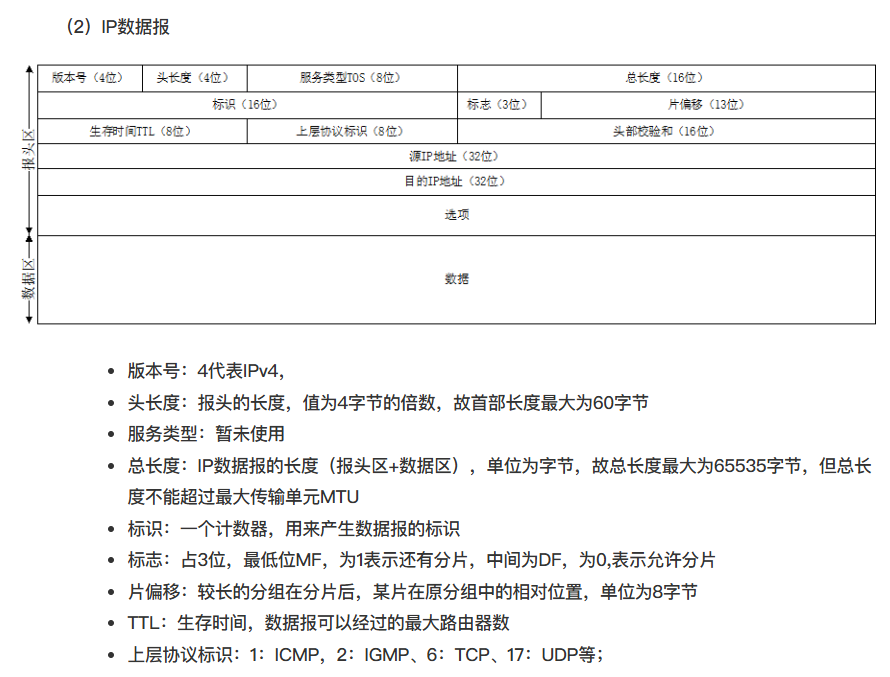
// 2 ip header 20B
// 4b Ver版本号 | 4b IHL头长度 | 1B TOS服务类型 | 2B TotalLen总长度
// | 2B ID | 3b Flags标志 |13b FragOffset片偏移 | 1B TTL生存时间 | 1B Proto上层协议标识
// | 2B HdrCksum头部校验和 | 4B SrcIP源IP | 4B DstIP | 0‑40B Options&Padding 选项&数据
// 跳过以太头
struct rte_ipv4_hdr *ip = (struct rte_ipv4_hdr*)(eth + 1); //msg + sizeof(struct rte_ether_hdr);
ip->version_ihl = 0x45; // 版本 4,首部长度 5*4B=20B
ip->type_of_service = 0;    // 普通服务
ip->total_length = htons(total_len - sizeof(struct rte_ether_hdr)); // IP 总长
ip->packet_id = 0; // 分片 ID
ip->fragment_offset = 0; // 不分片 Flags+FragOffset合并为16位ip->fragment_offset
ip->time_to_live = 64; // TTL
ip->next_proto_id = IPPROTO_UDP; // 协议号 17 UDP
ip->src_addr = global_sip;
ip->dst_addr = global_dip;
ip->hdr_checksum = 0; // 先清零,再计算
ip->hdr_checksum = rte_ipv4_cksum(ip); // 计算校验和
UDP协议
传输层
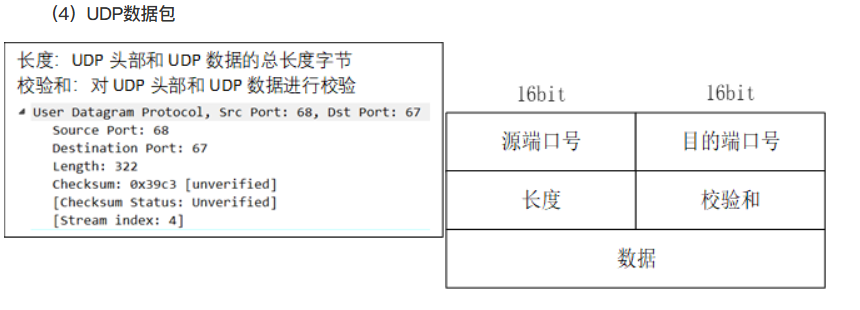
// 3 udp header
// 16b Sport源端口 | 16b Dport | 16b Length | 16b Checksum校验和
struct rte_udp_hdr *udp = (struct rte_udp_hdr *)(ip + 1); // 跳过 IP 头 指针跳过1个struct rte_ipv4_hdr长度
udp->src_port = global_sport;
udp->dst_port = global_dport;
// udplen =总长度 -以太头长度 -IP头长度 =UDP头长度(8B) +UDP数据长度
uint16_t udplen = total_len - sizeof(struct rte_ether_hdr) - sizeof(struct rte_ipv4_hdr);
udp->dgram_len = htons(udplen); // // UDP 长度 = UDP 头 + 数据

rte_memcpy((uint8_t*)(udp+1), data, udplen);
udp->dgram_cksum = 0;
udp->dgram_cksum = rte_ipv4_udptcp_cksum(ip, udp); // 计算校验和
TCP协议
传输层
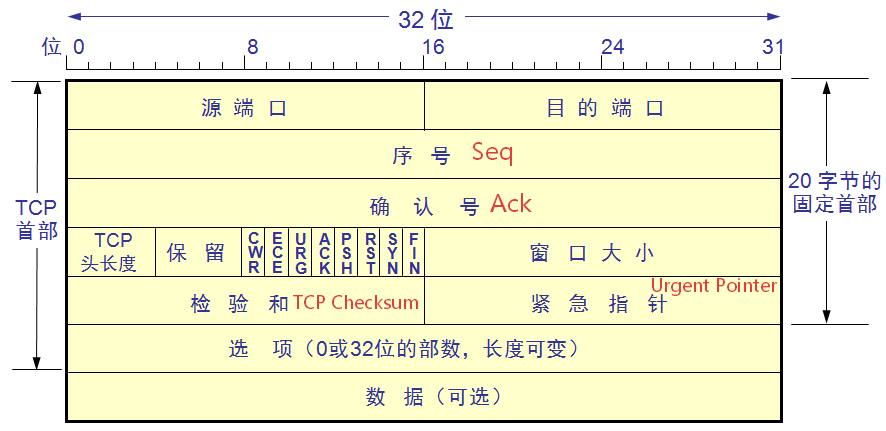
// 3 tcp header 20B
// 2B Sport | 2B Dport | 4B Seq序号 | 4B Ack确认号 | 4b DataOff头部长度
// | 6b Reserved保留 | 6b Flags标志 | 2B Win窗口大小 | 2B Checksum校验和 | 2B UrgPtr紧急指针

struct rte_tcp_hdr *tcp = (struct rte_tcp_hdr *)(ip + 1);
tcp->src_port = global_sport;
tcp->dst_port = global_dport;
tcp->sent_seq = htonl(12345);    // 硬编码 seq
tcp->recv_ack = htonl(global_seqnum + 1); // ack = 对端 seq + 1
tcp->data_off = 0x50;     // 首部长度 5*4B=20B
tcp->tcp_flags = RTE_TCP_SYN_FLAG | RTE_TCP_ACK_FLAG; //0x1 << 1; // SYN+ACK

tcp->rx_win = TCP_INIT_WINDOWS; //htons(4096);  // rmem
tcp->cksum = 0;
tcp->cksum = rte_ipv4_udptcp_cksum(ip, tcp);
三次握手
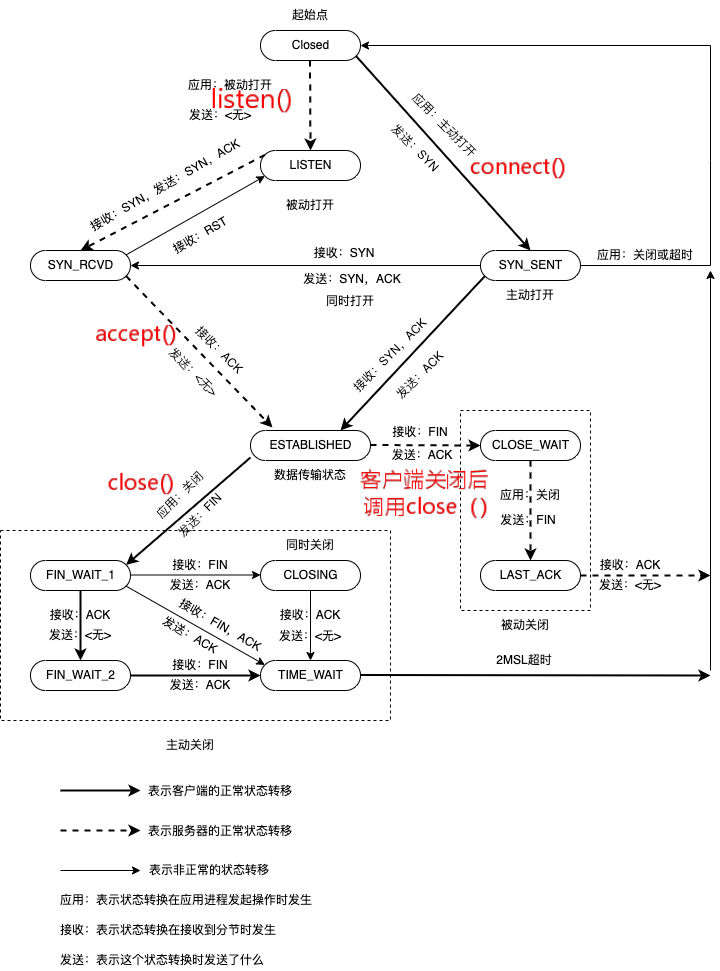
-
客户端发送syn1
-
服务端回复ack1( 数值等于syn1+1)和syn2,状态从LISTEN转为SYN_RCVD
-
客户端回复ack2(数值等于 syn2+1)
-
服务端收到ack2,状态转为ESTABLISHED
ag-0-1k47ip578ag-1-1k47ip578ag-0-1k47ip578ag-1-1k47ip578ag-0-1k47ip578ag-1-1k47ip578
// 收到 SYN:LISTEN → SYN_RCVD,回 SYN+ACK
if (global_flags & RTE_TCP_SYN_FLAG) {

    if (tcp_staag-0-1k47ip578ag-1-1k47ip578tus == USTACK_TCP_STATUS_LISTEN) {
        // 三次握手的第二个报文 SYN+ACK 是不带数据的,所以总长就是三个头部之和。
        uint16_t total_len = sizeof(struct rte_tcp_hdr) + sizeof(struct rte_ipv4_hdr) + sizeof(struct rte_ether_hdr);

        // 从 mbuf 内存池中分配一个新的 mbuf,用于构造回包
        struct rte_mbuf *mbuf = rte_pktmbuf_alloc(mbuf_pool);
        if (!mbuf) {
            rte_exit(EXIT_FAILURE, "Error rte_pktmbuf_alloc\n");
        }
        mbuf->pkt_len = total_len;
        mbuf->data_len = total_len;

        uint8_t *msg = rte_pktmbuf_mtod(mbuf, uint8_t *);

        ustack_encode_tcp_pkt(msg, total_len);

        rte_eth_tx_burst(global_portid, 0, &mbuf, 1);

        tcp_status = USTACK_TCP_STATUS_SYN_RCVD;
    }

}
// 收到 ACK:SYN_RCVD → ESTABLISHED
if (global_flags & RTE_TCP_ACK_FLAG) {


    if (tcp_status == USTACK_TCP_STATUS_SYN_RCVD) {

        printf("enter established\n");
        tcp_status = USTACK_TCP_STATUS_ESTABLISHED;
    }

}
// 收到 PSH:打印数据
if (global_flags & RTE_TCP_PSH_FLAG) {
    // PSH = Push,表示接收方应尽快把数据交给应用层,而不是缓存在接收缓冲区
    printf("enter established: %d\n", tcp_status);
    if (tcp_status == USTACK_TCP_STATUS_ESTABLISHED) {

        uint8_t hdrlen = (tcphdr->data_off >> 4) * sizeof(uint32_t);

        uint8_t *data = ((uint8_t*)tcphdr + hdrlen);

        printf("tcp data: %s\n", data);
    }

}
DPDK 可以通过 UIO 或 VFIO 将网卡绑定到用户态驱动。
两者是内核中一个IO驱动框架。给用户提供统一的接口,可以直接访问硬件资源等。
43 Insert IGB UIO module
igb_uio 是 DPDK 提供的一个 UIO 驱动,专门用于把网卡绑定到用户态。
44 Insert VFIO module
加载 vfio-pci 内核模块。
45 Insert KNI module
加载 rte_kni 内核模块。把 DPDK 用户态收到的包注入回内核协议栈。
46 Setup hugepage mappings for non-NUMA systems
为非 NUMA 系统配置大页内存。non-NUMA同一内存访问。所有 CPU 访问内存的距离和速度是一样的。
47 Setup hugepage mappings for NUMA systems
为 NUMA 系统配置大页内存。非同一内存访问。每个 CPU 有自己的内存,访问自己内存快,访问别人的内存慢。
49 Bind Ethernet/Baseband/Crypto device to IGB UIO module
把网卡(或其他设备)绑定到 igb_uio 驱动。
需要设置虚拟机支持多网卡队列。
添加红色标注的两句代码。

不同的dpdk版本之间差异很大,api函数等好多都不一样。
wait:22.11.11
king:19.08.02
sudo mkdir -p /mnt/huge
sudo mount -t hugetlbfs nodev /mnt/huge -o pagesize=2M
mount | grep hugetlbfs // 查看是否成功
成功:hugetlbfs on /mnt/huge type hugetlbfs
sudo chmod -R 777 /mnt/huge
sudo chmod -R 777 /dev/hugepages
#大页分配
cat /sys/kernel/mm/hugepages/hugepages-2048kB/nr_hugepages
#期望:1024
#自动挂载
mount | grep /mnt/huge
#期望:nodev on /mnt/huge type hugetlbfs (rw,relatime,pagesize=2M)
#/proc/meminfo
grep -i huge /proc/meminfo
#期望:HugePages_Total: 1024
#查看网卡 PCI 地址和当前驱动
lspci -nn | grep -i ethernet
sudo lspci -k -s 03:00.0
#加载 vfio-pci 模块
sudo modprobe vfio-pci
#查看当前驱动
sudo dpdk-devbind.py --status
成功:drv=vfio-pci
#启用 NO-IOMMU 模式
echo Y | sudo tee /sys/module/vfio/parameters/enable_unsafe_noiommu_mode
ifconfig eth0
ip:192.168.43.233
mac:00:0c:29:3a:e5:43
#先把 eth0 接口 down 掉
ip link set eth0 down
#绑定到 vfio-pci
sudo dpdk-devbind.py --bind=vfio-pci 0000:03:00.0
sudo dpdk-devbind.py --status
成功:drv=vfio-pci
WIN:
arp -a
接口: 192.168.43.121 --- 0xc
0xc=12
netsh -c i i add neighbors 12 192.168.43.233 00-0c-29-3a-e5-43
netsh interface ipv4 show interfaces
找到12对应WLAN,Wireshark监听的时候选择WLAN
vim /etc/default/grub
GRUB_CMDLINE_LINUX="find_preseed=/preseed.cfg noprompt net.ifnames=0 biosdevname=0 default_hugepagesz=1G hugepagesz=2M hugepages=1024 isolcpus=0-2"

GRUB_CMDLINE_LINUX_DEFAULT="quiet"
GRUB_CMDLINE_LINUX="find_preseed=/preseed.cfg noprompt net.ifnames=0 biosdevname=0 hugepagesz=2M hugepages=1024 isolcpus=0-2"

// 原
GRUB_DISTRIBUTOR=`lsb_release -i -s 2> /dev/null || echo Debian`
GRUB_CMDLINE_LINUX_DEFAULT="quiet"
GRUB_CMDLINE_LINUX="find_preseed=/preseed.cfg noprompt net.ifnames=0 biosdevname=0 default_hugepagesz=1G hugepagesz=2M hugepages=1024 isolcpus=0-2"
sudo update-grub
设置后重启一下才生效
cd
./usertools/dpdk-setup.sh
39 只需要一次
sudo mkdir -p /mnt/huge
sudo mount -t hugetlbfs nodev /mnt/huge -o pagesize=2M
sudo su
ifconfig eth0 down
export RTE_SDK=/home/king/share/dpdk/dpdk-stable-19.08.2/
RTE_SDK=/home/wait2204/DPDK/dpdk-stable-19.08.2/
export RTE_TARGET=x86_64-native-linux-gcc
./usertools/dpdk-setup.sh
43
44
45
46
512
47
512
49
etho: 0000:03:00.0
60
# 0_skt_seg.py
import os
import sys
import csv
import re
import datetime
import chardet
'''
解析 SKT 原始 .log 文件,提取加速度、陀螺仪、磁力计数据,按采样率生成时间戳和采样序号,输出为标准 CSV 文件。
同时输出一份数据质量/错误报告(txt),包含:错误帧数、错误率、丢帧数、有效数据量、覆盖时长等。
'''
# ==================== 用户配置区域 ====================
# INPUT_FILE = r"D:\Aprocedure\xm_changjiang\test_data\second\cf-skt\cf_skt_IMU1.log"
# OUTPUT_FILE = r"D:\Aprocedure\xm_changjiang\test_data\second\cf-skt\cf_skt_IMU1.csv"
# INPUT_FILE = r"D:\Aprocedure\xm_changjiang\test_data\second\cf-skt\cf_skt_IMU2.log"
# OUTPUT_FILE = r"D:\Aprocedure\xm_changjiang\test_data\second\cf-skt\cf_skt_IMU2.csv"
# INPUT_FILE = r"D:\Aprocedure\xm_changjiang\test_data\second\cf-skt\SKT1_100HZ_second.log"
# OUTPUT_FILE = r"D:\Aprocedure\xm_changjiang\test_data\second\cf-skt\SKT1_100HZ_second.csv"
# LOG_FILE = r"D:\Aprocedure\xm_changjiang\test_data\second\cf-skt\SKT1_100HZ_second_log.txt"
INPUT_FILE = r"D:\Aprocedure\bd_data\TuLin\CF\SCH_wifi_2.txt"
OUTPUT_FILE = r"D:\Aprocedure\bd_data\TuLin\CF\SCH_wifi_2.csv"
LOG_FILE = r"D:\Aprocedure\bd_data\TuLin\CF\SCH_wifi_log.txt"
DECIMAL_PLACES = 6
INCLUDE_UNITS_IN_HEADER = True
SAMPLE_RATE_HZ = 100
DATA_START_MARKERS = [
"index,acc_x,acc_y,acc_z,gyro_x,gyro_y,gyro_z,mag_x,mag_y,mag_z",
"index,acc_x",
"0,-",
"0,",
]
# 文件头/日志信息行关键字(非数据行,跳过且不计入错误)
INFO_LINE_KEYWORDS = ['receive', 'session', 'total records', 'sampling', '====', '----']
# 期望字段数:None 表示从文件头 "Format: ..." 行自动推断,推断失败则用 DEFAULT_FIELD_COUNT
EXPECTED_FIELD_COUNT = None
DEFAULT_FIELD_COUNT = 10
# 报告中"错误帧明细"最多打印的条数
MAX_ERROR_DETAILS = 50
AUTO_DETECT_ENCODING = True
FALLBACK_ENCODING = 'gbk'
# ====================================================
def detect_file_encoding(file_path, sample_size=10000):
try:
with open(file_path, 'rb') as f:
raw_data = f.read(sample_size)
result = chardet.detect(raw_data)
encoding = result['encoding']
confidence = result['confidence']
print(f"检测到文件编码: {encoding} (置信度: {confidence:.2%})")
if confidence < 0.5:
print(f"编码检测置信度较低,使用备用编码: {FALLBACK_ENCODING}")
return FALLBACK_ENCODING
return encoding
except Exception as e:
print(f"编码检测失败: {e},使用备用编码: {FALLBACK_ENCODING}")
return FALLBACK_ENCODING
def read_file_with_encoding(file_path, encoding=None):
"""返回 (lines, 实际使用的编码)"""
if encoding:
try:
with open(file_path, 'r', encoding=encoding) as f:
return f.readlines(), encoding
except UnicodeDecodeError:
print(f"使用编码 {encoding} 读取失败,尝试自动检测...")
if AUTO_DETECT_ENCODING:
detected_encoding = detect_file_encoding(file_path)
try:
with open(file_path, 'r', encoding=detected_encoding) as f:
return f.readlines(), detected_encoding
except UnicodeDecodeError:
print(f"使用检测到的编码 {detected_encoding} 读取失败")
common_encodings = ['utf-8', 'gbk', 'gb2312', 'gb18030', 'latin-1', 'cp1252']
for enc in common_encodings:
if enc != detected_encoding:
try:
print(f"尝试使用编码: {enc}")
with open(file_path, 'r', encoding=enc) as f:
return f.readlines(), enc
except UnicodeDecodeError:
continue
try:
print(f"使用备用编码: {FALLBACK_ENCODING}")
with open(file_path, 'r', encoding=FALLBACK_ENCODING) as f:
return f.readlines(), FALLBACK_ENCODING
except UnicodeDecodeError:
print("所有编码尝试失败,使用 'ignore' 模式读取")
with open(file_path, 'r', encoding='utf-8', errors='ignore') as f:
return f.readlines(), 'utf-8(ignore)'
def find_data_start_line(lines, markers=None):
if markers is None:
markers = DATA_START_MARKERS
for i, line in enumerate(lines):
line_stripped = line.strip()
if not line_stripped:
continue
for marker in markers:
if marker in line_stripped:
return i
if re.match(r'^[\d\.\-]+,', line_stripped):
parts = line_stripped.split(',')
if len(parts) >= 10:
try:
float(parts[0].strip())
return i
except ValueError:
continue
return -1
def calculate_timestamp(sample_index, sample_rate_hz, start_time_ms=0):
interval_ms = 1000.0 / sample_rate_hz
return int(start_time_ms + sample_index * interval_ms)
def parse_declared_total(lines, end_idx):
"""从文件头解析 'Total records: N' 作为声明总帧数"""
for line in lines[:end_idx + 1]:
m = re.search(r'Total\s+records\s*:\s*(\d+)', line, re.IGNORECASE)
if m:
return int(m.group(1))
return None
def parse_expected_fields(lines, end_idx):
"""从文件头 'Format: index,acc_x,...' 行推断期望字段数"""
for line in lines[:end_idx + 1]:
if 'format' in line.lower() and ',' in line:
cols = [c.strip() for c in line.split(':', 1)[-1].split(',') if c.strip()]
if len(cols) >= 2:
return len(cols)
return DEFAULT_FIELD_COUNT
def format_gap_ranges(gaps, max_show=40):
"""把缺失序号区间格式化成文本行"""
out = []
for i, (start, end, count) in enumerate(gaps[:max_show], 1):
rng = f"{start}" if start == end else f"{start} ~ {end}"
out.append(f" {i:>4} {rng:<26} {count:>8}")
if len(gaps) > max_show:
out.append(f" ... 其余 {len(gaps) - max_show} 段省略")
return out
def build_conclusion(rep):
"""根据统计结果生成结论与建议"""
notes = []
total_span = rep['frame_span']
if rep['error_count'] == 0 and rep['missing_total'] == 0:
notes.append("未发现错误帧,采样序号完全连续,数据完整可用。")
else:
if rep['missing_total'] > 0:
notes.append(
f"采样序号存在 {len(rep['gaps'])} 处不连续,共丢失 {rep['missing_total']} 帧"
f"(丢帧率 {rep['drop_rate']:.6f}%,约 {rep['missing_s']:.3f} s)。")
if rep['struct_errors']:
notes.append(
f"存在 {len(rep['struct_errors'])} 行字段数异常(≠{rep['expected_fields']}),"
f"这些行已丢弃,对应时间点数据缺失。")
if rep['extra_field_errors']:
notes.append(
f"其中 {len(rep['extra_field_errors'])} 行字段数偏多,属于记录间换行丢失造成的行粘连,"
f"虽已丢弃,若发现相邻帧异常需重点检查这些行号。")
if rep['value_errors']:
notes.append(f"存在 {len(rep['value_errors'])} 行数值解析失败。")
if rep['missing_total'] / max(total_span, 1) < 0.001:
notes.append("结论:错误集中且占比极低(<0.1%),对惯导积分与轨迹解算影响可忽略,可直接使用。")
elif rep['missing_total'] / max(total_span, 1) < 0.01:
notes.append("结论:错误占比 <1%,数据基本可用,建议对错误区间的轨迹结果做重点关注。")
else:
notes.append("结论:错误占比 >1%,数据质量较差,建议核查原始采集设备与传输链路后重新采集。")
if rep['gaps']:
first_bad = rep['gaps'][0][0]
last_bad = rep['gaps'][-1][1]
notes.append(
f"异常集中在序号 {first_bad} ~ {last_bad} 区间,"
f"对应时间约 {first_bad / rep['sample_rate']:.2f} s ~ {last_bad / rep['sample_rate']:.2f} s,"
f"建议重点核对该区间的采集记录。")
return notes
def write_quality_report(report_path, rep):
"""把数据质量与错误统计写入 txt 报告"""
if not report_path:
return
report_dir = os.path.dirname(report_path)
if report_dir and not os.path.exists(report_dir):
os.makedirs(report_dir, exist_ok=True)
L = []
add = L.append
bar = "=" * 78
sub = "-" * 78
add(bar)
add("SKT IMU 数据解析质量报告")
add(bar)
add(f"生成时间 : {datetime.datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
add(f"输入文件 : {rep['input_file']}")
add(f"输出文件 : {rep['output_file']}")
add(f"报告文件 : {report_path}")
add(f"文件编码 : {rep['encoding']}")
add(f"采样率 : {rep['sample_rate']} Hz (采样间隔 {1000.0 / rep['sample_rate']:.2f} ms)")
add(f"期望字段数 : {rep['expected_fields']}")
add("")
# ---------- 一、数据总量 ----------
add(sub)
add("一、数据总量")
add(sub)
add(f"文件总行数 : {rep['total_lines']}")
add(f"数据区起始行 : 第 {rep['start_line_no']} 行")
add(f"数据区行数 : {rep['data_zone_lines']}")
add(f" 有效数据帧 : {rep['valid']} (占数据区 {rep['valid_ratio']:.4f}%)")
add(f" 错误帧 : {rep['error_count']} (占数据区 {rep['error_ratio']:.6f}%)")
add(f" ├ 字段数不足(截断) : {len(rep['struct_errors'])}")
add(f" ├ 字段数偏多(粘连) : {len(rep['extra_field_errors'])}")
add(f" └ 数值解析失败 : {len(rep['value_errors'])}")
add(f" 表头/格式行 (跳过) : {rep['header_skipped']}")
add(f" 日志信息行 (跳过) : {rep['info_skipped']}")
add(f" 空行 (跳过) : {rep['empty_lines']}")
if rep['declared_total'] is not None:
add(f"声明记录总帧数 (文件头) : {rep['declared_total']}")
add("")
# ---------- 二、错误率 ----------
add(sub)
add("二、错误率")
add(sub)
add(f"错误率 (错误帧 / 数据区行) : {rep['error_ratio']:.6f} %")
add(f"错误率 (错误帧 / 有效帧+错误帧): {rep['error_ratio_valid']:.6f} %")
add(f"数据可用率 : {rep['valid_ratio']:.4f} %")
if rep['declared_total']:
add(f"相对声明总帧数的错误率 : {rep['error_ratio_declared']:.6f} %")
add("")
# ---------- 三、丢帧 / 序号连续性 ----------
add(sub)
add("三、丢帧 / 采样序号连续性")
add(sub)
if rep['first_raw_index'] is None:
add("无有效数据,无法统计序号连续性。")
else:
add(f"首帧采样序号 : {rep['first_raw_index']}")
add(f"末帧采样序号 : {rep['last_raw_index']}")
add(f"序号理论跨度 : {rep['frame_span']} 帧")
add(f"实际有效帧数 : {rep['valid']}")
add(f"序号不连续次数 : {len(rep['gaps'])}")
add(f"丢失采样帧数 : {rep['missing_total']}")
add(f"丢帧率 : {rep['drop_rate']:.6f} %")
add(f"数据完整率 : {rep['integrity']:.4f} %")
if rep['backward_jumps']:
add(f"序号回退次数 : {rep['backward_jumps']} (需人工核查)")
add("")
if rep['gaps']:
add("缺失序号明细:")
add(f" {'#':>4} {'缺失序号区间':<26} {'缺失帧数':>8}")
for line in format_gap_ranges(rep['gaps']):
add(line)
else:
add("缺失序号明细: 无")
add("")
# ---------- 四、时长统计 ----------
add(sub)
add("四、时长统计")
add(sub)
add(f"覆盖时长 (末序号-首序号) : {rep['cover_s']:.3f} s ({rep['cover_s'] / 60.0:.3f} min)")
add(f"有效数据时长 (有效帧/采样率): {rep['valid_s']:.3f} s")
add(f"丢失时长 (丢帧/采样率) : {rep['missing_s']:.3f} s")
add(f"理论帧数 (覆盖时长*采样率+1): {rep['expected_frames']}")
add(f"实际有效帧数 : {rep['valid']}")
add(f"帧数差异 : {rep['valid'] - rep['expected_frames']:+d} 帧")
add("")
# ---------- 五、错误帧明细 ----------
add(sub)
add("五、错误帧明细")
add(sub)
details = ([("字段数不足", ln, f"实际 {n} 列 < {rep['expected_fields']}", txt) for ln, n, txt in rep['struct_errors']]
+ [("字段数偏多", ln, f"实际 {n} 列 > {rep['expected_fields']}", txt) for ln, n, txt in rep['extra_field_errors']]
+ [("数值解析失败", ln, msg, txt) for ln, msg, txt in rep['value_errors']])
details.sort(key=lambda x: x[1])
if not details:
add("无错误帧。")
else:
add(f" {'#':>4} {'行号':>10} {'类型':<14} {'说明':<18} 行内容")
for i, (typ, ln, msg, txt) in enumerate(details[:MAX_ERROR_DETAILS], 1):
add(f" {i:>4} {ln:>10} {typ:<14} {msg:<18} {txt[:90]}")
if len(details) > MAX_ERROR_DETAILS:
add(f" ... 其余 {len(details) - MAX_ERROR_DETAILS} 条省略")
add("")
# ---------- 六、结论与建议 ----------
add(sub)
add("六、结论与建议")
add(sub)
notes = build_conclusion(rep)
if notes:
for n in notes:
add(f" - {n}")
else:
add(" - 无")
add("")
add(bar)
with open(report_path, 'w', encoding='utf-8-sig') as f:
f.write("\n".join(L))
print(f"质量报告已写入: {report_path}")
def convert_imu_data(input_file, output_file, report_file=None,
decimal_places=6, include_units=True, sample_rate_hz=100):
if not os.path.exists(input_file):
print(f"错误:输入文件不存在 - {input_file}")
return False
input_dir = os.path.dirname(input_file)
if input_dir:
output_path = os.path.join(input_dir, output_file)
else:
output_path = output_file
print(f"输入文件: {input_file}")
print(f"输出文件: {output_path}")
print(f"小数位数: {decimal_places}")
print(f"采样频率: {sample_rate_hz} Hz")
print(f"采样间隔: {1000.0 / sample_rate_hz:.2f} ms")
try:
lines, encoding_used = read_file_with_encoding(input_file)
if not lines:
print("错误:文件为空或无法读取")
return False
print(f"文件读取成功,共 {len(lines)} 行")
start_line_idx = find_data_start_line(lines)
if start_line_idx == -1:
print("错误:未找到数据开始标记(index,acc_x或0开头的数据行)")
print("请检查文件格式是否正确")
return False
print(f"数据开始位置: 第 {start_line_idx + 1} 行")
data_lines = lines[start_line_idx:]
expected_fields = EXPECTED_FIELD_COUNT or parse_expected_fields(lines, start_line_idx)
declared_total = parse_declared_total(lines, start_line_idx)
output_rows = []
if include_units:
header = [
"时间戳(ms)", "采样序号", "加速度计x(g)", "加速度计y(g)", "加速度计z(g)",
"陀螺仪x(deg/s)", "陀螺仪y(deg/s)", "陀螺仪z(deg/s)",
"磁力计x(µT)", "磁力计y(µT)", "磁力计z(µT)"
]
else:
header = [
"timestamp_ms", "sample_index", "acc_x", "acc_y", "acc_z",
"gyro_x", "gyro_y", "gyro_z", "mag_x", "mag_y", "mag_z"
]
output_rows.append(header)
sample_idx = 1
valid_count = 0
error_count = 0
skip_count = 0 # 空行
header_skipped = 0 # 表头/格式行
info_skipped = 0 # 日志信息行
struct_errors = [] # (行号, 实际列数, 行内容) 字段数不足
extra_field_errors = [] # (行号, 实际列数, 行内容) 字段数偏多
value_errors = [] # (行号, 错误信息, 行内容)
gaps = [] # (缺失起始序号, 缺失结束序号, 缺失帧数)
backward_jumps = 0
first_sample_index = None
first_raw_index = None
last_raw_index = None
timestamp_start = 0
for line_num, line in enumerate(data_lines, start_line_idx + 1):
raw_line = line.strip()
if not raw_line:
skip_count += 1
continue
line_lower = raw_line.lower()
# --- 日志信息行(非数据)---
if any(keyword in line_lower for keyword in INFO_LINE_KEYWORDS):
info_skipped += 1
continue
parts = raw_line.split(',')
# --- 表头行 / Format 行 ---
if any(keyword in line_lower for keyword in ['index', 'acc_x', 'gyro_x', 'mag_x']):
is_header = False
for part in parts[:3]:
try:
float(part.strip())
except ValueError:
is_header = True
break
if is_header:
header_skipped += 1
print(f"检测到表头行,已跳过: {raw_line[:80]}...")
continue
# --- 结构检查:字段数必须等于期望值 ---
if len(parts) != expected_fields:
if len(parts) < expected_fields:
struct_errors.append((line_num, len(parts), raw_line))
else:
extra_field_errors.append((line_num, len(parts), raw_line))
print(f"警告:第 {line_num} 行字段数异常 (期望={expected_fields},实际={len(parts)}),跳过: {raw_line[:50]}...")
error_count += 1
continue
# --- 数值检查 ---
try:
values = [float(p.strip()) for p in parts]
except ValueError as e:
value_errors.append((line_num, str(e), raw_line))
print(f"警告:第 {line_num} 行数据解析失败: {e}")
print(f" 行内容: {raw_line[:100]}...")
error_count += 1
continue
try:
sample_index_raw = int(values[0])
if first_sample_index is None:
first_sample_index = sample_index_raw
timestamp_start = 0
# 采样序号连续性检查
if first_raw_index is None:
first_raw_index = sample_index_raw
elif sample_index_raw > last_raw_index + 1:
gaps.append((last_raw_index + 1, sample_index_raw - 1,
sample_index_raw - last_raw_index - 1))
elif sample_index_raw < last_raw_index + 1:
backward_jumps += 1
last_raw_index = sample_index_raw
timestamp = int(timestamp_start + (sample_index_raw - first_sample_index) * (1000.0 / sample_rate_hz))
acc_x, acc_y, acc_z = values[1], values[2], values[3]
gyro_x, gyro_y, gyro_z = values[4], values[5], values[6]
mag_x, mag_y, mag_z = values[7], values[8], values[9]
row = [
str(timestamp), str(sample_idx),
f"{acc_x:.{decimal_places}f}", f"{acc_y:.{decimal_places}f}", f"{acc_z:.{decimal_places}f}",
f"{gyro_x:.{decimal_places}f}", f"{gyro_y:.{decimal_places}f}", f"{gyro_z:.{decimal_places}f}",
f"{mag_x:.{decimal_places}f}", f"{mag_y:.{decimal_places}f}", f"{mag_z:.{decimal_places}f}"
]
output_rows.append(row)
sample_idx += 1
valid_count += 1
except (ValueError, IndexError) as e:
value_errors.append((line_num, str(e), raw_line))
print(f"警告:第 {line_num} 行处理异常: {e}")
error_count += 1
continue
# ---------------- 统计汇总 ----------------
data_zone_lines = max(len(data_lines) - skip_count - header_skipped - info_skipped, 0)
if first_raw_index is None:
frame_span = 0
else:
frame_span = last_raw_index - first_raw_index + 1
missing_total = sum(g[2] for g in gaps)
# 按采样序号跨度推算的理论帧数(首序号到末序号全部连续时应有的帧数)
expected_frames = frame_span
rep = {
'input_file': input_file,
'output_file': output_path,
'encoding': encoding_used,
'sample_rate': sample_rate_hz,
'expected_fields': expected_fields,
'total_lines': len(lines),
'start_line_no': start_line_idx + 1,
'data_zone_lines': data_zone_lines,
'valid': valid_count,
'error_count': error_count,
'header_skipped': header_skipped,
'info_skipped': info_skipped,
'empty_lines': skip_count,
'declared_total': declared_total,
'struct_errors': struct_errors,
'extra_field_errors': extra_field_errors,
'value_errors': value_errors,
'gaps': gaps,
'backward_jumps': backward_jumps,
'first_raw_index': first_raw_index,
'last_raw_index': last_raw_index,
'frame_span': frame_span,
'missing_total': missing_total,
'expected_frames': expected_frames,
'cover_s': (frame_span - 1) / sample_rate_hz if frame_span > 1 else 0.0,
'valid_s': valid_count / sample_rate_hz,
'missing_s': missing_total / sample_rate_hz,
'error_ratio': (error_count / data_zone_lines * 100.0) if data_zone_lines else 0.0,
'error_ratio_valid': (error_count / (valid_count + error_count) * 100.0) if (valid_count + error_count) else 0.0,
'error_ratio_declared': (error_count / declared_total * 100.0) if declared_total else 0.0,
'valid_ratio': (valid_count / data_zone_lines * 100.0) if data_zone_lines else 0.0,
'drop_rate': (missing_total / frame_span * 100.0) if frame_span else 0.0,
'integrity': (valid_count / frame_span * 100.0) if frame_span else 0.0,
}
# 报告先写,即使没有任何有效数据也保留证据
if report_file:
write_quality_report(report_file, rep)
if valid_count == 0:
print("错误:未解析到任何有效数据行")
return False
with open(output_path, 'w', newline='', encoding='utf-8-sig') as f:
writer = csv.writer(f)
writer.writerows(output_rows)
print(f"\n{'='*50}")
print(f"转换完成!")
print(f"{'='*50}")
print(f"成功转换: {valid_count} 条数据")
print(f"错误/跳过: {error_count} 条")
print(f"空行跳过: {skip_count} 条")
print(f"输出文件: {output_path}")
print(f"\n时间范围: {int(output_rows[1][0])} ms → {int(output_rows[-1][0])} ms")
print(f"覆盖时长: {rep['cover_s']:.2f} 秒")
print(f"理论帧数: {rep['expected_frames']} 帧 (采样率 {sample_rate_hz} Hz)")
print(f"实际帧数: {valid_count} 帧 (差异 {valid_count - rep['expected_frames']:+d})")
print(f"错误率: {rep['error_ratio']:.6f} % 丢帧率: {rep['drop_rate']:.6f} %")
if missing_total > 0:
print(f"⚠ 警告:存在 {missing_total} 帧缺失({len(gaps)} 处序号不连续)!")
return True
except Exception as e:
print(f"转换过程中发生错误: {e}")
import traceback
traceback.print_exc()
return False
def main():
global INPUT_FILE, OUTPUT_FILE, LOG_FILE, DECIMAL_PLACES, INCLUDE_UNITS_IN_HEADER, SAMPLE_RATE_HZ
# Windows 控制台默认 GBK,遇到 ✓ ✗ ⚠ 等符号会抛 UnicodeEncodeError 中断脚本,这里容错替换
try:
sys.stdout.reconfigure(errors='replace')
sys.stderr.reconfigure(errors='replace')
except (AttributeError, ValueError):
pass
if len(sys.argv) >= 2:
input_file = sys.argv[1]
if len(sys.argv) >= 3:
output_file = sys.argv[2]
else:
base = os.path.splitext(input_file)[0]
output_file = f"{base}_converted.csv"
# 报告路径:优先取第三个参数,否则与输入文件同名加 _log.txt
report_file = sys.argv[3] if len(sys.argv) >= 4 else f"{os.path.splitext(input_file)[0]}_log.txt"
else:
input_file = INPUT_FILE
output_file = OUTPUT_FILE
report_file = LOG_FILE
success = convert_imu_data(
input_file, output_file, report_file, DECIMAL_PLACES,
INCLUDE_UNITS_IN_HEADER, SAMPLE_RATE_HZ
)
if success:
print("\n✓ 转换成功完成!")
else:
print("\n✗ 转换失败,请检查错误信息。")
sys.exit(1)
if __name__ == "__main__":
main()文章参考<零声教育>的C/C++linux服务期高级架构系统教程学习:0voice · GitHub