K近邻算法(KNN)
KNN 属于典型的**"懒学习"(Lazy Learning)算法**(计算开销大)------它没有显式的训练过程,而是把样本存起来,等预测时再去计算。
优点:简单直观,无需训练;天然支持多分类和非线性
缺点:预测慢,计算开销大;高维度性能下降;对特征缩放极度敏感,必须标准化;对不平衡数据敏感
-
核心思想:
【底层假设(前提)】物以类聚,人以群分 :在特征空间中,相似的样本(距离近)通常具有相似的输出标签。这是 KNN 能够通过邻居进行推断的理论基础。
【预测机制】近朱者赤,近墨者黑 :给定一个测试样本,算法在训练集中找出距离它最近的 K 个样本。**
分类任务采用少数服从多数的【投票原则】,回归任务**对邻居输出【取平均值】,以此得到测试样本的类别或者预测值。 -
工作原理:
-
数据标准化:确保所有特征处于同一尺度,避免数值量级大的特征主导距离计算。
-
计算距离 :计算测试样本与所有训练集样本之间的距离 (欧式距离公式)。
-
找K个邻居 :将距离按递增顺序排序,选取距离最近的 **K 个训练样本(K值选择)**作为"邻居"。
-
分类任务 :统计这 K 个训练样本的类别,将出现次数最多的类别作为预测结果(投票法)。
回归任务:将这 K 个样本的目标值取平均,作为预测结果(平均法)。
-
-
欧式距离公式:
二维平面上,欧氏距离公式:
d=(x1−x2)2+(y1−y2)2 d = \sqrt{(x_1 - x_2)^2 + (y_1 - y_2)^2} d=(x1−x2)2+(y1−y2)2
多维空间中,欧氏距离公式:
d=∑i=1n(xi−yi)2 d = \sqrt{\sum_{i=1}^{n} (x_i - y_i)^2} d=i=1∑n(xi−yi)2
-
K值的选择:
K值的选择本质上是偏差与方差的权衡(Bias-Variance Tradeoff)。
K值大小 模型特性 风险 生动比喻 太小 对噪声敏感 决策边界不稳定 容易过拟合 泛化能力差 只问1-2个邻居,容易被个别极端观点误导。 适中 较好的泛化能力 稳定的预测结果 性能最优 咨询一个理性且小范围的邻里共识。 太大 模型过于简化 忽略局部特征 容易欠拟合 分类边界模糊 问太多人的意见,反而失去了"近邻"的意义。 -
常规范围 :通常选择 3 - 10 之间。
-
奇偶选择 :优先选择奇数(避免平票)。
-
实战建议 :
K值≈n附近的奇数(n为样本数) K值 \approx \sqrt{n}附近的奇数(n为样本数) K值≈n 附近的奇数(n为样本数)
-
- 科学调优 :使用交叉验证(如
cross_val_score)或网格搜索(GridSearchCV)寻找K的最优值。
-
分类器选择:
对比维度 KNeighborsClassifier (分类) KNeighborsRegressor (回归) 预测目标 离散的类别标签(如:0, 1, 2) 连续的数值(如:3.14, 100.5) 核心机制 多数投票法 (Majority Voting) 平均值法 (Averaging) 预测输出 这 K 个邻居中出现次数最多的类别 这 K 个邻居目标值的算术平均值 model.score()返回值准确率 (Accuracy)(正确预测的比例) 决定系数 (R2*R*2)(拟合优度,越接近1越好) 常用评估指标 准确率、精确率、召回率、F1分数 均方误差 (MSE)、平均绝对误差 (MAE)、R2R2 导入方式 from sklearn.neighbors import KNeighborsClassifierfrom sklearn.neighbors import KNeighborsRegressor -
案例:鸢尾花分类
维度类型 名称(中文) 特征维度 (X) 花萼长度 花萼宽度 花瓣长度 花瓣宽度 标签维度 (y) 山鸢尾 变色鸢尾 维吉尼亚鸢尾 第一步:网格搜索 + 交叉验证(确定参数)
pythonimport numpy as np from sklearn.datasets import load_iris from sklearn.model_selection import cross_val_score from sklearn.model_selection import train_test_split from sklearn.neighbors import KNeighborsClassifier # 准备数据 iris = load_iris() x=iris.data # 特征值 y=iris.target # 标签数据 # 划分数据集和测试集 x_train,x_test,y_train,y_test = train_test_split( x,y,test_size=0.2,random_state=42 ) # 数据标准化 from sklearn.preprocessing import StandardScaler scaler = StandardScaler() x_train_scaler = scaler.fit_transform(x_train) x_test_scaler = scaler.transform(x_test) k_range = range(1, 31) # 尝试1到30的K值 k_scores = [] for k in k_range: model = KNeighborsClassifier(n_neighbors=k) # 5折交叉验证,评估指标为准确率 # 参数: # n_neighbors=k(循环改变的参数) # cv=5(5折交叉验证) # np.argmax(k_scores)(找出最高得分对应的索引,即最佳K值) scores = cross_val_score(model,x_train_scaler,y_train, cv=5, scoring='accuracy') k_scores.append(scores.mean()) # 记录平均准确率 print(f"{k} -> {scores.mean()}") best_k = k_range[np.argmax(k_scores)] print(f"交叉验证得出的最佳K值: {best_k}") ------------------------------------------------------------------------------ 1 -> 0.9416666666666668 2 -> 0.9333333333333333 3 -> 0.95 4 -> 0.9416666666666668 5 -> 0.925 6 -> 0.9333333333333333 7 -> 0.9416666666666668 8 -> 0.9416666666666668 9 -> 0.9416666666666668 10 -> 0.9416666666666668 11 -> 0.95 12 -> 0.95 13 -> 0.95 14 -> 0.9416666666666668 15 -> 0.95 16 -> 0.925 17 -> 0.9333333333333333 18 -> 0.9166666666666667 19 -> 0.9166666666666666 20 -> 0.9166666666666667 21 -> 0.9166666666666667 22 -> 0.9083333333333334 23 -> 0.9 24 -> 0.9 25 -> 0.8666666666666666 26 -> 0.875 27 -> 0.875 28 -> 0.875 29 -> 0.875 30 -> 0.875 交叉验证得出的最佳K值: 3 ------------------------------------------------------------------------------第二步:模型构建与应用
pythonfrom sklearn.datasets import load_iris from sklearn.model_selection import train_test_split from sklearn.neighbors import KNeighborsClassifier from sklearn.metrics import classification_report from sklearn.metrics import confusion_matrix import seaborn as sns import matplotlib.pyplot as plt # 准备数据 iris = load_iris() x=iris.data # 特征值 y=iris.target # 标签数据 # 划分数据集和测试集 x_train,x_test,y_train,y_test = train_test_split( x,y,test_size=0.2,random_state=42 ) # 数据标准化 from sklearn.preprocessing import StandardScaler scaler = StandardScaler() x_train_scaler = scaler.fit_transform(x_train) x_test_scaler = scaler.transform(x_test) # 模型 model = KNeighborsClassifier(n_neighbors=3) # K取值为3 # 模型训练 model.fit(x_train_scaler,y_train) # 预测评估 predictions = model.predict(x_test_scaler) # 【方式一】:准确率 accuracy = model.score(x_test_scaler,y_test) print(f"模型准确率:{accuracy:.2f}") # 【方式二】:分类报告 cm = classification_report(y_test,predictions,target_names=iris.target_names) print(cm) # 【方式三】:混淆矩阵------可视化 plt.rcParams['font.sans-serif'] = ['SimHei', 'Microsoft YaHei'] # 黑体优先,备选微软雅黑 plt.rcParams['axes.unicode_minus'] = False # 解决负号变成方框 sns.set(font="SimHei") # seaborn热力图也要指定字体 # 混淆矩阵 cm = confusion_matrix(y_test, predictions) # 设置画布大小 plt.figure(figsize=(8, 6)) # 绘制热力图 sns.heatmap( cm, annot=True, # 在格子里显示具体数字 fmt='d', # 数字格式化为整数(避免出现科学计数法) cmap='Blues', # 颜色主题:蓝色调(Blues) xticklabels=iris.target_names, # X轴标签(预测标签) yticklabels=iris.target_names # Y轴标签(真实标签) ) # 添加坐标轴和标题 plt.ylabel('真实标签 (True label)') plt.xlabel('预测标签 (Predicted label)') plt.title('KNN分类混淆矩阵 (KNN Confusion Matrix)') # 显示图像 plt.show() ---------------------------------------------------------------------------- 模型准确率:1.00 precision recall f1-score support setosa 1.00 1.00 1.00 10 versicolor 1.00 1.00 1.00 9 virginica 1.00 1.00 1.00 11 accuracy 1.00 30 macro avg 1.00 1.00 1.00 30 weighted avg 1.00 1.00 1.00 30 ----------------------------------------------------------------------------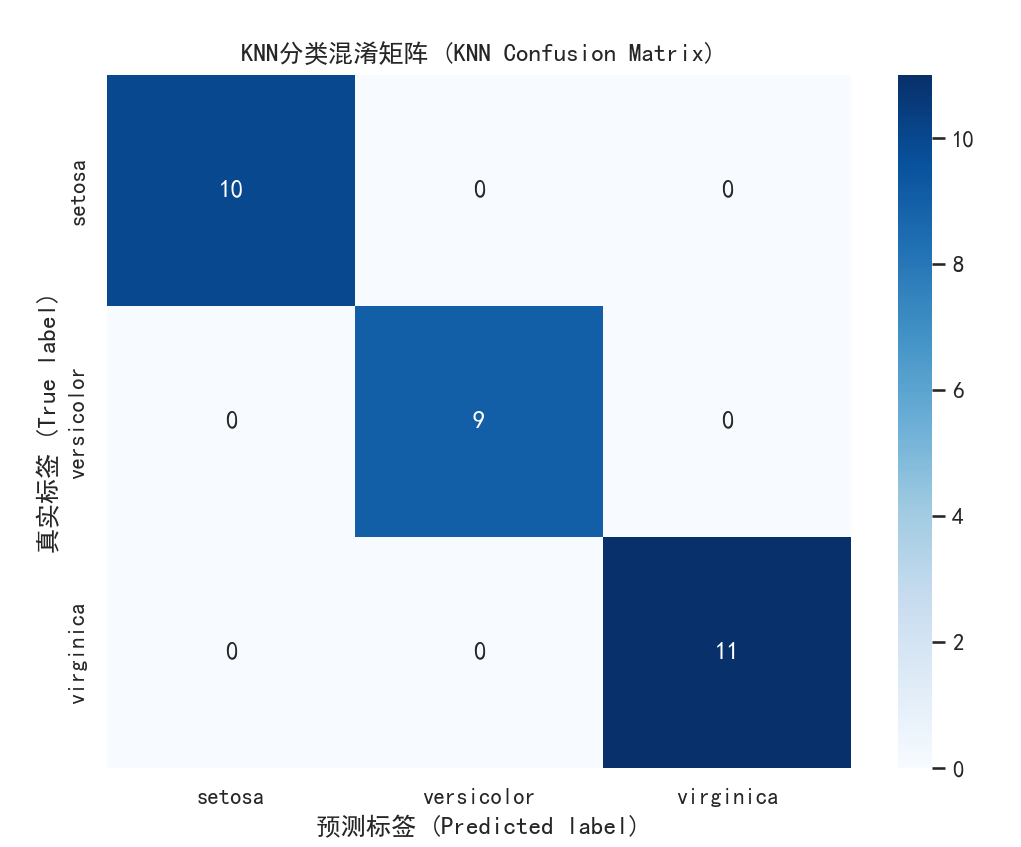
- 对角线(左上到右下) :预测正确的样本数(这是我们最希望看到数字最大的地方)。
- 非对角线 :预测错误的样本数(即混淆的部分)。
-
KNN应用场景:
何时使用 KNN? 何时考虑替代算法? 数据集规模适中(几千到几万,不会造成严重计算负担) 大规模数据集:考虑决策树、随机森林、神经网络 特征维度较低(少于20维,避免维度灾难) 高维数据:先降维(PCA),或用 SVM、神经网络 需要简单可解释的模型(决策过程透明易懂) 实时预测需求:用朴素贝叶斯、逻辑回归(预测速度快) 数据分布复杂(决策边界非线性,难以用简单函数拟合) 需要概率输出:选择逻辑回归或随机森林 增量学习场景(新增样本可直接加入训练集,无需重新训练) 数据极度不平衡:需配合重采样或改用树模型