《Large Language Model-Brained GUI Agents: A Survey》对"大语言模型驱动的GUI智能体"这一新兴领域进行了全面、系统的综述。以下是其主要研究内容的总结概括:
一、研究背景与动机
核心问题:传统GUI自动化依赖脚本或规则,缺乏灵活性和适应性,难以应对动态、多样化的真实应用场景。
变革契机:大语言模型(LLM)及多模态模型的出现,带来了自然语言理解、代码生成、任务泛化和视觉处理能力的飞跃,催生了新一代"LLM驱动"的GUI智能体。
定义:LLM驱动的GUI智能体是指以LLM为核心推理与认知引擎,在GUI环境中灵活、自适应地生成、规划和执行动作的智能体。
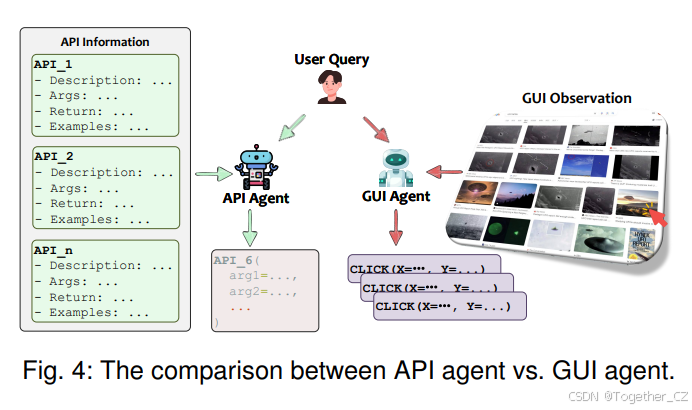
与API智能体的区别:GUI智能体通过通用图形界面操作(点击、输入等)控制软件,具有更广泛的适用性和可观察性;API智能体效率更高但受限于API可用性。二者可混合使用。
二、历史演变
论文将GUI智能体的发展划分为三个阶段:
-
早期自动化系统(2023年以前):基于随机、规则和脚本的方法,适用于固定工作流,但缺乏灵活性。
-
向智能智能体转变:引入机器学习、计算机视觉、自然语言处理和强化学习,提升了适应性和智能水平,但仍难以泛化到新任务。
-
LLM驱动GUI智能体的出现(2023年至今):LLM和多模态模型实现端到端自动化,在Web、移动、桌面等平台快速发展,工业界也开始积极布局(如Claude Computer Use、OpenAI Operator)。
三、核心组件与架构
论文提出了LLM驱动GUI智能体的通用架构,包含以下关键组件:
-
操作环境:涵盖移动、Web、桌面平台,智能体通过截图、控件树等感知环境状态,并接收反馈。
-
提示工程:构建包含用户请求、智能体指令、环境状态、动作文档、演示示例和补充信息的综合提示。
-
模型推理:LLM进行规划(任务分解、长期目标与短期动作)和动作推理(生成函数调用字符串),并输出推理过程、状态等互补信息。
-
动作执行:包括UI操作(点击、输入、手势)、原生API调用和AI工具(如摘要、图像生成)。
-
记忆机制:短期记忆(当前任务上下文)和长期记忆(历史任务、规则、外部知识),支持持续学习和个性化。
高级增强技术:
-
基于计算机视觉的GUI定位(如OmniParser)
-
多智能体框架(专业化与协作)
-
自我反思(ReAct、Reflexion)
-
自我进化(任务轨迹、规则提取、新工具发现)
-
强化学习(MDP建模、DigiRL、DistRL等)
四、主要框架
论文按平台分类综述了代表性框架:
-
Web GUI智能体:SeeAct、WebVoyager、WebAgent、LASER、Search-Agent、WebPilot、WebDreamer、Hybrid Agent、AutoWebGLM、ECLAIR等。
-
移动GUI智能体:AppAgent、MobileAgent、Mobile-Agent-v2、VisionTasker、DroidBot-GPT、CoCo-Agent、CoAT、AutoDroid、MobileGPT、FedMobileAgent等。
-
计算机GUI智能体:UFO、UFO2、Cradle、OS-Copilot、PwP等。
-
跨平台GUI智能体:AutoGLM、TinyClick、OSCAR、AgentStore、MMAC-Copilot、AGUVIS、Agent S2等。
关键趋势:多智能体协同、多模态输入、动作集扩展、新兴决策技术(世界模型、搜索算法)、跨平台泛化、纯视觉智能体。
五、数据收集与优化
论文提出了完整的GUI智能体数据收集管道:
-
数据组成:用户指令、环境感知(截图、控件树、UI属性)、任务轨迹。
-
收集方法:程序生成脚本、人工标注、模型/智能体引导。
-
处理流程:指令实例化、过滤、增强、轨迹记录与评估。
主要数据集:
-
Web:Mind2Web、WebLINX、MultiUI、InSTA等。
-
移动:Rico、PIXELHELP、AITW、META-GUI、MobileViews等。
-
计算机:ScreenAgent、LAM、DeskVision等。
-
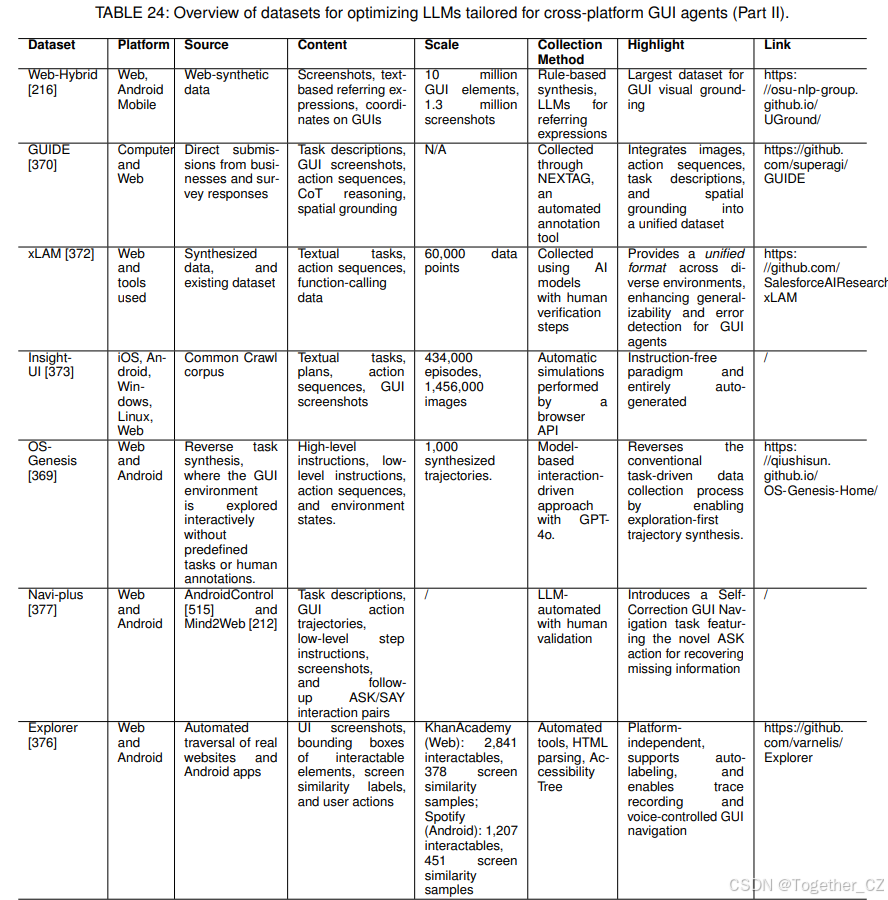
跨平台:ScreenAI、VisualAgentBench、GUI-World、xLAM、OS-Genesis等。
关键要点:规模与多样性、跨平台灵活性、自动化数据收集、统一数据格式。
六、模型优化
论文区分了基础模型和大型动作模型(LAM):
-
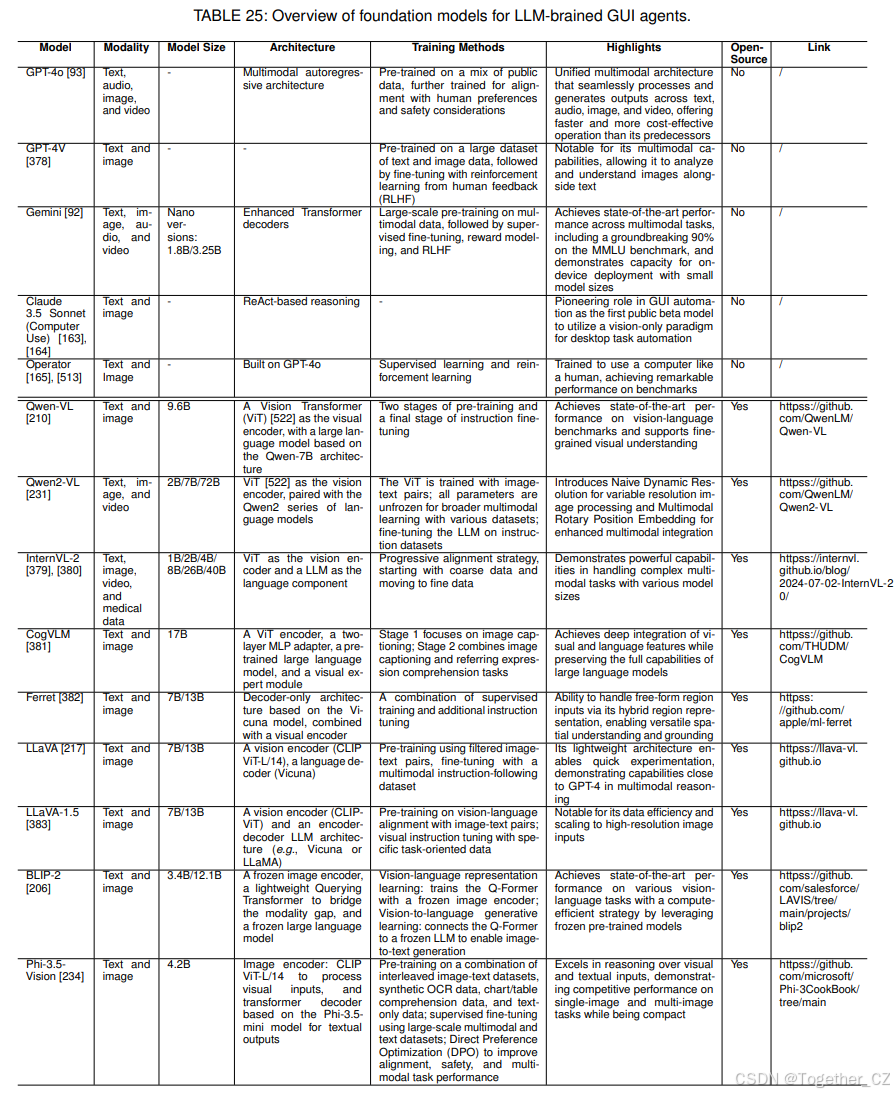
基础模型:闭源(GPT-4V、GPT-4o、Gemini、Claude 3.5 Sonnet、Operator)和开源(Qwen-VL、Qwen2-VL、InternVL-2、CogVLM、Ferret、LLaVA、BLIP-2、Phi-3.5-Vision)。
-
LAM:在GUI特定数据集上微调的基础LLM,具有增强的动作导向性、长复杂任务规划、GUI理解与视觉定位、模型尺寸缩减等优势。
-
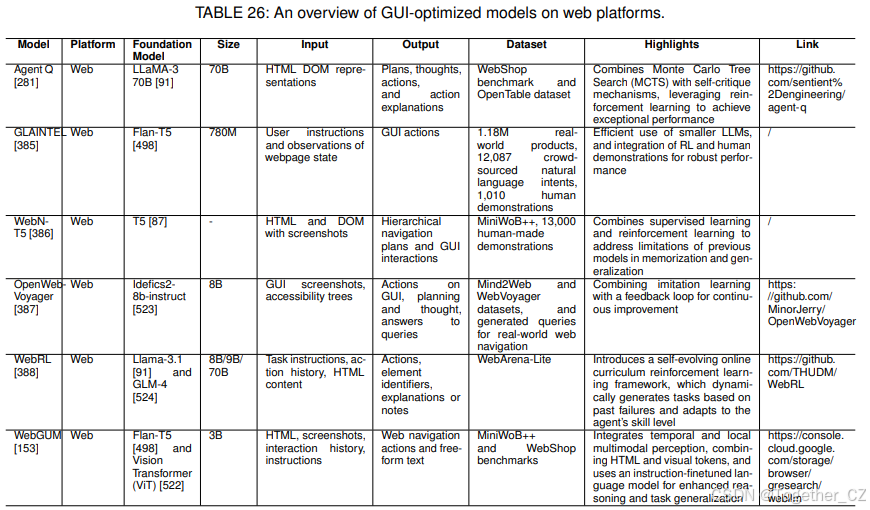
各平台LAM:Web(WebGUM、Agent Q、GLAINTEL、OpenWebVoyager、WebRL)、移动(MobileVLM、DigiRL、Digi-Q、VEM、VGA、UINav、UI-R1、ViMo)、计算机(ScreenAgent、Octopus、LAM、ScreenLLM)、跨平台(CogAgent、Ferret-UI 2、ShowUI、OS-ATLAS、Magma、UI-TARS)。
关键趋势:小模型端侧推理、增强GUI理解减少结构化数据依赖、强化学习弥合静态与动态环境、统一函数调用、推理时计算。
七、评估方法与基准
论文系统梳理了评估指标、测量方法和平台:
-
评估指标:步骤成功率、轮次成功率、任务成功率、效率分数、策略下完成率、风险比率。
-
测量方法:文本匹配、图像匹配、元素匹配、动作匹配、状态信息。
-
评估平台:Web、移动、桌面。
主要基准:
-
Web:MiniWoB++、Mind2Web、WebArena、VisualWebArena、VideoWebArena、WorkArena、BrowserGym、STWebAgentBench等。
-
移动:PIXELHELP、ANDROIDLAB、Mobile-Bench、MobileSafetyBench、SPA-BENCH、MobileAgentBench、LlamaTouch、GTArena等。
-
计算机:Act2Cap、OSWorld、WindowsArena、OFFICEBENCH、Spider2-V、AssistGUI、WorldGUI、Computer Agent Arena等。
-
跨平台:VisualAgentBench、CRAB、ScreenSpot等。
关键趋势:更交互和现实的环境、跨平台基准、增加人类交互、可扩展性与自动化、强调安全隐私合规。
八、应用场景
-
GUI测试:从脚本驱动转向自然语言驱动,涵盖一般测试、文本输入生成、错误复现、验证等。代表工作:GPTDroid、DROID-AGENT、AUITestAgent、VisionDroid、AXNav、CrashTranslator、AdbGPT、BugCraft等。
-
虚拟助手:从简单命令到复杂上下文感知交互,涵盖研究(ProAgent、LLMPA、VizAbility、EasyAsk、GPTVoiceTasker、AutoTask、AssistEditor)、开源项目(OpenAdapt、AgentSea、Open Interpreter)和生产应用(Power Automate、MultiOn、YOYO Agent、Eko)。
九、挑战与未来方向
论文识别了八大挑战:
-
隐私问题:敏感数据上传云端,需端侧推理、联邦学习、差分隐私等。
-
延迟、性能和资源约束:多步执行累积延迟,需模型压缩、硬件加速、边缘计算。
-
安全性和可靠性:动作不可逆、LLM输出不确定,需验证、回滚、权限管理。
-
人机交互:共享界面冲突、指令模糊,需澄清对话、人在环、透明可解释。
-
定制和个性化:用户偏好差异大,需用户建模、偏好学习、隐私保护。
-
伦理和监管挑战:偏见、问责、合规,需伦理指南、审计机制、偏见缓解。
-
可扩展性和泛化:界面动态变化、平台差异,需综合数据集、迁移学习、元学习、知识库。
-
总结:需跨学科合作,持续评估和适应。
LLM与GUI自动化的结合标志着人机交互的变革性时刻。LLM提供"大脑",GUI自动化工具作为"手",共同形成LLM驱动的GUI智能体,允许用户通过自然语言命令控制应用。本综述提供了该领域的全面概述,涵盖核心组件、先进技术、数据、模型、框架、评估和应用,并指出了局限性和未来方向。随着持续研究,LLM驱动的GUI智能体有望从根本上增强生产力和可访问性,重塑人类与数字系统的交互方式。这里是自己的论文阅读记录,感兴趣的话可以参考一下,如果需要阅读原文的话可以看这里,如下所示:
项目地址在这里,如下所示:
摘要------图形用户界面(GUI)长期以来一直是人机交互的核心,为用户访问和操作数字系统提供了直观的、以视觉驱动的方式。传统上,自动化GUI交互依赖于基于脚本或基于规则的方法,这些方法虽然对固定工作流有效,但缺乏动态真实世界应用所需的灵活性和适应性。大语言模型(LLM)的出现,特别是多模态模型,开启了GUI自动化的新时代。它们在自然语言理解、代码生成、任务泛化和视觉处理方面展现出了卓越的能力。这为新一代能够解释复杂GUI元素并基于自然语言指令自主执行动作的"LLM驱动"GUI智能体铺平了道路。这些智能体代表了一种范式转变,使用户能够通过简单的对话命令执行复杂的多步骤任务。它们的应用涵盖网页导航、移动应用交互和桌面自动化,提供了变革性的用户体验,彻底改变了个人与软件的交互方式。这一新兴领域正在迅速发展,研究和工业界都取得了重大进展。为了对这一趋势提供结构化理解,本文对LLM驱动的GUI智能体进行了全面综述,探讨了它们的历史演变、核心组件和先进技术。我们解决了关键的研究问题,例如现有的GUI智能体框架、用于训练专用GUI智能体的数据的收集和利用、为GUI任务定制的大型动作模型的开发,以及评估其有效性所需的评估指标和基准。此外,我们还考察了由这些智能体驱动的新兴应用。通过详细分析,本综述确定了关键的研究空白,并概述了该领域未来发展的路线图。通过整合基础知识和最先进的发展,本工作旨在指导研究者和实践者克服挑战,充分释放LLM驱动的GUI智能体的潜力。我们预计本综述既可以作为构建LLM驱动的GUI智能体的实用指南,也可以作为推动这一快速发展领域研究的权威参考。
索引词------大语言模型,图形用户界面,AI智能体,自动化,人机交互
1 引言
图形用户界面(GUI)一直是人机交互的基石,从根本上改变了用户在数字系统中导航和操作的方式1。GUI旨在使计算更加直观和易于访问,它以视觉驱动的、用户友好的环境取代了命令行界面(CLI)2。通过使用图标、按钮、窗口和菜单,GUI使更广泛的用户能够通过点击、输入和手势等简单操作与计算机交互。这一转变使计算访问民主化,即使是非技术用户也能有效地使用复杂系统。然而,GUI通常为了可用性而牺牲效率,特别是在需要重复或多步骤交互的工作流中,CLI可能仍然更加精简3。
虽然GUI彻底改变了可用性,但其主要针对人类视觉交互而设计的特点,给自动化带来了重大挑战。GUI布局的多样性、动态性和平台特定性,使得开发能够适应各种环境的灵活智能自动化工具变得困难。早期自动化GUI交互的努力主要依赖于基于脚本或基于规则的方法4、5。虽然这些方法对预定义工作流有效,但其范围本质上很窄,主要集中于软件测试和机器人流程自动化(RPA)6等任务。它们的刚性需要频繁手动更新以适应新任务、GUI布局变化或不断演变的工作流,限制了其可扩展性和通用性。此外,这些方法缺乏支持动态的、类人交互所需的复杂性,从而限制了它们在复杂或不可预测场景中的适用性。
大语言模型(LLM)8、9的兴起,特别是那些增强了多模态能力的模型10,已成为GUI自动化的游戏规则改变者,重新定义了智能体与图形用户界面交互的方式。从ChatGPT11等模型开始,LLM在自然语言理解、代码生成和跨多样任务的泛化方面展现出了非凡的能力8、12-14。视觉语言模型(VLM)的集成进一步扩展了这些能力,使这些模型能够处理视觉数据,例如GUI的复杂布局15。这种演变弥合了语言理解和视觉理解之间的鸿沟,使智能体能够以更加类人和自适应的方式与GUI交互。通过利用这些进步,LLM和VLM提供了变革性的潜力,使智能体能够导航复杂的数字环境、动态执行任务,并彻底改变GUI自动化领域。
1.1 LLM驱动的GUI智能体的动机
以LLM作为其"大脑",LLM驱动的GUI自动化引入了一类新型智能体,能够解释用户的自然语言请求、分析GUI屏幕及其元素,并自主执行适当的动作。重要的是,这些能力是在不依赖复杂的平台特定脚本或预定义工作流的情况下实现的。这些智能体被称为"LLM驱动的GUI智能体",可以正式定义为:
在GUI环境中运行的智能体,利用LLM作为其核心推理和认知引擎,以灵活和自适应的方式生成、规划和执行动作。
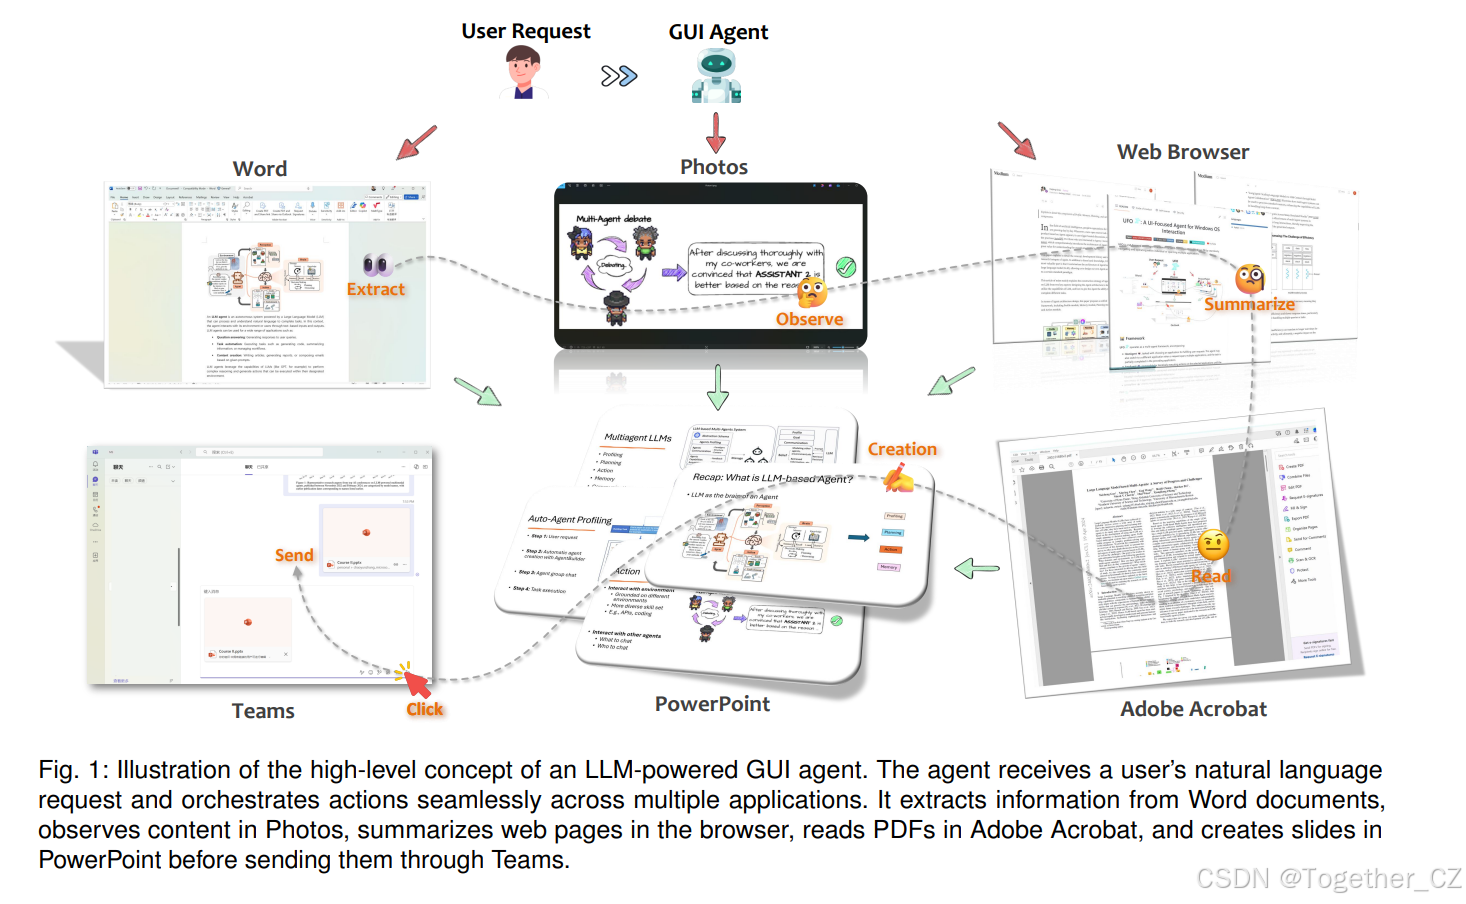
这一范式代表了GUI自动化的变革性飞跃,促进了跨多样平台的动态、类人交互。它使得创建能够推理、实时决策并灵活响应不断演变的任务和环境的智能自适应系统成为可能。我们在图1中展示了这一高层概念。
传统GUI自动化通常受限于预定义规则或狭隘地专注于特定任务,限制了其适应动态环境和多样应用的能力。相比之下,LLM驱动的GUI智能体通过将自然语言理解、视觉识别和决策整合到一个统一框架中,带来了范式转变。这使它们能够泛化到广泛的用例中,转变任务自动化,并显著增强人机交互的直观性和效率。此外,与新兴的纯应用程序编程接口(API)智能体趋势不同------后者依赖于可能并不总是暴露或可访问的API------GUI智能体利用图形界面的通用性。GUI提供了一种控制大多数软件应用的通用机制,使智能体能够以非侵入性的方式运行,无需内部API访问。这一能力不仅拓宽了GUI智能体的适用性,还使外部开发者能够在跨多样平台和生态系统的现有软件之上构建高级功能。这些创新共同将GUI智能体定位为未来智能自动化的多功能变革性技术。
这一新范式使用户能够通过对话命令控制通用软件系统16。通过减少多步骤GUI操作的认知负担,LLM驱动的智能体使复杂系统对非技术用户可访问,并简化了跨多样领域的工作流。值得注意的例子包括用于网页导航的SeeAct17、用于移动交互的AppAgent18和用于Windows操作系统应用的UFO19。这些智能体类似于《钢铁侠》中J.A.R.V.I.S.那样的"虚拟助手"20------一个直观的、自适应的系统,能够理解用户目标并自主跨应用执行动作。一个AI驱动的操作系统以流畅和精确的方式执行跨应用任务的未来概念正在迅速成为现实21、22。
LLM驱动的GUI智能体的真实世界应用已经出现。例如,Microsoft Power Automate利用LLM简化低代码/无代码自动化²,允许用户以最少的技术专业知识设计跨Microsoft应用的工作流。生产力软件中的集成AI助手,如Microsoft Copilot³,正在弥合自然语言指令与应用操作之间的差距。此外,LLM驱动的智能体在增强可访问性方面显示出前景23,可能允许视障用户通过将自然语言命令转换为可执行步骤来更有效地导航GUI。这些发展凸显了LLM驱动的GUI智能体在多样应用中的及时性和变革性潜力。
LLM与GUI自动化的融合解决了人机交互中长期存在的挑战,并引入了智能GUI控制的新机遇24。这种整合催化了研究活动的激增,涵盖应用框架19、数据收集25、模型优化15和评估基准26。尽管取得了这些进展,关键挑战和局限性仍然存在,许多基础问题仍未得到探索。然而,对这一快速发展领域的系统综述明显缺失,留下了理解上的关键空白。
1.2 综述范围
为了填补这一空白,本文提供了对LLM训练的GUI智能体的开创性、全面综述。我们涵盖GUI智能体的历史演变,提供构建这些智能体的逐步指南,总结基本和先进技术,回顾与框架、数据和模型相关的著名工具和研究,展示代表性应用,并概述未来方向。具体而言,本综述旨在回答以下研究问题(RQ):
1)RQ1:LLM驱动的GUI智能体的历史发展轨迹是什么?(第4节)
2)RQ2:构成LLM训练的GUI智能体基础的基本组件和先进技术是什么?(第5节)
3)RQ3:LLM GUI智能体的主要框架是什么,它们的定义特征是什么?(第6节)
4)RQ4:现有数据集是什么,如何收集综合数据集以训练优化的GUI智能体LLM?(第7节)
5)RQ5:收集的数据如何用于训练GUI智能体的专用大型动作模型(LAM),当前该领域的领先模型是什么?(第8节)
6)RQ6:用于评估GUI智能体能力和性能的指标和基准是什么?(第9节)
7)RQ7:LLM驱动的GUI智能体最重要的真实世界应用是什么,它们如何被适配用于实际使用?(第10节)
8)RQ8:开发鲁棒和智能GUI智能体的主要挑战、局限性和未来研究方向是什么?(第11节)
通过这些研究问题,本综述旨在提供该领域当前状态的全面概述,提供构建LLM训练的GUI智能体的指南,识别关键研究空白,并提出未来工作的方向。本综述是系统考察LLM训练的GUI智能体领域的先驱之一,整合了LLM进展、GUI自动化和人机交互的视角。
1.3 综述结构
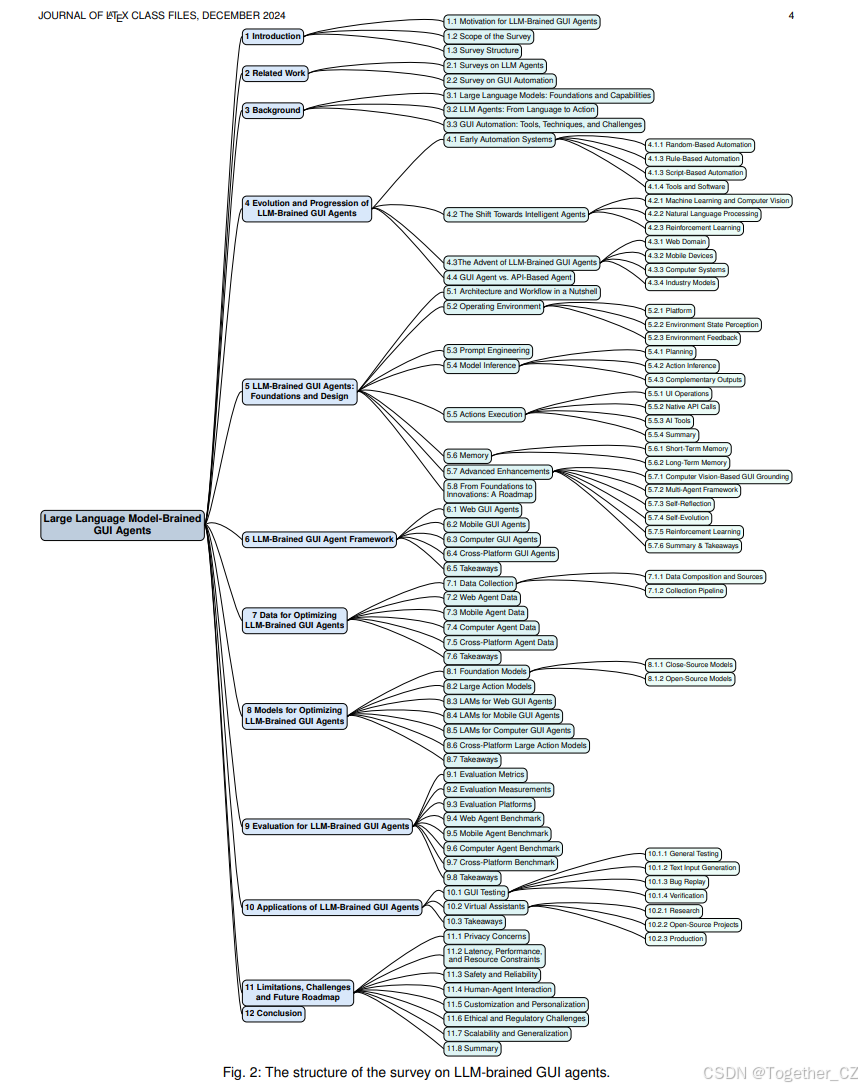
本综述组织如下,结构图示见图2。第2节回顾了关于LLM智能体和GUI自动化的相关综述和评论文献。第3节提供了LLM、LLM智能体和GUI自动化的初步背景。第4节追溯了LLM驱动的GUI智能体的演变。第5节介绍了LLM驱动的GUI智能体中的关键组件和先进技术,作为全面指南。第6节介绍了LLM驱动的GUI智能体的代表性框架。第7节讨论了数据集收集和与优化GUI智能体LLM相关的数据中心研究。第8节涵盖了GUI智能体的基础模型和优化模型。第9节概述了评估指标和基准。第10节探讨了真实世界应用和用例。最后,第11节考察了当前的局限性、挑战和潜在未来方向,第12节总结了本综述。为清晰起见,表1提供了缩写列表。
2 相关工作
LLM与GUI智能体的整合是一个新兴且快速发展的研究领域。一些相关综述和教程提供了基础性见解和指导。我们简要回顾了关于GUI自动化和LLM智能体的现有概述文章,因为这些主题与我们的研究重点密切相关并为其提供信息。首先,我们概述了关于GUI自动化、LLM智能体及其整合的代表性综述和书籍,总结在表2中。这些工作要么直接解决GUI自动化和LLM驱动智能体的一个或两个核心领域,要么提供有价值的见解,虽然不直接解决该主题,但间接有助于推动该领域的发展。
2.1 GUI自动化综述
GUI自动化有着悠久的历史和广泛的工业应用,特别是在GUI测试27-29和任务自动化RPA6、42方面。
Said等人30提供了移动应用GUI测试的概述,涵盖了该领域的目标、方法和挑战。Li31进一步缩小了范围,专注于Android应用,而Oksanen等人32探索了Windows GUI应用的自动测试技术,这是智能体操作的关键平台。类似地,Moura等人72回顾了Web应用的GUI测试,涉及多样的工具、输入和方法。Deshmukh等人33讨论了用于增强用户体验的自动化GUI测试,这是LLM也带来新能力的领域。现代GUI测试的基石是计算机视觉(CV),用于解释UI元素并识别可操作控件34。Yu等人35综述了CV在移动GUI测试中的应用,强调了其重要性和相关挑战。在LLM驱动的GUI智能体中,应用UI截图同样至关重要,作为可靠任务理解和执行的关键输入。
另一方面,RPA专注于自动化重复性人工任务,也严重依赖GUI自动化来完成相关流程。Syed等人36综述了该领域并强调了当代RPA主题,确定了未来研究的关键挑战。Chakraborti等人37强调了从传统的基于脚本的RPA向更智能、自适应范式转变的重要性,提供了这一方向进展的系统概述。鉴于RPA广泛的工业应用,Enriquez等人38和Ribeiro等人39从工业角度综述了该领域,强调了其重要性并提供了RPA方法、发展趋势和实际挑战的全面概述。
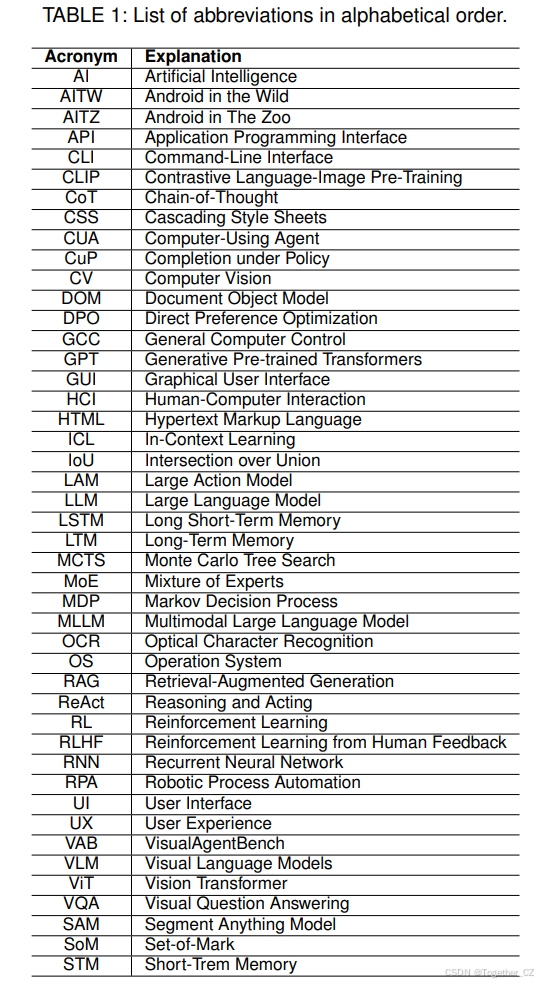
GUI测试40和RPA41在实现更高智能和鲁棒性方面继续面临重大挑战。LLM驱动的GUI智能体有望在这些领域发挥变革性作用,提供增强的能力并增加实质性价值以解决这些持续存在的问题。
2.2 LLM智能体综述
LLM的出现显著增强了智能体的能力43,使它们能够解决以前无法完成的复杂任务,特别是涉及自然语言理解和代码生成的任务44。这一进步推动了对为广泛应用设计的基于LLM的智能体的大量研究45。
Xie等人46和Wang等人47都提供了关于LLM驱动智能体的全面综述,涵盖基本背景信息、详细组件分解、分类法和各种应用。这些综述为理解LLM驱动的智能体提供了有价值的基础参考,为进一步探索基于LLM的GUI智能体奠定了基础。Xie等人59提供了多模态智能体的广泛概述,这些智能体除了文本外还可以处理图像、视频和音频。这种多模态能力显著拓宽了传统基于文本智能体的范围60。值得注意的是,大多数GUI智能体属于这一类别,因为它们依赖图像输入(如截图)来有效解释和交互图形界面。多智能体框架经常被用于GUI智能体的设计中,以增强其能力和可扩展性。Guo等人48和Han等人49的综述提供了该领域当前格局、挑战和未来方向的全面概述。Sun等人50概述了利用强化学习加强多智能体LLM系统的近期方法,为增强其能力和适应性开辟了新途径。这些综述为在GUI智能体框架内设计有效的多智能体系统提供了有价值的见解和指导。
在数字环境领域,Wu等人61提出了关于在移动环境中运行的LLM智能体的综述,涵盖了移动GUI智能体的关键方面。在更广泛的范围内,Wang等人62提出了关于基础模型与GUI智能体整合的综述。Gao等人的另一篇综述提供了跨各种数字平台运行的自主智能体的概述63,强调了它们的能力、挑战和应用。所有这些综述都突出了该领域的新兴趋势。
关于LLM智能体内的各个组件,一些综述提供了对GUI智能体特别相关的详细见解。Huang等人51考察了LLM智能体中的规划机制,这对于执行长期任务至关重要------这是GUI自动化中的常见需求。Zhang等人54探索了记忆机制,允许智能体存储关键历史信息,有助于知识保留和决策。此外,Shen13综述了LLM使用工具(如API和代码)与环境有效交互的方式,以产生切实影响的方式将动作落地。此外,Chang等人55提供了关于LLM评估方法的全面综述,这对于确保GUI智能体的鲁棒性和安全性至关重要。另外两篇综述56和58提供了专门针对多模态LLM的基准和评估方法的全面概述。评估还促进了一个反馈循环,允许智能体基于评估结果迭代改进。这些综述共同作为有价值的资源,提供了关于LLM智能体基本组件的指导,并为基于LLM的GUI智能体奠定了基础知识。
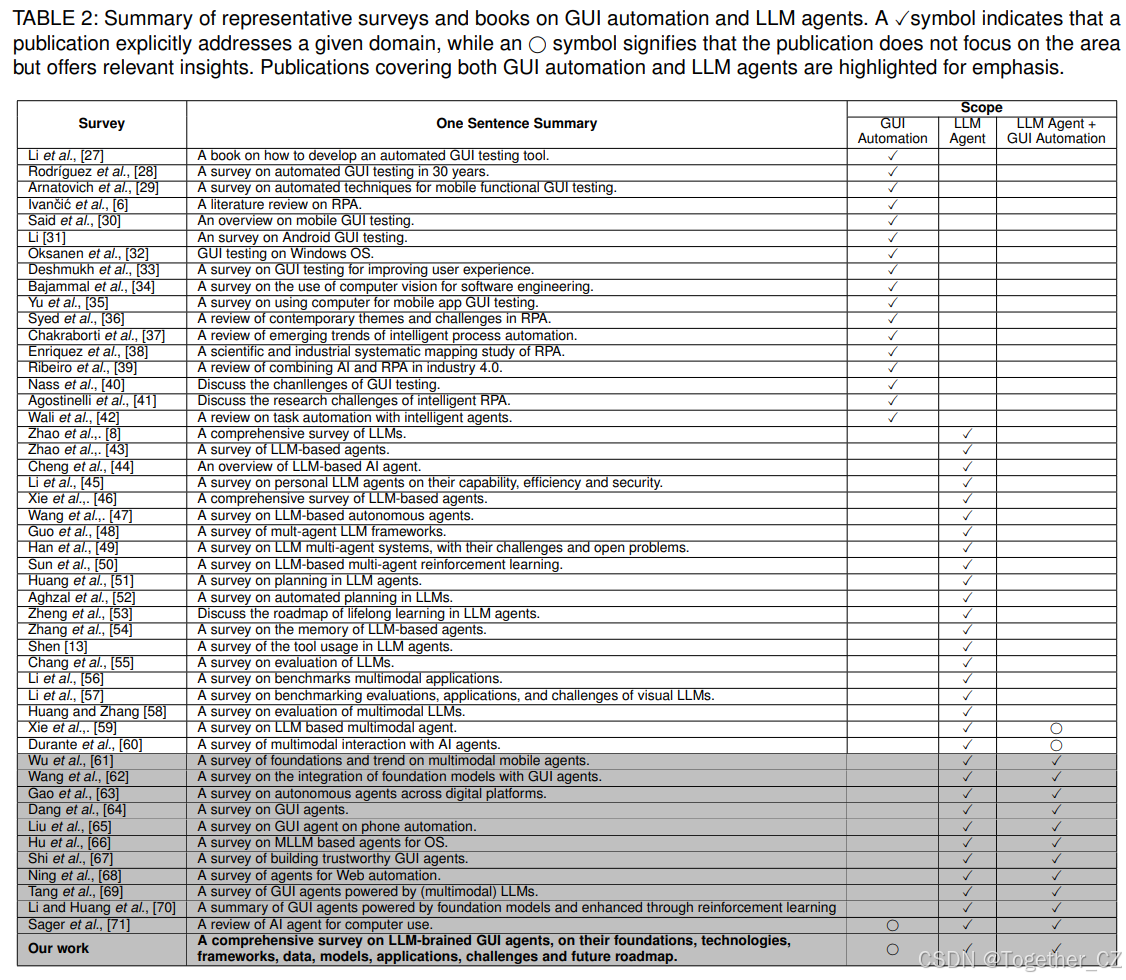
与现有综述相比,我们的工作提供了对LLM驱动的GUI智能体格局更加全面和最新的概述。我们整理并综合了500多篇参考文献,涵盖基础模型、数据源、系统框架、基准、评估方法和实际部署等广泛主题。虽然之前的综述通常集中在选定平台(如Web、移动)的较窄方面,但我们的综述采取了跨越整个开发和部署生命周期的整体视角。除了叙述性总结外,我们还为每个子领域提供了综合参考表,使读者能够跨平台和研究主题快速分类和定位相关工作------既可作为研究者的实用手册,也可作为实践者的参考。此外,我们纳入了基础背景材料,并提出了评估方法。
3 背景
LLM训练的GUI智能体的发展基于三大进步:(i)大语言模型(LLM)8,它们在自然语言理解和代码生成方面带来了先进能力,构成了这些智能体的核心智能;(ii)伴随的智能体架构和工具47,它们扩展了LLM能力,弥合了语言模型与物理环境之间的差距,以实现切实影响;(iii)GUI自动化73,它培育了一套对GUI智能体功能至关重要的鲁棒工具、模型和方法论。这些组件中的每一个都在LLM驱动的GUI智能体的出现中发挥了关键作用。在以下小节中,我们简要概述这些领域,为我们的讨论奠定基础。
3.1 大语言模型:基础与能力
语言模型的研究有着悠久而丰富的历史74,从早期的统计语言模型75和较小的神经网络架构76开始。在这些基础概念之上,最近的进展集中在基于Transformer的LLM上,如生成式预训练Transformer(GPT)77。这些模型在广泛的文本语料库上预训练,具有显著更大的模型规模,验证了缩放定律,并在广泛的自然语言任务中展现出卓越的能力。除了其庞大的规模外,这些LLM还展现出增强的语言理解和生成能力,以及较小规模语言模型中不存在的涌现特性78。
早期的神经语言模型基于循环神经网络(RNN)79和长短期记忆网络(LSTM)80等架构,在性能和泛化方面都受到限制。Transformer模型的引入,建立在注意力机制81之上,标志着一个变革性的里程碑,建立了现在几乎所有后续LLM中普遍存在的基础架构。这一发展导致了模型结构的变体,包括仅编码器模型(如BERT82、RoBERTa83、ALBERT84)、仅解码器模型(如GPT-185、GPT-286)和编码器-解码器模型(如T587、BART88)。2022年,基于GPT-3.589的ChatGPT11作为突破性的LLM推出,从根本上改变了人们对语言模型可以实现什么的看法。此后,许多先进的LLM涌现,包括GPT-490、LLaMA-391和Gemini92,推动该领域快速增长。今天的LLM高度通用,其中许多能够处理多模态数据并执行从问答到代码生成的一系列任务,使其成为各种应用中不可或缺的工具93-96。
LLM的出现还引入了重要的先进特性,为其应用注入活力,使以前具有挑战性的任务(如自然语言驱动的GUI智能体)变得可行。这些进步包括:
1)少样本学习77:也称为上下文学习97,LLM可以在推理期间从提示中呈现的少量演示示例中获取新任务,无需重新训练。这一能力对于使GUI智能体能够以最小努力跨不同环境泛化至关重要。
2)指令遵循98:经过指令调优后,LLM展现出遵循新任务指令的卓越能力,表现出强大的泛化技能89。这允许LLM有效理解针对GUI智能体的用户请求,并准确遵循预定义目标。
3)长期推理99:LLM具有通过将复杂任务分解为可管理步骤来规划和解决复杂任务的能力,通常采用思维链(CoT)推理等技术100、101。这一能力对GUI智能体至关重要,因为许多任务需要多个步骤和强大的规划框架。
4)代码生成和工具利用102:LLM擅长生成代码和利用各种工具,如API13。这种专业知识至关重要,因为代码和工具构成了GUI智能体与环境交互的基本工具包。
5)多模态理解10:先进的LLM可以将额外的数据模态(如图像)整合到其训练过程中,演变为多模态模型。这一能力对GUI智能体尤为重要,因为它们必须解释以图像形式呈现的GUI截图才能有效运作103。
为了进一步增强LLM对GUI智能体的专业化,研究人员通常使用领域特定数据(如用户请求、GUI截图和动作序列)微调这些模型,从而提高其定制化和有效性。在第8节中,我们深入探讨这些先进的、为GUI智能体定制的模型,讨论其独特适配和改进的图形界面交互能力。
3.2 LLM智能体:从语言到行动
传统AI智能体通常专注于增强特定能力,如符号推理或在特定任务(如围棋或国际象棋)中表现出色。相比之下,LLM的出现通过为AI智能体提供自然语言界面、实现类人决策能力,并装备它们执行各种任务和在多样环境中采取切实行动,从而改变了AI智能体12、47、104、105。在LLM智能体中,如果LLM构成GUI智能体的"大脑",那么其伴随组件则充当其"眼睛和手",使LLM能够感知环境状态并将其文本输出转化为产生切实影响的可操作步骤46。这些组件将LLM从被动信息源转变为代表用户执行任务的交互式智能体,重新定义了LLM的角色,从纯文本生成模型转变为能够驱动行动和实现特定目标的系统。
在GUI智能体的背景下,智能体通常通过截图和控件树106感知GUI状态,然后执行模仿用户操作的动作(例如,鼠标点击、键盘输入、手机上的触摸手势)在环境中。由于任务可能是长期的,通常需要有效的规划和任务分解,这带来了独特的挑战。因此,LLM驱动的GUI智能体通常具备多模态能力59、鲁棒的规划系统51、分析历史交互的记忆机制54以及与环境交互的专用工具包27。我们将在第5节详细讨论这些为GUI智能体量身定制的设计。
3.3 GUI自动化:工具、技术与挑战
自计算中GUI早期以来,GUI自动化一直是研究和应用的关键领域。最初为提高软件测试效率而开发,GUI自动化专注于在图形应用中模拟用户操作,如点击、文本输入和导航,以验证功能30。早期的GUI自动化工具设计用于在静态界面上执行重复测试用例28。这些方法简化了质量保证流程,确保一致性并减少手动测试时间。随着数字解决方案需求的增长,GUI自动化已超越测试扩展到其他应用,包括RPA6和人机交互(HCI)107。RPA利用GUI自动化在业务工作流中复制人类操作,自动化日常任务以提高运营效率。类似地,HCI研究采用GUI自动化模拟用户行为,实现可用性评估和交互研究。在这两种情况下,自动化都通过最小化重复任务和实现更大的系统适应性,显著提高了生产力和用户体验108、109。
传统GUI自动化方法主要依赖脚本和基于规则的框架4、110。基于脚本的自动化利用Python、Java和JavaScript等语言以编程方式控制GUI元素。这些脚本模拟用户在界面上的操作,通常使用Selenium111等工具进行基于Web的自动化,或使用AutoIt112和SikuliX113进行桌面应用。同时,基于规则的方法基于预定义启发式操作,使用规则根据位置、颜色和文本标签等属性检测和交互特定GUI元素4。虽然对可预测的静态工作流有效114,但这些方法难以适应现代GUI的变异性,其中动态内容、响应式布局和用户驱动的变化使维护刚性、基于规则的自动化变得具有挑战性115。
CV已成为解释GUI视觉方面的 essential 技术35、116、117,使自动化工具能够识别和交互屏幕元素,即使布局和设计发生变化。CV技术允许GUI自动化系统通过分析截图和识别感兴趣区域来检测和分类屏幕元素,如按钮、图标和文本字段118-120。光学字符识别(OCR)通过从图像中提取文本内容进一步增强这一能力,使自动化系统能够准确解释标签、错误消息和表单说明121。目标检测模型增加了鲁棒性,允许自动化智能体即使视觉布局发生变化也能定位GUI元素103。通过整合CV,GUI自动化系统在动态环境中实现了更大的韧性和适应性。
尽管取得了进展,传统GUI自动化方法在處理当代界面的复杂性和变异性方面仍然不足。今天的应用通常具有动态、自适应元素,无法仅通过刚性脚本或基于规则的方法可靠地自动化122、123。现代界面越来越需要上下文感知124,例如处理屏幕文本、解释用户意图和识别视觉线索。这些需求揭示了现有自动化框架的局限性,以及对能够实时适应和上下文敏感响应的更灵活解决方案的需求。
LLM为这些挑战提供了有前景的解决方案。凭借其理解自然语言、解释上下文和生成自适应脚本的能力,LLM可以实现更智能、多功能的GUI自动化125。它们处理复杂指令和从上下文学习的能力使它们能够弥合静态、基于规则的方法与当代GUI动态需求之间的差距126。通过将LLM与GUI智能体整合,这些系统获得了根据界面当前状态即时生成脚本的能力,提供了传统方法无法实现的适应性和复杂性水平。LLM和GUI智能体的结合为先进的、以用户为中心的自动化范式铺平了道路,能够灵活响应用户请求并无缝交互复杂、不断演变的界面。
4 LLM驱动的GUI智能体的演变与进展
"罗马不是一天建成的。"LLM训练的GUI智能体的发展是一个渐进的过程,建立在数十年的研究和技术进步之上。从简单的GUI测试脚本和基于规则的自动化框架开始,该领域通过整合机器学习技术而显著发展,创造了更智能和自适应的系统。LLM的引入,特别是多模态模型,通过实现自然语言交互并从根本上重塑用户与软件应用的交互方式,改变了GUI自动化。
如图3所示,在2023年LLM出现之前,GUI智能体的工作在范围和能力上都有限。此后,基于LLM的方法的激增促进了跨平台(包括Web、移动和桌面环境)的众多显著发展。这一激增仍在继续,并持续推动该领域的创新。本节带您踏上一段追溯GUI智能体演变的旅程,强调将该领域带到当前状态的关键里程碑。
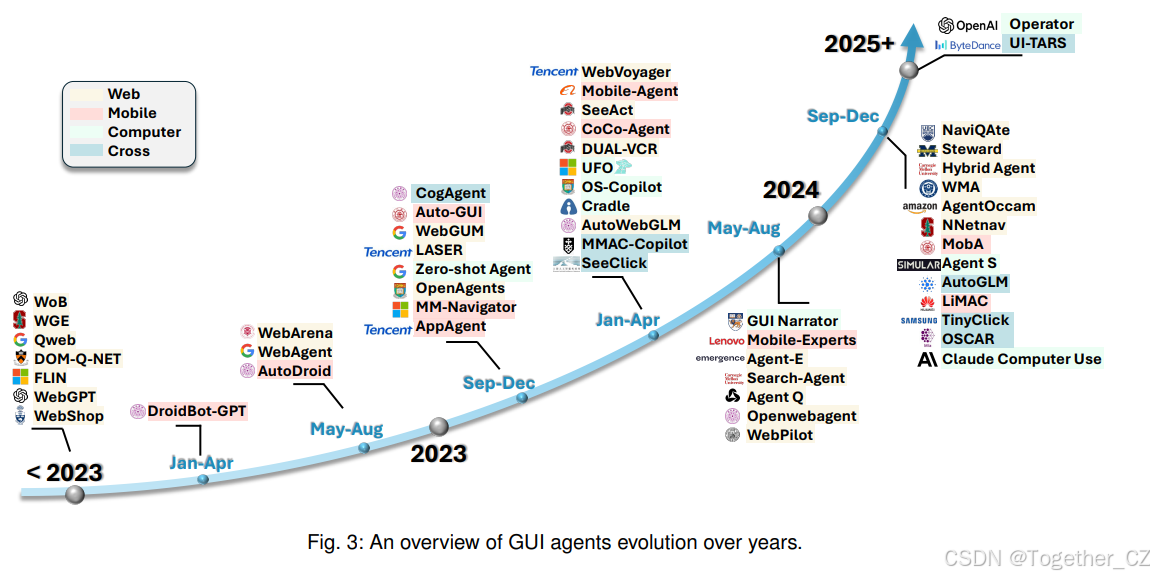
4.1 早期自动化系统
在GUI自动化的初始阶段,研究人员依赖基于随机、基于规则和基于脚本的策略。虽然这些方法是基础性的,但在灵活性和适应性方面存在明显局限性。
4.1.1 基于随机的自动化
基于随机的自动化在GUI中使用随机动作序列,不依赖特定算法或结构化模型,使用猴子测试127。这种方法广泛用于GUI测试,通过探索不可预测的输入序列来发现潜在问题128。虽然在识别边缘情况和错误方面有效,但基于随机的方法由于大量冗余或不相关的试验而通常效率低下。
4.1.2 基于规则的自动化
基于规则的自动化应用预定义规则和逻辑来自动化任务。2001年,Memon等人129引入了一种规划方法,通过一系列预定义操作符将初始状态转换为目标状态来生成GUI测试用例。Hellmann等人4(2011)展示了基于规则的方法在探索性测试中的潜力,增强了错误检测。在RPA领域,SmartRPA130(2020)使用基于规则的处理来自动化日常任务,说明了规则在简化结构化流程中的效用。
4.1.3 基于脚本的自动化
基于脚本的自动化依赖详细脚本来管理GUI交互。jRapture5(2000)等工具使用Java二进制文件和JVM记录和重放基于Java的GUI序列,通过精确重现输入序列实现一致执行。类似地,DART131(2003)自动化了GUI测试生命周期,从结构分析到测试用例生成和执行,为回归测试提供了综合框架。
4.1.4 工具和软件
在此期间,为GUI测试和业务流程自动化开发了一系列软件工具。Microsoft Power Automate132(2019)提供了低代码/无代码环境,用于在Microsoft应用中创建工作流。Selenium133(2004)支持跨浏览器Web测试,而Appium134(2012)促进了移动UI自动化。商业工具如TestComplete135(1999)、Katalon Studio136(2015)和Ranorex137(2007)允许用户创建具有跨平台能力的自动化测试。
虽然这些早期系统对自动化特定的预定义工作流有效,但它们缺乏灵活性,需要手动脚本或基于规则的逻辑。尽管如此,它们建立了GUI自动化的基础,更智能的系统在此基础上构建。
4.2 向智能智能体的转变
机器学习的引入标志着向更自适应和更有能力的GUI智能体的重大转变。这一阶段的早期里程碑包括机器学习、自然语言处理、计算机视觉和强化学习应用于GUI任务的进步。
4.2.1 机器学习和计算机视觉
RoScript110(2020)是一个开创性系统,引入了用于触摸屏应用的非侵入式机器人测试系统,将GUI自动化扩展到多样平台。AppFlow138(2018)使用机器学习识别常见屏幕和UI组件,实现广泛应用类别的模块化测试。计算机视觉的进步也使GUI测试取得了重大进展,框架117(2010)自动化了视觉交互任务。Humanoid139(2019)使用在Android系统内人类交互轨迹上训练的深度神经网络模型来学习用户如何基于应用的GUI选择动作。该模型随后用于指导测试输入生成,在测试期间产生改进的覆盖率和更类人的交互模式。类似地,Deep GUI140(2021)应用深度学习技术过滤屏幕中不相关的部分,从而通过仅关注重要元素来增强GUI测试中的黑盒测试有效性。这些方法展示了深度学习通过使GUI测试更接近实际用户行为,使其更高效和直观的潜力。
控件检测,如White等人103(2019)所展示的,利用计算机视觉准确识别UI元素,作为一种支持技术,实现更智能和响应式的UI自动化。通过检测和分类界面组件,这种方法增强了智能体与复杂动态GUI有效交互的能力141。
4.2.2 自然语言处理
自然语言处理能力为GUI自动化引入了新维度。RUSS142(2021)和FLIN143(2020)等系统允许用户通过自然语言命令控制GUI,弥合了人类语言和机器动作之间的差距。数据集,如144(2020)中的数据集,通过将自然语言指令映射到移动UI动作,进一步推动了该领域的发展,为GUI控制开辟了更广泛的应用。然而,这些方法仅限于处理简单的自然命令,不具备管理长期任务的能力。
4.2.3 强化学习
World of Bits(WoB)145(2017)等环境的开发使得使用强化学习(RL)训练基于Web的智能体成为可能。工作流引导探索146(2018)提高了RL效率和任务性能。DQT147(2024)应用深度强化学习通过保留控件结构和语义来自动化Android GUI测试,而AndroidEnv148(2021)为Android上的智能体训练提供了逼真的模拟。WebShop149(2022)展示了大规模Web交互的潜力,强调了RL驱动的GUI自动化日益增长的复杂性。
虽然这些基于机器学习的方法比早期的基于规则的系统更具适应性150、151,但它们仍然难以泛化到多样、不可预见的任务。它们对预定义工作流的依赖和有限的适应性需要为新环境进行重新训练或定制,自然语言控制仍然有限。
4.3 LLM驱动的GUI智能体的出现
LLM的引入,特别是GPT-4o93(2023)等多模态模型,通过允许通过自然语言进行直观交互,彻底改变了GUI自动化。与之前需要整合单独模块的方法不同,LLM为GUI自动化提供了端到端解决方案,提供自然语言理解、视觉识别和推理方面的高级能力。
LLM为GUI智能体提供了几个独特优势,包括自然语言理解、多模态处理、规划和泛化。这些特性使LLM和GUI智能体成为强大的组合。虽然之前已有探索,但2023年标志着LLM驱动的GUI智能体的关键一年,在Web、移动和桌面应用等各个平台都取得了重大发展。
4.3.1 Web领域
LLM在GUI自动化中的初步应用是在Web领域,早期研究建立了基准数据集和环境145、149。一个关键里程碑是WebAgent152(2023),它与WebGUM153(2023)一起开创了使用LLM的真实世界Web导航。这些进步为后续发展17、154、155铺平了道路,利用更专业的LLM增强基于Web的交互。
4.3.2 移动设备
LLM整合到移动设备始于AutoDroid156(2023),它将LLM与领域特定知识结合用于智能手机自动化。MM-Navigator157(2023)、AppAgent18(2023)和Mobile-Agent158(2023)等额外贡献实现了对智能手机应用的精细控制。研究继续通过模型微调159、160(2024)提高移动GUI自动化的准确性。
4.3.3 计算机系统
对于桌面应用,UFO19(2024)是最早利用具有视觉能力的GPT-4在Windows环境中完成用户命令的系统之一。Cradle161(2024)将这些能力扩展到软件应用和游戏,而Wu等人162(2024)提供了跨多样桌面应用的交互,包括Web浏览器、代码终端和多媒体工具。
4.3.4 行业模型
在工业界,Claude 3.5 Sonnet模型163(2024)引入了"计算机使用"功能,能够通过UI操作与桌面环境交互164。这标志着业界日益认识到LLM驱动的GUI智能体作为有价值的应用,利益相关者越来越多地投资于这项技术。
OpenAI迅速跟进,于2025年发布了Operator165,这是一个类似于Claude的计算机使用智能体(CUA),在各种基准上实现了最先进的性能。这一发展凸显了行业对GUI智能体价值的认可及其在该领域日益增长的投资。随着兴趣的持续激增,GUI智能体的研究和开发预计将变得越来越有竞争力,标志着快速演变格局的开始。
毫无疑问,LLM引入了新的范式,并以以前无法实现的方式提高了GUI智能体的智能。随着该领域的不断发展,我们预计将出现商业化浪潮,导致用户与GUI应用交互的变革性变化。
4.4 GUI智能体 vs. 基于API的智能体
在数字环境中运行的LLM驱动智能体领域,动作空间可以大致分为两种类型:
1)GUI智能体,主要依赖GUI操作(如点击、按键)来完成任务。
2)基于API的智能体,利用系统或应用原生API来实现目标。
我们在图4中展示了两种智能体类型的原理。每种类型都有独特的优势,深入理解这些方法对于设计有效的智能体至关重要。
GUI操作提供了一种通用控制界面,可以使用相同的动作原语跨多样应用操作。这使GUI智能体高度可泛化,因为它们可以与广泛的软件环境交互,无需应用特定适配。然而,基于GUI的交互本质上更复杂;即使简单任务也可能需要多个顺序步骤,这增加了智能体的决策成本和长期多步骤工作流所需的计算资源。另一个关键方面是GUI智能体中动作的透明度。由于GUI智能体以与人类相同的方式与应用交互,通过点击、输入和导航界面,它们的动作本质上更可观察和可解释。这种透明度促进了智能体-计算机交互中更好的信任和理解。
相比之下,基于API的智能体提供了更高效和直接的任务完成方法。通过利用原生API,任务通常可以通过单个精确调用完成,显著减少执行时间和复杂性。然而,这些原生API通常是私有的或限于特定应用,限制了可访问性和通用性。这使基于API的智能体在API访问不可用或不足的场景中不那么通用。此外,基于API的智能体在后台运行,通过直接系统调用执行任务,虽然通常更高效和可靠,但可能使其操作对最终用户不那么可见和难以调试。
最有效的数字智能体可能以混合方式运行,结合两种方法的优势。这样的智能体可以利用GUI操作实现跨软件的广泛兼容性,同时在可用的情况下利用原生API最大化效率和有效性。这些混合智能体在泛化和任务优化之间取得平衡,使其成为本综述的关键焦点领域。关于GUI智能体和API智能体之间更全面的比较,请参考166。
5 LLM驱动的GUI智能体:基础与设计
本质上,LLM训练的GUI智能体旨在处理以自然语言给出的用户指令或请求,通过截图或UI元素树解释GUI的当前状态,并在各种软件界面中执行模拟人类交互的动作19。这些智能体利用LLM复杂的自然语言理解、推理和生成能力,准确理解用户意图、评估GUI上下文,并自主跨多样环境与应用交互,从而完成复杂的多步骤任务。这种整合使它们能够无缝解释和响应用户请求,为GUI自动化带来适应性和智能。
作为LLM智能体的一种 specialized 类型,大多数当前GUI智能体采用类似的基础框架,整合规划、记忆、工具使用和多智能体协作等高级增强等核心组件47。然而,每个组件都必须量身定制以满足GUI智能体的特定目标,以确保在各种应用环境中的适应性和功能性。
在以下小节中,我们深入概述每个组件,提供从头构建LLM驱动的GUI智能体的实用指南和教程。这一全面分解可作为创建有效和智能GUI自动化系统的指南,利用LLM的能力。
5.1 架构和工作流概述
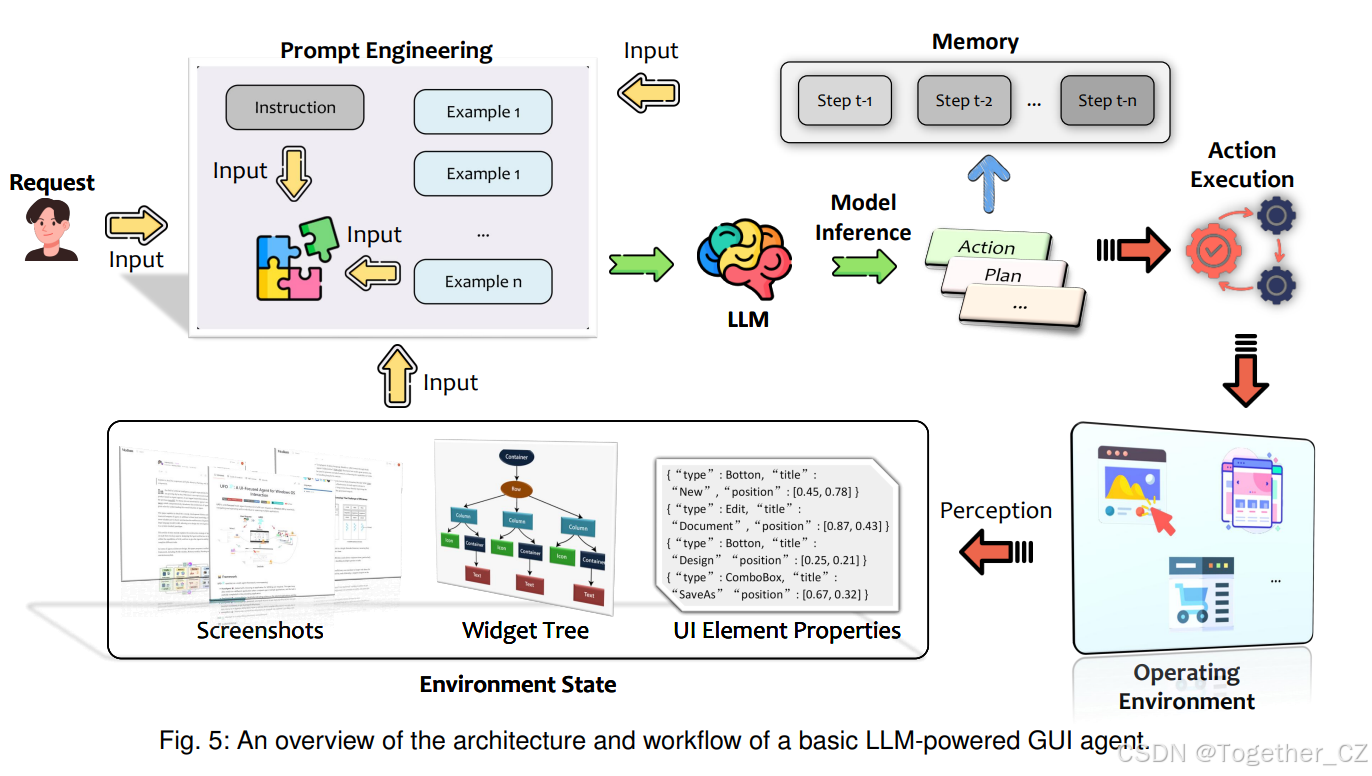
在图5中,我们展示了LLM训练的GUI智能体的架构,展示了从用户输入到任务完成的操作序列。该架构包含几个集成组件,每个组件都有助于智能体基于用户提供的自然语言指令解释和执行任务的能力。在收到用户请求后,智能体遵循系统化工作流,包括环境感知、提示工程、模型推理、动作执行和持续记忆利用,直到任务完全完成。
一般来说,它包括以下组件:
1)操作环境:环境定义了智能体的操作上下文,包括移动设备、Web浏览器和Windows等桌面操作系统等平台。为了有意义地交互,智能体通过截图、控件树或其他捕获UI结构的方法感知环境的当前状态167。它持续监控每个动作影响的反馈,实时调整策略以确保有效任务进展。
2)提示工程:在环境感知之后,智能体构建详细提示以指导LLM的推理168。该提示包含用户指令、处理的视觉数据(如截图)、UI元素布局、属性以及与任务相关的任何额外上下文。这种结构化输入最大化LLM生成连贯、上下文感知响应的能力,与当前GUI状态一致。
3)模型推理:构建的提示传递给LLM,即智能体的推理核心,它产生完成用户请求所需的计划、动作和见解序列。该模型可以是通用LLM或使用GUI特定数据微调的专用模型,实现对GUI交互、用户流和任务要求更细致的理解。
4)动作执行:基于模型的推理结果,智能体识别任务执行所需的特定动作(如鼠标点击、键盘输入、触摸屏手势或API调用)13。智能体内的执行器将这些高级指令转换为直接影响GUI的可操作命令,有效模拟跨多样应用和设备的类人交互。
5)记忆:对于多步骤任务,智能体维护内部记忆以跟踪先前动作、任务进度和环境状态54。该记忆确保复杂工作流中的连贯性,因为智能体可以引用先前步骤并相应调整其动作。还可以纳入外部记忆模块以实现持续学习、访问外部知识和增强对新环境或要求的适应性。
通过迭代遍历这些阶段并组装基础组件,LLM驱动的GUI智能体智能地操作,无缝适应各种软件界面,弥合基于语言的指令和具体行动之间的差距。每个组件对智能体的鲁棒性、响应性和在动态环境中处理复杂任务的能力都至关重要。在以下小节中,我们详细介绍了每个组件背后的设计和核心技术,提供了从头构建LLM驱动的GUI智能体的全面指南。
5.2 操作环境
LLM驱动的GUI智能体的操作环境包括各种平台,如移动、Web和桌面操作系统,这些智能体可以在其中与图形界面交互。每个平台都有影响GUI智能体感知、解释和行动方式的独特特征。每个平台的GUI示例见图6。本节详细介绍了每个平台的细微差别、智能体收集环境信息的方式,以及它们在适应多样操作环境时面临的挑战。
5.2.1 平台
LLM驱动的GUI智能体的操作环境包括各种平台,如移动、Web和桌面操作系统,这些智能体可以在其中与图形界面交互。每个平台都有影响GUI智能体感知、解释和行动方式的独特特征。每个平台的GUI示例见图6。本节详细介绍了每个平台的细微差别、智能体收集环境信息的方式,以及它们在适应多样操作环境时面临的挑战。
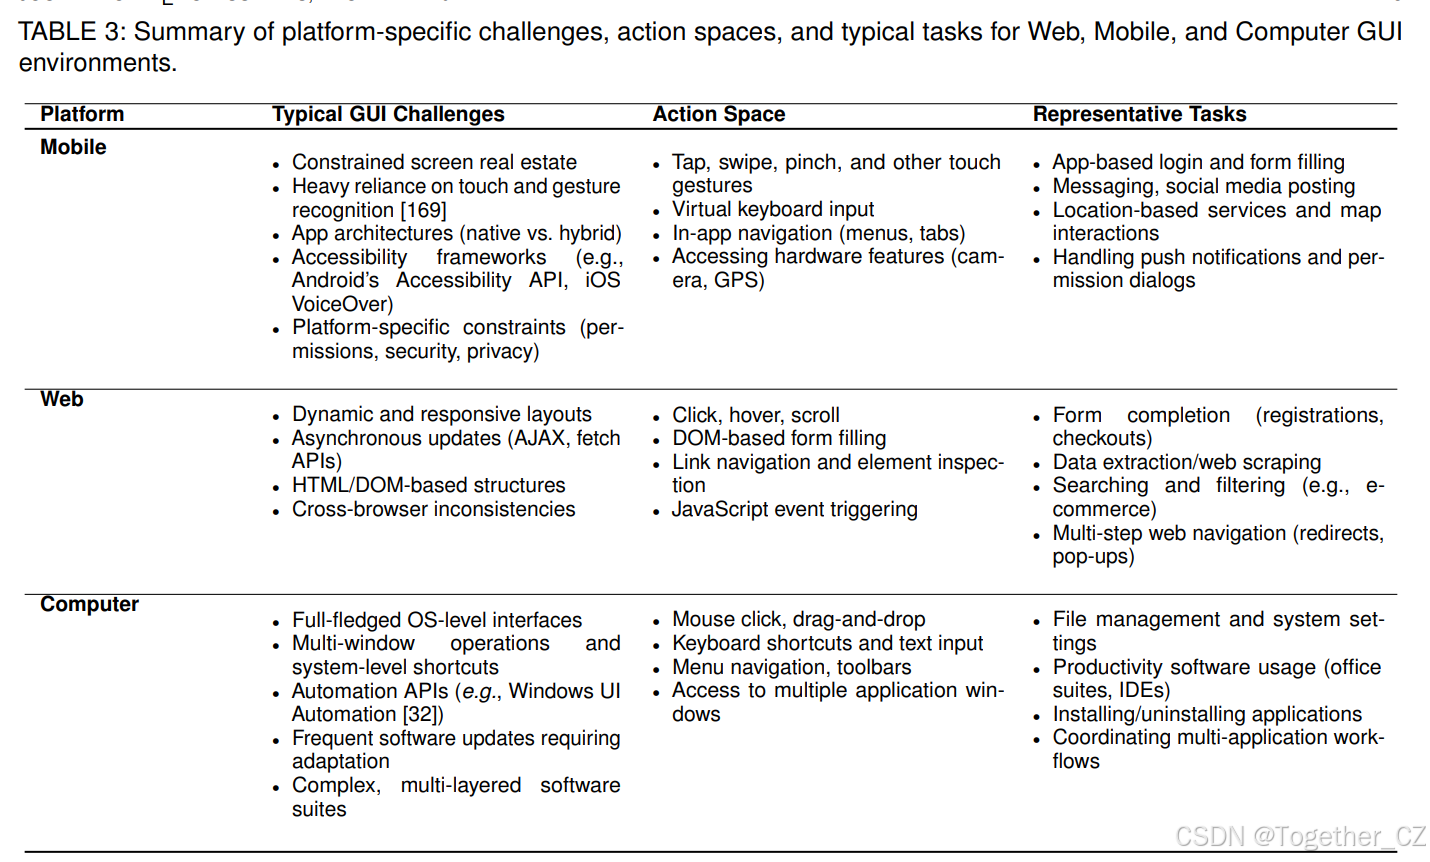
1)移动平台:移动设备在受限的屏幕空间内运行,严重依赖触摸交互170,并提供多样的应用架构(如原生应用与混合应用)。移动平台通常使用无障碍框架,如Android的无障碍API⁴171和iOS的VoiceOver无障碍检查器⁵,来暴露UI元素的结构化信息。然而,GUI智能体必须处理移动环境中的额外复杂性,如手势识别169、应用导航172和平台特定约束(如安全和隐私权限)173、174。
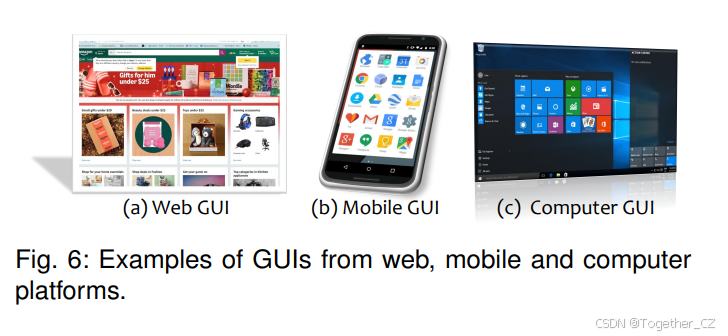
2)Web平台:Web应用提供相对标准化的界面,通常通过超文本标记语言(HTML)和文档对象模型(DOM)结构访问175、176。GUI智能体可以利用HTML属性,如元素ID、类和标签,来识别交互组件。Web环境还呈现动态内容、响应式布局和异步更新(如AJAX请求)177,要求智能体持续评估DOM并使其动作适应变化的界面元素。
3)计算机平台:计算机操作系统平台,如Windows,提供对GUI交互的完全控制。智能体可以利用系统级自动化API,如Windows UI Automation32,获取全面的UI元素数据,包括类型、标签、位置和边界框。这些平台通常支持更广泛的交互类型,鼠标、键盘和复杂的多窗口操作。这些使GUI智能体能够执行复杂的工作流。然而,这些系统也需要对多样应用进行复杂适配,从简单UI到复杂的多层软件套件。
总之,跨移动、Web和桌面环境的平台多样性使GUI智能体能够提供广泛的自动化能力,使其成为适应统一框架的通用解决方案。然而,每个平台在系统和应用层面都呈现独特的特征和约束,需要量身定制的方法以实现有效整合。通过考虑这些平台特定特征,可以优化GUI智能体以满足每个环境的独特要求,从而增强其在各种自动化场景中的适应性和可靠性。
5.2.2 环境状态感知
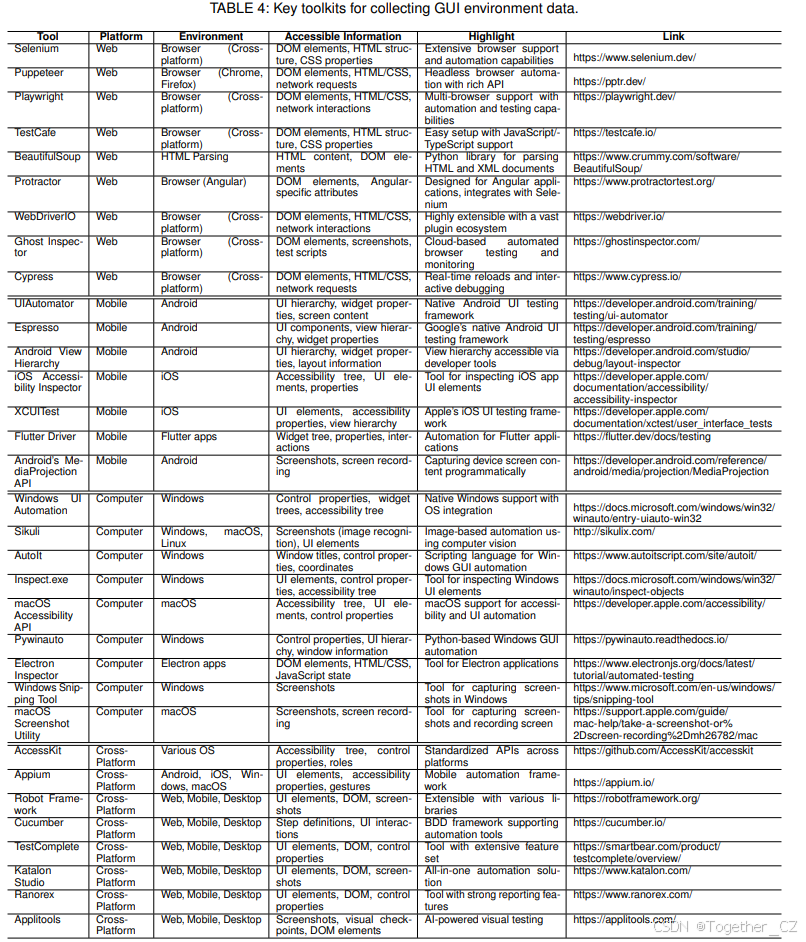
准确感知环境的当前状态对LLM驱动的GUI智能体至关重要,因为它直接影响其决策和动作规划过程。这种感知通过收集结构化数据(如控件树)和非结构化数据(如截图)的组合来实现,以捕获界面及其组件的完整表示。在表4中,我们概述了跨各种平台收集GUI环境数据的关键工具包,下面我们详细讨论它们的作用:
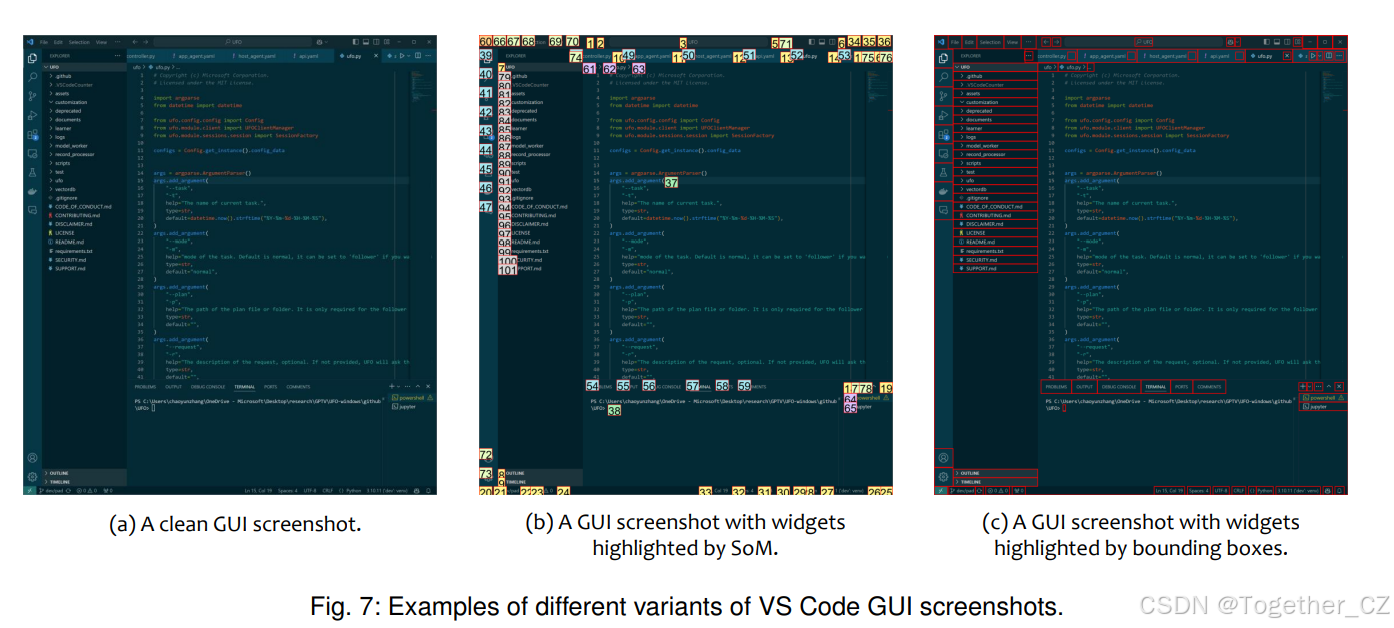
1)GUI截图:截图提供应用的视觉快照,捕获给定时刻GUI的整个状态。它们为智能体提供布局、设计和视觉内容的参考,当UI元素的结构细节有限或不可用时至关重要。图标、图像和其他可能包含重要上下文的图形线索等视觉元素可以直接从截图中分析。许多平台有内置工具捕获截图(如Windows截图工具、macOS截图实用程序和Android的MediaProjection API),截图可以通过额外注释增强,如Set-of-Mark(SoM)高亮178或围绕关键UI组件的边界框179,以简化智能体决策。图7展示了VS Code GUI的各种截图,包括干净版本,以及带有SoM和边界框的版本,突出可操作组件,帮助智能体关注界面最关键区域。
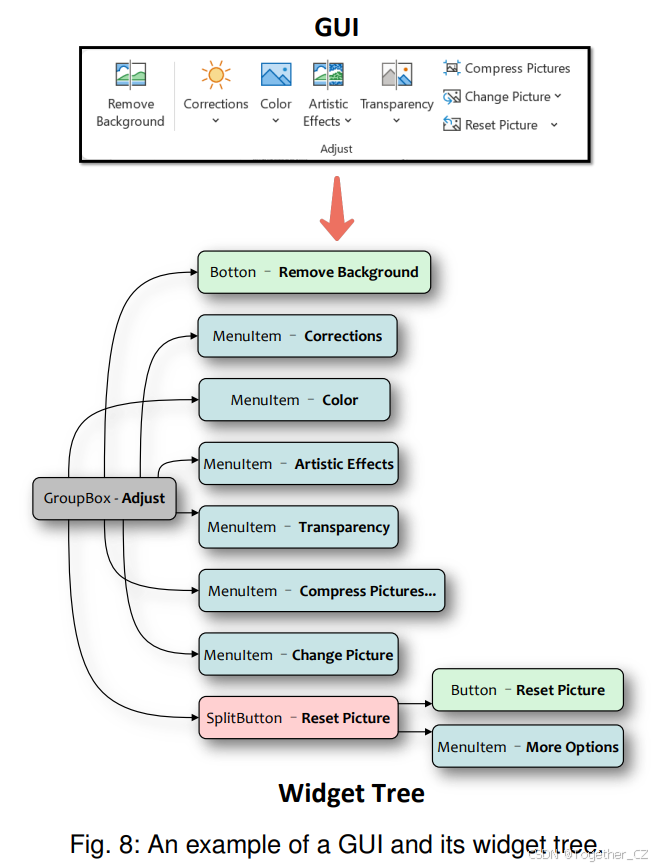
2)控件树:控件树呈现界面元素的层次视图,提供有关组件之间布局和关系的结构化数据180。我们在图8中展示了GUI及其控件树的示例。通过访问控件树,智能体可以识别元素类型、标签、角色和界面内的关系等属性,所有这些对上下文理解至关重要。Windows UI Automation和macOS的Accessibility API¹⁰等工具为桌面应用提供结构化视图,而Android的Accessibility API和HTML DOM结构分别服务于移动和Web平台。这种层次数据对智能体映射逻辑交互和基于UI做出明智选择不可或缺。
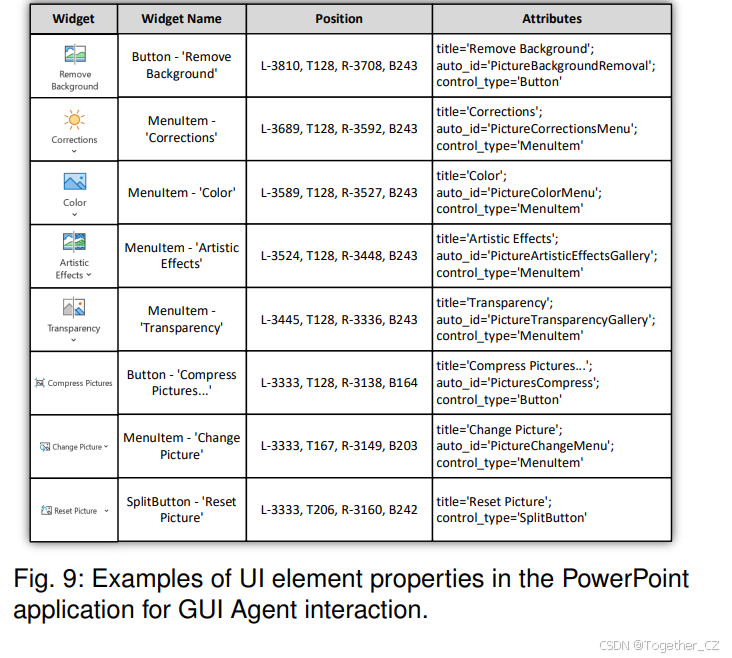
3)UI元素属性:界面中的每个UI元素包含特定属性,如控件类型、标签文本、位置和边界框尺寸,帮助智能体定位适当组件。这些属性对智能体做出关于空间关系(如相邻元素)和功能目的(如区分按钮和文本字段)的决策至关重要。例如,Web应用揭示DOM属性(id、class、name)和CSS样式等属性,提供上下文和控制信息。这些属性帮助智能体精确定位精确元素进行交互,增强其在多样UI环境中导航和操作的能力。图9展示了Windows UI Automation API提取的选定UI元素属性示例,这些属性支持GUI智能体决策。
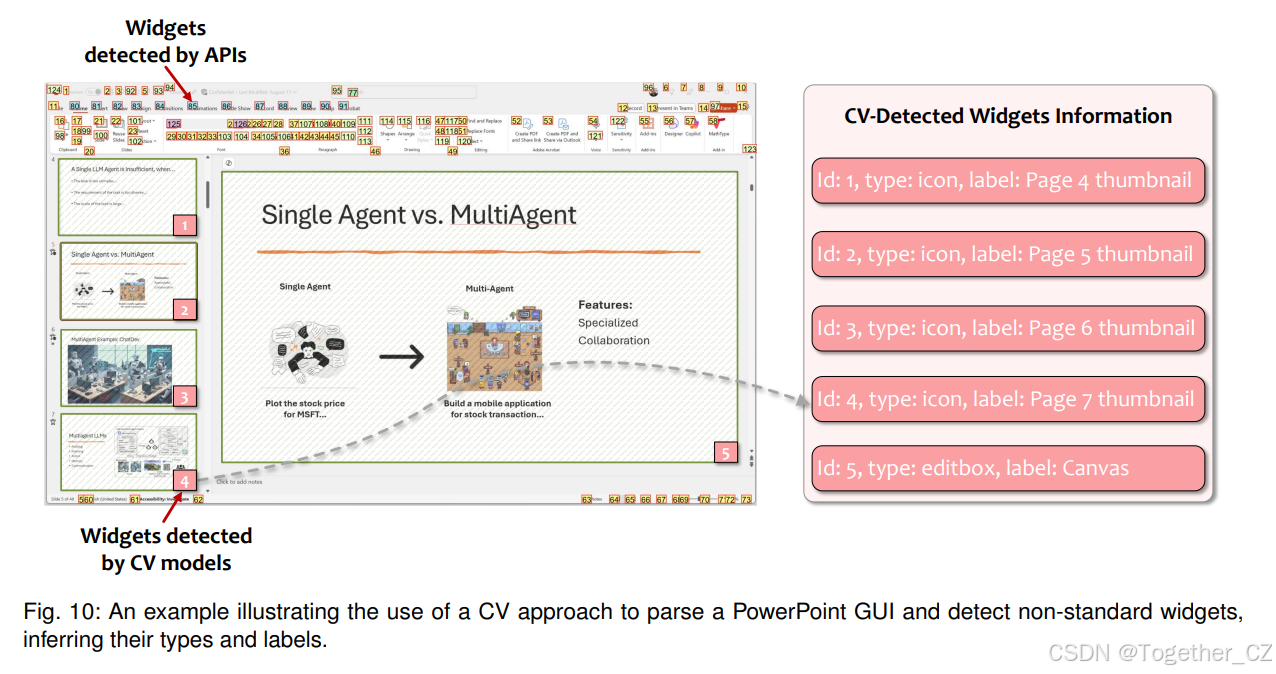
4)互补CV方法:当结构化信息不完整或不可用时,计算机视觉技术可以提供额外见解181。例如,OCR允许智能体直接从截图提取文本内容,便于阅读标签、错误消息和说明121。此外,先进的目标检测120模型如SAM(Segment Anything Model)182、DINO183和OmniParser184可以识别和分类各种布局中的UI组件,支持智能体在UI元素可能频繁变化的动态环境中。这些基于视觉的方法确保鲁棒性,使智能体即使在标准UI API不足的设置中也能有效运作。我们在图10中展示了互补信息的示例,并在第5.7.1节进一步详述这些先进的计算机视觉方法。
这些元素共同创建了GUI环境当前状态的全面多模态表示,提供结构化和视觉数据。通过将这些信息纳入提示构建,智能体能够做出明智的、上下文感知的决策,而不遗漏关键环境线索。
5.2.3 环境反馈
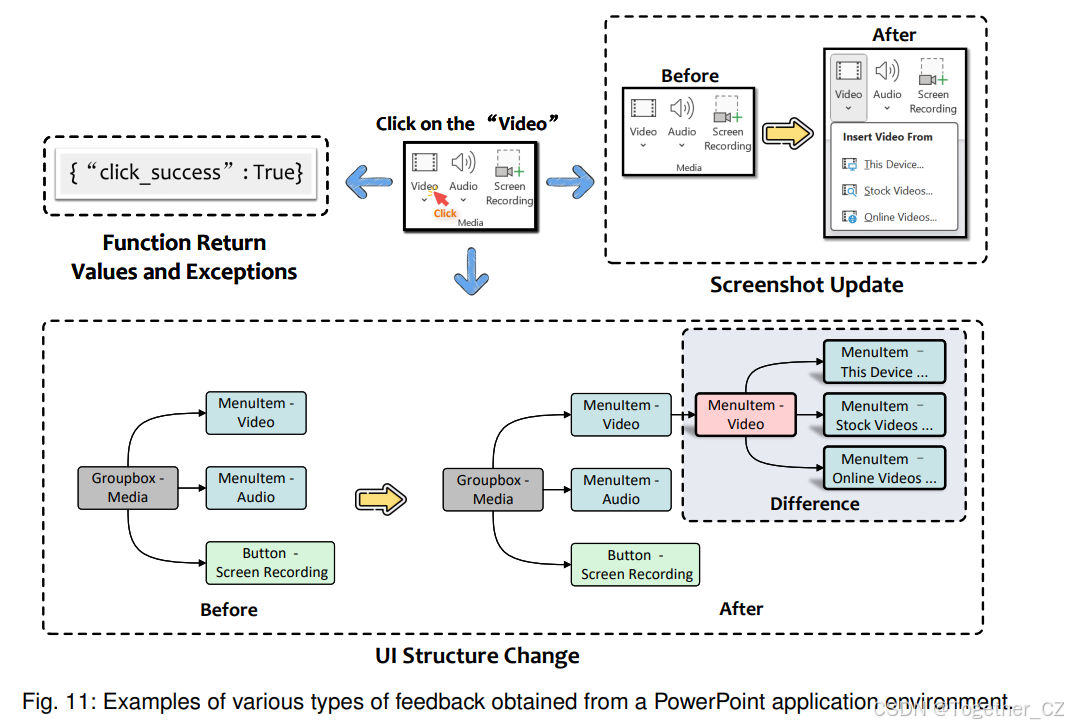
有效的反馈机制对GUI智能体评估每个动作的成功并为后续步骤做出明智决策至关重要。反馈可以采取多种形式,取决于平台和交互类型。图11展示了从环境获得的各种反馈类型的示例。
1)截图更新:通过比较前后截图,智能体可以识别表示应用状态变化的视觉差异。截图分析可以揭示界面中的细微变化,如通知的出现、视觉线索或确认消息,这些可能无法被结构化数据捕获185。
2)UI结构变化:执行动作后,智能体可以检测控件树结构的修改,如元素的出现或消失、元素属性的更新或层次变化186。这些变化表明成功交互(如打开下拉菜单或点击按钮),并帮助智能体基于更新的环境状态确定下一步。
3)函数返回值和异常:某些平台通过函数返回值或系统生成的异常提供动作结果的直接反馈187。例如,API响应或JavaScript返回值可以确认Web平台上动作成功,而异常或错误代码可以表示交互失败,引导智能体重试或选择替代方法。
环境提供的这些反馈对GUI智能体评估先前动作的结果至关重要。这些实时信息使智能体能够评估其干预的有效性,并确定是坚持初始计划还是转向替代策略。通过这种自我反思过程,智能体可以调整其决策,优化任务执行并增强在动态和多样应用环境中的整体性能。
5.3 提示工程
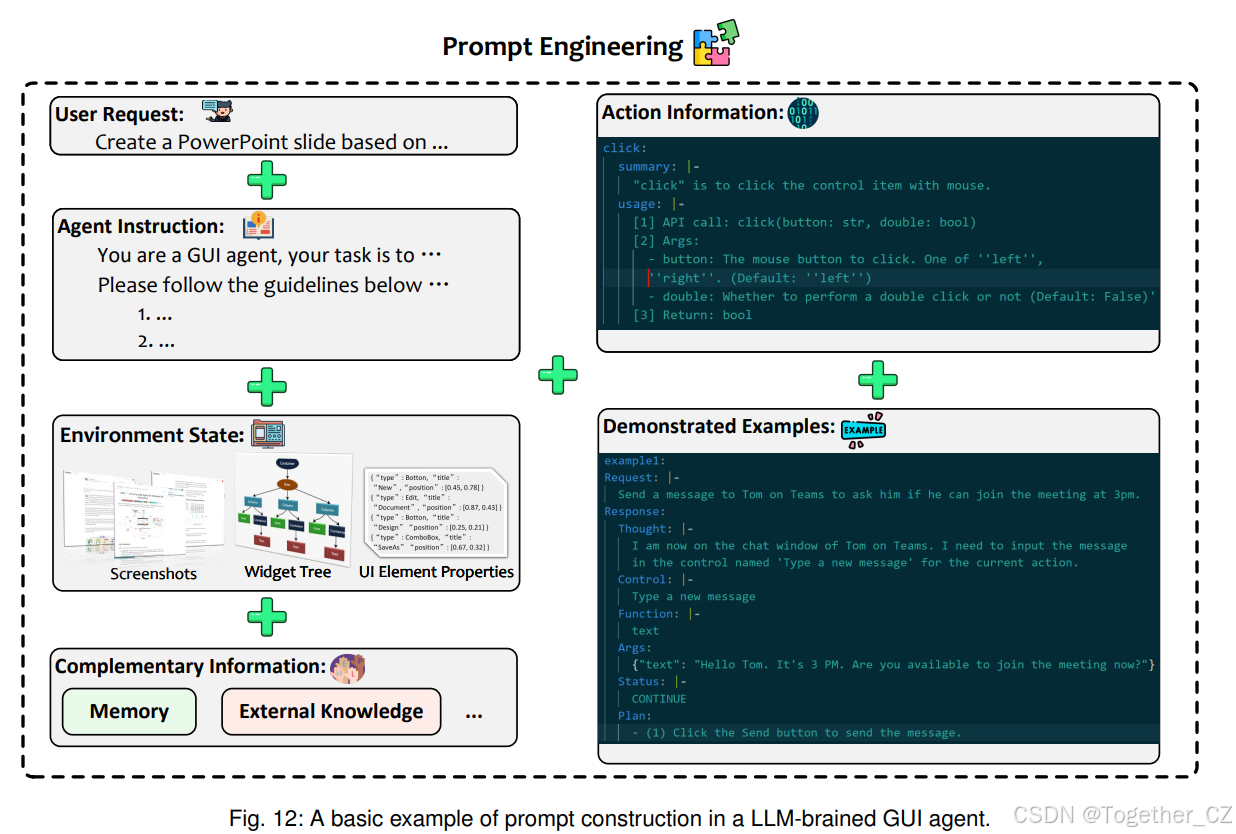
在LLM驱动的GUI智能体的操作中,有效的提示构建是关键步骤,它封装了智能体成功生成适当响应和执行任务所需的所有必要信息168。在从环境收集相关数据后,智能体制定综合提示,结合LLM推理所需的各种组件。每个组件都有特定目的,它们共同使智能体能够高效执行用户请求。图12展示了LLM驱动的GUI智能体中提示构建的基本示例。提示的关键元素总结如下:
1)用户请求:这是用户提供的原始任务描述,概述目标和期望结果。它作为智能体动作的基础,对确保LLM理解任务上下文和范围至关重要。
2)智能体指令:本节为智能体的操作提供指导,详述其角色、要遵循的规则和具体目标。指令阐明智能体将接收什么输入,并概述LLM的预期输出,为推理过程建立框架。核心智能体指令通常嵌入LLM的基础系统提示中,补充指令根据环境反馈和上下文适应动态注入或更新。
3)环境状态:智能体包括感知的GUI截图和UI信息,如第5.2.2节所述。这种多模态数据可能包含各种版本的截图(如干净版本和SoM注释版本),以确保清晰度并减轻UI控件被注释遮挡的风险。这种环境的全面表示对准确决策至关重要。
4)动作文档:此组件概述智能体可以采取的可用动作,详述相关文档、函数名、参数、返回值和其他必要参数。提供此信息为LLM提供选择和生成适合当前任务的动作所需的上下文。
5)演示示例:包括示例输入/输出对对于激活LLM的上下文学习97能力至关重要。这些示例帮助模型理解和泛化任务要求,增强其执行GUI智能体职责的性能。
6)补充信息:还可以包括有助于规划和推理的额外上下文。这可以包括从智能体记忆检索的历史数据(详见第5.6节)和外部知识源,如通过检索增强生成(RAG)方法获得的文档188、189。这些补充信息可以提供有价值的见解,进一步优化智能体的决策过程。
有效提示的构建是LLM驱动的GUI智能体性能的基础。通过系统性地纳入上述信息,智能体确保LLM具备准确高效执行任务所需的上下文和指导。
5.4 模型推理
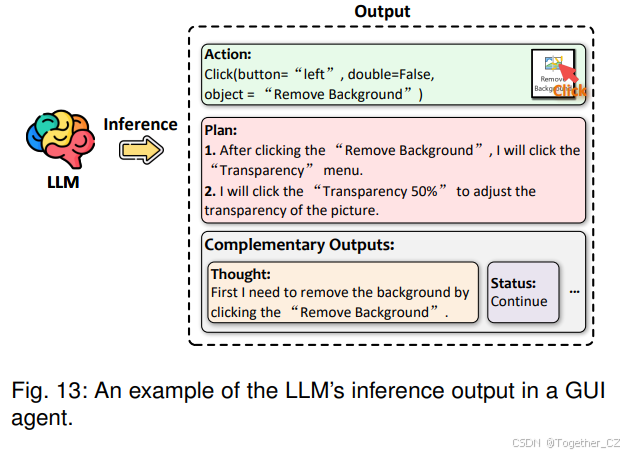
构建的提示提交给LLM进行推理,LLM的任务是生成执行用户请求所需的计划和具体动作。这个推理过程至关重要,因为它决定了GUI智能体在动态环境中的有效性能。它通常涉及两个主要组件:规划和动作推理,以及互补输出的生成。图13展示了LLM推理输出的示例。
5.4.1 规划
成功执行GUI任务通常需要一系列顺序动作,要求智能体进行有效规划52、190。类似于人类认知过程,深思熟虑的规划对于组织任务、安排动作和确保成功完成至关重要51、191。LLM必须首先构思长期目标,同时专注于短期动作以启动朝着该目标的进展192。
为了有效导航多步骤任务的复杂性,智能体应将总体任务分解为可管理的子任务,并建立执行时间表193。可以采用CoT推理100等技术,使LLM能够制定指导动作执行的结构化计划。该计划可以存储以供未来推理步骤参考,增强智能体活动的组织和焦点。
规划的粒度可能因任务性质和智能体角色而异51。对于复杂任务,结合全局规划(识别广泛子目标)和局部规划(为这些子目标定义详细步骤)的层次方法可以显著提高智能体有效管理长期目标的能力194。
5.4.2 动作推理
动作推理是推理阶段的核心目标,因为它将规划转化为可执行任务。推断的动作通常表示为函数调用字符串,包含函数名和相关参数。这些字符串可以容易地转换为与环境的真实世界交互,如点击、键盘输入、移动手势或API调用。这些动作类型的详细讨论见第5.5节。输入提示必须包括智能体可选择的预定义动作集。智能体可以从该集合中选择动作,或者如果允许,生成自定义代码或API调用与环境交互161。这种灵活性可以增强智能体对不可预见情况的适应性;然而,它可能引入可靠性问题,因为生成的代码可能容易出错。
5.4.3 互补输出
除了规划和动作推理外,LLM还可以生成增强智能体能力的互补输出。这些输出可能包括澄清智能体决策的推理过程(如CoT推理)、用于用户交互的消息、与其他智能体或系统的通信,或任务状态(如继续或完成)。这些功能的设计可以量身定制以满足特定需求,从而丰富GUI智能体的整体性能。
通过有效平衡规划和动作推理,同时纳入互补输出,智能体可以以更高程度的组织和适应性导航复杂任务。
5.5 动作执行
在推理过程之后,关键的下一步是GUI智能体在GUI环境中执行从推断命令派生的动作,并随后收集反馈。虽然"GUI智能体"一词可能暗示仅关注用户界面动作,但通过整合各种工具箱可以大大扩展动作空间,增强智能体的多功能性。广义上,GUI智能体可用的动作分为三大类:(i)UI操作144,(ii)原生API调用196,和(iii)AI工具197。每个类别都提供独特的优势和挑战,使智能体能够更有效地处理多样任务。我们在表5中总结了GUI智能体中常用的各种动作,分类为不同类型,并在下面提供每个类别的详细解释。
5.5.1 UI操作
UI操作包括用户在软件应用中通常与GUI执行的基本交互。这些操作包括各种形式的输入,如鼠标动作(点击、拖动、悬停)、键盘动作(按键、组合键)、触摸动作(点击、滑动)和手势(捏合、旋转)。这些动作的具体内容可能因平台和应用而异,需要为每个环境量身定制方法。
虽然UI操作构成智能体与GUI交互的基础,但由于这些任务的顺序性质,它们可能相对较慢。每个操作必须逐步执行,这可能导致延迟增加,特别是在涉及大量交互的复杂工作流中。尽管有这个缺点,UI操作对于保持跨各种应用的广泛兼容性至关重要,因为它们利用标准用户界面元素和交互。
5.5.2 原生API调用
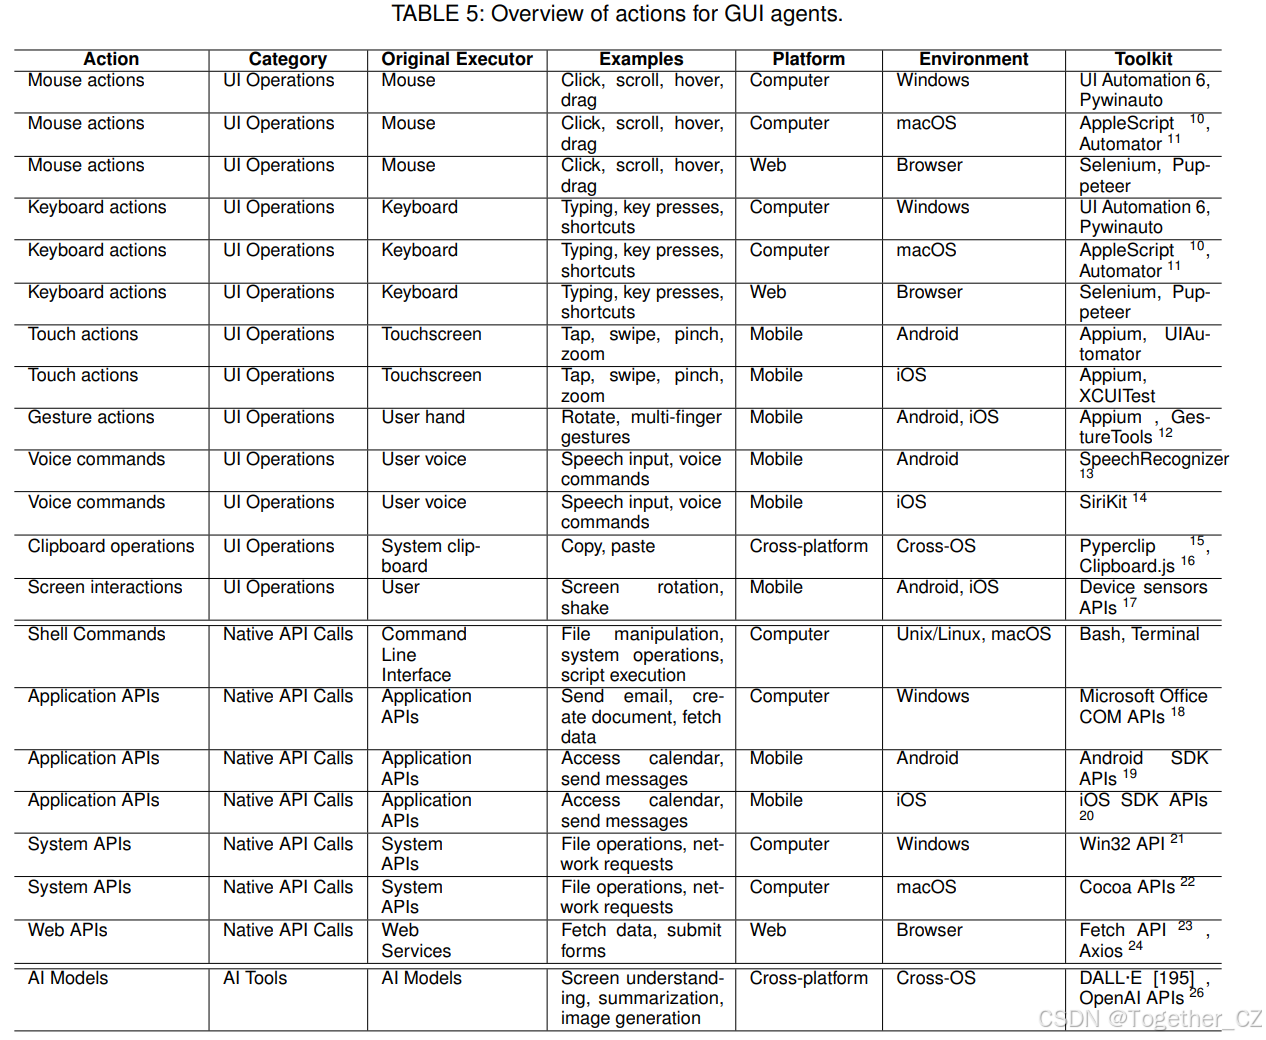
与UI操作相比,一些应用提供原生API,允许GUI智能体更高效地执行动作。这些API提供对应用内特定功能的直接访问,使智能体能够用单个命令执行复杂任务198。例如,调用Outlook API允许智能体在一次操作中发送电子邮件,而使用UI操作则需要一系列步骤,如导航菜单和填写表单199。
虽然原生API可以显著提高动作执行的速度和可靠性,但其可用性有限。并非所有应用或平台都暴露API供外部使用,开发这些接口可能需要大量努力和专业知识。因此,虽然原生API提供了高效完成任务的有力手段,但它们可能不像UI操作那样跨不同应用通用。
5.5.3 AI工具
将AI工具整合到GUI智能体中代表了其能力的变革性进步。这些工具可以协助广泛的任务,包括从截图或文本中总结内容、文档增强、图像或视频生成(如调用ChatGPT11、DALL-E195),甚至调用其他智能体或Copilot工具进行协作协助。生成式AI技术的快速发展使GUI智能体能够解决以前超出其能力的复杂挑战。
通过整合AI工具,智能体可以扩展其功能并在多样上下文中增强其性能。例如,GUI智能体可以使用AI摘要工具快速从长文档中提取关键信息,或利用图像生成工具为用户演示创建自定义视觉效果。这种整合不仅简化了工作流,还使智能体能够在传统所需时间的一小部分内提供高质量结果。
5.5.4 总结
先进的GUI智能体应熟练利用所有三类动作:UI操作以实现广泛兼容性,原生API以实现高效执行,AI工具以增强能力。这种多方面方法使智能体能够在各种应用中可靠运行,同时最大化效率和有效性。通过熟练导航这些动作类型,GUI智能体可以更熟练地完成用户请求,最终带来更无缝和高效的用户体验。
5.6 记忆
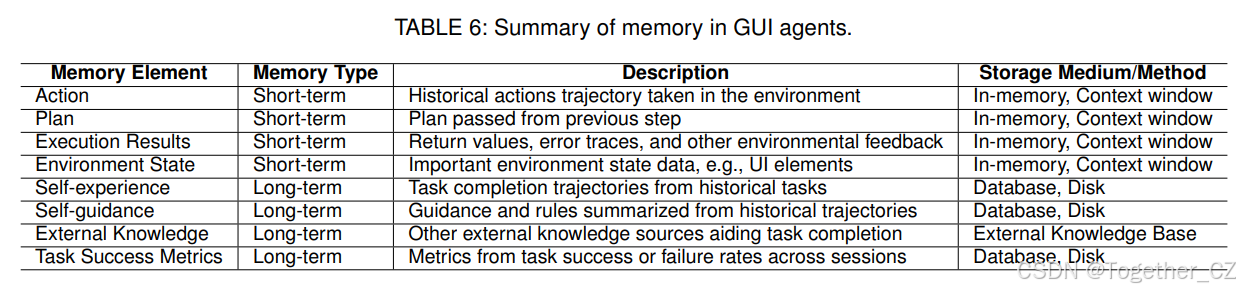
为了使GUI智能体在复杂的多步骤任务中实现鲁棒性能,它必须保留记忆,使其能够在原本无状态的环境中管理状态。记忆允许智能体跟踪其先前动作、结果和任务整体状态,所有这些对后续步骤中的明智决策至关重要200。通过建立连续性,记忆将智能体从反应式系统转变为主动的、有状态的系统,能够基于积累的知识进行自我调整。智能体的记忆通常分为两种主要类型:短期记忆201和长期记忆202。我们在表6中展示了GUI智能体中不同类型记忆的概述。
5.6.1 短期记忆
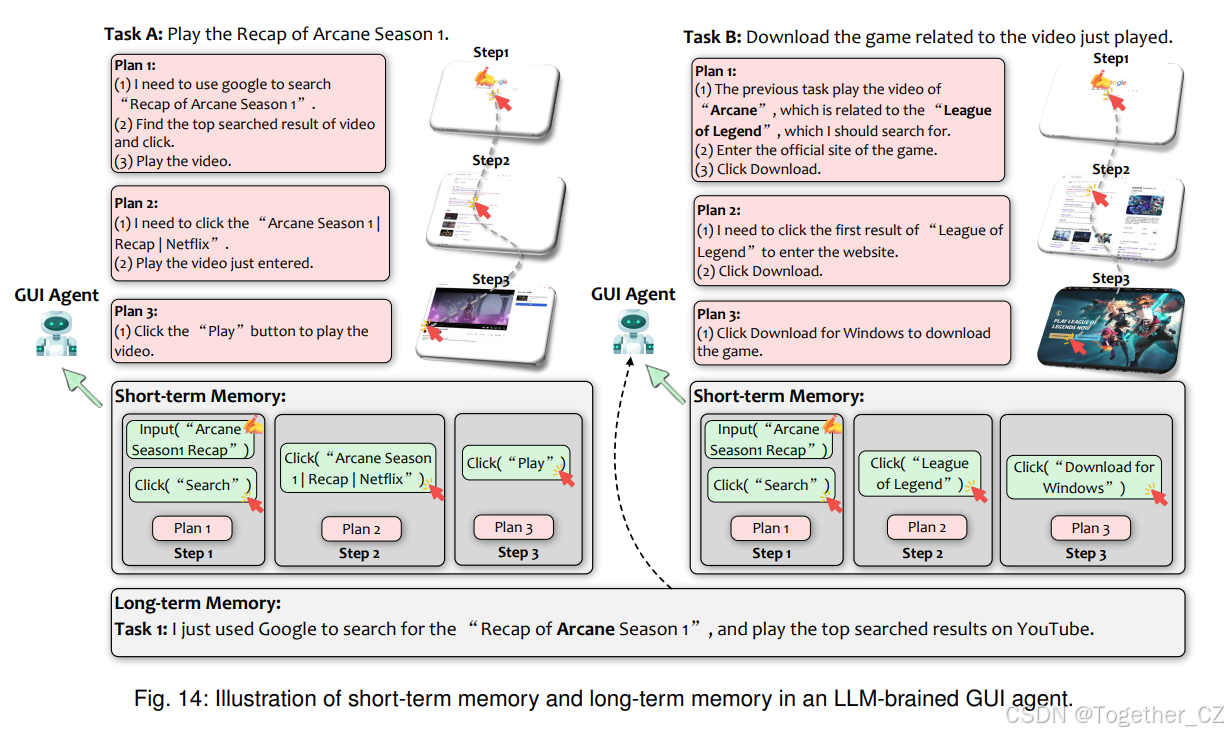
短期记忆(STM)提供LLM在运行时使用的主要、短暂的上下文203。STM存储与当前任务相关的信息,如近期计划、动作、结果和环境状态,并持续更新以反映任务的持续状态。这种记忆在多步骤任务中特别有价值,其中每个决策都建立在前一个决策之上,要求智能体对任务轨迹保持清晰理解。如图14所示,在完成独立任务期间,任务轨迹(包括动作和计划)存储在STM中。这允许智能体有效跟踪任务进度并做出更明智的决策。
然而,STM受LLM上下文窗口的限制,限制了它可以向前携带的信息量。为了管理这一限制,智能体可以采用选择性记忆管理策略,如选择性丢弃或总结不太相关的细节,以优先考虑最有影响力的信息。尽管规模有限,STM对于确保连贯、上下文感知的交互和支持智能体以即时、相关反馈执行复杂工作流的能力至关重要。
5.6.2 长期记忆
长期记忆(LTM)作为外部存储库,用于存储超出即时运行时的上下文信息204。与短暂的STM不同,LTM保留历史任务数据,包括先前完成的任务、成功的动作序列、上下文提示和学到的见解。LTM可以存储在磁盘或数据库中,使其能够保留比LLM即时上下文窗口内可行量更大的信息量。在图14所示的示例中,当第二个任务请求下载与前一个任务相关的游戏时,智能体从其LTM检索相关信息。这使智能体能够准确识别正确的游戏,促进高效任务完成。
LTM通过保留成功任务轨迹、操作指南和常见交互模式的示例,有助于智能体随时间的自我改进。当接近新任务时,智能体可以利用RAG技术检索相关历史数据,增强其基于先前成功调整策略的能力。这类似于终身学习53,使LTM有助于培养智能体从经验中"学习"的能力,使其随着跨会话积累见解而以更高的准确性和效率执行任务。例如,205提供了一个说明性示例,使用存储在记忆中的过去任务轨迹来指导和增强未来决策,这种技术高度适用于GUI智能体。它还通过保留先前任务信息实现更好的个性化。
5.7 高级增强
虽然大多数LLM训练的GUI智能体纳入感知、规划、动作执行和记忆等基本组件,但已经开发了几种先进技术来显著提高这些智能体的推理和整体能力。在这里,我们概述了研究中广泛采用的共享进步,以指导更专业和更有能力的LLM训练的GUI智能体的开发。
5.7.1 基于计算机视觉的GUI定位
尽管各种工具(第4节)使GUI智能体能够访问控件位置、标题和属性等信息,但某些非标准GUI或控件可能不遵循这些工具的协议243,使其信息无法访问。此外,由于权限管理,这些工具并不总是可用。这种不完整的信息可能对GUI智能体构成重大挑战,因为LLM可能需要通过估计坐标来独立定位和交互所需控件以执行点击等动作------如果没有精确的GUI数据,这本质上是一项困难的任务。
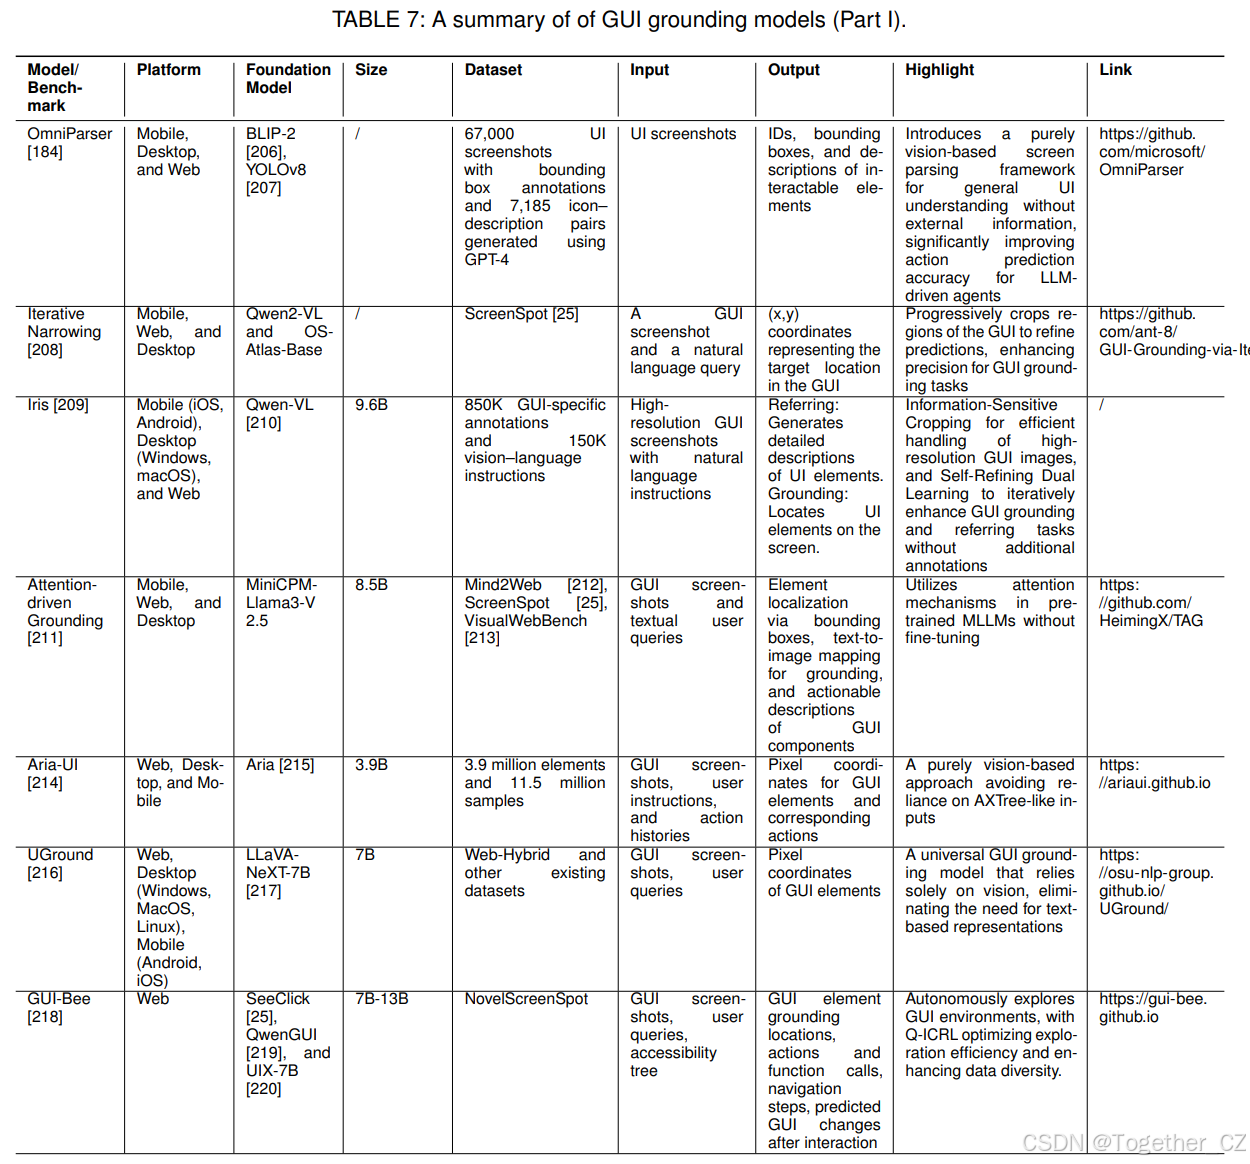
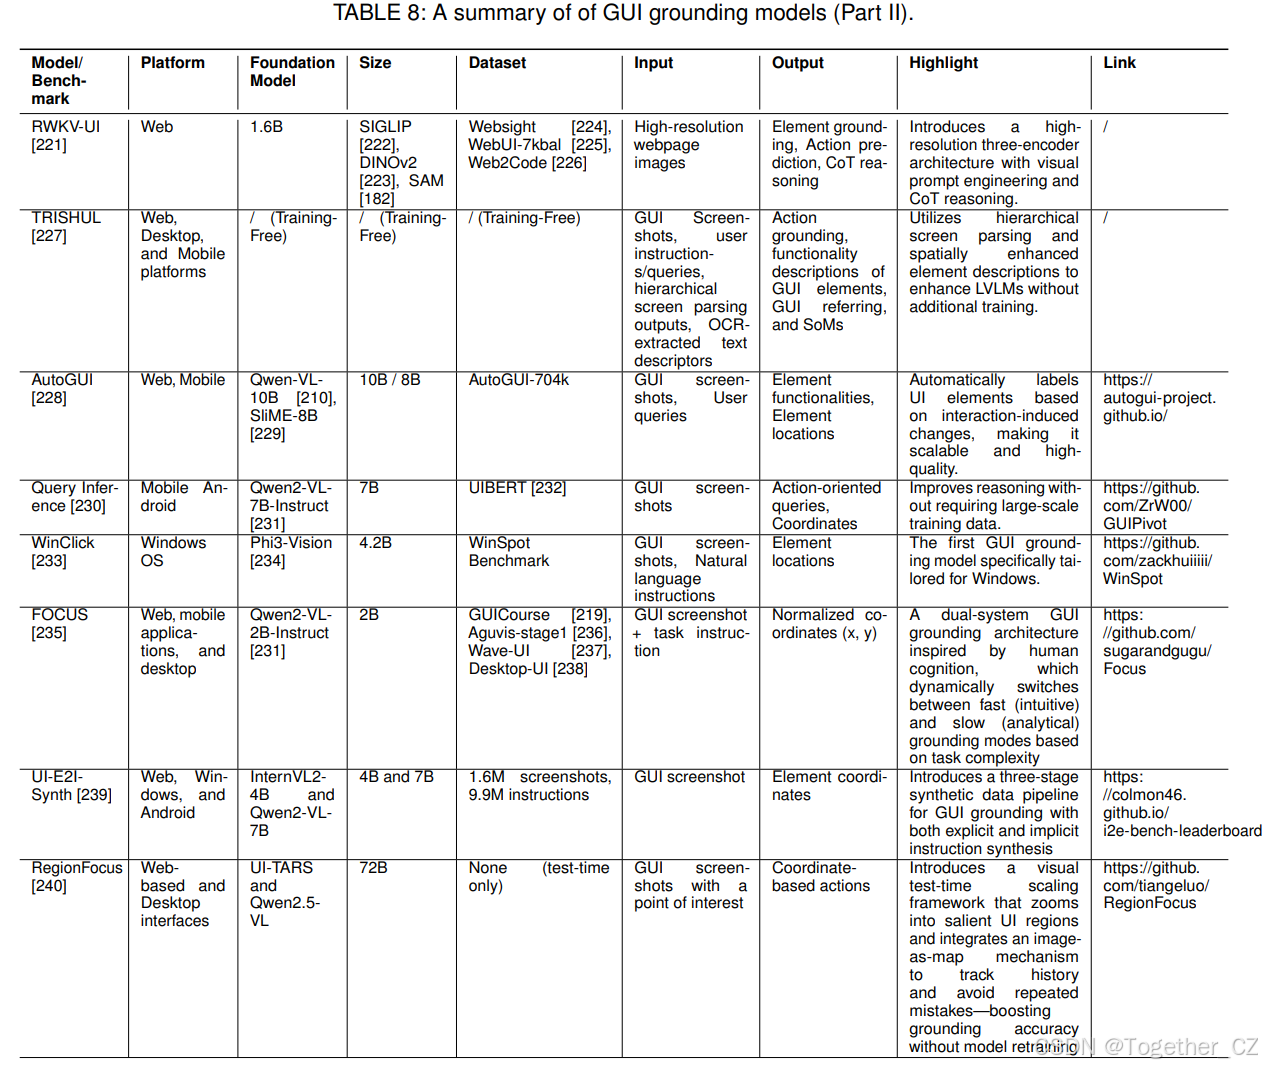
CV模型提供了直接从截图进行GUI定位的非侵入式解决方案,使控件的检测、定位、分割甚至功能估计成为可能103、244-246。这种方法允许智能体解释GUI的视觉结构和元素,而不依赖系统级工具或内部元数据,这些可能不可用或不完整。基于CV的GUI解析为智能体提供有关交互组件、屏幕布局和控件功能的宝贵见解,仅基于视觉线索,增强其识别和操作屏幕上元素的能力。图10提供了基于CV的GUI解析器如何工作的说明性示例。虽然标准基于API的检测捕获预定义控件,但CV模型可以识别额外元素,如缩略图和画布,这些在PowerPoint界面中可能没有明确的API表示。这增强了控件识别,允许智能体检测超出API检测范围的组件。我们在表7、8和9中展示了相关GUI定位模型和基准的概述。
一个值得注意的例子是OmniParser184,它实现了多阶段解析技术,涉及用于检测可交互图标的微调模型、用于提取文本的OCR模块,以及为每个UI元素生成本地化语义描述的图标描述模型。通过整合这些组件,OmniParser构建GUI的结构化表示,增强智能体对交互区域和功能元素的理解。这种全面的解析策略已被证明能显著提高GPT-4V的屏幕理解和交互准确性。
这种基于CV的GUI定位层提供关键的定位信息,显著增强智能体准确直观地与多样GUI交互的能力。这对于处理偏离典型无障碍协议的定制或非标准元素特别有益。此外,迭代缩小等提示方法已显示出提高VLM控件定位能力的希望208。这些方法共同为更自适应和韧性的GUI智能体铺平了道路,能够在更广泛的屏幕环境和应用上下文中有效运行。
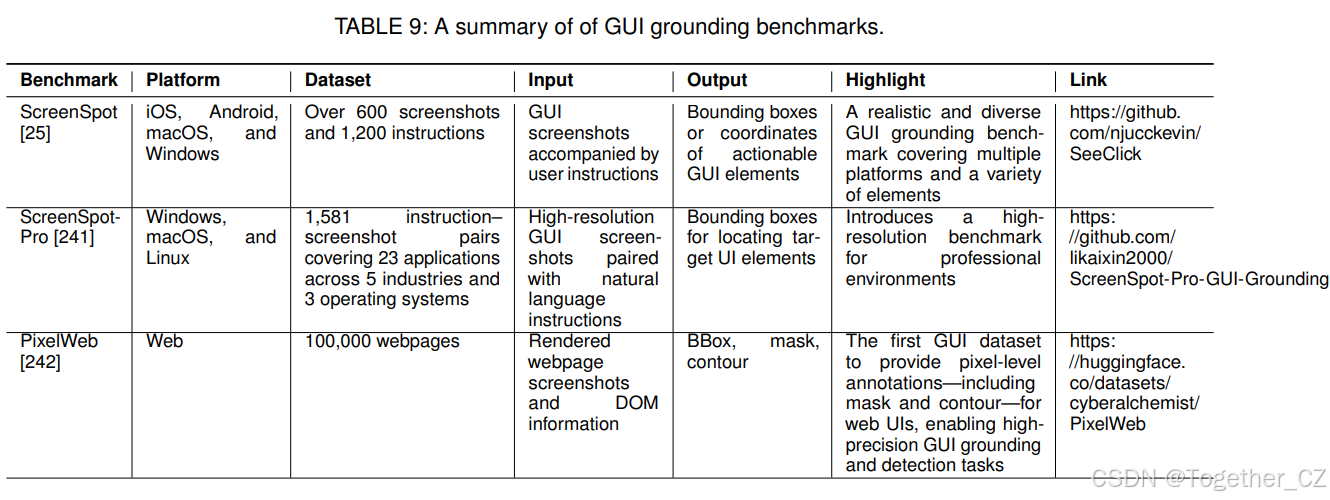
一些工作引入了基准来评估模型和智能体的GUI定位能力。例如,ScreenSpot25作为一个开创性基准,旨在评估LLM驱动的智能体在多样平台(包括iOS、Android、macOS、Windows和Web环境)上的GUI定位性能。它具有超过600张截图和1,200条指令的数据集,重点关注复杂GUI组件,如控件和图标。该基准强调GUI定位在增强下游任务(如Web自动化和移动UI交互)中的重要性。在此基础上,ScreenSpot-Pro241将范围扩展到更专业的高分辨率环境。这个演进版本包括1,581个高质量注释任务,涵盖软件开发、创意工具、CAD、科学应用和办公生产力等领域。ScreenSpot-Pro的关键特征包括真实的高分辨率截图和领域专家提供的细致注释。
这些基准为评估GUI定位能力提供了关键评估标准,从而推动GUI智能体的发展,以改进GUI理解和交互。
5.7.2 多智能体框架
"三个臭皮匠,顶个诸葛亮"这一谚语对GUI自动化任务特别相关,其中单个智能体虽然有能力,但在多智能体框架内可以显著增强247、248。多智能体系统利用多个智能体的集体智慧、专业技能和互补优势,比任何单个智能体单独更有效地处理复杂任务。在GUI智能体的背景下,多智能体系统通过两种主要机制提供先进能力:(i)专业化和(ii)智能体间协作。图15展示了LLM驱动的多智能体如何协作创建桌面的示例。
1)智能体专业化:在多智能体框架中,每个智能体被设计为专注于特定角色或功能,利用其独特能力为整体任务做出贡献。如图15所示,专业化使不同的智能体能够专注于任务管道的不同方面。例如,"文档提取器"专注于从本地文档(如PDF)中提取相关内容,而"网络检索器"专注于从在线源收集额外信息。类似地,"设计师"将检索到的信息转换为视觉吸引人的幻灯片,"评估者"提供反馈以完善和改进输出。这种功能分离确保每个智能体在其指定任务上高度熟练,从而提高效率和质量249。
2)智能体间协作动态:图15所示的多智能体系统展示了智能体如何动态协作处理复杂任务。过程从"文档提取器"和"网络检索器"开始,它们并行工作从本地和在线源收集信息。检索到的数据传达给"设计师",后者将其合成为连贯的幻灯片集。幻灯片创建后,"评估者"审查输出,提供反馈以供完善。这些智能体共享信息、交换上下文并以协调方式操作,反映类人团队合作动态。例如,如图所示,智能体的角色紧密整合------每个输出馈入下一阶段,创建反映真实世界协作环境的简化工作流19。
在这样的系统中,智能体可以集体参与需要规划、讨论和决策的任务。通过这些交互,系统利用每个智能体的领域专业知识和专业化的潜在潜力,在多样多步骤过程中最大化整体性能。
5.7.3 自我反思
"承认错误等于改正一半"。在GUI多智能体系统的背景下,自我反思指智能体在任务执行过程中内省评估其推理、动作和决策的能力250。这种能力允许智能体检测潜在错误、调整策略和完善动作,从而提高其决策的质量和鲁棒性,特别是在复杂或不熟悉的GUI环境中。通过定期评估自身性能,自我反思智能体可以动态适应以产生更准确和有效的结果251。
自我反思对GUI智能体特别关键,因为用户界面的可变性和即使人类操作系统也可能出错的可能性。GUI智能体经常遇到偏离预期的情况,如点击错误按钮、遇到意外广告、导航不熟悉的界面、接收来自API调用的错误消息,甚至响应用户对任务结果的反馈。为确保任务成功,GUI智能体必须快速反思其动作,评估这些反馈信号,并调整其计划以更好地符合期望目标。
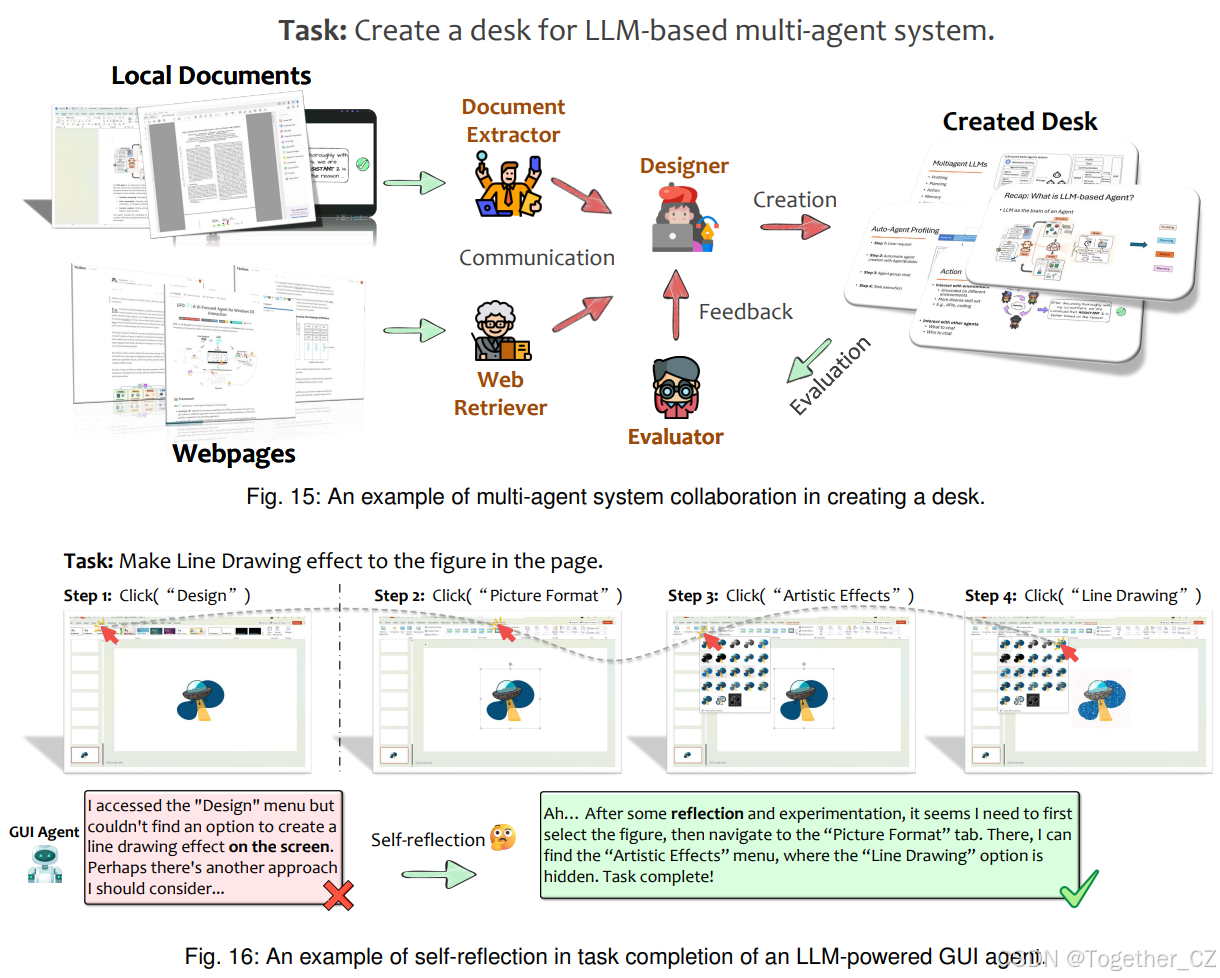
如图16所示,当智能体最初未能在设计菜单中找到"线条绘制"选项时,自我反思使其能够重新考虑并识别其在"图片格式"菜单下"艺术效果"中的正确位置,从而成功完成任务。
在实践中,GUI智能体的自我反思技术通常涉及两种主要方法:(i)ReAct252和(ii)Reflexion253。
1)ReAct(推理和行动):ReAct通过让智能体评估每个动作的结果并推理下一个最佳步骤,将自我反思整合到智能体的动作链中。在这个框架中,智能体不是简单地遵循线性动作序列;相反,它动态适应,持续根据每个动作的反馈重新评估其策略。例如,如果尝试填写表单的GUI智能体意识到它点击了错误的字段,它可以通过回溯并选择正确元素来调整。通过ReAct,智能体实现更高的一致性和准确性,因为它学会在每个完成的步骤中完善其行为。
2)Reflexion:Reflexion强调基于语言的反馈,智能体从环境接收和处理作为语言输入的反馈,称为自我反思反馈。这种反馈被上下文化并用作后续交互的输入,帮助智能体从先前错误中快速学习。例如,如果GUI智能体从应用接收错误消息,Reflexion使智能体能够处理此消息、更新其对界面的理解,并在未来交互中避免类似错误。Reflexion的迭代反馈循环促进持续改进,对导航复杂多步骤任务的GUI智能体特别有价值。
5.7.4 自我进化
自我进化254是GUI智能体应具备的关键属性,使其能够通过积累的经验逐步增强性能。在GUI多智能体系统的背景下,自我进化不仅允许单个智能体改进,还通过智能体间共享知识和策略促进集体学习和适应。在任务执行期间,GUI智能体生成详细的动作轨迹以及补充信息,如环境状态、内部推理过程(智能体的思维过程)和评估结果。这些丰富的数据作为有价值的知识库,GUI智能体可以从中学习和进化。从经验中提取的知识可以分为三个主要领域:
1)任务轨迹:智能体执行的动作序列以及相应的环境状态对学习至关重要255。这些成功的轨迹可以通过两种重要方式利用。首先,它们可以用于微调支撑智能体的核心LLM。使用这种领域特定和任务相关的数据微调增强了模型泛化和改进未来类似任务性能的能力。其次,这些轨迹可以用作演示示例,在提示工程期间激活LLM的上下文学习能力。通过在提示中包括成功任务执行的示例,智能体可以更好地理解和复制期望行为,而无需额外模型训练。例如,假设一个智能体成功完成了涉及跨多个应用自动化数据输入的复杂任务。记录的动作轨迹------包括所采取的步骤、做出的决策和上下文线索------可以与其他智能体共享。这些智能体在面临类似任务时可以使用此轨迹作为指南,减少学习曲线并提高效率。
2)指导与规则:从积累的经验中,智能体可以提取高级规则或指南,封装最佳实践、成功策略和从过去错误中学到的教训256、257。这种指导可以由LLM本身通过轨迹总结256获得,甚至通过基于搜索的算法,如蒙特卡洛树搜索(MCTS)257。这些知识可以形式化为策略或启发式,智能体在决策过程中参考,从而增强其推理能力。例如,如果智能体在尝试执行某些动作时反复遇到错误,因为没有适当的先决条件(如尝试在指定文件路径之前保存文件),它们可以制定规则在执行动作之前检查这些先决条件。这种主动方法降低了错误可能性并提高了任务成功率。
3)新工具包:在交互过程中,GUI智能体可能发现或开发更有效的方法、工具或动作序列,以简化任务执行161。这些可能包括优化的API调用、宏或UI操作组合,比先前方法更有效地完成任务。LLM可以利用自动分析执行轨迹,以总结、发现和生成高级快捷方式或常用快速API,然后可以重用用于未来执行258。通过将这些新工具纳入其技能库,智能体扩展其能力并提高整体效率。例如,智能体可能发现使用批处理API比在循环中执行单个UI操作更有效地自动化重复任务。这种新方法可以在多智能体系统内的智能体之间共享,允许所有智能体从改进的方法中受益并将其应用于相关任务。
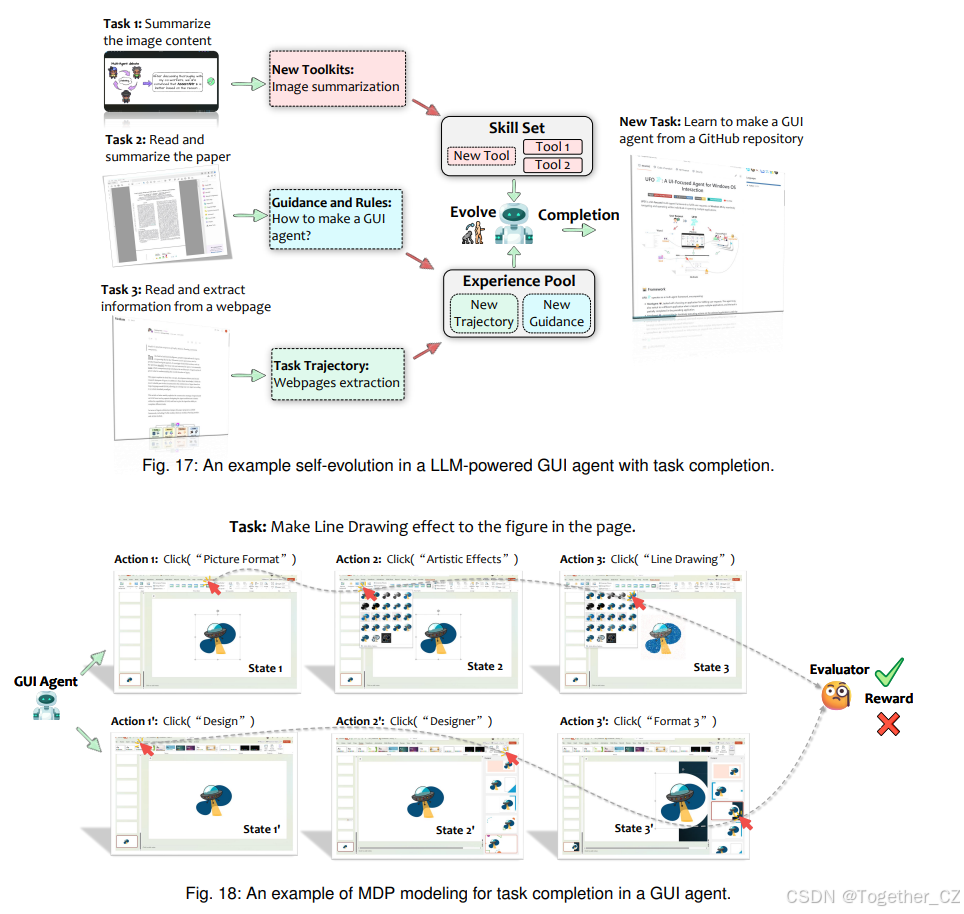
图17展示了GUI智能体如何通过任务完成进化。在操作过程中,智能体向其技能集添加新能力,如图像摘要工具包,从阅读关于创建GUI智能体的论文中获得见解,并将网页提取等任务轨迹存储在经验池中。当分配新任务时,如"从GitHub仓库学习制作GUI智能体",智能体利用其获得的技能和过去经验来适应和有效执行。这种动态进化突出了智能体持续学习、成长和完善其能力的能力。通过利用过去经验、纳入新知识和扩展其工具集,GUI智能体可以适应多样挑战、改进任务执行并显著增强系统的整体性能,促进协作和不断改进的环境。
5.7.5 强化学习
强化学习(RL)259在使LLM与期望行为对齐方面取得了显著进展260,最近已被用于LLM智能体的开发50、261。在GUI多智能体系统的背景下,RL提供了巨大潜力来增强GUI智能体的性能、适应性和协作。GUI自动化任务自然与马尔可夫决策过程(MDP)262的结构一致,使其特别适合基于RL的解决方案。在这种情况下,状态对应于环境感知(如GUI截图、UI元素属性和布局配置),而动作直接映射到UI操作,包括鼠标点击、键盘输入和API调用。奖励可以基于各种性能指标明确定义,如任务完成、效率和准确性,允许智能体优化其动作以获得最大有效性。图18展示了GUI智能体中任务完成的MDP建模示例,其中状态、动作和奖励被明确定义。
通过将GUI智能体交互表述为MDP,我们可以利用RL技术训练通过试错学习最优策略的智能体263。这种方法使智能体能够做出随时间最大化累积奖励的决策,导致更有效和高效的任务完成。例如,学习在Web应用中自动化表单填写的智能体可以使用RL发现最有效的动作序列来输入数据并成功提交表单,最小化错误和冗余步骤。这个过程帮助智能体更紧密地与GUI自动化任务中的期望行为对齐,特别是在预定义动作序列不足的复杂或模糊情况下。
作为代表性方法,Bai等人引入了DigiRL264,一种用于在动态环境中训练GUI智能体的两阶段RL框架。DigiRL从离线RL阶段开始,使用离线数据初始化智能体模型,然后进行在线微调,模型直接与环境交互以通过实时数据在Android学习环境中使用LLM评估器提供可靠奖励信号来完善其策略。这种自适应设置使智能体能够有效学习和响应动态GUI的复杂性。Wang等人提出了DistRL265,一种专门为在Android内运行的设备上移动控制智能体设计的RL微调管道。DistRL采用异步架构,在异构工作设备和环境中部署RL微调智能体进行去中心化数据收集。通过利用离策略RL技术,DistRL使集中训练能够使用从多样环境远程收集的数据,显著增强模型的可扩展性和鲁棒性。这些代表性方法说明了RL改进GUI智能体的潜力,展示了集中式和分布式RL框架如何能够在真实世界应用中实现更响应、自适应和有效的GUI自动化模型。
5.7.6 总结与要点
总之,先进技术显著增强了LLM训练的GUI智能体的能力,使其在多智能体框架内更加多功能、高效和自适应。重要的是,这些技术并非互斥------许多可以整合以创建更强大的智能体。例如,在多智能体框架内纳入自我反思允许智能体协作改进任务策略并从错误中恢复。通过利用这些进步,开发者可以设计不仅擅长自动化复杂多步骤任务,而且能够通过自我进化、适应动态环境和有效的智能体间协作持续改进的LLM训练的GUI智能体。未来研究预计将产生更复杂的技术,进一步扩展GUI自动化的范围和鲁棒性。
5.8 从基础到创新:路线图
构建鲁棒、自适应和有效的LLM驱动的GUI智能体是一个多方面的过程,需要仔细整合几个核心组件。在第5节中概述了架构、设计、环境交互和记忆的坚实基础后,我们现在将重点转向在实际场景中部署这些智能体所需的关键要素。这一探索从第6节中对最先进的LLM训练的GUI智能体框架的深入回顾开始,突出其进步和对该领域的独特贡献。在此基础上,我们深入研究优化GUI智能体LLM的方法,从第7节的数据收集和处理策略开始,进展到第8节的模型优化技术。为确保鲁棒开发和验证,我们随后在第9节中考察评估方法和基准,这对于评估智能体性能和可靠性至关重要。最后,我们在第10节中探索各种实际应用,展示这些智能体在不同领域的变革性影响。
这些章节共同提供了从基础概念到真实世界实施和创新的LLM训练的GUI智能体推进的全面路线图。这条路线图,从基础组件到真实世界部署,封装了将LLM驱动的GUI智能体概念从构思到实施所需的 essential 管道。
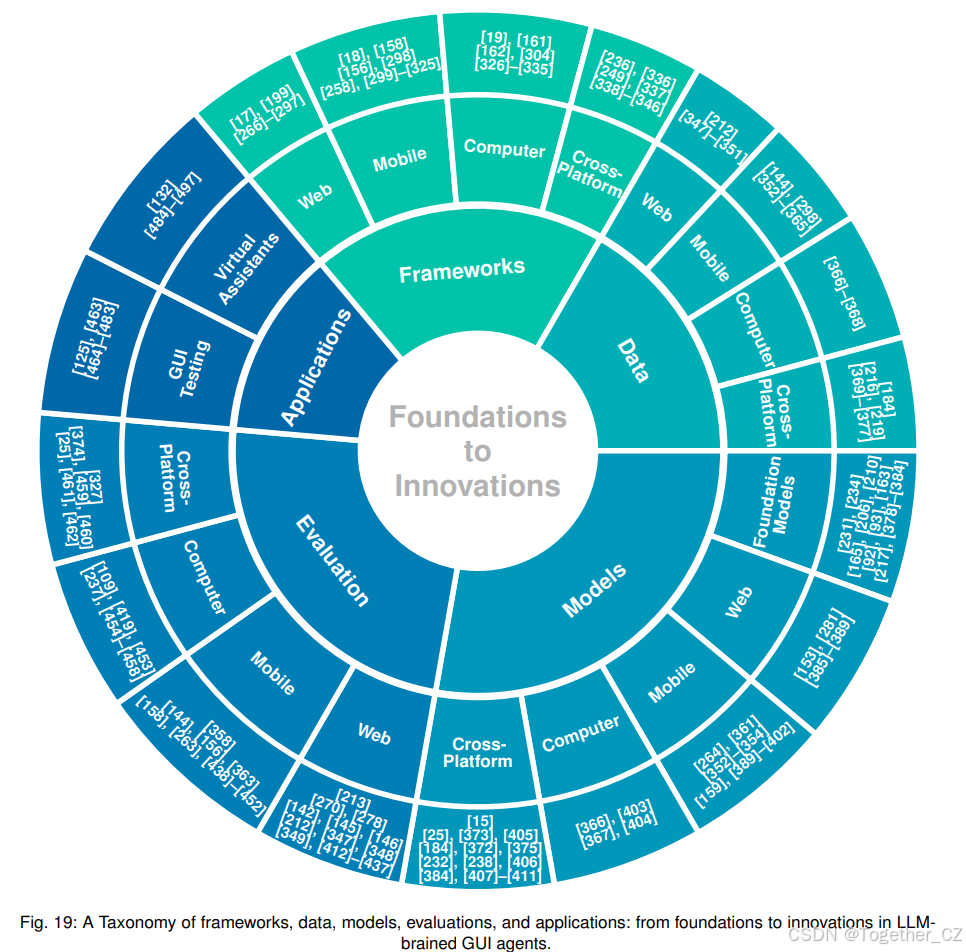
为了提供全面的视图,我们首先在图19中引入分类法,对LLM训练的GUI智能体的近期工作进行分类,涵盖框架、数据、模型、评估和应用。这个分类法作为导航每个领域广泛研究和开发工作的蓝图,同时承认类别之间的重叠,其中某些模型、框架或数据集有助于GUI智能体功能的多个方面。
我们详细讨论每个框架,考察其基础设计原则、技术进步以及它们在GUI自动化领域解决的具体挑战。通过深入研究这些方面,我们旨在提供更深入的见解,了解这些智能体如何塑造人机交互和任务自动化的未来,以及它们在推动这一变革性领域中发挥的关键作用。
6.1 Web GUI智能体
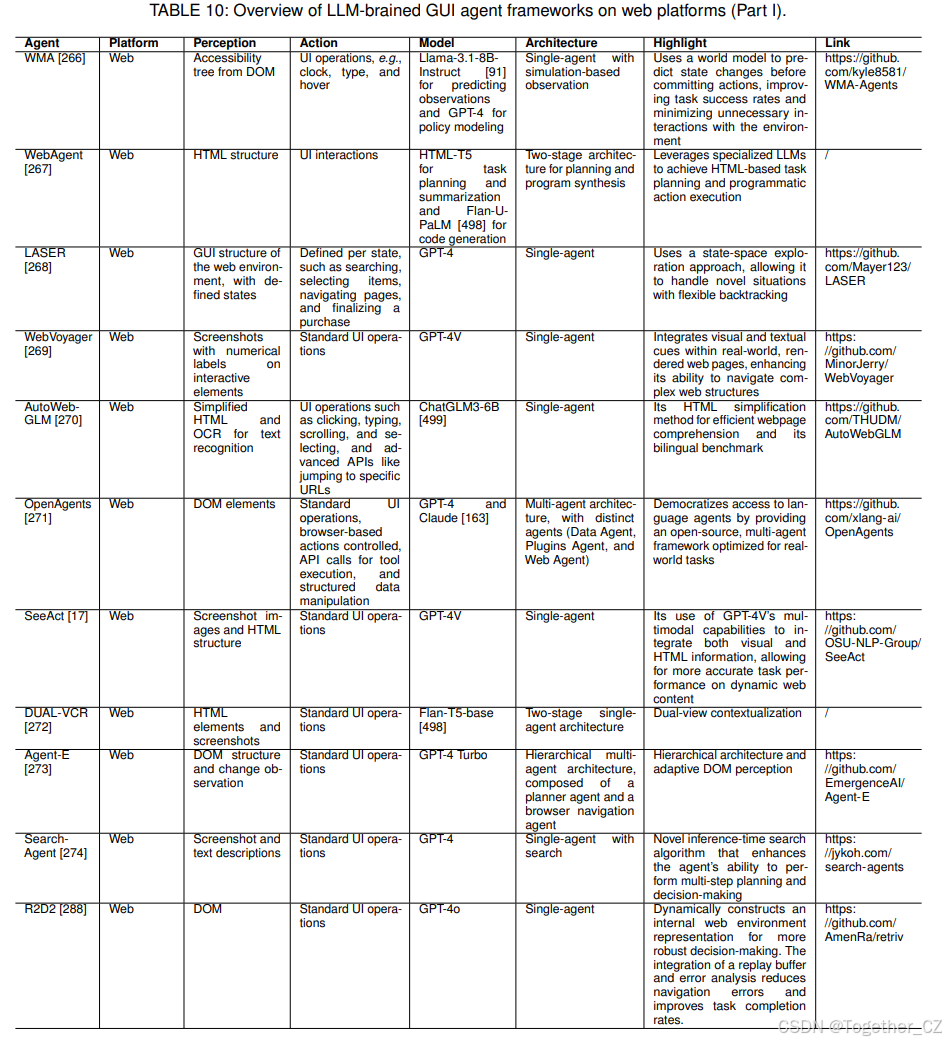
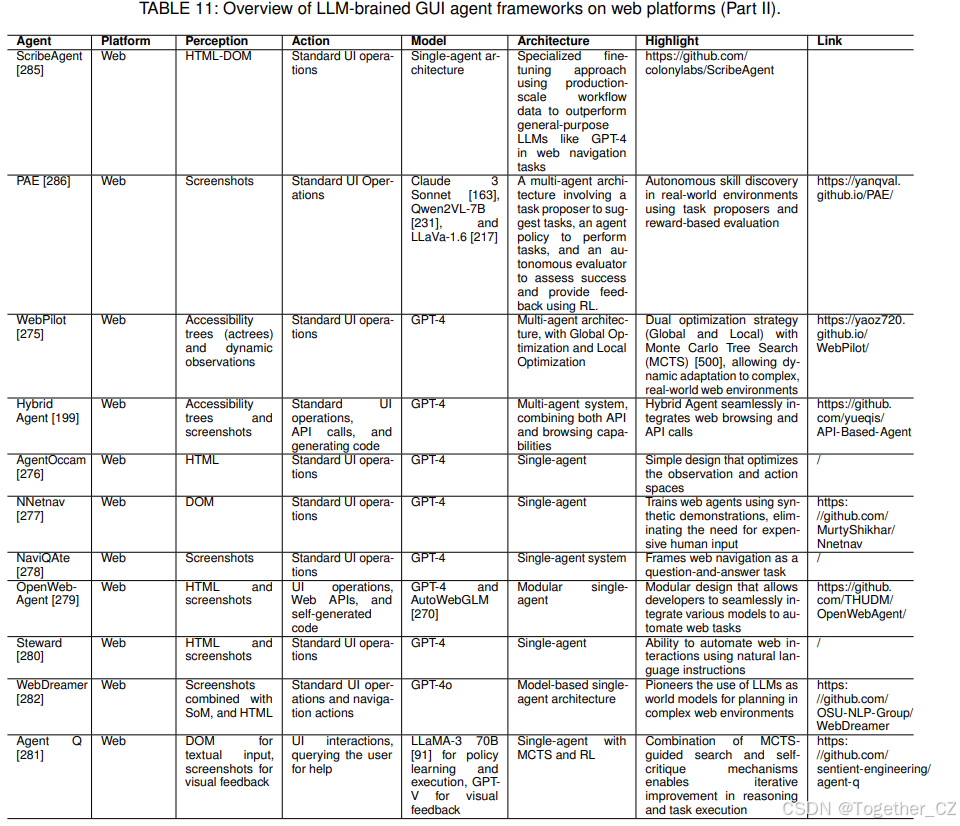
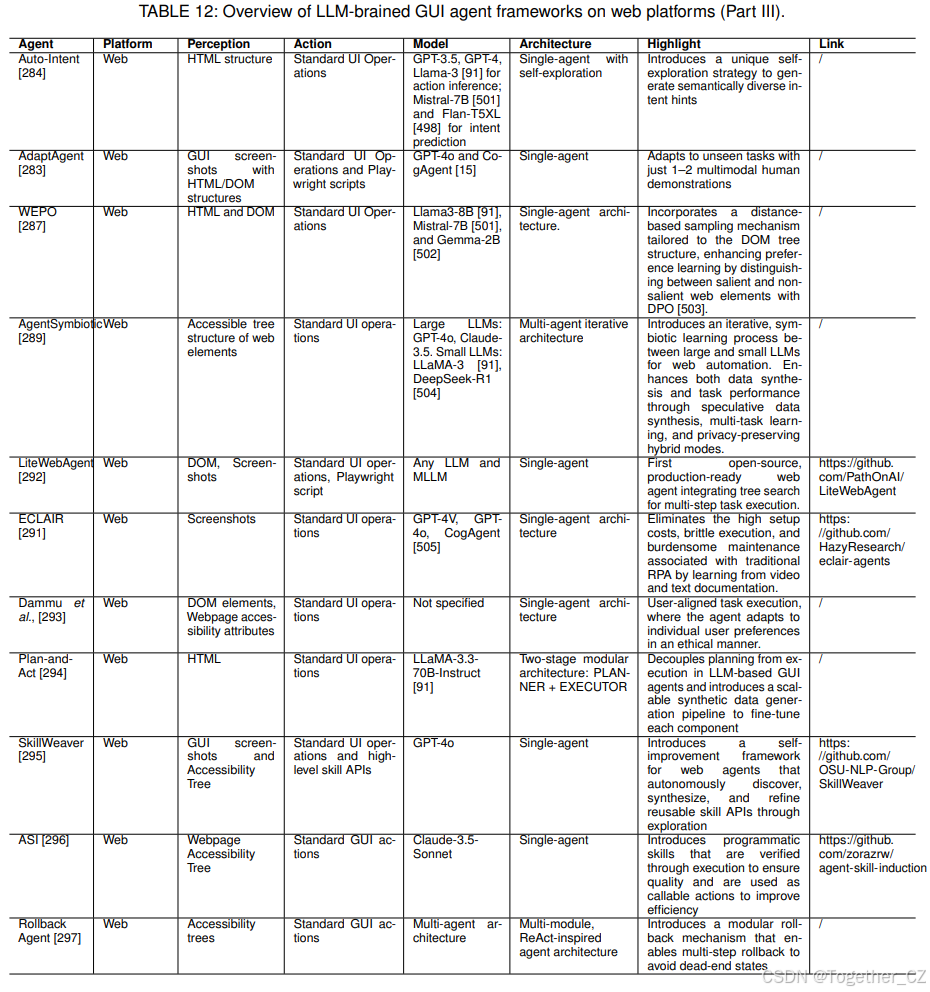
Web GUI智能体的进步在自动化多样和动态Web环境中的复杂任务方面取得了重大进展。最近的框架引入了创新方法,利用多模态输入、预测建模和任务特定优化来增强性能、适应性和效率。在本小节中,我们首先在表10、11和12中总结关键Web GUI智能体框架,然后深入探讨代表性框架,突出其独特贡献以及它们如何共同推动基于Web的GUI自动化的边界。
一个显著趋势是整合多模态能力以改进与动态Web内容的交互。例如,SeeAct17利用GPT-4V的多模态能力在实时网站上有效定位动作。通过利用视觉数据和HTML结构,SeeAct整合使用图像注释、HTML属性和文本选择的定位技术,优化与实时Web内容的交互。这种方法使SeeAct在实时Web任务上实现了51.1%的任务成功率,突出了动态评估在开发鲁棒Web智能体中的重要性。
基于多模态输入的优势,WebVoyager269通过支持跨真实世界Web环境的端到端任务完成来推进自主Web导航。利用GPT-4V进行视觉(截图)和文本(HTML元素)输入,WebVoyager有效与动态Web界面交互,包括具有动态渲染内容和复杂交互元素的界面。这种多模态能力使WebVoyager能够以显著超过传统纯文本方法的成功率管理复杂界面,为基于Web的任务自动化设定了新基准。
除了多模态整合,一些框架专注于解析复杂的Web结构并生成可执行代码以导航复杂网站。WebAgent267采用两层模型方法,将用于解析长复杂HTML文档的HTML-T5与用于程序合成的Flan-U-PaLM498相结合。这种模块化设计使WebAgent能够将用户指令转换为可执行Python代码,通过任务特定子指令自主处理复杂真实世界网站。WebAgent在真实网站上展示了相比传统单智能体模型50%的成功率提升,展示了将HTML特定解析与代码生成整合用于多样和动态Web环境的优势。
为了增强Web导航中的决策,一些框架引入了状态空间探索和搜索算法。LASER268将Web导航建模为状态空间探索,允许灵活回溯和高效决策,无需大量上下文示例。通过将动作与特定状态关联并利用GPT-4的函数调用功能进行基于状态的动作选择,LASER最小化错误并提高任务成功,特别是在WebShop和Amazon等电子商务导航任务中。这种基于状态的方法提供了可扩展和高效的解决方案,推进了LLM智能体在GUI导航中的效率。
类似地,Search-Agent274创新性地引入了最佳优先搜索算法,以增强交互式Web环境中的多步骤推理。通过探索多个动作路径,这种方法改进了决策,在WebArena412等基准上实现了高达39%的成功率提升。Search-Agent与现有多模态LLM的兼容性证明了基于搜索的算法对复杂交互式Web任务的有效性。
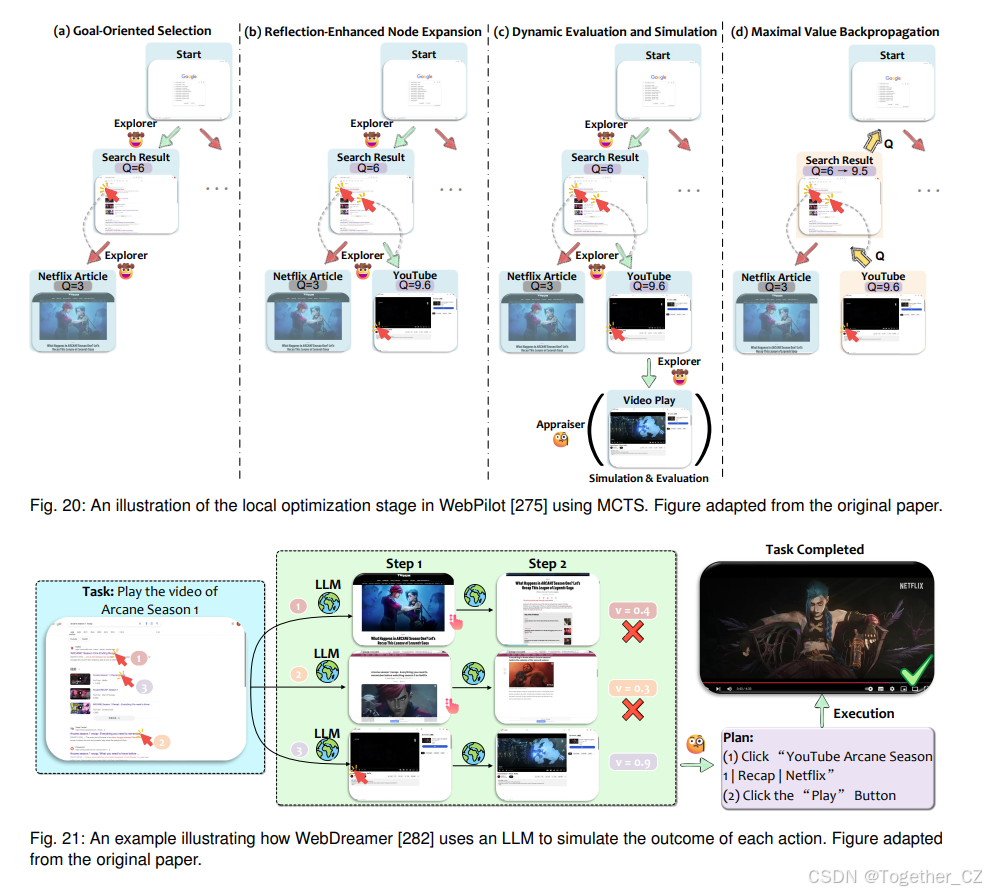
扩展基于搜索的策略,WebPilot275采用结合全局和局部蒙特卡洛树搜索(MCTS)500的双重优化策略,以提高复杂和动态环境中的适应性。如图20所示,WebPilot将总体任务分解为可管理的子任务,每个子任务经历局部优化。这种方法允许WebPilot根据实时观察持续调整策略,模仿类人决策和灵活性。在WebArena412和MiniWoB++146等基准上的广泛测试证明了WebPilot的最先进性能,展示了与现有方法相比的卓越适应性。
进一步推进预测建模的概念,WMA266引入了世界模型来模拟和预测UI交互的结果。通过关注基于转换的观察,WMA允许智能体在提交之前模拟动作结果,减少不必要的动作并提高任务效率。这种预测能力在需要高准确性的长视野任务中特别有效,WMA在WebArena412和Mind2Web212等基准上展示了强大性能。
沿着类似的思路,WebDreamer282引入了LLM用于Web导航中基于模型的规划的创新用途,如图21所示。WebDreamer在执行前使用LLM模拟和评估潜在动作及其多步结果506,类似于一个"梦想家"设想各种场景。通过预先评估不同计划的潜在价值,WebDreamer选择并执行期望值最高的计划。这种方法解决了Web自动化中的关键挑战,如安全问题和复杂动态环境中对鲁棒决策的需求,在VisualWebArena413和Mind2Web-live349等基准上展现出优于反应式智能体的性能。
超越预测建模,将API交互整合到Web导航中提供了增强的灵活性和效率。Hybrid Agent199结合了网页浏览和API交互,根据任务需求在方法之间动态切换。通过利用API调用处理结构化数据交互,Hybrid Agent减少了传统Web导航所需的时间和复杂性,在任务性能和效率方面实现了更高的准确性和效率。这种混合架构凸显了整合结构化API数据和类人浏览能力在AI智能体系统中的优势。
针对复杂Web结构和跨域交互的挑战,AutoWebGLM270通过简化HTML以聚焦关键网页组件来提高任务准确性,提供了一种高效解决方案。利用强化学习和拒绝采样进行微调,AutoWebGLM在英文和中文网站的复杂导航任务中表现出色。其双语数据集和结构化动作-感知模块使其适用于跨域Web交互,强调了在多样Web任务中高效处理的重要性。
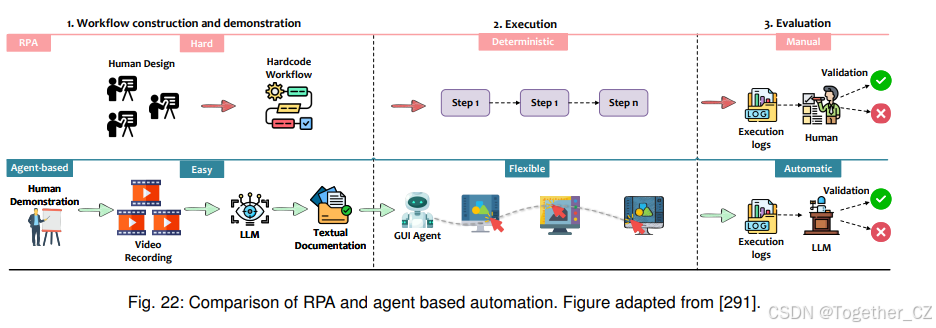
ECLAIR291代表了一个开创性应用,用基础模型驱动的GUI智能体替代传统RPA用于企业自动化。与依赖手动编程规则和刚性脚本的传统RPA不同,ECLAIR从视频演示和文本SOP(标准操作程序)中动态学习工作流,显著减少设置时间并提高适应性。它在企业Web应用上运行,利用GPT-4V和CogAgent505感知GUI元素、规划动作、执行工作流并自动验证。通过消除RPA的高维护成本 and 执行脆弱性,ECLAIR引入了一种更灵活和可扩展的GUI自动化方法。我们在图22中展示了这种基于智能体的自动化与RPA自动化的比较。这项工作为LLM驱动的GUI自动化建立了重要基础,展示了多模态基础模型如何弥合流程挖掘、RPA和完全自主企业工作流之间的差距。
总之,Web GUI智能体的近期框架通过整合多模态输入、预测模型和高级任务特定优化取得了实质性进展。这些创新为真实世界任务提供了鲁棒解决方案,增强了基于Web的GUI智能体的能力,标志着开发智能、自适应Web自动化的重要步骤。
6.2 移动GUI智能体
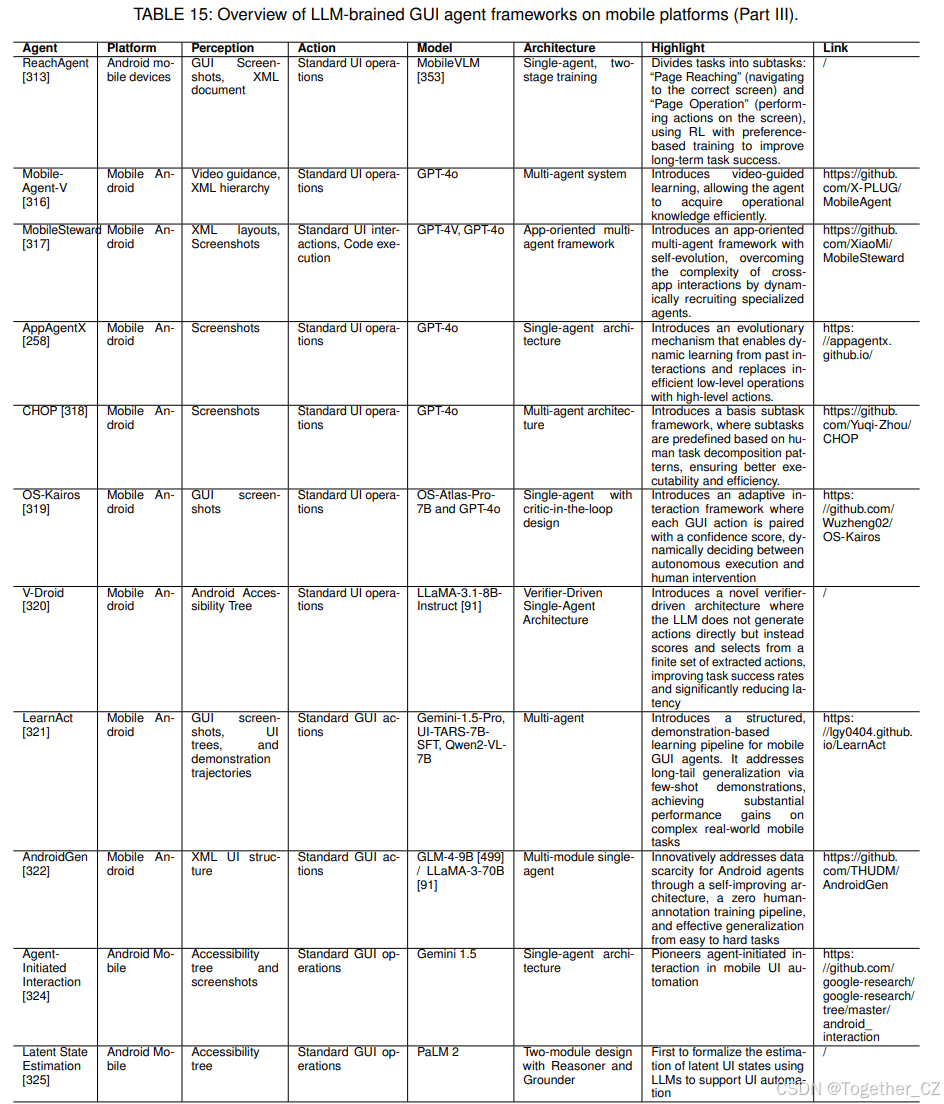
移动GUI智能体的演变以利用多模态模型、复杂架构和自适应规划来应对移动环境独特挑战的显著进步为标志。这些智能体从基本交互能力发展到能够在多样移动应用中执行动态、上下文感知操作的复杂系统。我们首先在表13、14和15中概述移动GUI智能体框架。
Wang等人323开创性地使用LLM实现与移动UI的对话交互,为移动GUI智能体建立了最早的基础之一。他们的方法涉及直接使用Android视图层次的结构化表示提示PaLM等基础模型,这些表示被转换为类HTML文本以更好地对齐LLM的训练分布。作者定义并评估了四个核心任务,包括屏幕摘要、屏幕问答、屏幕问题生成和指令到UI映射------证明只需每个任务两个提示示例即可实现强大性能。强调实用性和可访问性,这项工作实现了无需模型微调的快速原型设计,是LLM驱动的移动应用GUI智能体基于提示评估的开创性努力。
早期努力集中在实现类人GUI交互而无需后端系统访问。AppAgent18就是这样一个开创性框架,它利用GPT-4V的多模态能力理解并响应视觉和文本信息。通过使用实时截图和结构化XML数据执行点击和滑动等操作,AppAgent可以直接与各种应用(从社交媒体到复杂图像编辑)的GUI交互。其通过自主探索和观察人类演示学习的独特方法允许快速适应新应用,突出了多模态能力在移动智能体中的有效性。
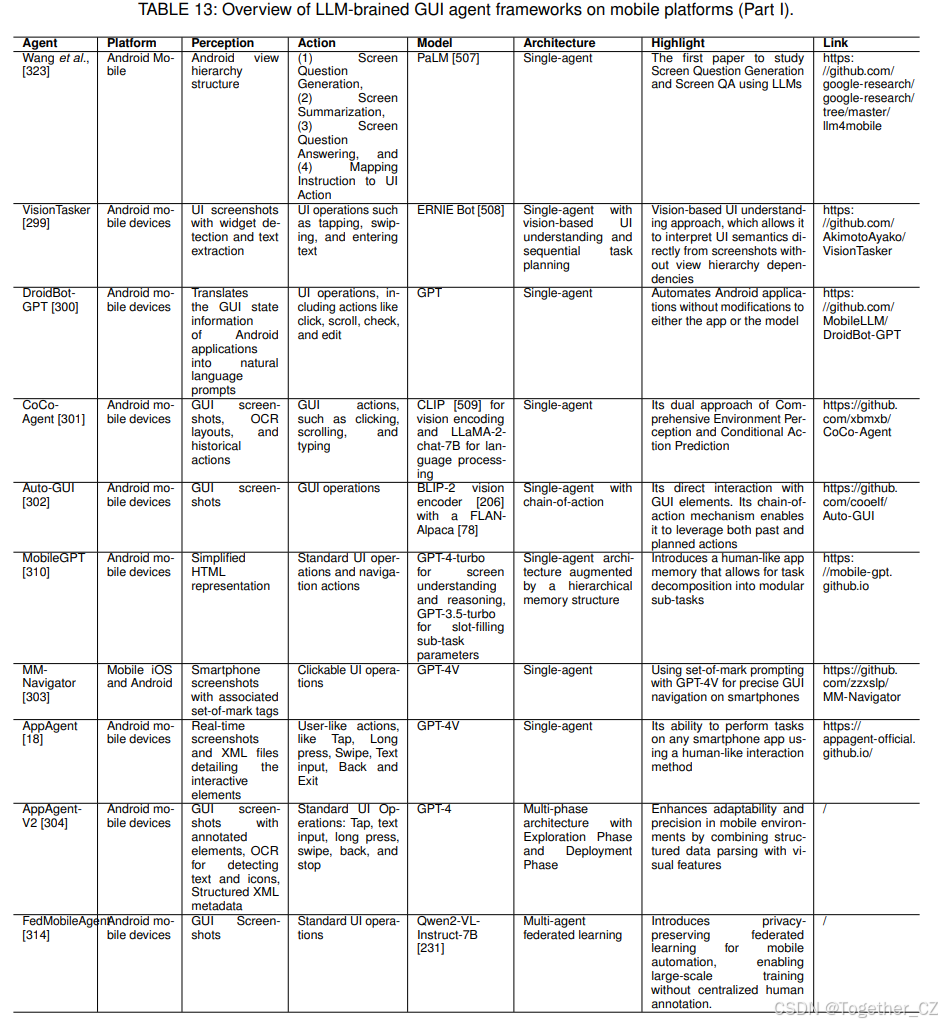
在此基础上,AppAgent-V2304通过增强视觉识别和纳入结构化数据解析来推进框架。这实现了精确的上下文感知交互以及在跨不同应用中执行复杂多步骤操作的能力。AppAgent-V2还引入了安全检查以处理敏感数据,并通过跟踪和适应实时交互支持跨应用任务。这一进展强调了先进视觉识别和结构化数据处理在提高实时移动环境中任务精度和安全性方面的重要性。
与这些发展并行,以视觉为中心的方法出现,以进一步增强移动任务自动化而无需依赖应用特定数据。例如,MobileAgent158利用OCR、CLIP509和Grounding DINO183进行视觉感知。通过使用截图和视觉工具,Mobile-Agent执行从应用导航到复杂多任务的操作,迭代遵循指令并通过自反思机制调整错误。这种基于视觉的方法将MobileAgent定位为移动任务的多功能自适应助手。
为了应对长序列导航和复杂的多应用场景挑战,Mobile-Agent-v2306引入了多智能体架构,将规划、决策和反思分离。通过在三个智能体之间分配职责,该框架优化任务进度跟踪、保留任务相关信息记忆,并在错误发生时执行纠正动作。与Grounding DINO183和Qwen-VL-Int4210等先进视觉感知工具集成,Mobile-Agent-v2在Android和Harmony OS上展示了任务完成率的显著改进,突出了多智能体系统处理复杂移动任务的潜力。
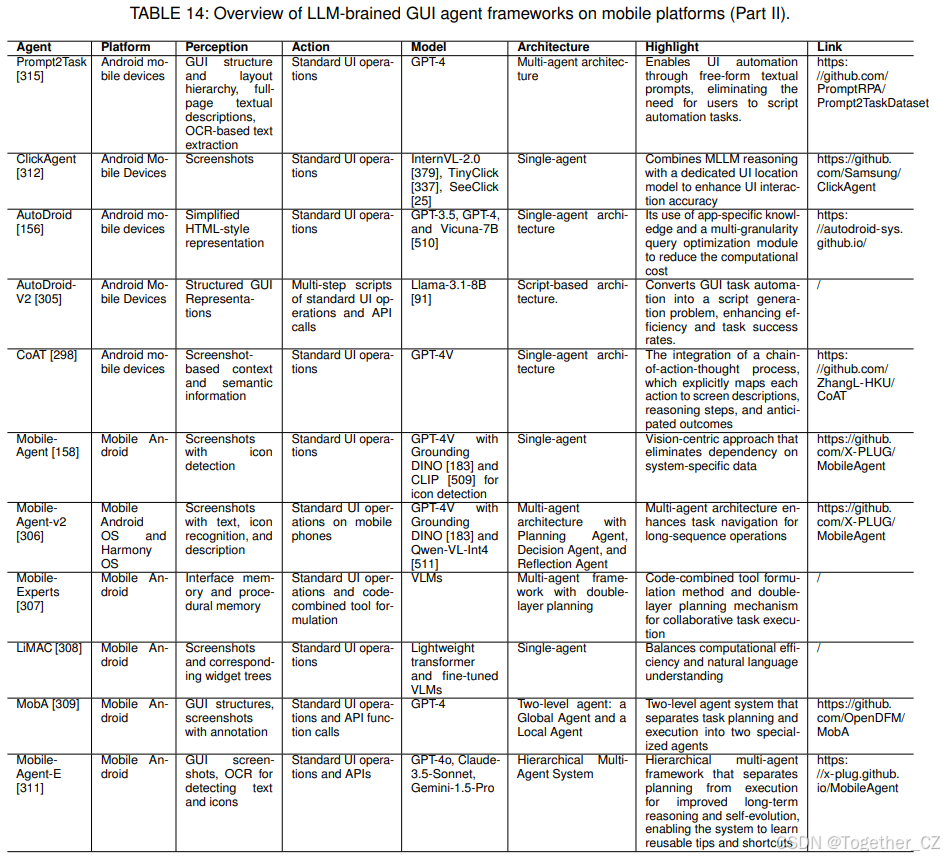
除了以视觉为中心的方法外,一些框架专注于将GUI状态转换为语言以实现基于LLM的动作规划。VisionTasker299将基于视觉的UI解释与顺序LLM任务规划相结合,通过将移动UI截图处理为结构化自然语言。在YOLO-v8207和PaddleOCR²⁸的支持下进行控件检测,VisionTasker允许智能体在陌生应用中自动化复杂任务,在某些任务上展示出比人类操作员更高的准确性。这种两阶段设计说明了一个多功能和自适应的框架,为移动自动化树立了强有力的先例。
类似地,DroidBot-GPT300展示了一种创新方法,将GUI状态转换为自然语言提示,使LLM能够自主决定动作序列。通过解释GUI结构并将其转换为GPT模型可以理解的语言,DroidBot-GPT无需应用特定修改即可泛化到各种应用。这种适应性强调了LLM在处理复杂多步骤任务中具有最小自定义数据的变革性作用。
为了增强动作预测和上下文感知,先进框架将感知和动作系统整合在多模态LLM中。CoCo-Agent301通过其综合事件感知和综合动作规划模块处理图标和布局等GUI元素来例证这一点。通过将动作分解为可管理步骤并利用Android in the Wild(AITW)358和META-GUI357等基准的高质量数据,CoCo-Agent展示了在多样智能手机应用中可靠自动化移动任务的能力。
进一步推进这种整合,CoAT298引入了动作链思维过程以增强动作预测和上下文感知。利用GPT-4V和set-of-mark标记等复杂模型,CoAT解决了传统基于坐标的动作识别的局限性。通过利用Android-In-The-Zoo(AITZ)数据集构建,CoAT提供了深度上下文感知,提高了动作预测准确性和任务完成率,突出了其在Android平台上增强可访问性和用户便利性的潜力。
针对以较低计算成本高效处理多步骤任务的需求,AutoDroid156将基于LLM的理解与应用特定知识相结合。使用HTML风格GUI表示和基于记忆的方法,AutoDroid减少了对大量LLM查询的依赖。其云和端侧模型的混合架构增强了响应性和可访问性,使AutoDroid成为多样移动任务的实用解决方案。AutoDroid-V2305通过利用端侧语言模型生成和执行多步骤脚本以自动化用户任务来增强其前身。通过将移动应用的动态复杂GUI元素转换为结构化应用文档,它实现了高效准确自动化而不依赖云端资源。这种基于脚本的方法通过最小化查询频率降低计算开销,从而提高任务效率并解决逐步智能体的局限性。这一进步实现了移动平台上隐私保护和可扩展的任务自动化。
MobileGPT310使用类人应用记忆系统在Android设备上自动化任务,该系统模拟任务分解的认知过程------探索、选择、推导和回忆。这种方法产生了高度高效和准确的任务自动化。其层次记忆结构支持跨多样上下文的模块化、可重用和适应性任务及子任务。MobileGPT在任务成功率、成本效率和适应性方面展示了优于最先进系统的性能,突显了其推进移动任务自动化的潜力。
在更先进的分布式设置中,FedMobileAgent314采用联邦学习框架,使用用户手机交互的自源数据训练移动自动化智能体。它通过引入自动注释来解决与传统人工标注数据集相关的高成本和隐私问题,自动注释利用视觉语言模型(VLM)从截图和动作推断用户意图。该系统通过联邦学习实现去中心化训练,同时保护用户隐私,其自适应聚合方法增强了非IID数据条件下的模型性能。在多个移动基准上的实验结果表明,FedMobileAgent以人工标注模型成本的一小部分实现了相当的性能。
总之,移动GUI智能体已经显著发展,从单智能体系统进展到能够动态、上下文感知操作的复杂多智能体框架。这些创新表明,复杂架构、多模态处理和先进规划策略对于处理移动环境的多样挑战至关重要,标志着移动自动化能力的重大进步。
6.3 计算机GUI智能体
计算机GUI智能体已发展到跨多样操作系统提供复杂自动化能力,解决跨应用交互、任务泛化和高级任务规划等挑战。它们导致了能够在桌面环境中处理复杂任务的复杂框架的发展。这些智能体从简单自动化工具发展到智能系统。
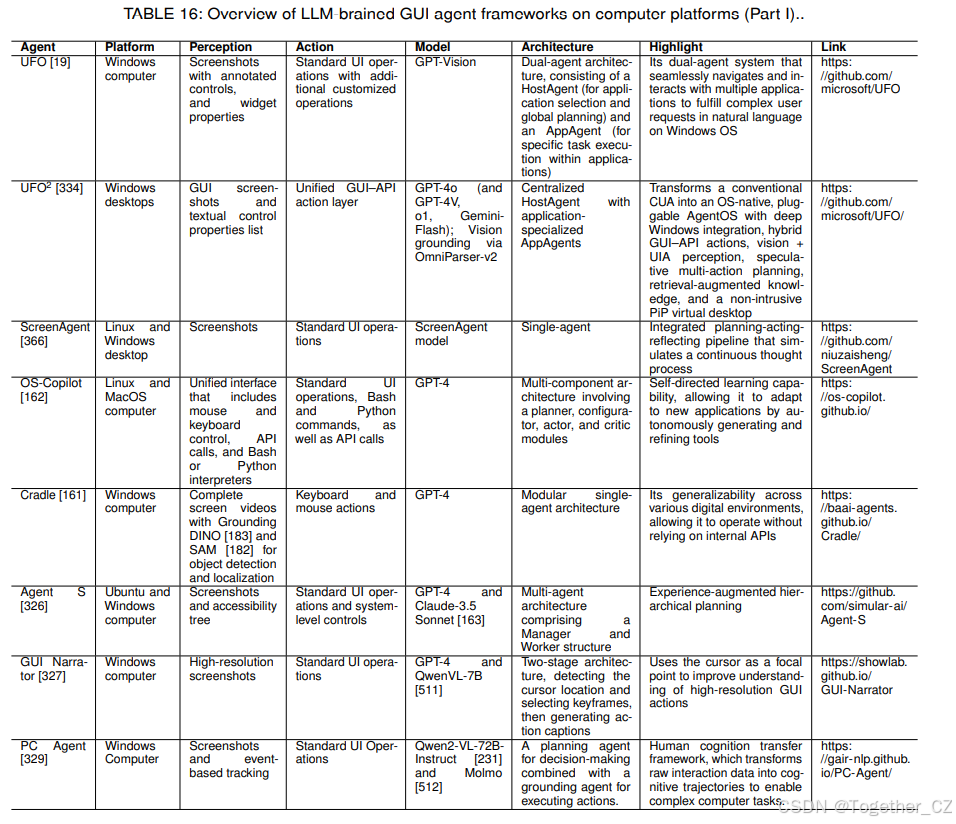
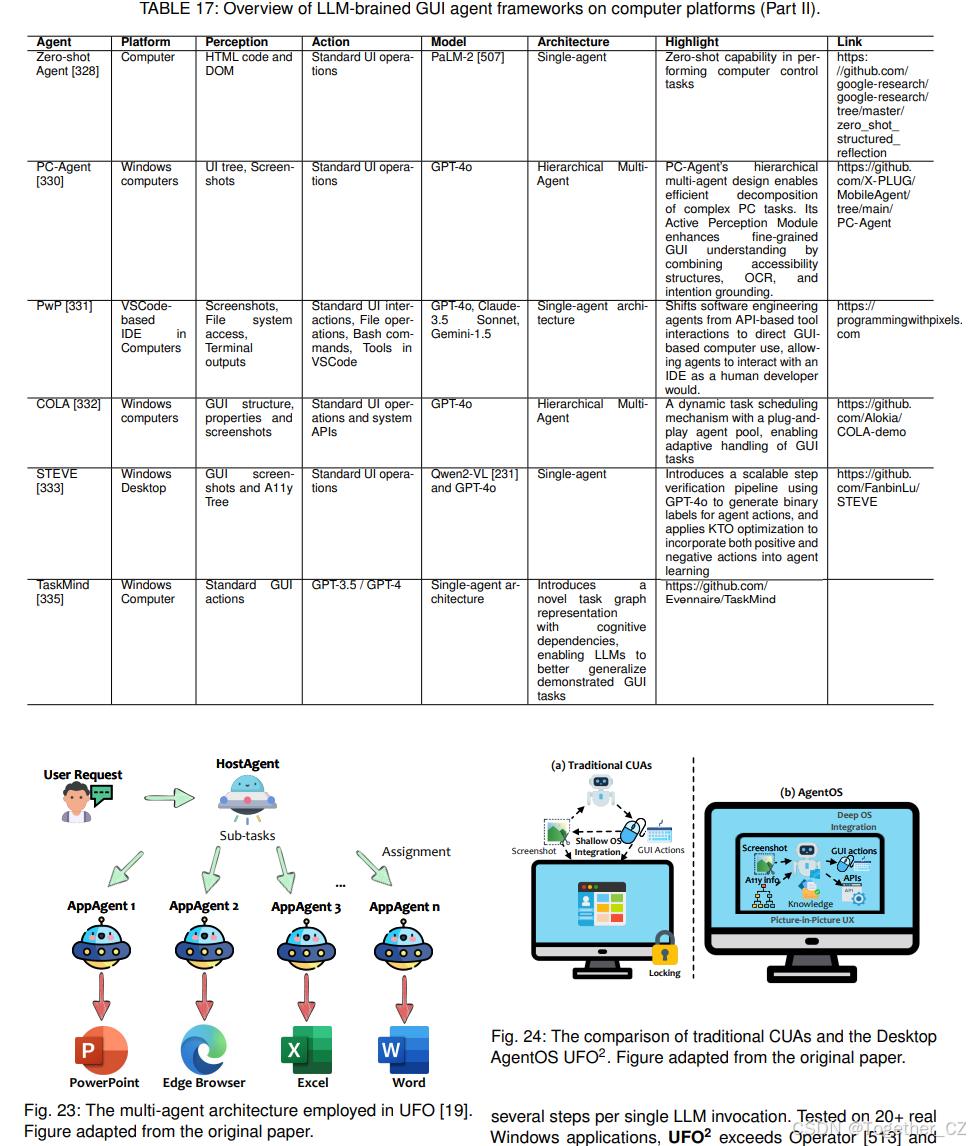
UFO19是Windows操作系统交互的突出框架,采用双智能体架构,包括用于跨应用协调的HostAgent和用于应用特定执行的AppAgent。如图23所示,HostAgent解释用户请求,将其分解为子任务,并将这些子任务分配给相应的AppAgent。每个AppAgent随后在其指定应用内执行动作,利用UI Automation(UIA)API等工具获取控件信息并执行操作。UFO引入了以UI为中心的交互方法,利用Windows UIA API收集详细的控件信息,使智能体能够准确理解应用界面并与之交互。通过利用GPT-4V的视觉能力,UFO还可以处理UIA信息不足的场景,使用截图进行补充理解。UFO2334进一步增强了这一框架,引入Picture-in-Picture界面,允许智能体在虚拟化桌面环境中运行而不中断用户工作流。UFO2还通过检索增强的帮助文档和执行日志进一步提升运行时性能,结合推测性多动作规划,每次LLM调用执行多个步骤。在20多个真实Windows应用上测试,UFO2在成功率上超过Operator513和其他CUA超过10个百分点,同时将LLM调用减半。由于框架是模型无关的,将GPT-4o替换为更强的LLM(如o1)可在无需代码更改的情况下获得额外收益。
在适应性和通用能力主题的基础上,Cradle161通过利用VLM与各种软件交互,从游戏到专业应用,无需API访问,推动了通用计算机控制的边界。Cradle采用GPT-4o解释屏幕输入并执行低级动作,使其适用于不同类型的软件环境。其六模块结构涵盖信息收集和自我反思等功能,使智能体能够执行任务、推理动作并利用过去交互为未来决策提供信息。Cradle在动态环境(包括复杂软件)中运行的能力标志着朝着创建具有广泛桌面环境适用性的通用智能体迈出的重要一步。
将计算机GUI智能体的能力扩展到多个操作系统,OS-Copilot162引入了设计用于跨Linux和macOS系统运行的通用框架。其显著特征FRIDAY展示了自 directed 学习的潜力,通过适应各种应用并执行任务而无需为每个应用显式训练。与特定应用智能体不同,FRIDAY集成了API、键盘和鼠标控制以及命令行操作,创建了一个灵活平台,可以在与新应用交互时自主生成和完善工具。OS-Copilot在未见应用上的泛化能力,通过其在GAIA基准上的性能验证,为能够在复杂环境中进化的OS级智能体提供了基础模型。这展示了创建能够处理多样桌面环境和复杂任务要求的自适应数字助手的 promising 方向。
在LLM驱动的桌面环境GUI智能体的新兴领域中,Programming with Pixels(PwP)331引入了传统基于工具的软件工程智能体的引人注目的替代方案。PwP不依赖预定义API调用,而是使智能体能够使用视觉感知、键盘输入和鼠标点击直接与IDE交互,模仿人类开发人员在IDE中操作的方式。这种方法允许超越预定义API的泛化,提供高度表达性的环境,智能体可以执行广泛的软件工程任务,包括调试、UI生成和代码编辑。在PwP-Bench上进行的评估表明,计算机使用智能体尽管缺乏对结构化API的直接访问,但在某些场景中可以达到甚至超过传统基于工具的方法。
总之,计算机GUI智能体已经显著发展,从单任务自动化工具进展到能够执行复杂多应用任务并从交互中学习的先进多智能体系统。UFO、Cradle和OS-Copilot等框架说明了自适应、通用智能体在桌面自动化中的潜力,为更智能和多功能的AgentOS框架的演变铺平了道路。
6.4 跨平台GUI智能体
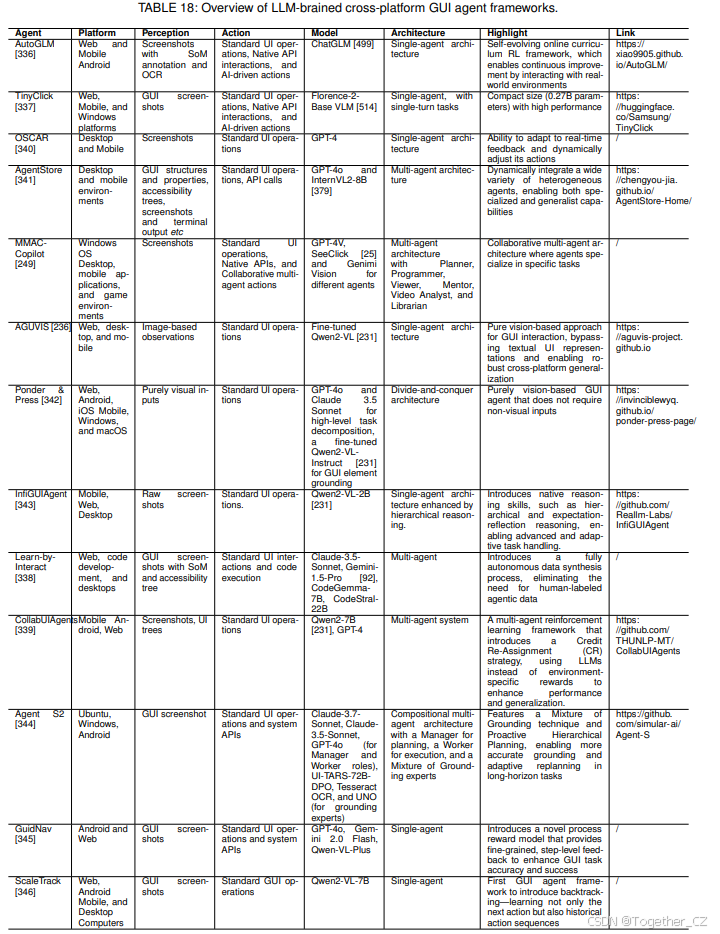
跨平台GUI智能体已成为能够与各种环境(从桌面和移动平台到更复杂系统)交互的多功能解决方案。这些框架优先考虑适应性和效率,利用轻量级模型和多智能体架构来增强跨平台可操作性。在本小节中,我们首先在表18中概述跨平台GUI智能体框架,然后探讨体现跨平台GUI自动化进步的关键框架。
这一领域的一个重要进展由AutoGLM336代表,它通过整合大型多模态模型实现跨平台无缝GUI交互,弥合了网页浏览和Android控制之间的差距。AutoGLM引入了中间接口设计,将规划和定位任务分离,改进了动态决策和适应性。通过采用具有强化学习的自进化在线课程,智能体从真实世界反馈中增量学习并能够从错误中恢复。这种适应性和鲁棒性使AutoGLM成为多样用户应用中真实世界部署的理想选择,为跨平台自动化设定了新标准,并为未来基础智能体研究提供了 promising 方向。
虽然一些框架专注于整合先进模型进行跨平台交互,但其他框架强调效率和可访问性。TinyClick337通过专注于GUI内的单轮交互来解决轻量级解决方案的需求。利用Florence-2-Base视觉语言模型,TinyClick仅用0.27亿参数即可基于用户命令和截图执行任务。尽管体积紧凑,它仍实现了高准确性------在Screenspot25上达到73%,在OmniAct459上达到58.3%------超过GPT-4V等更大的多模态模型,同时保持效率。其多任务训练和基于MLLM的数据增强实现了精确的UI元素定位,使其适用于低资源环境,并解决了UI定位和动作执行中的延迟和资源约束。
除了轻量级模型外,多智能体架构在增强跨平台GUI交互中发挥着关键作用。OSCAR340通过引入能够自主导航和控制桌面及移动应用的通用GUI智能体来例证这种方法。通过利用状态机架构,OSCAR动态处理错误并根据实时反馈调整其动作,使其适合由自然语言指导的复杂工作流自动化。标准OS控制(如键盘和鼠标输入)的整合允许OSCAR以通用方式与应用交互,提高多样GUI环境中的生产力。其开源设计促进了广泛采用和无缝集成,为跨平台任务自动化和生产力增强提供了多功能工具。
在 multi-agent 系统概念的基础上,AgentStore341引入了灵活和可扩展的框架,用于整合异构智能体以跨操作系统自动化任务。AgentStore的关键特征是MetaAgent,它使用创新的AgentToken策略动态管理不断增长的专用智能体。通过启用动态智能体注册,该框架促进适应性和可扩展性,允许专业化和通用能力共存。这种多智能体架构支持多样平台,包括桌面和移动环境,利用GUI结构和系统状态等多模态感知。AgentStore的贡献突出了结合专业化与通用能力以克服先前系统局限性的重要性。
进一步推进跨平台GUI交互,MMAC-Copilot249采用多智能体、多模态方法处理3D游戏、办公和移动应用中的任务,不依赖API。通过利用Planner、Viewer和Programmer等专用智能体,MMAC-Copilot协作适应视觉丰富环境的复杂性。使用GPT-4V进行视觉识别和OCR进行文本分析,它在视觉复杂环境中实现了高任务完成率。该框架与VIBench(非API应用基准)的整合强调了其真实世界相关性和适应性。MMAC-Copilot在跨平台动态交互方面的鲁棒基础将应用扩展到游戏、医疗保健和生产力等行业。
AGUVIS236利用纯视觉方法自动化GUI交互,克服了HTML或无障碍树等基于文本系统的局限性。其平台无关设计支持Web、桌面和移动应用,同时降低推理成本。AGUVIS采用两阶段训练过程:第一阶段专注于GUI定位,第二阶段在统一模型中整合规划和推理。这种方法在离线和在线场景中都提供了最先进的性能,简化了决策和执行。
Agent S2344在其前身Agent S326的基础上,引入了用于GUI智能体的层次和组合框架,将通用模型与专用定位模块整合。它偏离了单体架构,采用Grounding混合(MoG)策略将细粒度定位任务委托给专家模块,并采用主动层次规划(PHP)根据不断演变的观察动态修订行动计划。仅依赖GUI截图,Agent S2在Ubuntu、Windows和Android平台上有效泛化。它展示了强大的可扩展性,并通过战略性地分配认知职责持续优于更大的单体模型。Agent S2的设计强调了模块化架构在处理长视野、高保真GUI交互方面的优势。
总之,跨平台GUI智能体体现了多功能自动化的未来,提供了从TinyClick等轻量级模型到MMAC-Copilot等复杂多智能体系统的解决方案。每个框架都带来独特创新,为多样化的GUI自动化工具生态系统做出贡献,增强了跨不同平台的交互能力,标志着跨平台GUI自动化的重大进步。
6.5 要点
GUI智能体框架的格局已经取得了显著进步,特别是在多智能体架构、多模态输入和增强动作集方面。这些发展为更通用和强大的智能体奠定了基础,能够处理复杂、动态的环境。近期进展的关键要点包括:
1)多智能体协同:多智能体系统,如UFO19和MMAC-Copilot249中的系统,代表了GUI智能体发展的显著趋势。通过在框架内为不同智能体分配专门角色,多智能体系统可以增强任务效率、适应性和整体性能。随着智能体在多样平台上承担更复杂的任务,多个智能体的协调使用被证明是一种强大的方法,使智能体能够以更高的精度和速度处理复杂工作流。
2)多模态输入优势:虽然一些智能体仍然仅依赖文本输入(如DOM结构或HTML),但纳入视觉输入(如截图)已显示出明显的性能优势。WebVoyager269和SeeAct17等智能体突出了视觉数据与文本输入相结合如何提供更丰富的环境状态表示,帮助智能体做出更明智的决策。这种多模态输入的整合对于在视觉复杂或动态环境中准确解释至关重要,其中仅文本可能无法捕获所有必要上下文。
3)超越UI操作扩展动作集:最近的智能体已将其动作集扩展到标准UI操作之外,包括API调用和AI驱动动作,如Hybrid Agent199和AutoWebGLM270所示。纳入多样动作使智能体能够实现更高水平的交互和任务完成,特别是在可以通过API调用直接检索或操作数据的环境中。这种灵活性增强了智能体能力,使其在更广泛的应用中更高效和自适应。
4)改进决策的新兴技术:WMA266中的世界模型和Search-Agent274中基于搜索的策略等新方法代表了更先进决策的 promising 方向。世界模型允许智能体模拟动作结果,减少不必要的交互并提高效率,特别是在长视野任务中。类似地,最佳优先和MCTS等基于搜索的算法帮助智能体更有效地探索动作路径,增强其在复杂实时环境中的适应性。
5)走向跨平台泛化:跨平台框架,如AutoGLM336和OSCAR340,强调了GUI智能体设计中通用性的价值。这些智能体是创建跨移动、桌面和Web平台无缝工作的解决方案的开创性努力,更接近能够跨多个生态系统操作的一站式GUI智能体的目标。跨平台灵活性对于旨在跨数字交互一致地协助用户的智能体至关重要。
6)纯视觉智能体:为了实现通用GUI控制,纯视觉框架已成为突出解决方案。这些智能体仅依赖截图进行决策,无需访问控件树或元素属性等元数据。AGUVIS236等著名工作例证了这种方法。虽然纯视觉方法提供更大的通用性并绕过系统API限制,但它们需要强大的"定位"能力来准确定位和交互UI元素------这是许多基础模型通常缺乏的能力。专门针对视觉定位和GUI理解微调模型,或整合OmniParser184等GUI解析技术,可以解决这一挑战并增强智能体执行精确交互的能力。
GUI智能体领域正朝着多智能体架构、多模态能力、多样动作集和新颖决策策略发展。这些创新标志着朝着创建能够在多样和动态环境中高性能运行的智能、自适应智能体迈出的重要步骤。GUI智能体的未来在于这些趋势的持续完善,推动智能体朝着更广泛适用性和跨平台更复杂、类人交互的方向发展。
7 优化LLM驱动的GUI智能体的数据
在上一节中,我们探讨了LLM训练的GUI智能体的一般框架,其中大多数依赖GPT-4V和GPT-4o等基础LLM。然而,为了提升这些智能体的性能和效率,优化其"大脑"------底层模型至关重要。这通常涉及使用大规模、多样和高质量的上下文GUI数据集515微调基础模型,这些数据集专门策划以使这些模型在GUI特定任务中表现出色。收集此类数据集,特别是富含GUI截图、元数据和交互的数据集,需要复杂的数据获取、过滤和预处理过程,每个都需要大量努力和资源516。
随着GUI智能体继续获得关注,研究人员专注于组装代表广泛平台并捕获GUI环境多样复杂性的数据集。这些数据集对于训练能够有效泛化的模型至关重要,因为它们覆盖了多样界面、工作流和用户交互。为了确保全面表示,已采用创新方法来收集和结构化这些数据资产。在以下章节中,我们详细介绍了为训练GUI特定LLM量身定制的数据收集和处理的端到端管道。我们还考察了来自各种平台的重要数据集,提供了对其独特特征、创建方法和在推进LLM训练的GUI智能体领域潜在应用的见解。
7.1 数据收集
数据对于训练专用GUI智能体至关重要,但由于任务的复杂性和涉及的各种环境,收集数据需要大量时间和精力。
7.1.1 数据组成和来源
GUI智能体训练的基本数据组件与第5.2.2节和第5.4节讨论的智能体感知和推理要求密切一致。在高层次上,这些数据包括:
1)用户指令:这些提供任务的总体目标、目的和具体细节,通常以自然语言形式,为智能体提供明确的目标,例如"将所有文本的字体大小改为12"。
2)环境感知:这通常包括GUI截图,通常带有各种视觉增强,以及可选的补充数据,如控件树和UI元素属性,以丰富上下文。这应涵盖环境状态的静态评估(第5.2.2节)和捕获动作后变化的动态环境反馈(第5.2.3节),从而提供足够的上下文信息。
3)任务轨迹:这包含完成任务所需的关键动作序列,以及补充信息,如智能体的计划。轨迹通常涉及多个步骤和动作来导航任务。
虽然用户指令和环境感知作为模型输入,但预期的模型输出是任务轨迹。轨迹的动作序列随后在环境中落地以完成任务。
对于用户指令,确保其现实且反映实际用户场景至关重要。指令可以通过以下几种方式获取:(i)直接来自人类设计师,他们可以基于真实世界应用提供见解;(ii)从现有相关数据集中提取(如果有合适数据);(iii)从公共材料中获取,如网站、应用帮助文档和其他公开资源;以及(iv)由LLM生成,可以模拟不同上下文中的广泛用户请求。此外,LLM可用于数据增强517,提高从原始数据派生的指令的质量和多样性。
对于收集环境感知数据,可以使用各种工具包------如第5.2.2节讨论的那些------来捕获所需的GUI数据。这可以在环境模拟器(如Android Studio模拟器²⁹、Selenium WebDriver³⁰、Windows Sandbox³¹)中完成,或直接与真实环境接口以捕获GUI元素状态,包括截图、控件树和其他对智能体操作至关重要的元数据。
收集任务轨迹,即智能体完成任务的动作序列,通常是最具挑战性的方面。任务轨迹需要准确、可执行且经过良好验证。收集方法包括:(i)使用程序生成的脚本,为预定义任务定义动作序列,提供高度控制的数据源;(ii)使用人类标注者,以众包方式完成任务并记录每个步骤,允许丰富、真实的动作数据;以及(iii)利用模型或智能体引导518,其中现有LLM或GUI智能体尝试完成任务并记录其动作,尽管这种方法可能由于潜在不准确而需要额外验证。所有这些方法都需要相当大的努力,反映了为训练GUI智能体收集可靠、任务准确数据的复杂性。
7.1.2 收集管道
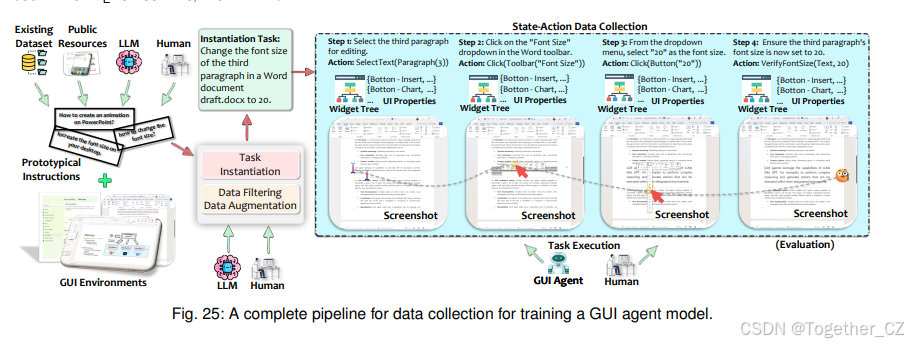
图25展示了用于训练GUI智能体模型的数据收集完整管道。过程从收集初始用户指令开始,这些指令可能来自上述各种来源。这些指令通常是原型性的,尚未针对特定环境定制或落地374。例如,来自通用网站的"如何更改字体大小?"这样的指令缺乏具体性,与用户在特定应用中可能提出的具体请求不一致。为了解决这个问题,需要一个实例化步骤374,其中指令在特定环境中上下文化,使其更具可操作性。例如,指令可能被细化为"将draft.docx的Word文档中第三段的字体大小改为20",给它一个清晰、环境特定的目标。这个实例化过程可以由人类手动进行或由LLM编程进行。
在实例化之后,指令可能经历过滤步骤以去除低质量数据,确保只保留相关和可操作的指令。此外,可以应用数据增强技术来扩展和多样化数据集,提高鲁棒性。这两个过程都可以涉及人工验证或利用LLM提高效率。
一旦指令细化完成,任务轨迹和环境感知同时收集。当在环境中执行动作时,每个步骤都被记录,提供环境状态和所采取具体动作的记录。在记录完整任务轨迹后,需要评估阶段以识别和删除失败或不准确的序列,保持数据集质量。通过迭代此管道,可以编译高质量的GUI智能体数据集,这对于训练优化模型至关重要。
在以下章节中,我们回顾各种平台的现有GUI智能体数据集,提供对当前实践和潜在改进领域的见解。
7.2 Web智能体数据
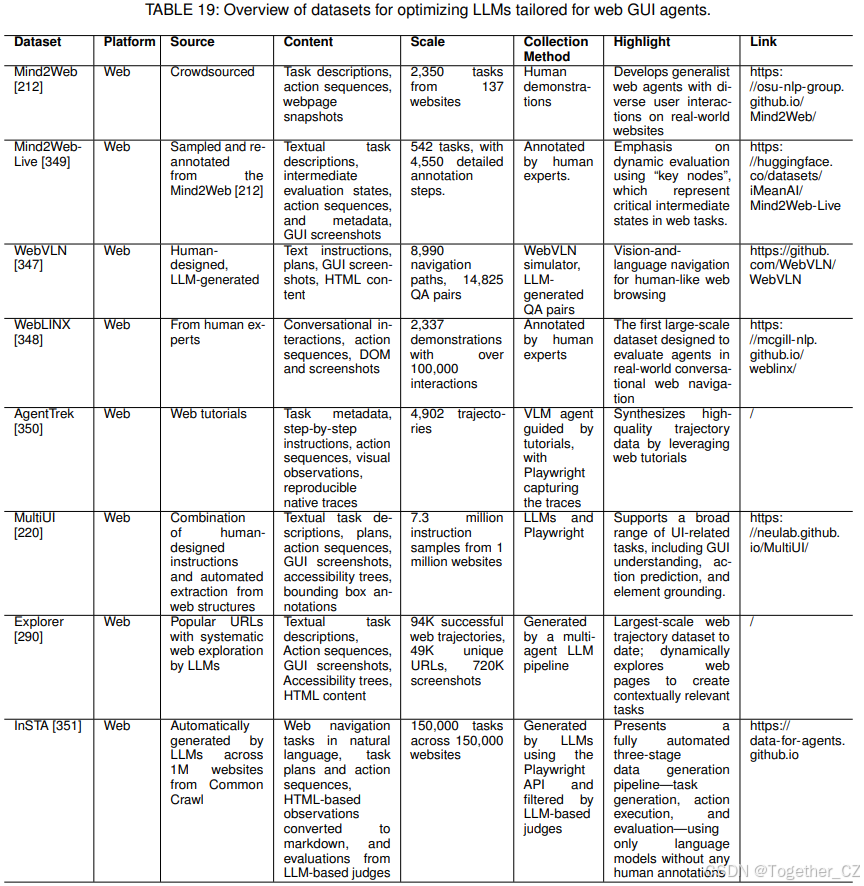
基于Web的GUI智能体需要捕获真实世界Web交互复杂性和多样性的数据集。这些数据集通常涵盖多样的网站结构,包括DOM树和HTML内容,以及反映真实用户导航和交互模式的多步骤任务注释。开发能够跨不同网站泛化并执行复杂任务的智能体需要提供丰富上下文信息的综合数据集。我们在表19中提供了基于Web的GUI智能体数据集概述。
在此基础上,已经开发了几个重要数据集来推进基于Web的GUI智能体。与专注于狭隘预定义任务的传统数据集不同,Mind2Web212通过强调开放式任务描述迈出了重要一步,推动智能体独立解释高级目标。它提供了跨137个多样网站的2,350多个人工标注任务,捕获Web导航中典型的复杂交互模式和序列。这种设置有助于评估智能体在未见领域的泛化能力,并作为Web GUI中语言落地的基准,增强真实世界应用的适应性。
类似地,WebVLN347通过将导航与问答相结合扩展了Web GUI任务。它为智能体提供基于文本的查询,引导它们定位相关网页并提取信息。通过利用网站的HTML和视觉内容,WebVLN与Web浏览的真实世界挑战保持一致。该数据集对于旨在开发能够在GUI驱动的Web空间中进行复杂、类人交互的智能体的研究人员特别有价值。
此外,WebLINX348专注于对话式GUI智能体,特别强调通过多轮对话进行真实世界Web导航。具有跨155个真实网站的2,300多个专家演示,WebLINX创建了丰富的环境,包含DOM树和截图,用于训练和评估能够进行动态、用户引导导航任务的智能体。该数据集促进智能体跨新网站和任务的泛化,具有全面的动作和对话数据,提供增强真实Web场景中智能体响应性的见解。
MultiUI220是 designed 增强GUI智能体文本丰富视觉理解的大型数据集。它包含从100万个网站收集的730万个多模态指令样本,涵盖关键Web UI任务,如元素定位、动作预测和交互建模。与传统依赖原始HTML的数据集不同,MultiUI利用结构化无障碍树生成高质量多模态指令。在MultiUI上训练的模型表现出显著性能改进,在VisualWebBench213上获得48%的提升,在Mind2Web212上元素准确性提高19.1%。
InSTA351是用于训练基于GUI的Web智能体的互联网规模数据集,完全通过自动LLM管道生成,无需人工标注。它涵盖从Common Crawl采样的15万个多样网站,包括丰富的Web导航任务、Playwright API调用轨迹以及使用基于LLM的评判者的评估。该数据集突出了强大的泛化能力和数据效率,在零样本和低资源设置中显著优于Mind2Web212和WebLINX348等人工收集的数据集。InSTA代表了LLM驱动的GUI智能体可扩展数据策划的关键进步,提供了对真实世界Web界面的前所未有的覆盖。
这些数据集共同代表了 essential 资源,使Web智能体能力的进步成为可能,支持开发适应性强和智能的智能体用于Web环境。
7.3 移动智能体数据
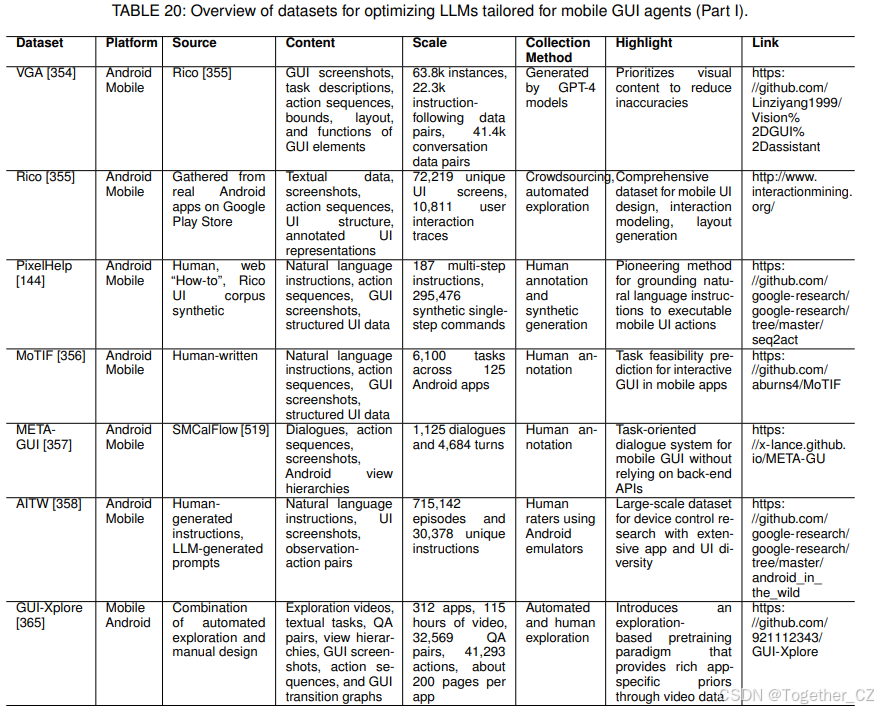
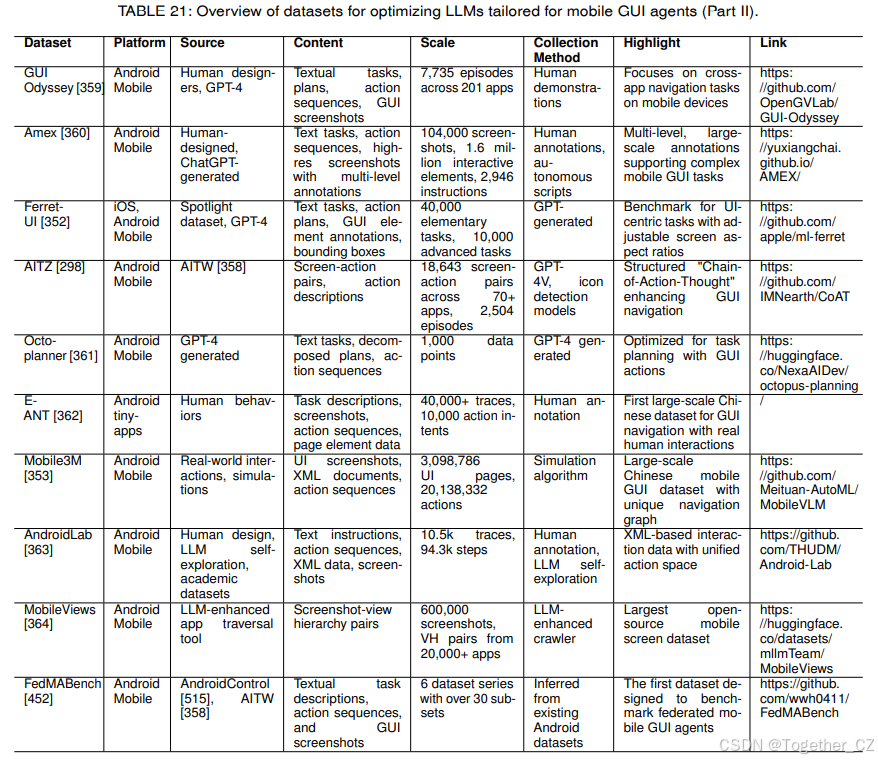
移动平台由于其多样的应用和独特的用户交互而对GUI智能体至关重要。为了开发能够有效导航和交互移动界面的智能体,数据集必须提供单步和多步任务的混合,专注于自然语言指令、UI布局和用户交互。我们首先在表20和21中概述移动GUI智能体数据集。
这一领域早期和基础性的贡献是Rico数据集355,它提供了来自9,700多个Android应用的72,000多个独特UI屏幕和10,811个用户交互轨迹。Rico对UI布局相似性、交互建模和感知建模等任务起到了重要作用,为移动界面理解和GUI智能体发展奠定了基础。
基于将自然语言指令落地到移动UI动作的需求,PIXELHELP144引入了一个专门为此目的设计的数据集。它包括多步骤指令、截图和结构化UI元素数据,使详细分析口头指令如何转换为移动动作成为可能。该数据集在可访问性和任务自动化方面有重要应用,支持基于口头线索自主执行任务的智能体。
进一步扩展范围,Android in the Wild(AITW)数据集358提供了最广泛的自然设备交互集合之一。涵盖广泛的Android应用和多样UI状态,AITW捕获模拟真实世界设备使用的多步骤任务。通过与Android模拟器交互收集,它包括截图和动作序列,使其成为开发不依赖应用特定API导航应用界面的GUI智能体的理想选择。由于其规模和多样性,AITW已成为该领域广泛使用的标准。
此外,META-GUI357通过实现与移动GUI的直接交互,绕过基于API的控制,为移动任务导向对话系统提供了独特数据集。这种方法允许智能体使用多轮对话和GUI轨迹在各种移动应用中交互,无需自定义API依赖即可拓宽其在真实世界应用中的能力。该数据集对复杂交互和多轮对话场景的支持使其对构建鲁棒对话智能体很有价值。
最近,MobileViews364作为迄今为止最大的移动屏幕数据集出现,提供了来自20,000个Android应用的600,000多个截图-视图层次对。使用LLM增强的应用遍历工具收集,它为移动GUI智能体在屏幕摘要、可点击性预测和UI组件识别等任务中提供了高保真资源。其规模和屏幕状态的全面覆盖使MobileViews成为推进移动GUI智能体能力的关键资源。
总之,移动平台目前拥有最丰富的数据集,因为其多样的工具、模拟器支持和多样用例,反映了移动应用中高质量、自适应GUI智能体的需求。
7.4 计算机智能体数据
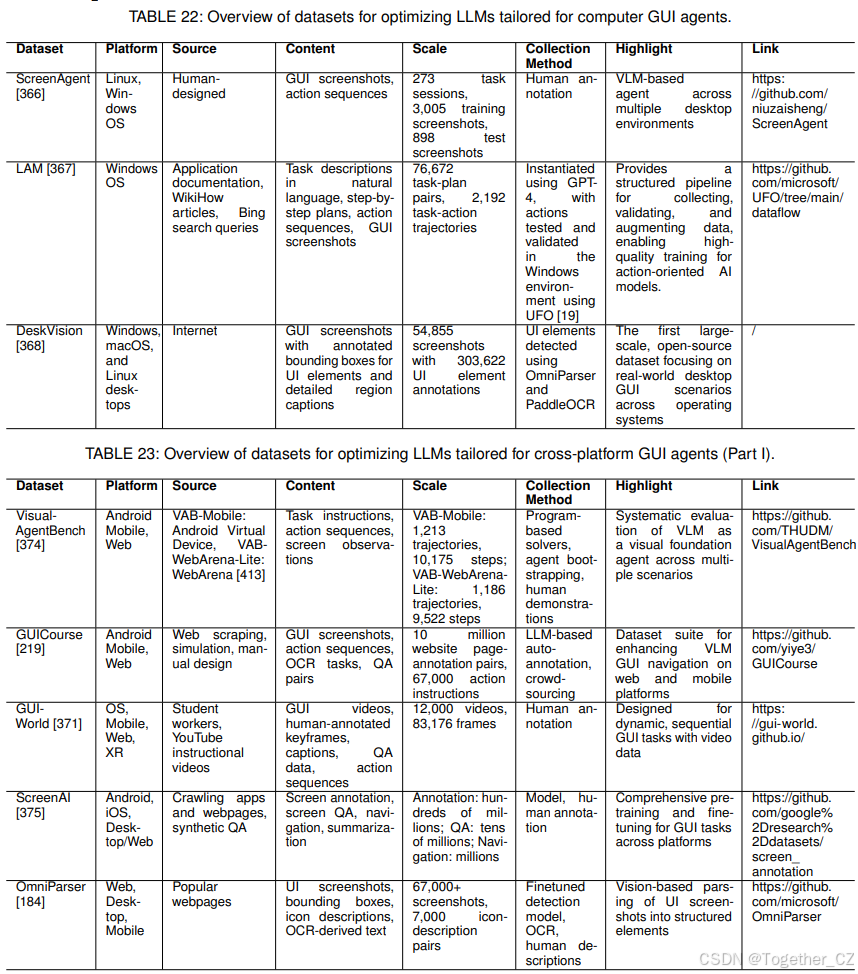
与移动和Web平台相比,GUI智能体的桌面领域拥有相对较少的专用数据集,尽管其对生产力工具和企业软件等应用至关重要。然而,已经做出了显著努力来支持为复杂多步骤桌面任务设计的智能体的开发和评估。我们在表22中展示了计算机GUI智能体的相关数据集。
这一领域的重要贡献是ScreenAgent366,一个专为促进Linux和Windows桌面环境中GUI控制而设计的数据集和模型。ScreenAgent提供了全面的管道,使智能体能够自主执行多步骤任务,涵盖规划、动作和反思阶段。通过利用标注截图和详细动作序列,它允许UI元素定位和任务完成的高精度,超过先前模型的准确性。该数据集对于旨在推进桌面领域GUI智能体能力、增强智能体决策准确性和用户界面交互的研究人员非常宝贵。
LAM367专门设计用于训练和评估GUI环境的大型动作模型(LAM),弥合自然语言任务理解和动作执行之间的差距。它包含两个核心组件:Task-Plan数据,详述用户任务及逐步计划;以及Task-Action数据,将这些计划转换为可执行GUI动作。来源于应用文档、WikiHow文章和Bing搜索查询,数据集使用GPT-4丰富和结构化。针对Windows OS,重点关注Microsoft Word中的任务自动化,它包括76,672个任务-计划对和2,688个任务-动作轨迹,使其成为基于GUI动作学习的最大集合之一。数据质量通过结合基于LLM的实例化、GUI交互测试和人工审查的鲁棒验证管道确保。每个条目都补充了GUI截图和元数据,使模型能够学习高级任务规划和低级执行。数据集的模块化设计支持针对特定GUI任务的微调,并作为在其他环境中构建数据集的可复制框架,标志着对推进基于GUI的自动化的重大贡献。
虽然桌面领域与移动和Web相比数据集较少,但ScreenAgent和LAM等努力突出了为计算机系统开发复杂GUI智能体的日益增长的兴趣和潜力。
7.5 跨平台智能体数据
跨平台数据集在开发能够跨移动、计算机和Web环境无缝运行的多功能GUI智能体方面发挥着关键作用。这些数据集支持通用性和适应性,使智能体能够在真实世界应用中处理多样界面和任务。我们在表23和24中提供了跨平台GUI智能体相关数据集的概述。
一个重要贡献是ScreenAI375,它将数据收集范围扩展到包括移动和桌面界面。涵盖屏幕注释、问答和导航等任务,ScreenAI提供了数亿个标注样本。其全面的规模和混合平台覆盖使其成为需要管理跨多样界面的复杂布局和交互的GUI智能体的鲁棒基础。通过强调元素识别和屏幕摘要,ScreenAI推进了能够处理多样视觉结构的多平台GUI智能体的发展。
基于评估跨环境视觉基础模型的需求,VisualAgentBench374是一个开创性的跨平台基准,旨在评估移动和Web设置中的GUI智能体。它强调交互 focused 任务,使用Android Virtual Device和WebArena-Lite412等环境评估和改进智能体对GUI布局和用户界面动作的响应。该数据集的创新收集方法结合了基于程序的求解器和大型多模态模型引导,促进了增强GUI智能体任务适应性和错误恢复的鲁棒训练轨迹。
此外,GUI-World371跨越多个平台,包括桌面、移动和XR环境,具有超过12,000个标注视频。设计用于解决动态和顺序GUI任务的挑战,GUI-World允许研究人员跨多样界面基准测试GUI智能体能力。通过提供详细动作序列和问答对,它为在复杂真实世界场景中评估智能体设定了高标准。
此外,xLAM372通过提供设计用于支持多轮交互、推理和函数调用任务的统一数据格式,为可操作智能体发展做出了重要贡献。来源于WebShop425、ToolBench520和AgentBoard521等数据集,xLAM标准化了跨多样环境的数据格式,解决了阻碍智能体训练和跨环境兼容性的常见数据结构不一致问题。通过提供一致结构,xLAM增强了GUI智能体的适应性和错误检测能力,允许更无缝的集成和跨不同应用的性能。
OS-Genesis369采用反向任务合成方法用于Android和Web平台。它利用GPT-4o交互式探索环境并以反向方式生成指令。这个过程构建了高质量、多样的GUI轨迹,无需依赖人工标注或预定义任务。通过消除这些依赖,OS-Genesis实现了GUI智能体的可扩展和高效训练,同时显著增强了生成数据的多样性和质量。
这些跨平台数据集共同为构建多平台GUI智能体做出贡献,为能够在不同界面无缝导航和执行任务的智能体铺平道路,促进更通用和自适应的系统。
7.6 要点
LLM驱动的GUI智能体的数据收集和策划是一个密集型过程,通常需要大量人工参与,特别是生成准确的动作序列和注释。虽然早期数据集在规模和任务多样性方面有限,但最近的进步导致了支持更复杂和真实GUI交互的大规模、多平台数据集。这些发展的关键见解包括:
1)规模和多样性:高质量、大规模数据对于训练能够处理多样UI状态和任务的鲁棒GUI智能体至关重要。MobileViews364和ScreenAI375等数据集说明了广泛和多样数据的重要性,以适应移动和桌面应用的动态性质,增强智能体在不同环境中的韧性。
2)跨平台灵活性:VisualAgentBench374和GUI-World371等跨平台数据集强调了通用性的价值,使智能体能够在移动、Web和桌面环境中一致地执行。这种跨平台适应性是创建一站式解决方案的关键步骤,其中单个GUI智能体可以跨多个平台无缝运行。
3)自动数据收集:AI驱动的数据收集工具,如OmniParser184和MobileViews364所例证的,展示了显著减少手动努力和加速可扩展数据集创建的潜力。通过自动化注释过程,这些工具为更高效的数据管道铺平了道路,朝着AI支持AI的未来发展,加速复杂GUI交互的数据收集和标注。
4)统一数据格式和协议:xLAM的统一数据格式是一项 essential 创新,提高了跨多样平台的兼容性372,解决了跨平台GUI智能体发展的重大瓶颈。建立标准化的数据收集协议或动作空间,特别是考虑到跨平台数据格式、动作空间和环境表示的差异,对于进一步推动智能体泛化和一致性至关重要。
总之,LLM驱动的GUI智能体数据集的演变格局跨越多个平台,每个数据集解决其环境特有的独特挑战和要求。这些基础资源是使智能体理解复杂UI、执行细致交互并提高跨多样应用泛化的关键。跨平台适应性、自动数据收集和标准化数据格式的推动将继续塑造GUI智能体的未来。
8 优化LLM驱动的GUI智能体的模型
LLM作为GUI智能体的"大脑",使它们能够解释用户意图、理解GUI屏幕并执行直接影响环境的动作。虽然几个现有基础模型足够鲁棒可以作为这一核心,但它们可以进一步微调和优化以演变为大型动作模型(LAM)------专门为提高GUI智能体性能和效率而定制的模型。这些LAM弥合了通用能力与基于GUI交互特定需求之间的差距。
在本节中,我们首先介绍当前构成GUI智能体骨干的基础模型,突出其优势和局限性。然后我们深入探讨LAM的概念,讨论如何使用GUI特定数据集微调这些模型以增强其在GUI环境中的适应性、准确性和动作导向性。通过这一探索,我们说明了从通用LLM到专用LAM的进展,为先进、智能的GUI智能体奠定基础。
8.1 基础模型
基础模型作为LLM驱动的GUI智能体的核心,提供理解和交互图形界面所需的基本能力。最近在闭源和开源MLLM方面的进展显著增强了GUI智能体的潜力,在效率、可扩展性和多模态推理方面提供了改进。本小节探讨这些基础模型,突出其创新、贡献和对GUI智能体应用的适用性。快速参考请见表25,其中概述了关键模型及其特征。
8.1.1 闭源模型
虽然专有模型不公开可用于定制,但它们提供了强大的能力,可以直接用作GUI智能体的"大脑"。
其中,GPT-4V378和GPT-4o93由于强大的能力,在现有GUI智能体框架中最常用,如第6节所讨论。GPT-4V代表了多模态AI的重大进步,结合文本和图像分析以扩展传统LLM的功能。其基于文本和视觉输入理解和生成响应的能力使其非常适合需要深度多模态推理的GUI智能体任务。尽管由于安全和伦理考虑其部署受限,GPT-4V强调了基础模型以增强效率和灵活性彻底改变GUI智能体发展的潜力。
类似地,GPT-4o提供了统一的多模态自回归架构,能够处理文本、音频、图像和视频。该模型擅长高效生成多样输出,与前代相比以更低成本实现更快响应时间。其严格的安全和对齐实践使其对敏感任务可靠,将其定位为需要全面多模态理解的智能GUI智能体的鲁棒工具。
Gemini模型家族92通过提供针对高复杂度任务、可扩展性能和端侧效率定制的版本,推进了多模态AI建模。值得注意的是,Nano模型尽管体积小,但在推理和编码任务中表现出显著能力,使其适合资源受限设备。Gemini的多功能性和效率使其成为需要性能和适应性的GUI智能体的引人注目的选择。
强调行业对GUI自动化的投资,Claude 3.5 Sonnet(计算机使用)通过利用纯视觉范式进行桌面任务自动化引入了开创性方法163、164。它利用实时截图观察GUI状态并生成动作,无需元数据或底层GUI结构。该模型通过解释屏幕、移动光标、点击按钮和输入文本有效自动化GUI任务。其独特架构将基于ReAct252的推理范式与选择性观察相结合,通过仅在必要时观察环境来减少计算开销。此外,Claude 3.5维护GUI截图历史,增强任务适应性并以类人方式实现与软件环境的动态交互。尽管在处理动态界面和错误恢复方面存在挑战,该模型代表了创建通用GUI智能体的重要一步。其发展突出了对该领域的重大行业投资,表明越来越关注利用LLM进行高级GUI自动化。
Operator模型165、513由OpenAI开发,代表了计算机使用智能体(CUA)的新前沿,类似于Claude 3.5 Sonnet(计算机使用)。设计用于通过LLM驱动的推理和视觉能力与GUI环境交互,Operator建立在GPT-4o之上,整合强化学习以跨数字界面(如浏览器、表单和应用)导航和执行任务。通过感知截图、解释UI元素并通过虚拟光标和键盘执行动作,Operator实现了复杂基于GUI工作流的自动化,包括在线购物、电子邮件管理和文档编辑。值得注意的是,Operator在理解和操作数字环境方面表现出色,将自己确立为人机交互自动化的强大工具。其在各种基准上的卓越性能强调了其在基于GUI任务自动化中的领先能力。
8.1.2 开源模型
开源模型提供定制和优化的灵活性,允许开发者使用上下文数据定制GUI智能体并将其部署在资源有限的设备上。
Qwen-VL系列210以其细粒度视觉理解和多模态能力而著称。具有基于Vision Transformer的视觉编码器和Qwen-7B语言模型511,它在视觉语言基准上实现了最先进的结果,同时支持多语言交互。其效率和开源可用性,以及用于资源效率的量化版本,使其适合开发需要精确视觉理解的GUI智能体。
在此基础上,Qwen2-VL231引入了Naive Dynamic Resolution和Multimodal Rotary Position Embedding等创新,实现了包括扩展长度视频在内的多样模态的高效处理。Qwen2-VL的可扩展版本平衡了计算效率和性能,使其适用于端侧应用和GUI环境中的复杂多模态任务。
InternVL-2379、380将Vision Transformer与大型语言模型相结合,处理文本、图像、视频和医疗数据输入。其渐进对齐策略和各种尺寸的可用性允许部署灵活性。通过在复杂多模态任务中实现最先进性能,InternVL-2展示了对需要全面多模态理解的GUI智能体有价值的能力。
推进视觉和语言信息的高效整合,CogVLM381以相对较少的可训练参数在跨模态任务中表现出色。其深度整合视觉和语言特征同时保留大型语言模型全部能力的能力使其成为GUI智能体发展的基石,特别是在资源效率至关重要的应用中。
增强空间理解和定位,Ferret382为GUI智能体提供了创新方法。通过在单一框架内统一引用和定位任务并采用混合区域表示,它提供了与图形界面的精确交互。其对对象幻觉的鲁棒性和高效架构使其成为实时GUI应用中端侧部署的理想选择。
LLaVA模型217将视觉编码器与语言解码器整合,促进模态之间的高效对齐。其轻量级投影层和模块化设计实现了快速实验和适应,使其适合需要快速开发周期和强大多模态推理能力的GUI智能体。在此基础上,LLaVA-1.5383引入了新颖的基于MLP的跨模态连接器并扩展到高分辨率图像输入,以最少训练数据实现令人印象深刻的性能。其数据效率和开源可用性为需要详细视觉推理的GUI应用的广泛使用铺平了道路。
BLIP-2206通过利用冻结的预训练模型并引入轻量级Querying Transformer,采用计算高效策略。这种设计允许在视觉语言任务上以更少的可训练参数实现最先进性能。BLIP-2的模块化和效率使其适合资源受限环境,突出了其用于端侧GUI智能体的潜力。
最后,Phi-3.5-Vision234在紧凑模型尺寸内实现了多模态推理的竞争性能。其创新训练方法和图像与文本理解的高效整合使其成为需要多模态推理和端侧推理而无需更大模型计算开销的GUI智能体的鲁棒候选。
总之,闭源和开源基础模型都显著推进了LLM驱动的GUI智能体的能力。虽然专有模型提供强大的开箱即用性能,但开源模型提供定制和优化的灵活性,使针对多样GUI智能体应用的定制解决方案成为可能。这些模型在多模态推理、效率和可扩展性方面的创新突出了基础模型的演变格局,为更智能和可访问的GUI智能体铺平了道路。
8.2 大型动作模型
虽然通用基础LLM在多模态理解、任务规划和工具利用等能力方面表现出色,但它们通常缺乏GUI导向任务所需的专门优化。为了解决这个问题,研究人员引入了大型动作模型(LAM)------使用上下文、GUI特定数据集(如第7节所述)微调的基础LLM,以增强其动作驱动能力。这些模型代表了完善GUI智能体"大脑"以获得卓越性能的重要一步。
在GUI智能体领域,LAM提供了几个变革性优势:
1)增强动作导向性:通过专注于动作导向任务,LAM能够准确解释用户意图并生成精确的动作序列。这种微调确保LAM可以无缝地将其输出与GUI操作对齐,提供针对用户请求定制的可操作步骤。
2)长复杂任务的专门规划:LAM擅长设计和执行复杂的多步骤工作流。无论任务跨多个应用还是涉及相互依赖的操作,LAM利用其在广泛动作序列数据集上的训练来创建连贯的长期计划。这使其成为需要在各种工具中进行复杂规划的生产力 focused 任务的理想选择。
3)改进的GUI理解和视觉定位:在包含GUI截图的数据集上训练允许LAM提升其检测、定位和解释UI组件(如按钮、菜单和表单)的能力。通过利用视觉线索而不是仅依赖结构化UI元数据,LAM变得高度自适应,在各种软件环境中有效执行。
4)通过模型尺寸缩减提高效率:许多LAM建立在较小的基础模型之上------通常约70亿参数------针对GUI特定任务优化。这种紧凑、目的驱动的设计减少了计算开销,即使在资源受限环境中(如端侧推理)也能实现高效操作。
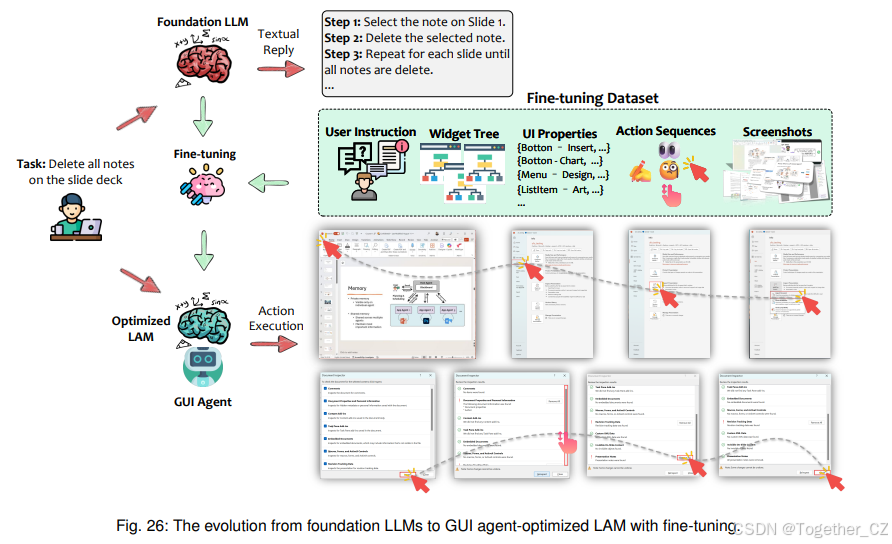
如图26所示,为GUI智能体开发专用LAM的过程始于鲁棒的通用基础模型,最好具有VLM能力。在全面的专门GUI数据集(包括用户指令、控件树、UI属性、动作序列和标注截图)上微调这些模型将其转化为优化的LAM,有效装备它们作为GUI智能体的"大脑"。
这种优化弥合了规划和执行之间的差距。通用LLM可能仅提供文本计划或抽象指令以响应用户查询,这可能缺乏精确性。相比之下,LAM赋能的GUI智能体超越规划,主动智能地在GUI上执行任务。通过直接与应用界面交互,这些智能体以卓越的精确性和适应性执行任务。这种范式转变标志着GUI智能体从被动任务规划者进化为主动、智能的执行者。
8.3 Web GUI智能体的LAM
在基于Web的GUI智能体领域,研究人员开发了专门的LAM,增强Web环境中的交互和导航。这些模型专为理解Web GUI的复杂性而定制,包括动态内容和多样交互模式。我们在表26中展示了对Web GUI智能体定制的LAM分析。
基于多模态理解的需求,WebGUM153通过时间和局部令牌将HTML理解与视觉感知整合。它利用Flan-T5498进行指令微调,ViT522进行视觉输入,使其能够高效处理文本和视觉信息。这种多模态定位允许WebGUM有效泛化任务,在MiniWoB++146和WebShop425等基准上显著优于先前模型。其数据高效设计和多步骤推理能力,WebGUM强调了结合多模态输入在增强GUI智能体性能中的重要性。
针对GUI环境中多步骤推理和规划的挑战,研究人员引入了结合高级搜索和学习机制的框架。例如,Agent Q281采用MCTS结合自我批评机制和直接偏好优化(DPO)503来提高复杂任务(如产品搜索和预订)的成功率。通过微调LLaMA-3 70B模型91处理HTML DOM表示并生成结构化动作计划、想法和环境特定命令,该框架展示了整合推理、搜索和迭代微调对自主智能体发展的力量。
利用较小模型进行高效Web交互,GLAINTEL385展示了无需大型计算资源即可实现高性能。利用780M参数的Flan-T5498模型,它专注于模拟电子商务平台等动态Web环境。该模型纳入RL以优化查询制定和导航等动作,有效整合人类演示和无监督学习。以GPT-4基于方法计算成本的一小部分实现相当结果,GLAINTEL强调了强化学习在增强基于Web的GUI智能体任务特定优化中的潜力。
为了实现跨多样Web领域的持续改进和泛化,OpenWebVoyager387结合模仿学习与迭代探索-反馈-优化循环。利用Idefics2-8B523等大型多模态模型,它执行自主Web导航任务。通过在多样数据集上训练并使用GPT-4反馈验证的轨迹微调,智能体解决真实世界复杂性而不依赖合成环境。这种方法通过展示跨多样Web领域和任务泛化的能力显著推进了GUI智能体框架。
此外,针对稀疏训练数据和策略分布漂移等挑战,WebRL388引入了自进化课程和鲁棒奖励机制来训练LLM作为熟练的Web智能体。通过基于智能体性能动态生成任务,WebRL微调Llama-3.191和GLM-4499等模型,在WebArena环境中的基于Web任务中实现显著成功率。该框架优于专有API和其他开源模型,突出了自适应任务生成和持续学习改进在开发高级GUI智能体中的有效性。
这些Web GUI智能体LAM的进步说明了整合多模态输入、高效模型设计和创新训练框架以增强复杂Web环境中智能体能力的重要性。
8.4 移动GUI智能体的LAM
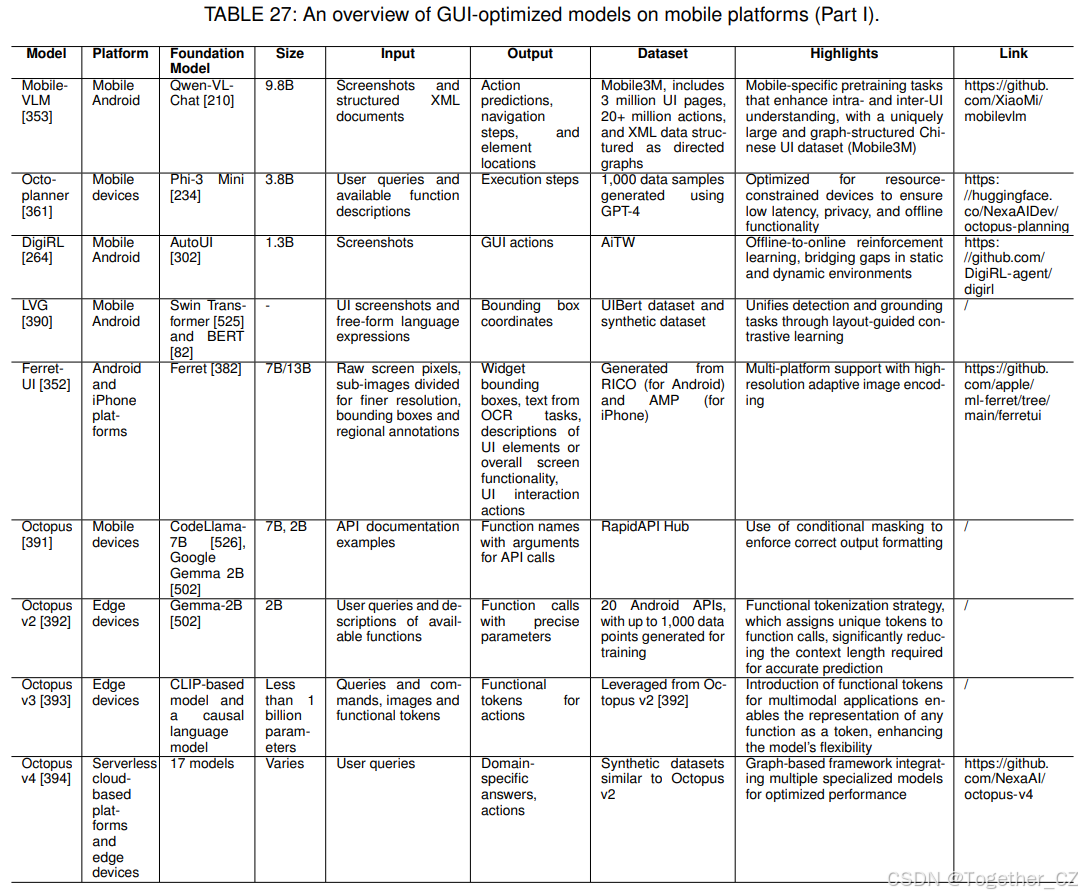
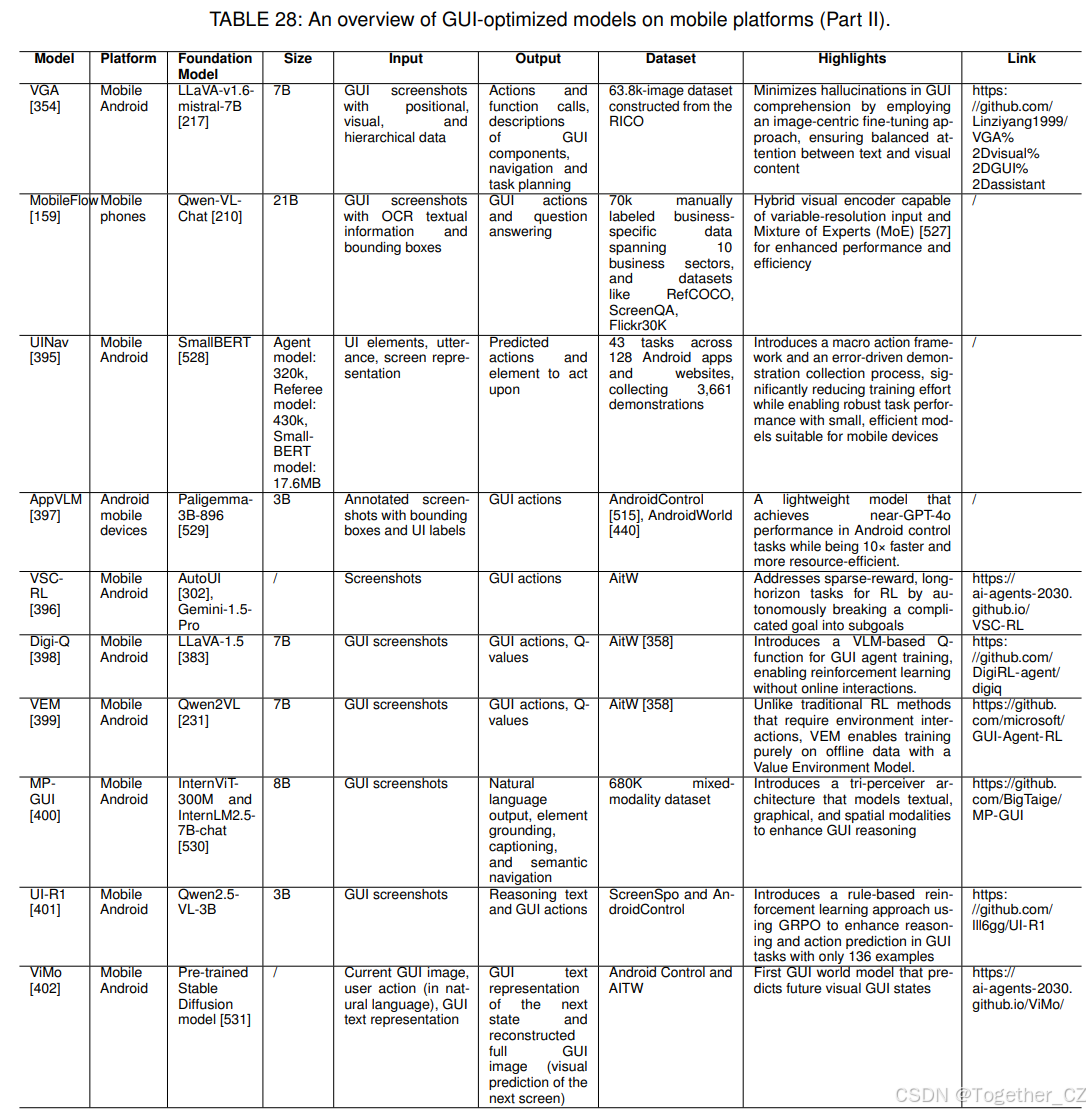
移动平台为GUI智能体带来了独特挑战,包括多样屏幕尺寸、触摸交互和资源约束。研究人员开发了专门的LAM来应对这些挑战,增强移动环境中的交互和导航。我们在表27和28中概述了为移动GUI智能体定制的LAM。
专注于详细UI理解,MobileVLM353引入了专为移动UI操作任务设计的先进视觉语言模型。建立在Qwen VL-Chat210之上,它纳入移动特定的预训练任务以进行UI内和UI间理解。通过利用Mobile3M数据集------包含300万UI页面和交互轨迹组织成有向图的综合语料库------该模型在动作预测和导航任务中表现出色。MobileVLM的新颖两阶段预训练框架显著增强了其对移动UI的适应性,在ScreenQA532和Auto-UI302等基准上优于现有VLM。这项工作突出了定制预训练在改进移动GUI智能体性能中的有效性。
针对动态环境中鲁棒交互的需求,DigiRL264提出了基于强化学习的框架,专为在Android环境中训练GUI智能体而定制。通过利用离线到在线RL,DigiRL适应真实世界随机性,使其适合多样多步骤任务。与依赖模仿学习的先前模型不同,DigiRL从交互数据中自主学习,完善自身以从错误中恢复并适应新场景。使用具有13亿参数的预训练视觉语言模型能够高效处理GUI截图和导航命令。其在AITW数据集上的性能展示了相对基线方法的显著改进,将DigiRL定位为优化复杂GUI交互的智能体发展的基准。
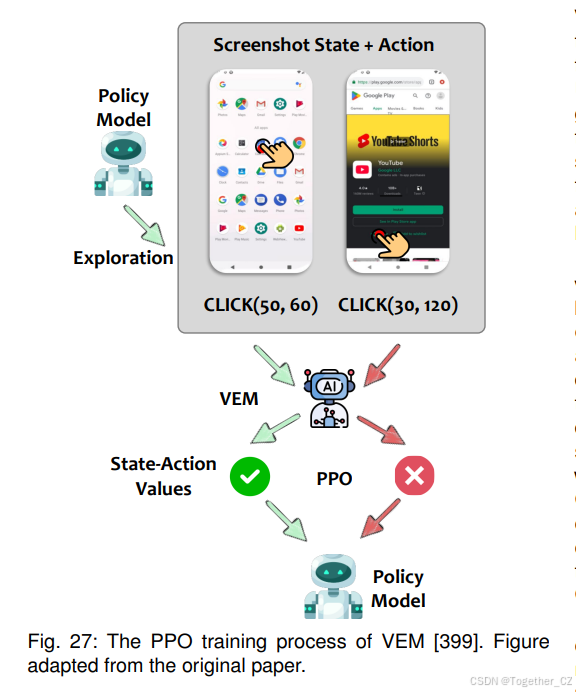
Digi-Q398和VEM399都研究了使用离线RL增强GUI智能体性能而无需直接与环境交互。Digi-Q采用时序差分学习离线训练Q函数,并基于预测的Q值通过Best-of-N选择策略推导策略。类似地,VEM引入了为使用PPO训练LLM驱动的GUI智能体量身定制的无环境RL框架。它通过使用GPT-4o的标注值数据微调,直接从离线数据估计状态-动作值,从而无需在GUI环境中实时执行即可进行策略训练。在推理时,仅使用策略模型。图27展示了VEM的整体架构。该研究进一步证明,具有结构化信用分配的离线RL可以实现与交互式RL模型相当的性能。总体而言,VEM提供了一种可扩展且布局无关的方法来训练GUI智能体,同时最小化交互成本。两项工作都强调了离线RL用于GUI智能体训练的潜力。
为了增强GUI理解并减少对文本数据的依赖,VGA354采用微调的视觉语言模型,优先考虑基于图像的线索,如形状、颜色和位置。利用RICO355数据集进行训练,VGA专为Android GUI定制,采用两阶段微调过程使响应与视觉数据和人类意图对齐。该模型在理解GUI布局、预测设计意图和促进精确用户交互方面表现出色。通过在GUI理解基准上优于GPT-4V等现有模型,VGA为移动GUI智能体的准确性和效率设定了新标准。
在轻量级和高效模型的背景下,UINav395展示了训练神经智能体在移动设备上自动化UI任务的实用系统。它通过宏动作和错误驱动的演示收集过程平衡准确性、通用性和计算效率。UINav使用紧凑的编码器-解码器架构和SmallBERT528进行文本和屏幕元素编码,使其适合端侧推理。一个关键创新是它能够以最少演示泛化到多样任务和应用,以多功能框架解决UI自动化中的关键挑战。
UI-R1401引入了基于RL的训练范式,旨在增强多模态大语言模型(MLLM)的GUI动作预测。由此产生的模型UI-R1-3B使用新颖的基于规则的奖励函数微调Qwen2.5-VL-3B,该函数联合评估动作类型正确性和点击坐标准确性,同时通过结构化<think>标签启用o1风格533的思维链(CoT)推理。UI-R1仅依赖通过三阶段过滤策略选择的136个高质量样本。尽管监督有限,UI-R1-3B在域内和域外基准上都实现了显著改进。通过利用Group Relative Policy Optimization(GRPO)534,该框架将策略优化与GUI定位和任务执行的目标对齐。UI-R1建立了一种通过RL训练GUI智能体的可扩展和数据高效方法,并为轻量级但有效的智能体设计铺平了道路。其方法也已成功扩展到跨平台智能体410、411,展示了强大的泛化能力。
除了动作模型外,ViMo402引入了用于GUI智能体的新颖生成式视觉世界模型,旨在通过预测下一个GUI状态作为图像而不是文本描述来改进App智能体决策。ViMo的一个关键创新是符号文本表示(STR),它用结构化占位符替换GUI文本区域,以促进准确和清晰的文本合成。这种解耦设计允许系统使用微调扩散模型处理GUI图形生成,并通过LLM进行文本生成,从而实现高视觉保真度和语义精度。ViMo显著提升了GUI预测质量和下游智能体性能,据报道GUI生成指标相对改进29.14%,并增强了长视野任务的规划准确性。作为前向模拟器,ViMo代表了朝着移动GUI智能体可靠世界模型的关键进步,支持视觉环境中更有效的决策评估和轨迹规划。
8.5 计算机GUI智能体的LAM
对于桌面和笔记本电脑环境,GUI智能体必须处理复杂应用、多任务和多样交互模态。为计算机GUI智能体定制的LAM增强了这些设置中的能力,实现更复杂的任务执行。我们在表29中概述了计算机GUI智能体的LAM。
整合规划、行动和反思阶段,ScreenAgent366设计用于与计算机屏幕自主交互。基于CogAgent15,它使用ScreenAgent数据集微调,提供跨多样任务的全面GUI交互数据。输入为截图,输出为JSON格式的鼠标和键盘动作,ScreenAgent实现了精确的UI元素定位并处理连续多步骤任务。其使用基础模型处理实时GUI交互的能力为LLM驱动的GUI智能体设定了新基准,使其成为未来构建更通用智能体研究的理想参考。
弥合高级规划与真实世界操作之间的差距,Octopus403代表了具身视觉语言编程的开创性步骤。利用MPT-7B535和CLIP ViT-L/14509,Octopus整合自我中心和鸟瞰视图进行视觉理解,生成可执行动作代码。使用OctoVerse套件训练,其数据集涵盖OmniGibson、Minecraft和GTA-V等丰富标注环境,覆盖常规和推理密集型任务。值得注意的是,Octopus通过环境反馈强化学习进行创新,确保自适应规划和执行。其视觉依赖功能在未见场景中提供无缝任务泛化,强调了其作为在复杂GUI环境中运行的具身智能体的统一模型的能力。
Wang等人367提供了LAM的综合概述,这是AI中设计用于在GUI环境中执行切实行动的新范式,以Windows OS上的UFO19作为案例研究平台。建立在Mistral-7B501基础上,LAM通过将任务规划与可操作输出整合,超越了传统LLM。利用UI Automation(UIA)API等工具的结构化输入,LAM生成可执行步骤以进行动态规划和自适应响应。涵盖任务计划预训练、模仿学习、自举探索和强化学习的多阶段训练策略确保鲁棒性和准确性。在真实世界GUI任务上的评估突出了LAM相比标准模型的优越任务成功率。这一创新为能够将用户请求转化为真实世界动作的智能GUI智能体奠定了基础,推动生产力和自动化的显著进步。
计算机GUI智能体的这些发展突出了先进视觉理解、规划和动作执行的整合,为更复杂和更有能力的桌面智能体铺平了道路。
8.6 跨平台大型动作模型
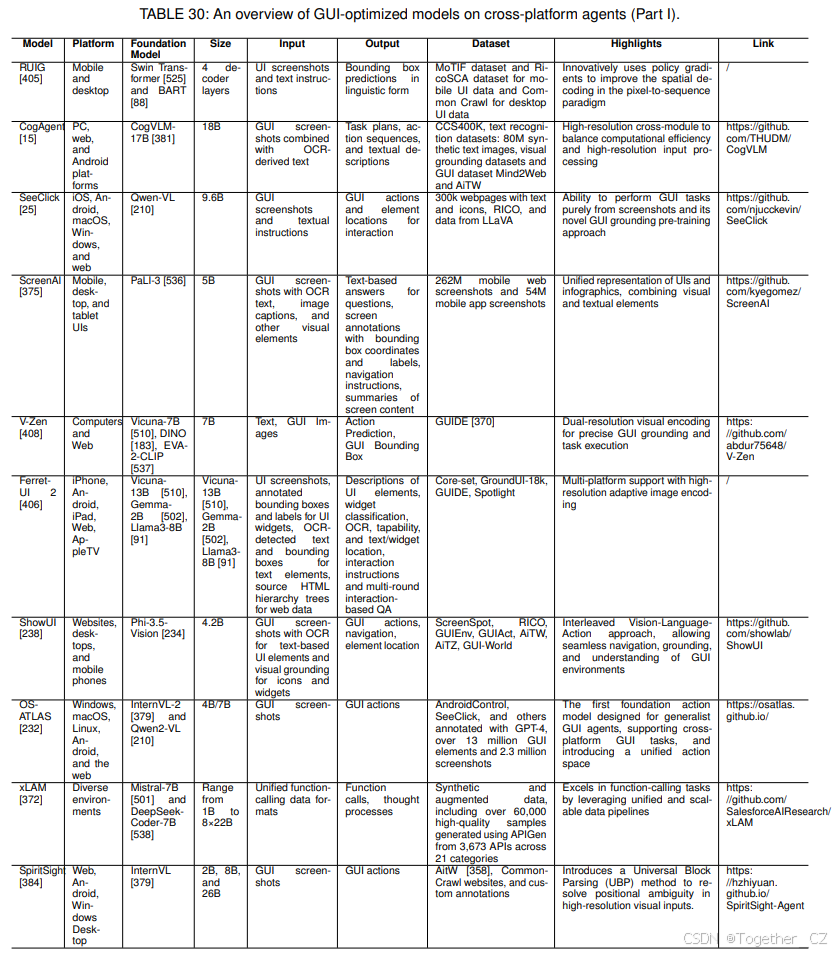
为了实现跨各种平台的多功能性,跨平台LAM已被开发,使GUI智能体能够在移动设备、桌面和Web界面等多种环境中无缝运行。我们在表30和31中提供了为跨平台GUI智能体定制的LAM分析。
CogAgent15作为先进的视觉语言模型脱颖而出,专注于PC、Web和Android平台的GUI理解和导航。建立在CogVLM381之上,它纳入了新颖的高分辨率跨模块以高效处理GUI截图,实现GUI元素及其空间关系的详细理解。在需要OCR和GUI定位的任务中表现出色,CogAgent在Mind2Web212和AITW358等基准上实现了最先进性能。其生成准确动作计划和与GUI接口的能力使其成为开发针对GUI环境优化的智能体的关键步骤。CogAgent已进一步发展为其beta版本GLM-PC505,提供增强的控制能力。
专注于通用GUI理解,Apple的Ferret-UI 2406是最先进的多模态大语言模型,设计用于掌握跨多样平台(包括iPhone、Android设备、iPad、Web和AppleTV)的UI理解。通过采用动态高分辨率图像编码、自适应网格化和通过GPT-4生成的高质量多模态训练数据,它在UI引用、定位和交互任务中优于其前身和其他竞争模型。Ferret-UI 2的先进数据集和创新训练技术确保空间理解和以用户为中心交互的高准确性,为跨平台UI适应性和性能设定了新基准。
推进GUI自动化,ShowUI238引入了开创性的视觉-语言-动作模型,将高分辨率视觉输入与文本理解整合,执行定位、导航和任务规划。针对Web、桌面和移动环境优化,ShowUI利用Phi3.5-vision-instruct骨干和综合数据集,在ScreenSpot25和GUI-Odyssey359等基准上实现鲁棒结果。其处理多帧和动态视觉输入以及JSON结构化输出动作的能力突出了其多功能性。在交错图像-文本处理和函数调用能力方面的创新,ShowUI为LLM驱动的GUI智能体设定了新标准。
针对统一动作空间的需求,OS-ATLAS232引入了专为跨Windows、macOS、Linux、Android和Web等平台的GUI智能体设计的基础动作模型。通过利用大规模多平台数据集并实现统一动作空间,OS-ATLAS在GUI定位和分布外泛化任务中实现了最先进性能。其可扩展配置适应不同计算需求,同时在处理自然语言指令和GUI元素方面保持多功能性。作为商业解决方案的强大开源替代品,OS-ATLAS标志着朝着普及高级GUI智能体访问的重要一步。
Magma409是用于多模态AI智能体的基础模型,将LLM与视觉和动作理解相结合,完成UI导航和机器人操作任务。与之前针对UI自动化或机器人优化之一的模型不同,Magma联合训练异构数据集(约3900万样本),涵盖UI截图、Web导航、机器人轨迹和教学视频。它采用SoM和Trace-of-Mark技术,通过标记GUI环境中的可操作元素和跟踪机器人任务中的运动轨迹来增强动作定位和预测。
UI-TARS407是专为多平台GUI智能体优化的先进、基于视觉的大型动作模型(LAM)。与传统方法不同,它仅依赖GUI截图进行感知,消除了对结构化表示的需求。通过纳入统一动作空间,UI-TARS实现了跨Web、Windows、macOS和Android环境的无缝执行。建立在Qwen-2-VL之上,它在600万个GUI教程、大规模截图数据集和多个开源基准上训练。UI-TARS的一个关键创新是其System-2推理能力,允许它在执行动作前生成显式推理步骤,增强动态环境中的决策。此外,它采用迭代自我改进框架,通过基于反思的学习完善其性能。实验结果表明,UI-TARS在任务执行基准上优于现有模型,包括GPT-4o和Claude。
这些跨平台LAM展示了能够适应多样环境的统一模型的潜力,增强了GUI智能体在各种上下文中的可扩展性和适用性。
8.7 要点
对GUI智能体LAM的探索揭示了几个关键见解,这些见解正在塑造与图形用户界面智能交互的未来:
1)用于端侧推理的较小模型:许多优化的LAM建立在较小的基础模型之上,通常在10亿到70亿参数范围内。模型尺寸的减小增强了计算效率,使其能够在资源受限设备(如手机和边缘设备)上部署。无需依赖云服务即可执行端侧推理的能力解决了隐私问题并减少了延迟,带来更响应的用户体验。
2)增强的GUI理解减少对结构化数据的依赖:VGA354和OmniParser184等模型强调视觉定位和以图像为中心的微调以减少对结构化UI元数据的依赖。通过直接从视觉输入改进GUI理解,智能体对不同的软件环境更加适应,包括那些结构化数据可能无法访问或不一致的环境。
3)强化学习弥合静态和动态环境:DigiRL264等模型中强化学习的应用证明了弥合静态训练数据与动态真实世界环境的有效性。这种方法允许智能体从交互中学习、从错误中恢复并适应变化,增强其在实际应用中的鲁棒性和可靠性。
4)统一函数调用增强互操作性:标准化数据格式和函数调用机制的努力,如xLAM372中所见,促进了跨不同平台的多轮交互和推理。这种统一解决了兼容性问题,并增强了智能体执行涉及多个API和服务的复杂任务的能力。
5)推理时计算和推理模型:最近的工作强调了推理时计算的重要性,其中模型即时规划、推理和分解任务而无需架构更改。扩展上下文窗口和思维链提示(如"o1风格"推理)等技术实现了更鲁棒的长视野决策。UI-R1401、GUI-R1410和InfiGUI-R1411是这一方向的 pioneering 努力。基于规则的奖励和成本函数也日益受到关注,指导推理时行为,整合显式启发式以提高GUI智能体的稳定性、可解释性和泛化性。
GUI智能体LAM的进步突出了朝着专门化、高效和自适应模型的趋势,能够在各种平台上执行复杂任务。通过专注于专业化、多模态整合和创新训练方法,研究人员正在克服通用LLM的局限性。这些见解为更智能、响应更快和用户友好的GUI智能体铺平了道路,可以改变与软件应用的交互。
9 LLM驱动的GUI智能体的评估
在GUI智能体领域,评估对于增强功能性和用户体验至关重要56、58,应在多个方面进行。通过系统评估这些智能体在各种任务中的有效性,评估不仅衡量其在不同维度上的性能,还为其持续改进提供框架541。此外,它通过识别潜在发展领域鼓励创新,确保GUI智能体与LLM的进步同步发展并符合用户期望。
如图28所示,当GUI智能体完成任务时,它产生动作序列、捕获截图、提取UI结构并记录结果环境状态。这些输出作为通过各种指标和测量跨多样平台评估智能体性能的基础。在后续章节中,我们深入探讨这些评估方法,讨论用于全面评估GUI智能体的指标和测量。我们还概述了针对不同平台GUI智能体的现有基准,突出其关键特征和所解决的挑战。
9.1 评估指标
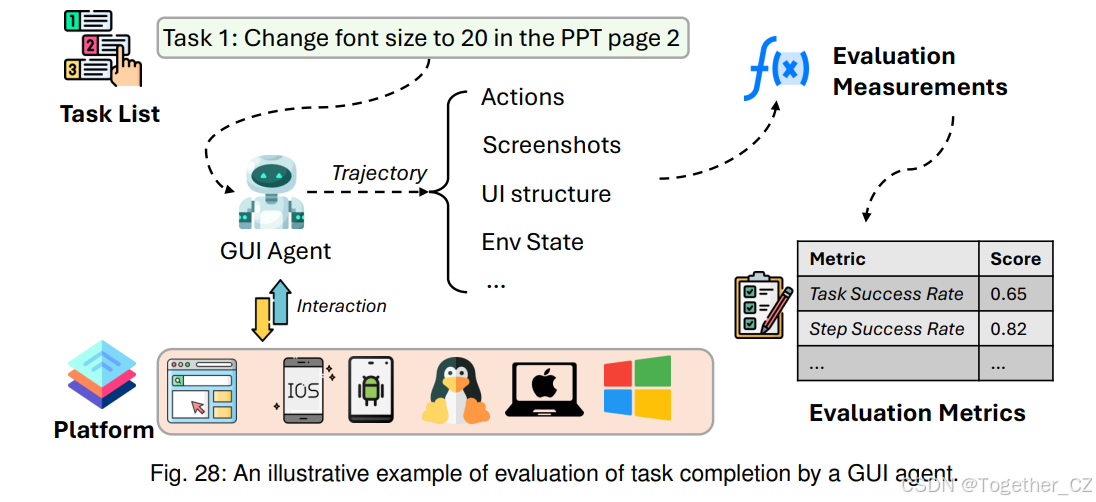
评估GUI智能体需要鲁棒和多维度的指标来评估其在准确性、效率和合规性(如安全性)等各个方面的性能。在典型基准设置中,GUI智能体被提供自然语言指令作为输入,并预期自主执行动作直到任务完成。在此过程中,可以收集各种资产,如智能体所采取的动作序列、逐步观察(如DOM或HTML结构)、截图、运行时日志、最终状态和执行时间。这些资产使评估者能够确定任务是否成功完成并分析智能体的性能。在本节中,我们总结了常用于基准测试GUI智能体的关键评估指标。请注意,不同研究工作可能对这些指标使用不同的名称,但计算方式相似。我们在本节中对齐其名称。
1)步骤成功率:完成任务可能需要多个步骤。该指标衡量任务中成功步骤数与总步骤数的比率。高步骤成功率表示精确和准确地执行细粒度步骤,这对于涉及多步骤任务的可靠性能至关重要212、349、358。
2)轮次成功率:轮次表示用户与智能体之间的单次交互。一个轮次可能包含多个步骤,完成任务可能包含多个轮次。该指标衡量在该交互中成功满足请求的轮次与所有轮次的比率。它关注智能体在交互或对话式任务中理解和满足用户期望的能力,确保智能体在迭代交互中的响应性和可靠性,特别是在需要动态用户-智能体通信的任务中155、348。
3)任务成功率:任务成功率衡量基准中设置的所有任务中成功完成的任务数。它评估最终任务完成状态是否实现,而不管中间步骤。该指标提供端到端任务完成的整体衡量,反映智能体整体处理复杂工作流的能力419、425、438。
4)效率分数:效率分数评估智能体在考虑资源消耗、执行时间或智能体可能采取的总步骤数的情况下完成任务的有效性。该指标可以分解为以下子指标:
时间成本:衡量完成任务所需的时间。
资源成本:衡量完成任务的内存/CPU/GPU使用量。
LLM成本:评估任务执行期间使用的LLM调用的计算或金钱成本。
步骤成本:衡量完成任务所需的总步骤数。
根据所使用的具体指标,效率分数在不同论文中可能有不同的解释442、444。
5)策略下完成率:该指标衡量在遵守策略约束的情况下成功完成任务的比率。它确保智能体在任务执行期间遵守用户定义或组织规则,如安全、伦理、安全、隐私或业务指南。该指标特别适用于合规性与任务成功同等重要的应用416。
6)风险比率:与前一个指标类似,风险比率评估任务执行期间智能体动作相关的潜在风险。它识别任务处理过程中可能出现的漏洞、错误或安全问题。较低的风险比率表示更高的可信度和可靠性,而较高的比率可能表明需要改进以最小化风险并增强鲁棒性的领域416。
每个GUI智能体基准中指标的实现可能因平台和任务表述而异。在本节的所有表格中,我们将基准中使用的原始指标(可能具有不同名称)映射到我们上面定义的类别。
9.2 评估测量
为了有效评估GUI智能体,采用各种测量技术来评估其准确性和与预期输出的一致性。这些测量验证智能体性能的不同方面,从文本和视觉正确性到交互准确性和系统状态感知,使用代码、模型甚至智能体作为评估者26。下面,我们总结了用于基准测试GUI智能体的关键测量方法。基于这些测量,可以相应计算预先定义的评估指标。
1)文本匹配:该测量评估智能体的基于文本的输出是否与预期结果匹配。例如,当智能体浏览电子商务网站时是否到达目标产品名称。它可以涉及不同严格程度,包括:
-
精确匹配:确保输出与预期结果完全匹配。
-
部分或模糊匹配:允许近似匹配,对于处理细微变化如拼写错误或同义词有用。
-
语义相似性:使用文本嵌入的余弦相似度或其他语义相似性度量来衡量语义意义的更深对齐。
文本匹配广泛应用于涉及文本选择、数据输入或自然语言响应的任务。
2)图像匹配:图像匹配专注于验证智能体是否在预期页面(如网页、应用UI)上行动或停止,或选择正确的图像。它涉及使用图像相似性度量或视觉问答(VQA)方法比较截图、选定图形元素或视觉结果与真实图像。这种测量对于需要精确视觉识别的任务特别关键。
3)元素匹配:该测量检查智能体交互的特定控件元素(如HTML、DOM或应用UI层次中的元素)是否与预期元素对齐。这些可能包括:
HTML标签和属性:确保智能体识别并交互正确的结构元素。
URL和链接:验证导航相关元素。
DOM层次:确认与动态或复杂Web界面中预期DOM结构的对齐。
UI控件和控件:验证与平台特定控件(如按钮、滑块、复选框、下拉菜单或桌面和移动应用中的其他GUI组件)的交互。
无障碍标识符:利用Android和iOS等移动平台中的无障碍标识符或资源ID确保正确元素选择。
视图层次:评估与移动应用中预期视图层次的对齐,类似于Web应用中的DOM层次。
系统控件和API:确保正确交互操作系统控件或API,如桌面环境中的文件对话框、系统菜单或通知。
元素匹配确保任务执行期间跨不同平台与用户界面组件的鲁棒交互。
4)动作匹配:该测量通过将智能体的动作(如点击、滚动或按键)与预期序列比较来评估其准确性。它涉及:
动作准确性:验证每个动作(包括动作类型及其参数)是否正确执行(如点击正确按钮、输入正确输入)。
动作序列对齐:确保动作按正确顺序发生以满足任务要求。
位置预测:检查空间动作(如鼠标点击或触摸手势)是否针对界面的预期区域。
动作匹配对于评估任务完成中的逐步正确性至关重要。
5)状态信息:状态信息捕获任务执行期间与系统环境相关的运行时数据。它提供可能影响智能体行为的上下文因素的见解,如:
应用状态:关于正在交互的应用状态的信息(如打开的文件、活动窗口、给定位置中的已保存文件)。
系统日志:记录智能体决策和交互的详细日志。
环境变量:关于操作系统或运行时环境的上下文数据。
这种测量对于调试、性能分析和确保在多样条件下的可靠性很有价值。
每种测量技术都有助于全面的评估框架,确保智能体不仅完成任务,而且以精确、效率和适应性完成任务。它们共同帮助建立对智能体在真实世界场景中可靠执行能力的信任,同时保持对策略约束的合规性。
9.3 评估平台
评估GUI智能体需要多样平台来捕获这些智能体运行的不同环境。平台跨越Web、移动和桌面环境,每个都有独特特征、挑战和评估工具。本节总结了这些平台的关键方面及其在基准测试GUI智能体中的作用。
1)Web:Web平台是GUI智能体最常见的环境之一,反映了它们在浏览、表单填写和数据抓取等日常任务中的普遍性。Web平台评估的关键特征包括:
动态内容:Web应用通常涉及通过JavaScript、AJAX或类似技术生成的动态元素,要求智能体有效处理异步更新。
多样框架:Web技术的多样性(如HTML、CSS、JavaScript框架)要求鲁棒的智能体能够与一系列界面设计和结构交互。
工具和库:评估通常使用Selenium、Puppeteer或Playwright等工具模拟浏览器交互、收集运行时信息并将结果与预期结果比较。
无障碍合规性:还可以评估WCAG(Web内容无障碍指南)遵守等指标以确保包容性。
2)移动:移动平台,特别是Android和iOS,由于其受限界面和基于触摸的交互而对GUI智能体构成独特挑战。在移动平台上评估智能体涉及:
屏幕尺寸约束:智能体必须适应有限的屏幕空间,确保交互保持准确和高效。
触摸手势:评估智能体模拟点击、滑动和捏合等手势的能力至关重要。
平台多样性:Android设备在屏幕尺寸、分辨率和系统版本方面差异显著,而iOS提供更标准化的条件。
评估工具:Appium和Espresso(用于Android)或XCTest(用于iOS)以及模拟器等工具常用于测试和评估。
3)桌面:桌面平台为GUI智能体提供更丰富和复杂的环境,跨越Windows、macOS和Linux等多个操作系统。桌面平台上的评估通常强调:
应用多样性:智能体必须处理广泛的桌面应用,包括生产力工具、Web浏览器和定制企业软件。
交互复杂性:桌面界面通常包括高级功能,如键盘快捷键、拖放和上下文菜单,智能体必须正确处理。
跨平台兼容性:评估可能涉及确保智能体能够跨多个操作系统和版本运行。
自动化框架:Windows UI Automation、macOS Accessibility API和Linux的AT-SPI等工具用于自动化和监控智能体交互。
资源使用:内存和CPU使用是重要指标,特别是对于长时间运行的任务或资源密集型应用。
每个平台为评估GUI智能体提供了独特的挑战和机遇。Web平台强调可扩展性和动态交互,移动平台专注于触摸界面和性能,桌面平台需要处理复杂工作流和跨应用任务。一些基准是跨平台的,要求智能体具有鲁棒性、适应性并能够跨不同环境泛化。
所讨论的所有指标、测量和平台对于跨多个方面全面评估GUI智能体都是 essential 的。大多数现有基准依赖它们进行评估。在接下来,我们选择性地详述GUI智能体的这些基准。
9.4 Web智能体基准
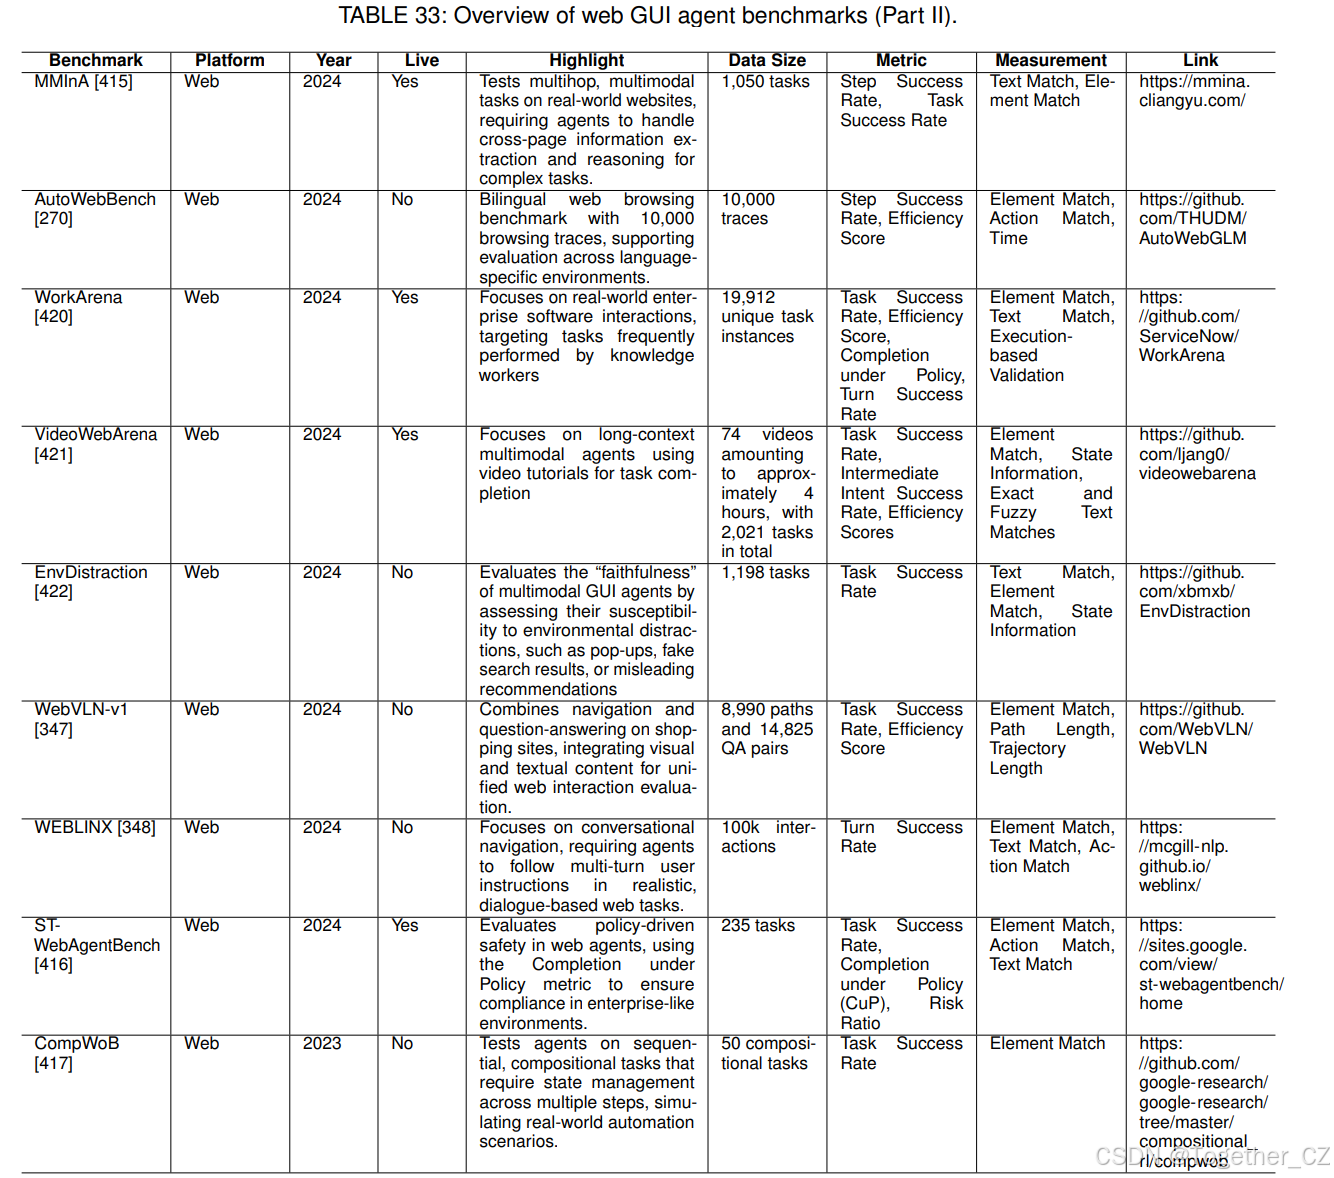
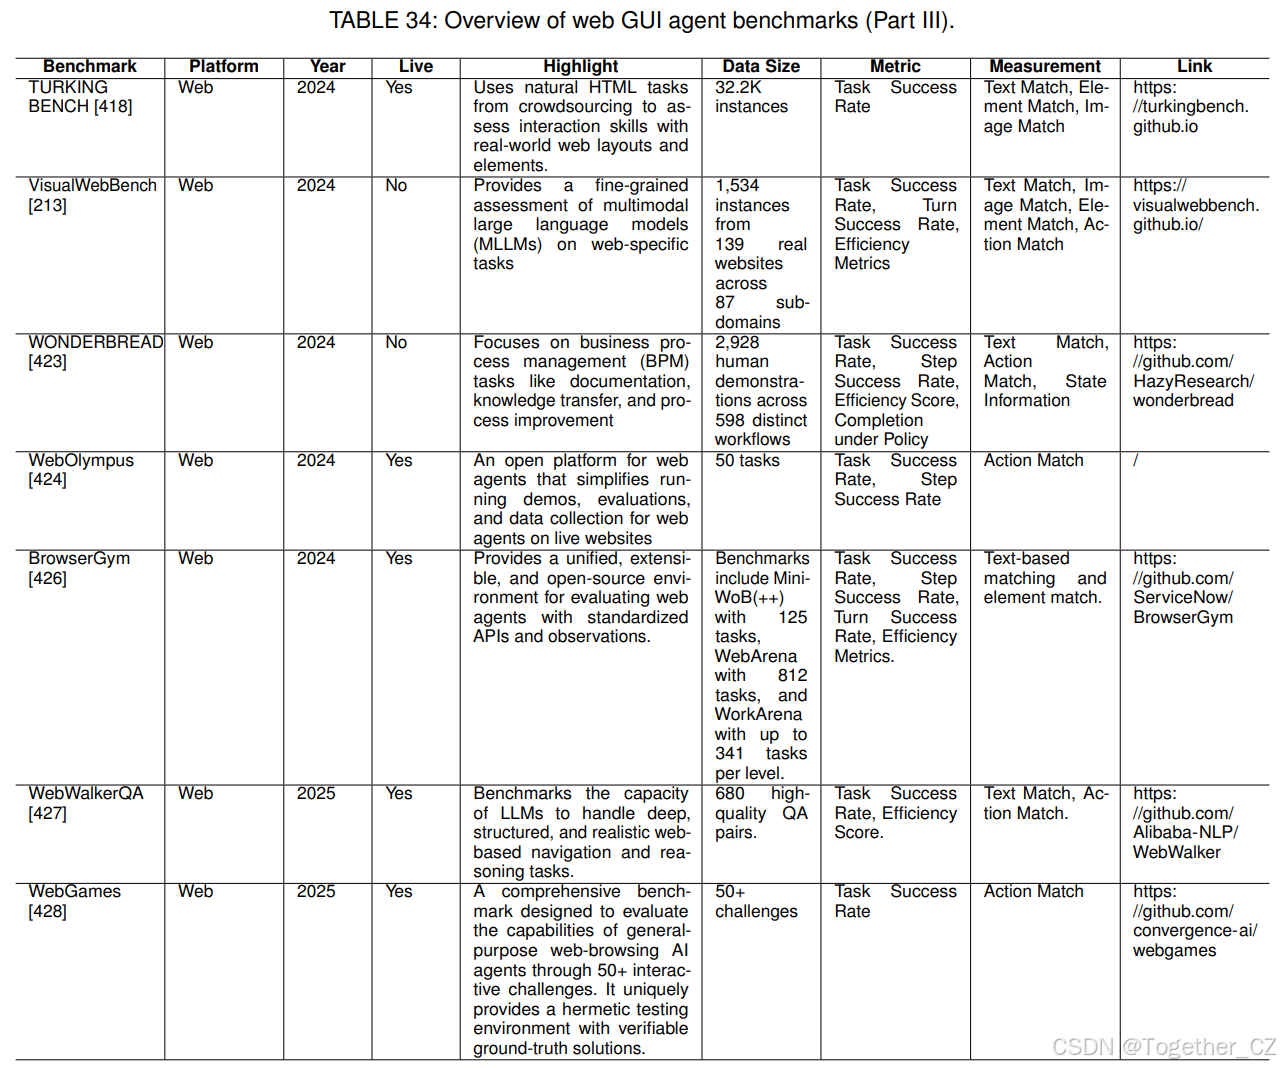
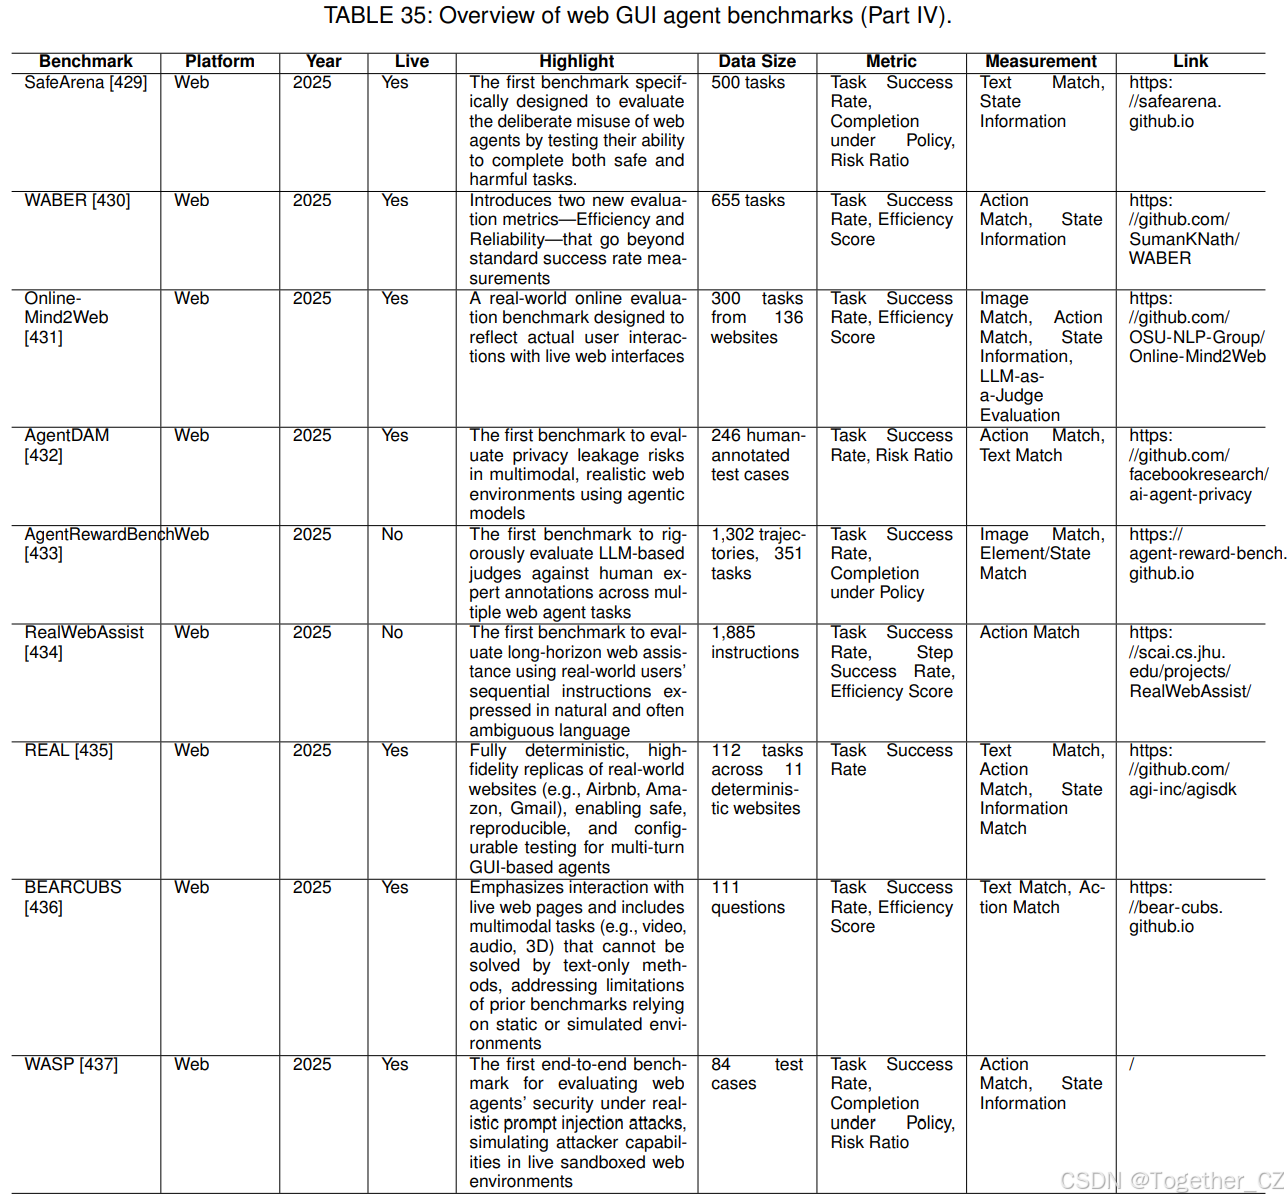
在Web环境中评估GUI智能体需要捕获基于Web任务复杂性和细微差别的基准。多年来,已经开发了几个基准,每个都为推进该领域贡献了独特的视角和挑战。我们首先在表32、33、34和35中概述这些基准。
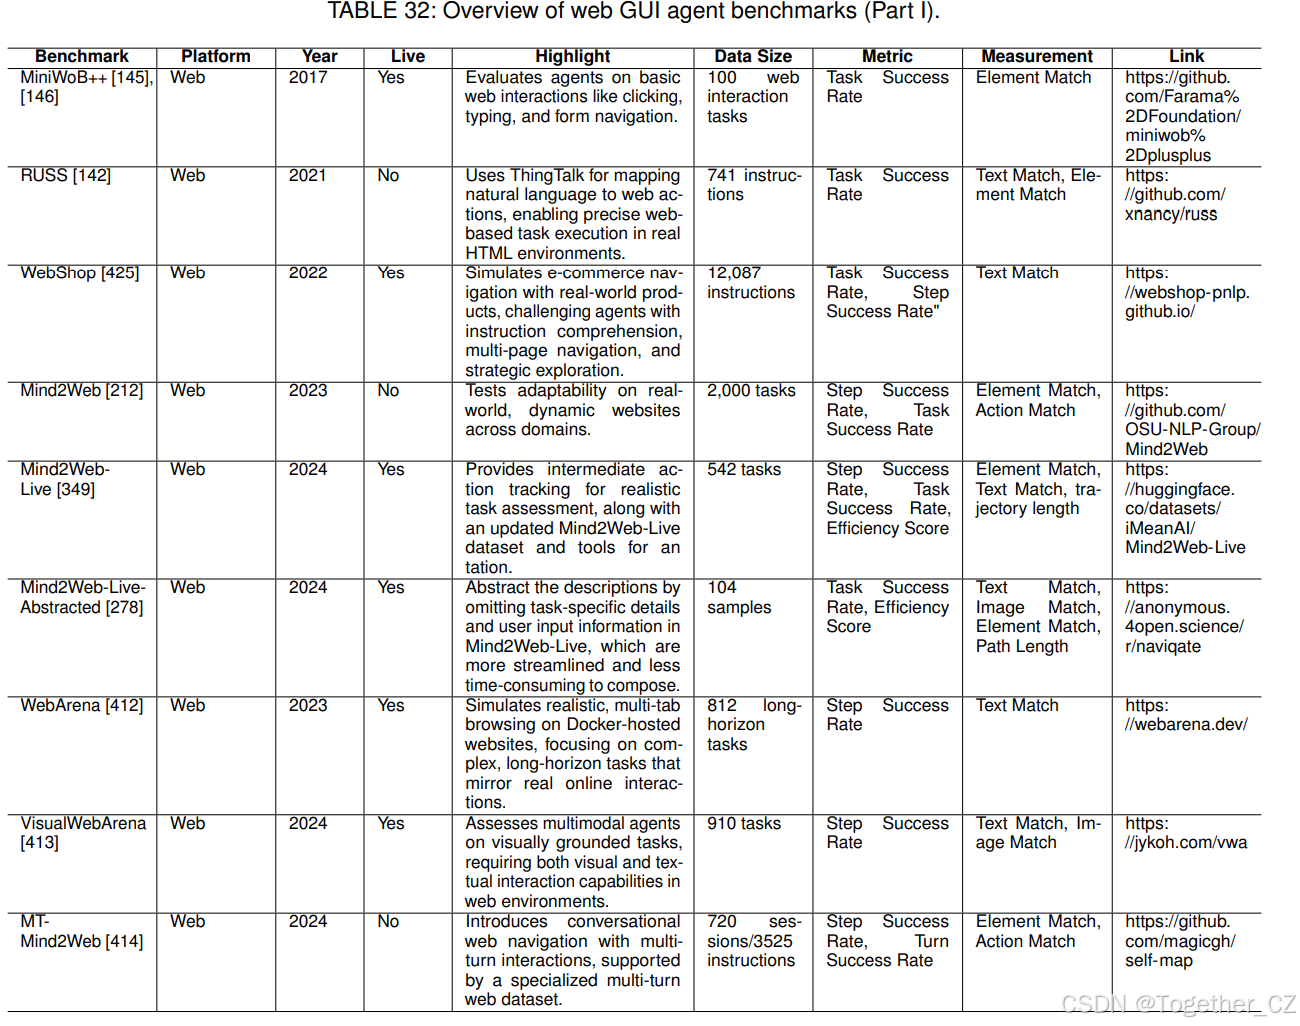
这一领域的 pioneering 努力之一是Mini-WoB++145、146,专注于评估基于Web的GUI任务上的强化学习智能体。它引入了现实的交互场景,包括点击、输入和导航Web元素,并利用工作流引导探索(WGE)提高稀疏奖励环境中的效率。智能体基于成功率评估,由其实现最终目标状态的能力决定,突出跨各种复杂性的适应性和鲁棒性。
基于对更现实环境的需求,Mind2Web212通过使智能体能够处理真实世界HTML环境而不是简化模拟,代表了重大进步。在LLM出现后建立157,它提供了跨多个领域的2,000多个任务的大型数据集,呈现从基本动作到复杂多页工作流的挑战。该基准通过元素准确性和任务成功率等指标强调端到端任务性能,鼓励对智能体的严格评估。
扩展Mind2Web的能力,MT-Mind2Web414引入了对话式Web导航,需要跨用户和环境的多个轮次的复杂交互。这个高级基准包括720个Web导航对话会话和3,525个指令和动作序列对,每个会话平均五次用户-智能体交互,从而测试智能体的对话能力和适应性。
为了进一步增强现实性,WebArena412以其模仿真实人类交互的现实Web环境设定了新标准。具有跨多个领域的812个任务,它要求智能体在多标签Web界面上执行复杂的长期交互。通过关注功能正确性而非表面匹配,WebArena促进对智能体实际能力的彻底评估。
认识到多模态能力的重要性,VisualWebArena作为WebArena412的扩展,设计用于评估智能体在现实视觉定位Web任务上的表现。包含Classifieds、Shopping和Reddit等领域910个多样任务,它增加了新的视觉功能来测量开放式任务,如视觉问答和模糊图像匹配,从而在多模态理解方面挑战智能体。
类似地,VideoWebArena421专注于评估智能体理解和交互Web上视频内容的能力。它呈现了跨2,021个任务的74个视频,挑战智能体在基于视频的信息检索、上下文推理和技能应用方面。该基准突出了当前模型的关键缺陷,强调需要智能体推理和视频理解的进步。
补充这一点,VisualWebBench213提供了多模态基准,评估网站、元素和动作级别的理解、OCR、定位和推理。跨越来自真实世界网站的1.5K样本,它识别了低分辨率输入下定位不佳和OCR不足等挑战,提供与通用多模态基准不同的关键评估视角。
超越多模态挑战,理解智能体对环境干扰的韧性至关重要。EnvDistraction422引入了基准,评估多模态GUI智能体在非恶意干扰(如弹窗和推荐)下的忠实性。研究表明即使先进智能体也容易受到此类干扰,揭示了需要鲁棒多模态感知以实现可靠自动化的脆弱性。
关注安全性和可信度,STWebAgentBench416通过强调企业环境中不安全行为的管理采取独特方法。它具有人在环系统和策略驱动层次结构,引入策略下完成(CuP)指标以评估智能体对组织、用户和任务特定策略的合规性。该基准使用BrowserGym426在Web环境中运行,包括235个任务,策略涉及各种安全维度,为企业场景中评估智能体提供全面框架。
针对企业软件任务的自动化,WorkArena420提供了强调ServiceNow平台内常见任务的基准。具有跨33个任务的19,912个独特实例,它突出了当前最先进智能体与企业UI自动化中人类能力之间的显著性能差距,为未来创新设定了轨迹。
BrowserGym426构建了为Web智能体研究设计的生态系统。它统一了Mini-WoB(++)146、WebArena412和WorkArena420等各种基准在单一框架下,解决了Web智能体评估中的碎片化问题。通过利用标准化观察和动作空间,它实现了可重现的实验。BrowserGym的可扩展架构使其成为开发和测试LLM驱动的GUI智能体的重要工具,显著加速了Web自动化研究的创新。
在与实时网站交互领域,WebOlympus424引入了开放平台,使Web智能体能够通过基于Chrome扩展的界面与实时网站交互。支持多样任务并整合安全监控器以防止有害动作,它促进了基于Web任务的安全自动化,并提供了在现实场景中评估智能体性能的关键工具。
这些基准共同为推进基于Web的GUI智能体的评估做出了重大贡献,每个都解决了现实性、多模态性、安全性和企业适用性等不同方面。它们的发展反映了创建能够进行复杂Web交互的复杂智能体的不断演变的挑战和要求。
9.5 移动智能体基准
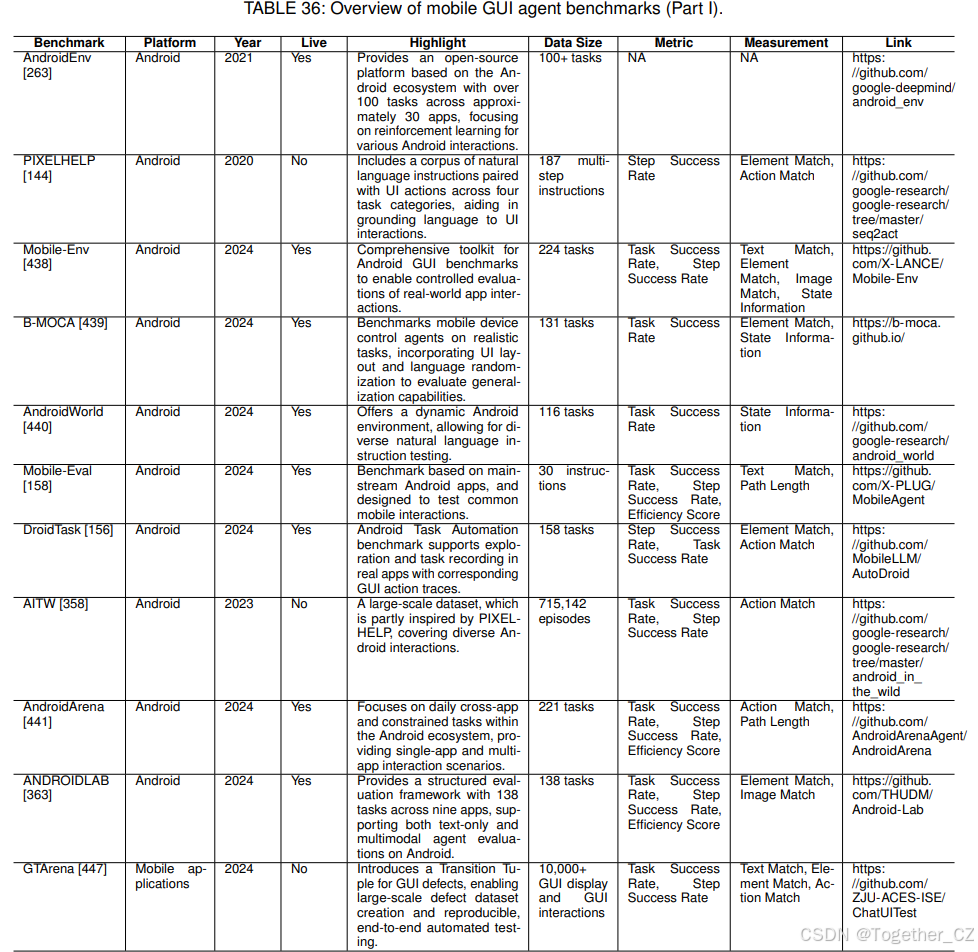
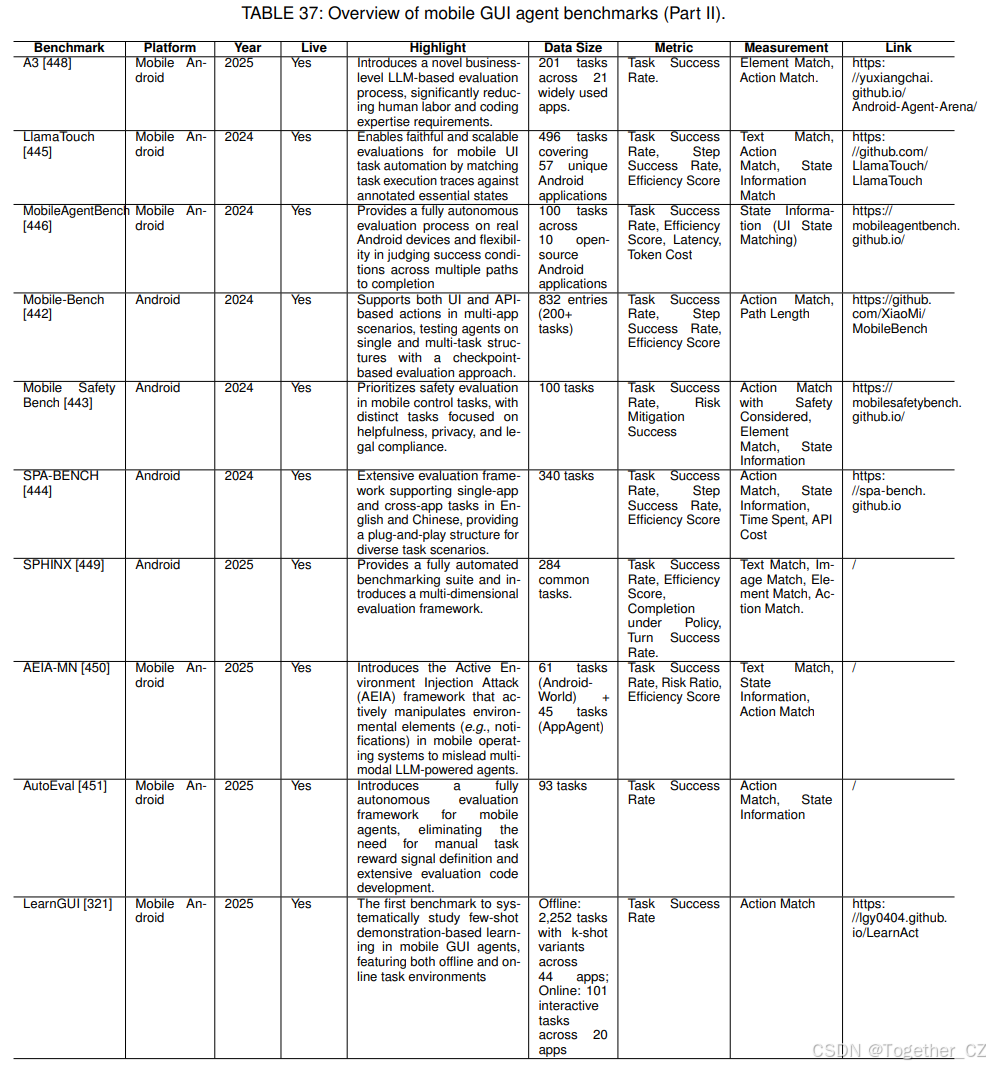
在移动平台上评估GUI智能体由于其交互的多样性和移动应用的复杂性而面临独特挑战。已经开发了几个基准来应对这些挑战,每个都为推进移动智能体评估做出贡献。我们首先在表36和37中分析这些移动基准。
这一领域的早期努力是PIXELHELP144,专注于将自然语言指令落地到移动用户界面上的动作。解决解释和执行复杂多步骤任务的重大挑战,PIXELHELP提供了在移动UI模拟器上将英语指令与人类执行动作配对的数据集。它包含跨四个任务类别的187个多步骤指令,为评估模型任务准确性提供了鲁棒资源,通过完全匹配和部分匹配等指标。
基于系统评估的需求,ANDROIDLAB363建立了基于Android的自主智能体的综合框架。它引入了动作空间和操作模式,支持文本和多模态模型的一致评估。通过提供XML和SoM操作模式,ANDROIDLAB允许LLM和LMM在等效环境中模拟真实世界交互。该基准包括跨九个应用的138个任务,涵盖典型Android功能,并使用成功率等指标评估智能体。
为了进一步挑战智能体处理API和UI操作,Mobile-Bench442通过在现实Android环境中结合这些元素提供了创新方法。其多应用设置和三个不同任务类别测试智能体处理简单和复杂移动交互的能力,超越传统的单应用场景。评估利用CheckPoint指标,在每个关键动作步骤评估智能体,提供对规划和决策技能的见解。
强调移动设备控制中的安全性,MobileSafetyBench443提供了优先考虑有用性和安全性的结构化评估框架。它在Android模拟器内严格测试智能体在常见移动任务中的表现,专注于分层风险评估,包括法律合规性和隐私。一个显著特征是其间接提示注入测试以探测智能体鲁棒性。评估确保智能体在实际成功的同时管理风险,推进LLM可靠性和安全自主设备控制的研究。
将范围扩展到多语言和应用场景,SPA-BENCH444引入了智能手机智能体的广泛基准。它评估单应用和跨应用任务,采用支持无缝智能体集成的即插即用框架。具有跨Android应用的多样任务集合,包括系统和第三方应用,SPA-BENCH提供现实测试环境,通过成功率、效率和资源使用等指标衡量智能体理解UI和处理应用导航的能力。
专注于高效和用户友好的评估,MobileAgentBench446为Android设备上的智能体提供了量身定制的基准。它提供全自动测试过程,利用最终UI状态匹配和实时应用事件跟踪。具有跨10个开源Android应用的100个任务按难度分类,它适应多种成功路径,增强可靠性和适用性。综合指标包括任务成功率、效率、延迟和令牌成本,提供对智能体性能的见解。
补充这些努力,LlamaTouch445引入了在真实Android环境中移动UI任务自动化的基准和测试平台。强调 essential 状态注释,它能够精确评估任务执行路径可变性或动态UI元素。具有跨57个独特应用的496个任务,LlamaTouch通过先进匹配技术展示可扩展性和保真度,整合像素级截图和文本屏幕层次,减少假阴性并支持多样任务复杂性。
Zhao等人引入了GTArena447,一个形式化框架和基准,旨在推进自动化GUI测试智能体。GTArena为多模态大语言模型提供了标准化评估环境。其设计的核心是新颖的Transition Tuple数据结构,系统地捕获和分析GUI缺陷。该基准评估三个核心任务------测试意图生成、任务执行和缺陷检测------使用包含真实世界、人工注入和合成缺陷的多样数据集,将GTArena确立为GUI测试智能体的开创性基准。
这些基准共同显著推进了基于移动的GUI智能体的评估,解决了任务复杂性、安全性、效率和可扩展性方面的挑战。它们的贡献有助于为移动平台开发更有能力和可靠的智能体。
9.6 计算机智能体基准
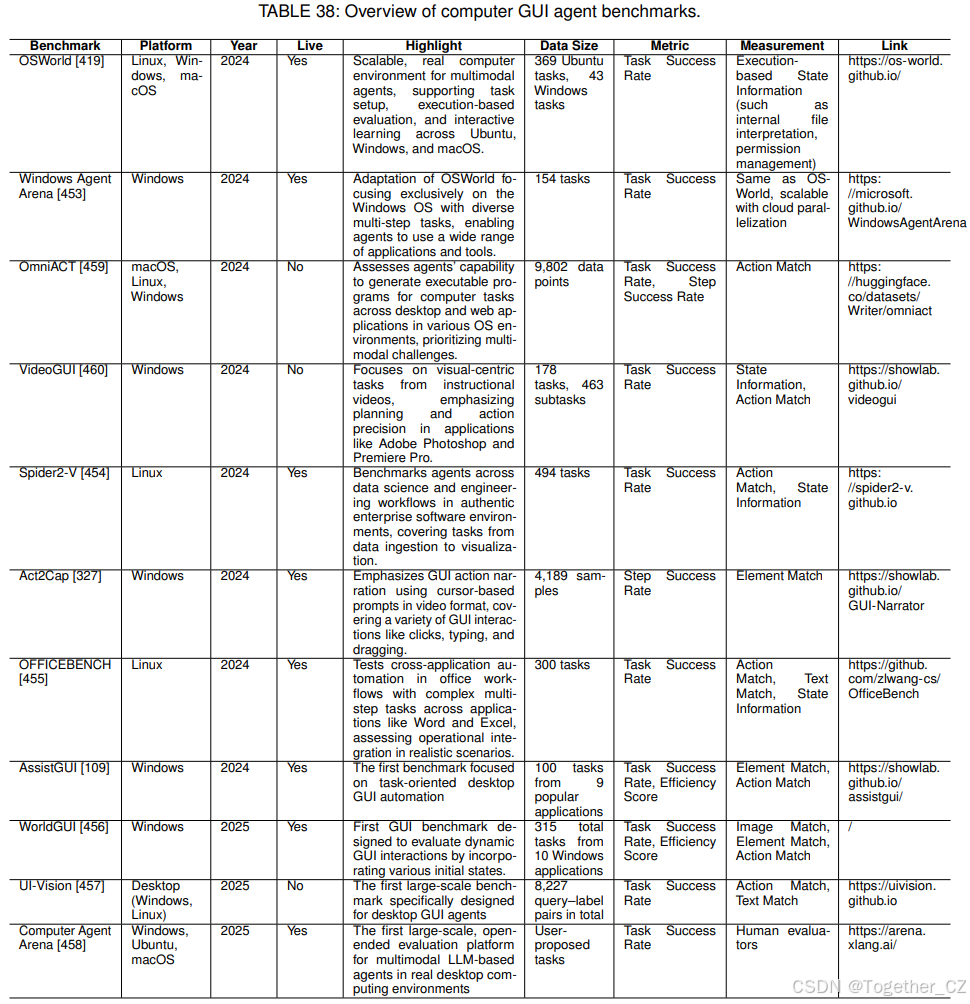
在台式计算机上评估GUI智能体涉及多样应用和复杂工作流。已经开发了几个基准来评估智能体在这些环境中的能力,每个都解决特定挑战并推进该领域。我们在表38中概述计算机GUI智能体的基准。
这一领域的早期基准是Act2Cap327,专注于使用光标作为关键视觉指南以视频格式捕获和叙述GUI动作。Act2Cap强调GUI交互的详细细微差别,特别是基于光标的动作如点击和拖动,对推进GUI密集型任务的自动化能力至关重要。它包括跨各种Windows GUI环境的4,189个样本的 substantial 数据集,采用基于元素级Intersection over Union的指标评估语义准确性以及时间和空间精度。
为了为多模态智能体提供可扩展和真实的计算机环境,OSWorld419引入了开创性框架,支持跨多个操作系统(包括Ubuntu、Windows和macOS)的任务设置、基于执行的评估和交互式学习。OSWorld作为统一环境,镜像真实世界计算机使用的复杂性和多样性,容纳任意应用和开放式计算机任务。它包括Ubuntu上369个任务和Windows上43个任务的综合套件,利用基于执行的评估指标如成功率进行严格评估。
在OSWorld基础上,WindowsArena453将框架适配为专门为Windows操作系统创建150多个多样任务。专注于多模态多步骤任务,它要求智能体在真实Windows环境中展示规划、屏幕理解和工具使用能力。为了解决评估时间慢的挑战,WindowsArena支持Azure云中的并行部署,大幅减少评估时间,允许跨各种应用和Web域进行全面测试。
专注于办公自动化任务,OFFICEBENCH455引入了在现实办公工作流中基准测试LLM智能体的开创性框架。在Linux Docker环境中模拟跨多个办公应用(如Word、Excel和Email)的复杂工作流,它评估智能体跨应用自动化的熟练程度。该基准以不同难度级别挑战智能体复杂任务,要求适应不同复杂性和用例。定制指标评估操作准确性和决策,提供对智能体管理多应用办公场景能力的关键见解。
针对数据科学和工程工作流的自动化,Spider2-V454提供了独特基准。它具有跨20个企业级应用的494个真实世界任务,涵盖从数据仓储到可视化的整个数据科学工作流。评估智能体在Ubuntu上真实企业软件环境中处理代码生成和复杂GUI交互的能力,它采用多方面评估方法,包括基于信息的验证、基于文件的比较和基于执行的验证。
在生产力软件领域,AssistGUI109提供了评估智能体能力的开创性框架。它引入了Actor-Critic Embodied Agent框架,能够进行复杂层次任务规划、GUI解析和动作生成。数据集包括设计、办公工作和系统设置等多样任务,支持项目文件以实现可重现性。通过强调像素级精度和程序遵守的结果驱动评估,AssistGUI突出了当前基于LLM的智能体在管理复杂桌面软件工作流方面的潜力和局限性。
WorldGUI456是 designed 在Windows平台上评估动态条件下GUI智能体的基准。与之前静态基准不同,它引入各种初始状态以模拟桌面和Web应用中的真实世界交互。不是总是从固定默认状态开始,智能体必须适应变化的UI布局、用户交互、系统设置和预先存在的条件,要求鲁棒的适应性以有效执行。该基准包括跨10个流行软件应用的315个任务,并纳入教学视频、项目文件和多个动作前场景,为评估智能体处理复杂任务执行的能力提供全面和现实的评估框架。
Computer Agent Arena458通过实时、用户配置的桌面环境为基准测试基于LLM的GUI智能体提供了新范式。与传统静态数据集不同,它提供了交互式云基础设施,智能体在跨Web浏览、编程和生产力使用Google Docs、VSCode和Slack等真实应用的任务上评估。其创新在于使用头对头智能体比较、人类判断和基于Elo的排名来评估现实设置中的通用数字智能体。该基准支持Windows和Ubuntu,macOS支持计划中,并允许具有多样软件和网站设置的定制任务场景。通过启用众包评估和计划开源发布,它促进社区驱动的改进和鲁棒比较。
这些基准共同为桌面平台上的GUI智能体提供了全面评估框架。
9.7 跨平台智能体基准
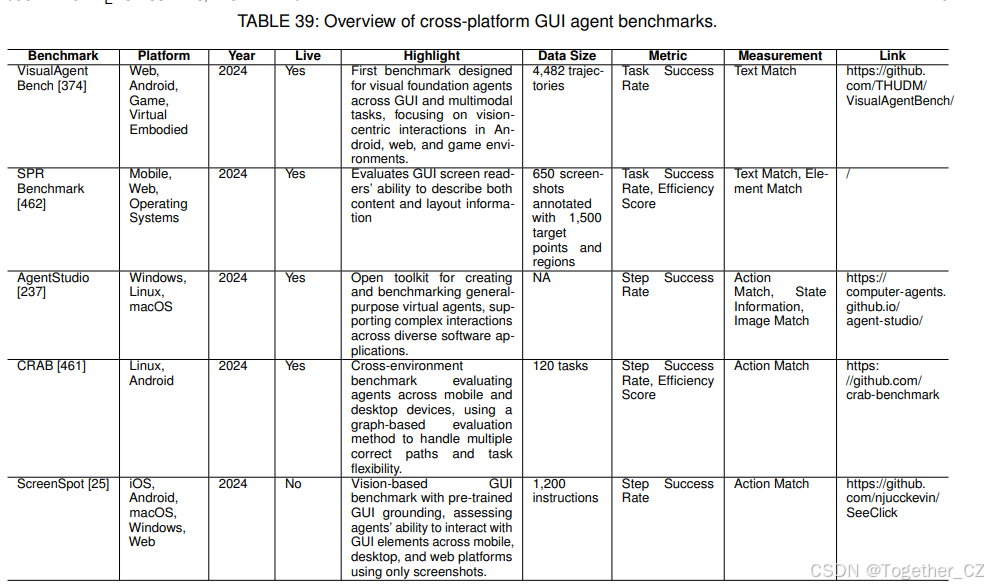
为了开发能够在多个平台上运行的GUI智能体,跨平台基准至关重要。这些基准挑战智能体适应不同环境和界面,评估其多功能性和鲁棒性。我们在表39中概述了跨平台GUI智能体的基准。
针对这一需求,VisualAgentBench(VAB)374代表了评估跨广泛现实交互任务的GUI和多模态智能体的开创性基准。涵盖Web(WebArena-Lite412)、Android(VAB-Mobile363)和游戏环境等平台,VAB专注于基于视觉的交互和高级决策任务。该基准采用多层次数据收集策略,涉及人类演示、基于程序的求解器和模型引导。评估指标集中于成功率,确保在导航和内容修改等任务中的全面性能评估,从而填补了基于GUI的LLM智能体基准标准的重大空白。
补充这一点,CRAB461通过评估多模态语言模型智能体在跨环境交互中引入了创新基准。它独特地支持无缝多设备任务执行,在任务跨越Ubuntu Linux和Android环境的场景中评估智能体。通过引入基于图的评估方法,将任务分解为子目标并适应多种正确完成路径,CRAB提供了对规划、决策和适应性的细致评估。完成率、执行效率、成本效率和成功率等指标提供对智能体性能的全面见解。
专注于跨平台视觉智能体的GUI定位,ScreenSpot25提供了强调依赖解释截图而非结构化数据的任务的综合基准。ScreenSpot包括超过600张截图和跨越移动(iOS、Android)、桌面(macOS、Windows)和Web平台的1,200个多样指令。它通过测量智能体仅通过视觉线索有效识别和交互GUI元素的能力来评估点击准确性和定位精度。通过以各种UI元素挑战模型,ScreenSpot解决了真实世界复杂性,使其成为评估跨多样环境视觉GUI智能体的 essential 资源。
这些跨平台基准共同推进了能够在多个平台无缝运行的GUI智能体的发展。通过提供全面评估框架,它们有助于评估和增强智能体在多样环境中的多功能性和适应性。
9.8 要点
GUI智能体基准的演变反映了向更现实、交互式和全面评估环境的更广泛转变。本节强调了LLM训练的GUI智能体基准测试的关键趋势和未来方向。
1)走向更交互和现实的环境:GUI智能体基准测试的近期进展强调从合成场景向更交互和现实环境的过渡。这种转变在模拟器、Docker容器和真实世界应用的使用中显而易见,以创建"实时"环境,更好地模仿真实用户交互。此类环境不仅提供对智能体能力更准确的评估,而且在性能和鲁棒性方面带来新挑战。
2)跨平台基准:涵盖移动、Web和桌面环境的跨平台基准的出现代表了评估GUI智能体泛化性的重要一步。然而,这些基准引入了每个平台特有的 fundamental 挑战。用于访问平台特定信息(如HTML和DOM结构)的统一接口可以大幅简化基准测试过程并减少实施工作。未来工作应专注于标准化这些接口,以促进跨多样环境的无缝智能体评估。
3)增加人类交互和现实性:基准中纳入更类人交互的趋势日益增长,如多轮和对话场景中所见。这些设置更紧密地镜像真实世界用例,从而对智能体处理动态、迭代交互的能力进行严格测试。随着GUI智能体变得更加复杂,基准必须继续发展以包括这些细微的交互模式,确保智能体能够在复杂、以人为中心的环境中有效运行。
4)可扩展性和自动化挑战:可扩展性仍然是基准测试GUI智能体的重要关注点。创建现实任务和为个别案例开发评估方法通常需要大量人工努力。这些过程的自动化可以缓解一些可扩展性问题,实现更广泛和高效的基准测试。未来研究应探索自动任务生成和评估技术以增强可扩展性。
5)强调安全性、隐私和合规性:评估GUI智能体在安全性、隐私和合规性指标上的趋势日益明显。随着智能体整合到敏感和受监管领域,这些考虑越来越重要。鼓励这一趋势将有助于确保智能体不仅有效执行任务,而且遵守必要的法律和道德标准。未来基准应继续扩展这些维度,纳入反映真实世界合规和数据安全要求的评估。
GUI智能体基准测试的格局正在快速发展以满足日益复杂和交互环境的需求。通过拥抱跨平台评估、促进类人交互、解决可扩展性挑战并优先考虑安全性和合规性,社区可以为下一代复杂GUI智能体铺平道路。持续的创新和协作对于完善基准至关重要,以确保它们准确捕获现代智能体的多方面能力,最终带来更直观和有效的人机交互。
10 LLM驱动的GUI智能体的应用
随着LLM训练的GUI智能体继续成熟,越来越多的应用利用这一概念创建更智能、用户友好和自然语言驱动的界面。这些进步反映在研究论文、开源项目和行业解决方案中。典型应用包括(i)GUI测试,已从传统的基于脚本的方法过渡到更直观、基于自然语言的交互,以及(ii)虚拟助手,通过自然语言界面以更自适应和响应式的方式自动化用户的日常任务。
10.1 GUI测试
GUI测试评估软件应用的图形用户界面,以确保符合指定要求、功能和用户体验标准。它验证按钮、菜单和窗口等界面元素及其对用户交互的响应。最初手动进行,GUI测试随着Selenium和Appium等自动化工具的出现而发展,使测试人员能够自动化重复任务、增加覆盖率并减少测试时间35、543。然而,LLM驱动的GUI智能体引入了范式转变,允许非专家通过自然语言界面直观地测试GUI。这些智能体涵盖多样场景,包括一般测试、输入生成和错误复现,无需传统脚本543。
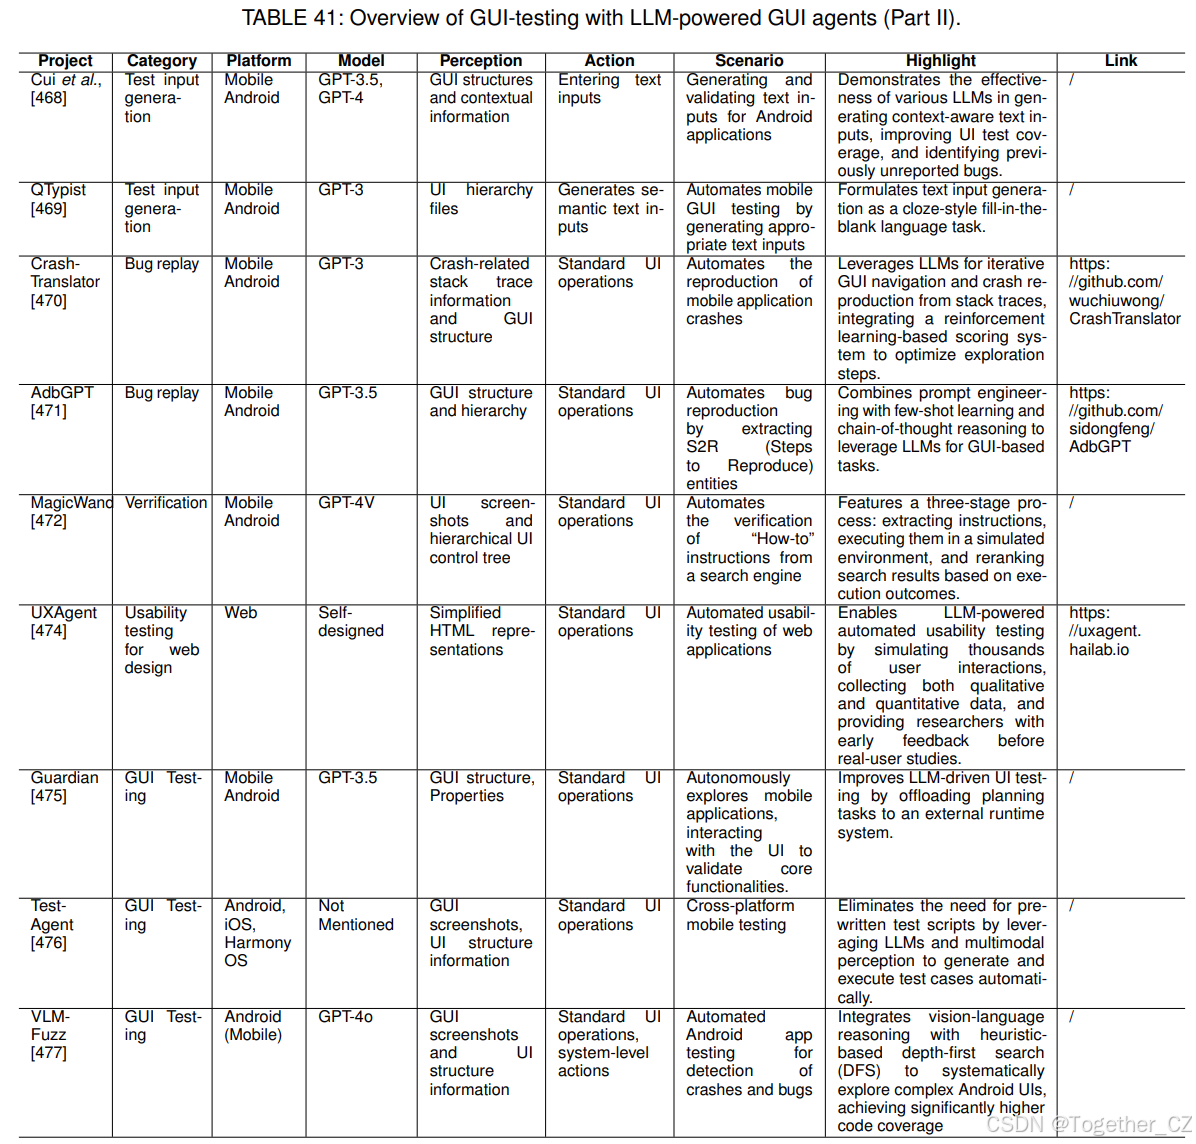
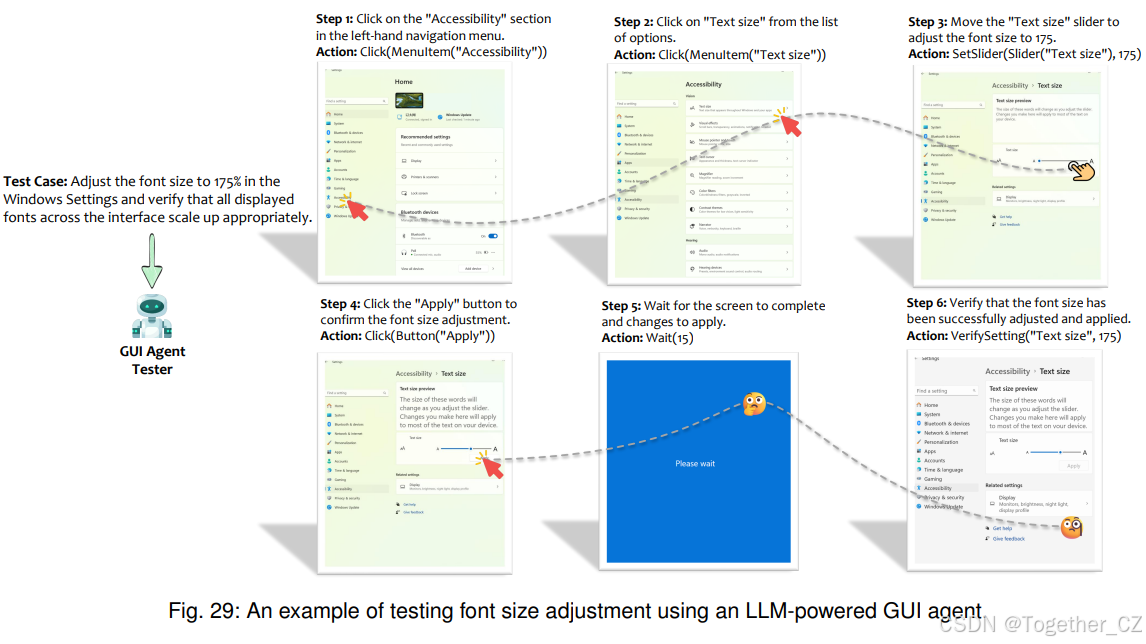
图29展示了使用LLM驱动的GUI智能体测试Windows OS上字体大小调整的过程。仅凭自然语言测试用例描述,智能体通过执行UI操作、导航设置菜单并利用其屏幕理解能力验证字体大小调整的最终结果来自主执行测试。这种方法大幅减少了人工或基于脚本测试所需的工作量。接下来,我们详述由GUI智能体驱动的GUI测试工作,并首先在表40、41和42中概述。
10.1.1 一般测试
早期探索展示了GPT-3等LLM如何通过解释自然语言测试用例并以编程方式执行来自动化GUI测试。例如,一种方法将GUI状态与GPT-3提示整合,利用Selenium和OpenCV等工具减少手动脚本并实现黑盒测试542。在此基础上,后续研究使用GPT-4和Selenium WebDriver进行Web应用测试,相比猴子测试等传统方法实现了更高的分支覆盖率463。这些进步突出了LLM如何简化GUI测试工作流,同时显著增强覆盖率和效率。
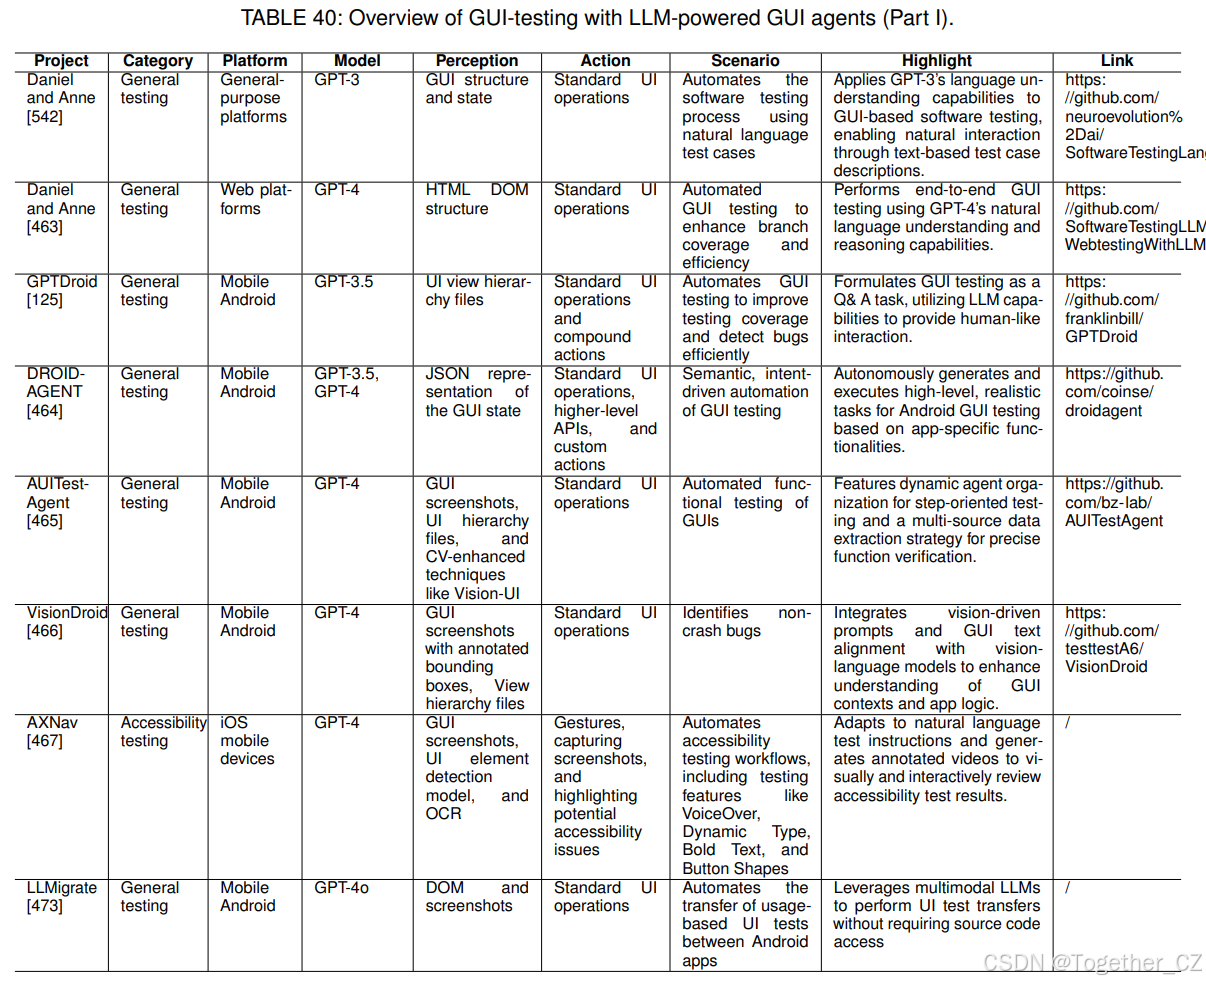
进一步推动边界,GPTDroid将GUI测试重新表述为交互式问答任务。通过从GUI页面提取结构化语义信息并利用记忆机制进行长期探索,它将活动覆盖率提高了32%,以显著精度发现关键错误125。这种方法强调了将对话界面与记忆整合用于全面应用测试的潜力。对于Android环境,DROID-AGENT引入了意图驱动测试框架。它通过以JSON格式感知GUI状态并使用LLM进行现实任务规划来自动化任务生成和执行。其设置高级目标和实现卓越功能覆盖率的能力展示了意图驱动测试如何转变GUI应用中的功能验证464。
ProphetAgent482引入了LLM驱动的GUI测试的新方法,通过从自然语言描述自动合成Android应用测试脚本。与之前直接将LLM应用于GUI截图或应用行为的方法不同,ProphetAgent构建了富含语义注释的聚类UI转换图(CUTG)。这种结构化表示实现了自然语言测试步骤与GUI操作之间更准确的映射,导致完成率(78.1%)和动作准确性(83.3%)的显著改进。系统采用双智能体架构:SemanticAgent处理语义注释,而GenerationAgent生成可执行脚本。ProphetAgent展示了强大的可扩展性和真实世界适用性------在ByteDance将测试人员工作量减少70%以上。其性能强调了将LLM与显式语义知识图结合在基于GUI环境中的有效性。
AUITestAgent通过弥合自然语言驱动需求和GUI功能之间的差距扩展了LLM驱动的GUI测试的能力465。采用多模态分析和动态智能体组织,它高效执行简单和复杂测试指令。该框架突出了结合多源数据提取与鲁棒语言模型在商业应用中自动化功能测试的价值。纳入基于视觉的方法,VisionDroid通过将截图与文本上下文对齐重新定义了GUI测试以检测非崩溃错误466。这种创新通过识别逻辑不一致和探索传统方法经常忽略的应用功能来确保应用可靠性。
无障碍测试也从LLM驱动的智能体中受益。AXNav解决了iOS无障碍工作流中的挑战,使用自然语言指令和基于像素的模型自动化VoiceOver和Dynamic Type等功能的测试。其生成注释视频以供交互审查的能力使AXNav成为无障碍测试的可扩展和用户友好解决方案467。
10.1.2 文本输入生成
在文本输入生成领域,Cui等人展示了GPT-3.5和GPT-4如何通过为UI字段生成上下文感知文本输入来增强Android应用测试468。通过系统评估这些输入在多个应用中的表现,他们揭示了LLM在改进测试覆盖率和以最少人工干预检测独特错误方面的潜力。类似地,QTypist将文本输入生成表述为填空任务,利用LLM将活动和页面覆盖率提高高达52%469。
10.1.3 错误复现
对于错误复现,CrashTranslator通过将强化学习与LLM整合来自动化从堆栈跟踪复现崩溃。其迭代导航和崩溃预测步骤显著减少了调试时间并优于最先进方法470。同时,AdbGPT展示了少样本学习和思维链推理如何将文本错误报告转换为可操作的GUI操作。通过动态推断GUI动作,AdbGPT为错误复现提供了高效和轻量级解决方案471。
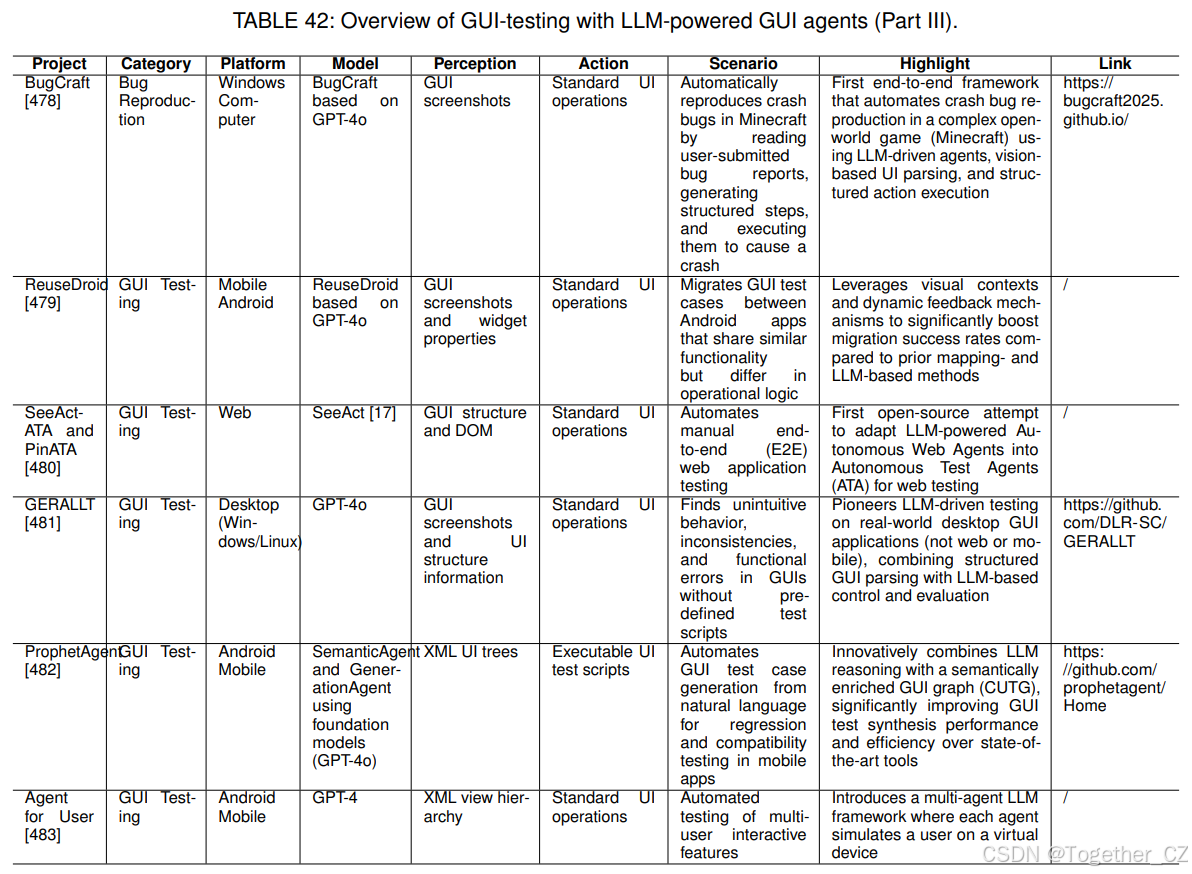
BugCraft478利用LLM驱动的GUI智能体自动化游戏中的错误复现,特别针对Minecraft的开放式和复杂环境。它采用GPT-4o作为推理引擎,整合文本错误报告、通过OmniParser184的视觉GUI理解和来自Minecraft Wiki的外部知识来生成和执行结构化复现步骤。动作通过自定义Macro API执行,实现与游戏GUI和环境的鲁棒交互。BugCraft将非结构化错误描述转换为可执行游戏内行为的能力突出了视觉增强LLM智能体在推进软件测试和调试方面的强大潜力。
10.1.4 验证
最后,作为测试中的新颖应用,MagicWand展示了LLM在自动化"How-to"验证方面的潜力。通过从搜索引擎提取、执行和完善指令,它解决了以用户为中心的任务自动化中的关键挑战,提高了GUI驱动工作流的可靠性472。
总之,LLM驱动的GUI智能体通过引入自然语言驱动方法、基于视觉的对齐和自动崩溃复现,彻底改变了GUI测试。这些创新增强了测试覆盖率、效率和可访问性,为智能GUI测试框架设定了新基准。
10.2 虚拟助手
虚拟助手,如Siri³²,是AI驱动的应用,通过在各种平台(包括Web浏览器、手机和计算机)上执行任务、回答问题 and 执行命令来帮助用户。最初,这些助手仅限于通过语音或文本输入处理简单命令,提供基于规则的响应或运行类似RPA的固定工作流。它们专注于基本任务,如设置闹钟或查看天气。
随着LLM和智能体的进步,虚拟助手已经显著发展。它们现在通过文本或语音命令支持设备GUI上更复杂、上下文感知的交互,并提供个性化响应,满足各种平台上的多样应用和用户需求。这一进展已将虚拟助手从基本实用工具转变为智能、自适应工具,能够管理复杂工作流并增强跨平台用户生产力。图30展示了智能手机上GUI智能体驱动的虚拟助手的概念示例。在这种情况下,智能体使用户能够通过聊天交互,代表他们处理设置截图快捷方式等任务。此功能对于不熟悉手机功能的用户特别有益,将复杂任务简化为对话命令。
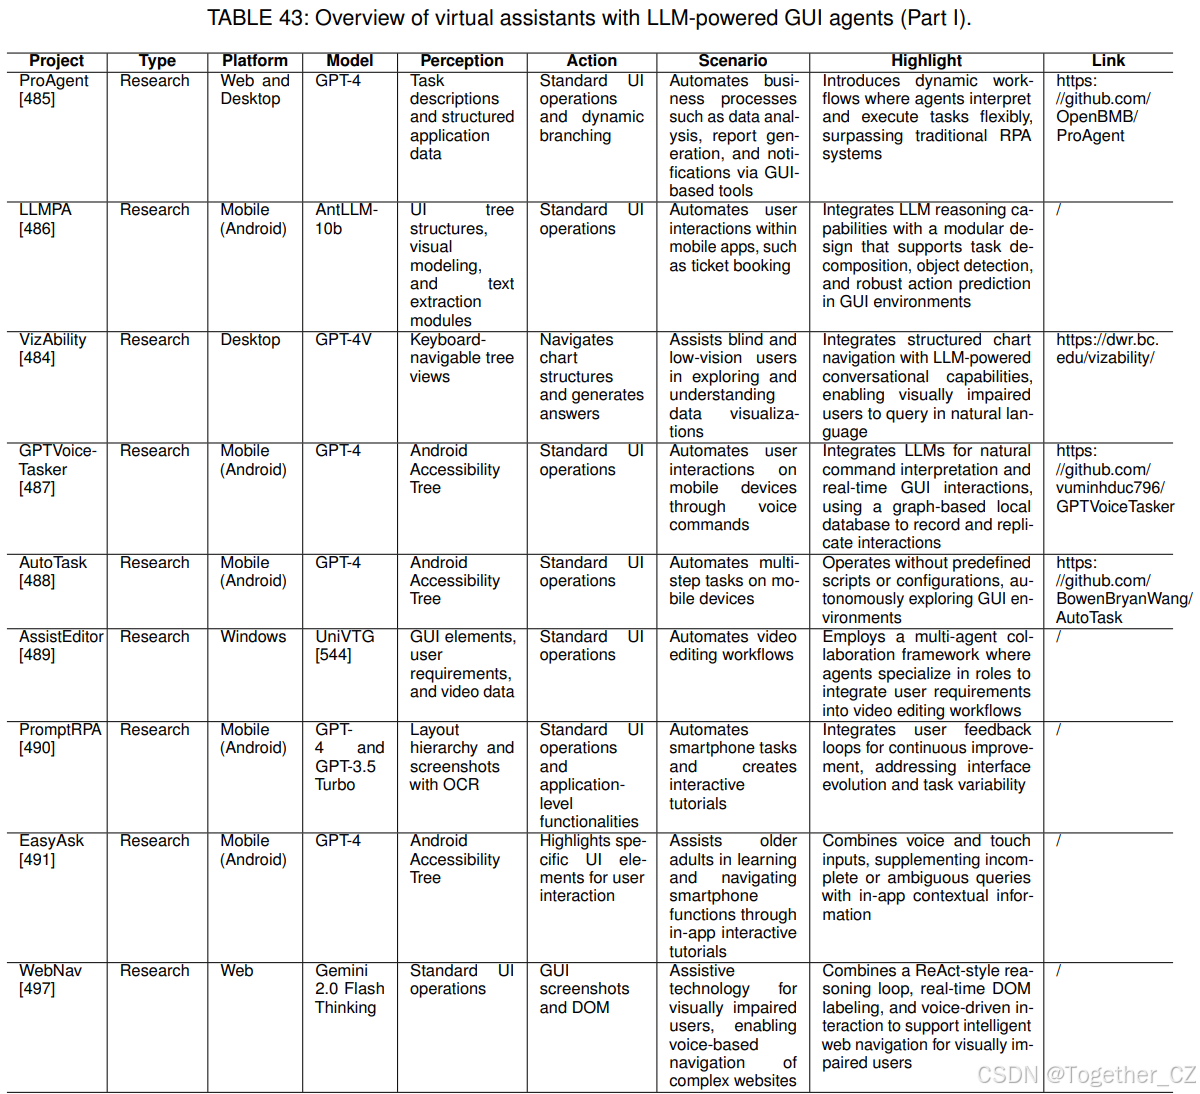
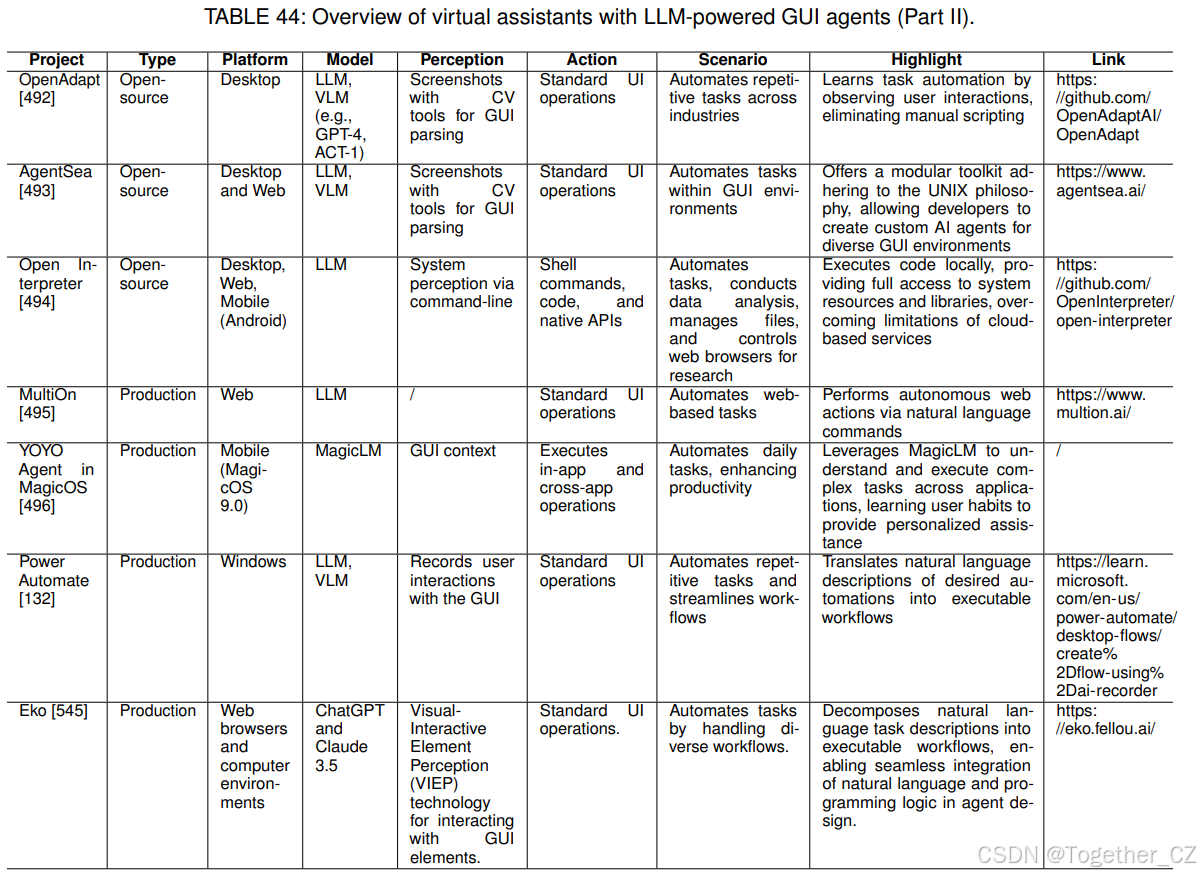
为了探索由GUI智能体驱动的虚拟助手的更多真实世界应用,我们在表43和44中概述了研究、开源倡议和生产级应用的进展。
10.2.1 研究
最近的研究工作通过整合LLM驱动的GUI智能体显著推进了虚拟助手的能力,在各种应用中实现更智能和自适应的交互。
首先,LLM整合到基于GUI的自动化中已被探索以增强业务流程自动化。例如,485通过开发ProAgent引入了Agentic Process Automation,它在GUI环境中自动化工作流的创建和执行。通过利用ControlAgent和DataAgent等智能体,它支持Slack和Google Sheets等应用中的动态分支和报告生成等复杂动作。这种方法超越传统RPA,实现灵活、智能的工作流,显著减少手动干预需求,并突出LLM驱动的智能体在虚拟助手中的变革性潜力。
在将LLM与GUI环境整合的想法基础上,研究人员专注于移动平台以自动化复杂任务。LLMPA486是一个开创性框架,利用LLM自动化Alipay等移动应用中的多步骤任务。它直接与应用GUI交互,模仿点击和输入等人类动作,并采用UI树解析和目标检测进行精确环境理解。独特的可控校准模块确保逻辑动作执行,展示了LLM驱动的虚拟助手处理复杂工作流和在协助用户多样任务中的真实世界影响的潜力。
类似地,通过自然语言提示自动化智能手机任务已由PromptRPA490解决。利用多智能体框架,它在智能手机GUI环境中自动化任务,解决界面更新和用户输入变异性等挑战。采用OCR和层次GUI分析等先进感知方法理解和交互移动界面。通过支持实时反馈和迭代改进,PromptRPA强调了LLM驱动的虚拟助手中以用户为中心设计的重要性。
在可访问性领域,LLM驱动的GUI智能体在增强残疾人士用户体验方面发挥了重要作用。例如,VizAbility484增强了盲人和低视力用户对数据可视化的可访问性。通过将结构化图表导航与基于LLM的对话交互相结合,用户可以提出自然语言查询并获得关于图表内容和趋势的见解。利用Olii³⁴等框架和Vega-Lite³⁵等图表规范,VizAbility允许在没有直接视觉感知的情况下探索视觉数据,解决了GUI中的真实世界可访问性挑战。
此外,针对老年人的需求,EasyAsk491作为上下文感知的应用内助手,增强非技术用户的可用性。通过整合多模态输入,将自然语音查询和触摸交互与GUI元素相结合,它生成准确和上下文相关的教程搜索。EasyAsk展示了GUI智能体如何通过整合上下文信息和交互式教程来增强可访问性,使用户能够有效导航智能手机功能。
语音交互也一直是焦点领域,GPTVoiceTasker487等工具通过自然语言命令促进与Android GUI的免提交互。它使用实时语义提取和UI元素的层次表示弥合语音命令和基于GUI动作之间的差距。通过自动化多步骤任务并从用户行为中学习,它增强任务效率并减少认知负担,突出了LLM在改善移动环境中可访问性和用户体验方面的变革性潜力。
扩展语音驱动交互,AutoTask488使虚拟助手能够在GUI环境中执行多步骤任务而无需预定义脚本。它自主探索和学习移动GUI,有效结合语音命令界面与动态动作引擎来交互GUI元素。利用试错和经验驱动学习,AutoTask适应未知任务和环境,展示了其在增强免提交互的语音驱动虚拟助手中的潜力。
最后,在创意工作流领域,AssistEditor489例证了用于自动化视频编辑任务的多智能体框架。通过与GUI环境交互,它使用对话系统和视频理解模型自主执行复杂工作流,弥合用户意图与专业编辑任务之间的差距。专业智能体的创新使用确保高效的任务分配和执行,展示了LLM驱动的GUI智能体在真实世界场景中的实际应用,并将自动化扩展到创意领域。
这些研究努力共同展示了LLM驱动的GUI智能体的显著进步,突出了其将虚拟助手转变为能够在各种平台和用户需求中处理复杂任务的智能、自适应工具的潜力。
10.2.2 开源项目
除了研究原型外,开源项目也为LLM驱动的GUI智能体的开发和可访问性做出了重大贡献,使更广泛的采用和定制成为可能。
一个这样的项目是OpenAdapt492,一个开源框架,利用大型多模态模型通过观察和复制用户在GUI环境中的交互来自动化任务。它捕获截图并记录用户输入,采用计算机视觉技术理解和执行标准UI操作。设计用于简化各行业的工作流,OpenAdapt从用户演示中学习,从而减少手动脚本需求并展示GUI驱动任务自动化中的适应性。
类似地,AgentSea493提供了全面和模块化的工具包,用于创建能够跨多个平台导航和交互各种GUI环境的智能体。其灵活性对于开发能够在应用中自动化复杂任务、增强用户生产力的虚拟助手特别有益。通过遵循UNIX哲学,AgentSea确保每个工具都是专业化的,促进易用性和可扩展性。其开源性质促进了AI驱动的GUI自动化中的社区协作和创新。
Open Interpreter494通过利用大语言模型本地执行代码进一步例证了开源贡献的潜力。用户可以通过自然语言命令与计算机的GUI交互,支持多种编程语言并跨各种平台操作。通过促进数据分析、Web自动化和系统管理等任务,Open Interpreter提供对系统资源和库的无限制访问,增强灵活性和控制。其定制能力使其成为旨在通过AI驱动的虚拟协助简化操作的用户的宝贵资产。
这些开源项目不仅推进了LLM驱动的GUI智能体的状态,还使智能虚拟助手的访问民主化,使开发者和用户能够根据特定需求和应用定制解决方案。
10.2.3 生产
LLM驱动的GUI智能体整合到生产环境中展示了其实际可行性和对增强商业应用中用户体验的影响。
Power Automate132例证了AI驱动的GUI智能体增强用户与桌面应用交互的方式。通过允许用户在录制动作时以自然语言描述任务,它将描述转换为自动化工作流,有效弥合用户意图和执行之间的差距。其在GUI内记录和复制用户动作的能力简化了重复任务的自动化,使其成为提高效率的宝贵工具,并突出了用户友好自动化解决方案的进步。
在Web交互领域,MultiOn495作为个人AI智能体,自主与基于Web的GUI交互以执行用户定义的任务。利用大语言模型,它解释自然语言命令并将其转换为精确的Web动作,有效自动化复杂或重复任务。MultiOn感知和操作Web元素的方法使其能够在各种Web平台上无缝运行,增强用户生产力并简化Web交互。
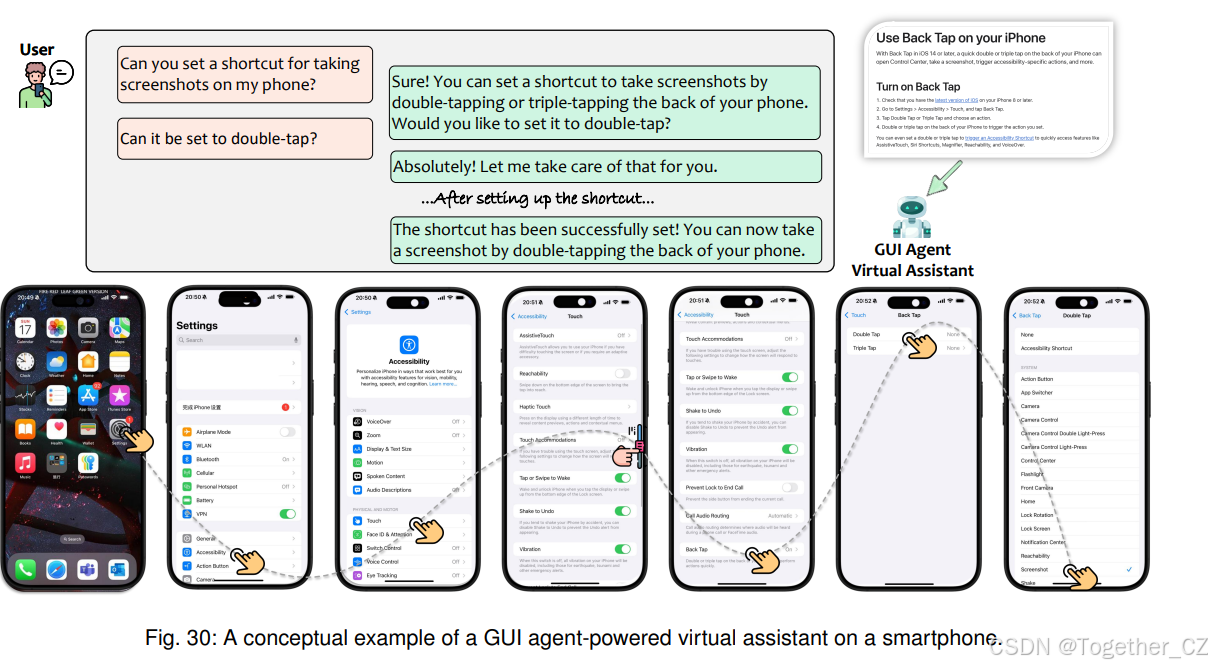
在移动平台上,MagicOS中的YOYO Agent496例证了在MagicOS 9.0界面内运行的LLM驱动的GUI智能体。利用Honor的MagicLM,它理解并执行跨各种应用的用户命令,从用户行为中学习以提供个性化协助。这种整合展示了大型语言模型如何增强虚拟助手,使其能够在GUI环境中执行复杂任务并改善移动设备上的用户体验和生产力。
Eko545作为多功能和高效工具的主要示例,用于开发能够在各种平台上与GUI交互的智能体。其与多个LLM的整合和创新的Visual-Interactive Element Perception(VIEP)技术突出了其通过自然语言指令执行复杂任务的能力。Eko的全面工具支持使其成为旨在创建可定制和生产就绪的基于智能体工作流的开发者的宝贵资源。通过促进GUI环境内的无缝交互,Eko例证了LLM驱动的虚拟助手的进步。
这些生产级实现突出了LLM训练的GUI智能体在增强跨不同平台和行业的自动化、生产力和用户参与方面的实际应用和益处。
10.3 要点
LLM训练的GUI智能体的应用为GUI测试和虚拟助手等任务带来了新能力和界面,引入了自然语言交互、增强的自动化和跨平台改进的可访问性。这些智能体通过简化复杂任务和使技术更易访问,正在改变用户与软件应用交互的方式。然而,尽管取得了这些进步,LLM训练的GUI智能体仍处于起步阶段,需要解决几个挑战才能成熟。近期发展的关键见解包括:
1)自然语言驱动的交互:LLM驱动的GUI智能体使用户能够使用自然语言与应用交互,显著降低了非专家用户的入门门槛。在GUI测试中,GPTDroid125和AUITestAgent465等工具允许测试人员用简单语言指定测试用例和需求,自动化执行和验证过程。类似地,LLMPA486和ProAgent485等虚拟助手解释用户命令以执行复杂任务,展示了自然语言界面在简化跨平台用户交互方面的潜力。
2)复杂任务的增强自动化:这些智能体展示了无需手动脚本即可自动化多步骤和复杂工作流的能力。AutoTask488和GPTVoiceTasker487等项目自主探索和交互GUI环境,基于高级目标或语音命令执行任务。在GUI测试中,智能体已...
3)多模态感知和交互:整合视觉和文本输入增强了智能体对GUI上下文的理解,导致更好的决策和交互准确性。VizAbility484和OpenAdapt492等智能体利用截图、UI树和OCR更全面地感知环境。这种多模态方法对于需要精确识别和操作GUI元素的应用至关重要,特别是在动态或视觉复杂的界面中。
4)改进的可访问性和用户体验:LLM驱动的GUI智能体有助于使技术对残疾或技术熟练度有限的用户更可访问。VizAbility484等工具帮助盲人和低视力用户理解数据可视化,而EasyAsk491协助老年人导航智能手机功能。通过针对多样用户群体的需求定制交互,这些智能体增强了包容性和用户体验。
LLM驱动的GUI智能体通过引入自然语言理解、增强自动化能力和改进可访问性,正在改变GUI交互和自动化的格局。虽然它们仍处于发展的早期阶段,但持续的进步和新兴应用对未来的前景充满希望。持续的研究和创新对于克服当前挑战并充分实现这些智能体在多样领域和平台中的潜力至关重要。
11 局限性、挑战和未来路线图
尽管LLM驱动的GUI智能体的发展取得了显著进步,但必须承认这一领域仍处于起步阶段。几个技术挑战和局限性阻碍了它们在真实世界应用中的广泛采用。解决这些问题对于增强智能体的有效性、安全性和用户接受度至关重要。在本节中,我们概述关键局限性并提出未来研究方向以克服这些挑战,提供具体示例说明每一点。
11.1 隐私问题
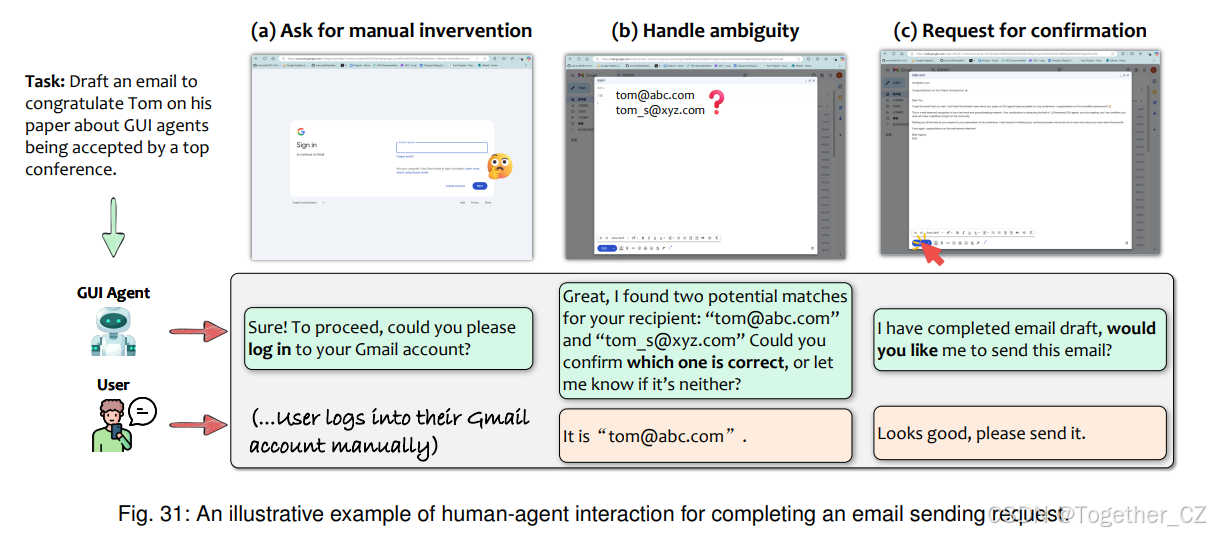
隐私是LLM驱动的GUI智能体背景下独特加剧的关键问题。这些智能体通常需要访问敏感用户数据------如截图、交互历史、个人凭证和机密文档------以有效感知和交互GUI环境。在许多情况下,这些数据必须传输到远程服务器进行模型推理,特别是在依赖基于云的LLM时546-548。此类部署带来重大隐私风险,包括数据泄露、未经授权的访问和个人信息滥用。当敏感输入通过第三方API路由或设备外处理时,这些担忧进一步放大,造成合规和安全漏洞,可能阻碍真实世界采用。
例如,负责管理用户电子邮件收件箱的GUI智能体可能需要阅读、分类和回复包含高度个人或机密内容的邮件。将此处理卸载到云端引入暴露风险,促使用户和组织因潜在隐私侵犯而犹豫432、549、550。与传统LLM应用相比,GUI智能体在更细粒度的用户活动层面操作,通常需要更广泛的系统访问,使隐私保护部署策略成为关键和领域特定的挑战。
潜在解决方案:为了缓解隐私问题,未来研究应专注于实现端侧推理,其中语言模型直接在用户设备上运行而不上传个人数据551、552。实现这一目标需要模型压缩技术553、端侧优化554和高效推理算法555的进步,以适应用户设备的计算限制。此外,框架必须纳入数据脱敏、安全通信渠道和智能体上下文中数据使用的明确范围。此外,与系统级隐私控制和用户同意机制(如运行时权限对话框或沙箱执行)的整合对于在受监管领域部署至关重要。
从技术角度来看,实施联邦学习556、差分隐私557和同态加密558等隐私保护技术可以增强数据安全性,同时允许模型从用户数据中学习。此外,GUI智能体的开发者应与隐私政策制定者合作,确保用户数据和隐私得到适当保护559。他们应向用户透明地说明数据处理过程,清楚告知正在传输哪些数据以及如何使用,并获得用户的明确同意560。
11.2 延迟、性能和资源约束
GUI智能体特别突出的一个挑战------区别于一般LLM应用------是交互式多步骤执行环境中的延迟问题。由于GUI智能体依赖大语言模型来规划和发出动作,其计算需求可能导致高延迟和慢响应时间,直接影响用户体验561。这在时间敏感或交互场景中尤为关键,动作执行的延迟可能导致用户沮丧甚至触发意外系统行为。与单次LLM任务不同,GUI智能体通常在扩展的步骤序列上操作,使延迟累积并随时间更具破坏性。在端侧部署中问题进一步放大,因为计算资源有限。例如,在移动应用内运行LLM驱动的智能体可能导致性能迟缓或电池快速耗尽,显著削弱资源受限平台上的可用性562-564。这些担忧在GUI智能体中尤为明显,因为它们需要在动态环境中实时感知、决策和UI控制563。
潜在解决方案:未来工作应旨在通过优化模型架构以提高速度和效率来减少推理延迟565。模型蒸馏等技术可以创建更小、更快的模型而不显著损害性能566。利用GPU、TPU或专用AI芯片等硬件加速器,并探索并行处理方法可以增强计算效率567。实施增量推理和缓存机制也可以通过重用适用计算来提高响应性568。此外,研究模型优化和压缩技术,如剪枝569和量化553,可以产生适合在资源受限设备上部署的轻量级模型。探索边缘计算552和分布式推理570可以帮助有效分配计算负载。
此外,GUI智能体应与应用开发者合作,鼓励他们为不同功能暴露高级原生API198、199,将多个UI操作组合为单个API调用。通过将这些API整合到GUI智能体中,任务可以用更少步骤完成,使过程更快并减少累积延迟。
11.3 安全性和可靠性
GUI智能体的真实世界 actuation 能力引入了超越通用LLM面临的独特和重大安全性和可靠性风险。因为GUI智能体可以直接操作用户界面------点击按钮、删除文件、提交表单或启动系统级操作------动作生成中的错误可能产生不可逆的后果548、571。这些可能包括数据损坏、意外消息发送、应用崩溃或未经授权访问敏感系统组件572、573。这些风险因LLM输出中固有的不确定性和非确定性而加剧:智能体可能幻觉动作、误解UI上下文或跨会话行为不一致574-578。例如,自动化金融交易的智能体可能错误地执行错误的转账,导致重大损失。此外,GUI智能体暴露比传统LLM应用更广泛的攻击面------它们容易受到黑盒对抗攻击,可能操纵其输入或利用其决策策略579。
与被动语言模型不同,GUI智能体在动态软件生态系统中运行,其中不正确的动作可能跨应用传播或升级为系统范围的破坏。整合挑战也出现,包括与不断演变的UI框架的兼容性、用户权限边界和软件特定的安全约束,以及恶意攻击580、581。这些担忧,加上缺乏可解释性和形式化保证,导致用户和开发者的怀疑和不愿。因此,解决GUI智能体中的安全性和可靠性不仅需要鲁棒的模型行为,还需要运行时保护582、回滚机制和针对这种交互范式量身定制的界面感知验证技术。
潜在解决方案:确保安全性和可靠性需要鲁棒的错误检测和处理机制583。未来研究应专注于整合验证步骤,在执行前验证推断动作的正确性584。开发形式化验证方法585、实施异常处理例程586和建立回滚程序587对于预防和减轻错误影响至关重要。此外,纳入权限管理588-591以限制智能体的访问权限可以防止未经授权或有害操作。
此外,创建标准化交互协议可以促进与各种应用和系统更顺畅和安全的整合592。确保智能体遵守安全最佳实践,如安全认证和授权协议593,至关重要。
11.4 人机交互
人机交互在GUI智能体背景下引入了独特挑战,其中智能体和用户在同一动态界面内操作。任何用户干预------如移动鼠标、更改窗口状态或修改输入------都可能无意中干扰智能体的持续执行,可能导致冲突、意外动作或任务流中断594、595。设计鲁棒的协作协议来管理智能体何时应让出控制、暂停执行或服从用户是GUI自动化特有的非平凡问题。
进一步复杂化这种交互的是用户指令的模糊性。自然语言命令可能模糊、未充分指定或上下文相关,导致误解或不完整任务计划。GUI智能体还可能遇到运行时不确定性------如意外弹窗、缺失输入或冲突的UI状态------需要它们寻求用户澄清或反馈19、596。确定智能体何时以及如何请求用户输入------无论是消歧、许可还是验证------对于确保可靠性和用户信任至关重要67、597、598。
这一挑战在图31所示的虚构场景中得到例证,其中GUI智能体被指示向"Tom"发送电子邮件。智能体必须首先提示用户安全登录,通过避免自动输入来保护凭证。然后当发现多个名为"Tom"的联系人时遇到模糊性,并通过提示用户选择预期收件人来解决。最后,在发送电子邮件之前,智能体请求明确确认,认识到发送电子邮件是不可逆动作且有隐私影响19。虽然任务看似简单,但反映了真实世界人-GUI智能体协作的复杂性,涉及隐私保护、消歧和意图确认599。这些不是通用LLM问题,而是根植于与软件界面共享交互的领域特定挑战------强调需要围绕共享控制、中断处理和主动澄清的新设计范式在GUI智能体系统中。
潜在解决方案:强调以用户为中心的设计600原则可以解决用户需求和担忧,提供定制和控制智能体行为的选项596。为智能体配备在用户指令不清楚时进行澄清对话的能力可以提高任务准确性601。自然语言理解组件可以检测模糊性并提示用户提供额外信息。例如,智能体可以问:"有两个名为John的联系人。您是指John Smith还是John Doe?"纳入人在环系统允许在任务执行期间进行人工干预,使用户能够在必要时指导或纠正智能体的决策602。开发促进人类和智能体之间无缝协作的自适应交互模型至关重要。此外,提供智能体推理过程的透明度和可解释性可以建立用户信任并改善合作67、603、604。
最后,为智能体开发虚拟桌面环境------连接到用户的主桌面会话而不中断其工作流------可以显著增强人机交互中的用户体验(UX)。UFO2334中实现的画中画模式在实践中展示了这一概念,如图32所示。通过允许智能体在可调整大小和移动的虚拟化桌面内运行,用户可以轻松最小化或重新定位智能体窗口。这种灵活性改善了与基于GUI智能体交互的可用性和整体UX。
11.5 定制和个性化
有效的GUI智能体必须超越通用任务完成,提供针对个人用户个性化的体验,适应其独特工作流、偏好和行为模式45、605。与在孤立提示或对话中操作的通用LLM应用不同,GUI智能体在用户交互风格可能显著不同的软件环境中工作。一刀切的智能体可能无法与特定用户编辑文档、导航界面或组织任务的方式对齐------导致摩擦、低效或用户沮丧606。
例如,协助文档编辑的GUI智能体必须学习用户偏好的语气、格式约定和词汇。没有这种上下文理解,智能体可能提供不相关的建议或强制执行与用户意图不一致的格式。因此,GUI智能体中的个性化需要纵向学习,智能体基于先前交互持续适应、微调其行为以匹配用户期望,并跨会话保持一致性607。
然而,这引入了新挑战。用户偏好的高度可变性------特别是在自由形式的GUI环境中------使得定义通用个性化策略变得困难。此外,收集和利用用户特定数据必须负责任地进行,引发关于隐私、数据保留和端侧学习的关键担忧。在有效定制和用户信任之间取得平衡对GUI智能体特别重要,因为它们通常操作敏感文档、个人应用或系统级界面。
潜在解决方案:未来研究应专注于开发用户建模608和偏好学习609机制,使智能体能够根据个人用户定制其动作。强化学习 from 用户反馈610、协同过滤611和上下文感知计算612等技术可以帮助智能体随时间学习用户偏好。确保在不损害隐私的情况下实现个性化至关重要613,可能通过端侧学习和匿名数据处理。在更未来主义的、赛博朋克启发的场景中,智能体可能反向生成适合用户需求的GUI,实现更大的定制和个性化614。
11.6 伦理和监管挑战
LLM驱动的GUI智能体由于其跨软件界面执行真实世界动作的能力而引发独特的伦理和监管问题。与传统LLM不同,这些智能体可以自主触发操作、操纵数据并与敏感应用交互------放大围绕问责、公平性和用户同意的风险548、615-618。
一个关键关注是继承自训练数据的偏见,可能导致敏感工作流中的不公平行为。例如,协助招聘的GUI智能体可能无意中表现出性别或种族偏见619、620。由于跨多应用动作的可追溯性有限,这些风险在GUI层面更难审计。监管合规增加了进一步的复杂性。GUI智能体通常跨具有严格数据保护法的领域操作,但缺乏标准化机制来记录动作或确保用户同意。这使得满足法律和道德标准变得具有挑战性,特别是当智能体在不透明或后台上下文中行动时。解决这些问题需要针对GUI智能体的量身定制解决方案,包括权限控制、运行时确认和透明活动日志------确保在多样环境中安全、公平和合规部署。
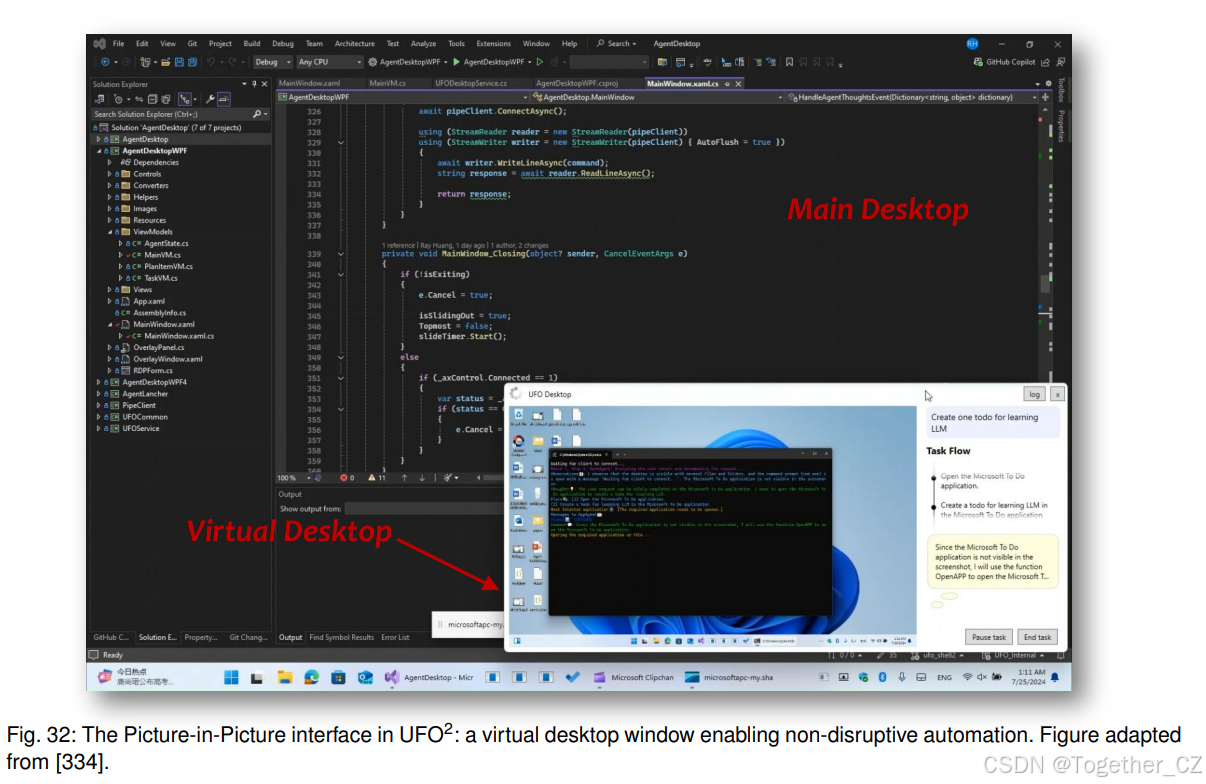
潜在解决方案:解决这些关注需要为GUI智能体的开发和使用建立明确的伦理指南和监管框架621。未来工作应专注于创建审计和监控智能体行为的机制622以确保符合伦理标准和法律要求623。在语言模型中纳入偏见检测和缓解策略可以帮助防止歧视或不公平动作624。为用户提供数据使用控制权和关于智能体能力的清晰信息可以增强透明度和信任。
11.7 可扩展性和泛化
GUI智能体通常难以扩展到特定应用或环境之外,限制其泛化。每个软件界面具有独特的布局、风格和交互模式------即使常见的UI元素如弹窗也可能差异很大625。这些变化使得设计无需重新训练或微调即可跨平台鲁棒运行的智能体变得困难。
进一步的挑战是真实世界GUI的动态性质。由于软件更新、A/B测试或界面重新设计导致的频繁变化------如按钮重新定位或控件层次修改------可以轻易破坏先前功能正常的智能体。例如,在一个版本的字处理器上训练的智能体可能在布局变化时失败,或在部署到具有类似功能但界面结构不同的程序时失败。即使GUI具有视觉相似性,智能体通常在没有额外探索或适应的情况下无法泛化626。这种鲁棒性缺乏限制了实际设置中的部署并增加了维护成本,需要频繁更新或重新训练以与不断演变的环境保持一致627-629。克服这一挑战对于开发真正可扩展和自适应的GUI智能体仍然至关重要。
潜在解决方案:为了增强可扩展性和泛化,从数据集角度的解决方案是创建涵盖广泛环境、用户请求、GUI设计、平台和交互模式的综合GUI智能体数据集。通过在训练期间将LLM暴露于多样数据源,模型可以学习常见模式并发展更通用的理解,使其能够基于学到的相似性推断新界面的功能630。
为了进一步增强适应性,研究可以专注于迁移学习631和元学习632等技术。迁移学习涉及在大型多样数据集上预训练模型,然后在较小的任务特定数据集上微调。在GUI智能体的背景下,这意味着在广泛GUI交互上训练LLM,然后为特定应用或领域定制。元学习使模型能够通过识别不同任务之间的底层结构和模式,以最少数据快速适应新任务。这些方法使智能体能够从有限数据泛化并以最少重新训练适应新环境。
然而,即使采取这些措施,智能体在陌生环境中仍可能遇到困难。为了解决这个问题,我们倡导开发者提供有用的知识库,如指导文档、应用文档、可搜索FAQ甚至关于如何使用应用的人类演示633-635。可以采用RAG189等技术,其中智能体在运行时从知识库检索相关信息以告知其决策636。例如,如果智能体遇到未知界面元素,它可以查询文档以了解其目的以及如何交互。这种方法增强了智能体的能力而无需大量重新训练。实施这些解决方案不仅需要智能体开发者的协作努力,还需要应用或环境提供者的协作。
11.8 总结
LLM驱动的GUI智能体在自动化复杂任务和增强各种应用中的用户生产力方面具有重大前景。然而,实现这一潜力需要通过专门的研究和开发努力来解决所概述的局限性。通过解决这些挑战,社区可以开发更鲁棒和广泛采用的GUI智能体。
研究人员、行业从业者、政策制定者和用户之间的合作对于成功应对这些挑战至关重要。建立跨学科团队可以促进创新并确保GUI智能体以负责任的方式开发,清楚理解技术、伦理和社会影响。随着该领域的进步,持续评估和适应对于将技术进步与用户需求和期望对齐至关重要,最终带来更智能、安全和用户友好的GUI智能体。
12 结论
LLM与GUI自动化的结合标志着人机交互的变革性时刻。LLM为自然语言处理、理解和GUI理解提供"大脑",而GUI自动化工具作为"手",将智能体的认知能力转化为软件环境中的可操作命令。它们共同形成LLM驱动的GUI智能体,引入用户交互的新范式,允许用户通过简单的自然语言命令控制应用,而不是复杂的平台特定UI操作。这种协同作用已显示出显著潜力,应用在研究和工业中蓬勃发展。
在本综述中,我们提供了LLM驱动的GUI智能体领域的全面、系统和及时的概述。我们的工作介绍了支撑这些智能体的核心组件和先进技术,同时考察了数据收集、模型开发、框架、评估方法和真实世界应用等关键要素。此外,我们探讨了这些智能体当前面临的局限性和挑战,并概述了未来研究方向的路线图。我们希望本综述既可作为学习LLM驱动的GUI智能体的宝贵手册,也可作为旨在保持该领域发展前沿的研究人员的参考点。
展望未来,LLM驱动的GUI智能体的概念有望变得越来越切实,从根本上增强日常生活和工作的生产力和可访问性。随着持续的研究和开发,这项技术有望重塑我们与数字系统交互的方式,将复杂工作流转变为无缝、自然的交互。