本文要处理的问题:当模型与产品按周迭代时,怎么用一套可复用的评估口径,判断一次发布是否真的改善了用户的日常任务。
一、问题:发布会上的能力指标,和用户手里的任务不是一套账
一场开发者大会可以给出二十项更新,覆盖新模型、编程与办公能力、智能体工具,以及一项全新产品。发布会结束之后,重度用户的反馈却集中在另一处:影响每天使用的问题没有消失。
这里其实有两套彼此独立的度量。
一套是能力指标:纸面性能、推理效率、把吞吐量统一折算之后的横向对比。这套指标描述的是上限,通常取一批公开任务上的表现。另一套是任务完成率:用户当天要交付的东西,有没有按时按质做完。它依赖具体的任务集、上下文长度、并发情况以及额度余量。
能力指标上涨,任务完成率未必跟着动。原因往往不在算力,而在任务集被换掉了------新的评测集更容易出分,而用户手里那批任务,还是原来那一批。
同一次更新还会带进另一个变量:使用额度。在算力紧张的阶段,订阅套餐的新用户注册一度暂停,随后可用额度又被收紧。对评估系统来说,这意味着历史基线在用户没有做任何操作的情况下发生了变化。
如果评估口径不把额度写进去,两次发布之间的对比就会失真。用户感知到的变慢,有时是模型本身的问题,有时只是同样的时间窗里可调用的量变少了。
能力指标描述的是上限,任务完成率描述的是日常。
二、方案:任务集、指标、阈值三层分离
工程上把评估拆成三层,每层只对上一层负责。
- 任务集层:固定一批贴近真实交付的任务,标注输入、上下文长度与验收标准;
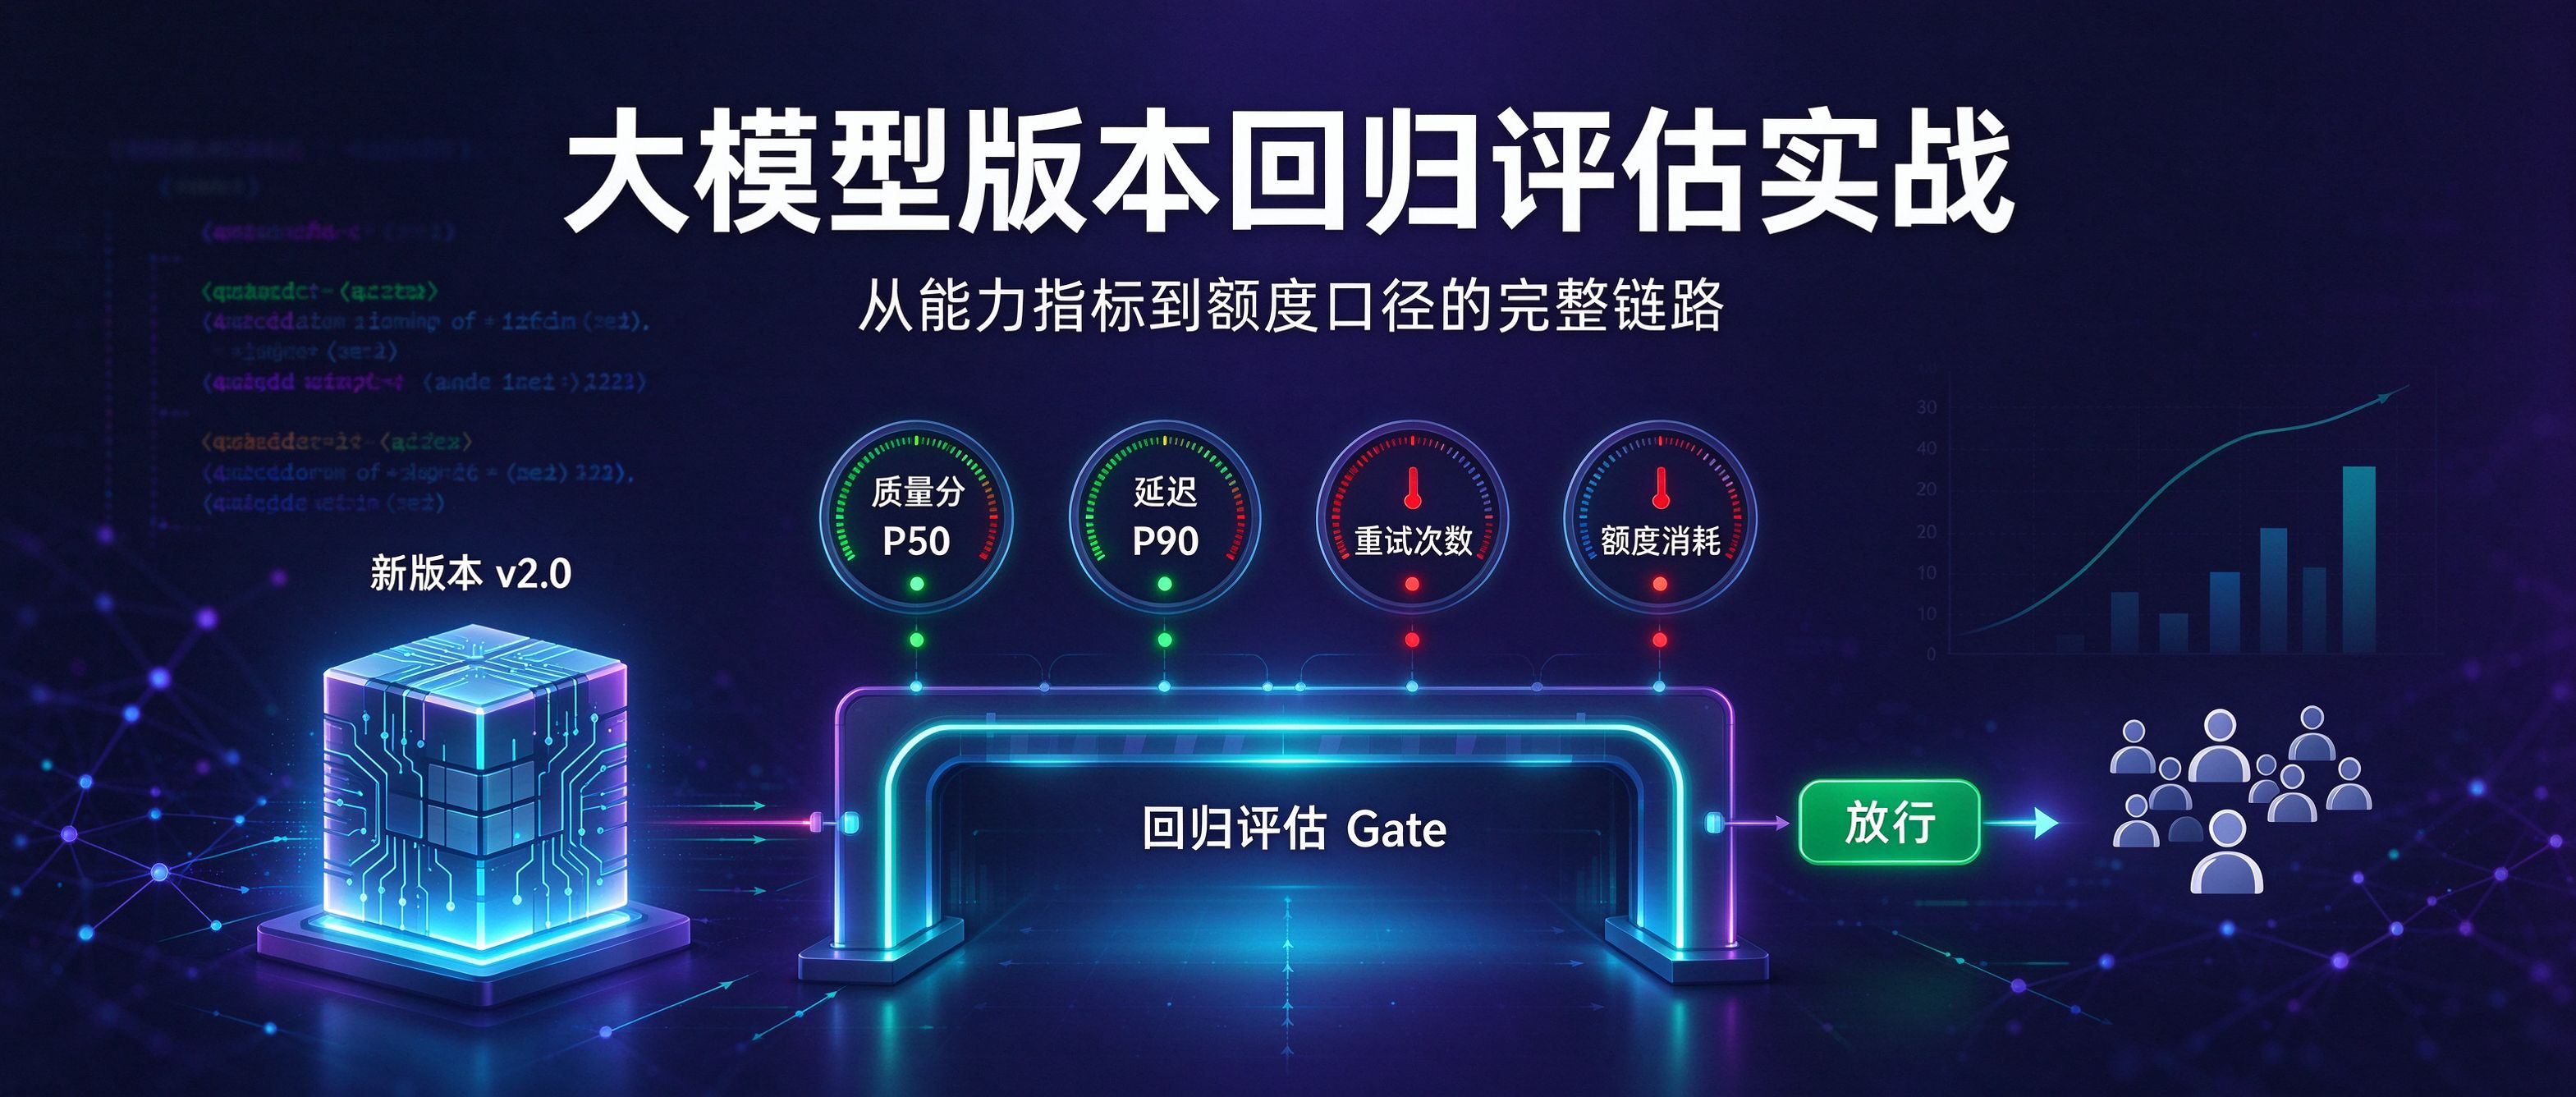
- 指标层:同时输出质量分、完成耗时、重试次数与额度消耗;
- 阈值层:为每项指标设定回归边界,超出即拦截发布。
目录结构
release-eval/
├── tasks/ # 固定任务集与验收标准
│ ├── registry.yaml
│ └── fixtures/
├── metrics/ # 指标计算
│ └── collect.py
├── gate/ # 回归阈值与拦截规则
│ ├── thresholds.yaml
│ └── decide.py
└── report/
└── render.py
评估配置
eval:
task_set: v3
repeats: 3
metrics:- quality_score
- latency_p50_ms
- latency_p90_ms
- retry_count
- quota_used
baseline: last_release
normalize:
throughput: true
context_length: true
dimensions: - task_family
- context_bucket
repeats 这个字段不能省。同一批任务只跑一次,得到的是那一瞬间的状态;跑三次取分位数,才能把机器抖动和真实回归分开。
normalize 里的两项同样关键。把吞吐量和上下文长度折算到同一基准之后再比,才不至于拿短上下文的成绩去解释长任务的表现。
三、指标口径
口径不统一的后果是:两份看起来都很完整的报告,放在一起没法比。
| 指标 | 计算方式 | 需要注意的地方 |
| 质量分 | 固定验收标准下的人工或规则判定 | 判定标准要外置,不能写在脚本里 |
| 完成耗时 | 任务开始到验收通过的时长 | 取分位数,均值容易被长尾拉偏 |
| 重试次数 | 单次任务内的返工轮数 | 与质量分同看,单独看会误判 |
| 额度消耗 | 单个任务消耗的可调用量 | 跨版本对比的前提是任务集不变 |
| 稳定性 | 同一批任务三次跑分的波动幅度 | 波动过大时,先修采集再谈优化 |
口径外置成配置文件之后,调整口径不再需要改动采集代码,历史数据也能按新口径重算。
四、验证
评估系统的问题往往不是准不准,而是稳不稳。同一批任务在同一个版本上连跑三次,结果差异过大,说明评估本身有问题。
checks: - name: 采样稳定性
rule: stdev(three_runs) / mean(three_runs) <= 0.10 - name: 任务集覆盖
rule: covered_families == configured_families - name: 额度口径一致
rule: all(r.quota_used_unit == "token" for r in results) - name: 基线可比
rule: baseline.task_set == current.task_set - name: 回归拦截
rule: drop(quality_score) <= 0.02
基线可比这一条容易被跳过。任务集一换,历史分就不再有参照意义,此时应当重建基线,而不是拿新旧数字直接相减。
五、踩坑记录
坑一:用单次跑分代表一个版本。 只看一次评估就下结论,误区在于波动被当成了信号。正确做法是固定任务集多次采样后取分位数。
坑二:跨任务族直接比耗时。 不同任务族的上下文长度和调用次数差异很大,原值直接比较会得出误导性结论。可比的前提是同一任务族、同一时间窗、同一口径。
坑三:把额度消耗排除在指标之外。 额度收紧之后,同样的任务要消耗更多轮次才能完成,如果报告里只有耗时没有额度,回归定位就会找错方向。
坑四:把发布清单当验收清单。 清单记录的是做出来的功能,验收记录的是任务通过率。两者混用,会出现功能全在、体验没变的局面。
反例:只看能力指标就放行
gate = {"score": bench.score, "pass": bench.score >= baseline.score}
正例:能力指标与任务完成率同时进闸门
runs = repeat_eval(task_set="v3", repeats=3)
gate = {
"quality_p50": percentile(runs, "quality_score", 50),
"latency_p90": percentile(runs, "latency_p50_ms", 90),
"quota_delta": delta(runs, "quota_used", baseline="last_release"),
"pass": percentile(runs, "quality_score", 50) >= baseline.quality_p50 - 0.02,
}
部署时还有一处细节:评估入口的地址用 your-domain.test 这类占位域名统一管理,按环境分发到不同执行节点,否则单点故障会同时污染多个版本的样本。
六、小结
从发布会上的能力指标到用户手里的任务完成率,中间隔着一整套评估口径。评估系统的价值不在于把分数刷多高,而在于让不同版本、不同任务族、不同额度窗口的结果能够放在同一张表里比较。
顺序也应当反过来:先固定口径,再谈优化。