目录
- 前言
- [1. 最终成绩](#1. 最终成绩)
- [2. 安装](#2. 安装)
-
- 该选哪个模型
- [注意点 1:模型下载太慢](#注意点 1:模型下载太慢)
- [注意点 2:Strata 引擎下载太慢](#注意点 2:Strata 引擎下载太慢)
- [注意点 3:如何指定模型路径?](#注意点 3:如何指定模型路径?)
- [注意点 4:安装 nvidia-cublas 和 nvidia-cuda-runtime 很慢](#注意点 4:安装 nvidia-cublas 和 nvidia-cuda-runtime 很慢)
- [注意点 5:如何指定上下文大小和端口?](#注意点 5:如何指定上下文大小和端口?)
- [注意点 6:如何指定推理强度?](#注意点 6:如何指定推理强度?)
- 3.结语
前言
这几天,一个新的推理框架 Strata 火了,能让消费级显卡(英伟达 30、40 系列)实现本地运行 Qwen3.8 Flash。看了 GitHub 上的介绍和很多人的测试,用 8G 显存和 32G 内存就能跑出不错的成绩,大概 50 tok/s。于是趁着假期,我也赶紧试了一下,这里记录一下。
1. 最终成绩
我用 32k 上下文和 128k 上下文分别进行了测试,总体来说,差别不是很大。
md
显卡:英伟达 4080 12G 显存
内存:64G
模型:Qwen3.8 Flash IQ2_XS 量化版本
速度:平均 50 tok/s,最高 70 tok/s(32k 上下文)
速度:平均 40 tok/s,最高 60 tok/s(128k 上下文)
作为对比,我此前本地一直使用的 Qwen3.8-27B,成绩差很远:
md
显卡:英伟达 4080 12G 显存
内存:64G
模型:Qwen3.8-27B-UD-IQ3_S.gguf 量化版本
速度:平均 40 tok/s(8k 上下文)
速度:平均 5 tok/s(30k 上下文)
Claude Code、Codex、OpenCode 等工具初始化时,都会发给模型 30k 左右的 token,因此这些工具如果接 Qwen3.8-27B,体验会非常差。现在有了 Strata,可以说是质的提升。速度很快,128k 上下文能达到四五十 tok/s,比之前 30k 上下文下 5 tok/s 的体验好太多。因此推荐大家都去试一试。
2. 安装
该选哪个模型
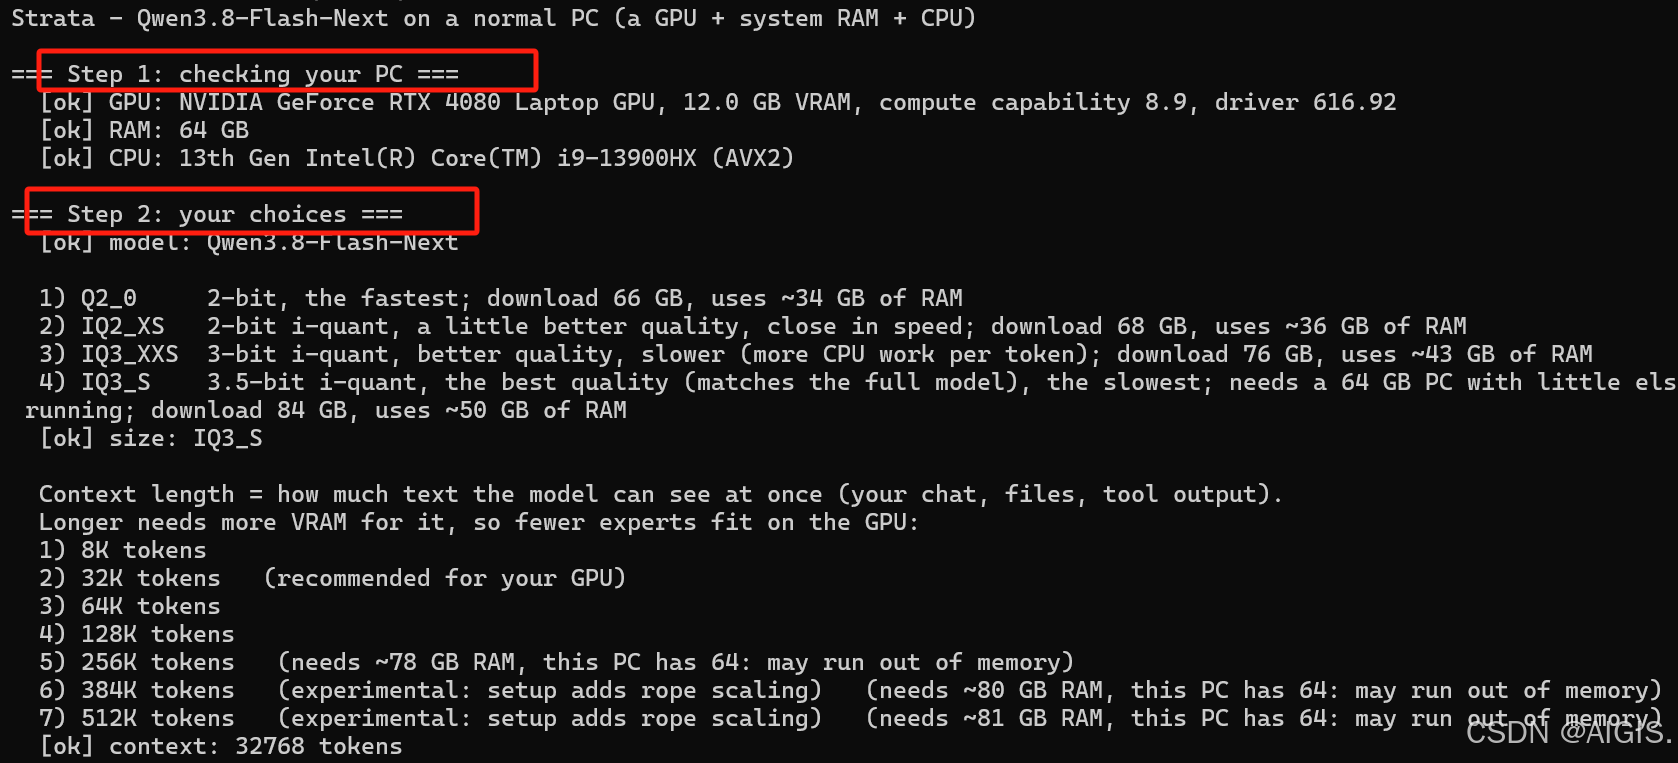
安装程序会根据你的内存推荐一个。同一个模型有几种规格,压缩程度不同。规格越小越快,越大越聪明一些。
| 你的内存 | 选择 | 原因 |
|---|---|---|
| 32 GB | Coder(IQ1_M) | 32 GB 装得下,而且专为代码打造(如果显卡是 24 GB,Q2_0 和 IQ2_XS 也能跑) |
| 48 GB | IQ2_XS(或 Q2_0,最快) | 更大的规格装不下 |
| 64 GB | IQ2_XS(推荐),或 IQ3_XXS / IQ3_S | 所有规格都装得下;IQ3_S 最好,也最慢 |
| 96 GB 或以上 | IQ3_S,或 Unsloth 的 UD-IQ4_XS(约 4-bit) | 开着其他程序也能放下最大的规格 |
因为这是一个 Python 项目,起初我想用 Conda 创建环境,但安装时才发现不能用 Conda 环境,因为项目的安装步骤把 Python 环境固定在了项目的 .venv 文件夹中。项目地址是:
https://github.com/Niko1221/Strata
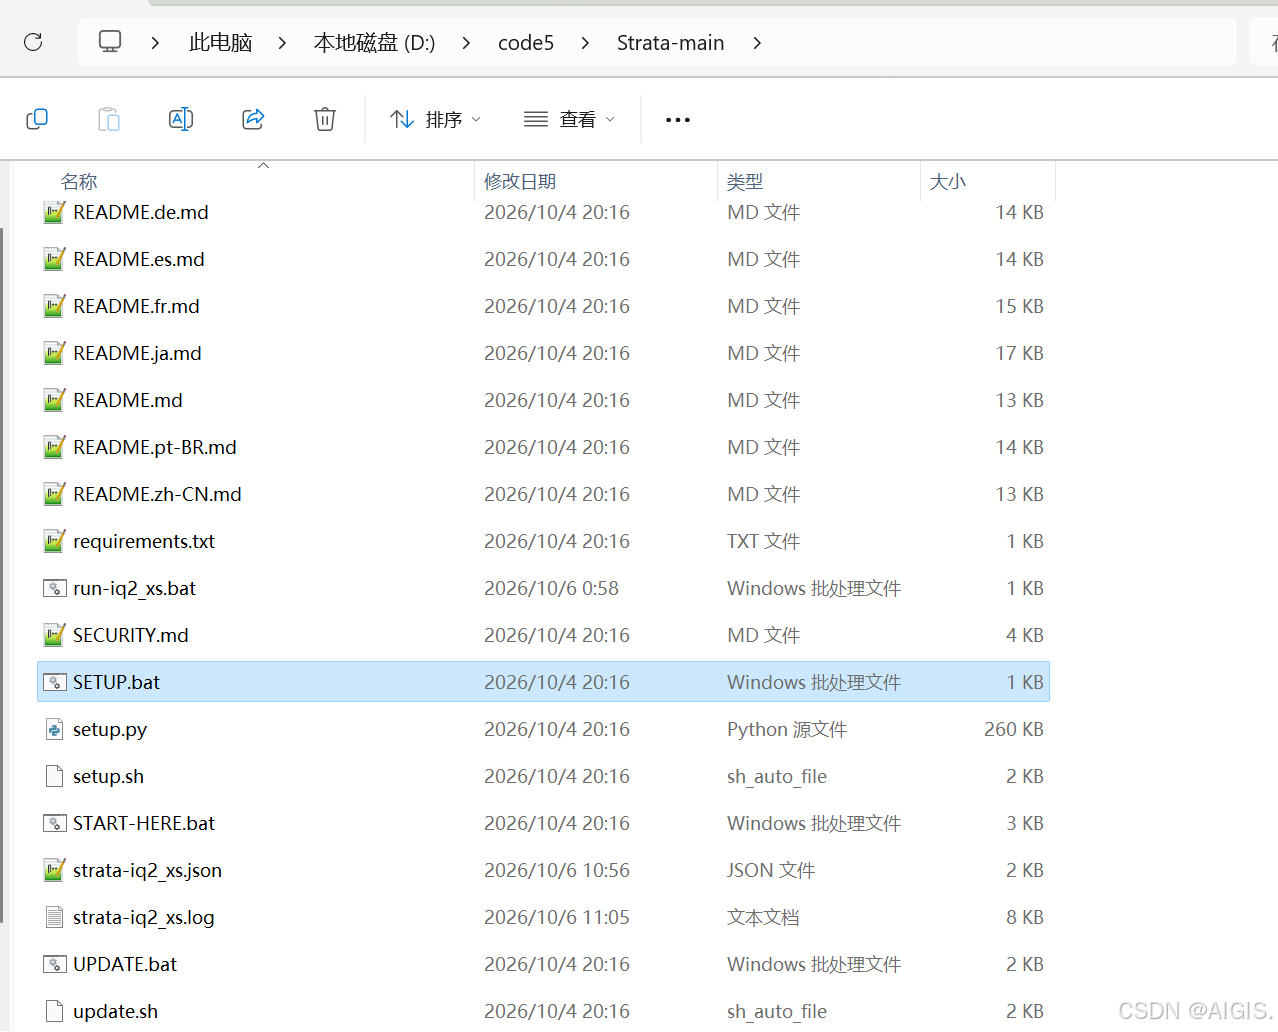
安装时只需先把项目克隆到本地,然后双击 SETUP.bat(本质上会调用 START-HERE.bat),程序就会自动一步步往下执行。不过这种方式会比较慢,具体原因见下文。
注意点 1:模型下载太慢
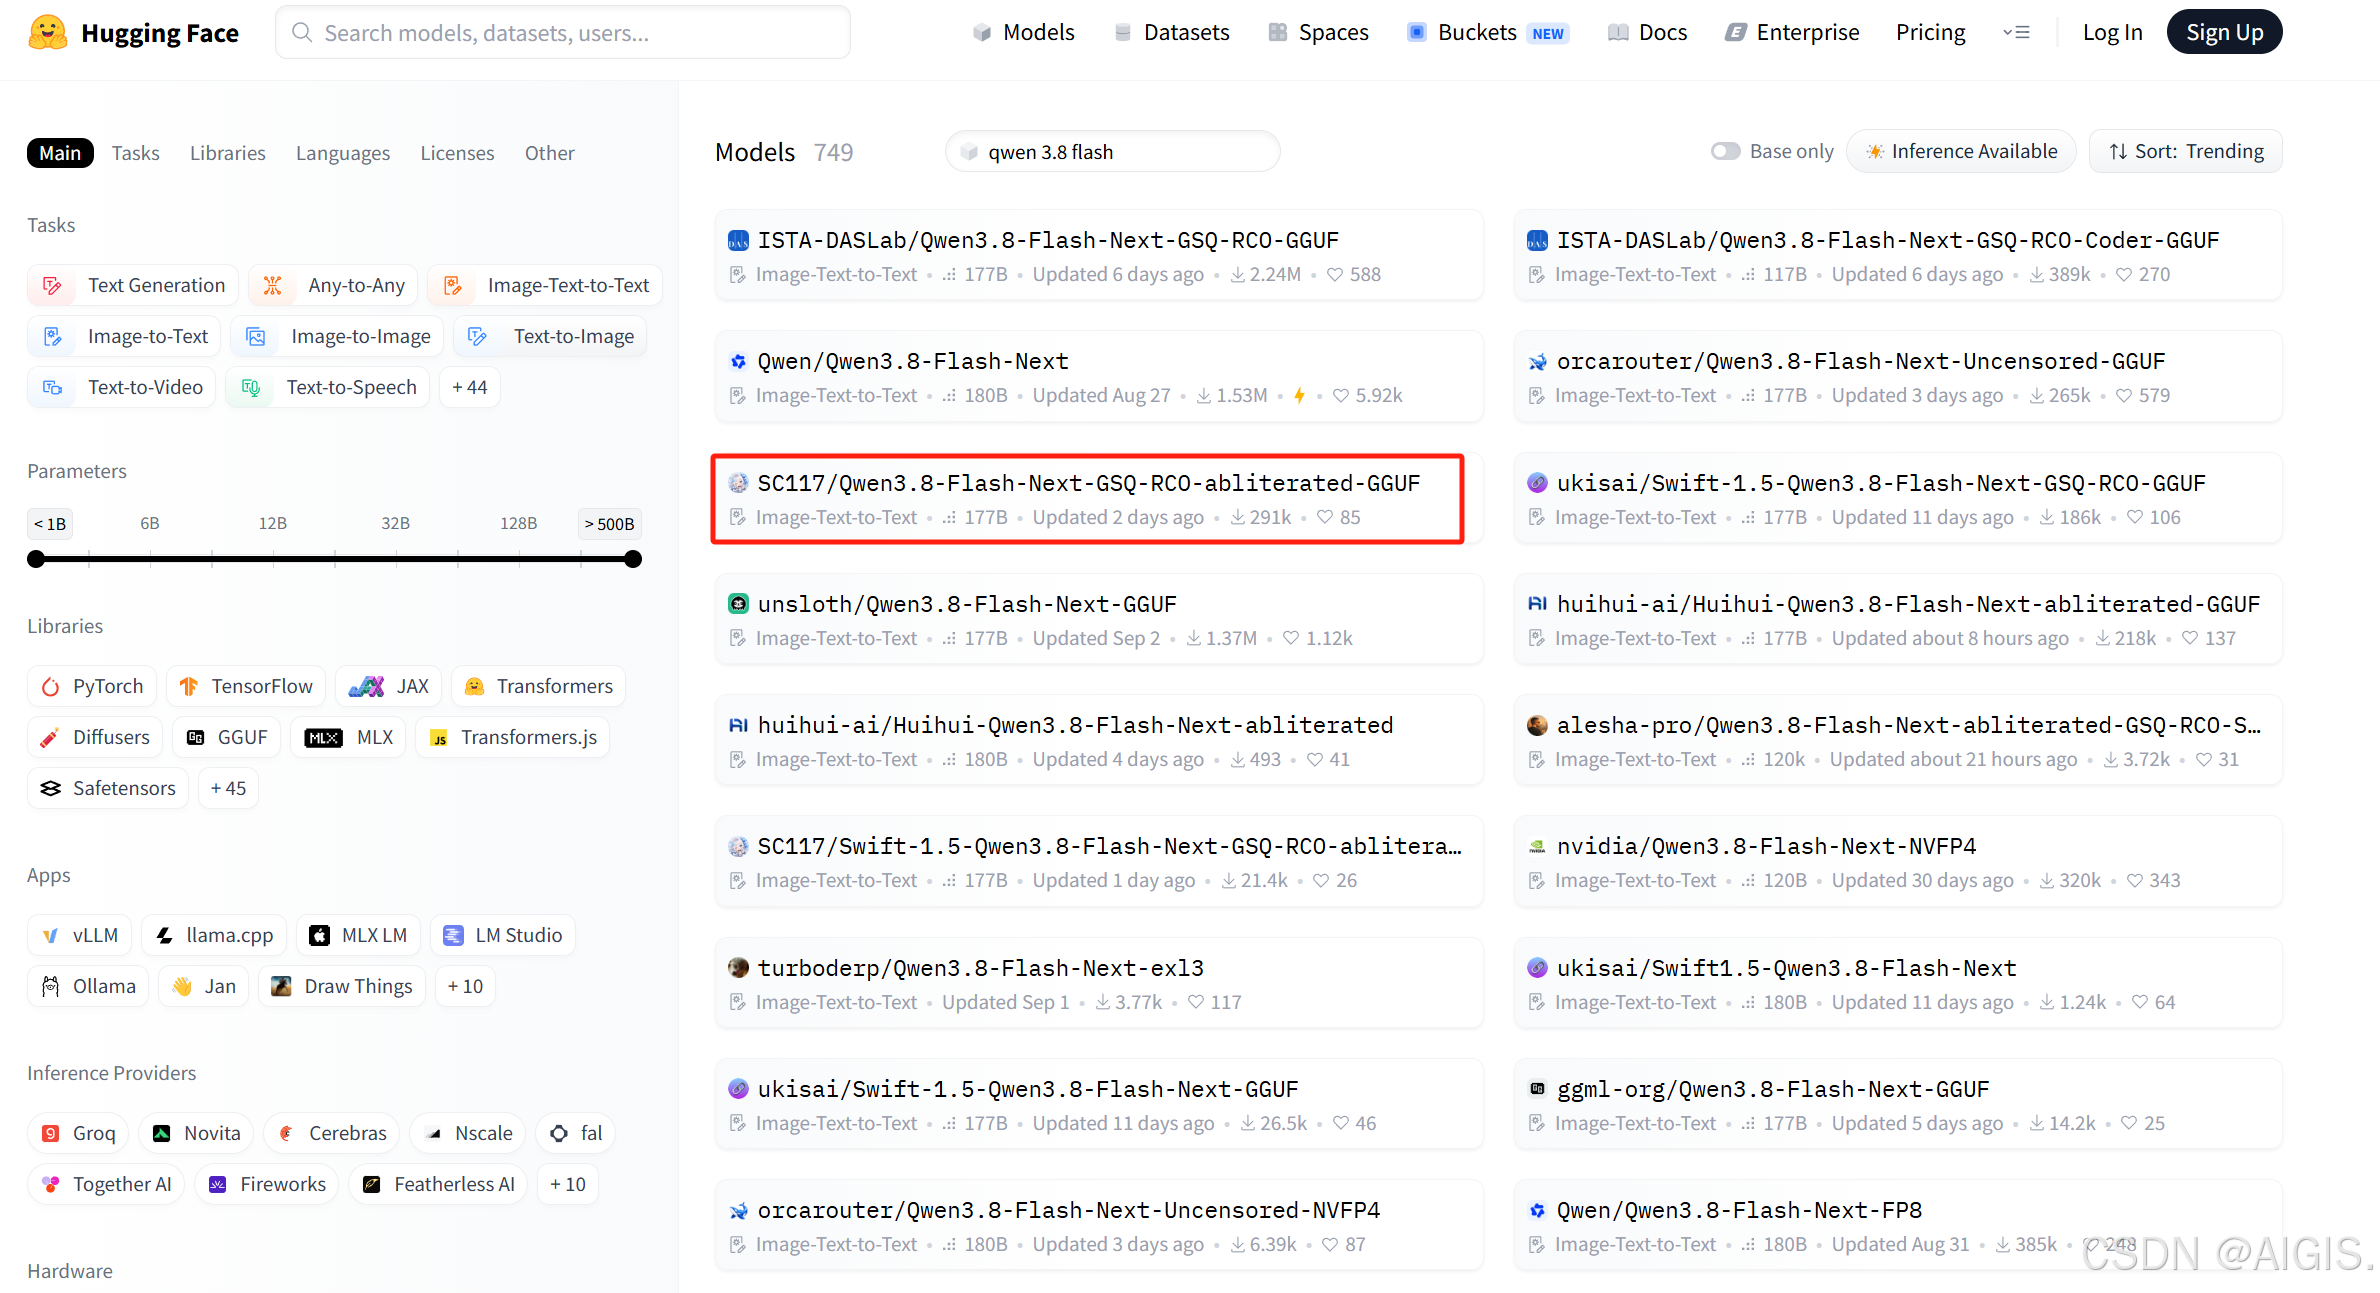
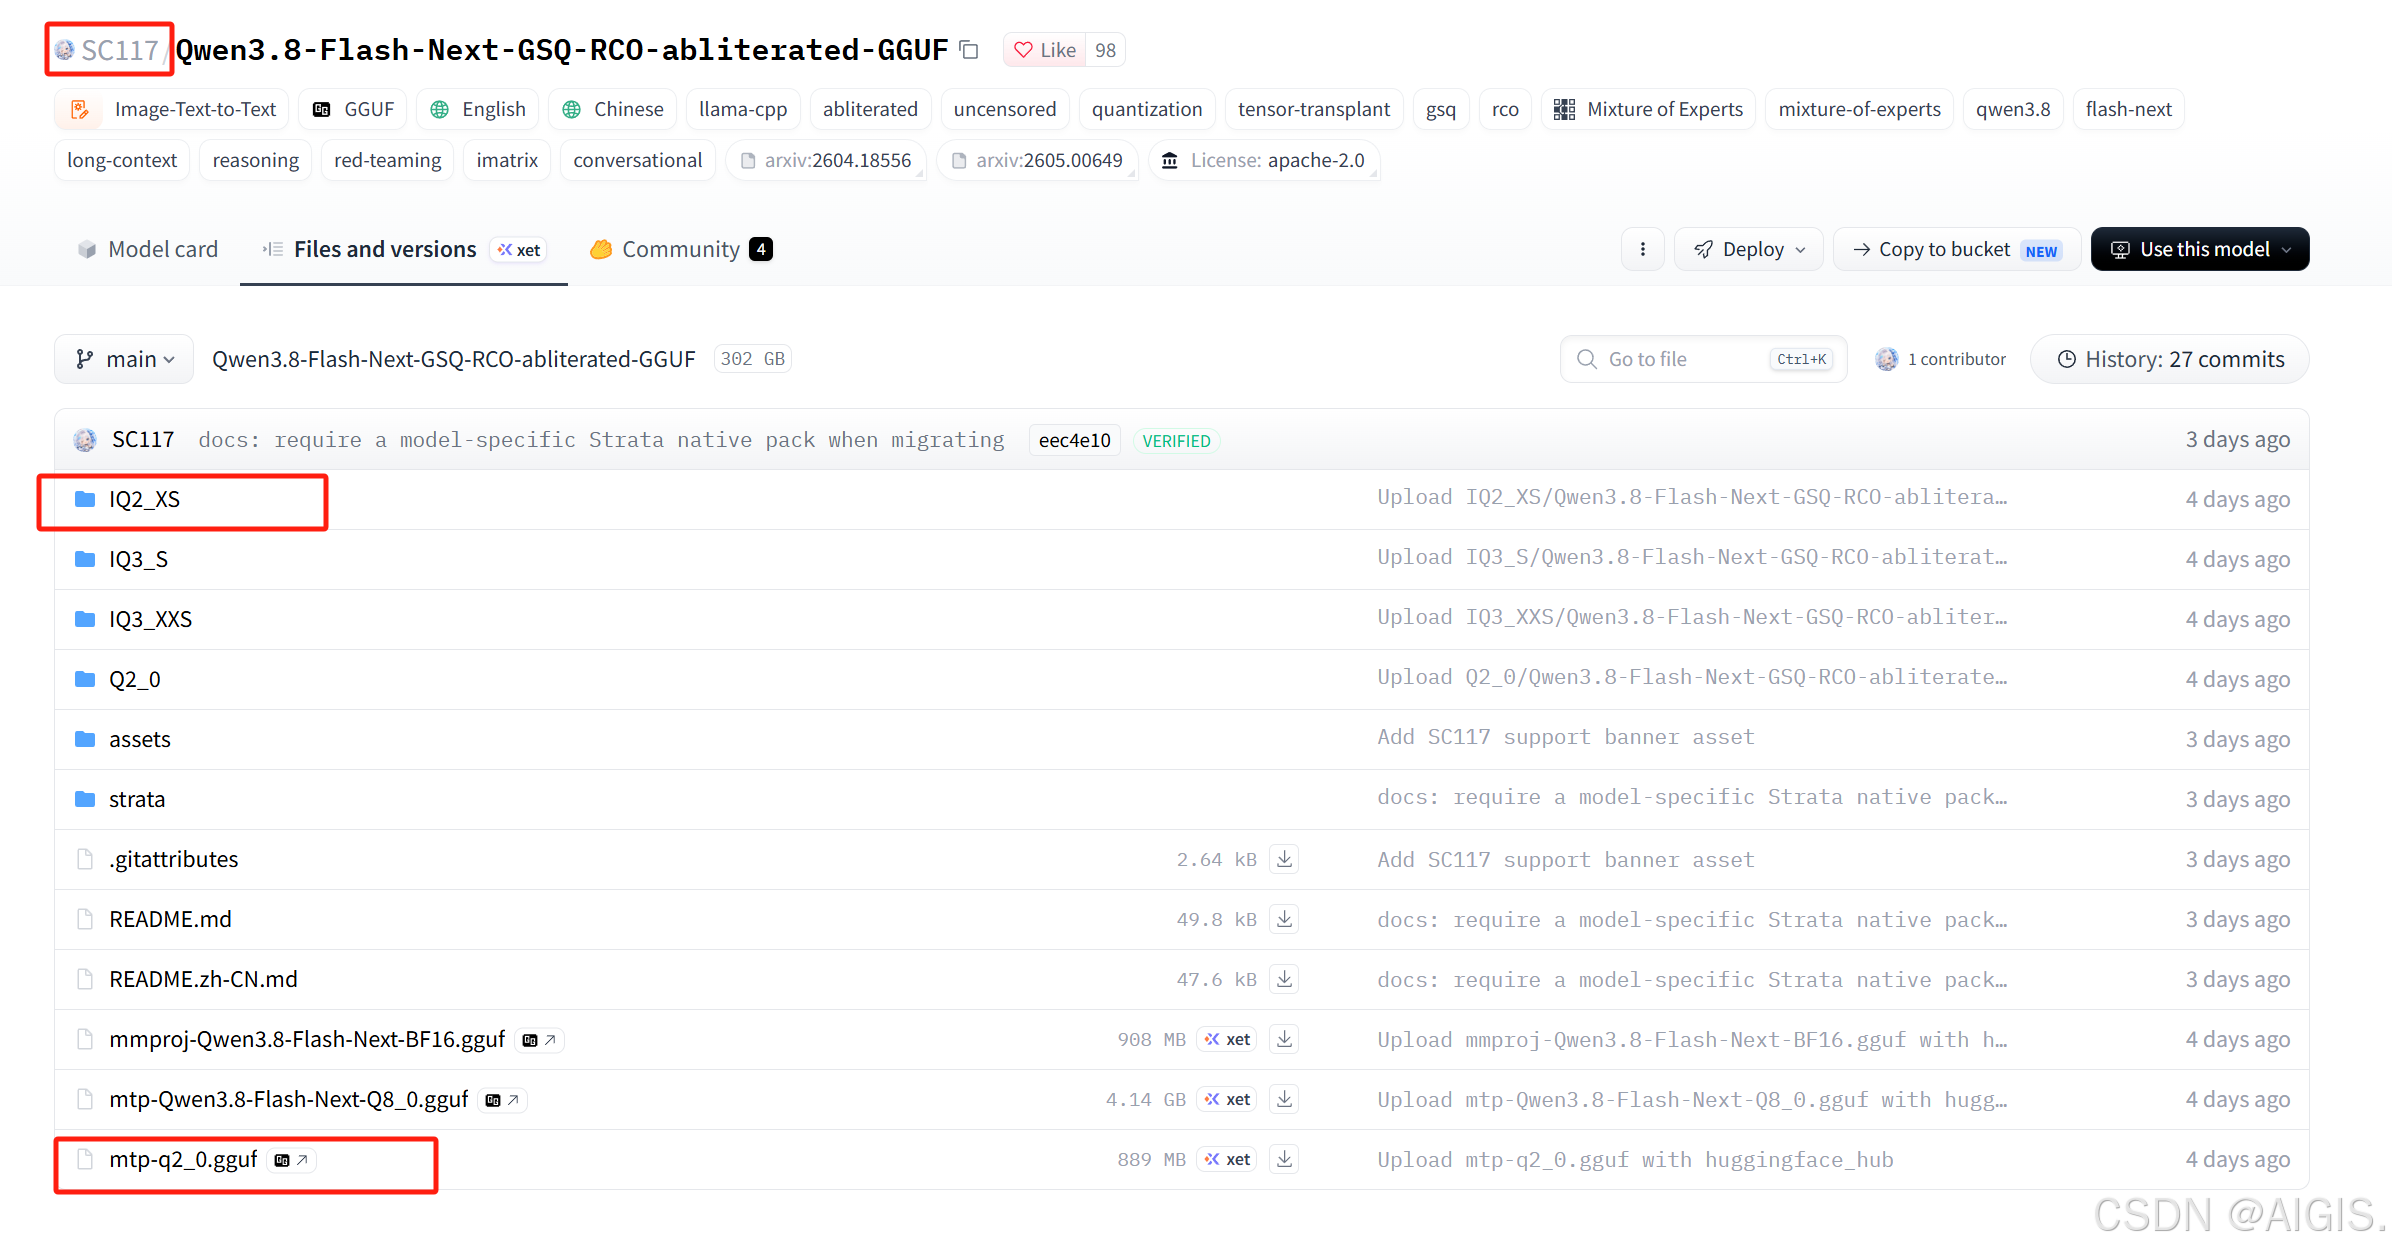
这个项目会自动到 Hugging Face 下载 Qwen3.8 Flash。即使是 Q2 量化版本,也有 70GB 左右,很慢。因此推荐大家自己到 Hugging Face 中国镜像站:
下载会快很多。注意要选 SC117 开头的,只有这里面有 mtp-q2_0.gguf,后面会用到。
注意点 2:Strata 引擎下载太慢
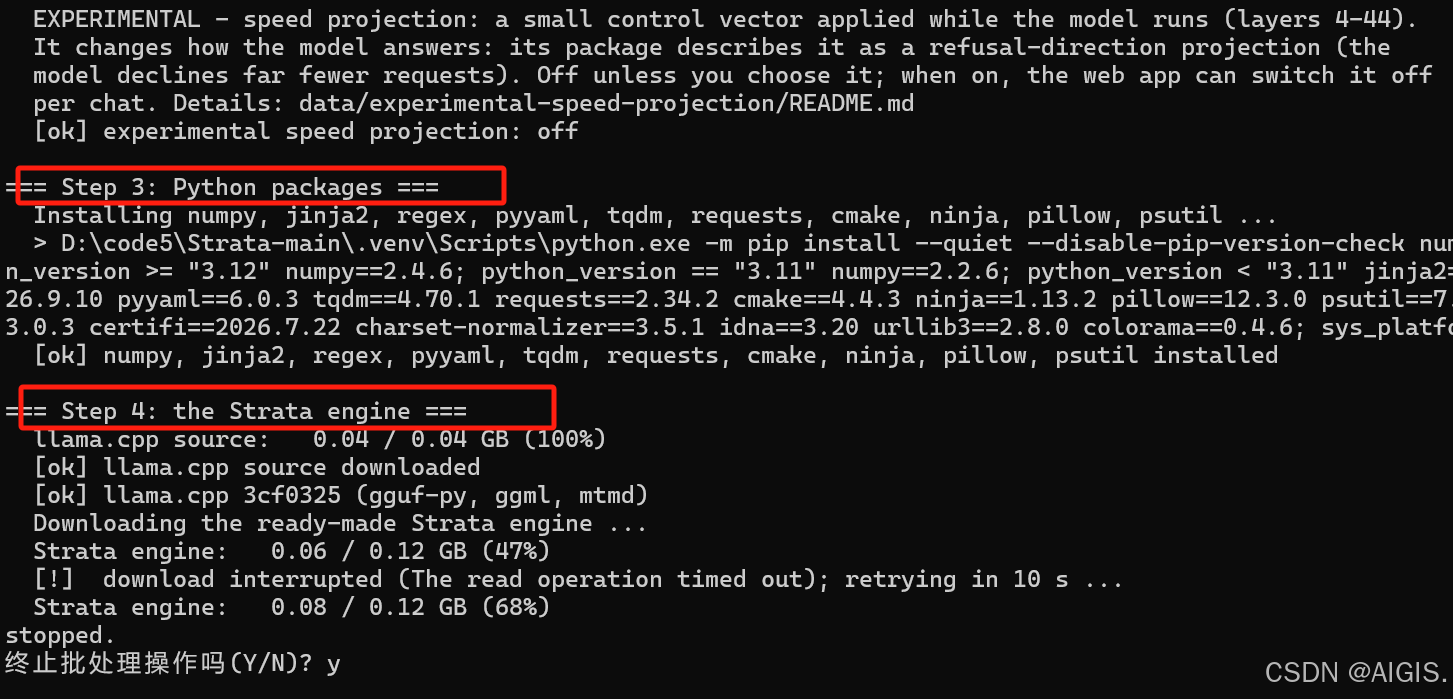
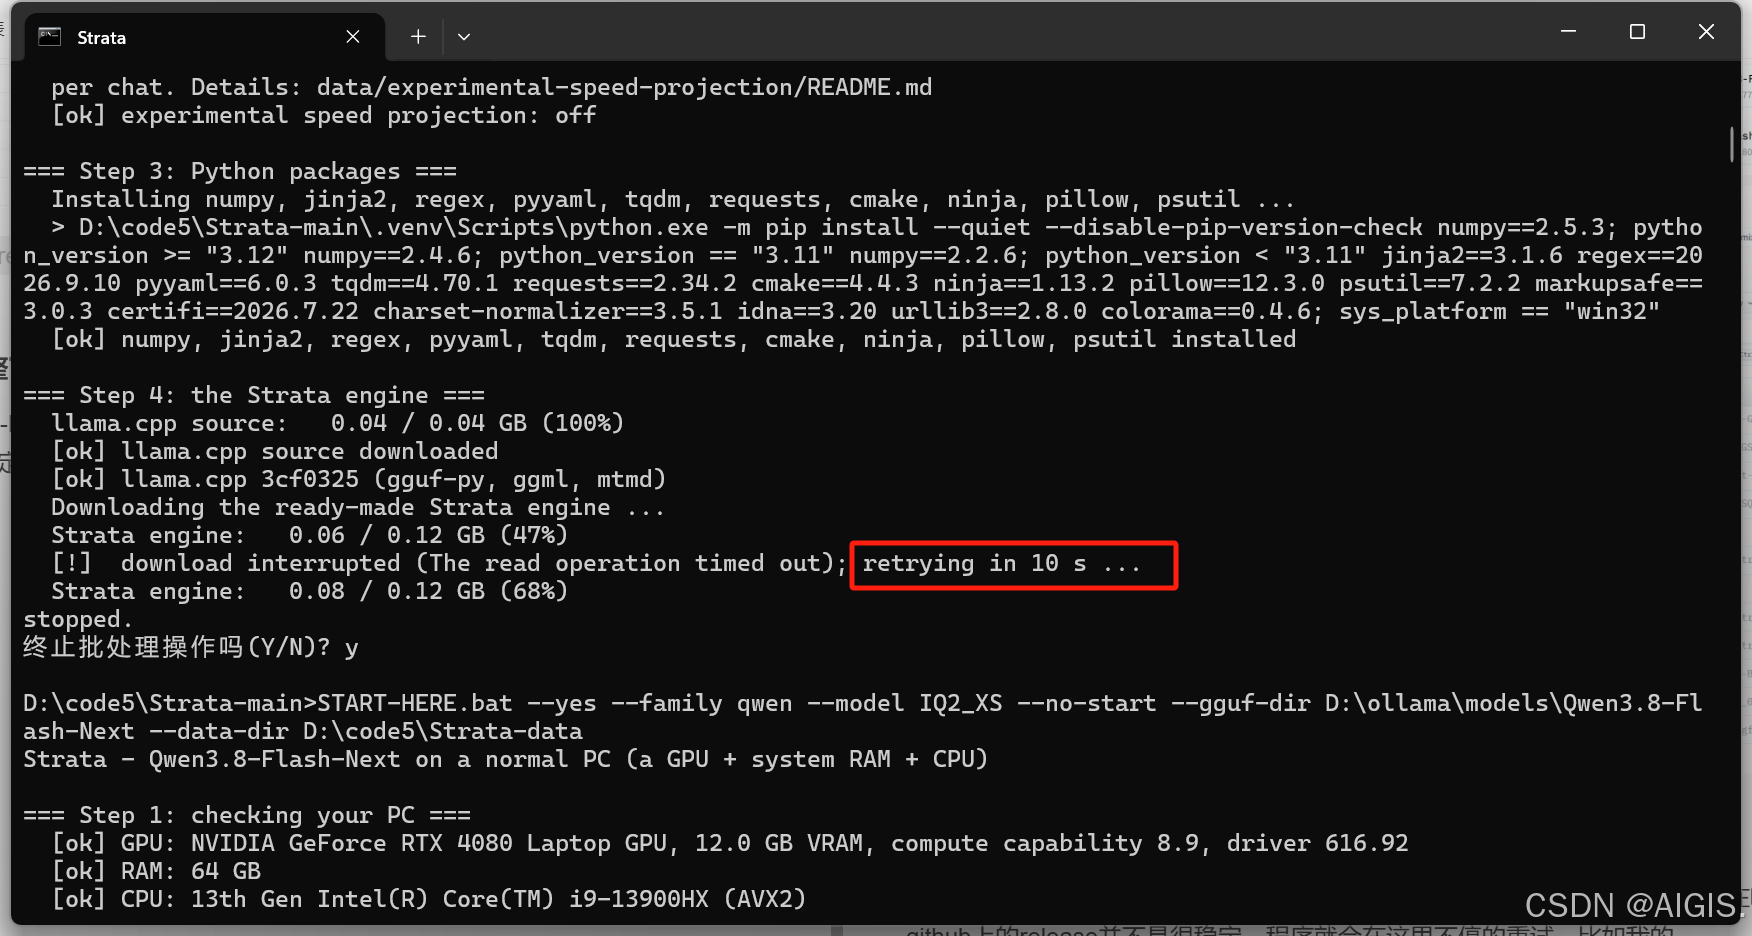
我在这里卡了很久。Start-Here.bat 运行时,并不会在 cmd 窗口中显示正在下载什么。有些电脑访问 GitHub Release 并不稳定,程序就会不停重试。比如我的电脑就反复卡在这个界面,等了十几分钟都没有任何进展,一度以为安装失败了。
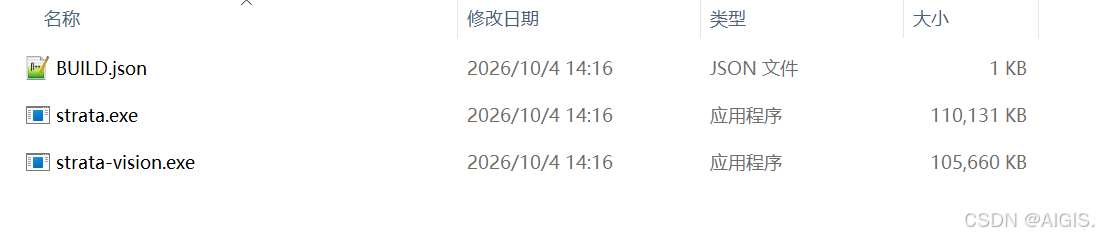
后来我仔细观察任务管理器才发现,它其实是在后台默默下载 Strata 引擎的 release 压缩包,只是没有任何进度提示,看起来就像卡死了一样。而且这个下载过程是串行的,如果网络不稳定,一次失败就要从头重试,非常折磨人。比如我的情况:
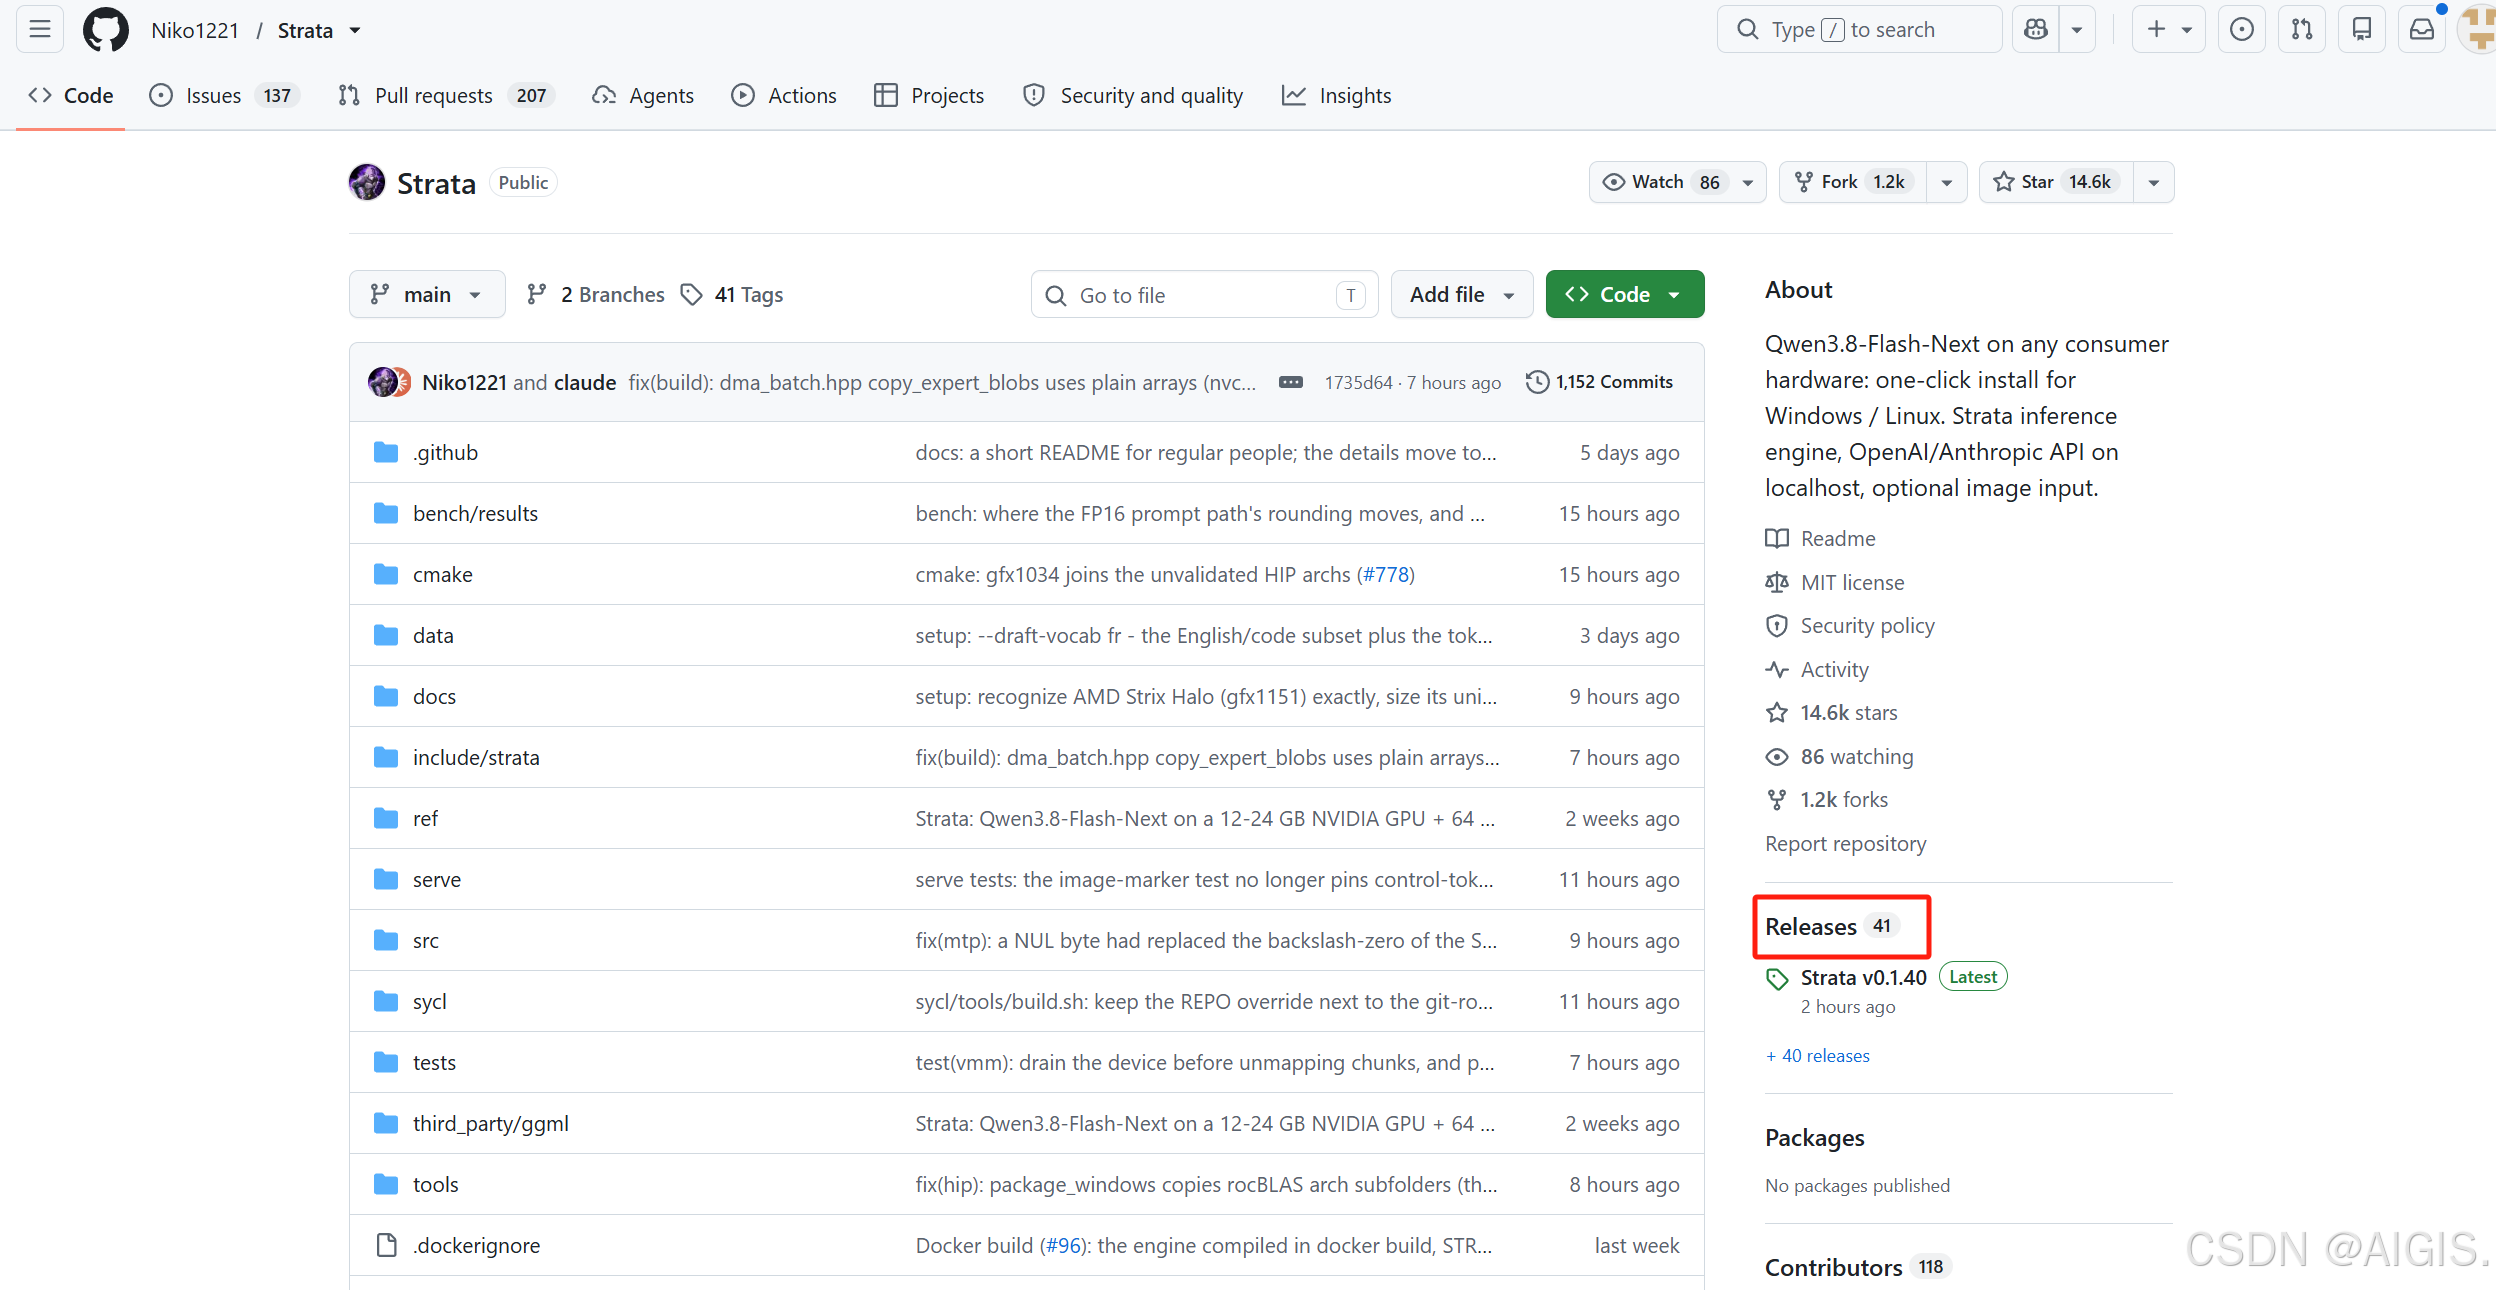
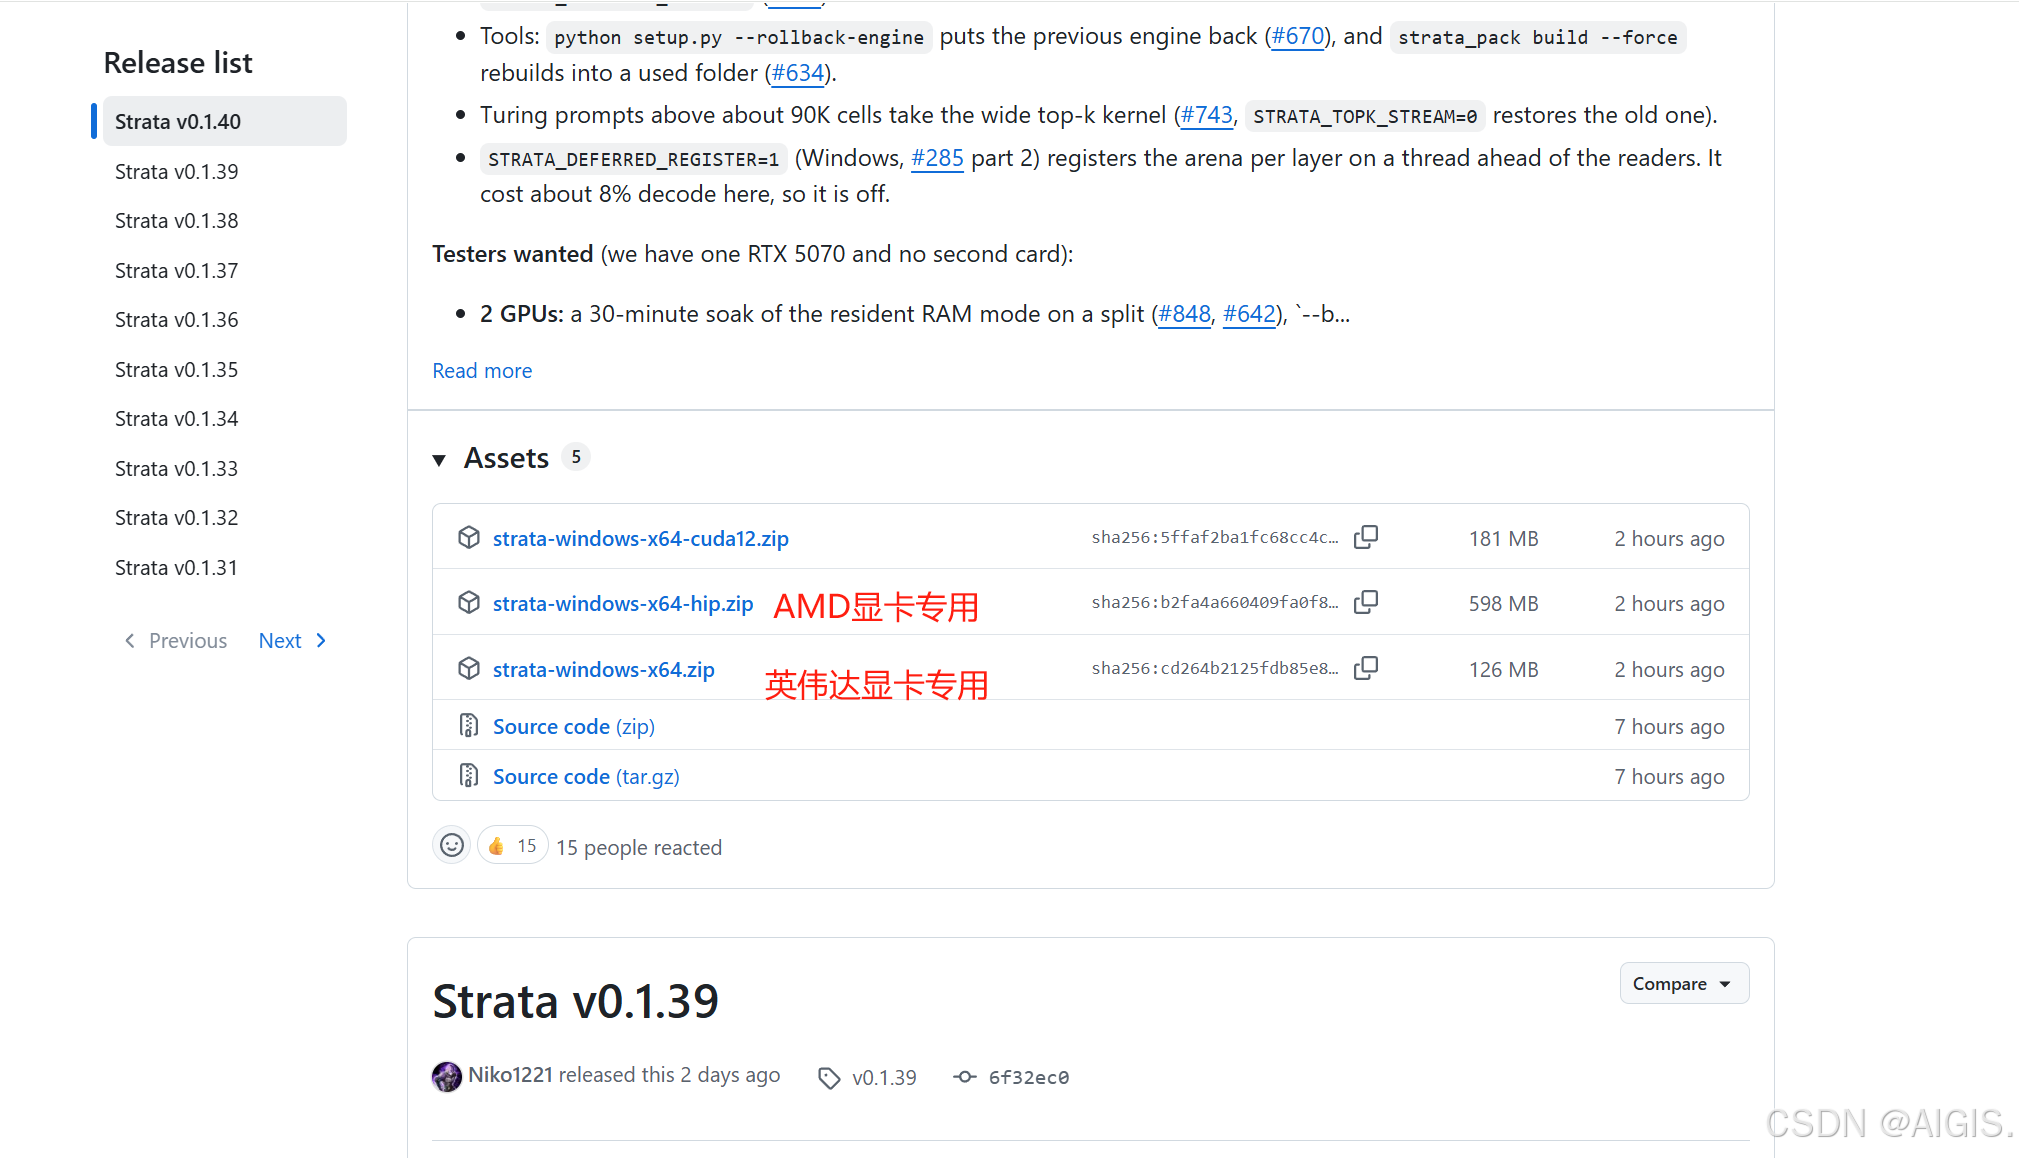
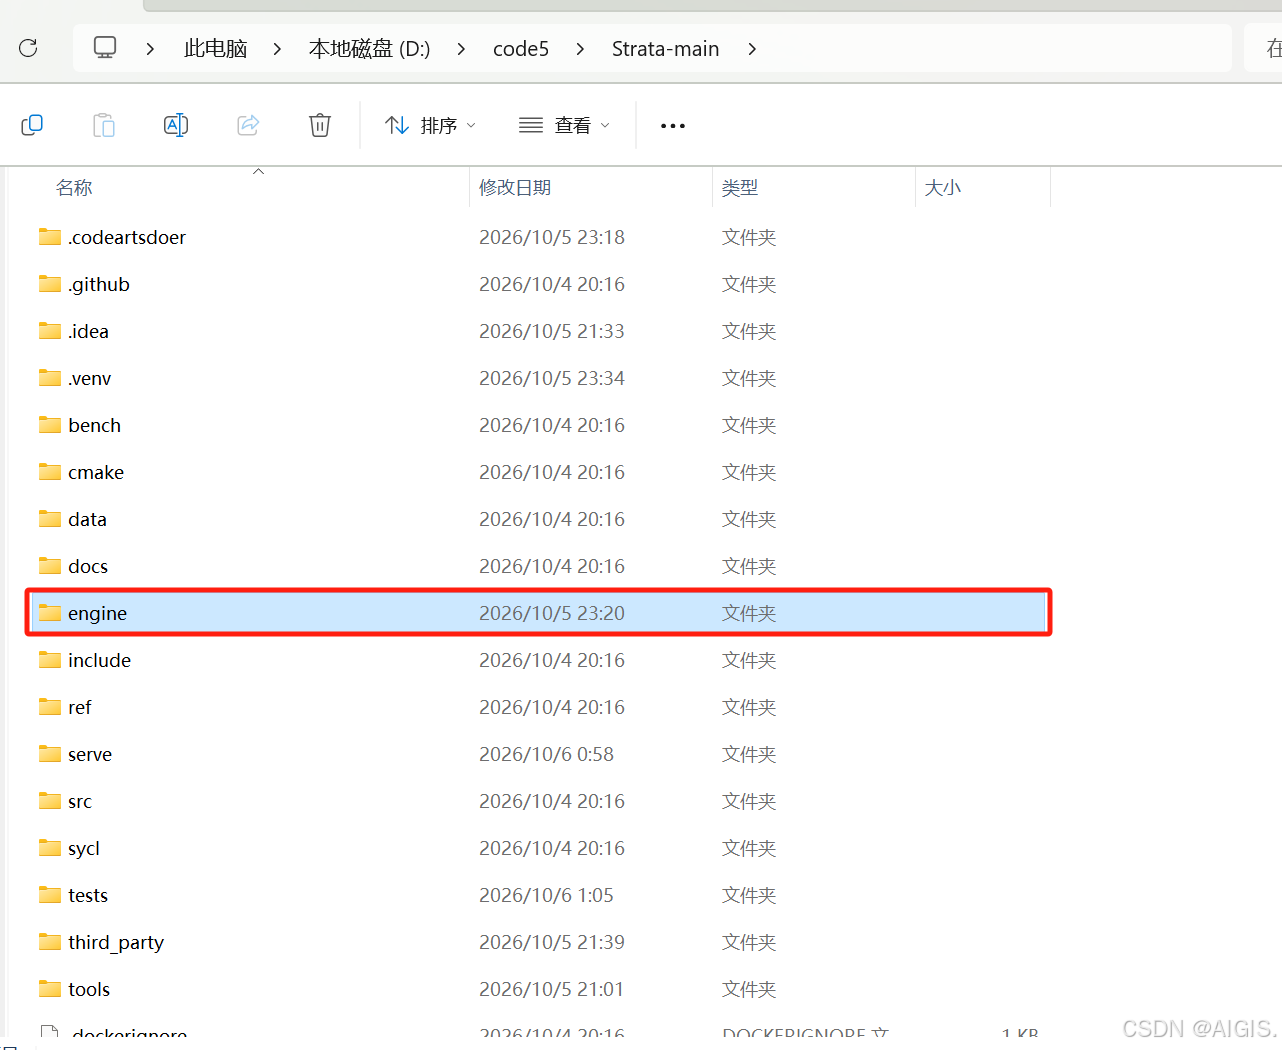
解决办法就是自己去 GitHub Release 页面下载,解压后放到 engine 目录下即可。
注意点 3:如何指定模型路径?
运行 START-HERE.bat 时,可以用 --gguf-dir 指定模型路径。注意一定要把前文下载的几个文件都放到同一个文件夹下。
bat
D:\code5\Strata-main>START-HERE.bat --yes --family qwen --model IQ2_XS --no-start --gguf-dir D:\ollama\models\Qwen3.8-Flash-Next --data-dir D:\code5\Strata-data| 参数 | 含义 | 作用与说明 |
|---|---|---|
START-HERE.bat |
Windows 启动入口脚本 | 内部调用 setup.py,负责检查硬件、创建 .venv、安装依赖、准备模型、生成启动脚本 |
--yes |
自动确认 | 对所有交互提问自动选择推荐值,不再弹出确认,适合自动化或不想手动选择 |
--family qwen |
指定模型家族 | 使用 Qwen3.8-Flash-Next 原版。其他可选:swift、coder、unsloth |
--model IQ2_XS |
指定量化规格 | 告诉 setup 要运行 IQ2_XS。这是固定选项,不是文件名;若使用 IQ3_S,替换为对应值即可 |
--no-start |
安装后不启动 | 只完成安装和配置,不自动启动服务。方便先查看生成的 run-xxx.bat,再手动启动 |
--gguf-dir D:\ollama\models\Qwen3.8-Flash-Next |
已有 GGUF 模型目录 | 让 setup 从这个目录读取已经下载好的 IQ2_XS 分片文件,避免重新下载 |
--data-dir D:\code5\Strata-data |
Strata 数据目录 | 存放模型包、MTP 文件、专家缓存、JSON 配置和日志等 |
注意点 4:安装 nvidia-cublas 和 nvidia-cuda-runtime 很慢
第四步安装 Strata 引擎时,我卡在这两个包很久。原本的命令是:
bat
D:\code5\Strata-main\.venv\Scripts\python.exe -m pip install --quiet --disable-pip-version-check nvidia-cublas==13.0.2.14 nvidia-cuda-runtime==13.0.96可以按 Ctrl+C 停掉,然后自己用 uv 安装,很快。命令是在前面加上 uv 即可:
bat
cd /d D:\code5\Strata-main
.venv\Scripts\activate
uv pip install --quiet --disable-pip-version-check nvidia-cublas==13.0.2.14 nvidia-cuda-runtime==13.0.96
注意点 5:如何指定上下文大小和端口?
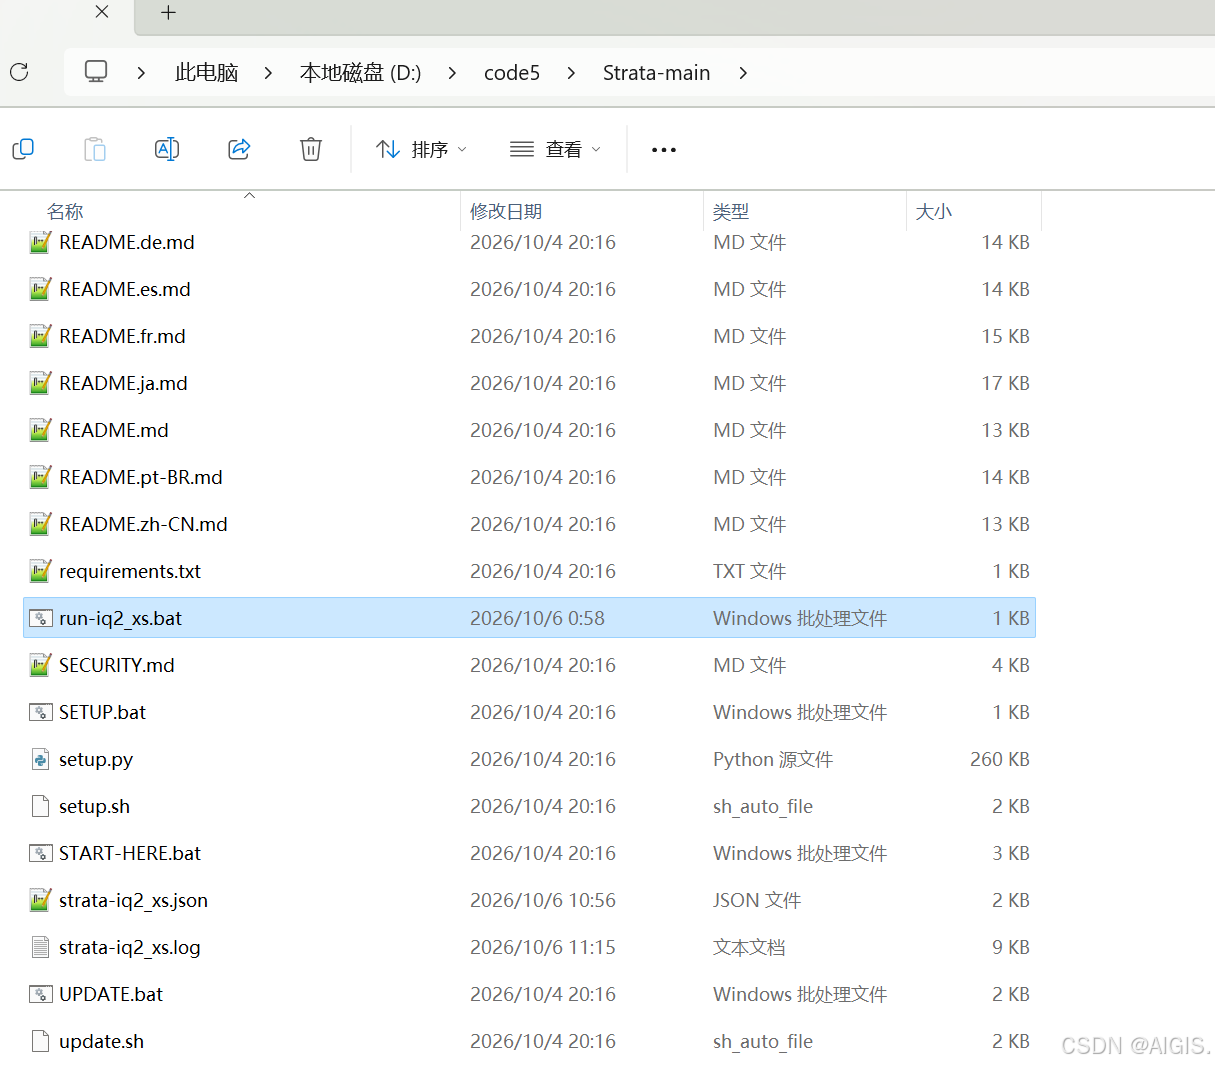
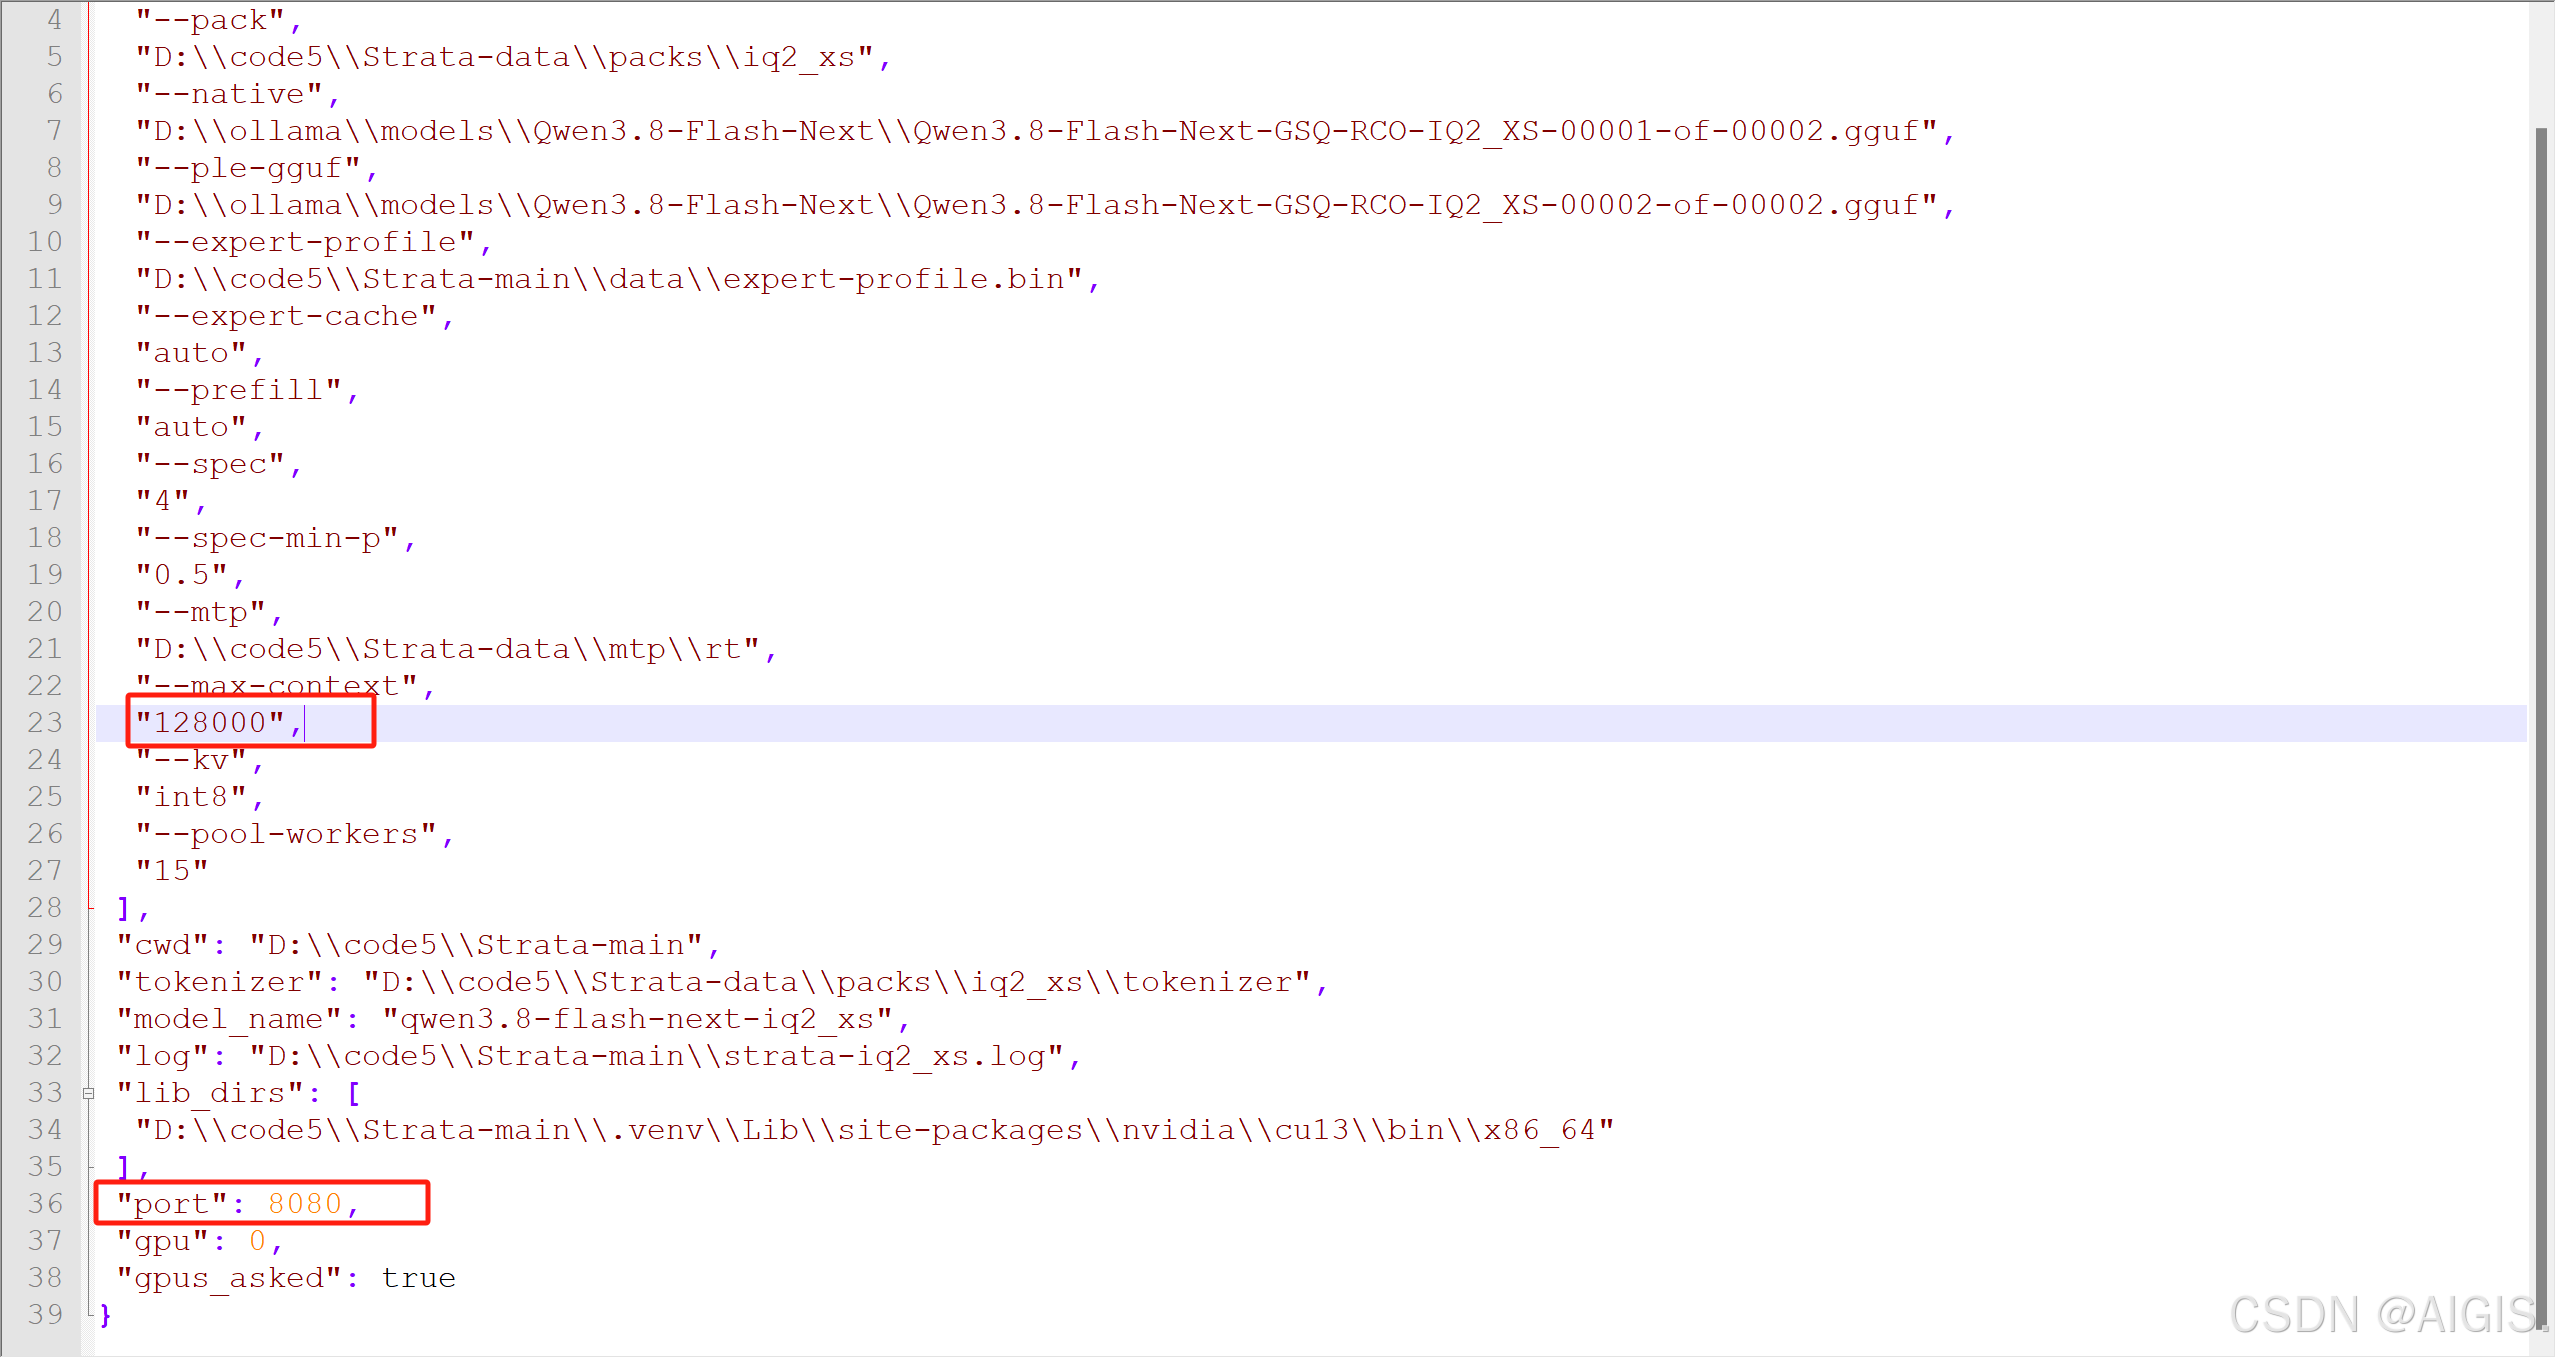
安装完后,会在目录下生成一个 run xxx.bat,xxx 就是你选择的量化版本。以后执行它就会直接启动模型。
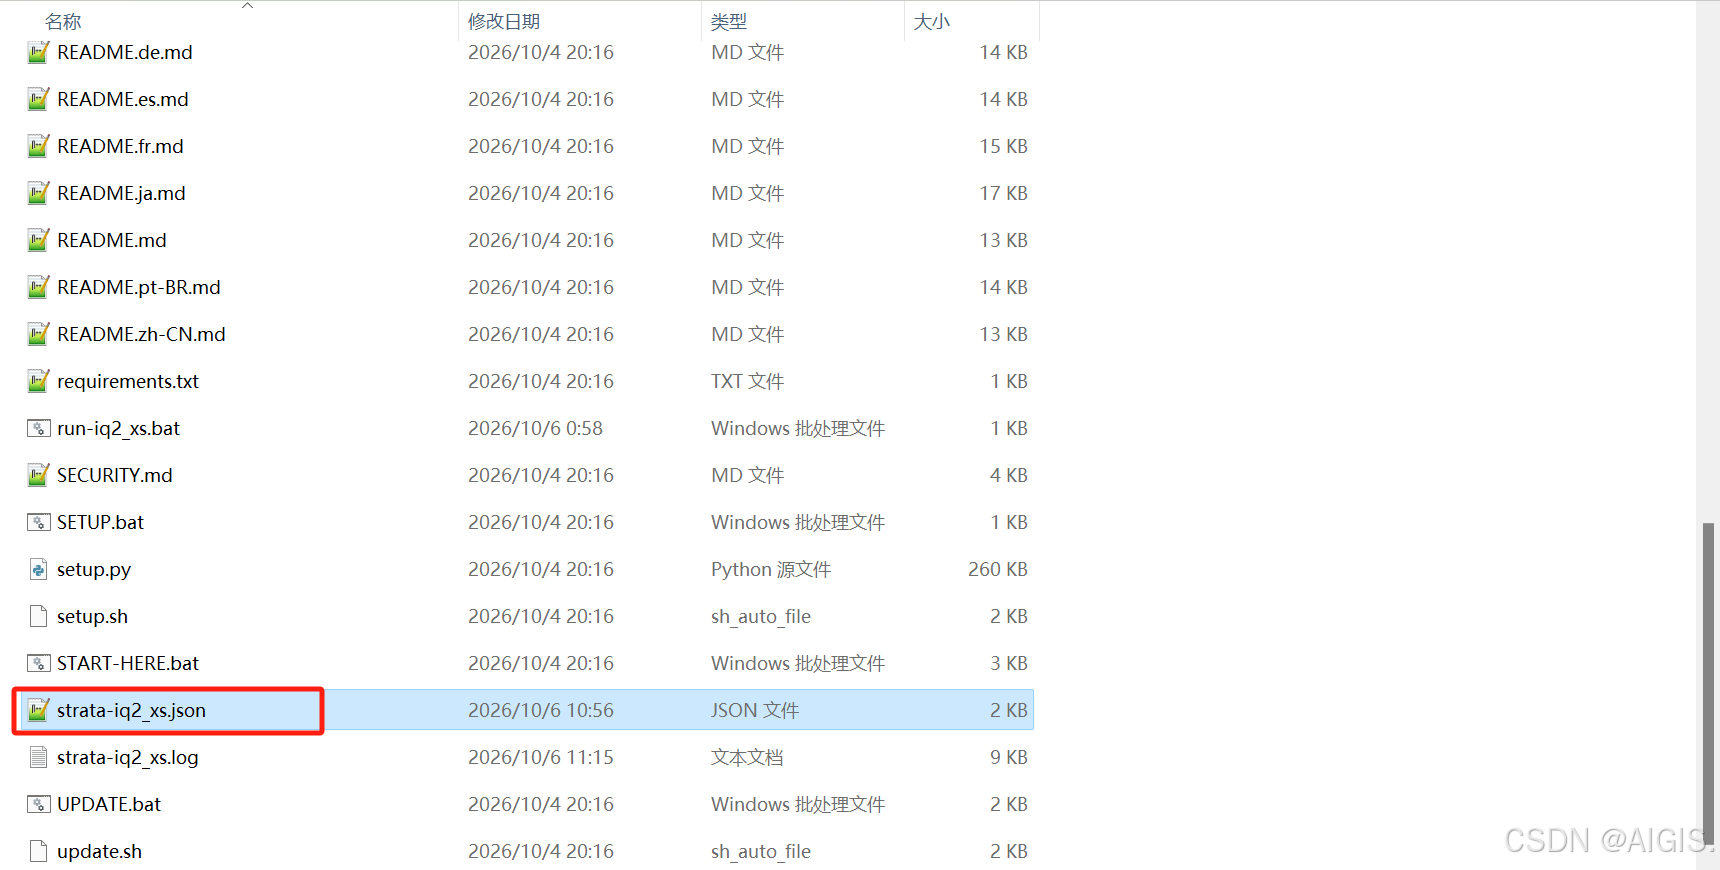
修改上下文大小和端口,需要修改 strata-xxx.json 文件。
注意点 6:如何指定推理强度?
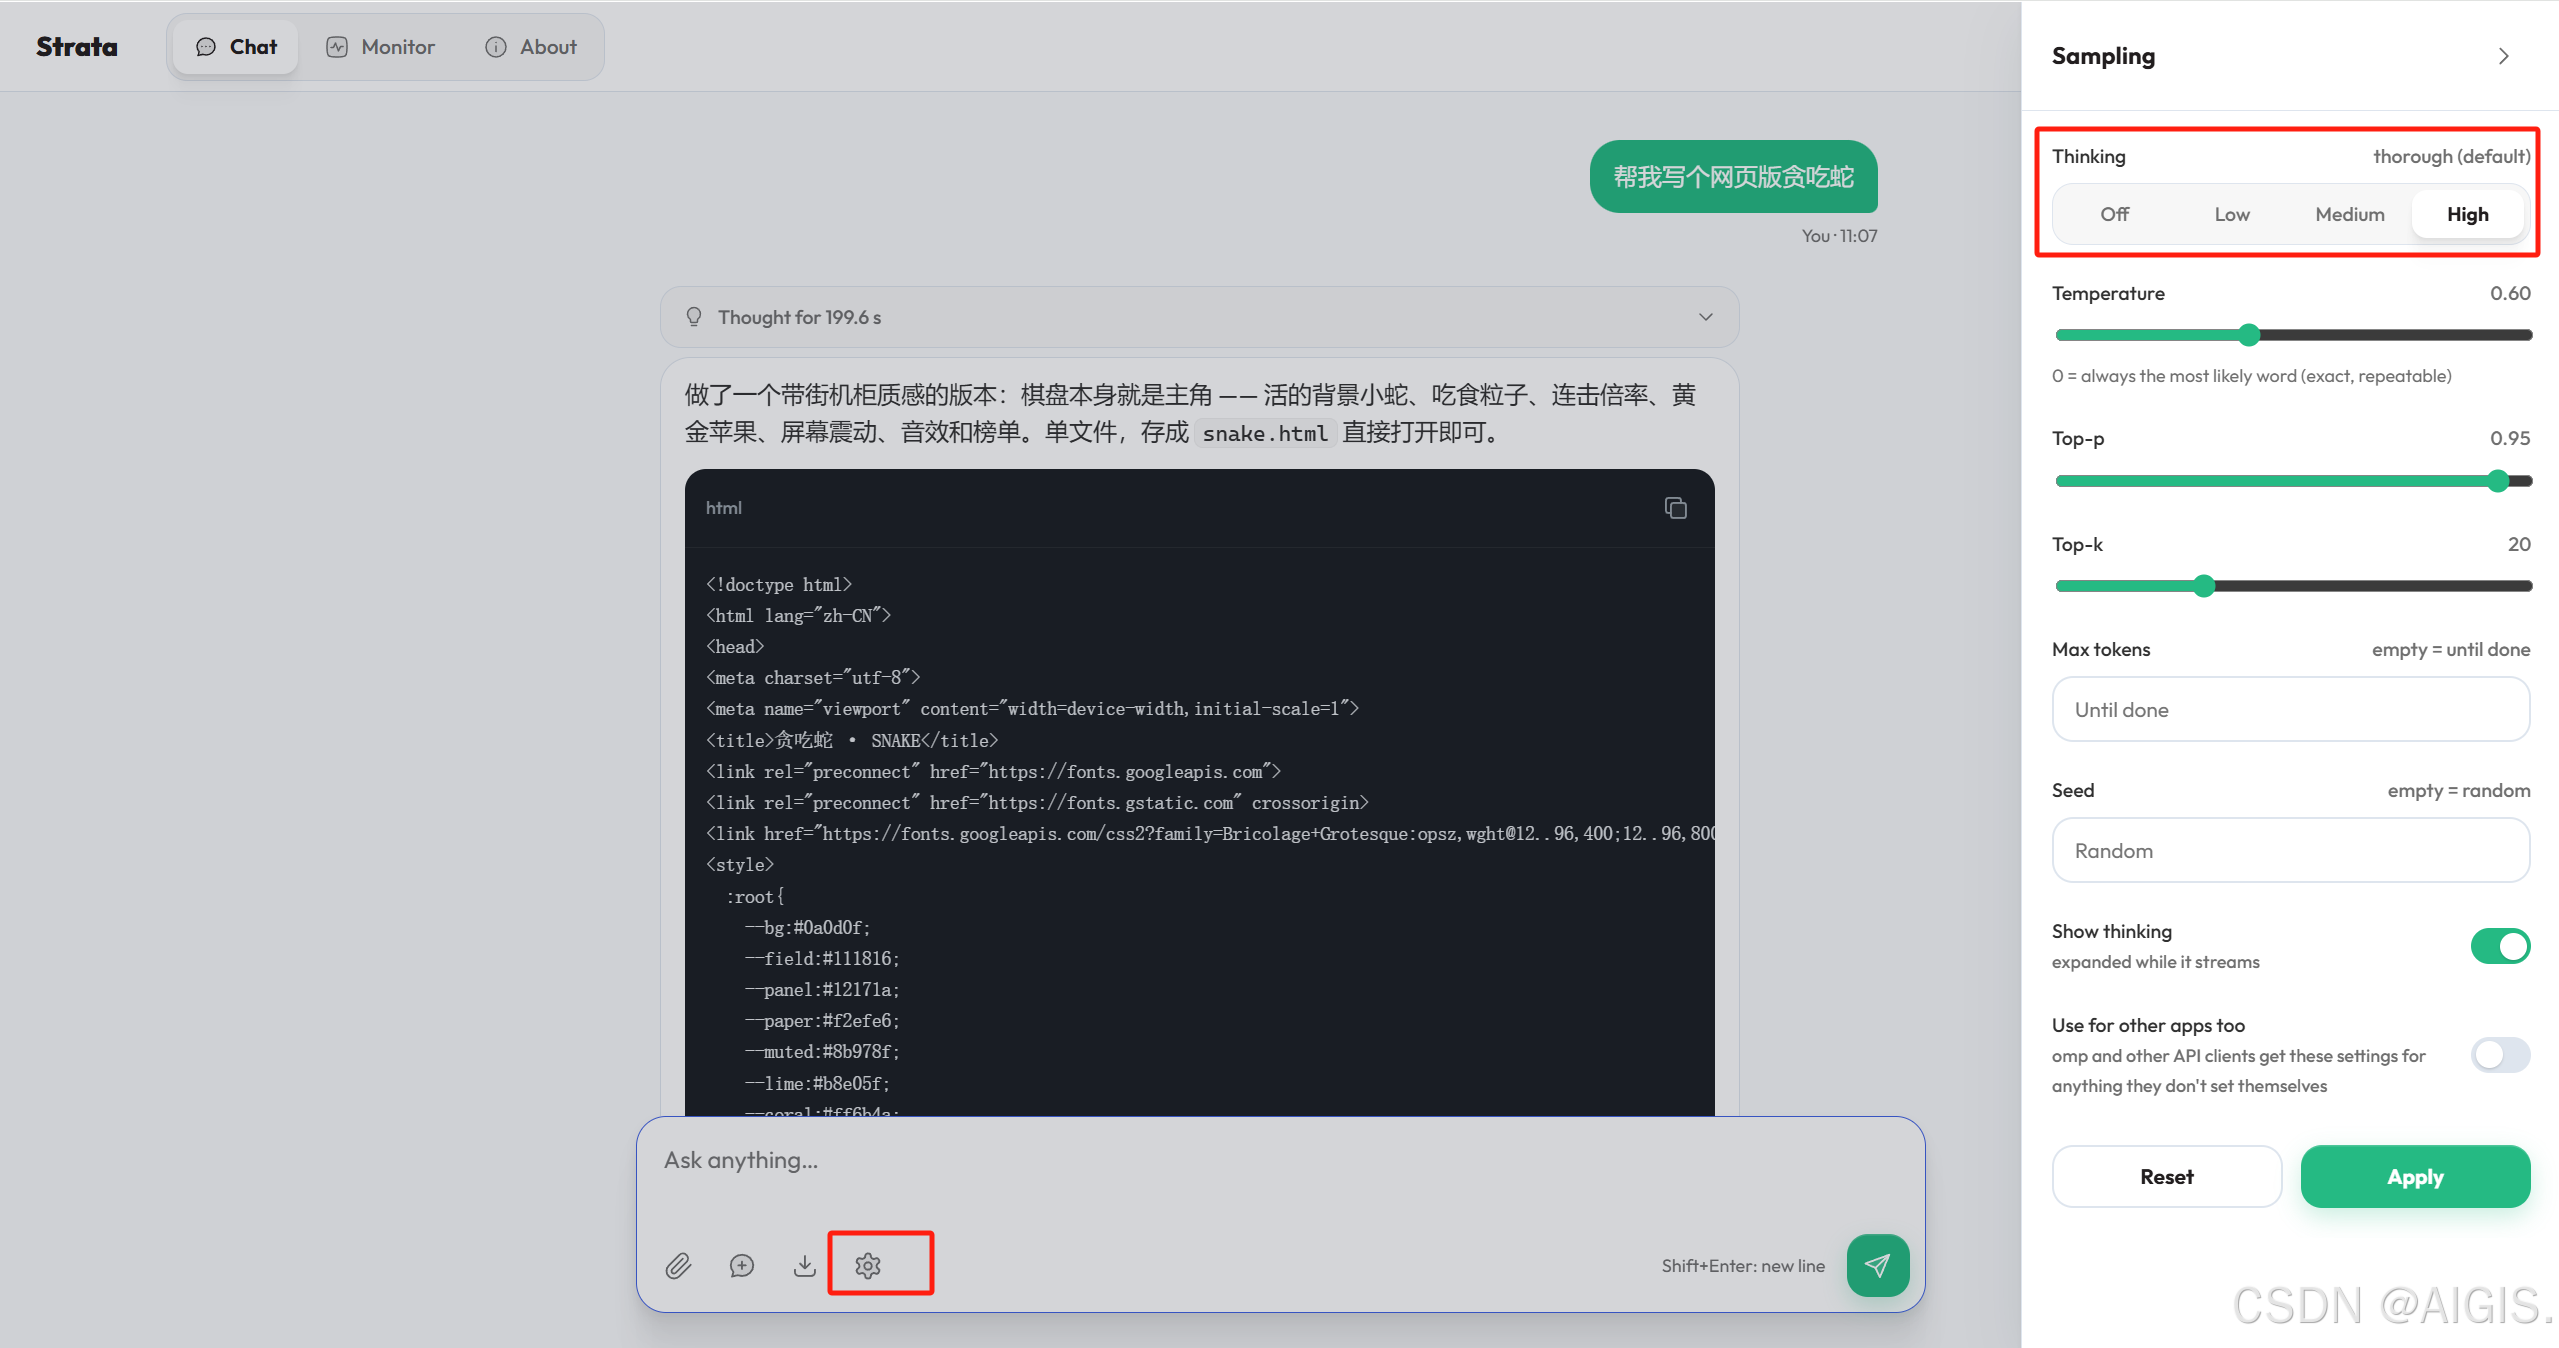
浏览器输入:
点击齿轮进行修改。
3.结语
AI 发展太快了,现在居然能在本地跑 125B 的模型,以前根本不敢想。因为我们使用的是 Qwen3.8-Flash-Next Q2 或 Q3 量化版本,根据作者测试,深度思考模式下的输出质量要比浅层思考模式好很多,当然也更费时间。
现在 token 的问题解决了,于是又回到之前谈过的话题:AI 时代拼的是创意。谁的创意好,谁就能做出好东西。希望大家都能抓住这一波风口,回见~