📚 本文收录于「流浪」的系列专栏
| 🐧 Linux系统 | ⚙️ C++ |
| 📊 数据结构与算法 | 🐍 Python |
| 🔗 LangChain & LangGraph | 🗄️ MySQL 数据库 |
| 🌿 Git 工具 | 🌐 计算机网络 |
| 🤖 AI | 💯 大厂面试、八股 |
| 📚 学习筑基专栏 |
🏠 博客主页:流浪 | 📝 原创首发于 CSDN
前言: 线程(八)把 ticket 减到负数的全过程拆完,病根落在两条缝隙上------一次减减的三步之间、判断与修改之间。 药只有一味:让同一时刻只许一个线程进那段代码。本篇讲的就是这味药,
互斥锁:三种初始化与加锁接口的用法、锁的本质、以及申请锁为什么必须是原子的。
一、临界资源与临界区,用锁划出这条线
1.1 两个名词先立住
1. 临界资源
- 被多个执行流共享、一次只允许一个执行流修改的资源,叫临界资源
- 篇38 拆过私有和共享的清单:
- 共享的:地址空间、全局变量、堆、文件描述符表
- 私有的:一组寄存器、栈、errno
- 抢票里的 ticket、本篇要保护的共享数据,都是临界资源
2. 临界区
- 访问临界资源的那段代码,叫临界区
- 资源和代码是两回事:
- 资源在内存里,等着被改
- 代码是要跑的指令,改资源的是它
- 保护资源这件事没法直接对内存做,只能落在代码上
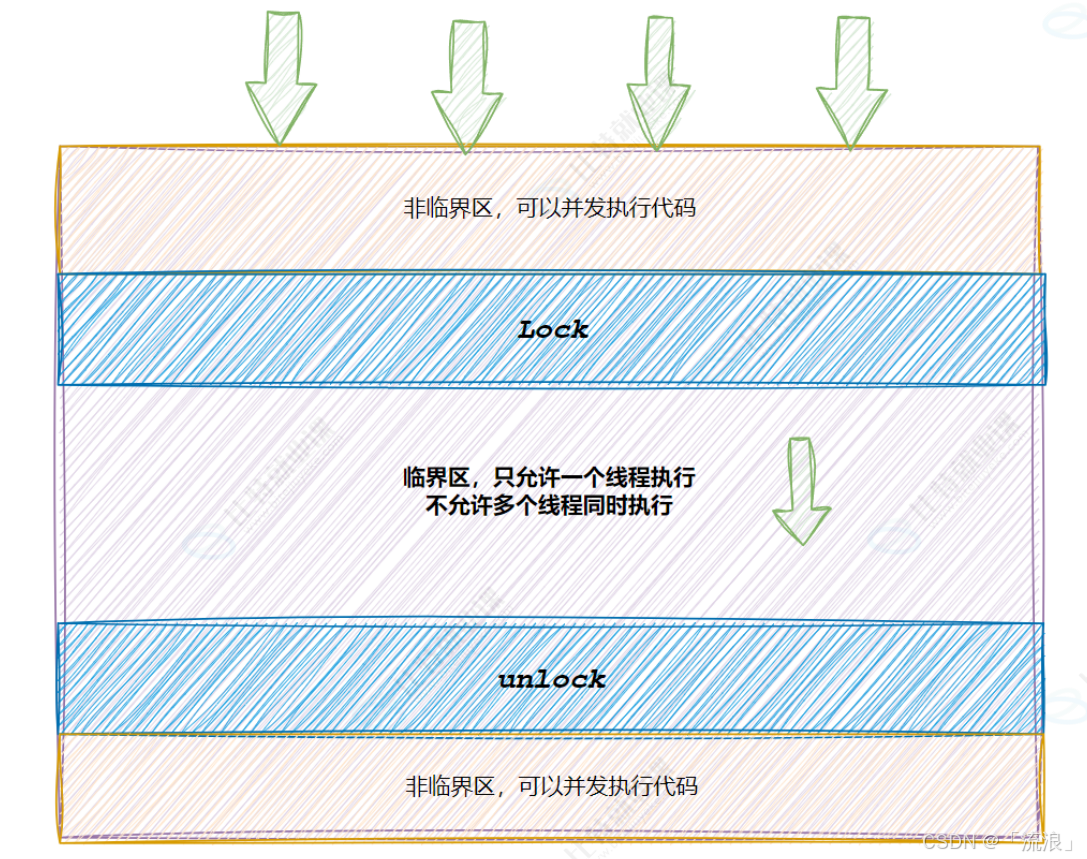
1.2 用锁来划分临界区和非临界区
1. 锁是分界线
- 加锁和解锁之间的那段,就是临界区
- 锁外面的代码,谁跑都不碍着谁,是非临界区
2. 保护的本质落在代码上
对临界资源进行保护,本质就是用锁把临界区这段代码保护起来。资源本身没有"门",是代码给它装了一道。
1.3 串行的是临界区,不是整个线程
1. 锁把并行换成串行
- 多个执行流竞争同一把锁,抢到的往下走,没抢到的挂起
- 同一时刻只有一个执行流待在临界区里
2. 只有这一小段被串行
- 临界区之外,所有线程照旧并发跑
- 锁住的代码越长,被串行掉的部分越多,并发度掉得越狠
锁的本质不是"让线程排队跑完整个函数",而是把临界区这一段从并行里抠出来、改成串行。
二、互斥锁的两种初始化方式
2.1 全局锁,用宏静态初始化
1. 写法
cpp
pthread_mutex_t mutex = PTHREAD_MUTEX_INITIALIZER; // 定义即初始化,不做错误检查PTHREAD_MUTEX_INITIALIZER是一个宏,写在全局变量(或 static 变量)的定义处- POSIX 手册的口径:效果等同于
pthread_mutex_init()传 NULL 属性,只是不做错误检查 ,初始化后锁处于已初始化且未加锁 状态

2. 用不着手动销毁
- 手册对静态初始化的锁没有强制要求调用
pthread_mutex_destroy(),官方示例里也是只 lock、unlock 就完事 - 这类锁随程序的生命周期走,进程结束、资源一并回收
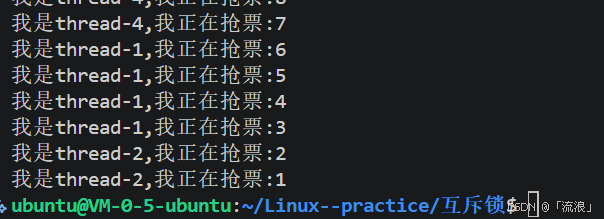
demo
cpp
#include <iostream>
#include <string>
#include <mutex>
#include <pthread.h>
#include <unistd.h>
#include <cstdio>

pthread_mutex_t mutex = PTHREAD_MUTEX_INITIALIZER;
int ticket = 100;
class ThreadData
{
public:
    ThreadData(const std::string &name, pthread_mutex_t *lock)
        : _name(name), _lockp(lock)
    {
    }
    std::string _name;
    pthread_mutex_t *_lockp;
};

void *routine(void *mes)
{
    ThreadData *tmp = static_cast<ThreadData *>(mes);

    while (true)
    {
        pthread_mutex_lock(tmp->_lockp);

        if (ticket > 0)
        {
            usleep(1000);
            printf("我是%s,我正在抢票:%d\n", tmp->_name.c_str(), ticket);
            ticket--;
            pthread_mutex_unlock(tmp->_lockp);
        }

        else
        {
            pthread_mutex_unlock(tmp->_lockp);
            break;
        }
    }
    return nullptr;
}
int main()
{

    pthread_t tid1, tid2, tid3, tid4;

    ThreadData *t1 = new ThreadData("thread-1", &mutex);
    pthread_create(&tid1, nullptr, routine, (void *)t1);

    ThreadData *t2 = new ThreadData("thread-2", &mutex);
    pthread_create(&tid2, nullptr, routine, (void *)t2);

    ThreadData *t3 = new ThreadData("thread-3", &mutex);
    pthread_create(&tid3, nullptr, routine, (void *)t3);

    ThreadData *t4 = new ThreadData("thread-4", &mutex);
    pthread_create(&tid4, nullptr, routine, (void *)t4);

    pthread_join(tid1, nullptr);
    pthread_join(tid2, nullptr);
    pthread_join(tid3, nullptr);
    pthread_join(tid4, nullptr);
    delete t1;
    delete t2;
    delete t3;
    delete t4;
    return 0;
}
2.2 局部锁,init 之后必须 destroy
1. 写法
c
pthread_mutex_t mutex;                  // 局部变量,只有空间、没有初始化
pthread_mutex_init(&mutex, NULL);       // 动态初始化,attr 传 NULL 用默认属性
/* ... 使用 ... */
pthread_mutex_destroy(&mutex); // 用完了手动销毁- 局部锁落在栈上或堆上,编译器不会替你填初值,必须显式 init
- 手册明确:已初始化的锁不能再次 init,会撞上未定义行为------要重新初始化,得先 destroy
2. 销毁的时机有硬约束
- 销毁一个已解锁的锁是安全的
- 销毁仍被锁住的锁、或有别的线程正尝试获取它的锁,属于未定义行为;实现若检测到,建议返回
EBUSY - 判定标准就一句:确保没有任何线程还可能引用它
2.3 一句话记住差别
全局锁由宏静态初始化、不用手动销毁,生命周期跟程序走;局部锁必须 init 初始化、用完 destroy,生命周期自己管。
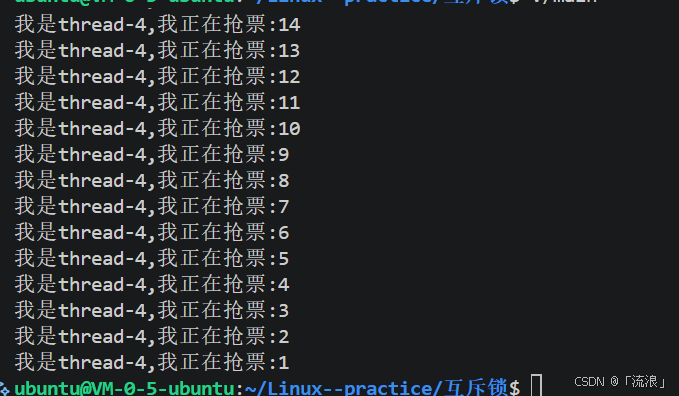
demo简单实现
cpp
#include <iostream>
#include <string>
#include <mutex>
#include <pthread.h>
#include <unistd.h>
#include <cstdio>
int ticket = 100;
class ThreadData
{
public:
    ThreadData(const std::string &name, pthread_mutex_t *lockp)
        : _name(name), _lockp(lockp)
    {
    }
    std::string _name;
    pthread_mutex_t *_lockp;
};

void *routine(void *mes)
{
    ThreadData *tmp = static_cast<ThreadData *>(mes);

    while (true)
    {
        pthread_mutex_lock(tmp->_lockp);
        if (ticket > 0)
        {
            usleep(1000);
            printf("我是%s,我正在抢票:%d\n", tmp->_name.c_str(), ticket);
            ticket--;
            pthread_mutex_unlock(tmp->_lockp);
        }

        else
        {
            pthread_mutex_unlock(tmp->_lockp);
            break;
        }
    }
    return nullptr;
}
int main()
{
    pthread_mutex_t lock;
    pthread_mutex_init(&lock, nullptr);
    pthread_t tid1, tid2, tid3, tid4;

    ThreadData *t1 = new ThreadData("thread-1", &lock);
    pthread_create(&tid1, nullptr, routine, (void *)t1);

    ThreadData *t2 = new ThreadData("thread-2", &lock);
    pthread_create(&tid2, nullptr, routine, (void *)t2);

    ThreadData *t3 = new ThreadData("thread-3", &lock);
    pthread_create(&tid3, nullptr, routine, (void *)t3);

    ThreadData *t4 = new ThreadData("thread-4", &lock);
    pthread_create(&tid4, nullptr, routine, (void *)t4);

    pthread_join(tid1, nullptr);
    pthread_join(tid2, nullptr);
    pthread_join(tid3, nullptr);
    pthread_join(tid4, nullptr);

    pthread_mutex_destroy(&lock);

    delete t1;
    delete t2;
    delete t3;
    delete t4;
    return 0;
}
三、三个加锁接口,阻塞与非阻塞
3.1 pthread_mutex_lock,阻塞版本
1. 两条返回路径
- 成功:返回 0,锁变成锁定状态、调用线程成为它的持有者,继续向后执行、访问临界资源
- 失败 :锁被别的线程占着,调用线程阻塞挂起,直到锁可用
2. 手册里的原文口径
- 若锁已被其他线程锁定,调用线程应当阻塞到锁可用为止
- 信号打断了等待也没关系:从信号处理程序返回后,线程继续等,就像没被打断过
- 这些函数不会返回 EINTR
3.2 pthread_mutex_trylock,非阻塞版本
1. 和 lock 的差别只有一处
- 语义与
pthread_mutex_lock()等价 - 差别在于:锁当前被占用(包括被自己占用)时,立即返回,不挂起
2. 返回值是判据
- 成功返回 0
- 抢不到返回
EBUSY------用返回值决定"转去干点别的"还是"继续重试"
3.3 pthread_mutex_unlock,解锁
1. 解锁做两件事
- 把锁释放掉,归还"可用"状态
- 若有线程阻塞在这把锁上,调度策略决定下一个拿到它的是谁
2. 解锁不是"给某个指定线程"
- 唤醒谁不由调用方指定
- 被唤醒的线程还要自己再去抢一次------抢不到就继续等
四、锁自己也是临界资源,申请过程必须原子
4.1 谁来保护锁
1. 锁是共享的
- 多个线程要竞争同一把锁,前提是它们都能看见它
- 能被多个执行流共同访问的东西,就是临界资源------锁自己也是
2. 答案不是再套一把锁
- 再套一把锁,就又要问那把锁谁保护,无限递归
- 出路只有一条:申请锁的过程做成原子的
锁自己保护自己:不是靠别的锁来看着它,而是靠"申请"这个动作本身不可被打断。
4.2 硬件提供的原子交换指令
1. swap 与 exchange
- 为了实现互斥,大多数体系结构都提供了 swap 或 exchange 指令
- 作用是把寄存器和内存单元的数据相交换
- 它是一条汇编指令------交换这一步在物理上不可再分
2. 一条指令在多核下靠什么
- 单核单处理器上,一条 CPU 指令实现的操作天然是原子的,XCHG 这类指令可以放心用
- 多核下光有"一条指令"不够,必须让指令断言总线上的 LOCK 信号,挡住其他核对同一块内存的访问
- x86 上 XCHG 自带锁定语义,CMPXCHG 这类则要显式加
lock前缀
4.3 内存中mutex 的取值约定
1. 两个值的含义
- mutex = 1 :锁空闲,可以申请
这个1很重要(只有一份,是判断线程是否持有锁的关键) - mutex = 0:锁已经被某个线程拿走了
2. 初值和释放
- 创建并初始化锁,本质是在内存里申请一块空间、把它置为 1
- 解锁则是把它写回 1------把"钥匙"放回原处
4.4 申请锁的完整汇编逻辑
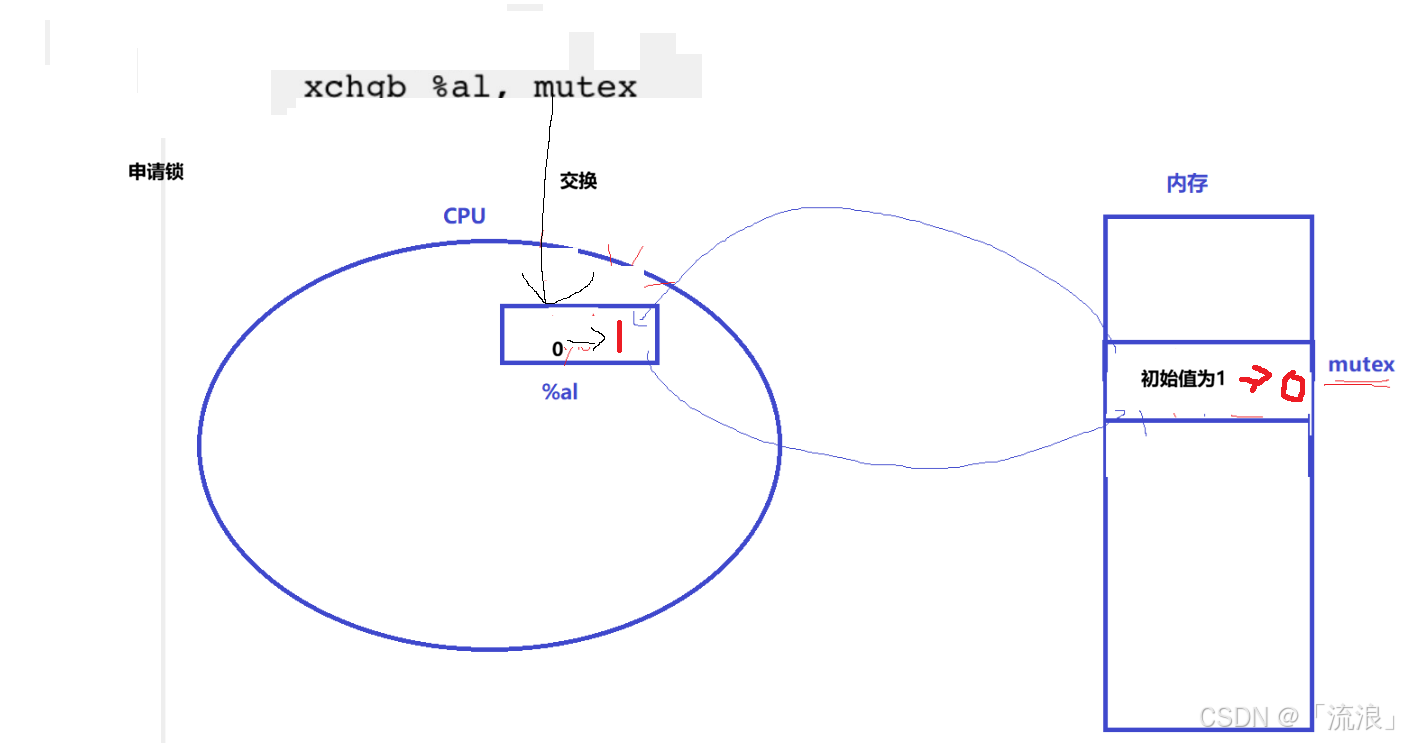
asm
lock:
    movb    $0, %al          ; 1. 先把自己的 %al 清 0
    xchgb   %al, mutex       ; 2. 原子交换:%al 与内存里的 mutex 换值
    if (%al > 0)             ; 3. 换回来是 1,说明抢到了
        return 0;            ;    申请成功,进临界区
    else
        挂起等待;            ;    换回来是 0,锁在别人手里
        goto lock;           ;    被唤醒后重新申请
1. 三步各管什么
- 清 0 :每个新来申请锁的线程都会把
%al清 0,不带任何前值进交换 - 交换:真正抢锁的动作,就这一条指令
- 判断:看换回来的是什么,决定继续走还是去排队
2. 判断在交换之后
- 判断的是
%al里的值,不是再去读一次内存里的 mutex - 判断只解释结果,不参与抢锁
3. 被唤醒后重新来过
- 挂起的线程被唤醒,不是直接进入临界区
- 而是回到
lock标签重新执行一遍------清 0、交换、再判断
4.5 解锁为什么不清 %al
1. 不做也不出错
- 解锁只做两件事:把 mutex 置回 1、唤醒等待的线程
%al里还留着 1,不影响正确性
2. 因为下一次申请会先清 0
- 每个线程申请锁的第一步都是
movb $0, %al - 上次残留的值在这一步被覆盖掉,不存在"多一把锁"的问题
五、交换到寄存器,就是"持有锁"
5.1 寄存器硬件只有一套,数据可以有多份
1. 硬件与数据的分工
- CPU 内部的寄存器硬件只有一套,所有线程共用这套物理寄存器
- 但寄存器里面的数据可以有多份------每个执行流一份,就是它的上下文
2. 上下文是线程私有的
- 当前 CPU 寄存器的内容,属于当前执行流私有
- 篇38 的清单里,一组寄存器正列在私有那一栏
- 线程被切走时保存上下文、切回时恢复上下文,保的就是这份数据
5.2 交换的本质是把共享的锁变成私有上下文
1. 一句话讲清交换
把一个变量的内容交换到 CPU 寄存器内部,本质是把这个变量的内容,获取到当前执行流的硬件上下文里。
2. 内存里只有一份
- 因为是"交换"而不是"拷贝",mutex 的值从内存挪进寄存器后,内存里就只剩换过来的 0
- 上面说过
每个线程申请锁的第一步都是 movb $0, %al,所以别的线程再来交换,拿到的只能是 0
3. 谁申请,谁持有
- 拿到 1 的那个线程,把锁装进了自己的上下文
- 锁跟着上下文走,谁也拿不走
谁先执行那条交换指令、谁把 1 换进了自己的寄存器,锁就是谁的。
5.3 拿到锁之后被切走,锁不会丢
1. 锁不禁止切换
- 互斥锁不关中断、也不暂停调度,持有锁的线程照样会被切走
- 被切走时保存的上下文里,就带着那个 1
2. 别人照样抢不到
- 锁的值在持有者的私有上下文里,内存里躺的是 0
- 其他线程来交换,换到的还是 0,只能继续等
六、完整推演,线程 A 拿到锁、线程 B 落空
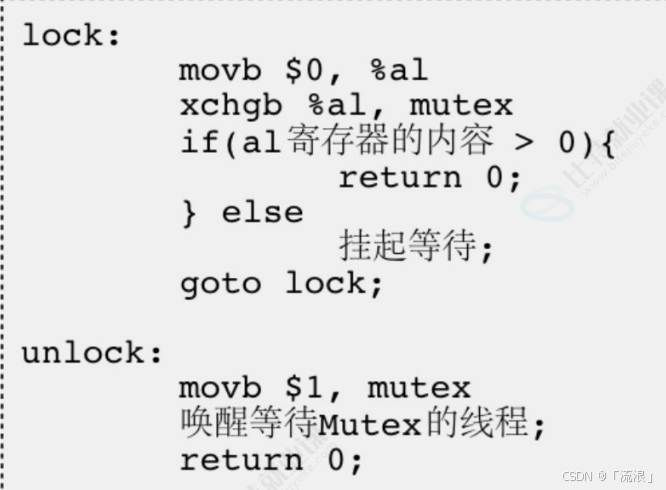
6.1 线程 A,换回 1
1. 清 0 与交换
movb $0, %al------把%al清 0xchgb %al, mutex------0 和 1 互换- 交换后:%al = 1,mutex = 0
2. 此刻被切走会怎样
- 保存上下文,里面记着
%al: 1 - 锁跟着它进了上下文,回来接着跑,锁还在它手里
6.2 线程 B,换回 0
1. 同样先清 0
movb $0, %alxchgb %al, mutex------但内存里的 mutex 早被 A 换成 0 了
2. 判断不成立,挂起
- 交换后线程 B 的视角:%al = 0,mutex = 0
%al > 0不成立,线程 B 挂起等待
6.3 两个线程的时间线
| 时刻 | 线程 A | 线程 B | 内存里的 mutex |
|---|---|---|---|
| t1 | movb $0, %al |
还没上场 | 1 |
| t2 | xchgb,%al 变 1 |
--- | 0 |
| t3 | 被切走,保存上下文 %al:1 | movb $0, %al |
0 |
| t4 | 等待队列里排队 | xchgb,%al 仍是 0 |
0 |
| t5 | --- | 判断不成立,挂起等待 | 0 |
| t6 | 切回,进临界区 | --- | 0 |
| t7 | 解锁,mutex 写回 1,唤醒 B | --- | 1 |
| t8 | --- | 被唤醒,goto 重新申请 | 1 |
- t2 之后内存里就只有 0------A 没解锁前,谁来换都换不到 1
- t8 的 B 不是直接进临界区,而是从头再抢一次
6.4 真正决定成败的是那条交换指令
- 成败由
xchgb %al, mutex这一条指令定下,判断只是事后读结果 - 这条指令是原子的,中间不会有第二个线程插进来
- 于是"申请锁"这件事整体就是原子的------它自己保护了自己
七、全篇总结
1. 临界资源与临界区
- 一次只允许一个执行流修改的共享资源是临界资源,访问它的代码是临界区
- 保护资源只能落在代码上:用锁把临界区圈出来
2. 两种初始化
- 全局锁:
PTHREAD_MUTEX_INITIALIZER静态初始化,无需手动销毁 - 局部锁:
pthread_mutex_init初始化,用完必须pthread_mutex_destroy
3. 三个接口
lock抢不到就阻塞挂起,trylock抢不到立即返回EBUSYunlock释放锁并唤醒等待者,下一个归属由调度策略决定
4. 锁的本质
- 把临界区这一段从并行改成串行,非临界区依旧并发
- 锁本身也是临界资源,靠申请过程的原子性自己保护自己
5. 原子性来自硬件
- swap/exchange 一条指令完成寄存器与内存的交换
- 单核天然原子,多核靠 LOCK 信号挡住其他核
6. 谁交换到 1,谁持有锁
- 交换把共享的锁变成线程私有的上下文
- 持有者被切走也不丢锁,别人换到的只能是被留下的 0
八、文末面试题
8.1 推导题
1. 锁本身也是临界资源,为什么不需要再用一把锁来保护它?
答(推导):因为申请锁的过程是原子的。多个线程竞争前都必须先执行同一条 swap/exchange 指令,这条指令把内存里的 mutex 与自己的寄存器交换,谁先把 1 换进自己的寄存器,谁就是持有者;内存里只剩下换过去的 0,后续线程换到的必然是 0,只能挂起等待。要保护的对象在"申请"这一瞬间已经被原子地搬进私有上下文,不需要外部再套一层锁------若再套一层,那层锁又需要被保护,会无限递归。
2. 申请锁为什么要先 movb $0, %al?不清零会怎样?
答(推导):清零是为了让每个线程不带任何前值进入交换 ,交换后 %al 里的值就只取决于内存里 mutex 当时的值------是 1 就是抢到了,是 0 就是没抢到。不清零的话,若 %al 里残留着 1,即使 mutex 已经是 0,交换后 %al 仍可能是 1,判断会误判成申请成功,两个线程同时进临界区。清零把"判断依据"唯一化,这一步是判断能成立的前提。
3. 线程拿到锁之后还没进临界区就被切走,锁会不会丢?
答(推导):不会。交换完成后锁的值已经在线程的私有上下文(%al)里,切走时这份上下文被完整保存,内存里留下的仍是 0。其他线程此时来申请,换到的还是 0,照样挂起。互斥锁不禁止线程切换,它保证的是"值在谁手里",而不是"谁一直占着 CPU"------持有者睡着也照样锁着。
4. 判断的是 %al 而不是内存里的 mutex,这个顺序能颠倒吗?
答(推导):不能。判断必须发生在交换之后、且只能看交换回来的结果。如果先读内存判断"是不是 1"、再去做修改,那就是读和写两段独立操作,中间可以被切走------两个线程都读到 1、都以为自己抢到了,正是抢票事故的原样复现。交换指令把"读---改"压成一个不可再分的动作,先交换、后判断,判断的才是真正属于自己那一刻的结果。
5. 被唤醒的线程为什么还要 goto 回去重新申请?
答(推导):唤醒只代表"锁可能可用了",不代表"锁归你了"。解锁把 mutex 写回 1 之后,等待队列里可能排着多个线程,它们被唤醒后都要重新走一遍清 0、交换、判断的流程,谁先执行那条交换指令谁拿到。若唤醒即视为持有,多个线程就会被同时放进临界区;回到 lock 标签重新申请,是把"唤醒"和"获得"这两件事彻底分开。
6. 锁的本质是"把并行换成串行",串行的是哪一段?
答(推导):串行的是临界区这一小段,不是整个线程或整个函数。加锁与解锁之间的代码同一时刻只允许一个执行流进入,锁外的非临界区所有线程照旧并发执行。因此临界区划得越长,被串行掉的部分越多、并发度掉得越狠------锁的粒度本质上是"你愿意交出多少并行度换正确性"的取舍。
8.2 真题
1. 互斥锁加锁失败后是睡眠还是忙等?和自旋锁的区别是什么,各自用在什么场景?
【真题·转述自 小林coding《面试官:你说说互斥锁、自旋锁、读写锁、悲观锁、乐观锁的应用场景》(题库型,未标注具体公司)】
答(推导 · 已对照面经,转述):互斥锁加锁失败时线程释放 CPU、由内核置为睡眠状态,等锁释放后再唤醒,代价是两次线程上下文切换(睡眠一次、唤醒一次),开销在几十纳秒到几微秒;自旋锁加锁失败则原地忙等,靠 CPU 的 CAS 在用户态循环重试,不发生上下文切换。选谁看临界区长短:能确定被锁住的代码执行时间很短,用自旋锁(切换成本比等锁还贵);临界区长或竞争激烈,用互斥锁,让出 CPU 给别的线程干活。本篇的阻塞挂起路径,正是互斥锁这一侧的形态。
2. 为什么加锁必须是"一步完成"的原子操作,先判断再修改为什么不行?
【真题·转述自 阿里云开发者社区《线程互斥、同步(一)》(技术社区问答,题库型,未标注具体公司)】
答(推导 · 已对照公开问答,转述):先判断再修改等于把一件事拆成两段:中间可以被切走,两个线程都读到"锁空闲"、都去修改,锁就形同虚设------这和 ticket-- 的三步被切走是同一个骨架。加锁必须由一条 swap/exchange 指令一次完成"读---改",硬件保证这一条指令执行期间不会有别的执行流插入,因此判断和修改是一体的:交换回来的值是多少,锁当时就是什么状态。真实实现里多核还要靠 LOCK 信号挡住其他核,单靠"只有一条指令"在多核下并不够。
💬 结语: 锁的全部秘密就藏在那一句交换里------内存里只有一份,谁先把它换进自己的寄存器,谁就持有它,切走也带得走。看懂这条指令,再看 lock/unlock 就不会只当它是两个函数调用了。评论区聊聊你第一次手写自旋锁时踩的坑。如果这篇对你有帮助,点个赞再走,关注流浪,Linux 系统篇持续更新。