欢迎来到我的频道!【点击跳转专栏】
本文所有代码已托管至码云:【点此转跳】
文章目录
- [0. ⽹络层](#0. ⽹络层)
- [1. IP协议](#1. IP协议)
- [1.1 基本概念补充](#1.1 基本概念补充)
- [1.2 几个简单问题入门](#1.2 几个简单问题入门)
- [1.2.1 初步理解IP作用](#1.2.1 初步理解IP作用)
- [1.2.2 IP地址的构成和查找目标主机的方法是什么](#1.2.2 IP地址的构成和查找目标主机的方法是什么)
- [1.2.3 TCP VS IP](#1.2.3 TCP VS IP)
- [1.3 协议头格式](#1.3 协议头格式)
- [1.4 ⽹段划分(重要!)](#1.4 ⽹段划分(重要!))
- [1.4.1 划分原理](#1.4.1 划分原理)
- [1.4.2 为什么要进行网段划分?](#1.4.2 为什么要进行网段划分?)
- [1.4.3 分类划分法](#1.4.3 分类划分法)
- [1.4.4 CIDR(⽆类别域间路由)](#1.4.4 CIDR(⽆类别域间路由))
- [1.4.5 特殊的IP地址](#1.4.5 特殊的IP地址)
- [1.5 IP地址的数量限制](#1.5 IP地址的数量限制)
- [1.6 私有IP地址和公⽹IP地址](#1.6 私有IP地址和公⽹IP地址)
- [1.7 尝试理解公⽹](#1.7 尝试理解公⽹)
- [1.8 路由(公网)](#1.8 路由(公网))
- [2. IP分⽚和组装的具体过程](#2. IP分⽚和组装的具体过程)
- [2.1 分片](#2.1 分片)
- [2.2 组装](#2.2 组装)
- [2.3 如何和为什么要避免分片](#2.3 如何和为什么要避免分片)
0. ⽹络层
在复杂的⽹络环境中确定⼀个合适的路径。
1. IP协议
1.1 基本概念补充
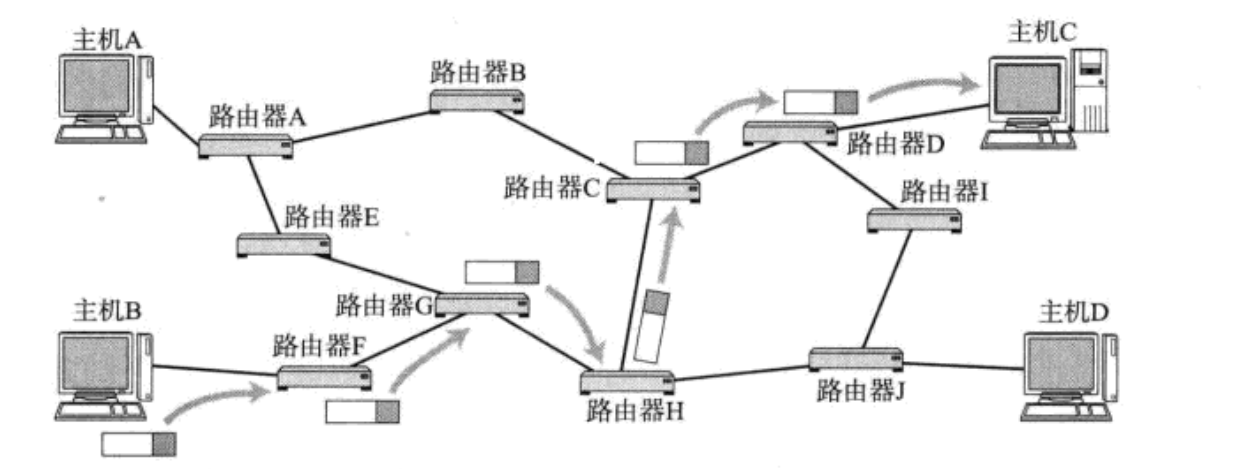
- 主机: 配有IP地址, 也要进行路由控制的设备;
- 路由器: 即配有IP地址, 又能进行路由控制( 路由器本质上也是主机的一种 );
- 节点: 主机和路由器的统称;
- 在网络中 我们一般将 两端称为
主机,中间途经的叫节点
1.2 几个简单问题入门
1.2.1 初步理解IP作用
数据从B->C,中间要经历无数个子网转发,而主机是根据报文中的目的IP,进行路径选择的!
1.2.2 IP地址的构成和查找目标主机的方法是什么
IPV4是由4字节组成的,IP地址 = 目标网络(子网) + 目标主机(子网中的编号)
如学号 = 学院号 + 专业号 + 班级号 + 个人编号组成,这样就能很方便我们找到这个学号对应的人,这也就表明 单纯的数字是能够具有一定的指向性的!
我们要理解的不是单纯一个数字,真正要理解的是网络的组织结构,在这个特定场景下 IP地址才有指向意义!
1.2.3 TCP VS IP
- IP协议提供了一种能力:把数据包从主机A 跨网络 经过路径选择,路由转发,传送到主机B的能力!
我们要知道什么叫
能力?我们说你有进大厂的能力, 不是说你一定能进大厂,而是 你有极大的概率能做成这件事情!而光有能力还行!你还得保证可靠性(即知道怎么失败的,失败后怎么改进,怎么做能成功),于是你就找到了你学校导师, 她负责帮你培训,帮你改简历,帮你分析面试失败原因,给你解决方法,直到你顺利进入大厂。
进入大厂,靠的是你自己的能力(
相当于IP协议),而保障你能顺利不出岔子,为你进入大厂提供策略的老师就相当于TCP协议!一个提供可靠性策略(TCP),而具体落地完成靠的是IP协议!
综上,TCP(提供可靠)+IP(提供能力),就能保障将数据包可靠的从A主机传送到主机B!
1.3 协议头格式
首先要认识:IP本身是内核内的一个结构体:
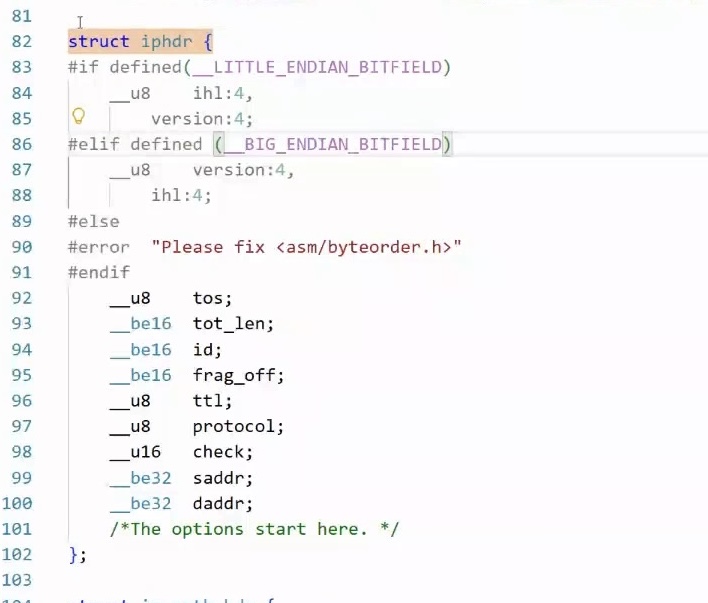
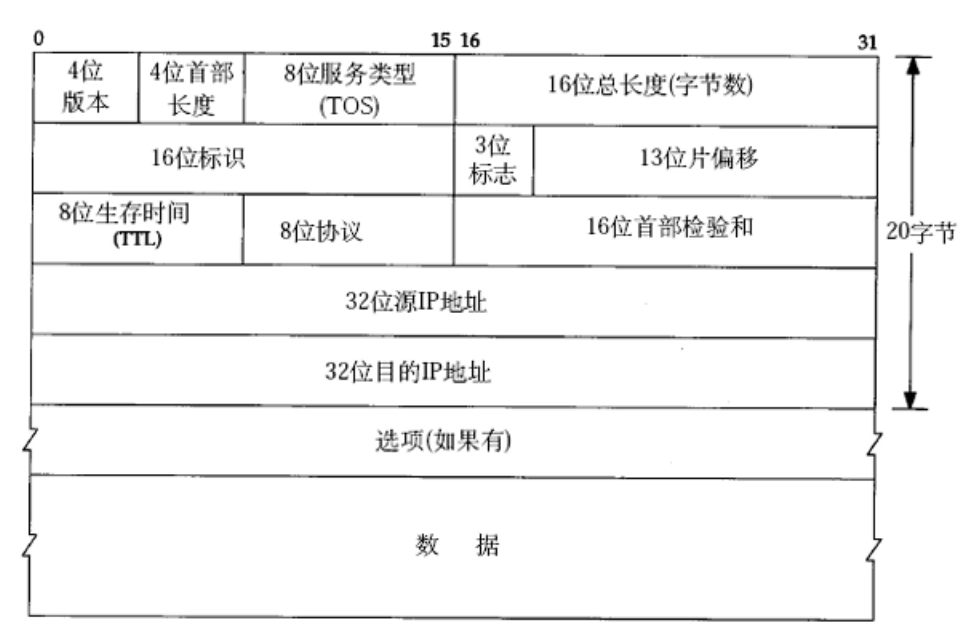
- 4位版本号(version) :指定 IP 协议的版本, 对于 IPv4 来说,就是
4。- 4位头部长度(header length) : IP 头部的长度是多少个 32bit,也就是
length * 4的字节数。4bit 表示最大的数字是 15,因此 IP 头部最大长度是 60 字节。(有了这个,IP报头和有效载荷分离的问题自然而然就解决了! )- 8位服务类型(Type Of Service) :3 位
优先权字段(已经弃用),4 位TOS 字段,和1 位保留字段(必须置为 0)。 4 位 TOS 分别表示 :最小延时、最大吞吐量、最高可靠性、最小成本(即 优先选择最便宜的传输路径)。这四者相互冲突,只能选择一个。对于ssh/telnet这样的应用程序,最小延时比较重要;对于ftp这样的程序,最大吞吐量比较重要。- 16位总长度(total length) :IP 数据报整体占多少个字节,整个 IP 数据报的总字节长度 = IP 首部 + IP 数据部分,65535 字节,这就是 IP 数据包最大总长度
- 16位标识(id) :(暂时先不管 )
- 3位标志字段 :(暂时先不管 )
- 13位分片偏移(fragment offset) :(暂时先不管 )
- 8位生存时间(Time To Live, TTL) : 数据报到达目的地的最大报文跳数。一般是 64。每次经过一个路由,
TTL -= 1,一直减到 0 还没到达,那么就丢弃了。这个字段主要是用来防止出现路由循环。- 8位协议 : 表示上层协议的类型是
TCP还是UDP等(如TCP:6、UDP:17),由发送端来填!。- 16位头部校验和 : 使用
CRC进行校验,来鉴别头部是否损坏,上层是UDP直接丢不关心,TCP则会重传。- 32位源地址和32位目标地址 : 表示发送端和接收端。
- 选项字段(不定长,最多40字节 ):略。
- 数据 : UDP或者TCP报文。
1.4 ⽹段划分(重要!)
1.4.1 划分原理
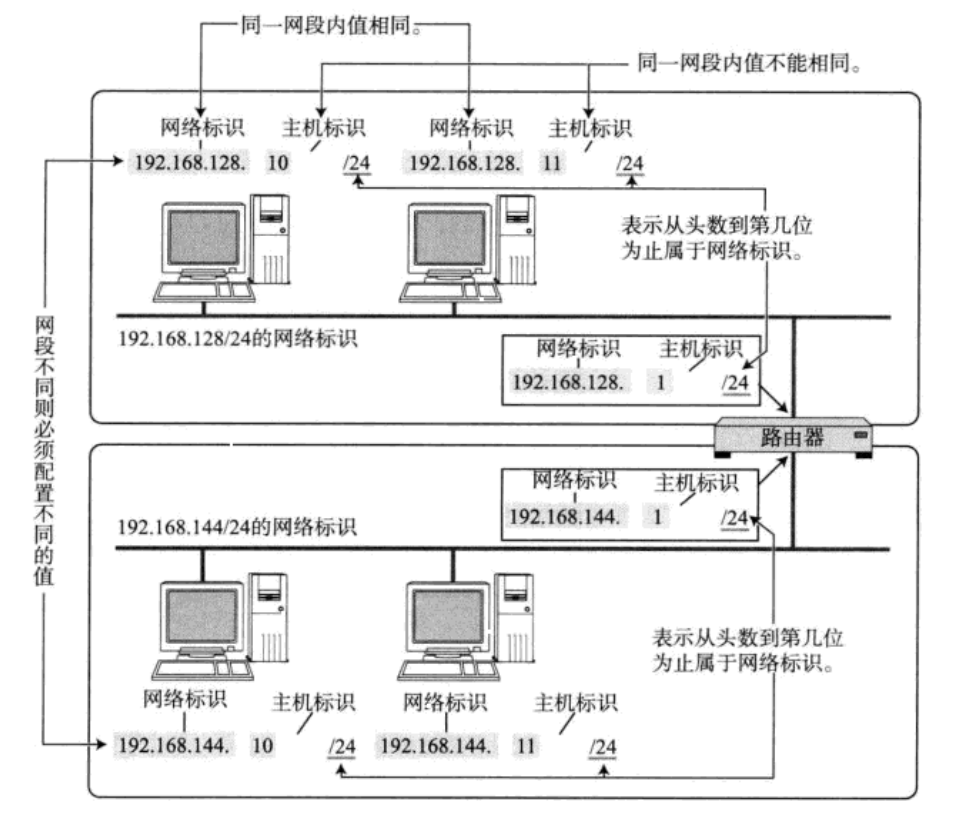
IP地址分为两个部分, ⽹络号和主机号:
- ⽹络号: 保证相互连接的两个⽹段具有不同的标识
- 主机号: 同⼀⽹段内, 主机之间具有相同的⽹络号, 但是必须有不同的主机号
路由器有个核心能力(
DHCP协议,知道就行):叫做构建子网(局域网)
- 不同的⼦⽹其实就是把⽹络号相同的主机放到⼀起
- 如果在⼦⽹中新增⼀台主机, 则这台主机的⽹络号和这个⼦⽹的⽹络号⼀致, 但是主机号必须不能和⼦⽹中的其他主机重复
通过合理设置主机号和⽹络号, 就可以保证在相互连接的⽹络中, 每台主机的IP地址都不相同
那么问题来了, ⼿动管理⼦⽹内的IP, 是⼀个相当⿇烦的事情~!
- 有⼀种技术叫做
DHCP, 能够⾃动的给⼦⽹内新增主机节点分配IP地址, 避免了⼿动管理IP的不便 - 般的路由器都带有
DHCP功能. 因此路由器也可以看做⼀个DHCP服务器
1.4.2 为什么要进行网段划分?
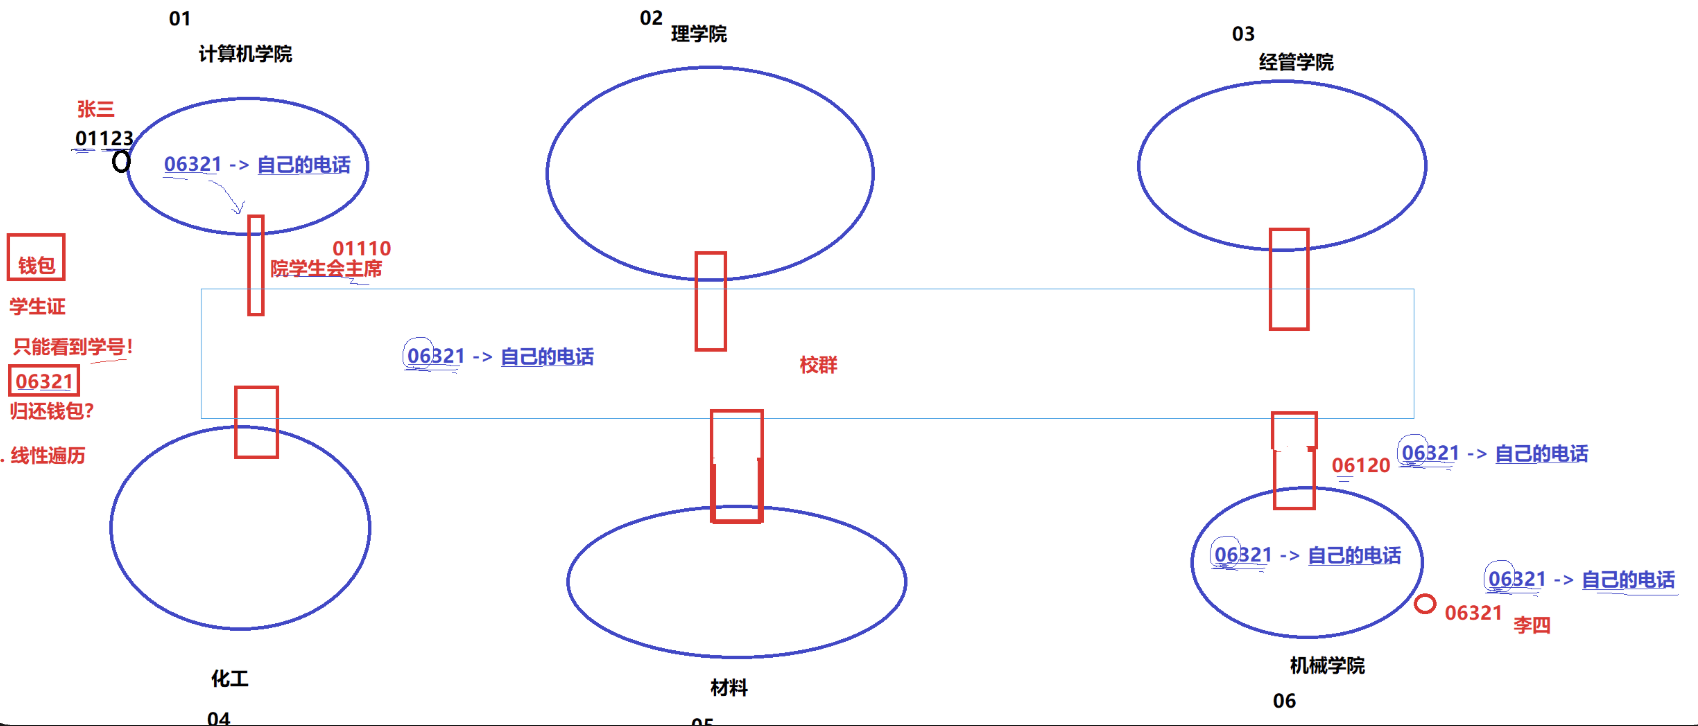
讲个故事: 每个学院由院学会,于是学生会长和该院所有学生拉了个群叫
院群,然后学校所有院的学生会长又再一起拉了个校群,其中学号前两位代表学院(如计算机学院是01),后三位代表你是学院里的哪一个!有一天张三(学号01123)捡到个钱包,只有学号(06321),作为 计算机学院的普通一份子,正常人都不会关心其他学院是几开头的,但是知道06不是计算机学院的!于是就在院群@学生会主席,学生会主席虽然不知道321具体是机器学院的谁!但是他知道06是机器学院的!再在校群@机器学院的学生会主席机器学院主席一看是机器学院(06)序号321的学生的,于是就在他们院群@321学号的人,321的学生李四 看到,就说:"钱包是我的!",就此 钱包顺利归还!
在这个故事里面 张三就是源主机;李四就是目标主机;钱包就是报文;学生会主席就是路由器;院群就是内网或者子网;校群就是公网!
报文交给目标主机的 本质其实就是个查找工作 !而查找的本质就是 淘汰!
我们学习过线性遍历!他查找效率为什么慢? 因为他一次只淘汰一个! 而二分为什么快? 因为他一次淘汰一半!!
而张三决定将学号交给院学生会主席,本质就是 淘汰一整个计算机学院的人! 而院学生会主席@机器学院学生会主席,本质是 淘汰除机器学院其他学院的所有人!
所以为什么要网段划分?本质 是为了支持我们查找时的快速淘汰!大大提高查找效率!
一次淘汰一整个其他网段,不用遍历全网几十亿台主机,这就是子网划分的根本意义。
1.4.3 分类划分法
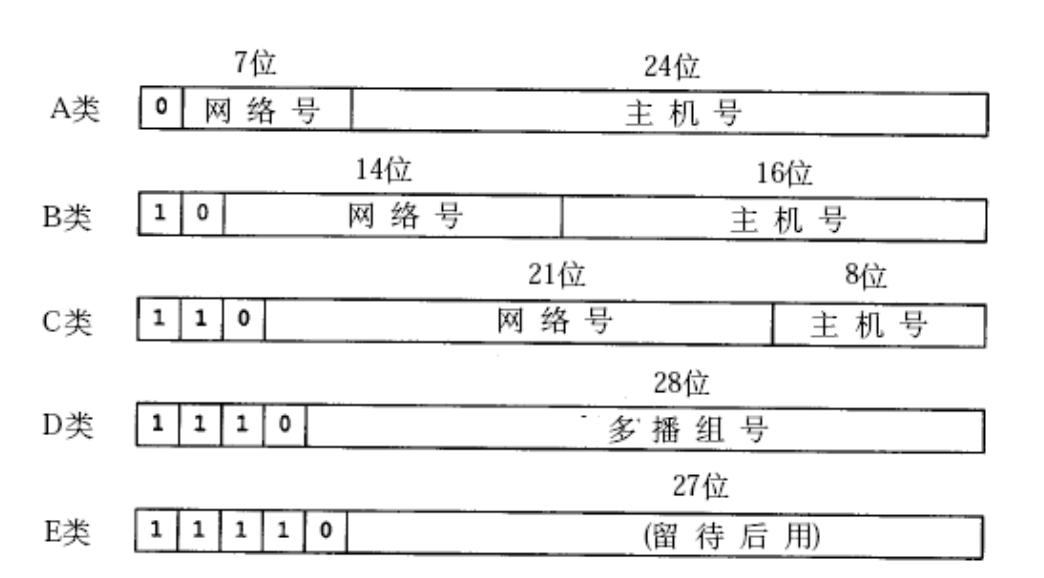
- A类: 0.0.0.0到127.255.255.255
- B类: 128.0.0.0到191.255.255.255
- C类: 192.0.0.0到223.255.255.255
- D类: 224.0.0.0到239.255.255.255
- E类: 240.0.0.0到247.255.255.255
随着Internet的⻜速发展,这种划分⽅案的局限性很快显现出来,⼤多数组织都申请B类⽹络地址, 导致B类地址很快就分配完了, ⽽A类却浪费了⼤量地址
- 例如, 申请了⼀个B类地址, 理论上⼀个⼦⽹内能允许6万5千多个主机. A类地址的⼦⽹内的主机数更多
- 然⽽实际⽹络架设中, 不会存在⼀个⼦⽹内有这么多的情况. 因此⼤量的IP地址都被浪费掉了
分类划分法最大的问题:IP地址使用不充分的问题。
1.4.4 CIDR(⽆类别域间路由)
针对这种情况提出了新的划分方案,称为CIDR(Classless Interdomain Routing)(无类别域间路由):
- 引入一个额外的
子网掩码(subnet mask) 来区分网络号和主机号; - 子网掩码也是一个32位的正整数. 通常用一串 "0" 来结尾;
- 将IP地址和子网掩码进行 "按位与" 操作, 得到的结果就是网络号;
- 网络号和主机号的划分与这个IP地址是A类、B类还是C类无关;
子网掩码往往是内置在路由器内部!
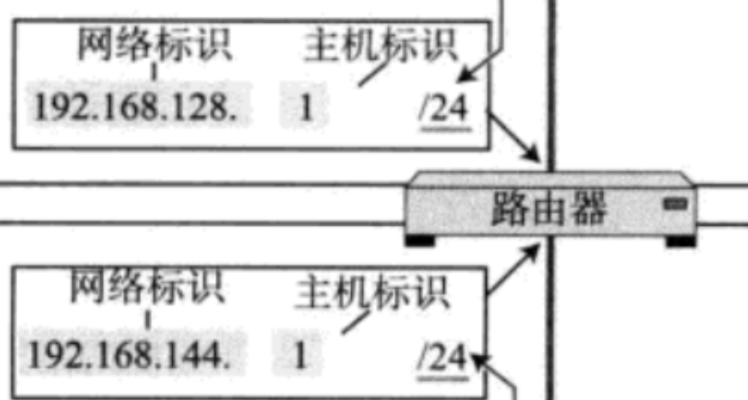
这个24 就表示其子网掩码为:
255.255.255.0(左半部分24个1)可⻅,IP地址与⼦⽹掩码做与运算可以得到⽹络号, 主机号从全0到全1就是⼦⽹的地址范围
IP地址和⼦⽹掩码还有⼀种更简洁的表⽰⽅法,例如
140.252.20.68/24,表⽰IP地址为140.252.20.68, ⼦⽹掩码的⾼24位是1,也就是255.255.255.0
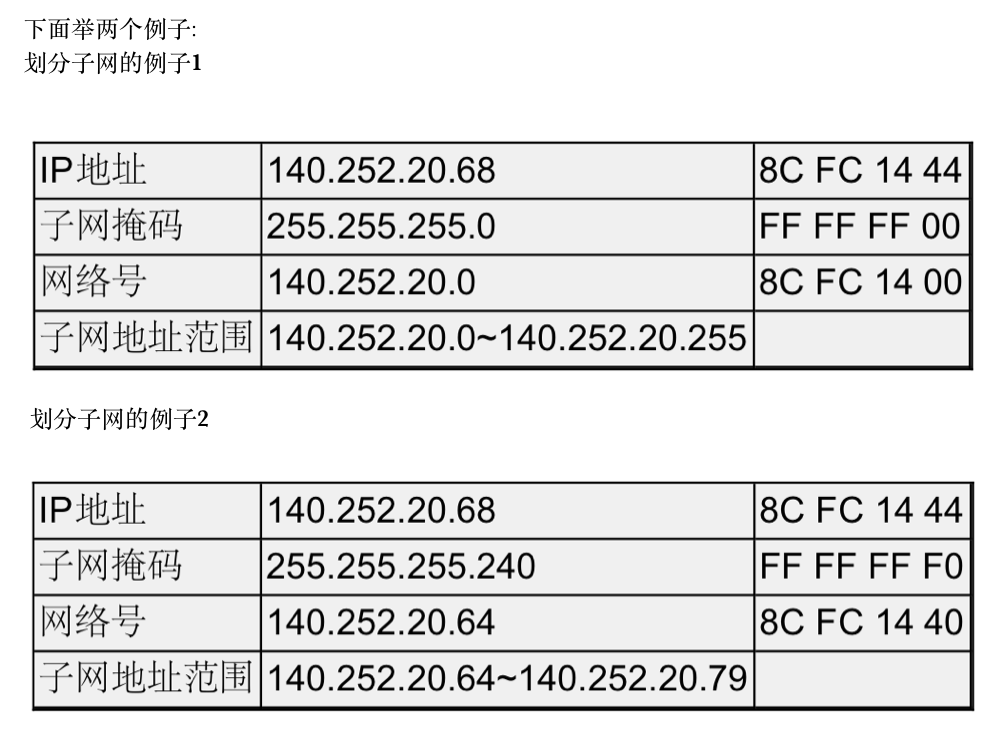
那么这两种方法冲突吗??
不冲突!比如说 A机构申请了个A类的地址
0000 0111 XXXXX...但是如果我最多只能有2的16方个主机!那么不就有8位浪费了??于是我就可以把子网掩码设置成
16位,于是我内部不就可以凭白多搭建2的8次方的子网!于是我就能把我的资源在我的内部再次进行好好划分,即在子网里面搭建新的子网!7.0.0.0到7.255.0.0不就是我能新划分的子网吗!
分类划分和子网划分,本质属于粗分和细分!可以通过子网掩码动态调整位数的方式为申请好的A类或者B类网络进行更加精细化的划分!
1.4.5 特殊的IP地址
- 将IP地址中的主机地址全部设为0, 就成为了网络号, 代表这个局域网;
- 将IP地址中的主机地址全部设为1, 就成为了广播地址, 用于给同一个链路中相互连接的所有主机发送数据包;
127.*的IP地址用于本机环回(loop back)测试,通常是127.0.0.1
1.5 IP地址的数量限制
我们知道,IP 地址(IPv4)是一个 4 字节 32 位的正整数,那么一共只有 2的32次方 个 IP 地址,大概是 43 亿左右。而 TCP/IP 协议规定,每个主机都需要有一个 IP 地址。
这意味着,一共只有 43 亿台主机能接入网络么?
实际上并非如此,原因有二:
- 由于一些特殊的 IP 地址的存在,实际可用的数量远不足 43 亿;
- IP 地址并非是按照主机台数来配置的,而是每一个网卡都需要配置一个或多个 IP 地址。
CIDR 在一定程度上缓解了 IP 地址不够用的问题(提高了利用率,减少了浪费,但是 IP 地址的绝对上限并没有增加),仍然不是很够用。这时候有三种方式来解决:
- 动态分配 IP 地址:只给接入网络的设备分配 IP 地址。因此同一个 MAC 地址的设备,每次接入互联网中,得到的 IP 地址不一定是相同的;
- NAT 技术(后面会重点介绍);
- IPv6:IPv6 并不是 IPv4 的简单升级版。这是互不相干的两个协议,彼此并不兼容;IPv6 用 16 字节 128 位来表示一个 IP 地址;但是目前 IPv6 还没有公网环境普及。
1.6 私有IP地址和公⽹IP地址
如果⼀个组织内部组建局域⽹,IP地址只⽤于局域⽹内的通信,⽽不直接连到Internet上,理论上 使⽤任意的IP地址都可以,但是RFC 1918规定了⽤于组建局域⽹的私有IP地址
10.*,前8位是网络号,共16,777,216个地址172.16.*到172.31.*,前12位是网络号,共1,048,576个地址192.168.*,前16位是网络号,共65,536个地址
包含在这个范围中的,都成为私有IP,其余的则称为全局IP(或公网IP);
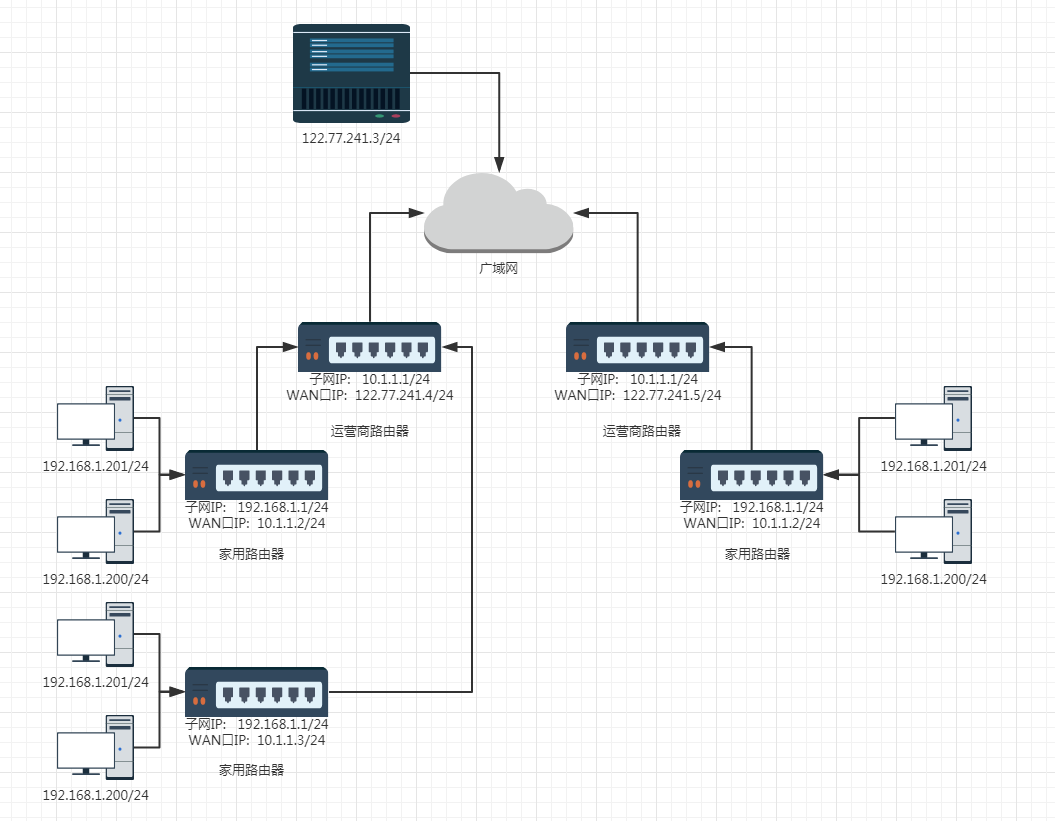
- ⼀个路由器可以配置两个IP地址, ⼀个是
WAN⼝IP, ⼀个是LAN⼝IP(⼦⽹IP). - 路由器LAN⼝连接的主机, 都从属于当前这个路由器的⼦⽹中.
- 不同的路由器, ⼦⽹IP其实都是⼀样的(通常都是192.168.1.1). ⼦⽹内的主机IP地址不能重复. 但是⼦⽹之间的IP地址就可以重复了
- 每⼀个家⽤路由器, 其实⼜作为运营商路由器的⼦⽹中的⼀个节点. 这样的运营商路由器可能会有很多级,
最外层的运营商路由器, WAN⼝IP就是⼀个公⽹IP了
⼦⽹内的主机需要和外⽹进⾏通信时, 路由器将IP⾸部中的IP地址进⾏替换(替换成WAN⼝IP), 这样逐级替换, 最终数据包中的IP地址成为⼀个公⽹IP. 这种技术称为NAT(Network Address Translation,⽹络地址转换),当对方服务器返回时,路由器内部会有一个映射表将其原分不动的转换回去!具体细节以后再说。
细节1: 我们所有人,都不可能直接连接公网,我们都是通过先连到局域网中,通过局域网入的公网!
细节2: 私有IP可以重复,但是公网IP是不能重复的!但也因为私有IP可以重复,IP不足问题不就被大大缓解了!
细节3: 内网到公网的过程,途经路由器都会替换src ip,变成自己的WAN口IP!公网内就不做替换,这个替换工作,只在内网转发进行!
1.7 尝试理解公⽹
真实的⽹络结构⾮常复杂,即涉及到划分公⽹IP的组织,ICANN,还要在全球范围内进⾏区域划分,⽐如亚太,北美,欧洲等,⼜要考虑各个国家内部的ISP代理,整体拓扑⾮常复杂, 我们简化所有过程,简单理解公⽹即可。
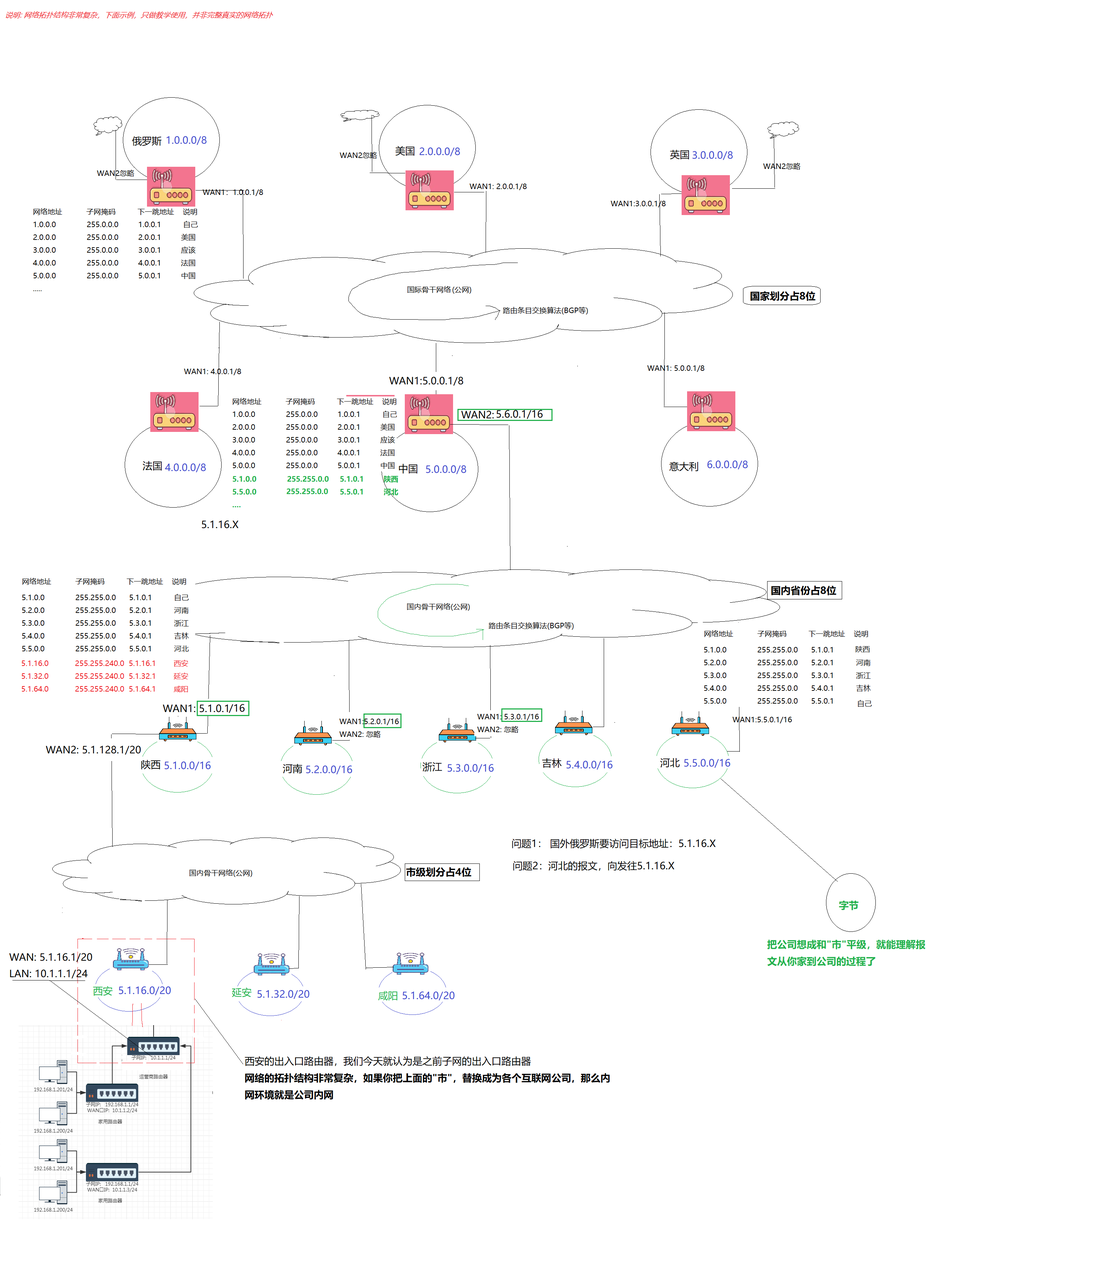
可以把这张图理解成"从全球互联网一路找到某家公司电脑"的过程。
图中最上方的云是国际互联网 ,俄罗斯、美国、英国、法国、中国、意大利等国家或地区都通过路由器接入这里。每个国家或大型网络拥有一段公网 IP 地址,例如图中用 1.0.0.0/8、2.0.0.0/8、5.0.0.0/8 表示不同的大网络。这里的 /8 表示前 8 位是网络部分,后面的地址可以继续划分。
中国得到 5.0.0.0/8 后,又继续划分成更小的网络。例如:
text
中国公网:5.0.0.0/8
省级网络:5.1.0.0/16
城市网络:5.1.16.0/20
公司对应出口:5.1.16.X
图中的"国家级公网""省内公网""市级部分"可以看成不同层级的道路。路由器通过 BGP 等路由协议互相交换信息,知道"访问 5.1.16.0/20 的数据应该往哪个方向转发"。因此,当国外用户访问 5.1.16.X 时,数据大致会经过:
text
国外网络
→ 国际互联网
→ 中国国家级公网
→ 对应省级网络
→ 对应城市网络
→ 公司出口路由器
→ 公司内部网络
公司出口路由器外侧使用的是公网地址,例如 5.1.16.1;内侧通常使用 192.168.x.x、10.x.x.x 等私网地址。比如公司内部可能是:
text
公司内网:192.168.1.0/24
员工电脑:192.168.1.20
公司出口:公网 IP 5.1.16.1
员工电脑访问互联网时,数据先从 192.168.1.20 发到公司路由器,再由 NAT 把私网地址转换成公网地址 5.1.16.1,然后进入公网。外部网络通常只能看到公司的公网地址,不能直接看到内部的 192.168.1.20。
所以,公网就是不同国家、地区、运营商和组织之间共同连接的、可以通过公网 IP 和路由协议互相到达的网络 。图中的国际公网、国家公网、省级公网和市级公网都属于公网;图中公司内部的 192.168.x.x、10.x.x.x 网络则属于内网。需要注意,图中的地址划分主要是为了教学演示,现实中的公网地址分配并不是简单地"一整个网段对应一个国家"。
1.8 路由(公网)
在复杂的⽹络结构中, 找出⼀条通往终点的路线。
举个例子:小明要去清华大学,问了一个大爷,大爷说不知道(路由表没有),于是告诉你,前面有个大娘(默认路由,一般是其出口即更高级路由器),她知道你可以问她!
大娘告诉你位置说往前走坐公交32路坐两站下车即可(查路由表告诉你下一跳结果),然后下车后问了一个保安,保安说 这里就是(找到目标网络),后面你问保安,5号楼怎么走,保安告诉你左转第一个路口再右转即可(内网转发,根据目的主机进行转发!)
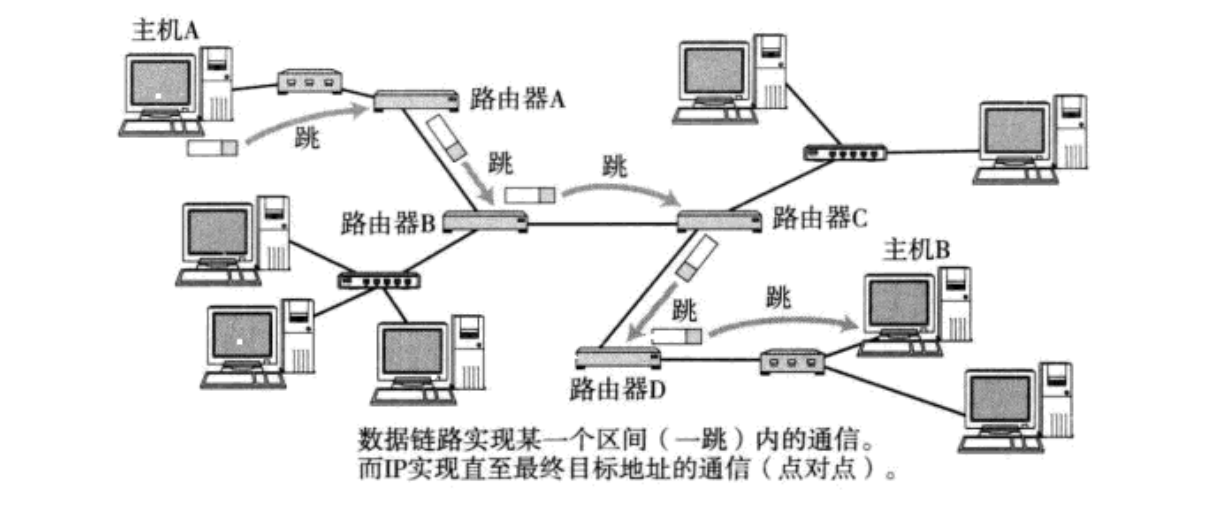
IP数据包的传输过程也和问路一样.
- 当IP数据包,到达路由器时,路由器会先查看目的IP;
- 路由器决定这个数据包是能直接发送给目标主机,还是需要发送给下一个路由器;
- 依次反复,一直到达目标IP地址;
那么如何判定当前这个数据包该发送到哪里呢? 这个就依靠每个节点内部维护一个路由表;
路由表可以使⽤route命令查看:
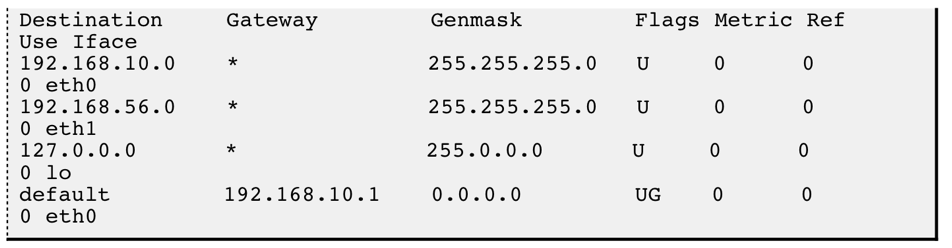
如果⽬的IP命中了路由表, 就直接转发即可;
路由表中的最后⼀⾏,主要由下⼀跳地址和发送接⼝两部分组成,当⽬的地址与路由表中其它⾏都不匹配时,就按缺省路由条⽬规定的接⼝发送到下⼀跳地址
路由表的Destination是目的网络地址,Genmask是子网掩码,Gateway是下一跳地址,Iface是发送接口,Flags中的U标志表示此条目有效(可以禁用某些条目),G标志表示此条目的下一跳地址是某个路由器的地址,没有G标志的条目表示目的网络地址是与本机接口直接相连的网络,不必经路由器转发;
注意:
- 如果看到
eth0、eth1等则表示网卡设备名。lo:loopback 回环网卡,127.0.0.1,本机自己和自己通信wlan0: 无线 WiFi 网卡(wlan = wireless lan)
转发过程例1:目的地址 192.168.56.3
- 跟第一行的子网掩码做与运算,得到
192.168.56.0,与第一行的目的网络地址不符; - 再跟第二行的子网掩码做与运算,得到
192.168.56.0,正是第二行的目的网络地址,因此从eth1接口发送出去; - 由于
192.168.56.0/24正是与eth1接口直接相连的网络,因此可以直接发到目的主机,不需要经路由器转发。
转发过程例2:目的地址 202.10.1.2
- 依次和路由表前几项进行对比,发现都不匹配;
- 按缺省路由条目,从
eth0接口发出去,发往192.168.10.1路由器; - 由
192.168.10.1路由器根据它的路由表决定下一跳地址。
2. IP分⽚和组装的具体过程
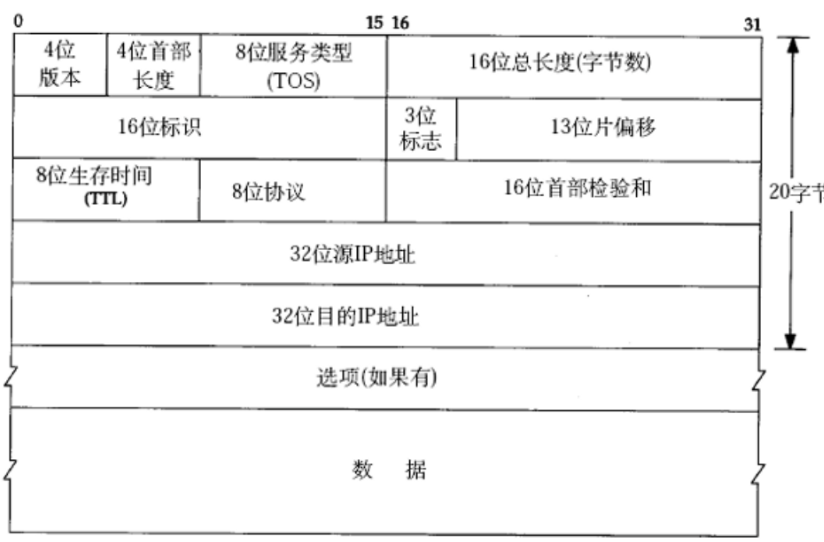
- 16位标识(id) : 唯一的标识主机发送的报文。如果 IP 报文在数据链路层被分片了,那么每一个分片里面的这个 id 都是相同的。
- 3位标志字段:第一位保留(保留的意思是现在不用,但是还没想好说不定以后要用到)。第二位置为 1 表示禁止分片,这时候如果报文长度超过 MTU,IP 模块就会丢弃报文。第三位表示"更多分片",如果分片了的话,最后一个分片置为 0,其他是1。类似于一个结束标记。
- 13位分片偏移(fragment offset) :是分片相对于原始 IP 报文开始处的偏移。其实就是在表示当前分片在原报文中处在哪个位置。实际偏移的字节数是这个值
* 8得到的。因此,除了最后一个报文之外,其他报文的长度必须是 8 的整数倍(否则报文就不连续了)。
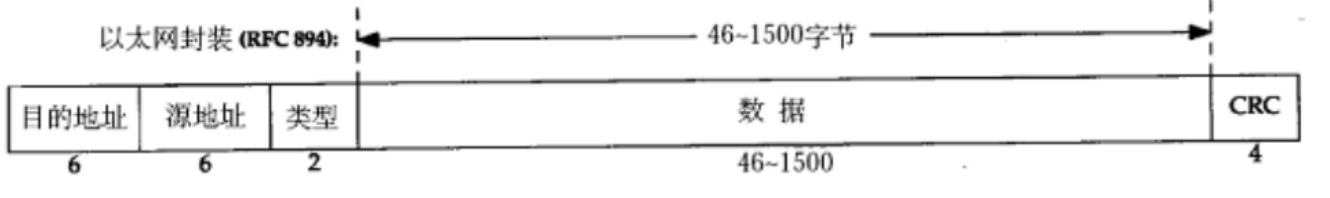
给大家个结论:在数据链路层,有效载荷不能超过
MTU(1500字节)
2.1 分片
1. 检查 MTU 限制
- 当一个
IP 数据报的大小超过了网络的MTU(最大传输单元)限制时,就需要进行分片。MTU是数据链路层对 IP 层数据包进行封装时所能接受的最大数据长度。
2. 分割数据报
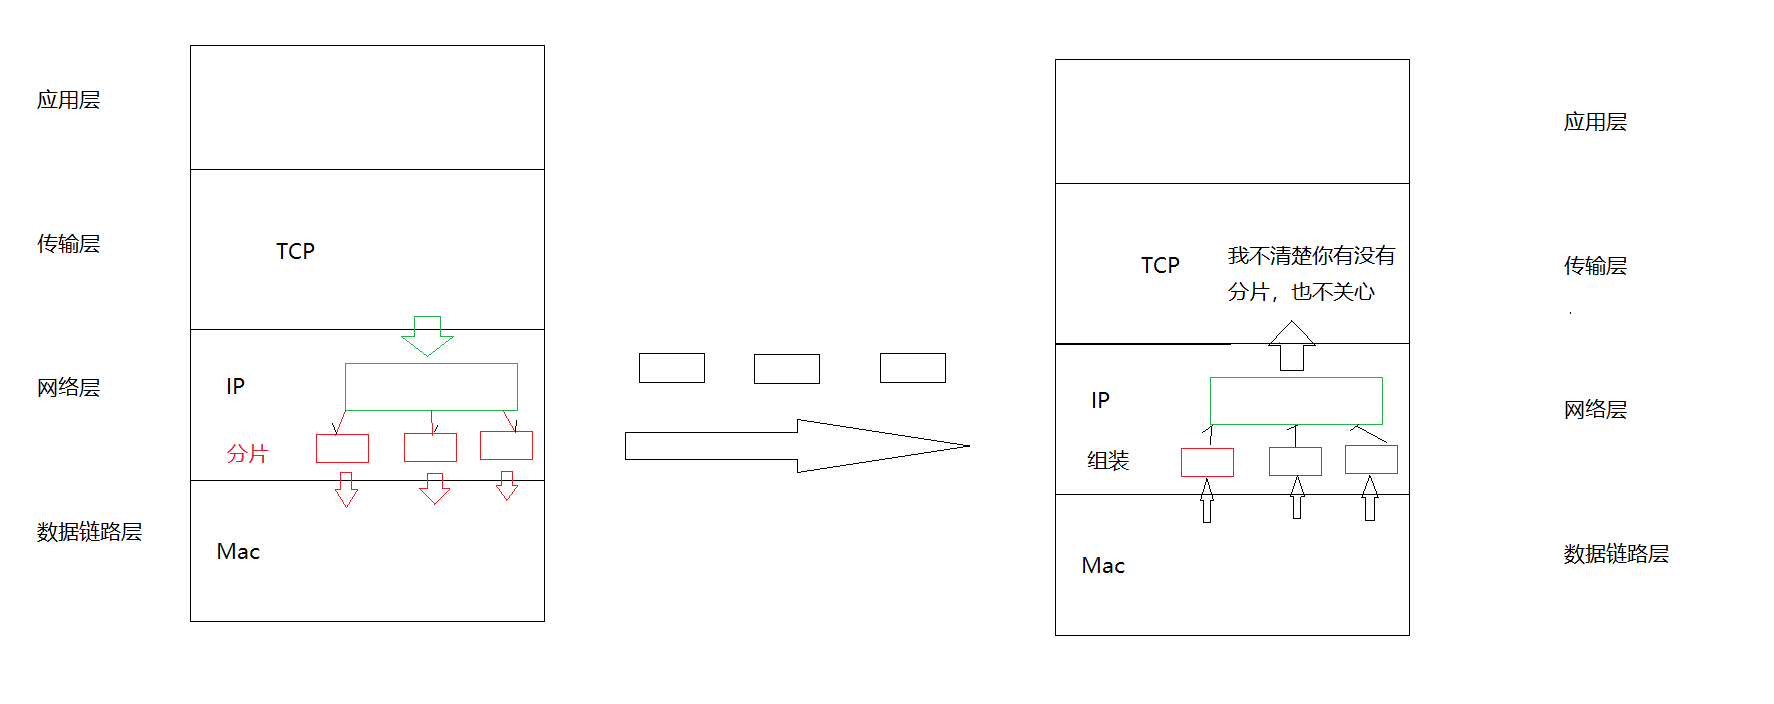
- IP 层将原始的 IP 数据报分割成多个较小的片段(真正分片是有效载荷在分片 )。
- 对于每个片段,IP 层会设置 相应的标识(Identification)、偏移量(Fragment Offset)和标志位(Flags)等字段。
- 标识字段用于标识属于同一个数据报的不同分片,确保所有分片能够被正确地重新组装。
- 偏移量字段指示了当前分片相对于原始数据报的起始位置,以 8 字节为单位。
- 标志位字段包含了 3 个位,其中
MF(More Fragment)位用于指示是否还有更多的分片,DF(Do Not Fragment)位用于指示数据报是否允许进行分片。
3. 添加 IP 头部
- 每个分片都会加上自己的 IP 头部,与完整 IP 报文拥有类似的 IP 头结构,但
MF和Fragment Offset等字段的值会有所不同。
4. 发送分片
- 分片在传输过程中独立传输,每个分片都有自己的 IP 头部,并且各自独立地选择路由。
2.2 组装
1. 接收分片
- 当目的主机的 IP 层接收到这些分片后,会根据标识字段将属于同一个数据报的所有分片挑选出来。
2. 排序与组装
- 利用片偏移字段,IP 层会对属于同一个数据报的分片进行排序。
- 当所有的分片都到达并正确排序后,IP 层会将这些分片重新组装成一个完整的 IP 数据报。
3. 传递给上层协议
- 组装好的 IP 数据报会传递给上层的协议进行处理。
如何确定分片是齐的:当前分片片偏移 + 自己的长度 = 下一片的片偏移! 我们最后只需要根据顺序遍历一遍所有分片即可。
2.3 如何和为什么要避免分片
我们不建议分片和组装,第一个是慢!第二点是只要丢一个分片都算丢包,因为分片和组装是网络层的事,觉定要不要发送是传输层的事情,如果分片丢失,那么传输层只能完整重传报文,这么做会增加丢包概率!!
但是是否要分片 不是网络层决定的!是他上层决定的,传输层给他多大他就必须处理多大!这也就是为什么 传输层在滑动窗口里是一小段一小段发送的!就是为了减少分片和组装!!(因为你数据链路层规定MTU是1500,不代表别的路由器规定不会小于1500)
所以说 如果TCP和IP采用标准报头长度的话!TCP数据最大就是1460(称为MSS 最大段尺寸!)
即双方通信的时候 如果双方能得知对方的MSS就能保证以更好的效率进行传输,那么怎么得到对方的MSS呢? 其实在三次握手的时候,TCP的报头选项里面有字段专门传输MSS。