目录
[1. 介绍 Spring AI Alibaba](#1. 介绍 Spring AI Alibaba)
[2. 多模态](#2. 多模态)
[3. 文生图(同步调用)](#3. 文生图(同步调用))
[4. 语音合成(实时合成)](#4. 语音合成(实时合成))
[4.1 语音合成的概念](#4.1 语音合成的概念)
[4.2 实战(单向流式调用)](#4.2 实战(单向流式调用))
[5. 语音识别](#5. 语音识别)
[5.1 语音识别概念](#5.1 语音识别概念)
[5.2 实战(非流式调用)](#5.2 实战(非流式调用))
[5.3 实战( 双向流式调用:基于回调 (识别传入麦克风的声音) )](#5.3 实战( 双向流式调用:基于回调 (识别传入麦克风的声音) ))
[6. 视频生成与编辑](#6. 视频生成与编辑)
[6.1 视频生成与编辑 概念](#6.1 视频生成与编辑 概念)
[6.2 万相3.0 系列 相关](#6.2 万相3.0 系列 相关)
[6.3 文生视频(同步/异步)](#6.3 文生视频(同步/异步))
[6.4 图生视频](#6.4 图生视频)
[6.4.1 基于首帧生成](#6.4.1 基于首帧生成)
[6.4.2 基于首尾帧生成](#6.4.2 基于首尾帧生成)
[6.5 全模态参考生视频](#6.5 全模态参考生视频)
1. 介绍 Spring AI Alibaba
Spring AI Alibaba是基于Spring AI 研发,用更高层级API帮助开发者简化AI应用开发。开发者通过dashscope调用阿里百炼云平台上的大模型。
阿里百炼云平台是一个饭店,dashscope就像店里面的厨师,用户在前台点菜,厨师做完菜你才能拿到。意思是:dashscope是阿里百炼的引擎,用户调用的模型都是它在返回给你。
dashscope sdk 和 open ai一样都是独立的,dashscope 不依赖、不兼容 open ai,它也不只在spring boot框架中使用,在什么地方都可以,别的语言中也可以使用。强调一点:
spring-ai-alibaba-starter-dashscope 是原生dashscope sdk的高级封装,但它是已经开源了,社区维护版本更新速度相对于原生sdk来说它会慢得多,就导致许多官方新鲜玩意它没有。下面都用目前最新的 dashscope-sdk-java 2.22.262. 多模态
多模态指的是 模型 同时理解和处理文本、图像、音频和其他数据格式信息的能力。Spring AI官方提供了Message API,它提供了多模态大语言模型(LLM)所需的所有抽象。
多模态就像人的感官。人有 听、说、看、写等感知,模型包含两种及以上感官能力的就叫多模态,包含全部感官的就叫"全模态"
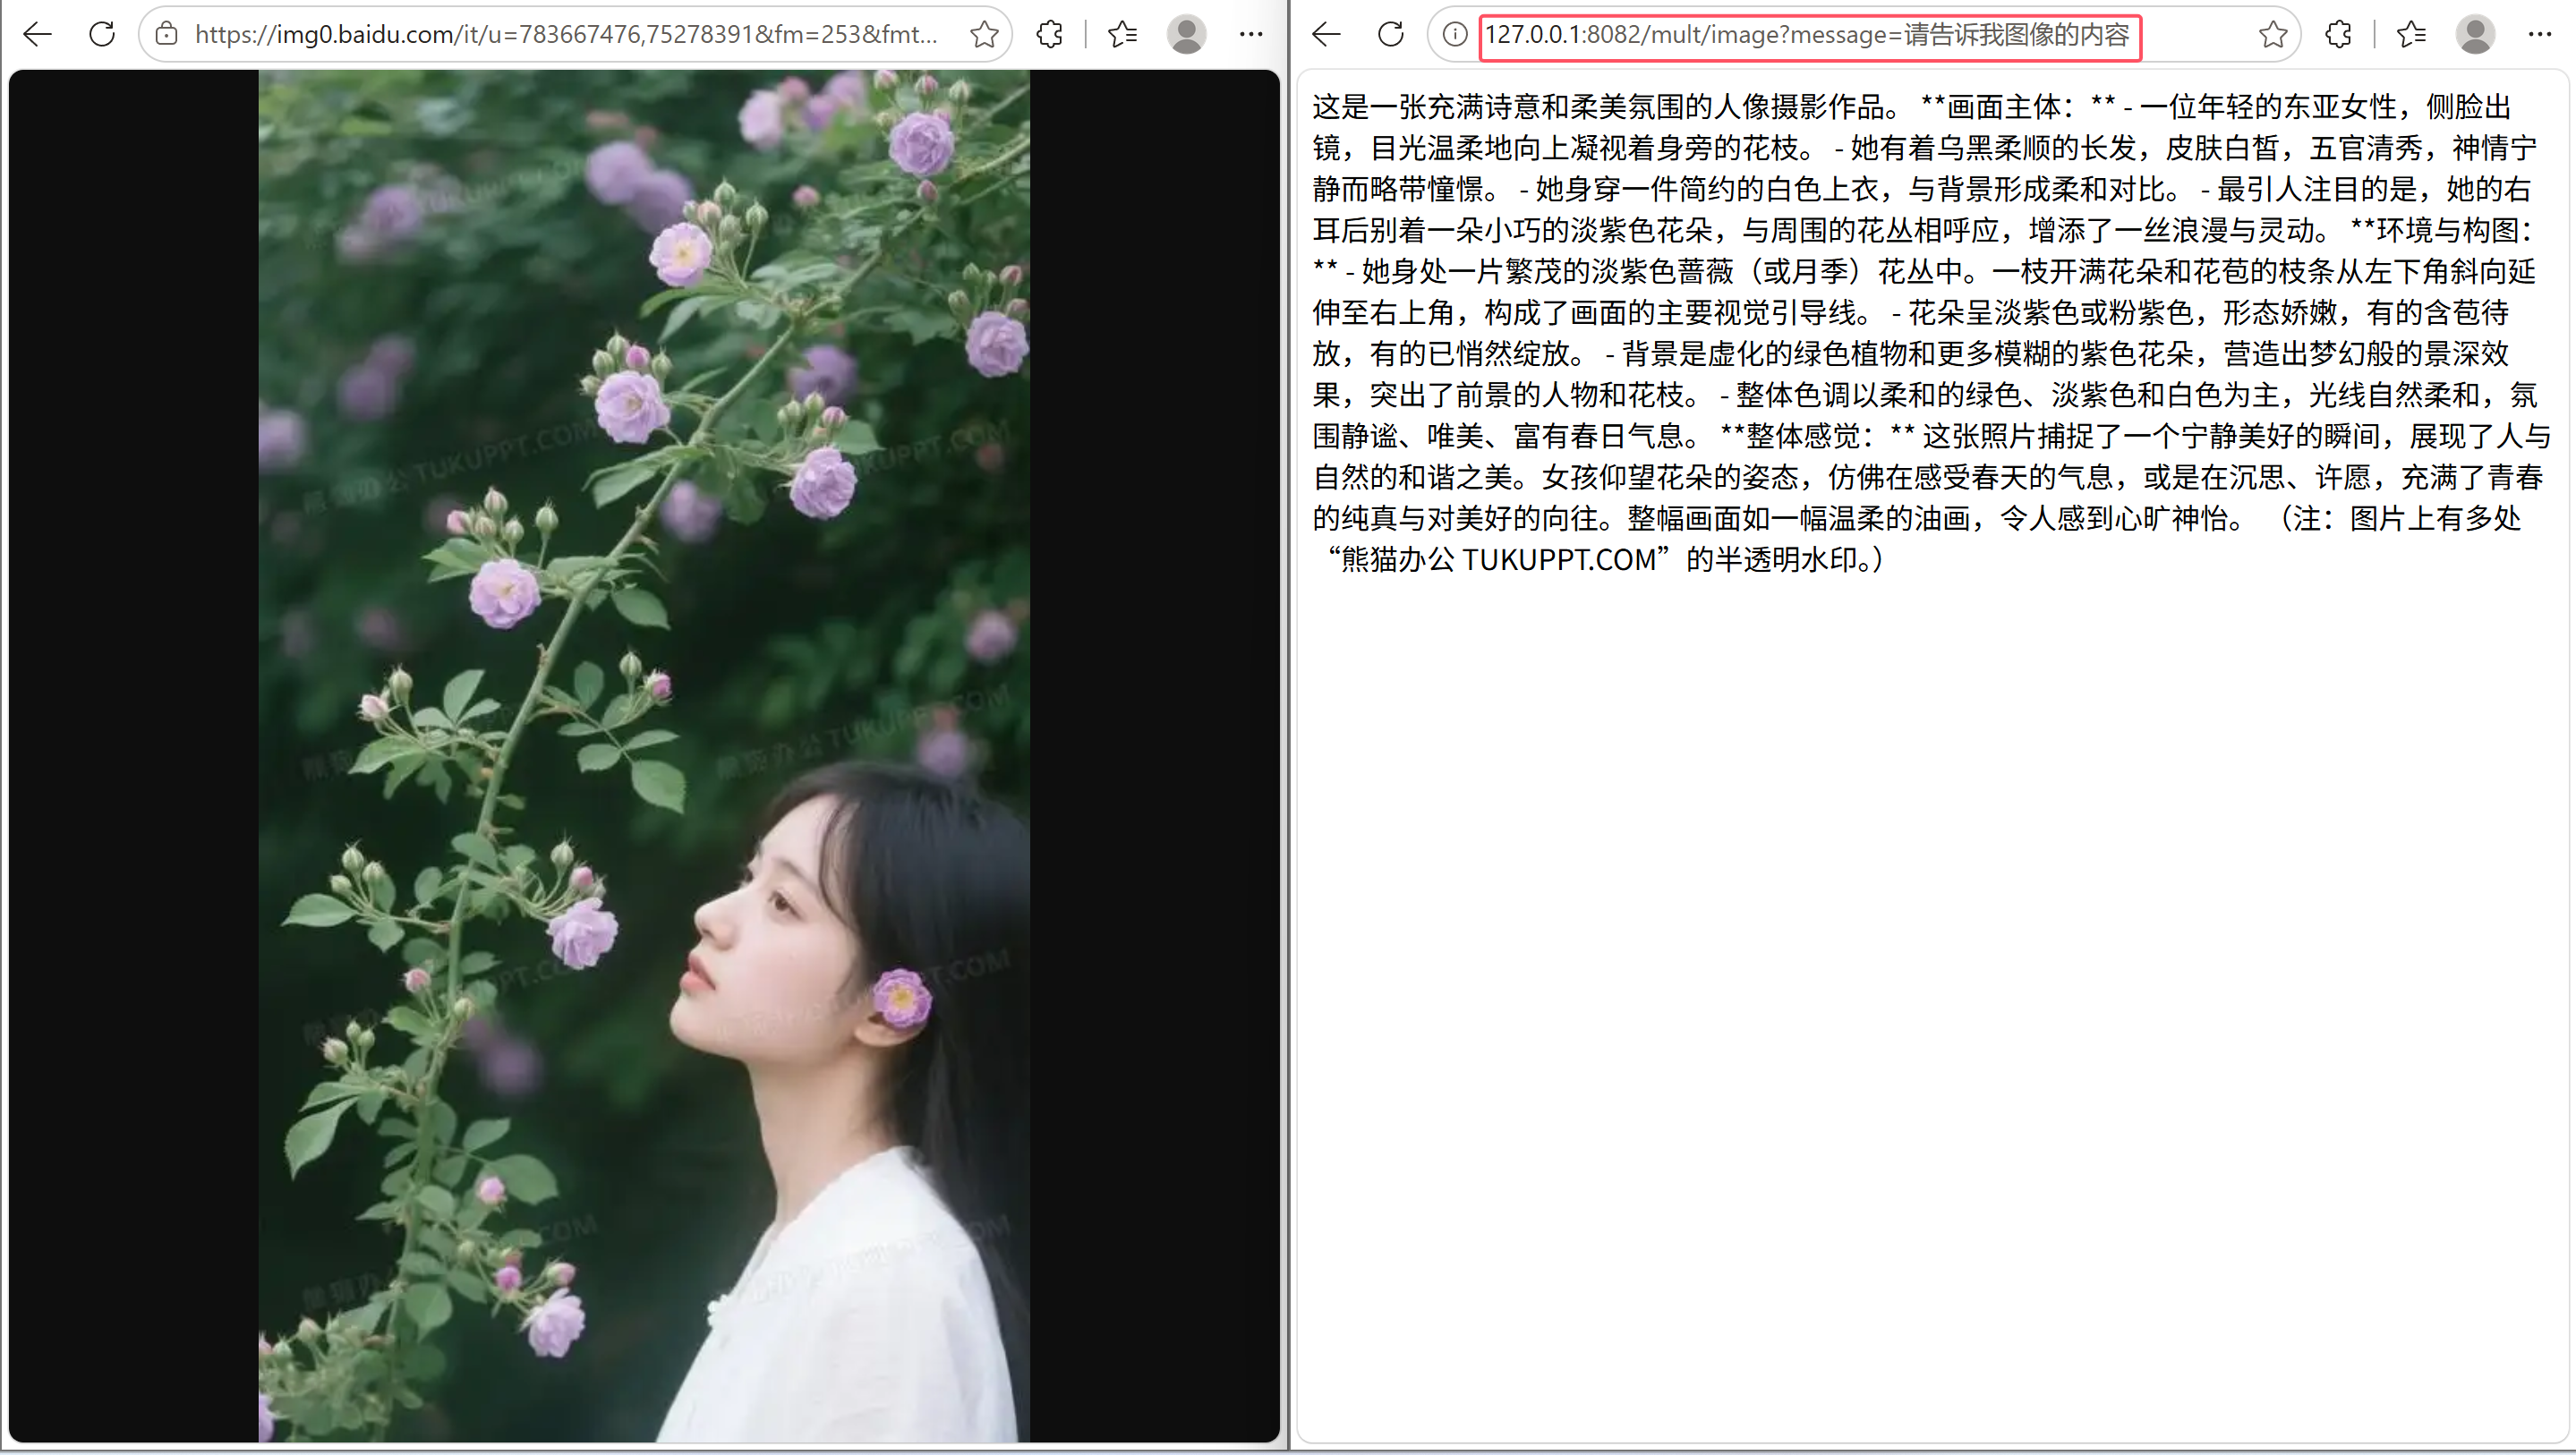
多模态示例:用户可通过 文字描述 生成音频,可通过文字(或加上图像、视频给AI读取作为参考)生成图像、视频,示例很多总之就是感官之间的相互搭配。下面代码示例:"给AI图片,通过文字叫它告诉我图片的内容 (视觉理解)"
controller层代码: 巨蛇神/JavaEE进阶 - 码云 - 开源中国
pom.xml代码: 巨蛇神/JavaEE进阶 - 码云 - 开源中国
application.yml配置: 巨蛇神/JavaEE进阶 - 码云 - 开源中国
java
    private final ChatClient chatClient;
    //构造注入
    public MultiModelController(ChatClient.Builder builder) {
        this.chatClient = builder.build();
    }

    @RequestMapping("/image")
    public String image(String message) throws URISyntaxException, MalformedURLException {
        String url = "https://img0.baidu.com/it/u=783667476,75278391&fm=253&fmt=auto&app=138&f=JPEG?w=500&h=889";
//        String url = "https://img.shetu66.com/2023/07/19/1689756946086335.jpg";
//        String url="https://pic.rmb.bdstatic.com/bjh/news/116367f183dd830ed1fdb3feec901d48.png";
        //传入图片URL来解析图片,不会被 MediaType 影响;图片中会包含数据格式标识,模型会根据标识解析。
        //但是传入base64、byte[]、本地 Resource,MediaType 就很重要的是!
        List<Media> medias = List.of(new Media(MediaType.IMAGE_JPEG,new URI(url).toURL().toURI()));
        //定义用户提示词
        UserMessage user = UserMessage.builder()
                .text(message)
                .media(medias)
                .build();
        //调用大模型
        String content = chatClient.prompt(new Prompt(user))
                .call()
                .content();
        return content;
    }
3. 文生图(同步调用)
阿里百炼云平台提供自研的千问(Qwen)系列和万象(Wan)系列模型,可进行文生图。目前 wan2.7-image-pro 和 wan2.7-image 及 wan2.6系列无法使用 spring-ai-alibaba-starter-dashscope 依赖使用。(spring-ai-alibaba-starter-dashscope是对原生 dashscope-sdk-java的封装,此时可能模型更新太快封装速度没跟上)
只能通过原生 dashscope-sdk-java 使用最新的万象 "wan2.7-image-pro"。
同、异步调用官方都有示例:万相-图像生成与编辑2.7 API参考 - 阿里云百炼
所需依赖: 巨蛇神/JavaEE进阶 - 码云 - 开源中国
所需配置: dashscope-sdk-java 不是spring框架的产物,不能在配置文件中配置api-key和模型等。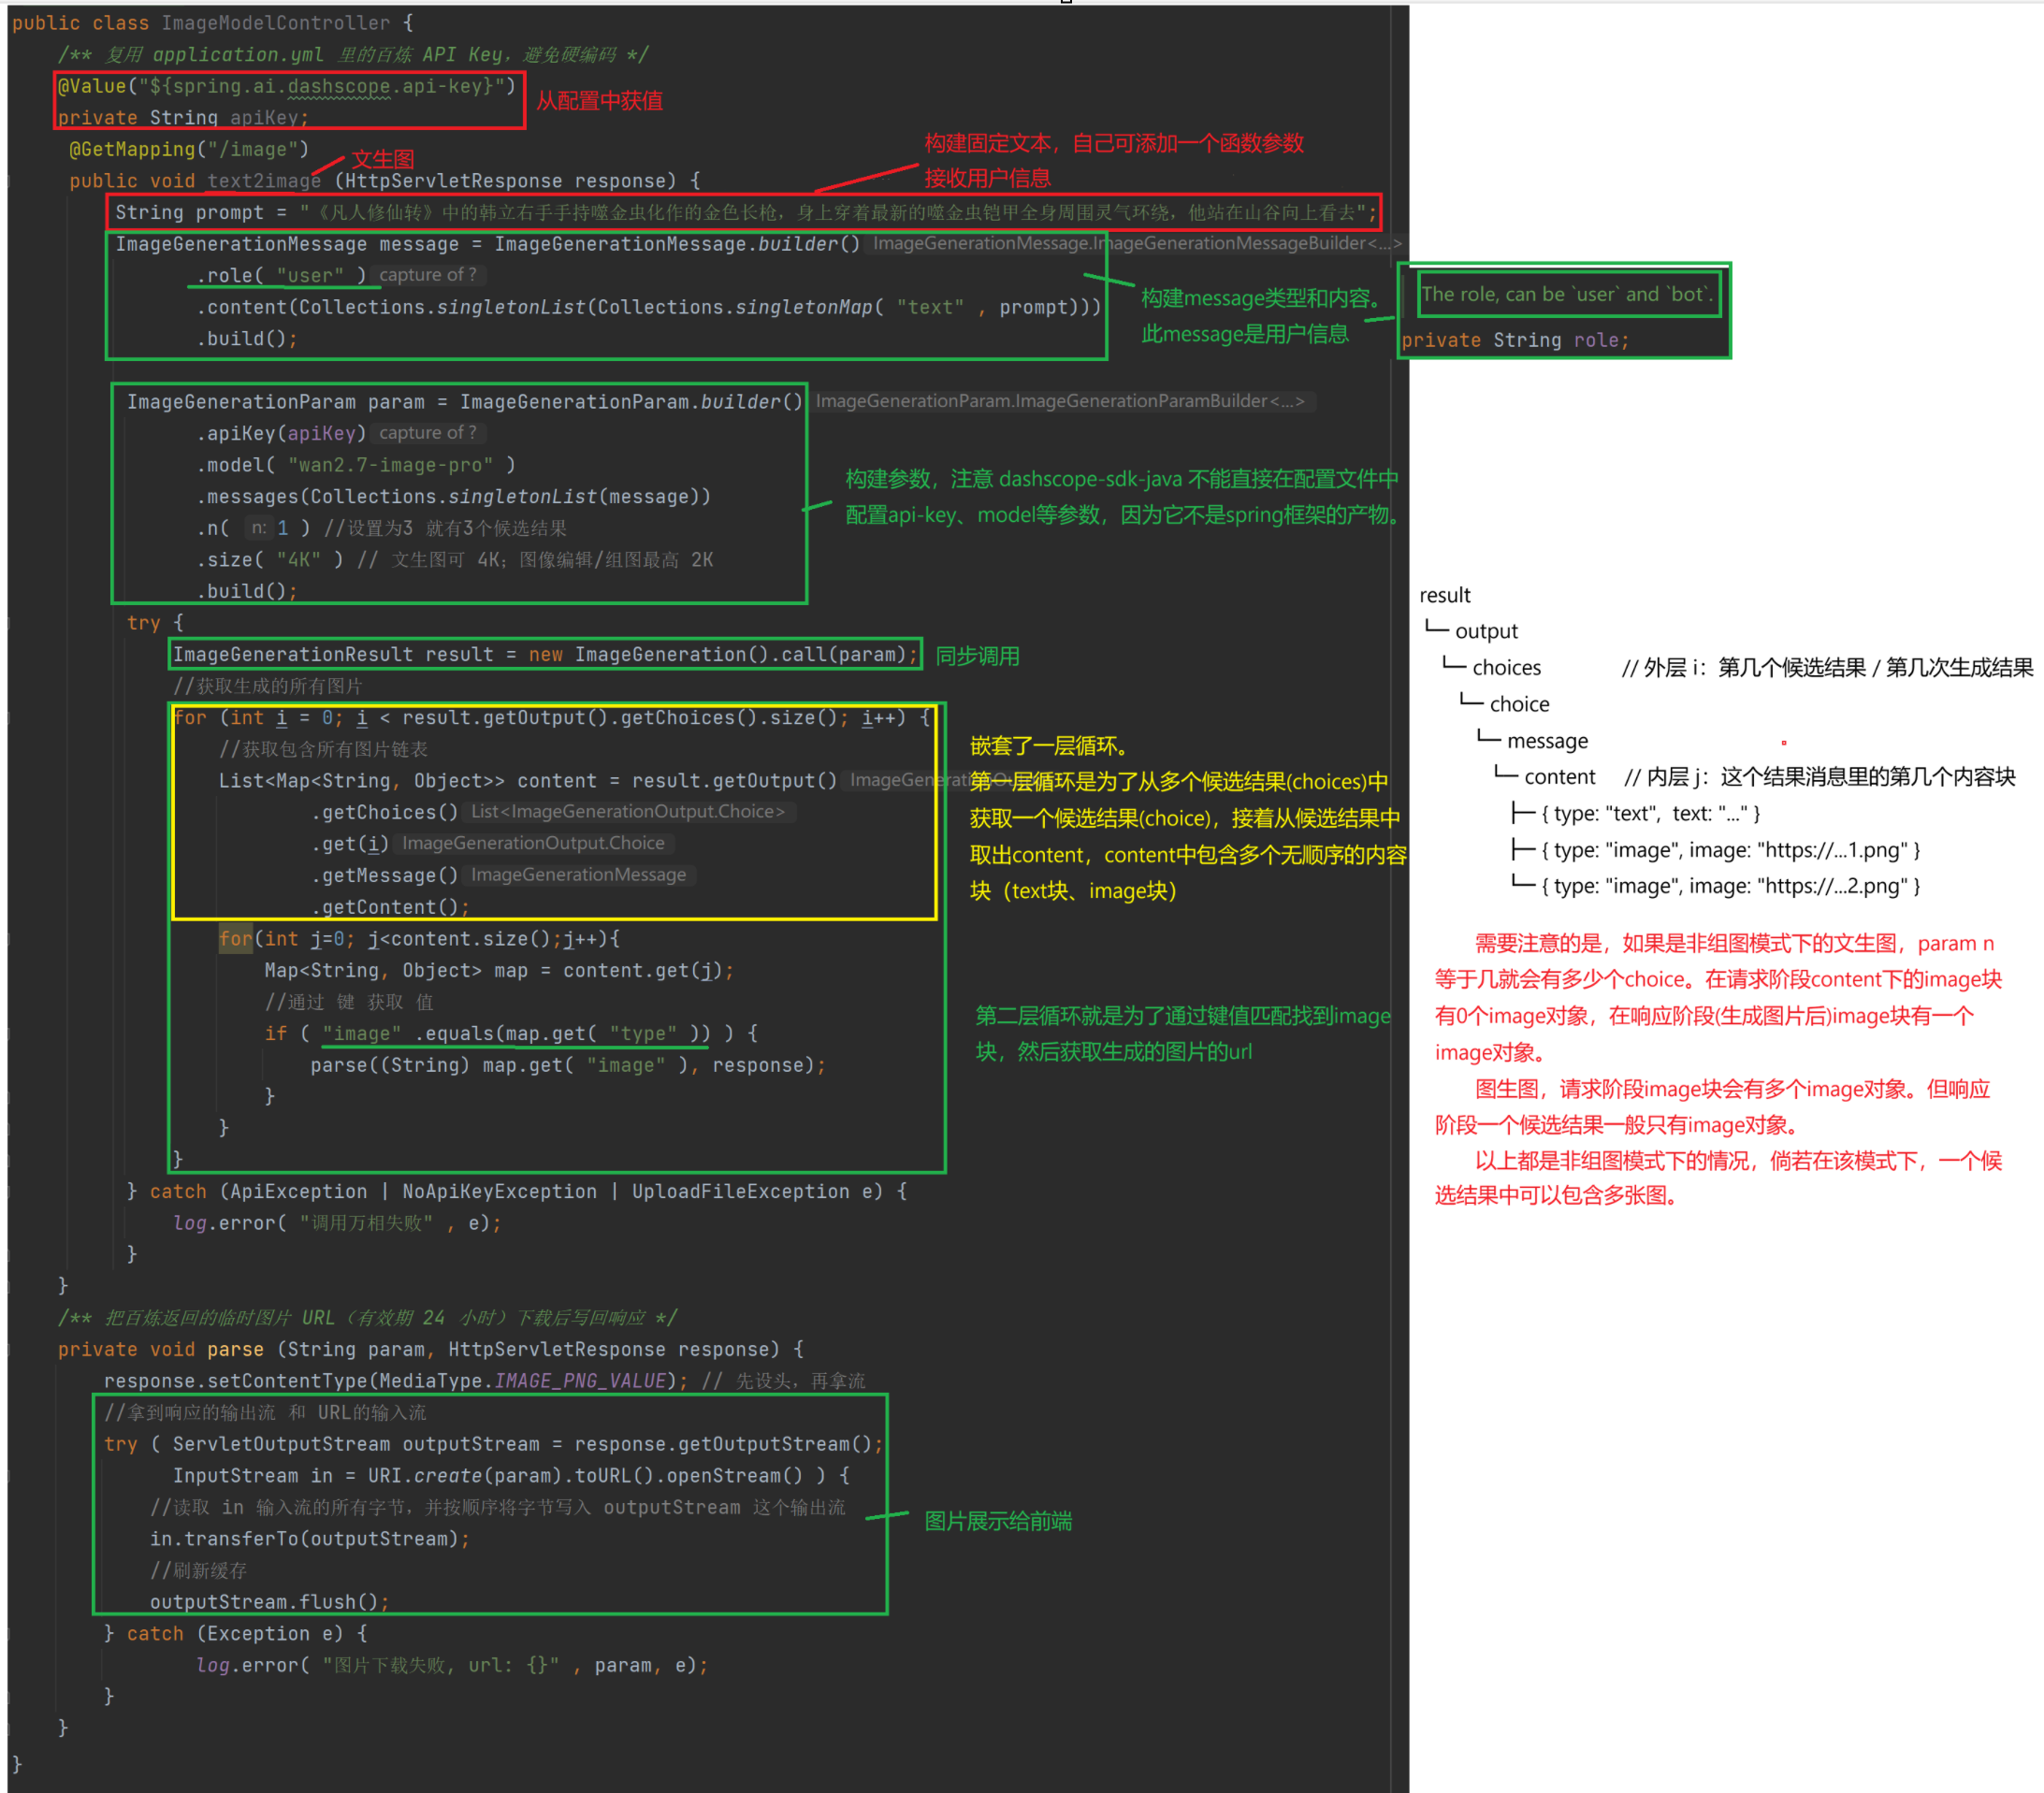
下面生成的图片虽然一点也不像韩立,但可以传几张图片给模型作为参考再生成;
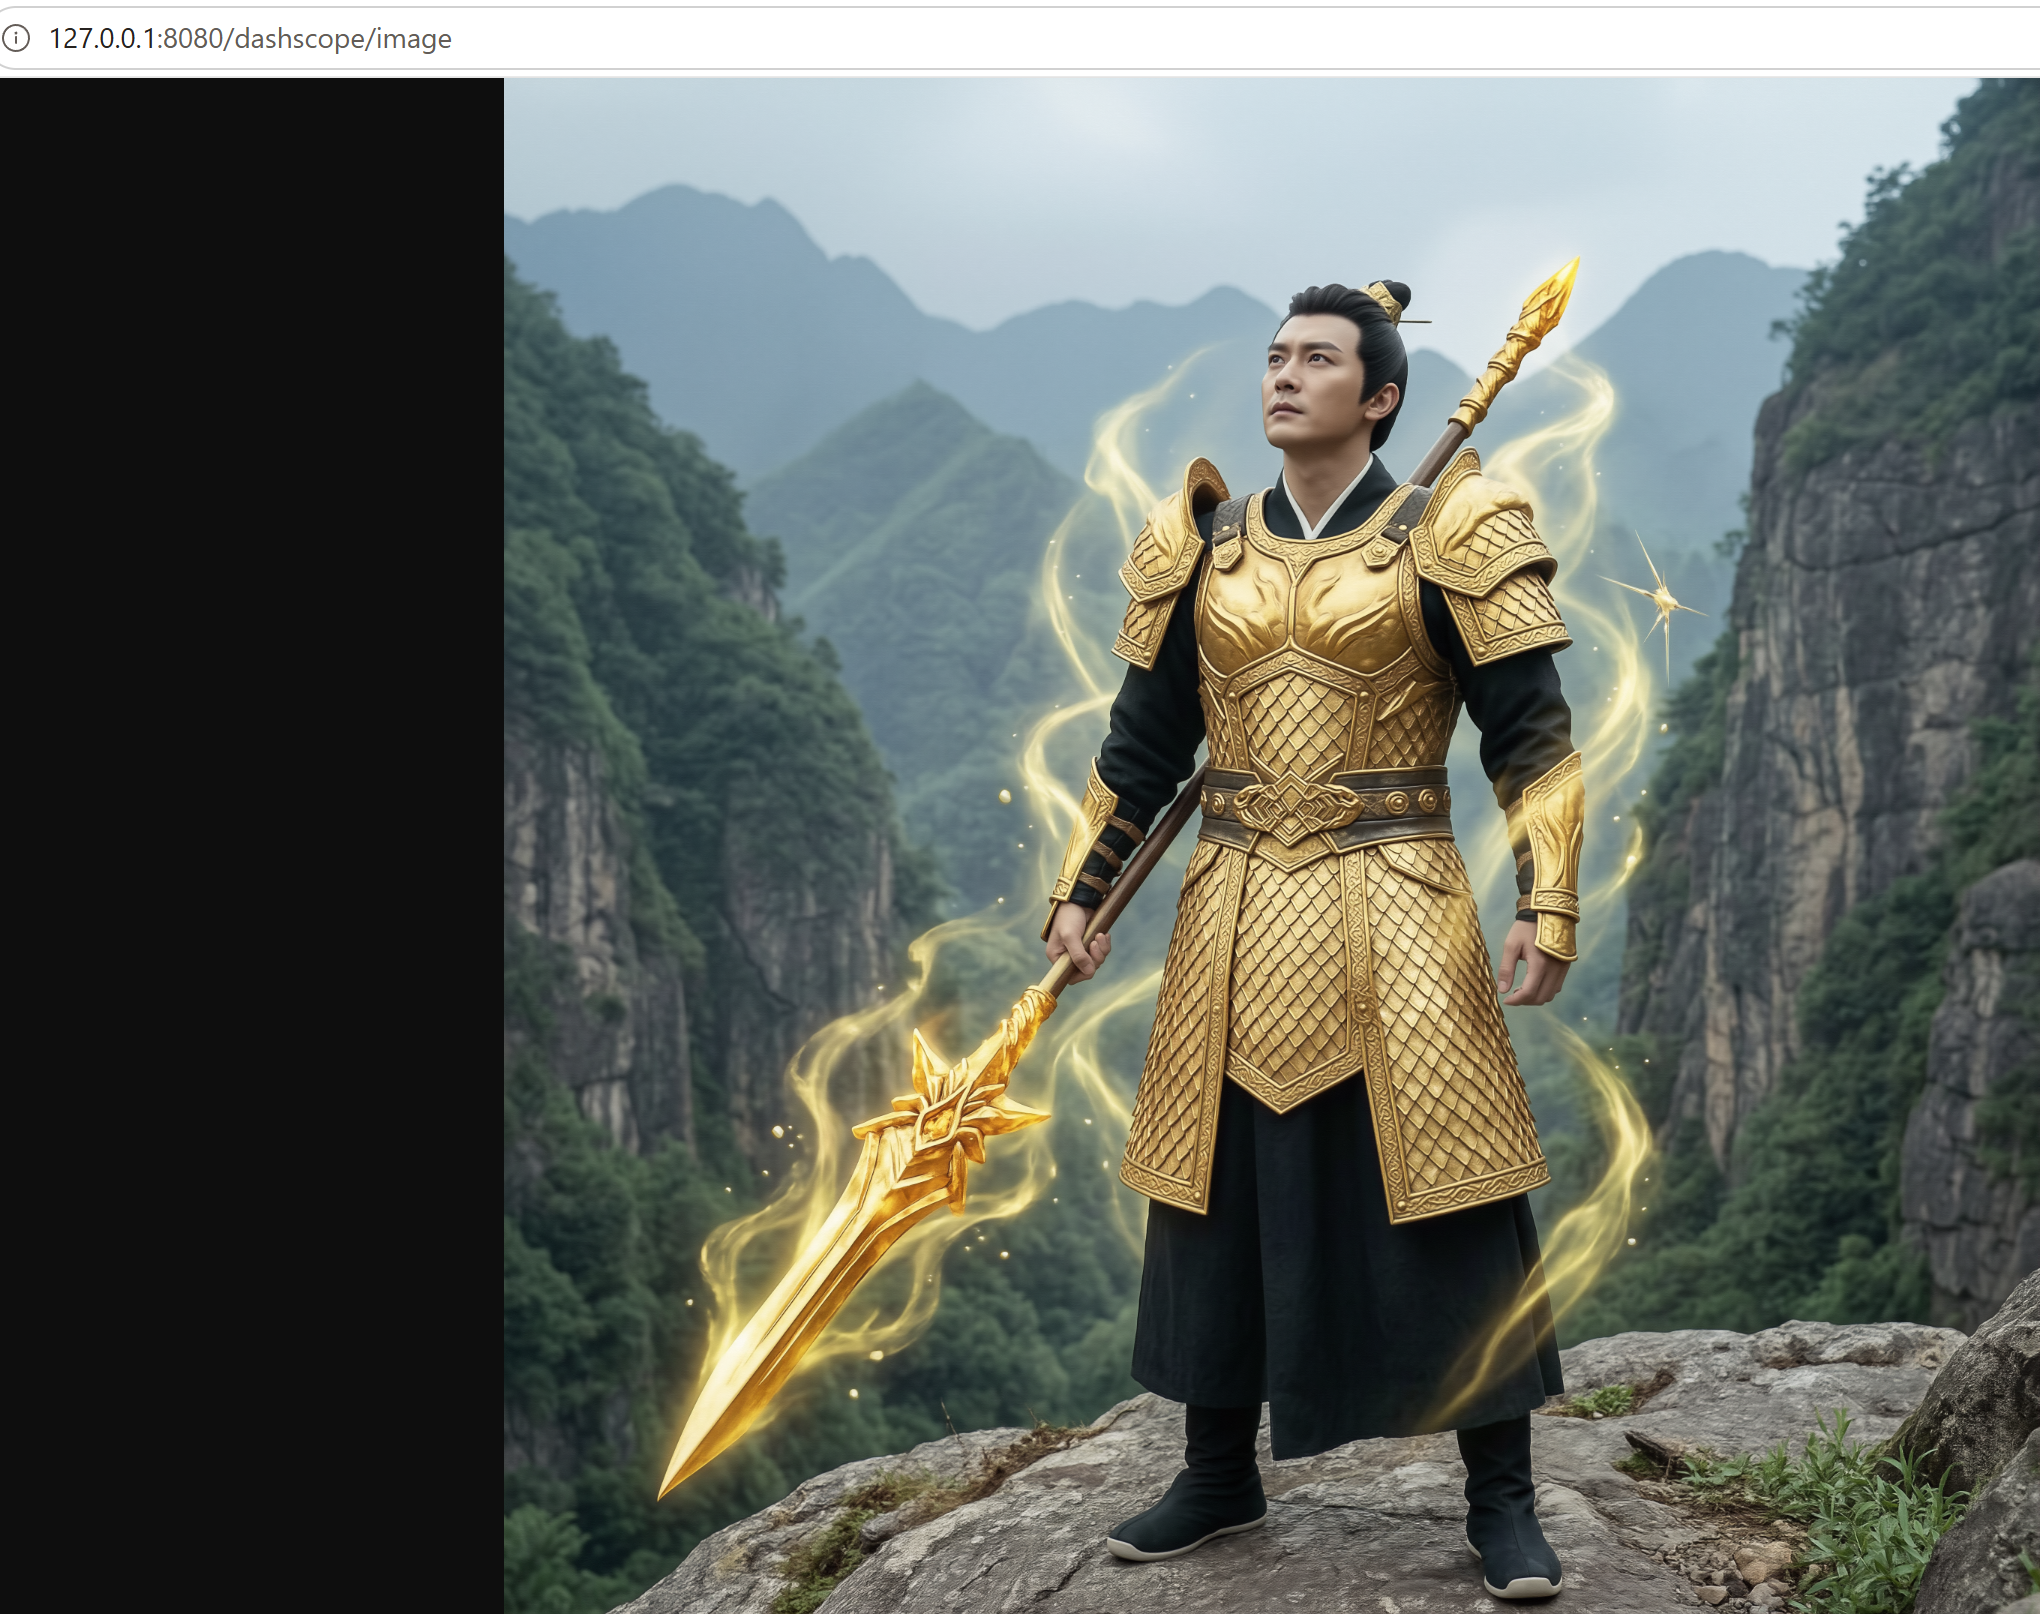
温馨提醒:wan2.7-image-pro 文生图代码稍微修改就能图生图。在构建参数时,组图生成参数:
parameters.enable_sequential(bool,默认为 false)。仅wan2.7-image-pro和wan2.7-image支持,Qwen系列不可用。开启组图模式时,thinking_mode和color_palette参数不可用。更多参数细节:万相-图像生成与编辑2.7 API参考 - 阿里云百炼
若用 spring-ai-alibaba-starter-dashscope依赖生图非常简单,还可以在yml文件中直接配置模型相关参数,详细可见:
controller层:巨蛇神/JavaEE进阶 - 码云 - 开源中国
所需依赖:
java
    <dependencies>
        <dependency>
            <groupId>com.alibaba.cloud.ai</groupId>
            <artifactId>spring-ai-alibaba-starter-dashscope</artifactId>
        </dependency>
        <!-- 必需 -->
        <dependency>
            <groupId>org.springframework</groupId>
            <artifactId>spring-webflux</artifactId>
        </dependency>
    </dependencies>

    <!-- spring-ai-alibaba-starter-dashscope 1.0.0.2以后bom换成了spring-ai-extensions-bom -->
    <dependencyManagement>
        <dependencies>
            <dependency>
                <groupId>com.alibaba.cloud.ai</groupId>
                <artifactId>spring-ai-alibaba-bom</artifactId>
                <version>1.0.0.2</version>
                <type>pom</type>
                <scope>import</scope>
            </dependency>
        </dependencies>
    </dependencyManagement>
4. 语音合成(实时合成)
4.1 语音合成的概念
语音合成指的是Text To Speech(TTS),也就是文本转语音。TTS生成的音频只有一个音色,也是就是只有一个人在说话。但是音频合成可以一同营造周围环境的声音,比如,"两个人正在说话,旁边有鸟在鸣叫、大爷在唱歌"
- 目前阿里百炼语音合成主要有三款系列模型
- Qwen-Audio-TTS / CosyVoice / Qwen 系列模型
- Qwen-Audio-TTS/CosyVoice 系列模型使用同一模型名称同时支持 WebSocket 和 HTTP 两种接入方式;Qwen 系列模型通过模型名称区分,带
-realtime后缀的为 WebSocket 接入,不带后缀的为 HTTP 接入。 - CosyVoice 系列模型还支持通过 AOQ 协议接入;
- 各模型系列的各个版本都有对应可使用的音色,版本甚至系列之间的音色混用。
- 目前几乎只有Qwen-Audio-TTS / CosyVoice 支持使用声音复刻 和使用声音设计
注:
- 使用声音复刻:当已有目标人物的录音素材,希望在合成中还原该音色时。
- 使用声音设计:当没有录音素材,希望根据文字描述从零创建全新音色时。
4.2 实战(单向流式调用)
使用模型:qwen-audio-3.1-tts-flash
需添依赖:
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-web</artifactId>
</dependency>
<dependency>
    <groupId>com.alibaba</groupId>
    <artifactId>dashscope-sdk-java</artifactId>
    <version>2.22.26</version>
</dependency>
java
package com.jusheshen.alibaba.controller;

import com.alibaba.dashscope.audio.tts.SpeechSynthesisResult;
import com.alibaba.dashscope.audio.ttsv2.SpeechSynthesisParam;
import com.alibaba.dashscope.audio.ttsv2.SpeechSynthesizer;
import com.alibaba.dashscope.common.ResultCallback;

import java.io.*;
import java.time.LocalDateTime;
import java.time.format.DateTimeFormatter;
import java.util.concurrent.CountDownLatch;

class TimeUtils {
    private static final DateTimeFormatter formatter =
            DateTimeFormatter.ofPattern("yyyy-MM-dd HH:mm:ss.SSS");

    public static String getTimestamp() {
        return LocalDateTime.now().format(formatter);
    }
}

public class AudioTTSController {
    // 模型
    private static String model = "qwen-audio-3.0-tts-flash";
    // 音色
    private static String voice = "longanhuan_v3.6";
    //音频存储的文件路径
    public static String audioFileLoad = System.getProperty("user.dir")+"/audio.mp3";
    //File
    private static final File file = new File(audioFileLoad);

    public static void streamAudioDataToSpeaker() {
        CountDownLatch latch = new CountDownLatch(1);

        // 实现回调接口ResultCallback
        ResultCallback<SpeechSynthesisResult> callback = new ResultCallback<SpeechSynthesisResult>() {
            @Override
            public void onEvent(SpeechSynthesisResult result) {
                if (result.getAudioFrame() != null) {
                    // 此处实现保存音频数据到本地的逻辑
                    try(OutputStream output = new FileOutputStream(file,true)){//每帧都会重新打开 OutputStream ,设置为true前面的帧才不会被覆盖
                        //获取音频字节数组,并写入文件
                        output.write(result.getAudioFrame().array());
                        //刷新缓冲区,数据真正写入文件
                        output.flush();
                    }catch (FileNotFoundException e) {
                        throw new RuntimeException(e);
                    } catch (IOException e) {
                        throw new RuntimeException(e);
                    }
                    System.out.println(TimeUtils.getTimestamp() + " 收到音频");
                }
                // 获取输出信息,包含事件类型和原始文本
                if (result.getOutput() != null && result.getOutput().has("type")) {
                    System.out.println("事件类型: " + result.getOutput().get("type").getAsString()
                            + ", 原始文本: " + (result.getOutput().has("original_text") ? result.getOutput().get("original_text").getAsString() : ""));
                }
            }

            @Override
            public void onComplete() {
                System.out.println(TimeUtils.getTimestamp() + " 收到Complete,语音合成结束");
                latch.countDown();
            }

            @Override
            public void onError(Exception e) {
                System.out.println("出现异常:" + e.toString());
                latch.countDown();
            }
        };

        // 请求参数
        SpeechSynthesisParam param =
                SpeechSynthesisParam.builder()
                        // 新加坡和北京地域的API Key不同。获取API Key:https://help.aliyun.com/zh/model-studio/get-api-key
                        // 若没有配置环境变量,请用百炼API Key将下行替换为:.apiKey("sk-xxx")
                        .apiKey(System.getenv("DASHSCOPE_API_KEY"))
                        .model("qwen-audio-3.1-tts-flash") // 模型
                        .voice("loongstella_v3.1") // 音色
                        .build();
        // 第二个参数"callback"传入回调即启用异步模式
        SpeechSynthesizer synthesizer = new SpeechSynthesizer(param, callback);
        // 非阻塞调用,立即返回null(实际结果通过回调接口异步传递),在回调接口的onEvent方法中实时获取二进制音频
        try {
            synthesizer.call("今天天气怎么样?");
            // 等待合成完成
            latch.await();
            // 等待播放线程全部播放完
        } catch (Exception e) {
            throw new RuntimeException(e);
        } finally {
            // 任务结束后关闭websocket连接
            synthesizer.getDuplexApi().close(1000, "bye");
        }
        // 首次发送文本时需建立 WebSocket 连接,因此首包延迟会包含连接建立的耗时
        System.out.println(
                "[Metric] requestId为:"
                        + synthesizer.getLastRequestId()
                        + ",首包延迟(毫秒)为:"
                        + synthesizer.getFirstPackageDelay());
    }

    public static void main(String[] args) {
        // 以下为华北2(北京)地域的配置,调用时请将"{WorkspaceId}"替换为真实的业务空间ID,各地域的配置不同。
//        Constants.baseWebsocketApiUrl = "wss://{WorkspaceId}.cn-beijing.maas.aliyuncs.com/api-ws/v1/inference";
        streamAudioDataToSpeaker();
        //关闭进程
        System.exit(0);
    }
}SpeechSynthesizer是语音合成的一个重要类,想进一步了解它可到:Qwen-Audio-TTS Java SDK - 阿里云百炼
更多示例在:alibabacloud-bailian-speech-demo/samplesGitHub
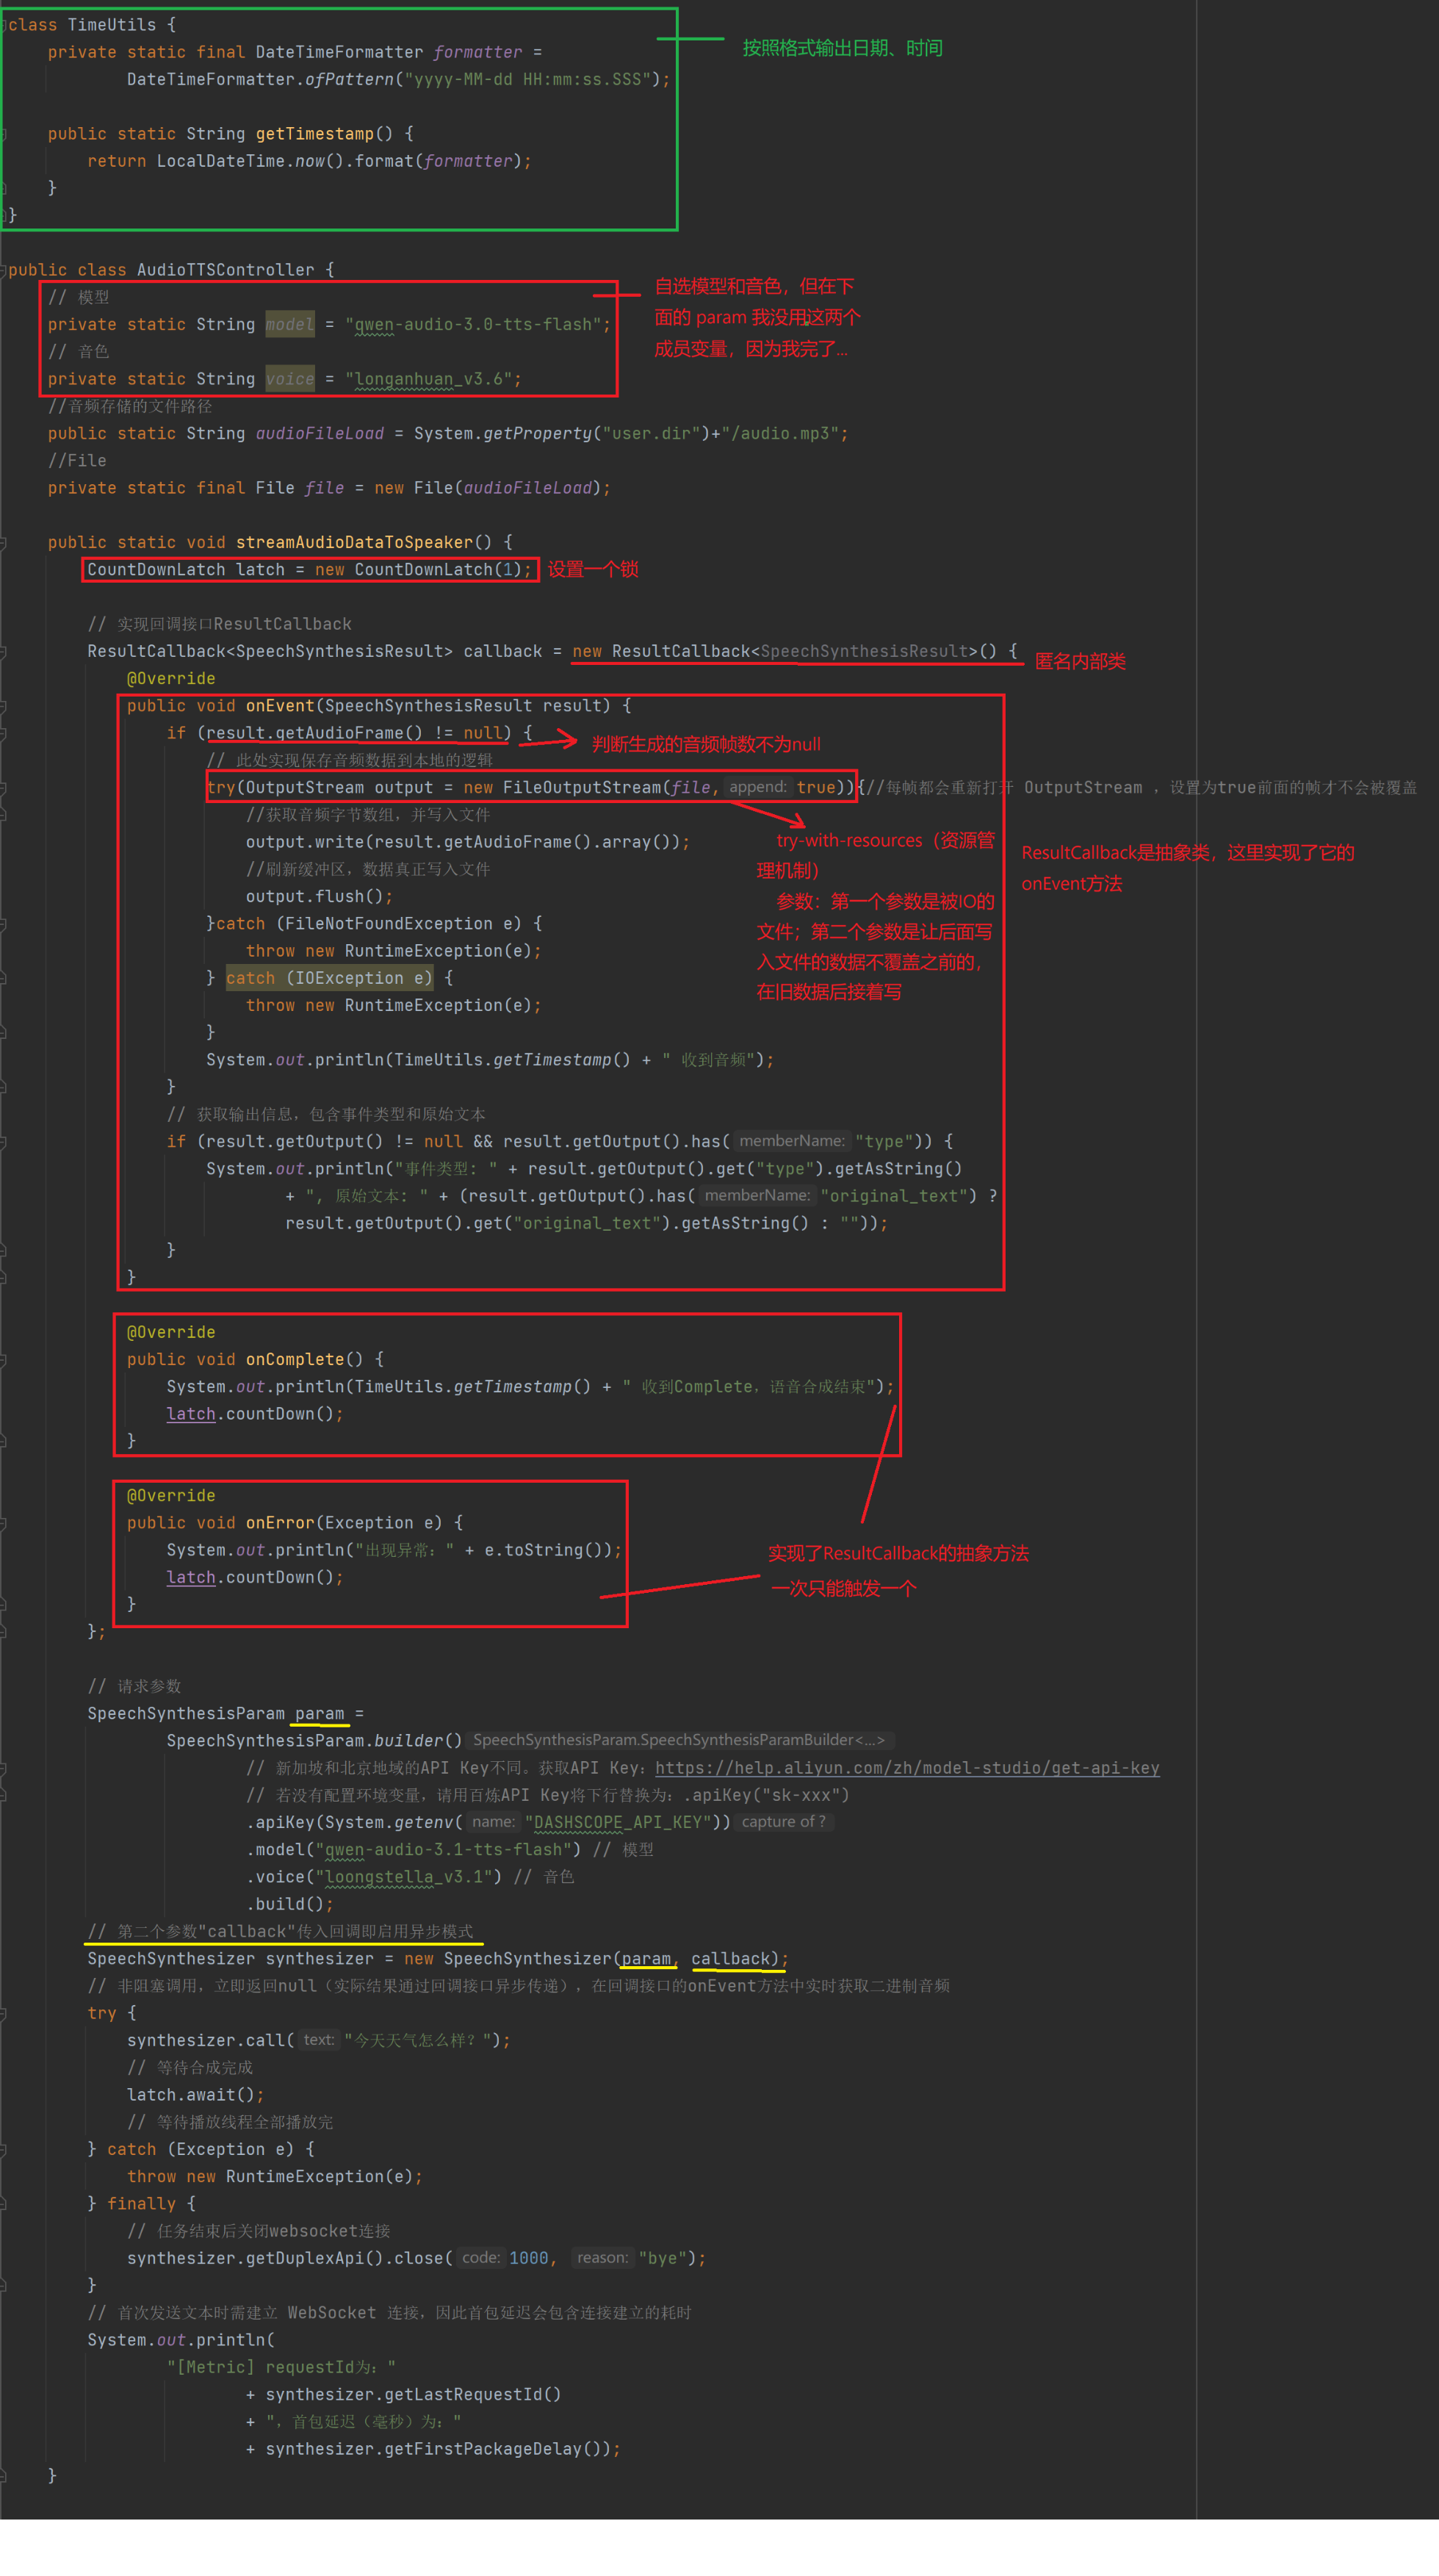
上面代码的解析补充,但其实也没补充些啥:
5. 语音识别
5.1 语音识别概念
语音识别指的是Speech To Text(STT),也就是语音转文本,与语音合成相反。
- 模型有如下功能:
- 实时识别 和 非实时识别
- 处理专业术语。多个领域可能出现相同的术语,在系统提示词中描述你的领域背景,模型在每次请求时自适应。
- 说话人声分离。归类哪些人说了哪些话。
一个模型可能有多个功能,但也可能你想要的功能们在一个模型上没有,比如"实时人声分离"目前没有一个模型同时拥有。(现:2026/10/1)
阿里云百炼官方:语音识别概述 - 阿里云百炼
5.2 实战(非流式调用)
所需依赖与语音生成一样。
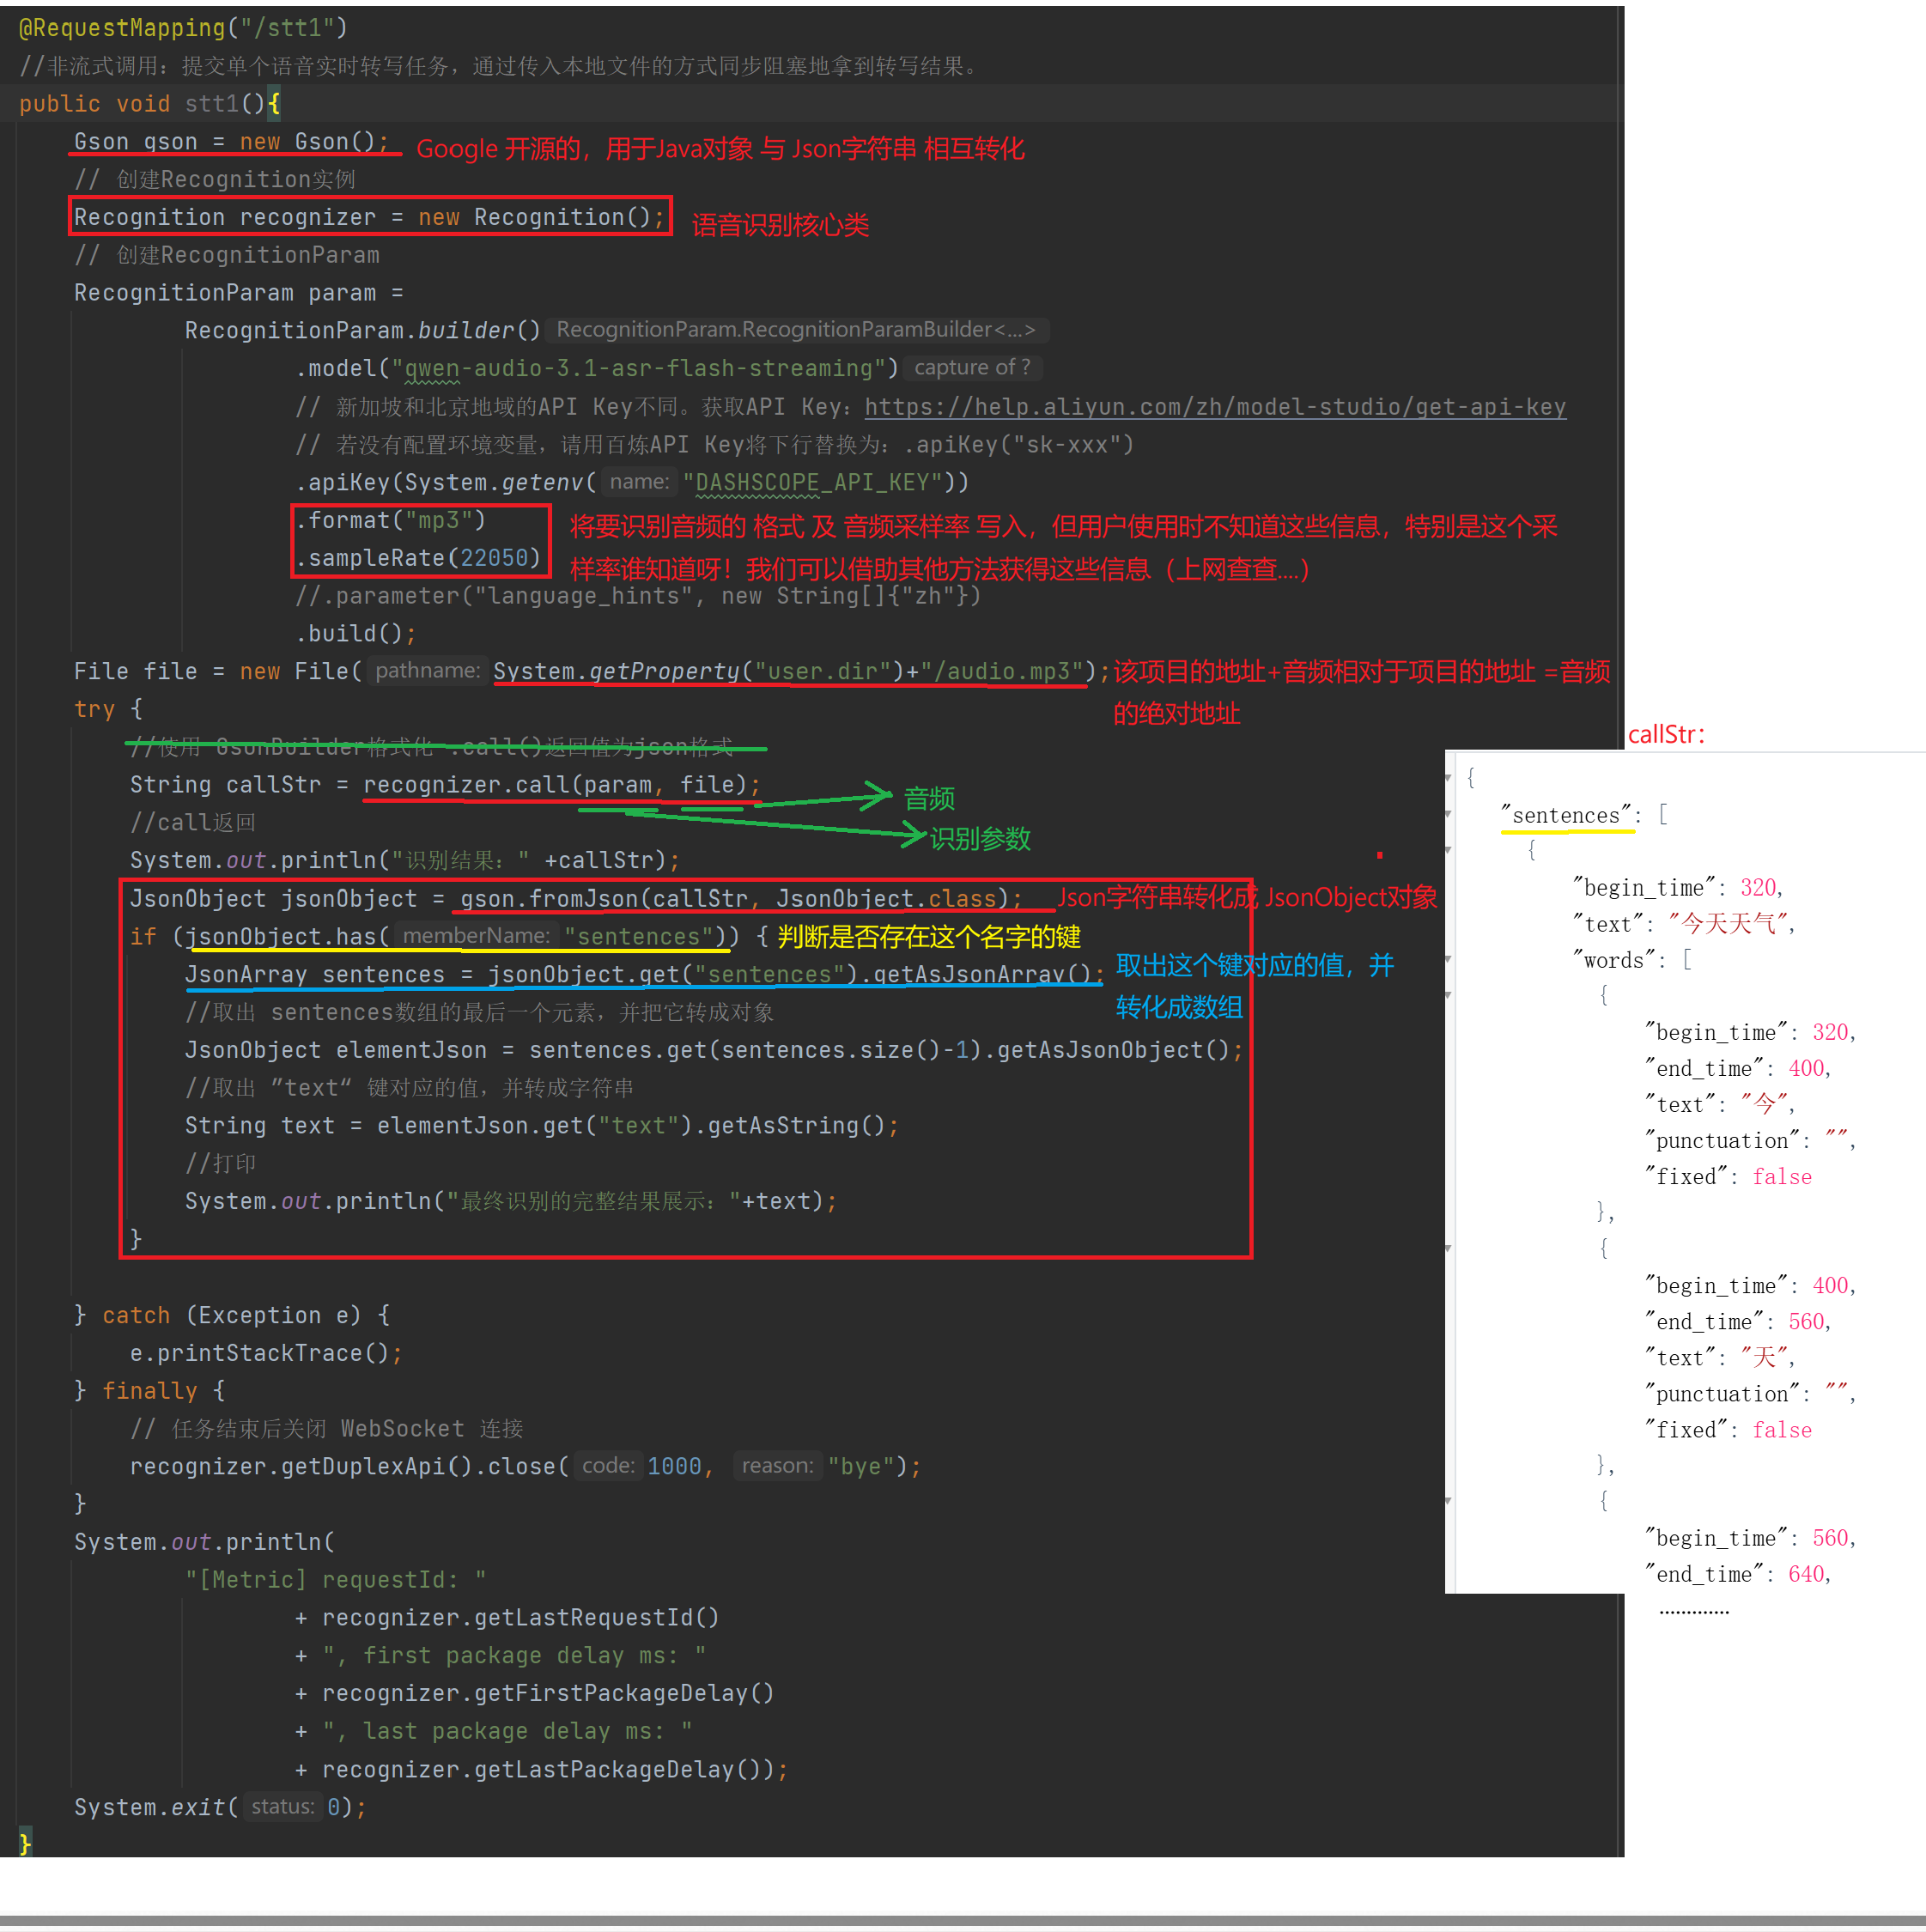
notice :不同模型在RecognitionParam param手动配置参数方面可能不完全一致,例如下面的"qwen-audio-3.1-asr-flash-streaming" 的参数需要手动写入将要识别音频的采样率。
java
    @RequestMapping("/stt1")
    //非流式调用:提交单个语音实时转写任务,通过传入本地文件的方式同步阻塞地拿到转写结果。
    public void stt1(){
        Gson gson = new Gson();
        // 创建Recognition实例
        Recognition recognizer = new Recognition();
        // 创建RecognitionParam
        RecognitionParam param =
                RecognitionParam.builder()
                        .model("qwen-audio-3.1-asr-flash-streaming")
                        // 新加坡和北京地域的API Key不同。获取API Key:https://help.aliyun.com/zh/model-studio/get-api-key
                        // 若没有配置环境变量,请用百炼API Key将下行替换为:.apiKey("sk-xxx")
                        .apiKey(System.getenv("DASHSCOPE_API_KEY"))
                        .format("mp3")
                        .sampleRate(22050)
                        //.parameter("language_hints", new String[]{"zh"})
                        .build();
        File file = new File(System.getProperty("user.dir")+"/audio.mp3");
        try {
            String callStr = recognizer.call(param, file);
            //call返回
            System.out.println("识别结果:" +callStr);
            JsonObject jsonObject = gson.fromJson(callStr, JsonObject.class);
            if (jsonObject.has("sentences")) {
                JsonArray sentences = jsonObject.get("sentences").getAsJsonArray();
                //取出 sentences数组的最后一个元素,并把它转成对象
                JsonObject elementJson = sentences.get(sentences.size()-1).getAsJsonObject();
                //取出 "text" 键对应的值,并转成字符串
                String text = elementJson.get("text").getAsString();
                //打印
                System.out.println("最终识别的完整结果展示:"+text);
            }

        } catch (Exception e) {
            e.printStackTrace();
        } finally {
            // 任务结束后关闭 WebSocket 连接
            recognizer.getDuplexApi().close(1000, "bye");
        }
        System.out.println(
                "[Metric] requestId: "
                        + recognizer.getLastRequestId()
                        + ", first package delay ms: "
                        + recognizer.getFirstPackageDelay()
                        + ", last package delay ms: "
                        + recognizer.getLastPackageDelay());
        System.exit(0);
    }
上述代码进一步解析:
5.3 实战( 双向流式调用:基于回调 (识别传入麦克风的声音) )
以下是官方示例Qwen-Audio-ASR-Stream 系列模型的 "双向流式调用:基于回调" 的识别传入麦克风的声音代码,这个代码比较多,代码逻辑比较复杂,请看Gitee
AudioTranscription.stt2():巨蛇神/JavaEE进阶 - 码云 - 开源中国
utils(RealtimeRecognitionTask):巨蛇神/JavaEE进阶 - 码云 - 开源中国
notice:官方示例 Qwen-Audio-ASR-Streaming实时语音识别 没有实现如何返回给前端的代码,我的代码中简单实现了,但比较粗糙,看我下面的解析后,大家可以自行丰富或修改。
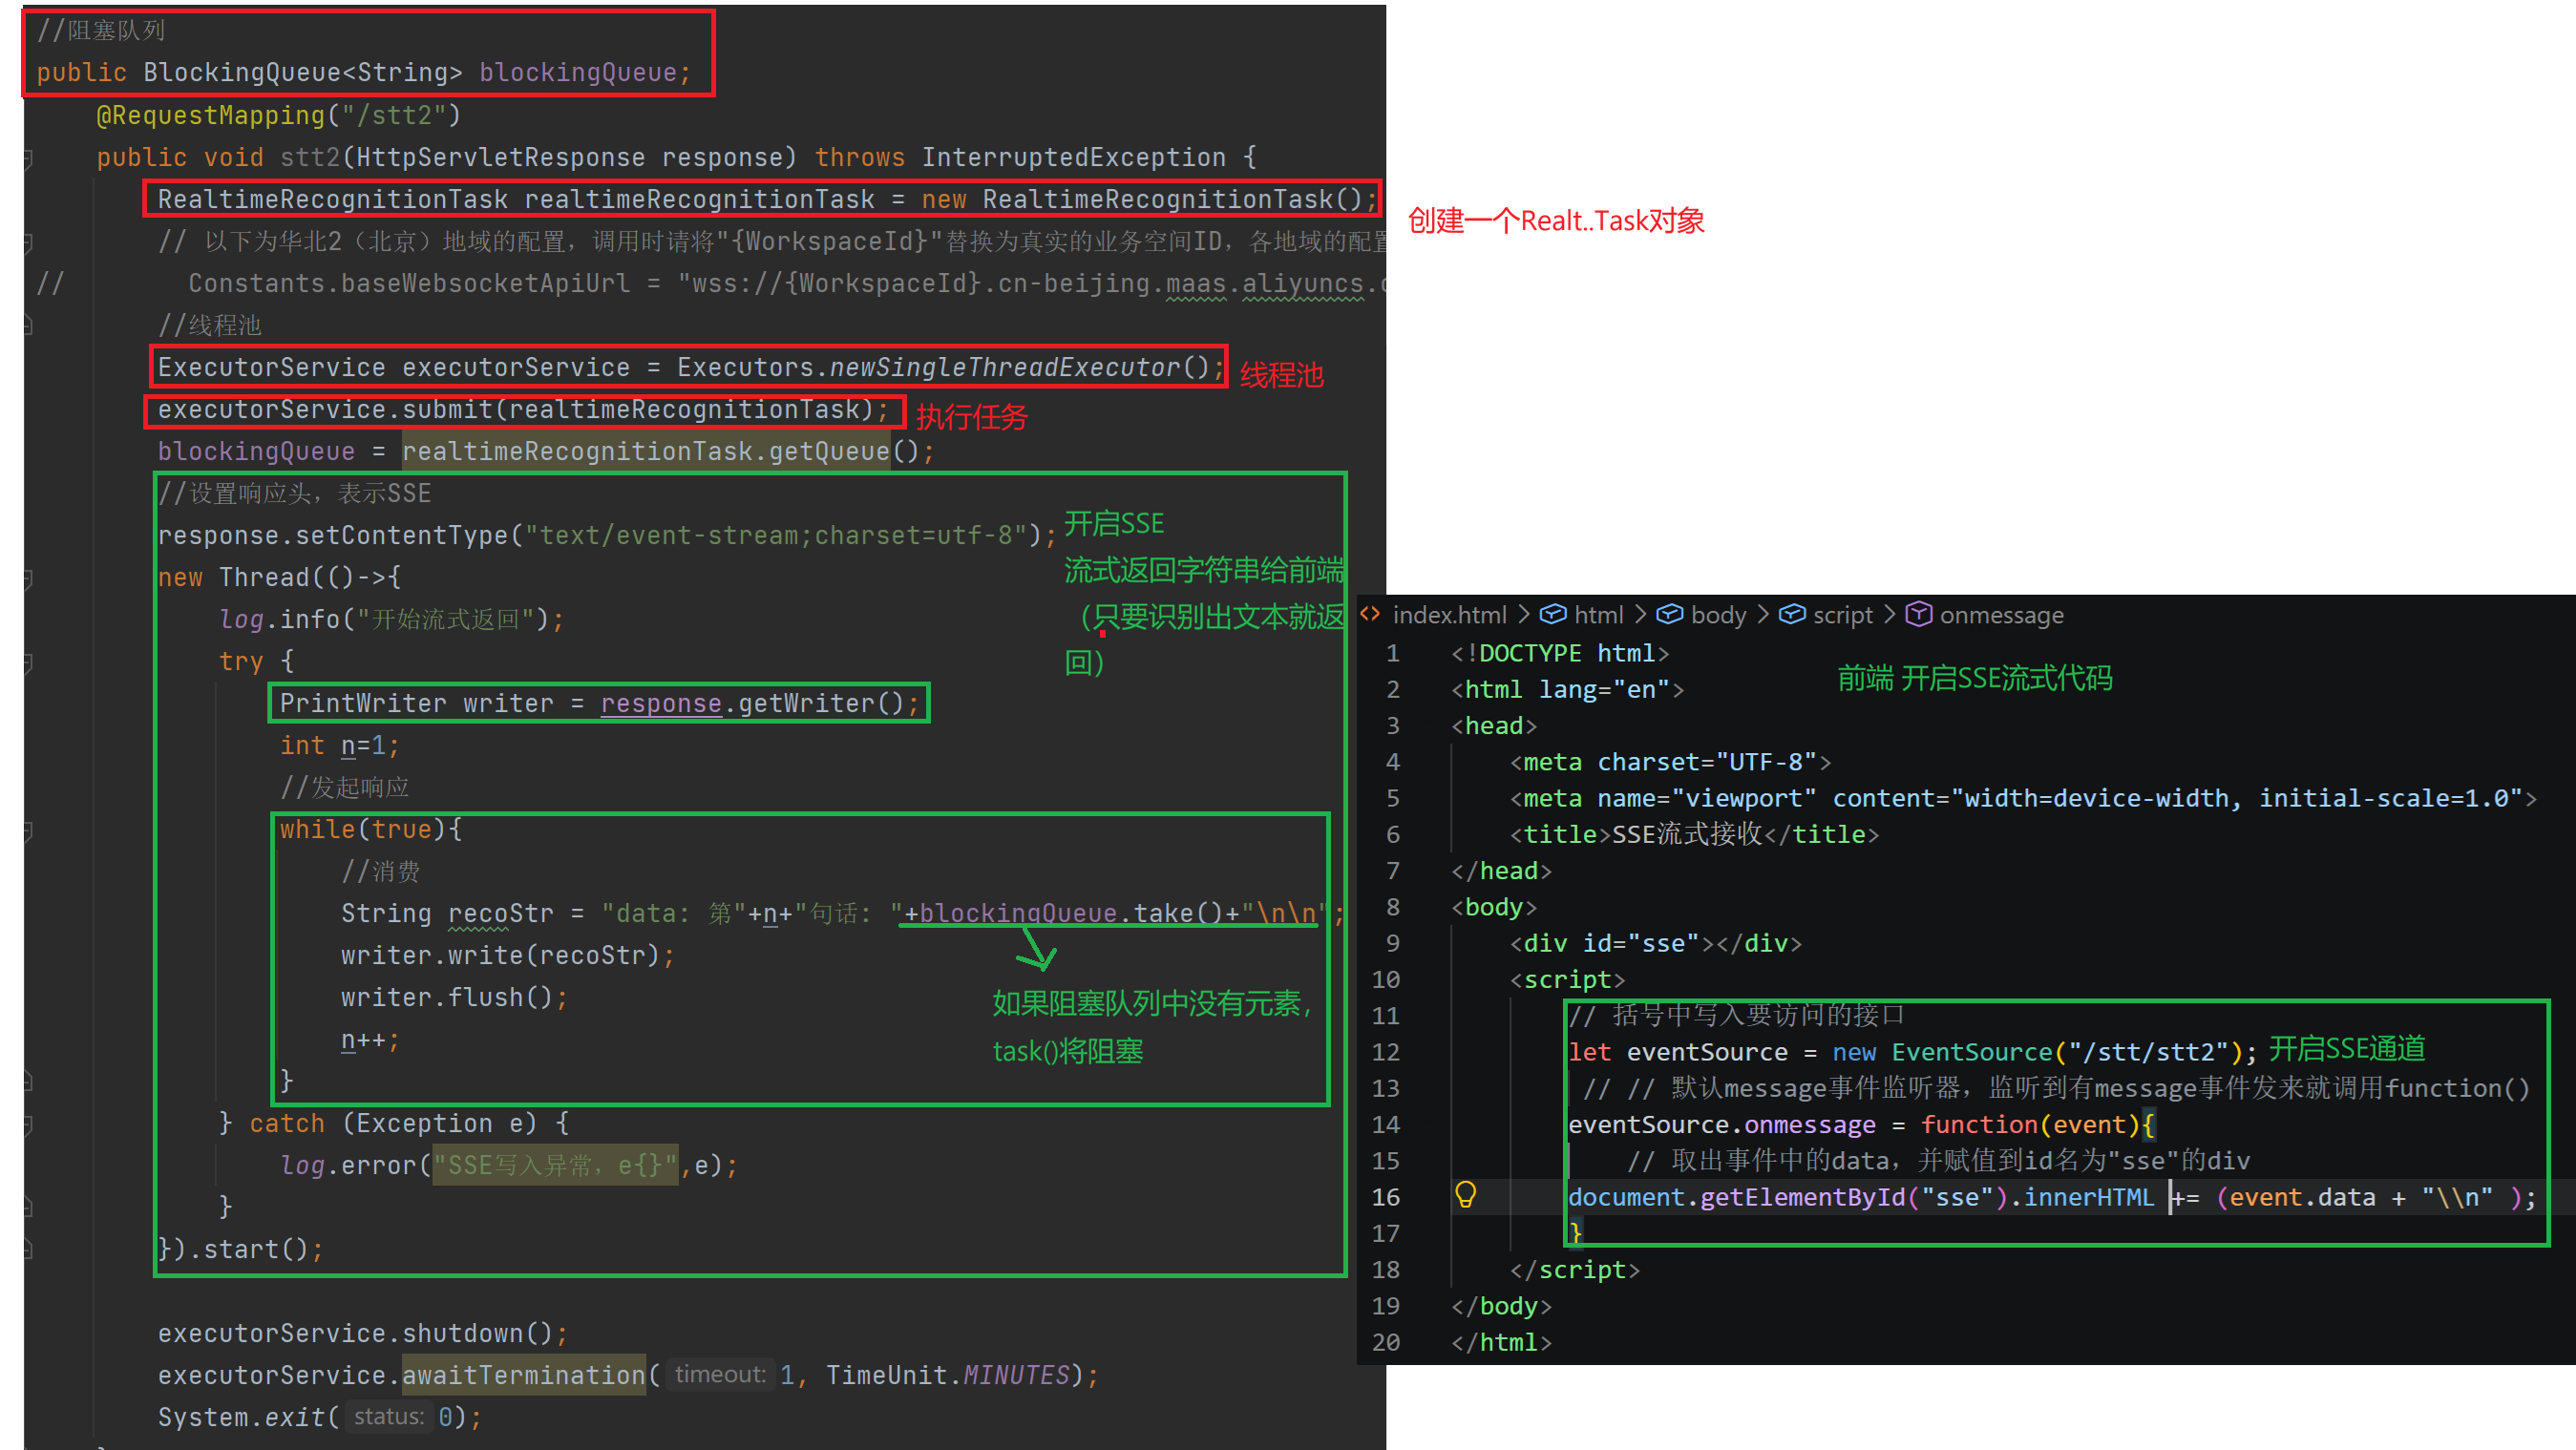
目前粗糙项目存在的问题:
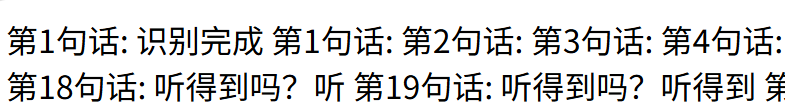
前端显示的文本间没有明确分隔:
前端/后端 处理不够好导致没有识别内容的文本也发送(其实是我懒得做了......)
stt2()中的部分代码是官方示例的代码,他给的代码可能是为了让人好理解,要说资源利用这块,还是开发者自己操心。
6. 视频生成与编辑
6.1 视频生成与编辑 概念
视频生成 与 视频编辑 是两个大类,就像 文生图 与 语音合成 ;除此之外,Wan3.0系列模型还有一个 视频延长 (可向前、向后或前后延长视频)。
视频生成包含:
- 文生视频
- 图生视频 (其中图生视频分为 基于首尾帧 和基于首帧生成)
- 参考生视频
以上都支持传入音频;下面解释这三种生成的含义
视频编辑就叫视频编辑,没有子集视频编辑比如可以: "修改背景风格"、"添加视频元素"、"删除元素"和"修改元素"等改变视频内容的能力
-
文生视频:直接通过提示词生成视频。详细:文生视频 - 阿里云百炼
-
图片生成---基于首尾帧:提供两张图片,一张作为视频首帧,另一张作为视频尾帧,视频中间的内容通过提示词描述生成。详细:图生视频-基于首尾帧 - 阿里云百炼
-
图片生成---基于首帧:提供一张图片作为视频首帧,视频的内容通过提示词描述生成。详细:万相-图生视频-基于首帧 - 阿里云百炼
-
参考生视频:可通过传入多张图片 + 多个视频 + 多个音频 资源根据提示词相互作用生成,也可只使用单种资源生成。相对于前几种,这个组合生成方式比较多,详细:参考生视频 - 阿里云百炼
阿里目前最新的视频生成模型支持 全模态输入 生成视频,它就是 万相3.0 ( wan3.0-video / wan3.0-video-prime**),** 使用这个模型你可以使用 视频生成和编辑 的全部功能(nb,不用来回切换模型了)。
**注意!注意!**要用万相3.0系列模型 需dashscope-java-sdk 版本在2.22.31或以上;Wan 3.0包含更多type参数,这些参数有些不能随意搭配,例如:first_frame/last_frame 与reference_image/reference_video /reference_audio/file/link 类型互斥,不能在同一请求中混用。
官方给出了详细的素材组合(参数组合):万相3.0-视频生成API参考 - 阿里云百炼
需要注意:一次请求 type参数的值只能file、link二选一,且只能最多一个,就不能多个file 或 多个link。综上,type共有7种值,详细参数说明可看官方 万相3.0-视频生成API参考 - 阿里云百炼(官方有请求/响应包示例)
6.2 万相3.0 系列 相关
- Wan3.0系列模型都只有30秒免费额度,生成失败的话不算入。
- 要用Wan3.0系列模型 需dashscope-java-sdk 版本在2.22.31或以上。
- 不允许生成含有真人脸的视频,模型在生成视频时会检测生成的视频是否含有,若含有就不会返回视频。
- 一次只能输出一个视频。
6.3 文生视频(同步/异步)
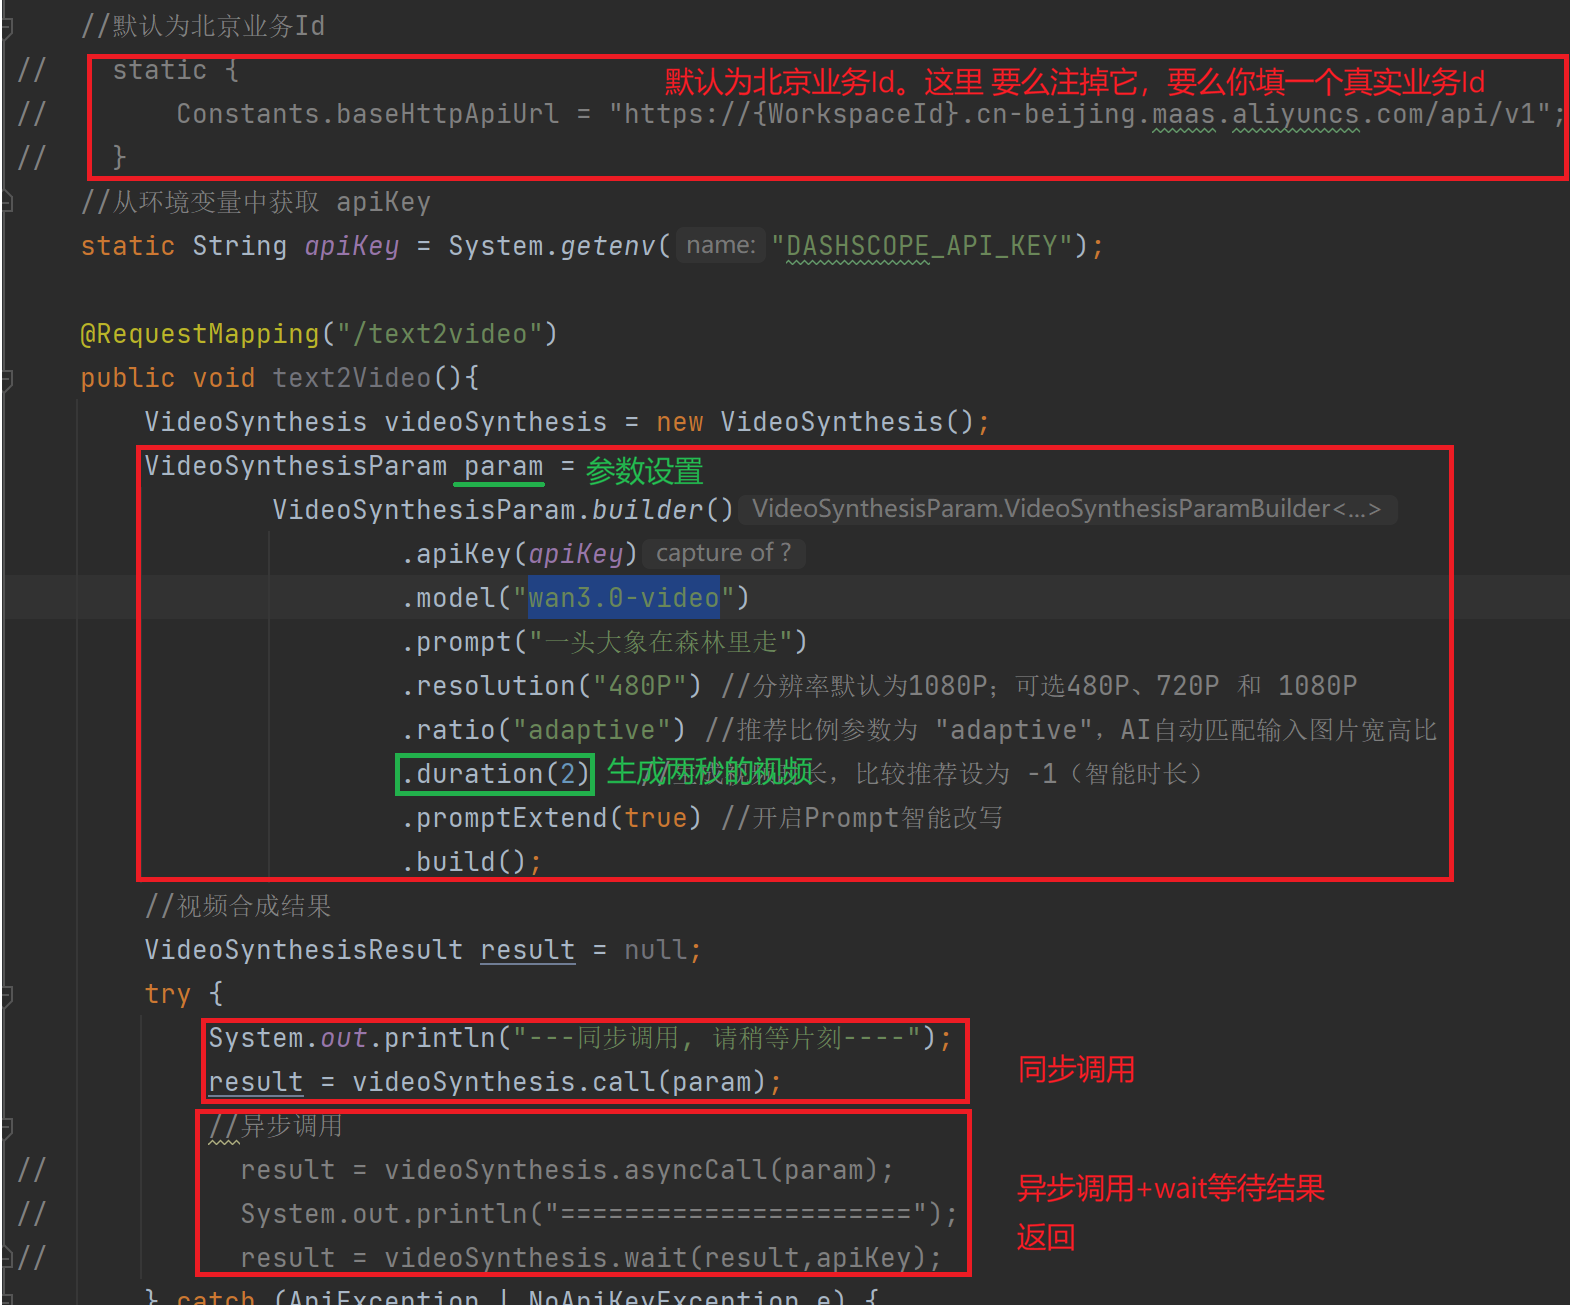
代码老简单了:巨蛇神/JavaEE进阶 - Gitee.com
6.4 图生视频
6.4.1 基于首帧生成
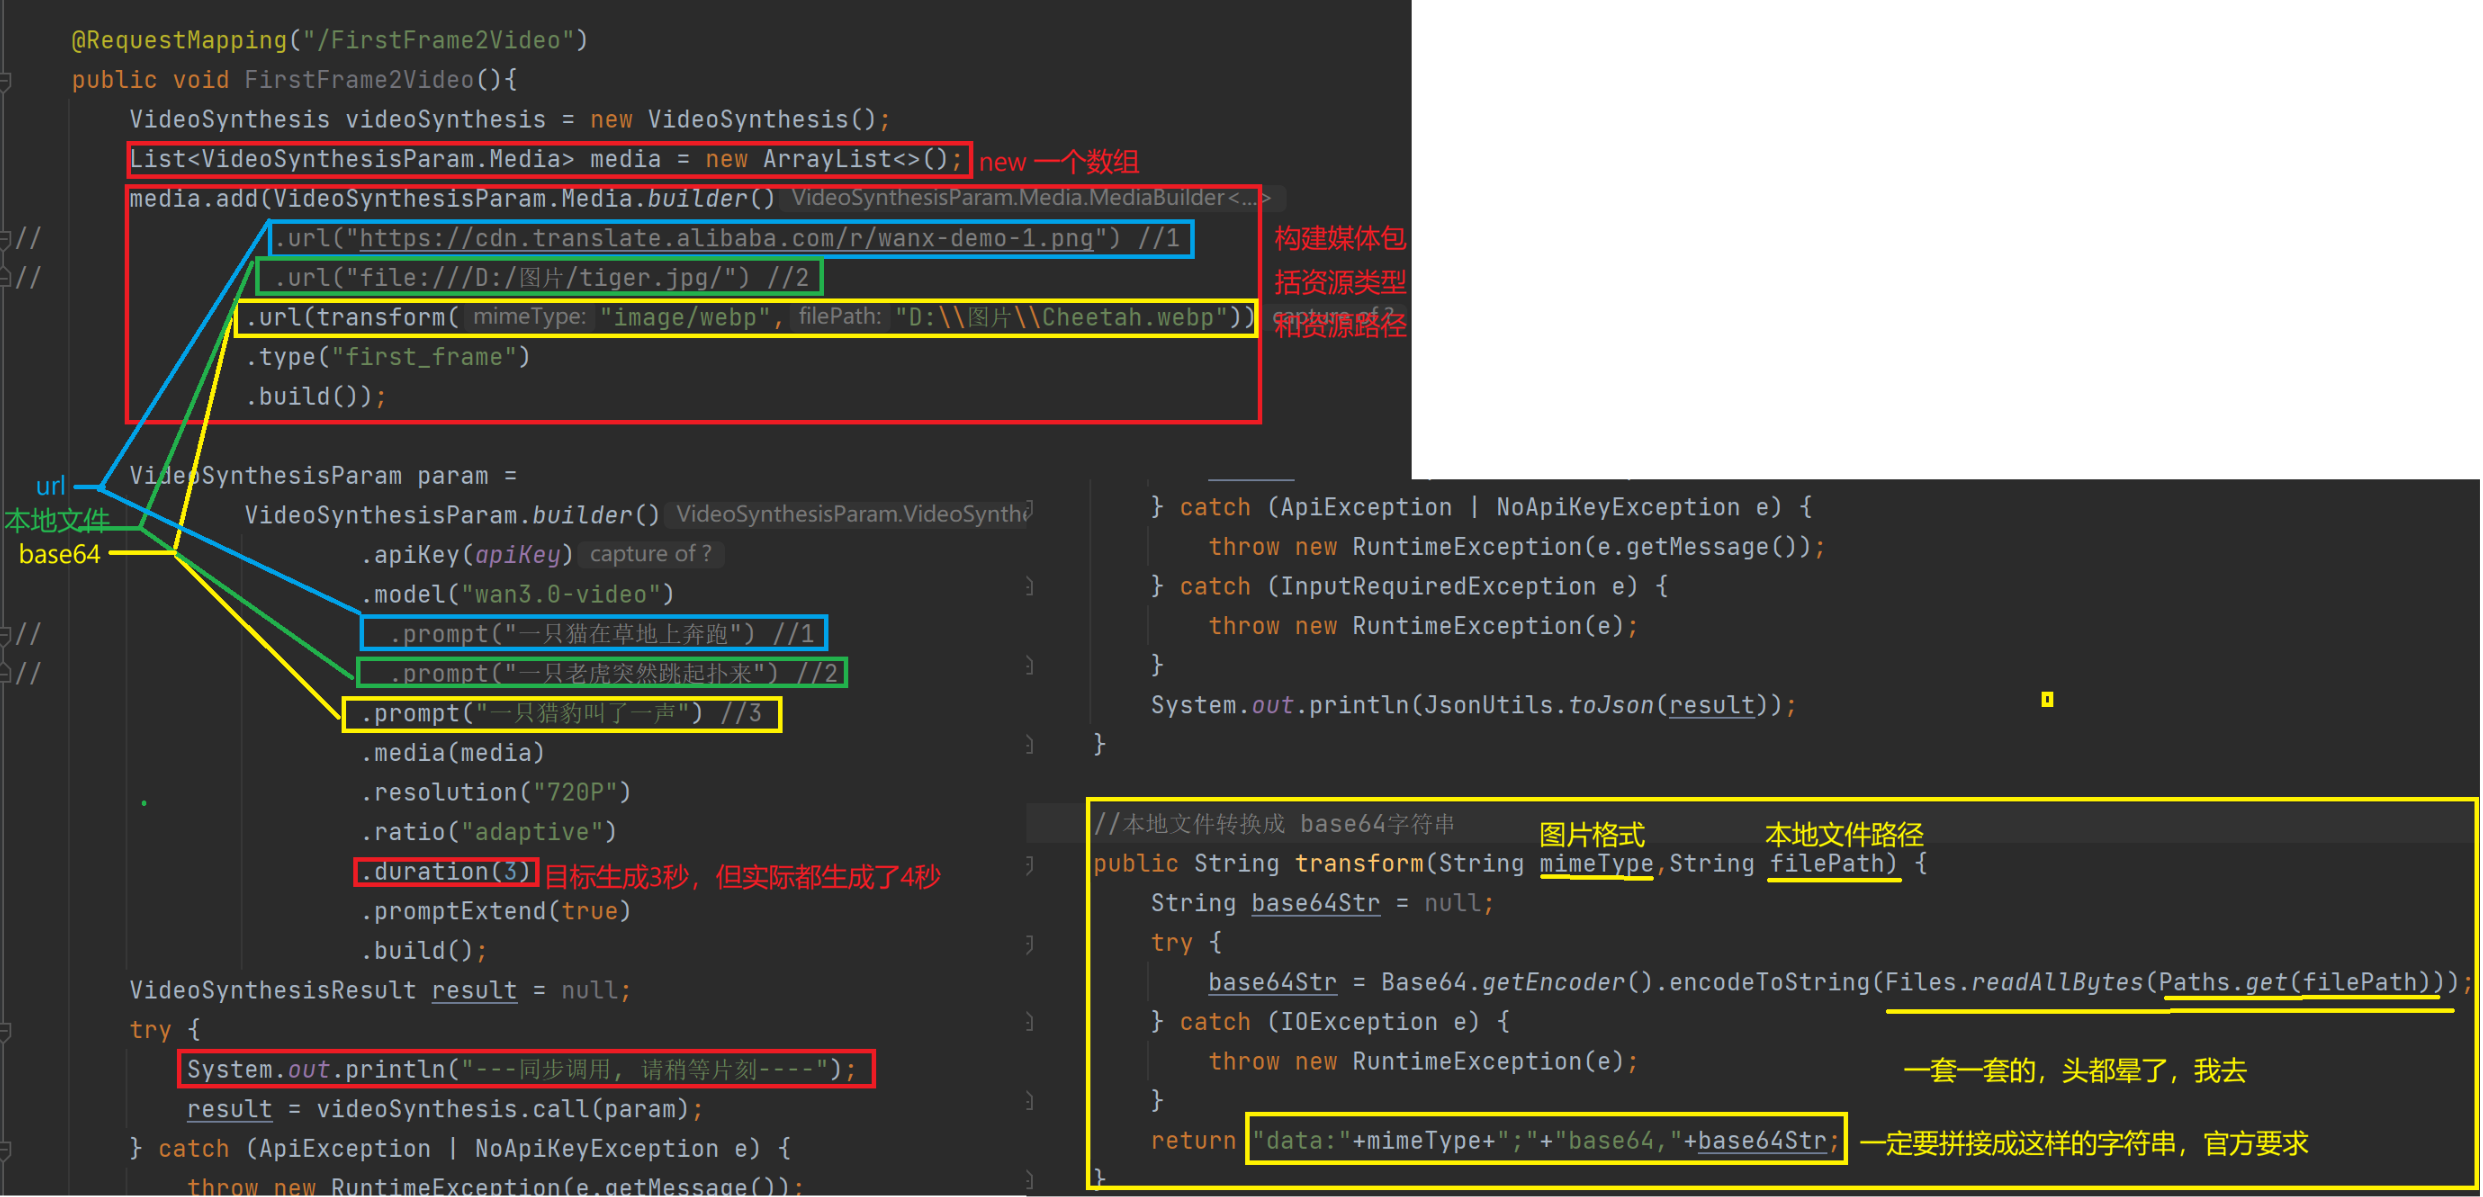
基于首帧可以通过 图像URL、本地文件路径、Base64编码字符串 三种方式构建media生成视频。
代码非常简单:巨蛇神/JavaEE进阶 - 码云 - 开源中国
由于first_frame与reference_audio不能共存,所以要想视频出现想要的音效只能通过提示词描述,这也是官方在文档中明确提到的。
我的代码只展示了同步调用的代码示例,但异步调用+轮询等待的操作应该与上面的文生视频一模一样,因为这个模型没有第二个asyncCall方法。
Wan3.0系列模型不能像 Wan2.5/Wan2.7系列模型 一样通过指定视频特效生成含有该特效的视频。
6.4.2 基于首尾帧生成
基于首尾帧 只需在 基于首帧 生成视频的代码上额外添加几行代码:
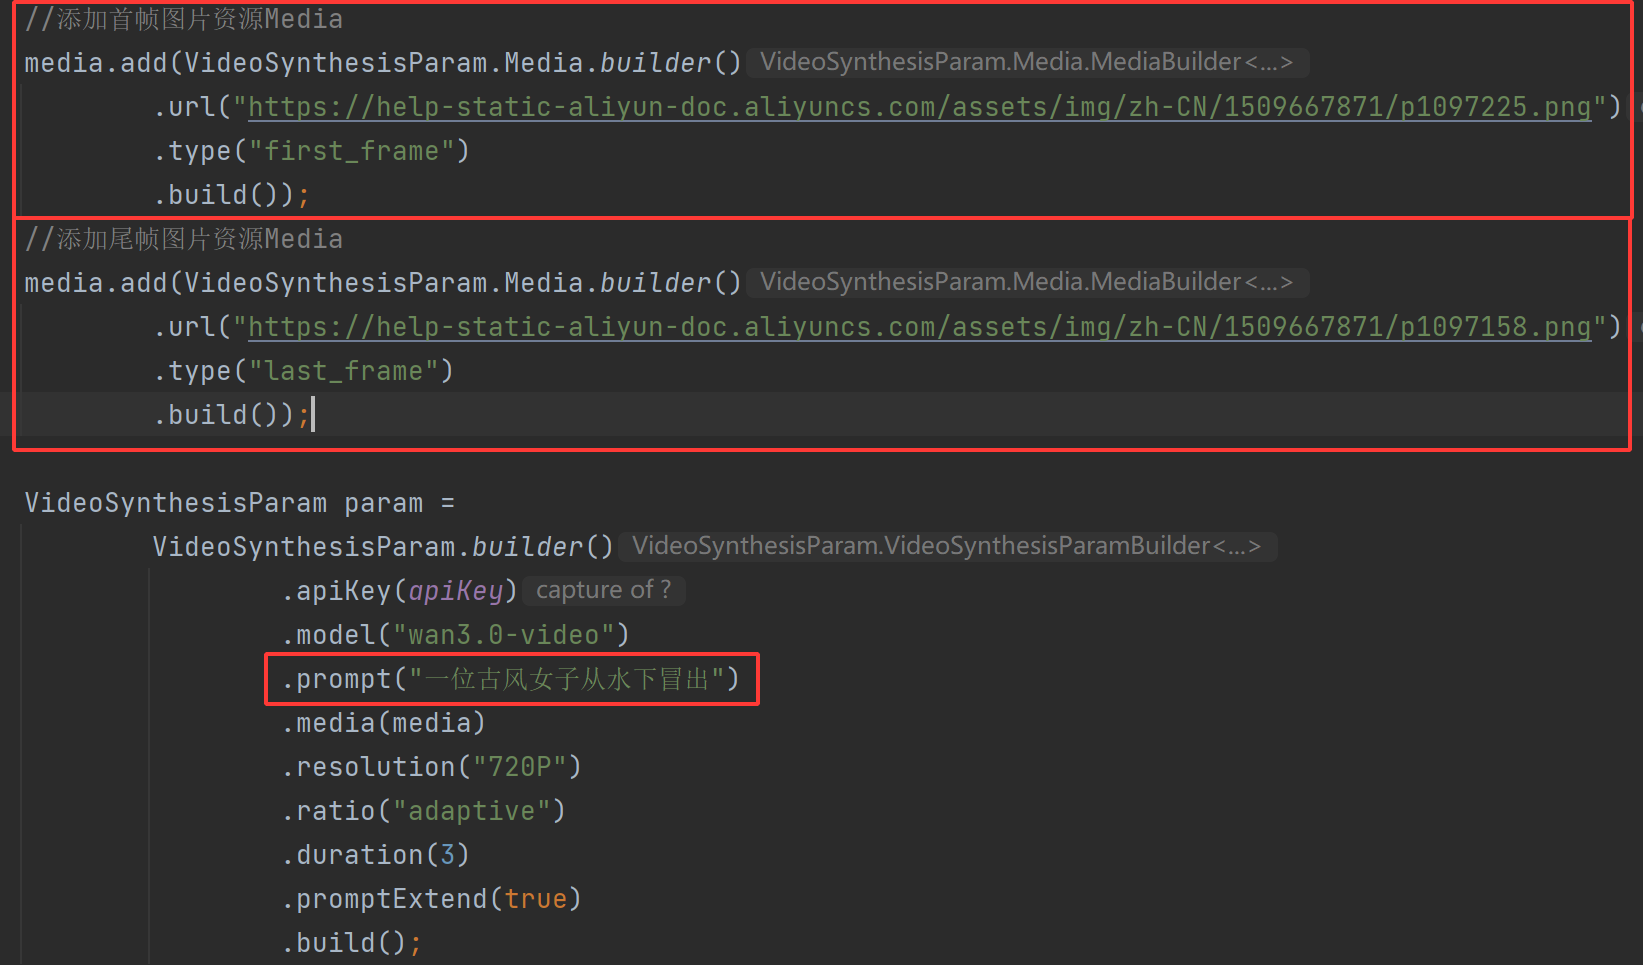
notice:首尾帧的两张图片资源必须要分开放到两个Media。其实不仅是图片资源要分放Media,一个Media仅代表一个资源,例如下面要讲的 参考生视频,传入的每种的每个 视频、图片和音频 资源都独享一个Media。
6.5 全模态参考生视频
万相3.0系列模型,可参考图片/视频/音频生成视频,也可参考文件或网页生成。
参考文件或网页生成视频type分别为file 与 link,这两个非常好用。如传入ppt URL,让模型根据ppt生成视频。
对于参考生视频 图像 的传入支持以下1,2,3;视频 和 音频 传入仅支持1,2;参考文件传入也仅支持1,2可同样支持官方示例解说:官方上传了
- 公网URL
- 临时URL
- Base64 编码字符串
阿里官方给出的示例很详细:万相3.0-视频生成 - 阿里云百炼。
暂时停止......