承接《TensorRT 自定义算子插件实战》系列前两篇:第一篇 customScaledTanh(单输入、逐元素、带参)、第二篇 customGatedTanh(双输入、融合、带参)。本篇实现第三个形态、也是真正拉开差距的一个:customMaxpool ------一个 2×2 核、stride=1、无参数 的窗口算子。它的难点不再是"多输入",而是两个全新问题:算子没有参数(参数机制整个被砍掉) 、输出尺寸发生变化(不再等于输入)。这三个算子加起来,正好覆盖了自定义插件的三大典型形态。
前两篇链接🔗:
TensorRT 自定义算子插件实战(一):从零手写 customScaledTanh
TensorRT 自定义算子插件实战(二):双输入融合算子 customGatedTanh
🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴
目录
- 一、算子的区别
- 二、为什么需要自定义插件
- [三、为什么需要 Plugin 和 PluginCreator 两个类](#三、为什么需要 Plugin 和 PluginCreator 两个类)
- 四、本案例的算子与网络
- [五、Python 端:导出无参数的窗口算子](#五、Python 端:导出无参数的窗口算子)
- [六、C++ 端:头文件------无参数后的"减法"](#六、C++ 端:头文件——无参数后的"减法")
- [七、C++ 端:CUDA 核函数------真正的难点](#七、C++ 端:CUDA 核函数——真正的难点)
- [八、C++ 端:Plugin 类的实现------两处"从抄到算"](#八、C++ 端:Plugin 类的实现——两处"从抄到算")
-
- [8.1 差异一:getOutputDimensions 真正计算输出尺寸](#8.1 差异一:getOutputDimensions 真正计算输出尺寸)
- [8.2 差异二:serialize 空实现](#8.2 差异二:serialize 空实现)
- [九、C++ 端:PluginCreator 类的实现------被"架空"的工厂](#九、C++ 端:PluginCreator 类的实现——被"架空"的工厂)
- 十、构建与验证
- 十一、实践经验
- 十二、小结
一、算子的区别
| 维度 | ScaledTanh / GatedTanh(前两篇) | customMaxpool(本篇) |
|---|---|---|
| 算子类别 | 逐元素 | 空间邻域(窗口取最大值) |
| 算子参数 | 有(k/a、a/b) | 无 |
| 输出形状 | = 输入形状 | ≠ 输入(H-1、W-1) |
| 线程与数据的关系 | 线程 index = 元素 index,一一对应 | 线程 = 输出元素,再反查输入窗口 |
| getOutputDimensions | return inputs0 | 真正计算 H-1、W-1 |
| 构造函数 | 3 个(含带参、反序列化 buffer) | 1 个(仅 name) |
| serialize | memcpy mParams | 空实现,返回 0 |
| Creator 的 mAttrs | 有参数 | 空(无参数可传) |
一句话概括本篇的核心: 无参数,让插件里"参数那套机制"(多个构造、mParams、serialize、Creator 解析)整体消失,外壳变得极简;输出尺寸变化,让 getOutputDimensions 从"抄输入"变成"真算",也让 kernel 的索引从"和元素一一对齐"变成"对齐输出、反查输入窗口 "。前者是减法,后者是难度真正的来源。
🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴
二、为什么需要自定义插件
和TRT 不认识 customMaxpool 这个节点,必须用插件实现。不同的是,TRT 本身就有标准 MaxPool 层------这里写它纯粹是为了演示"空间邻域算子"这一类插件的写法(卷积、池化、下采样、邻域统计都是这类)。所以本篇的示范意义在于:当你需要一个 TRT 没有的、或者你想自己控制的窗口运算时,怎么写空间邻域插件。
🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴
三、为什么需要 Plugin 和 PluginCreator 两个类
机制与前两篇完全相同,不重复。本篇要额外强调的一个现象:无参数时,PluginCreator 这个类虽然还在,但被"架空"了------它的 mAttrs 是空的、createPlugin/deserializePlugin 都只是直接 new 一个 Plugin。原因不变:TRT 只和 Creator 打交道,Creator 是插件的注册入口,即使没有参数要传递,注册这件事也必须有。所以 Creator 删不掉,只是参数部分归零。
🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴
四、本案例的算子与网络
算子定义(窗口算子,输出尺寸与输入不同):
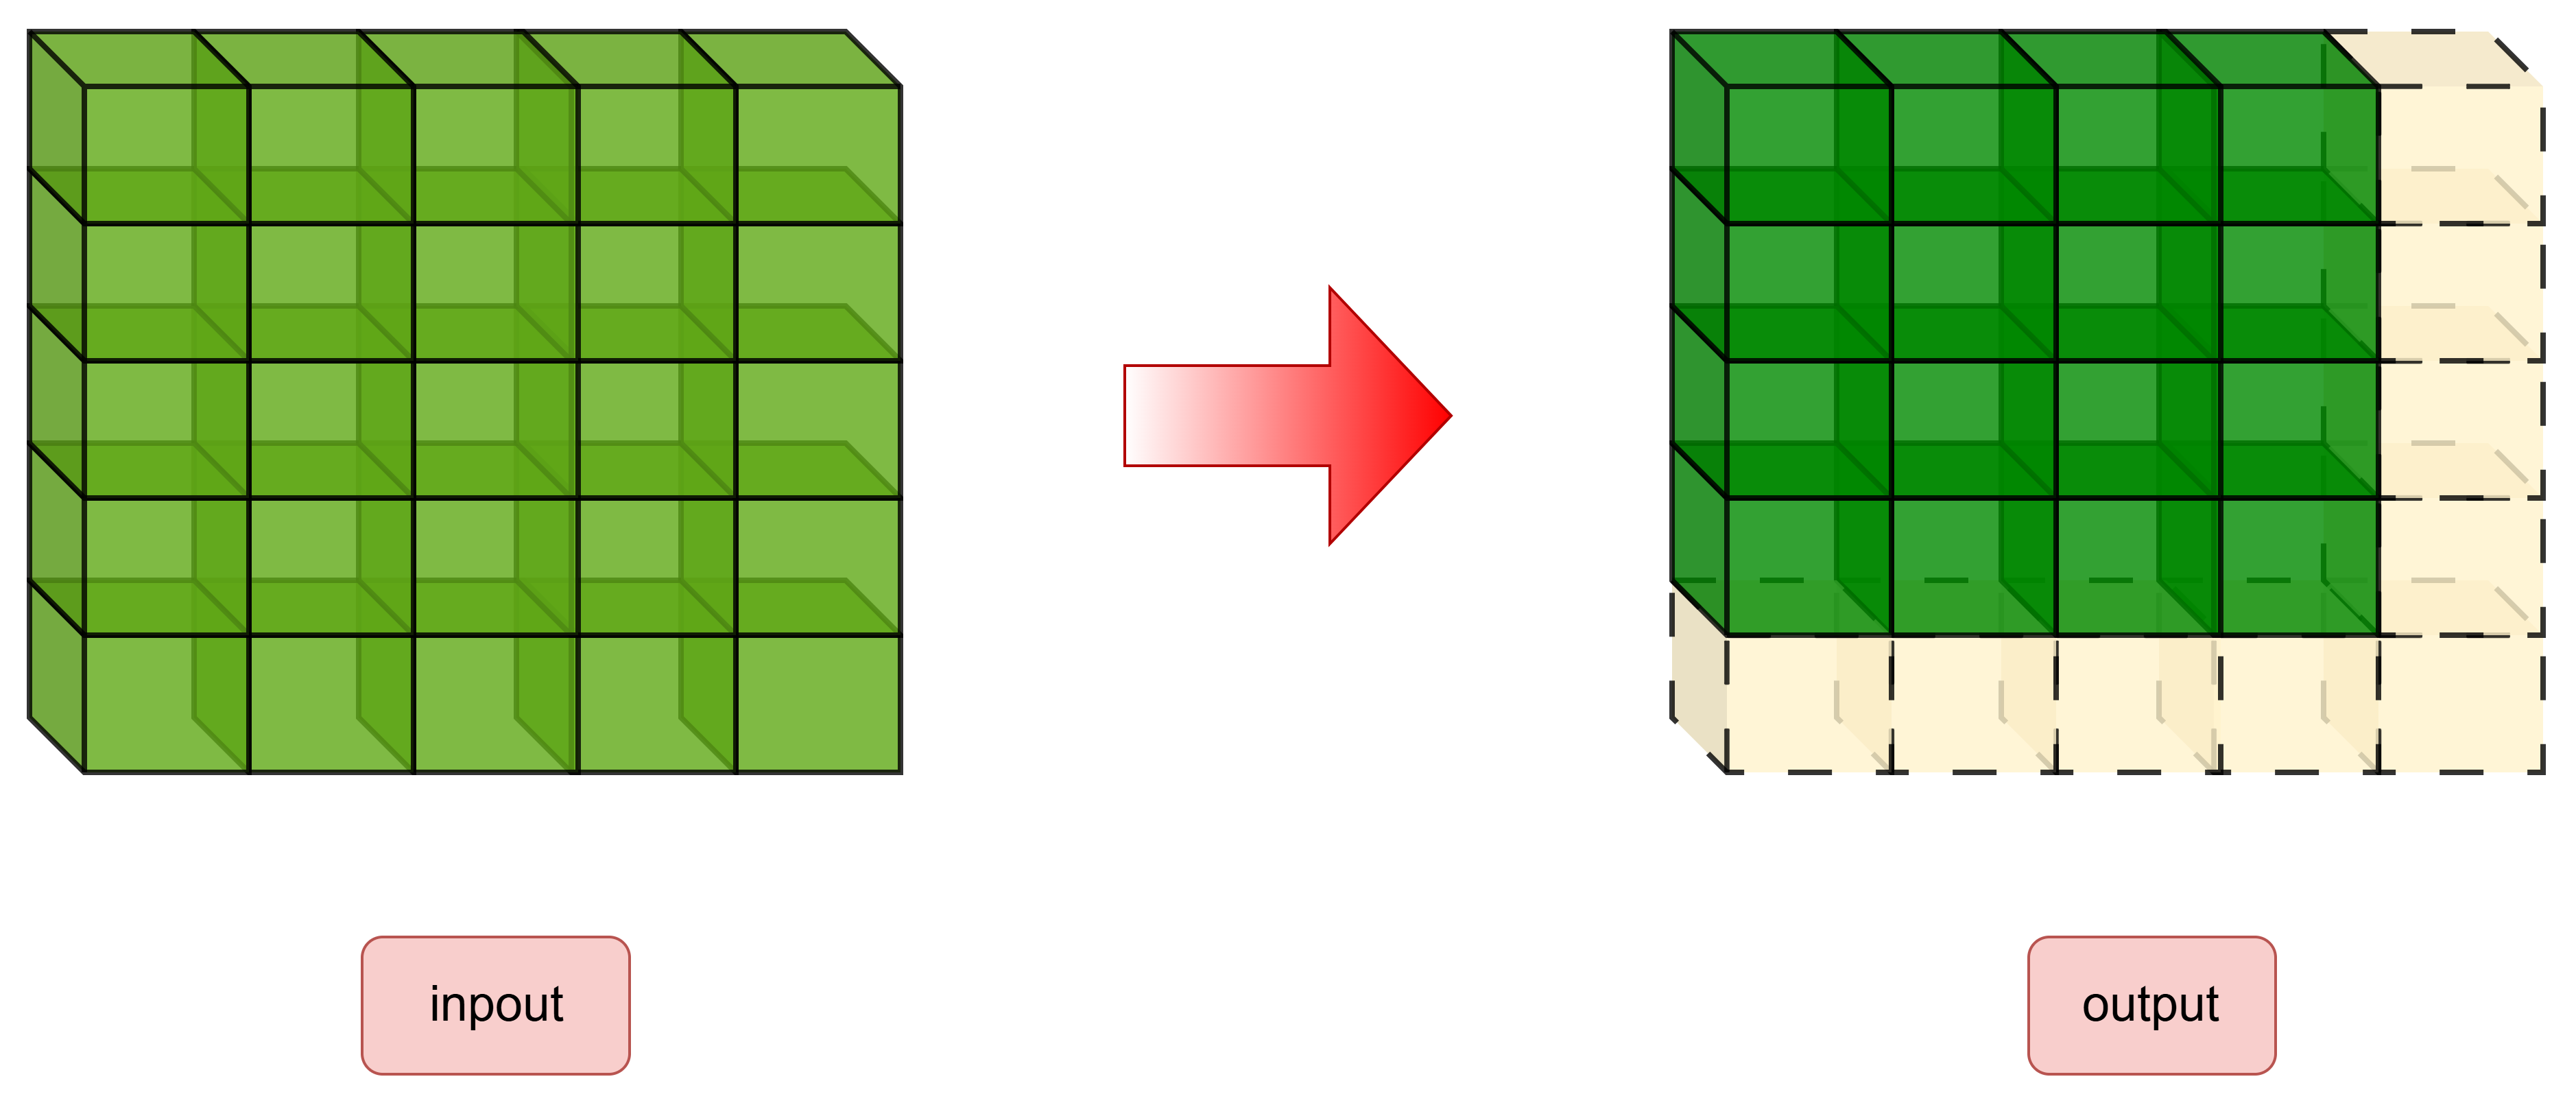
输入 [1,2,5,5] → 2×2 ,步长为1的最大池化 → 输出 [1,2,4,4]- 池化核 2×2、stride=1,因此输出高度 = 输入高度 − 1(5→4),宽度同理(5→4)。
- 通道数不变(2)。
网络结构 (单输入、单输出):
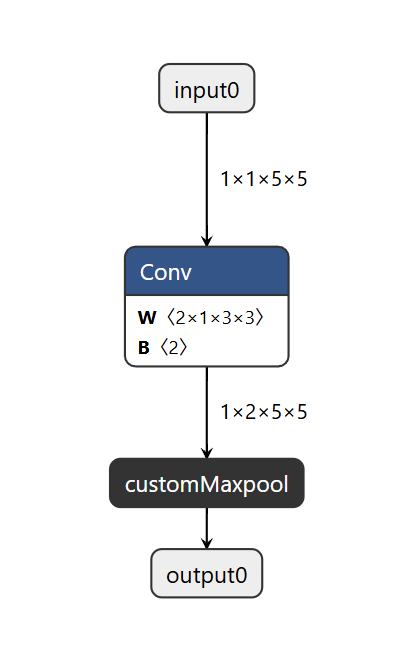
和前两篇对照:前两篇是"卷积 → 逐元素处理",输出尺寸不变;本篇是"卷积 → 窗口池化",输出在 H、W 上各小 1 ------这正是
getOutputDimensions和 kernel 索引要处理的新问题。尺度变化如下图所示(以单通道为例):
🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴
五、Python 端:导出无参数的窗口算子
和前两篇最大的区别:symbolic 不再接收任何标量参数,g.op 也不带 _f 属性后缀------算子完全由数据和内核行为定义。python 内容不多,撰写如下:
python
import torch
import torch.onnx
import torch.nn as nn
import onnx
import onnxsim

class CustomMaxpoolImpl(torch.autograd.Function):
    @staticmethod
    def symbolic(g, x):
        # 无参数:只传张量 x,不带任何属性
        return g.op("custom::customMaxpool", x)

    @staticmethod
    def forward(ctx, x):
        # 与 TRT 侧 kernel 对应的行为:2×2 最大池化,stride=1
        return torch.max_pool2d(x, kernel_size=2, stride=1)

class CustomMaxpool(nn.Module):
    def forward(self, x):
        return CustomMaxpoolImpl.apply(x)


class Model(torch.nn.Module):
    def __init__(self):
        super().__init__()
        self.conv     = nn.Conv2d(1, 2, (3, 3), padding=1)
        self.maxpool  = CustomMaxpool()
        for m in self.modules():
            if isinstance(m, nn.Conv2d):
                nn.init.kaiming_normal_(m.weight, mode='fan_out', nonlinearity='relu')

    def forward(self, x):
        x = self.conv(x)
        x = self.maxpool(x)
        return x


def export_norm_onnx(input, model):
    file = "./sample_customMaxpool.onnx"
    torch.onnx.export(
        model=model, args=(input,), f=file,
        input_names=["input0"], output_names=["output0"],
        opset_version=11)
    model_onnx = onnx.load(file)
    model_onnx, check = onnxsim.simplify(model_onnx)
    assert check
    onnx.save(model_onnx, file)


if __name__ == "__main__":
    torch.manual_seed(1)
    input = torch.rand(1, 1, 5, 5)
    model = Model().eval()
    export_norm_onnx(input, model)
🍉与前两篇的差异:
- symbolic 无属性 :前两篇是
g.op(..., k_f=k, a_f=a)带标量属性,本篇g.op("custom::customMaxpool", x)一个属性都不带------这是"无参数"在 Python 端的体现。 - forward 用现成算子 :前两篇 forward 手写公式(tanh/sigmoid 组合),本篇直接调
torch.max_pool2d------因为 PyTorch 有这个算子,forward 只要能算对即可,真正实现池化逻辑的是后面 CUDA kernel 。
🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴
六、C++ 端:头文件------无参数后的"减法"
无参数最直观的体现就是头文件变短 :前两篇的 Plugin 有"带参构造 + 反序列化 buffer 构造 + 默认构造"三个,本篇只剩一个 name 构造;mParams 结构体整个删除。差异片段:
cpp
class CustomMaxpoolPlugin : public IPluginV2DynamicExt {
public:
    CustomMaxpoolPlugin(const std::string &name);   // 唯一的构造(parse / clone / 反序列化 共用)
    // ... 其余接口声明与前两篇完全相同 ...

private:
    const std::string mName;   // 注意:没有 mParams 成员了
    std::string       mNamespace;
};

class CustomMaxpoolPluginCreator : public IPluginCreator {
    // ... 与前两篇相同,但 mAttrs 为空 ...
};
为什么无参数就能砍到只剩一个构造? 回顾前两篇:带参构造是"parse 阶段接收 k/a 并存入 mParams",反序列化 buffer 构造是"从引擎字节流恢复 mParams"。既然没有参数,mParams 不存在了,这两个构造自然失去意义 ------parse 后无需存参数,反序列化也无需恢复参数。于是三个构造收敛成一个 name 构造,parse、clone、deserialize 三个场景复用同一个构造 。
🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴
七、C++ 端:CUDA 核函数------真正的难点
核函数是本篇最难、也最值得看的部分。它和逐元素算子有本质区别:线程不再和输入元素一一对应,而是对齐输出元素,再反查输入窗口。 cu 内容不多,完整代码如下:
cpp
// custom-Maxpool.cu
#include <cuda_runtime.h>
#include <math.h>
#include <cuda_fp16.h>

// 辅助函数:求输入 in 在通道 c 内、以 (oy, ox) 为左上角的 2×2 窗口的最大值
__device__ float Window_Max(const float* in, int c, int inH, int inW, int oy, int ox)
{
    float m = -3.4e38f;
    for (int i = 0; i < 2; i++)          // 列偏移 i
    {
        for (int j = 0; j < 2; j++)      // 行偏移 j
        {
            // 一页一页算:先跳到通道 c 的页首,再加行偏移,再加列偏移
            int temp_index = c * inH * inW + (oy + j) * inW + (ox + i);
            m = in[temp_index] > m ? in[temp_index] : m;
        }
    }
    return m;
}

// 主核:线程 = 输出元素(不是输入!)
__global__ void customMaxpoolKernel(
    const float* inputs, float* outputs, int c, int inH, int inW, int outH, int outW, const int nElements)
{
    const int index = blockIdx.x * blockDim.x + threadIdx.x;
    int total = c * outH * outW;        // 输出的总元素数
    if (index >= total)                 // 物理裁剪:超出的线程直接退出
        return;

    // 从输出下标反解出:属于哪个通道 c、哪个输出行 oy、哪个输出列 ox
    int temp_c  = index / (outH * outW);     // 先定通道
    int temp_r  = index % (outH * outW);     // 通道内的余数
    int temp_oy = temp_r / outW;             // 输出行
    int temp_ox = temp_r % outW;             // 输出列

    outputs[index] = Window_Max(inputs, temp_c, inH, inW, temp_oy, temp_ox);
}

void customMaxpoolImpl(const float * inputs, float * outputs, const int nElements, cudaStream_t stream)
{
    dim3 blockSize(256, 1, 1);
    dim3 gridSize(ceil(float(nElements) / 256), 1, 1);
    // 注意:这里把形状写死成了 2/5/5/4/4(c=2, inH=5, inW=5, outH=4, outW=4),见第十节坑
    customMaxpoolKernel<<<gridSize, blockSize, 0, stream>>>(
        inputs, outputs, 2, 5, 5, 4, 4, nElements);
}
索引逻辑,是其与逐元素算子最大的分水岭。
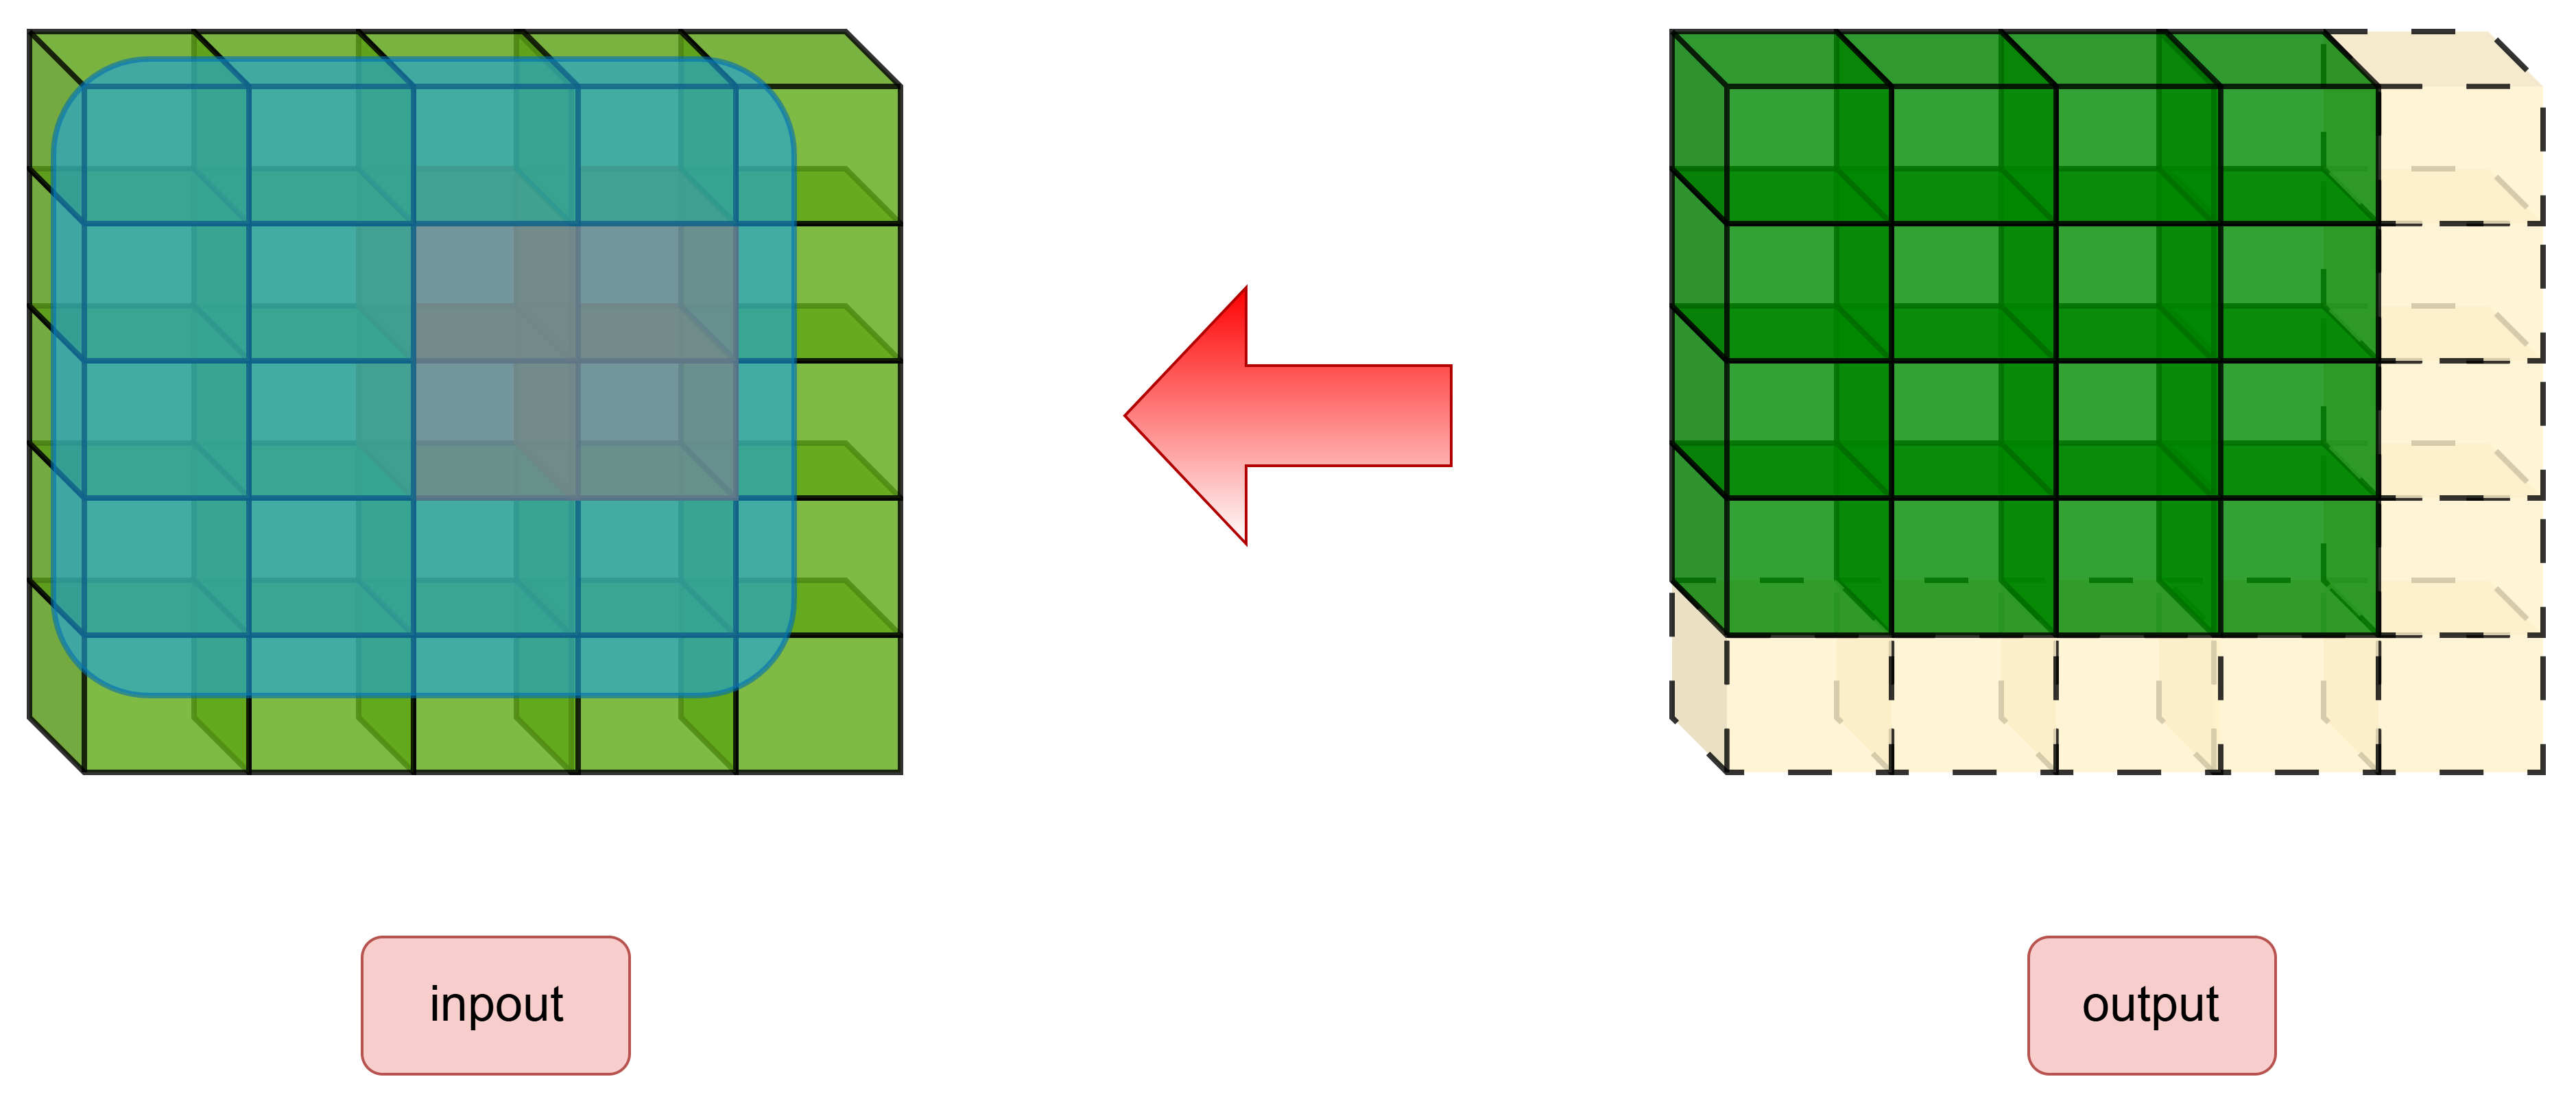
前两个算子(ScaledTanh、GatedTanh)里,index 既是输入下标也是输出下标,一个线程算一个对应位置的元素。但最大池化的输入输出元素对不上 :输入 1,2,5,5 有 50 个元素,输出 1,2,4,4 只有 32 个,每个输出元素要"看"输入里 4 个元素。所以线程数量必须由输出决定:
-
线程 = 输出元素 :
total = c * outH * outW,guard 用输出元素数裁剪(index >= total就 return)。这和你第一篇看过的"逐元素 guard"含义完全不同------那里 index 是输入下标,这里 index 是输出下标。 -
从输出下标反解坐标 :一个输出元素 index 要回答"它在哪个通道、哪一行、哪一列",用一连串整除/取模拆出来:
index ÷ (outH×outW) → 通道 c index % (outH×outW) → 通道内线性位置,再 ÷ outW → 行 oy,再 % outW → 列 ox -
反查输入窗口 :有了 (c, oy, ox),去输入里取以 (oy, ox) 为左上角的 2×2 邻域,窗口内元素下标是
c*inH*inW + (oy+j)*inW + (ox+i)(j 是行内偏移 0/1,i 是列内偏移 0/1)。这是逐元素算子里绝不会出现的"空间邻域寻址"。
一句话:逐元素算子是"一个线程对一个元素";窗口算子是"一个线程对一个输出元素、但要从输入的邻域里取数据"。索引的对齐对象从"输入"变成了"输出",这就是空间邻域算子难的地方。
🍭无参数在 kernel 里的体现
kernel 签名里没有 a/b 这类标量参数,只剩数据指针、形状参数和元素数------因为算子行为(取 2×2 最大值)是写死的,不需要任何可调参数。
🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴
八、C++ 端:Plugin 类的实现------两处"从抄到算"
无参数、输出尺寸变化带来的改动集中在两个方法,其余接口(构造、getPluginType、clone、destroy......)与前两篇逐字相同。
8.1 差异一:getOutputDimensions 真正计算输出尺寸
前两篇直接 return inputs[0](逐元素算子输出 = 输入)。最大池化输出在 H、W 上各小 1,必须真算:
cpp
DimsExprs CustomMaxpoolPlugin::getOutputDimensions(
    int32_t outputIndex, const DimsExprs* inputs, int32_t nbInputs, IExprBuilder &exprBuilder) noexcept
{
    DimsExprs out = inputs[0];   // 先拷贝:N、C(d[0]、d[1])不变
    // NCHW:d[2]=H、d[3]=W,输出 = 输入 - 1(因为 2×2 核、stride=1)
    out.d[2] = exprBuilder.operation(DimensionOperation::kSUB,
                  *inputs[0].d[2], *exprBuilder.constant(1));   // H-1
    out.d[3] = exprBuilder.operation(DimensionOperation::kSUB,
                  *inputs[0].d[3], *exprBuilder.constant(1));   // W-1
    return out;
}- 动态维度要用 IExprBuilder 运算 :因为插件是 DynamicExt 版本,H、W 可能是动态的,不能用普通整数相减,要用
exprBuilder.operation(kSUB, d[2], constant(1))声明"输出维度 = 输入维度 − 1"。 - 这样 TRT 就知道输出是
[N, C, H-1, W-1],[1,2,5,5]进来给到[1,2,4,4]。
8.2 差异二:serialize 空实现
无参数 → 没有东西可序列化:
cpp
size_t CustomMaxpoolPlugin::getSerializationSize() const noexcept { return 0; }

void CustomMaxpoolPlugin::serialize(void *buffer) const noexcept
{
    // 无参数:什么都不写
    return;
}
对照前两篇的 memcpy(buffer, &mParams, sizeof(mParams))------mParams 没了,序列化也随之归零。
🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴
九、C++ 端:PluginCreator 类的实现------被"架空"的工厂
无参数让 Creator 也大幅变空:mAttrs 不再注册任何 PluginField,createPlugin/deserializePlugin 直接 new。
cpp
CustomMaxpoolPluginCreator::CustomMaxpoolPluginCreator()
{
    // 无参数:不再 emplace_back 任何 PluginField
    // mAttrs.emplace_back(PluginField("a", ...));  ← 已注释掉
    // mFC.nbFields = 0;
}

IPluginV2* CustomMaxpoolPluginCreator::createPlugin(const char* name, const PluginFieldCollection* fc) noexcept
{
    // 无参数:不需要从 fc 里解析任何值
    return new CustomMaxpoolPlugin(name);
}

IPluginV2* CustomMaxpoolPluginCreator::deserializePlugin(const char* name, const void* serialData, size_t serialLength) noexcept
{
    // 无参数:反序列化也不需要恢复任何值
    return new CustomMaxpoolPlugin(name);
}
为什么 Creator 还是不能删? 因为 REGISTER_TENSORRT_PLUGIN(CustomMaxpoolPluginCreator) 注册的是这个 Creator,TRT 靠它按 op_type + domain 找到"如何创建这个插件"。即使它内部什么都不做,注册这个入口本身不能省。所以无参数时 Creator 是"空壳但必须存在"。
🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴
十、构建与验证
main函数比较简单,直接读取相关的onnx文件,进行本地引擎构建,再推理即可。与上篇的唯一区别,就是推理时候读取的onnx文件不一样。
cpp
#include <iostream>
#include <memory>

#include "utils.hpp"
#include "model.hpp"

using namespace std;

int main(int argc, char const *argv[])
{
    Model model("models/onnx/sample_customMaxpool.onnx", Model::precision::FP16);

    if(!model.build()){
        LOGE("fail in building model");
        return 0;
    }
    if(!model.infer()){
        LOGE("fail in infering model");
        return 0;
    }
    return 0;
}
验证方式相同:PyTorch 跑 ONNX、C++ 加载 TRT 引擎跑插件,对比输出。我的实现里两者完全一致,证明"输出尺寸变化 → getOutputDimensions 算对 → kernel 对齐输出反查输入窗口"这条链路成立。
python程序的输出结果为:
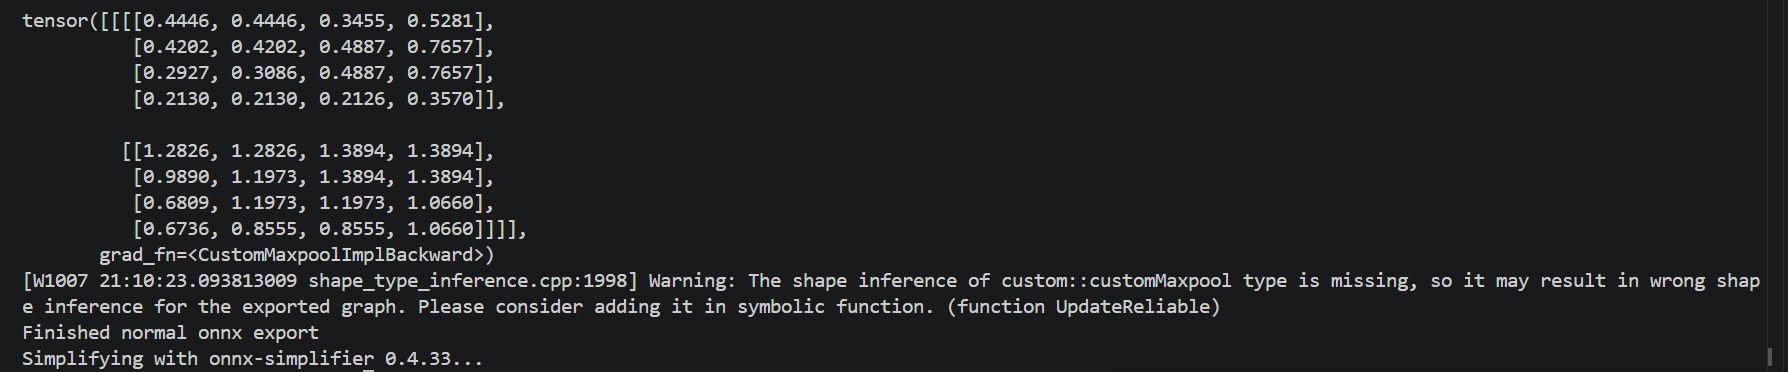
cpp程序的输出结果为:
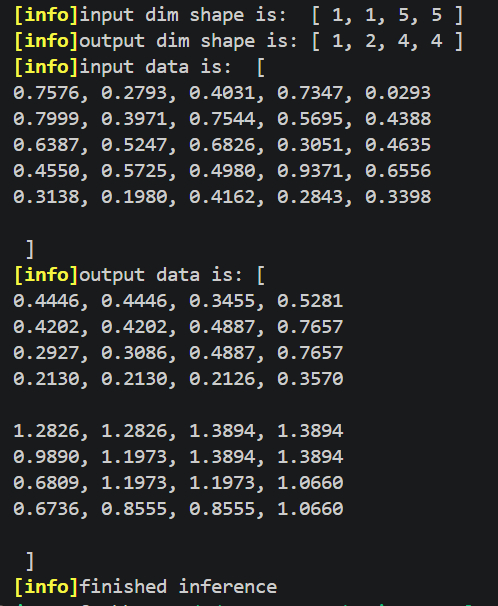
实验发现,Python 与 C++ 的推理结果完全一致,基本可以确定软件没有问题。
🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴🔴
十一、实践经验
- host 封装把形状硬编码了 。
customMaxpoolImpl里customMaxpoolKernel<<<...>>>(inputs, outputs, 2, 5, 5, 4, 4, ...)把 c/inH/inW/outH/outW 写死成当前模型的尺寸。这能让 demo 跑通,但换了输入尺寸就错 。正确做法应从inputDesc[0].dims(或 configurePlugin 保存的尺寸)动态取出 H、W,算出 outH、outW 再传 kernel。 - enqueue 传"输入元素数"、kernel 用"输出元素数",口径不一致 。enqueue 里 nElements = 输入总元素数(2×5×5=50),而 kernel 里 guard 用的是输出 total(2×4×4=32)。本例因为输出 < 输入,guard 正确裁剪了,但如果输入输出关系反过来或开方不整,grid 划分和 guard 就可能出问题。栅格划分应基于实际要执行的输出元素数。
- 线程对齐对象变了 。逐元素算子线程对齐输入元素;窗口算子线程必须对齐输出元素(因为输出个数决定要算几个数)。很多人第一次写池化 kernel,下意识按输入去分线程,结果边界全错------先想清楚"线程数该由谁决定"。
- 动态维度运算要用 IExprBuilder 。DynamicExt 插件里算输出尺寸不能直接写
d[2] - 1,必须用exprBuilder.operation(kSUB, ...),否则动态 shape下会错。
🔑对于以上第一点,为了达到更好的兼容性,customMaxpoolImpl函数内部可以加上如下代码:
cpp
// 从输出取 outH、outW,从输入取 c、inH、inW(NCHW:d[0]=N、d[1]=C、d[2]=H、d[3]=W)
int c    = inputDesc[0].dims.d[1];
int inH  = inputDesc[0].dims.d[2];
int inW  = inputDesc[0].dims.d[3];
int outH = outputDesc[0].dims.d[2];
int outW = outputDesc[0].dims.d[3];
// 再传进 customMaxpoolImpl → kernel
🔑对于以上第二点,所以enqueue()函数更好的实现方法是,用outputDesc来算元素个数:
cpp
int32_t CustomMaxpoolPlugin::enqueue(
    const PluginTensorDesc* inputDesc, const PluginTensorDesc* outputDesc,
    const void* const* inputs, void* const* outputs,
    void* workspace, cudaStream_t stream) noexcept
{
    /*
     * Plugin的核心的地方。每个插件都有一个自己的定制方案
     * Plugin直接调用kernel的地方
    */
    int nElements = 1;
    for (int i = 0; i < outputDesc[0].dims.nbDims; i++){
        nElements *= outputDesc[0].dims.d[i];
    }

    customMaxpoolImpl(
        static_cast<const float *>(inputs[0]),
        static_cast<float *>(outputs[0]),
        nElements, stream);

    return 0;
}
另外两点已经在代码中有所体现,不再赘述。
十二、小结
三个算子写到这里,正好覆盖自定义插件的三大形态,做一个收尾对照:
| 形态 | 代表算子 | 实现难点 |
|---|---|---|
| 单输入 · 逐元素 · 带参 | customScaledTanh | 参数在"onnx 属性 → mFC → mParams → 序列化"间传递 |
| 双输入 · 融合 · 带参 | customGatedTanh | enqueue 多取一个指针、supports 多一个 case |
| 单输入 · 窗口 · 无参 | customMaxpool | 无参数机制砍掉;输出尺寸变化;线程对齐输出、反查输入窗口 |
无参数让插件结构"减"到最简(一个构造、空 serialize、空 Creator),你因此看清了哪些外壳是"参数机制"撑起来的、哪些是"注册机制"必需的;输出尺寸变化则逼你把 getOutputDimensions 从"抄输入"升级成"真算",把 kernel 索引从"元素对齐"升级成"对齐输出、空间邻域寻址"。这三篇加起来,自定义插件里"外壳"与"内核"的开发范式就完整了。