MobileSAM 论文方法详解:解耦合知识蒸馏让 SAM 跑上手机
论文:MobileSAM: Faster Segment Anything for Mobile Devices
摘要: 本文提出MobileSAM,通过解耦合知识蒸馏实现轻量化分割模型部署。针对SAM"头重脚轻"的结构,创新性地将训练过程解耦:仅用MSE损失蒸馏Image Encoder的embedding,无需依赖Mask Decoder。该方法使训练成本降低至1%以下,仅需2块GPU、11K数据即可达到0.75 mIoU,压缩比达109×,推理速度提升38×。相比半耦合与全耦合策略,解耦合显著降低优化难度,且可直接复用原始Decoder,实现小模型高精度、低延迟的移动端部署,性能超越FastSAM。
一、SAM 的结构与问题
1.1 SAM 的"头重脚轻"结构
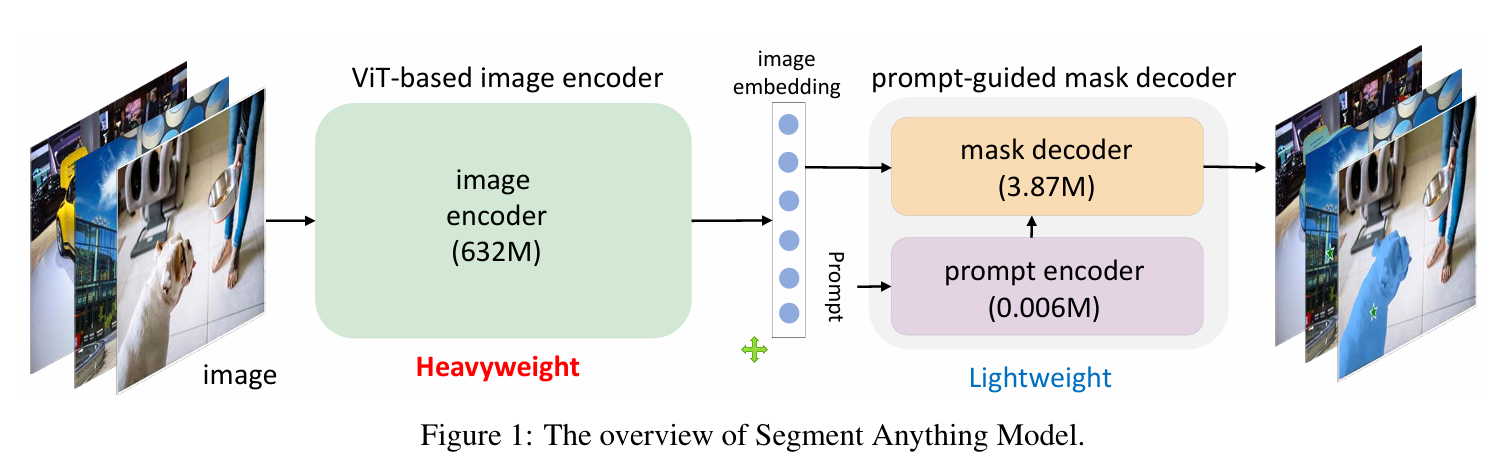
SAM 由两部分组成:
| 模块 | 参数 | 性质 |
|---|---|---|
| Image Encoder (ViT-H) | 632M | 重量级,占 99% 计算 |
| Mask Decoder | 3.87M | 轻量级 |
| Prompt Encoder | 0.006M | 可忽略 |
推理时,一张图要先过 Image Encoder 生成 image embedding,然后用户给个点/框提示,Mask Decoder 基于 embedding 和 prompt 生成分割掩膜。
关键观察 :Mask Decoder 本身很轻,在资源受限设备上也能跑。瓶颈完全在 Image Encoder。所以目标很明确:把 632M 的 ViT-H 换成一个轻量级编码器(如 ViT-Tiny,约 5M 参数)。
1.2 官方方法的代价
原始 SAM 论文中,训练 ViT-L/B 版本的 SAM 需要 128 块 GPU × 多天 。这是因为官方采用的是端到端联合训练:Image Encoder 和 Mask Decoder 同时从头训练,两者互相依赖,优化难度极高。
二、三种蒸馏策略的演进
论文把"训练轻量化 SAM"重新定义为**知识蒸馏(Knowledge Distillation, KD)**问题,并提出了三种不同程度的耦合策略:
全耦合  →  半耦合  →  解耦合
(最难)   (中等)    (最简单有效)
三、全耦合蒸馏(Fully-Coupled Distillation)
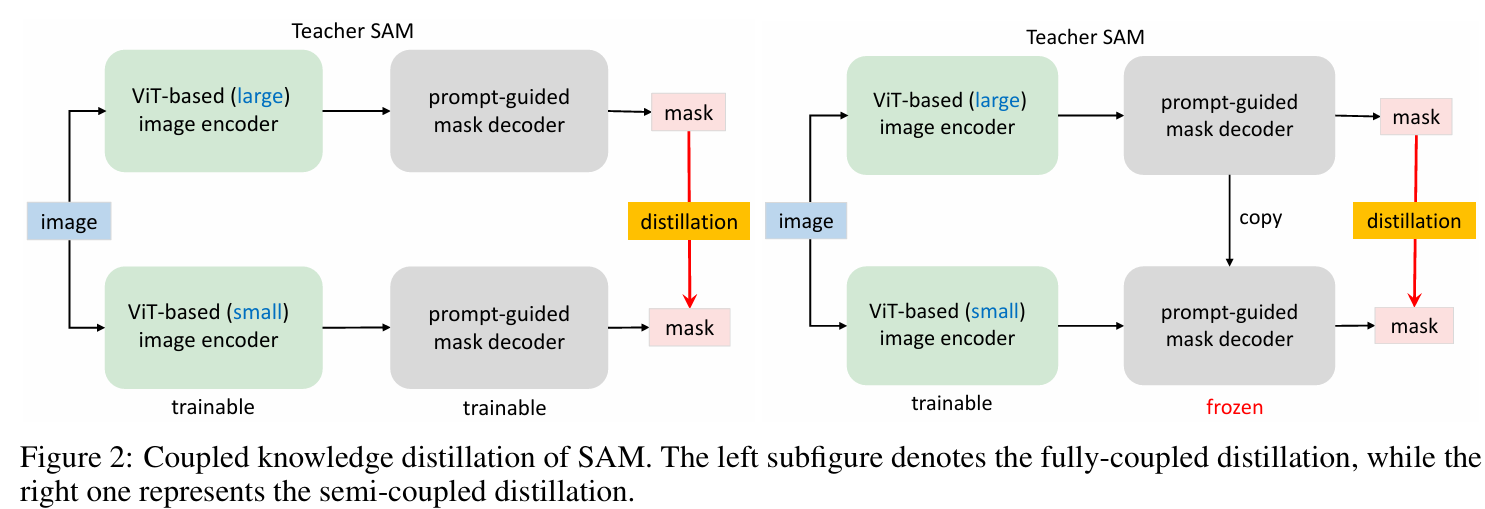
方法
- Teacher:原始 SAM(ViT-H Encoder + 原始 Mask Decoder)
- Student:小 SAM(小 Encoder + 小 Mask Decoder)
- 训练方式:同时训练 Student 的 Encoder 和 Decoder
- 蒸馏目标:让 Student 输出的 mask 与 Teacher 输出的 mask 尽可能一致(用 Focal Loss + Dice Loss)
问题
两个模块都处于"糟糕"的初始状态,需要同时优化:
- 小 Encoder 还没学会提取好特征 → Decoder 学不好
- Decoder 预测不准 → Encoder 的梯度也不准
这就像让两个刚学走路的人互相扶着走,很容易一起摔倒。官方训练 ViT-B SAM 用的就是这种策略,需要 128 GPU。
四、半耦合蒸馏(Semi-Coupled Distillation)
方法
- Teacher:原始 SAM(ViT-H Encoder + 原始 Mask Decoder)
- Student :小 Encoder(可训练)+ 从原始 SAM 复制并冻结的 Mask Decoder
- 训练方式:只训练小 Encoder,Mask Decoder 保持冻结
核心思想
"冻结 Decoder,防止它被差的 Encoder 拖垮"
因为原始 SAM 的 Mask Decoder 已经训练得很好了,直接复制过来冻结住。这样 Student Encoder 只需要学会生成能被这个"好 Decoder"理解的 embedding 就行。
局限
论文指出,这种方法仍然不够理想:
-
Prompt 的随机性导致 Decoder 输出可变:用户给的点/框提示是随机的,同一个 Encoder 输出面对不同 prompt,Decoder 会产生不同的 mask。这意味着 Encoder 的优化目标不是固定的,增加了训练难度。
-
优化仍未完全解耦:Encoder 的优化仍然间接依赖于 Decoder 的行为(虽然 Decoder 冻结了,但 prompt 变化导致目标变化)。
五、解耦合蒸馏(Decoupled Distillation)⭐ 论文核心
方法
-
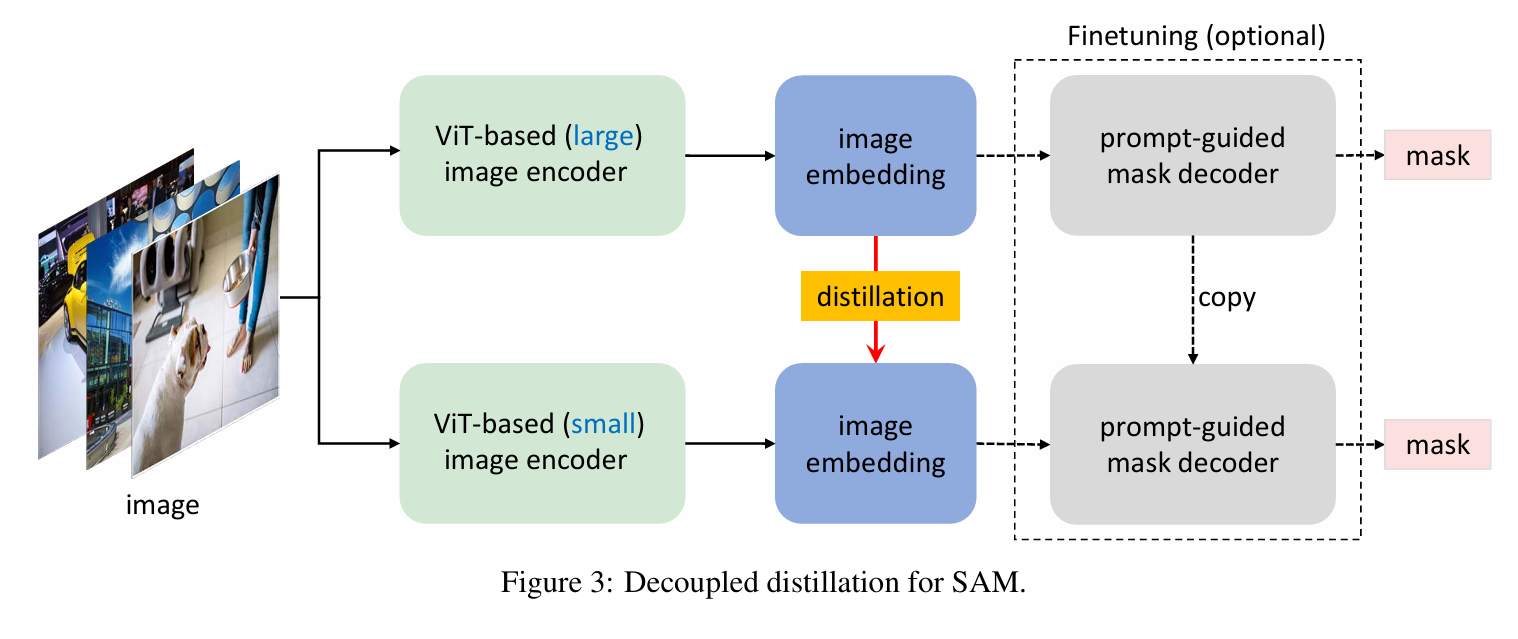
Teacher :原始 SAM 的 ViT-H Image Encoder
-
Student :轻量级 Image Encoder(如 ViT-Tiny)
-
训练方式 :完全不需要 Mask Decoder!
-
蒸馏目标 :直接用 MSE Loss 让 Student Encoder 输出的 image embedding 与 Teacher Encoder 输出的 embedding 尽可能一致
图像 → ViT-H (Teacher) → embedding_t
↓
图像 → ViT-Tiny (Student) → embedding_sLoss = MSE(embedding_s, embedding_t)
为什么这样可行?
论文的关键洞察是:
SAM 的 Mask Decoder 是轻量且通用的,只要 Student Encoder 生成的 embedding 与 Teacher 足够接近,原始 Decoder 就能直接拿来用,不需要重新训练。
因为:
- 蒸馏后的 embedding 空间与原始 embedding 空间高度对齐
- Mask Decoder 本来就被设计为接受这种 embedding 并生成 mask
- 所以 Decoder 可以"即插即用"
可选的第二步:Mask Decoder 微调
虽然论文发现即使不微调 Decoder,效果也已经很好(因为 embedding 对齐了),但 optionally 可以:
- 冻结轻量级 Encoder
- 微调原始 Mask Decoder 几个 epoch
- 或者联合微调两者
这作为可选步骤,能进一步提升一点点性能。
六、半耦合 vs 解耦合 核心区别对比
| 对比维度 | 半耦合蒸馏(Semi-Coupled) | 解耦合蒸馏(Decoupled) |
|---|---|---|
| 蒸馏目标 | Mask 输出(Focal + Dice Loss) | Image Embedding(MSE Loss) |
| 是否用 Mask Decoder | ✅ 用,且冻结原始 Decoder | ❌ 完全不用 Decoder |
| Prompt 依赖 | ✅ 依赖,需要随机采样 prompt | ❌ 不依赖,只过 Encoder |
| 优化耦合度 | 半耦合(Encoder 仍受 Decoder+Prompt 影响) | 完全解耦(Encoder 独立优化) |
| 训练复杂度 | 中等(需要前向过 frozen Decoder) | 极简(只过两个 Encoder) |
| 损失函数 | Focal Loss + Dice Loss(复杂) | MSE Loss(简单) |
| 训练速度 | 慢(Teacher 要过完整 SAM) | 极快(可预计算 Teacher embedding) |
| 资源消耗 | 需要 GPU 跑 Teacher 前向 | 可预存 Teacher embedding,单 GPU 即可 |
形象比喻
- 全耦合:让两个新手(小 Encoder + 小 Decoder)互相教学,一起学画画 → 效率极低
- 半耦合:给一个新手(小 Encoder)配一个大师级助手(冻结 Decoder),但助手每次给的评价标准随题目变化 → still 有点混乱
- 解耦合 :直接让新手模仿大师(Teacher Encoder)的"素描功底"(embedding),不用管后面怎么上色(Decoder)。只要素描像了,上色自然能用原来的流程 → 最简单高效
七、实验结果
7.1 训练成本对比(ViT-B 作为小 Encoder)
| 指标 | 全耦合(官方) | 半耦合 | 解耦合(论文) |
|---|---|---|---|
| mIoU | 0.72 | - | 0.75 |
| GPU 数 | 128 | 较多 | 2 |
| Batch Size | 128 | - | 4 |
| 迭代次数 | 180k | - | 55k |
| 训练数据 | 11M | - | 11K(仅 0.1%) |
| 计算资源 | 基准 | - | < 1% |
7.2 MobileSAM 最终性能(ViT-Tiny)
| 指标 | 原始 SAM | MobileSAM | 压缩比 |
|---|---|---|---|
| Encoder 参数 | 632M | 5.78M | 109× |
| 总参数 | ~636M | ~9.66M | 66× |
| Encoder 速度 | 452ms | 8ms | 56× |
| 总速度 | ~456ms | ~12ms | 38× |
7.3 与 FastSAM 对比
| 指标 | FastSAM | MobileSAM | 优势 |
|---|---|---|---|
| 参数 | 68M | 9.66M | MobileSAM 小 7× |
| 速度 | 64ms | 12ms | MobileSAM 快 5× |
| mIoU | 0.27~0.41 | 0.73 | MobileSAM 精度高得多 |
| 分割质量 | 边界不平滑、易漏物体 | 与原始 SAM 几乎一致 | 明显更好 |
关键结论:MobileSAM 比 FastSAM 更小、更快、更准,且完全保持了原始 SAM 的 pipeline,可以即插即用替换到现有 SAM 项目中。
八、总结
| 策略 | 核心思想 | 缺点 | 论文选择 |
|---|---|---|---|
| 全耦合 | 同时训练 Encoder + Decoder | 资源消耗巨大,优化困难 | ❌ |
| 半耦合 | 冻结 Decoder,只训 Encoder | 仍受 Prompt 随机性干扰,未完全解耦 | ❌ |
| 解耦合 | 直接蒸馏 Embedding,不用 Decoder | 几乎无缺点 | ✅ |
解耦合蒸馏的精髓 在于:把"训练一个完整 SAM"的问题,转化为"训练一个能模仿大 Encoder 输出 embedding 的小 Encoder"的问题。由于 Mask Decoder 本身很轻且通用,只要 embedding 对齐,Decoder 就能无缝衔接。这种"分而治之"的策略将训练成本从 128 GPU×多天 降到了 1 GPU×不到一天,同时效果还更好。