引子:三个更底层的问题
大多数 Codex 教程的开头都是"左边是功能区,右边是工作区"。这对,但没用。真正决定你能不能用好、用安全 Codex 的是三件事:
- 它每一轮到底往模型里塞了什么? ------决定它为什么"记得住"和"忘得快"。
- 它的安全边界是技术强制的,还是靠模型自觉? ------决定你敢不敢让它执行 rm -rf。
- 它的记忆是有损压缩的,那约束会不会被压掉? ------决定长任务为什么会"行为漂移"。
文章分两部分:先讲八大功能,但每条都落到实现机制;再进桌面端,把 Agent Loop、沙盒模型、持久化指令、上下文压缩、MCP 信任边界拆开。
第一部分:八大功能,以及它们背后的机制
| 功能 | 定位 | 机制关键词 |
|---|---|---|
| 新聊天 | 临时问问题 | 上下文隔离 |
| 资料库 | 找以前的文件 | 文件持久化 |
| 项目 | 长期做一件事 | 工作目录边界 |
| 定时任务 | 到点自动干活 | 触发式调度 |
| 插件 | 接别的工具 | 工具注册 |
| 站点 | 做网页 | 产物托管 |
| 图片 | 生图改图 | 生成物版本 |
| GPTs | 找专门助手 | 预设系统提示 |
新聊天------上下文隔离,不是"清屏"
每次新对话,模型的输入序列是重新构造的。上一轮的 assistant 消息、工具调用结果、你的追问,全部不在新序列里。
这不是 UI 层面的"清空显示",而是请求体本身不同。所以"在一个对话里连着问十件不相关的事"是错的------不是因为界面乱,而是因为模型每轮采样的提示词里,都混着上一条任务的工具输出和执行痕迹。
工程含义 :上下文是稀缺资源,并且单调增长。而这个增长的代价不是线性的------第二部分会算这笔账。
资料库------文件的持久化层
它是跨会话的文件寻址:上下文清空了,文件还在。本质上,这是把"记忆"从易失的上下文转移到持久化存储------对抗上下文窗口有限性的第一种手段。
项目------工作目录边界
项目同时承担两件事:上下文容器 (会话、资料、要求归拢一处,减少重复交代),以及安全边界 ------这个最容易被忽略。Codex 的沙盒默认把文件写入限制在当前工作目录内,而项目划定的正是这个可写根目录(writable roots)。
所以"建项目"一半是效率问题,一半是安全问题:它决定了 Agent 能改哪些文件。
定时任务------把触发权交出去
工程含义 :任务一旦由时间或事件触发,执行时没有人在看。这在安全上是个质变------交互式场景里你能在审批弹窗按"拒绝",无人值守场景里没人按这个按钮。这正是后面 auto_review 这类机制存在的理由。
插件------工具注册表
插件最终会被注册成工具定义 ,进入模型每轮请求的 tools 字段。模型看到的只是"名称 + 描述 + 参数 schema",它不区分这个工具来自 Codex 内置、Responses API 还是 MCP。
这条认知极其关键,它推出两件事:
- 模型只按描述选工具------描述写得含糊,它就会选错。
- 沙盒只保护 Codex 内置的 shell 工具,不保护 MCP 工具------MCP 得自己实现安全边界。这是后面所有 MCP 安全讨论的起点。
插件不是越多越好,机制上的理由也更硬:工具清单是提示词的一部分,中途变动会导致缓存失效。
6--8. 站点、图片、GPTs
- 站点:描述需求 → 生成页面 → 托管,把"生成"到"交付"的最后一段路走完。
- 图片:生成与修改,历史结果可回溯。
- GPTs :本质是预置的系统级提示 + 能力配置。注意------它做的事,你在 Codex 里用 AGENTS.md 也能做,区别只是前者是别人调好的,后者是你自己写的、可版本控制。
落点 :八个功能里真正带"机制"性质的是三个------项目(边界)、插件(工具注册)、定时任务(无人值守) 。其余五个是效率工具。抓住这三个,理解就超过多数教程了。
第二部分:Codex 桌面端,拆到机制层
Codex 已整合进新版 ChatGPT 桌面端,Windows 和 Mac 都能用。左侧功能区管理任务、项目、插件,右侧工作区下达任务。但真正值得讲的是下面五件事。
一、Agent Loop:每一轮到底在干什么
Codex 的核心是一个 ReAct 风格的单智能体循环:
用户输入
  ↓
构造提示词(系统指令 + 工具定义 + 项目指令 + 环境信息 + 历史 + 本轮输入)
  ↓
调用 Responses API(HTTP POST + SSE 流式返回)
  ↓
模型输出:要么给用户的消息(回合结束),要么工具调用请求
  ↓
执行工具(经审批与沙盒)→ 结果追加回提示词 → 回到上一步
直到模型不再请求工具调用、直接给出面向用户的消息,这一"回合"(turn)才结束。
洞察一:工具形态极简。 Codex 对外主要暴露两类工具:shell(执行命令,返回 stdout/stderr 与退出码)与 apply_patch(用补丁格式改文件,而非让模型重写整个文件)。
apply_patch 值得单独说:它换来三个性质------变更意图显式、产出 diff 人眼可审、无关内容不易被误覆盖。这是"最小可审 diff"哲学的工程落地,让"只改关键几行"成为默认行为。
洞察二:提示词构造顺序是刻意安排的。 静态内容在前(系统消息、工具定义、developer 指令、AGENTS.md、环境信息),动态内容在后。原因见下条。
二、提示词缓存:为什么"顺序"是个性能问题
这是最容易被忽略、影响却最大的工程约束。
对话是累加的:第 N 轮提示词 = 第 N-1 轮 + 新增内容。若每轮重发完整历史,请求体与计算量会呈二次方增长 。Responses API 提供了 previous_response_id 来缓解,但 Codex 有意不用 ------为的是让每个请求完全无状态 ,从而支持零数据保留(ZDR)。这是个明确取舍:用二次方的传输成本,换无状态带来的合规能力。
控成本靠提示词缓存 :只有新提示词以旧提示词为精确前缀时缓存才命中,命中时采样从二次方退回线性。于是所有设计围绕"保持前缀稳定":
- 静态内容前置------不变的东西放前面,才能形成稳定前缀。
- 中途配置变更用"追加"而非"改写" ------沙盒或审批模式变了,Codex 是插入一条新的 developer 消息,而不是回头修改前面的消息,旧前缀因此依然有效。
- 工具清单必须顺序一致------早期 MCP 支持就踩过坑:工具枚举顺序不稳定,直接导致缓存未命中。
会打破缓存的操作:中途改变可用工具、切换模型、改变沙盒设置、改变审批模式、改变当前工作目录。
实际价值 :长任务中途频繁切模型、改权限、切目录,你不只损失缓存,还在为重复推理付费。把配置在开跑前定好,不是习惯问题,是成本问题。
三、沙盒与审批:技术边界 vs 策略决策
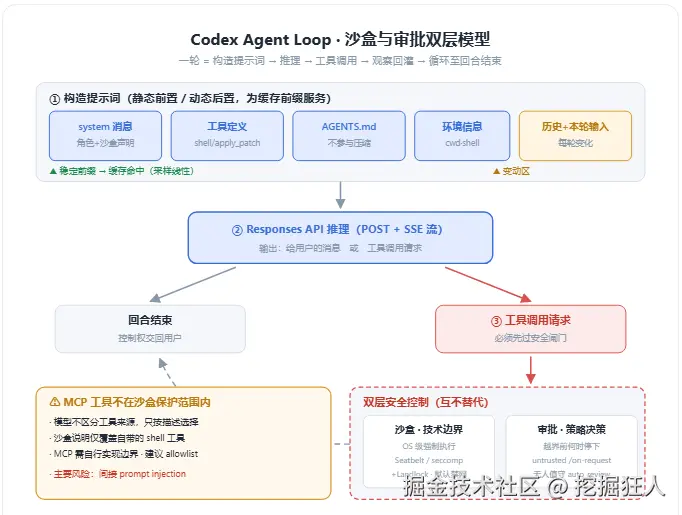
Codex 安全模型里最漂亮的一处解耦:
沙盒定义技术边界,审批策略决定 Codex 在越界前何时必须停下来问你。两者独立。
沙盒是操作系统级强制执行的,不靠模型自觉:
| 平台 | 实现机制 |
|---|---|
| macOS | Seatbelt 策略(sandbox-exec + profile) |
| Linux | seccomp + Landlock 组合 |
| Windows | 原生沙盒,或经 WSL2 使用 Linux 实现 |
| 云端 | OpenAI 托管的隔离容器 |
默认沙盒做两件事:① 默认禁用网络访问;② 文件编辑限制在当前工作区内。 禁用网络不是性能考虑而是安全设计------它显著降低 prompt injection、数据外泄、误连恶意外部资源的风险。
Linux 上有个实际坑:沙盒依赖 bubblewrap(bwrap)。Ubuntu 24.04 上装完 bubblewrap 后,可能仍需加载 bwrap-userns-restrict 的 AppArmor profile,否则启动时会警告"无法创建所需的用户命名空间"。
三种沙盒模式 :read-only(可读,未经审批不可编辑、不可执行命令)、workspace-write(可读、工作区内可编辑、可跑常规本地命令,本地默认)、danger-full-access(无限制,取消文件系统与网络边界)。
三种审批策略:untrusted(非受信任命令前询问)、on-request(默认沙盒内工作,越界时询问)、never(不因审批停止)。
低风险本地自动化的推荐组合是 workspace-write + on-request;"完全访问"等价于 danger-full-access + never,应远离普通用户。配置落在 ~/.codex/config.toml,管理员也可用 requirements.toml 强制下限(如锁定 allowed_sandbox_modes,用户无法放宽)。
中间层是规则(Rules) :与其无脑扩权,不如精确放行或拦截命令前缀。
ini
prefix_rule(
  pattern = ["gh", "pr", ["view", "list"]],
  decision = "allow",
  justification = "只读的 GitHub PR 查看",
)
无人值守的补充 :定时任务和 CI 里没人按审批按钮,于是有 approvals_reviewer = "auto_review"------把符合条件的高风险请求交给评审子智能体 自动裁决。注意:自动审查不改变沙盒边界,它只是边界处的裁决者。
四、AGENTS.md:为什么它不会被"忘记"
多数人把 AGENTS.md 当配置文件,没意识到它的角色特殊得多。它分层加载、逐层拼接,越具体优先级越高:
- ~/.codex/AGENTS.md------个人全局偏好
- 仓库根目录 AGENTS.md------团队共用约定
- 当前工作目录及子目录的 AGENTS.md------子模块细则
注意:同名 AGENTS.override.md 是"替代"同级文件,不是合并。 每层默认 32 KiB 上限。
关键机制:AGENTS.md 的内容不参与上下文压缩。 它是每轮重新带入的初始项目上下文,无论对话多长、压缩多少次,核心规则通常还在。这才是"持久化指令"的真实含义------把约束钉在压缩器够不着的地方。
现在回答引子里的问题:为什么长任务会"行为漂移"? 因为上下文压缩是有损的。token 逼近上限时,系统把早期对话归纳成摘要腾出空间,原则是"保留决策关键信息,丢弃可重建的冗余":
| 维度 | 压缩前 | 压缩后 |
|---|---|---|
| 早期对话 | 完整多轮问答 | "已完成 X,决定采用 Y" |
| 文件读取 | 完整内容 | 关键结论 / 接口签名 |
| 工具日志 | 完整输出与堆栈 | 成败结论 + 关键错误 |
| Token 占用 | 逼近上限(95%+) | 回落到 40%~50% |
问题在这里:你中途用自然语言说的约束,如果没落进 AGENTS.md,就有被压掉的风险。 更麻烦的是,安全类约束在摘要器眼里恰恰像"低信息密度的样板文字",天然容易被丢。社区对此已有研究,做法叫 Constraint Pinning(约束钉定) :把治理类约束排除在压缩之外、每轮重新注入------代价极小,却能把约束违规率压回零。
可操作结论:
- AGENTS.md 要短。 有分析发现大量 agent 技能内容里超过六成是不可执行的冗余。更优写法是渐进式披露:主文件只放核心规则和索引,细则拆到子目录文件按需加载。
- 压缩阈值可调。 建议把自动压缩阈值设到有效窗口的 60% 左右,给摘要器留出空间。
五、MCP:能力扩张,以及它没有的那层保护
MCP 让 Codex 接外部能力------文件系统、数据库、Git、Figma 等。配置顶层键是 mcp_servers(不是 JSON 风格的 mcpServers):
ini
[mcp_servers.server-name]
command = "npx"
args = ["-y", "mcp-server"]
env = { "API_KEY" = "value" }
必须说清的边界 :Codex 往提示词里插入的沙盒说明,只适用于 Codex 自己提供的 shell 工具 。MCP 工具不在沙盒保护范围内,安全边界得由 MCP 实现方负责。
而外部工具生态恰恰是最薄弱的一环。学术界对代码智能体的 prompt injection 做过系统性梳理,结论不乐观:自适应攻击下主流防护的成功率仍可能很高;统计的 CVE 中就包括 MCP 经 STDIO 传输的远程代码执行类漏洞,以及 Codex CLI 自身的命令注入类漏洞。
典型攻击形态是间接注入 :你让 Agent 分析一个 GitHub issue,而 issue 正文埋了指令,诱导它去读敏感文件、或调用某个 MCP 工具并传入攻击者控制的参数。真正的失效点往往不是模型被骗,而是 Agent 的自主性设置本来就放行了这次读取------用户根本没看到确认提示。
防护原则(按性价比排序) :
- 网络默认关着,别急着开;需要时优先域名白名单,而不是放开整张网。
- 把 AGENTS.md、 .codex/ 、MCP 配置、插件、技能都当供应链看------它们和代码一样需要 review。
- MCP 服务器走 allowlist,不要见什么接什么。
- 无人值守任务加更严的围栏:隔离 worktree、明确停止条件、先人工监督试跑。
- 日志可追溯:Codex 支持导出 OpenTelemetry 日志(提示词、审批决策、执行结果、MCP 使用、网络代理允许/拒绝事件),这是事后定责的唯一线索。
六、把这些机制用回实操
回到实战任务:让 Codex 收集近一个月科技产品热点,做成 PPT。 理解机制后,操作方式会不一样:
① 先建项目。 它同时建立上下文容器和可写边界。
② 用结构化描述代替祈使句。 不只说"做什么",而要说清受众、时间范围、重点、用途------模型是按描述做工具调度决策的,描述越具体,调度越准。
③ 选模式。 计划模式先出方案、确认后执行,适合点子未成熟或步骤多的任务;目标模式给出目标后持续工作到完成,适合长任务但 token 消耗可观。工程建议是先计划后目标 ,且注意缓存机制------模式在开跑前定,中途少切。
④ 只配需要的插件。 这次装 Chrome 与 Computer Use。理由不只是整洁:工具清单变动会破坏提示词缓存。
⑤ 权限按场景分级。 读文件、搜资料、生成新文件可放宽;删除文件、登录账号、对外发送必须先确认。
⑥ 执行中纠偏。 发现跑偏了直接输入新要求(如"PPT 色调改成蓝色"),无需中断任务。这个"引导打断"利用的正是"每轮重新构造提示词"这一机制。
⑦ 检查结果,迭代到达标。
流程仍抽象为六步,但每步背后都有一层机制支撑,而不是经验之谈:
描述任务 → 选择模式 → 配置插件 → 观察执行 → 及时纠偏 → 检查结果七、Codex 宠物:一个说明设计意图的小细节
桌面版内置「Pets」组件,按任务状态(运行中 / 等待确认 / 已完成)切换动画,不必反复切窗口。唤醒方式:/pet 指令、Settings → Appearance → Pets,或 Cmd+K / Ctrl+K。
它看似彩蛋,解决的却是真实问题:长任务里用户最需要知道的不是"做到哪一步",而是"是不是卡在等我"。 宠物把"等待确认"外化成可见信号------本质上是审批机制在人机交互层的提示器。
结语:三个真正值得记住的机制
第一,上下文是稀缺且单调增长的资源。 提示词构造顺序、缓存前缀、压缩策略都围绕这一点展开。理解了它,就理解了为什么"少切换、先定配置"是对的。
第二,安全靠双层解耦,不是模型自觉。 沙盒用操作系统能力强制边界(Seatbelt / seccomp+Landlock / 原生沙盒),审批策略决定何时停下问你。但 MCP 工具不在这层保护里------这是最需要你自己补的地方。
第三,约束要写在压缩器够不着的地方。 对话里说的话可能被压掉,AGENTS.md 里的规则不会。凡是需要长期生效的,尽快落成文件。
八大功能是入口、是效率工具;真正决定你能走多远的,是上面这三条机制。2026 年 AI 工具不必每个都学,但 Codex 值得真正用一次------而"真正用一次"的含义,不只是把任务跑通,是知道它为什么这样工作、在哪儿会失效。