在医院信息科工作过的人,大概率都遇到过这样的场景:评审前突击补齐文档,容灾方案写得漂亮,演练报告签字齐全,但真遇到核心交换机故障或勒索病毒攻击时,恢复流程走下来才发现,------备份文件导不进去、数据库版本对不上、跨院区的网络路径根本不通。
问题在于把"有备份"当成了"有容灾"。医院容灾备份系统的建设是一个分层工程,每一层的缺失都会让上层的努力归零。
第一层:基础设施容灾,决定"能不能启动"
HIS、EMR、LIS 这些核心系统的容灾,第一步不是备份数据,而是确保灾难发生时有一套可用的运行环境。当前行业主流实践正逐步向"两地三中心"架构靠拢:同城双活中心通过裸纤互联实现数据实时同步,RPO趋近于零,应用层面支持虚拟机跨域调度;异地灾备中心通过异步复制构建远端数据备份,以抵御区域性灾难。
对于多院区医院,可以利用院区之间的物理距离构建"双活+灾备"混合模式,各院区数据独立写入、实时双向流转。实践表明,基于 X86 架构的容灾平台可实现 RTO≤15 分钟、RPO≈0,支持P1级核心业务系统在灾备平台的持续稳定运行。
这一层的投入门槛不低,但电子病历评级和等保要求已经把标准拉到了这个高度:三级医院要求核心应用异地灾难恢复 RTO 不超过 60 分钟、RPO 不超过 30 分钟,电子病历5级场景下还要求每季度至少进行一次数据恢复验证、每年至少一次灾备演练覆盖所有重要系统数据。
第二层:数据层容灾,决定"数据在不在"
基础设施就绪之后,数据保护策略才是真正的分水岭。全量备份提供"单点可恢复"能力,任何一个完整副本都是独立的恢复源;增量备份把日常传输负担压缩到最小。两者的组合是大多数医院在数据量和恢复效率之间的务实平衡。
但数据层容灾有一个容易被忽略的盲区:备份系统本身也是攻击目标。在勒索病毒攻击场景中,备份系统往往成为首轮攻击对象。这意味着备份数据的存放位置需要与生产系统物理隔离,备份介质本身也需要具备一定的不可篡改性。
当前较先进的做法是引入持续数据保护技术,通过实时 I/O 捕获实现数据零丢失,逻辑故障恢复时间可缩短至1分钟以内,容灾演练周期从3天缩短至10分钟以内。这种"双活-备份-演练"融合架构为医院核心数据库场景提供了可复制的建设范式。
第三层:网络层容灾,决定"能不能恢复"
这是最容易被低估的一层。很多医院在设计容灾方案时把注意力集中在存储和服务器上,却忽略了数据从生产端到备份端、从备份端恢复到生产端所经过的网络路径。
医院网络环境往往比想象中复杂:核心业务在生产内网,部分辅助系统在 DMZ 区,影像数据可能存放在独立的存储网络中,异地灾备中心与主中心之间可能只有有限的专线带宽。如果备份方案只支持一种网络方向------比如只能从内网备份到公网------那么在面对"公网设备需要备份回内网""两个内网之间需要互备但都没有公网IP"这类实际场景时,就会直接卡住。
一套覆盖完整链路的方案需要同时支持内网对内网、内网到公网、公网到内网三种方向,并且在无外网的隔离环境中也能正常运行。对于化验室仪器电脑、影像归档服务器这类处于独立网络区域的设备,备份路径的灵活性直接决定了容灾方案能不能落地。
恢复验证:把"演练"从纸上搬到实际
无论架构设计得多完整,容灾体系最终都要通过演练来验证。当前医院灾备演练的常见问题是周期长、环境搭建繁琐,部分演练流于形式,未模拟真实业务场景。更隐蔽的风险在于,演练时只验证了"数据库能启动",却没有验证路由连通方式、域名解析依赖、代码中硬编码的IP地址是否在灾备环境中依然有效。
有效的演练应当聚焦应用可用性和业务可切换性,至少覆盖三个动作:从备份介质中提取指定时间点的数据并验证可读性,将数据导入灾备环境并确认业务系统能够启动,以及从用户端验证核心业务流程(挂号、开单、收费)是否正常流转。每一步都需要形成可追溯的记录,这些记录在评审时比方案文档本身更有说服力。
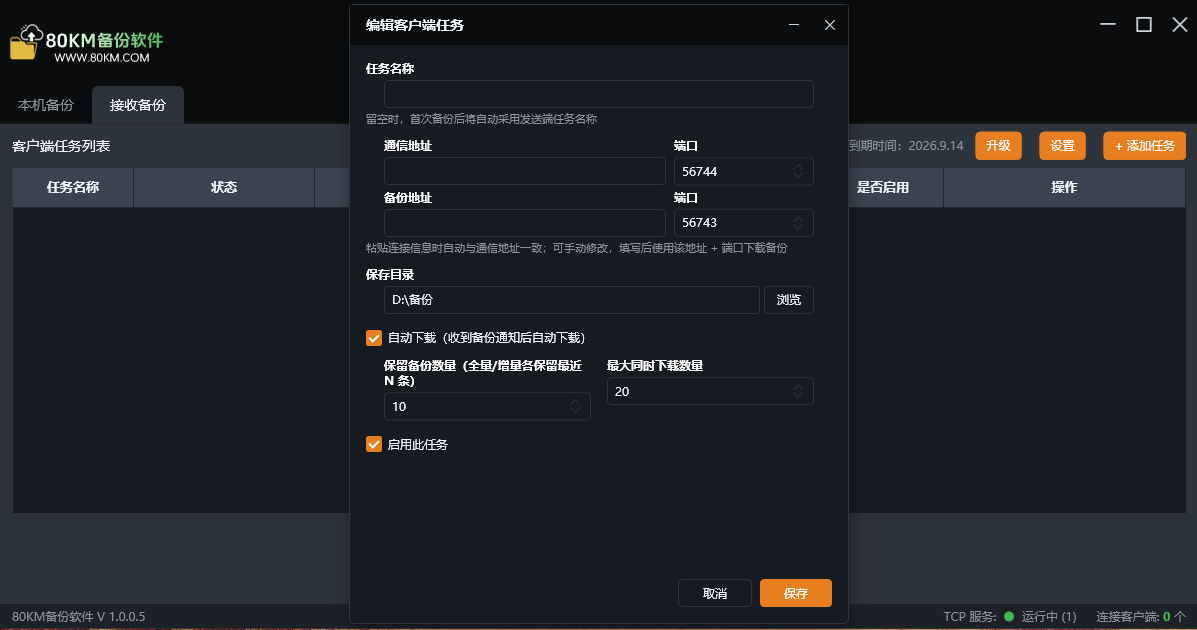
在实际部署层面,除了大型双活数据中心方案,科室级和中小院区同样需要轻量化的备份能力作为补充。以80KM备份软件 为例,它不追求替代双活数据中心,而是为尚未具备完整灾备体系的场景提供节点间的自动化备份能力,支持全量与增量的组合模式,覆盖内网互备、内网到公网、公网到内网三种网络方向,数据保存在自建节点上,适合对数据主权有要求的医疗环境。需要说明的是,该软件当前版本支持全量与增量两种模式,差异备份功能仍在规划中,选型时需注意这一功能边界。
医院容灾备份系统建设的终点,不是采购了多少台存储设备、部署了多少套备份软件,而是当灾难真的发生时,从故障确认到核心业务恢复可用的时间能不能被压缩到临床可接受的范围内。把基础设施、数据和网络这三层都想清楚,比堆砌任何单一技术都更接近这个目标。