这篇文章,我们把生产者消费者模型彻底拆开讲透。先摆出它的"321"原则,说清它凭什么能解耦、又凭什么高效;再落到代码上,用C++实现一个BlockingQueue;最后钻进细节里,把条件变量那些绕不开的坎,while校验、伪唤醒、锁的变迁,一个个剖开看明白。
目录
[1.1 什么是生产者消费者模型](#1.1 什么是生产者消费者模型)
[1.2 一个模型怎么拆开------三种关系、两个角色与一个交易场所](#1.2 一个模型怎么拆开——三种关系、两个角色与一个交易场所)
[1.2.1 三种关系------生产、消费与协作](#1.2.1 三种关系——生产、消费与协作)
[1.2.2 两个角色------生产者与消费者](#1.2.2 两个角色——生产者与消费者)
[1.2.3 一个交易场所------数据如何在两者之间流转](#1.2.3 一个交易场所——数据如何在两者之间流转)
[1.3 为什么需要生产者消费者模型](#1.3 为什么需要生产者消费者模型)
[1.3.1 传统串行处理为什么效率有限](#1.3.1 传统串行处理为什么效率有限)
[1.3.2 生产者消费者模型解决了什么问题](#1.3.2 生产者消费者模型解决了什么问题)
二、BlockingQueue------连接生产者与消费者的中间环节
[3.1 BlockQueue.hpp:阻塞队列的实现](#3.1 BlockQueue.hpp:阻塞队列的实现)
[3.2 Main.cc:生产者与消费者的运行入口](#3.2 Main.cc:生产者与消费者的运行入口)
[3.3 Task.hpp:任务对象的定义](#3.3 Task.hpp:任务对象的定义)
[3.4 阻塞队列实现中的关键细节与常见坑点](#3.4 阻塞队列实现中的关键细节与常见坑点)
[3.4.1 为什么条件判断必须使用while而不是if](#3.4.1 为什么条件判断必须使用while而不是if)
[3.4.2 pthread_cond_wait内部发生了什么:锁的状态如何变化](#3.4.2 pthread_cond_wait内部发生了什么:锁的状态如何变化)
[3.4.3 先Signal还是先Unlock:唤醒与解锁的顺序如何选择](#3.4.3 先Signal还是先Unlock:唤醒与解锁的顺序如何选择)
一、认识生产者消费者模型------从并发问题到线程协作
1.1 什么是生产者消费者模型
多线程编程里,生产者消费者模型是个绕不开的经典范式,专门解决数据共享和线程协作。把它搁进生活里,就像一出戏:**生产者是埋头造货的工厂,消费者是掏钱买货的顾客。**两边并不直接一手交钱一手交货,中间隔着个超市,交易全在超市里完成。
这个模型的本质,就是拿一块由特定数据结构构成的内存空间当缓冲区,把产生数据的线程(生产者)和处理数据的线程(消费者)拆开、解耦。数据高效地流动,任务有条不紊地调度,两头各忙各的,谁也不卡谁。
1.2 一个模型怎么拆开------三种关系、两个角色与一个交易场所
要把这个模型理解得既严谨又系统,可以把它高度凝练成一套"321"原则。
1.2.1 三种关系------生产、消费与协作
缓冲区本质上是一块被多个线程同时访问的临界资源。为了保证数据的正确与一致,生产者与消费者之间必须守住三种约束:
生产者与生产者之间------互斥。 多个生产者同时往货架上摆商品,稍不留神就可能位置冲突,或者把别人刚放好的数据覆盖掉。所以生产者之间也是互斥的,同样存在竞争。
消费者与消费者之间------互斥。 货架上商品少的时候,多个消费者同时伸手去拿同一件,数据一致性就崩了。消费者之间,同样得互斥。
生产者与消费者之间------互斥与同步并存。
-
互斥:生产者往缓冲区里写的时候,消费者不能同时读。不然读到的可能是还没构建完的残缺数据,半成品,没法用。
-
同步:缓冲区满了,生产者就得挂起等待,直到消费者取走数据腾出空间;缓冲区空了,消费者也得挂起等待,直到生产者送来新货。
1.2.2 两个角色------生产者与消费者
生产者:由专门的执行流(线程)承担,负责抓取外部数据、构建任务,然后塞进缓冲区。
消费者:同样由专门的执行流(线程)承担,负责从缓冲区里取数据或任务,执行具体的业务逻辑。
1.2.3 一个交易场所------数据如何在两者之间流转
交易场所:在内存里,它就是一块临界资源,通常由阻塞队列(BlockingQueue)、环形缓冲区(RingBuffer)这类特定数据结构来实现,充当数据的中转缓冲。
1.3 为什么需要生产者消费者模型
1.3.1 传统串行处理为什么效率有限
先看看老路子是怎么走的。在单线程或常规函数调用里,main()里调一个fun(a, b, c),会发生什么?
- main()的执行流必须停下来,干等着fun()把参数处理完。
- 等fun()跑完、结果返回,main()才敢继续往下走。
这种强耦合的机制,把调用方(生产者)和被调用方(消费者)在时间线上死死绑成了一串。一个动,另一个才能动;一个停,另一个也得干等。资源利用率,自然高不到哪去。
1.3.2 生产者消费者模型解决了什么问题
换成生产者消费者模型,局面立刻不一样了。
解耦:生产者不用操心数据被谁消费、什么时候消费,只管往缓冲区里扔。消费者也不用追着生产者要数据,只管从缓冲区里取。两边不直接照面,模块之间的耦合度一下就降下来了。
支持忙闲不均:缓冲区在这里扮演了蓄水池和缓冲垫的角色。工厂临时停产?没关系,超市里还有库存顶着。消费者少?也无所谓,生产者可以铆足劲生产,把仓库填满。两端的处理能力差异,被缓冲区抹平了。
极大提高整体并发效率:这里很多初学者会犯嘀咕,往缓冲区存取数据,不还得加锁互斥吗?入队、出队的过程明明是串行的,凭什么说它高效?
关键在于:效率的提升,根本不体现在临界区里那点加锁存取上,而体现在临界区之外。
-
生产者与消费者之间的并发:生产者在获取外部数据、构建任务,比如网络IO接收、数据解析,这些活,可以和消费者的处理过程同时进行。
-
消费者与消费者之间的并发:多个消费者从缓冲区拿到任务后,可以同时并发地去执行那些耗时业务逻辑,复杂计算、磁盘写入,各跑各的,谁也不用等谁。
锁只锁住了"交接"那一瞬间,真正耗时的活儿,全在锁外面并行跑着。这才是这个模型效率翻倍的真正秘密。
二、BlockingQueue------连接生产者与消费者的中间环节
在多线程编程里,阻塞队列(Blocking Queue)是撑起生产者消费者模型的主力数据结构。它跟普通队列最大的区别,就在"阻塞"这两个字上:
-
队列空了,还想取元素?对不起,取不了。操作会被阻塞,一直等到有生产者往里头塞进新元素为止。
-
队列满了,还想放元素?也不行。操作同样被阻塞,一直等到有消费者从里头取走元素、腾出空间为止。
当然,这些阻塞都发生在不同线程之间。一个线程在阻塞队列上操作时,一旦条件不满足,它自己就会被挂起。
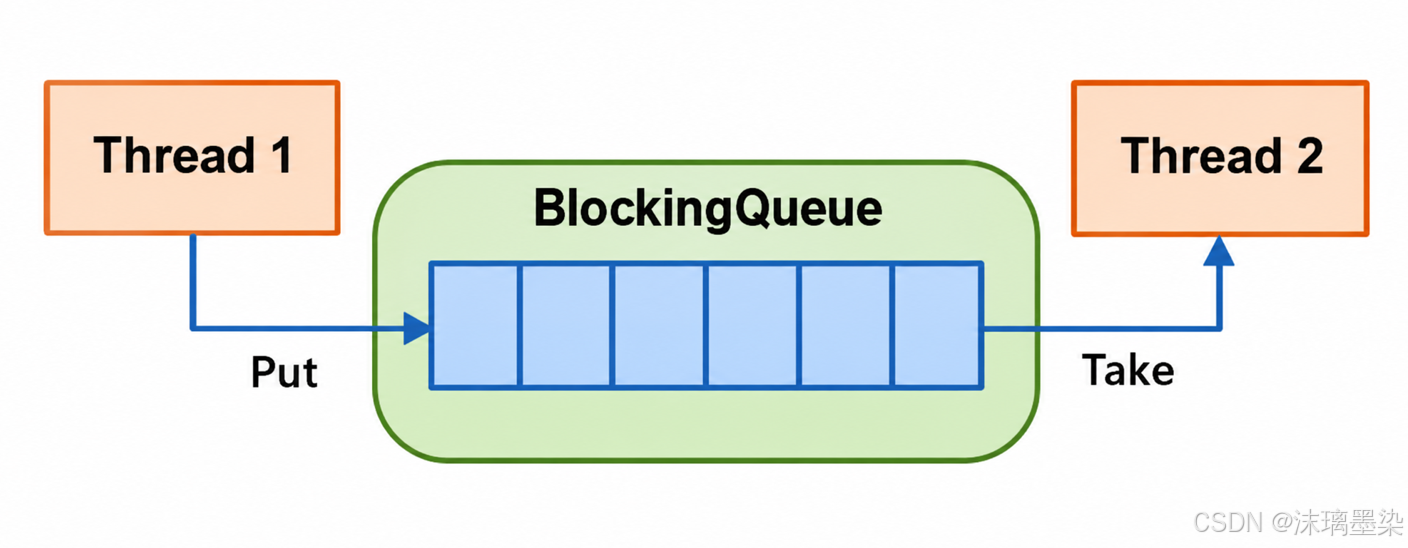
一句话概括:阻塞队列是一个容量有上限的队列。读写条件不满足的时候,对应的线程就得乖乖阻塞,等条件成熟再动。
三、用阻塞队列实现生产者消费者模型
理论讲完了,接下来动手写代码。下面这个BlockQueue.hpp,就是我们自己实现的阻塞队列。它用互斥锁保安全,用两个条件变量分别管理生产者和消费者的等待与唤醒,是一个标准的生产者消费者模型底座。
3.1 BlockQueue.hpp:阻塞队列的实现
cpp
#pragma once
#include <iostream>
#include <pthread.h>
#include <unistd.h>
#include <queue>
#include <cstdio>

const size_t DEFULT_CAPACITY = 5;

namespace MyBlockQueue
{
    template<class T>
    class BlockQueue
    {
    private:
        bool IsFull()
        {
            return _queue.size() == _capacity;
        }
        bool IsEmpty()
        {
            return _queue.empty();
        }
    public:
        BlockQueue(int cap = DEFULT_CAPACITY)
            : _capacity(cap)
            , sleep_c(0)
            , sleep_p(0)
        {
            pthread_mutex_init(&_mutex, nullptr);
            pthread_cond_init(&_cond_c, nullptr);
            pthread_cond_init(&_cond_p, nullptr);
        }

        void Equeue(const T& args)
        {
            // 生产者调用
            pthread_mutex_lock(&_mutex);
            while (IsFull())
            {
                std::cout << "生产者进入休眠 sleep_p = " << sleep_p << std::endl;
                sleep_p++;
                pthread_cond_wait(&_cond_p, &_mutex);
                sleep_p--;
            }
            _queue.push(args);
            if (sleep_c != 0)
            {
                pthread_cond_signal(&_cond_c);
            }
            pthread_mutex_unlock(&_mutex);
        }

        T Pop()
        {
            // 消费者调用
            pthread_mutex_lock(&_mutex);
            while (IsEmpty())
            {
                std::cout << "消费者进入休眠 sleep_c = " << sleep_c << std::endl;
                sleep_c++;
                pthread_cond_wait(&_cond_c, &_mutex);
                sleep_c--;
            }
            T _data = _queue.front();
            _queue.pop();

            if (sleep_p != 0)
            {
                pthread_cond_signal(&_cond_p);
            }
            pthread_mutex_unlock(&_mutex);
            return _data;
        }

        ~BlockQueue()
        {
            pthread_mutex_destroy(&_mutex);
            pthread_cond_destroy(&_cond_p);
            pthread_cond_destroy(&_cond_c);
        }

    private:
        std::queue<T> _queue;
        size_t _capacity;
        pthread_mutex_t _mutex;
        pthread_cond_t _cond_p;
        pthread_cond_t _cond_c;
        size_t sleep_c;
        size_t sleep_p;
    };
}
3.2 Main.cc:生产者与消费者的运行入口
这段Main.cc是生产者消费者模型的主程序,把BlockQueue真正跑起来。它创建了5个生产者线程和5个消费者线程,生产者往队列里丢任务,消费者从队列里取任务并执行。
cpp
#include "BlockQueue.hpp"
#include "Task.hpp"

// Producer-Consumer Problem
const size_t THREAD_SIZE = 5;

class ThreadData
{
public:
    ThreadData(MyBlockQueue::BlockQueue<task_t>* bqueue, char* name)
        : _bqueue(bqueue)
        , _name(name)
    {}

    MyBlockQueue::BlockQueue<task_t>* _bqueue;
    char* _name;
};

void *Produce(void *args)
{
    MyBlockQueue::BlockQueue<task_t>* _bqueue =
        static_cast<ThreadData*>(args)->_bqueue;
    while (true)
    {
        std::cout << "生产一个任务" << std::endl;
        _bqueue->Equeue(DownLoadTask);
    }
    delete[](static_cast<ThreadData*>(args)->_name);
}

void *Consumer(void *args)
{
    sleep(3);
    MyBlockQueue::BlockQueue<task_t>* _bqueue =
        static_cast<ThreadData*>(args)->_bqueue;
    while (true)
    {
        std::cout << "消费一个任务" << std::endl;
        task_t task = _bqueue->Pop();
        task();
    }
    delete[](static_cast<ThreadData*>(args)->_name);
}

int main()
{
    std::vector<pthread_t> pnums;
    std::vector<pthread_t> cnums;
    MyBlockQueue::BlockQueue<task_t>* bqueue =
        new MyBlockQueue::BlockQueue<task_t>();

    // 生产者创建
    for (int i = 0; i < THREAD_SIZE; i++)
    {
        pthread_t tid = 0;
        char *name = new char[64];
        int n = snprintf(name, 64, "PThread-%d", i);
        (void)n;
        ThreadData* data = new ThreadData(bqueue, name);
        pthread_create(&tid, nullptr, Produce, data);
        pnums.push_back(tid);
    }

    // 消费者创建
    for (int i = 0; i < THREAD_SIZE; i++)
    {
        pthread_t tid = 0;
        char *name = new char[64];
        int n = snprintf(name, 64, "CThread-%d", i);
        (void)n;
        ThreadData* data = new ThreadData(bqueue, name);
        pthread_create(&tid, nullptr, Consumer, data);
        cnums.push_back(tid);
    }

    // 回收生产者
    for (auto e : pnums)
    {
        pthread_join(e, nullptr);
    }

    // 回收消费者
    for (auto e : cnums)
    {
        pthread_join(e, nullptr);
    }
    return 0;
}
3.3 Task.hpp:任务对象的定义
先看这个任务定义的头文件:
cpp
#pragma once
#include <functional>

using task_t = std::function<void(void)>;

void DownLoadTask(void)
{
    std::cout << "这是一个下载任务" << std::endl;
}
短短几行,却把生产者消费者模型里"任务"这个角色定死了。
task_t是一个类型别名,本质上是std::function<void(void)>,一个不接受参数、也不返回任何东西的可调用对象。有了它,生产者往队列里塞的就不只是冷冰冰的数据,而是"一段待执行的逻辑"。消费者从队列里取出来的,也不是单纯的数字或字符串,而是一个可以立刻task()调用的动作。
DownLoadTask就是一个具体的任务实现,简单到只打印一行字。但它示范了任务的统一形态:不管未来是下载、计算、写日志还是发网络请求,只要签名对得上,都能塞进这个task_t里,被生产者丢进队列,再由消费者取出来执行。
这层抽象,正是生产者消费者模型"解耦"二字的物理落点:生产者只管造任务,消费者只管跑任务,中间隔着一个队列,谁也不知道对方是谁。
3.4 阻塞队列实现中的关键细节与常见坑点
用条件变量和阻塞队列搭生产者消费者模型,有几个细节藏得极深,但个个致命。
3.4.1 为什么条件判断必须使用while而不是if
有些实现里,会写出这么一段逻辑:
cpp
// 存在严重 Bug 的逻辑
if (IsFull())
{
    _psleep_num++;
    pthread_cond_wait(&_full_cond, &_mutex); // 被唤醒后直接往下走
    _psleep_num--;
}
_q.push(in); // 万一碰上伪唤醒或广播唤醒,就会往已满的队列里硬塞数据!
问题出在哪?两种场景,都能让它当场翻车。
场景一:伪唤醒(Spurious Wakeup)。 pthread_cond_wait有可能在没有任何线程调用pthread_cond_signal的情况下,因为系统信号或内核调度之类的原因,莫名其妙地返回。没人叫它,它自己醒了。这时候条件根本没变,你却以为可以往下走了。
场景二:广播唤醒(pthread_cond_broadcast)。 假设多生产者场景下,队列已经满了,5个生产者线程全都堵在等待上。这时消费者取走1个元素,调用pthread_cond_broadcast,一口气把 5 个生产者全叫醒。
第一个抢到锁的生产者,成功插入元素,队列重新变满。等它释放锁,剩下4个生产者依次拿到锁,从pthread_cond_wait里返回。可因为用的是if,它们压根不会再检查队列状态,直接执行 _q.push(in),往一个已经满了的队列里硬塞。数据溢出、逻辑崩溃,一连串事故全来了。
解决方案:把if换成while。
cpp
// 正确写法:循环检查条件
while (IsFull())
{
    _psleep_num++;
    pthread_cond_wait(&_full_cond, &_mutex);
    _psleep_num--;
}
_q.push(in); // 重新拿到锁,且百分百确认 IsFull() 为 false,才执行插入
只要线程被唤醒、重新拿到锁,就必须回到while开头重新检测条件。条件不满足?那就继续挂起等待。一次不行就再等一次,直到条件真正成熟,才允许往下走。这样,伪唤醒也好,广播唤醒也好,都骗不过这道循环关卡。
3.4.2 pthread_cond_wait内部发生了什么:锁的状态如何变化
把pthread_cond_wait的内部执行流程搞明白,是彻底吃透条件变量的关键。一句话概括它的行为:
cpp
挂起前:自动释放锁 → 挂起等待
唤醒后:被唤醒 → 重新竞争锁 → 拿到锁后返回

pthread_cond_wait(&_full_cond, &_mutex);
**自动释放锁:**函数调用成功后,在挂起当前线程之前,系统会自动且原子地释放传入的_mutex锁。这一手很关键,锁不释放,别的线程就进不来,条件永远改变不了,持有锁休眠就是死锁的温床。
**重新申请锁:**线程被唤醒时,默认是站在临界区外被叫醒的。要从pthread_cond_wait成功返回,它必须重新申请并成功拿到_mutex锁。不是醒了就算数,醒了还得重新排队抢锁。
**锁竞争阻塞:**如果被唤醒后申请锁失败,说明锁被别人抢走了。这时候线程不会干瞪眼,而是乖乖在互斥锁的等待队列上阻塞,直到成功获取到锁,才从函数返回。
3.4.3 先Signal还是先Unlock:唤醒与解锁的顺序如何选择
生产或消费完毕,准备唤醒对端线程的时候,代码有两种写法:
cpp
// 写法一:先唤醒,再解锁(推荐)
pthread_cond_signal(&_empty_cond);
pthread_mutex_unlock(&_mutex);

// 写法二:先解锁,再唤醒
pthread_mutex_unlock(&_mutex);
pthread_cond_signal(&_empty_cond);
看着只是两行代码调了个顺序,里头的门道却不少。
写法一(先唤醒,再解锁):先把等待线程叫醒,让它从条件变量的等待队列,转到互斥锁的等待队列里排队。然后当前线程再解锁,被唤醒的线程去抢锁,抢到了就继续往下跑。
写法二(先解锁,再唤醒):先放手,把锁放出去。可万一这时候有第三方线程手快,抢先拿到锁、把状态又改了,那接下来这个signal唤醒的线程,面对的就已经不是当初那个局面了。信号照样发,等待线程照样转到锁的等待队列,但中间多了一层不确定性。
单从理论上看,写法二似乎还更"聪明"一点,先解锁,等被唤醒的线程去抢锁时,锁已经空出来了,省掉"醒来发现锁没放"的额外步骤。
但现实是,Linux的NPTL实现里,内核对写法一有wait-morphing(requeue)优化。 它能直接在内核层把线程从条件变量队列挪进锁等待队列,中间不产生虚假的上下文切换开销。写法一的那点"理论劣势",被内核优化抹平了。
所以,工程规范和POSIX标准都更推荐写法一:先唤醒,再解锁。 逻辑更一致,代码更严谨,还不用担心第三方线程插队捣乱。
如果这篇文章对你有帮助,别忘了点个赞、点个收藏、点个关注。你的每一次反馈,都是我继续硬核输出的最大动力。