做数据科学和机器学习,范数(Norm)这个东西你迟早会碰到。
损失函数正则化、向量相似度计算、矩阵分解------这些场景背后都有范数的影子。
但很多同学对范数的理解停留在"好像是个求长度的东西"这个层面,具体怎么算、不同范数之间有什么区别,一问就含糊了。
其实范数没那么抽象,用 NumPy 的 linalg.norm() 函数跑几行代码,再配合几何直观,基本就能搞明白。
下面从最基础的概念出发,一步一步把常见的向量和矩阵范数过一遍。
1. 范数到底是什么?
先说人话:范数就是给向量(或矩阵)量"大小"的一种方式。
你在高中学过的向量长度,其实就是一种范数------L2 范数。
但 "大小" 这个概念可以有不同的定义方法,就像你可以用直线距离衡量两点远近,也可以用"走街道的格子距离"来衡量(想想曼哈顿的街区)。
每种定义方式对应一种范数。
从数学上说,范数是一个函数,它把 n 维向量空间里的向量映射到一个非负实数:
∥⋅∥:Rn→R
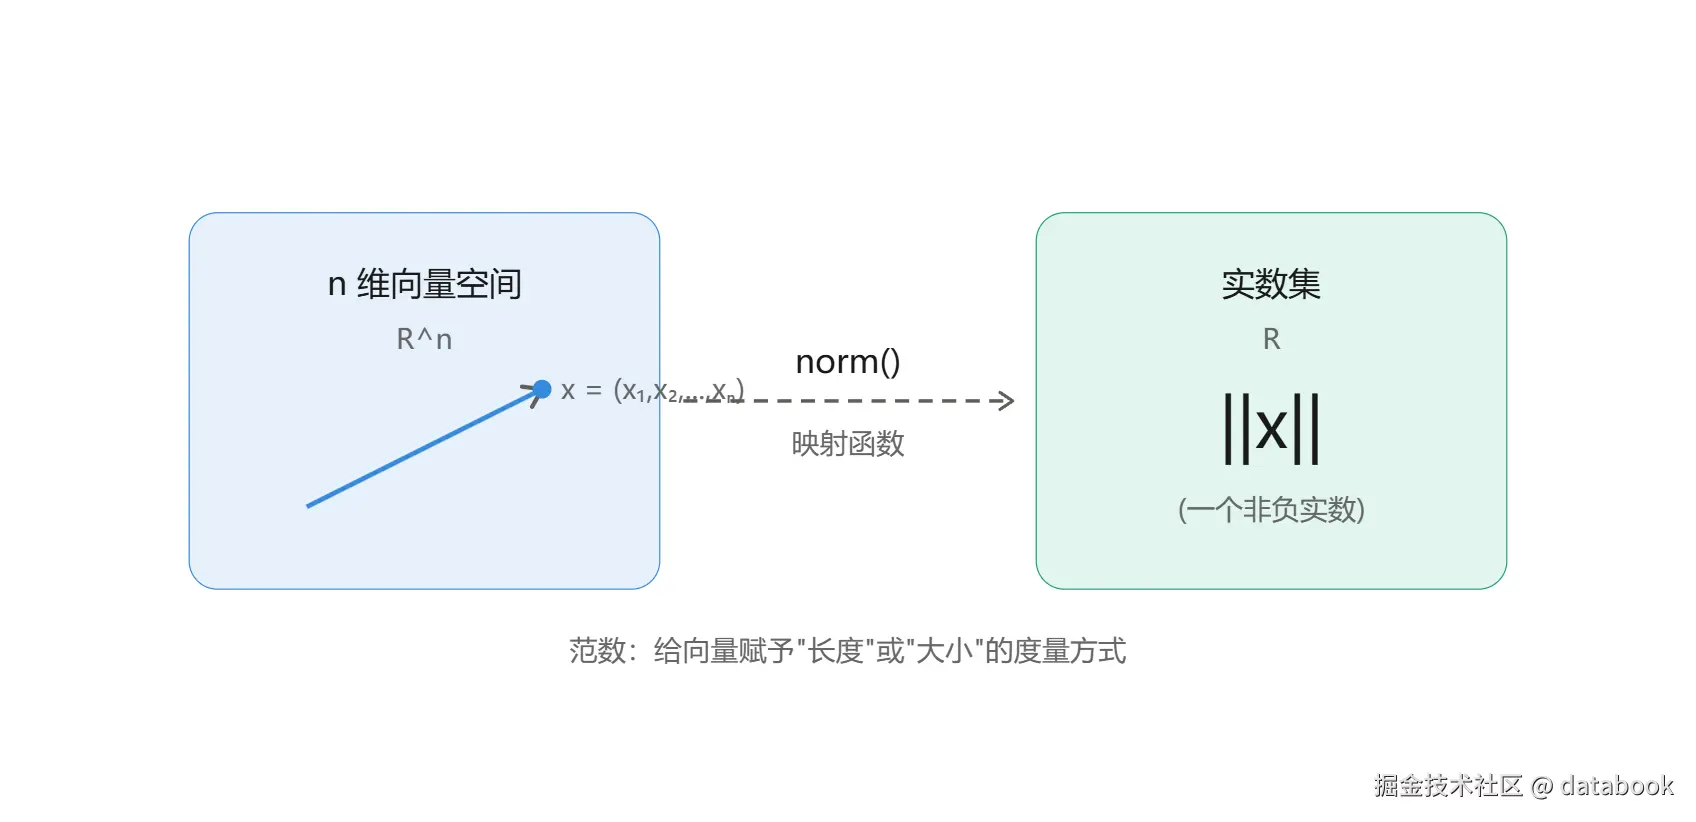
一个合法的范数需要满足三条性质:
- 非负性:范数永远大于等于零,只有零向量的范数才等于零
- 三角不等式 :两个向量之和的范数不超过各自范数之和( ∥x+y∥≤∥x∥+∥y∥),这跟三角形两边之和大于第三边是一个道理
- 齐次性:向量乘以一个标量 α 后,范数也乘以 |α|
这三条看起来有点数学味,但直觉上就是任何合理的"长度度量"都应该遵守的规则。
2. 向量范数家族:L1、L2 和 L∞
所有 Lp 茁数都从一个通用的公式出发。对于向量 x = (x₁, x₂, ..., xₙ),它的 Lp 范数定义为:
∥x∥p=(∑i=1n∣xi∣p)1/p
p 取不同的值,就得到不同的范数。
我们挑最常用的三种来说。
2.1 L1 范数:曼哈顿距离
把 p=1 代入上面的公式,绝对值的幂次和根号都消失了,剩下的是所有元素绝对值之和:
∥x∥1=∑i=1n∣xi∣
L1 范数也叫曼哈顿距离(Manhattan Distance),因为你想象在曼哈顿城里走路,只能沿着街道的格子走,不能穿建筑物的对角线,走过的街区总数就是 L1 距离。
在机器学习里,L1 正则化(Lasso)用的就是这个东西,它倾向于让模型参数变得稀疏------很多参数直接变成零,这在特征选择中特别有用。
2.2 L2 范数:我们熟悉的欧几里得距离
p=2 时就是我们最熟悉的向量长度:
∥x∥2=∑i=1nxi2
这就是高中数学里那个"勾股定理推广到 n 维"的版本。
L2 范数是默认的、最直观的"长度",也是 NumPy 中 norm() 函数不传额外参数时默认计算的范数。
L2 正则化(Ridge)用的就是它,它会让参数整体变小,但不会像 L1 那样产生大量精确的零。
2.3 L∞ 范数:最大值决定一切
当 p 趋近于无穷大时,公式中最大的那个分量会主导整个求和结果,所以 L∞ 范数就是所有元素绝对值的最大值:
∥x∥∞=max(∣x1∣,∣x2∣...,∣xn∣)
这个范数在某些优化问题和数值分析中会出现,它的特点是只关心"最极端"的那个分量。
下面这张图把三种范数的几何意义放在一起对比,一看就能感受到它们的区别:
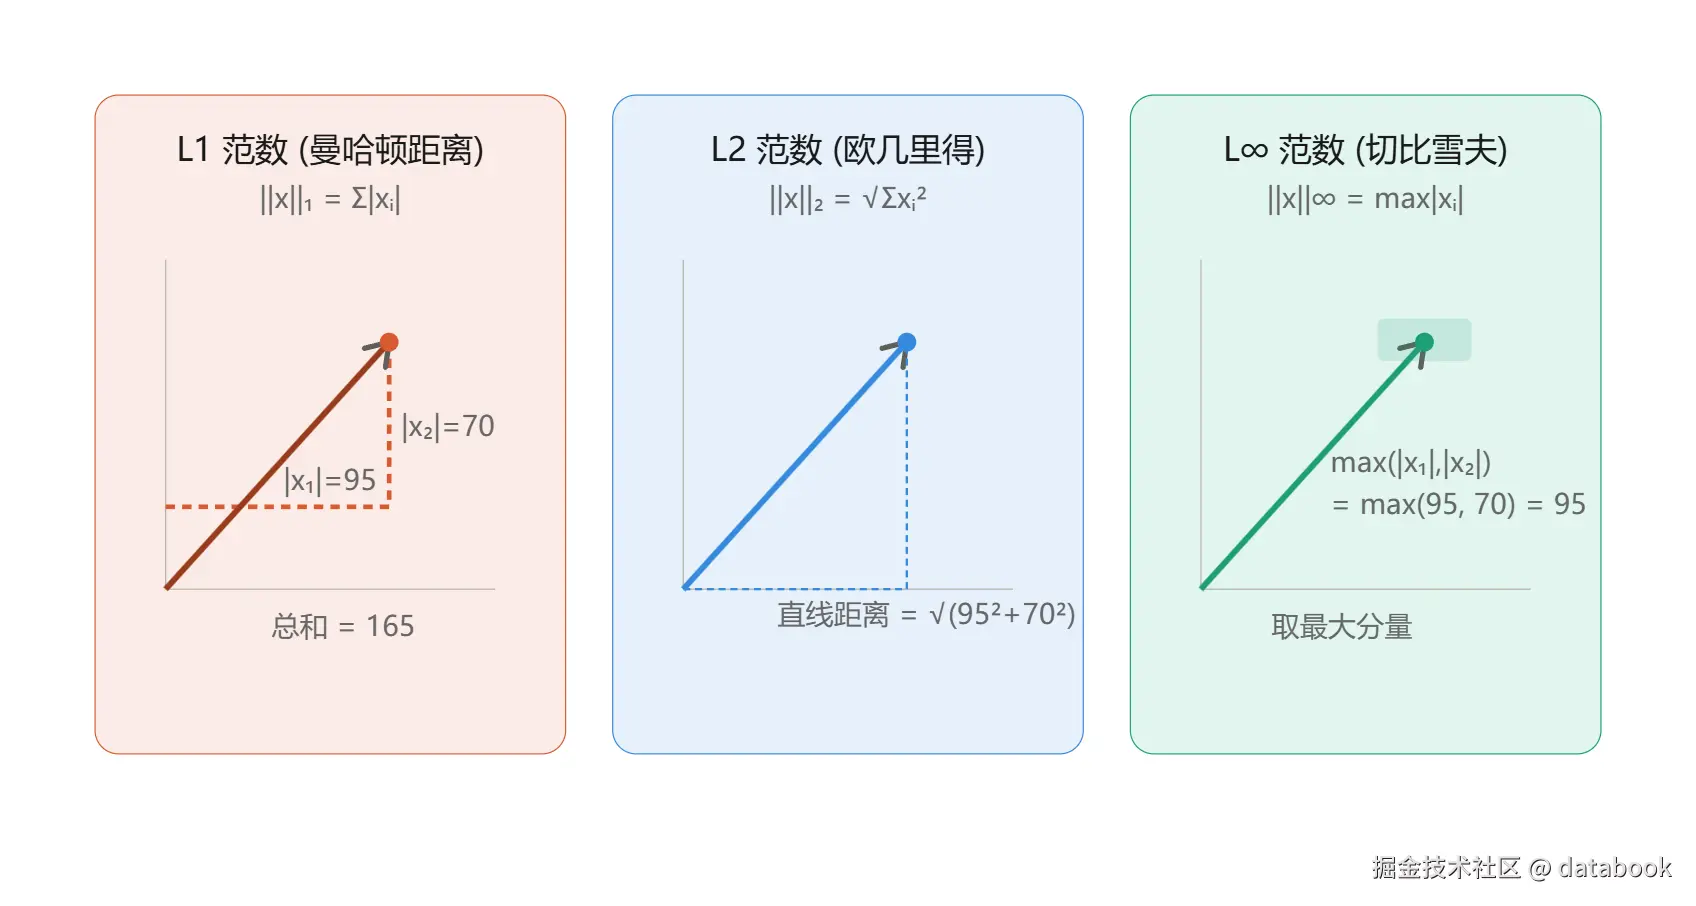
可以看到,同一个向量(图中从原点到终点的箭头),三种范数给出了完全不同的"大小"值。L1 是沿坐标轴走的折线距离之和,L2 是直线距离,L∞ 则只看最大的那个分量。
3. 用 NumPy 动手算向量范数
概念说完了,上代码。NumPy 的 linalg 模块提供了 norm() 函数,基本上一个函数搞定所有范数计算。
先准备一个测试向量:
python
import numpy as np
from numpy import linalg

vector = np.arange(1, 7)   # [1, 2, 3, 4, 5, 6]
print(vector)
# 输出: [1 2 3 4 5 6]
3.1 计算 L2 范数(默认行为)
norm() 最简单的用法------不传任何可选参数,它就算 L2 范数:
python
l2_norm = linalg.norm(vector)
print(f"{l2_norm = :.2f}")
# 输出: l2_norm = 9.54
你也可以显式地指定 ord=2,结果完全一样:
python
l2_norm = linalg.norm(vector, ord=2)
print(f"{l2_norm = :.2f}")
# 输出: l2_norm = 9.54
手动验证一下:√(1²+2²+3²+4²+5²+6²) = √91 ≈ 9.539,对上了。
3.2 计算 L1 范数
把 ord 设为 1 就行:
python
l1_norm = linalg.norm(vector, ord=1)
print(f"{l1_norm = :.2f}")
# 输出: l1_norm = 21.00
因为我们的向量全是正数,L1 茁数就等于各元素之和:1+2+3+4+5+6 = 21。如果向量里有负数,会先取绝对值再求和。
3.3 计算 L∞ 范数
ord 设为 np.inf:
python
inf_norm = linalg.norm(vector, ord=np.inf)
print(f"{inf_norm = }")
# 输出: inf_norm = 6.0
结果 6 就是向量中的最大值。顺便说一下,ord=-np.inf 也是合法的,它返回最小绝对值:
python
neg_inf_norm = linalg.norm(vector, ord=-np.inf)
print(f"{neg_inf_norm = }")
# 输出: neg_inf_norm = 1.0
3.4 L0 范数:数非零元素
严格来说 L0 不是真正的范数(它违反了齐次性------乘以标量后非零元素个数不变),但它很实用。ord=0 会返回向量中非零元素的个数:
python
another_vector = np.array([1, 2, 0, 5, 0])
l0_norm = linalg.norm(another_vector, ord=0)
print(f"{l0_norm = }")
# 输出: l0_norm = 3.0    # 三个非零元素
这在稀疏向量分析中经常用到,比如看看一个嵌入向量中有多少维度是非零的。
到这里,向量范数这块就比较完整了。小结一下:numpy.linalg.norm() 通过 ord 参数来切换范数类型,ord=1 是 L1,ord=2(或省略)是 L2,ord=np.inf 是 L∞,ord=0 数非零元素。一个函数,几种用法,记忆负担很小。
4. 矩阵范数:从向量到二维的推广
向量搞定了,矩阵怎么办?其实矩阵范数可以理解为向量范数在二维上的推广------同样是给一个矩阵赋予一个"大小"的标量值。
最常见的两种矩阵范数是 Frobenius 范数 和核范数(Nuclear Norm),它们各有各的用途。
4.1 Frobenius 范数:矩阵版的 L2
Frobenius 范数的计算方式非常直观------把矩阵的所有元素平方后求和,再开根号:
∥A∥F=∑i=1m∑j=1n∣aij∣2
你可以把它想象成把矩阵"拉平"成一个长向量,然后对这个向量求 L2 范数。
它在数值计算和深度学习中经常出现,比如权重衰减有时候就用 Frobenius 范数来约束。
先把之前的向量 reshape 成矩阵:
python
matrix = vector.reshape(2, 3)
print(matrix)
# 输出:
# [[1 2 3]
#  [4 5 6]]
计算 Frobenius 范数:
python
# 显式指定 'fro'
frob_norm = linalg.norm(matrix, ord='fro')
print(f"{frob_norm = :.2f}")
# 输出: frob_norm = 9.54

# 不指定 ord,默认也是 Frobenius
frob_norm = linalg.norm(matrix)
print(f"{frob_norm = :.2f}")
# 输出: frob_norm = 9.54注意这里的一个设计细节:对于向量,norm() 默认算 L2 范数;对于矩阵,默认算 Frobenius 范数。
NumPy 帮你做了这个区分,挺贴心的。
4.2 核范数:奇异值之和
核范数(Nuclear Norm)稍微特殊一点,它基于矩阵的 SVD 分解(奇异值分解)。
简单来说,一个矩阵可以被分解成三个矩阵的乘积 A=UΣVT,其中 Σ 对角线上的元素就是奇异值。
核范数就是所有奇异值之和:
∥A∥∗=σ1+σ2+...+σk
核范数在矩阵补全(Matrix Completion)、推荐系统、降维等场景中大量使用。
它的一个重要性质是可以作为矩阵"秩"的凸近似------直接优化秩是 NP 难的,但优化核范数可以用凸优化的方法高效求解。
python
nuc_norm = linalg.norm(matrix, ord='nuc')
print(f"{nuc_norm = :.2f}")
# 输出: nuc_norm = 10.28
4.3 沿指定轴计算:axis 参数的威力
实际工作中,有时候我们不想对整个矩阵求一个总的范数,而是想按行或按列分别计算。
这时候 axis 参数就派上用场了。
以 L1 范数为例:
python
# axis=0:沿列方向计算(跨行,对每列求范数)
col_norms = linalg.norm(matrix, ord=1, axis=0)
print(f"{col_norms = }")
# 输出: col_norms = array([5., 7., 9.])
# 含义:第1列 |1|+|4|=5,第2列 |2|+|5|=7,第3列 |3|+|6|=9

# axis=1:沿行方向计算(跨列,对每行求范数)
row_norms = linalg.norm(matrix, ord=1, axis=1)
print(f"{row_norms = }")
# 输出: row_norms = array([ 6., 15.])
# 含义:第1行 1+2+3=6,第2行 4+5+6=15
这个功能在做数据归一化的时候特别有用。
比如你想把每一列的数据缩放到单位范数,就可以用 axis=0 先算出每列的范数,再做除法。
5. 一张图总结 norm() 的用法
说了这么多,最后用一张表把 numpy.linalg.norm() 的核心用法汇总一下:
| 目标 | 写法 | 说明 |
|---|---|---|
| 向量 L2 范数 | linalg.norm(v) 或 linalg.norm(v, ord=2) |
默认行为,欧几里得长度 |
| 向量 L1 范数 | linalg.norm(v, ord=1) |
绝对值之和 |
| 向量 L∞ 范数 | linalg.norm(v, ord=np.inf) |
最大绝对值 |
| 非零元素计数 | linalg.norm(v, ord=0) |
L0 伪范数 |
| 矩阵 Frobenius | linalg.norm(M) 或 linalg.norm(M, ord='fro') |
矩阵默认行为 |
| 矩阵核范数 | linalg.norm(M, ord='nuc') |
奇异值之和 |
| 按列求范数 | linalg.norm(M, ord=p, axis=0) |
跨行计算 |
| 按行求范数 | linalg.norm(M, ord=p, axis=1) |
跨列计算 |
记住两个关键就行:ord 决定范数类型 ,axis 决定计算方向。
其他的基本都是围绕这两个参数的组合变化。