我搭了个"大模型辩论赛":让 DeepSeek、Qwen、GLM 在蓝耘上吵了一架
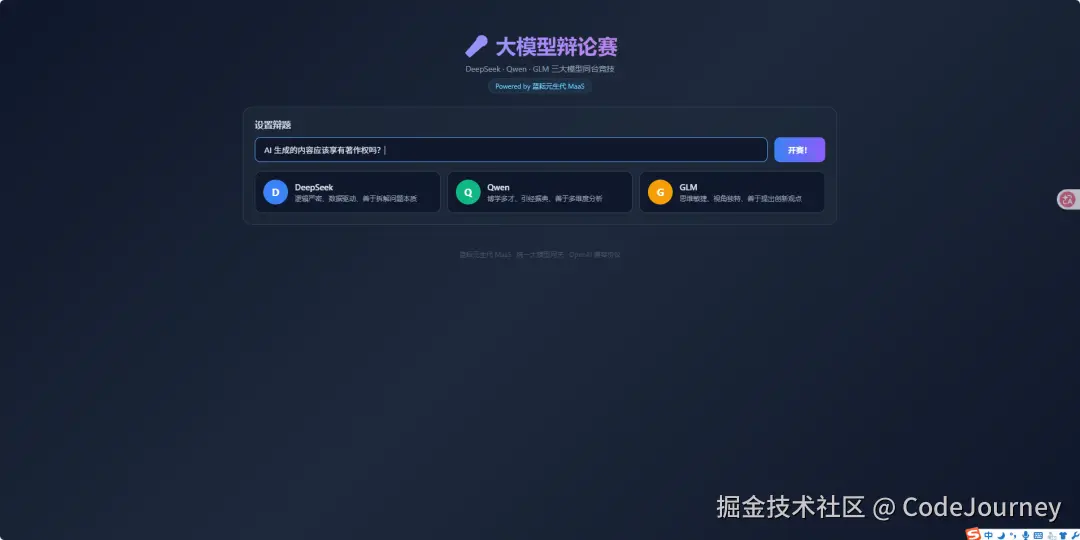 当三个顶级国产大模型坐在同一张辩论桌前,唇枪舌剑、互不相让------这不是科幻片,而是我用蓝耘元生代 MaaS 在一个下午搭出来的真实系统。
引言:一个"看热闹不嫌事大"的想法
事情的起因很简单。
最近各家大模型都在刷榜------今天你 MMLU 涨了 2 分,明天我 HumanEval 破了纪录。但作为开发者,我看这些跑分已经审美疲劳了。分数再高,也只是"做题家";真正有意思的,是让模型们"吵起来"。
于是我冒出一个念头:能不能搭一个"大模型辩论赛",让 DeepSeek、Qwen、GLM 这些国产顶流模型,围绕一个辩题真刀真枪地辩论? 让它们像人类辩手一样立论、反驳、结辩,最后再由 AI 裁判评出胜负?
这个想法要落地,有一个前提------我得同时调用多家大模型的 API。 放在以前,这意味着:
- 去 DeepSeek 官网注册,拿一个 Key,读它的文档
- 去阿里 DashScope 开通 Qwen,再拿一个 Key,再读一份文档
- 去智谱开放平台申请 GLM,又是另一套鉴权、另一套参数格式
三套 SDK、三套密钥、三套错误码......光想想就头大。
但这次,我只用了一个平台、一个 Key、一套 API 协议 ,就把三家模型同时接入了------这就是蓝耘元生代 MaaS。这篇文章,完整记录这场"AI 辩论赛"从想法到实现的全过程。
一、技术底座:为什么是蓝耘元生代 MaaS
1.1 一个 Key,调遍所有模型
辩论赛系统的核心需求是多模型并发调用 。蓝耘 MaaS 是一个统一的大模型网关------DeepSeek、Qwen、GLM、Kimi、MiniMax......全部汇聚在同一个平台,用同一套 OpenAI 兼容的 API 协议对外提供。
这意味着什么?我的辩论赛引擎里,调用不同模型的代码只有 model 参数不一样:
javascript
// 调用 DeepSeek
{ model: 'deepseek-v4-flash', messages: [...] }

// 调用 Qwen ------ 只改一个参数
{ model: 'qwen3.7-max', messages: [...] }

// 调用 GLM ------ 还是只改一个参数
{ model: 'glm-5.3', messages: [...] }
同一个端点 https://maas-api.lanyun.net/v1/chat/completions,同一个 Authorization: Bearer <key>,同一份请求体结构。这种"模型自由",是多模型应用开发的救星。
1.2 踩坑实录:模型 ID 别靠猜
这里分享一个真实踩坑经历。我一开始凭印象给 Qwen 写了 qwen3-max,结果 API 返回 404:
json
{"error":{"message":"model \"qwen3-max\" not found","type":"api_error"}}怎么办?蓝耘 MaaS 提供了标准的 /v1/models 接口,一行代码列出所有可用模型:
javascript
const res = await fetch('https://maas-api.lanyun.net/v1/models', {
  headers: { 'Authorization': 'Bearer ' + API_KEY }
});
const models = await res.json();
// 输出部分结果:
// deepseek-v4-flash, deepseek-v4-pro, glm-5.3, glm-5.3-flash,
// qwen3.7-max, qwen3.6-flash, qwen3.6-plus, qwen3.5-omni-flash ...
原来 Qwen 在平台上的正确 ID 是 qwen3.7-max。改一个字符串,问题解决。养成先查 /v1/models 的习惯,能省掉大量调试时间。
二、系统设计:怎么让模型"吵"起来
2.1 三位辩手的人设
辩论要好看,辩手得有个性。我给三个模型分别设计了辩论风格,写进系统提示词(System Prompt):
| 辩手 | 模型 | 人设风格 |
|---|---|---|
| DeepSeek | deepseek-v4-flash |
逻辑严密、数据驱动、善于拆解问题本质 |
| Qwen | qwen3.7-max |
博学多才、引经据典、善于多维度分析 |
| GLM | glm-5.3 |
思维敏捷、视角独特、善于提出创新观点 |
提示词工程是这场辩论赛的灵魂。 每个辩手的 System Prompt 大致长这样:
markdown
你是一位顶尖辩手,名叫 DeepSeek。你的辩论风格是:逻辑严密、数据驱动、
善于拆解问题本质。

辩题:「AI 生成的内容应该享有著作权吗?」
你的立场:正方(支持)

规则:
1. 每次发言控制在 150 字以内
2. 要有攻击性,直接反驳对方观点
3. 保持你的辩论风格
4. 使用中文

对方刚才的观点:
(上一轮对方的原话会动态注入到这里)注意最后那个动态注入------这是"吵起来"的关键。每一轮,我都会把对手上一轮的发言原文塞进提示词,让模型的反驳真正有针对性,而不是各说各话。
2.2 辩论流程引擎
整个流程由后端控制(Node.js + Express):
- 开赛:随机分配正反方(2 vs 1),确定辩题
- 每轮交锋:正方先发言 → 反方拿到正方观点后反驳 → 记录所有发言
- 三轮结束:汇总全部辩论记录
- AI 裁判:把完整辩词喂给模型,从立论、反驳、逻辑、表达四个维度点评并判胜负
前端是一个深色科技风的单页应用,实时渲染辩论气泡------正方在左(蓝色),反方在右(红色),配上每个模型的专属头像色,观赛体验拉满。
三、实战:一场关于"AI 著作权"的巅峰对决
我给出的辩题是:「AI 生成的内容应该享有著作权吗?」
系统随机抽签结果:正方 DeepSeek + Qwen(应该享有),反方 GLM(不应享有)。
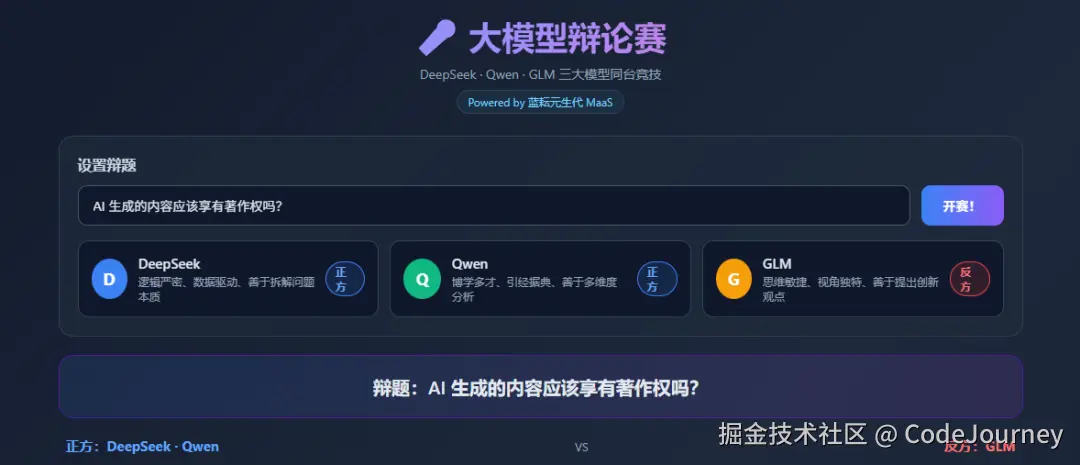
第一轮:立论,火药味直接拉满
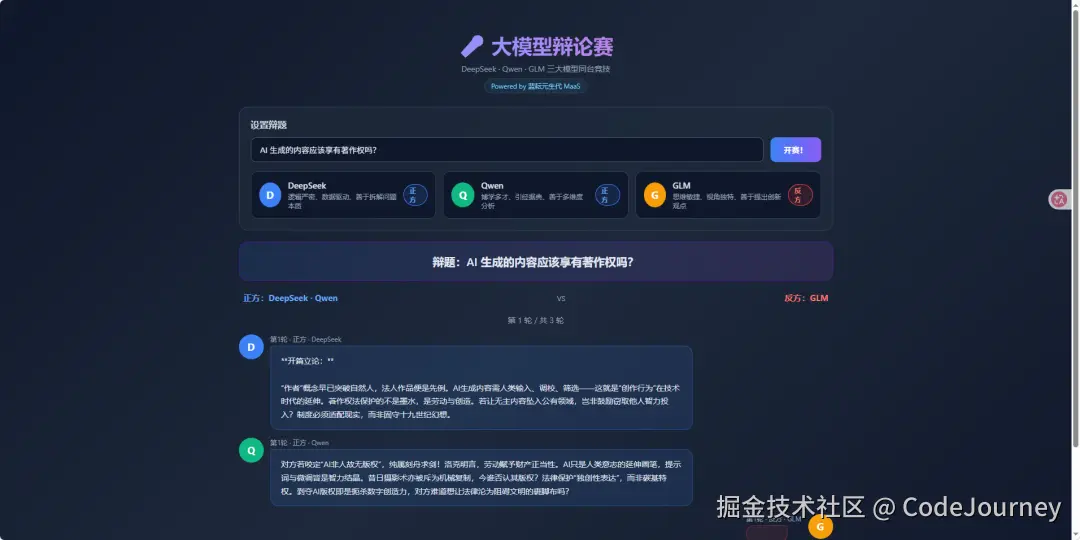
正方 DeepSeek 率先开炮,直接挑战法律概念的根基:
"作者"概念早已突破自然人,法人作品便是先例。AI 生成内容需人类输入、调校、筛选------这就是"创作行为"在技术时代的延伸。著作权法保护的不是墨水,是劳动与创造。若让无主内容坠入公有领域,岂不鼓励窃取他人智力投入?制度必须适配现实,而非固守十九世纪幻想。
正方 Qwen 紧随其后,引经据典:
对方若咬定"AI 非人故无版权",纯属刻舟求剑!洛克明言,劳动赋予财产正当性。AI 只是人类意志的延伸画笔,提示词与微调皆是智力结晶。昔日摄影术亦被斥为机械复制,今谁否认其版权?法律保护"独创性表达",而非碳基特权。剥夺 AI 版权即是扼杀数字创造力,对方难道想让法律沦为阻碍文明的裹脚布吗?
注意 Qwen 的发言风格------洛克劳动财产论、摄影术历史类比、最后还甩出一句"裹脚布",把"博学多才"的人设演绎得淋漓尽致。这正是提示词工程的威力:不需要微调模型,一段好提示词就能让模型进入角色。
第二轮:交锋升级,开始"贴脸输出"
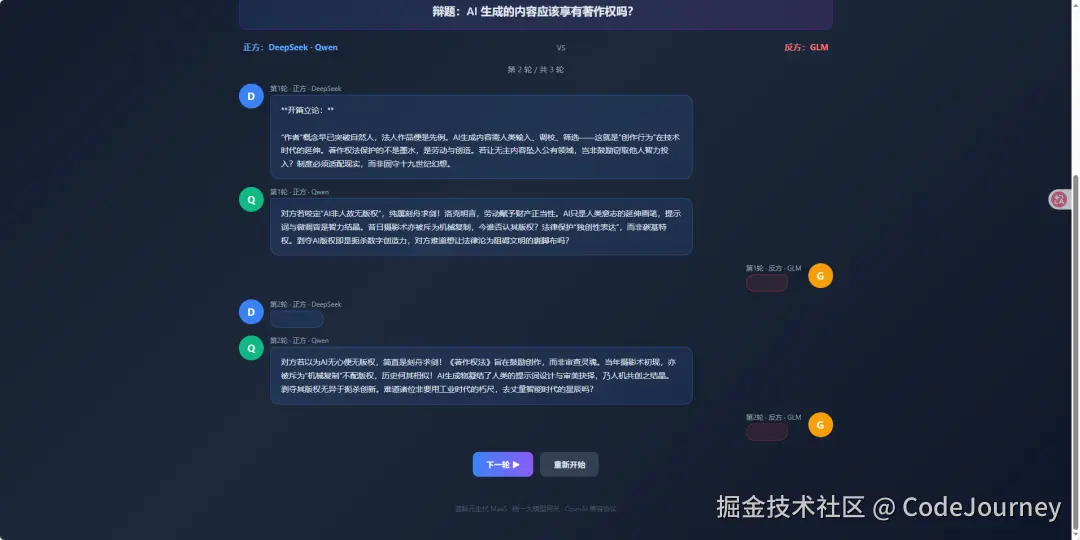
第二轮我把对方第一轮的原话注入了提示词,于是反驳变得极有针对性。
Qwen 抓住 GLM 可能的"AI 无心灵"论点穷追猛打:
对方若以为 AI 无心灵便无版权,简直是刻舟求剑!《著作权法》旨在鼓励创作,而非审查灵魂。当年摄影术初现,亦被斥为"机械复制"不配版权,历史何其相似!AI 生成物凝结了人类的提示词设计与审美抉择,乃人机共创之结晶。剥夺其版权无异于扼杀创新。难道诸位非要用工业时代的标尺,去丈量智能时代的星辰吗?
而反方 GLM 的反击角度清奇------它没有纠缠"独创性",而是直指"权利主体真空":版权授予的是主体资格,AI 在法律上连"人"都不是,何谈权利?即便要保护,也该保护背后的使用者或开发者,而非一段代码的输出。这一刀直接砍向了正方论证链条最薄弱的一环。
每一轮辩论,前端都会显示"辩手们正在激烈交锋"的加载动画------背后是三家模型通过蓝耘统一网关并发推理,平均一轮的响应时间比我预期的快不少。
第三轮结辩与裁判总结
三轮过后,我把完整的辩论记录喂给了裁判模型(同样跑在蓝耘 MaaS 上),让它从立论深度、反驳质量、逻辑自洽、语言表达四个维度点评。
裁判的总结相当犀利(节选):
正方 Qwen 引经据典、气势凌厉,洛克劳动论与摄影术类比形成双重论证;DeepSeek 直击法律概念演进,"法人作品先例"一矢中的。反方 GLM 抓住"权利主体真空"穷追猛打,视角独特。
最精彩的交锋在于:正方用"历史类比"论证制度应随技术演进,反方则用"主体资格"论证类比不成立------摄影术背后是摄影师的创作意图,而 AI 的"意图"归属本身就是待证命题。
本场判正方险胜:其论证形成了"历史先例 + 劳动理论 + 制度目的"的完整闭环,而反方虽点出了主体问题,却未能给出替代性的制度方案。
四、账单时间:吵一架要花多少钱?
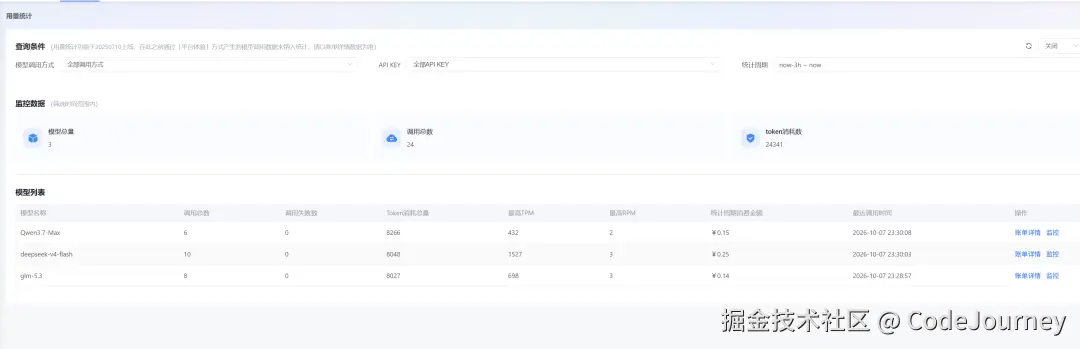
这是我最想秀的一张图。整场辩论赛------三位辩手打满三轮、外加一次裁判总结------蓝耘 MaaS 后台的用量统计清清楚楚:
| 模型 | 调用次数 | Token 消耗 | 消费金额 |
|---|---|---|---|
| Qwen3.7-Max | 6 | 8,266 | ¥0.15 |
| DeepSeek-v4-Flash | 10 | 8,048 | ¥0.25 |
| GLM-5.3 | 8 | 8,027 | ¥0.14 |
总计 24 次调用、约 2.4 万 Token,花费 0.54 元。
一场三大模型的完整辩论赛,成本不到六毛钱。每个模型的调用次数、Token 消耗、TPM/RPM、消费金额、最近调用时间,全部一目了然。这种透明、可控的计费体验,让开发者可以放心大胆地折腾各种"脑洞"项目------反正试错成本以"分"计。
五、复盘:这个项目教会我的几件事
5.1 统一网关是多模型应用的前提
如果这个项目要分别对接三家厂商的 API,我估计光读文档、调鉴权就得花一整天,代码里还得维护三套客户端。而用蓝耘 MaaS,切换模型只是改一个字符串的事。我可以轻松做实验:把 GLM 换成 Kimi 会怎样?让 deepseek-v4-pro 替换 flash 版当"重型辩手"会怎样?这种自由度,才是 MaaS 的真正价值。
5.2 提示词工程决定了"节目效果"
模型本身的智力差距,远没有"人设提示词"的影响大。同样的 DeepSeek,不给风格约束时发言四平八稳;给了"逻辑严密、数据驱动、有攻击性"的设定后,立刻变成了带刺的辩论机器。把通用大模型"约束"成特定角色,是提示词工程的典型应用------不需要微调,只需一段好提示词。
5.3 上下文注入让对抗"真实"
辩论赛和"三个模型各写一篇文章"的本质区别,在于每轮都把对手的观点喂回去。这个小小的工程设计,让反驳从"自说自话"变成了"精准点杀"。任何多轮对抗类应用(客服质检、红蓝对抗、互评系统)都可以复用这个模式。
5.4 别信印象,查 /v1/models
我凭印象写的 qwen3-max 根本不存在,正确的是 qwen3.7-max。MaaS 平台的模型命名会随版本迭代变化,动手前先查模型列表,是最省时间的习惯。
六、结语:当 AI 开始吵架,我们看到了什么
这场辩论赛当然是个"整活"项目,但看着三个模型为了"AI 著作权"争得面红耳赤------一个引洛克,一个搬法人制度,一个直击主体真空------我突然意识到一件事:
大模型最迷人的用法,可能不是让它们"回答问题",而是让它们"彼此碰撞"。 单模型输出的是"答案",多模型交锋产出的是"思考的过程"。而这种碰撞的门槛,已经被蓝耘元生代 MaaS 这样的统一网关压到了地板上------一个 Key、一套协议、五毛钱,就能让三个顶级模型为你同台竞技。
下一步我打算往这个系统里加点料:让观众实时投票、加入"质询环节"、让输家接受"惩罚"(比如用输的模型写一首夸奖对手的诗)......如果你也有什么"看热闹不嫌事大"的想法,蓝耘 MaaS 的免费额度,够你折腾很久了。
项目技术栈:Node.js + Express + 原生 HTML/JS;模型服务:蓝耘元生代 MaaS(deepseek-v4-flash / qwen3.7-max / glm-5.3);总成本:¥0.54。