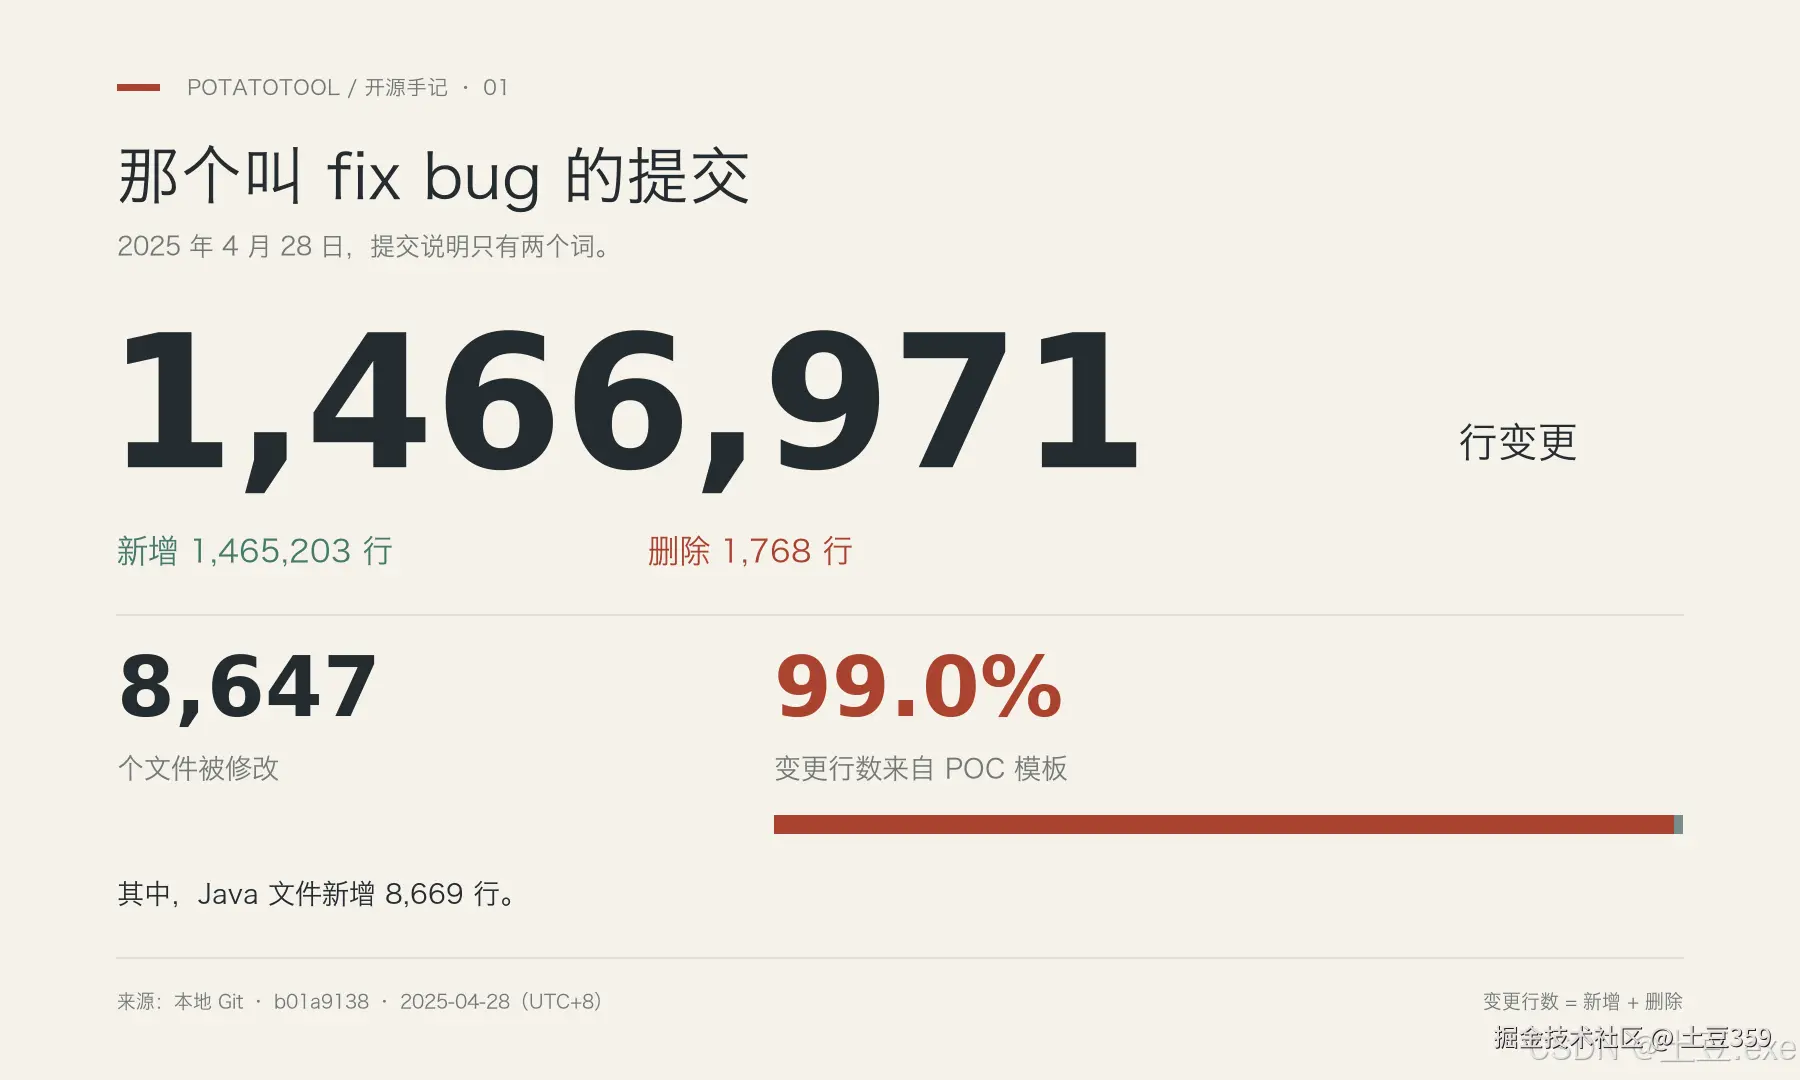
2025 年 4 月 28 日,我给 PotatoTool 提交了一个 commit,消息栏里写着 fix bug。
那次提交动了 8647 个文件、140 多万行,其中 99% 的行数来自八千多份 POC 模板,手写的 Java 不到九千行。
这不是什么值得学的工程习惯。但它能说明这个项目是怎么长出来的:一个人,断断续续两年半,顺手就改。
现在它开源了,Apache 2.0,仓库在 potato-security 下,早先挂在 hotBoy-java。决定把它拿出来,是因为算了一笔时间的账,账面对不上。
再往前翻,第一个提交更夸张。2024 年 3 月 20 日,v1.0 初始化,89 万行,其中 87 万行是两份字典文件,webshell 解密时拿来爆破密钥用的。
PotatoTool 是一个 JavaFX 桌面工具,红队和蓝队的功能塞在同一个界面里。技术栈上没什么时髦的东西:Java 8 打底,JavaFX 画界面,OkHttp 发请求,SQLite 存数据。仓库根目录放了两套构建描述,jdk8.xml 和 jdk11+.xml,因为这两拨用户的 JavaFX 根本不是同一个东西,砍掉哪个都会有人来问我为什么跑不起来。
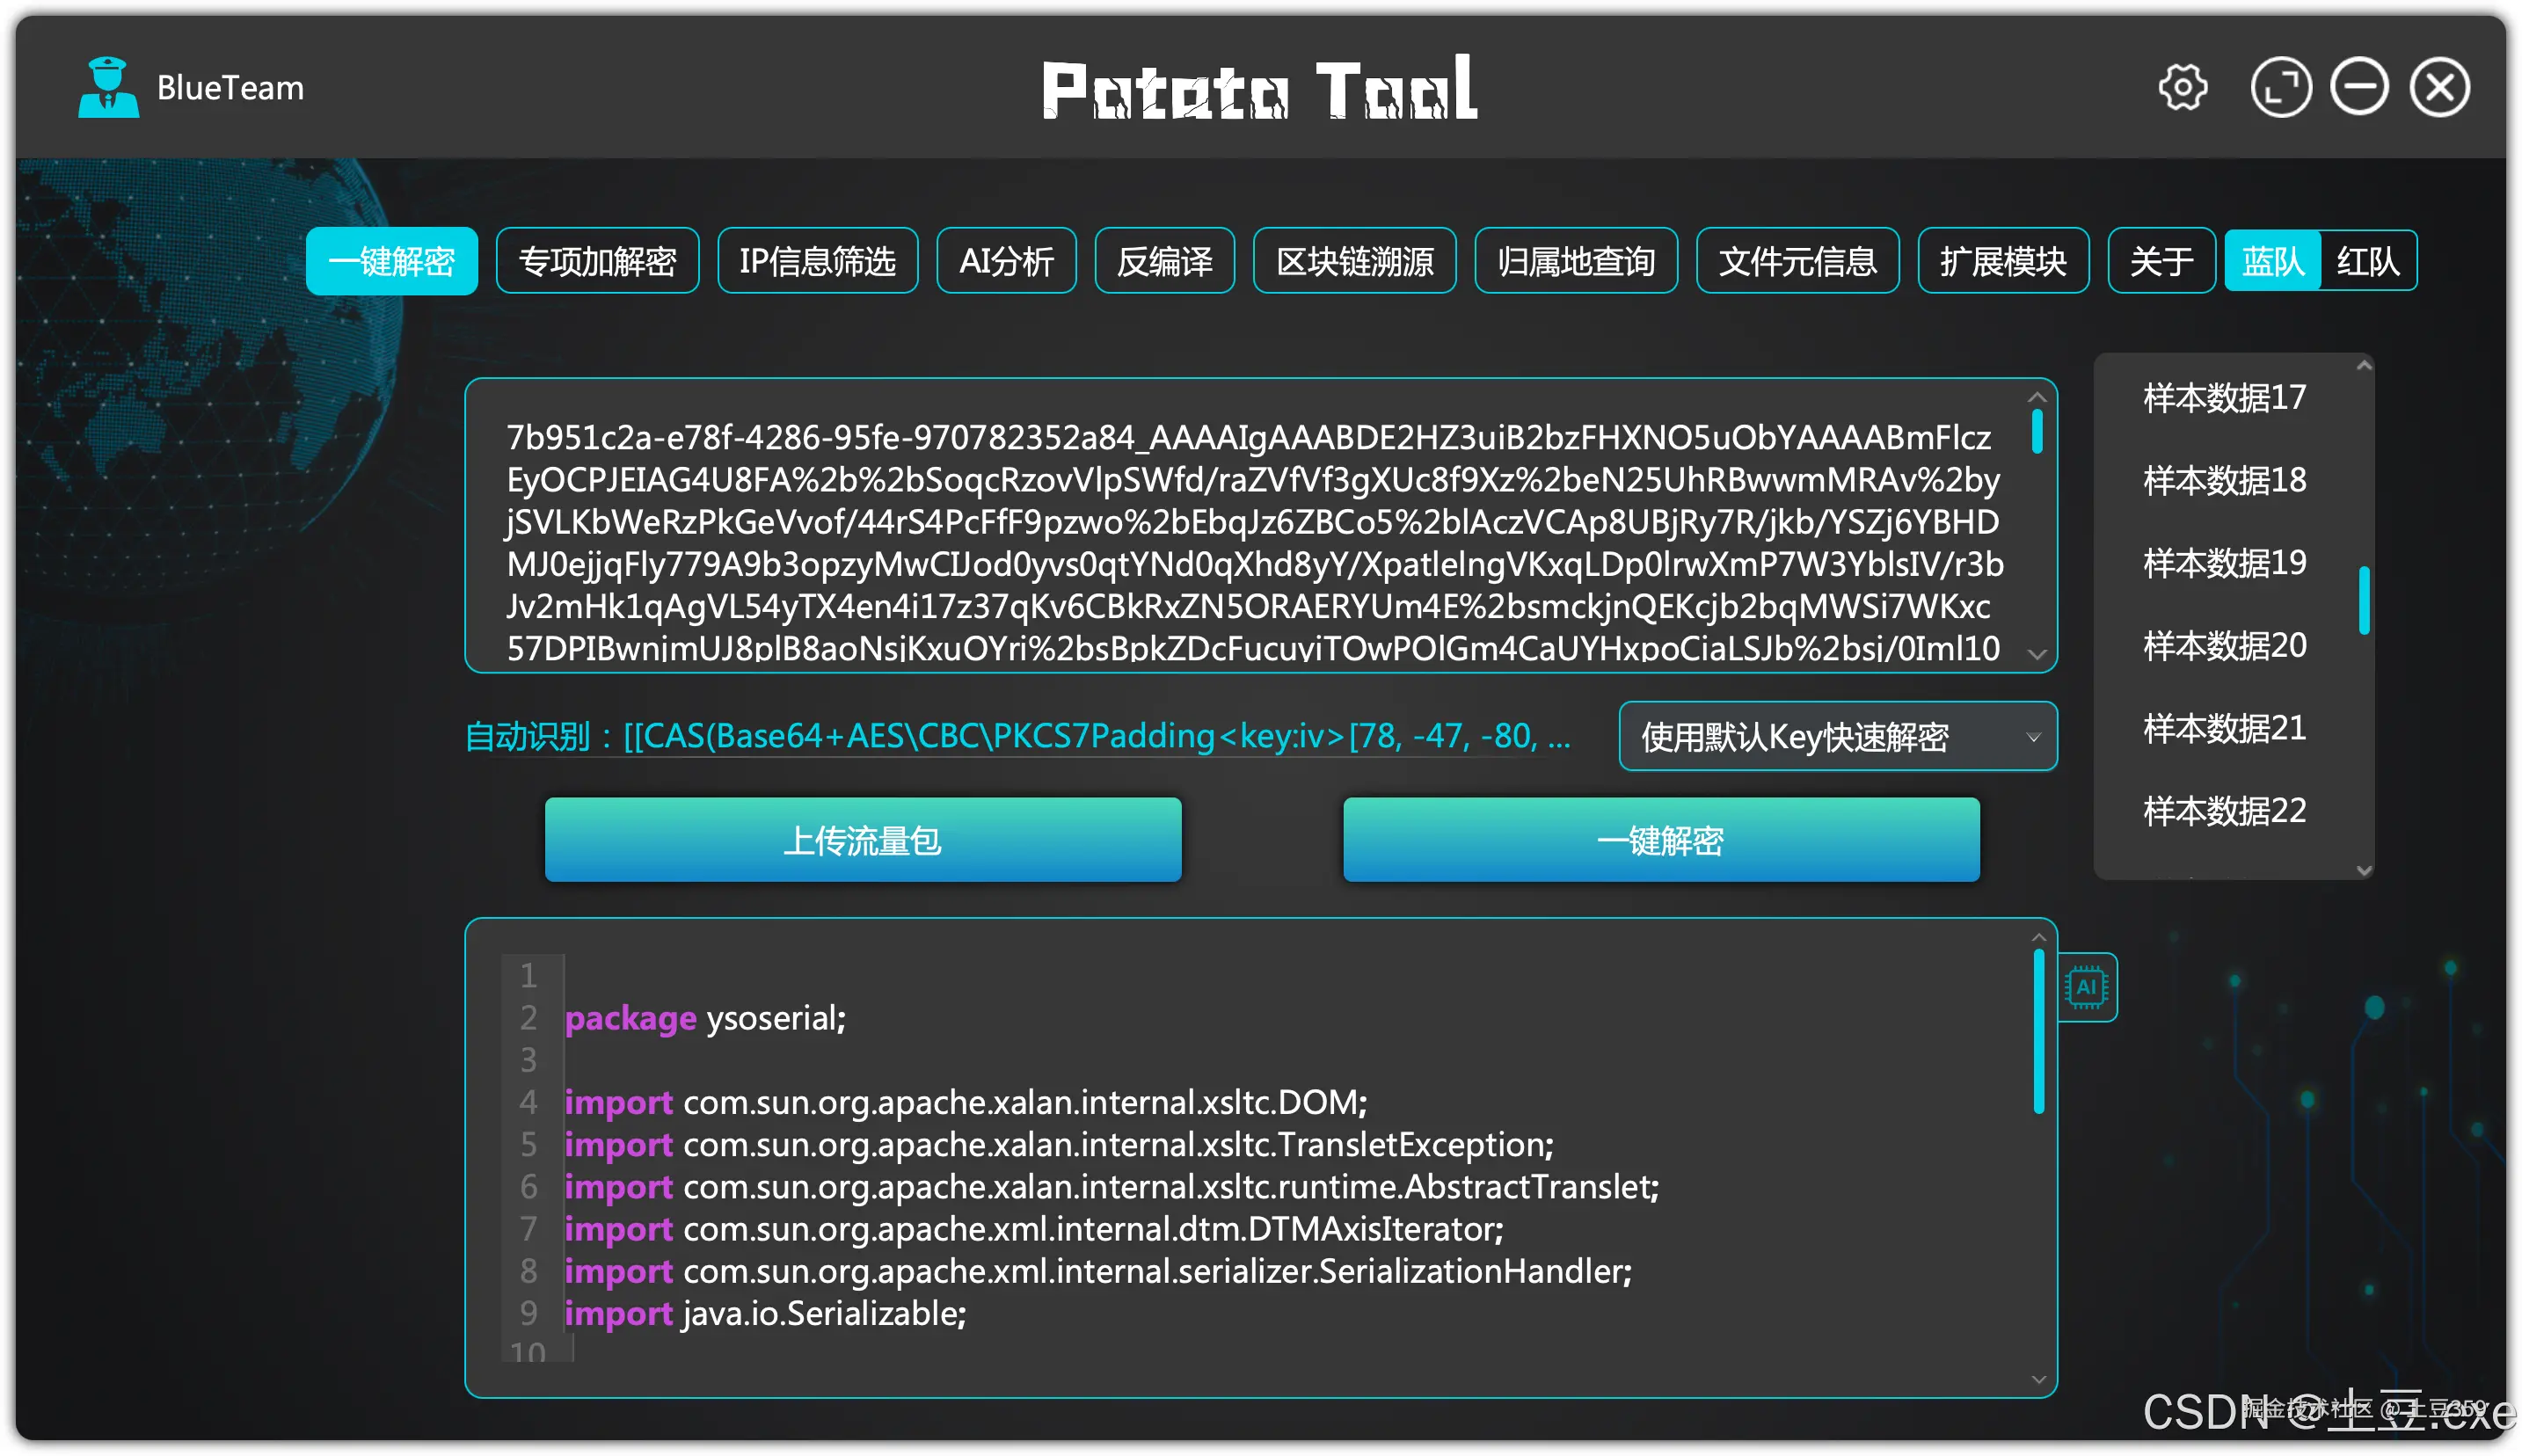
蓝队那一半是它的老本行:一键解密。把 webshell 流量的密文、各种中间件和组件里的配置密文粘进去,工具告诉你这是什么加密方式、明文长什么样。红队那一半是后来慢慢长出来的,漏洞扫描、端口扫描、信息收集、内存马生成、反序列化载荷,还有一个把 AI 串起来做自动渗透的模块。
听着像功能清单。可真正吃掉时间的从来不是功能。
没有密钥,还得知道自己猜对了没有
难点从一开始就不在算法。AES、DES、SM4 都有现成的库,把参数传对就完事了。
难的是你手里没有密钥,还得判断自己猜对了没有。用户丢过来的东西什么样都有:一段光秃秃的密文、一个完整的 HTTP 请求、JSON 或者表单参数,Shiro Cookie、XML、multipart 各走各的分支。
一键解密的本质是猜谜。工具拿字典一个个试 key,试完还要回答一个问题:这回吐出来的是明文,还是又一坨垃圾?这一步没有数学可以依赖,只能上启发式:可打印字符占多少、乱码字符有几个、字符串短到一定程度阈值要不要收紧。默认可打印比例是 0.8,不到 20 个字符就提到 0.9。这套判断写在一个叫 ReadabilityChecker 的类里,可能土得没法看,但工具的成败就压在这几个数字上。
这类判断得一条条对着真实流量调。JDK 自带的 Character.isLetterOrDigit 没法直接用,Ԅ 这种字符在它眼里算字母,所以这里自己写了一套可打印判定,把中日韩文字和全角标点单独放行。
再比如前端用 JavaScript 做 base64 时会走 btoa 加 UTF-16 转二进制,解出来的明文里每个正常字符后面都粘着一个不可见字符。这是编码路径留下的副作用,你不处理它,可打印率就永远过不了线。最后的办法是把结果按奇数和偶数下标拆成两串,分别验证。
有些坑更阴。哥斯拉的流量 gzip 解压之后会出现连续空字节,得当成 = 补回去;可换成 class 文件或者 Java 反序列化数据,开头的 CAFEBABE、ACED0005 里也有零字节,补进去就把数据改坏了。同一行代码,得先知道自己手里拿的是什么。
九千多个 POC 怎么塞进一条执行链
扫描模块内置了九千七百多个 POC:Nuclei 九千三、Goby 三百六、Xray 三十一、Pocsuite 三个。它们各自的原生引擎都不是 Java。Nuclei 有自己的一套 DSL,Xray 用 CEL,Goby 靠 Go 正则;还有 Python 风格的命名分组 (?P<name>...),Java 不认,代码里得先改写成 Java 的写法。想把它们缝到一条链上,等于给四种方言做翻译。
缝的过程里攒出一堆没人愿意写的活儿:Goby 的 POC 里,recommendation 这个词在网上有两种拼法,少一个 m 的那种也有人写,两种都得认;同一个变量前缀,有时是 $header 有时是 $head;body|text 看起来像关键词匹配器,实际意思是"把响应片段存成变量"。Go 的正则允许花括号直接当字面量出现,Java 编译时直接抛异常,中间只能垫一层兼容:先正常编译,失败了再把非量词的花括号转义重试。
还有一件事得先开口:有些模板我确实做不到。Nuclei 里 unsafe 和 read-all 同时启用的请求块会被跳过,单独出现则留下降级告警。假装支持最省事,代价是别人扫完拿着报告来问你为什么没打中。所以转换器里留了一份降级台账:哪些直接丢弃记 P0,哪些降级执行打警告记 P2,连它落在模板里第几个请求块都标出来。看报告的人得分得清两件事,这次没发现和这部分没按原意执行,差得很远。
不好看,但比"已完整支持 Nuclei 模板"这种话诚实。
AI 模块的那些闸门
今年六月加的 AI 自动渗透,从信息收集一路串到出报告。这个模块真正要紧的地方是它会真的往外发请求,比它打不打得准重要得多。
所以模块里跑得最勤的其实是审批和拦截。定目标要填授权范围,范围支持 IP、CIDR 和域名后缀;域名不能只比字符串,必须先解析,再拿解析出来的 IP 去比对允许和拒绝列表,不然一个看着合规的域名解析到内网,你就在帮别人扫自己的服务器。启动前有十项预检,任何一项是阻断级就不让跑。主动扫描要显式开启,标了侵入性和危险级的技能直接拒绝执行。
脱敏这块比想象中琐碎:给 AI 的上下文、写进数据库的证据、导出的报告,全都要过一遍,不只是常规的 Authorization 头和密码字段,还包括 JSON 转义之后的形态,也就是 = 被写成 \u003d 的那种,很容易漏。AI 的输出只用来展示和解释,不进控制流:挑哪个技能、要不要拦,都由代码里的固定规则决定,不是模型说了算。
把大模型接进一个能真的往外发请求的系统,先要解决的是怎么把它拦住;让它更聪明,可以慢慢来。
时间不够,是字面意思
时间。不是"最近有点忙"的那种时间问题。
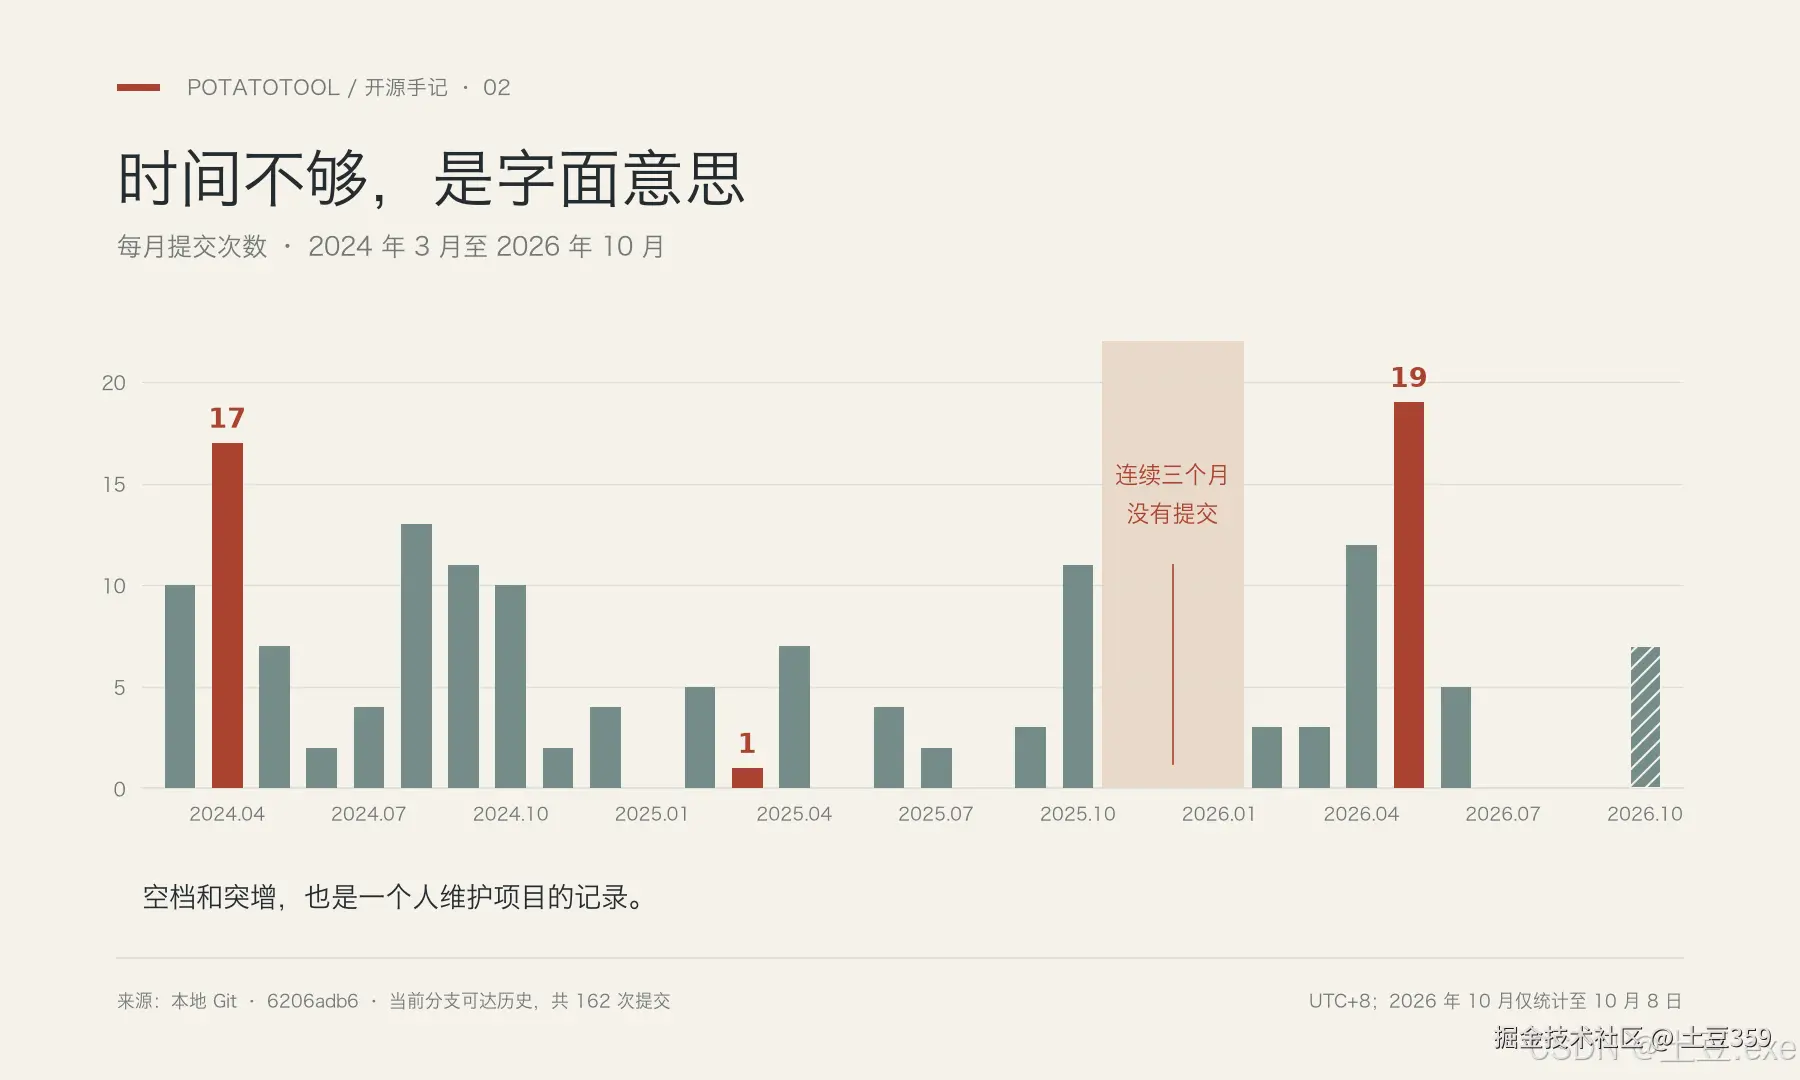
我平时要上班,同时在创业,这两件事各自都能把一天填满。项目排在它们后面,剩下那点边角料时间才轮得到。仓库的提交记录里能看到形状:2024 年 4 月提交了 17 次,2025 年 3 月只有 1 次,2025 年 11 月到 2026 年 1 月一次都没有,然后 2026 年 5 月又堆了 19 次。中间还夹着一次 UI 大改,做了一百多个提交,最后整体回退,只留了一个分支当存档。
收尾也停了。README 的使用场景里有一条 CTF,从 2024 年底那篇介绍文章起就写着"下个版本"。
还有一处空着是主动的。免杀那边的加壳、混淆、代码虚拟化只留了接口,secureprotect 包里 21 个文件 281 行,方法体全是"测试版,代码已剔除"。这部分比较敏感,容易被大规模滥用,索性不公开。
也不是全空着。执行生命周期、模板语义、本地靶场的测试都在仓库里。另有一类问题不会出现在功能清单上:代理开关在设置页显示已开,实际请求却没用上。这比按钮画得丑严重得多。
还有一笔更现实的账。自带 AI 是走我自己搭的网关转发的,客户端证书一直在包里;要开源,这证书就不能进仓库,私钥给出去等于把服务白送出去给人刷。所以公开仓库里没有这张证书,装好之后想用 AI,得关掉内置开关,填自己的模型服务地址和 Key。
这个项目再放在我硬盘上,只会变成又一个"等我有空"的项目。它需要的不是我再攒出一个完整的周末,是有人真的用它。
当前源码版本是 V2.5,报告和关于页的版本号在开源前刚对齐。GitHub 上现存的 Release 还是 2025 年初打的包,之后的源码一直往前走,想用当前代码只能自己构建。
代码公开之后,有人可以拿去读,有人可以拿去改,Apache 2.0 允许二次开发,也包括商用。许可解决的是版权,不解决你有没有权限去打那个目标,这件事只能自己负责:这工具里有内存马、有反序列化载荷、有一个能自动打出去的模块,用在不该用的地方,后果是使用者自己的。
免费放开代码,跟免费兜底是两件事。FAQ 里那句"失败可以和作者沟通讨论一下"现在还挂在仓库里。麻烦在于每一条这样的反馈都得有人接,而人只有我一个。公开之后它多了一层保障,看不懂的地方可以直接读代码,但没有人能承诺响应时间,我也不能。
它也还不是完成品。内部版不在这个仓库里,有些格式的兼容是明着降级处理的。有窟窿的地方早点讲明白,比等人踩上去再解释便宜。
至于节奏,我不打算承诺。发版要同步四个地方的版本号,这事我拖到开源前才刚对上,大概就是这个速度。
两年半前那个 89 万行的初始提交,现在长到了一百六十多个提交。后来陆续有人在用,有人提 bug,仓库也换了地方。
现在我不太确定它会走到哪。可能就这么挂着,偶尔有人提个 issue;也可能有人把它拆开,拿走其中一块放进自己的工具。那套一键解密的成功判定、照 DevTools 协议自己写的浏览器控制(没用 Selenium 也没用 Playwright)、几个解析器,都是能单独拎出来用的东西。
这两种结果我都能接受。我唯一确定的一件事是,它现在不在我一个人的硬盘上了。