一、先说结论:我的待办,不查任务表
一个后台管理系统里,审批中心通常就是这么一排菜单:
发起申请
我发起的
我的待办
我的已办
我的抄送
五个入口,五种"我的"。第一反应是:待办、已办都在任务表里,一个查状态等于进行中、一个查状态不等于进行中,不就完事了?
我们的引擎不是这么写的。四个"我的"入口,各自把归属条件钉在四张不同表的不同列上:
| 菜单 | 门面 action | 引擎硬加的那一条谓词 | 谓词住在哪张表 |
|---|---|---|---|
| 我的待办 | todoList |
pta.actor_id = 我 |
task_actor |
| 我的已办 | doneList |
t.operator = 我 |
task |
| 我发起的 | page |
t.operator = 我 |
instance |
| 我的抄送 | ccList |
cc.actor_id = 我 |
cc_instance |
(action 全称分别是 processTask/todoList、processTask/doneList、processInstance/page、processInstance/ccList;表名全称一律带 wf_process_ 前缀。)
四行里有两个 t.operator------同一个列名,挂在任务表上读作"这条任务我处理过",挂在实例表上读作"这个流程我发起的"。列名相同不代表语义相同,语义是由它所在的表决定的,这也是这一排菜单最容易写错的地方。
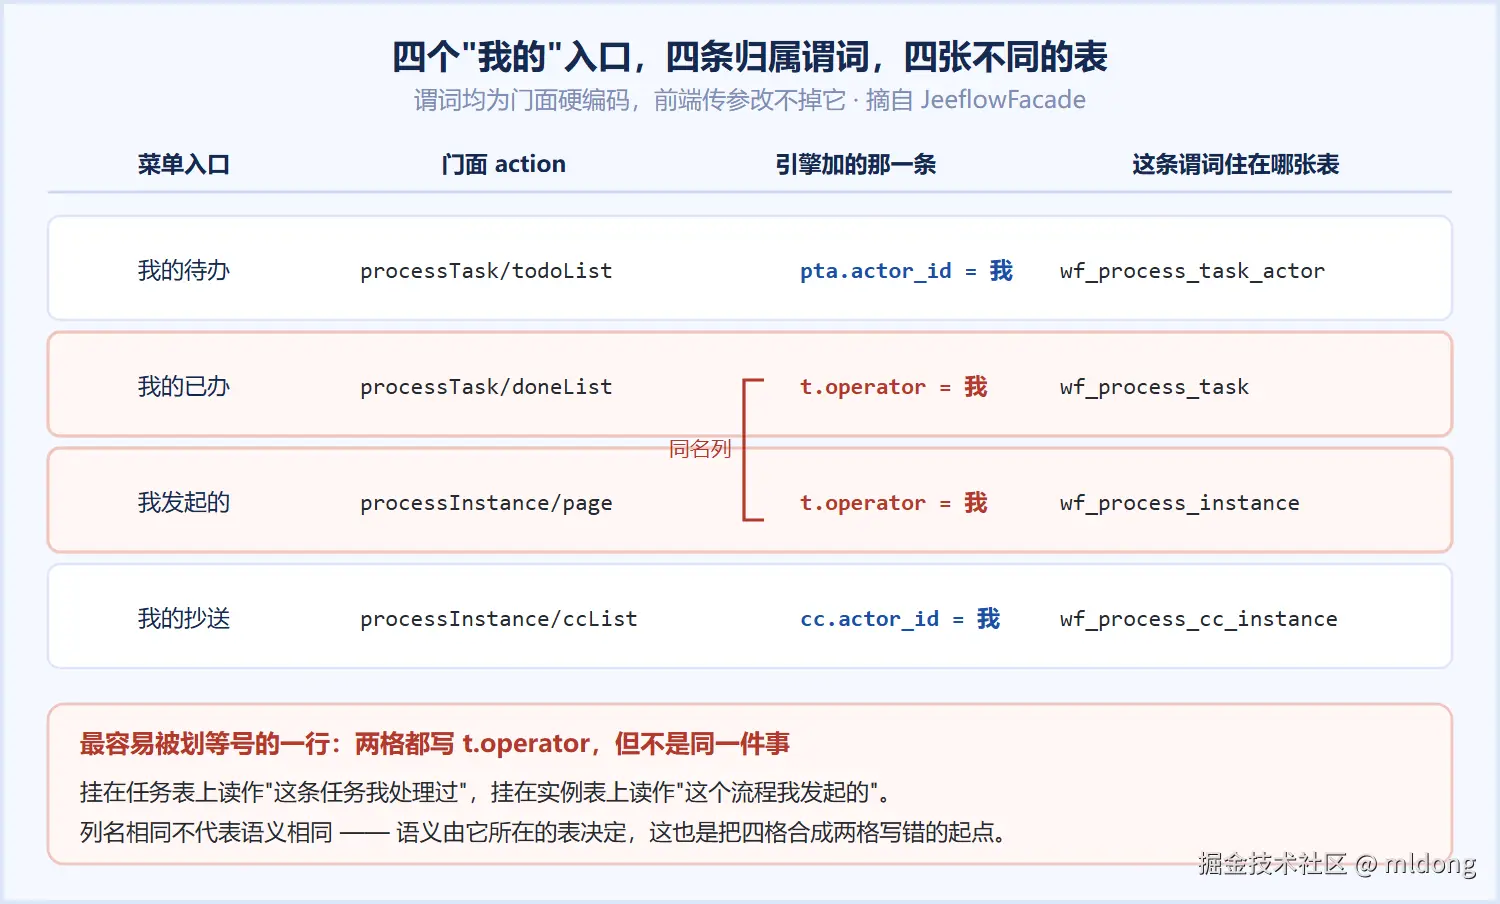
这篇就把这四条腿逐个拆开:谁驱动哪张表、为什么这么分、索引够不够用、以及"全部/未读/已读"这种页签该由谁来筛。
二、归属条件是引擎加的,不是前端传的
Java 是参考实现,四个入口在门面层各自只干一件事:把当前操作人按到对应那条列上。
java
// 我的待办
query.add("pta.actor_id", "EQ", userId);

// 我的已办
query.add("t.operator", "EQ", userId);

// 我发起的(流程实例)
query.add("t.operator", "EQ", userId);

// 我的抄送
query.add("cc.actor_id", "EQ", userId);
这四行的位置全在 JeeflowFacade.java,长度一行,但它们是硬编码的 。用户传什么都改变不了它------前端可以带一堆 m_* 筛选参数,那条归属谓词永远在那儿。这一点很重要,第四节会说为什么。
引擎门面不感知登录态,operator 是显式传参,由集成方(框架壳层)从登录上下文注进去。我们十三栈的薄壳里都有同一句:
java
// 2. 注入操作人(门面约定 args.operator)
body.put("operator", LoginUserHolder.getUserId().toString());
三、我的待办:驱动表是参与者表,四表 JOIN,计数必须去重
这是整排菜单里最反直觉的一条。待办列表的 SQL 骨架长这样(Java 仓储层,逐行摘自 JdbcProcessRepository.pageTasks):
java
"FROM wf_process_task t "
  + "LEFT JOIN wf_process_instance pi ON t.process_instance_id = pi.id "
  + "LEFT JOIN wf_process_define pd ON pi.process_define_id = pd.id "
  + "LEFT JOIN wf_process_task_actor pta ON t.id = pta.process_task_id "
  + "WHERE 1=1"
然后按"待办 / 已办"分岔:
java
if (done) {
    baseSql.append(" AND t.task_state <> 10");
} else {
    baseSql.append(" AND t.task_state = 10");
}
待办的完整判据是:任务进行中 + 参与者表里有一条"我是参与者"的行。
为什么要多一张参与者表?因为一个任务节点可以有多个人。会签、或签、"部门经理"这种解析出来是两个人的角色,都是一个任务行配多个参与者行。把待办写在任务表上,就得在任务行里塞一个"处理人列表",那样既没法按人筛,也没法表达"这仨人都还没批"。拆出 wf_process_task_actor 之后,一张任务对 N 行参与者,待办就是"N 行参与者里挑属于我的那一行"。
代价也来了:JOIN 会扇出。同一条任务如果配了三个人,pta 那边就出三行,分页计数会重复。所以取数用 SELECT DISTINCT,计数单独写了去重:
java
String countSql = "SELECT COUNT(DISTINCT t.id) " + baseSql;这两句得挨着写。pta 与 t 是一对多------一条任务配三个人就出三行------列表用 SELECT DISTINCT 压掉重复之后,计数如果不按同一个口径去重,就会比列表多算:分页组件显示的总数和真正翻得到的条数不一致,而列表看着是对的。所以判据很朴素:只要 JOIN 的表是一对多,计数就得明确它按什么去重。
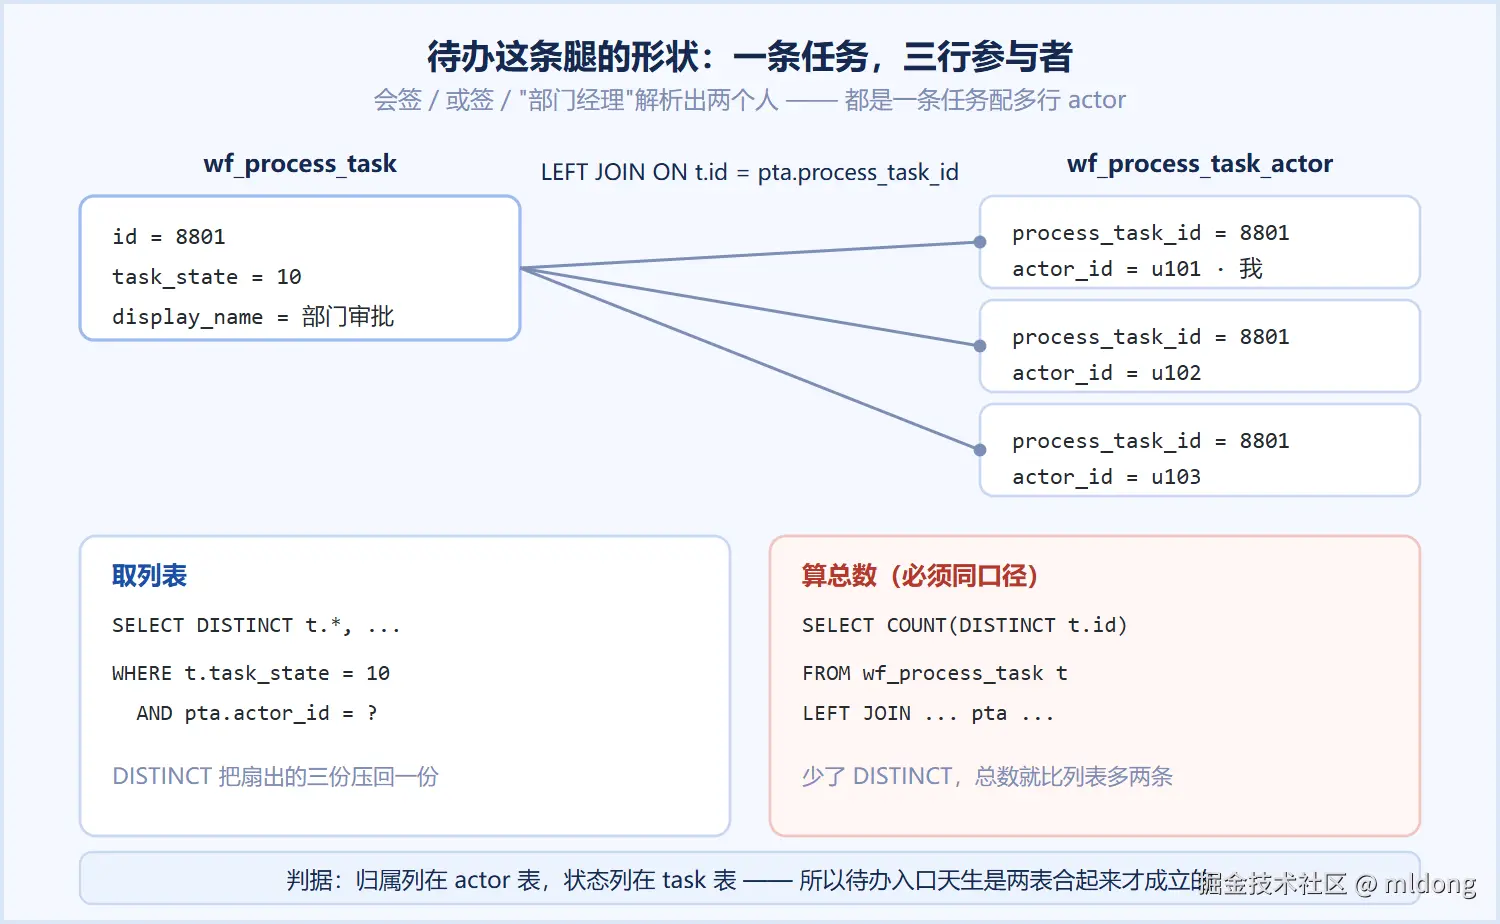
这条腿在三栈里形状完全一致,只是操作人传进去的方式不同。Go 把归属当位置参数:
go
func filterWhere(done bool, filter string) string {
	if done {
		return " AND t.task_state <> 10 AND t.operator = ?"
	}
	return " AND t.task_state = 10 AND pta.actor_id = ?"
}
Python 把 JOIN 和 WHERE 拆成两段拼:
python
where = (" FROM wf_process_task t"
    " LEFT JOIN wf_process_instance pi ON t.process_instance_id = pi.id"
    " LEFT JOIN wf_process_define pd ON pi.process_define_id = pd.id"
    " LEFT JOIN wf_process_task_actor pta ON t.id = pta.process_task_id")
if done:
    where += " WHERE t.task_state <> 10 AND t.operator = ?" + cond_sql
else:
where += " WHERE t.task_state = 10 AND pta.actor_id = ?" + cond_sql三段字符串几乎逐字对齐------这就是多语言联邦的日常:行为对齐靠的不是约定,是同一句 SQL 在每个语言仓里都能被指出来。
四、我的已办:用补集 <> 10,而不是 = 20
已办这一格,藏着一个纯业务判断。
任务状态一共六个:进行中(10)、已完成(20)、已撤回(30)、强行终止(40)、挂起(50)、已废弃(99)。最省事的写法是"已办 = 状态等于已完成":
sql
-- 看着合理,但会丢东西
WHERE t.task_state = 20
问题出在撤回单。我发起一条报销,走到经理那儿他撤回了,或者被管理员强行终止了------这条任务对经理来说既不算"进行中",也不算"已完成"。用 = 20 的话,它从他的待办和已办里同时消失:待办里找不到(状态不是 10 了),已办里也找不到(状态不是 20)。用户视角就是"我明明批过一条单子,怎么找不着了"。
所以我们把已办写成补集:
sql
WHERE t.task_state <> 10 AND t.operator = ?一句话定义:待办 = 还在等我,已办 = 我经手过且不再等我。 撤回、终止、废弃都进已办,因为"这件事对我来说已经不用再操作了"。
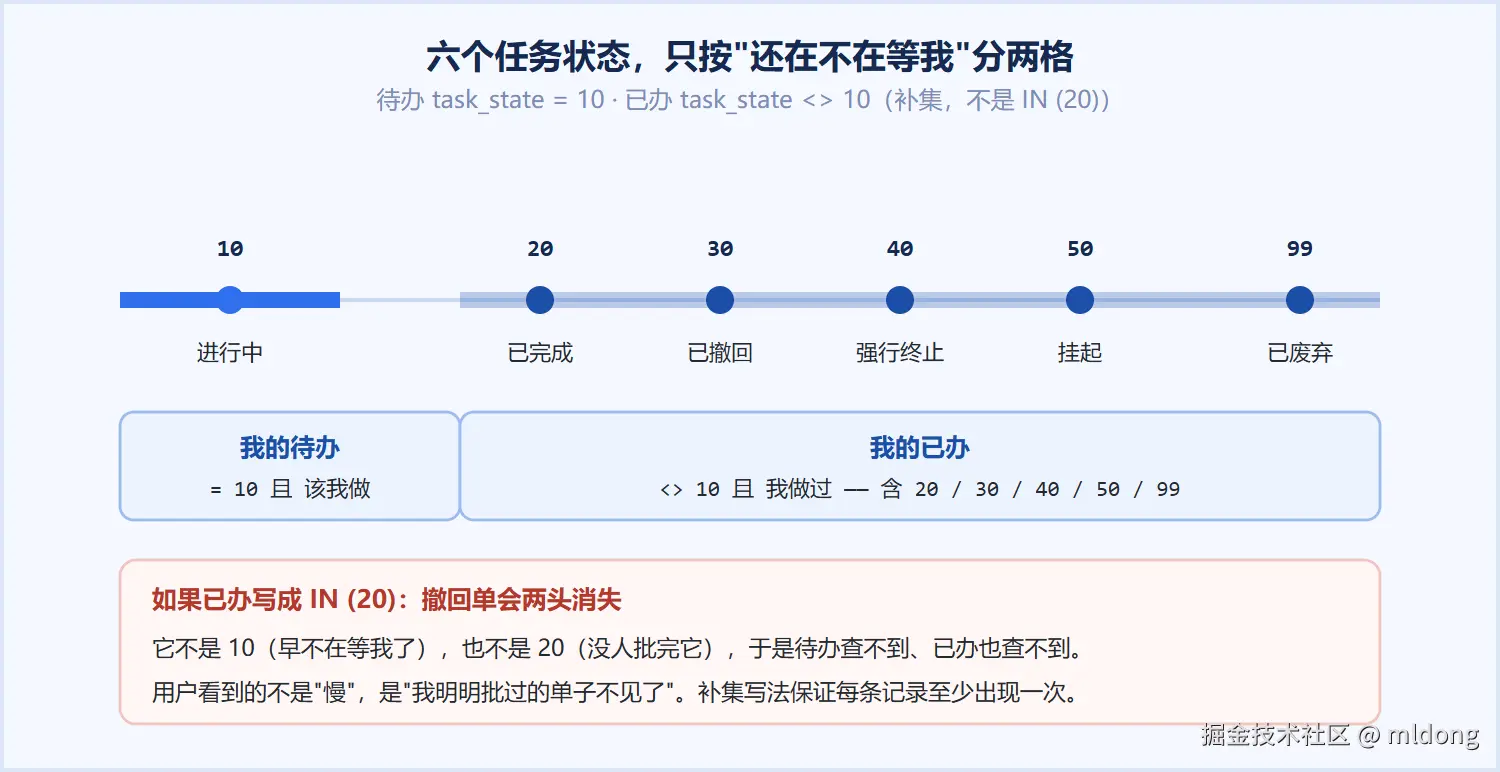
状态集这条口径写在引擎规范的动作表里,八语言对齐的是行为而不是枚举白名单------早先有两个语言写的是 = 20,跨栈门禁一比就露出来了:同一份数据,Java 栈上能查到的撤回单,在另外两栈上就是空的。
还有一条容易看错的:已办用 t.operator,不用参与者表。所以"参与但没我提交的"不算已办。一个三人会签,另外两个人批完把单子推走了,我在参与者表里有行、在 operator 上不是我的名字,那么它进我的待办(还在等我)而不进我的已办。这两列不能混用:actor_id 回答"该谁做",operator 回答"谁做了"。
顺带把两代实现的差别留在这儿,供从内置工作流模块迁过来的同学对照。上一代内置引擎的已办是这么写的:
java
queryWrapper.notIn("t.task_state", DOING, WITHDRAW);
queryWrapper.eq("pta.actor_id", LoginUserHolder.getUserId());
queryWrapper.ne("t.operator", FlowConst.AUTO_ID);
三处差别:按参与者表归属、排除撤回、排除自动节点。换成 t.operator + <>10 之后,撤回单不再两头消失,"我办理的"也不再被"该我但没我"的行污染。迁移时如果要保持老系统的列表口径不变,得知道这三处差异,不要指望一句 SQL 平移。
五、我发起的:operator 不是 create_user,applicant 也不是列
这一格最容易写错,因为表里三个字段看着都像"发起人"。
wf_process_instance 的相关列(逐行摘自建表 SQL):
sql
operator    VARCHAR(64) NULL COMMENT '流程发起人',
create_time DATETIME(3) NULL COMMENT '创建时间',
create_user VARCHAR(64) NULL COMMENT '创建用户',
引擎用的是 operator。这一格最容易写成 create_user,因为 mldong 系框架每张业务表都带这一列,含义是"这行记录是谁插进来的",属于审计面。实例聚合根在创建时三列同时赋值(逐行摘自 ProcessInstance 的工厂方法):
java
instance.operator   = operator;
instance.createTime = LocalDateTime.now();
instance.createUser = operator;      // 审计列:发起那一刻与 operator 同值
instance.updateUser = operator;也就是说今天这两列的值是一样的 ,用 create_user 筛"我发起的"在今天也能筛出来。但这正是它危险的地方:值相等是实现巧合,不是契约。operator 是引擎承诺的归属列,create_user 是仓储写入的审计列------一旦接入代提交、系统账号自动发起这类路径(审计面本来就该记真实写入者),或者将来改审计列的填充方式,两列立刻分叉,而"我发起的"这个菜单坏了也不会报错,只会安静地少几单或多几单。
更能说明问题的是:通用筛选的列白名单里根本没有 create_user。
java
private static final Set<String> INSTANCE_WHITELIST =
        new HashSet<>(asList(
    "t.id", "t.parent_id", "t.process_define_id", "t.state",
    "t.business_no", "t.operator", "t.create_time",
    "t.expire_time", "t.variable",
    "pd.name", "pd.display_name", "pd.type", "pd.version"
));
这张白名单是"这个入口允许按哪些列筛"的清单。审计列不在里面,意思是:前端拿 m_EQ_createUser 来筛"我发起的",这个条件会被直接丢掉,而不是报个错。列白名单同时扮演两件事------挡住注入,也挡住语义越界。
第三个坑是 applicant。申请节点的 assignee="applicant" 在发起那一刻就被解析成真实用户 id 写进任务行,它不是任何一张表里的列值 。想按"申请人"去查库的人最后都会写出 WHERE operator = 'applicant' 这种条件------它永远查不出东西。
六、我的抄送:查的是实例表,抄送表只出条件
"我的抄送"这个入口的返回是流程实例,不是抄送行。因为用户要看的是"有哪些单子抄送给我了",一眼扫过去需要的是流程名、发起人、当前状态,这些都在实例表上。抄送表只负责回答"这条实例是不是抄送给我的"。
java
private PageResult<InstanceRow> pageInstances(
        PageQuery query, boolean cc, Set<String> whitelist) {
    StringBuilder baseSql = new StringBuilder(
        "FROM wf_process_instance t " +
        "LEFT JOIN wf_process_define pd ON t.process_define_id = pd.id ");
    if (cc) baseSql.append(
        "LEFT JOIN wf_process_cc_instance cc " +
        "ON t.id = cc.process_instance_id ");
    baseSql.append("WHERE 1=1");
抄送表里那列 state(1 已读 / 0 未读)在 WHERE 里用,不在 SELECT 出口里 。列表接口不返回"这条抄送是否已读",返回的是实例字段。所以前端"已读"这个状态不是从数据里读出来的------打开详情时先打一次 processInstance/updateCCStatus 落库,再把本地集合加进去。
那"全部 / 未读 / 已读"三个页签要怎么实现?就靠白名单里那一列:
java
private static final Set<String> CC_INSTANCE_WHITELIST =
        new HashSet<>(asList(
    "t.id", "t.process_define_id", "t.state",
    "t.business_no", "t.operator", "t.create_time",
    "t.variable", "pd.name", "pd.display_name",
    "pd.type", "pd.version", "cc.actor_id", "cc.state"
));
多传一个 m_cc_EQ_state = 0 就是未读页签。列在这一格是"能力",页签是"展示"------把能力做到,页签随时能加,不需要引擎改一行。
这一格还有一条硬闸,值得单独讲:
java
public PageResult<InstanceRow> pageCcInstances(PageQuery query) {
    // 归属条件必填:cc.actor_id 缺失或为空值 ⇒ 空页
    if (!hasEffectiveCondition(query, "cc.actor_id")) {
        return PageResult.of(query.getPageNum(),
                query.getPageSize(), 0, new ArrayList<>());
    }
    return pageInstances(query, true, CC_INSTANCE_WHITELIST);
}注释里那句"旧形状"是真出过事的:LEFT JOIN 不带归属条件时,返回的是全部流程实例------"我的抄送"退化成了"所有人的抄送"。这类 bug 的隐蔽之处在于它不会报错,只会返回一个看起来完全正常的分页数据。所以归属条件不是"加了更好",是"不给就返回空页"。
七、四条归属列,两道闸
上一节那条规则不是只写在抄送一处。四张表的归属列被集中登记成一个集合:
java
/**
 * 归属谓词列:这几列定义"这条记录属于谁",空值绝不能等于"不过滤"。
 */
private static final Set<String> OWNERSHIP_COLUMNS = new HashSet<>(asList(
    "t.operator", "pi.operator", "pta.actor_id", "cc.actor_id"));
通用 WHERE 构建里有一道针对它的专门分支:
java
boolean blankVal = val == null
    || (val instanceof String && ((String) val).trim().isEmpty());
if (blankVal && "EQ".equalsIgnoreCase(cond.getOperator())
        && OWNERSHIP_COLUMNS.contains(cond.getColumn())) {
    sql.append(" AND 1=0");
    continue;
}
空值时拼的是 AND 1=0(返回零行),而不是"这条条件不加"。这两者差了一整个数据泄漏级别。
这道闸有意的双层设计,两层都得留着:
- 门面层归一化:
operator传空串、全空白、或者干脆没传 ⇒ 视为同一个值走缺省(demo 口径user1); - 仓储层兜底:绕过门面直接调仓储的调用方、以及将来门面的一次改动,都可能带着空值到底层,靠
AND 1=0拦住。
只修门面那半不算修完。这条纪律来自实际教训:同一个空 operator,八个栈一度给出三种答案------五个栈把条件丢掉读了全库,两个栈当真实值过滤出空页,一个栈归到缺省。跨语言对齐最难的部分往往不是"新功能怎么写",而是"坏输入怎么写才算一致"。
顺便一句边界:这道闸只收归属列 。同一个 buildWhere 里,m_LIKE_xxx 这类可选过滤传空值走的是另一条规则------"当作没填"。如果照字面把"空值即空页"推广到所有列,用户填了一半的搜索表单就会全部查出零行。
八、索引账:九条二级索引,四条查询各有归宿
建表 SQL 里这四张表的二级索引一共九条(PRIMARY KEY 不算):
sql
-- wf_process_instance
KEY idx_process_instance_pfid    (process_define_id),
KEY idx_process_instance_operator(operator);

-- wf_process_task
KEY idx_process_task_piid    (process_instance_id),
KEY idx_process_task_name    (task_name),
KEY idx_process_task_operator(operator);

-- wf_process_task_actor
KEY idx_process_task_actor_ptid(process_task_id),
KEY idx_process_task_actor_aid (actor_id);

-- wf_process_cc_instance
KEY idx_process_cc_instance_piid(process_instance_id),
KEY idx_process_cc_instance_aid (actor_id);
和四个入口对上(索引名一律省掉 idx_process_ 前缀,全名见上面那段 DDL):
| 入口 | 收窄靠哪一列 | 走的索引 |
|---|---|---|
| 我的待办 | pta.actor_id |
task_actor_aid,再按 process_task_id 回任务表 |
| 我的已办 | t.operator |
task_operator |
| 我发起的 | t.operator(实例表) |
instance_operator |
| 我的抄送 | cc.actor_id |
cc_instance_aid,实例侧走主键 |
四条归属列都有索引,这不是巧合,是"菜单入口决定索引"的设计。反过来说,这张账本也告诉你缺了什么:
task_state上没有索引,也没有(operator, task_state)这种复合索引。所以待办是"用actor_id拿到我参与的全部行,再过滤状态",不是索引直取。- 已办那句
<> 10本来也用不上索引------范围不等号在 MySQL 里基本不成索引条件,真正收窄结果集的还是operator。
这两条要不要补,取决于单个人名下挂多少条待办。审批场景里走 actor_id 收窄之后剩下的是"我参与的任务"这一小把,在它们中间过滤状态成本很低------索引设计该跟着"哪一列负责收窄"走,而不是跟着"WHERE 里写了哪几列"走。 真到了单人名下动辄上万条待办的量级(公共审批入口、批量发起那种),再考虑 (actor_id, task_state) 复合索引,这是有实测数据之后才该做的决定,本文没有这组数据。
还有一个反直觉的点值得记住:待办列表的入口不在任务表。 很多人接手这套库时的第一动作是给 task_state 加索引,那条索引对这四个查询一个都不起作用------因为驱动侧根本不是状态,是归属。
九、筛选参数:三段式写法与它挡掉的两样东西
上面反复提到 m_cc_EQ_state 这种参数,它是 mldong 系的通用查询约定:
m_{别名}_{操作符}_{列名}解析器就一个函数(Java JeeflowQueryParser):
java
if (parts.length == 2) {
    // m_EQ_taskName → column="t.task_name",默认别名 t
    operator = parts[0];
    column   = "t." + toUnderscore(parts[1]);
} else {
    // m_t_EQ_taskName → column="t.task_name"
    String alias = parts[0];
    operator = parts[1];
    column   = alias + "." + toUnderscore(parts[2]);
}
query.add(column, operator.toUpperCase(), value);驼峰自动转下划线,displayName 变 display_name;操作符 EQ / NE / LIKE / GT / LT / IN 走参数化占位符,不进字符串拼接。
别名那一段是为多表 JOIN 准备的。待办那条 SQL 里四张表带四个别名(t / pi / pd / pta),光写 m_LIKE_displayName 会落到默认别名 t 上------任务表恰好有一个 display_name(节点显示名),于是这个参数搜的是"节点名"。要按流程名搜,得显式写 m_pd_LIKE_displayName。前端实测就是这个区别:
ts
// 我的待办:搜节点名
{ fieldName: 'm_t_LIKE_displayName' }

// 我发起的:搜流程名
{ fieldName: 'm_pd_LIKE_displayName' }
{ fieldName: 'm_pd_LIKE_name' }

// 工作台"在办"卡:按实例状态筛
processInstancePage({ m_EQ_state: 10, pageNum: 1, pageSize: 6 })参数名和列白名单是对得上的:t.display_name 在待办白名单里、pd.display_name 在实例白名单里、t.state 也在------所以这三个筛选都是真生效的。
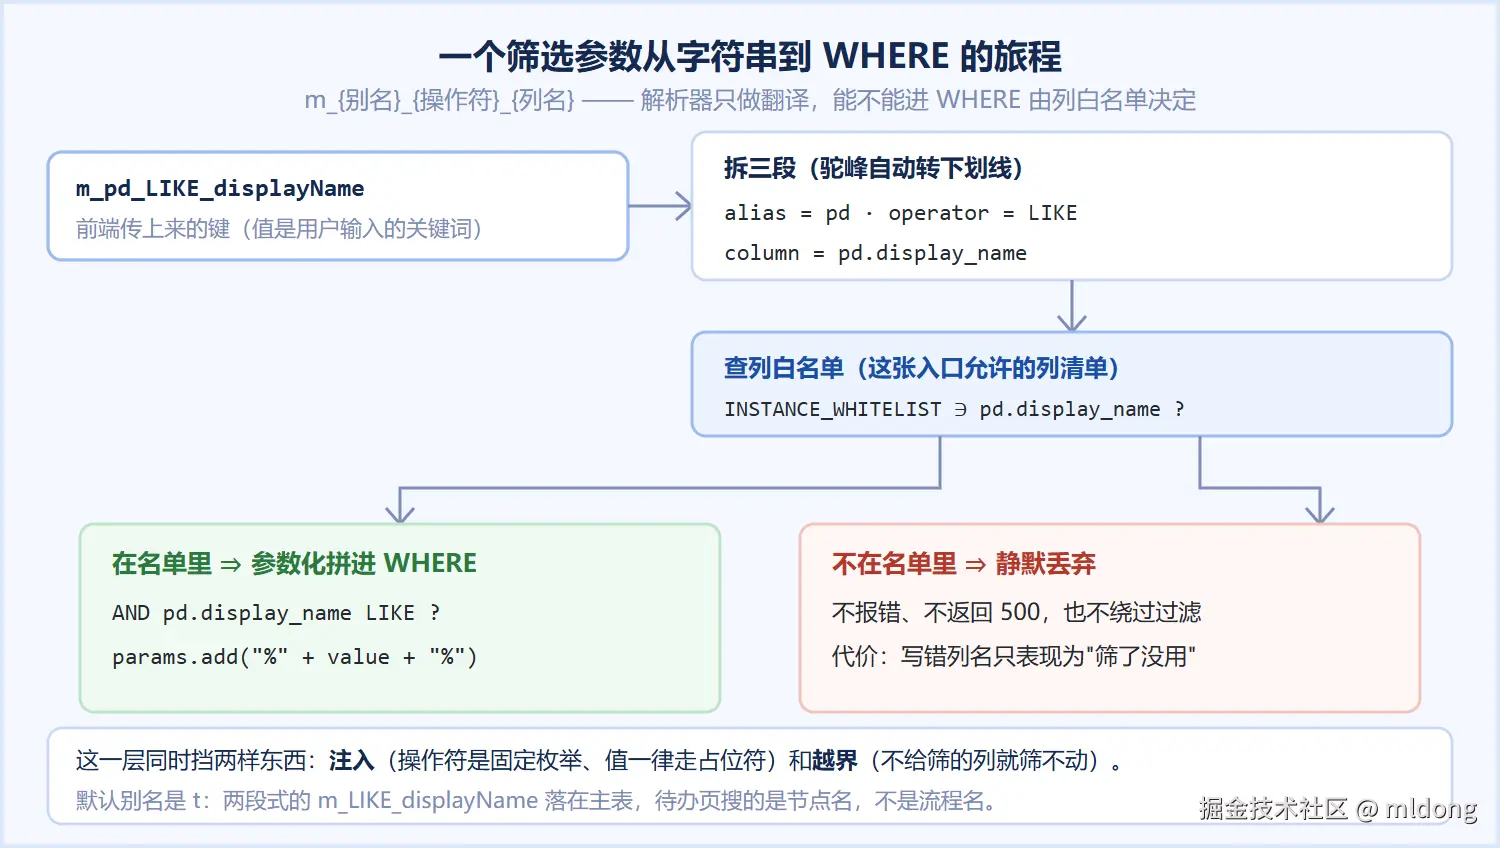
这套机制同时挡两样东西:
- 注入:操作符来自固定枚举、值一律走占位符,前端传什么都拼不出可执行 SQL;
- 越界 :不在白名单的列被静默丢弃。第二样常被误认为缺点------"我参数写错了怎么不报错?"------但它正是这张表存在的理由:一个错误的列名不该变成一条 500,也不该悄悄把过滤条件绕过。代价是写错列名不会有任何提示,只会表现为"这个筛选不管用"。所以加筛选项的时候,验证方式不是看接口返不返回 200,而是拿同一个关键词比较带参数和不带参数两次结果。
十、拿去自查:一个"我的"入口该问的六个问题
如果这篇只留一节,留这节。给自家审批中心(或任何多角色协作模块)做取数设计时,六个问题逐个答:
一,归属列在哪张表? 待办在参与者表、已办在任务表、发起在实例表、抄送在抄送表。四个入口挤在两张表里,是所有"我的"列表出错的起点。
二,该谁做和谁做了是两个问题。 actor_id 回答前者,operator 回答后者。用同一列做待办和已办,就会把"该我没做"和"我做完了"混成一堆。
三,状态用白名单还是补集? 只要存在"撤回/终止/废弃"这类既不是进行中也不是已完成的状态,IN (已完成) 就会造出两头消失的记录。每条记录必须在"待办"和"已办"里至少出现一次,除非你有明确的产品理由让它消失。
四,JOIN 一对多时计数按什么去重? 一个任务多个参与者是标配形状。列表去重而计数不去重,分页就会长期显示一个错的总数。
五,坏输入返回什么? 归属列为空的查询,答案是"空页"还是"全库"?这一条要写成代码里的显式分支(我们的写法是 AND 1=0),而且要同时钉在不同实现上------同一套接口如果有内存版和数据库版两个仓储,只修一个等于没修。
六,哪一列负责收窄结果集? 索引跟着它加,而不是跟着 WHERE 里的列名挨个加。task_state 上那条索引看着对症,实际四个查询一个都不走。
结语
这一排菜单在产品上是最普通不过的五个入口,在库里是四张表、四条归属列、九条索引、两层空值闸。麻烦的地方从来不在"能不能查出来",而在同一句话------"我的"------在不同表上得用不同列来回答,一旦漏掉这个,用户看到的就不是慢,是他的单子不见了。
引擎本体不依赖 ORM、也不依赖任何 Web 框架,但它对"我的"这件事的处理方式是可以直接搬进任何一套后台系统的:先决定归属列住在哪张表,再决定状态集怎么用,最后给收窄列配索引。
参考资料
- jeeflow 工作流引擎文档站:jeeflow-doc.mldong.com
- 动作与参数契约(规范 06 · 门面):jeeflow-doc.mldong.com/spec/06-fac...
- 数据模型与建表 SQL(规范 01):jeeflow-doc.mldong.com/spec/01-dat...
- GitHub(Java 参考实现):github.com/mldong/jeef...
- mldong 快速开发框架:github.com/mldong/mldo...