前言
RabbitMQ 是微服务中常见的消息中间件,主要用来完成异步通信、服务解耦和流量削峰。本文从同步调用的问题开始,依次讲解 RabbitMQ 的核心对象、Spring Boot 集成、Work Queue、交换机、消息可靠性、业务幂等和延迟消息,并给出可以直接改造到 Spring AMQP 项目中的代码示例。
一、为什么需要消息队列
同步调用中,调用方必须等待被调用方返回结果。以支付为例,支付服务扣款后还要同步调用订单、通知、积分等服务。下游服务越多,调用链越长,支付请求的响应时间越难控制;其中一个服务变慢或故障,还可能占满上游线程,引发级联失败。
异步调用把"通知下游处理"变成一条消息。发送方把消息交给消息代理后即可继续执行,消费者在自己的节奏下处理消息。这样可以减少服务之间的直接依赖,并用队列暂存突发流量。
异步调用适合"后续动作依赖前置结果,但前置服务不需要等待后续结果"的场景,例如支付成功后通知订单服务更新状态、通知服务发送消息、积分服务增加积分。若下一步必须立即拿到上一步的返回值,仍应使用同步调用。
异步方案需要接受几个代价:调用方不能立即得到下游结果,消息代理或消费者故障需要补偿,消息可能重复投递。因此,可靠性和幂等性必须一起设计。
二、RabbitMQ基础概念与环境准备
1. RabbitMQ的核心对象
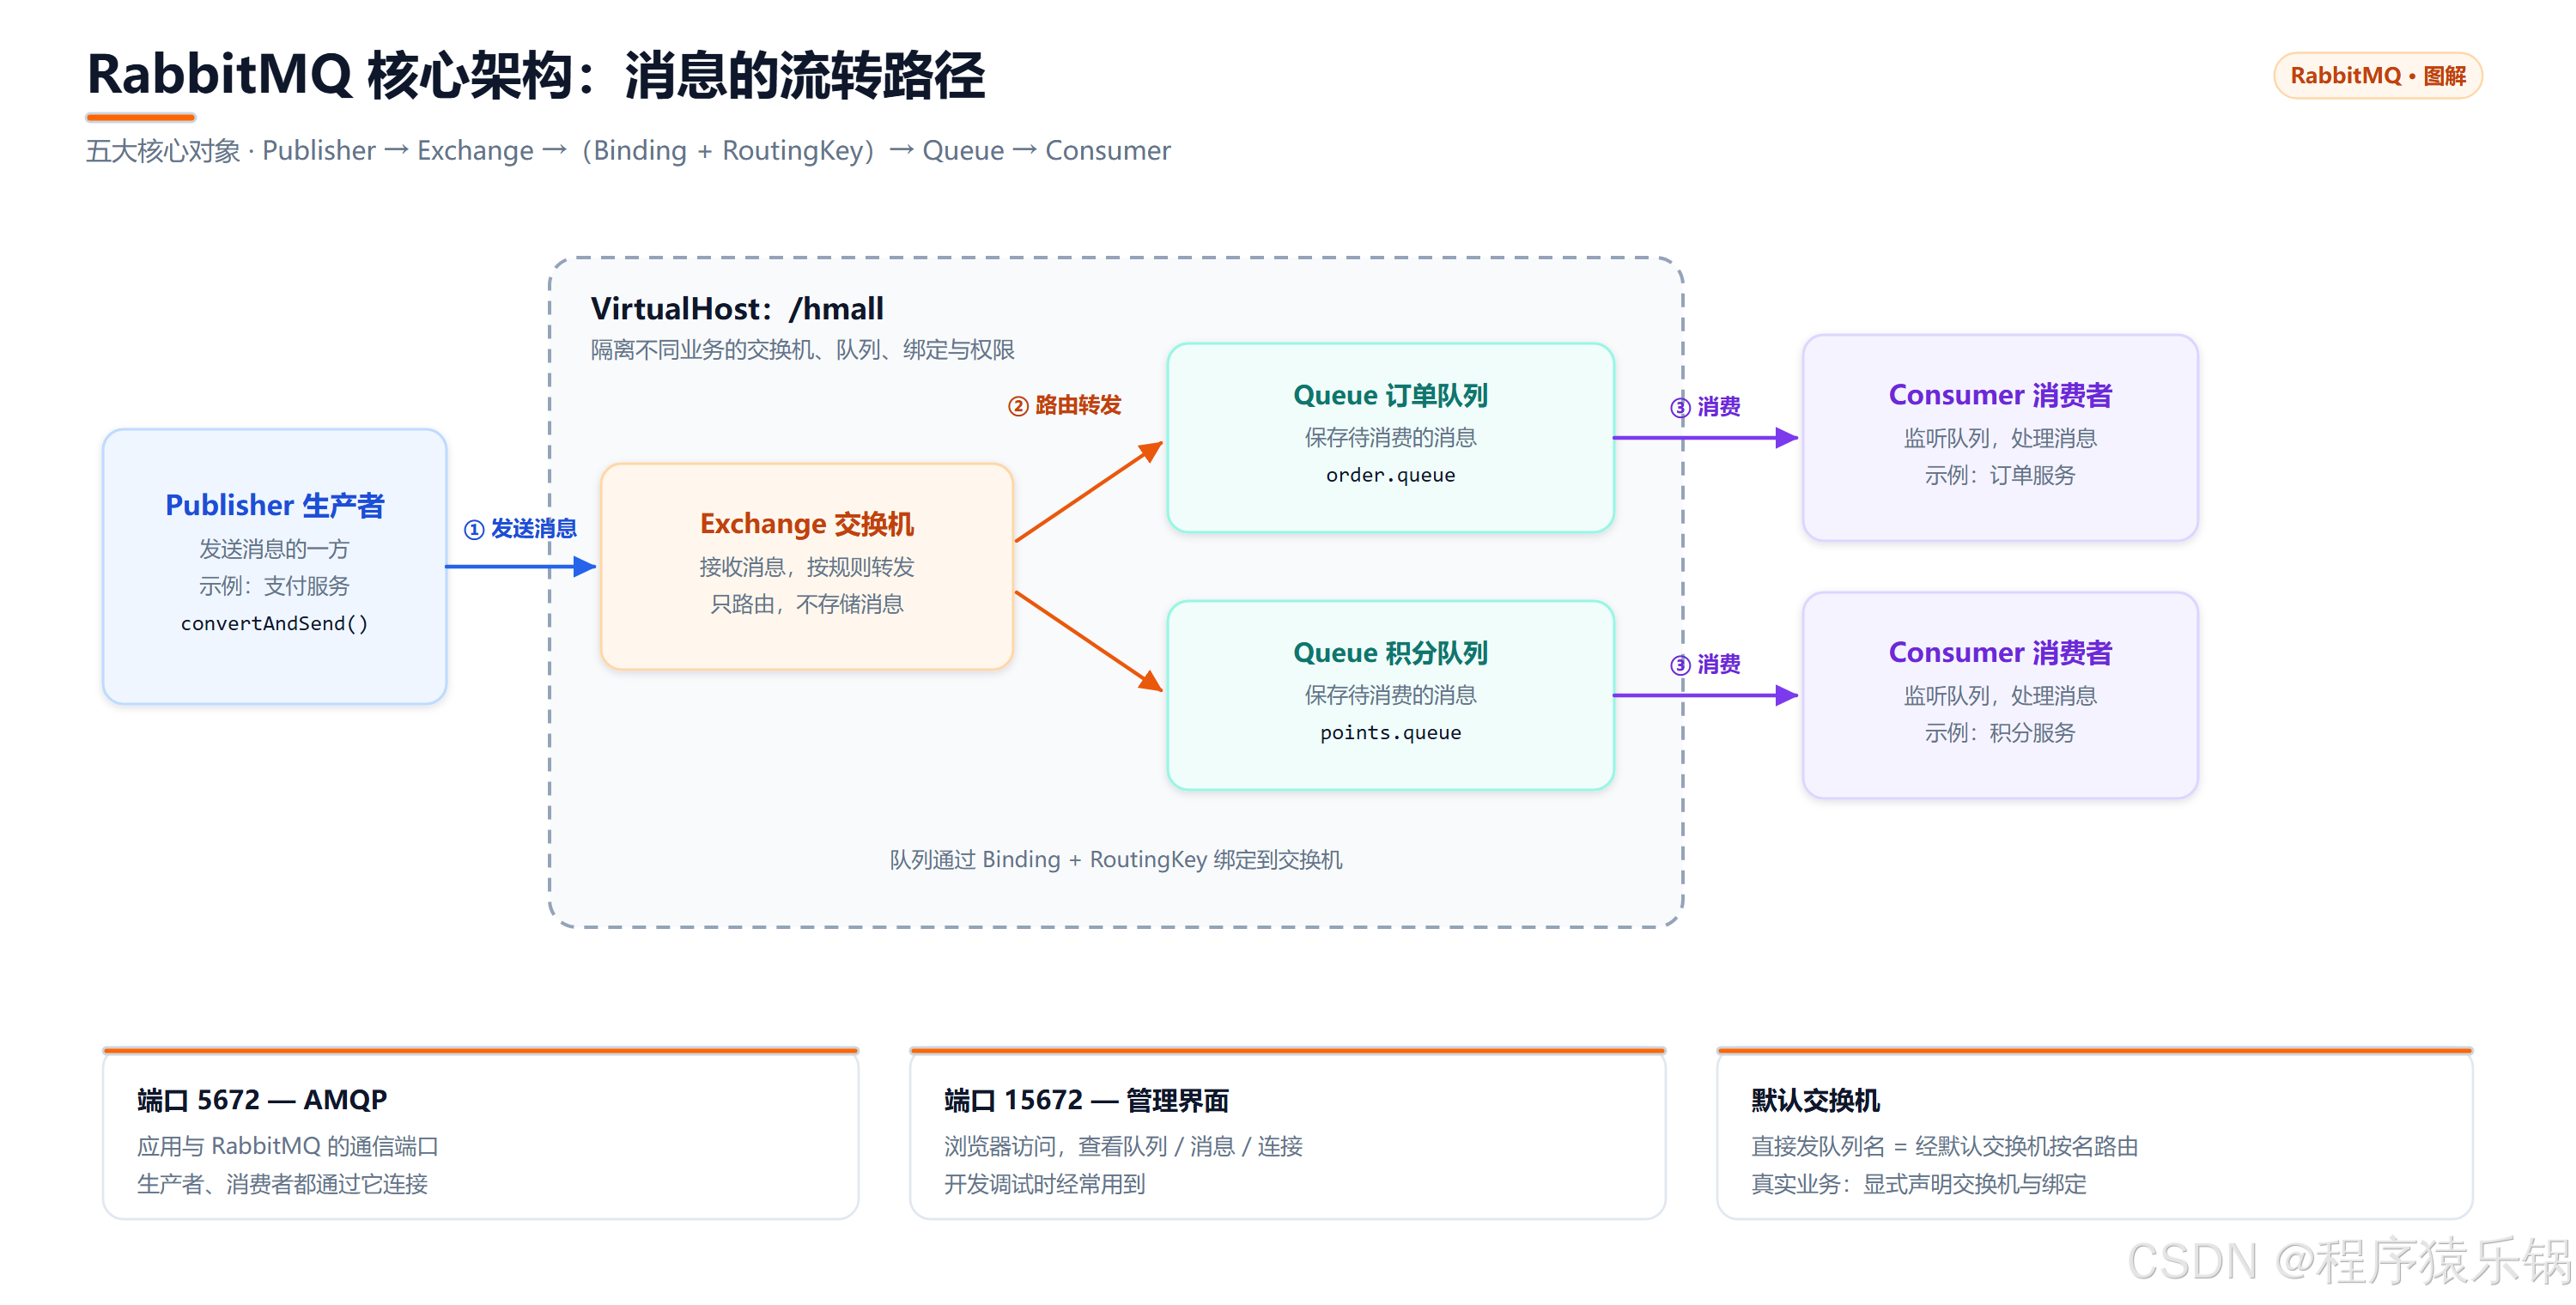
RabbitMQ中最重要的对象有五个:
- Publisher:发送消息的生产者。
- Exchange:交换机,接收消息并根据路由规则转发。
- Queue:队列,保存等待消费的消息。
- Consumer:消费者,从队列接收并处理消息。
- VirtualHost:虚拟主机,用于隔离不同业务的交换机、队列、绑定和权限。
消息的典型路径是:
text
Publisher -> Exchange -> Binding + RoutingKey -> Queue -> Consumer交换机只负责路由和转发,不负责长期存储消息。生产者直接向队列发送时,使用的是 RabbitMQ 的默认交换机;进入真实业务后,通常显式声明业务交换机和绑定关系。
2. Spring AMQP依赖和连接配置
Spring Boot 集成 RabbitMQ 时需要引入 spring-boot-starter-amqp:
xml
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-amqp</artifactId>
</dependency>
连接配置至少要保持 host、port、virtual-host、username 和 password 一致:
yaml
spring:
  rabbitmq:
    host: localhost
    port: 5672
    virtual-host: /hmall
    username: ******
    password: ******
    connection-timeout: 1s
5672 是 AMQP 客户端端口,15672 是管理页面端口。连接到哪个 VirtualHost,决定了应用能看到哪一组交换机和队列。
三、Spring AMQP的基本收发
1. 生产者发送消息
Spring AMQP通过 RabbitTemplate 封装了连接、信道和消息转换。发送字符串到队列可以直接调用:
java
@Autowired
private RabbitTemplate rabbitTemplate;

@Test
void testSend() {
    String queueName = "test.quene";
    String message = "hello world";
    rabbitTemplate.convertAndSend(queueName, message);
}第一个参数是目标名称。这里传入队列名,消息会经由默认交换机按队列名路由;第二个参数是消息体。convertAndSend 会根据消息转换器把 Java 对象转换为 RabbitMQ 消息。
2. 消费者监听队列
消费者使用 @RabbitListener 声明监听目标:
java
@Component
public class MqListener {

    @RabbitListener(queues = "test.quene")
    public void listenSimpleQuene(String message) {
        System.out.println("消费者收到了test.quene消息:" + message);
    }
}
应用启动后,Spring AMQP会为监听方法创建消费者。方法参数接收消息体,方法正常返回时消息会进入确认流程;如果方法抛出异常,则由确认模式和重试配置决定消息是否重新投递。
3. 对象消息使用JSON转换
默认的消息转换器可能使用 JDK 序列化,消息在管理页面上可读性较差,也会带来更大的体积和反序列化风险。项目在 publisher 启动类中配置了 JSON 转换器:
java
@Bean
public MessageConverter messageConverter() {
    Jackson2JsonMessageConverter converter = new Jackson2JsonMessageConverter();
    converter.setCreateMessageIds(true);
    return converter;
}
Jackson2JsonMessageConverter 负责把对象转换为 JSON;setCreateMessageIds(true) 会为消息生成 messageId,为后续去重提供消息级标识。发送 Map 时:
java
Map<String, Object> map = new HashMap<>(2);
map.put("name", "张三");
map.put("age", 18);
rabbitTemplate.convertAndSend("Object.queue", map);
消费者应使用与发送端匹配的类型接收消息,例如使用 Map<String, Object> 接收上述 JSON 对象。生产者和消费者的消息转换器必须保持兼容,不能让同一队列中同时混用无法互相解析的序列化格式。
四、Work Queue:多个消费者共同处理一个队列
当单个消费者处理速度跟不上生产速度时,消息会在队列中堆积。Work Queue 让多个消费者监听同一个队列,同一条消息只会交给其中一个消费者处理,适合把任务分摊给多个实例。
生产者可以在短时间内发送一批消息:
java
@Test
void testSimple() throws Exception {
    String queueName = "simple.quene";
    for (int i = 1; i <= 50; i++) {
        String message = "hello simple:" + i;
        rabbitTemplate.convertAndSend(queueName, message);
        Thread.sleep(20);
    }
}
消费者端配置两个监听方法:
java
@RabbitListener(queues = "simple.quene")
public void listenSimpleQuene1(String message) throws InterruptedException {
    System.out.println("消费者收到了simple.quene消息:" + message);
    Thread.sleep(20);
}

@RabbitListener(queues = "simple.quene")
public void listenSimpleQuene2(String message) throws InterruptedException {
    System.out.println("消费者收到了simple.quene消息..................:" + message);
    Thread.sleep(200);
}
默认分发方式接近轮询,消费者能力不同也可能拿到相近数量的消息。项目在 consumer 模块配置:
yaml
spring:
  rabbitmq:
    listener:
      simple:
        prefetch: 1
prefetch: 1 表示消费者处理完当前消息后再获取下一条。这样处理速度快的消费者可以继续领取任务,处理速度慢的消费者不会提前积压一批未完成消息。
五、交换机决定消息如何路由
1. Fanout:广播到所有绑定队列
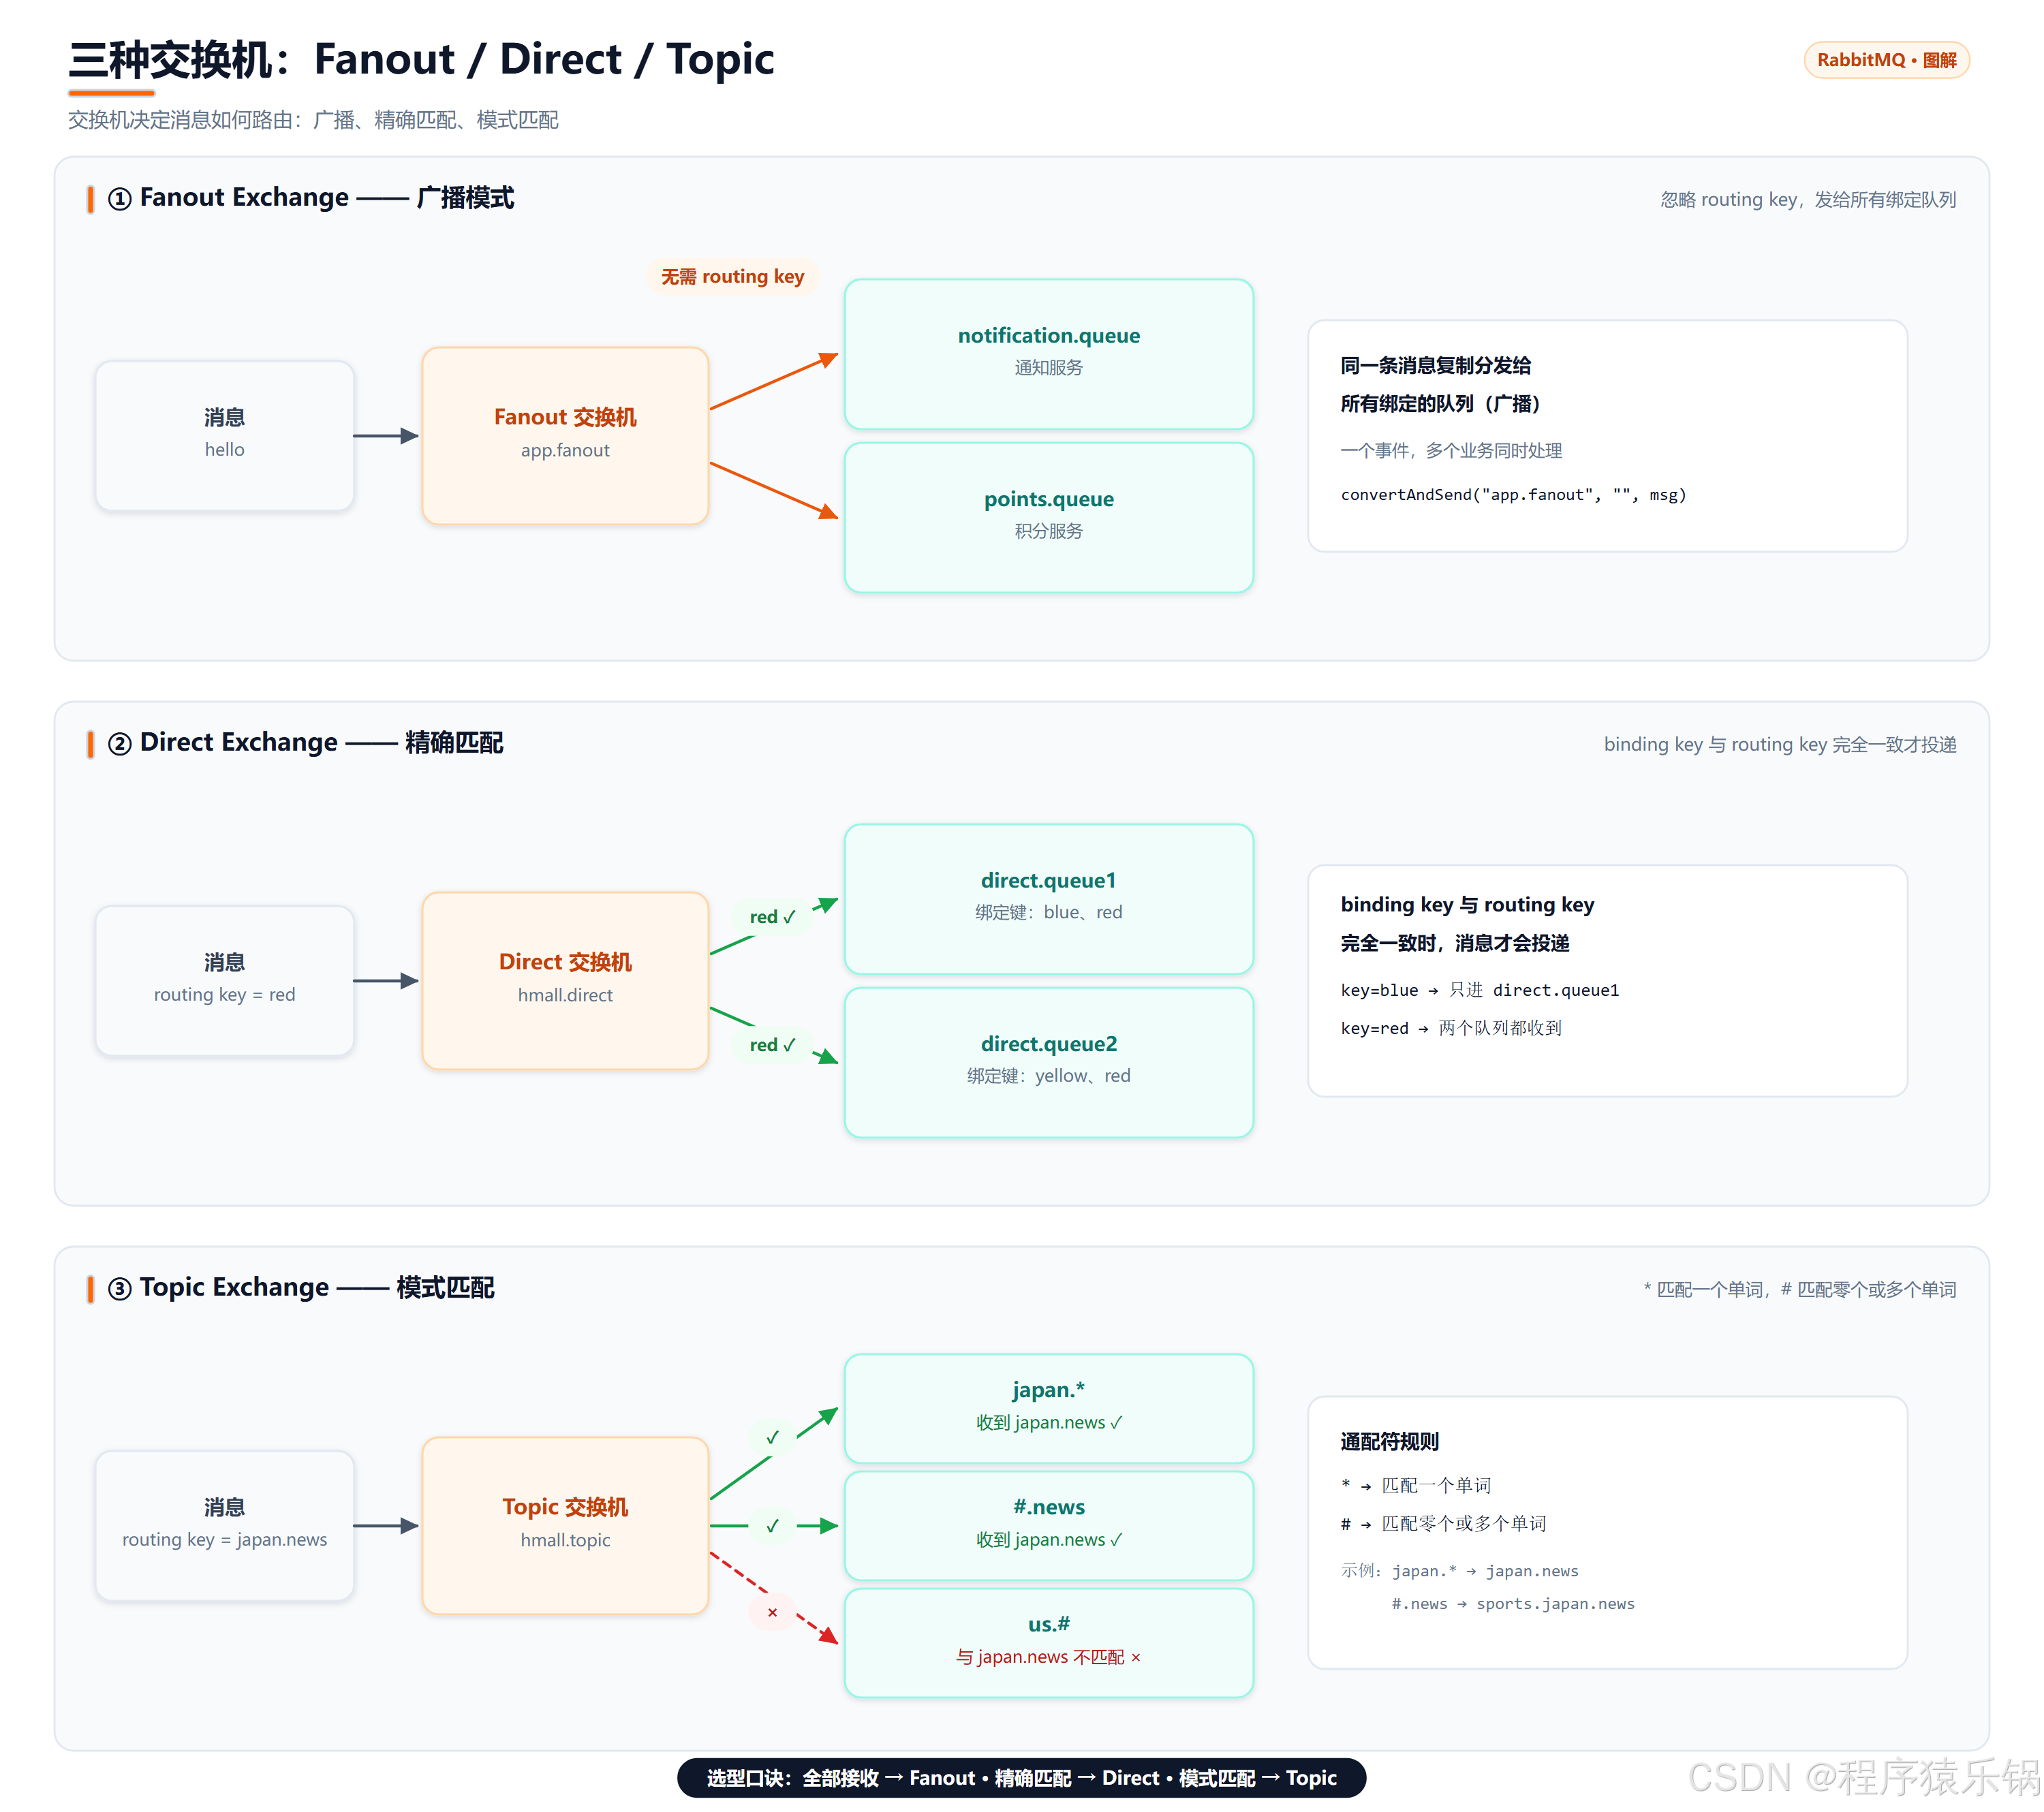
Fanout 交换机忽略 routing key,把消息发送给所有绑定队列。一个事件需要被多个业务同时处理时,可以使用广播模式。
可以通过配置类声明交换机、队列和绑定:
java
@Configuration
public class FanoutConfiguration {

    @Bean
    public FanoutExchange fanoutExchange() {
        return new FanoutExchange("app.fanout");
    }

    @Bean
    public Queue fanoutQueue3() {
        return new Queue("notification.queue", true);
    }

    @Bean
    public Queue fanoutQueue4() {
        return new Queue("points.queue", true);
    }

    @Bean
    public Binding bindingFanoutQueue3(Queue fanoutQueue3,
                                      FanoutExchange fanoutExchange) {
        return BindingBuilder.bind(fanoutQueue3).to(fanoutExchange);
    }

    @Bean
    public Binding bindingFanoutQueue4(Queue fanoutQueue4,
                                      FanoutExchange fanoutExchange) {
        return BindingBuilder.bind(fanoutQueue4).to(fanoutExchange);
    }
}
这里两个队列都绑定到同一个 FanoutExchange,因此同一条消息会分别进入两个队列。队列名称必须稳定,生产者发送时使用交换机名:
java
rabbitTemplate.convertAndSend("app.fanout", "", "hello everyone");2. Direct:按精确 routing key 路由
Direct 交换机要求 binding key 与消息的 routing key 精确匹配。下面两个监听器分别声明自己的队列和绑定键:
java
@RabbitListener(bindings = @QueueBinding(
        value = @Queue(name = "direct.queue1", durable = "true"),
        exchange = @Exchange(
                name = "hmall.direct",
                type = ExchangeTypes.DIRECT),
        key = {"blue", "red"}
))
public void listenDirectQueue1(String message) {
    System.out.println("消费者收到了direct.queue1消息:" + message);
}

@RabbitListener(bindings = @QueueBinding(
        value = @Queue(name = "direct.queue2", durable = "true"),
        exchange = @Exchange(
                name = "hmall.direct",
                type = ExchangeTypes.DIRECT),
        key = {"yellow", "red"}
))
public void listenDirectQueue2(String message) {
    System.out.println("消费者收到了direct.queue2消息..................:" + message);
}
发送 routing key 为 blue 时,只会匹配 direct.queue1;发送 red 时,两个队列都会匹配。Direct 适合路由条件明确、值域有限的场景。
3. Topic:用通配符匹配 routing key
Topic 交换机在 Direct 的精确匹配基础上增加通配符:* 匹配一个单词,# 匹配零个或多个单词。例如 japan.* 可以匹配 japan.news,#.news 可以匹配 japan.news 或 sports.japan.news。
发送 Topic 消息时,可以把业务领域和事件类型写入 routing key:
java
rabbitTemplate.convertAndSend("hmall.topic", "japan.news", "日本爆炸了");Topic 适合把业务领域、事件类型等信息编码进 routing key,再由多个队列按模式订阅。选择交换机时,可以按"全部接收、精确匹配、模式匹配"分别对应 Fanout、Direct、Topic。
六、从发送到入队:生产者可靠性
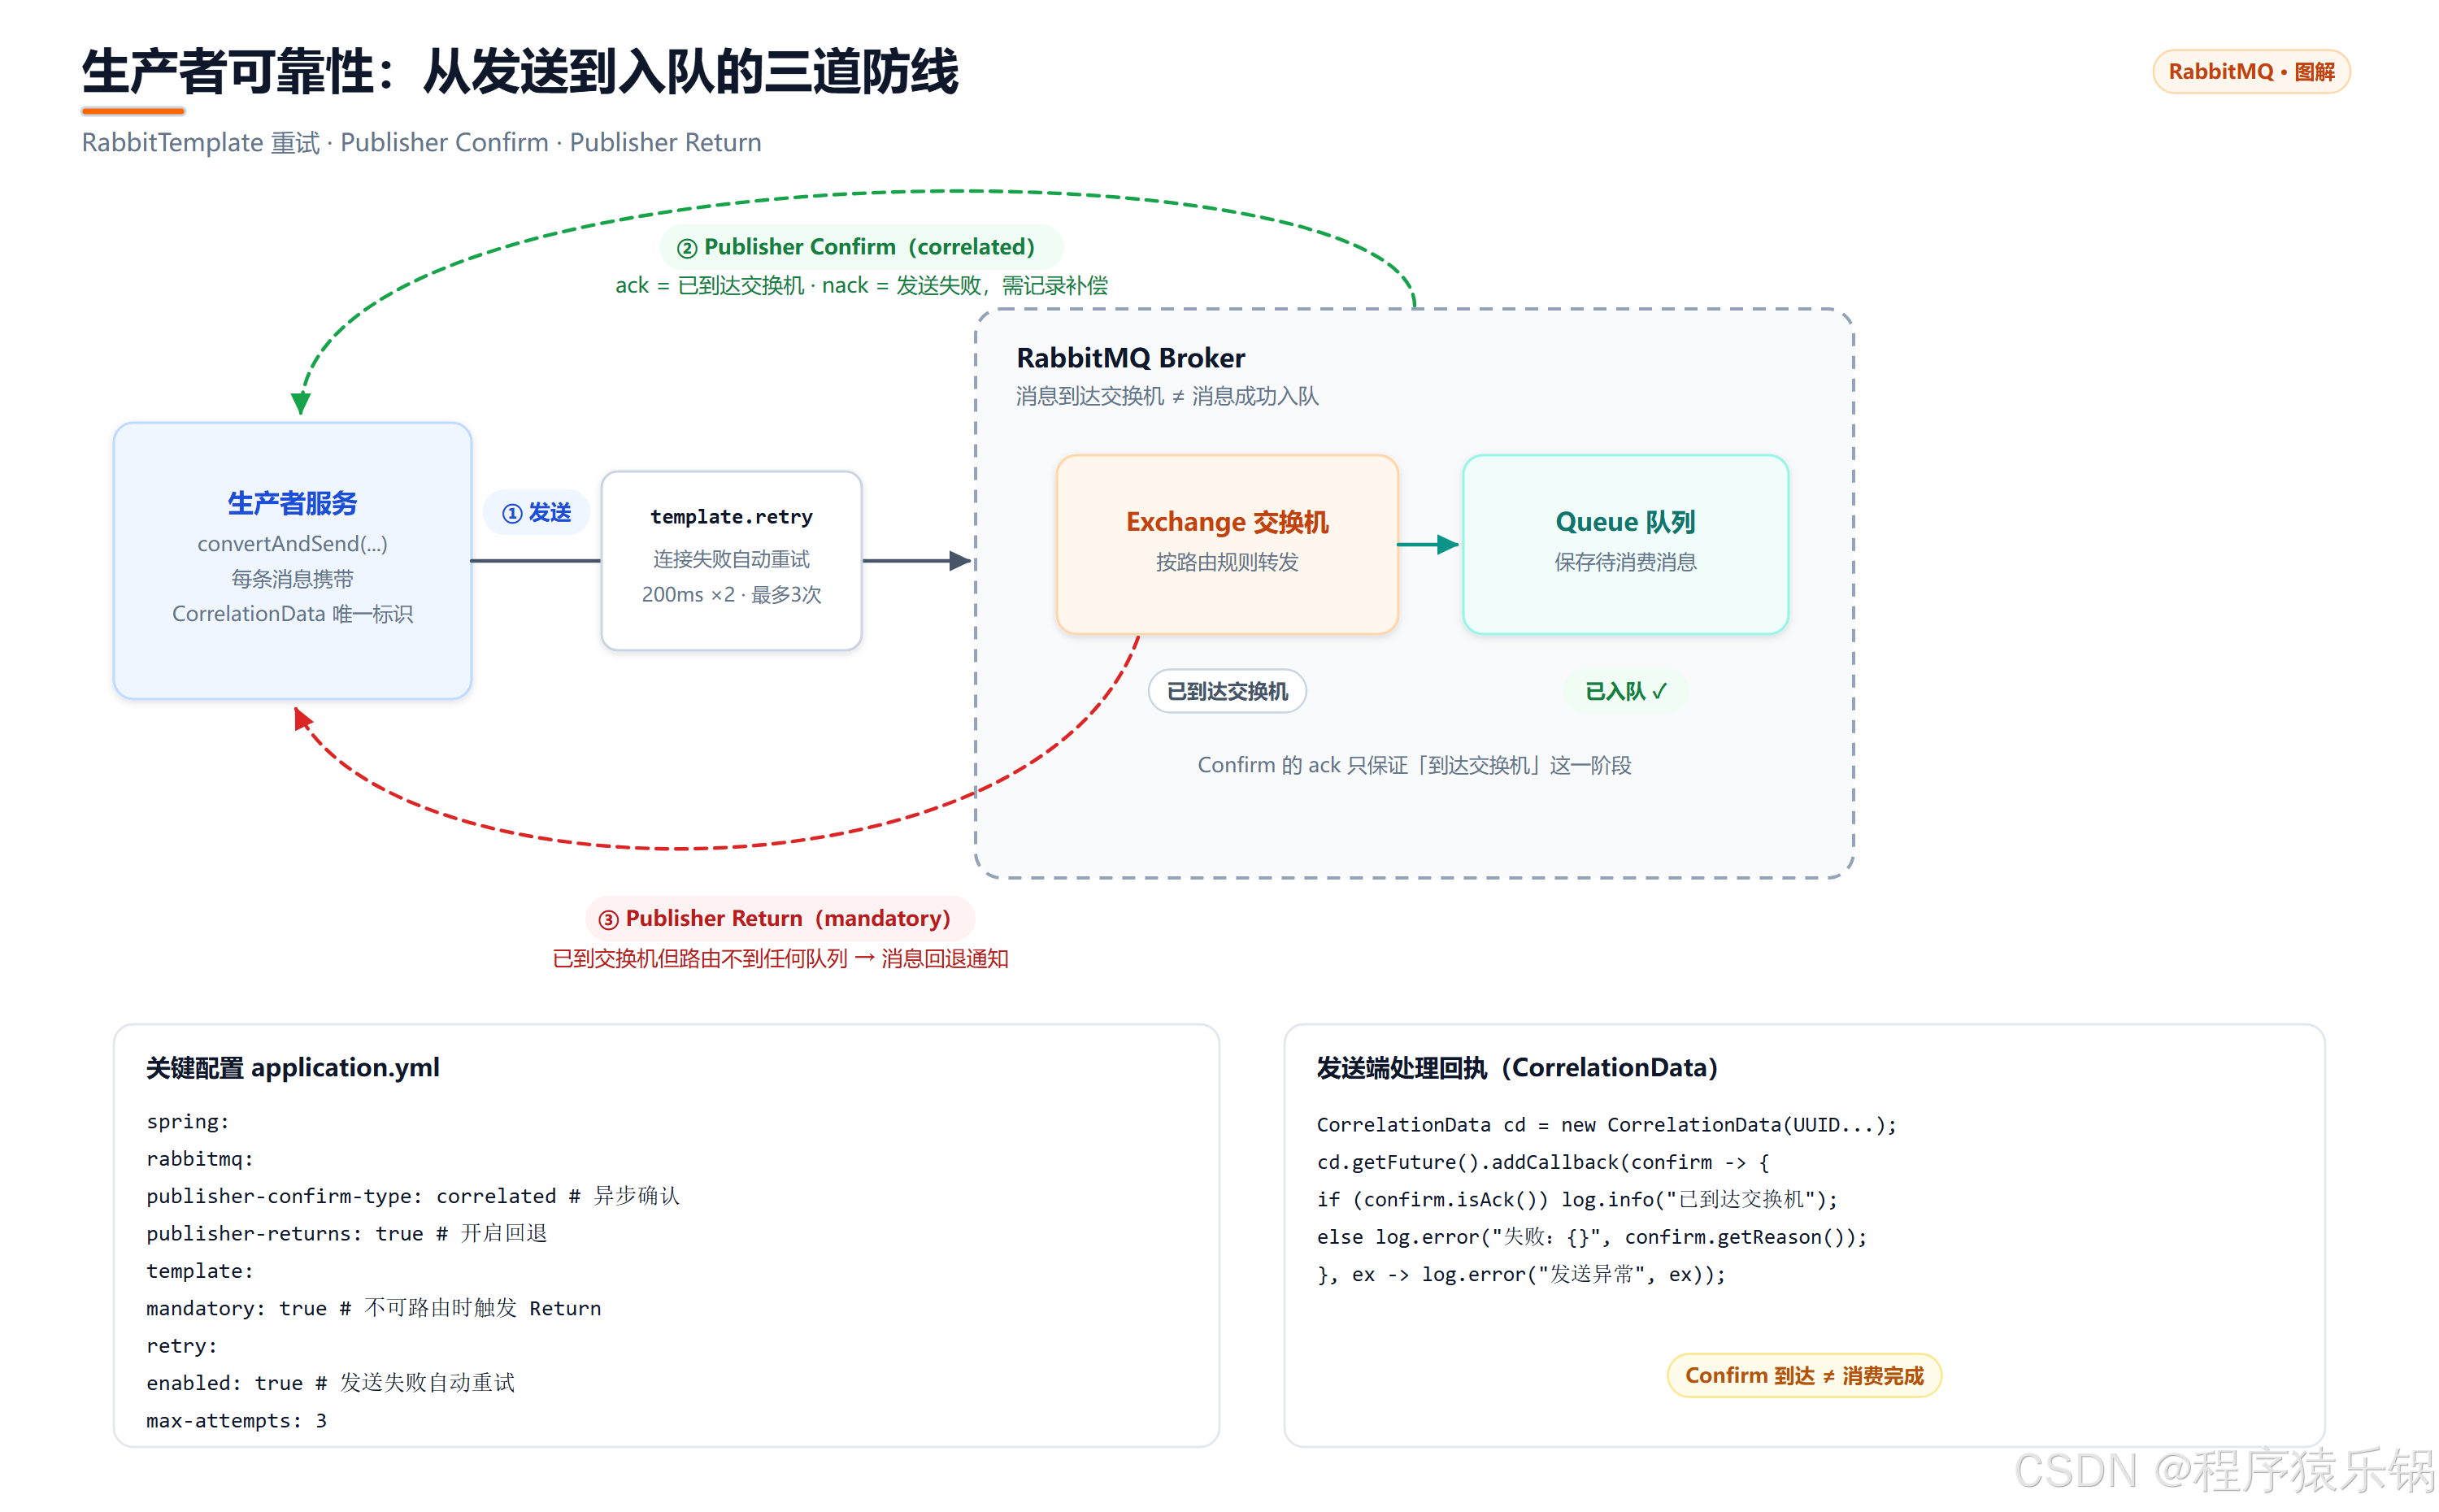
消息可能在生产者到 RabbitMQ 的连接阶段失败,也可能到达交换机后没有匹配到队列。生产者可靠性通常包括 RabbitTemplate 操作重试、Publisher Confirm 和 Publisher Return:
yaml
spring:
  rabbitmq:
    connection-timeout: 1s
    template:
      retry:
        enabled: true
        initial-interval: 200ms
        multiplier: 2
        max-attempts: 3
      mandatory: true
    publisher-confirm-type: correlated
    publisher-returns: true
connection-timeout 只控制建立连接的超时时间,template.retry 控制 RabbitTemplate 操作失败后的重试,两者作用不同。重试可以应对短暂网络抖动,但同步重试会占用发送线程,重试次数和等待时间需要结合接口响应要求设置。
Publisher Confirm 用来确认 RabbitMQ 是否接收了发布请求;correlated 模式通过 CorrelationData 异步关联每条消息的回执。Confirm不代表消息已经被消费者处理。Publisher Return 用来处理"消息已到交换机,但无法路由到队列"的情况,需要开启 mandatory,并且每个 RabbitTemplate 只能设置一个 ReturnCallback:
java
@Configuration
@Slf4j
public class MqConfirmConfig implements ApplicationContextAware {

    @Override
    public void setApplicationContext(ApplicationContext applicationContext) {
        RabbitTemplate rabbitTemplate =
                applicationContext.getBean(RabbitTemplate.class);
        rabbitTemplate.setReturnsCallback(returned -> log.debug(
                "收到消息的return callback, exchange:{}, key:{}, msg:{}, code:{}, text:{}",
                returned.getExchange(),
                returned.getRoutingKey(),
                returned.getMessage(),
                returned.getReplyCode(),
                returned.getReplyText()));
    }
}
发送端可以使用 CorrelationData 处理确认:
java
CorrelationData correlationData =
        new CorrelationData(UUID.randomUUID().toString());
correlationData.getFuture().addCallback(
        new ListenableFutureCallback<CorrelationData.Confirm>() {
            @Override
            public void onFailure(Throwable ex) {
                log.error("消息发送失败", ex);
            }

            @Override
            public void onSuccess(@Nullable CorrelationData.Confirm result) {
                if (result != null && result.isAck()) {
                    log.info("消息发送成功");
                } else {
                    log.error("消息发送失败,原因:{}", result.getReason());
                }
            }
        });

rabbitTemplate.convertAndSend("hmall.direct", "red", "hello", correlationData);
确认成功只能说明发布链路达到了对应阶段,业务仍要记录失败消息、处理无法路由的消息,并决定是否重试。错误的交换机名、routing key 或绑定关系,应优先修正配置,而不是无限重发。
七、RabbitMQ消息持久化
RabbitMQ的持久化需要同时考虑三个对象:
- 交换机持久化,保证交换机重启后仍存在。
- 队列持久化,保证队列重启后仍存在。
- 消息持久化,保证消息可以被写入磁盘。
只持久化队列而不持久化消息,仍然可能在 RabbitMQ 重启时丢失消息;只持久化消息而没有持久化队列,也无法恢复完整路由链路。持久化交换机、队列和持久化消息是三个独立设置,生产环境应在控制台或代码中明确检查 durable 和 delivery mode。
1. 交换机和队列持久化
编程式声明交换机和队列时,可以明确指定持久化:
java
@Bean
public DirectExchange orderExchange() {
    return new DirectExchange("order.direct", true, false);
}

@Bean
public Queue orderQueue() {
    return new Queue("order.queue", true);
}
第二个参数 true 表示交换机或队列持久化。RabbitMQ重启后,持久化对象可以重新加载;临时交换机或临时队列则可能随着连接或服务结束而消失。
2. 消息持久化
发送消息时,可以通过消息属性指定持久化投递模式:
java
Message message = MessageBuilder
        .withBody("订单支付成功".getBytes(StandardCharsets.UTF_8))
        .setDeliveryMode(MessageDeliveryMode.PERSISTENT)
        .build();

rabbitTemplate.convertAndSend(
        "order.direct", "order.paid", message);
只有交换机、队列和消息都满足持久化要求,RabbitMQ重启后才有机会恢复完整消息链路。持久化会增加磁盘写入开销,发布确认也应与持久化策略一起考虑。
3. Lazy Queue和消息堆积
消费者处理速度过慢时,消息会在队列中积压。旧版本 RabbitMQ中可以使用 x-queue-mode=lazy 让消息更早写入磁盘,降低内存占用。
java
@Bean
public Queue lazyQueue() {
    return QueueBuilder
            .durable("lazy.queue")
            .withArgument("x-queue-mode", "lazy")
            .build();
}
RabbitMQ 3.12及之后,经典队列的实际行为已经接近历史上的惰性队列,旧的 x-queue-mode=lazy 配置可能被忽略。使用时应以实际 RabbitMQ 版本的官方文档和管理页面为准,不要把旧版本配置直接当成所有版本都适用的结论。
消息持久化会带来磁盘写入开销,发布确认在持久化完成后才有意义。消息大量堆积时要关注内存、磁盘和消费者处理速度,避免把持久化当成无限扩容手段。
八、消费者确认、重试和失败消息
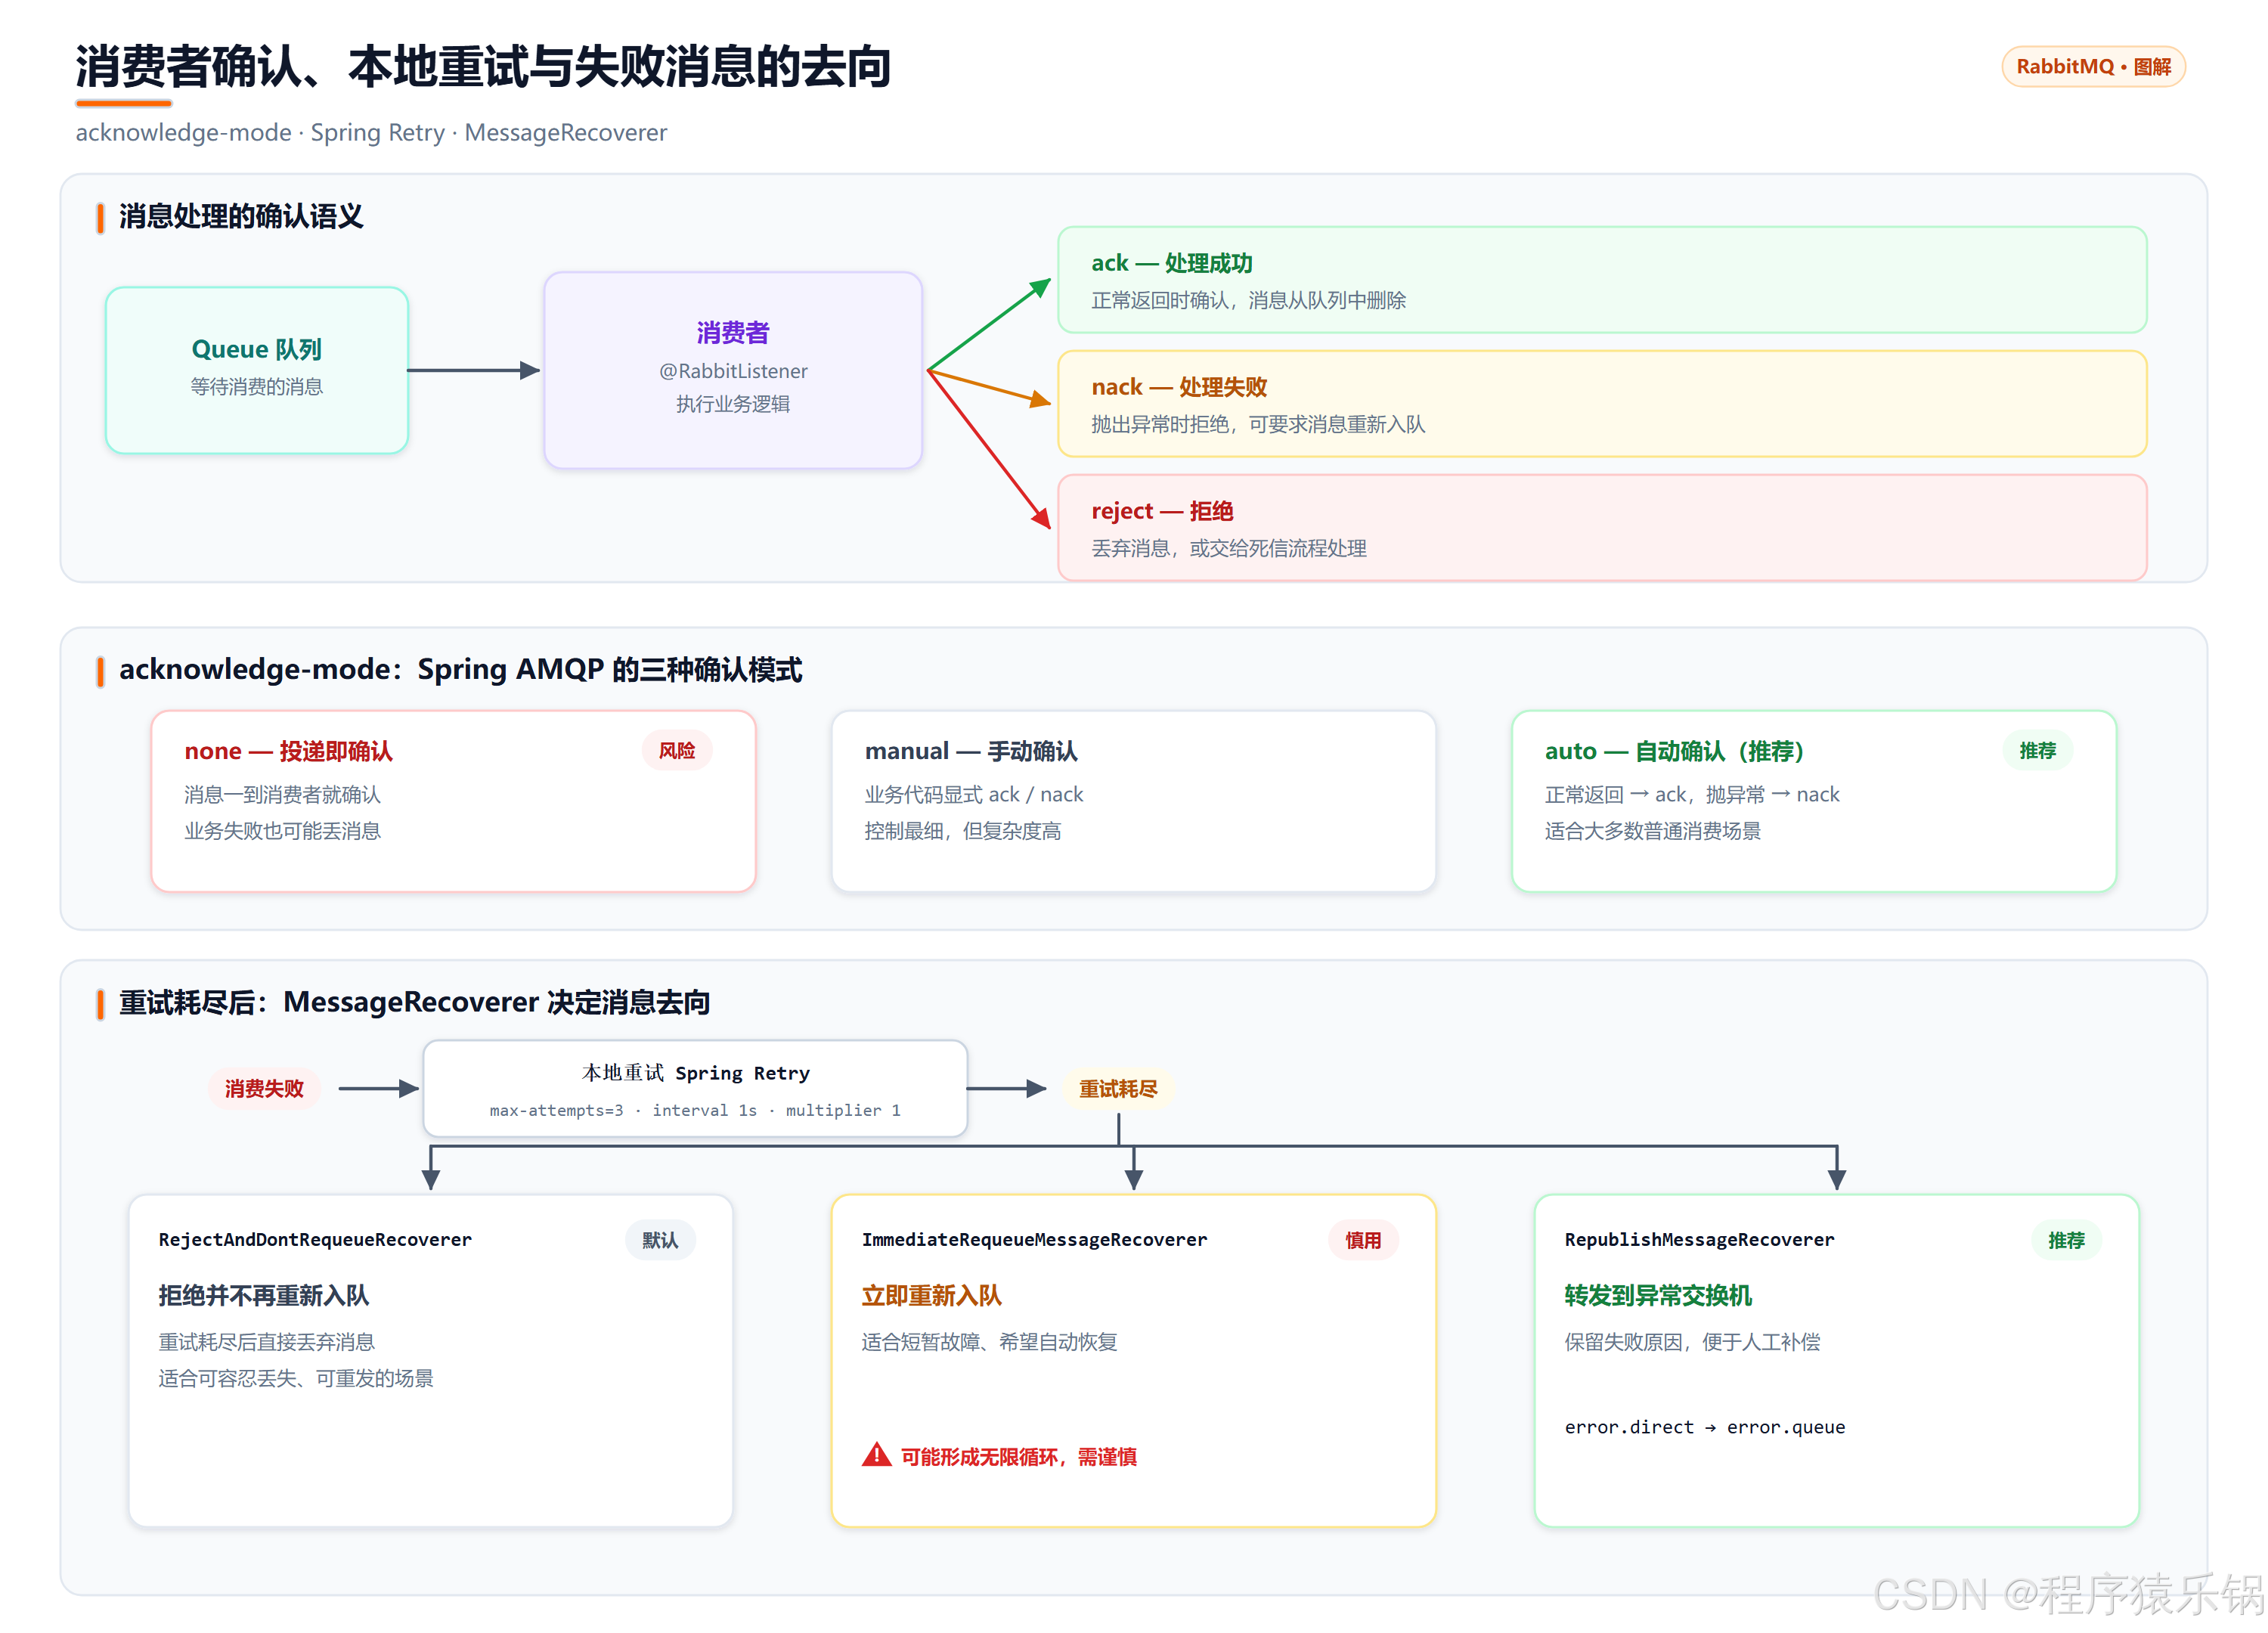
消费者确认用于告诉 RabbitMQ 消息处理结果:
ack:处理成功,消息从队列中删除。nack:处理失败,可以要求消息重新入队。reject:拒绝消息并丢弃,或交给死信流程。
Spring AMQP的 acknowledge-mode 常见有三种:
none:消息投递给消费者后立即确认,业务失败也可能丢消息。manual:业务代码显式调用确认 API,控制最细,但会增加业务代码复杂度。auto:Spring 根据监听方法是否正常返回来确认或拒绝消息,适合大多数普通消费场景。
普通队列监听器可以配置为 auto 模式:
yaml
spring:
  rabbitmq:
    listener:
      simple:
        acknowledge-mode: auto
对于简单业务,auto 模式可以让消息处理成功时自动 ack,抛出异常时进入失败处理流程。关键业务要结合重试、幂等和异常队列一起使用。
如果异常消息一直重新入队,会形成"消费失败 -> requeue -> 再次消费"的无限循环。Spring Retry 可以把有限次数的重试放在消费者本地:
yaml
spring:
  rabbitmq:
    listener:
      simple:
        acknowledge-mode: auto
        retry:
          enabled: true
          initial-interval: 1000ms
          multiplier: 1
          max-attempts: 3
          stateless: true
max-attempts 是总尝试次数,initial-interval 是第一次失败后的等待时间,multiplier 控制后续等待时间的增长。是否使用 stateless,要根据业务是否依赖事务上下文判断。
重试耗尽后,MessageRecoverer 决定消息去向:
RejectAndDontRequeueRecoverer:拒绝并丢弃,默认策略。ImmediateRequeueMessageRecoverer:重新入队,适合短暂故障,但要防止循环。RepublishMessageRecoverer:把失败消息重新发布到异常交换机,保留失败原因,便于人工处理和补偿。
可以声明异常交换机、异常队列和恢复器,核心配置如下:
java
@Bean
public MessageRecoverer messageRecoverer(RabbitTemplate rabbitTemplate) {
    return new RepublishMessageRecoverer(
            rabbitTemplate, "error.direct", "error");
}
交换机名称、队列名称和恢复器目标必须保持一致,否则重试耗尽后消息无法按预期进入异常队列。异常队列不应被当成普通业务队列长期堆积,需要配套人工处理、补偿或告警机制。
九、业务幂等:允许重复投递但不能重复生效
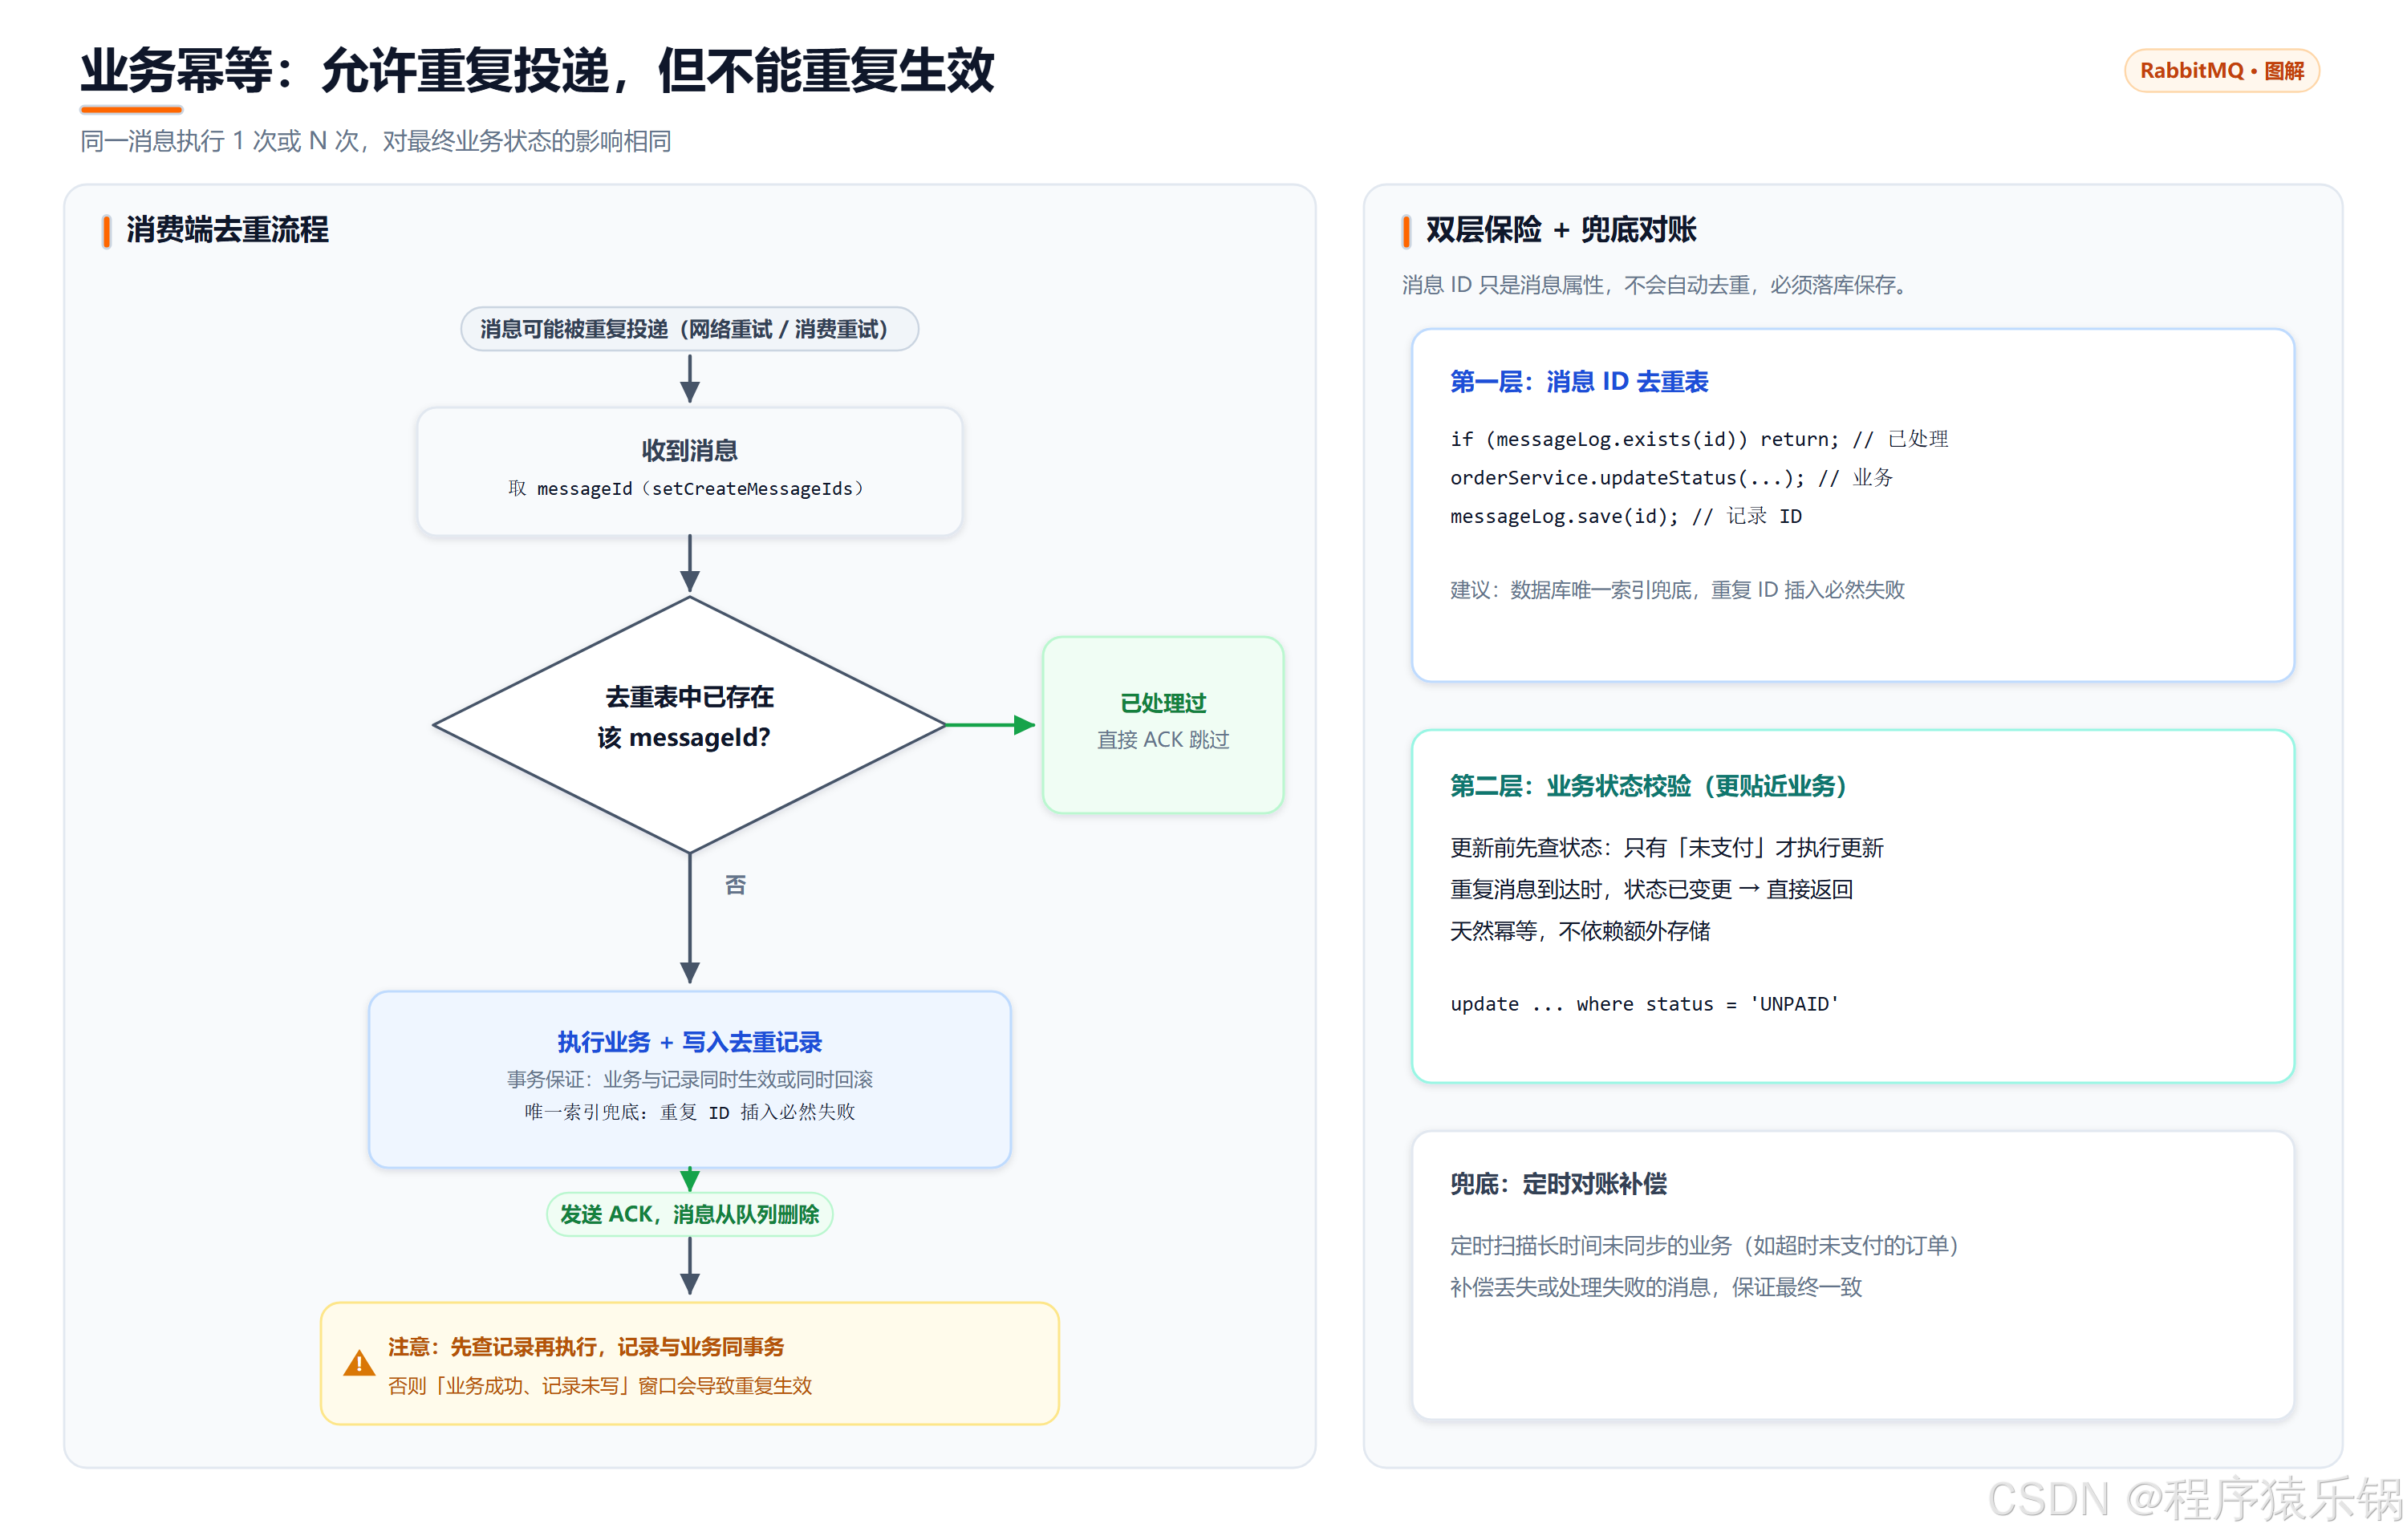
消息系统为了可靠性可能重复投递,消费者重试也可能让同一业务被再次执行。幂等的目标是:同一业务执行一次或多次,对最终业务状态的影响相同。
一种通用做法是为每条消息设置唯一 ID:
- 生产者生成业务唯一 ID,并和消息一起发送。
- 消费者处理业务成功后,把 ID 写入去重表或业务记录。
- 再次收到相同 ID 时,先查询处理记录,已处理则直接确认并跳过。
项目启用了 JSON 消息 ID:
java
converter.setCreateMessageIds(true);消息ID只是消息属性,不能自动完成去重。消费者仍需要把已经处理过的消息ID保存到数据库或其他可靠存储中:
java
@RabbitListener(queues = "order.queue")
public void listenOrder(OrderMessage message) {
    if (messageLogService.exists(message.getMessageId())) {
        return;
    }

    orderService.updateOrderStatus(message.getOrderId(), "PAID");
    messageLogService.save(message.getMessageId());
}
实际项目中,业务处理和去重记录最好放在同一个事务中,或者通过数据库唯一索引保证同一个消息ID只能成功写入一次。
更稳妥的做法是使用业务本身的唯一约束。例如支付成功后更新订单状态,更新前先查询订单当前状态,只有"未支付"状态才执行更新;已经支付的订单再次收到消息时直接返回。这样做比单纯依赖消息 ID 更贴近业务,也便于处理消息重发。
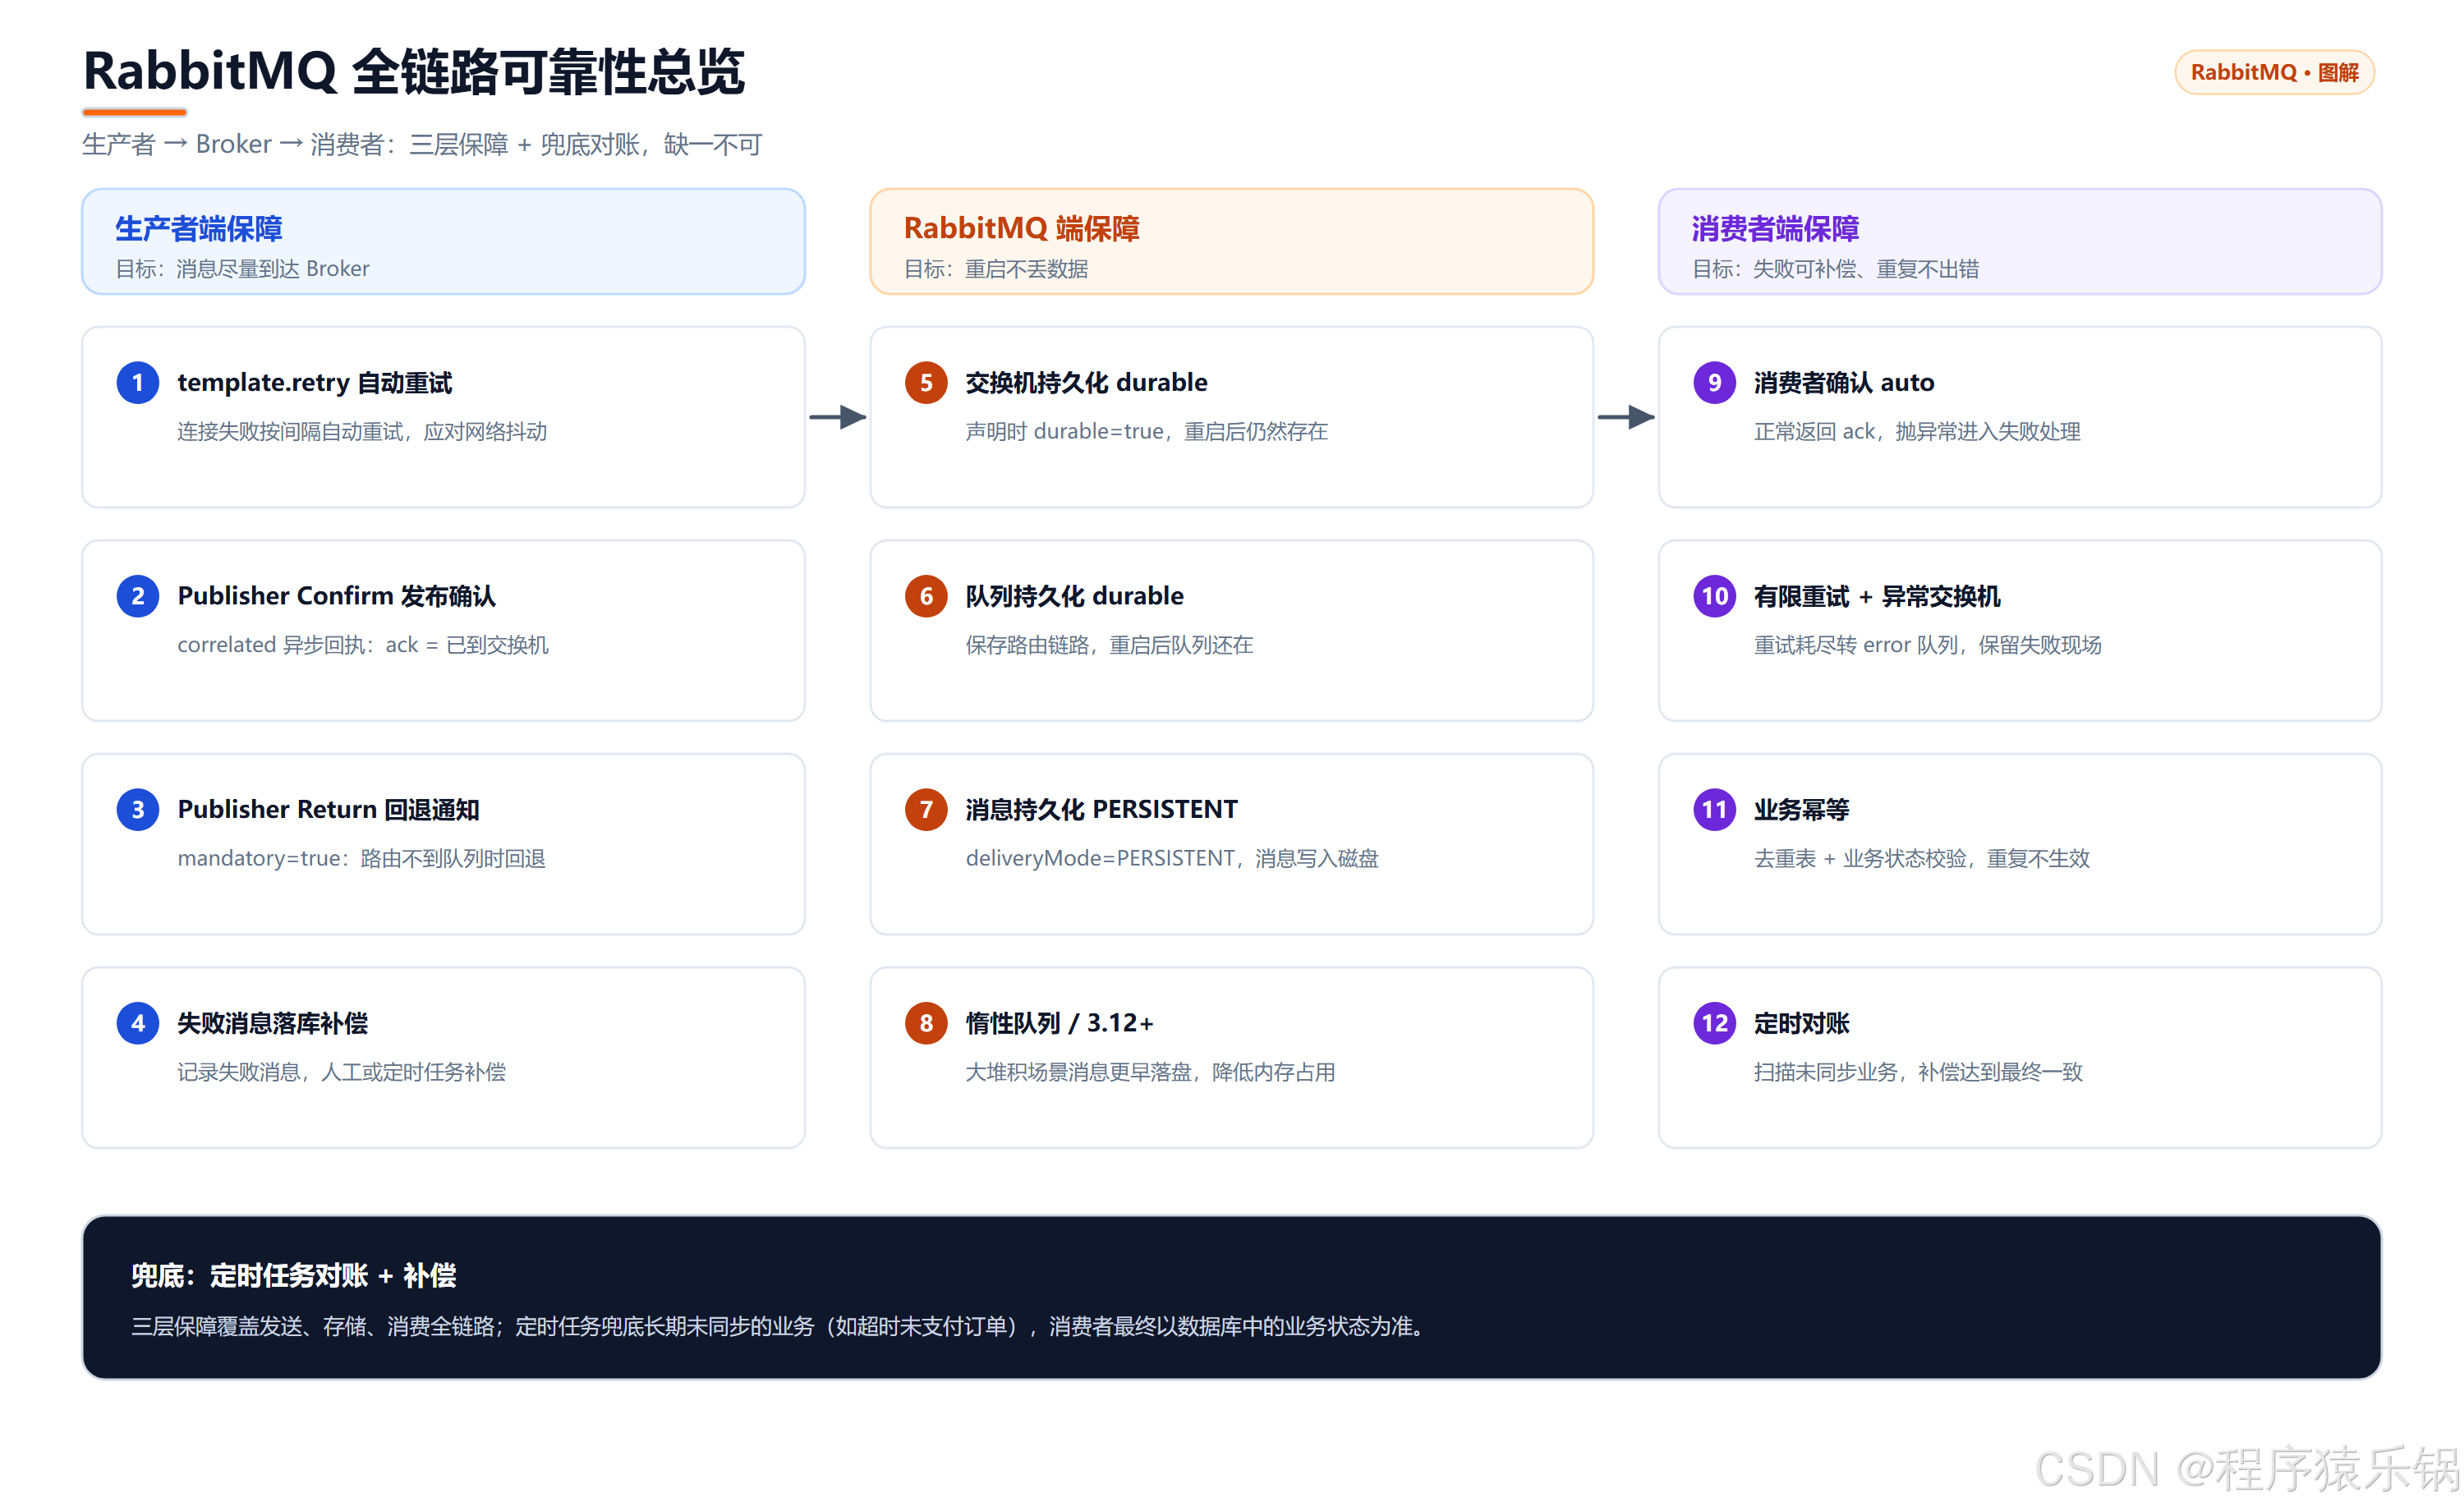
支付服务、交易服务之间的最终一致性可以按三层保障:生产者确认保证消息尽量到达,RabbitMQ持久化减少服务重启造成的丢失,消费者确认和幂等更新保证重复或失败处理不会破坏业务状态。必要时再使用定时任务定期对账,补偿长时间未同步的订单。
十、延迟消息与延迟消息插件
延迟消息在发送时指定等待时间,消费者在延迟时间到达后才收到消息。它适合订单超时关闭、定时检查支付状态、延时通知等场景。
1. 死信交换机
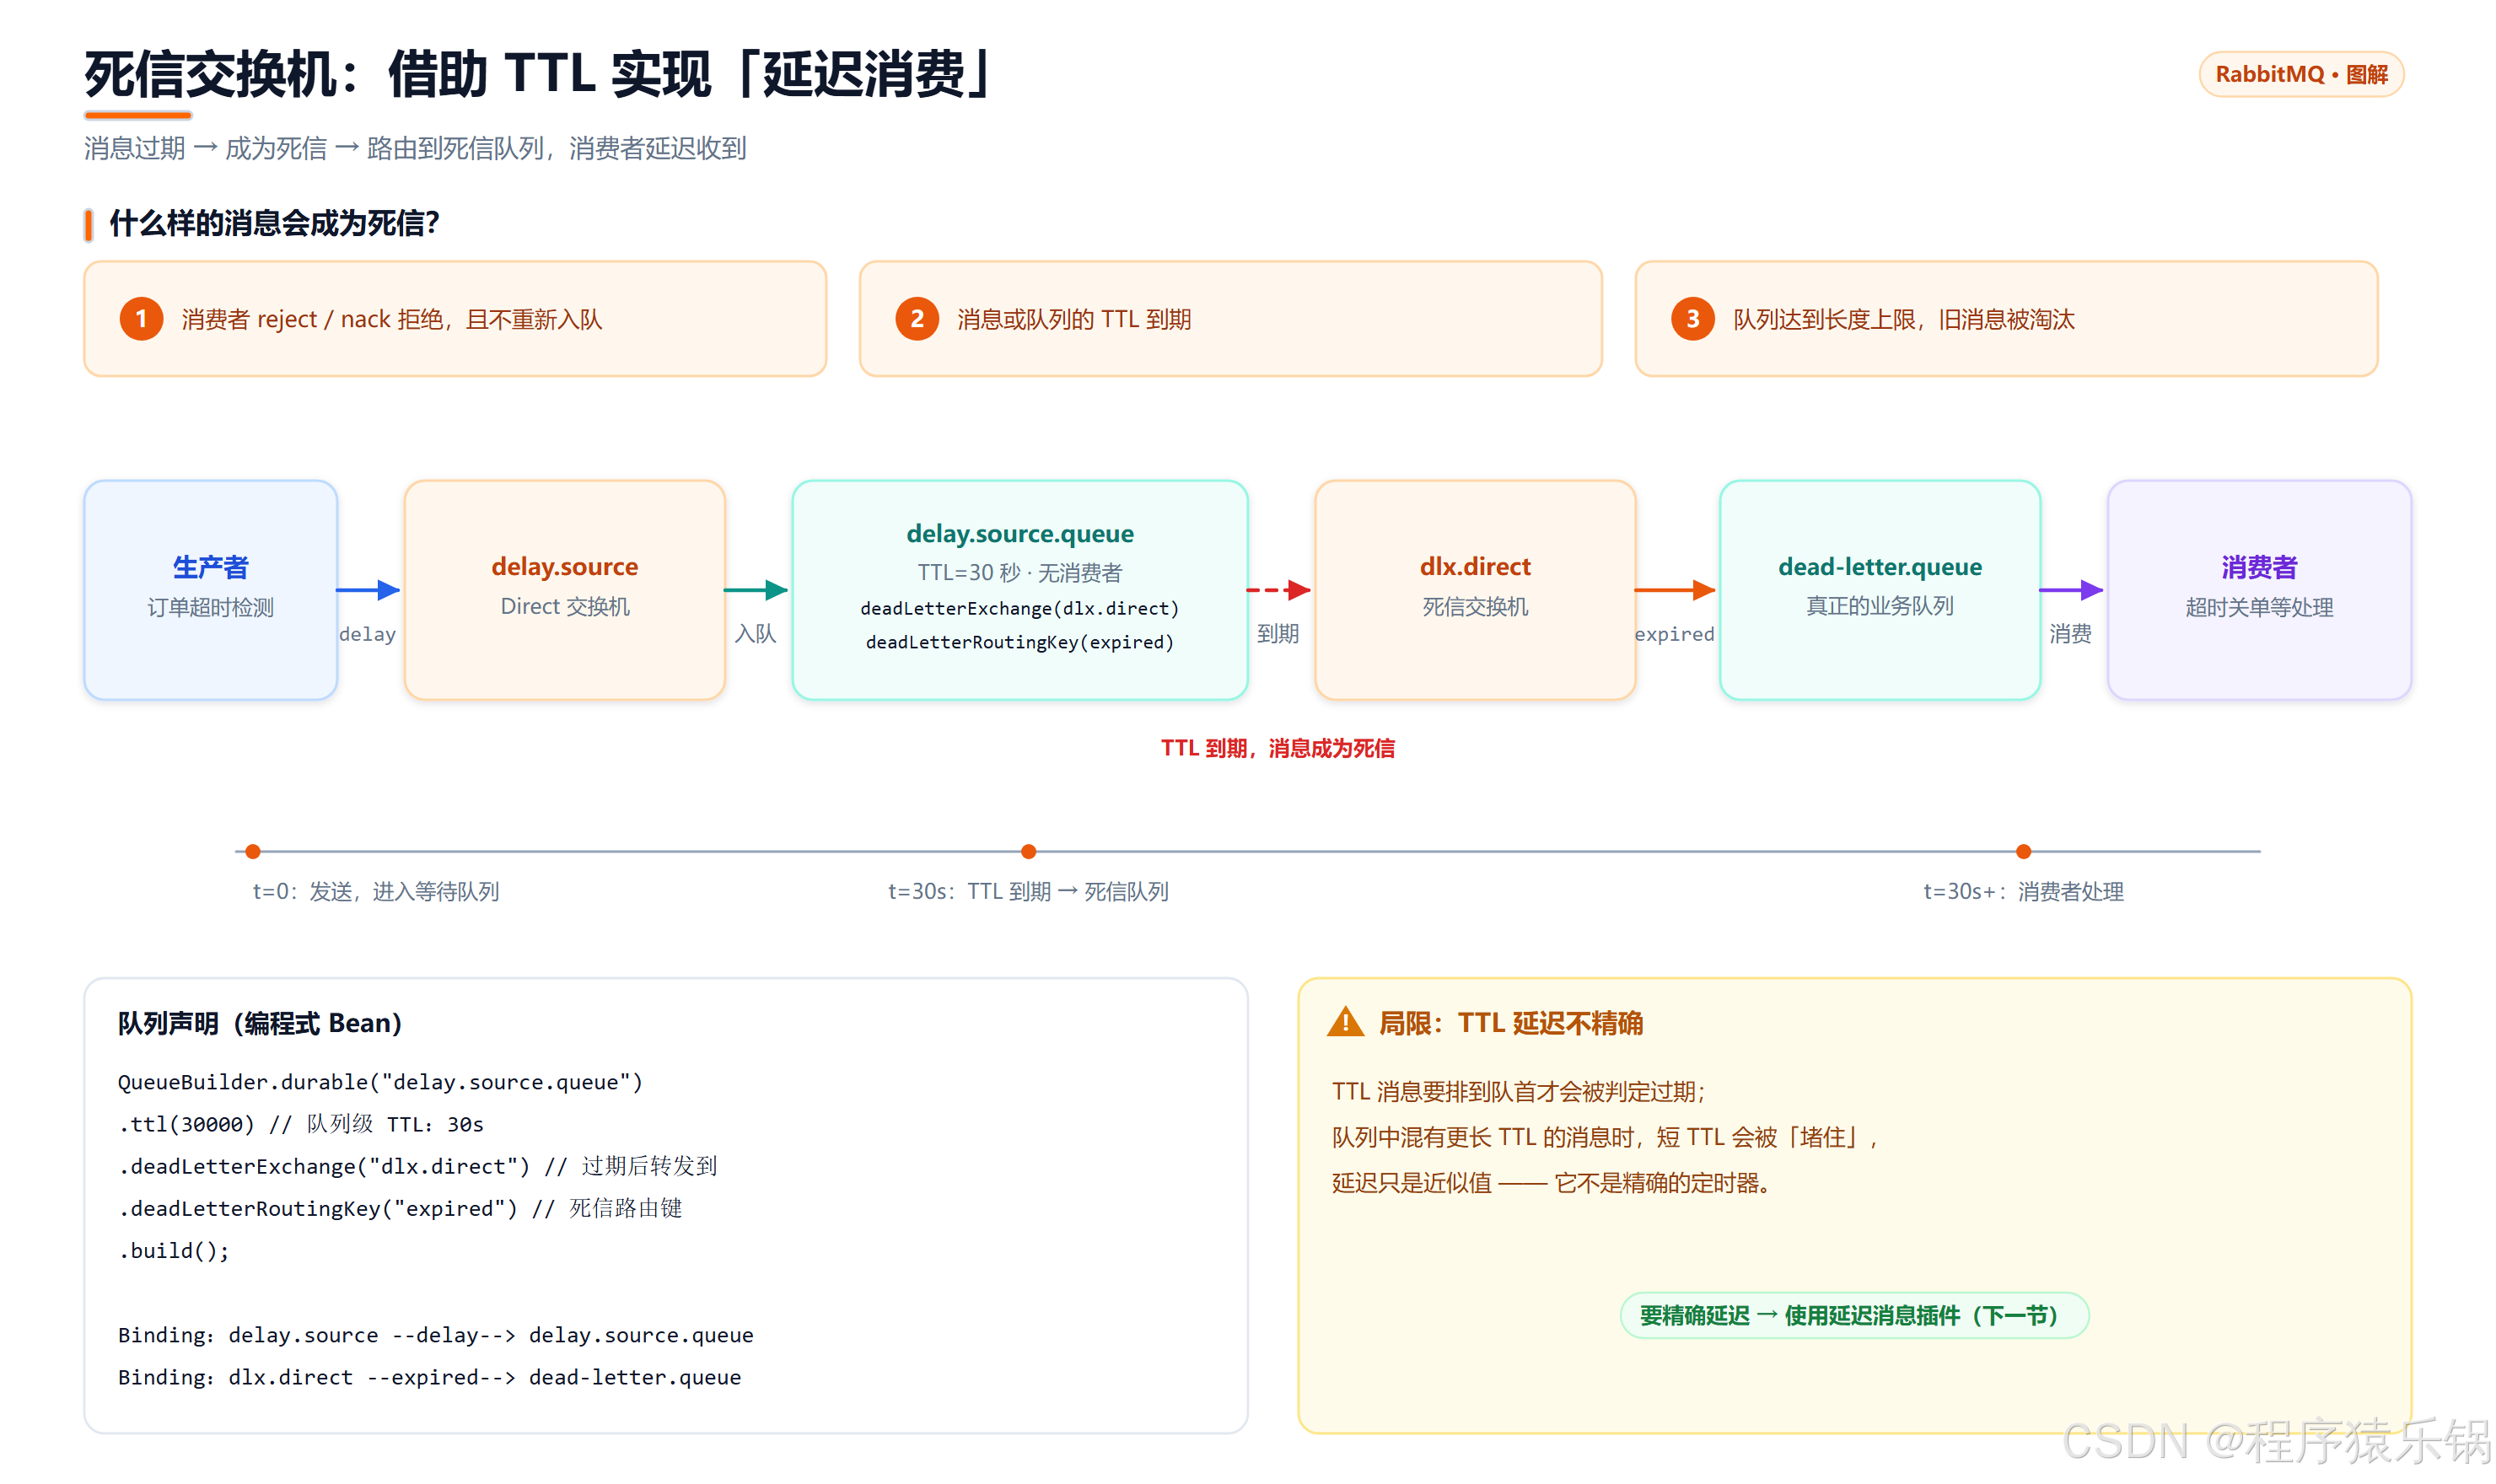
消息出现以下情况之一时,会成为死信:
- 消费者使用 reject 或 nack 拒绝消息,并且不重新入队。
- 消息达到队列或消息本身的过期时间。
- 队列达到长度上限,旧消息被淘汰。
队列通过 dead-letter-exchange 指定交换机后,死信会被重新投递到该交换机,再由交换机路由到死信队列。利用"过期后进入死信队列"的过程,可以间接实现延迟消费;不过 TTL 消息通常要等到期消息到达队首后才会被处理,因此它不是精确的定时器。
下面的配置让消息先进入等待队列,30秒后过期,再通过死信交换机进入真正的业务队列:
java
@Bean
public DirectExchange delaySourceExchange() {
    return new DirectExchange("delay.source", true, false);
}

@Bean
public DirectExchange deadLetterExchange() {
    return new DirectExchange("dlx.direct", true, false);
}

@Bean
public Queue delaySourceQueue() {
    return QueueBuilder.durable("delay.source.queue")
            .ttl(30000)
            .deadLetterExchange("dlx.direct")
            .deadLetterRoutingKey("expired")
            .build();
}

@Bean
public Queue deadLetterQueue() {
    return new Queue("dead-letter.queue", true);
}

@Bean
public Binding sourceBinding(Queue delaySourceQueue,
                             DirectExchange delaySourceExchange) {
    return BindingBuilder.bind(delaySourceQueue)
            .to(delaySourceExchange)
            .with("delay");
}

@Bean
public Binding deadLetterBinding(Queue deadLetterQueue,
                                 DirectExchange deadLetterExchange) {
    return BindingBuilder.bind(deadLetterQueue)
            .to(deadLetterExchange)
            .with("expired");
}
ttl(30000) 设置队列中消息的存活时间,deadLetterExchange 指定过期消息的目标交换机,deadLetterRoutingKey 指定死信路由键。生产者把消息发到 delay.source 后,消息会先进入等待队列,过期后再被转发到 dead-letter.queue。
2. 安装rabbitmq-delayed-message-exchange插件
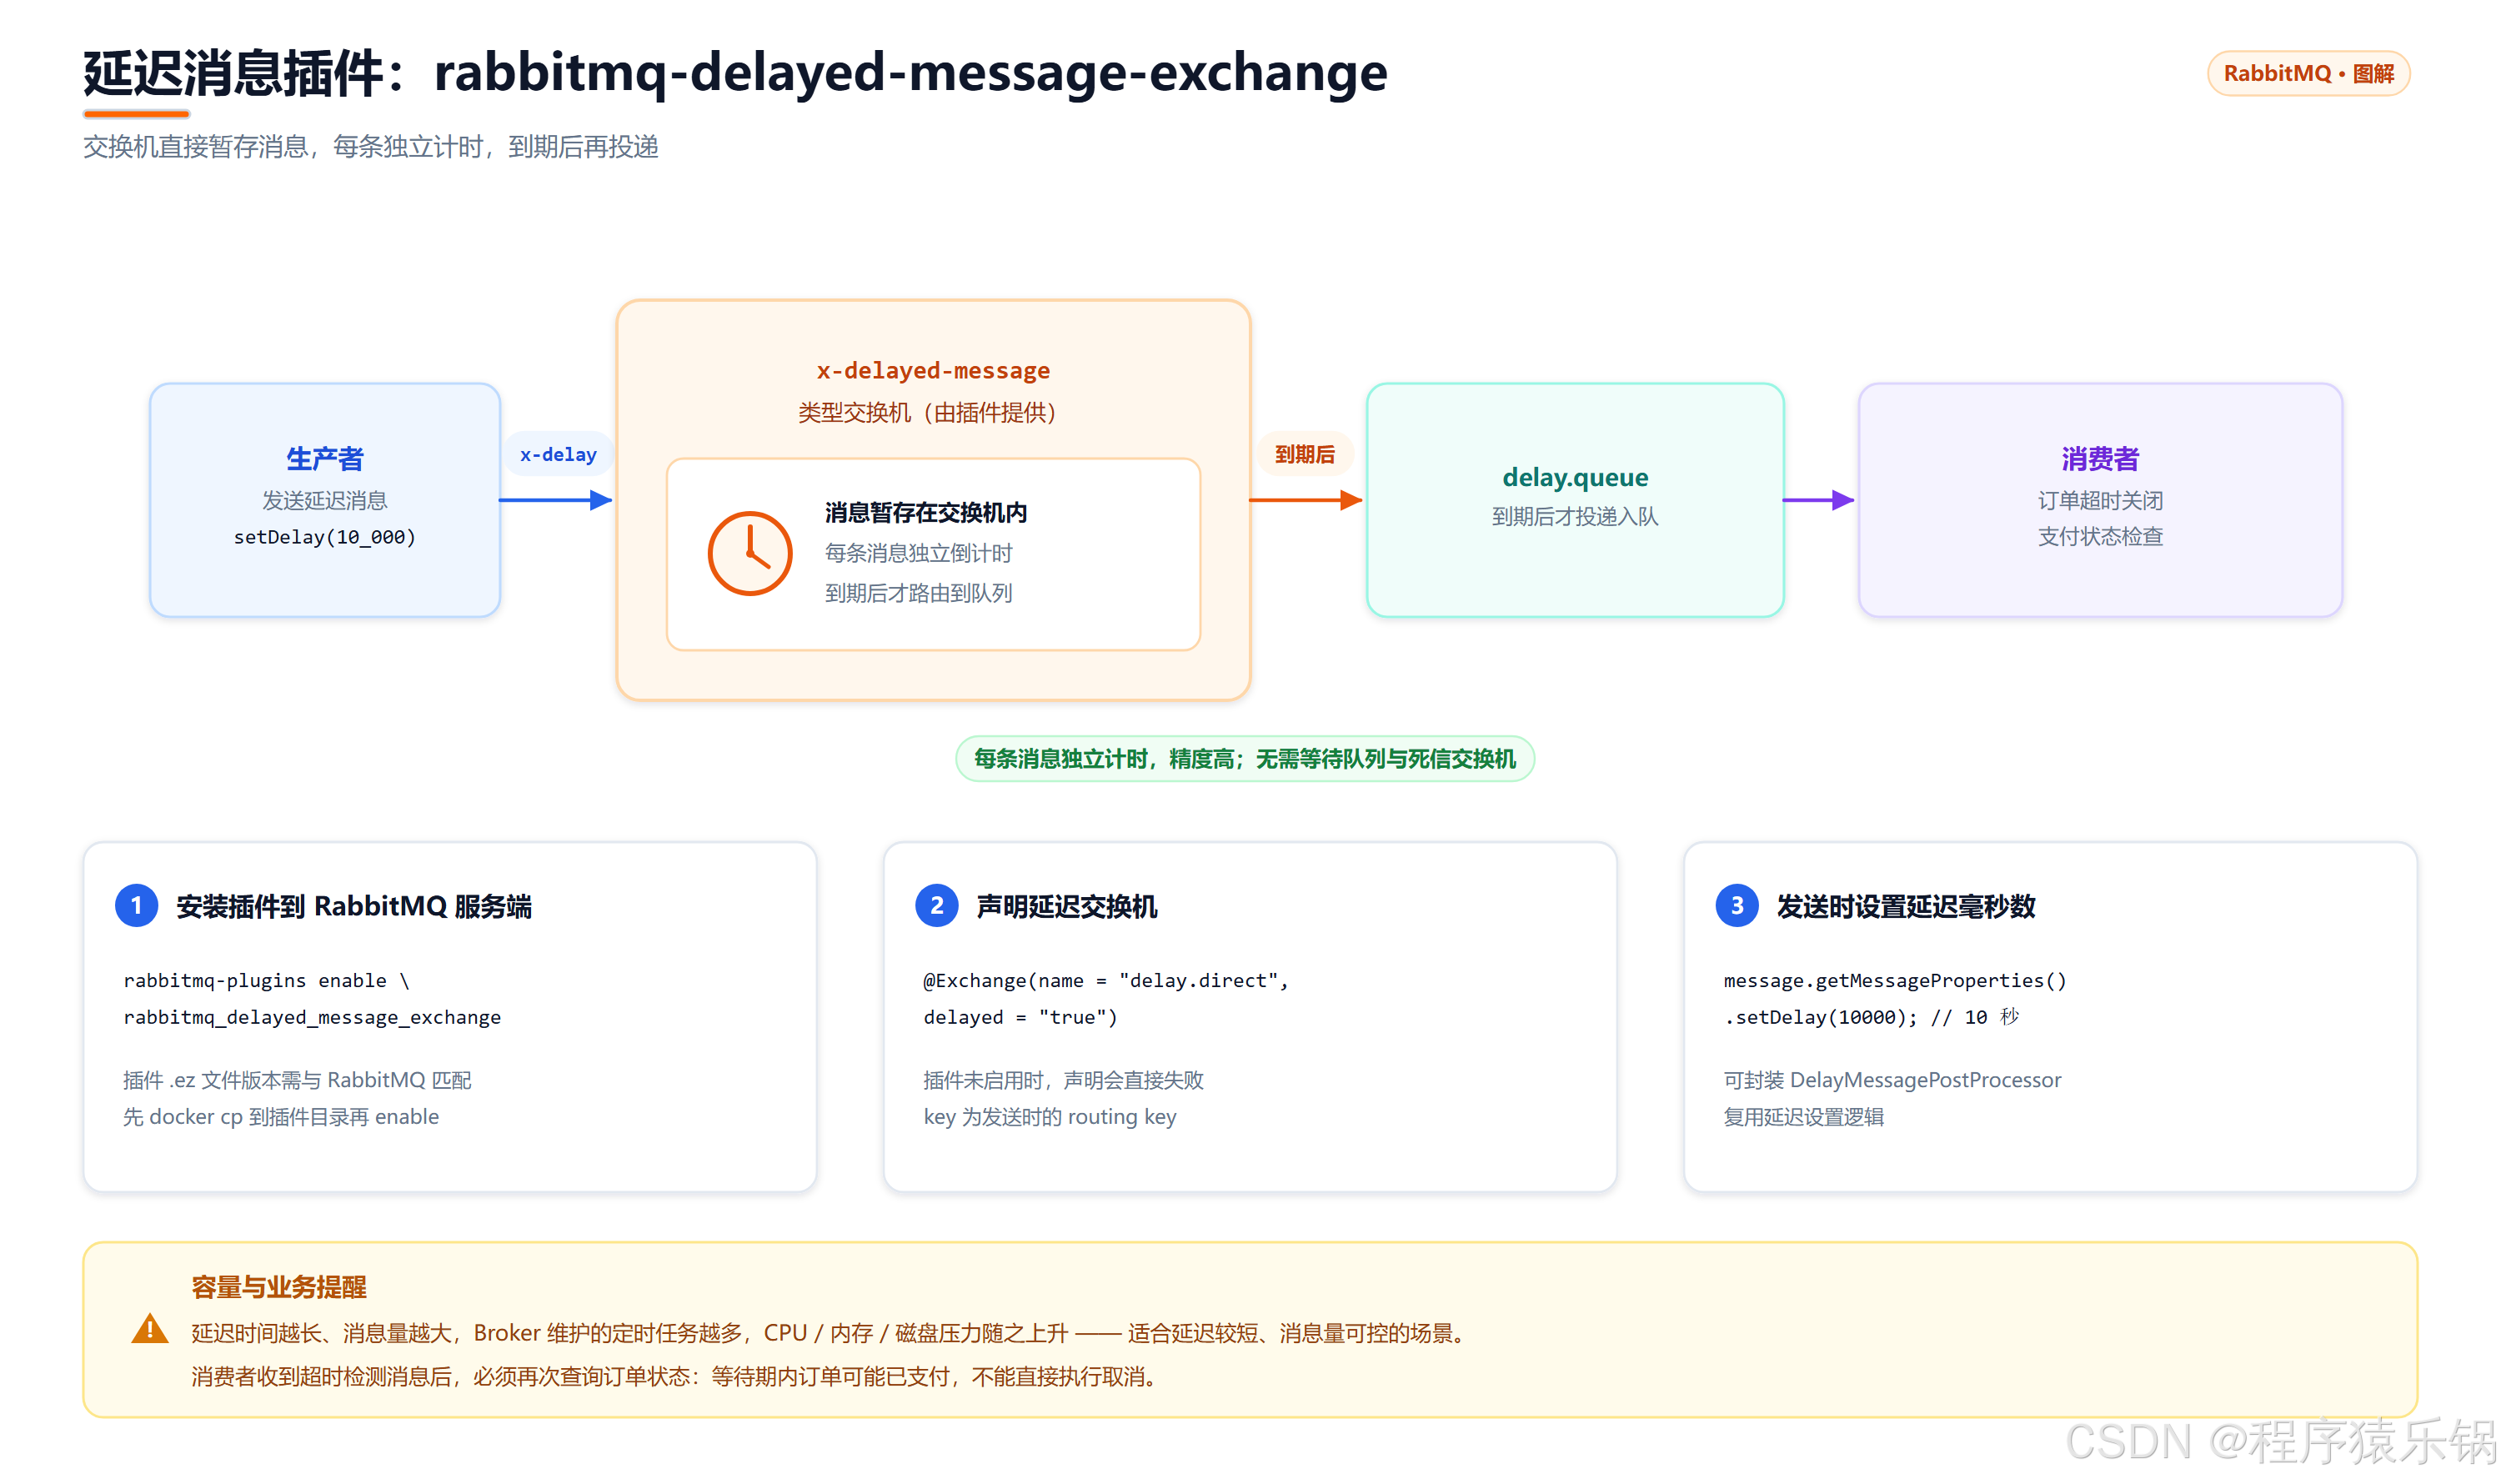
RabbitMQ提供了 rabbitmq-delayed-message-exchange 插件,可以让交换机本身暂存延迟消息。插件版本要尽量匹配当前 RabbitMQ 版本,插件文件不是 Maven 依赖,需要安装到 RabbitMQ 服务端。
bash
# 查看RabbitMQ容器的插件目录
docker exec rabbitmq rabbitmq-plugins directories -s

# 将下载的插件文件复制到插件目录,实际目录以命令输出为准
docker cp rabbitmq_delayed_message_exchange-<version>.ez \
  rabbitmq:/opt/rabbitmq/plugins/

# 启用延迟消息插件
docker exec rabbitmq \
  rabbitmq-plugins enable rabbitmq_delayed_message_exchange

# 重启RabbitMQ容器
docker restart rabbitmq
启用插件后,RabbitMQ才能识别 x-delayed-message 类型的交换机。插件缺失时,声明 delayed = "true" 的交换机会失败。
3. 声明延迟交换机和队列
Spring AMQP可以通过 @Exchange 声明延迟交换机:
java
@RabbitListener(bindings = @QueueBinding(
        value = @Queue(name = "delay.queue", durable = "true"),
        exchange = @Exchange(
                name = "delay.direct",
                delayed = "true",
                type = ExchangeTypes.DIRECT),
        key = "delay"
))
public void listenDelayQueue(String message) {
    System.out.println("消费者收到了delay.queue消息:" + message);
}
delayed = "true" 表示这个交换机依赖延迟消息插件,key 是消息发送时使用的 routing key。声明队列和交换机后,生产者还必须在消息属性中设置延迟时间。
4. 发送延迟消息
发送时通过 MessagePostProcessor 设置延迟毫秒数:
java
rabbitTemplate.convertAndSend(
        "delay.direct",
        "delay",
        "Hello, DelayQueue!",
        message -> {
            message.getMessageProperties().setDelay(10000);
            return message;
        });
setDelay(10000) 表示延迟10秒。延迟时间越长、消息量越大,代理需要维护的延迟消息越多,CPU 和存储压力也会增加。订单超时场景还要考虑消息堆积:很多订单可能在等待期内已经完成支付,消费者收到检测消息后仍需再次查询订单状态,而不能直接执行取消操作。
如果多个业务都需要发送延迟消息,可以把设置延迟时间的逻辑封装成可复用的消息处理器:
java
public class DelayMessagePostProcessor
        implements MessagePostProcessor {

    private final int delay;

    public DelayMessagePostProcessor(int delay) {
        this.delay = delay;
    }

    @Override
    public Message postProcessMessage(Message message) {
        message.getMessageProperties().setDelay(delay);
        return message;
    }
}
调用时只需要传入延迟时间:
java
rabbitTemplate.convertAndSend(
        "delay.direct",
        "delay",
        "订单超时检测",
        new DelayMessagePostProcessor(30 * 60 * 1000));
延迟插件适合延迟时间较短、消息量可控的场景。延迟消息过多时,RabbitMQ需要维护更多定时任务,会增加 CPU、内存和磁盘压力。消费者收到订单检测消息后,仍然要查询订单当前状态,只有订单确实未支付时才能执行取消操作。
总结
RabbitMQ的基础使用可以归纳为一条链路:生产者通过 RabbitTemplate 发送消息,交换机按类型和 routing key 路由到队列,消费者通过 @RabbitListener 接收并处理。Work Queue解决消费能力不足,Fanout、Direct、Topic解决不同的分发需求。
可靠性要同时覆盖生产者、RabbitMQ和消费者:发布确认与返回处理发送结果,持久化减少服务重启丢失,消费者确认和有限重试处理异常,异常交换机保留失败消息,幂等设计避免重复消费造成业务错误。延迟消息适合订单超时和定时检查,但消费者最终仍应以数据库中的业务状态为准。