⭐️在这个怀疑的年代,我们依然需要信仰。
个人主页 :YYYing.
⭐️设计模式系列专栏:Python系列
系列下期内容:暂无
前言
python系列前几篇的基础疑难杂症主要是解决在学python时,个人觉得多少需要记忆或注意的点,也就是第一人称纯粹的笔记和学习视角来写的博客(个人向博客),基础好点的不用太仔细看,查缺补漏即可。
1. 函数
1.1 函数定义
想用到某个.py文件的函数可以用from 文件名(不包含.py) import 函数名
如果想用文件中所有的接口
from 文件名(不包含.py) import *
当然函数可以返回许多值,这些值其实是通过tuple返回的。
python
def getposition(x,y):
    return x, y
python
from func import *
num1 = 0; num2 = 0
num1, num2 = getposition(1,3)
print('num1 is %d, num2 is %d' %(num1,num2))
print('result is: ', getposition(1,3) )
1.2 参数
1.可变参数与关键字参数
可变参数使用和定义都非常方便
定义:
python
def calsum(*nums):
    sum = 0
    for i in nums:
        sum = sum+ i
    return sum
使用:
python
#-*-coding:utf-8-*-
from func import *
L=[1,3,5,7,9]
print(calsum(*L))
print(calsum(*range(0,101)))
定义可变参数前边加*,使用时可以传入list,tuple等,实参前也加*即可。
关键字参数其实和可变参数类似,关键字参数可以直接传入字典
定义:
python
def getinfo2(name, age, **info):
    print("姓名:", name, "年龄:", age, "其他信息:", info)

def getinfo3(name,age,**info):
    if 'city' in info:
        print("有城市信息")
    if 'job' in info:
        print("有工作记录")
    print("姓名:", name, "年龄:", age, "其他信息:", info)
定义关键字参数在形参前边加**
使用:在实参前加**表示取出字典中所有内容依次传递给函数
python
from func import *
info ={'性别':'女','job':'学生','city':'上海'}
info2 ={'性别':'男','job':'工人','city':'北京'}
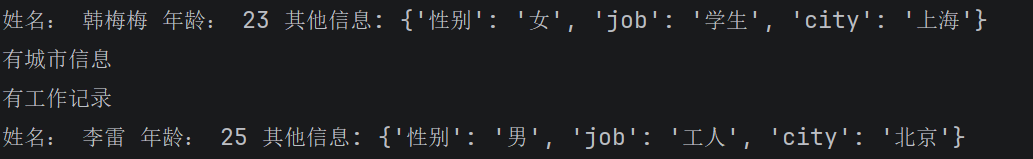
getinfo2('韩梅梅', 23, **info)
getinfo3('李雷',25,**info2)
结果
2.命名关键字参数
命名关键字参数就是传入命名的关键字,如指定传入的关键字参数的key为'city','type'等等。
python
def getinfo8(name, age, *,city, job):
    print("姓名:", name, "年龄:", age, "城市:", city, "工作:", job)
def getinfo7(name, age, *infolist, city, job):
    print("姓名:", name, "年龄:", age, "城市:", city, "工作:", job, "其他信息:", infolist)
可以看出命名关键字参数格式为(*,指定名称1,指定名称2...)的格式
当命名关键字参数之前的参数为可变参数时,那么不需要*,只需指明指定的几个名成即可
格式为:(*可变参数,指定名称1,指定名称2...)
python
from func import *
info ={'性别':'女','job':'学生','city':'上海'}
info2 ={'性别':'男','job':'工人','city':'北京'}
getinfo2('韩梅梅', 23, **info)
getinfo3('李雷',25,**info2)
getinfo8('王麻子',70, city ='南京', job = '裁缝')
infolist = ['有犯罪记录','酗酒']
getinfo7('张三',50,*infolist,city ='翰林',job ='无业游民')
结果:

3.参数混合使用
当参数列表包含位置参数,默认参数,可变参数,关键字参数和命名关键字参数时,
从左到右的顺序为
位置参数,默认参数,可变参数,命名关键字参数,关键字参数
读者可以自己考虑下为什么这么规定
对应关系:
| 顺序 | 参数类型 | 传递方式 | 作用 |
|---|---|---|---|
| 1 | 普通位置参数 a, b |
位置或关键字 | 最具体、最先匹配 |
| 2 | 默认参数 b=1 |
位置或关键字 | 可省略,但必须跟在无默认参数后 |
| 3 | 可变位置参数 *args |
只收位置 | 兜底多余位置参数 |
| 4 | 命名关键字参数 c, d=2 |
只能关键字 | 强制用名字传,避免误传 |
| 5 | 可变关键字参数 **kwargs |
只收关键字 | 兜底多余关键字参数 |
核心原因可以概括为:从确定到灵活,从位置到关键字,从具体到兜底。
例子我举一个,剩下感兴趣的可以下去再搜
调用时,Python 先按位置从左到右匹配参数。如果默认参数放在非默认参数前面:
pythondef f(a=1, b): # SyntaxError ...调用
f(2)时,2到底给a还是b?无法确定。所以语法强制:非默认参数必须在默认参数之前。
下面定义两个函数:
python
def getinfo5(name,age,city='沈阳',**info):
    print("姓名:", name, "年龄:", age, "城市:", city, "其他信息:", info)
def getinfo6(name,age,city='沈阳',*infolist ,health = '良好', job,**otherinfo):
    print("姓名:", name, "年龄:", age, "城市:", city, '工作信息:',job,'\n',
        "身体状况", health, "个人备注",infolist,'\n',
        "其他信息:", otherinfo)
使用这一系列定义的函数
python
info5 ={'性别':'男','job':'工人','兴趣':'修自行车'}
baselist=('Linkn',28,'上海','喜欢喝冰啤酒','爱打麻将')

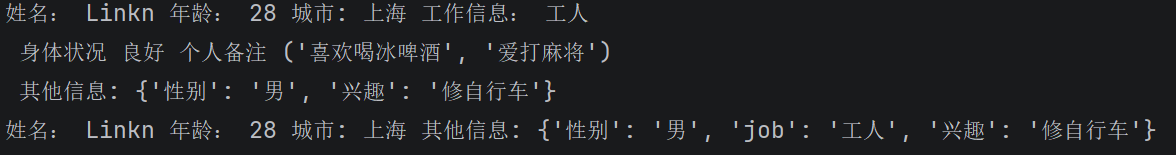
getinfo6(*baselist,**info5)
getinfo5('Linkn',28,'上海',**info5);
结果:
2. 生成器和迭代器
2.1 切片
list、tuple常常截取某一段元素,截取某一段元素的操作很常用 ,所以python提供了切片功能。
python
L=['a','b','c','d','e','f']
#取索引0,到索引3的元素,不包括索引3
print(L[0:3])
#开始索引为0可以省略
print(L[:3])
#下标1到3
print(L[1:3])
#取最后一个元素
print(L[-1])
#取倒数后两个元素
print(L[-2:])
#取前四个数,每两个取一个
print(L[:4:2])
#所有数,每两个取一个
print(L[::2])
2.2 迭代
除了list、tuple可以迭代外,python中的dict类型变量也可以迭代。
python
dictor = {'name':'Jul','age':17,'femail':1}
#迭代key
for key in dictor:
    print(key)
#迭代value
for value in dictor.values():
    print(value)
#迭代key,value
for k,v in dictor.items():
    print(k,v)
可以将list变为索引元素对的形式
python
for x,y in [(1,2),(3,4),(5,6)]:
    print(x,y)
#变为索引元素对
for i,value in enumerate(['A','B','C']):
    print(i,value)


#同时可以判断一个对象是否可以迭代

for x,y in [(1,2),(3,4),(5,6)]:
    print(x,y)
#变为索引元素对
for i,value in enumerate(['A','B','C']):
    print(i,value)
2.3 列表生成式
list函数可以将一组对象组合为列表,\[\]操作也可以。\[\]操作的方式称作列表生成式
print(x for x in range(1,11)) print(list(range(1,11))) 在列表生成式中可以加入一些运算规则,使生成的列表具备运算规则。
python
#变为索引元素对
for i,value in enumerate(['A','B','C']):
    print(i,value)
#平方
print([x*x for x in range(1,11)])
#偶数平方
print([x*x for x in range(1,11) if x%2 ])
#k:v形式的列表
strdic={'a':'a1','b':'b1','c':'c1'}
print([k+':'+v for k,v in strdic.items()])
#将列表中字符串换为小写
L = ['Hello', 'World', 18, 'Apple', None]
print([s.lower() for s in L if(isinstance(s,str)) ])
2.4 生成器
python提供生成器的功能,生成器根据函数或运算规则产生一系列数据,
通过对返回值g调用next(g)可以依次取出生成的数据。
python
g = (x*2 for x in range(1,11))
print(g)
print(next(g))
可以一直调用next(g),直到产生StopIteration异常。
当然也可以通过函数构造生成器,将函数return的关键字换为yield即可。
python
#斐波那契数列
def fib(max):
    a,b,n = 0,1,0
    while n < max:
        yield b
        a,b=b,a+b
        n = n+ 1
    return "exit"
通过下面方式next取出数列中的元素,第三次调用会抛出StopIteration异常。
python
g=fib(2)
print(g)
print(next(g))
print(next(g))
#print(next(g))
上面代码中g为迭代器,通过对g不断调用next取出数列中元素。
可以通过检测异常的方式完成遍历,避免程序崩溃。
python
g2 = fib(6)

while True:
    try:
        value = next(g2)
        print("value: ", value)
    except StopIteration as e:
        print("Generator return value is: ", e)
        break
可以用生成器实现杨辉三角,生成器函数为triangles()。
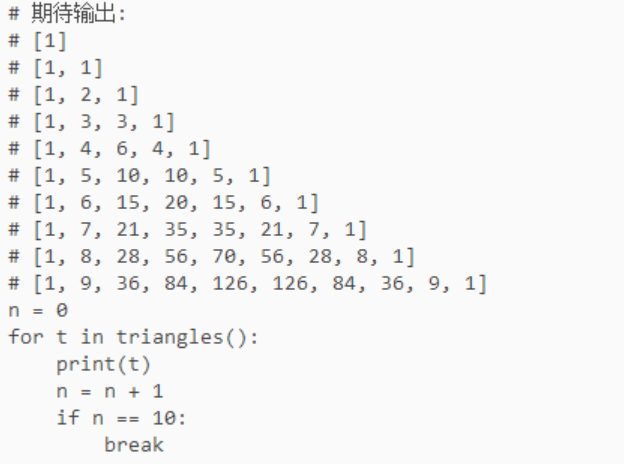
生成器函数triangles()实现如下:
python
def triangles():
    yield [1]
    yield [1,1]
    lists = [1,1]
    while True:
        i = 1
        n = len(lists)
        newlists = [1]
        while i < n:
            newlists.append(lists[i-1] + lists[i])
            i = i+1
        newlists.append(1)
        lists = newlists
        yield newlists
2.5 迭代器
python提供生成器的功能,生成器根据函数或运算规则产生一系列数据,
通过对返回值g调用next(g)可以依次取出生成的数据。g就是迭代器。
有的对象可以迭代但是不是迭代器,只有可以被next调用的对象才是迭代器。
同样可以通过isinstance函数判断迭代器。
python
from collections.abc import Iterable
from collections.abc import Iterator

b1 = isinstance([], Iterable)
b2 = isinstance([], Iterator)
print('[] is Iteralbe', b1)
print('[] is Iterator', b2)

b1 = isinstance({},Iterable)
b2 = isinstance({},Iterator)

print('[] is Iteralbe', b1)
print('[] is Iterator', b2)

b1 = isinstance((x*x for x in range(10)), Iterable)
b2 = isinstance((x*x for x in range(10)), Iterator)
print('x*x for x in range(10) isIterable', b1)
print('x*x for x in range(10) isIterator', b2)

#可以被next()函数调用并不断返回下一个值的对象称为迭代器:Iterator

b1 = isinstance(triangles(),Iterable)
b2 = isinstance(triangles(),Iterator)
print('triangles()', b1)
print('triangles()', b2)
3. 函数式编程
3.1 函数对象
函数同样可以作为对象复制给一个变量,如下:
python
f = abs;
print(f(-10))
f = 'abs';
print(f)

def add(a,b,f):
    return f(a) + f(b)

print(add(-1,2,f))
map 函数,map函数接受一个函数变量,第二个参数为一个可迭代对象,最后返回一个迭代器,由于迭代器的惰性,需要用list()函数返回所有元素。
python
def squart(n):
    return n* n;

print(map(squart,range(1,11) ) )
print(list(map(squart,range(1,11) ) ))reduce函数, reduce函数接受两个参数,第一个参数同样是函数对象f,f必须接受两个参数,并且返回和参数同类型的数据。第二个参数为一个可迭代序列。
python
def func(a, b):
    return a + b

print(reduce(func, range(1,11)))

#reduce和map函数不一样,reduce返回的是一个最终值

reduce(f,[x1, x2, x3, x4]) = f(f(f(x1,x2),x3),x4)
可以通过reduce和map函数搭配,将一个字符串转化为整数
python
def str2int(str):
    def char2int(c):
        return {'0':0,'1':1,'2':2,'3':3,'4':4,'5':5,'6':6,'7':7,'8':8,'9':9}
    def convertnum(a,b):
        return a*10 + b
    return reduce(convertnum, map(char2int, str))

print(str2int("123456789"))
filter 函数,filter函数同样有两个参数,第一个参数为函数对象,返回值为bool类型,第二个参数为可迭代序列,返回值为迭代器,
同样需要list()转化为序列。下面用filter和生成器实现一个素数生成器函数
python
# 构造奇数序列的生成器
def odd_generater():
    n = 1
    while True:
        n = n+2
        yield n

def primer_generater():
    yield 2
    #返回生成器地址
    it = odd_generater()
    print("it is ", it)
    while(True):
        #依次取出生成器的元素
        n = next(it)
        print("it2 is ", it)
        yield n
        #去掉可以被自己整除的元素返回新的生成器
        it = filter(lambda x:x%n > 0, it)
打印测试:
python
for i in primer_generater():
    if(i < 100):
        print (i)
    else:
        break
sorted 函数,第一个接受一个list,第二个为比较的规则,可以不写
python
print(sorted(["Abert","cn","broom","Dog"]) )

print(sorted(["Abert","cn","broom","Dog"], key = str.lower))

print(sorted(["Abert","cn","broom","Dog"], key = str.lower, reverse = True))
3.2 函数封装和返回
python
def lazy_sum(*arg):
    def sum():
        x = 0
        for i in arg:
            x = x +i
        return x
    return sum

f = lazy_sum(2,3,1,6,8)
print(f())
定义了一个lazy_sum函数,函数返回内部定义的sum函数。可以在函数A内部定义函数B,调用A返回函数B,从而达到函数B延时调用。
闭包:
在函数A内部定义函数B,函数B内使用了函数A定义的局部变量或参数,这种情况就是闭包。
使用闭包需要注意,在函数B中修改了函数A 定义的局部变量,那么需要使用nonlocal关键字。如果在函数B中修改了全局变量,那么需要使用global关键字。
python
def lazy_sum(*arg):
    sums = 0
    def sum():
        for i in arg:
            nonlocal sums
            sums = sums + i
        return sums
    return sum

f1 = lazy_sum(1,3,5,7,9)
f2 = lazy_sum(1,3,5,7,9)
print(f1 == f2)
print(f1() )
print(f2() )匿名函数:lambda, lambda后面跟函数的参数,然后用:隔开,写运算规则作为返回值
python
it = map(lambda x:x*x, (1,3,5,7,9))
print(list(it))

def lazy_squart():
    return lambda x:x*x
f = lazy_squart()
print(f(3) )装饰器: 装饰器实际就是函数A中定义了函数B,并且返回函数B,为了实现特殊功能,如写日志,计算时间等等。
先看个返回函数,并且调用的例子
python
def decoratorfunc(func):
    def wrapperfunc():
        print('func name is: %s'%(func.__name__))
        func()
    return wrapperfunc


def helloworld():
    print('Helloworld !!!')

helloworld = decoratorfunc(helloworld)
helloworld()
以后每次调用helloword,不仅会打印Helloworld,还会打印函数名字。
python提供装饰器的功能,可以简化上面代码,并且实现每次调用helloworld函数都会打印函数名字。
python
def decoratorfunc(func):
    def wrapperfunc(*args, **kw):
        time1 = time.time()
        func(*args, **kw)
        time2 = time.time()
        print('cost %d secondes'%(time2-time1))
    return wrapperfunc

@decoratorfunc
def output(str):
    print(str)
    time.sleep(2)

output('hello world!!!')
如果函数带参数,实现装饰器可以内部定义万能参数的函数
装饰器执行@decoratorfunc相当于
output = decoratorfunc(output) output('hello world!!!')
如果装饰器需要传入参数,那么可以增加多一层的函数定义,完成装饰器参数传入和调用。
python
def decoratorfunc(param):
    def decoratorfunc(func):
        def wrapperfunc(*arg, **kw):
            print('%s %s' %(param, func.__name__))
            func(*arg, **kw)
        return wrapperfunc
    return decoratorfunc

@decoratorfunc('execute')
def output(str):
    print(str)

output('nice to meet u')
print(output.__name__)
实际执行过程
python
decorator = decoratorfunc('execute')
output = decorator(now)

output('nice to meet u')执行print(output.name)发现打印出的函数名字不是output而是wrapperfunc,这对以后的代码会有影响。
可以通过python提供的装饰器@functools.wraps(func) 完成函数名称的绑定
python
def decoratorfunc(param):
    def decoratorfunc(func):
        @functools.wraps(func)
        def wrapperfunc(*arg, **kw):
            print('%s %s' %(param, func.__name__))
            func(*arg, **kw)
        return wrapperfunc
    return decoratorfunc

@decoratorfunc('execute')
def output(str):
    print(str)

print(output.__name__)print(output.name)显示为output,这符合我们需要的逻辑。
3.3 偏函数
如函数 int(a, base = 2) 可以实现一个字符串根据base提供的进制,转化成对应进制的数字。
可以通过偏函数,实现指定参数的固定,并且生成新的函数
python
intnew = functools.partial(int, base = 2)
print(intnew('100'))
也可以自己定义函数:
python
def add(a,b):
    return a+b
print(add(3,7))

addnew = functools.partial(add, 3)
print(addnew(7))

addnew2 = functools.partial(add, b = 7)
print(addnew2(3))
4. zip库的使用
4.1 zip的坑
zip()函数接收多个可迭代数列,将数列中的元素重新组合,在3.0中返回迭代器指向
数列首地址,在3.0以下版本返回List类型的列表数列。我用的是3.14版本python,
所以zip返回的是指向地址。
先看几个例子
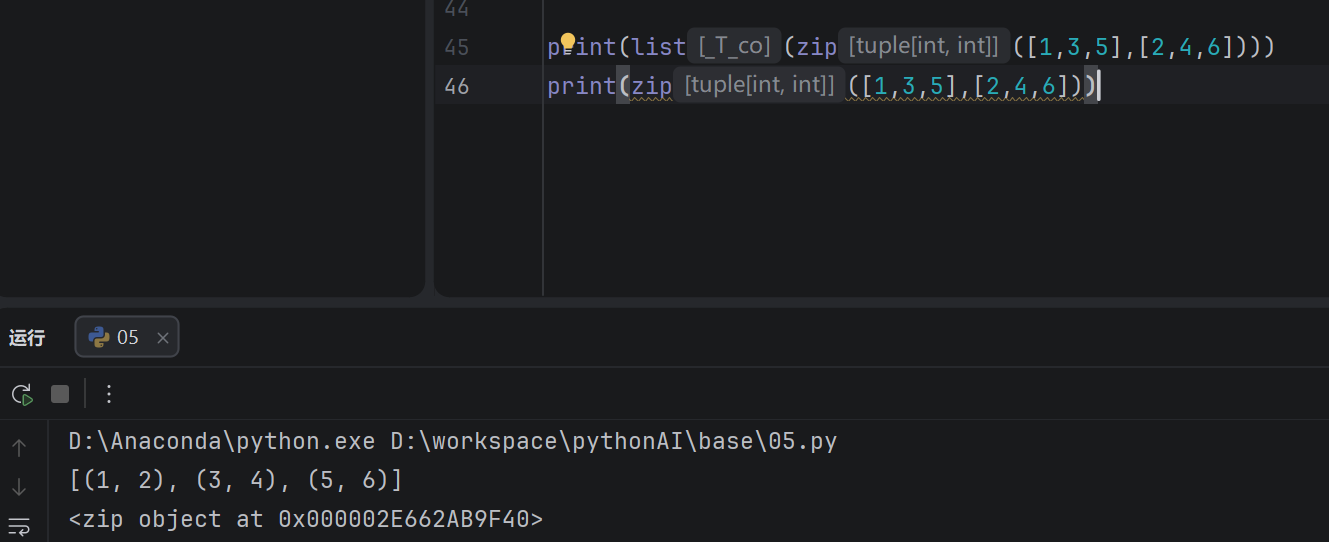
可见,在3.0以上版本,对zip函数返回的结果采用list函数可以转化为列表。
通过列表生成式同样可以将zip结果化为列表。
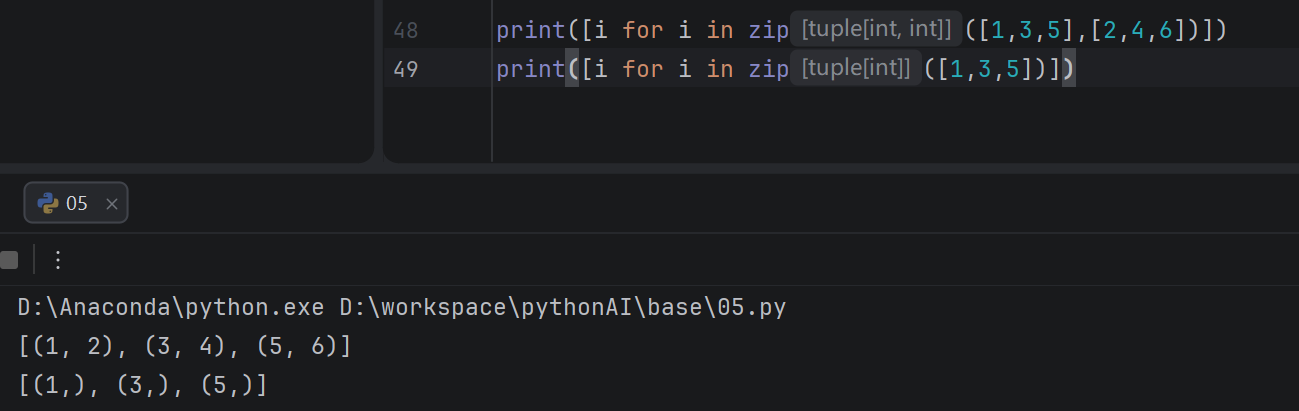
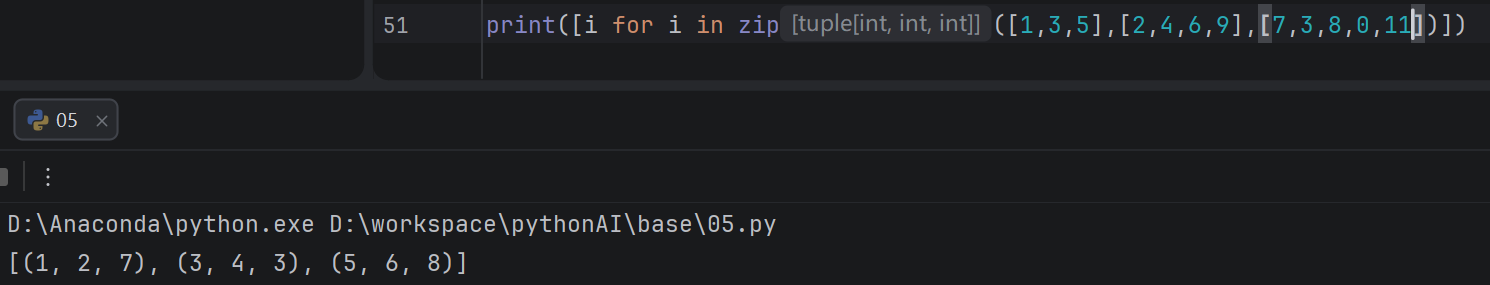
当zip操作的对象为一个列表,那么生成的列表中每个元素(元祖)中为(n,)形式。当zip操作的多个列表长度不一样,那么zip返回生成的列表中元素个数为最短列表长度。
list函数可以将一个元祖转化为列表。下面可以将zip返回的数据转化为我们方便操作的列表元素.
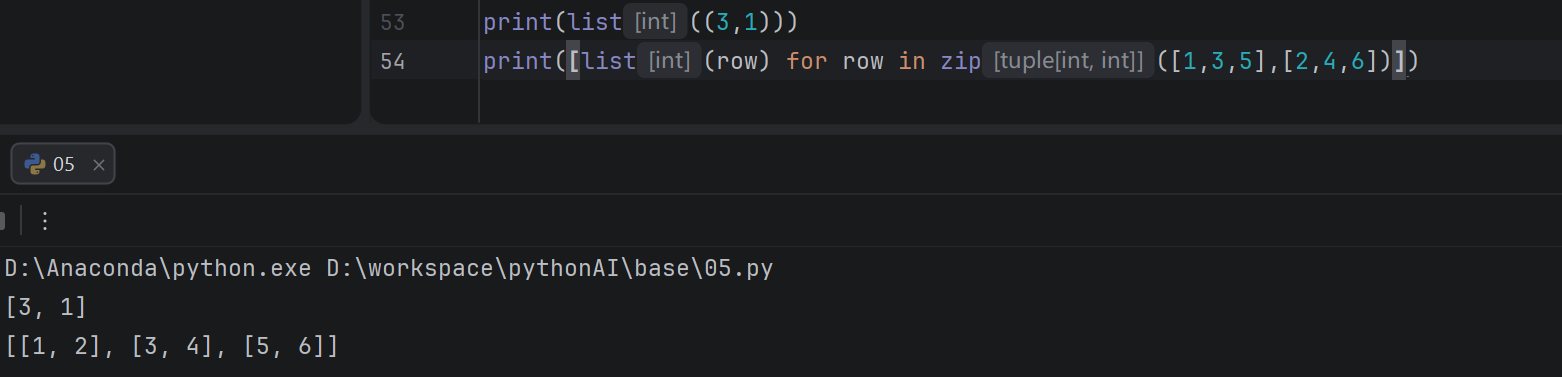
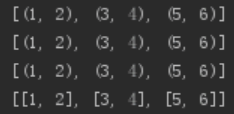
这样将zip函数返回的数据通过list和迭代,生成了二维List,方便以后操作。下边这段代码在3.0版本以上和3.0版本以下会有不同结果。
python
list1 = zip([1,3,5],[2,4,6])
print(list1)
print([row for row in list1])
print(list1)
print([list(row) for row in list1])
2.7版本结果
3.0版本结果
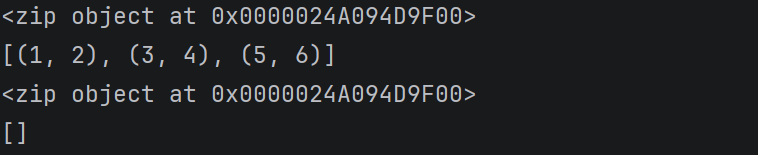
之前提起过zip在3.0以上版本返回迭代器指向内存地址。3.0以下版本返回的为列表,所以在3.0版本一下输出是符合最初目的。
但是3.0版本python最后一行输出却为空列表\[\]。这个原因主要是迭代器在被循环迭代或者访问后,会自动移动指针,指向下一个要迭代的元素。这和C++是不同的,
C++/C语言需要用户自己控制迭代器移位。那么肯定有人会说第一句和第三句打印的list1的值相同,是不是list1迭代器指向的空间没有移动呢?
不是的,只要list1被循环迭代,内部指向空间的地址就会变化,只是调用print打印list1时,python只返回迭代器指向空间的首地址,而不会告诉具体指向的地址空间。
修改下代码,看看是不是上文所述那样:
cpp
list1 = zip([1,3,5],[2,4,6])
print(list1)
print([row for row in list1])
print(next(list1))
print([list(row) for row in list1])
结果:
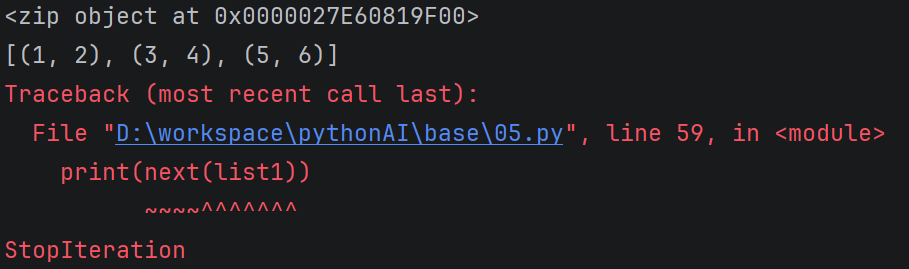
可见,输出list1指向地址内容的时候出现StopIteration异常,这个异常前几篇介绍过,是因为迭代器已经指向空间的末尾了,再调用就会出现该异常,所以对于迭代器当遍历迭
迭代后一定要注意迭代器指向地址变化的问题。
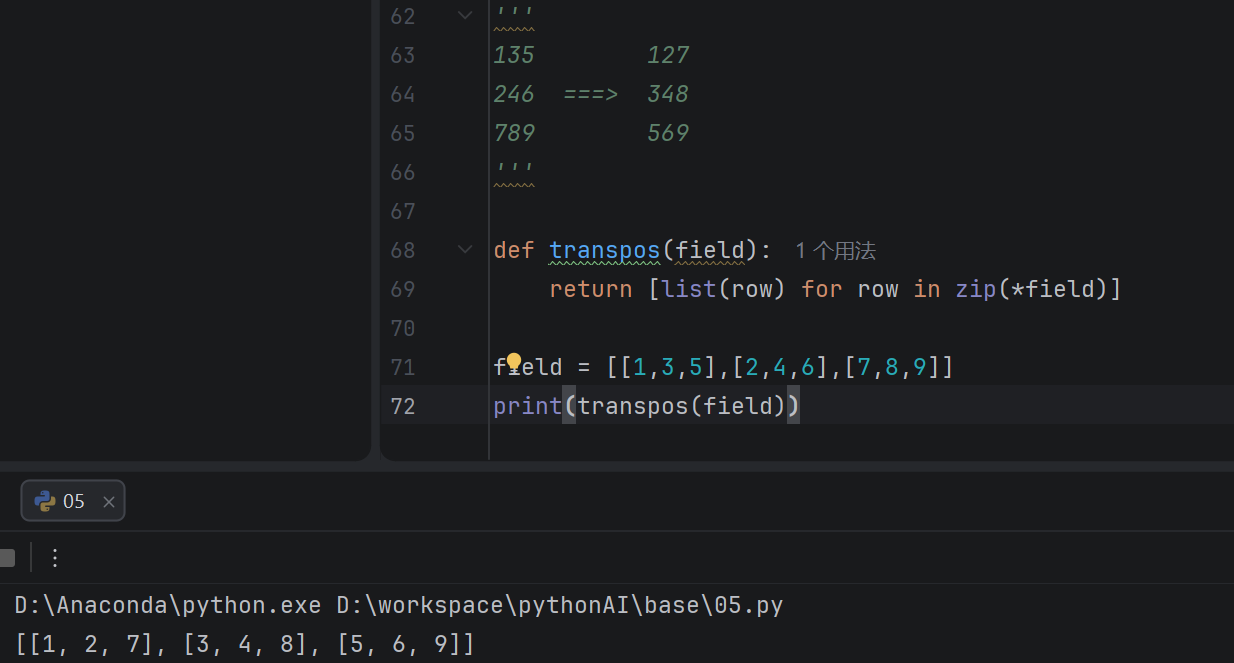
4.2 矩阵的转置和左右逆置
通过zip函数可以实现矩阵的转置和逆置,
将矩阵按照每一行存储在一个list中,这些list再组合成一个大的list,构成二维list表示矩阵。
4.3 defaultdict函数介绍
实现一个统计字符串个数的功能。
python
strings = ('puppy','kitten','popipa',''pipopa,
          'popipapa','pipopa')
如果用下边的代码实现统计功能
python
strings = ('puppy','kitten','popipa',''pipopa,
          'popipapa','pipopa')
counts = {}

for kw in strings:
counts[kw] += 1当counts中不存在某个单词,第一次调用countskw+=1会提示报错。所以有几种方式实现该功能。
cpp
strings = ('puppy','kitten','popipa',''pipopa,
          'popipapa','pipopa')
counts = {}

for kw in strings:
    if kw not in counts:
        counts[kw] = 1
    else:
        counts[kw] += 1
这种方式先判断counts中是否含有关键字,没有就先赋值。
cpp
for kw in strings:
    if kw not in counts:
        counts[kw] = 1
    else:
        counts[kw] += 1

strings = ('puppy','kitten','popipa',''pipopa,
          'popipapa','pipopa')
counts = {}

for kw in strings:
    counts[kw] = counts.setdefault(kw, 0) + 1
这种方式通过设置counts中关键字对应的默认值,当counts中不存在某个关键字,
那么该关键字对应的value为0,然后该值+1,表示第一次统计。
如果counts中存在该关键字,那么就不执行setdefault函数,关键字对应的value值加1。
python
from collections import defaultdict

strings = ('puppy','kitten','popipa',''pipopa,
          'popipapa','pipopa')

counts = defaultdict(lambda: 0)
这种方式引用了collections的defaultdict,difaultdict接收一个函数,该函数
返回dict中元素的默认值。
4.4 any函数介绍
any函数接收一个可迭代对象,一般为list或者tuple,list或者tuple中有一个
元素满足条件any函数就返回true,当所有元素都不满足条件,any返回false
python
nums = [1,2,3,5,6]
print(any((i%2) for i in nums))
print(any((i > 12) for i in nums))
print(any([0, '', False]))
print(any(['a', 'b', '', 'd']))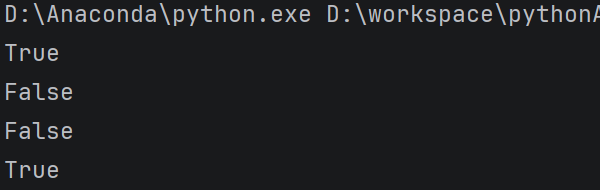
5. 定制类和枚举
5.1 定制类
python定制类主要是实现特定功能,通过在类中定义特定的函数完成特定的功能。
python
class Student(object):
    def __init__(self, name):
        self.name =name

student = Student("lilei")
print(student)str用法
python
class Student(object):
    def __init__(self, name):
        self.name = name
    def __str__(self):
        return ("self name is %s" %(self.name))

student2 = Student("hanmeimei")
print(student2)实现__str__函数,可以在print类对象时打印指定信息
通过实现__iter__和__next__同样可以使类对象产生可迭代序列,下面实现了斐波那切数列。
python
class Fib(object):
    def __init__(self):
        self.a , self.b = 0,1
    def __iter__(self):
        return self
    def __next__(self):
        self.a, self.b = self.b, self.a+ self.b
        if self.a > 30:
            raise StopIteration()
return self.a__iter__返回一个可迭代对象,这里我们返回了Fib自己的对象。 __next__是根据迭代器返回每一个迭代的序列,这里实现了运算规则,返回对象的a成员。 打印输出
python
for n in Fib():
print(n)getitem用法
可以实现__getitem__函数,这样就可以按照索引访问类对象中迭代元素了。
python
class OddNum(object):
    def __init__(self):
        self.num = -1
    def __iter__(self):
        return self
    def __next__(self):
        self.num = self.num +2
        if self.num > 10:
            raise StopIteration()
        return self.num

    def __getitem__(self,n):
        temp = 1
        for i in range(n):
            temp += 2
        return temp
python
for n in OddNum():
    print(n)

oddnum = OddNum()
print(oddnum[3])可以进一步完善OddNum类的__getitem__函数,使其支持切片处理
python
def __getitem__(self, n):
    if isinstance(n ,int):
        temp =1
        for i in range(n):
            temp +=2
        return temp
    if isinstance(n, slice):
        start = n.start
        end = n.stop
        if start is None:
            start = 0
        tempList = []
        temp = 1
        for i in range(end):
            if i >= start:
                temp += 2
                tempList.append(temp)
        return tempList
可通过如下方式调用 print(oddnum[1:4])
getattr用法
通过实现__getattr__函数,可以在类对象中没有某个属性时,自动调用__getattr__函数 实现__call__函数,可以实现类对象的函数式调用
python
def __getattr__(self,attr):
    if attr == 'name':
        return 'OddNum'
    if attr == 'data':
        return lambda:self.num
    raise AttributeError('\'OddNum\' object has no attribute \'%s\'' %attr)
def __call__(self):
return "My name is OddNum!!"只有在没有找到属性的情况下,才调用__getattr__,已有的属性不会在__getattr__中查找。
python
print(oddnum.name)
print(oddnum.data)
#没有func函数会抛出异常
#print(oddnum.func)
#可以直接通过oddnum()函数式调用
print(oddnum())
5.2 定制类案例
下面是一个链式转化例子,用到了这些特定函数
python
class Chain(object):
    def __init__(self, path=''):
        self.path = path
    def __getattr__(self,attr):
        return Chain('%s/%s'%(self.path, attr))
    def users(self, users):
        return Chain('%s/users/%s' %(self.path, users))
    def __str__(self):
        return self.path
    __repr__ = __str__
print(Chain().users('michael').repos)
repr 表示一个对象的字符串显示,当我们打印这个对象时,如果没有实现str 函数,则会调用repr 函数。 另外,当我们打印datetime对象时,可以看到repr 相比str 目标更具有准确性,str 目标在于可读性。 另外,在迭代器迭代打印的时候默认调用的是对象的repr 函数。 所以在我们实现了str 方法后,基本也会将其赋值给repr 函数。 具体的参考连接python中魔法方法__str__与__repr__的区别 - miaoning - 博客园 因为我们定义了getattr 函数,所以当属性不存在时就会构造一个新的对象返回,返回的对象拼接了之前的path信息和attr属性。 我们定义了users函数,这样可以调用users函数了。但是我们可以用更简洁的办法实现各种函数的调用而不用定义他们,就是通过实现call函数,这样就可以实现链式调用。
python
class Chain(object):
    def __init__(self, path=''):
        self.path = path
    def __getattr__(self,attr):
        return Chain('%s/%s'%(self.path, attr))
    def __call__(self, param):
        return Chain('%s/%s'%(self.path, param))
    def __str__(self):
        return self.path
    __repr__ = __str__

print(Chain().get.users('michael').group('doctor').repos)当调用users('michael')时,因为没有定义users函数,所以会调用getattr 函数,进而构造一个新的Chain对象。因为实现了call函数,所以这个对象可以被当作函数来使用,也就是Chain('michael')的方式。
5.3 enum枚举
python同样支持枚举操作
python
from enum  import Enum
Month = Enum('Month', ('Jan', 'Feb', 'Mar', 'Apr', 'May', 'Jun', 'Jul', 'Aug', 'Sep', 'Oct', 'Nov', 'Dec') )
for name, member in Month.__members__.items():
    print(name, '=>', member, ',', member.value)

from enum import  unique
@unique
class Weekday(Enum):
    Sun = 0 # Sun的value被设定为0
    Mon = 1
    Tue = 2
    Wed = 3
    Thu = 4
    Fri = 5
    Sat = 6

for name , member in Weekday.__members__.items():
    print(name, '=>', member, ',', member.value)
6. 元类
python 可以通过type函数创建类,也可通过type判断数据类型
python
import socket
from io import StringIO
import sys
class TypeClass(object):
    def typeprint(self, name = 'typeclass'):
        print('class name is %s' %(name))

typeclasses = TypeClass()
print(type(TypeClass))
print(type(typeclasses))

def printHW(self):
    print('Hello world!!!')
TypeClass2 = type('TypeClass2', (object,), dict(typeprinthw = printHW))
typeclass2 = TypeClass2()
typeclass2.typeprinthw()
type创建类格式为type('类名',(基类1,基类2...), dict(成员函数名=函数名)) 第一个参数为类名,第二个参数为一个tuple,如果继承的基类只有一个,要注意tuple写法(基类,),第三个参数为dict构造的类成员函数 除了可以用type创建类之外,可以用metaclass限制类的行为 使用metaclass需要先定义一个特定功能的元类,这个元类一般按照功能名字命名,末尾以Metaclass结束,表示一个特定功能的元类,这个元类必须继承于type类,内部必须实现 __new__借口完成类的限定。__new__的调用先于__init__,在对象构造之前调用。
python
class DictMetaclass(type):
    def __new__(cls, name, bases, attrs):
        def insertfunc(self, key, value):
            self[key]=value
        attrs['insert'] = insertfunc
        return type.__new__(cls,name,bases,attrs)

class MyDict(dict, metaclass = DictMetaclass):
    pass

mydict = MyDict()
mydict.insert('nice', 3)
print(mydict['nice'])定义了一个DictMetaclass元类,继承于type类,内部实现了new 方法,new 方法四个参数分别为准备创建的类对象,类名字,该类的基类集合,类的方法集合。并且new 内部调用了type类的new函数,完成了新功能属性的绑定。下面同样实现一个list类的扩展
python
class ListMetaclass(type):
    def __new__(cls, name, bases, attrs):
        attrs['insert'] = lambda self, value: self.append(value)
        return type.__new__(cls,name,bases,attrs)

class Mylist(list,metaclass = ListMetaclass):
    pass

mylist = Mylist()
mylist.insert('name')
mylist.insert('age')
print(mylist)
下面为ORM框架例子 ORM全称"Object Relational Mapping",即对象-关系映射,就是把关系数据库的一行映射为一个对象,也就是一个类对应一个表,这样,写代码更简单,不用直接操作SQL语句。 要编写一个ORM框架,所有的类都只能动态定义,因为只有使用者才能根据表的结构定义出对应的类来。 让我们来尝试编写一个ORM框架。 先实现Field类和其派生类
python
class Field(object):
    def __init__(self, name, column_type):
        self.name = name
        self.column_type = column_type
    def __str__(self):
        return '<%s%s>' %(self.__class__.__name__, self.name)

class IntegerField(Field):
    def __init__(self, name):
        super(IntegerField,self).__init__(name, 'bigint')

class StringField(Field):
    def __init__(self, name):
        super(StringField, self).__init__(name,'varchar(100)')
Field类用来管理数据库的字段和字段类型 实现ModelMetaclass这个元类,用于限制User类
python
class ModelMetaclass(type):
    def __new__(cls,name,bases,attrs):
        if  name == 'Model':
            return type.__new__(cls, name, bases, attrs)
        print('Founc model: %s' % name)
        mappings = dict()
        for k, v in attrs.items():
            if isinstance(v,Field):
                print('Found mapping: %s ==> %s' %(k,v))
                mappings[k] = v
        for k in mappings.keys():
            attrs.pop(k)
        attrs['__mappings__'] = mappings
        attrs['__table__'] = name
return type.__new__(cls, name, bases, attrs)ModelMetaclass类中过滤了Model类的处理,将其他类的属性删除,将映射关系存储至mappings 属性字段,并且table字段用来存储类名。 下面实现Model类
python
class Model(dict , metaclass=ModelMetaclass):
    def __init__(self, **kw):
        super(Model, self).__init__(**kw)
    def __getattr__(self, key):
        try:
            return self[key]
        except KeyError:
            raise AttributeError(r"'Model' object has no attribute '%s' " %key)
    def __setattr__(self, key, value):
        self[key]=value

    def save(self):
        fields = []
        params = []
        args = []
        for k, v in self.__mappings__.items():
            fields.append(v.name)
            params.append('?')
            args.append(getattr(self, k, None))
        sql = 'insert into %s (%s) values (%s)' % (self.__table__, ','.join(fields), ','.join(params))
        print('SQL: %s' % sql)
        print('ARGS: %s' % str(args))
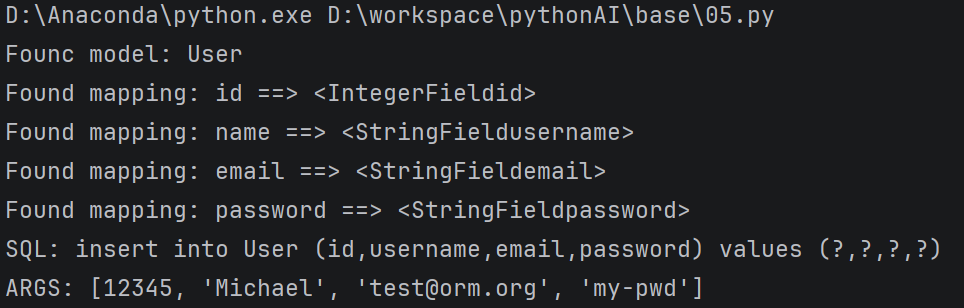
Model 类继承了dict, 实现save函数,save函数将mappings属性值内容取出来,就是在ModelMetaclass中构造的mappings,其他类继承Model,调用save函数可以动态调用sql语句。 定义User类并且调用save
python
class User(Model):
    # 定义类的属性到列的映射:
    id = IntegerField('id')
    name = StringField('username')
    email = StringField('email')
    password = StringField('password')

u = User(id=12345, name='Michael', email='test@orm.org', password='my-pwd')
u.save()
输出如下:
结语
我是YYYing,后面还有更精彩的内容,希望各位能多多关注支持一下主包。
无限进步,我们下次再见!